关于 lynx
Lynx 是面向开发者和编码 Agent 的本地 MCP 服务,用于回答 grep 难以处理的代码问题。它结合 AST 感知索引、混合检索和可选代码图,并将索引数据保留在本机。
主要功能
- 01AST 感知代码索引
- 02BM25 与稠密检索混合搜索
- 03可选代码知识图谱
- 04联合索引代码、文档和 PDF
- 05本地 MCP 服务和 CLI
适用场景
- 01修改符号前追踪调用方和影响范围
- 02标识符不明确时查找代码行为
- 03检索所用库版本的文档
- 04针对变更文件进行搜索审查
MCP 相关
Lynx 向 MCP 客户端提供代码搜索、符号查询、图查询、影响分析和来源维护工具。它还会在 MCP 握手期间提供使用说明和指南资源。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
Lynx
LynxMCP 是一款完全本地运行的 MCP 服务,可回答 grep 无法解答的代码问题:是谁调用了它、修改它会导致什么问题、执行 X 的代码在哪里、我实际使用的库版本表现如何。它支持 AST 感知分块、BM25 与稠密检索混合、可选的代码知识图谱,还能将库文档和 PDF 与代码一起编入索引。适用于任何 MCP 客户端(Claude Code、Cursor、Windsurf、Antigravity,等等)。




如果你知道标识符,而且 Agent 已经掌握了它,grep 就是合适的工具。Lynx 则用于回答 grep 无法解答的问题。行为问题:“我们在哪里限制摄像机缩放?”——没有任何字面匹配。结构问题:谁调用了它、什么继承了它、修改它会导致什么问题;多态分派不会留下文本痕迹。超出模型训练截止时间的知识:你所用框架版本的文档,可作为数据源编入索引。任何内容都不会离开你的设备。
grep 无法解答的问题
每一行都经过了测量;数字来自下方的基准测试(可复现)。
| 问题 | Agentic grep | Lynx |
|---|---|---|
“什么继承了 Field?”(Django,跨 4 层的 100 个类) | 101 轮 grep,每发现一个类就查一次 | 4 次 graph_query 调用,每条边都标出 file:line |
“修改 ApplyDamage 会导致什么问题?” | 对该名称的文本提及 | impact:所有传递调用方及其跳数距离,还有需要重新运行的测试 |
| “在 C#(Json.NET)中,我们在哪里验证会话令牌?” | hit@1 为 33% | hit@1 为 47% |
| “这个 API 在我们发布的版本中表现如何?” | 模型的记忆 | 你编入索引的文档,并注明引用页码 |
本页也会说明 grep 更好的情况。在 Guava 中,类名本身就能说明用途(BloomFilter、RateLimiter),grep 的排名更高:hit@1 为 73%,而 Lynx 为 60%。如果代码仓库能放进 Agent 的上下文中,内置工具就足够了。Lynx 在大型代码库、模型所掌握的信息已经过时的框架文档,以及需要反复探索、从头开始会造成浪费的多次会话中更有价值。
快速入门
# 1. Install the CLI (isolated, no venv ritual). About 460 MB on disk, no PyTorch.
pipx install lynx-mcp
#    or: uv tool install lynx-mcp

# 2. Create a config and point it at your project
lynx manager init
lynx source add myproject --type codebase --path /path/to/your/repo

# 3. Build the index (downloads the 130 MB embedding model on first run)
lynx build
lynx manager init 还会提供打开 Web UI 的选项,你可以通过带文件夹选择器的引导表单添加相同的数据源。以下操作无论采用哪种方式都适用。
AI 获得的每个工具也都可以作为命令使用,名称和输出都相同:lynx find-definition ApplyDamage、lynx impact ApplyDamage、lynx graph query --op callers --symbol ApplyDamage。为任意命令添加 --json,即可用于脚本。
接下来,在 MCP 客户端中注册 Lynx。这里以 Claude Code 为例;完整指南介绍了 Cursor、Antigravity 和通用 stdio 客户端,也可以运行 lynx manager ui 自动生成配置片段:
{
  "mcpServers": {
    "lynx": {
      "command": "lynx",
      "args": ["serve", "--config", "/absolute/path/to/config.json"]
    }
  }
}
服务会在约 1 秒内响应 MCP 握手,并在后台打开索引;如果调用提前到达,会先返回加载状态,然后重试。如果你想跳过终端,也可以使用适用于 macOS 和 Windows 的双击安装程序。
AI 获得的工具
工具集是固定的,不会随来源数量增加。它也分层设计,因为每轮对话中,所有工具定义都会占用客户端的上下文。共有三种配置:core(5 个工具,定义约占 1,300 个 token)、standard(10 个工具,约占 2,800 个 token,默认配置)和 full(17 个工具,约占 4,150 个 token)。在 config.json 中设置 tools.profile,或传入 lynx serve --profile full;tools.include 可向配置中添加单个工具。相关工具接受 source 参数。
| 工具 | 配置 | 可回答的问题 |
|---|---|---|
search(query, source?, outline?) | core | 主要的混合搜索。省略 source 即可同时搜索所有来源(经 RRF 融合)。outline=true 只返回签名,便于低成本初步筛查。 |
deep_search(queries, source?) | standard | 深入搜索:尝试多种查询表述,直到有一种达到质量阈值。 |
graph_query(operation, symbol?) | standard | callers、callees、subclasses、superclasses、imports、neighbors、shortest_path、overview、surprising_connections、status。 |
find_definition(symbol) | standard | X 定义在哪里?(图谱启用时采用精确 AST 查询,否则回退到 BM25。) |
find_usages(symbol) | core | X 的所有用法:调用和非调用引用(泛型、装饰器、文档)。 |
find_tests_for(symbol) | full | X 有对应的测试吗? |
find_similar(snippet) | full | 是否已有类似这样的代码? |
describe_symbol(symbol) | core | 一次性获取 X 的上下文:定义、调用它的对象、它调用的对象及其测试。 |
impact(symbol) | core | 影响范围:通过调用图 传递地 到达 X 的所有对象(附带跳数),以及需要重新运行的测试。 |
module_summary(file) | full | 将文件作为一个整体来查看:它定义的符号、导入的内容,以及依赖它的文件。(图谱) |
repo_overview() | standard | “这是什么,我该从哪里开始”:检测到的语言、框架、入口点,以及构建/测试/运行命令。 |
export_graph(target, mode?) | full | 将可分享的离线图谱视图(符号的影响范围或文件枢纽)渲染为单个自包含文件。(图谱) |
search_diff(query, base?) | standard | 仅搜索相对于基准分支已更改的文件。专为代码审查打造。 |
feedback(trying_to_do, tried, stuck) | core | 索引无法回答时,由 Agent 提交报告。报告完全保存在本地,是调整来源的依据。 |
list_sources / get_rag_status / update_source_index | full | 状态查看与维护。 |
检索工具带有 MCP readOnlyHint 注解,客户端可据此自动批准。唯一的写入操作是 export_graph,它会保存图谱视图文件。服务会在 MCP 握手中提供使用指南(instructions 和 lynx://guide 资源),因此 Agent 无需配置任何规则文件,就知道如何进行有效查询。
(图谱) 工具需要为相应来源启用可选的代码知识图谱。工具集按功能能力划分,不按来源划分。
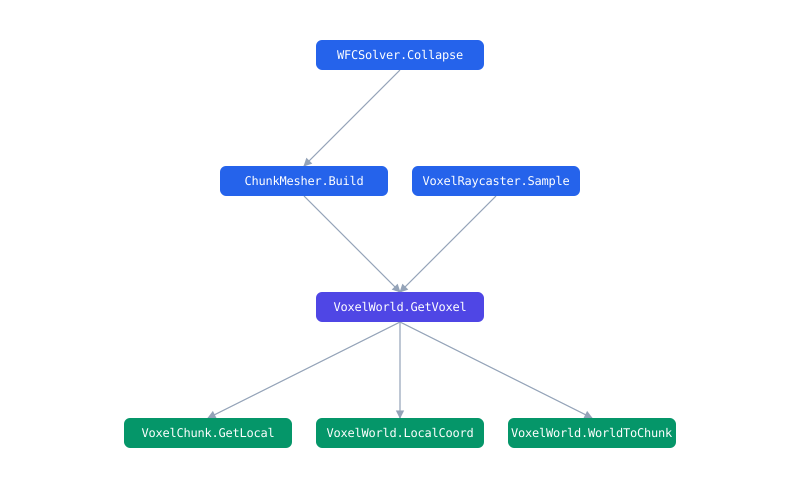
可分享的图谱视图:lynx graph export --symbol GetVoxel 会生成一个自包含的离线文件(无需服务或 CDN),其中展示该符号的影响范围、调用它的对象(上方)和它调用的对象(下方)。可将其附加到 PR,或存档以供审计。
flowchart LR
    A["Your code + docs + PDFs"] --> B["Tree-sitter<br/>AST chunker"]
    B --> C["bge-small<br/>dense embeddings"]
    B --> D["code-tokenized<br/>BM25"]
    B --> G["Code knowledge graph<br/>(opt-in)"]
    C --> R{{"RRF fusion"}}
    D --> R
    Q(["Your query"]) --> R
    R --> RR["Optional<br/>reranker"]
    RR --> RES["Ranked code<br/>file : line : symbol"]
    G --> GT["Graph tools<br/>callers · subclasses · usages"]

    classDef store fill:#fff3e6,stroke:#e8742c,color:#24292f;
    classDef out fill:#e8742c,stroke:#e8742c,color:#fff;
    class C,D,G store;
    class RES,GT out;
- Tree-sitter 可解析 18 种以上语言(包含 TSX 时共 19 种语法),并为完整的函数和类建立索引,而不是任意文本窗口。
- 检索采用混合方式:密集嵌入与经过代码词元处理的 BM25 相结合,通过 RRF 融合,并可选择使用交叉编码器重排器。
- 代码知识图谱(可选启用)会记录调用关系、继承关系和导入关系,并根据实际影响范围回答“如果我更改这个,会导致什么内容出问题?”。
- 数据源可以是代码库、公开文档网站(按需抓取一次;可选用无头 Chromium 处理由 JS 渲染的 SPA)和 PDF,并可并列搜索。
- 文件监视器会在大约 2 秒内为保存的文件重新建立索引,无需手动重建。
- 搜索和图谱也会通过本地 HTTP API 以行的形式提供服务,因此 SQL 引擎可以将代码与工单、PR 或日志联接起来(参见集成)。
lynx manager ui可在浏览器中提供引导式设置、查询试用区、诊断功能和客户端配置片段。
所有操作都在本地进行:HuggingFace 模型只需下载一次,之后 Lynx 就会切换到离线模式。没有遥测、云端索引,也不会上传代码。唯一的网络访问是下载模型,以及由你主动触发的 webdoc 抓取步骤。
模型运行于 ONNX Runtime,因此安装包中不含 PyTorch:磁盘占用约为 460 MB。在 Linux 上,下载量为 165 MB;而以前仅 torch wheel 就会带来 4 GB 的 CUDA 库。同一模型、同一向量,因此早期版本建立的索引仍可继续使用。
你可以在同一个索引上打开任意多个会话:两个编辑器窗口、编辑器加网页 UI,或在服务运行时执行 CLI 查询。它们都搜索同一个索引。只有索引操作是独占的;关闭正在执行索引的进程后,操作会自动交接。
处于防火墙之后或使用气隙隔离的机器?模型可以从镜像、本仓库的 GitHub Releases(自动回退选项),或你自行带入的归档文件获取;请参阅指南中的受限网络。
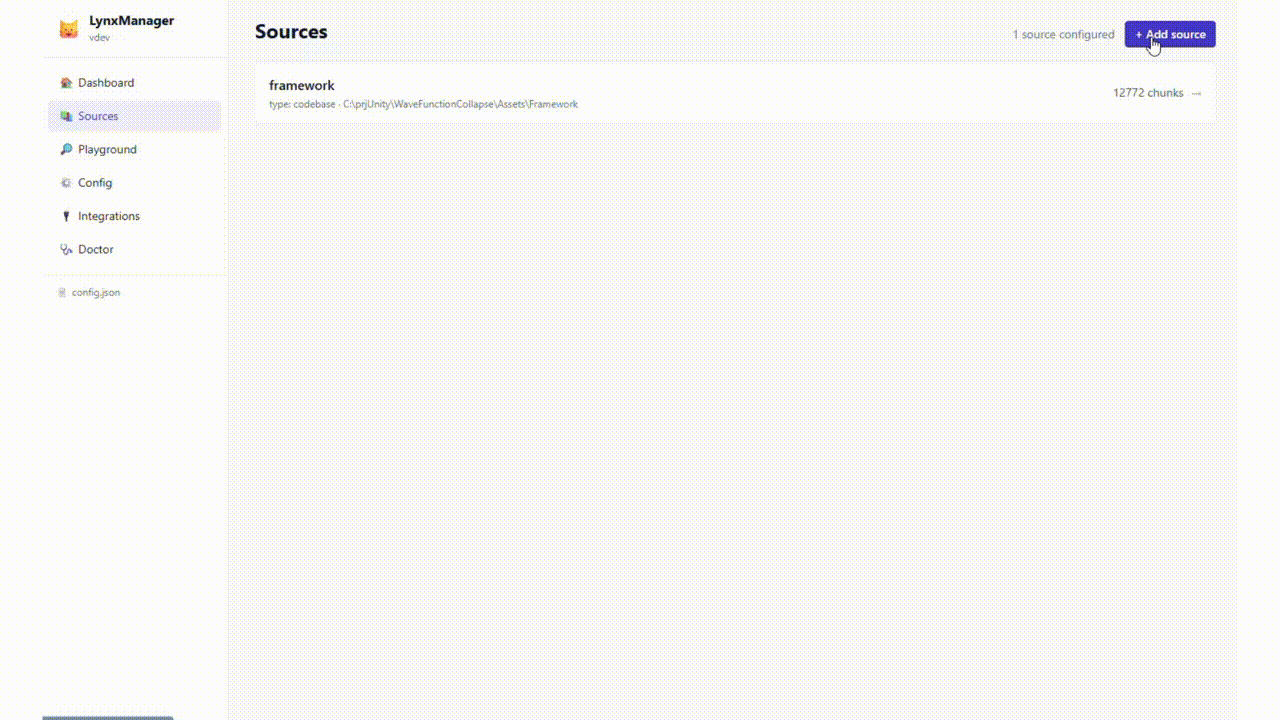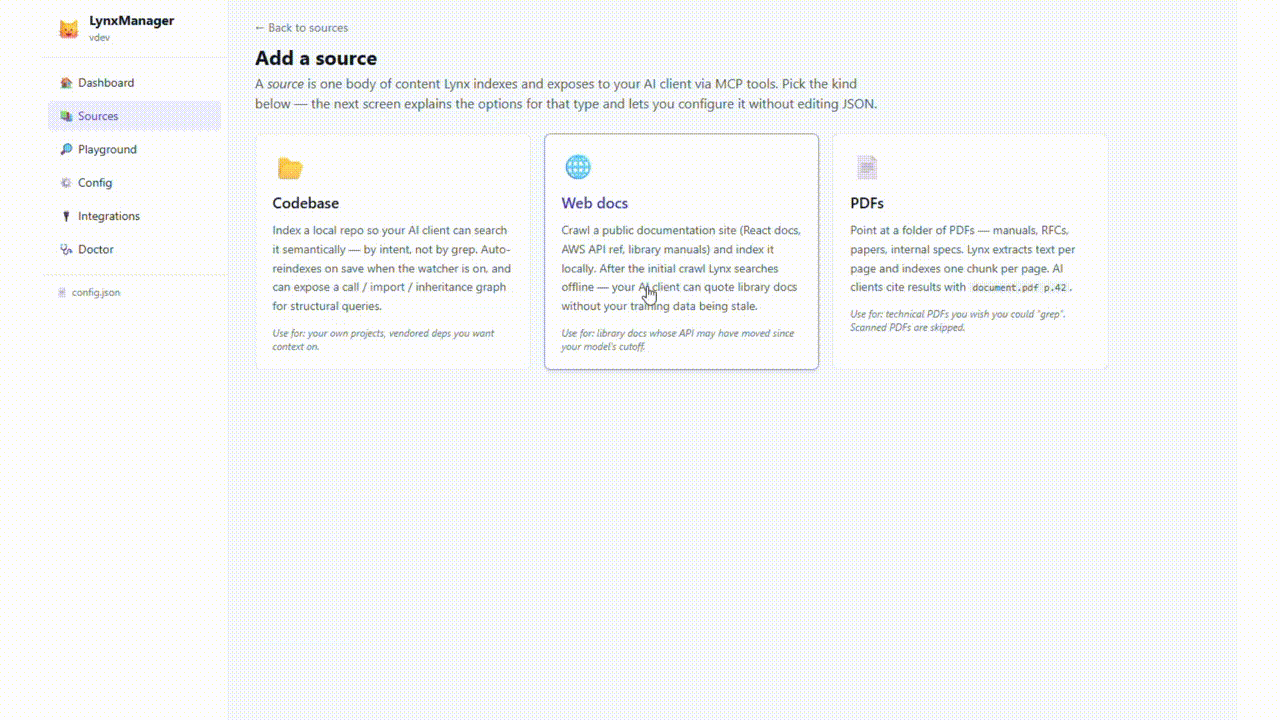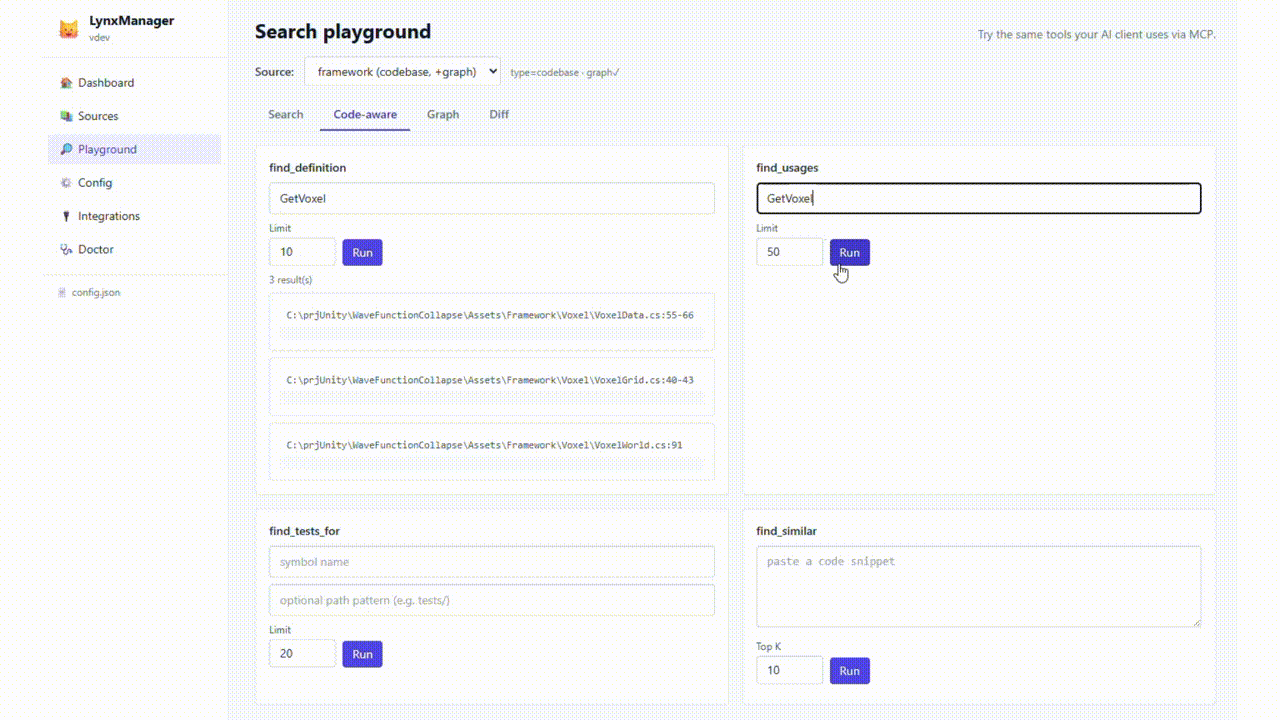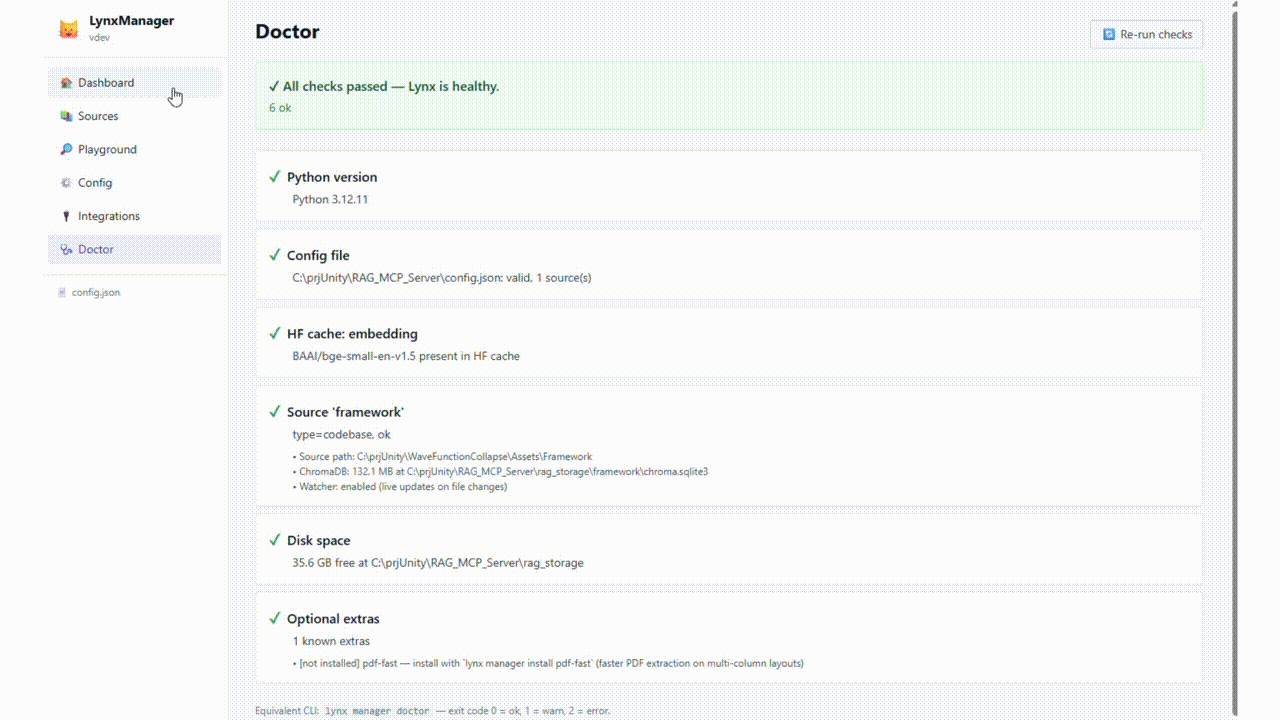
LynxManager:在浏览器中进行引导式设置、查询试用和诊断。查看完整演示
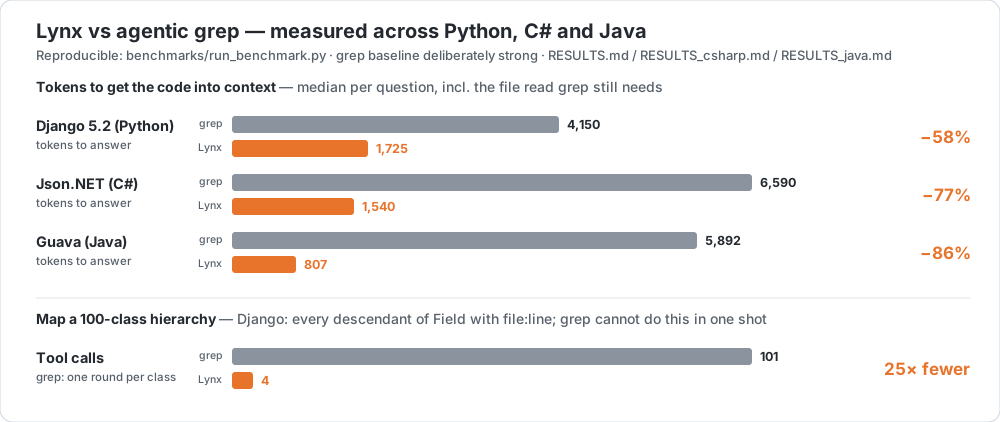
三个代码库、三种语言、带有已知真实文件的行为问题,以及一个旨在表现出色的 grep 基线(使用 IDF 加权的多关键词排序,并理想地移除停用词,比 Agent 首次运行 rg 更接近 BM25)。方法和各任务结果:Django、Json.NET、Guava。
| grep / Lynx | Django 5.2 (Python) | Json.NET (C#) | Guava (Java) |
|---|---|---|---|
| 代码库 | 883 个文件,158k 行,20 个问题 | 240 个文件,69k 行,15 个问题 | 606 个文件,181k 行,15 个问题 |
| hit@5 | 95% / 85% | 67% / 73% | 93% / 80% |
| hit@1 | 45% / 55% | 33% / 47% | 73% / 60% |
| MRR | 0.64 / 0.67 | 0.47 / 0.58 | 0.81 / 0.70 |
| 回答所需的中位令牌数 | 4,150 / 1,725 | 6,590 / 1,540 | 5,892 / 807 |
| 代码进入上下文前的工具往返次数 | 2+ / 1 | 2+ / 1 | 2+ / 1 |
排序结果会随代码的自描述程度而变化:在 C# 上 Lynx 领先,因为 PascalCase 标识符和稀少的注释会让词法基线表现不佳;在 Python 上结果不一,在 Django 这个文档字符串丰富的代码库中,hit@1 领先而 hit@5 落后;在 Guava 上则落后。令牌成本不会变化。每次都能降低 58% 至 86%,因为 Lynx 一次调用就会返回整个函数以及 file:line、符号和分数,而 grep 只会返回匹配行,之后还需要读取文件。
结构性差距则是另一回事。针对 Django 100 个类的层次结构提问“哪些类继承自 Field?”,grep 需要 101 轮,每发现一个类就进行一轮;每轮都要基于不断增长的上下文完整推理一次。graph_query 则根据已解析的继承边,只需 4 次调用就能回答,召回率相同,且每条边都标有 file:line。
# reproduce: Python (Django)
git clone --depth 1 --branch 5.2 https://github.com/django/django.git benchmarks/_target/django
python benchmarks/run_benchmark.py && python benchmarks/structural_demo.py

# reproduce: C# (Json.NET)
git clone --depth 1 https://github.com/JamesNK/Newtonsoft.Json.git benchmarks/_target/jsonnet
python benchmarks/run_benchmark.py --tasks benchmarks/tasks_jsonnet.json \
  --target-dir benchmarks/_target/jsonnet --storage-dir benchmarks/_storage_csharp \
  --results-json benchmarks/results_csharp.json --results-md benchmarks/RESULTS_csharp.md

# reproduce: Java (Guava)
git clone --depth 1 https://github.com/google/guava.git benchmarks/_target/guava
python benchmarks/run_benchmark.py --tasks benchmarks/tasks_guava.json \
  --target-dir benchmarks/_target/guava --storage-dir benchmarks/_storage_java \
  --results-json benchmarks/results_java.json --results-md benchmarks/RESULTS_java.md
成本:令牌和费用
每次检索可节省上文测得的差值:将答案放入上下文所需的令牌减少 2,400 至 5,100 个。每次会话中,工具定义需占用 1,300 个令牌(core)、2,800 个(standard)或 4,150 个(full),因此一次或两次检索后,工具列表的成本就已收回。对于宽泛的查询,outline 初步筛选还能让搜索步骤再缩短 2.4 倍(测量结果)。
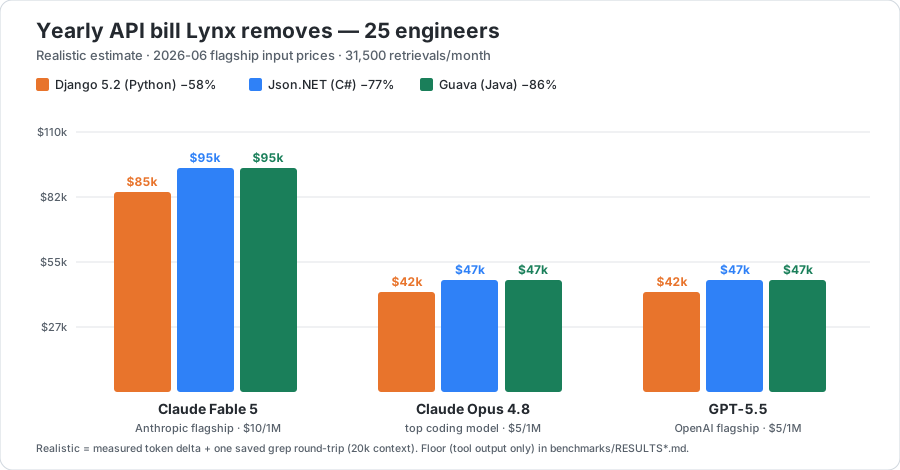
以费用计算,假设有 25 名工程师每天进行 60 次检索(每月 31,500 次),按三个代码库的结果计算,Lynx 每年可节省的 API 费用范围如下:
| 旗舰模型(输入每 100 万令牌的价格) | 实测下限 | 加上节省的一次往返 |
|---|---|---|
| Claude Fable 5 ($10) | $9,200 至 $19,200 | $16,700 至 $26,800 |
| GPT-5.5、Claude Opus 4.8 ($5) | $4,600 至 $9,600 | $8,400 至 $13,400 |
下限仅计算较小的工具输出,不作任何假设。第二列还计入 Lynx 节省的一次 grep 往返:其 20k 令牌的上下文会从提示词缓存中重新读取,价格为输入价格的十分之一。此折扣是唯一的建模假设,而且可以调整。使用你自己的团队、价格和代码库进行计算:运行 python benchmarks/savings_calculator.py --devs N,或使用交互式节省计算器(pricing.json 和 measured.json 中的预设可自行编辑)。
 ## 少读一些:大纲模式
所有搜索的排序方式都相同。search(query, outline=true)(或通过 HTTP 使用 ?view=outline)会返回排序相同的命中结果,但不包含正文:每项包含一行签名和文档字符串的首行,Agent 可以浏览候选项,再根据引用的 file:line 读取所需的单个正文。在公开仓库 psf/requests 上,这让搜索步骤的 token 数减少了 2.4 倍。何时使用哪种模式、测量数据和图表:docs/OUTLINE.md。
集成
搜索和代码图谱通过本地 HTTP API(/api/v1)以 NDJSON 格式提供;MCP 工具可以与 Agent 使用的任何其他 MCP 服务组合使用。以下所有操作都在你的机器上进行;只有联接的另一端(GitHub、Jira、Sentry)会访问 API。
- Coral:Lynx 是 Coral 注册表中的社区数据源,提供
lynx.search和六个图谱函数,因此可以将有关行为的问题转化为 SQL 表,并与实时 GitHub 或 Sentry 数据联接。 - DuckDB:
read_ndjson_auto('http://127.0.0.1:8765/api/v1/search?...')会作为表使用,无需插件或守护进程;可将代码相关性与 Git 变更、错误日志或工单导出数据联接。 - Steampipe:一个插件,提供
lynx_source、lynx_search和lynx_graph表,可逐行联接,即针对另一张表的每一行执行一次搜索;可在发布页面获取预构建的 macOS 和 Linux 二进制文件。 - GitHub Action:每个 PR 上都会发布一条评论,列出下游调用方和语义相关代码,索引在 runner 本地完成。
- MCP recipes:将 Lynx 与 GitHub、Sentry 和 Jira MCP 服务组合使用的 Agent 模式(分诊、PR 影响分析、从工单定位代码)。
文档
| 完整指南 | 配置、所有来源类型(代码库 / webdoc / PDF)、检索机制、工具配置方案、故障排除 |
| 管理器 UI | 引导式设置、操作场、诊断 |
| 大纲模式 | 使用签名而非正文:适用场景、测量数据、图表 |
| Coral / DuckDB / Steampipe | 将代码搜索和代码图谱作为 SQL 表使用 |
| MCP recipes | 将 Lynx 与 GitHub / Sentry / Jira MCP 服务组合使用 |
| PR 影响分析(GitHub Action) | 每个 PR 的评论中都会列出下游调用方和相关代码 |
| config.example.json | 带注释的示例配置 |
状态
由一位作者开发;在 1.x 稳定之前,API 仍可能发生变化。欢迎提交问题和 PR。测试套件使用 pytest 运行,CI 必须保持通过。请参阅 ROADMAP.md,了解正在考虑的事项(以及明确不在计划中的事项)。
许可证
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。