关于 lcc — Local Context Compiler
lcc 是面向编码 Agent 的本地上下文压缩工具,通过移出旧工具输出减少上下文占用,同时逐字保留其余内容并支持哈希校验后找回。它提供 CLI、Claude Code 插件和 MCP 服务。
主要功能
- 01本地压缩会话与文档
- 02逐字保留用户和助手消息
- 03暂存并按哈希找回输出
- 04生成可审计报告与删除说明
- 05离线统计令牌与缩减量
适用场景
- 01压缩长时间编码会话
- 02找回先前移出上下文的工具输出
- 03检查压缩过程保留或删除的内容
MCP 相关
lcc 作为 MCP 服务提供 compact、compact_transcript、recall、inspect、prepare、explain 和 intake 工具,供 MCP 客户端压缩上下文并找回暂存输出。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
7收录的工具列表 · 更新于 1 周前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| text | string | 是 | |
| provider | enum | 否 | auto | jev | laya | mechanical |
| question | string | 是 | |
| threshold | number | 否 |
详细介绍
lcc — 本地上下文编译器
紧凑的编码 Agent 上下文,不做摘要,不丢内容。
lcc 删除模型不需要的内容,其他内容逐字节保留,并生成操作记录。



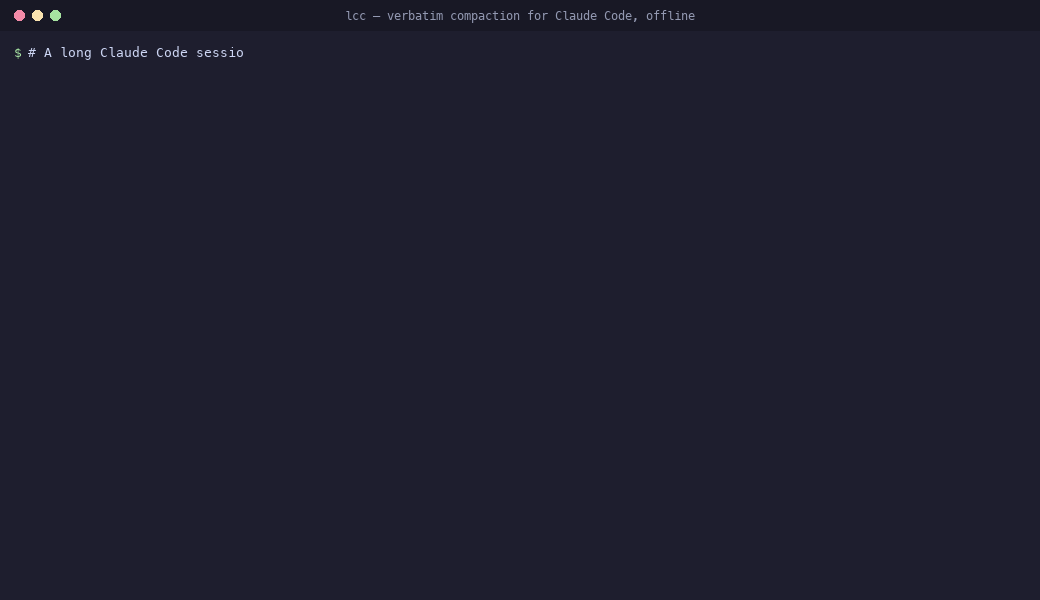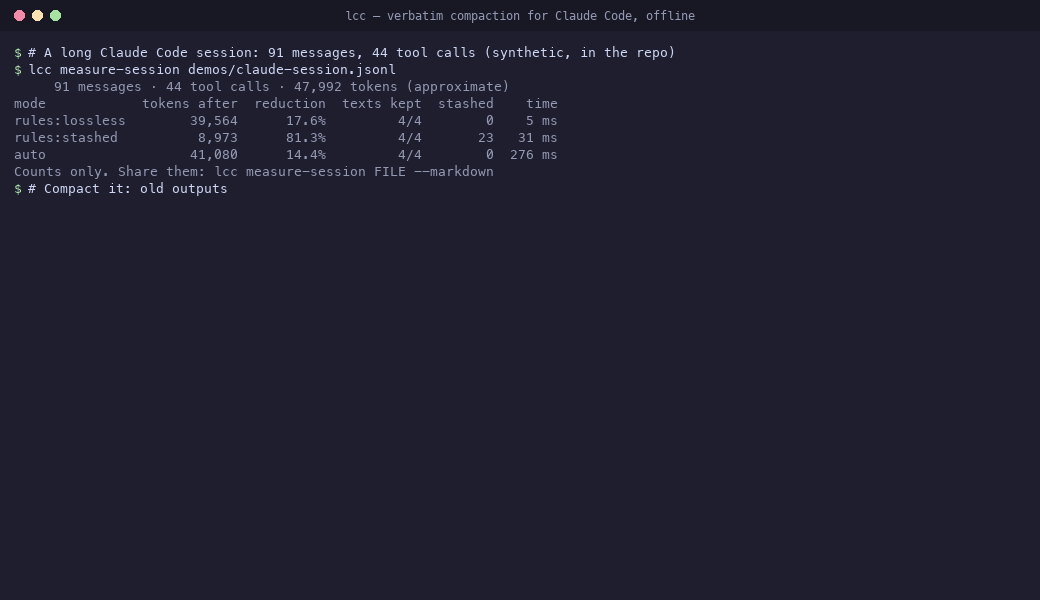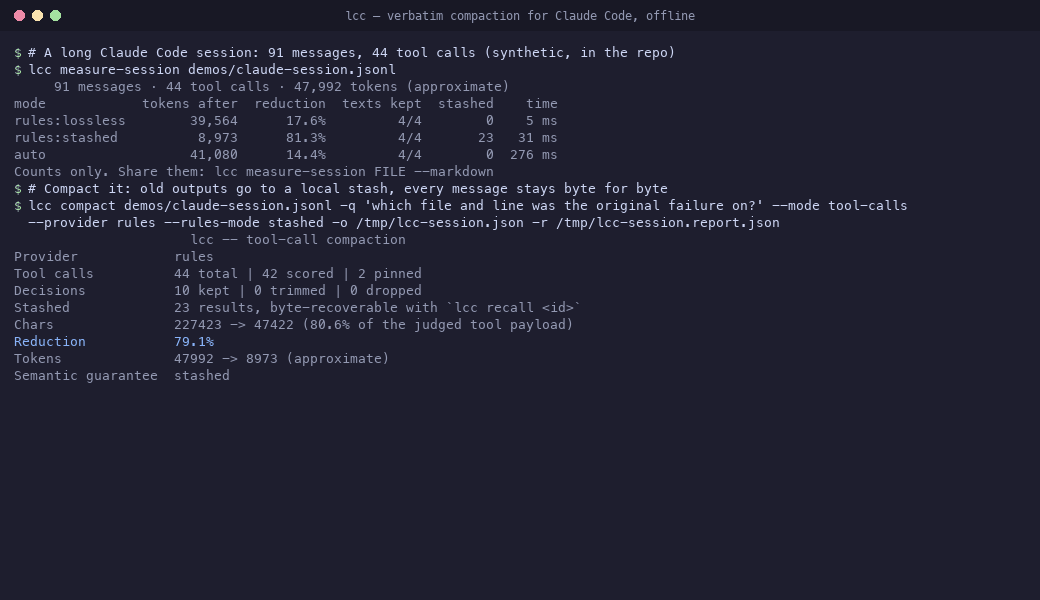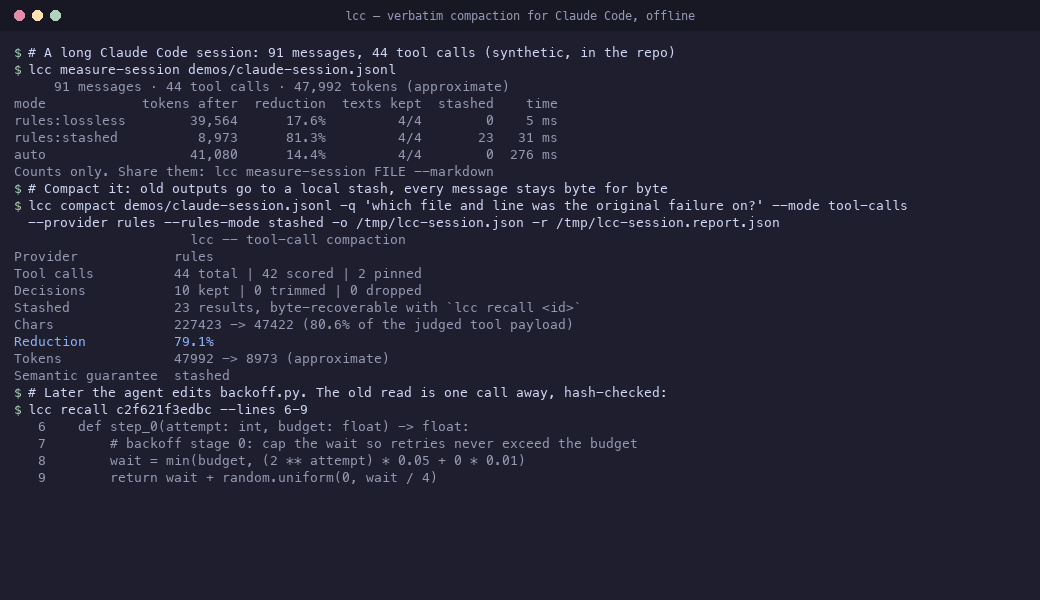
/compact 与 lcc 对比
Claude Code 的 /compact 会用模型生成的摘要替换你的会话。摘要会丢掉 Agent 两轮之后可能需要的确切错误、路径或行。lcc 则恰恰相反:旧工具输出会从上下文中移除,但只需一次 recall 就能取回;每条用户和助手消息都按原样保留。
| 一个真实的 Claude Code 会话(193 条消息,75 次工具调用) | token 数 | 用户和助手消息 | 移除的工具输出 |
|---|---|---|---|
| 之前 | 57,083 | 43 条,原样保留 | — |
/compact | 一份摘要 | 改写到摘要中 | 已丢失 |
lcc(rules、stashed) | 28,807(−49.5%) | 43 / 43 条,逐字节保留 | 33 条,每条都可通过一次 recall 取回 |
使用 lcc measure-session 测量(PyPI 1.2.0,离线,精确的 o200k_base token 数;于 2026-10-23 重新运行)。在 main 上,暂存说明如今会标明行数和大小;同一会话的结果是 28,983(−49.2%)。这个会话属于效果最好的情况之一。在我的全部 299 个长会话中(每个会话有 100 条以上消息,共 36.3 M 个 token),中位压缩率为 21.8%(中间一半在 15% 到 31% 之间,最高 65%),且没有丢失任何消息(python benchmarks/research/long_sessions.py,2026-10-23,main)。这些都是我的会话:在你的会话上运行并分享结果。
在一项针对 172 个真实请求的预注册测试中(证据),Agent 使用 stashed 上下文加 recall 作答,在文件内容回忆方面与使用完整上下文的效果相当(+0.006,95% CI −0.023 至 +0.034),token 数减少了 36.6%。对于 90% 的已移除内容相关问题,它都调用了 recall。对同一批会话生成的 /compact 式摘要(我们重新实现的 /compact,由 Opus 编写)仅有 73% 的确切值正确;完整且原样的上下文则为 98%。
安装
pip install "local-context-compiler[tiktoken]"   # the CLI is `lcc`
lcc fetch-tokenizer                               # once: exact token counts
lcc measure-session "$(ls -t ~/.claude/projects/*/*.jsonl | head -1)"   # your latest session
fetch-tokenizer 会下载 tiktoken 的编码文件;它只会让 lcc 连接网络一次。不运行它时,计数结果会标记为近似值。最后一行会读取你最近的 Claude Code 会话,离线运行规则模式,几秒内仅打印计数。不会更改任何内容,也不会有任何内容离开本机。
Claude Code 插件(替代 /compact 摘要)。函数钩子仍处于早期访问阶段,因此需要 Claude Code 2.1.274+ 和下方的标志:
export CLAUDE_CODE_ENABLE_FUNCTION_HOOKS=1
claude plugin marketplace add lucasmartins-ai/lcc
claude plugin install lcc@lcc --config provider=rules --config rulesMode=stashed
允许 mcp__plugin_lcc_lcc__recall,让 Agent 能取回已移除的输出。如果某轮处理失败或移除的内容太少,插件会改用内置摘要,并通过提示消息说明。详情:Claude Code 指南。
MCP(Claude Code、Cursor、Claude Desktop,以及任何 stdio 客户端):
{"mcpServers": {"lcc": {"command": "lcc", "args": ["mcp"]}}}
工具:compact、compact_transcript、recall、inspect、prepare、explain、intake(MCP 指南)。
CLI,可用于会话文件或任何文档:
lcc compact ~/.claude/projects/<project>/<session>.jsonl -q "finish the parser fix" \
  --mode tool-calls --provider rules --rules-mode stashed -o compacted.json -r report.json
lcc recall <id>                                   # a removed output, hash-checked

lcc compact notes.md -q "what is wrong with the booking flow?" \
  --provider mechanical -o compacted.md -r report.json
lcc explain report.json --source notes.md         # why each block was kept or dropped
把你的数据发给我们
lcc measure-session ~/.claude/projects/<project>/<session>.jsonl --markdown
# Codex CLI rollouts are auto-detected from their session_meta record:
lcc measure-session /path/to/rollout.jsonl --markdown
# or a whole project directory: per-mode median and p90 reduction over its sessions
lcc measure-session ~/.claude/projects/<project>/ --markdown
它会在你的某个会话上离线运行所有模式,并且只输出计数:消息数、工具调用数、压缩前后的 token 数、保留的消息数、耗时。不会输出文本、路径或工具输出。要获得精确计数,请安装 tiktoken 扩展并缓存一次其分词器(lcc 本身绝不会下载任何内容):
python -c "import tiktoken; tiktoken.get_encoding('o200k_base')"。否则,报告会说明计数为 approximate 以及原因。请将报告粘贴到
讨论 → 结果。
添加 --input-map,即可查看会话中计费输入的具体去向:缓存读取和写入,以及工具结果、工具调用输入、注入的指令和固定系统提示词及工具架构所占的比例(仅计数,来自文件中的用量记录)。
已经在用 lcc 压缩了吗?lcc share-stats 可将你的本地报告转换为同类的纯计数摘要(SHARE_STATS.md),也可以使用结果问题表单。
每一条来自我以外的人提供的数据,都会让上述说法更不只是我的主张,而成为更真实的结论。
为什么选择 lcc
- 原样保留。 保留的片段与源内容逐字节一致。不会总结或改写任何内容。
- 可恢复。
stashed会将移除的输出移入本地内容寻址存储 (~/.cache/lcc/stash);recall会在读取时重新计算哈希。 占位符[removed: 120 lines, 4.3 KB · lcc recall <id>]表示行数和大小,而非 token 数,因此在每台机器上的内容都相同。 - 可审计。 每次处理都会写入一份 JSON 报告;
lcc explain会说明每项内容被移除的原因。 - 本地运行。 默认评估器会在你的 CPU 上以纯 Python 运行。无需 API 密钥,也不需要联网。
提供方
| 提供方 | 运行方式 | 使用时机 | 报告内容 |
|---|---|---|---|
specialist-v3 | 本地、CPU | 默认(auto),只要存在 transcript 块就会使用:Claude Code hook、compact_transcript、--mode tool-calls | semantic_guarantee: none(这是排序,而非判断) |
mechanical | 本地、CPU | --provider mechanical;auto 模式下的纯文本(配置 TypeSafe 密钥不会改变这一点,除非设置 LCC_AUTO_REMOTE=1) | semantic_guarantee: none |
rules(lossless、recoverable、stashed) | 本地、不使用模型 | transcript 使用 provider: rules | lossless:仅移除可证明的重复内容;recoverable:也移除可重新读取的输出;stashed(推荐):移除的输出可通过 recall 按字节恢复 |
jev | 远程(TypeSafe API) | 选择启用:--provider jev / provider: jev,需要 TYPESAFE_API_KEY | 语义判断或明确的降级说明 |
laya | 本地模型 | 已弃用;仅在明确指定时运行 | 指定的模型及回退状态 |
specialist-v3 的详情和限制:SPECIALIST.md。规则模式:
TOOL_CALLS.md。Jev 是一条需要明确指定的可选路径
(--provider jev);它会将目标和上下文块发送到 TypeSafe API,而
LCC_DISABLE_NETWORK=1 可将其禁用。auto 绝不会自行选择它:拥有密钥并不代表同意将上下文发送到本机之外,因此除非设置 LCC_AUTO_REMOTE=1,否则 auto 模式下的纯文本仍会使用 mechanical。compact 会写入一份 relevance-compaction-1.2 报告;
请先检查 provider_used 和 degraded,再决定是否信任输出。
基准测试
真实会话(留出集,INFERIDO)。 简单来说:当排序器必须丢弃会话的一部分时,它能多频繁地保留 Agent 接下来实际使用的内容?1.0 表示始终保留。这是在 193 个条目上进行的一次性最终测试,这些条目来自维护者在训练截止日期之后开始的 36 个会话。候选 token 丢弃比例为 0–60% 时的保留率 AUC:
| 排序器 | 召回率 AUC | 全部保留 AUC |
|---|---|---|
| specialist-v3 | 0.899 | 0.434 |
| mechanical | 0.829 | 0.238 |
| recency | 0.818 | 0.306 |
| bm25 | 0.803 | 0.270 |
| random | 0.689 | 0.138 |
标签是从一位维护者的 Claude Code 会话中提取的下一步操作证据,这有利于 v3 的训练目标。这些会话是私有的;仅公开汇总数据 (SPECIALIST.md)。
合成、可复现(python benchmarks/run_judge_bench.py,约 20 s,无需网络)。
九个手写边界案例:取代、矛盾、配置更改、例外规则、葡萄牙语/英语混合、工具输出中的提示词注入、大型 git 差异、旧根因、重新读取。
| 原始排序 | specialist-v3 | mechanical | bm25 | recency |
|---|---|---|---|---|
| 在 30 / 50 / 70% 剪除比例下(共 9 个),保留了所有必保块的案例数 | 8 / 7 / 7 | 9 / 9 / 9 | 9 / 9 / 7 | 8 / 6 / 3 |
| 完整运行,默认设置 | 必保内容已保留 | 302 个块 | 1,138 个块 | 峰值 RSS |
|---|---|---|---|---|
specialist-v3,工具调用模式 | 9/9 | 181 ms | 3.4 s | 71 MB |
rules 无损模式 | 9/9 | 2 ms | 16 ms | 55 MB |
这些案例在词汇层面较简单,因此词汇基线表现不错;v3 未能保留葡萄牙语案例。计时数据来自高负载下的 macOS arm64。方法、所有测试组及限制: BENCHMARKS.md。真实会话上的规则模式: REAL_SESSION_BENCHMARKS.md。
压缩效果取决于上下文中噪声的占比。收益低于 25% 时,报告会将该次运行标记为不值得进行,Claude Code 插件则会保留内置摘要。
它不会做什么
- 它不会检查模型能否正确回答。结构上的
PASS并不代表回答质量达标。 - 不提供 RAG、嵌入或向量存储。
- 保护规则和有界恢复能降低证据丢失的风险,但无法完全避免;详见 安全模型。
specialist-v3使用 Claude Code 转录文本训练。其他 Agent 和普通文档属于分布外数据;普通文本默认使用mechanical,除非你选择启用 Jev。
文档
| 主题 | 链接 |
|---|---|
| 五分钟 CLI 导览 | QUICKSTART.md |
| Claude Code 插件 | CLAUDE_CODE.md |
| MCP 服务 | MCP.md |
| 工具调用压缩与规则模式 | TOOL_CALLS.md |
| 将 Aider 聊天记录作为输入 | AIDER.md |
| 本地排序器 | SPECIALIST.md |
| 基准测试 | BENCHMARKS.md、REAL_SESSION_BENCHMARKS.md、benchmarks/ |
Python API(lcc.msi.compile) | msi-api.md |
| 架构与决策 | architecture.md、ADR 0010、ADR 索引 |
| 选择启用及已弃用的提供方 | JEV.md、LAYA.md |
| 研究档案 | paper.md、results-master.md、TRANSCRIPT_AB.md |
| 隐私 | PRIVACY_POLICY.md |
开发
Python 3.11+。
python -m pip install -e '.[dev,tiktoken]'
pytest -q && ruff check . && mypy
npm test                                   # Node API and hook tests
python benchmarks/run_judge_bench.py --check --out /tmp/judge-bench
名为 lcc 的 PyPI 软件包与本项目无关;本项目的包名是 local-context-compiler。
贡献指南:CONTRIBUTING.md。安全:SECURITY.md。
变更记录:CHANGELOG.md。
许可证
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。