关于 Yeti
Yeti 是供使用 Claude 的产品团队采用的 MCP 服务,可将项目从问题探索推进到范围验证。它按阶段组织工作,跟踪需求和用户故事,以 RICE 评分排序,并可将工作发送到 Jira。
主要功能
- 01按五个设计阶段推进项目
- 02管理 MoSCoW 需求和用户故事
- 03计算并排序 RICE 分数
- 04生成 Mermaid 用户流程图
- 05导出待办并与 Jira 同步
适用场景
- 01将产品问题整理为需求和用户故事
- 02关闭项目前检查必需需求是否得到覆盖
- 03根据输入的 RICE 分数为想法排序
- 04将待办发送到 Jira 并同步完成状态
MCP 相关
Yeti 是面向 Claude 的 MCP 服务,提供管理项目、需求、用户故事、优先级、流程图、导出、仪表板及 Jira 操作的工具。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
npx -y yeti-mcpPRODUCT_DESIGN_DBAbsolute path of the SQLite database file. Set it to a folder you keep when running with npx.JIRA_SITEJira site, e.g. https://your-team.atlassian.net. Only needed for the Jira tools.JIRA_EMAILEmail of the Atlassian account. Only needed for the Jira tools.JIRA_API_TOKEN密钥Atlassian API token. Only needed for the Jira tools.本地服务需要在你的电脑上安装运行环境(如 Node.js 18+)。各客户端的配置文件位置不同,请参考客户端文档。
工具
31收录的工具列表 · 更新于 5 天前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| goal | string | 是 | 用户或企业应实现的目标 |
| mode | enum | 否 | strict | free |
| name | string | 是 | |
| users | string | 是 | 面向的对象 |
| problem | string | 是 | 要解决的问题 |
详细介绍
Yeti


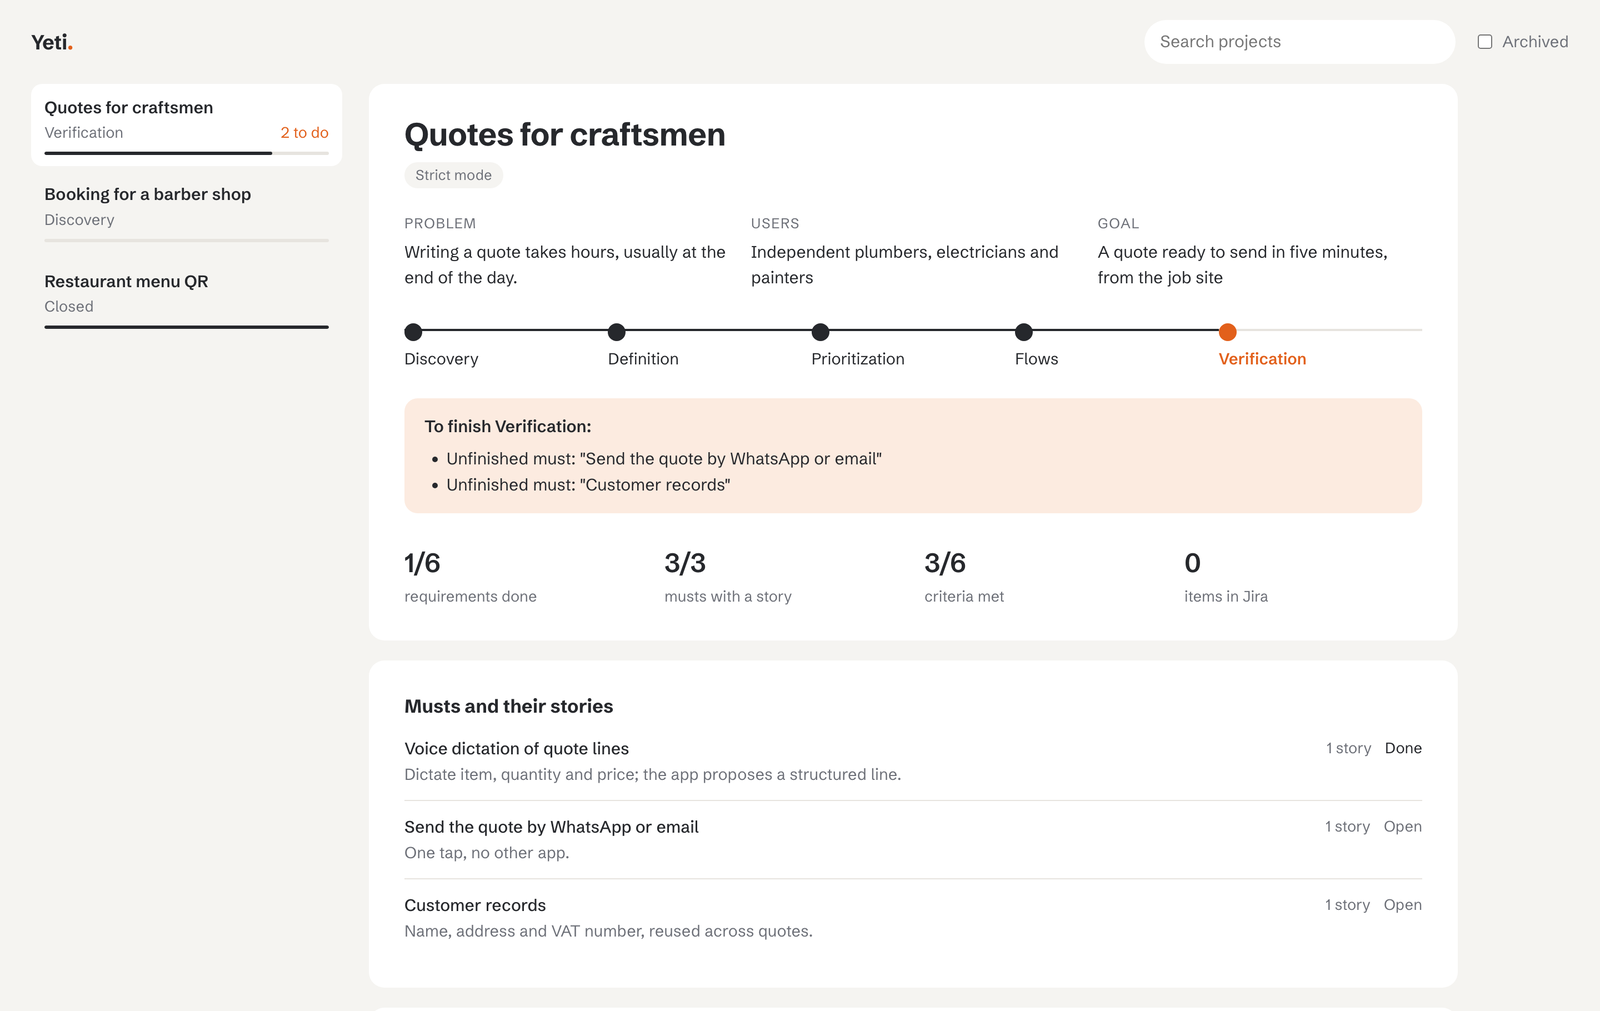
一个使用 Claude 进行产品设计的 MCP 服务。它将项目从问题推进到经过验证的范围:需求、用户故事、RICE 优先级和流程图。然后,它会将工作发送到 Jira。
快速开始
在 claude_desktop_config.json 中将 Yeti 添加到 Claude Desktop,然后重启 Claude Desktop:
{
  "mcpServers": {
    "yeti": {
      "command": "npx",
      "args": ["-y", "yeti-mcp"],
      "env": { "PRODUCT_DESIGN_DB": "/Users/you/yeti/yeti.sqlite" }
    }
  }
}
将 PRODUCT_DESIGN_DB 设置为你保留的文件夹中的文件。使用 npx 时,软件包存放在可清除的缓存中,存储在其中的数据库也会随之删除。Yeti 需要 Node.js 22.13 或更高版本。
然后向 Claude 提出请求:
使用 Yeti 创建一个名为「工匠报价」的项目。问题:编写报价需要数小时。用户:水管工和油漆工。目标:五分钟内生成一份报价。
打开 Yeti 仪表板。
工作原理
项目依次经过五个阶段:
- discovery:问题、用户和目标
- definition:需求(MoSCoW)和用户故事
- prioritization:对想法进行 RICE 评分
- flows:Mermaid 流程图
- verification:完成每项
must需求,并确保其有对应的用户故事,然后关闭项目
创建项目时需要选择项目模式:
strict(默认):只有满足阶段要求后才能进入下一阶段。advance_phase会告知你还缺少哪些内容。free:无论是否满足要求都可以进入下一阶段,响应中会列出跳过的内容。
工具
项目
| 工具 | 功能说明 |
|---|---|
create_project | 在发现阶段启动项目,可选择 strict 或 free 模式 |
list_projects | 列出项目的 ID、名称、阶段和模式;除非设置了 includeArchived,否则不显示已归档项目 |
get_project | 显示阶段、缺少的内容和关联项 |
project_summary | 进度概览:按优先级和状态排列的需求、用户故事覆盖的必需项、已完成的验收标准、RICE 排名第一项、Jira 链接,以及完成项目还缺少的内容 |
update_project | 更改项目名称、问题、用户或目标 |
advance_phase | 进入下一阶段,或列出缺少的内容 |
set_project_mode | 在 strict 和 free 之间切换项目模式 |
duplicate_project | 将项目的需求和用户故事复制到新项目中,作为未完成项(模板) |
archive_project | 在 list_projects 中隐藏项目,但不删除它 |
delete_project | 永久删除项目及其条目。需要设置 confirm: true;不会影响 Jira 问题 |
需求和用户故事
| 工具 | 功能说明 |
|---|---|
add_requirement | 添加需求并设置 MoSCoW 优先级 |
list_requirements | 按优先级、状态或项目筛选并列出需求 |
update_requirement | 更改需求的标题、描述或优先级 |
set_requirement_status | 将需求标记为 open 或 done |
delete_requirement | 删除需求并取消其与用户故事的关联 |
add_user_story | 创建带验收标准的用户故事;可选择关联需求(requirementIds) |
list_stories | 列出用户故事及其 ID、关联项、验收标准状态和 Jira 键 |
update_user_story | 更改用户故事的角色、目标、收益、关联需求或验收标准。更改验收标准会将其完成状态重置 |
set_criterion_status | 将用户故事的一项验收标准标记为已完成或未完成 |
delete_user_story | 删除用户故事 |
search_items | 按文本搜索需求和用户故事,可选择限定在某个项目中 |
优先级排序和流程
| 工具 | 功能说明 |
|---|---|
prioritize_rice | 计算并排序 RICE 分数 |
map_user_flow | 生成 Mermaid 流程图,包含 Yes/No 分支、next 和 ends |
list_flows | 列出项目中保存的流程图及其索引 |
delete_flow | 根据 list_flows 显示的索引删除一个已保存的流程图 |
导入、导出和仪表板
| 工具 | 功能说明 |
|---|---|
export_backlog | 将项目待办事项导出为 Markdown 或 CSV;设置 save 后,还会将其写入 data/exports/ |
import_requirements | 从符合 export_backlog 格式的 CSV 导入需求和用户故事。不会恢复用户故事与需求之间的关联 |
open_dashboard | 启动实时只读仪表板并返回其本地地址 |
export_dashboard | 将仪表板的静态 HTML 快照写入 data/exports/dashboard.html |
Jira
| 工具 | 功能说明 |
|---|---|
push_to_jira | 为项目创建 Jira 问题(每项需求对应一个 Task,每个用户故事对应一个 Story)。默认仅试运行;limit 可指定要发送的子集;update 可刷新已关联的问题;已发送的条目会跳过 |
sync_from_jira | 当 Jira 问题完成时,将需求和用户故事标记为已完成;问题恢复未完成状态时,也会重新打开对应条目。在 Yeti 中手动关闭的条目不会重新打开。此工具对 Jira 仅执行读取操作 |
需求、用户故事、RICE 分数和流程均可选用 projectId 关联到项目。
从源代码安装
你需要 Node.js 22.13 或更高版本(Yeti 使用内置的 node:sqlite 模块)。
git clone https://github.com/macorifice/yeti.git
cd yeti
npm install
npm run build
然后将其添加到 claude_desktop_config.json,并使用你计算机上 dist/index.js 的绝对路径:
{
  "mcpServers": {
    "yeti": {
      "command": "node",
      "args": ["/absolute/path/to/yeti/dist/index.js"]
    }
  }
}
编辑文件后,重启 Claude Desktop。
使用方法
连接后,你可以通过与 Claude 对话来使用 Yeti。典型项目如下所示。
1. 创建项目
创建一个项目“工匠报价”。问题:编写报价需要数小时。用户:水管工和油漆工。目标:五分钟内生成一份报价。
Yeti 会在 discovery 阶段创建项目。
2. 推进各个阶段
- definition:至少添加一项需求和一条与之关联的用户故事。
- prioritization:使用 RICE 为想法评分。
- flows:绘制至少一张流程图。
- verification:每项
must需求都已完成,并且有用户故事覆盖。
在 strict 模式(默认模式)下,Yeti 不会在阶段完成前推进,并会告知你缺少哪些内容。在 free 模式下,它会继续推进并列出跳过的内容。你可以通过 set_project_mode 切换模式。
3. 处理待办事项
- 编辑或删除需求和用户故事。
- 将验收标准标记为已完成。
- 搜索项目中的内容。
- 复制项目以将其用作模板。
- 从 CSV 文件导入需求。
4. 导出
将项目待办事项导出为 Markdown 并保存到文件。
设置 save: true 后,文件会写入数据库所在目录下的 data/exports/。
须知
- 数据存储在本地的
data/yeti.sqlite中。内容仍会经过聊天,因此请勿在其中放入敏感数据。 - RICE 分数就是你输入的数字。Yeti 会对其排序,但不会估算分数。
案例研究
以 Mastro 为例,展示从需求到 Jira 的小型项目:创建项目、需求和用户故事,进行 RICE 优先级排序,绘制流程图,通过验证关卡,发送到 Jira,并保持状态同步。

仪表板
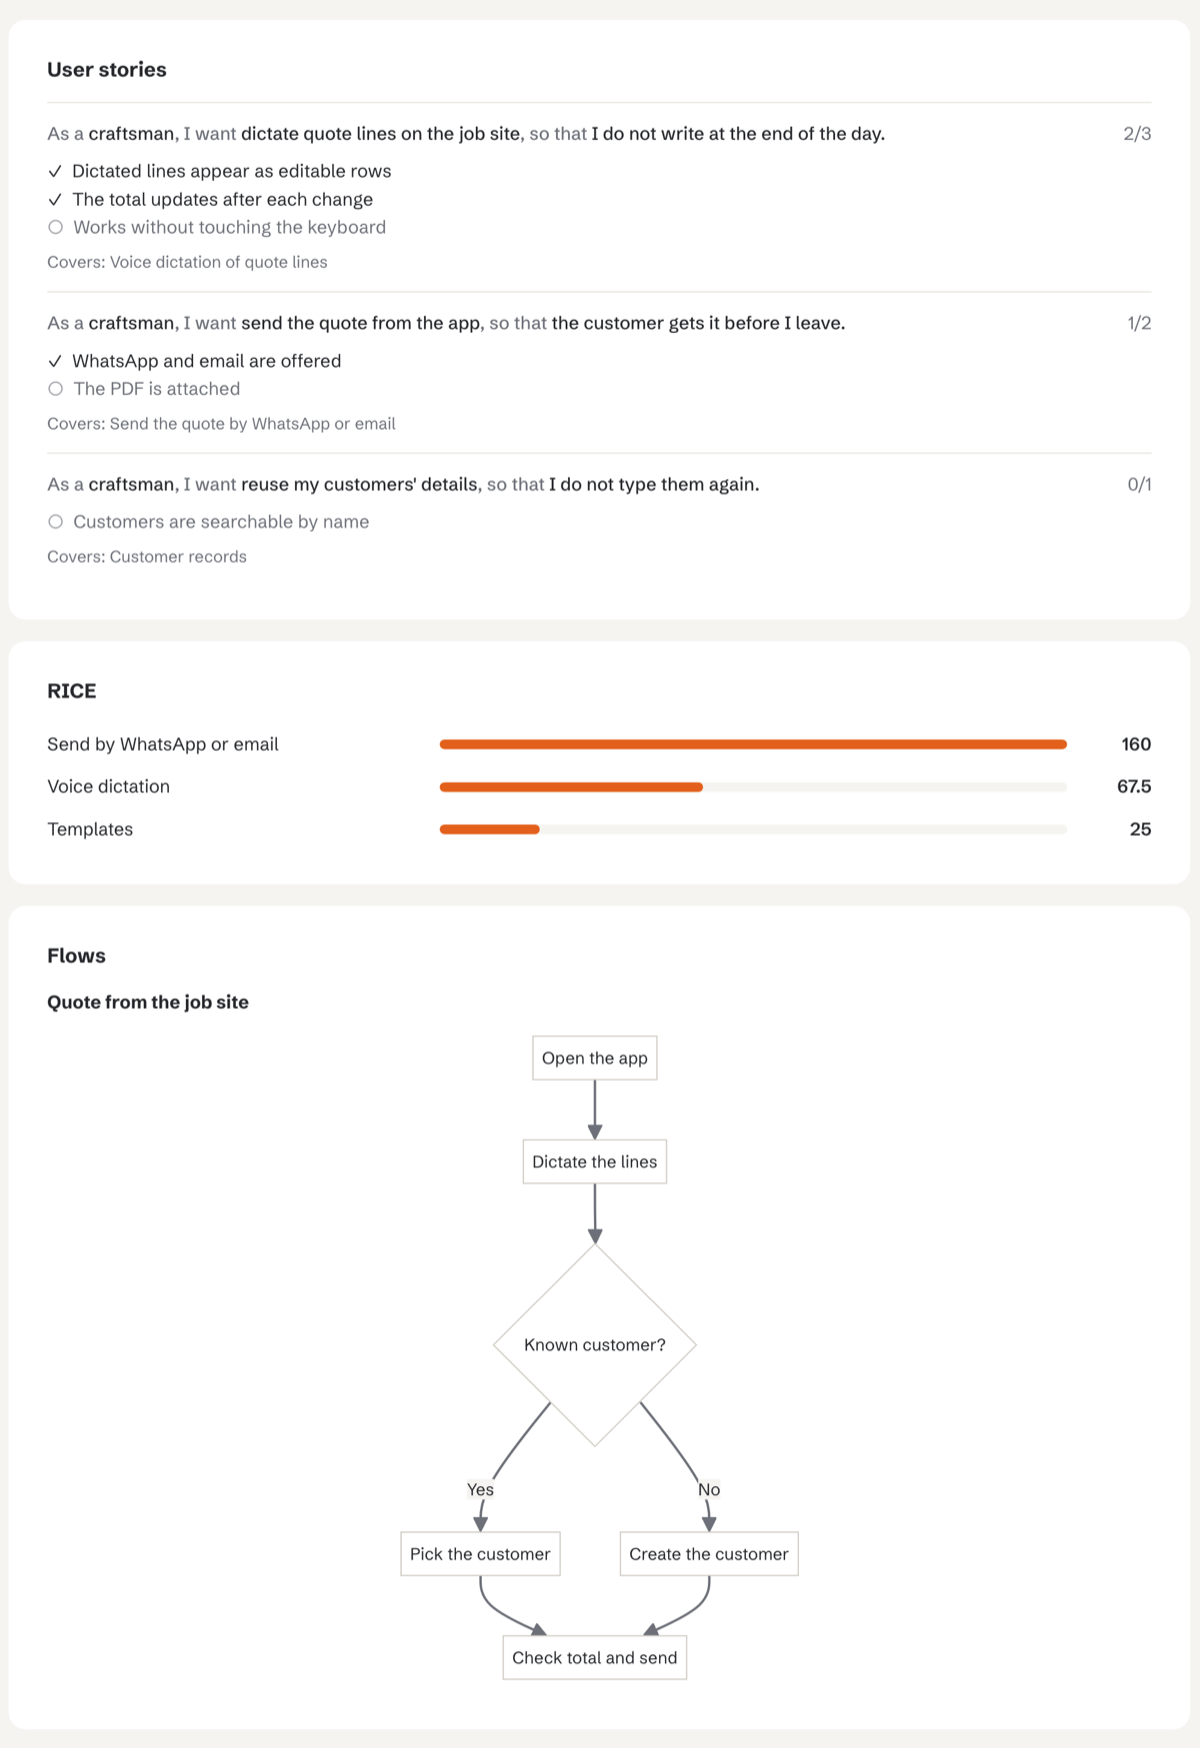
Yeti 提供只读仪表板,用于查看项目设计相关信息:每个项目所处的阶段、继续推进还缺少哪些内容、哪些 must 已由用户故事覆盖、验收标准、RICE 分数和流程图。它不显示任务看板:执行工作应在 Jira 中进行。
从 Claude 中打开:
打开 Yeti 仪表板。
Claude 会调用 open_dashboard 并提供一个地址,例如 http://127.0.0.1:4321。你也可以从终端启动:
npx yeti-mcp dashboard --port 4321
- 它仅侦听
127.0.0.1,因此其他计算机无法访问,并且会拒绝发往其他主机名的请求。 - 它读取与 MCP 服务相同的数据库,并每隔 10 秒刷新一次。
- 设置
JIRA_SITE后,Jira 键会变为链接。 - 图表使用从 CDN 加载的 Mermaid 绘制。没有网络连接时,图表会以文本形式显示。
export_dashboard 仍会将静态快照写入 data/exports/dashboard.html,供分享使用。
凭据
Yeti 无需任何账户即可使用。只有一个工具会与外部服务通信:
- 其他所有功能(项目、需求、用户故事、RICE、流程、验证、导出、搜索)都在本地运行,无需凭据。
push_to_jira会在 Jira 中创建问题。它需要三个环境变量:
| 变量 | 值 |
|---|---|
JIRA_SITE | 你的 Jira 站点,例如 https://your-team.atlassian.net |
JIRA_EMAIL | 你的 Atlassian 账户邮箱 |
JIRA_API_TOKEN | 在 id.atlassian.com → Security → API tokens 中创建的 API 令牌 |
将它们设置在你的 shell 配置文件中,例如 ~/.zshrc:
export JIRA_SITE="https://your-team.atlassian.net"
export JIRA_EMAIL="[email protected]"
export JIRA_API_TOKEN="your-token-here"
切勿将令牌放入代码库、提交的配置文件或聊天中。如果令牌泄露,请在同一页面撤销它并创建新令牌。
未设置这些变量时,push_to_jira 会拒绝发送,并告知你缺少哪个变量。试运行预览也无需这些变量。
数据
数据存储在 SQLite 中。从源码检出版本启动时,默认使用项目文件夹中的 data/yeti.sqlite;使用 npx 时,请按快速入门中的说明设置 PRODUCT_DESIGN_DB。早期版本使用 data/db.json:新版本首次运行时会自动导入该文件,之后不会再对其进行修改。若要使用其他位置,请设置 PRODUCT_DESIGN_DB 环境变量:
"env": { "PRODUCT_DESIGN_DB": "/absolute/path/to/yeti.sqlite" }
测试
npm test
测试会在临时数据库上启动服务,并检查每个工具及阶段流转。
状态
自 1.0.0 起已稳定。工具、工具的输入以及数据格式均遵循语义化版本规范:有破坏性的更改将随新主版本发布。
赞助
如果 Yeti 对你有帮助,可以通过 GitHub Sponsors 支持其开发。
许可证
MIT。参见 LICENSE。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。