关于 Hybrid Recursive Ladder
Hybrid Recursive Ladder 是用于长时间序列范围聚合的查询规划库、命令行工具、API 和 MCP 服务,通过减少源请求次数保留所需输出粒度。它按日历层级分解区间,也可结合源数据与本地物化数据。
主要功能
- 01按日历层级递归分解范围
- 02按获取层级合并连续区段
- 03将区间聚合折叠为输出区段
- 04结合覆盖状态优先读取本地数据
- 05验证并修复本地物化数据
适用场景
- 01聚合桶数受限 API 的长时间范围
- 02减少细粒度仪表板的请求次数
- 03将缓存点与未覆盖的源数据范围合并查询
MCP 相关
可选的 MCP 服务向兼容客户端提供 `ladder_meta`、`ladder_decompose`、`ladder_sum` 和 `ladder_verify` 工具。无需配置即可使用演示数据运行。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
uvx hybrid-recursive-ladder-mcpHL_SOURCESource backend: demo (default), thingsboard, or postgres.HL_TB_URLThingsBoard base URL, for example http://localhost:9090.HL_TB_USERNAMEThingsBoard username; pair with HL_TB_PASSWORD.HL_TB_PASSWORD密钥ThingsBoard password.HL_TB_TOKEN密钥ThingsBoard access token, used instead of username and password.HL_PG_DSN密钥PostgreSQL DSN for the local materialized store.HL_TIMEZONEIANA timezone for calendar boundaries; default Asia/Shanghai.HL_FINESTFinest ladder level: minute, hour, day, or month.本地服务需要在你的电脑上安装运行环境(如 Node.js 18+)。各客户端的配置文件位置不同,请参考客户端文档。
工具
4收录的工具列表 · 更新于 2 天前
此工具无需参数。
详细介绍
混合递归阶梯
面向桶数受限的时间序列 API 的查询规划。 只需少量源请求即可汇总较长时间范围,而不必针对每个桶发起数千次查询。
语言: English · 简体中文 · 日本語 · 한국어 · Español · Français · Deutsch · Português · Русский · العربية · हिन्दी
算法规范 · API 参考 · 基准测试 · 相关工作 · 公开披露 · 文档索引


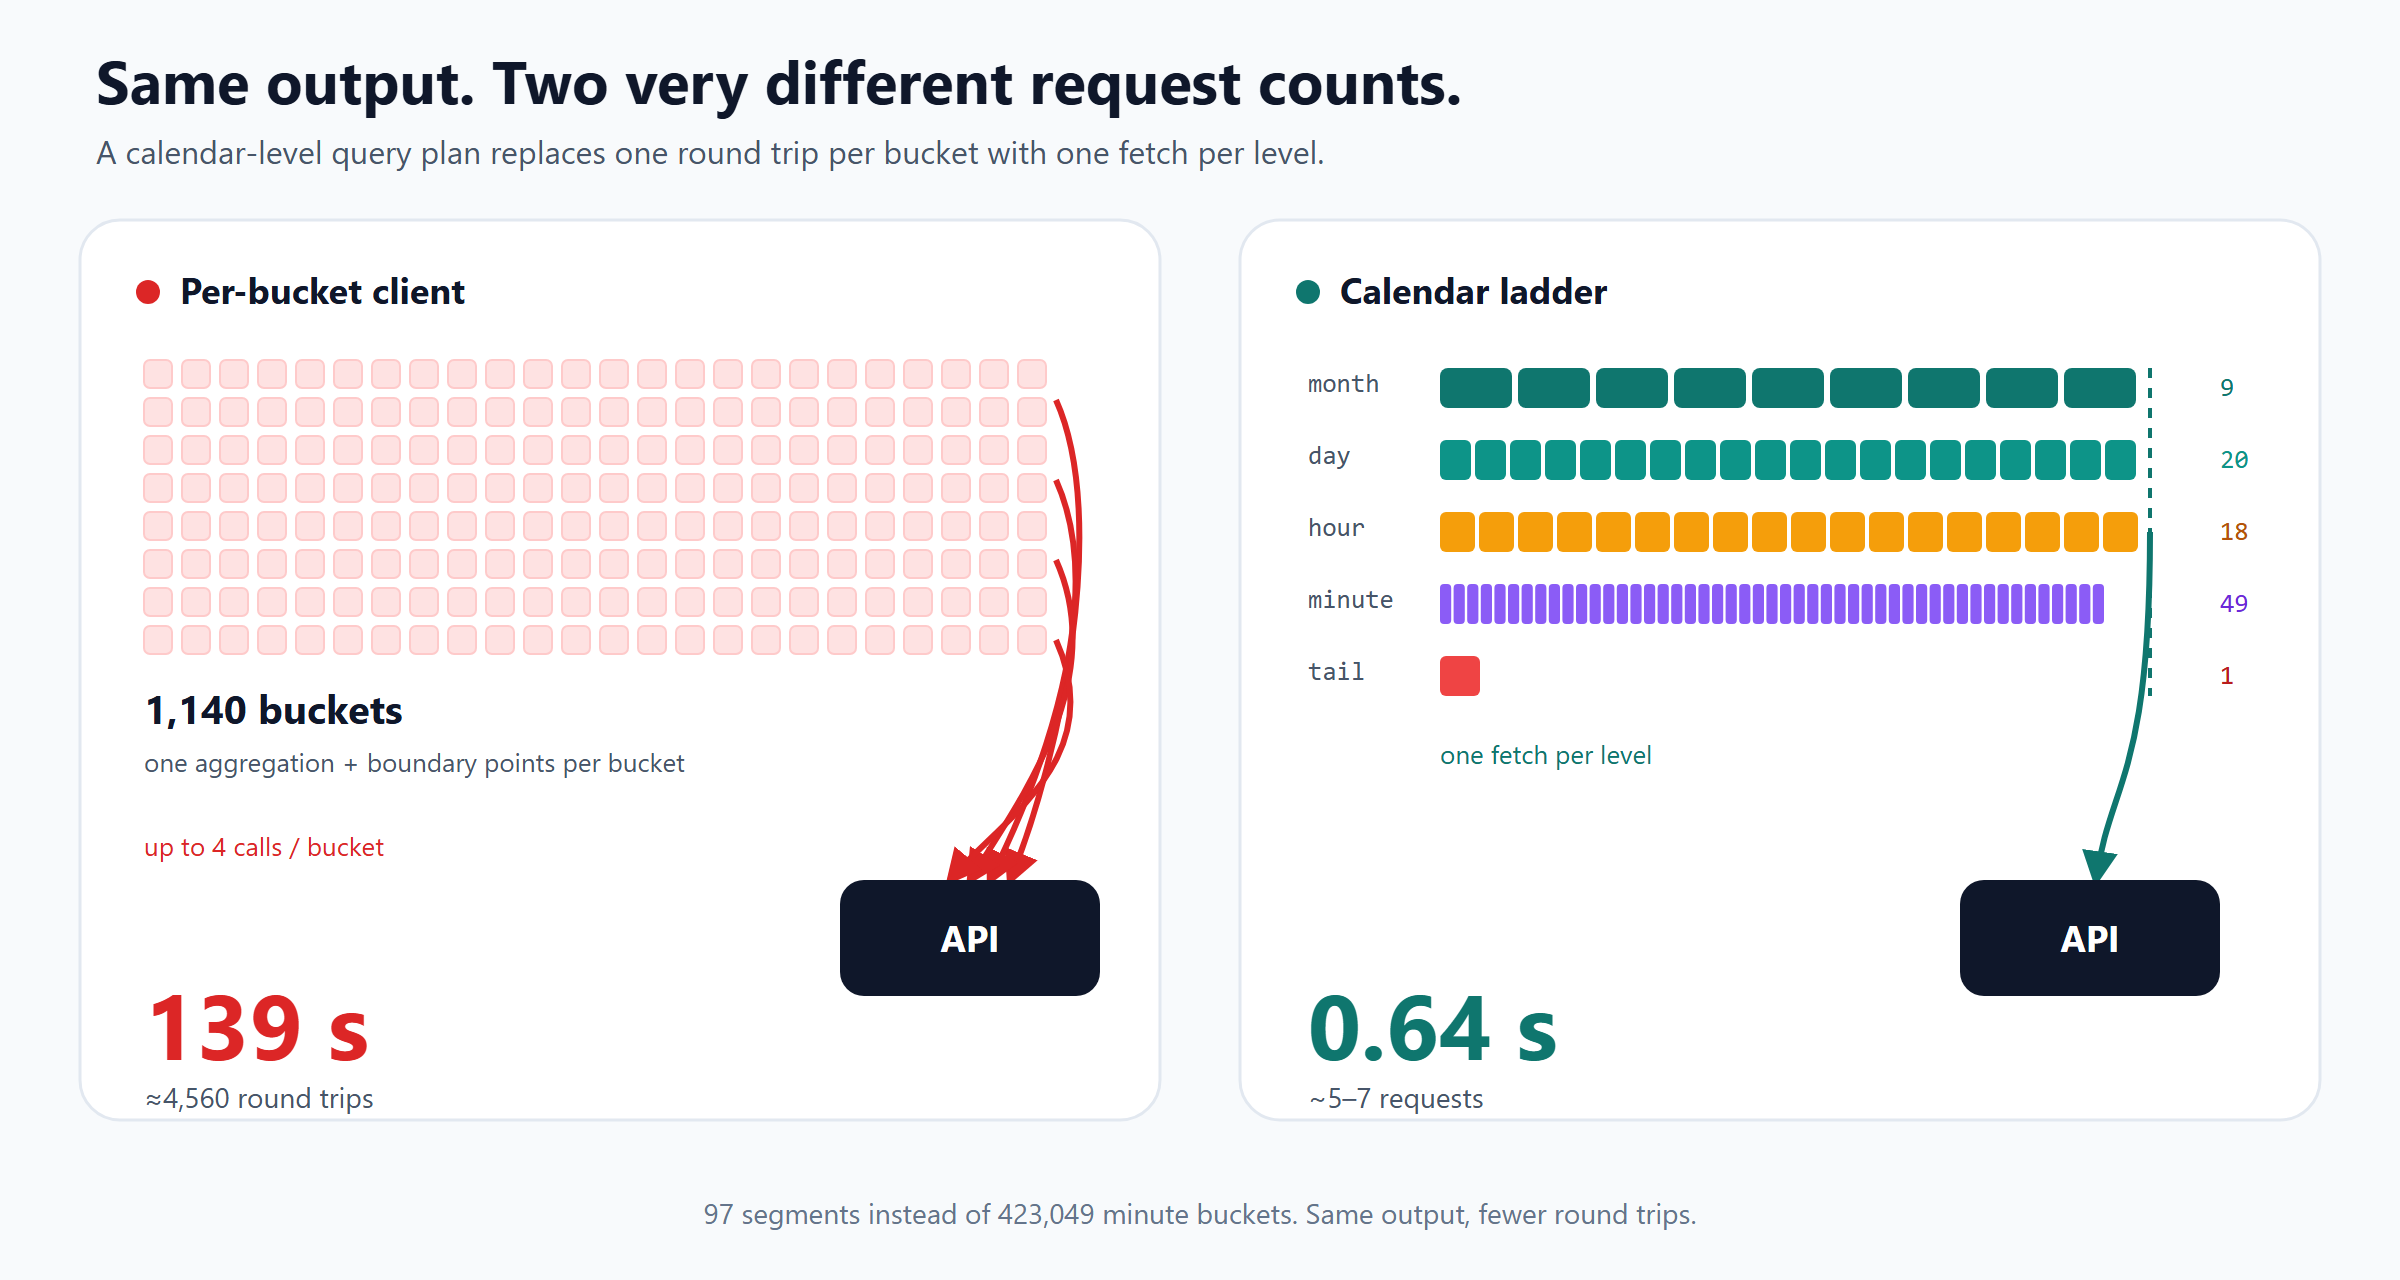
输出粒度相同。逐桶客户端每行都要支付一次往返开销;阶梯则每个层级只获取一次。
## 为什么会有这个项目大多数时间序列 API 都会按请求、按数据桶或按往返次数收费。一个 简单的「每个统计数据桶发起一次查询」客户端,会把两天的分钟级 时间范围拆成 2,880 个数据桶,每个最多需要 4 次 HTTP 调用。在生产环境的 ThingsBoard 部署中,通过 VPN 获取 1,140 个数据桶耗时 139 秒。
瓶颈不在计算,而在网络往返次数。
三种显而易见的解决方法都有所牺牲:
| 解决方法 | 代价 |
|---|---|
| 查询一个较粗的间隔 | 无法获得仪表板所需的分钟级或天级行 |
| 预聚合(连续聚合、汇总表) | 需要对数据源有写入权限或控制权 |
| 分页 | 页数不变,还会增加更多边界情况 |
这种梯级算法采用了不同的路径:保留输出粒度,但不再为每个输出单元 单独发起一次请求。 能够返回连续区间聚合结果的数据源,可以通过一次请求填充多个输出分段。
工作原理
- 分解
[start, end),从月到配置的最细粒度,拆分为完整的日历单位。仅输出完整单位;将左侧和右侧的部分边界推到更细一级。 - 分组 仅当相邻分段需要相同的获取级别时才进行合并。小时和分钟可以共用分钟级区间;月和天则不行。
- 获取 在下一级聚合粒度上,各获取一次最大的连续区间:月按天、天按小时、小时按分钟、分钟按分钟。
- 折叠 在本地将返回的数据桶合并到输出分段中。
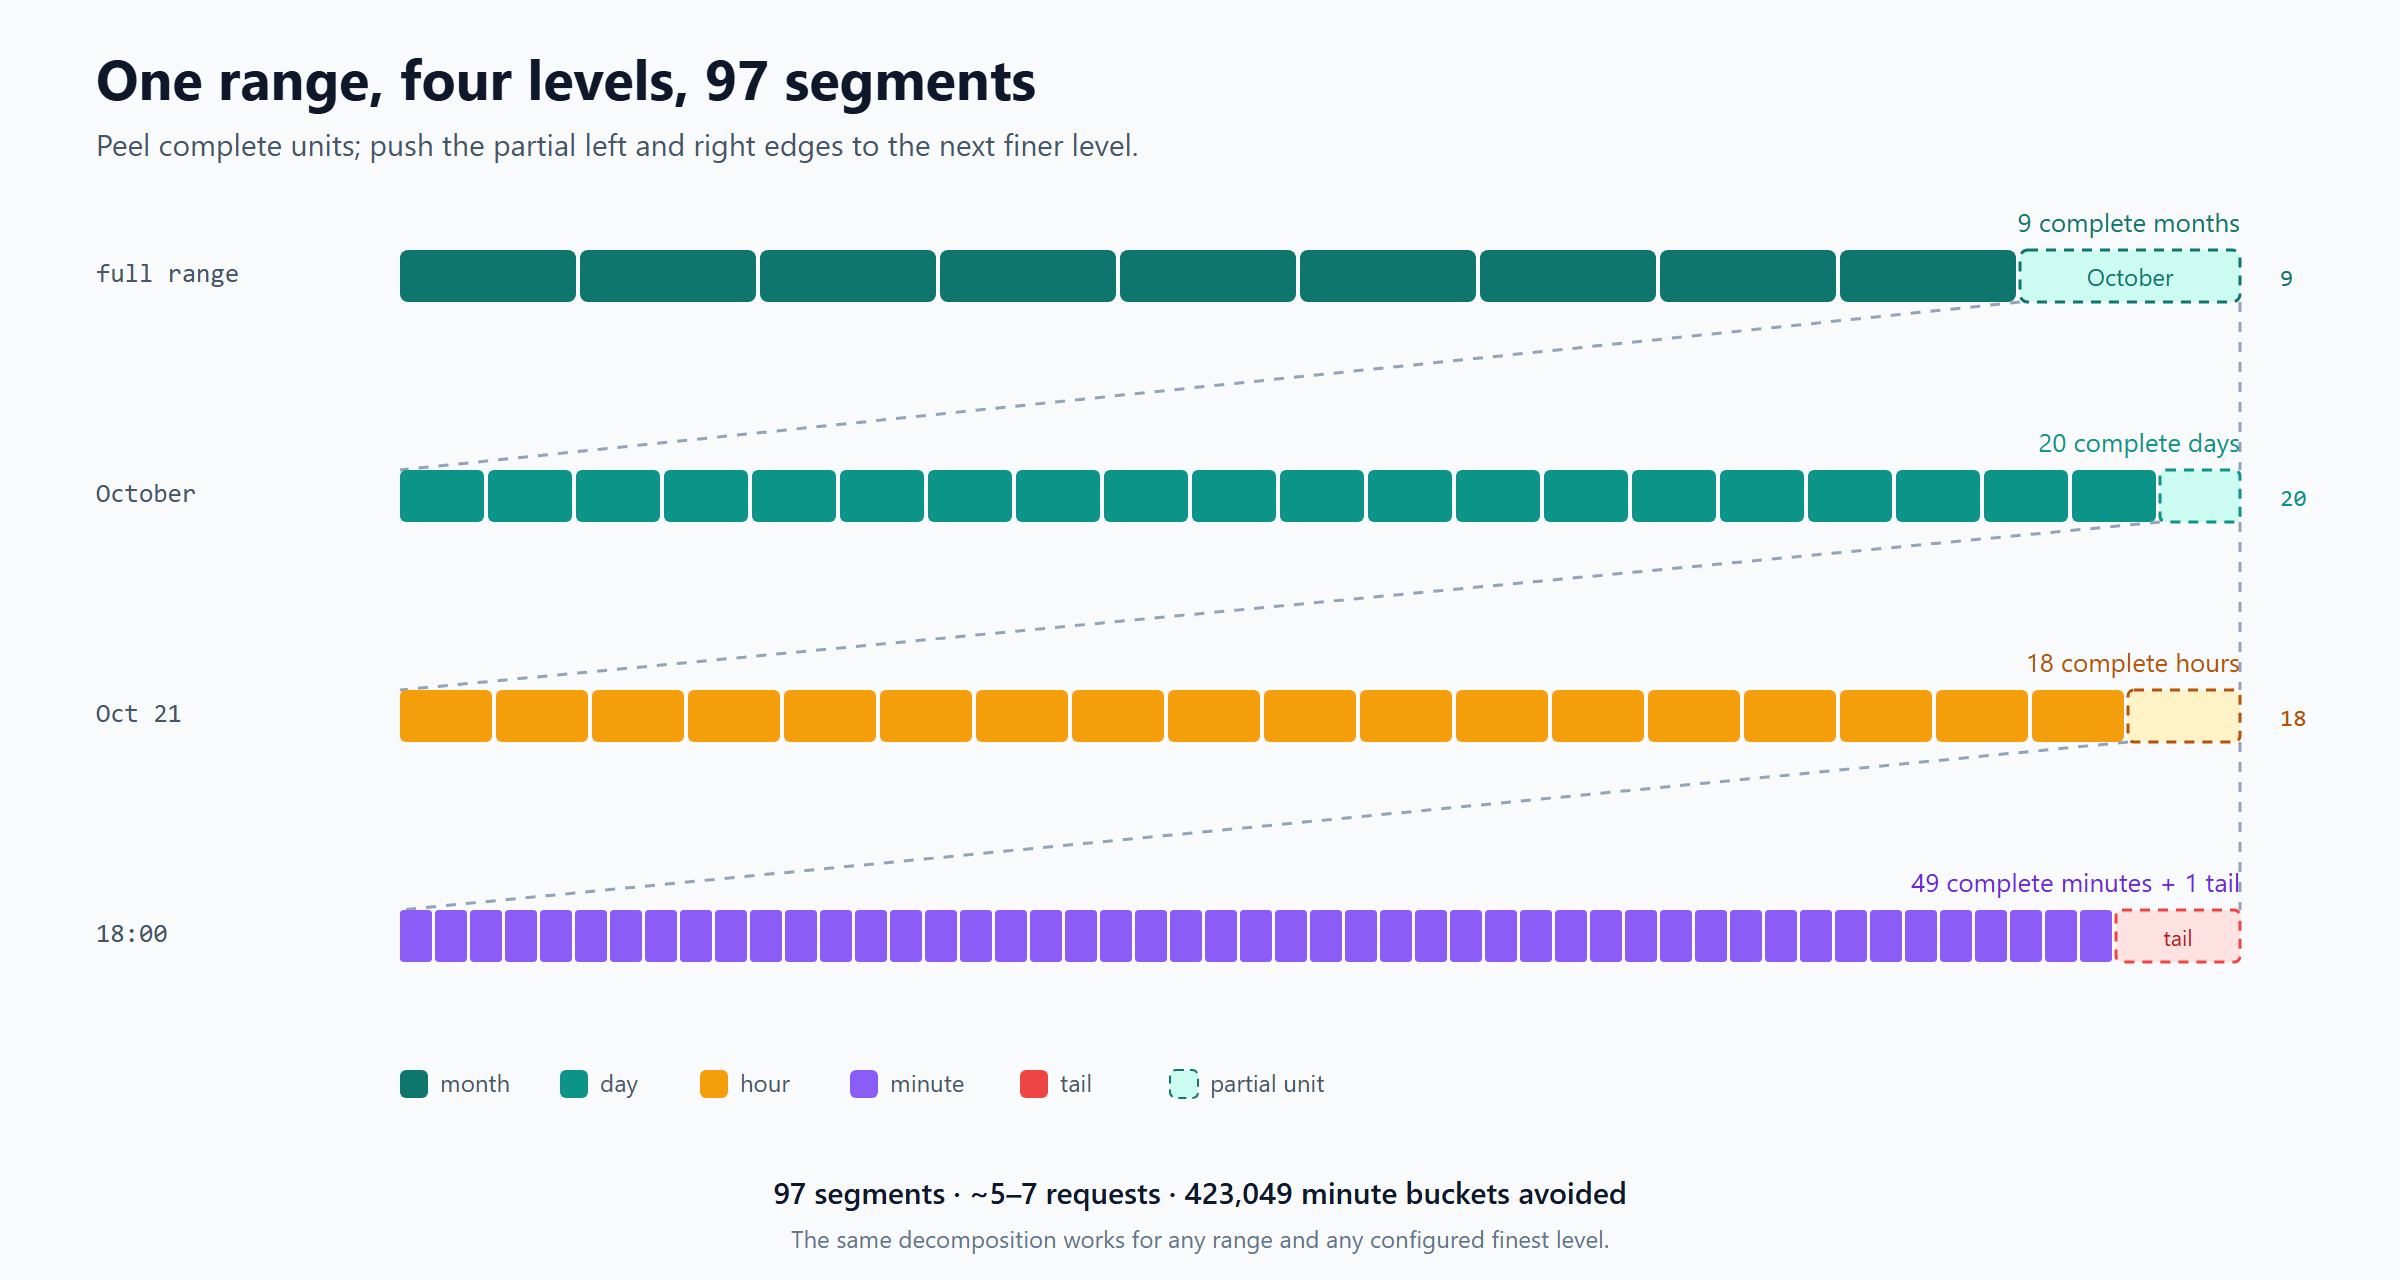
对于 2026-01-01 00:00:00 → 2026-10-21 18:49:59,只需 97 个分段,
而不是 423,049 个分钟数据桶。典型的 10 个月查询大约需要 5–7 次
聚合请求。
规则
- 左闭右开——
[start, end)。 - 仅完整单位——月、天、小时或分钟仅当完全位于范围内时,才会在对应级别输出。
- 递归处理边界——部分边界会推到更细一级;不足一分钟的余量会作为独立尾段。
- 本地日历——边界使用配置的 IANA 时区(默认为
Asia/Shanghai)。 - 无缝覆盖——分段有序、连续且互不重叠,其并集恰好为
[start, end)。
请求数上限
对于时长为 T、数据桶大小为 Δ、每个请求包含 K 个数据桶的获取区间:
requests(run) = ceil(T / (K * Δ))
细粒度处理仅限于两端的两个部分单位。对于默认层级,N <= N_month + 639;递归深度最多为 4。请求数为 O(N_month / K + 1)——它随粗粒度单位数量增长,而非随分钟数据桶数量增长。形式化命题见
docs/algorithm.md §5.3–5.5(中文)。
快速开始
pip install hybrid-recursive-ladder

hybrid-ladder demo
hybrid-ladder decompose --start 2026-01-01 --end 2026-10-21T18:49:59
演示会构造合成的 15 分钟数据,分解 120 天的时间范围,将其中一半物化,运行本地优先的混合查询,并验证总数相符。无需数据库、网络或配置。
可选附加项:
pip install "hybrid-recursive-ladder[thingsboard]"   # ThingsBoard source (httpx)
pip install "hybrid-recursive-ladder[postgres]"      # local store (psycopg 3)
pip install "hybrid-recursive-ladder[api]"           # FastAPI HTTP API
pip install "hybrid-recursive-ladder[mcp]"           # MCP server
pip install "hybrid-recursive-ladder[all]"           # everything
核心分解功能不依赖任何第三方依赖(仅在 Windows 上使用 tzdata 来可靠支持 IANA 时区)。
用法
| 形式 | 入口点 | 最适用于 |
|---|---|---|
| Python 库 | from hybrid_ladder import ... | 嵌入服务或流水线 |
| CLI | hybrid-ladder ... | 临时检查、脚本、cron |
| HTTP API | hybrid-ladder serve | 与语言无关的集成、异步任务 |
| MCP 服务 | hybrid-ladder mcp | AI Agent 和兼容 MCP 的客户端 |
| Agent 技能 | skills/hybrid-recursive-ladder/ | Claude/ZCode 风格的技能安装 |
Python 库
from hybrid_ladder import LadderEngine, MemorySource

source = MemorySource()
source.add("device-1", "energy", [(ts, 1.0) for ts in range(0, 86_400_000, 60_000)])

engine = LadderEngine(source)
result = engine.sum([("device-1", "energy")], 0, 86_400_000)

print(result.grand_total)                 # 1440.0
print(result.rows[0].segments[0].label)   # 1970-01-01 00:00
print(result.rows[0].empty_count)         # 0
引擎依赖两个小型协议:TimeSeriesSource(interval_agg、
raw_series)和 PointStore(sum_ranges、series、coverage、
upsert_points 等)。内置实现:MemorySource/MemoryStore、
ThingsBoardSource、PostgresStore。如需添加其他数据源,请参阅
docs/architecture.md (中文)。
CLI
# Demo data
hybrid-ladder sum --series demo-chiller-1:energy --start 2026-01-01 --end 2026-02-01

# ThingsBoard, local-first
export HL_TB_URL=https://tb.example.com
export HL_TB_TOKEN=...
export HL_PG_DSN='postgresql://user:[email protected]:5432/telemetry'
hybrid-ladder sum --source thingsboard --series <device>:<key> \
  --start 2026-01-01 --end 2026-10-21T18:49:59 \
  --mode mixed --materialize

# Verify and repair the local copy
hybrid-ladder verify --source thingsboard --series <device>:<key> --start ... --end ...
hybrid-ladder repair --source thingsboard --series <device>:<key> --start ... --end ...
HTTP API
hybrid-ladder serve --port 8000
# OpenAPI docs: http://127.0.0.1:8000/docs
curl "http://127.0.0.1:8000/v1/decompose?start_ts=1767196800000&end_ts=1792512599000"

curl -X POST http://127.0.0.1:8000/v1/ladder/sum \
  -H 'content-type: application/json' \
  -d '{"series":[{"entity":"demo-chiller-1","key":"energy"}],
       "start_ts":1767196800000,"end_ts":1777564800000,"mode":"tb"}'
# → {"code":0,"data":{"task_id":"...","async":true}}

curl http://127.0.0.1:8000/v1/tasks/<task_id>
API 成功时返回 {"code":0,"data":...},出错时返回 {"code":1,"detail":...}。所有端点均列于 docs/api.md (中文)。
MCP 服务
pip install "hybrid-recursive-ladder[mcp]"
hybrid-ladder mcp
工具:ladder_meta、ladder_decompose、ladder_sum、ladder_verify。未配置时,服务会提供演示数据,Agent 可以立即试用。客户端配置示例:
{
  "mcpServers": {
    "hybrid-ladder": {
      "command": "hybrid-ladder",
      "args": ["mcp"],
      "env": {
        "HL_SOURCE": "thingsboard",
        "HL_TB_URL": "https://tb.example.com",
        "HL_TB_TOKEN": "...",
        "HL_PG_DSN": "postgresql://..."
      }
    }
  }
}
Agent 技能
将 skills/hybrid-recursive-ladder/ 复制到 Agent 的技能目录中(例如 ~/.claude/skills/ 或
~/.zcode/skills/)。该技能会教 Agent 何时使用梯形分解、如何调用 CLI/API,以及如何解读 null 与 0.0 的区别和 source。
本地优先模式
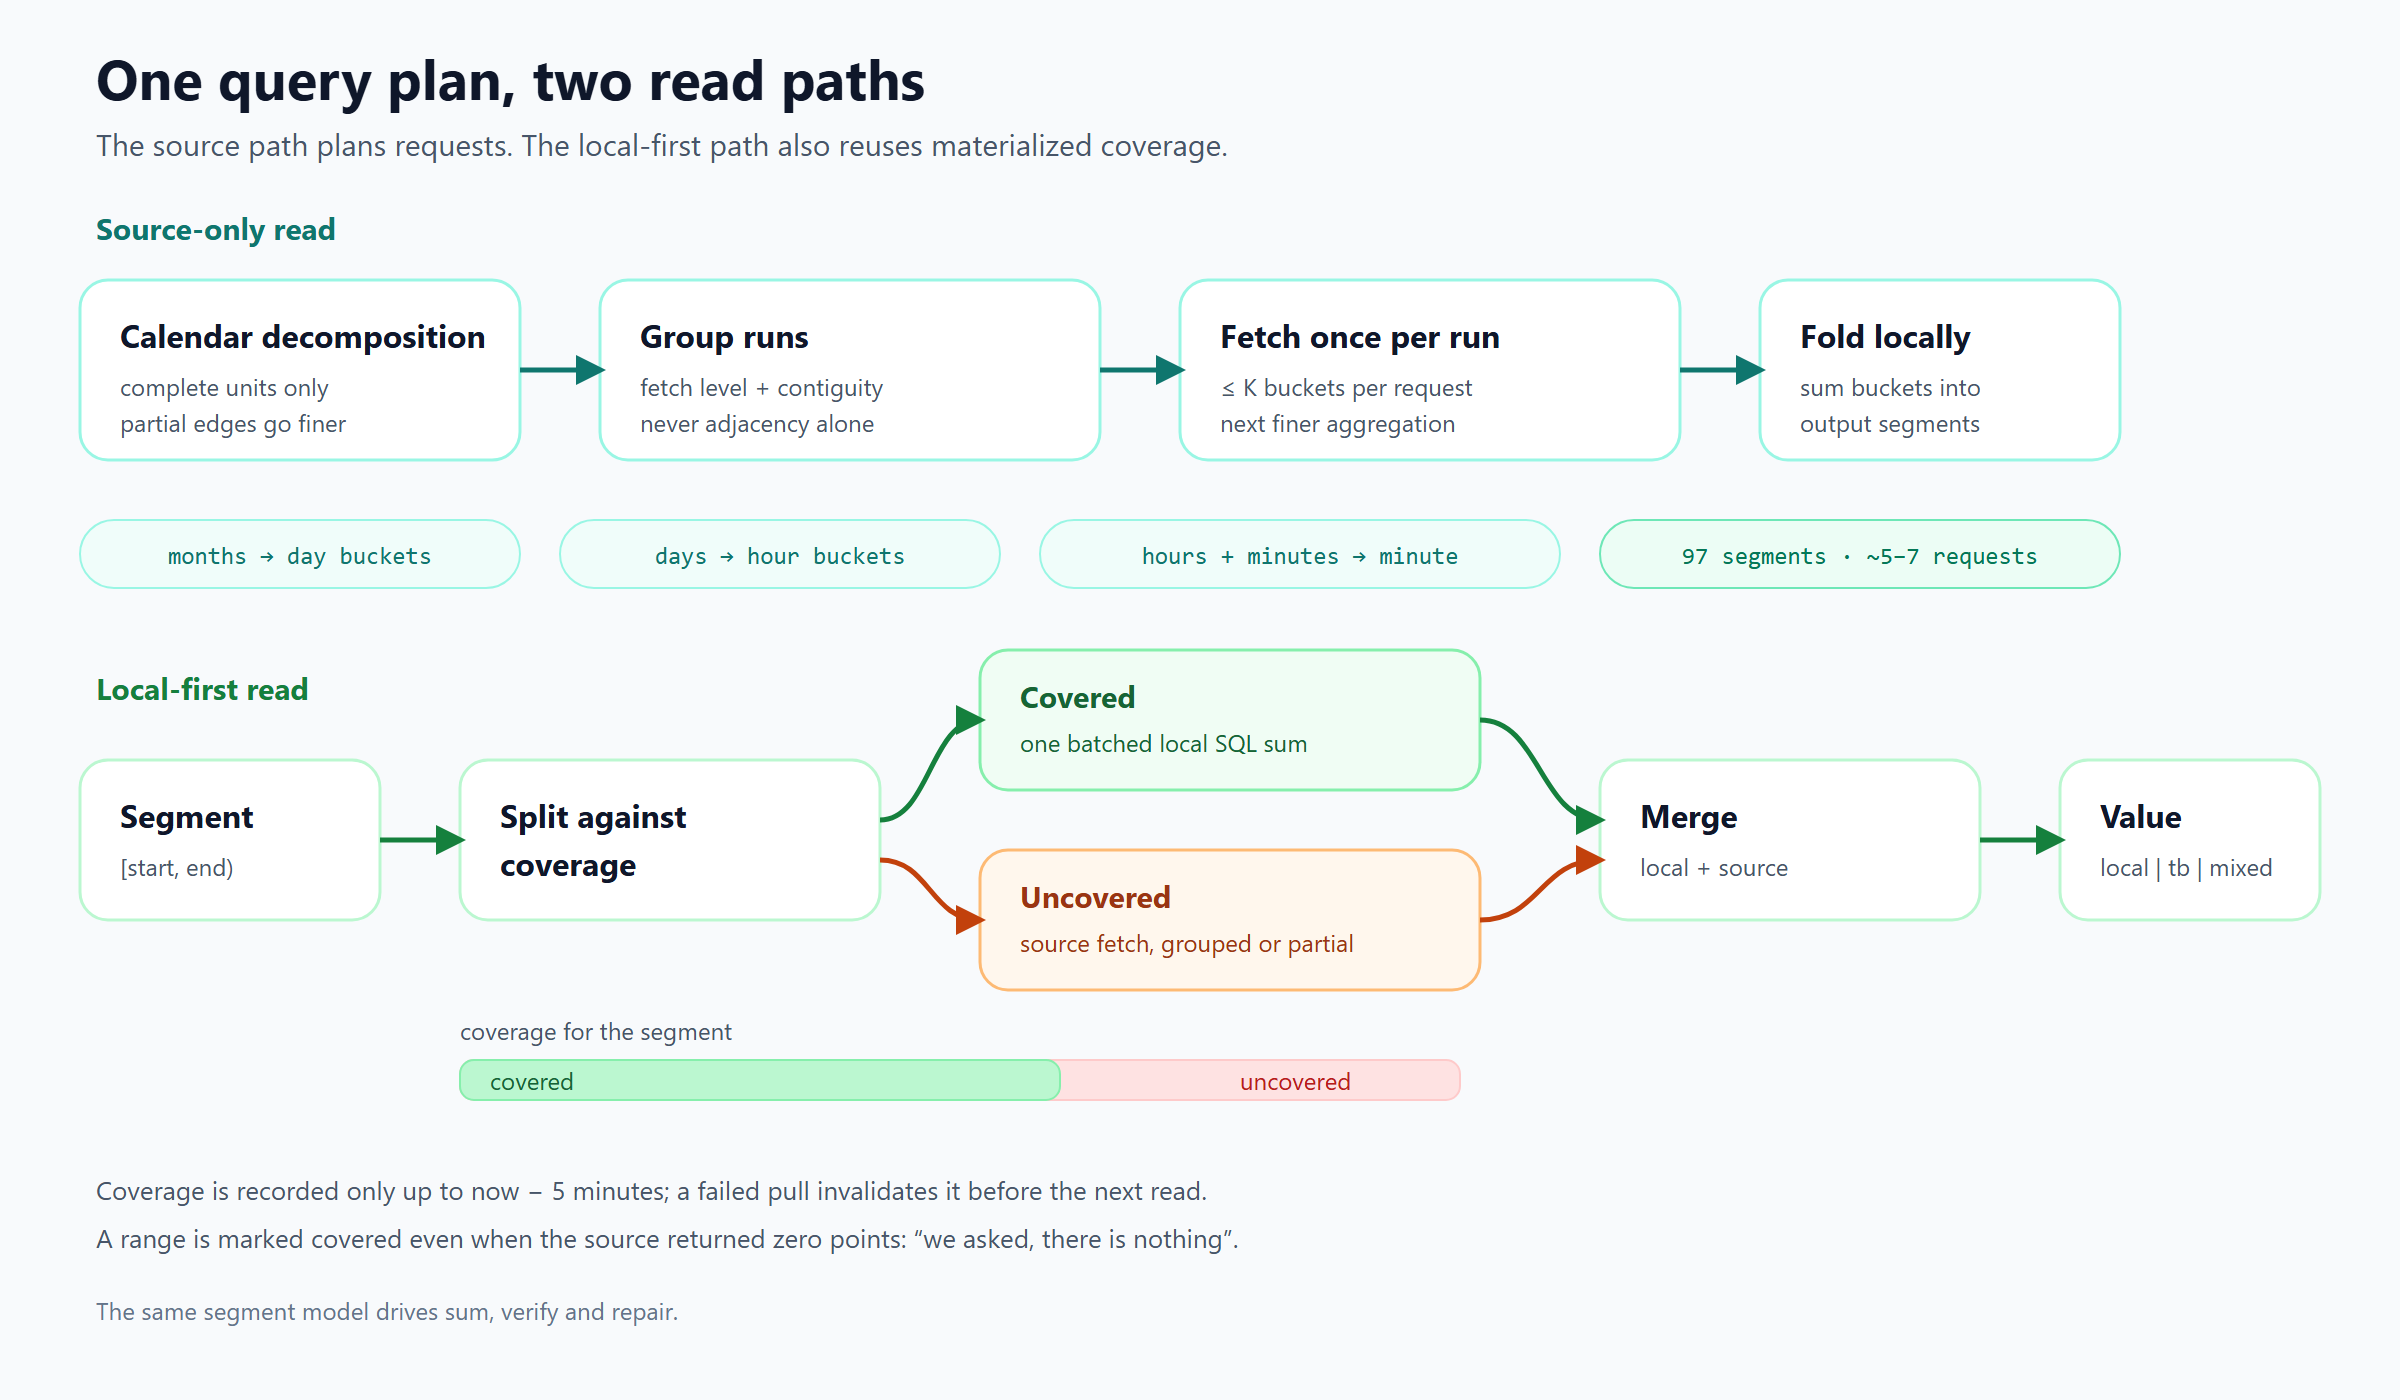
如果你有本地点存储,同样的区段会按照已物化的覆盖范围进行拆分。已覆盖部分通过一次批量本地查询获取;未覆盖部分从数据源获取;部分覆盖的区段只会提取缺失的部分。
from hybrid_ladder import LadderEngine, MemoryStore
from hybrid_ladder.sources.thingsboard import ThingsBoardSource

source = ThingsBoardSource("https://thingsboard.example.com", token="...")
store = MemoryStore()               # or PostgresStore("postgresql://...")
engine = LadderEngine(source, store)

# Pull raw points once; coverage is recorded.
engine.materialize([("device-id", "energy")], start_ms, end_ms)

# Repeated queries read local data and fetch only uncovered sub-ranges.
result = engine.sum_mixed([("device-id", "energy")], start_ms, end_ms)
print(result.source, result.source_counts)   # "local" / "mixed" / "tb"
print(result.rows[0].tb_ranges)              # ranges still missing locally

# Compare with the source, then repair if needed.
report = engine.verify([("device-id", "energy")], start_ms, end_ms)
if report["diff_segments"]:
    engine.repair([("device-id", "energy")], start_ms, end_ms)
覆盖范围只记录到 now - 5 minutes;正在写入的尾部数据绝不会被视为可信。即使数据源返回零个点(“我们查询过,这里没有数据”),范围也会标记为已覆盖。重写之前会清除其覆盖记录——拉取失败时,不会留下指向不完整数据的过期覆盖记录。
验证会逐段比较数据源(权威来源)与本地存储,只将不一致的区段逐级细查到点(added / removed / changed)。修复会删除本地范围,并按事务大小的时间窗口从数据源重新拉取,然后重新标记覆盖范围。
保证与限制
| 值 | 含义 | 显示为 |
|---|---|---|
null | 该区段没有样本 | — |
0.0 | 存在样本,且总和为零 | 0 |
| number | 样本总和 | 该数字 |
每个区段都包含 cnt(观测到的点/桶数)、expected(该区段应包含的桶数,适用于源区段)和 source(local、tb、mixed、empty、uncovered)。如果 cnt 远低于 expected,说明数据稀疏;总和在算术上仍然正确,只是基于较少的点计算。
保证
sum精确:所有区段的总和等于范围内源数据点的总和。不做近似,也不采样。- 区段恰好覆盖整个范围;没有零长度区段。
null和0.0在任何情况下都不同。- 物化操作具有幂等性;重叠的运行不会重复添加时间戳。
- 算法只读取源数据,不会向 ThingsBoard 写入数据。
限制
- v0.0.6 仅支持求和。
avg需要按sum+count加权;meter_delta需要每个区段的第一个值(ThingsBoard 不支持FIRST),因此这些规则尚未纳入迭代计划。 - 数据完整性 ≠ 算术正确性。 缺失样本会导致总和低于实际总量;
cnt/expected会显示这一情况,但不会估算缺失值。 - **ThingsBoard 限制:**约可接受 700 个桶,800 个会被拒绝(文档中的 1000 不可靠);适配器默认值为 500。每次请求的原始时间序列上限为 10,000 个点。同一分钟内的重复点会被
COUNT合并。 - 进程内任务会在重启时丢失;结果可以重新计算,已物化的数据不会丢失。
- **DST 时区:**支持日历边界,但由于源桶大小固定,按日/小时折叠是为
Asia/Shanghai等固定偏移时区设计的。在 DST 转换期间获取数据时,请使用hour或minute。
历史修复和版本说明见 CHANGELOG.md。
性能
数据来自生产环境中的 ThingsBoard 部署(数值会随网络和数据密度而变化):
| 查询 | 区段数 | 源请求数 | 耗时 | 结果 |
|---|---|---|---|---|
| 2 天,分钟级 | 69 | ~4 | 0.64 s | 2,217,024.0(与 2,566 个原始点一致) |
| 1 年,日级 | 42 | ~4 | 冷启动 1.18 s/热启动 0.20 s | 36,012,018.25 |
| 10 个月,混合级别 | 97 | ~5–7 | 不到 1 秒 | 避免处理 423,049 个分钟桶 |
| 本地读取,42–90 个区段 | — | 0 | 9–19 ms | 一条 SQL 语句 |
| 混合读取(3 个本地区段 + 1 个源区段) | 4 | 1 | 0.31 s | 与仅从源读取的结果相同 |
有关方法和注意事项,请参阅 docs/benchmarks.md(中文)。
定位与既有工作
这是一种查询规划方法,适用于可以读取区间聚合端点、但无法写入源数据或重新配置源数据的部署环境。它不是一种新的时序数据库,也不是一种新的通用聚合理论。它结合了日历混合进制分解、规范区间分解、向上汇总和多分辨率聚合。
最接近的系统包括 RRDtool/Whisper(多分辨率归档)、BTrDB(分层时间分区摘要)、TimescaleDB 分层连续聚合和 Druid 周期粒度。Prometheus 和 Grafana 等查询端系统会选择统一的步长;而该阶梯算法会在一次查询中规划多个日历层级。
完整比较、历史算法和有据可依的新颖性声明,请参阅相关工作与定位(中文)。该方法已作为公开披露发布(中文);一篇技术文章介绍了生产环境基准测试和请求数量论证。
项目、开发与路线图
项目布局
src/hybrid_ladder/
  core.py          pure decomposition, folding, coverage splitting
  engine.py        source/mixed/local reads, materialize, verify, repair
  models.py        Segment, SeriesRef, LadderConfig, QueryResult
  protocols.py     TimeSeriesSource / PointStore
  sources/         memory.py, thingsboard.py
  stores/          memory.py, postgres.py
  api.py           FastAPI app
  cli.py           hybrid-ladder CLI
  mcp_server.py    MCP tools
  tasks.py         in-process task registry
  demo.py          deterministic demo data
tests/             unit + API + adapter tests
docs/              algorithm, architecture, API, benchmarks, prior art
skills/            agent skill package
examples/          runnable examples
git clone https://github.com/MagicSquarekey/hybrid_recursive_ladder_algorithm.git
cd hybrid_recursive_ladder_algorithm
python -m venv .venv && source .venv/bin/activate   # Windows: .venv\Scripts\activate
pip install -e ".[dev]"
ruff check .
pytest
可选的 PostgreSQL 集成测试:
export HL_TEST_PG_DSN='postgresql://user:[email protected]:5432/testdb'
pytest -m integration
路线图:avg 和 meter_delta 规则;InfluxDB / Prometheus / ClickHouse 适配器;Celery/RQ 任务后端;OpenTelemetry 指标;PyPI 可信发布。
引用
@software{hybrid_recursive_ladder_2026,
  author  = {MagicSquarekey},
  title   = {Hybrid Recursive Ladder: Query Planning for Bucket-Limited Time-Series APIs},
  year    = {2026},
  version = {0.0.6},
  license = {MIT},
  doi     = {10.5281/zenodo.23683292},
  url     = {https://github.com/MagicSquarekey/hybrid_recursive_ladder_algorithm}
}
版本 DOI:10.5281/zenodo.23683292。
所有版本的概念 DOI:10.5281/zenodo.23556605。
CITATION.cff 提供相同的元数据,供 GitHub 的“引用此仓库”按钮使用。
许可证
MIT © 2026 MagicSquarekey
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。