关于 Mathlas
Mathlas 是面向数学研究 Agent 和 MCP 客户端的工具服务,提供定理检索、数值识别与验证能力。结果由 Lean 内核、PSLQ 或精确匹配等方法检查,不在服务内部调用 LLM。
主要功能
- 01检索 368 万条数学文档
- 02识别数值常数与整数序列
- 03验证数值和 Lean 形式化声明
- 04生成定理适用条件清单
- 05通过 PSLQ 检查常数关系
适用场景
- 01查找与数学问题相关的已有定理
- 02识别未知常数或 OEIS 数列
- 03检查数值结论或 Lean 证明
- 04评估定理前提是否满足
MCP 相关
Mathlas 以 MCP 服务形式向客户端提供 12 种纯数据工具,包括检索、识别和验证。可通过 stdio 连接,不需要 API 密钥;部分功能需要本地 OEIS 数据或 Lean 工具链。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
uvx mathlas-mcpMATHLAS_SEEDSet to 1 to force the lightweight built-in seed corpus and never load the multi-GB prebuilt index (fast cold start).MATHLAS_INDEXPath to a prebuilt index .npz to serve for search_existing_math (optional; the seed corpus is used when absent).本地服务需要在你的电脑上安装运行环境(如 Node.js 18+)。各客户端的配置文件位置不同,请参考客户端文档。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
mathlas


可在以下平台获取:mcp.so · Glama · 已收录于 awesome-mcp-servers 和 best-of-lean4。
供 AI 使用的严谨数学工具——无需大模型、无需 API 密钥,且免费。 将它接入 Claude Code、Cursor 或任何 MCP 客户端。AI 是大脑;mathlas 是 双手——它为 AI 提供其欠缺的能力,并返回供 AI 推理的数据 (候选项、判定结果、检查清单、脚手架)。 Apache-2.0。代码可免费用于任何用途;已发布的语料库/索引制品则遵循各自来源的许可条款(CC-BY/CC0)。
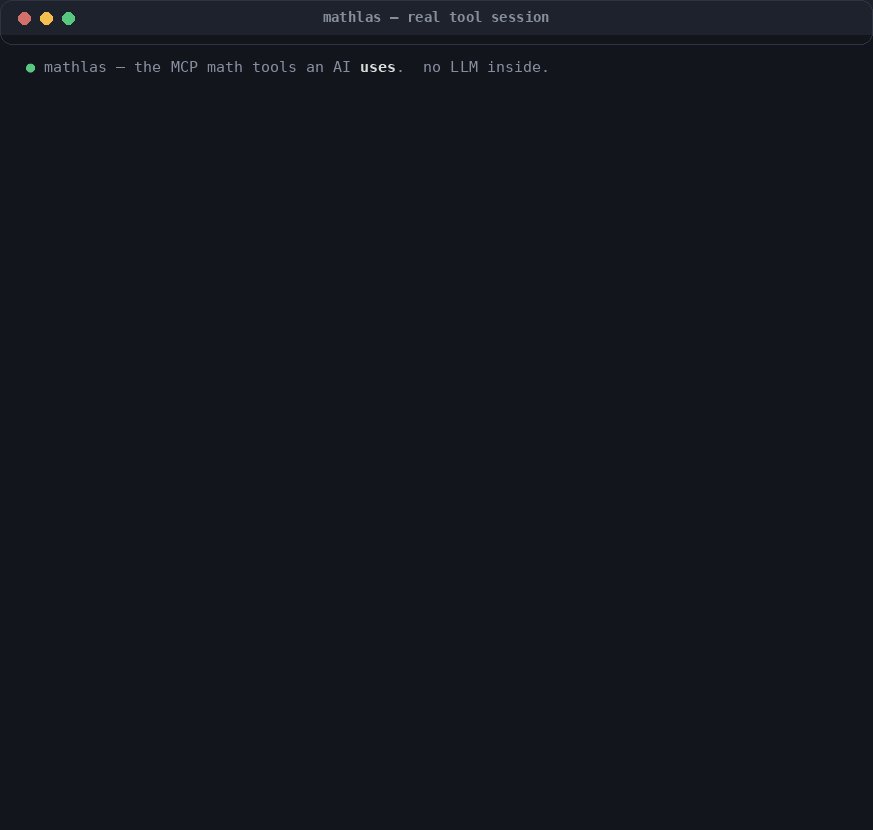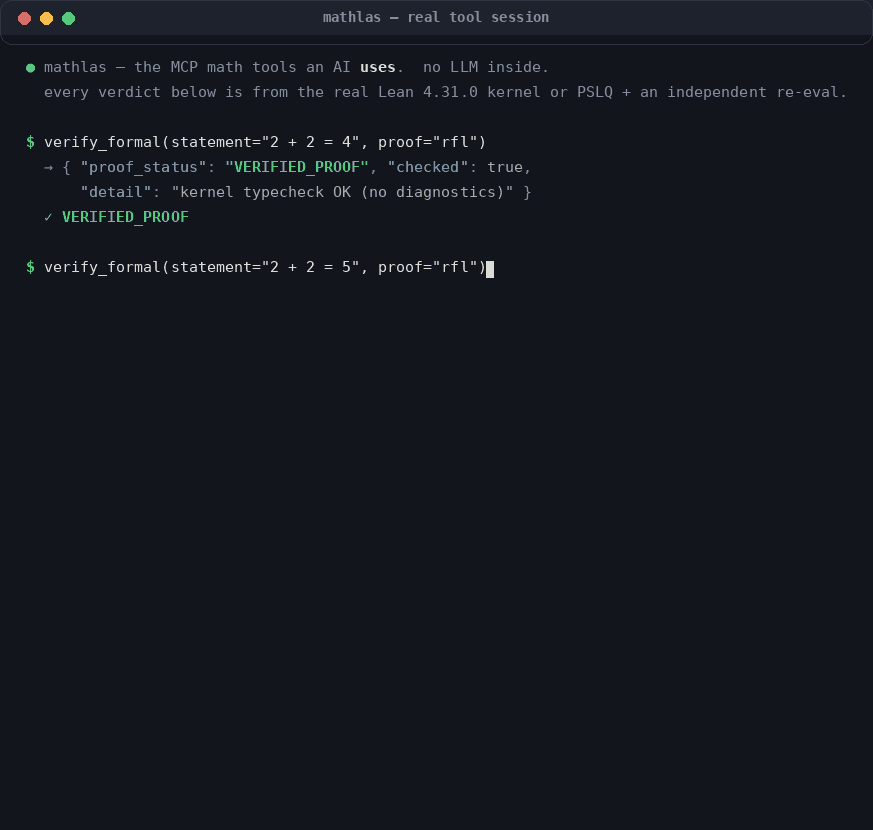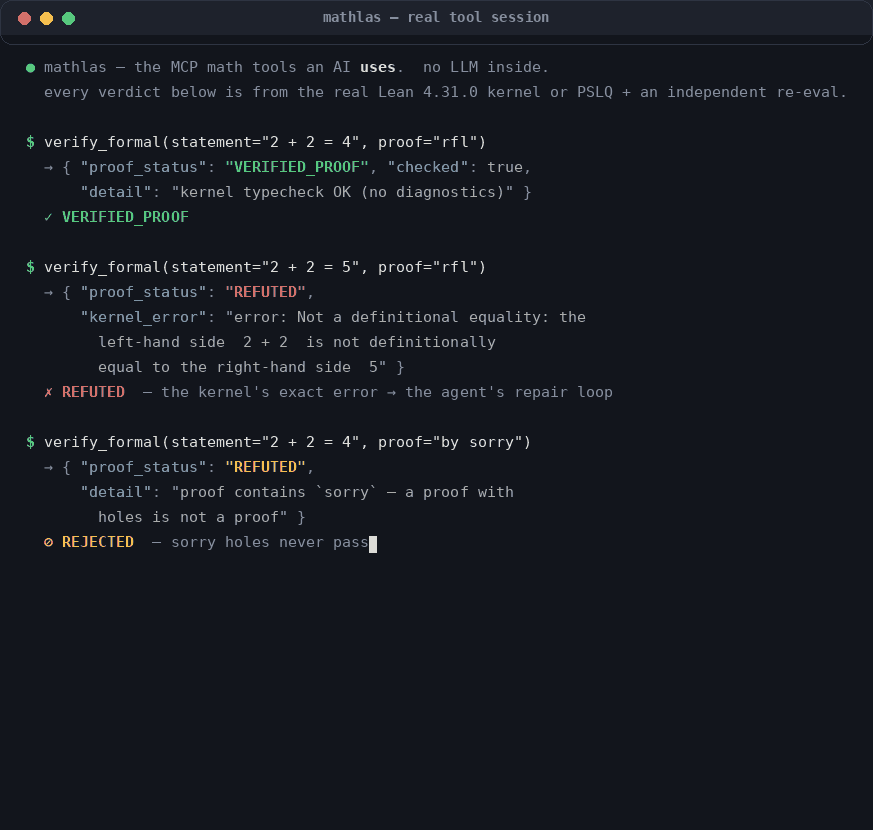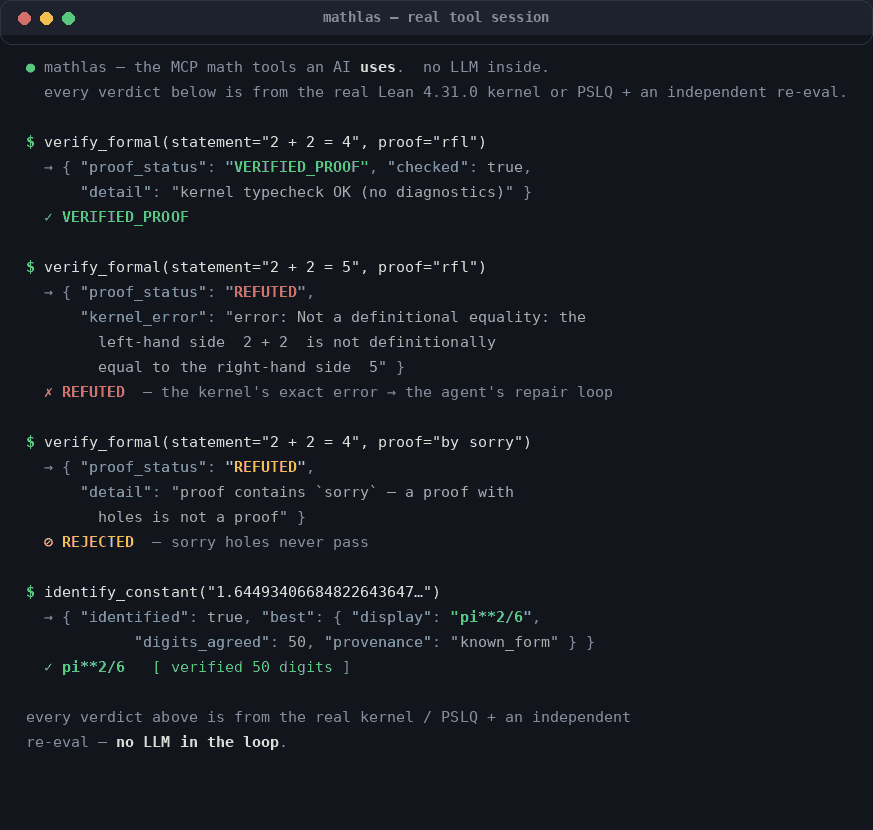
每个判定结果都来自真实的 Lean 4.31.0 内核 / PSLQ + 独立的重新求值——内部不使用大模型。这些是真实的进程内工具输出,由 assets/gen/capture_outputs.py 捕获。
适合你吗?
- 你使用 Claude Code / Cursor,希望 AI 不再幻觉数学内容——
search_existing_math可从包含 3.68M 篇文档的索引中找到真实定理;verify_numeric和verify_formal可在零幻觉风险下验证声明。 - 你有一个无法识别的数值常数或整数序列——
identify_constant可运行 PSLQ + 闭式匹配(50 位精度);identify_sequence可精确匹配 OEIS 序列项。 - 你需要某个结果的形式化(Lean/mathlib)名称——
search_formal_math代理公开的 Loogle + LeanSearch 服务,并返回带来源标注的声明名称 + 类型。 - 你正在构建需要在流程中使用严谨数学的 Agent 流水线——全部 12 个工具都是纯数据返回型 MCP 工具,内部不使用大模型,可与任何框架组合使用。
安装并注册到 Claude Code(无需 API 密钥)
一行命令,无需预先安装任何内容(需要 uv):
claude mcp add mathlas -- uvx mathlas-mcp
uvx mathlas-mcp 会在首次使用时获取并在隔离环境中运行服务。更喜欢 pip?
pip install mathlas-mcp              # core: numeric + retrieval + verify + scaffolds
pip install 'mathlas-mcp[mcp]'       # + official MCP SDK
pip install 'mathlas-mcp[retrieve]'  # + pyarrow, to read the real index
pip install 'mathlas-mcp[embed]'     # + sentence-transformers/torch, for the Qwen3 embedder

claude mcp add mathlas -- python -m mathlas.server
mathlas 现在会显示为 Agent 可调用的 十二个 工具。服务优先使用官方 mcp SDK;如果未安装 mcp,则回退到无需依赖的 stdio JSON-RPC 服务——始终可以运行。(Cursor / 任何 MCP 客户端:指向相同的 uvx mathlas-mcp 或 python -m mathlas.server stdio 命令即可。)
可选本地数据(会如实降级):
identify_sequence需要本地 OEIS 副本;verify_formal需要 Lean 工具链。没有这些时,工具会明确返回“数据/工具链不可用”——绝不会给出虚假答案。每项的一行设置命令请参见docs/methods.md。
一个实际示例——AI 使用这些工具
User:  "Does x = cos(x) have a unique solution I can reach by iterating?"

AI →   search_existing_math("contraction mapping unique fixed point complete metric space")
       ← [{name:"Banach Fixed-Point Theorem", statement:"Let (X,d) be a complete metric
            space and T a contraction. Then T has a unique fixed point ...", ...}, ...]
AI →   applicability_checklist(banach.statement)
       ← preconditions: ["(X,d) is a complete metric space", "T: X→X is a contraction"]
          conclusion:    "T has a unique fixed point"
AI  (reasons): [0,1] is complete; cos is a contraction there (|cos'|=|sin|≤sin 1<1).
       Every precondition holds ⇒ Banach applies ⇒ unique fixed point, reachable by iteration.
AI →   verify_numeric("0.7390851332151607", "<the Dottie-number closed form, if claimed>")
mathlas 提供了搜索、检查清单和严谨的数值核验。AI 负责判断。mathlas 内部没有调用任何大模型。
结果
我们的原则是要么严谨无误,要么不提供结果:结果必须是可独立核验的事实,或诚实地回答“没有结果”。所有层级的误报率均为 0(完整表格和命令见 RESULTS.md):
| 层级 | 已知项恢复率 | 误报 | 严谨核验依据 | 基准测试 |
|---|---|---|---|---|
数值(identify_constant) | 8/8 | 0/3 | 独立高精度重新求值(50–51 位) | benchmarks/numeric_bench.py |
数列(identify_sequence) | 8/8(7 个排名第一) | 0/3 | 与本地 OEIS 精确匹配数列项(约 40 万个数列) | benchmarks/tier_bench.py |
形式化(verify_formal) | 7/7 个判定 | — | 通过真实 Lean 4.31.0 内核类型检查 | benchmarks/tier_bench.py |
Ramanujan(conjecture_relation) | 6/6 | 0/2 | PSLQ + CF,每个命中结果都经过 ≥25 位重新核验 | benchmarks/tier_bench.py |
| 适用性护城河 | 15/15 项分解 + 6/6 项拦截 | — | 原子级前提条件、误用陷阱 | benchmarks/moat_bench.py |
| FunSearch + Web 增强 | 14/14 | — | 沙箱隔离(网络 / 超时 / 内存) | benchmarks/tools_bench.py |
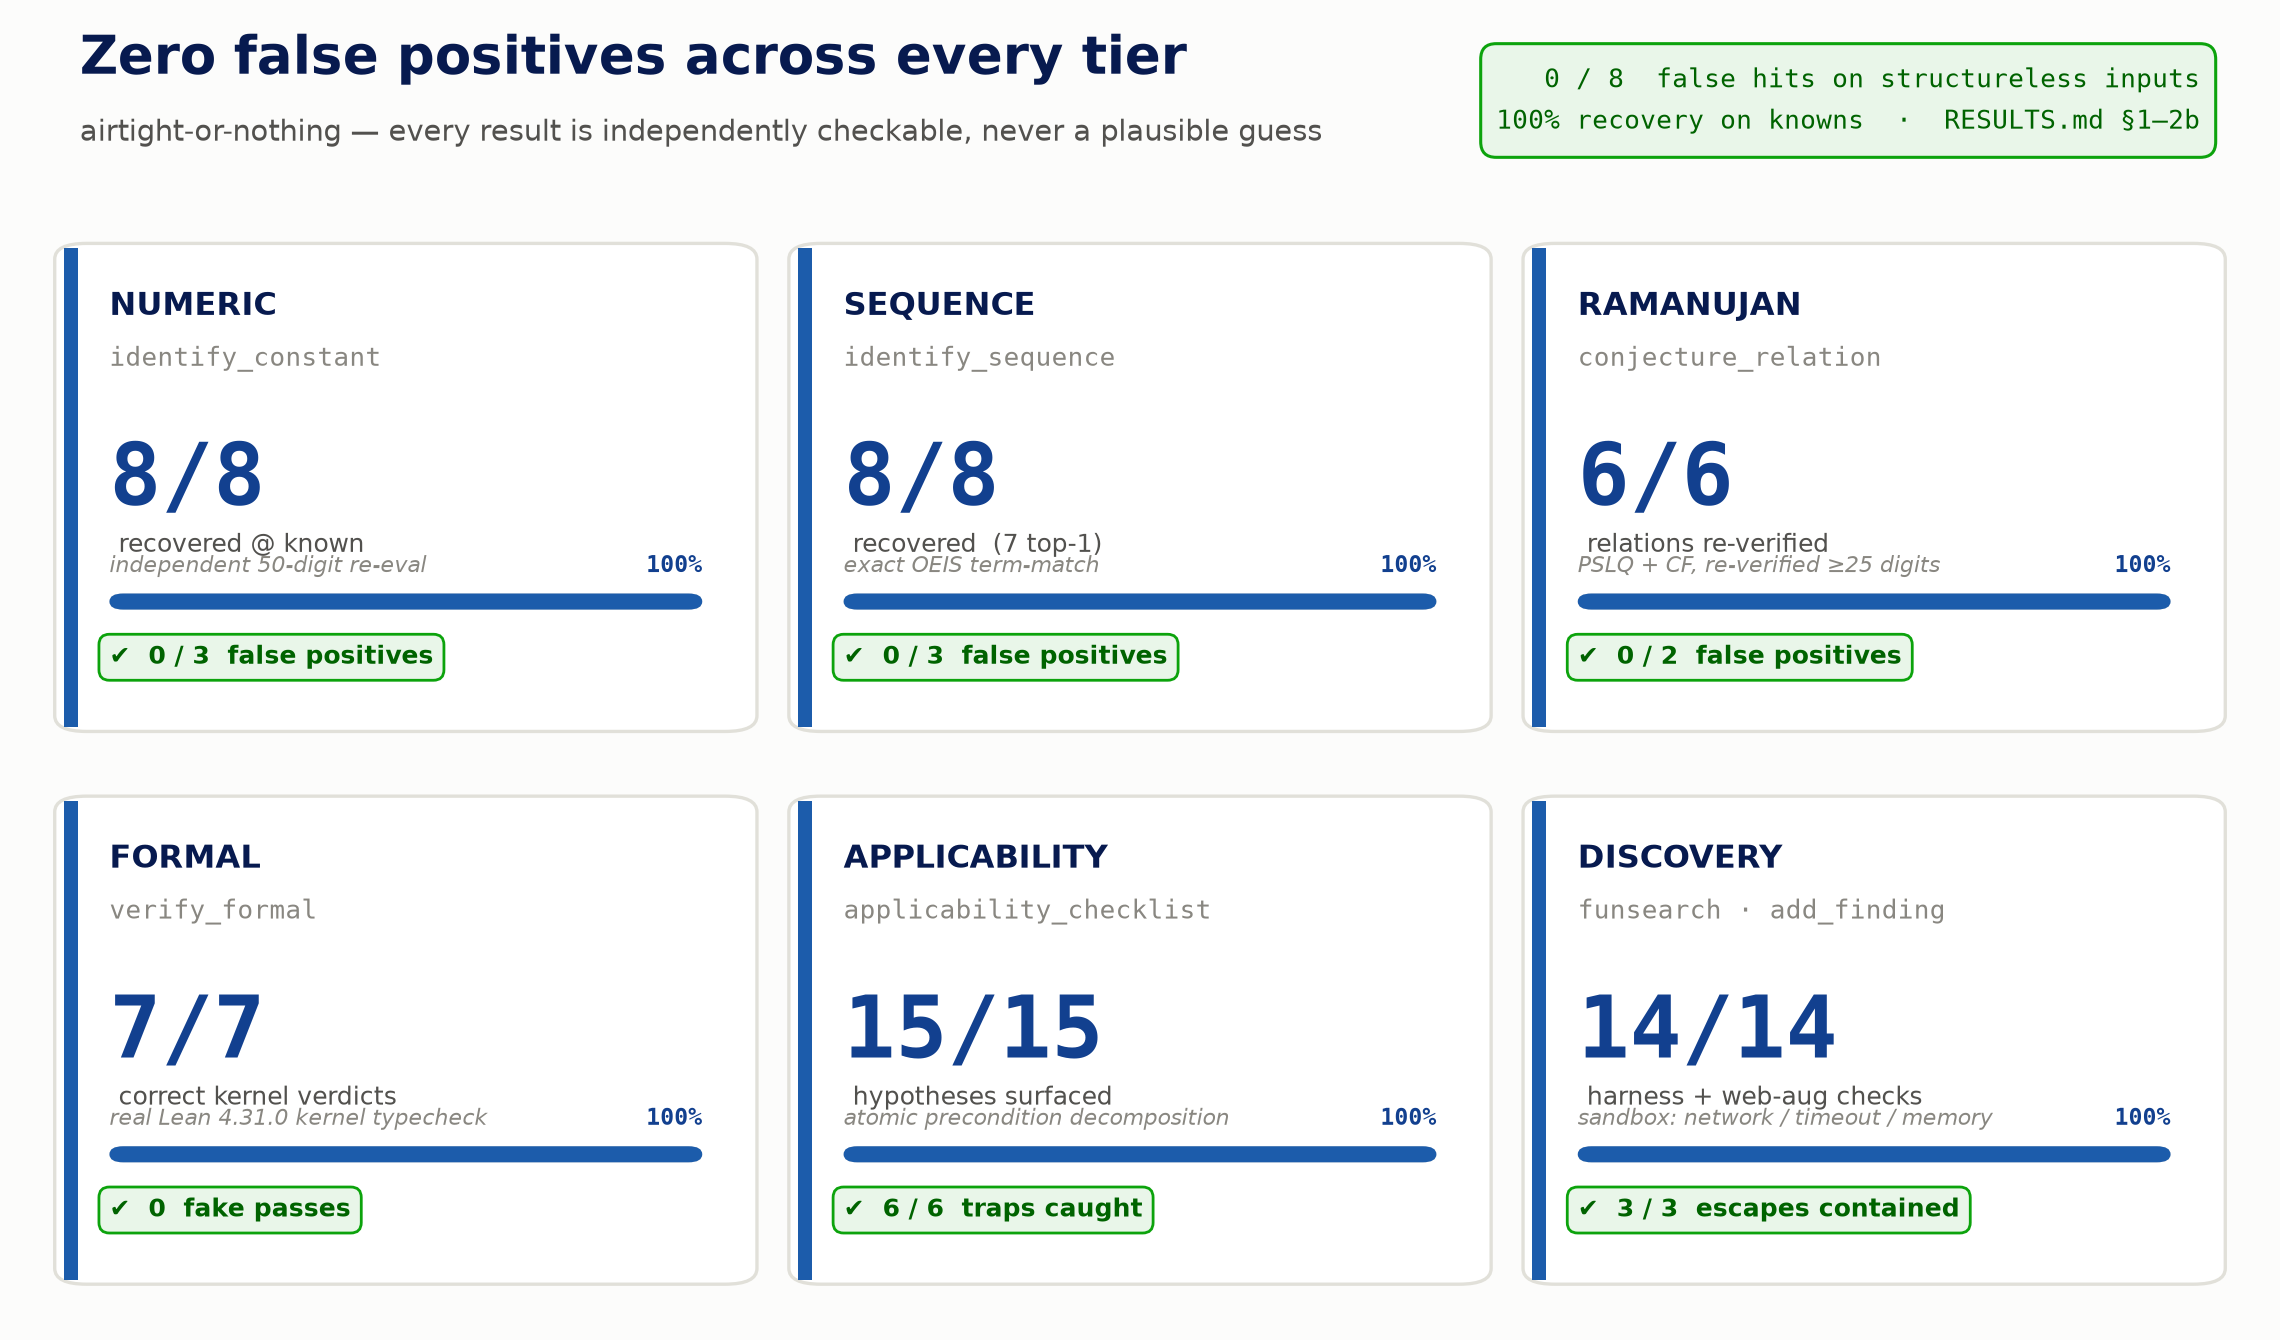
上表一览——所有层级的误报均为 0(8 个无结构输入中没有任何一个产生虚假命中),已知项恢复率为 100%。数据见:RESULTS.md §1–2b。
368 万文档索引。 search_existing_math 使用一个包含 3,683,428 篇文档的稠密索引(Qwen3-Embedding-8B,4096-d)提供服务:其中包含 134 万篇宽松许可的 CC-BY/CC0 TheoremSearch 子集,以及来自 Dolma 的 234 万篇嵌入口号的 arXiv-math 文档;采用稠密检索、Okapi-BM25 和 RRF。完整 368 万规模下的真实召回率:用文档的原始正文查询其嵌入口号的条目,R@1 0.614 / R@10 0.832——这是困难的跨表示自召回场景。(在较早的 163.5 万规模版本中,较容易的同表示“口号→口号”自召回,在其 81,833 篇文档的留出集上达到 R@1 0.977 / R@10 0.998。)
Hugging Face 上的开放语料库。 该索引的文本和元数据部分已发布在 kattri15/mathlas-corpus:共 3,683,428 篇定理级文档,以及较小的 findings 配置,分为 theoremsearch、dolma 和 findings 配置。内容包括口号、LaTeX 陈述、来源 URL、标题、标签、类别、已知时的引用次数,以及来源信息键。它不包含 30 GB 的嵌入矩阵或本地基准测试切片。许可证按配置划分:TheoremSearch 子集采用 CC BY-SA 4.0,Dolma 陈述采用 ODC-BY 1.0,我们的口号采用 CC BY 4.0,findings 采用 CC BY 4.0。完整审计报告:docs/HF_DATASET_LICENSING.md。
from datasets import load_dataset

ts = load_dataset("kattri15/mathlas-corpus", "theoremsearch", split="train")
dolma = load_dataset("kattri15/mathlas-corpus", "dolma", split="train")
量化笔记本电脑档位(可选启用)。 fp16 矩阵在磁盘上占 30 GB(常驻内存约 60 GB fp32)——构建机器足以胜任,笔记本电脑则不行。设置 MATHLAS_QUANTIZED=binary(或在 HybridRetriever.from_index 中设置 quantized="binary"),即可改用内存映射的量化旁路文件为同一索引提供服务:通过 1.9 GB 的符号位汉明距离筛选 1000 个候选项,再通过精确重评分选出 top-k。在完整的 368 万索引上,采用与摘要结果相同的 n=3000 协议测得,召回率无损(R@1 为 0.6143,fp16 为 0.6140;R@10 均为 0.8323;int8 模式:R@1 为 0.6147,占用 15 GB),在 4 个 CPU 线程下每次查询耗时 2.4 秒。如实说明:这只缩小了文档侧的体积——查询仍须使用同一个 Qwen3-Embedding-8B 进行嵌入(较小的 0.6B 编码器处于不同的向量空间)。真正的端到端小型编码器档位是下文的 0.6B 档位。详细数据、构建命令和注意事项见:docs/QUANTIZED_TIER.md。
0.6B 端到端笔记本档(可选启用)。 同一份包含 3,683,428 篇文档的语料库使用 Qwen3-Embedding-0.6B 重新嵌入了一次(1024 维,与服务端元数据按行对齐),因此查询编码器本身可以在笔记本电脑 CPU 上运行:MATHLAS_ENCODER=0.6b(可与 MATHLAS_QUANTIZED=binary 组合使用)。使用相同的 n=3000 跨表示协议进行测量,查询由 0.6B 模型重新编码:R@1 0.545 / R@10 0.745(binary + int8 重评分;0.6B fp16 精确扫描为 0.544 / 0.745,因此在这一档位内,量化同样不会造成精度损失)。与 8B 档(0.614 / 0.832)相比,实际代价是召回率约低 7–9 个百分点;双通道 8B 配置(0.965 / 0.999)仍是高端硬件的质量上限。笔记本档的亮点:使用 4 个 CPU 线程时端到端每次查询 0.67 秒(2 个线程时 0.88 秒),包括查询编码,覆盖全部 3.68M 篇文档。密集通道占用:binary 辅助文件 0.47 GB + 0.6B 编码器 约 1.2 GB(合计约 1.7 GB;建议使用 int8 重评分源文件 3.77 GB;完整 fp16 同系列索引 7.54 GB)。在仅使用 TheoremSearch-110 语料库的探测测试中,此档位的定理/论文 Hit@20 分别为 8.2% / 10.0%,而 8B 档为 10.0% / 11.8%(两者均受许可限制,是结果下限)。完整数据表、占用和注意事项:docs/QUANTIZED_TIER.md;构建:scripts/build_06b_index.py;评估:scripts/eval_06b_tier.py。
双通道检索(可选启用)。 0.614 这一指标反映的是跨表示差距:以 LaTeX 陈述形式编写的查询,检索的是通过口号嵌入的文档。第二个密集通道使用清理后的 LaTeX 陈述为同一批 3,683,428 篇文档生成嵌入(Qwen3-Embedding-8B,按行对齐,由 scripts/build_statement_channel.py 构建),然后按每篇文档的最大相似度合并到密集排序中。在相同的 n=3000 样本和完整语料库规模下测得:R@1 从 0.614 提升至 0.965,R@10 从 0.832 提升至 0.999。需要如实说明:此评估是自检索代理测试,陈述通道索引的正是查询所取自的文本(因此具有与 BM25 类似的精确文本优势);在无泄漏的 110 条人工查询基准测试中,提升确实存在,但幅度有限(论文 Hit@20 从 11.8% 提升至 12.7%)。而且第二个矩阵会让服务所需的 RAM 大致翻倍(完整规模测量:双通道服务进程峰值 150 GB,单通道约 95 GB;双通道密集扫描使用 2 个 CPU 线程时每次查询约 2.75 秒),因此严格设为可选启用(MATHLAS_STATEMENT_INDEX=/path/index_full_statement.npz,绝不会自动检测),且不能与量化档组合使用。完整数据和服务档位表:docs/RETRIEVAL_UPGRADE_NOTES.md。生产环境混合检索的默认 rrf_k 为 10(在所有测试过的 k 值中表现最佳),此外还支持可选的交叉编码器重排混合(MATHLAS_RERANK=1,Qwen3-Reranker-0.6B,可带来 +1.7 个百分点的诚实 R@1 提升)。重排后端可通过 MATHLAS_RERANK_MODEL 选择:qwen3(默认值,Qwen3-Reranker-0.6B,保持不变)或 jina-v3(jinaai/jina-reranker-v3,arXiv:2509.25085——一款 0.6B 级的“非后期”重排器,在 BEIR 的 0.6B 级别中领先)。两者都会在首次使用时延迟加载权重;若缺少 torch/transformers 或权重,则回退到未经重排的融合结果(并在 stderr 中如实提示);模型名称拼写错误时会报错,而不会静默地使用错误的重排器。我们提供接线支持,但不提供 jina 基准数据——请自行准备权重。
自我增强循环——超越 TheoremSearch
在 TheoremSearch 自有的 110 条人工编写查询 上,基线版 mathlas 遇到了覆盖率瓶颈——TheoremSearch 未公开其私有 9.2M 语料库的 85%,因此任何开放系统都无法找到 95 篇目标论文。随后 AI 运行循环:针对每个缺失的定理,它通过网络查找真实表述,使用相同的 Qwen3-Embedding-8B 对其进行嵌入,然后通过 add_finding(dense_vec=…) 在运行时经由稠密通道融合(于 2026-06-10 在所服务的 3.68M 索引上重新测量——循环后的关键结果完全复现;仅语料库基线因新增的 Dolma 干扰项从 13.6% 降至 11.8% 的论文级命中率,按实测结果报告):
| 方法 | 定理 Hit@20 | 论文 Hit@20 |
|---|---|---|
Google(site:arxiv.org) | — | 37.8% |
| ChatGPT 5.2 w/ Search | 19.8% | — |
| Gemini 3 Pro | 27.0% | — |
| TheoremSearch(Qwen3-8B,完整私有 9.2M) | 45.0% | 56.8% |
| mathlas — 基线(仅语料库) | 10.0% | 11.8% |
| mathlas — 自我增强网络循环后 | 59.1%(65/110) | 70.0%(77/110) |
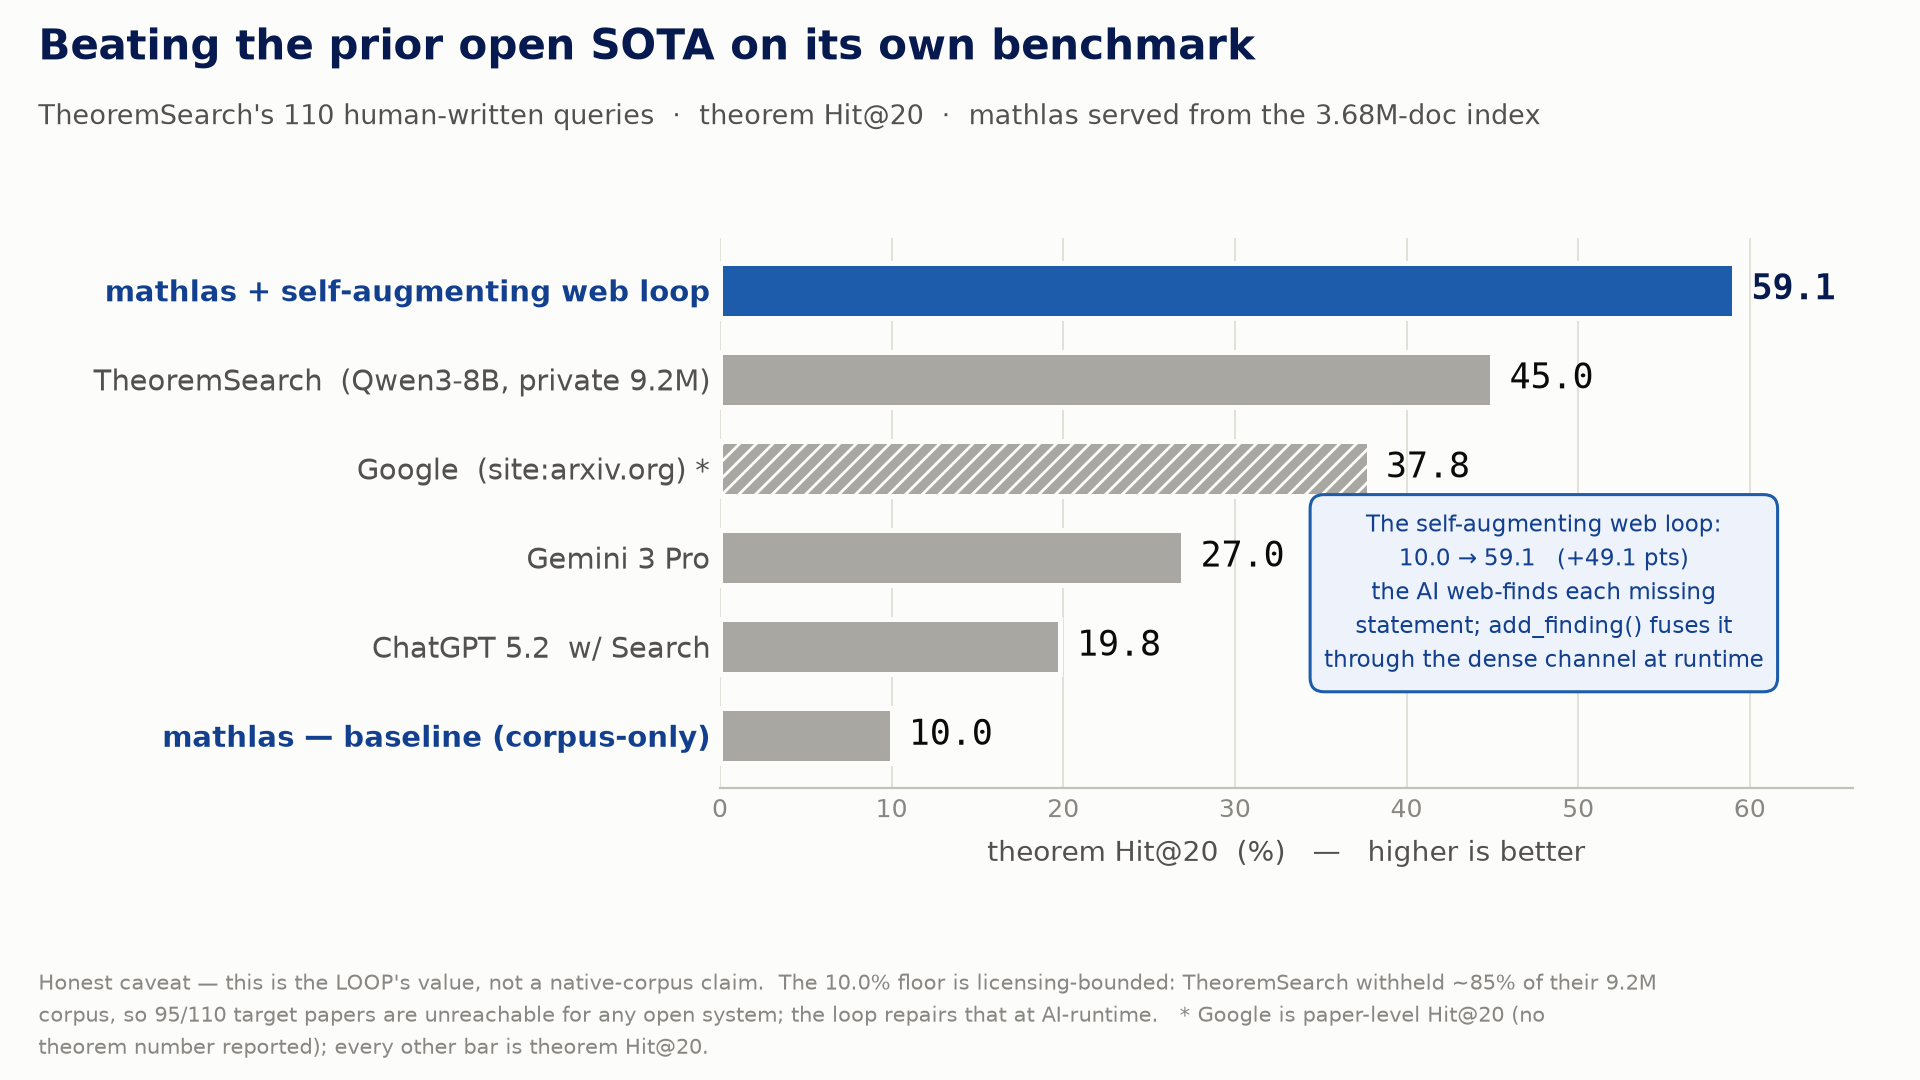
这体现的是循环的价值,而非原生语料库的表现。10.0% 的基线受许可限制——TheoremSearch 未公开其 9.2M 语料库中约 85% 的内容,因此任何开放系统都无法找到 110 篇目标论文中的 95 篇;自我增强网络循环在 AI 运行时弥补了这一覆盖缺口。Google 的柱状数据为论文级 Hit@20(未报告定理编号);其他所有柱状数据均为定理级 Hit@20。
使用 benchmarks/webaug_110_bench.py 复现(请使用完整的 82 条发现项工作清单 _findings_worklist_full.json)。
感知来源的检索(可选启用)。 将索引从 1.34M 扩大到 3.68M 产生了可测量的代价:2.34M 篇通过网络挖掘的 Dolma 文档将规范论文挤出了前 20 名(在相同的 110 条查询上,仅语料库的论文级命中率从 13.6% 降至 11.8%)。search_existing_math 现在接受可选的 source_filter / source_weights——例如,只需要规范定理表述时,可使用 source_filter={"exclude": ["dolma"]};排除 dolma 后可完全恢复增长前 13.6% 的论文级命中率(15/110;可检索的 15 篇论文中命中 15/15 = 100%),且定理级命中率高于旧索引(11.8% 对比 10.9%)。默认排序保持逐字节一致(由测试固定)。这是一项按查询意图调整的参数,并非免费提升:在 n=3000 的自召回测试中,目标中有 65% 是 Dolma 文档,下调 dolma 权重会严重损害这些查询的表现(dolma 目标的 R@10 从权重 0.5 时的 0.999 降至 0.884,排除 dolma 时降至 0)——这正是它默认关闭、仅可选启用的原因。我们还测试了双通道是否能在结构上修复这一退化,而不依赖该参数:它能部分恢复(默认设置下,论文命中率从 11.8% 升至 12.7%,定理命中率从 10.0% 升至 10.9%),但无法完全恢复到 13.6%,因此在此基准测试中,该参数仍是文档所述的缓解措施。完整对照表:docs/02_eval_vs_theoremsearch.md。
12 个工具
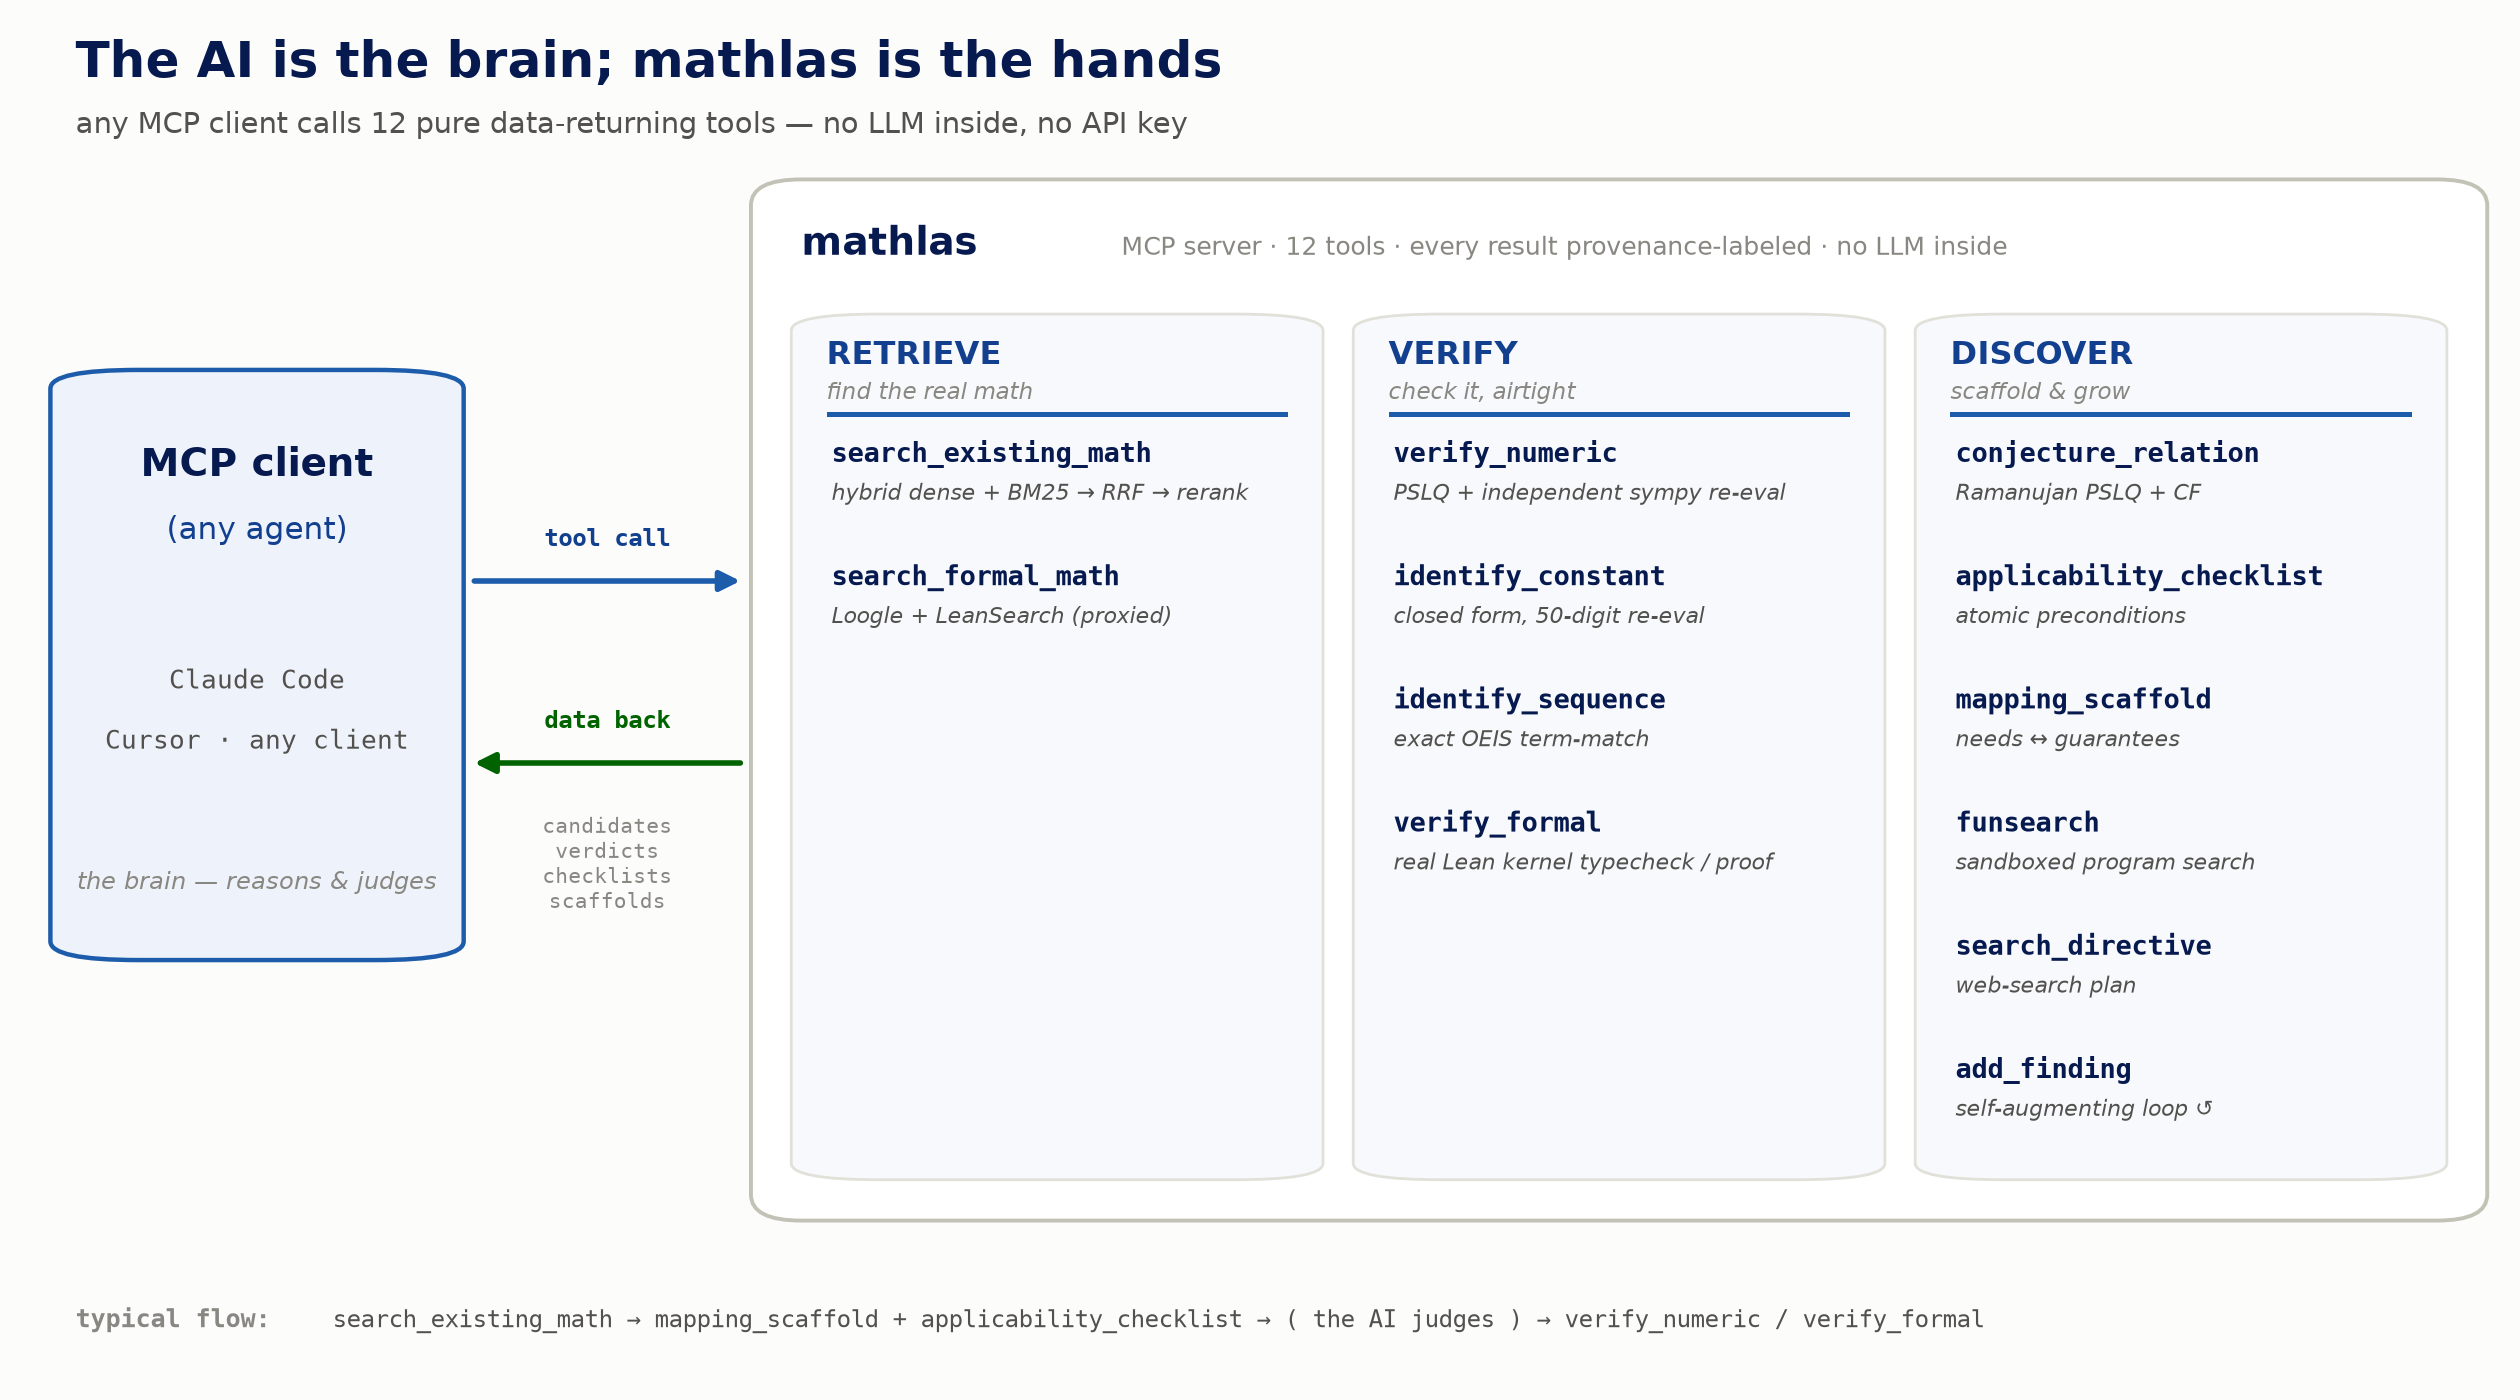
search_existing_math ─▶ mapping_scaffold + applicability_checklist ─▶ (AI judges) ─▶ verify_numeric / verify_formal
   (own index)            (needs↔guarantees, no LLM)                                  (airtight)
核心四个工具 — 大多数 Agent 会用到:
| 工具 | 功能 |
|---|---|
search_existing_math(query, k) | 查询 → 从 368 万文档的稠密检索 + BM25 + RRF 索引中返回排序后的结果 |
identify_constant(value) | 实数值 → 已知闭式表达式 + 来源(重新评估至 50 位精度) |
verify_numeric(value, closed_form) | 数位一致性判定 — 使用不同的引擎,以更高精度验证 |
verify_formal(statement, lean?, proof?) | 运行真正的 Lean 内核 — 对代码片段进行类型检查,或传入 proof,对完整的 Lean 4 证明进行内核检查:VERIFIED_PROOF / REFUTED(内核返回的确切错误,供修复循环使用)/ 诚实返回 UNDETERMINED |
完整工具包:
| 工具 | 功能 |
|---|---|
search_formal_math(query, backend) | 通过公开的 Loogle(模式/类型)+ LeanSearch(自然语言)服务查询 mathlib 声明名称和类型,并标注来源;服务不可用时会如实告知;同时提供 7 天磁盘缓存,当服务中断时返回最近一次成功响应,并清楚标注 (cached, <age> old) |
identify_sequence(terms) | 整数序列 → 匹配的 OEIS 条目(精确匹配序列项) |
applicability_checklist(statement) | 将结果的假设整理为清单,供 AI 逐项标记 |
mapping_scaffold(problem, statement) | 需要↔保证问题 + 填写模板 |
conjecture_relation(value) | Ramanujan Machine:基于丰富基组的 PSLQ + 连分数/递推猜想 |
funsearch(action, problem_id, …) | 一个工具即可使用 FunSearch 框架 — action=evaluate(对 AI 编写的程序进行沙箱评分)、register(MAP-Elites 数据库)、status(最优结果 + 少样本示例) |
search_directive(problem) | 网络搜索计划:arXiv 查询 + 子领域 + 建议运行的工具 |
add_finding(statement, slogan, source) | 将从网上发现的结果导入实时语料库 |
所有工具都只返回数据,不会调用 LLM。search_formal_math 是唯一会自行发起网络调用的工具(调用公开的 Loogle/LeanSearch 服务);其他工具完全在本地运行。
证明检查——修复循环
verify_formal 不只是对语句进行类型检查:给它一个命题和你的 Lean 4 证明,真正的内核就会检查完整声明。mathlas 从不编写证明(生成器与验证器严格分离)——但如果你的证明有误,内核会在 kernel_error 中逐字告诉你确切原因。这让证明编写形成紧密循环:Agent 编写证明 → mathlas 的内核准确指出错误 → Agent 修复并再次调用。
verify_formal(statement="∀ n : Nat, n + 0 = n", proof="by\n  intro n\n  rfl")
// → {"proof_status": "VERIFIED_PROOF", "checked": true, ...}
verify_formal(statement="2 + 2 = 5", proof="rfl")
// → {"proof_status": "REFUTED", "kernel_error": "error: Not a definitional equality:
//     the left-hand side 2 + 2 is not definitionally equal to the right-hand side 5 ...", ...}
从设计上杜绝虚假通过:sorry/admit 占位证明会被拒绝(Lean 本身在遇到含 sorry 的证明时会以 0 退出——mathlas 会扫描源代码和内核的 sorryAx 诊断信息);缺少工具链、超时(上限为 60 s),或当前裸工具链无法解析的导入,都会如实返回 UNDETERMINED,绝不会给出判定。tests/test_proof_check.py 仅保留真实内核集成检查;纯声明、解析器和 API 表面单元测试未纳入此审查分支。CI 还会运行 tests/test_hf_upload_corpus.py 中的合成 Hugging Face Parquet 构建/加载集成检查。
运行 CPU 数据管道和可选的 Lean 内核集成检查:
先执行 python -m pip install -e ".[retrieve]" pytest datasets,然后执行
python -m pytest -q tests/test_hf_upload_corpus.py tests/test_proof_check.py。
如果没有可用的 Lean 可执行文件,Lean 测试用例会跳过。
CLI / Python
mathlas 1.6449340668482264364724151666460251892   # -> pi**2/6  [verified 51 digits]
mathlas 1,1,2,3,5,8,13,21                          # -> A000045 Fibonacci  https://oeis.org/A000045
mathlas "a bounded sequence has a convergent subsequence" --k 5   # search + scaffold
mathlas mcp                                                        # run the MCP server
import mpmath
from mathlas import identify, identify_sequence, mapping_scaffold, applicability_checklist
print(identify(mpmath.zeta(2)))            # -> pi**2/6 [verified 51 digits]
print(identify_sequence([1,1,2,3,5,8,13,21]).matches[1].a_number)  # -> 'A000045'
文档
RESULTS.md— 复现了每个工具的验证过程,并附有命令。docs/methods.md— 架构、设计决策和引用。docs/05_open_dataset.md— 开放数据集与索引。docs/QUANTIZED_TIER.md— 量化笔记本电脑层级:实测召回率、占用空间和延迟。docs/02_eval_vs_theoremsearch.md— 检索效果正面对比。docs/REGISTRY_PUBLISH.md— 发布到官方 MCP 注册表。
定位——检索只是基本要求,验证才是护城河
**客观评价:**最接近的系统 TheoremSearch(UW Math AI Lab)如今已提供生产级 REST API 和自己的 MCP 端点(api.theoremsearch.com/mcp),覆盖 920 万份文档的语料库——在数学文献的原始召回率方面,它是我们需要超越的系统;“我们原生支持 MCP,他们只是实验室工具”不再是差异化优势。我们只将其开放许可(CC-BY/CC0)数据集的子集作为原始数据,用于构建自己的索引——不使用其 API、MCP、索引或代码。
DeepMind 释放的信号,以及开放验证器为何仍然重要。DeepMind 的 AlphaProof Nexus(arXiv:2605.22763)验证了 mathlas 的架构——由 LLM Agent 协调 Lean 内核和 OEIS 等结构化数学资源,将其作为真实依据——但它仅供内部使用:公开产物只是结果转储(google-deepmind/alphaproof-nexus-results),不是可运行的系统,也没有 API 或 MCP 接口。Gemini Deep Think 及同类系统进一步凸显了这一需求:随着 Agent 推理能力增强,Agent 可低成本、离线调用的本地确定性验证器将成为瓶颈,而非模型。mathlas 仍是唯一一个开放、无需 API 密钥、可组合 MCP 的验证层,任何 Agent 今天都可以直接接入——它现在还会将 DeepMind 自己的开放许可 formal-conjectures Lean 语料库(arXiv:2605.13171)作为索引来源导入(scripts/fetch_formal_conjectures.py;3,941 条 Lean 猜想语句;来源标签 formal_conjectures,包括冻结的 FC100SolvedSet1/FC100OpenSet1 评测子集)。
命名说明: mathlas 与 Matlas(matlas.ai,北京大学定理搜索,arXiv:2604.17484)无关——这是不同的项目,作者也不同;名称近似纯属巧合。
没有任何竞品具备检索之后的所有功能:
- 验证层级——
verify_numeric(独立进行 50 位精度重新计算)和verify_formal(由真正的 Lean 内核进行类型检查——包括完整证明检查,并逐字返回内核错误,供 Agent 修复循环使用——或者诚实地返回 UNDETERMINED)。检索会为你提供候选结果;mathlas 还可以检查结论和检查你对该结论的证明。 applicability_checklist——将候选定理分解为原子级前提,让 AI 逐一验证,捕捉误用情况(开区间与闭区间、无限群与有限群)。没有任何竞品具备此功能。- 自增强的
add_finding循环——AI 通过网络查找缺失的陈述,为其生成嵌入,并在运行时将其融合到实时索引中:在他们自己的 110 条查询基准测试中,定理 Hit@20 达到 59.1%,而 TheoremSearch 为 45.0%(见上文)。据我们所知,这是数学领域首个经过验证的写回 RAG 循环实例——这类双向检索系统会将经过验证的推理写回可检索存储(Bidirectional RAG,arXiv:2512.22199),而不是将检索视为只读(Self-RAG,arXiv:2310.11511;CRAG,arXiv:2401.15884)。数学领域之所以适合采用这种方式,是因为写回候选项在受信任之前可以经过确定性检查(verify_numeric/verify_formal),因此循环能够扩充语料库,而不会像通用写回循环那样带来放大幻觉的风险。 - 零误报原则——每个层级都会返回可独立检查的事实,或诚实地表示“无结果”;测得的误报率在所有层级均为 0(
RESULTS.md)。 - 免费、无需 API 密钥、标注来源——每个结果都注明其来源(
known_constant、conjectured_relation、web_added、external:loogle等),索引 100% 由开放许可的数据构建。
| mathlas | TheoremSearch | LeanSearch / Loogle | Wolfram MCP | sympy-mcp | |
|---|---|---|---|---|---|
| 非形式化数学检索 | ✅ 368 万份文档,开放 | ✅ 920 万份文档(约 85% 为私有) | ❌(仅限 mathlib 声明) | ❌ | ❌ |
| 形式化(mathlib)搜索 | ✅ 代理两者 → 一个 MCP 工具 | ❌ | ✅(正是此功能) | ❌ | ❌ |
| 数值验证 | ✅ 严谨的 50 位精度重新计算 | ❌ | ❌ | ⚠️ CAS 求值 | ⚠️ CAS(没有结论检查机制) |
| 形式化验证 | ✅ 真正的 Lean 内核(陈述和完整证明,支持修复循环的错误反馈) | ❌ | ❌(提供搜索,不提供检查) | ❌ | ❌ |
| 适用性检查清单 | ✅ 独有 | ❌ | ❌ | ❌ | ❌ |
| 自增强语料库 | ✅ add_finding(Hit@20 为 59.1,而对比项为 45.0) | ❌ | ❌ | ❌ | ❌ |
| 常数/数列 ID | ✅ PSLQ + OEIS + Ramanujan-Machine | ❌ | ❌ | ⚠️ 部分支持 | ❌ |
| 来源标签 | ✅ 每个结果都有 | ❌ | 不适用 | ❌ | 不适用 |
| 费用/密钥 | 免费,无需密钥 | 免费端点 | 免费 | 付费 Wolfram API 密钥 | 免费 |
| MCP | ✅ stdio,uvx 一行命令即可运行 | ✅ 远程端点 | ❌(mathlas 代理调用) | ✅ | ✅ |
(sympy-mcp 是一款不错的 CAS 运算服务——它的适用范围与 mathlas 几乎没有重叠:它会改写你提供的表达式;mathlas 则会查找、界定并验证已有数学内容。)
官方 MCP 注册表
mathlas 已以 io.github.Archerkattri/mathlas 的名称发布(参见 docs/REGISTRY_PUBLISH.md 和 server.json)。
mcp-name: io.github.Archerkattri/mathlas
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。