关于 Obsidian MCP Server
Obsidian MCP Server 是可自托管的 MCP 服务,将现有 Obsidian vault 提供给 Agent 使用,适合需要共享、可审阅笔记记忆的个人或团队。它支持关键词与语义搜索、wikilink 图操作,并通过写入保护机制避免基于过期内容覆盖修改。
主要功能
- 01直接服务现有 Obsidian vault
- 02提供关键词与语义搜索
- 03支持 wikilink 图操作
- 04OAuth 2.0 PKCE 与 API key 认证
- 05多用户按 vault 根目录隔离
- 06写入采用校验、原子发布与回收站
适用场景
- 01让 Agent 搜索并更新 Obsidian 笔记
- 02在多个 MCP 客户端间共享笔记上下文
- 03从手机会话检索并记录主题笔记
- 04避免并发编辑覆盖较新的笔记
MCP 相关
该项目通过 MCP 暴露笔记存储、搜索和图操作工具,供兼容客户端读取与写入 vault。可通过 HTTP 连接,并支持 OAuth 2.0 PKCE 或 API key 认证。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
docker run -i --rm -e DATABASE_URL -e VAULT_PATH -e SECRET_KEY -e MCP_HOSTNAME -e EMBEDDING_PROVIDER -e OLLAMA_URL -e OPENAI_API_KEY ghcr.io/maxkuminov/obsidian-mcp:v0.10.0DATABASE_URL密钥PostgreSQL 16 + pgvector (0.8.0+) connection URL for the app's NON-superuser role, e.g. postgresql+asyncpg://obsidian_mcp:<password>@postgres:5432/obsidian_mcp. A superuser role or a CHANGE_ME password is refused at startup.VAULT_PATHPath of the Obsidian vault inside the container (mount your vault read-write there).SECRET_KEY密钥itsdangerous signer for cookies/sessions. Generate with `openssl rand -hex 32`; the app refuses to start on a placeholder.MCP_HOSTNAMEPublic hostname your reverse proxy routes to. Also derives BASE_URL, ALLOWED_ORIGINS and ALLOWED_HOSTS as https://<MCP_HOSTNAME> unless those are set explicitly.EMBEDDING_PROVIDEREmbedding provider: `ollama` (self-hosted, default) or `openai` (bring your own key). Switching after deploy requires `make reset-embeddings`.OLLAMA_URLOllama endpoint serving bge-m3 (used when EMBEDDING_PROVIDER=ollama). Must be https or loopback unless EMBEDDING_ALLOW_PLAINTEXT is set.OPENAI_API_KEY密钥OpenAI (or OpenAI-compatible) API key for text-embedding-3-* (required when EMBEDDING_PROVIDER=openai; the server refuses to start without it).本地服务需要在你的电脑上安装运行环境(如 Node.js 18+)。各客户端的配置文件位置不同,请参考客户端文档。
ghcr.io/maxkuminov/obsidian-mcp:v0.10.0Streamable HTTP工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
Obsidian MCP 服务

Agent 的记忆,就在你已有的知识库中,可通过 claude.ai、ChatGPT、Claude Code 和手机访问。
一个运行在 Obsidian 知识库之上的可自托管 Model Context Protocol 服务。它有三项大多数替代方案都不具备的特点:
- 直接使用你现有的知识库。 不强加笔记格式,没有旁置语法,也不需要你采用“记忆”文件夹。Agent 读取你阅读的内容、遵循你的维基链接,并从知识库本身获取文件夹布局、frontmatter 架构和标签约定。
- 支持远程访问和多用户。 通过 OAuth 2.0 PKCE 和 API 密钥,claude.ai、Claude Desktop、Claude 移动端、ChatGPT、Claude Code 和 n8n 都能读写同一批文件,同时将每位用户限制在自己的知识库根目录中。
- 写入不会覆盖内容。
expected_hash前置条件会拒绝基于过期读取结果所做的编辑;每次发布都是原子操作,且默认禁止覆盖;删除的内容会移至.trash/;dry_run会在实际写入前返回差异。
通过 Claude Code 连接:
claude mcp add obsidian --transport http \
  --url "https://obsidian-mcp.<your-domain>/mcp" \
  --header "Authorization: Bearer omcp_..."
在 claude.ai、Claude Desktop 或 ChatGPT 中,添加自定义连接器,地址为 https://obsidian-mcp.<your-domain>/mcp,然后通过 OAuth 授权页面登录。连接客户端中有其余说明。
技术栈:Python 3.12、FastAPI、带 pgvector 的 PostgreSQL。嵌入模型可插拔(Ollama bge-m3,或 OpenAI text-embedding-3-{small,large})。
目录
- 存在的理由
- 键盘前的使用体验
- 离开键盘后的使用体验
- 包含的功能
- 与其他 Obsidian MCP 服务的比较
- 适用人群
- 控制面板
- 快速开始
- 升级
- 成本预期
- 自描述知识库
- 多用户模式
- 配置
- 架构
- 项目布局
- 开发
- 安全说明
存在的理由
这里有三件事,它们结合起来比各自单独存在更有意思。
1. 真正可读的 Agent 记忆
如果让 Agent 运行一段时间,它就需要记忆。大多数配置会用不透明的向量存储、SQLite 数据块,或你无法查看内部内容的托管“记忆”服务来解决这个问题。这样做行得通,直到你想知道 Agent 认为自己了解你的哪些信息、需要纠正某些内容,或想弄清楚它为什么突然给出奇怪的建议。
这个服务提供了另一种选择。Agent 的记忆以 Markdown 文件的形式保存在你的知识库中。文件夹结构、文件名、frontmatter,全部一目了然。你可以在 Obsidian 中打开并阅读文件,也可以编辑、删除或用 grep 搜索。Agent 的“记忆”是一份可由人审查的内容,存放在与你自己的笔记相同的位置,并且可以使用相同的工具。
家庭实验室是让我决定采用这种方案的用例。我的知识库中有关于机架、网络和每个 Home Assistant 集成的笔记。我可以说“在主浴室设置夜灯模式,晚上 11 点后调到 1%”,系统管理员 Agent 就会找到正确的配置、完成更改,并在同一轮操作中更新文档。六个月后,当我忘了它的工作原理时,答案就在知识库中,而不是埋在无法搜索的聊天记录里。
语义搜索和双链图谱仍然可以用于这些内容,因此检索既快速又能基于概念进行。但底层是你拥有的文件,而不是黑箱。
准确来说,这个服务提供的是可通过 MCP 访问的存储、关键词和语义搜索,以及针对 Markdown 笔记的图谱操作,供你连接的任意 MCP 客户端使用。Agent 自行决定读取和写入内容。后台没有运行任何信息提取或衰减流程,也不会因为模型判断某条笔记已经过时就重写它:Agent 写下笔记,便记住了某件事;有人删除笔记,它便忘记了这件事。到 2026 年末,这种观点已不再像听起来那么另类。每家供应商的整合步骤(“dreaming” 或“sleep-time”任务)都已变成可供检查的独立流程,而不是写入过程中悄无声息的信息提取。这个服务让 Agent 保持作者身份。它将来提供的整合辅助会是一份卫生检查报告,提出合并建议并标记重复内容,但绝不会写入任何内容(#359),而不是趁你不注意时修改笔记的流程。
2. 你和 Agent 之间的共享记忆层
另一半则反向运作:知识库不仅是 Agent 的记忆,也是我的记忆。我把自己的 Obsidian 知识库看作我的外接大脑。这个包含笔记、日历、脚本、搜索和 AI 助手的「扩展版自我」,能力远胜于仅依靠生物大脑的「本体自我」。我大部分思考也在这里进行,因为把事情写下来本身就是一种思考。
问题在于,直到最近,知识库都只是被动的。我必须主动去找东西。想帮我的 Agent 每次会话都得从头了解情况,也无法查看我已经写过的相关内容。
这个服务解决了这个问题。现在,同一个知识库既为我日常写作提供内容,也为我接入的任何 Agent 提供内容。Agent 读取我读过的内容,链接我链接的内容,沿用相同的 wikilinks,也能看到相同的 frontmatter。周日写下项目笔记后,周一早上的简报 Agent 已经能了解相关情况。Agent 在研究会话中留下的笔记,也会出现在我平时使用的 Obsidian 搜索中。
举个具体的例子:我会在 Claude Code 中围绕某个项目进行一段会话,收尾后推送提交,然后只需说一句「更新 Obsidian」。Agent 会读取知识库指南,找出我的目录结构中项目笔记的位置,选用合适的格式和 frontmatter,并留下一份会话日志,之后我可以把它整理进状态报告。无需传递路径,也不用告诉它该写什么——知识库里已经有这些惯例,它会遵循。
这就是外接大脑理念的具体体现:一个存放上下文的地方,人和 Agent 都以相同的方式在其中读写。
3. 知识库伴你同行
让我至今仍感到惊讶的是,这一切面向互联网。同一个知识库、同一批笔记,无论我在哪里与 Agent 对话都能访问——无论是在浏览器标签页中的 Claude、火车上的手机 Claude、按计划触发的 n8n 工作流,还是当前手边任意一台笔记本电脑上的 Claude Code 会话。所有访问都经过 OAuth 或 bearer key 保护,并且都指向同一个事实来源。
所以,当我通勤时听到一档有趣的播客,想用手机上的 Claude 畅所欲言时,Agent 并非从零开始。它可以调出我已经写过的相关主题内容,找出六个月前写到一半的笔记,并在对话结束时建议更新内容,再将其写入。知识库不必就在我身边,也能成为我正在使用的工作空间。(离开键盘的一段会话会详细介绍其中一个例子。)
键盘前的一段会话
为了让抽象的概念更具体,下面是一段真实会话的简短记录。工具调用以内联形式展示;用户用日常语言输入,Agent 选择合适的工具。
you  > find anything I've written about why retrieval-augmented
       chat is hard

claude
  → semantic_search(query="why retrieval-augmented chat is hard")
    • 2025-12-03 - RAG failure modes.md
    • 2025-10-18 - Chunking tradeoffs.md
    • 2024-06-22 - Vector recall vs precision.md

  the closest hit is your December note on RAG failure modes. let
  me see what it's connected to.

  → get_neighborhood(path="2025-12-03 - RAG failure modes.md",
                     depth=1)
    8 connected notes. notable ones:
    • "Hybrid search" — a re-ranking design you sketched but
      didn't ship
    • "Out-of-distribution queries" — a half-finished draft from
      October
    • "Embedding model choice" — links to bge-m3, your current
      model

  you have three connected pieces here: a failure-modes catalog,
  an unshipped hybrid-search sketch, and an abandoned O-O-D draft.
  want me to summarize all three together, or pull up the draft
  so you can decide whether to finish it?

you  > pull up the draft, and tag it #revisit-2026 in frontmatter
       while you're there

claude
  → read_note(path="2025-10-18 - OOD queries (draft).md")
  → set_frontmatter(
      path="2025-10-18 - OOD queries (draft).md",
      updates={"tags": ["draft", "rag", "revisit-2026"]}
    )

  here's the draft, and the tag is on. you stopped right before
  the section on confidence thresholds; the open question you
  left yourself was…
有两点值得注意。第一,Agent 不需要别人告诉它该查看哪个文件夹或使用哪些工具——它自己就做出了选择。第二,最后的写入是结构化的(由 set_frontmatter 修改 YAML,而不是对文件正文执行正则表达式),因此笔记可以干净地往返处理。自描述式知识库和 wikilink 图谱让这一过程显得自然而然。
一场远离键盘的会话
上面的对话记录是简单的情况:我坐在桌前,能看到 Agent 在做什么,而且只需按一下 Alt-Tab 就能切换到 Obsidian。真正改变我对这个服务的看法的那次会话,完全不是这样。
我出去散步,耳朵里听着健康类播客——一期很长的节目,有两个人显然意见不合,足足听了一个小时。我带着手机,没打算回家打开笔记本电脑。于是我找到了这期节目的文字稿,交给手机上的 Claude,然后我们边走边聊:实际的论点是什么,我已经记下了哪些部分,它在哪些地方与我几个月前做出并记录下来的决定相悖。
整个过程中,Agent 始终可以访问知识库。它找出了我以前写过的相关内容,指出一则旧笔记中的两个日期有误,并问我,考虑到节目中的论点,我去年记录的一项决定是否仍然成立。我回来时,它已经把所有内容都写了进去:散步时我实际做出的健康相关决定、旧笔记中的日期更正、几则关于这期节目的新笔记,还有一则关于我最初如何决定该信任哪些医学问题专家的长期笔记,因为整个对话总是绕回这个话题。我一直会重读最后这则笔记。它根本不是关于这期节目的,而是关于一整类决策背后的推理;现在它就保存在知识库中,下一个 Agent 会找到它。
我从未打开 Obsidian。散步时没有,回家后也没有。整个会话——检索、论证、纠正,以及由此产生的写作——都是通过 Agent 完成的,而知识库只是最终内容落脚的地方。Obsidian 是我事后检查成果的方式,而不是完成工作的方式。这种倒转正是这个项目呈现出如今面貌的主要原因。
包含内容
该服务提供 28 个 MCP 工具,分为五大类,此外还包含围绕这些工具构建的认证和运维层。
每个工具都带有 title 和 MCP ToolAnnotations,并且明确设置了全部四项提示:仅负责读取的 18 个工具(搜索、读取、列出、图谱、list_tasks、get_changes、check_upload)设置了 readOnlyHint;可能替换或删除内容的 8 个工具(edit_note、move_note、delete_note、set_frontmatter、write_file、delete_file、import_from_url 和 request_upload,后者生成的链接在兑换时可能覆盖内容)设置了 destructiveHint;只有 import_from_url 设置了 openWorldHint。create_note 和 request_download 只会添加内容。遵循注解的客户端无需每次调用都确认即可运行只读工具(Claude Code 也会并行运行这些工具),而对破坏性工具则会持续提示确认。这些只是提示:无论客户端如何处理,服务本身都会强制执行只读凭据。initialize 的结果还附带一段简短的 instructions,说明知识库是什么、应使用哪个工具,以及写入安全规则,供在会话开始时只加载工具名称的客户端使用。传输中的任何描述都不会超过 4,000 个字符,因此不会被客户端的描述长度限制截断。
搜索与发现
keyword_search(query, folder?, tags?, frontmatter?, limit=20), 通过 PostgreSQLtsvector进行全文搜索。笔记标题和 frontmatteraliases的排名高于正文,因此查询词若是笔记标题,该笔记会排在最前; 独立词语按 AND 组合;当完全匹配的结果不足以填满页面时,会接着显示 标记为match: any的部分匹配结果;每行都带有snippet:,并高亮 匹配内容(标题匹配时则显示head:,即笔记开头的词语)。文本搜索配置 可通过FTS_CONFIGS配置(参见 全文搜索语言)semantic_search(query, folder?, tags?, frontmatter?, limit=15), 通过 pgvector 进行向量相似度搜索,每篇笔记显示一个单行预览片段。 笔记按标题分块,每个块在Title > Heading > Subheading上下文前缀下 生成嵌入。新鲜的行会标明匹配的章节:§ "Plan/Risks" (#7)或§ (top of note),而read_note(path, section="#7")会读取该章节的 全部内容。过期行以及升级到标题感知分块后尚未重新生成嵌入的行,不带 定位信息。只要仍有笔记使用旧分块方式,每个响应都会在标题下方的index_transition:行中说明hybrid_search(query, limit=10, folder?, tags?, frontmatter?),融合以上 两种搜索,在每个搜索分支的前 50 条结果上使用倒数排名融合,每篇笔记 显示一行,其中包含融合分数、各分支的排名以及分数背后的1/(k+rank)项。这三个工具地位相同,每个说明都带有相同的路由提示:精确标识符、 代码符号、标题或已知短语使用keyword_search;概念性或改述的问题使用semantic_search;不确定时使用hybrid_search。对于各自擅长的查询, 单个搜索分支可能胜过融合结果。如果嵌入提供方不可用,hybrid_search会返回标记为arms: keyword-only (semantic unavailable: …)的关键词 排名结果,而不会悄然降级:该标记会出现在每条返回路径中,因此仅含关键 词的结果页不会被误认为融合结果。list_notes(folder?, limit=50, since?, until?, order_by?, cursor?), 按修改时间排序get_recent(folder?, limit=20, since?, until?, order_by?, cursor?), 返回近期更改的内容,并以 UTC 显示每项的修改时间 (YYYY-MM-DD HH:MM UTC)。对于这两个工具,使用order_by="content_changed"和since时,会列出内容已更改的笔记 (仅更新时间或重新同步但字节内容不变不算);since包含边界,until不包含边界,两者都可以是 UTC 日期(YYYY-MM-DD,表示整天) 或带明确时区偏移的 ISO 8601 日期时间。使用这四个参数中的任意一个时, 都会切换为键集分页,并在页脚显示more: cursor=…;不使用这些参数的 调用保持不变get_changes(since, folder?, kinds?, by="any", limit=50),变更动态: 按时间从早到晚,每行显示游标之后新建、修改、移动或删除的一篇笔记, 并标明执行操作的 API 密钥或 OAuth 客户端(使用你自己的凭据时显示(you)),或者标明索引发现的编辑来源human/sync(Obsidian、同步 客户端、git)。它会返回next_since,这是一个精确的ev:<n>游标, Agent 会将其保存在自己的笔记中,以供下一次会话使用;by可取值为any | me | agents | human。删除记录会说明原因(removed、not_indexable、quarantined);gap和reset行会说明视图何时 不完整get_tags(limit=50),返回标签及其计数list_tasks(folder?, status="open", due_by?, scheduled_by?, tags?, limit=100, cursor?), 从索引中列出整个库内的复选框任务(- [ ]、- [x]、- [-]、- [/]、……),不读取笔记:每行显示一个任务及其路径和行号、 Tasks 插件日期(📅 ⏳ 🛫 ✅)、优先级、任务自身的#tags、标题路径 和文本。按截止日期排序(无日期的排在最后),并使用next游标分页;due_by/scheduled_by表示“不晚于”。不会解析 Tasks 插件查询块。 标题始终会统计尚未扫描任务的笔记数,以及任务未能编入索引的笔记数, 因此空列表绝不意味着“没有待办任务”而不作提示get_vault_guide(),实时提供 Obsidian 入门指南以及此库的CLAUDE.md- 使用
make search-eval,根据从操作者自身使用日志中挖掘的判断结果 (搜索后读取其中一条结果)来衡量检索变更;参见 搜索评估工具
读取和写入
read_note(path, section?, offset=0, limit?)返回结构化结果 — 包含path、title、tags、frontmatter_yaml和 JSON 格式的frontmatter视图、heading(读取章节时)、content,以及作为数据提供的截断信息(truncated、offset、next_offset、total_chars、outline、notice)。受MAX_READ_RESPONSE_CHARS限制(默认值为 40,000)——参见响应大小限制。section=<heading>返回单个章节的正文,而非整篇笔记;offset用于继续读取被截断的内容。create_note(path, content),以原子方式写入,拒绝覆盖edit_note(path, …)支持四种互斥模式:完整替换(默认)、append=True、find=…(可选replace_all),或section=<heading>(ATX 标题,支持Parent/Child路径形式和#N序号消歧)。dry_run=True返回统一差异,不执行写入。旧版客户端可使用operation="append";operation="replace"可明确选择完整替换。move_note(from_path, to_path, rewrite_links=False),移动笔记,并可选择重写源笔记中指向该笔记的[[Old]]、[[Old|alias]]、[[Old#anchor]]、![[Old]]和[[folder/Old]]引用delete_note(path, permanent=False),默认软删除至.trash/<YYYYMMDD-HHMMSS>-<basename>-<8 hex>,通过单次不覆盖的重命名完成,因此不会覆盖现有的回收站条目(如果文件系统不支持此类重命名,软删除会以明确指出错误的方式拒绝操作,而不会改用其他方式)。permanent=True会解除文件链接。set_frontmatter(path, updates, remove?),以结构化方式修改 YAML。仅修改 frontmatter 时,正文保持字节完全一致。
文件访问(非 Markdown)
对任意 vault 文件(PDF、图片、技能资源、数据文件)进行原始读取、写入和浏览——与笔记工具相互独立,后者仍仅支持 Markdown。纯字节传输:服务端不会提取 PDF/文本,不会对非 Markdown 文件进行嵌入或索引。
read_file(path, encoding="auto", offset=0, limit?),文本类文件以文本形式返回,图片以客户端可渲染的内嵌图片块形式返回,其他二进制文件则以 base64 字符串返回。text/base64可强制指定形式。拒绝读取超过MAX_FILE_READ_BYTES(默认 10 MB)的文件;文本结果还受MAX_READ_RESPONSE_CHARS限制,并可通过offset继续读取。hash_only=True仅返回整个文件的content_hash,不返回内容;base64 结果会在标头中包含该哈希。文本结果保持纯文本。write_file(path, content, encoding="base64", overwrite=False),将文件写入 vault;二进制文件使用 base64,UTF-8 文件使用text。默认不覆盖,自动创建父目录,并以原子方式写入。大小上限为MAX_FILE_WRITE_BYTES(默认 25 MB)。list_files(folder=".", pattern="*", recursive=False, limit=200),以类似ls的方式浏览文件和子目录,并显示大小和修改时间;支持 glob 过滤并限制结果数量。delete_file(path, permanent=False),通过单次原子重命名将非 Markdown 文件软删除至.trash/<YYYYMMDD-HHMMSS>-<basename>-<8 hex>。拒绝处理 Markdown 文件(应使用delete_note)、目录和符号链接。
以上四种工具都会使用路径遍历防护,并排除路径中包含以 . 开头的组成部分的所有路径(点目录和点文件),例如 .obsidian、.git、.trash 等,与索引器的可见性规则一致。
防止基于过期读取进行编辑
编辑、更新 frontmatter、移动或删除笔记、覆盖原始文件或删除原始文件时,将读取结果的 content_hash 作为 expected_hash 传入。规范令牌的格式为 sha256:<64 位小写十六进制>,基于完整原始文件字节计算;即使读取的是某个分区或截断后的 read_note,返回的仍是整个文件的哈希值。对于原始文件,请使用 read_file(hash_only=True) 或 Base64 标头。请勿自行对返回的文本进行哈希计算。
令牌过期时,操作会在变更前被拒绝,并以最终一行 MCP-REFUSAL JSON 指明 stale_precondition 和当前哈希值。请重新读取并重新考虑编辑内容后再试。移动操作仅绑定源笔记;移动和删除操作通过预检比较后,仍允许就地编辑。覆盖操作会保留单独的调用内字节检查。成功发布的操作在可用时会报告新哈希值。
默认情况下,此参数为可选参数。WRITE_PRECONDITION_REQUIRED=true 会要求受支持的破坏性调用提供该参数;只有在客户端会提供令牌后才启用此设置。创建操作不受此要求限制,若传入令牌则会以 no_incumbent 拒绝。超过读取上限的文件无法使用此机制进行保护。
文件传输
没有 MCP 客户端能将用户正在查看的文件字节交给工具,因此只有在 Agent 已有文件内容时才能使用 write_file。这些工具通过短时有效的能力链接填补这一缺口,并通过公开的 /transfer/* 路由进行兑换。
request_upload(path, overwrite=False, expires_in?),生成一个仅绑定到指定目标路径的一次性链接。用户打开链接并选择文件,文件便会保存到path,无法通过该链接写入其他位置。check_upload(upload_id),返回pending/uploading/completed(包含路径、大小、sha256 和 MIME)/unknown(流已开始,但服务器未记录其结束方式——重新生成链接前请先读取该路径)/revoked(链接对应的凭据或保管库根目录已发生变化)/expired,且结果仅限生成该链接的身份查看。request_download(path, expires_in?),生成一个链接,供用户保存保管库中的一个文件。在过期前可多次使用,并绑定到生成时文件的确切字节内容。import_from_url(url, path, overwrite=False),按照明确的出站拒绝策略,将公开的 https 资源直接获取到保管库中(无论地址采用何种表示形式,均禁止私有、环回、链路本地、元数据或隧道地址;每次重定向时都会重新检查)。
令牌位于 URL 片段中,浏览器不会发送片段,因此任何服务器生成的请求目标或访问日志中都不会包含该令牌。上传会在读取任何正文字节之前被接收,并通过禁止覆盖语义原子发布;上传在生成时会绑定到其对应的文件状态——如果文件在等待期间被编辑,链接不会悄然撤销该编辑。必须设置 MCP_HOSTNAME 或 BASE_URL;若没有公开来源地址,生成链接的工具会拒绝操作,而不会生成 localhost 链接。
Wikilink 图谱
get_backlinks(path, limit=50),链接到path的笔记get_links(path),出站链接,包括已解析和未解析的链接get_neighborhood(path, depth=1, limit=50),在已解析链接图谱上执行无向 BFS,深度上限为 ≤ 5,数量上限为 ≤ 200find_related(path, limit=10),通过平均分块嵌入和 pgvector 余弦距离查找语义邻居,按笔记去重,并包含与semantic_search相同的分区定位符和index_transition:行find_orphans(folder?, limit=50),没有任何入向或出向已解析链接的笔记
身份验证与运维
- API 密钥以
omcp_为前缀,以 SHA-256 哈希形式存储,并具有read和readwrite权限范围。只读密钥无法调用写入工具。 - 面向公开客户端和机密客户端的 OAuth 2.0 PKCE(S256)流程, 包括 ChatGPT、Claude Desktop 和 claude.ai。动态注册默认授予两种 vault 权限级别;用户在授权同意页面选择实际授予的权限。
- 控制面板(Jinja2、手写 CSS、随附的 Chart.js、基于 nonce 的 CSP),用于管理密钥、使用日志、 索引器状态、嵌入提供方信息,以及危险区域重置。
- 每次工具调用都会记录到
usage_logs,包含名称、参数 (截断至 200 个字符)、耗时、响应大小和调用凭据的名称——在调用时 记录,因此即使删除了日志所描述的密钥或 OAuth 客户端,审计记录也会 保留。 /health无需身份验证,返回status和两个能力 字段:transfer_mount_check_available(内核是否支持传输写入所需的 挂载检查)以及vault_named_staging_fallback_active(此进程是否已实际以名称暂存过一次写入)。/health还包含一个indexer对象(status、task_running、failing_scopes、embedding_failing_scopes、max_consecutive_failures、quarantined_notes、last_success_at),当索引器任务 已终止,任何索引、嵌入或枚举失败计数器达到INDEXER_DEGRADED_AFTER_FAILURES,某个范围连续出现不完整的重新派生,或某条笔记被隔离时,顶层status会变为"degraded"。HTTP 状态码仍为 200——重启无法修复 vault 内容或提供方中断,而且 Kubernetes 使用/health检查存活状态——因此请监控status字段(使用关键词检查或 JSON 检查"status":"ok"),而非状态 码。仅提供计数:不含路径、错误文本或用户 ID。
所有写入——笔记工具、write_file、上传和导入——都会将新字节暂存到临时 inode 中,执行 fsync 后才发布。创建时通过内核原子硬链接发布,且不会覆盖现有文件;move_note 和软删除通过单次不可替换的重命名发布;覆盖则是在同一目录中重命名至目标位置。之后会对目标目录(以及调用时创建的任何目录)执行 fsync,因此写入期间即使发生崩溃,也不会截断笔记或丢失服务器已报告写入的笔记。
只要文件系统支持,暂存就会在未命名的 inode 中进行,因此 vault 中不会出现临时名称。若挂载点不支持此方式(某些 NFS 导出就是如此),这些写入会拒绝执行,并报错指出 VAULT_ALLOW_NAMED_STAGING_FALLBACK;设置该标志后,两种写入路径都会改用具名暂存,并明确采用较弱的保证。请参阅系统要求。
与其他 Obsidian MCP 服务的比较
自本 README 首次编写以来,这一领域已分化为两类,关键区别并非“轻量还是重量级”,而是 Agent 相对于 Obsidian 应用运行的位置。
桌面本地型。 工具与正在运行的 Obsidian 通信。Local
REST API 插件 自 4.0.0(2026-05-15)起就内置了
Streamable HTTP MCP 服务,5.5.0(2026-10-17)又加入了 If-Match
条件写入和结果上限,因此它已不再只是“胶水”,而是真正的本地 MCP
端点。官方的 Obsidian CLI(1.12)可以读取、写入、搜索和遍历反向链接,并且要求应用正在运行。应用内的 Agent 插件也属于同一类。这些工具都能免费使用应用自身的元数据缓存;它们都无法在无头环境中运行,也都无法让 claude.ai 或手机接入,除非你将桌面暴露出去。
无头和远程型。 服务直接处理保管库文件,无论文件挂载在哪里,都不需要运行 Obsidian 进程。本服务属于这一类。Vault Cortex(aliasunder,2026 年 9 月)是一个单容器方案,包含 OAuth 2.1、由 RRF 融合的 SQLite FTS5 和 sqlite-vec、本地重排序器、任务和每日笔记辅助工具,以及捆绑的 Obsidian Headless Sync 客户端;每个容器只能使用一个保管库,不支持多用户。StevenStavrakis/obsidian-mcp v2(2026-08)是一个 stdio 服务,支持带日志记录的原子写入、etag/if_match 前置条件和 30 天恢复快照,但不支持语义搜索。jacksteamdev/obsidian-mcp-tools 已于 2026-05-13 归档,因此不再列入表格。
如果 Agent 运行的机器上已打开 Obsidian,且你不需要远程访问,那么官方 CLI 或 REST 插件是更轻量的选择。本服务适用于无头、远程、多客户端和语义搜索场景:机器上只需运行一个容器和 Postgres,你拥有的所有客户端都能访问同一个保管库。
截至 2026-10-28:
| 本服务 | REST 插件 MCP | Obsidian CLI | Vault Cortex | StevenStavrakis v2 | |
|---|---|---|---|---|---|
| 无需 Obsidian 即可运行 | ✅ | — | — | ✅ | ✅ |
| 语义搜索 | ✅ pgvector | — | — | ✅ sqlite-vec + RRF + 重排序器 | — |
| Wikilink 图谱 | ✅ 反向链接、邻近节点、孤立笔记、相关笔记 | 反向链接 | 反向链接、孤立笔记、死胡同 | 反向链接、出站链接、孤立笔记 | — |
| 原子/带日志记录的写入 | ✅ 暂存、fsync、防覆盖发布 | ? | ? | ✅ 临时文件 + 重命名 | ✅ 带日志记录、回滚、快照 |
| 写入前置条件(哈希/etag) | ✅ expected_hash | ✅ If-Match(5.5.0) | — | — | ✅ if_match |
| 试运行差异 | ✅ | — | — | — | — |
| 软删除到回收站 | ✅ .trash/ | ? | ✅ | ✅ | ✅ 30 天快照 |
| 多用户保管库根目录 | ✅ | — | — | — | —(多保管库,单用户) |
| 面向 claude.ai / ChatGPT 的 OAuth | ✅ 2.0 PKCE + API 密钥 | —(API 密钥) | 不适用 | ✅ 2.1 PKCE + DCR | 不适用(stdio) |
| 审计日志 | ✅ 每次调用,显示在面板中 | ? | — | 服务日志 | 事务日志 |
| 配置成本 | Postgres + Docker | Obsidian + 插件 | Obsidian 1.12 | 单个容器(远程镜像需 Sync 订阅) | Node 22 |
该表根据各项目在该日期记录的功能编制,信息来自其 README 和发行说明;? 表示我无法确认是否支持。决定采用前,请核实具体情况。
与托管式记忆系统的比较
如今,我的大多数知识库流量都来自 Agent,而不是我自己,因此更重要的比较对象是作为服务的记忆:Agent 调用 API,服务存储收到的内容,并在之后返回它认为相关的内容。人们通常会想到 mem0、Zep 和 Letta。下文讨论的是这种架构——位于服务边界之后的记忆——而非任何单一产品当前的功能列表;后者的变化速度比 README 的更新速度快。
自这段话最初成立以来,有一件事已经改变:文件加搜索如今已成为主流基础,而非异类。Letta 的 MemFS 使用 Git 支持的 Markdown;Claude Code 的自动记忆使用一个 MEMORY.md 索引加主题文件;Anthropic 的记忆工具使用文件目录;OpenClaw 和 Hermes 使用 Markdown 工作区。单凭“可读的 Markdown 记忆”已无法让这个服务脱颖而出。最接近的可比对象是 Basic Memory(Markdown 加 SQLite 或 Postgres 索引、混合搜索、可选的重排器、结构化 frontmatter 筛选;使用自有文件夹和笔记格式,采用 AGPL,另有付费云服务)以及 doobidoo/mcp-memory-service(可自托管、通过 OAuth 提供远程 MCP、使用不透明的记忆记录而非文件)。与它们相比,差异有五点,而且很明确:
- 直接提供现有知识库,不强加文件夹或笔记格式。
- 通过 OAuth 支持远程和多用户,每位用户对应一个知识库根目录。
- 防止破坏性写入:
expected_hash、原子化且禁止覆盖的发布、.trash/、试运行差异。 - MIT。
- 没有托管版,也没有推出计划。
与记忆即服务的区别,在于记忆存放在哪里,以及谁能打开它。
- 可读性。 当记忆位于服务 API 之后时,读取它就意味着使用服务提供的端点或控制台,并接受其存储格式。这里,记忆本身就是产物:
Health/2026-08 - Trusting expertise.md,位于文件夹中,可在编辑器和grep中查看。Agent 存储的内容与你能查看的内容之间没有隔阂。 - 与你及 Agent 之间共享。 记忆服务通常面向某个应用及其用户;人类自己的写作则属于另一个系统。这里,所有内容都属于同一个语料库。我可以手动写入其中,每个已连接的客户端——Claude Desktop、Claude Code、手机上的 Claude、n8n 工作流——都按照相同规则读写同一批文件。我在星期日输入的笔记,无需导入,就能成为 Agent 在星期一的上下文。
- 可移植性。 从 Markdown 文件夹迁出的操作就是
cp -r。没有导出格式,没有迁移脚本,也不必担心项目停止维护后自己还能拿到什么。这是文件的特性,并非这个服务提供的功能。 - 自描述。 规则保存在语料库中,而非客户端配置里。知识库根目录下的
CLAUDE.md会在每个 Agent 首次调用时告知内容的存放位置及其 frontmatter 格式,因此约定与其约束的笔记一同纳入版本管理。
相较之下,托管式方案带来的优势确实存在,也值得坦率说明。你无需运行 Postgres,无需保持 pgvector 版本为最新,也无需照看容器——只需添加一个依赖,就能获得记忆层,这对大多数人来说确实是更好的取舍。而这一类系统通常还会完成这个服务有意不尝试的工作:自动从对话中提取事实、协调相互矛盾的事实,并为相关性评分或让旧记忆逐渐淡出,从而避免它们挤占新记忆的位置。在这里,只有当 Agent 决定写下一条笔记时,它才会记住某件事;判断什么值得保留的是 Agent,而不是服务。这里计划提供的整理辅助功能,是生成一份提议报告,绝不写入内容(#359)。如果你想要能自我整理的记忆,那么选择另一种方案是完全合理的。
与具有原始文件访问权限的 Agent 相比
另一种基准方案根本不是 MCP 服务:让 Claude Code、通用文件系统 MCP,或任何具有文件工具的 Agent 直接访问保险库文件夹。这确实可行——直到写入出错。Agent 根据先前读取时的记忆重写整个文件,迟早会覆盖某条笔记、跟随不该跟随的符号链接,或“整理”你的 .obsidian 配置。原始文件 API 不会对此做任何限制。这个服务的写入流程正是针对这类事故设计的,并且假定调用方最终会做错事:
- 定向编辑,而非重写。
edit_note可以定位某个查找字符串或单个章节,而不是替换整个文件;dry_run=True会在实际写入前返回统一差异。set_frontmatter会以结构化方式修改 YAML,并让正文保持字节级不变。 - 默认不覆盖。
create_note和write_file会拒绝覆盖现有文件;替换文件必须显式选择启用。 - 原子写入。 内容会暂存,并通过验证时打开的文件描述符重命名到位——笔记不会留下半写入状态,且被替换的文件就是经过检查的那个文件。
- 可撤销删除。
delete_note和delete_file会通过不可替换的重命名将文件软删除到.trash/;permanent=True是明确的例外选项,而非默认行为。 - 由内核验证的路径约束。 路径通过
openat2(RESOLVE_BENEATH | RESOLVE_NO_SYMLINKS | RESOLVE_NO_MAGICLINKS)解析,确保位于保险库根目录下;写入会拒绝以符号链接作为最终路径组件,且所有工具都无法访问点目录(.obsidian、.git、.trash)。 - 响应大小有上限。 读取内容有大小限制,截断会作为数据返回(
truncated、next_offset、大纲),而不是被静默丢弃,因此单篇超长笔记不会让 Agent 的上下文被塞满,进而导致错误编辑。 - 审计轨迹。 每次调用都会关联到一个密钥并记录日志;控制面板会显示谁在何时操作了什么。
Agent 通过此服务行为异常时,你会得到一次被拒绝的调用、一份差异、一条垃圾箱记录和一行使用日志。Agent 通过原始文件访问权限行为异常时,你能得到的只有 git diff 能恢复的内容——前提是保险库本来就在 git 中。
适用人群
- 已经运行 Postgres 和 Docker,或愿意启动它们的家庭实验室用户。语义层和图谱层的功能需要付出这份部署成本。
- 使用有明确规范的保险库的人——任务归类逻辑、frontmatter 架构、标签体系——并希望 Agent 第一次调用时就遵循这些约定,而不是每次会话都要先说明一遍。
- 使用多个 MCP 客户端(Claude Desktop、Claude Code、浏览器中的 Claude、n8n)访问同一批笔记,并厌倦了每次都向它们重新介绍保险库的人。
- 希望 Agent 的记忆以普通 Markdown 文件的形式保存,方便阅读、编辑、搜索和版本控制,而不是存放在不透明的向量存储或托管记忆服务中的人。
不适用人群
- “我只想让 Claude 读取我的笔记”,并且希望设置尽可能简单。请使用上文提到的桌面本地工具之一;你用不上这个服务。
- Agent 运行的机器上已经打开 Obsidian,且你不需要远程访问。官方 CLI 或 Local REST API 插件的 MCP 服务是更轻量的选择。
- 不愿意运行数据库的人。这里没有 SQLite 备用方案;pgvector 承担着实际工作,整个技术栈也需要支持 pgvector 的托管 Postgres。
- 想要开箱即用托管产品的人。这是一个需要自行运行的可自托管服务。
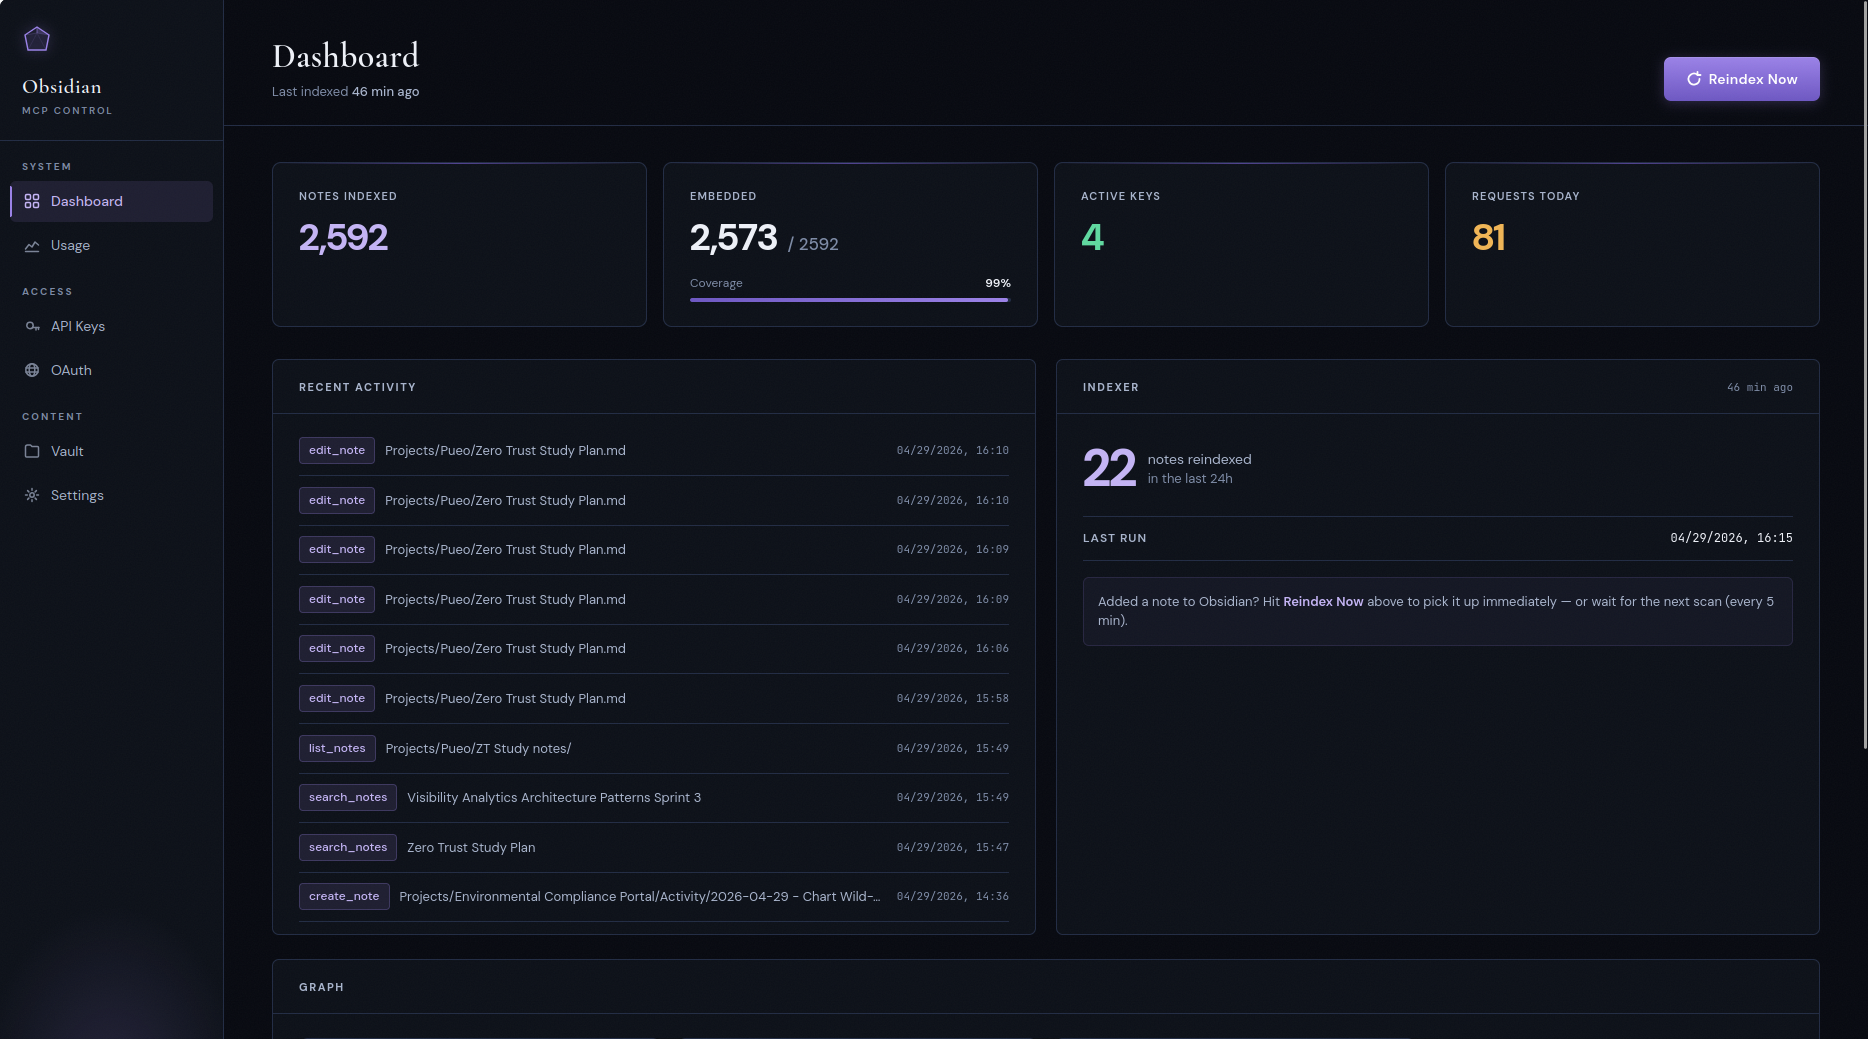
控制面板
该服务内置了管理 UI,便于查看那些通过查询不如直接查看方便的运维信息:创建密钥、监控索引器、查看工具调用流量,以及切换提供商时重置嵌入。
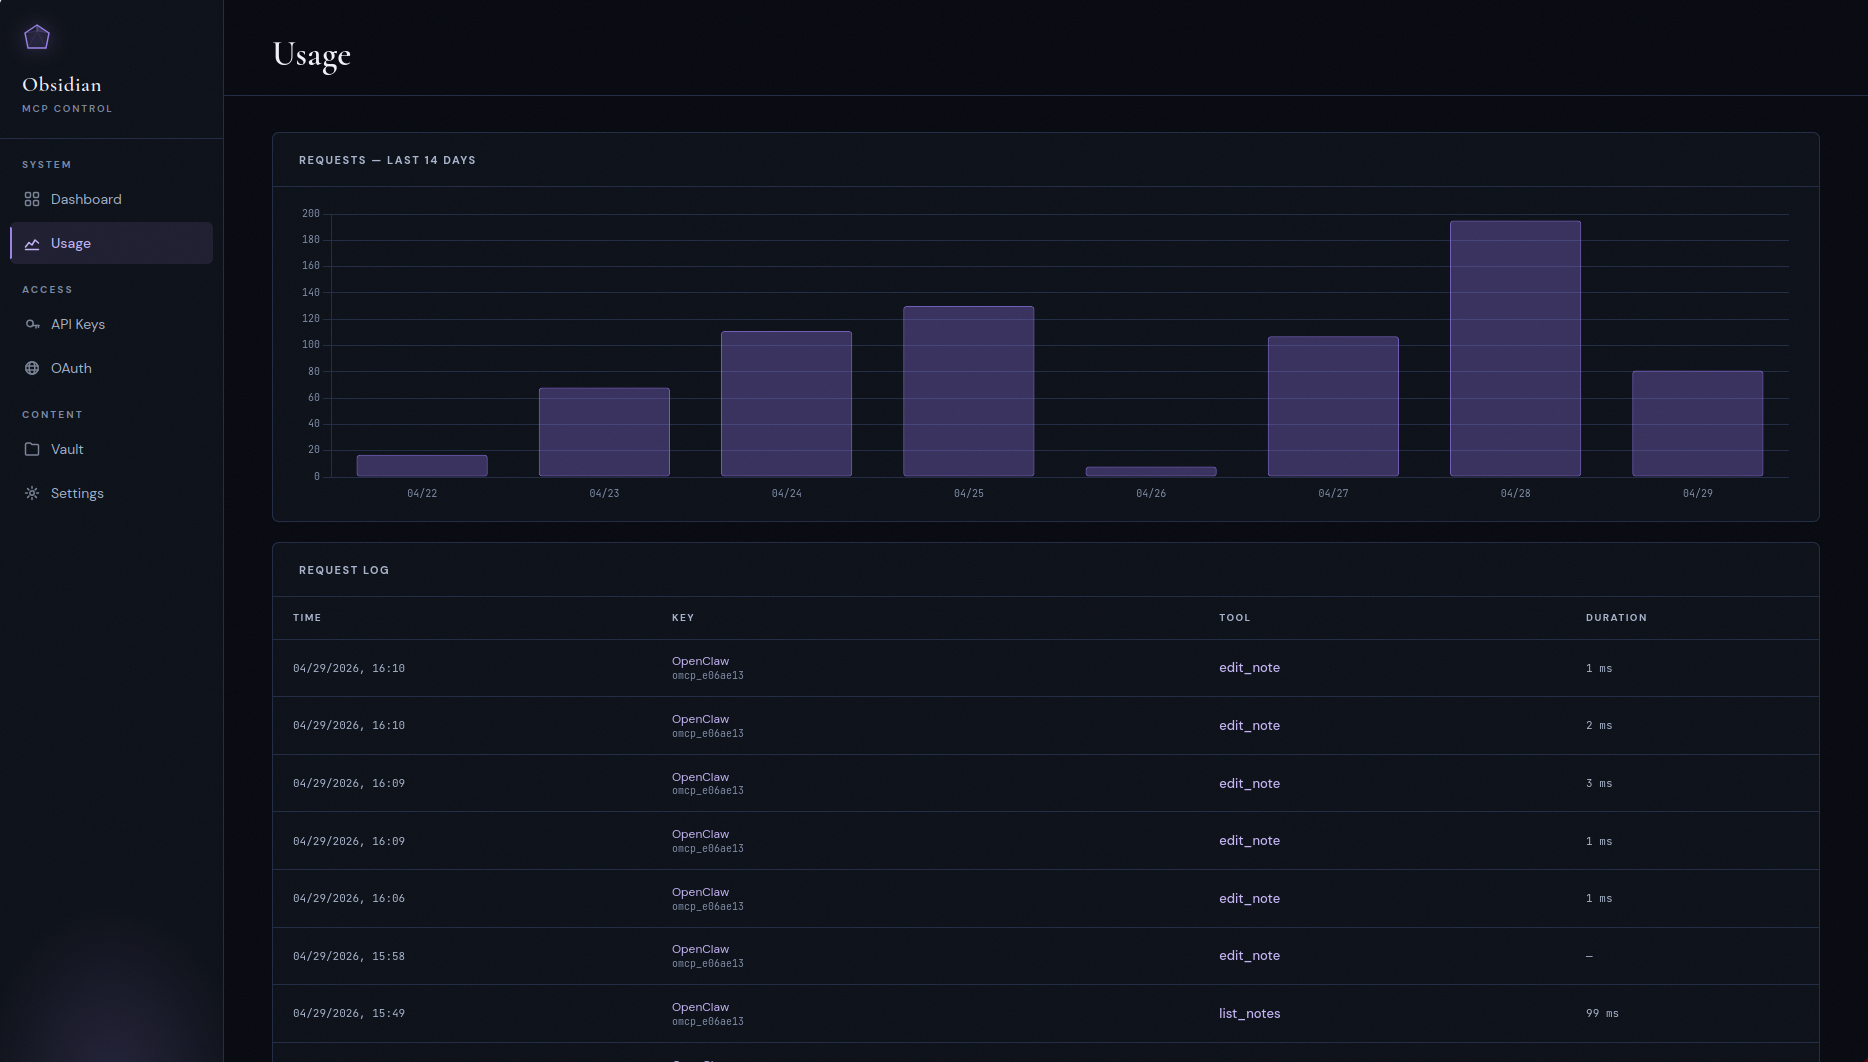
使用情况
按工具调用记录的审计日志,并提供 14 天请求直方图。每次 MCP 调用都会记录调用密钥、工具名称、耗时和响应大小,有助于发现行为异常的 Agent 是否在不该消耗令牌的地方浪费令牌。
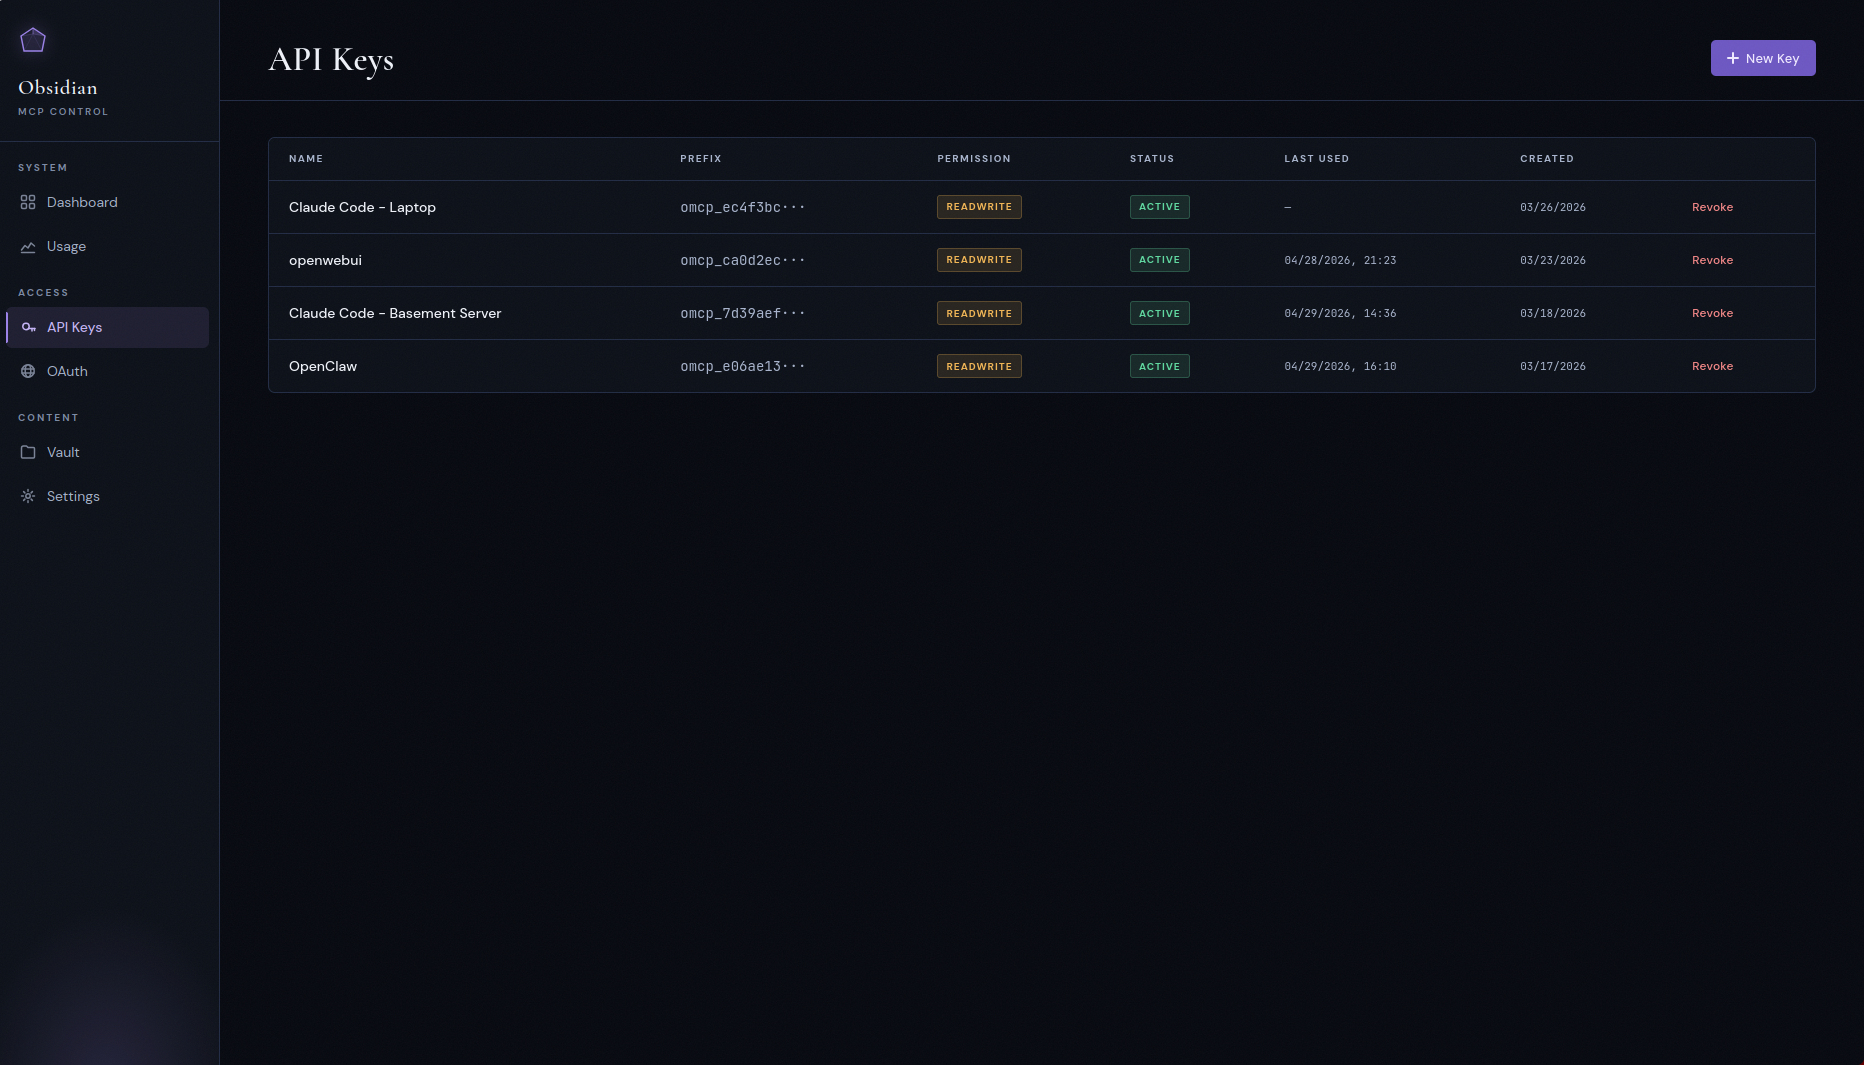
API 密钥和 OAuth 客户端
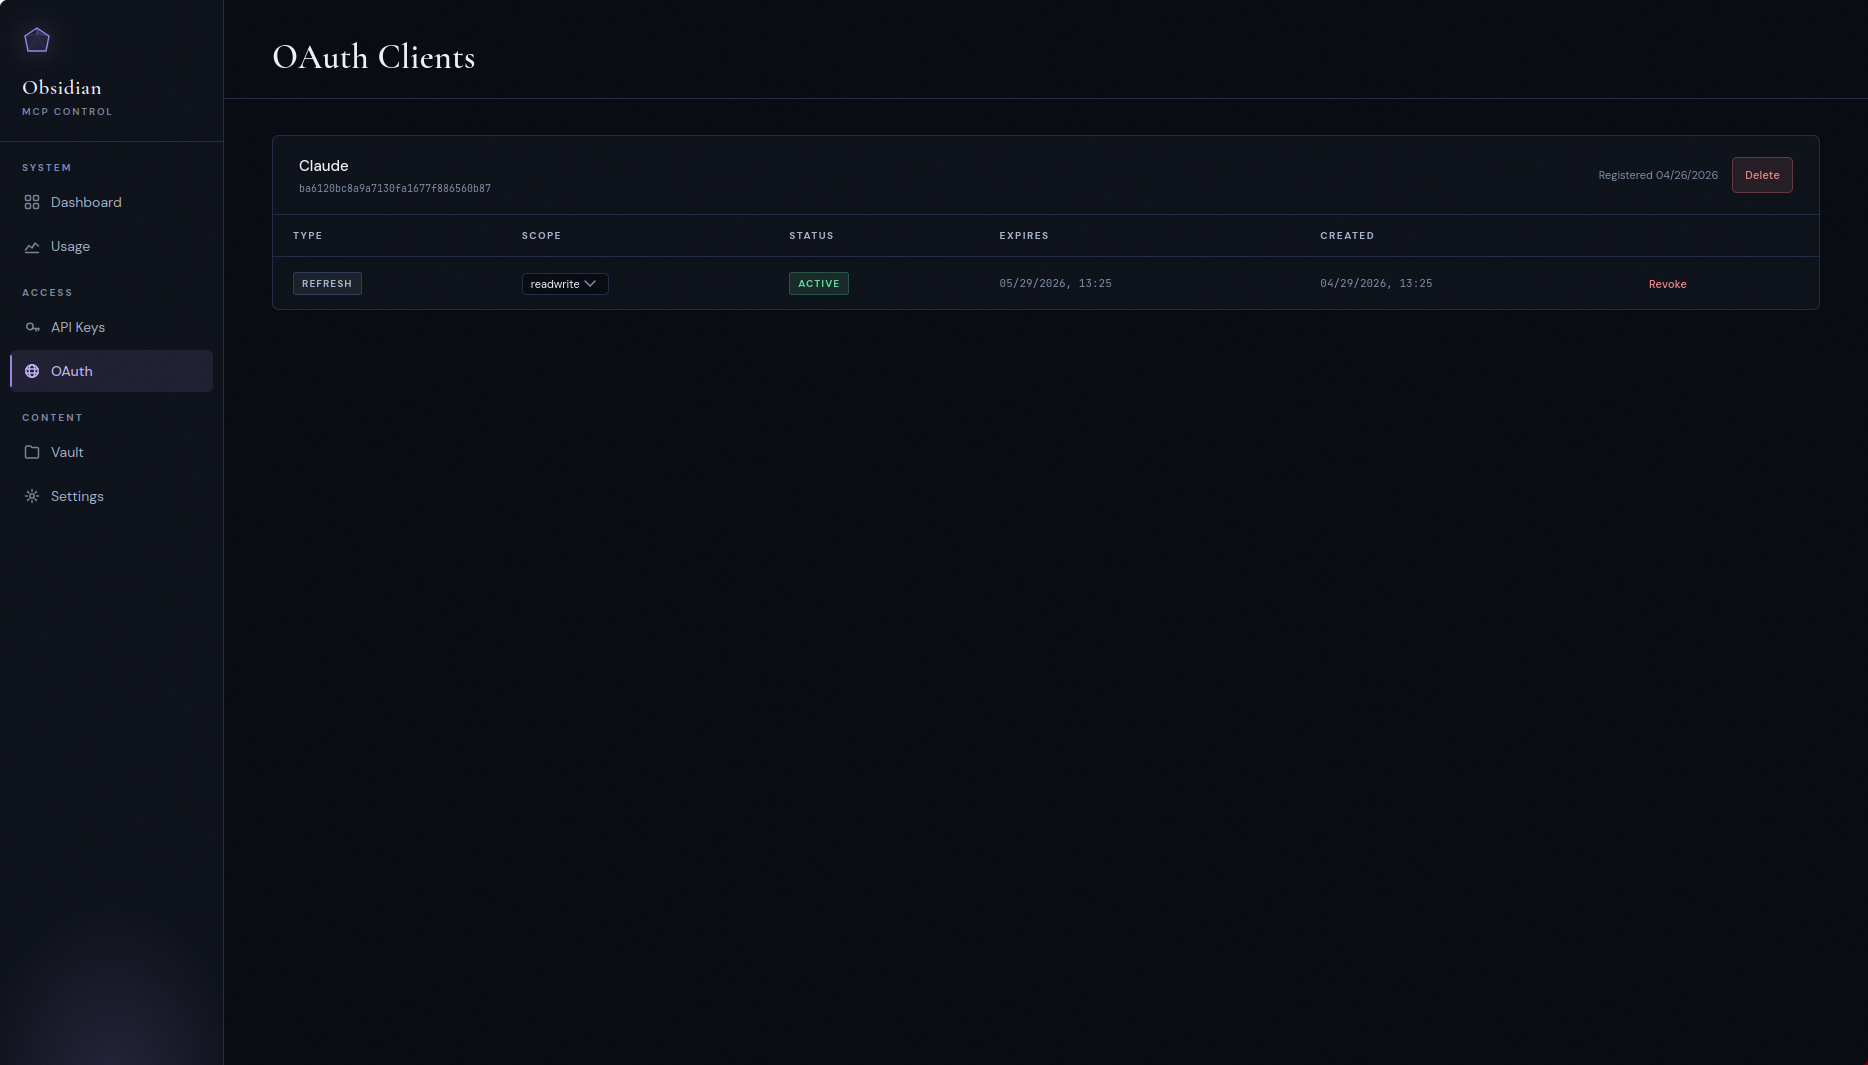
为 API 客户端提供带有 read / readwrite 范围的 Bearer 密钥;另外还为 ChatGPT、Claude Desktop 和 claude.ai 等需要标准授权码流程的客户端提供独立的 OAuth 2.0 PKCE 流程。OAuth 服务支持公共(none)和机密(client_secret_post)令牌端点身份验证,以及刷新令牌。
每个客户端的页面都会列出其授权记录——每次 /authorize 批准对应一行,而非每个令牌对应一行——并提供撤销控件和每条授权记录的权限选择器,这样撤销授权就能真正结束会话,而不是留下一个可用于生成替代令牌的刷新令牌。已撤销和已过期的记录会保留一周,并以变暗样式显示。
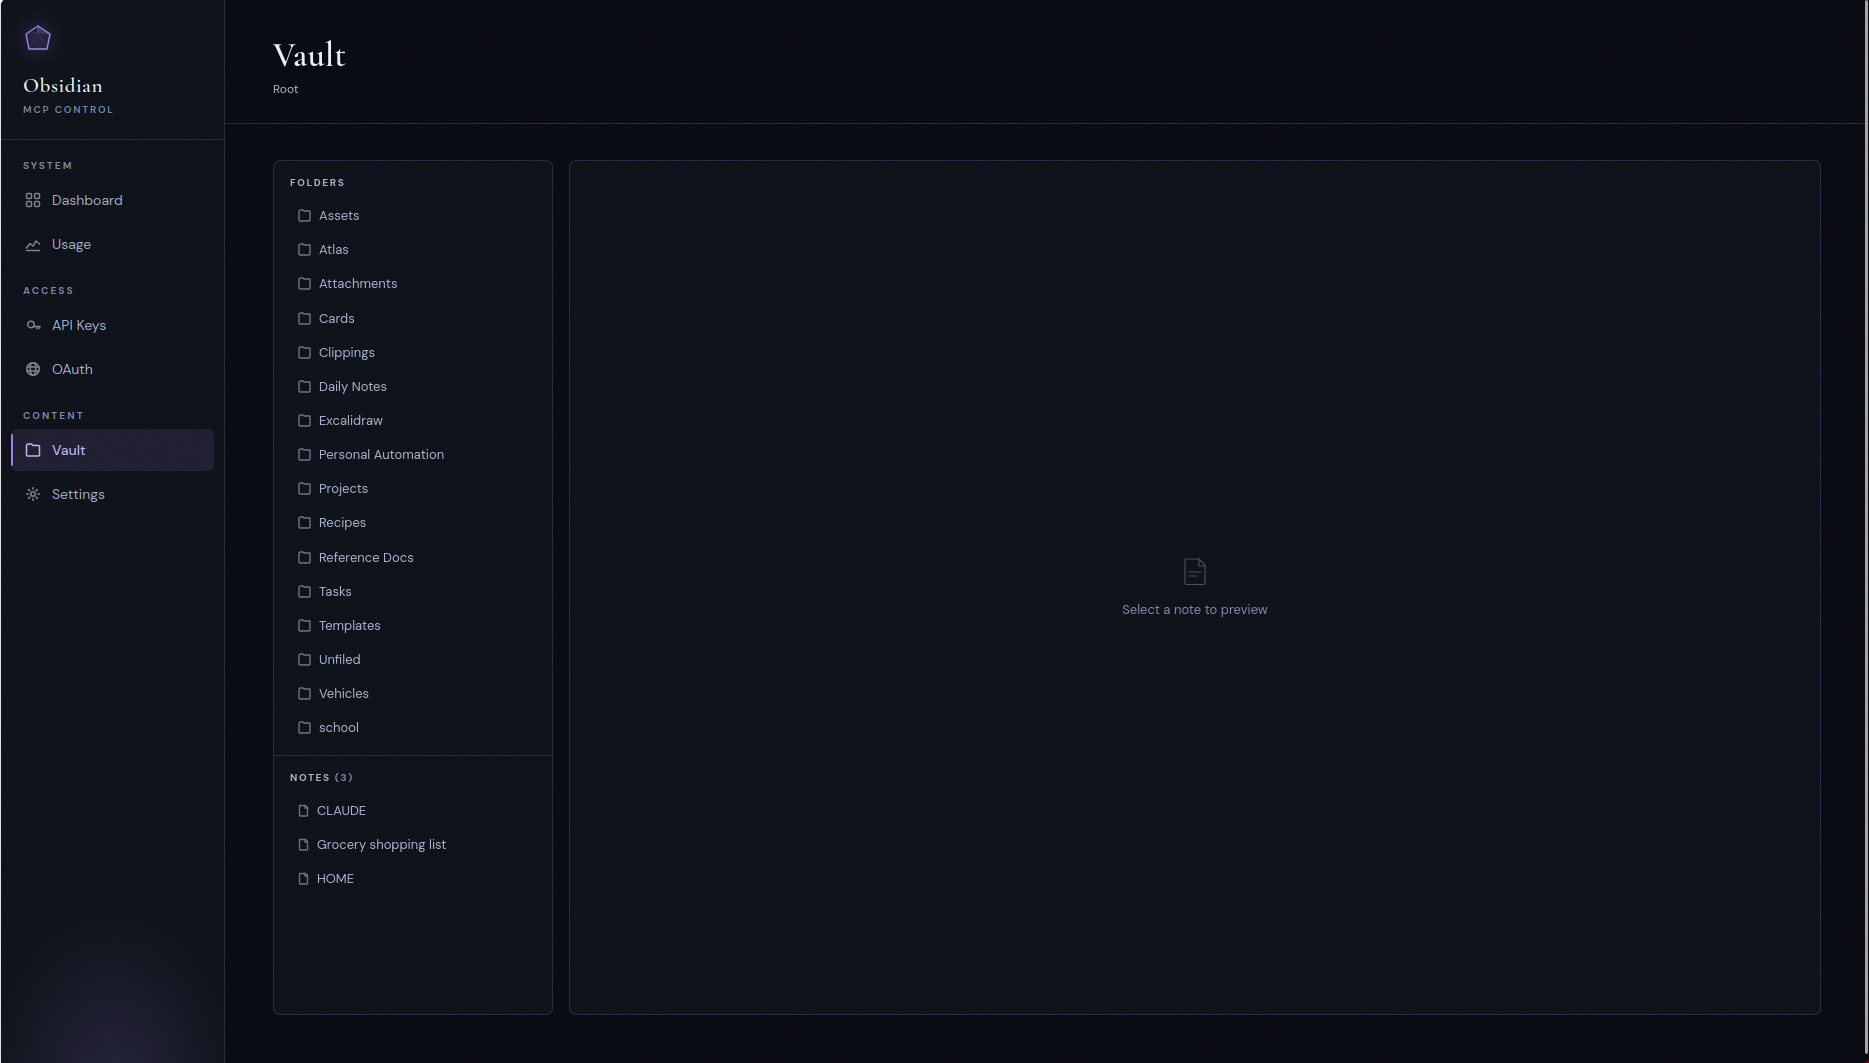
知识库浏览器
已挂载知识库的只读文件树,主要用于检查容器看到的内容是否符合预期。
设置
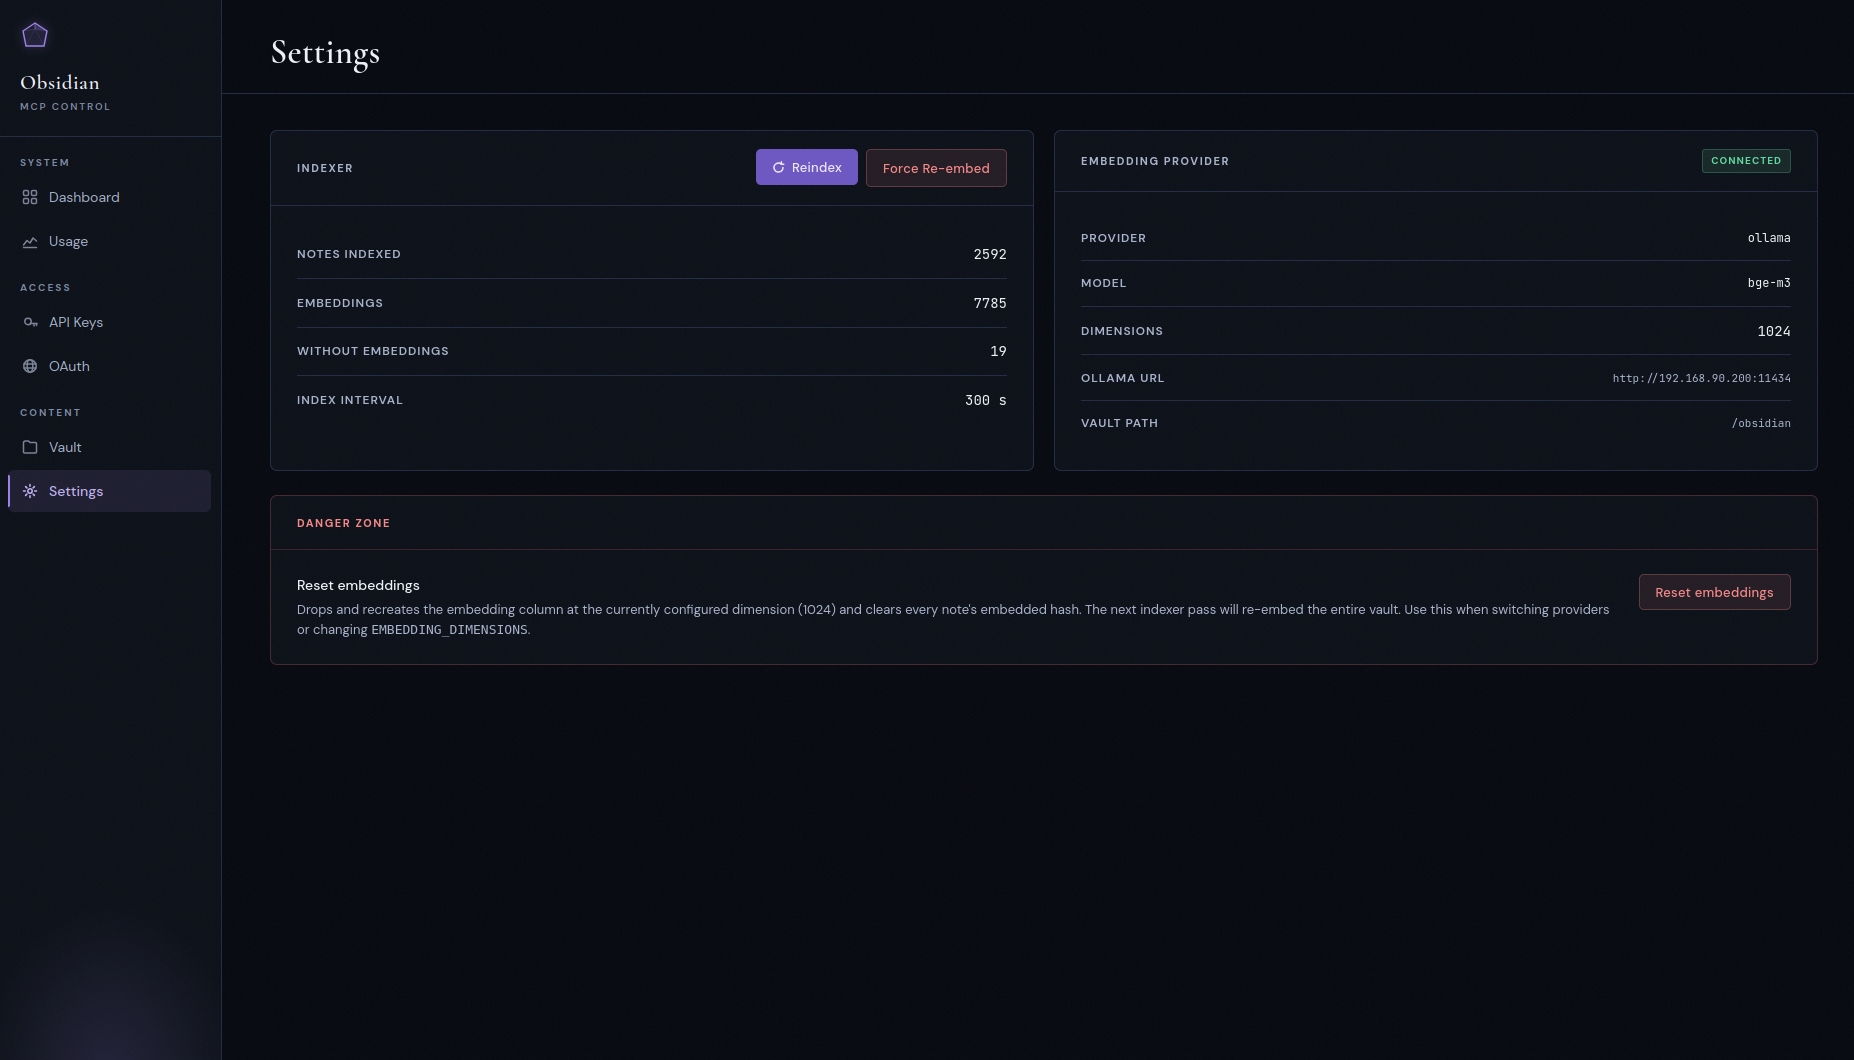
索引器状态、当前嵌入服务提供商和模型、知识库路径,以及危险区域:重置嵌入(删除并重新创建嵌入列,维度设为配置值——切换服务提供商时使用)和 强制重新嵌入(保留该列,清除每条笔记的嵌入内容哈希,让知识库在下次运行时重新嵌入)。这两项操作运行期间都会暂停索引器。
仪表板将过去容易混淆的两个项目分开:上次运行是索引器自身的心跳——上次完成的处理,即使没有任何内容发生变化;检测到上次更改是任意笔记中最新的 indexed_at。知识库没有变化时,第二项会显示较早的时间,但索引器依然运行正常。
快速开始
从头开始在 VPS 上部署?请参阅
DEPLOYMENT.md,了解完整的操作指南:Postgres 设置、Caddy 和 TLS、通过 Nextcloud 同步知识库,以及首次部署时容易踩到的坑。 使用 Kubernetes?请参阅docs/deployment-kubernetes.md和deploy/kubernetes/中的 kustomize 清单。
内置的 Caddy 配置会默认拒绝访问 /admin、/api 和 /authorize;启动前请替换其中的占位基本身份验证哈希值。
前提条件
- Docker 和 Docker Compose
- 一个容器可访问的 PostgreSQL 16 实例,且已安装
pgvector0.8.0 或更高版本 - 运行
bge-m3的 Ollama 实例,或 OpenAI API 密钥。 任何支持 OpenAI 嵌入协议的服务均可(Azure OpenAI、OpenRouter、Together 等)。 - Linux,内核版本为 5.6 或更高(见下文)
系统要求
服务器会在启动时检查这些要求,并告知哪项检查失败, 而不是等到之后运行异常。
Linux 内核 ≥ 5.6。 Vault 根目录下的每个目录都会通过一次
openat2(RESOLVE_BENEATH | RESOLVE_NO_SYMLINKS | RESOLVE_NO_MAGICLINKS) 打开。正是这一机制让内核(而非
应用程序)证明写入操作始终位于 Vault 内部。没有回退方案:如果内核版本较旧,或容器 seccomp 配置文件
阻止了 openat2,服务器会记录原因并以非零状态码退出。
文件传输需要内核 ≥ 5.8。 statx() 的 STATX_MNT_ID 可确保
发布操作拒绝目标目录与暂存目录位于不同挂载点的情况(否则,Vault 根目录下的嵌套绑定挂载可能要等整个上传内容传输完毕后才会报错)。低于 5.8 时,服务器会记录一条警告并启动:request_upload、
import_from_url 和 PUT /transfer/upload 会拒绝执行,其他所有功能
——读取、笔记写入、搜索、下载、面板、OAuth——均不受影响。/health 会以 transfer_mount_check_available 报告此状态。
pgvector ≥ 0.8.0。 带筛选条件的语义搜索需要
hnsw.iterative_scan,该功能在 0.8.0 中加入。较旧版本的扩展会将此设置作为未知占位项接受,并静默运行会丢弃后筛选候选项的查询计划——导致搜索结果悄然变差——因此服务器会直接退出。可通过 ALTER EXTENSION vector UPDATE 修复,或改用更新的数据库镜像。
文件系统。 必须区分大小写且不进行规范化(ext4、xfs 及常见的绑定挂载均符合要求)。文件系统必须支持在 Vault 根目录内创建硬链接,以及使用 renameat2(RENAME_NOREPLACE);不支持时,创建笔记、move_note 和软删除会以明确的错误拒绝执行,而不会退化为可能覆盖文件的发布操作。O_TMPFILE 是推荐功能,但并非必需:如果不可用,可设置 VAULT_ALLOW_NAMED_STAGING_FALLBACK=true 以接受使用具名暂存文件(参见配置)。macOS 和 Windows 主机不在支持范围内;请在 Linux VM 上运行容器。
1. 克隆、配置并指向你的 Vault
git clone https://github.com/maxkuminov/obsidian-mcp.git
cd obsidian-mcp
cp .env.example .env
$EDITOR .env
使用捆绑的服务栈(docker-compose.simple.yml 或
docker-compose.proxy.yml)?该服务栈运行的 PostgreSQL 使用两个身份:在 .env 中设置
OBSIDIAN_DB_PASSWORD(应用的非超级用户角色,compose 文件会据此构建 DATABASE_URL),并将
postgres.env.example 复制为 postgres.env,其中设置独立的
POSTGRES_PASSWORD(数据库超级用户密码,只有 postgres
容器能访问)。make init 会生成这两项。参见
DEPLOYMENT.md。
在 docker-compose.yml 中,将 /obsidian 卷指向你的 Vault:
volumes:
  - /path/to/your/vault:/obsidian
2. 选择嵌入后端
选项 A,OpenAI(无需本地基础设施):
EMBEDDING_PROVIDER=openai
OPENAI_API_KEY=sk-...
EMBEDDING_DIMENSIONS=1024
OPENAI_EMBEDDING_MODEL=text-embedding-3-small
服务器会在启动时验证 OPENAI_API_KEY,如果缺少该变量则拒绝启动。
选项 B,Ollama(可自托管,建议使用 GPU):
EMBEDDING_PROVIDER=ollama
OLLAMA_URL=http://your-ollama-host:11434
EMBEDDING_ALLOW_PLAINTEXT=true
EMBEDDING_MODEL=bge-m3
EMBEDDING_DIMENSIONS=1024
这是默认选项。省略 EMBEDDING_PROVIDER 时会回退到
Ollama。
嵌入 URL 必须使用 https,或者使用指向回环主机的 http(localhost、127.x、::1)。指向任何其他主机的明文 http——包括 http://ollama:11434 这样的另一个容器——都会拒绝启动,除非设置 EMBEDDING_ALLOW_PLAINTEXT=true,以确认分块和查询会经过未加密的链路。.env.example 中默认启用了该设置;端点改为 https 后请移除它(内部 CA 可使用
EMBEDDING_CA_FILE)。在容器内,localhost
指的是容器本身,因此 Docker 主机上的 Ollama 仍需设置此覆盖项。
3. 部署
make init       # data dirs and .env from template (skip if you've already edited)
make db-init    # create database, user, and pgvector extension
make deploy     # build, push to local registry, run migrations, recreate container
首次部署会回填索引、维基链接图和嵌入向量。对于使用 GPU 的 Ollama 上包含 2 到 3k 条笔记的知识库,这需要几分钟。使用 text-embedding-3-small 时只需几秒。
预构建镜像公开发布于 ghcr.io/maxkuminov/obsidian-mcp(每个发布标签对应 :v<release>,最新版本为 :main),由 CI 构建并扫描;发布标签是 CI 已验证适用于该提交的镜像,仅重新打标签,不会重新构建。docker pull ghcr.io/maxkuminov/obsidian-mcp:v<release> 无需令牌。也可以像上文所述在本地构建。
4. 连接客户端
在控制面板中生成 API 密钥,然后将 MCP 客户端指向:
URL:  https://obsidian-mcp.<your-domain>/mcp
Auth: Bearer omcp_...
对于 Claude Desktop,将以下内容添加到 claude_desktop_config.json:
{
  "mcpServers": {
    "obsidian": {
      "url": "https://obsidian-mcp.<your-domain>/mcp",
      "headers": { "Authorization": "Bearer omcp_..." }
    }
  }
}
对于 Claude Code:
claude mcp add obsidian --transport http \
  --url "https://obsidian-mcp.<your-domain>/mcp" \
  --header "Authorization: Bearer omcp_..."
任何 Agent 在新会话中首先要做的事,都应该是调用
get_vault_guide()。这样它就能在写入任何内容之前了解你的文件夹结构、
命名约定和 YAML 架构。
升级
拉取镜像,然后运行 make deploy(或重建 compose 栈);迁移会在启动时运行。在混合搜索版本(#354)中:
- 无需迁移,也无需重新推导或重新生成嵌入向量。 新增了一个工具
hybrid_search,以及一个可选设置HYBRID_RRF_K(默认值为 60)。 - 新增一个并发就绪周期。
hybrid_search与semantic_search共用embedding类,因此CLASS_MAPPING_VERSION升至 5,而升级前收集的make concurrency-report证据不再适用。 - 回滚只需重新部署之前的镜像;该工具的使用记录行会保留,但不会使用。
在变更流版本(迁移 033,#351)中:
- 只需执行一次迁移,无需重新推导。 033 新增
notes_metadata.content_changed_at(根据每条笔记的修改时间回填)和三个变更流表。不会重新解析或重新生成嵌入向量。升级后的首次扫描会启动变更流;033 之前没有任何事件。 - 变更流表会持久保留。
make db-backup和 Kubernetes 备份 Job 会导出这些表中的行(历史记录、游标和保留期限水位线无法从知识库重建)。恢复会将变更流回滚到备份时的状态,因此,之后获取的游标会被拒绝,Agent 将从某个日期重新开始。 - 新增一个并发就绪周期。
get_changes加入了scan类,因此CLASS_MAPPING_VERSION升至 4,而升级前收集的make concurrency-report证据不再适用。 - 新增四个设置,均有可用的默认值:
CHANGE_FEED_RETENTION_DAYS、CHANGE_FEED_MAX_EVENTS_PER_SCOPE、CHANGE_FEED_MAX_EVENTS_PER_PASS、CHANGE_FEED_LOCK_TIMEOUT_MS(参见 配置)。 - 回滚:之前的镜像既不会读取也不会写入这些对象;
alembic downgrade 032会将它们删除,且只会丢失变更流历史记录。
在任务列表版本(迁移 032,#350)中:
- 升级后完整重新推导一次,无需重新嵌入。
提取版本升至 4,因此首次运行会重新解析每条笔记一次,并存储其复选框任务,供新的
list_tasks工具使用——成本与之前的提取版本升级相同。版本 4 与版本 3 使用相同的嵌入清理器,因此不会重新嵌入,也不会调用提供方。在这次处理完成前,list_tasks会在标题中报告尚未扫描的笔记;move_note(rewrite_links=True)也会像每次升级后一样,以index_not_ready拒绝操作。 - 新的并发就绪纪元。
list_tasks加入scan类别,因此CLASS_MAPPING_VERSION升至 3,升级前收集的make concurrency-report证据不再有效。 - 回滚就是向前滚动。 直接重新部署旧镜像会重新提取每条笔记一次;由于旧镜像没有版本 4 的清理器,它还会清除每条笔记的嵌入认证;随后嵌入处理会重新分块每条笔记并复用所有已存储的向量(不会调用提供方),同时
semantic_search会将这些笔记标记为过期,直到处理追上。再次向前滚动还需要多进行一次重新推导。 - 没有新增设置。
跨越关键词排名版本(迁移 031,#344)升级时,请先阅读:
- 关键词排名立即变化;摘要片段需要重建一次。
迁移 031 会原地重写每个关键词向量,使标题和别名的排名高于正文——无需操作员执行步骤;现在,
make deploy会在待执行迁移之前停止应用,并在迁移后重新创建应用(手动操作 compose 栈时:停止 →alembic upgrade head→ 启动;Kubernetes 已会执行Recreate)。摘要片段来自仅在写入时存储的摘录,因此,在 031 之前建立索引的笔记不会显示摘要片段(标题会统计数量,启动日志也会记录数量),直到编辑这些笔记,或运行一次make rebuild-tsvectors(在 Kubernetes 上,先将应用缩放至零,再使用deploy/kubernetes/base/rebuild-tsvectors-job.example.yaml)。不会触及嵌入,也不会进行 API 调用。 - 新增可选设置:
RANK_WEIGHTS、KEYWORD_EXCERPT_CHARS、KEYWORD_SNIPPET_ROWS。请参阅配置。
以及跨越内部传输和面板 CSP 版本升级时:
- 重大变更:服务拒绝以 PostgreSQL 超级用户身份运行
(#324)。 在此版本之前,使用
docker-compose.simple.yml或docker-compose.proxy.yml创建的 Compose 部署会以集群 超级用户身份连接,必须执行 DEPLOYMENT.md,“升级:拆分数据库角色” 中的一次性转换(备份、新建postgres.env、在.env中设置OBSIDIAN_DB_PASSWORD、运行一个脚本);新版 compose 文件无法在 未转换的卷上运行。对于其他DATABASE_URL指向超级用户的部署, 服务会在启动时拒绝运行并显示提示;请改用数据库的非超级用户所有者, 或将DATABASE_ALLOW_SUPERUSER=true作为权宜之计。Kubernetes 部署包不受影响。现在,DATABASE_URL密码为changeme/CHANGE_ME时会被拒绝,内置默认 URL 不含密码。 - 重大变更:必须确认明文嵌入端点。 如果当前使用的嵌入 URL
(
OLLAMA_URL,或使用 OpenAI 提供方时的OPENAI_BASE_URL)是指向 非本机环回主机的http://地址(包括默认的http://ollama:11434),请在部署前将EMBEDDING_ALLOW_PLAINTEXT=true添加到.env,否则服务会拒绝启动, 并提示相关设置项。 - 数据库 TLS 仅有一个配置来源。 如果
DATABASE_URL中包含 TLS 参数(?ssl=…、?sslmode=…)或设置了任何PGSSL*环境变量, 服务会在启动时拒绝运行;请将其移至DATABASE_SSL_MODE。默认值prefer与之前的行为相同。 - 嵌入客户端会忽略环境的网络设置。
HTTP(S)_PROXY、SSL_CERT_FILE/SSL_CERT_DIR和.netrc不再作用于嵌入请求。 内部 CA 请使用EMBEDDING_CA_FILE。 - 面板现在会发送基于 nonce 的 Content-Security-Policy
(
PANEL_CSP=enforce),并且已移除 htmx。如果面板控件出现异常, 请设置PANEL_CSP=report-only(或off)并重新创建容器;无需重新构建。 - 新增可选设置:
DATABASE_SSL_MODE、DATABASE_SSL_CA_FILE、DATABASE_SSL_CERT_FILE、DATABASE_SSL_KEY_FILE、EMBEDDING_ALLOW_PLAINTEXT、EMBEDDING_CA_FILE、PANEL_CSP。请参阅配置, 以及DEPLOYMENT.md, 了解如何将两段连接都切换为经过验证的 TLS。
费用预期
如果选择 OpenAI 方案(仅使用 CPU 的 VPS 上较为现实的选择), 首次建立索引的费用很低,后续几乎免费。以下粗略估算假设每条笔记平均 约 1,500 个 token(分为三个 512-token 块),并采用本文撰写时 OpenAI 公布的价格:
| 模型 | 每 100 万个 token 的费用 | 1k 条笔记 | 10k 条笔记 | 100k 条笔记 |
|---|---|---|---|---|
text-embedding-3-small | $0.02 | ~$0.05 | ~$0.50 | ~$5.00 |
text-embedding-3-large | $0.13 | ~$0.30 | ~$3.00 | ~$30.00 |
首次建立索引后,只有变更过的笔记会重新生成嵌入。持续费用与编辑量成正比; 对于典型的 vault,每月只需几分钱。
如果使用 GPU 自托管 Ollama,嵌入费用就是电费。Ollama 在 CPU 上也能运行, 但速度太慢,不适合用于包含数百条以上笔记的 vault。
自描述知识库
这是大多数“Obsidian MCP”项目会忽略的部分。它们只支持读取、写入和列出。真正值得关注的问题不是“Agent 能否访问文件”,而是“Agent 是否了解规则”。
如果你的知识库有一套明确的规范——任务放置逻辑、文件夹约定、必需的 frontmatter、标签分类体系——那么在缺少这些上下文的情况下,拥有写入权限的 Agent 可能造成严重破坏。任务被放进错误的文件夹。纯日期文件名与模板发生冲突。错误的标签会破坏 Dataview 查询。数据层运行正常;问题出在上下文层。
解决方法很简单。在知识库根目录保留一个机器可读的指令文件(CLAUDE.md),描述系统自身的规则。将其作为专用工具公开。每个连接的 Agent 在会话开始时调用一次,便能立即了解知识库的工作方式。更新文件后,每个 Agent 在下次调用时都会看到更改。无需客户端配置。无需注入系统提示词。知识库自身的规则以它为准。
get_vault_guide() 正是如此。它会返回通用的 Obsidian 入门说明(wikilink 语法、嵌入语法、标签约定、常见插件字面值),以及实时读取的知识库 CLAUDE.md。写入工具的描述和服务端的 instructions 都会指向它——说明知识库约定存放在哪里,而非下达指令——因此即使没有提示词引导,Agent 也会自然采取正确的行为。
多用户模式
单用户模式是默认模式,工作方式与上述说明完全一致——一个知识库、一组 API 密钥、应用内不涉及用户概念。多用户模式是一个可选标志,可将同一个容器变成小型多租户部署:应用内用户名和密码登录、按用户划分知识库、用于排障的管理员角色,以及只能查看自己密钥、OAuth 客户端和用量的普通用户角色。一个容器、一个 Postgres,用户之间严格隔离。
在现有部署上启用此模式不会丢失数据——当前知识库和密钥会保留给引导管理员。
启用
- 在
.env中设置MULTI_USER_MODE=true和一个足够强的SECRET_KEY(可以使用openssl rand -hex 32)。应用无条件拒绝使用占位符SECRET_KEY启动——包括单用户模式——所以并不是此标志会启用这一要求。 - 运行
make deploy(或docker compose up -d --force-recreate)。 - 访问面板。由于
users表为空,你会被转到/admin/register——这是一次性引导表单。它仍受 Traefik 的chain-oauth@file中间件保护,因此只有 Traefik 已信任的人员才能注册为管理员。 - 使用选定的用户名和密码注册。引导表单会将
vault_path预填为VAULT_PATH的当前值,因此你现有的笔记会立即归属于这位新管理员。无需重新索引、无需重新嵌入、不会丢失数据——所有此前已索引的笔记、API 密钥、OAuth 客户端和用量日志记录,都会在一个事务中关联到引导用户。
邀请用户
-
编辑
docker-compose.yml,为新用户的知识库添加一个挂载卷,路径为/vaults/<username>。包含空格的主机路径必须作为单个 YAML 字符串加引号:volumes: - "/storage/vaults/alice:/vaults/alice" - "/storage/shared/bob/Obsidian:/vaults/bob"运行
make deploy以应用更改。 -
在面板中打开
/admin/users/create——选择用户名并设置初始密码。 -
打开
/admin/users/{id}/edit——将用户的vault_path设置为刚挂载的容器路径(例如/vaults/bob)。表单会显示磁盘上现有、尚未分配的/vaults/*目录下拉列表。 -
通过其他渠道分享登录凭据。用户在
/admin/auth/login登录后,即可查看自己的密钥、OAuth 和用量信息,且无法查看其他用户的笔记。
管理员看到的内容
管理员可以查看所有用户的 API 密钥、OAuth 客户端和使用日志;他们拥有 Settings 页面(嵌入提供方、索引器触发器、危险区域)和 Users 页面。管理员不会通过面板浏览其他用户的保险库内容——这是有意为之。要排查其他用户的保险库问题,需要通过 docker exec 检查,或临时重新分配其 vault_path,而不是通过 UI 窥探。
回滚
设置 MULTI_USER_MODE=false,然后重启。现有 API 密钥仍可正常使用(未设置用户上下文时会跳过按用户筛选),登录 UI 和会话 Cookie 会消失,面板会退回到仅使用 Traefik OAuth 的模式。数据库架构会保留,因此之后切回多用户模式时,无需重新引导即可从上次中断处继续(users 表非空,因此 /admin/register 会关闭)。
约束和已知限制
- 索引器在每个周期内依次遍历活跃用户。几十个用户时没有问题;如果有数百个用户,则需要并行处理。
- 密码恢复由管理员执行——没有基于电子邮件的重置方式。已登录的用户可以在
/admin/account更改自己的密码(输入当前密码、新密码并确认;至少 12 个字符),这会将该用户从其他浏览器中登出,同时保留更改密码所用的浏览器登录状态。对于完全无法登录的用户,仍需由管理员重置密码来恢复访问;重置也会结束该账户的所有有效会话。 /admin/auth/login和/admin/account/password的速率限制为每分钟 5 次请求;登录限制按客户端地址计算,密码更改则有两项独立限制——一项按账户计算,另一项按地址计算。限制器使用进程内存储,因此进程重启后计数器会重置。面板前方的 Traefik OAuth 门禁仍是主要的暴力破解防护措施;如果将/admin/auth/login暴露到开放互联网,也应在其前方配置速率限制中间件。- 面板会话以服务端数据行(
user_sessions)的形式存储,因此登出、更改密码、停用或删除账户都会真正结束会话。代价是:首次部署引入用户注册表的构建版本时,会一次性登出所有有效面板会话,因为此前签发的 Cookie 不含会话 ID,系统会拒绝这些 Cookie,而不会沿用旧会话。所有人都需要重新登录;除此之外不会有任何变化。 vault_path验证器不会解析符号链接,因此管理员在技术上可以通过符号链接的/vaults/<name>将用户指向主机文件。请将/vaults/视为管理员信任边界。 **实际会检查的内容(用户根目录重叠保护):**两个活跃用户的根目录不得指向重叠目录。系统会打开每个根目录一次,并根据 inode 标识((st_dev, st_ino))进行比较,以检测指向同一目录的符号链接别名或绑定挂载;还会对两个规范化的真实路径进行双向逐级包含性检查,以检测/vaults/team和/vaults/team/private这类祖先目录与后代目录的重叠。如果分配的路径冲突,面板会拒绝该操作并指出另一位用户;每次索引之前也会重新执行相同检查。因此,如果分配后创建了别名,两个账户都会被隔离:其 MCP 工具、索引流程和传输兑换均会被拒绝,直至管理员修正问题,并且不会删除任何索引行。若某个根目录完全无法打开,则只会隔离其所属账户。 仍无法检测的情况及其后果:将一个用户的保险库(或其中嵌套的任何挂载点)绑定挂载到另一个用户根目录内的路径。mount --bind /vaults/b /vaults/a/inner会使两个根目录的 inode 保持不同,两个规范化路径也互不包含,因此两项检查都无法发现问题。此时,用户 A 可以通过常规写入工具读取、覆盖并删除用户 B 保险库中的所有笔记;而用户 A 的索引流程会将 B 的笔记归入 A 的账户,因此 A 搜索时会返回 B 的内容。同样的漏洞也适用于无法检查的根目录,但若其别名可访问,则对等账户仍会继续提供服务。系统不会在任何地方报告这两种情况。两种情况都需要管理员在部署配置中写入绑定挂载——因此,管理员信任边界不仅包括路径字符串,还包括/vaults/和 compose 文件中的挂载配置。这是一项长期保留并已明确说明的限制,而不是待修复的问题:挂载检测曾被列入规范,但在三轮审查中每轮都因一种新拓扑而失败,最终被弃用。运维规则:绝不能将某位用户的目录或其中的任何内容挂载到另一位用户的根目录内。
配置
| 变量 | 默认值 | 用途 |
|---|---|---|
DATABASE_URL | — | postgresql+asyncpg://user:pass@host/db。此处不允许设置 TLS 参数——设置会被拒绝;请使用 DATABASE_SSL_MODE。密码为 changeme / CHANGE_ME 时会被拒绝。捆绑的 compose 文件会自行使用 OBSIDIAN_DB_PASSWORD 设置此变量。 |
DATABASE_ALLOW_SUPERUSER | false | 如果数据库角色是 PostgreSQL 超级用户,服务将拒绝启动。设为 true 会将其降级为警告;这只是转换现有安装时的临时措施,不应长期保留此设置。 |
DATABASE_SSL_MODE | prefer | 数据库 TLS:disable、prefer(尝试 TLS,失败时回退到明文)、require(加密,但不验证)、verify-ca、verify-full。严格模式下,如果会话未加密,进程将退出。任何 PGSSL* 变量都会被拒绝。 |
DATABASE_SSL_CA_FILE | — | verify-ca / verify-full 使用的 CA 证书包(PEM);这两种模式都必需,其他模式下设置会被拒绝。不回退到系统证书库。 |
DATABASE_SSL_CERT_FILE | — | 客户端证书(PEM)。仅适用于严格模式(require、verify-ca、verify-full);必须与 DATABASE_SSL_KEY_FILE 一起设置,否则两者都不设置。 |
DATABASE_SSL_KEY_FILE | — | DATABASE_SSL_CERT_FILE 对应的客户端私钥。必须两者都设置,或都不设置。 |
VAULT_PATH | /obsidian | 容器内的知识库挂载点 |
SECRET_KEY | — | itsdangerous 签名密钥 |
INDEX_INTERVAL_SECONDS | 300 | 定期重新索引的间隔 |
CHANGE_FEED_RETENTION_DAYS | 90 | get_changes 历史记录的保留天数(1–3650)。null(或空值)会禁用时限;0 会导致启动时被拒绝。通过定期轮询清理,绝不会在一次处理过程中清理;如果游标早于保留的数据,读取结果会显示 history_truncated: true。 |
CHANGE_FEED_MAX_EVENTS_PER_SCOPE | 100000 | 每位用户最多保留的变更源事件数(最少 1,000)。即使关闭时限,此限制也始终生效,以控制表的大小;每个范围最新的事件绝不会被清理。 |
CHANGE_FEED_MAX_EVENTS_PER_PASS | 2000 | 每次索引处理过程中为每位用户列出的事件数(100–50,000);其余事件会合并为一行 gap,指向 get_recent(order_by="content_changed", since=…)。 |
CHANGE_FEED_LOCK_TIMEOUT_MS | 2000 | 写入事件时等待用户变更源锁的时长(100–30,000)。超时绝不会导致一次处理或工具调用失败:处理过程会记录一个持久化的 gap,工具的变更则会在下一次处理时记录为未归属。 |
INDEXER_DEGRADED_AFTER_FAILURES | 3 | 任一索引器计数器连续失败的次数阈值(某范围的索引处理、嵌入处理、不完整项重新推导,或轮询自身的用户枚举)。达到此阈值后,/health 会报告 degraded,并记录一条 CRITICAL 级别的“需要人工干预”日志。 |
INDEXER_QUARANTINE_RETRIES_PER_TICK | 5 | 因数据库拒绝某条笔记(其行、关键词向量、移动或链接引发数据异常或程序限制错误)而隔离该笔记后,单次索引处理可以回滚并重新运行该范围的次数。超过此次数后,本次处理会作为普通失败处理;已找到的笔记会继续保持隔离,等待下一次轮询。 |
MULTI_USER_MODE | false | 应用内登录,每位用户拥有各自的知识库。请参阅多用户模式。 |
VAULT_ROOT_OBSERVE_TIMEOUT_SECONDS | 10 | 知识库根目录重叠检查在放弃某个根目录之前等待的时长。超时后会隔离该账户(root unexaminable),并继续检查,因此挂起的挂载不会阻塞启动。仅适用于多用户模式。 |
MCP_HOSTNAME | — | 公共主机名。派生出 BASE_URL、ALLOWED_ORIGINS 和 ALLOWED_HOSTS,格式为 https://<host>。传输工具必需(或设置 BASE_URL)。 |
BASE_URL | 派生值 | 显式指定的公共源。除回环地址外必须使用 HTTPS。 |
ALLOWED_ORIGINS | 派生值 | CORS 源,JSON 列表 |
ALLOWED_HOSTS | 派生值 | 接受的 Host 标头,JSON 列表。始终会添加 localhost。 |
SESSION_MAX_AGE | 604800 | 面板会话的有效期,单位为秒(多用户模式)。这是绝对期限——服务器端的记录绝不会延期,因此即使每天使用,会话仍会过期 |
SESSION_COOKIE_NAME | omcp_session | 面板会话 Cookie 名称 |
PANEL_CSP | enforce | 面板、登录页和同意页的 Content-Security-Policy:enforce、report-only(应用相同策略,仅报告)或 off。用于回滚的开关——更改后重新创建容器即可,无需重新构建。每次启动时,任何非 enforce 值都会记录 WARNING。 |
SESSION_TOUCH_INTERVAL_SECONDS | 60 | 已验证的 GET/HEAD 请求在重写会话的 last_seen_at 前,允许其过时的时长。仅用于遥测——不会据此授予任何权限。必须 ≥ 1。 |
SESSION_PURGE_RETAIN_DAYS | 7 | 死亡的面板会话记录的保留时长,从过期时间与撤销时间中较晚者起算,以便撤销状态在整个保留期限内可见。必须 ≥ 1。 |
OAUTH_KNOWN_REDIRECT_HOSTS | claude.ai,chatgpt.com | 同意页面徽章所标识的已知连接器目标重定向主机。支持 JSON 或 CSV。按主机名完全匹配——不支持通配符或后缀匹配;包含 *、/、@ 或内部空白字符的条目会在启动时被拒绝。空列表表示所有客户端都会显示为未验证。 |
OAUTH_GRANT_ABSOLUTE_LIFETIME_DAYS | 90 | OAuth 授权的绝对有效期,以整天计(1–365),从应用首次收到其令牌时开始计算。刷新不会延长有效期;过期后用户必须重新批准。此设置会显示在同意页面上。没有关闭选项——空值、null、none 和 0 都会导致启动被拒绝。降低此值会在每次授权下次请求时对所有授权生效;提高此值会延长现有授权的有效期。 |
MAX_FILE_READ_BYTES | 10485760 | read_file 上限(10 MB);限制服务从磁盘读取的数据量 |
MAX_FILE_WRITE_BYTES | 26214400 | write_file 上限(25 MB),按解码后的字节数计算 |
MAX_READ_RESPONSE_CHARS | 40000 | read_note / read_file 返回给调用方的内容上限(约 10K 个 token)。请参阅响应大小限制。 |
FTS_CONFIGS | english | 关键词搜索的全文检索配置。支持 JSON 或 CSV。请参阅全文检索语言。 |
RANK_WEIGHTS | {0.02, 0.2, 0.4, 1.0} | keyword_search 的 ts_rank_cd 权重数组 {D, C, B, A}:标题和别名按 A 索引,正文按 D 索引。使用默认值时,一次包含两个词的标题匹配得分高于正文中重复 50 次的匹配;PostgreSQL 自带的 D=0.1 则会让 10 次重复得分与之持平。四个有限数值,每个均在 [1e-6, 1] 范围内;只会改变标题与正文的相对权重。 |
KEYWORD_EXCERPT_CHARS | 20000 | 每篇笔记索引文本的前导字符数,用于存储 keyword_search 片段(1000–100000)。仅适用于之后索引的笔记;make rebuild-tsvectors 会重写其余内容。片段开销大致随此值线性增长;300 ms 的预算是在默认值下测得的。 |
KEYWORD_SNIPPET_ROWS | 20 | 每个 keyword_search 分页中生成片段的行数,不受 limit 影响(0–100;0 表示关闭片段)。限制每次调用的 ts_headline 开销,该开销大致随此值线性增长;300 ms 的预算是在默认值下测得的。 |
HYBRID_RRF_K | 60 | hybrid_search 的倒数排名融合常数(1–1000;超出范围会导致启动被拒绝):笔记得分为两个分支各自的 1/(k + rank) 之和。数值越小,各分支的高排名影响越大;数值越大,得分越趋于按票数计数。使用测试工具中的分支 scripts.search_eval_arms.hybrid:make_arm / make_arm_alt 衡量变更(ARM_OPTS="hybrid_k=60 hybrid_alt_k=20",请参阅 DEPLOYMENT.md 中的“衡量搜索质量”);没有逐次调用参数。 |
TRANSFER_TOKEN_TTL_SECONDS | 600 | 传输链接的默认有效期。每次调用的 expires_in 会限制在 60–3600。 |
TRANSFER_MAX_UPLOAD_SECONDS | 600 | 已认领的单次上传最多可以持续传输的时长,超时后令牌会失效 |
TRANSFER_MAX_CONCURRENT_UPLOADS | 4 | 同时进行的上传流数量 |
IMPORT_ALLOW_HTTP | false | 允许 import_from_url 获取普通 http。默认关闭。 |
VAULT_ALLOW_NAMED_STAGING_FALLBACK | false | 在不支持 O_TMPFILE 的文件系统上接受具名暂存。一个标志同时控制两条写入路径。请参阅系统要求。 |
WRITE_PRECONDITION_REQUIRED | false | 要求受支持的破坏性调用提供 expected_hash。创建操作除外;待客户端采用读取哈希后再启用。 |
EMBEDDING_PROVIDER | ollama | ollama 或 openai |
EMBEDDING_DIMENSIONS | 1024 | pgvector 列宽 |
OLLAMA_URL | http://ollama:11434 | 使用 Ollama 作为提供方时使用。必须为 https、回环地址上的 http,或由 EMBEDDING_ALLOW_PLAINTEXT 允许的地址。 |
EMBEDDING_MODEL | bge-m3 | Ollama 模型名称。部署后更改需要运行 make reset-embeddings;在已存储向量匹配之前,服务会拒绝启动。请参阅切换提供方或模型。 |
EMBEDDING_QUERY_INSTRUCTION | 空 | 每次发送给嵌入提供方的搜索查询前都会原样添加此内容,不添加分隔符;不会添加到笔记中。对于 Qwen3-Embedding 等经过指令微调的嵌入模型,可使用例如 "Instruct: Given a question, retrieve the notes that answer it\nQuery: "(使用双引号,以便 .env 将 \n 转换为换行符)。最多 1,000 个字符;不允许 NUL 字符,以及换行符和制表符以外的控制字符。此内容不会纳入已存储的嵌入指纹,因此更改后无需重置,也不会重新嵌入;更改模型仍需要重置。默认模型保持不变(bge-m3 不需要指令)。 |
OLLAMA_KEEP_ALIVE | -1 | Ollama 保持模型驻留的时长。-1 表示固定驻留;Go 时长(例如 30m)会在空闲时释放 VRAM。仅适用于 Ollama。 |
OPENAI_API_KEY | — | 使用 OpenAI 作为提供方时必需 |
OPENAI_BASE_URL | https://api.openai.com/v1 | Azure 或代理的覆盖地址。激活此提供方时,传输规则与 OLLAMA_URL 相同。 |
EMBEDDING_ALLOW_PLAINTEXT | false | 允许通过 http 连接非回环嵌入主机。未启用时,此类 URL 会导致启动被拒绝。.env.example 将其设为 true,以匹配其中的默认地址 http://ollama:11434。 |
EMBEDDING_CA_FILE | — | 连接使用内部 CA 的 https 嵌入端点时的信任锚(PEM);会替换默认 certifi 证书包。使用 http URL 时会被拒绝。嵌入客户端会忽略 HTTP(S)_PROXY、SSL_CERT_* 和 .netrc。 |
OPENAI_EMBEDDING_MODEL | text-embedding-3-small | OpenAI 模型。部署后更改需要运行 make reset-embeddings;在已存储向量匹配之前,服务会拒绝启动。请参阅切换提供方或模型。 |
CHUNK_SIZE | 512 | 每个分块的近似 token 数量(按每个 token 约 4 个字符估算) |
CHUNK_OVERLAP | 0 | 分块之间重叠的 token 数量 |
EMBEDDING_EXCLUDE_PATTERNS | ["*.excalidraw.md","Excalidraw/*"] | 嵌入器跳过的 glob 模式。排除的文件仍可进行关键词搜索。 |
MCP_AUTH_FAILURE_LIMIT | 60 | 在一个时间窗口内,单个客户端地址可进行的失败 /mcp 身份验证次数上限,超过后返回 429。在查询凭据之前进行检查,因此被拒绝的探测不会消耗查询次数。null 表示禁用。请参阅速率限制。 |
MCP_AUTH_FAILURE_WINDOW_SECONDS | 300 | 计算上述次数限制的时间窗口。 |
MCP_AUTH_FAILURE_TABLE_SIZE | 4096 | 固定大小、按进程加盐的地址表中的计数器槽位数。内存用量为 O(size);发生冲突只会让控制更严格。 |
MCP_RATE_LIMIT_PER_MINUTE | 600 | 每个主体(API 密钥或 OAuth 授权)每分钟可持续进行的工具调用数。设为 null 会同时禁用此通用桶及突发限制。 |
MCP_RATE_LIMIT_BURST | 120 | 通用桶的容量。必须与速率限制一同设置,或与其一同设为 null。 |
MCP_WRITE_RATE_LIMIT_PER_MINUTE | 120 | 每个主体每分钟可持续进行的知识库修改调用数——包括 8 个写入工具,以及计入生成该能力的主体的 PUT /transfer/upload。 |
MCP_WRITE_RATE_LIMIT_BURST | 30 | 写入桶的容量。 |
MCP_LIMITER_MAX_TRACKED_PRINCIPALS | 10000 | 拥有各自限流器条目的主体数量上限;超出后,其他主体将共用一个溢出条目。 |
MCP_REFUSAL_LOG_INTERVAL_SECONDS | 10 | 速率限制或槽位拒绝日志合并窗口的持续时间。窗口内拒绝时不会写入日志;最终写入的行代表 1 + suppressed 次拒绝。 |
MCP_CONCURRENCY_MODE | shadow | off、shadow 或 enforce。Shadow 模式会观察压力,但不会拒绝或等待。请参阅并发准入。 |
MCP_CONCURRENCY_WAIT_SECONDS | 0 | enforce 模式下等待工具准入的时长,0–5 秒。Shadow 模式下必须为零。 |
MCP_CONCURRENCY_TOOLS | 4 | enforce 模式下的全局工具并发上限,同时受类别、租户(3)和主体(2)上限约束。 |
MCP_CONCURRENCY_REQUESTS | 32 | 完整 MCP 请求并发上限,包括打开的流;每个 bearer 指纹的上限默认为 4。 |
MCP_CONCURRENCY_AUTH | 2 | 身份验证数据库会话并发上限。响应传递或下游工作开始前会释放会话。 |
MCP_CONCURRENCY_WRITERS | 1 | 使用日志写入器并发上限,包括回退插入。默认值:64 个待处理写入器,以及 enforce 模式下 0.25 秒的等待时间。 |
MCP_BODY_MEMORY_BUDGET_BYTES | 未设置 | /mcp 请求体的内存预算(≥ 64 MiB)。未设置时会根据容器内存限制推导——绝不表示关闭。超过内存限制的一半(扣除固定预留空间后)会导致启动被拒绝。 |
MCP_BODY_MEMORY_FRACTION / MCP_BODY_MEMORY_MULTIPLIER | 0.5 / 8 | 推导方式:限制 × fraction ÷ multiplier = 正在传输中的原始请求体字节数。Fraction 为 0.1–0.5,multiplier 为 8–32。 |
MCP_BODY_BUDGET_WAIT_SECONDS / MCP_BODY_BUDGET_WAITERS | 15 / 8 | 无法纳入预算的请求体在返回 429 前等待的时长,以及可同时等待的请求体数量。 |
DEFAULT_DAILY_REQUEST_LIMIT | 5000 | 调用方未指定限制时,新创建的 API 密钥每日获得的配额(JSON 字段未提供或面板字段为空)。不影响现有密钥。只有管理员可以创建或恢复无限制密钥,可通过面板的“无限制”复选框或显式设置 JSON null 实现。设为 null 时,创建密钥必须提供限制。 |
KEY_CREATION_ACCOUNT_LIMIT | 10 | 单个账户在每个时间窗口内可创建的 API 密钥数量上限,POST /api/keys 和面板表单合并计算。null 表示禁用。 |
KEY_CREATION_ADDRESS_LIMIT | 20 | 单个客户端地址在每个时间窗口内可创建的 API 密钥数量上限,跨两种路由和所有账户合并计算。null 表示禁用。 |
KEY_CREATION_WINDOW_SECONDS | 3600 | 计算上述两项密钥创建限制的固定时间窗口。 |
KEY_MAX_ACTIVE_PER_ACCOUNT | 25 | 非管理员账户可持有的有效 API 密钥数量上限;超过后,在撤销密钥前将拒绝创建。管理员不受此限制。null 表示禁用。 |
MCP_REJECT_UNKNOWN_ARGUMENTS | true | 拒绝携带工具未声明参数的工具调用(错误中会指出该参数),并在每个输入架构中发布 additionalProperties: false。false 会恢复 SDK 静默忽略多余参数的行为——用于回滚到兼容会发送额外参数的客户端的设置;更改后重新创建容器。每次启动时,false 都会记录 WARNING。 |
MCP_SANDBOX_MODE | false | 仅用于注册表评估。跳过数据库、索引器、嵌入提供方和 /mcp 身份验证,以便在没有外部依赖的情况下进行检查。请勿在生产环境中启用。 |
完整的配置项及其注释请参见 .env.example。关于首次索引的 OpenAI 费用,请参见上文的费用预估。 |
MCP 传输的请求正文大小上限是推导得出,而非手动配置:
max(2 × MAX_FILE_WRITE_BYTES, 6 × 10 MB) + 1 MiB,使用默认值时为 61 MiB。它必须与写入上限保持一致,这样每次超出支持范围的写入都会被工具拒绝,并显示可执行的提示,而不会被传输层直接返回一个简单的 HTTP 413。提高 MAX_FILE_WRITE_BYTES 后,传输层上限也会相应提高。
该上限针对单个请求。正在处理的请求正文总量也会受限,始终如此(#322):每个 /mcp POST 都会根据容器的内存限制,将其声明的大小计入预算(取内存限制的一半,再除以 8 作为解析开销——2 GiB 容器可容纳 128 MiB 原始正文);如果空间不足,则最多等待 15 秒,否则返回 HTTP 429,并附带 code: body_memory 和 Retry-After: 2。如果容器太小,无法容纳一个最大尺寸的正文(使用默认值时约为 1.1 GiB),服务将拒绝启动。.env.example 中的 MCP_BODY_* 设置只允许朝安全的方向调整。
切换提供方或模型
不同模型会生成处于不同空间的向量,而两个空间之间的余弦距离没有意义。因此,凡是用于生成已存储向量的配置发生变化,都需要完整重新嵌入——不只是切换提供方。具体包括:
EMBEDDING_PROVIDEREMBEDDING_MODEL(Ollama)或OPENAI_EMBEDDING_MODEL(OpenAI)——包括在两个维度相同的模型之间切换,因为维度检查无法检测到这种变化EMBEDDING_DIMENSIONSCHUNK_SIZE和CHUNK_OVERLAP
有两项特意不在此列表中。EMBEDDING_QUERY_INSTRUCTION 只影响查询,因此已存储的向量都不依赖它。分块格式本身(感知标题的分段和上下文前缀)则按笔记版本管理:格式变更时,索引器会在后台分多轮重新嵌入笔记,不会拒绝启动,也无需重置。
服务会存储这套配置的指纹,并在启动时进行比对。如果不匹配,服务会记录两个指纹及其差异字段,说明修复方式,然后以非零状态码退出——因此,以前可能会让两个向量空间悄悄混在同一列中的模型切换,现在会直接停止进程。
请按以下顺序操作:
- 更新
.env。 - 执行
make deploy(或docker compose up -d --force-recreate)。新容器将拒绝启动——可能触发指纹检查,也可能在向量维度改变时触发维度检查;这正是预期行为:在重置期间,无法启动的容器不会嵌入任何内容。 - 在服务停止期间执行
make reset-embeddings。该目标会运行docker compose run --rm,启动一个一次性容器并读取你修改后的.env:它会按新的维度重建数据列,清除所有embedded_content_hash,并在同一事务中记录新指纹。 - 重启服务。此时服务会静默启动,因为存储的行确实是在当前运行配置下生成的;下一轮索引器运行时会重新嵌入知识库。
这与早先建议的“先重置,再重建容器”顺序正好相反。 只有在配置声明不存储在数据库中时,这种顺序才安全;现在,重置操作会写入该声明,因此必须在应用新 .env 后运行,并且不能有使用旧配置的容器对其进行嵌入。跳过某一步只会耗费时间,不会影响正确性——数据库层的代际锁会拒绝旧配置容器的认证,避免认证信息写入——但按上述顺序操作,就无需依赖这一机制。
维护操作会等待正在执行的索引任务。 索引任务会在事务开始时获取同一把生成锁,并一直持有到事务提交,因此 make reset-embeddings 和 make rebuild-tsvectors 会阻塞,直到索引任务完成——大型知识库可能需要几分钟——而不会与其交错执行。这种等待是必要行为,不是需要绕开的卡顿:如果重置操作在索引任务执行期间完成,恰恰会导致某个配置生成的向量被存储在另一个配置的指纹之下。两个命令都不会设置较短的锁超时,也不应设置;并且由于服务会在每个连接上设置 60 秒的 statement_timeout,这两个命令(以及控制面板“危险区域”中的重置操作)都会在获取锁期间取消该超时,并在获取锁后恢复。否则,针对运行中的服务启动的命令会在等待一分钟后被取消,看起来像是命令故障,而不是索引繁忙。
你也可以在控制面板中使用“设置 → 危险区域 → 重置嵌入”,服务运行时执行相同的 SQL——包括指纹记录(暂停索引器、执行 SQL,然后恢复)。
指纹记录的是配置,而不是模型制品。
bge-m3是一个可变的 Ollama 标签,因此ollama pull可以替换其背后的权重;OLLAMA_URL/OPENAI_BASE_URL则被刻意排除在指纹之外——切换到另一台主机或代理通常只是基础设施调整,提供的仍是相同的制品;如果将其纳入指纹,就会因此要求完整地重新嵌入。 其后果是一个已接受的限制:如果模型名称未变,但背后的制品被替换——重新拉取某个标签,或指向使用相同名称但提供不同权重的主机——不同的向量空间就会混在一起而无法检测。这需要执行make reset-embeddings;如果跳过该操作,启动检查也无法发现。 服务无法获取能区分这两种情况的信息,而探测操作又必须信任它所检查的端点。
全文搜索语言
keyword_search 基于 PostgreSQL tsvector 执行。它使用的文本搜索配置——词干提取器和停用词词典——由 FTS_CONFIGS 控制。默认值为 english,与历史行为完全一致,因此现有部署无需采取任何操作。
对于每个已配置的搜索配置,向量会以权重 A 保存笔记的标题和 frontmatter 中的 aliases,并以权重 D 保存正文;排名则使用 RANK_WEIGHTS。因此,如果查询词是某篇笔记的标题,该笔记会排在首位;过去它可能会输给一篇反复出现这些词的长笔记。裸词之间按 AND 组合;如果完全匹配的结果未填满页面,则将相同词语按 OR 组合以填充剩余结果,并标记为 match: any。每一行都包含一个 snippet:,它根据已索引文本中存储的摘录(KEYWORD_EXCERPT_CHARS)生成,并为前 KEYWORD_SNIPPET_ROWS 行计算。摘录会与向量一同写入;make rebuild-tsvectors 也会为之前已建立索引的笔记存储摘录。
FTS_CONFIGS 是一个列表,可设置为 JSON(FTS_CONFIGS=["simple","norwegian"])或逗号分隔值(FTS_CONFIGS=simple,norwegian)。每篇笔记都会按列表中的每个配置建立索引;只要任一配置的解析结果命中,查询就会匹配。这正是混合语言知识库能够正常工作的原因:
FTS_CONFIGS | 行为 |
|---|---|
english | 英语 Snowball 词干提取器(默认;running ↔ run)。 |
simple | 不依赖语言。不进行词干提取,也不使用停用词——只匹配完全相同的单词形式。这是混合语言知识库的合理默认值:关键词搜索负责精确匹配,而 semantic_search(bge-m3 支持多语言)负责形态变化带来的召回。 |
english,norwegian | 同时应用两种词干提取器——关键词搜索端同时支持两种语言的形态变化。 |
simple,norwegian | 原样词项加上挪威语词干。 |
该设置是全局的,适用于每个 vault(与同样为全局设置的 EMBEDDING_MODEL、CHUNK_SIZE 等一致)。对于混合语言的多用户实例,请设置一个超集(例如 ["english","norwegian"] 或 ["simple"])。按用户配置 FTS 是未来可以干净扩展的方向,但目前尚未实现。 |
配置名称拼写错误或未安装时,服务会在启动时立即失败,并提示列出 Postgres 实例中可用的配置,而不是悄无声息地返回零条搜索结果。
更改 FTS_CONFIGS 需要重建,并且在完成重建前,服务会拒绝启动。 存储的 tsvector 是在索引时计算的,因此配置列表更改后就会过时;而词干分析器过时带来的问题不只是结果不完整。在 english 配置下,词元 running 会以词位 run 的形式存储,因此在 simple 配置下查询 run,会匹配一条并不包含该词的笔记——这是一个无法与真实命中区分的误报。因此,关键词向量会像嵌入一样在不确定时拒绝服务:服务会存储 FTS_CONFIGS 的指纹,并在启动时进行比较;若配置成员发生变化,就会记录两个配置列表及差异项,说明需要执行重建,然后以非零状态退出。(相同名称仅顺序不同不算变化:笔记会按每个配置建立索引,查询只要任一配置命中就会匹配,因此顺序不影响结果,也不会进行比较。)
操作步骤:
- 编辑
.env中的FTS_CONFIGS。 - 执行
make deploy。新容器会因关键词指纹校验而拒绝启动,并保持停止状态。 - 执行
make rebuild-tsvectors。该操作会在一个事务中重建所有包含行的作用域——每个所有者都包括在内,单用户模式下不属于任何所有者的行也包括在内;只有在所有作用域都报告重建完成后,才会记录新指纹。这是一个全有或全无的操作:如果某个作用域无法重建,整个操作就会回滚,说明该作用域及原因,并且不会写入指纹,因为该指纹是对所有保留行的统一声明。 - 重启。服务将正常启动,不再输出提示。
如果第 3 步指出某个作用域无法重建——例如用户未分配 vault、租户仍在重新推导其来源信息,或多用户模式下存在无所有者的行——可按优先顺序采取以下措施:
- 解决该作用域的问题:分配或删除该用户,或者等待重新推导完成,然后再次运行重建。
- 删除无所有者的行或为其重新分配所有者,然后再次运行重建。
- 将
FTS_CONFIGS恢复为之前的值。这样可以立即解除拒绝,无需重建——配置编辑始终可撤销,这正是该拒绝机制不会导致服务中断的原因。
重建会重新读取每条笔记,并根据新的配置重新计算其 content_tsvector。它只重建关键词索引——不会触及嵌入/向量,也不会调用 API,因此几千条笔记只需数秒即可完成。(请勿将其与开销较大的 make reset-embeddings 流程混淆。)
**分词注意事项:**无论使用哪种配置,tsvector 的解析器仍会按标点符号和连字符拆分内容,因此
bge-m3会被分词为bge+m3。simple会保留单词的形式,但不会保留带标点的字符串;要实现带标点符号的精确字符串匹配,需要使用三元组索引,这不在本次范围内。
响应大小限制
工具结果会作为模型输入。read_note 返回的内容会直接传回调用方的下一次请求,因此不设上限的读取就意味着不设上限的提示词——调用方通常只有在推理服务提供商拒绝请求时才会发现问题。
MAX_READ_RESPONSE_CHARS(默认值为 40,000,约合 10K 个词元)限制 read_note 和 read_file 返回的文本结果。这与 MAX_FILE_READ_BYTES 是两个不同的限制,后者限制服务从磁盘读取的数据量。3 MB 的笔记完全不会触及 10 MB 的读取上限,但仍可能撑爆上下文窗口;因此两项限制都不可或缺,而且应设置为不同的合理值。
它按组件分别应用,而不是对整个响应只应用一次:content 窗口会受到上限约束,标题 outline 独立受到上限约束,元数据字段(title、tags、frontmatter_yaml 及其 JSON 视图、heading)则共同使用第三份预算。截断的读取可能同时包含这三部分,因此请按最坏情况预留大约 3 × MAX_READ_RESPONSE_CHARS,再加上固定说明文字——由于 MCP 结果同时包含结构化内容和 JSON 文本块,预算还要翻倍;对于大多由控制字符组成的内容,还需考虑 JSON 转义导致的膨胀。
当笔记超出上限时,你会获得首个窗口,以及作为数据返回的截断信息——truncated、用于继续读取的 next_offset、total_chars——如果是读取整篇笔记,还会获得笔记各部分的 outline:
{"entries": [
  {"ordinal": 1, "depth": 1, "text": "Client Records",
   "size": 2855343, "exceeds_cap": true,  "duplicate": false},
  {"ordinal": 2, "depth": 2, "text": "Balance Sheet.xlsx",
   "size": 391199,  "exceeds_cap": true,  "duplicate": false},
  {"ordinal": 3, "depth": 2, "text": "Lease Agreement.pdf",
   "size": 464,     "exceeds_cap": false, "duplicate": false},
  {"ordinal": 4, "depth": 2, "text": "Invoice 2025-044.pdf",
   "size": 1075,    "exceeds_cap": false, "duplicate": true}
 ], "truncated": false}
以每次 40K 的大小分页读取一篇数 MB 的笔记,技术上可行,实际上却毫无用处,因此优先使用大纲:通过 read_note(path, section="Lease Agreement.pdf") 读取所需的一个部分。部分支持三种寻址方式:大纲中显示的 #N 序号、Parent/Child 路径形式,以及精确的标题文本。只有序号能区分重复的同级标题;它们共享所有祖先,因此无法通过路径消除歧义。批量提取生成的笔记往往充斥这类标题。
单独的 #N 始终按位置选择,因此我们在大纲中提供的序号不会被恰好名为 #2 的标题覆盖。这类标题仍可通过路径形式(Parent/#2)或其自身的序号访问。
大纲本身也受上限约束:如果笔记包含数千个标题,就会返回截断后的列表,其中会报告省略的部分数量(omitted)和完整的序号范围(first_ordinal、last_ordinal),而不会让大纲比它所伴随的内容窗口还大。无法纳入预算的元数据会整项丢弃,并在 metadata_omissions 中报告——绝不会截断,也绝不会在字段内部标记,因此笔记控制的字段中不会出现前缀或服务端说明文字。frontmatter_yaml 是 frontmatter 块的 YAML 源文本,已移除围栏行并统一为 LF 换行符(与 content 中声明的终止符残留相同);它是权威副本,其旁边的 frontmatter JSON 视图仅供便利使用,当 YAML 包含 JSON 无法表示的内容时,会附带原因一并省略。
limit 可以降低单次调用的上限,但不能提高上限。如果客户端确实需要读取更多内容,请提高 MAX_READ_RESPONSE_CHARS——这是由了解部署情况的运维人员一次性作出的决定。
升级说明: 有三项明显的契约变更。
过去,
read_note对大型笔记会返回全文;现在会截断。响应会说明自身状态,因此 Agent 无需预先了解情况即可继续读取,但假设会读取整篇笔记的脚本应改为传入section=或提高上限。另外,过去
read_note会返回一个渲染后的字符串——先是# <title>/**Path:**标头,再是\n---\n分隔符,最后是内容。现在改为返回字段,因为该标头的每个部分都受笔记内容控制:笔记可以伪造分隔符,导致通过拆分响应来恢复部分正文的 Agent 取回一段精心构造的字符串,并将其写回覆盖该部分。解析旧封装格式的客户端应改为读取content(读取部分时还要读取heading);忽略structuredContent的客户端仍会收到明确无歧义的 JSON 文本块。面板会话现在存储为服务端记录,因此升级时所有人都会退出一次登录。 升级前签发的 Cookie 不包含会话标识,因此会被拒绝,而不会获得过渡性兼容——如果继续接受,就会在修复发布后再额外保留七天的旧重放窗口。请重新登录;无需迁移任何内容。
速率限制
此服务的使用方是 Agent,触发重试风暴或受到提示词注入的 Agent 都是普通输入。三项控制措施限制单个凭据创建工作负载的速度。
- 通用令牌桶——
MCP_RATE_LIMIT_PER_MINUTE(600)持续速率、MCP_RATE_LIMIT_BURST(120)容量——适用于每次工具调用。 - 写入令牌桶——每分钟 120 次、突发容量 30 次——除通用令牌桶外,八种会修改保险库的工具还必须通过此限制,
PUT /transfer/upload也会消耗此额度;额度计入签发能力令牌的主体,避免通过签发链接并兑换链接来绕过写入速率限制。 /mcp认证失败时的按地址预算——每 5 分钟失败 60 次——在查询凭据前检查,因此被拒绝的探测不会触发数据库查询。
令牌桶按主体划分:可以是 API 密钥,也可以是 OAuth 授权。刷新访问令牌会沿用同一额度,不会生成新的额度;对同一客户端进行两次独立的 /authorize 授权,会获得彼此独立的额度。
Agent 实际看到的内容。 拒绝会作为普通工具结果返回——绝不会是协议错误,也不会是悄无声息的空结果集——并以一行机器可读内容结尾:
Error: this credential exceeded its general rate limit of 600 calls per minute, so the call was refused before it ran. Nothing was read, written, or counted against the daily quota. Retry in 1 seconds, or slow the calling loop down.
MCP-REFUSAL {"code":"rate_limited","scope":"principal","limit":600,"limit_unit":"calls_per_minute","retry_after_seconds":1}
MCP-REFUSAL 标记位于行首,JSON 也只占一行,因此即使被引用到对话记录中,也能保留下来。结构化工具会在其声明的错误字段中返回完全相同的文本。只有等待确实有帮助时,才会包含 retry_after_seconds——对于未分配保险库或无法编码的参数,拒绝结果会省略此字段,以免引发无法终止的循环。每日配额(over_quota)、查询长度上限(argument_too_long)以及工具正文中的拒绝情况(如 not_found、already_exists 和 invalid_path)都采用相同的格式。部分写入也会携带类型化结果:重试前请先阅读说明,因为部分字节可能已经更改。空搜索结果和成功的无操作调用仍视为成功。
传输层拒绝不属于此契约,因为没有工具调用可供响应:超出预算的未认证请求,或被强制实施的 MCP 请求/认证并发限制拒绝时,都会返回带有 Retry-After 的 HTTP 429。超出速率限制的 PUT /transfer/upload 也会返回相同响应;此时会释放其声明,而不是消耗它,因此同一链接在令牌桶补充后仍可兑换一次。
运维说明。
- 限速器状态保存在进程内,不会持久化,因此重启后所有令牌桶都会重新满额。只有在容器以
--workers 1运行时,这种做法才可靠;增加工作进程数量会使上述所有速率按工作进程数量倍增。 /admin/performance会将拒绝显示为拒绝计数,而不是延迟百分位数。重复的速率限制拒绝和强制并发限制拒绝会合并记录——每个MCP_REFUSAL_LOG_INTERVAL_SECONDS时间段内,每个凭据/工具/范围仅记录一行,每行代表1 + suppressed次拒绝——避免拒绝循环导致写日志本身成为负载。- 速度限制的默认值是根据少量样本估算的。请先查看一周的
/admin/performance数据,再将这些值视为定值;如需禁用某项限制,可将其设为空值、null或none(启动时会拒绝零值)。 - 每日配额是持久化的上限,与上述限制相互独立:从现在起创建的密钥,如果未指定配额,将采用
DEFAULT_DAILY_REQUEST_LIMIT(5,000);面板中的空白字段也会采用默认值。只有管理员才能显式地将密钥设为无限制。已有密钥会保留原有设置;OAuth 授权则完全没有每日上限,只有速度限制。 - 每个新密钥都是拥有完整突发额度的新主体,因此创建密钥也有自己的预算:每个账户每小时最多 10 个密钥,每个客户端地址每小时最多 20 个密钥;JSON API 和面板表单共享此预算。非管理员账户最多可持有 25 个有效密钥。
设计依据见docs/architecture/rate-limits.md。
并发准入
并发准入随 MCP_CONCURRENCY_MODE=shadow 一起提供。它会在现有使用记录的 concurrency_shadow 下记录压力,并针对请求/身份验证压力发出有界的安全事件。调用会保留其实际结果、配额统计和耗时。影子模式以零等待观察当前占用;它不会预测流量在强制执行时的表现。
在 enforce 模式下,服务会限制完整 MCP 请求(包括已打开的 SSE 流)、身份验证数据库会话、工具和使用日志写入器。工具会先通过速率、保险库和参数检查,再获取并发槽位;之后才会检查每日配额。被拒绝的工具会收到 slot_timeout,且不会消耗每日配额。零等待表示立即准入或拒绝;正等待时间会使用有界队列和单一截止时间。重试提示并不保证正在运行的调用会在该时间内完成。
四类工具的默认并发调用数均为 1:semantic_search 使用 embedding,find_related 使用 vector,八个会修改保险库的工具使用 write,其余工具使用 other。全局、租户和主体上限默认分别为 4、3 和 2。OAuth 刷新会保留同一主体。完整请求和每个 bearer 的上限默认分别为 32 和 4,身份验证上限为 2,使用记录写入器上限为 1。所有设置和队列限制均列在 .env.example 中。
启动时会按 auth + 2 × tools + writers + 4 ≤ 15 验证连接池预算。预留的 4 个连接由面板、OAuth、索引和传输工作共享;当这些其他使用者耗尽连接时,仅凭此算式无法保证连接可用。影子模式不会强制执行该预算。控制器在进程内运行,要求沿用现有的单工作进程部署方式。
启用 enforce 前,请检查压力观测数据和长时间运行的流的占用情况。选择 off 可禁用并发准入;现有的速率限制和每日配额仍然适用。影子模式要求工具等待时间为零,而且绝不会添加写入器等待,也不会因观测到的压力而丢弃使用记录。
架构
┌──────────────┐                       ┌──────────────────────┐
│ MCP clients  │   HTTP + Bearer key   │   FastAPI app        │
│  Claude Desk │ ────────────────────▶ │  ┌────────────────┐  │
│  Claude Code │                       │  │  MCP server    │  │
│  n8n agents  │                       │  │  (28 tools)    │  │
│  OpenWebUI   │                       │  └─────┬──────────┘  │
└──────────────┘                       │        ▼             │
                                       │  ┌────────────────┐  │
                                       │  │  Services:     │  │
                                       │  │  - vault       │  │
                                       │  │  - search      │  │
                                       │  │  - embeddings  │  │
                                       │  │  - links       │  │
                                       │  │  - indexer     │  │
                                       │  └─────┬──────────┘  │
                                       │        ▼             │
                                       │  ┌────────────────┐  │
                                       │  │ Postgres +     │  │
                                       │  │ pgvector       │  │
                                       │  └────────────────┘  │
                                       └──────────┬───────────┘
                                                  ▼
                                       ┌────────────────────┐
                                       │  Embedding         │
                                       │  provider          │
                                       │  (Ollama / OpenAI) │
                                       └────────────────────┘
索引流水线
.md files in vault
    ↓ skip dot-dirs
parse frontmatter, extract tags (YAML + inline #hashtags)
    ↓ SHA-256 hash
skip if unchanged
    ↓
UPSERT notes_metadata (path, title, tags[], frontmatter JSONB,
                       content_hash, tsvector, modified_at)
    ↓
extract wikilinks/embeds/markdown-links → resolve targets →
note_links (source_id, target_id or NULL for dangling)
    ↓
chunk content (512 tokens, no overlap) → embed via provider →
note_embeddings (note_id, chunk_index, chunk_text, embedding[N])
    ↓
set embedded_content_hash = content_hash
索引器会在启动时运行,之后每隔 INDEX_INTERVAL_SECONDS 运行一次(默认 5
分钟)。哈希仅基于内容,因此变更检测器会忽略 mtime 抖动。陈旧的嵌入向量会通过
embedded_content_hash != content_hash 不匹配来检测。
数据库架构
| 表 | 用途 |
|---|---|
notes_metadata | 路径、标题、标签、frontmatter、内容哈希、嵌入哈希、tsvector、修改时间 |
note_embeddings | 每个分块一行。embedding 的类型为 vector(EMBEDDING_DIMENSIONS)。 |
note_links | Wikilink 图:源/目标 ID、target_path、类型(link、embed、markdown) |
api_keys | 哈希后的 bearer 令牌、用于显示的前缀、权限、过期时间 |
usage_logs | 每次工具调用的审计记录 |
oauth_clients、oauth_codes、oauth_tokens | OAuth 2.0 PKCE 状态,包括用于关联同意授权令牌的 grant id |
transfer_tokens | /transfer/* 链接对应的能力记录:方向、目标路径、状态、指纹、过期时间 |
users | 多用户模式:登录名、角色、每位用户的 vault_path,以及最近一次构建索引时使用的保险库 |
user_sessions | 每个正在使用的面板浏览器会话对应一条可撤销记录,以 Cookie 的会话 ID 的 SHA-256 值作为键。删除用户时级联删除。 |
在 content_tsvector 和 tags[] 上建立 GIN 索引。在常用外键上建立 B-tree
索引。pgvector HNSW 表达式索引
(embedding::halfvec(N)) halfvec_cosine_ops(m=16, ef_construction=64),
在维度 ≤ 2000 时构建;结果会按全精度距离重新排序。查询会设置
hnsw.ef_search=80,并在 Python 中以 5 倍过量获取结果后按笔记去重。
项目布局
src/
  main.py             FastAPI app, lifespan, MCP mount
  config.py           pydantic-settings
  database.py         async SQLAlchemy engine/session
  models/db.py        ORM models
  mcp_server/         MCP server, tools, auth middleware
  services/           vault ops, anchored filesystem, search, FTS,
                      embeddings, links, indexer, transfer
  transfer/           public /transfer/* capability-redemption routes
  auth/               login, sessions, per-request identity context
  api/                control-panel REST endpoints
  control_panel/      Jinja2 templates and static assets
  oauth/              OAuth 2.0 authorization-code flow
alembic/              database migrations
scripts/              one-off ops scripts (e.g. reset_embeddings.py)
tests/                pytest suite + smoke-test docs
openspec/             change proposals (spec-driven workflow)
开发
pip install -r requirements-dev.txt
pytest
单元测试套件涵盖嵌入提供方抽象、OpenAI 批处理与重试行为、配置验证,以及维度不匹配启动检查。依赖网络的测试使用 respx 模拟 httpx,因此不需要访问真实网络。
requirements*.txt 中的依赖版本均通过 == 精确锁定,并由 Renovate 更新;renovate.json 将 mcp 限制在 2.x 以下(2.x 迁移对应议题 #365,不属于常规更新),并通过摘要锁定 Docker 基础镜像。
在 Docker 外运行服务:
DATABASE_URL=... SECRET_KEY=... VAULT_PATH=... uvicorn src.main:app --reload --no-proxy-headers
Make 目标
make init             First-time setup (data dirs, .env)
make build            Build Docker image (no cache)
make build-cached     Build Docker image (with cache)
make push             Push the image to the configured registry
make image            Build and push
make deploy           Build, scan, push, backup, migrate, recreate container
make up / down / restart / shell   Container lifecycle
make logs             Tail container logs
make db-init          Create database, user, and pgvector extension
make db-migrate       Run alembic migrations
make db-check         alembic check — schema vs. ORM models (must be clean)
make test-schema      Schema gate: migrations vs. models on a throwaway pgvector container
make db-backup        Dump database to backups dir (derived index tables schema-only; BACKUP_FULL=1 dumps their rows too)
make db-restore FILE=<path>   Restore from a backup
make reindex          Explain how to trigger a reindex (panel only; there is no headless trigger)
make reset-embeddings Drop and recreate embedding column at configured dim
make rebuild-tsvectors Recompute keyword index for FTS_CONFIGS (no embeddings, no API calls)
make status           Show container and health status
make audit            Audit Python dependencies (pip-audit)
make trivy            Scan the local image for HIGH/CRITICAL CVEs (SCAN_IMAGE=obsidian-mcp:local for the bundled stacks)
make clean            Remove containers and images (data preserved)
make deploy 会运行完整流水线:构建、镜像扫描、推送、数据库备份、alembic upgrade head,然后重新创建容器。任何包含迁移的部署前,都要运行 make test-schema;部署后则运行 make db-check。
安全说明
- API 密钥使用
omcp_前缀,并以 SHA-256 哈希形式存储。 原始密钥在创建时只显示一次。 - 控制面板应部署在外部身份验证网关之后。随附的
docker-compose.yml使用带 OAuth 链的 Traefik。不要将/admin直接暴露到互联网。 - 面板会话以服务端数据行的形式存储。签名 Cookie 携带一个 256 位随机 ID;数据库只存储其 SHA-256 哈希,因此数据库转储不包含可用的会话信息。退出登录会撤销该数据行;更改密码、管理员重置、停用账户或删除账户都会撤销该账户的所有会话。
- OAuth 同意页面会标明所请求授权的客户端信息:授权码将发送到的重定向主机名(取自 URI 的主机名,绝不取自其
netloc,并以 punycode 而非解码后的形式显示)、服务端生成的客户端 ID,以及注册日期。每次渲染页面都会说明该应用是自行注册的,且未经此服务验证;不在OAUTH_KNOWN_REDIRECT_HOSTS中的主机名会被标记为无法识别。 - OpenAI 密钥在设置页面上以
key[:8] + "..." + key[-4:]的形式显示,且不会在 HTML 或 JS 源码中完整出现。 - 服务层会阻止路径遍历,并由内核确保路径包含关系:每个 vault 根目录下的目录都通过一次
openat2(RESOLVE_BENEATH | RESOLVE_NO_SYMLINKS | RESOLVE_NO_MAGICLINKS)从已打开的根目录描述符打开,之后的操作都会使用该描述符,而不会重新遍历路径名。 - 修改类工具会按指定路径操作。若最后一个路径组件是符号链接,则会拒绝操作并指出链接目标,而不是跟随链接,因此 vault 内的别名无法重定向写入。读取操作仍会跟随链接,这正是别名的用途。
- 每个路径防护都会拒绝隐藏组件,因此所有工具都无法访问
.obsidian、.git、.trash等目录。 - 传输链接会将令牌放在 URL 片段中,浏览器不会发送该片段;令牌只能通过
Authorization: Bearer请求头兑换。请在反向代理和 APM 中关闭请求头日志记录。对于未知、过期、已使用和已撤销的令牌,公开路由都会返回完全相同的 404;具体状态由经过身份验证的check_upload工具提供。 import_from_url只会从真正公开的地址获取内容,并会在每次重定向时重新应用明确的拒绝列表。/mcp身份验证失败次数按客户端地址限制,并在查询凭据之前计数,因此被拒绝的探测不会创建数据库会话,也不会执行查询。地址取自应用信任的代理请求头,绝不直接读取某个请求头;没有可解析地址的请求会计入共享额度,而不会被豁免。此限制约束的是未经身份验证的调用方能够强制触发的数据库工作;它并非针对猜测 256 位密钥的防御措施。请参阅速率限制。- 所有查询均使用参数化查询。绝不将字符串插值到 SQL 中。
- 响应头包含 HSTS、
X-Content-Type-Options: nosniff、X-Frame-Options: DENY和Referrer-Policy: no-referrer。面板、登录和同意页面会为每个响应添加带 nonce 的 Content-Security-Policy,且不允许内联脚本(PANEL_CSP)。 - 应用自身各跳的传输安全会在启动时检查:数据库遵循
DATABASE_SSL_MODE,嵌入端点必须使用https或回环地址,除非EMBEDDING_ALLOW_PLAINTEXT另有设置。每次启动都会为每一跳记录一条传输日志;对于仍使用明文传输的每一跳,还会记录一个internal_transport_plaintext安全事件。
状态
由单人维护,目前作为维护者的个人外部认知系统积极使用 (2,500 多条笔记,多个互联 Agent)。向所有想要分叉的人开放。欢迎提交 Issues 和 PR,但请做好迎接明确主张的评审的准备。 这是一个正在使用中的系统,而非通用平台。
已列入官方 MCP Registry,名称为 io.github.maxkuminov/obsidian-mcp,每次发布版本标签时都会从
server.json 发布,并收录于
Glama。这两个目录条目都使用了本 README 顶部的标语:供 AI Agent 使用的记忆系统,以纯 Markdown 格式存储,可在 Obsidian 中打开。
许可证
MIT。请参阅 LICENSE。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。