关于 Stats Explorer
Stats Explorer 是用于本地数据文件统计分析的 MCP 服务,供 AI 助手执行检验和数据探索。它通过逐步确认、可解释结果及可选的 Jev 独立检查来约束分析流程。
主要功能
- 0118 种统计与分析工具
- 02检验与 A/B 测试分析
- 03六步假设检验流程
- 04读取本地 CSV、TSV、Excel 和 Parquet 文件
- 05图表及 HTML 或 Markdown 报告
- 06可选 Jev 审核
适用场景
- 01检验实验版本是否改变转化率
- 02探索分布并汇总类别数据
- 03比较组别并找出差异组
- 04根据已确认的分析生成报告
MCP 相关
向 MCP 客户端提供统计和分析工具,用于分析获准读取的本地数据文件。还可连接 Jev MCP 服务进行可选检查。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
npx -y stats-explorer-mcpSTATS_EXPLORER_ROOTSFolders the tools may read data files from and write reports to (separated by : on macOS/Linux, ; on Windows). Defaults to the client's workspace roots, or the current directory.STATS_EXPLORER_STREAM_MBCSV/TSV/Parquet files above this size (MB) are streamed in parallel passes; any size works. Default 512.STATS_EXPLORER_WORKERSParallel readers for large files. Default: all CPU cores but one (max 16).STATS_EXPLORER_CACHEKeep columns read from large files for fast follow-up questions: ask (default), on or off.STATS_EXPLORER_CACHE_DIRFolder for saved large-file columns. Default: the system temp folder.STATS_EXPLORER_MAX_FILE_MBRefuse data files larger than this (MB). Default: no limit.STATS_EXPLORER_GUIDEDon (default): classify each request and follow the six-step workflow for hypothesis tests. off: expose the individual test tools directly.STATS_EXPLORER_CONFIRM_SELECTIONSon (default): the user confirms every column, chart type and report section before anything runs. off: run with the AI's choices.STATS_EXPLORER_CONFIRM_VIAauto (default): forms where the client supports them. chat: always ask in the conversation (recommended for Claude Code).STATS_EXPLORER_HIDE_LINKSet to 1 to remove the one-line Stats Explorer app link from results.STATS_EXPLORER_JEVIndependent checks by Jev (TypeSafe): off (default), cooperate (the AI calls your Jev MCP server), enforce (Stats Explorer calls the Jev API) or orchestrated (signed decisions from an orchestrator).STATS_EXPLORER_JEV_CHECKPOINTSComma list of plan, conclusions, data. Default plan,conclusions (data sends column names and text samples to Jev).TYPESAFE_API_KEY密钥Enforce mode only: TypeSafe API key Stats Explorer uses to call Jev.STATS_EXPLORER_APPROVAL_SECRET密钥Orchestrated mode only: shared secret (32+ characters) the orchestrator signs decisions with.STATS_EXPLORER_AUDIT_LOGPath of a JSON Lines file recording every Jev checkpoint decision.本地服务需要在你的电脑上安装运行环境(如 Node.js 18+)。各客户端的配置文件位置不同,请参考客户端文档。
工具
23收录的工具列表 · 更新于 5 天前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| file | string | 否 | 用户指定或附加到聊天中的数据文件(CSV、TSV、Excel 或 Parquet):传入其路径或名称,切勿传入文件内容。支持大型文件。 |
| mode | enum | 是 | 用于描述、比较、排序、总结、绘图或发现模式(大多数分析问题)的 "explore";用于检验差异或关系是否显著或真实的 "hypothesis_test"。hypothesis_test | explore |
| question | string | 是 | 用用户自己的措辞表述其请求。 |
详细介绍
Stats Explorer MCP
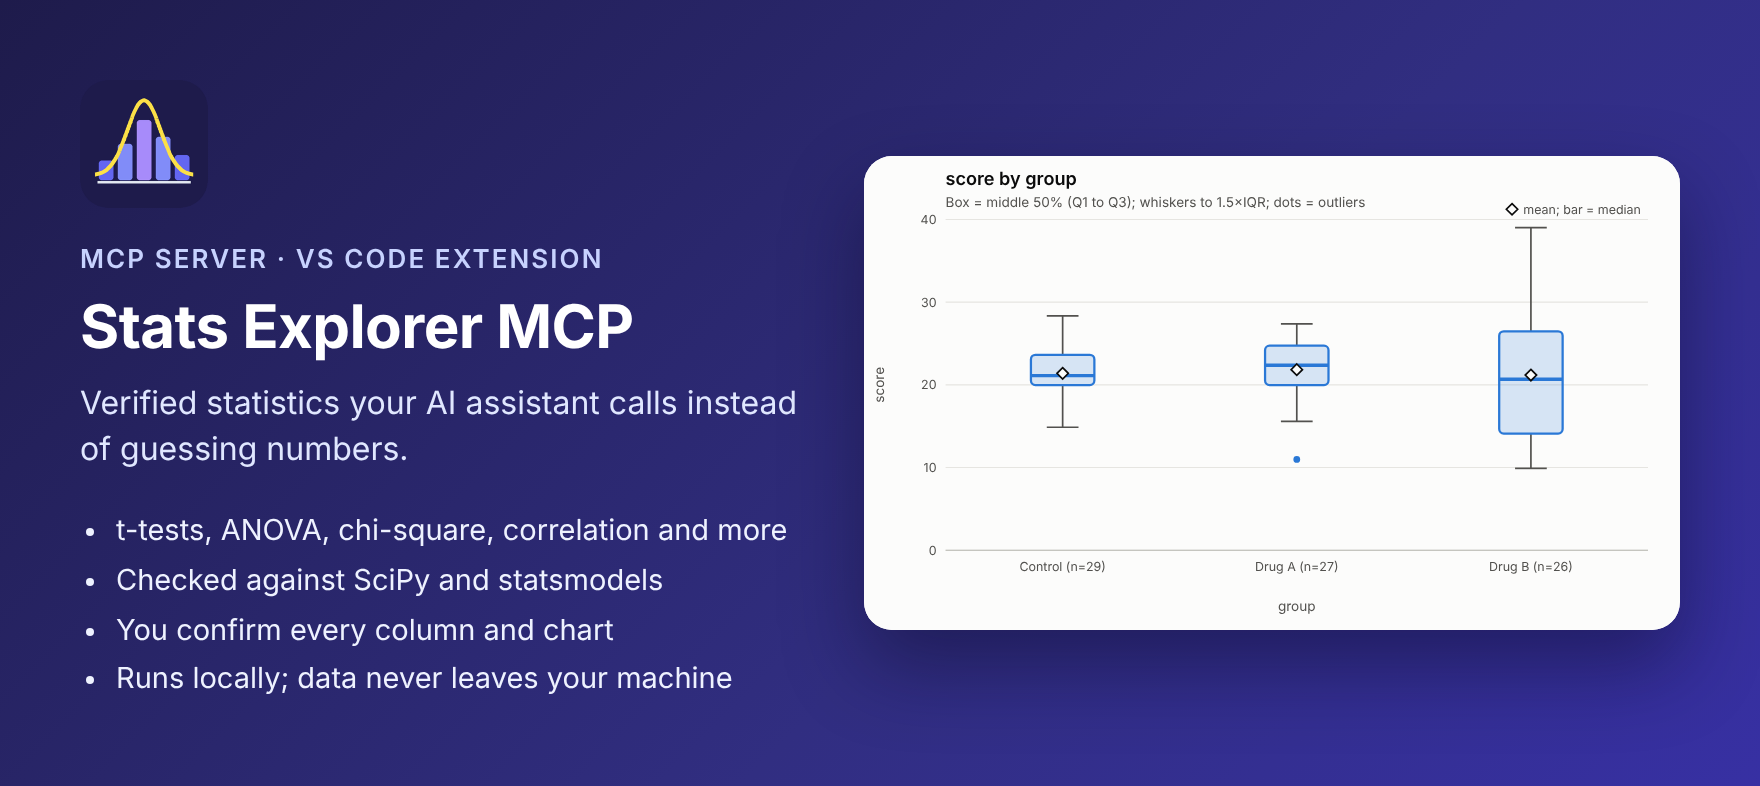
一个 MCP 服务,提供 18 种统计和分析工具,AI 助手可以调用这些工具,而不必猜测数字;支持任意大小的数据文件:
- 检验: t 检验、z 检验、ANOVA(含 Tukey HSD 事后检验,可指出存在差异的组)、ANCOVA、MANOVA、卡方检验、Fisher 精确检验、二项检验和相关性检验。
- A/B 测试: 针对转化率和收入类指标的 A/B 与 A/B/n 分析结果(提升幅度及区间、样本比例失配检查、Holm 校正比较、优于对照组的贝叶斯概率、细分结果),以及样本量规划。
- 分析: 按类别汇总总量、平均值和计数(前 N 项),并跨所有列对“什么因素驱动 X?”进行排名。
- 辅助工具: 描述性统计、置信区间、功效分析、“我该使用哪种检验?”工具,以及数据文件检查器。
这些工具可按列名读取开发者的 CSV、TSV、Excel 或 Parquet 文件,因此无需将大型数据集粘贴到聊天中。每个结果都包含:
- 效应量和置信区间,
- 通俗易懂的解释,
- 假设条件可能不稳妥时发出的警告。
此外:
- 准确。 每次提交都会使用 SciPy 和 statsmodels 对照 43 个参考案例进行检查,精度至少达到 6 位有效数字。
- 默认提供引导。 Agent 会先判断你的请求需要假设检验还是只需探索。假设检验会按照 Stats Explorer 的 Bring it all together 指南依次遵循六个步骤。
- 由你掌控。 Agent 提议的每一列、每个组、图表类型和报告部分都会显示出来,供你确认或修改,然后才会运行。
- 注重隐私。 在本地通过 stdio 运行。不会发出任何网络请求,也不需要 API 密钥(除非你启用下文的 Jev 强制模式)。数据文件仅读取自你的工作区文件夹。
- 可按需由 Jev 检查。 将 Jev(TypeSafe 的快速判断模型)连接到它旁边,Jev 会独立检查检验计划,以及助手根据计算结果撰写的结论。你可以在不使用编排器的情况下运行,由 Stats Explorer 自行强制执行;也可以在生产级编排器下运行,由其为每项决策签名。
引擎、文件导入功能和六步指南与 Stats Explorer 应用共享,因此结果与应用完全一致。
连接方式(选择你的助手)
VS Code 中的 GitHub Copilot:约 1 分钟,无需安装其他内容
- 在 VS Code 中,打开 扩展(Ctrl+Shift+X / Cmd+Shift+X),搜索 Stats Explorer MCP,然后点击 安装。
- 打开 Copilot Chat,将模式下拉菜单切换为 Agent。
- 点击聊天框中的 工具图标,确认列表中显示并勾选了 Stats Explorer。
- 打开存放数据的文件夹,然后提出问题(参见示例问题)。
此扩展使用 VS Code 内置运行时自行注册服务,因此你无需 Node.js 或 mcp.json 文件。确认提示会以表单形式显示,你可以编辑表单。
Claude Code(终端或 VS Code 中的 Claude Code 面板):约 2 分钟
你需要安装 Node.js 22 或更高版本(推荐使用 24 LTS)。在终端中运行一次:
claude mcp add -s user stats-explorer -e STATS_EXPLORER_CONFIRM_VIA=chat -- npx -y stats-explorer-mcp
claude mcp list
claude mcp list 应显示 stats-explorer … ✓ Connected。然后启动新的 Claude 会话,因为服务会在会话启动时加载。在 VS Code 中:Ctrl+Shift+P → Developer: Reload Window,然后选择 New session。在聊天中输入 /mcp,即可查看该会话可用的服务。
-s user会使其在每个文件夹中都可用(不加此参数,则仅在运行命令的文件夹中可用)。STATS_EXPLORER_CONFIRM_VIA=chat会将确认请求作为聊天消息显示,你可以通过回复来回答。Claude Code 不一定总会显示表单式提示。- 如果已安装 VS Code 扩展,Stats Explorer: Copy Setup Command for Claude Code 会为你复制此命令。
Claude Desktop、Cursor、Windsurf、Cline 和其他 MCP 客户端
将以下内容添加到客户端的 MCP 配置中(例如 claude_desktop_config.json、.cursor/mcp.json),然后重启客户端:
{
  "mcpServers": {
    "stats-explorer": {
      "command": "npx",
      "args": ["-y", "stats-explorer-mcp"],
      "env": { "STATS_EXPLORER_ROOTS": "/path/to/your/data", "STATS_EXPLORER_CONFIRM_VIA": "chat" }
    }
  }
}
需要 Node.js 22 或更高版本。STATS_EXPLORER_ROOTS 是工具可读取的一个或多个文件夹;请参阅数据文件。
示例问题
在消息中注明文件名(或附上文件);助手会将其传递给工具,绝不会把数据粘贴到聊天中。
- sales.csv 里有什么?
- 按州统计 sales.csv 中的总收入,列出前 10 名。(group_summary)
- sales.csv 中哪些因素会影响利润?(find_relationships,然后继续追问)
- 展示订单金额的分布,以及按细分群体划分的箱线图。
- Consumer 和 Business 细分群体的平均利润是否不同?差异是否显著?(六步假设检验)
- 新的结账页面(variant B)是否提高了 experiment.csv 中的转化率?请按设备细分。(ab_test)
- 如果每天有 3,000 名访客,要检测 4% 转化率提升 10%,需要多少访客?(ab_test_plan)
- 三个地区的收入是否不同?具体是哪些地区?(ANOVA + Tukey HSD)
- 将分析结果制作为 HTML 报告,并保存为 findings.html。
analyze、explore_data 和 hypothesis_test 提示词(VS Code 和 Claude 中的斜杠命令)会启动相同的工作流。
与 Jev 协作(可选)
当 Stats Explorer 和 Jev MCP 服务同时连接到 Claude 或 Copilot 时,它们会分工协作。Stats Explorer 负责计算所有数值,Jev 会在你查看结果前检查两件事:
- **检验计划:**检验方法是否恰当、假设是否正确、列是否选对?
- **书面结论:**每个数值是否一致?“显著”的说法是否正确?是否声称了分析无法支持的因果关系?
Stats Explorer 还会对每项结论执行自己的数值和显著性检查。只有通过检查的结论才会纳入报告,每份报告都会在独立检查下列出所有检查项。
| 模式 | 将 STATS_EXPLORER_JEV 设为 | 谁调用 Jev | 适用场景 |
|---|---|---|---|
| 协作 | cooperate | 助手通过你的 Jev MCP 服务调用,并使用 Stats Explorer 准备的数据包 | 在 Claude Code 或 Copilot 中工作,且不使用编排工具 |
| 强制 | enforce(另加 TYPESAFE_API_KEY) | Stats Explorer 直接通过 Jev API 调用 | 助手无法跳过或更改的检查 |
| 编排 | orchestrated(另加 STATS_EXPLORER_APPROVAL_SECRET) | 你的编排器(LangGraph、Temporal、Step Functions 等)负责签署每项决策 | 带审计日志的生产流水线 |
使用 Claude Code 快速开始(无需编排器):
claude mcp add -s user jev -e TYPESAFE_API_KEY=YOUR_KEY -- npx -y @jkudish/jev-mcp
claude mcp add -s user stats-explorer -e STATS_EXPLORER_JEV=cooperate -e STATS_EXPLORER_CONFIRM_VIA=chat -- npx -y stats-explorer-mcp
npx -y stats-explorer-mcp init-jev     # adds routing rules to CLAUDE.md and .github/copilot-instructions.md
任何 Jev MCP 服务都可使用(@jkudish/jev-mcp、jev-mcp、typesafe-mcp 等):数据包会采用相应工具所需的格式。在 VS Code 中,设置 Stats Explorer › Jev: Mode。各种模式和设置、签名审批格式(含 JavaScript 和 Python 示例)、发送给 Jev 的内容,以及可运行的编排器示例(位于 examples/orchestrator/),请参阅 docs/JEV.md。
工作原理(默认)
1. Agent 对你的请求进行分类
每次分析都从 start_analysis 开始,由 Agent 选择一种模式:
| 你的请求听起来像是…… | 模式 | 处理方式 |
|---|---|---|
| “药物会改变评分吗?”、“A 比 B 好吗?”、“这种差异显著吗?” | hypothesis_test | 执行以下六步工作流 |
| “总结……”、“展示……的分布”、“按 Y 绘制 X 图表”、“平均值是多少,置信区间是多少?” | explore | 仅使用描述性工具和图表:不提出假设、不计算 p 值,报告中也不包含假设部分 |
如果请求不明确,Agent 会按指示向你询问。在调用 start_analysis 之前,不会运行其他任何操作。
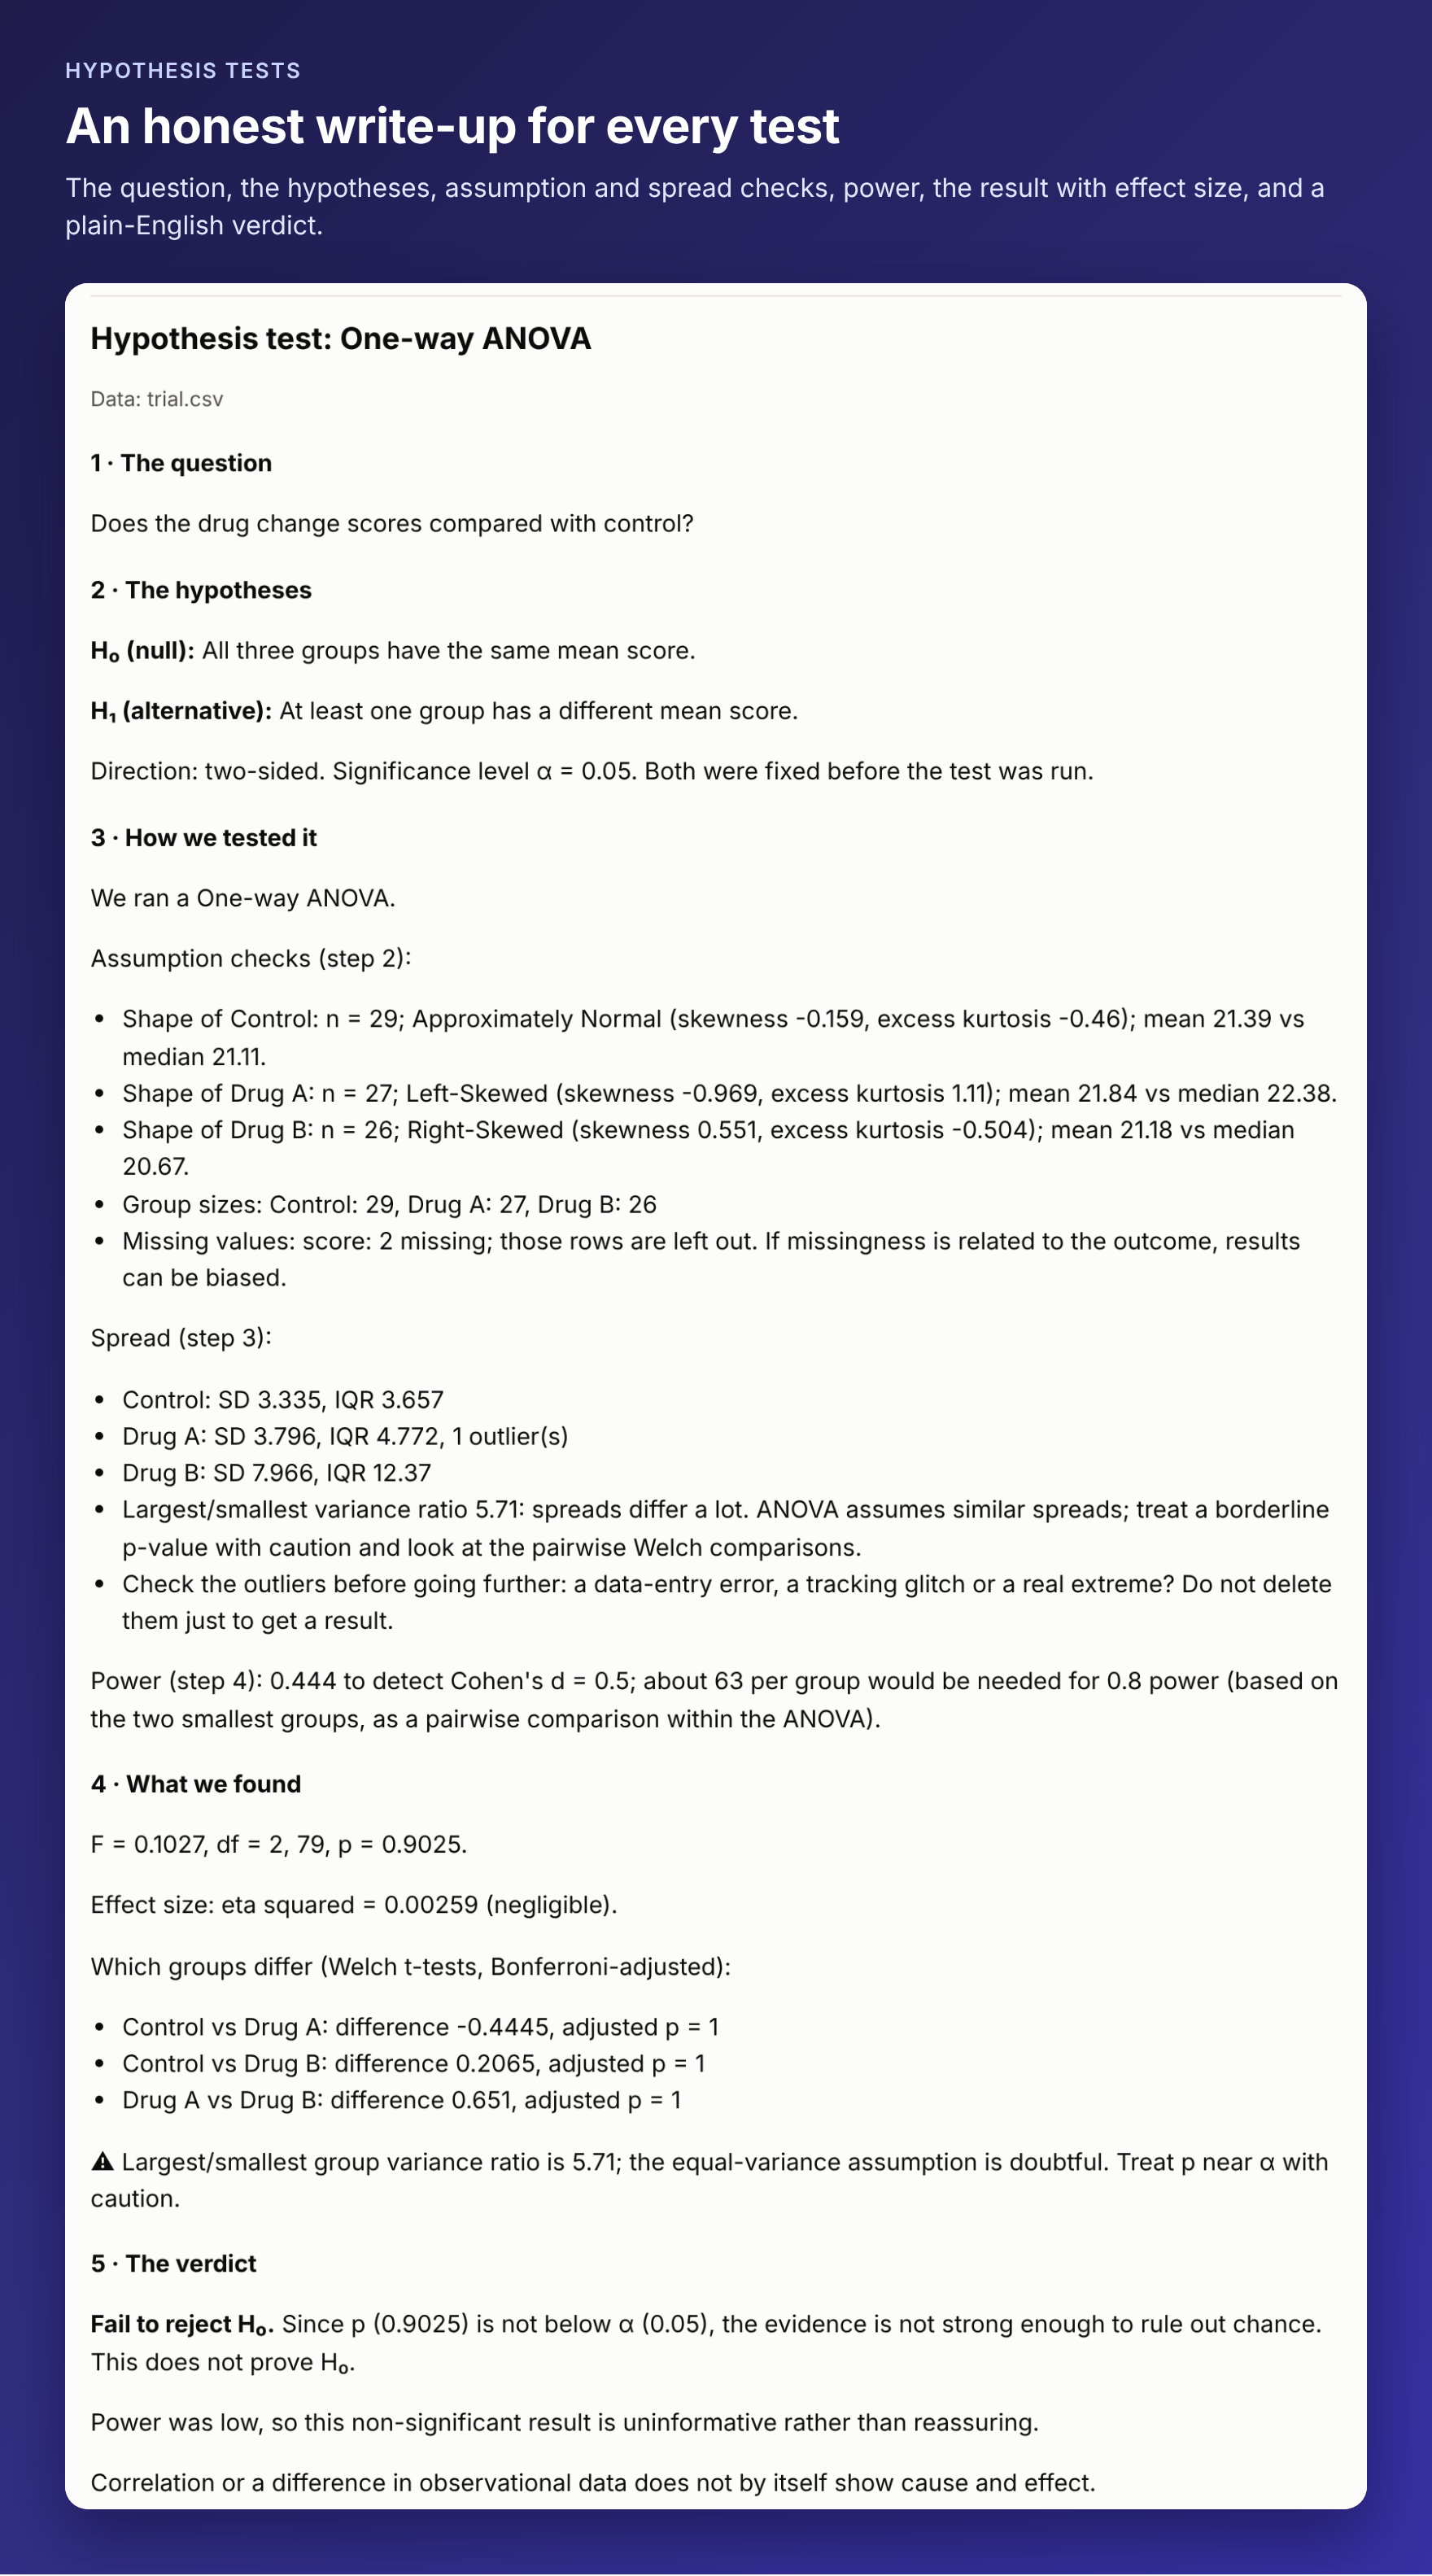
2. 假设检验按顺序执行六个步骤
| 步骤(来自应用的 Learn 选项卡) | 工具 |
|---|---|
| 1. 陈述问题并选择合适的检验 | state_hypotheses:检验、列、组、H₀/H₁、方向和 α,均须在看到任何结果之前确定 |
| 2. 根据检验的假设验证数据 | check_assumptions:形状、小型偏态样本、组大小、离群值、期望计数、ANCOVA 斜率相等性、缺失值、“样本中缺少了哪些人?” |
| 3. 检查离散程度 | check_spread:标准差、四分位距、变异系数、离群值、方差比 |
| 4. 运行检验前先计算功效 | power_analysis:针对你关心的最小效应计算检验功效,并计算达到 80% 功效所需的样本量 |
| 5. 运行检验,然后如实报告 | run_test:严格运行你在第 1 步确认的检验,并给出 p 值、效应量、置信区间和结论 |
| 6. 根据基准率对罕见事件进行合理性检查 | base_rate_check(PPV/NPV);如果问题并非关于罕见事件,则使用 skip_step 并说明原因 |
如果未按顺序调用步骤,系统会拒绝并告知下一步。只有步骤 4 和 6 可以跳过,且必须说明原因,该原因会出现在报告中。如果步骤 2 显示所选检验不适用,可以在步骤 1 重新陈述计划,并从后续步骤重新开始。应用指南将此称为有原则的修订,而不是 p 值操纵。
3. 每项选择都由你确认
当 Agent 提议列、组、图表类型或报告部分时:
- 支持 MCP 表单(用户引导)的客户端(例如 VS Code)会向你显示一份表单,其中已将 Agent 的选择预先填入下拉菜单和复选框。你可以修改,然后接受或拒绝。拒绝后不会运行任何操作。
- 其他客户端会收到一条
CONFIRMATION NEEDED响应,其中列出提议、备选项和一次性令牌。Agent 会按指示向你展示选项,并且只有在你同意后才使用令牌再次调用。令牌仅适用于发放时对应的确切选择,因此如果选择发生变化,系统会再次提出供你确认。
在同一会话中,你已确认的选择不会被重复询问。
4. 图表和报告
create_visualization:直方图、箱线图、散点图(带最小二乘拟合线)、条形图(按类别统计均值或数量)、折线图和饼图。这些是应用支持的图表类型。返回无障碍 SVG(支持浅色和深色模式),也可以保存为.svg。build_report:仅在你提出要求时生成,并且只包含你勾选的部分。已完成的假设检验会按照应用的格式撰写报告,内容包括问题、假设、检验方法(步骤 2–4)、发现、结论和基准率。探索报告不会包含假设部分。报告默认保存为 HTML,也可保存为 Markdown,存放在你的工作区中;除非你明确要求,否则不会覆盖已有文件。
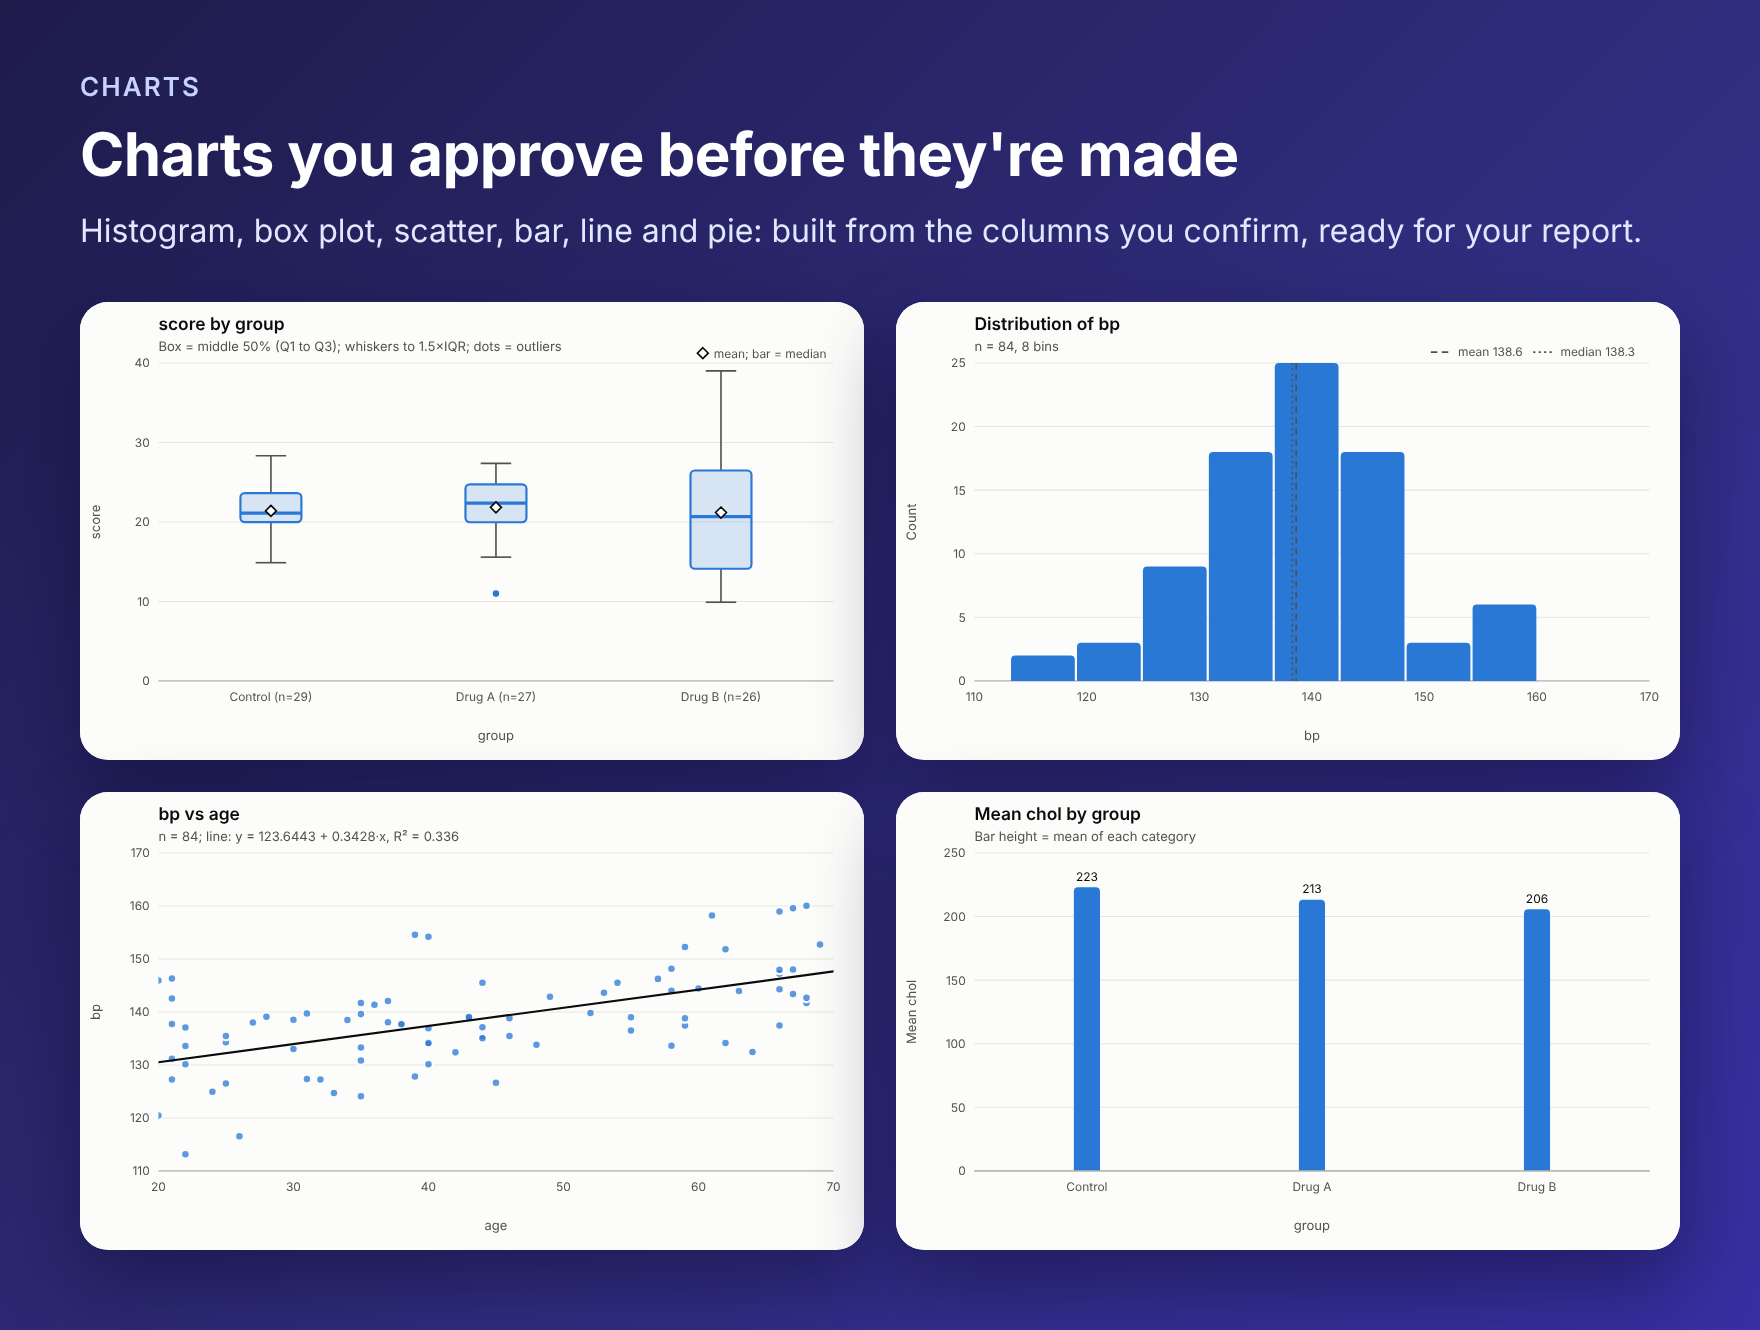
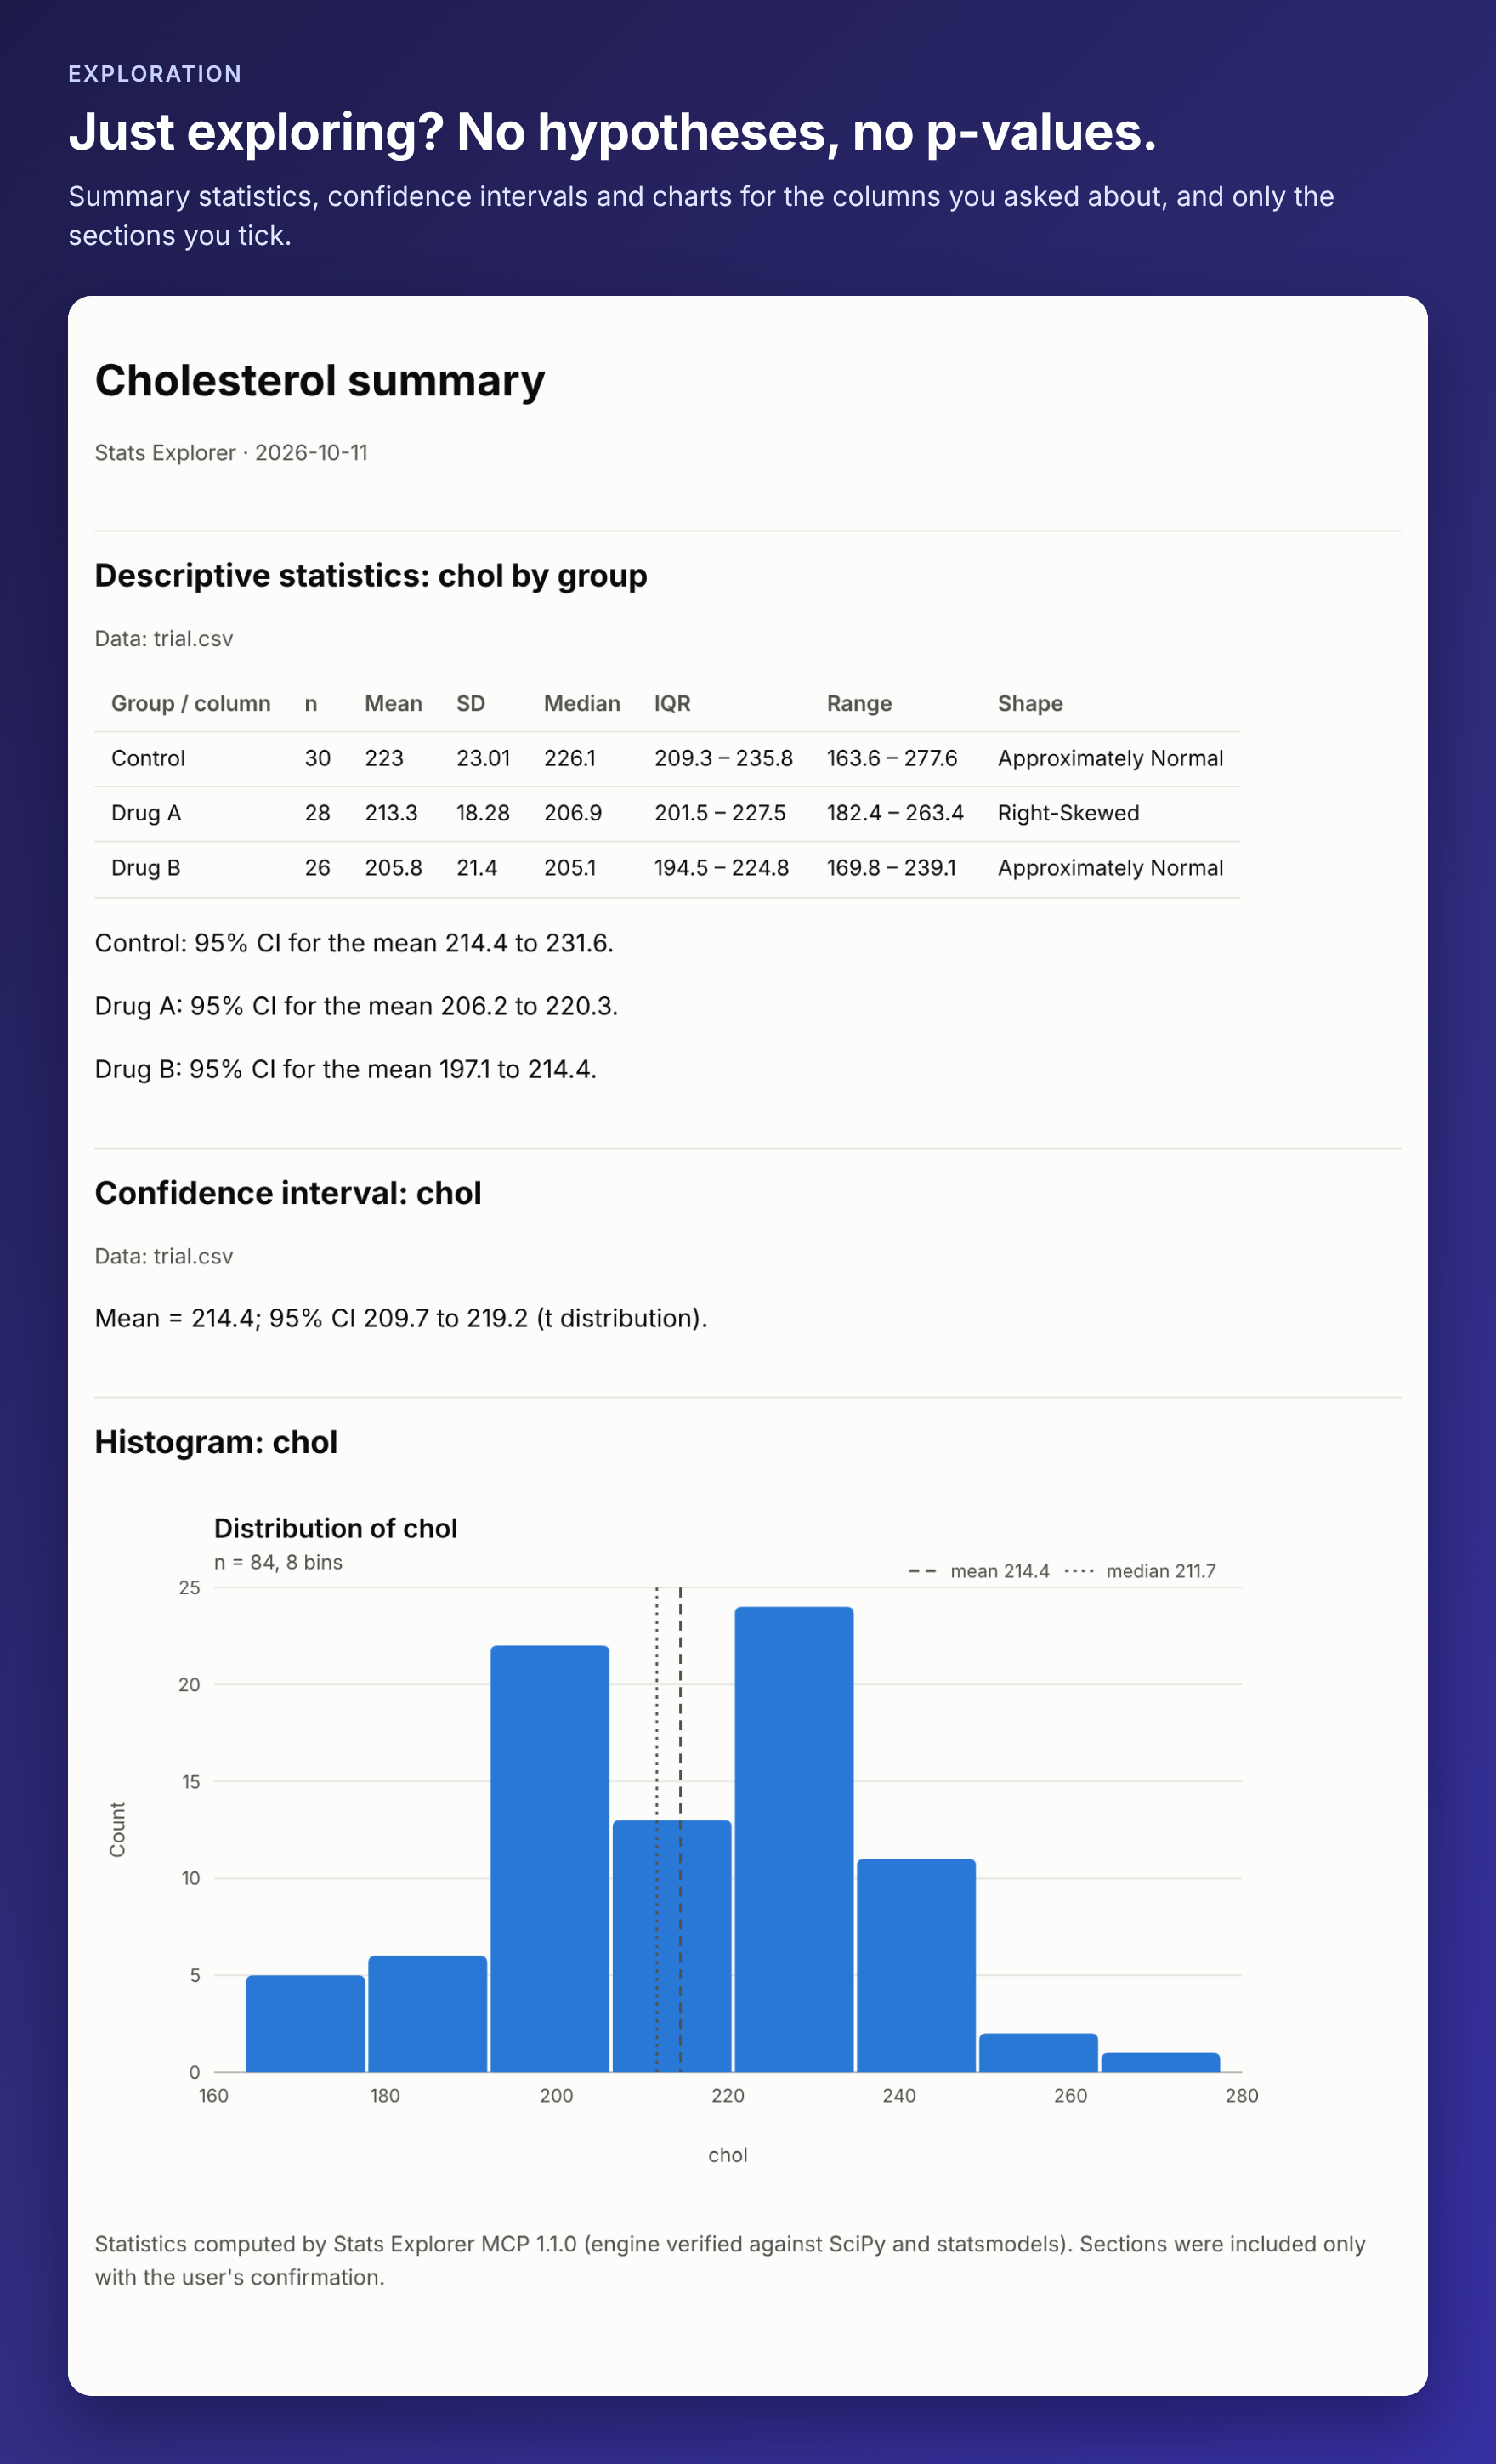
图片展示了示例数据集的实际输出。
工具
| 工具 | 用途 |
|---|---|
start_analysis | 将请求分类(假设检验或探索) |
inspect_data_file | 查看数据文件的列、类型、缺失值、类别和预览 |
choose_test | 为问题推荐合适的检验 |
state_hypotheses、check_assumptions、check_spread、power_analysis、run_test、base_rate_check、skip_step | 六个步骤 |
describe | n、均值、标准差、中位数、四分位数、范围、偏度、峰度、分布形态、均值置信区间(可按组查看) |
confidence_interval | 均值的置信区间(t)或比例的置信区间(Wilson) |
correlation | Pearson 或 Spearman r,含置信区间和拟合线,不含 p 值(显著性检验需经过步骤 1) |
group_summary | 按类别统计总数、平均值、中位数和计数;前 N 项(分析) |
ab_test_plan | A/B 测试所需的访客数和天数,或给定样本可检测到的最小提升幅度 |
find_relationships | 找出与数值型结果最相关的列(“X 的驱动因素是什么”) |
create_visualization、build_report | 创建图表和报告 |
workflow_status | 查看当前分析进度和已保存结果 |
large_file_plan、job_status、cancel_job、manage_cache | 处理超大文件:读取全部数据或样本、后台任务、保留列 |
步骤 1 中可用的检验:t 检验(单样本、配对、Welch 或 Student)、z 检验(已知 σ 的均值、比例)、单因素 ANOVA(含 Tukey HSD 事后检验,以及可选的 Bonferroni Welch 配对检验)、ANCOVA、MANOVA、卡方检验(拟合优度、独立性)、Fisher 精确检验、二项精确检验、相关性检验和 A/B 测试。
ANOVA 事后检验(Tukey HSD)。 每项包含 3 组或更多组的单因素 ANOVA 都会执行 Tukey HSD(组大小不等时使用 Tukey–Kramer),无论是内存中的文件还是超大文件:报告每一对的差异、调整后的 p 值和同时置信区间;显著的组对会标记 ★(“B > A”);并给出最佳组及其是否优于所有其他组,还会提供字母显示(共享同一字母的组之间无显著差异)。报告会列出存在差异的组。
A/B 测试(ab_test)。 可使用内联数字,或包含变体列和结果列的文件:
metric: "conversion"(是否转化):双比例 z 检验;计数较小时使用 Fisher 精确检验 p 值。metric: "continuous"(收入、时间、订单价值):Welch t 检验。- 对比每个变体与对照组:绝对提升(百分点)和相对提升,均附带置信区间;Cohen's h 或 d。
- 样本比例不匹配检查:根据计划的分流比例(
expected_split)进行检查;分配异常时会阻止决策。 - A/B/n:总体检验(卡方检验,或使用 Tukey HSD 的 ANOVA)和 Holm 调整后的 p 值(也可选择 Bonferroni 或不调整)。
- 贝叶斯视角: 每个变体优于对照组的概率、成为最佳的概率,以及上线该变体的预期损失(Beta-Binomial,通过数值求积计算,因此结果可复现)。
- 本次测试的最小可检测效应;可选的
mde(具有实际意义的最小提升幅度),用于判断实际显著性;可选的segment_column分组分析及辛普森悖论警告;以及直白的决策结论。 - 在引导式工作流中,步骤 2 会添加样本比例检查,步骤 4 会按提升幅度计算所需样本量。
该服务还提供 analyze、hypothesis_test 和 explore_data 提示词;VS Code 等客户端会将其显示为斜杠命令。
数据文件
Stats Explorer 专为表格格式(CSV、TSV、Excel 和 Parquet)打造,可用于运行假设检验或探索统计数据。文件由应用自带的导入代码读取:
- 带引号的字段、嵌入的逗号和换行符、BOM,以及制表符、分号或竖线分隔符;
- 缺失值(空白、NA、N/A、null、#N/A、……)会被跳过;
- 严格解析数字(
"12 kg"是文本,不是 12),但1,234、$12.50和45%仍会被视为数字; - 日期会转换为
YYYY-MM-DD文本; - 重复的列名会被重命名,而非覆盖;
- Excel 序列日期会被转换;
- 使用 Snappy、gzip、zstd、Brotli 或 LZ4 压缩的 Parquet 文件均可读取。
CSV、TSV 和 Parquet 文件没有大小限制;请参阅大文件。
JSON、BSON、NDJSON 和 NoSQL 数据库(MongoDB、CouchDB、Redis 连接字符串,……)属于文档数据,而非表格数据。对于这些数据,每个工具都会返回该说明,并建议先导出为 CSV 或 Parquet(例如 mongoexport --type=csv)。包含嵌套对象或数组的内嵌行也会得到相同的答复。
文件只会从允许的文件夹读取,并且会拒绝指向其他位置的符号链接:
- 如果设置了
STATS_EXPLORER_ROOTS(macOS/Linux 上以:分隔,Windows 上以;分隔),则使用该变量;否则 - 使用 MCP 客户端报告的工作区根目录;否则
- 使用服务的工作目录。
大型文件(数 GB 至数 TB)
不超过 512 MB 的文件会加载到紧凑的列式存储中(一个 190 MB、含 1,000,000 行的 CSV 使用不到 0.5 GB 内存,约 8 秒即可加载)。更大的 CSV、TSV 和 Parquet 文件没有大小限制。系统会以单次遍历的方式读取这些文件,所有工具都需要这样做:
- 单次遍历,内存固定。 每个工具只读取自己使用的列,并行分块读取(每个 CPU 核心一块),同时持续累计计数、均值、方差、平方和与交叉乘积。内存用量不会随文件大小增加:单个读取器约需 0.5 GB,每增加一个并行读取器约需 0.2 GB。一个 2.5 GB、含 1,300 万行的 CSV,单核耗时 45 秒,双核耗时 22 秒;相同数据存为 340 MB 的 Parquet 文件时,耗时 9 秒。
- 能精确计算的结果就精确计算。 t 检验、z 检验、ANOVA(含两两比较)、ANCOVA、MANOVA、卡方检验、Fisher 精确检验、Pearson 相关、均值、标准差、偏度、峰度和置信区间,均会基于每一行进行精确计算。对于最多含 100,000 个值的组,系统会保留实际值,因此所有相关结果(包括中位数)都是精确的。
- 必须估算时才估算,并明确标注。 较大组的中位数、四分位数、直方图柱和离群值计数由 KLL 分位数草图估算(测试中的秩误差约为 0.03%)。Spearman 的 ρ 根据 100,000 对随机样本计算;
inspect_data_file对列中不同值的计数在超过 10,000 个时,则通过 HyperLogLog 估算(误差约为 2%)。包含估算值的结果会在large_file.approximate和警告中列出这些估算值。 - 先询问。 如果读取整个文件需要超过 2 分钟,系统会询问你是要读取每一行(精确),还是快速读取分布在整个文件各处的数据块中约 1% 的行(快速、近似)。带表单的客户端会通过表单显示选项;否则,助手会询问你,并调用
large_file_plan。 - 在后台运行。 耗时超过 40 秒的读取会作为后台作业继续运行;工具会返回
STILL RUNNING和job_id,job_status会在结果准备就绪后返回结果(同时提供进度和剩余时间)。cancel_job可停止作业。支持 MCP 进度通知的客户端会显示进度条。 - 只读取一次。 工作流步骤共享同一次遍历:第 1 步读取文件,第 2 至第 5 步复用累计结果。经你同意后,读取的列可以保存在磁盘上(每个数字占 8 字节,每个文本值占 4 字节),之后针对这些列的问题只需数秒即可回答。
manage_cache可列出或删除这些列。 - 与小型文件使用相同规则。 流式读取器严格遵循应用的导入规则。它已针对 24 个边缘案例文件和 300 个随机文件与内存读取器进行比对,并在 CSV 和 Parquet 文件上测试了 228 次工具调用(包括检验、图表和完整的六步工作流),最多拆分为 3 个并行块。系统会处理带引号的值中的换行符:如果分割点落在这类值内,文件就会作为一个整体重新读取。
Excel 文件始终会整体读取(最大约 1.9 GB);如需处理非常大的工作簿,请将其导出为 CSV 或 Parquet。
配置
| 变量 | 默认值 | 作用 |
|---|---|---|
STATS_EXPLORER_GUIDED | on | 设为 off 后,可直接使用各个检验工具(t_test、anova 等),无需 start_analysis 和六个步骤 |
STATS_EXPLORER_CONFIRM_SELECTIONS | on | 设为 off 后,Agent 会直接使用其列、图表和报告选择运行,不再征求你的同意 |
STATS_EXPLORER_ROOTS | workspace | 可读取数据文件(并写入报告)的文件夹 |
STATS_EXPLORER_STREAM_MB | 512 | 超过此大小的 CSV/TSV/Parquet 文件会以流式方式读取(Parquet:按行数 × 列数计算) |
STATS_EXPLORER_WORKERS | cores − 1 | 大文件的并行读取器(默认最多 16 个) |
STATS_EXPLORER_ASK_SECONDS | 120 | 预计完整读取所需时间超过此值时先询问 |
STATS_EXPLORER_BACKGROUND_SECONDS | 40 | 超过此时长后作为后台任务继续运行 |
STATS_EXPLORER_SAMPLE_PERCENT | 1 | 快速抽样的大小 |
STATS_EXPLORER_CACHE | ask | 保留从大文件读取的列:ask、on 或 off |
STATS_EXPLORER_CACHE_DIR | system temp | 保存列数据的位置 |
STATS_EXPLORER_MAX_FILE_MB | no limit | 拒绝处理大于此大小的文件 |
STATS_EXPLORER_CONFIRM_VIA | auto | 即使客户端声称支持表单,chat 也会在对话中请求确认(建议用于 Claude Code) |
STATS_EXPLORER_HIDE_LINK | 0 | 设为 1 后,结果末尾的一行应用链接将被移除 |
STATS_EXPLORER_APP_URL | 更改该链接 | |
STATS_EXPLORER_JEV | off | Jev 检查:cooperate、enforce 或 orchestrated。其他设置见 docs/JEV.md |
准确性
test/reference/generate.py 使用 SciPy 和 statsmodels 为 43 个案例计算预期值,涵盖所有检验和备择假设、Welch 和 Student t 检验、小于 1e-30 的 p 值、Spearman 中的并列值、ANCOVA(Type II SS)、包含 2 个和 3 个结果变量的 MANOVA,以及含缺失值的文件输入。test/reference/guided.json 补充了 ANCOVA 斜率相等性 F 检验和第 4 步的功效计算(双样本、单样本、比例和相关性),并使用 statsmodels 进行验证。test/reference/abtest.py 会检查 Tukey HSD(studentized range、调整后的 p 值、置信区间和拒绝结果,并与 scipy.stats.tukey_hsd 及 statsmodels 的 pairwise_tukeyhsd 对比),以及每项 A/B 数值:z、p 和单侧 p(proportions_ztest)、提升幅度置信区间(confint_proportions_2indep)、Wilson 置信区间、Fisher 精确检验、卡方检验、Holm/Bonferroni(multipletests)、样本比例检查、Welch t 检验、贝叶斯概率和预期损失(使用 SciPy 数值积分),以及样本量(NormalIndPower)。npm test 会通过真实 MCP 客户端以 stdio 运行所有测试(包括支持和不支持表单的客户端),并要求相对误差小于 1e-6。
结果中也会说明以下已知近似:
- 功效使用正态近似(与精确功效相差约 0.01 以内,与 statsmodels 的
NormalIndPower一致); - Spearman 的 p 值使用 t 近似(与 SciPy 相同);
- 卡方检验不使用连续性校正;
- 对于非常大的文件,中位数、四分位数、直方图柱、异常值计数和 Spearman 的 ρ 均为估算值(见“大文件”)。
值得了解的限制
- 只有支持 MCP elicitation 的客户端才会显示确认表单。其他情况下,服务器会指示 Agent 将提议转达给你,令牌流程依赖于此。令牌无法猜测,也不能用于其他选择。
- 请求所需的模式由 Agent 根据服务器的指示决定。如果它选择了错误的模式,请告知它;它可以开始新的分析。
开发
npm install
npm test                      # reference, unit, guided-workflow and large-file tests
STATS_EXPLORER_STREAM_MB=0 npm test                               # the same, every file through the streaming path
STATS_EXPLORER_STREAM_MB=0 STATS_EXPLORER_EXACT_CAP=3 npm test    # ... using only one-pass summaries
npm run inspect               # open the MCP Inspector
npm run reference             # regenerate reference cases (needs Python + scipy + statsmodels)
npm run reference:ab          # regenerate the Tukey / A/B reference values and test/fixtures/experiment.csv
npm run jev:eval -- --dry-run # measure Jev on labeled cases (drop --dry-run and set TYPESAFE_API_KEY to call Jev)
cd vscode-extension && npm install && npm test && npm run package   # build the .vsix
src/engine/ 由 Stats Explorer 应用通过 npm run sync-engine -- <path-to-app> 复制而来:包括统计功能、数据导入模块以及 Learn 选项卡的工作流文本。请在应用中修复,再重新同步,以免两者出现差异。
许可证
MIT
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。