关于 jobd
jobd 是面向自有多台机器的作业队列与调度器,适合管理 GPU 和其他计算任务的开发者。它依据实时 VRAM、RAM、CPU 等容量分配任务,并提供 MCP 接口供 Agent 管理作业。
主要功能
- 01按实时 VRAM 与主机能力路由
- 02跨机器排队和持久化作业
- 03优先级抢占及检查点宽限期
- 04查看状态、日志并取消作业
- 05支持作业数组与批量任务
适用场景
- 01将训练任务分配到有足够空闲显存的主机
- 02关闭终端后继续运行并查看作业
- 03由 Agent 通过 MCP 提交和监控作业
MCP 相关
jobd-mcp 将作业队列功能提供为九种工具,供 MCP 客户端提交、查看、取消及管理作业和 Worker。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
uvx jobdJOBD_URLBase URL of the jobd broker the MCP server talks to. Defaults to http://127.0.0.1:8765.JOBD_API_TOKEN密钥Bearer token; must match the broker's JOBD_API_TOKEN. Required unless the broker runs with JOBD_ALLOW_NO_AUTH=1.本地服务需要在你的电脑上安装运行环境(如 Node.js 18+)。各客户端的配置文件位置不同,请参考客户端文档。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
jobd
jobd 是一个任务代理,并提供 MCP 服务,让 AI Agent 能在你自己的几台机器上提交、路由和照看任务。类似 task-spooler 或 pueue,但可在你通过 Tailscale 或局域网连接的所有机器之间运行,并将每项任务路由到有足够空闲 VRAM 的工作节点,不需要云服务、Kubernetes 或 Slurm。




# from any machine on your tailnet:
job submit --project myproj --gpu --vram-required 16 --wait -- python train.py
# → routed to whichever worker has ≥16 GB VRAM free, streamed back to your terminal
VRAM 路由每台主机只跟踪一块 GPU:工作节点仅报告 GPU 索引 0 上的空闲显存。
为什么要开发它
- 按 VRAM 适配路由。 每项任务都会分配给实时空闲 VRAM、RAM、CPU、能力标签以及架构/操作系统均符合要求的工作节点,不必再猜哪台机器有空。
- 带检查点窗口的抢占。 优先级更高的任务可以抢占正在运行的任务:发送
SIGTERM,为工作负载留出宽限时间,将状态保存到其JOBD_CHECKPOINT_DIR,然后发送SIGKILL。被抢占的任务不会重新运行;要恢复任务,请提交一个指向检查点的新任务(docs/preemption.md)。 - 会话结束后依然运行。 任务保存在代理中,而非你的 shell 里。提交任务,合上笔记本,明天再来查看。
- 原生支持 Agent。 MCP 服务可让 AI Agent 通过工具调用提交、监控和照看任务(基准测试展示的内容)。
- 由你掌控。 在你自己的机器上运行一个代理进程。不需要账号,不收集遥测数据,也不按 GPU 小时计费。只有可选的自更新脚本会联网(运行手册)。
为什么不直接用……?
| 工具 | 提供的功能 | 为什么选择 jobd |
|---|---|---|
nohup / tmux / ssh | 在一台机器上运行命令 | 没有队列、VRAM 感知路由、抢占功能,也不会记录任务在哪台机器上运行 |
| task-spooler | 单机任务队列 | jobd 可跨所有机器排队,并根据实时 VRAM/CPU 适配情况进行路由 |
| Pueue | 成熟的单机队列守护进程 | Pueue 的 README 将分布式执行列为范围之外;jobd 提供这一层,并支持 GPU 感知 |
| HyperQueue | 源自 HPC 的多机调度,采用单一二进制文件 | 会统计 GPU 数量,但不跟踪 VRAM;没有抢占/检查点约定或 Agent 接口 |
| Slurm | 数据中心级调度 | 对于 2–3 台个人机器来说,搭建和运维负担太重 |
| SkyPilot / dstack | 在云端和自有机器上运行 | SkyPilot 的“现有机器”模式会在你的机器上安装 Kubernetes(k3s);dstack 要求每台主机都安装 Docker 并配置免密 sudo |
| Modal | 无服务器 GPU 计算 | 在 Modal 的机器上运行,而不是在你的机器上 |
| Ray | 分布式计算;Ray Jobs 可在 Ray 集群上运行任意 shell 命令 | 你得先搭建并运行 Ray 集群 |
安装
pip install jobd               # broker + CLI
pip install "jobd[mcp]"        # adds the MCP server
pip install "jobd[worker]"     # adds the worker daemon (jobd-worker)
需要 Python ≥ 3.11。scripts/install-worker.sh 会在 ~/jobd-worker 下配置一个工作节点,其中包含独立的 venv 和生成的配置文件。
快速入门(单主机)
# 1. start the broker (binds 127.0.0.1:8765 by default)
JOBD_ALLOW_NO_AUTH=1 jobd          # no-auth is fine for a loopback-only broker

# 2. in another shell, install + start a worker pointed at it
pip install "jobd[worker]"
JOBD_URL=http://127.0.0.1:8765 JOBD_WORKER_HOST=local jobd-worker

# 3. submit a job and wait for it
job submit --project demo --wait -- echo hello
job list
job logs <id>
如需多主机部署(Docker broker、systemd 工作节点、Tailscale 绑定、共享身份验证令牌),请参阅 docs/security.md 以及 docker-compose.yml 和 scripts/ 中的模板。向运行中的集群添加工作节点只需执行一条命令:
job fleet add user@newbox      # ssh in, install pinned to the broker's version,
                               # wire systemd units + the self-update timer,
                               # verify it registers. `job fleet status` shows drift.
日常运维(健康检查、排空工作节点、升级、令牌轮换、备份)请参阅 docs/runbook.md。
工作原理

broker(FastAPI + SQLite)负责维护队列、运行匹配器并解析各项目的优先级。每台主机上运行一个工作节点,它们会轮询 broker,因此不会有任何连接主动进入工作节点:每个工作节点都会报告实时容量、认领可运行的任务、回传日志并遵循抢占规则。提交的 argv 会原样运行(shell=False);job submit --stdin 和 MCP jobd_submit 工具是例外,它们会将命令字符串作为 bash -c <string> 运行。设计说明:docs/ARCHITECTURE.md。
CLI
job submit -p PROJ [options] -- CMD...       # queue a job
job list [--state STATE] [--project P]       # queue + recent jobs
job status ID | A<id> [--watch]              # one job, or an array's aggregate
job logs ID [-n BYTES]                       # tail captured output
job wait ID                                  # block until terminal
job cancel ID  /  job preempt ID             # stop a job
job adopt --pid N -p PROJ [--gpu]            # track a process started outside jobd (Linux)
job workers                                  # fleet snapshot + health
job projects list | set NAME PRI | nudge NAME DELTA
job audit [--project P] [--since 24h]        # event history
任务数组和扫描、--explain 试运行、job adopt,以及 pueue/task-spooler 命令对照表:docs/cli.md。
MCP / Agent 集成
jobd-mcp 将队列公开为九个工具:jobd_submit、jobd_status、jobd_logs、jobd_list、jobd_cancel、jobd_preempt、jobd_events、jobd_workers、jobd_worker_delete。docs/agent-cookbook.md 介绍如何监控任务、执行抢占、进行扫描,以及询问任务无法调度的原因。
适用于 Claude Code:
claude mcp add jobd \
  --env JOBD_URL=http://127.0.0.1:8765 \
  --env JOBD_API_TOKEN=<your-token> \
  -- jobd-mcp
其他 MCP 客户端:
{
  "mcpServers": {
    "jobd": {
      "command": "jobd-mcp",
      "env": {
        "JOBD_URL": "http://127.0.0.1:8765",
        "JOBD_API_TOKEN": "<your-token>"
      }
    }
  }
}
JOBD_API_TOKEN 必须与 broker 的令牌一致,否则每次调用都会返回 401。examples/claude-code-hooks/ 提供可选钩子,可提示(或强制阻止)Agent 通过 jobd 提交重型命令。
基准测试结果
我们用 Claude 对 38 个关于实时 broker 的问题进行了比较:一次使用该服务,一次使用 jobd 自带的 job CLI,每种设置各运行 3 次。使用 Claude Haiku 5.5 时,该服务每次运行都答对全部 38 题,而 CLI 答对 29 题:这是预注册的胜出结果(Holm 校正后的 McNemar p = 0.008)。使用 Sonnet 5.5 时,结果为 36 比 30;使用 Opus 5.5 时,结果为 38 比 37,差异都不显著。对于这三种模型,该服务的答案成本更低、速度更快;使用 Sonnet 时,成本为 0.20 倍,耗时为 0.17 倍。
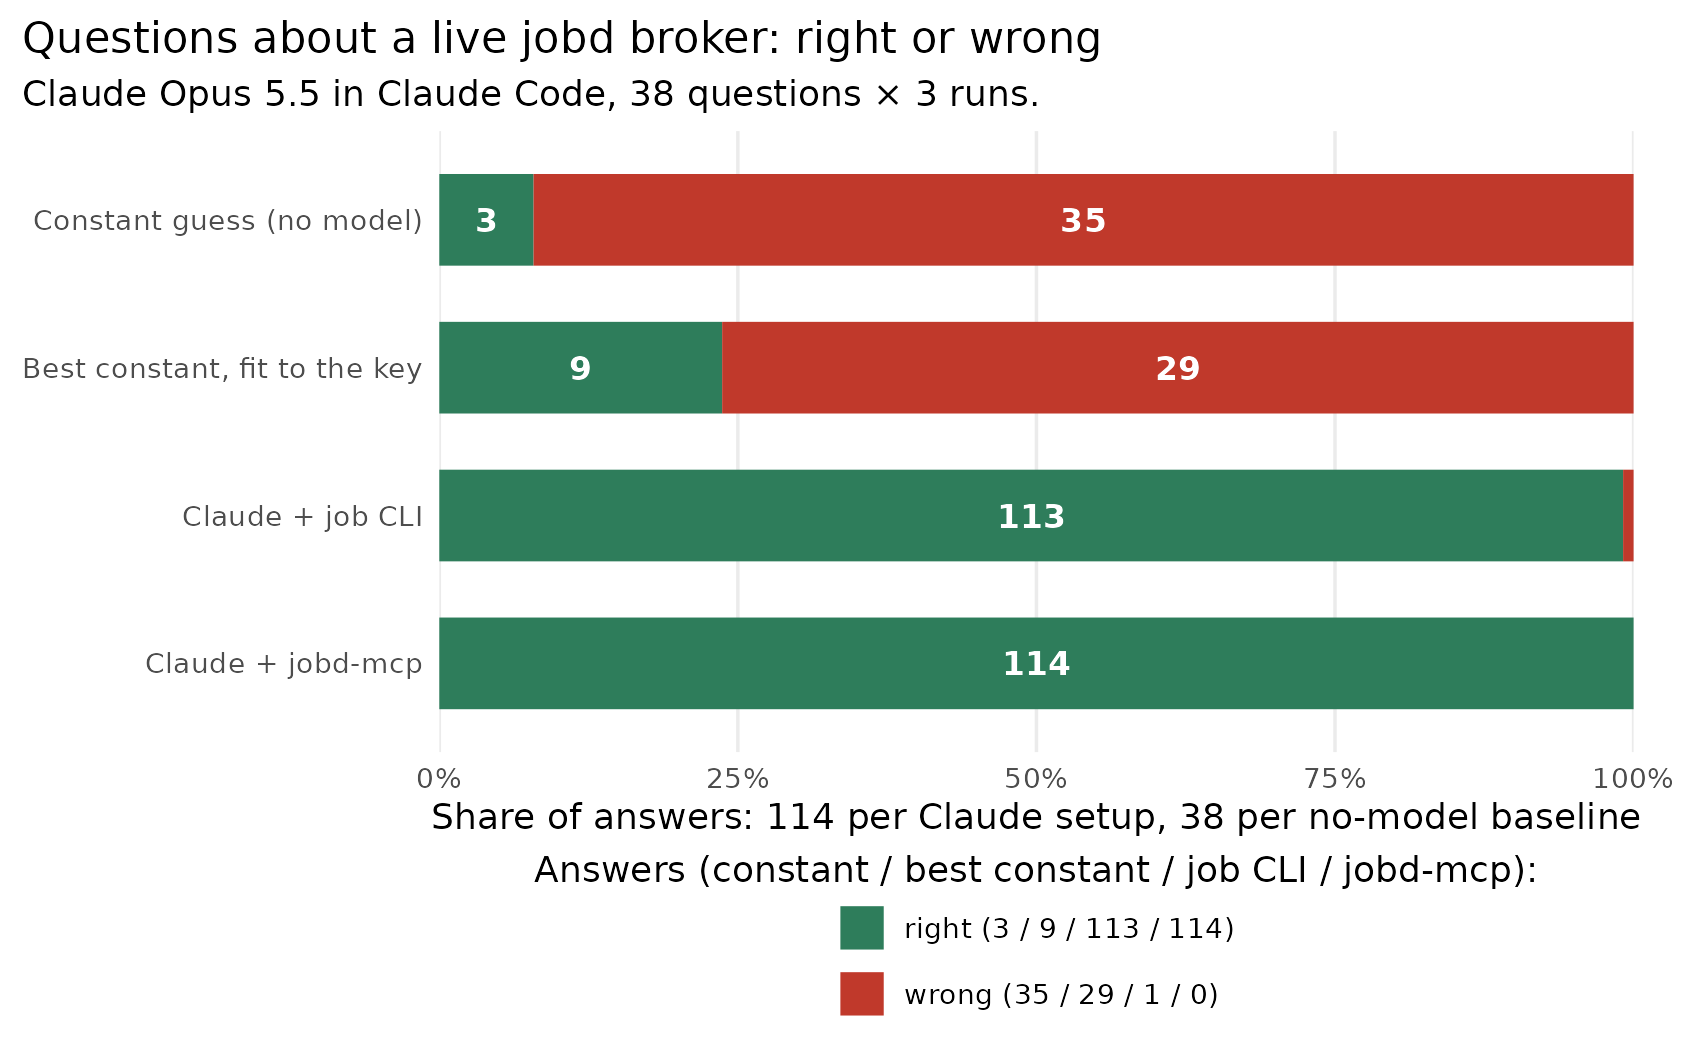
图表显示的是 Opus 5.5 的运行结果(2026-10-18)。该运行中,该服务的答案成本中位数为 0.20 倍(95% CI 为 0.15 至 0.28),耗时为 0.16 倍(0.13 至 0.20),并且在全部 38 道题上都更便宜、更快。这些是次要终点,测量时使用了一个尚未发布的提交,该提交为 jobd_list 添加了 finished_at 时间窗口。在更早、难度更低的一组测试中,两种设置都答对了 123 题中的 123 题。
问题由我们编写,基准测试也由我们执行;欢迎外部复测。方法、控制措施和局限性:benchmarks/agent_qa;Haiku 和 Sonnet 的运行结果:2026-10-20 复测。
支持的平台
| 组件 | Linux | macOS | Windows |
|---|---|---|---|
Broker(jobd) | 已测试 | 预期支持 | 预期支持(推荐使用 WSL) |
CLI(job)/ MCP(jobd-mcp) | 已测试 | 预期支持 | 预期支持 |
Worker(jobd-worker) | 已测试 | 功能受限 | 未测试 |
CI 在没有 GPU runner 的 Ubuntu 上运行(VRAM 路径通过 mock 测试);如果没有 systemd 用户实例,worker 仍会运行作业,但会失去内存上限、进程回收和抢占保证。
配置
- 配置文件(
projects.yaml、profiles.yaml、classifier.yaml)均为可选,并从JOBD_CONFIG_DIR读取;请参阅 docs/projects-yaml.md。 - **环境变量:**所有
JOBD_*变量都列于 docs/configuration.md。 - 并发(每个 worker 运行多个作业):docs/concurrency.md。日志和作业记录的保留策略:docs/runbook.md。
安全
将 broker 运行在 loopback 或 Tailscale tailnet 上,切勿绑定到公共接口。共有三层控制:
- 绑定地址:
JOBD_HOST默认值为127.0.0.1;将其设为 Tailscale 地址(100.64.0.0/10),切勿设为0.0.0.0。broker 不会强制执行此限制。 - **源 IP:**来自 loopback 和
100.64.0.0/10以外的请求会收到403(设置JOBD_DISABLE_TAILNET_ACL=1可关闭此功能)。 - **令牌:**每台主机都必须设置
JOBD_API_TOKEN;JOBD_ALLOW_NO_AUTH=1仅适用于只绑定 loopback 的 broker,绑定到其他地址时会向你的 tailnet 暴露未经身份验证的代码执行能力。
/livez、/readyz 和 /metrics 不受源 IP 检查和令牌验证限制;/metrics 会显示每个 worker 的主机名和版本,因此不要对 broker 进行端口转发。威胁模型和令牌轮换:docs/security.md。
License
MIT; see LICENSE.
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。