关于 PubChem Finder
PubChem Finder 是面向化学研究人员的命令行工具、Python 库和 MCP 服务,可按结构搜索化合物。它结合带评分的本地相似性与子结构索引、实时 PubChem 记录和离线 RDKit 分析。
主要功能
- 01本地化合物相似性搜索
- 02按 SMILES 或 SMARTS 搜索子结构
- 03查询 PubChem 信息及生物活性
- 04使用 RDKit 计算描述符和警示
- 05绘制结构并突出差异或匹配
- 06将 SDF 文件构建为索引
适用场景
- 01在本地化合物索引中查找类似物
- 02按结构片段筛选化合物
- 03检查化合物性质和药物化学警示
- 04查询 PubChem 安全和生物测定资料
MCP 相关
MCP 服务通过 stdio 或 streamable HTTP 向客户端提供本地结构搜索、RDKit 分析和 PubChem 查询工具。需要本地索引的工具须先构建索引;实时 PubChem 查询无需索引。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
PubChem Finder
在终端或 Claude 中按化学结构搜索 PubChem。PubChem Finder 会为 PubChem(全部数据或你需要的部分数据)构建本地指纹索引,从而实现不受速率限制的精确相似性搜索和子结构搜索;它会封装 PubChem 的实时服务,获取名称、安全数据和生物测定信息,并提供 RDKit 化学功能:结构绘图、药物化学初筛和描述符。它可作为命令行工具、Python 库和 MCP 服务运行,供 Claude Desktop、Claude Code 和其他 MCP 客户端使用。



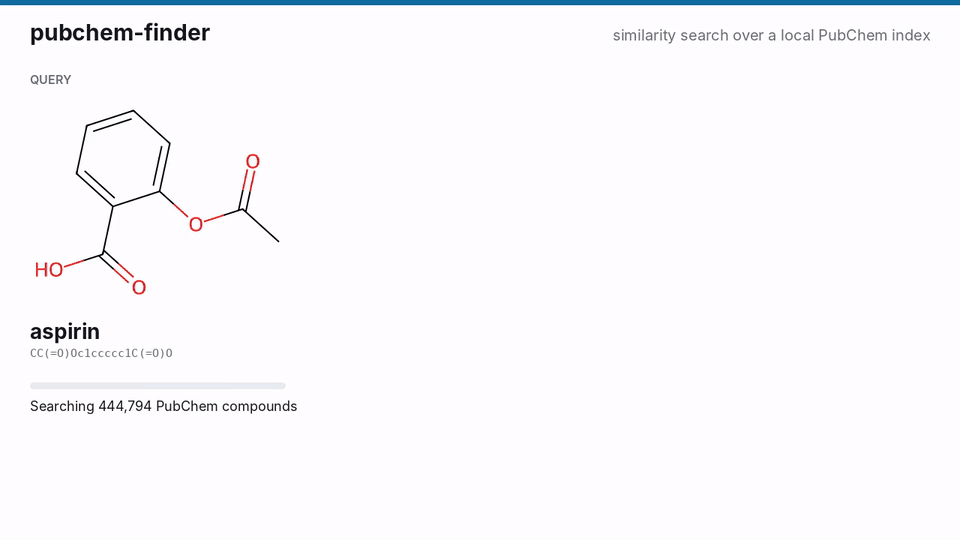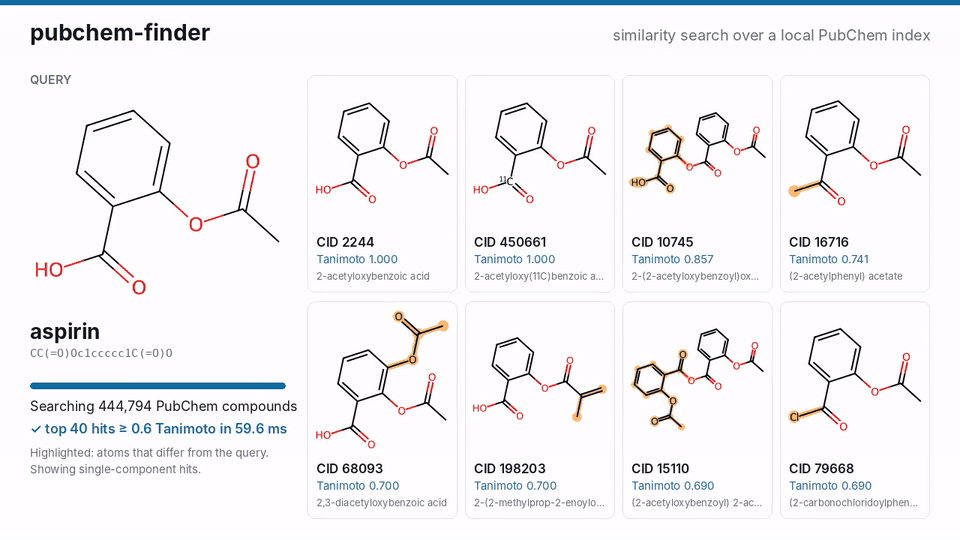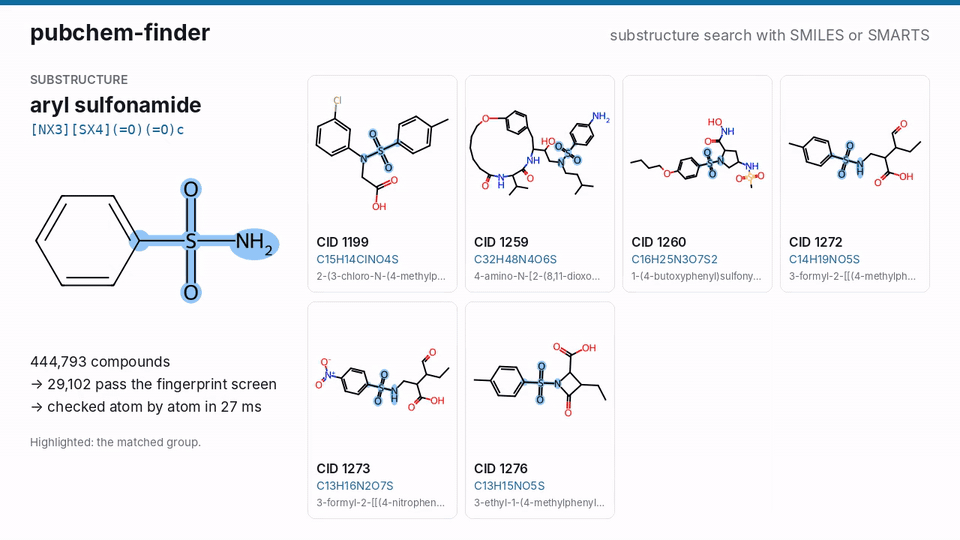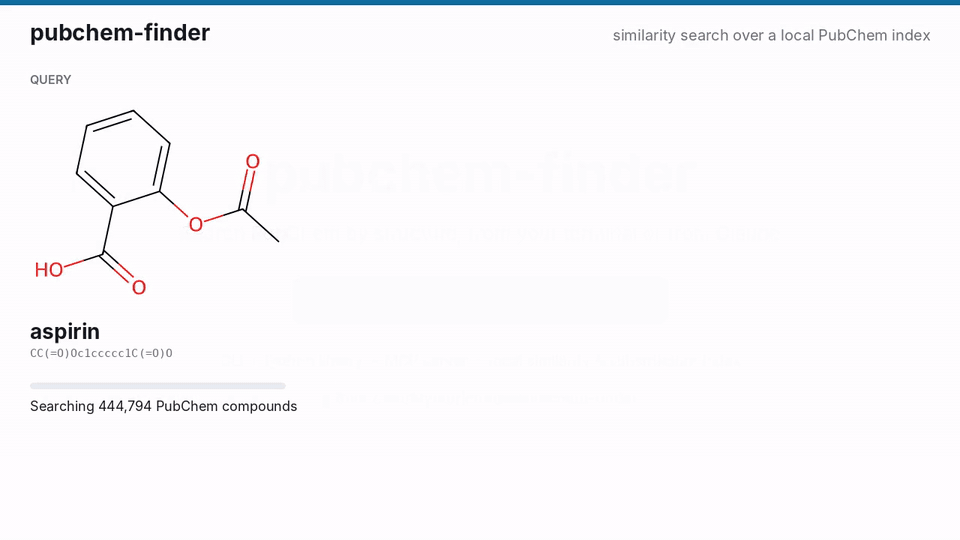
基于 PubChem 前 444,794 种化合物的真实搜索结果,使用项目的真实数据工作流构建的索引生成:先显示阿司匹林的相似性匹配项,并高亮显示与其不同的原子;然后显示芳基磺酰胺 SMARTS 的匹配项,并高亮显示匹配结构。 MP4 版本。
为什么选择它
其他 PubChem 工具(包括 MCP 服务)都会将查询转发到 PubChem 的 Web API。这适合查找化合物,但通过 API 进行结构搜索会受到速率限制,通用查询会超时,且返回的只是未评分的样本。PubChem Finder 还维护一个本地索引:
- 精确、带评分的相似性搜索:在毫秒内搜索所有已索引化合物(默认使用 ECFP4 Tanimoto),借助 FPSim2 实现,它也是 ChEMBL 相似性搜索背后的引擎。
- 本地子结构搜索:支持 SMILES 或 SMARTS,先进行指纹筛选,再逐原子匹配,因此每个匹配项都是真正的匹配结果。
- 离线化学功能:借助 RDKit 提供描述符、标准化、PAINS/Brenk/NIH 警示、QED、合成可及性评估,以及用于展示类似物之间变化的结构绘图。
- 带来源引用的 PubChem 知识:同义词和 CAS 编号、交叉引用、GHS 分类、药理学、毒性和生物测定摘要,每项都标注来源。
无需数据库服务器,也无需 Docker:索引只是数据目录中的一对文件。
在 Claude 中使用
需要 uv,首次运行时会自动下载 Python 和其他所有所需内容。
Claude Code:
claude mcp add pubchem-finder -- uvx pubchem-finder mcp
也可以作为插件使用,在 Cowork 中同样适用:
/plugin install pubchem-finder --marketplace MysterionRise/pubchem-finder
Claude Desktop(进入 Settings、Developer、Edit Config,然后重启 Claude):
{
  "mcpServers": {
    "pubchem-finder": {
      "command": "uvx",
      "args": ["pubchem-finder", "mcp"]
    }
  }
}
然后可以提出以下问题:
- “咖啡因的分子量和 XLogP 是多少?它符合 Lipinski 规则吗?”
- “布洛芬有危害吗?它的 GHS 标签上写了什么?请注明来源。”
- “塞来昔布在 PubChem 生物测定中的主要靶点有哪些?”
- “展示阿司匹林最相似的类似物,并突出显示有哪些变化。”
- “这种化合物有 PAINS 警示吗?
O=C1C(=Cc2ccccc2)SC(=S)N1” - 使用本地索引:“查找与布洛芬最相似的 20 种化合物”,或“哪些已索引化合物含有芳基磺酰胺?绘制几种,并突出显示该基团。”
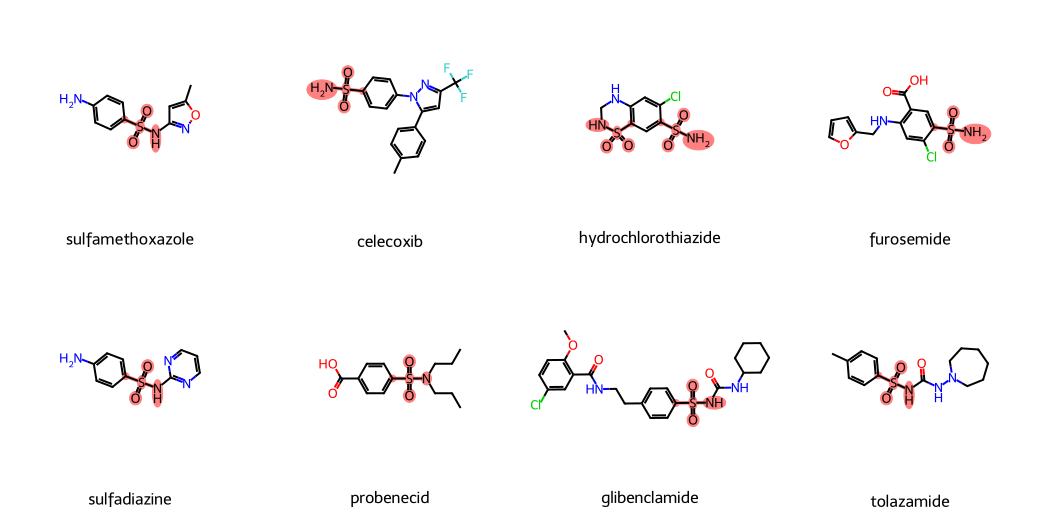
draw_molecules 配合 highlight="smarts":八种磺酰胺药物,突出显示了
[NX3][SX4](=O)(=O)c 的匹配结果,如 Claude 内嵌显示的那样。
本地索引工具需要索引;从命令行(如下所示)构建索引后,服务会自动使用它。若要使用非默认数据目录,请在 Claude Desktop 配置项中添加
"env": {"PUBCHEM_FINDER_HOME": "/path"},或在 claude mcp add 命令中添加
--env PUBCHEM_FINDER_HOME=/path。
**其他 MCP 客户端:**该服务通过 stdio 使用标准 MCP,因此任何能够运行本地 MCP 服务的客户端(Cursor、VS Code、Windsurf、Zed、JetBrains IDE、Codex CLI、LM Studio……)
都可以使用相同的命令和参数启动它。它已作为 io.github.MysterionRise/pubchem-finder
列入 MCP registry,供从该处安装服务的客户端使用。
docs/clients.md
介绍了配置、快速检查以及经过测试的配置方法;如果你使用其中某个客户端,欢迎将你的配置补充到文档中,作为一项很好的首次贡献。
通过 HTTP 使用:pubchem-finder mcp --transport http 会通过
http://127.0.0.1:8000/mcp(MCP streamable HTTP)提供相同的工具,供连接 URL 而非启动进程的客户端使用,也适用于在团队机器上共享一个索引。例如,
claude mcp add --transport http pubchem-finder http://127.0.0.1:8000/mcp。服务本身不提供身份验证或 TLS:绑定到 127.0.0.1 以外的地址前,请先阅读
通过 HTTP 使用。
工具
| 工具 | 功能说明 |
|---|---|
pubchem_lookup(query, by, limit) | 将名称、CID、SMILES 或 InChIKey 解析为 PubChem 记录:标识符、分子式、分子量、XLogP、氢键计数、TPSA、链接。 |
compound_properties(smiles) | 计算任意 SMILES 的 RDKit 描述符并进行 Lipinski 检查。离线。 |
standardize(smiles) | 移除盐和反离子、中和并规范化。离线。 |
compare(smiles_a, smiles_b) | 使用 ECFP4 和 MACCS 指纹计算 Tanimoto 相似度。离线。 |
medchem_profile(smiles) | 计算 QED、合成可及性,检查 Lipinski/Veber 规则及 PAINS/Brenk/NIH 警示(含原子信息),并给出 Murcko 骨架。离线。 |
draw_molecules(smiles, legends, highlight, smarts, reference_smiles) | 将结构作为内嵌图像展示,可高亮 SMARTS 匹配项、显示与参考结构的差异,或生成相似性图。离线。 |
similarity_search(smiles, threshold, top_k, metric, group_by_scaffold) | 在本地索引中查找最相似的化合物,可选择按 Murcko 骨架分组。 |
substructure_search(query, query_type, max_hits) | 查找包含 SMILES 或 SMARTS 片段的已索引化合物,按 CID 从低到高排列。 |
index_status() | 查看本地索引是否已构建、包含哪些内容,以及如何构建缺失部分。 |
pubchem_similarity_search(smiles, threshold, max_records) | 实时搜索整个 PubChem 中的相似化合物,并使用 ECFP4 重新评分。 |
pubchem_substructure_search(smiles, max_records) | 实时搜索整个 PubChem 中包含某个片段的化合物。 |
pubchem_exact_match(smiles, identity_type) | 查询与此结构完全匹配的 PubChem 记录,可选择忽略立体化学或同位素。 |
pubchem_synonyms(cid, limit) | 获取常用名、品牌名和系统名称,以及 CAS 注册号。 |
pubchem_xrefs(cid) | 获取注册 ID(CAS、ChEMBL、DrugBank 等)、PubMed 文章和专利。 |
pubchem_description(cid) | 获取经过整理的描述及来源。 |
pubchem_annotations(cid, heading, max_chars) | 获取化合物页面中的一个部分:GHS 分类、危害、药理学、作用机制、药物信息、实验性质、毒性、用途、食品添加剂。每项均注明来源。 |
pubchem_bioactivity(cid) | 获取生物测定摘要:测定数量、结果、主要靶点以及活性最强的结果。 |
通过命令行使用
uvx pubchem-finder lookup caffeine                     # PubChem record by name, CID, SMILES or InChIKey
uvx pubchem-finder props "CC(=O)Oc1ccccc1C(=O)O"       # RDKit descriptors (offline)
uvx 可运行最新版本,无需安装。若要安装命令以便后续使用:
uv tool install pubchem-finder(或 pip install pubchem-finder)。以下示例
假设已安装。若要试用开发版本,请在任何 uvx
命令中将 pubchem-finder 替换为
--from git+https://github.com/MysterionRise/pubchem-finder pubchem-finder。
构建本地索引并搜索
pubchem-finder index build --limit 1 --with-substructure   # first PubChem chunk: ~445,000 compounds
pubchem-finder search "CC(=O)Oc1ccccc1C(=O)O" --threshold 0.7 --top 20
pubchem-finder search "CC(=O)Oc1ccccc1C(=O)O" --group-by-scaffold
pubchem-finder substructure "c1ccc2[nH]ccc2c1"              # everything indexed that contains indole
pubchem-finder substructure "[NX3][SX4](=O)(=O)c" --smarts  # aryl sulfonamides, as SMARTS
pubchem-finder index status

pubchem-finder index build --sdf my_library.sdf.gz         # or index your own SDF files
index build --limit N 会通过 HTTPS 从 NCBI 下载 PubChem 约 350 个 SDF 分块中的前 N 个(每个分块约含 500,000
个 CID),验证每个文件的 MD5,为其生成指纹,删除下载文件,并将所有内容合并为一个可搜索索引。可以安全地重复运行:已完成的
分块会跳过,因此中断的构建可以续接,增大 --limit 则可扩展现有索引。--all 会为整个 PubChem 建立索引。默认指纹为 ECFP4(Morgan
半径 2,1024 位);为新索引设置 --radius 和 --fp-size 可更改这些参数。
子结构搜索是可选的,因为它需要第二个指纹数据库。该数据库根据索引中已有的 SMILES 构建,因此对现有索引运行 index build --with-substructure 即可添加,无需下载任何内容;后续构建会使其保持最新(--without-substructure 可将其移除)。系统会先使用每个化合物的 RDKit 模式指纹进行筛选,再逐原子匹配候选项(忽略立体化学)。命中项按 CID 从低到高排列,使已知时间较久的化合物排在前面;搜索会在找到 --max 个命中项或检查完 --max-candidates 个化合物后停止,并说明是否已检查所有候选项。
直接查询 PubChem
pubchem 命令会查询 PubChem 的实时服务,无需索引:
pubchem-finder pubchem similarity "CC(=O)Oc1ccccc1C(=O)O" --threshold 90   # across all of PubChem
pubchem-finder pubchem substructure "c1ccc2[nH]ccc2c1" --max 50
pubchem-finder pubchem exact "CC(=O)Oc1ccccc1C(=O)O" --identity same_connectivity
pubchem-finder pubchem synonyms 2244          # names and CAS numbers
pubchem-finder pubchem xrefs 2244             # registry IDs, PubMed articles, patents
pubchem-finder pubchem describe 2244          # curated descriptions with sources
pubchem-finder pubchem annotations 2244 --heading "GHS Classification"
pubchem-finder pubchem bioactivity 2244       # assay outcomes, top targets, most potent results
PubChem 的相似性搜索使用自己的指纹,不会报告分数,因此这里会使用 ECFP4 为每个结果评分。ECFP4 与本地索引使用的指纹相同,结果也会按该分数排序。成功的响应会缓存 7 天,因此重复查询无需额外开销,也不会超出 PubChem 的速率限制(pubchem-finder cache info | clear;设置 PUBCHEM_FINDER_CACHE=0 可关闭缓存)。
图片、分类和完整文件
pubchem-finder draw "CC(=O)Oc1ccccc1C(=O)O" "COC(=O)c1ccccc1O" -l aspirin -l "methyl salicylate" \
    --highlight diff --reference "CC(=O)Oc1ccccc1C(=O)O" -o analogues.png
pubchem-finder draw "O=C(O)c1ccccc1O" "CC(=O)Nc1ccc(O)cc1" --highlight similarity_map \
    --reference "CC(=O)Oc1ccccc1C(=O)O" -o similarity.png
pubchem-finder triage "O=C1C(=Cc2ccccc2)SC(=S)N1"     # QED, SA score, rules, PAINS/Brenk/NIH alerts

# .smi ("SMILES [id]" per line), .csv/.tsv with a smiles column, or - for stdin; CSV out
pubchem-finder triage -i library.smi -o triage.csv
pubchem-finder props -i library.csv -o props.csv
pubchem-finder search -i queries.smi -o hits.csv --threshold 0.6 --top 50
pubchem-finder substructure -i fragments.smi -o hits.csv
批处理模式下失败的行会在 error 列中显示错误,而不会中止运行。
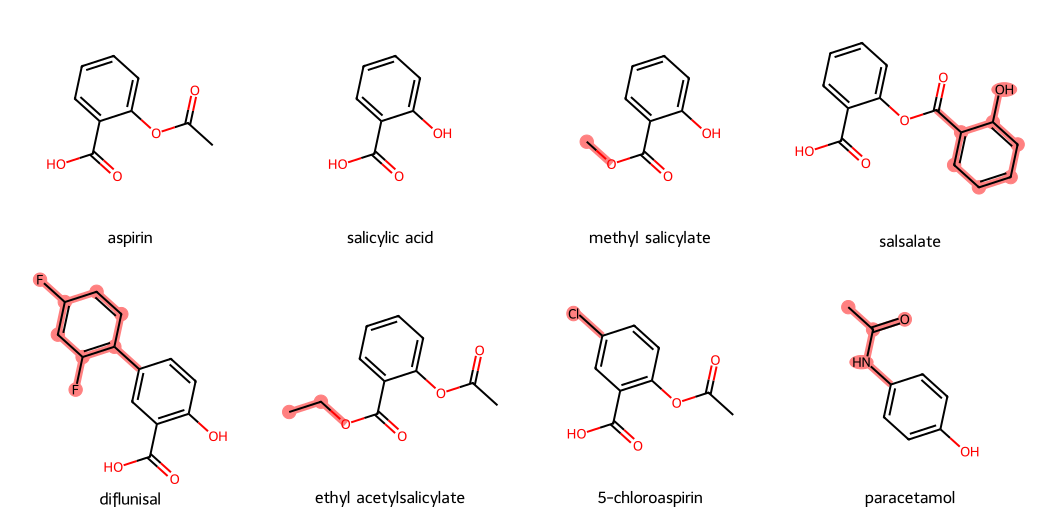
--highlight diff:将每个类似物与其和阿司匹林共有的核心结构对齐,并突出显示新增的原子。
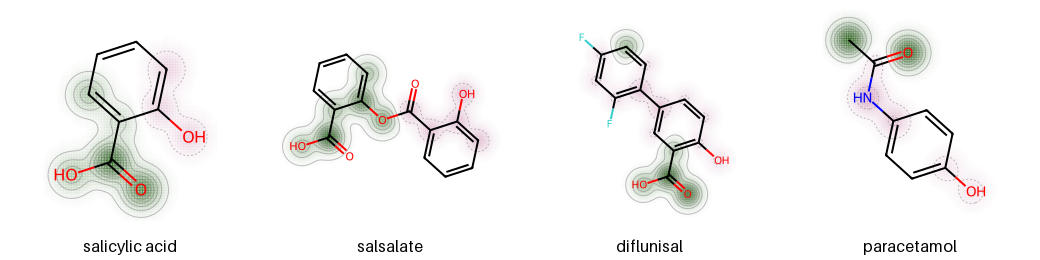
--highlight similarity_map:使 ECFP4 与阿司匹林相似度提高的原子以绿色显示,降低相似度的原子以粉色显示。
它有多大?
第一列的数据来自真实运行 index build --limit 1 的结果:在 MacBook Pro 上运行,以及在标准 GitHub Actions Linux runner 上通过项目的真实数据工作流使用 --with-substructure 运行。该工作流随后会针对生成的索引运行每条命令和 MCP 工具。完整 PubChem 列的数据是按这些数字扩展到 PubChem 约 1.2 亿种化合物后的估算值。
| 第一个 PubChem 数据块(实测) | 全部 PubChem 数据(估算) | |
|---|---|---|
| 已索引化合物 | 444,794(RDKit 跳过 29 个) | ~1.2 亿 |
| 指纹计算 | 单个 MacBook 核心上耗时 80 秒,GitHub runner 上耗时 169 秒 | 8 核上约 1 小时,另需下载时间 |
| 下载 | 一个 SDF 文件,索引完成后删除 | 通过 HTTPS 下载约 100 GB,逐块流式传输 |
| 相似性索引文件 | 36 MB | ~10 GB |
| 内存中的相似性搜索所需 RAM | 64 MB | ~17 GB |
| 子结构搜索(可选) | 额外耗时 169 秒构建,文件大小 88 MB,RAM 占用 121 MB | 8 核上约 1.5 小时,文件约 24 GB,RAM 占用约 33 GB |
| 构建时所需可用磁盘空间 | 少量 | 约 45 GB;使用子结构搜索时另需约 50 GB |
在第一个数据块上的查询时间(GitHub runner):内存中的相似性扫描耗时约 3 ms,磁盘扫描耗时 0.12 秒;获取 40 个结果的名称和 SMILES 后,完整调用耗时约 60 ms。包含 50 个结果的子结构搜索在内存中耗时 35–50 ms,在磁盘上耗时 0.3 秒。首次查询还会加载索引,在此规模下耗时远低于 1 秒。筛选时间大致随索引大小线性增长。
当索引能轻松放入可用 RAM 时,会在内存中搜索;否则会从磁盘搜索。设置 PUBCHEM_FINDER_INDEX_MODE=memory|disk 可强制指定模式。在笔记本电脑上,使用 --limit 为部分数据建立索引,而不要索引全部 PubChem。
数据存储在平台数据目录中(Linux 上为 ~/.local/share/pubchem-finder,macOS 上为 ~/Library/Application Support/pubchem-finder,Windows 上为 %LOCALAPPDATA%\pubchem-finder)。可通过 --home DIR 或 PUBCHEM_FINDER_HOME 更改该目录。
在 Python 中使用
CLI 和 MCP 服务是 pubchem_finder.service 的轻量封装:
from pubchem_finder import service

service.properties("CC(=O)Oc1ccccc1C(=O)O").molecular_weight  # 180.16
service.standardize("CC(=O)[O-].[Na+]").smiles  # 'CC(=O)O'
service.compare("CCO", "CCCO").ecfp4_tanimoto  # 0.556
service.lookup("caffeine").compounds[0].cid  # 2519 (network)
service.similarity_search("CC(=O)Oc1ccccc1C(=O)O", threshold=0.7)  # needs an index
service.substructure_search("[NX3][SX4](=O)(=O)c", query_type="smarts")
如果要让你自己的 Agent 使用这些工具,请与 MCP 服务交互:
examples/mcp_client.py
通过普通 MCP 客户端在不到 50 行代码中实现了这一功能(uv run examples/mcp_client.py,无需 API 密钥)。欢迎提供面向 Agent 框架的示例,详见
#34。
故障排除
- 首次运行需要一分钟。 uv 会在需要时下载 Python,并一次性下载数百 MB 的软件包(RDKit、PyArrow、DuckDB 等);之后运行大约一秒即可启动。
- Claude Desktop 提示服务启动失败。 macOS 上的桌面应用无法读取 shell 的
PATH,因此可能找不到uvx。请将其完整路径用作command(运行which uvx查找,通常是~/.local/bin/uvx)。服务日志位于 Claude Desktop 的 MCP 日志中。 similarity_search或substructure_search提示“No local index”。 使用pubchem-finder index build --limit 1构建索引(如需子结构搜索,请添加--with-substructure)。index_status会指出缺少什么。- PubChem 响应缓慢或繁忙。 请求会限制在 PubChem 每秒 5 次的上限内,并在 PubChem 繁忙时重试。针对整个 PubChem 的结构搜索可能会因片段过于通用而超时;请使用更具体的查询,或使用本地索引。
- 使用代理时: 设置
HTTPS_PROXY;所有发往 PubChem 和 NCBI 的请求都会遵循该设置。 - ARM Linux(aarch64): FPSim2 未提供该平台的 wheel,因此安装时需要 C++ 编译器来构建。
- 重新开始:
pubchem-finder cache clear会清空响应缓存;删除数据目录也会一并移除索引。
数据、致谢与引用
数据来自 PubChem,即美国国家医学图书馆的开放化学数据库。 请遵循 NCBI 的政策和 PubChem 关于引用的指南, 并在使用其数据时引用 PubChem:
Kim S, et al. PubChem 2025 update. Nucleic Acids Research 2025;53(D1):D1516-D1525. doi:10.1093/nar/gkae1059
注释(安全性、药理学、毒性等)由其他组织提交; 每条注释都会注明来源,部分注释还附有各自的许可条款。
PubChem Finder 基于 RDKit、 FPSim2、DuckDB、 Apache Arrow 和 MCP Python SDK 构建。若要引用 PubChem Finder 本身,请参阅 CITATION.cff(GitHub 的“引用此仓库”按钮)。
开发
需要安装 uv。支持 Python 3.11 至 3.14;仓库中的
.python-version 会让 uv sync 使用 3.12,即使 pyenv 或 conda 将较旧的 Python 放在
PATH 前面也不例外。
uv sync            # create .venv and install everything, including dev tools
make check         # ruff lint + format check, mypy (strict), pytest with coverage
make test          # just the tests
PUBCHEM_LIVE=1 uv run pytest -m live   # tests that call the real PubChem services
uv run python scripts/smoke.py --live  # every MCP tool through the real stdio server
uv run python scripts/smoke.py --url http://127.0.0.1:8000/mcp  # same, against a running HTTP server
顶部的动画由真实索引生成,使用 scripts/demo_media.py
(collect 会运行搜索并计时,render 会生成 GIF 和 MP4);其文档字符串中列出了确切命令,真实数据工作流会在每次运行时重新生成动画。
docs/media/demo-data.json 保存了当前动画背后的结果,因此
uv run python scripts/demo_media.py render docs/media/demo-data.json -o docs/media 可以在没有索引的情况下重新绘制动画。
CI 会在 Linux、macOS 和 Windows 上运行测试,在三种系统上对构建出的 wheel 进行冒烟测试,并每周运行实时 PubChem 测试。请参阅 CONTRIBUTING、 ROADMAP 和 CHANGELOG。
PubChem Compound SDF (HTTPS) --> streaming RDKit parse --> chunks/<chunk>.parquet  (CID, SMILES, InChIKey, name, formula, MW)
                                                      \-> chunks/<chunk>.h5       (FPSim2 fingerprints)
                                                            \-> merge + popcount sort -> index/pubchem.h5 + manifest.json
chunks/<chunk>.parquet SMILES --> RDKit pattern fingerprints --> chunks/pattern/<chunk>.h5 -> index/pubchem-pattern.h5
                                                                  (only with --with-substructure)
pubchem-finder CLI  ----\                 /-> FPSim2 exact similarity (in memory or on disk) + DuckDB over Parquet
                         +--> service ---+--> FPSim2 pattern screen + RDKit atom match (substructure)
MCP server (stdio|HTTP) /                 \-> PubChem PUG REST / PUG View for live data
此仓库于 2020 年创建,最初是一个基于 Indigo + Elasticsearch 的 PubChem 数据转储索引器;
相关代码可在 git 历史中 commit 06619d9 之前找到。
许可证
MIT。请参阅 LICENSE。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。