关于 cogvault
cogvault 是面向 Agent 的本地记忆服务,可为普通 Markdown 文件建立索引,无需 LLM。它结合语义与关键词搜索,并支持隔离的租户目录;Markdown 始终是可编辑的事实来源。
主要功能
- 01基于 Markdown 的记忆
- 02向量与 BM25 混合搜索
- 03隔离的租户目录
- 04增量索引
- 05可选时间衰减与 MMR
适用场景
- 01跨 Agent 会话查找决策
- 02搜索现有 Markdown 笔记库
- 03为多个 Agent 分隔记忆
- 04根据标注查询评估召回效果
MCP 相关
MCP 服务提供 cogvault_recall,用于混合搜索记忆;并提供 cogvault_record,将事实保存为已索引的 Markdown 卡片。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
uvx cogvaultCOGVAULT_MODELEmbedding model override; otherwise .cogvault.toml in the tenant, then the multilingual defaultCOGVAULT_LOGRecall log: 'off' to disable, or a path to relocate the JSONL log本地服务需要在你的电脑上安装运行环境(如 Node.js 18+)。各客户端的配置文件位置不同,请参考客户端文档。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍




30 秒快速上手
Claude Code 插件 — MCP 服务加上一项技能,用于告诉 Agent 何时回忆以及 何时记录:
/plugin install cogvault --marketplace NBibikov/cogvault
Claude Code 低于 2.1.275 的版本:先运行 /plugin marketplace add NBibikov/cogvault,再运行
/plugin install cogvault@cogvault。
记忆存储在 ~/.cogvault/memory 中(设置 COGVAULT_TENANT 可更改路径)。该插件
还会添加 /cogvault:remember。
任意 MCP 客户端,一行命令(需要 uv):
claude mcp add cogvault -- uvx cogvault mcp --tenant ~/agent/memory
Claude Desktop、Cursor、Windsurf、Cline — JSON 配置
将以下内容添加到 claude_desktop_config.json、~/.cursor/mcp.json 或客户端的 MCP 配置中:
{
  "mcpServers": {
    "cogvault": {
      "command": "uvx",
      "args": ["cogvault", "mcp", "--tenant", "~/agent/memory"]
    }
  }
}
已有 Markdown 记忆? 将租户指向它即可,无需导入。Claude
Code 的自动记忆可以直接使用(包括 frontmatter type、[[links]] 等):
M=~/.claude/projects/<project>/memory
uvx cogvault index  --tenant $M --ignore MEMORY.md   # first pass embeds, later passes are incremental
uvx cogvault search --tenant $M "how do we deploy"
MCP 服务会在启动时自动建立索引;CLI 的 search 会读取现有索引。
--ignore MEMORY.md 可避免索引文件与其指向的卡片争抢检索结果。
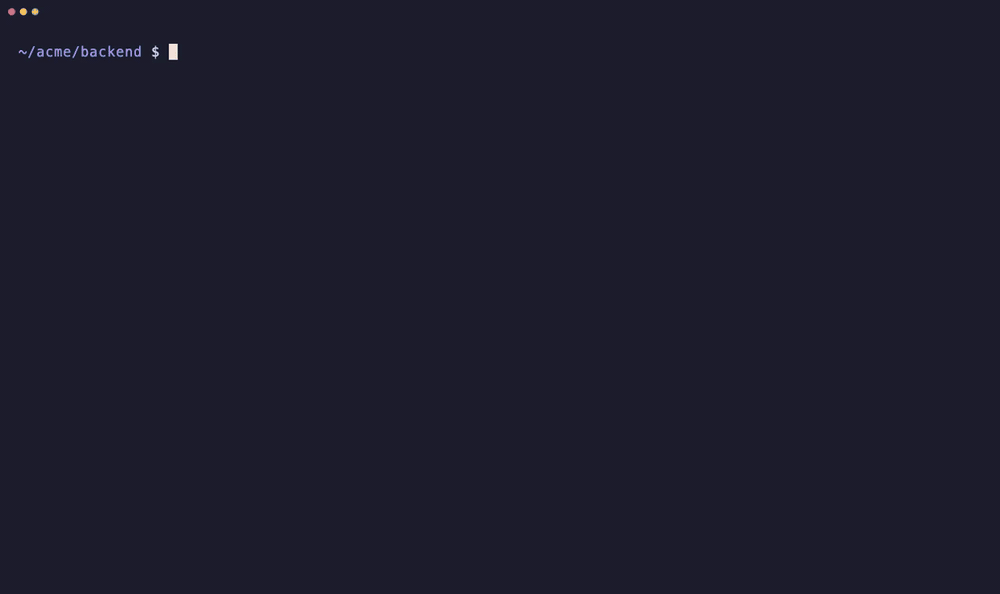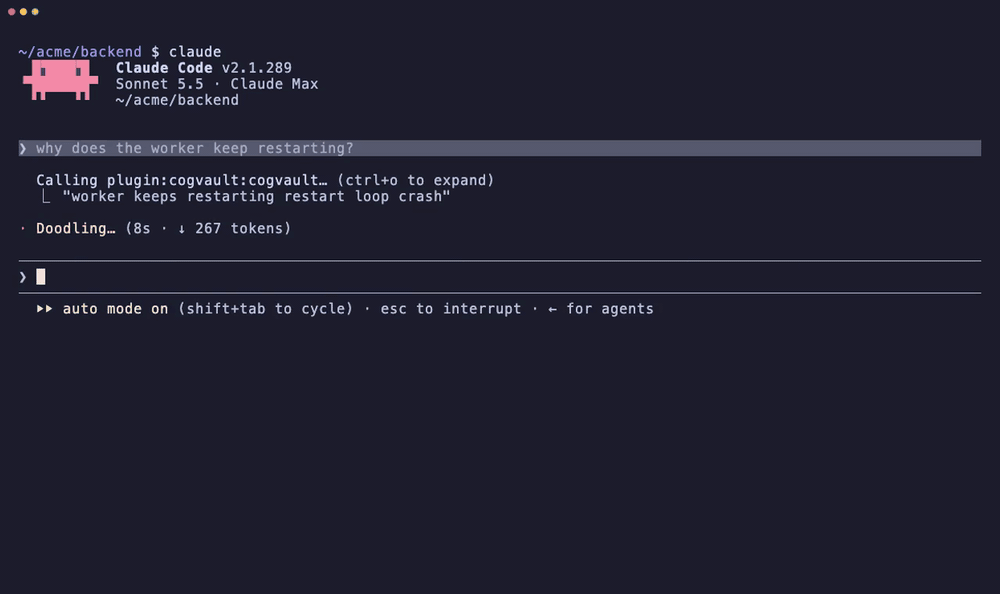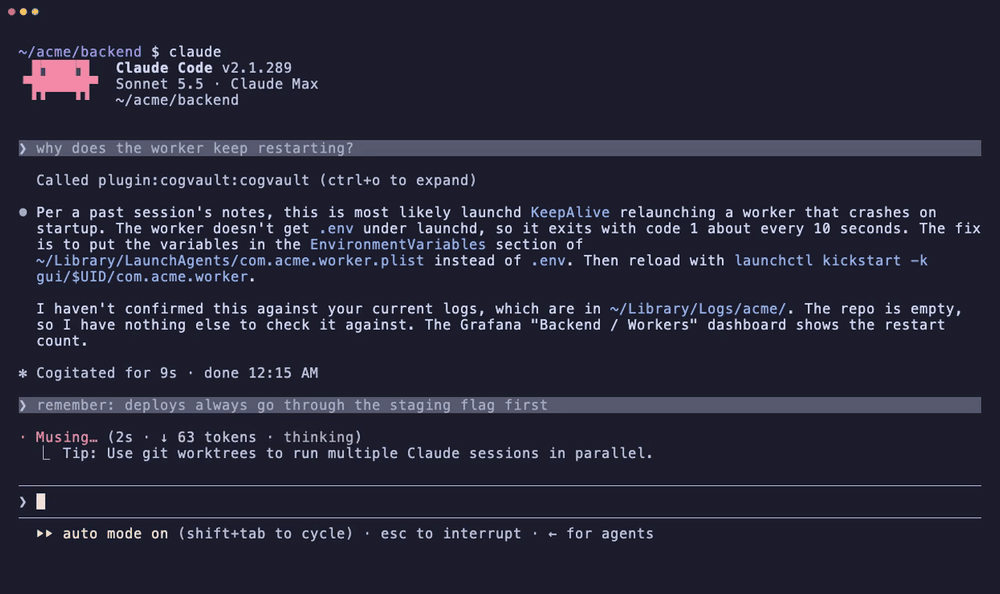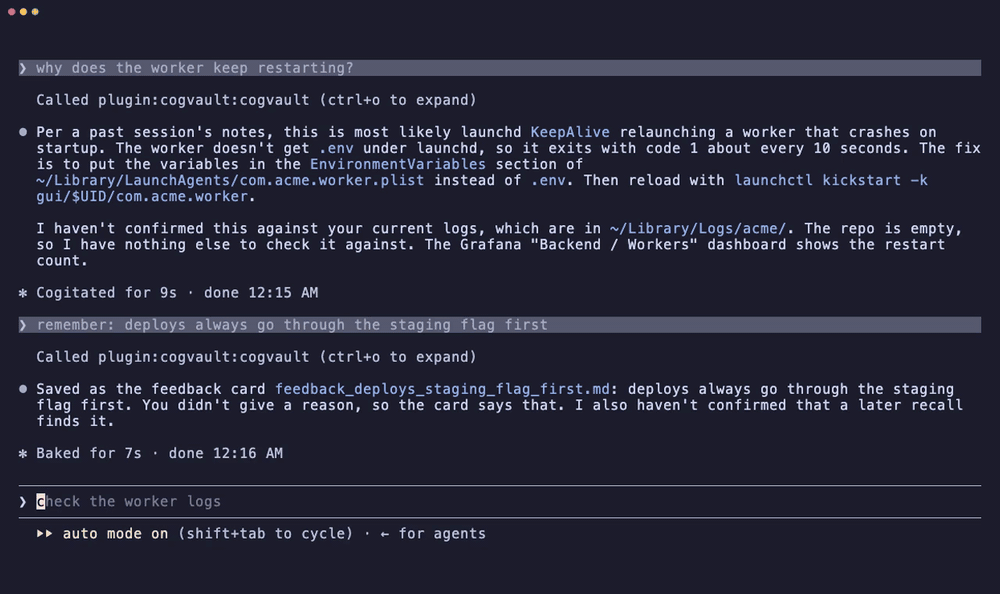
来自真实会话的未经编辑的回答(Sonnet,已安装插件,包含六张卡片的演示记忆);仅删去了等待时间。
为什么
大多数“AI Agent 记忆”工具都想成为自主运行的 LLM 守护进程,将你的工作总结到不透明的数据库或无法读取的图谱中。对于只需要可靠地回忆决策、缺陷修复或基础设施细节的编码 Agent 集群来说,这并不是合适的取舍。
cogvault 选择了相反的方向:
- 你的 Markdown 文件是事实来源。 可以打开、编辑,也可以用
git diff查看。SQLite 索引只是派生缓存——删掉后会从文件重新构建。 - 一个库,多个租户。 每个 Agent 都通过自己的目录获得隔离的记忆命名空间。一个进程只加载一次各嵌入模型,并在其接触的所有租户之间共享;使用 stdio MCP 服务时,这意味着每个 Agent 会话只需一个小型进程,而非中央守护进程。
- LLM 不参与其中。 写入和检索都是确定性的。你的 Agent 就是 LLM——记忆不需要第二个 LLM。
- 本地、私密、离线。 FastEmbed 在设备上运行。任何内容都不会离开你的机器。
对比
于 2026-10-05 对照各项目的 README 和文档核查。
| cogvault | basic-memory | mem0 | Graphiti | Letta Code | |
|---|---|---|---|---|---|
| 唯一事实来源 | Markdown 文件 | Markdown 文件 | 向量数据库(Qdrant / pgvector) | 图数据库(Neo4j、FalkorDB、……) | 每个 Agent 在各自 git 仓库中的 Markdown |
| 存储或回忆是否需要大模型 | 否 | 否(可选重排器) | 默认需要(add() 会提取事实) | 摄取时需要 | 需要——由 Agent 编辑自己的记忆 |
| 检索 | 向量 + BM25、RRF、衰减、MMR | 全文 + 向量,可选重排 | 语义 + BM25 + 实体 | 语义 + BM25 + 图 | 文件搜索;可选混合检索 |
| 基础设施 | 单进程、SQLite 文件 | 单进程、SQLite(可选 Postgres) | 库,或 Docker + Postgres 服务 | 图数据库 | Letta 后端 |
在以下情况下选择其他方案: 你希望由大模型为你提炼并合并事实(mem0);实体间的关系是重点(Graphiti);你希望 Agent 管理自己的记忆(Letta);或者你想要一款基于相同 Markdown 理念、功能更丰富的笔记应用,支持 Obsidian 同步和托管选项(basic-memory——与 cogvault 最接近)。
在以下情况下选择 cogvault: 你运行多个 Agent,并希望每个 Agent 的记忆都隔离在各自的目录中,由一个进程统一管理;你希望回忆过程可确定且离线;并且你希望对它进行度量——cogvault eval 会根据 Agent 的真实查询为回忆效果评分,cogvault analyze 会列出它们尝试回忆但未能找回的内容。
工作原理

回忆机制剖析

混合检索通过倒数排名融合融合语义(向量)和关键词(BM25/FTS5)排序,然后可选应用时间衰减(近期记忆优先于陈旧记忆)和 MMR(让靠前的结果更多样,而不是出现 5 个近乎重复的结果)。每张卡片只贡献其最佳文本块,因此单个长文件不会占满整个结果列表。
基准测试

使用真实召回流量进行测量,而非合成问题:从 6 个在线 Agent 租户的查询日志中抽取 66 个查询(58% 为乌克兰语,其余为英语),并根据实际卡片逐条判断——包括没有任何配置返回答案的查询。其中一个查询在记忆中没有答案,计为一个缺口,因此评分查询共 65 个。每种配置都在相同租户的副本上使用 cogvault 0.11.0 从头重新建立索引。
| 配置 | hit@1 | hit@5 | MRR@10 |
|---|---|---|---|
multilingual-e5-small,chunk_chars = 700,摘要分块 | 0.57 | 0.91 | 0.70 |
multilingual-e5-small,chunk_chars = 700,无摘要分块 | 0.55 | 0.86 | 0.69 |
paraphrase-multilingual-MiniLM-L12-v2(内置默认配置) | 0.54 | 0.80 | 0.66 |
bge-small-en-v1.5(仅英语) | 0.57 | 0.77 | 0.65 |
这些数字能说明什么,不能说明什么:
- hit@1 不相上下。 四种配置的结果都在 0.54–0.57 之间,95% bootstrap 区间几乎完全重叠。真实 Agent 查询读起来像卡片标题,因此通常仅凭卡片名称就能选中正确卡片。
- 差距体现在前 5 个结果中。 在这种混合语言的记忆中,带摘要分块的 e5-small 能让 91% 的查询在前 5 个结果中找到答案,而默认 MiniLM 为 80%,仅支持英语的 bge 为 77%。这正是 Agent 实际读取 5 个结果时能感受到的差异。
- 65 个查询仍然只是小样本。 对小于约 0.1 的差异,应视为噪声。汇总数据见
assets/benchmark.json;查询内容为私有数据,并保留在各自租户中。
重排序
交叉编码器会同时读取查询和每张候选卡片,因此它可以判断哪张卡片能回答问题,而不仅仅是判断哪张卡片与问题主题相同。设置 rerank = "BAAI/bge-reranker-v2-m3-int8" 后,cogvault 会根据每个卡片文件的前 800 个字符,为混合检索的前 10 个结果评分并重新排序。在同一组 65 个查询上(cogvault 0.12.0,e5-small + 摘要分块):
| hit@1 | hit@5 | MRR@10 | |
|---|---|---|---|
| 仅混合检索 | 0.60 | 0.88 | 0.70 |
| 混合检索 + 重排序器 | 0.80 | 0.91 | 0.85 |
重排序器改善了 17 个查询,使 3 个查询变差。hit@1 提升幅度的 95% bootstrap 区间为 +0.09 至 +0.34。代价是约 2 GB RAM,以及在 Apple M 系列 CPU 上每次召回耗时 1–2 秒,因此它仅在共享守护进程和 cogvault eval 中运行(--no-rerank 会在不使用重排序器的情况下评分)。
在你自己的记忆上运行相同的检查:将经过判断的查询放入
<tenant>/.cogvault-golden.jsonl({"query": "...", "relevant": ["file.md"]},relevant 为空表示已知缺口),然后运行 cogvault eval --tenant DIR。
选择嵌入模型
Agent 的记忆通常不只包含英文。默认使用多语言模型,确保开箱即用——但请根据你的设备群的语言组合选择合适的模型(设置 COGVAULT_MODEL,或使用 Config(model=...))。切换模型时会自动重建索引。
模型(COGVAULT_MODEL) | 维度 | 大小 | 真实查询 hit@5* | 西里尔字母 / 多语言 | 适用场景 |
|---|---|---|---|---|---|
paraphrase-multilingual-MiniLM-L12-v2 (默认) | 384 | 0.22 GB | 0.80 | ✅ 可用 | 多语言设备群;安全的默认选项 |
BAAI/bge-small-en-v1.5 | 384 | 0.13 GB | 0.77 | ❌ 西里尔字母向量会出错 | 仅含英文的记忆 |
intfloat/multilingual-e5-small | 384 | 0.47 GB | 0.91 | ✅ 每 GB 表现最佳(512-token 窗口) | 多语言设备群;使用 chunk_chars = 700 |
intfloat/multilingual-e5-large | 1024 | 2.24 GB | 未测量 | ✅ 最佳 | 追求最高质量,且内存充足 |
*数据来自上方的基准测试:针对混合英语和乌克兰语记忆进行的 65 次真实查询,cogvault 0.11.0。对于仅含英文的记忆,bge-small-en 是不错的选择;但对于乌克兰语内容,它会返回负相关性边际(干扰项的排名高于答案),因此不适合非英文记忆。请在自己的知识库上运行 cogvault eval 来做决定。
COGVAULT_MODEL=BAAI/bge-small-en-v1.5 cogvault index --tenant ~/agent/memory
按租户固定模型,让模型随数据一起使用,而不是依赖每条命令都导出 COGVAULT_MODEL(一旦忘记,模型不匹配就会悄悄重新嵌入整个索引)。在租户根目录下放置 .cogvault.toml:
# ~/agent/memory/.cogvault.toml
model = "BAAI/bge-small-en-v1.5"
# optional: recursive = true, strip_frontmatter = true, ignore_globs = ["Templates/*"]
现在,cogvault search --tenant ~/agent/memory "…" 无需环境变量即可使用正确的模型。优先级:显式指定的 --model / $COGVAULT_MODEL > .cogvault.toml > 内置默认值。
安装
uv tool install cogvault        # CLI on PATH
# or
pip install cogvault
也可以跳过安装,按需使用 uvx cogvault … 运行。首次运行时会下载嵌入模型(约 0.2–0.5 GB,每台机器只需下载一次)。
一行命令即可将其作为 MCP 服务添加到 Claude Code:
claude mcp add cogvault -- uvx cogvault mcp --tenant ~/agent/memory
它也已列入官方 MCP Registry,名称为 io.github.NBibikov/cogvault。每个 GitHub 发行版都附带 Wheels。
快速入门
# index a tenant's markdown memory
cogvault index --tenant ~/agent/memory

# search (hybrid semantic + keyword)
cogvault search --tenant ~/agent/memory "how do I restart the worker service"

# enable temporal decay (recent wins) and tune diversity
cogvault search --tenant ~/agent/memory "deployment steps" --half-life 30 --mmr 0.5

# only cards of one frontmatter type (user / feedback / project / reference / …)
cogvault search --tenant ~/agent/memory "hard rules for deploys" --type feedback
记忆卡片
cogvault 支持两种轻量级 Markdown 约定(均为可选——普通文件也可以正常建立索引):
- Frontmatter
type——支持扁平格式(type: reference)或嵌套格式(metadata:→type: reference)。在建立索引时解析,并可在搜索时筛选(--type、MCPtype参数、search(card_type=...))。每条搜索结果都包含type字段;没有 frontmatter 的卡片会将该字段设为null。 [[wiki-links]]——链接目标会被编入索引,排名最高的搜索结果会包含一个related列表,其中列出索引中存在的关联卡片(不存在的链接会被忽略;按精确的文件名主干匹配)。
作为 MCP 服务使用(Claude Code、Cursor 及任何 MCP 客户端)
claude mcp add cogvault -- uvx cogvault mcp --tenant ~/agent/memory
提供两个工具:
cogvault_recall——以自然语言对该 Agent 的记忆进行混合搜索。可选的type参数可按一种 frontmatter 卡片类型筛选;排名最高的结果会包含根据其[[wiki-links]]生成的Related:行。cogvault_record——保存事实;内容会写入 Markdown 卡片并编入索引
为文件夹树编制索引(Obsidian 库、知识库)
默认情况下,一个租户是由 .md 文件组成的扁平目录。对于嵌套库
(例如 Obsidian,其中包含 01-Projects/…、frontmatter 和要跳过的文件夹),可选择启用:
cogvault index --tenant ~/vault \
  --recursive \
  --strip-frontmatter \
  --ignore ".obsidian/*" --ignore ".trash/*" --ignore "Templates/*"
--recursive会遍历子目录;文件保留相对于租户的路径,因此不同文件夹中同名的Tasks.md永远不会冲突。--strip-frontmatter会移除开头的 YAML--- … ---块,以免其中的键污染嵌入内容。--ignore GLOB(可重复使用)会跳过相对于租户根目录的路径。
search 和 mcp 也支持相同的标志,库则可使用 Config(recursive=True, strip_frontmatter=True, ignore_globs=(...))。索引采用增量方式:首次处理时会嵌入所有内容,之后只会重新嵌入有更改的文件。(参考数据:约 3,500 条笔记的库 → 约 9,500 个文本块,首次索引约需 3–4 分钟,之后热缓存召回耗时为个位数毫秒。)
作为库使用
from cogvault import Vault, Config

vault = Vault("~/agent/memory", Config(half_life_days=30))
vault.reindex()
for hit in vault.search("where are credentials stored"):
    print(hit["score"], hit["file"], hit["snippet"])
保持租户健康
cogvault doctor --tenant DIR 会报告会悄然降低召回效果的问题:缺少 frontmatter 或类型的卡片、旧式时间戳文件名、嵌套的 frontmatter、重复的 name: slug,以及无法解析到任何内容的 [[links]]。链接会根据 frontmatter 中的 name:、文件名主体、任一分隔符样式,以及是否包含卡片类型前缀进行解析;代码中的链接和指向租户外文件的路径不计入。
cogvault repair --tenant DIR 会修复可机械处理的问题(默认进行试运行,使用 --apply 写入更改):展开嵌套的 frontmatter、推断缺失的类型,将 card-<timestamp>-….md 重命名为 <type>_<slug>.md 并重写所有指向它的引用(包括 MEMORY.md),并为缺少 frontmatter 的 <type>_*.md 卡片添加最精简的 frontmatter。健康的卡片不会被改动,修复后的卡片会保留其 mtime,因此不会重置时间衰减。
效果日志
每次召回都会记录一行 JSONL,以便衡量记忆是否确实发挥了作用。cogvault analyze 会将日志整理成报告:
cogvault analyze            # recalls, latency, per-tenant hit distance, weakest hits, card writes
cogvault analyze --json     # machine-readable
cogvault analyze --since 7  # only the last 7 days (or --since 2026-10-05)
最重要的部分是效果最弱的命中:每个租户中按向量距离排序最差的十分位——这些查询中召回确实返回了某些内容(混合搜索几乎总会如此),但很可能没有返回答案。这份列表展示了你的 Agent 尝试召回却未能找到的内容,也就是有待填补的记忆空白。设置 COGVAULT_LOG=off 可禁用日志,或设置 COGVAULT_LOG=/path.jsonl 更改日志位置。
多租户集群
一个进程可连接多个租户——每个目录都是一个隔离的命名空间,测试套件已验证此行为(test_multi_tenant_isolation)。除非将 Agent B 指向 Agent A 的目录,否则 Agent B 永远无法召回 Agent A 的记忆。

每个 MCP 客户端都会启动自己的 cogvault mcp。没有守护进程时,这些进程中的每一个都会加载嵌入模型(约 1 GB),而且都无法负担重排器的开销。cogvault daemon 会为所有租户各加载一次模型,并通过 Unix 套接字提供服务(~/.cache/cogvault/daemon.sock,模式为 600)。cogvault mcp 和 cogvault search 会自动发现它并转发请求;此时 MCP 进程的内存占用会保持在约 40 MB。守护进程停止时,它们会像以前一样在进程内搜索,但不使用重排器,并在查询日志中记录一条 daemon-fallback 事件。
cogvault daemon            # run in the foreground
cogvault daemon --status   # ping it: version, loaded models, tenants served
模型在 10 分钟内没有搜索或重新索引操作后会被守护进程卸载,并在下一次召回时重新加载(该次调用额外耗时约 1.5 秒)。设置 --idle-unload SECONDS 或 $COGVAULT_IDLE_UNLOAD(设为 0 可保持模型加载状态)。使用 e5-small 和重排器测得:加载时约 1.8 GB,卸载后约 0.4 GB。ONNX Runtime 使用 4 个线程($COGVAULT_THREADS,0 = 使用所有核心),且不使用 CPU 内存 Arena,因此完整重新索引的峰值内存约为 1 GB,而不会在此后继续占用数 GB 内存。在守护进程停止时启动的垫片最多等待 60 秒;若守护进程仍未启动,它便会自行加载模型,并在守护进程恢复响应后立即卸载自行加载的模型。
重排器有独立的线程数设置($COGVAULT_RERANK_THREADS,默认值 = Apple 芯片上的性能核心数,否则为 4)。它只在召回时运行,也是召回延迟的主要来源:在 10 个 P 核上,召回 p50 耗时从 2.3 秒(4 个线程)降至 1.65 秒;使用 onnxruntime 1.31 后降至 1.05 秒(该版本还将 4 线程召回耗时降至 1.5 秒)。
在 macOS 上,可通过 launchd 运行它,并设置 RunAtLoad 和 KeepAlive(程序参数为 cogvault daemon)。升级 cogvault 后,请重启守护进程:
launchctl kickstart -k gui/$(id -u)/<label>。
设计说明
| 决策 | 原因 |
|---|---|
| Markdown = 事实来源 | 人类可读,可用 git 进行版本管理,可编辑,永远不会被锁在数据库中 |
SQLite + sqlite-vec + FTS5 | 无需基础设施的混合搜索;一个可移植的 .db 文件;可重建 |
| FastEmbed(默认使用多语言 MiniLM,384 维) | 进程内 ONNX,无需服务端、无需 API 密钥,约 220 MB |
| 内容哈希缓存 | 重新索引时仅为已更改的块生成嵌入 |
| RRF + 衰减 + MMR | 无需图数据库即可兼顾准确性、时效性和多样性 |
| 单进程,多租户 | 面向服务集群的基础设施,而非单用户桌面附属程序 |
| WAL + 增量重新索引 | 一个进程写入时,多个 Agent 可并发读取;仅为已更改的文件重新生成嵌入 |
| 可选的共享守护进程 | 服务集群中的每个模型只加载一份;守护进程停止时,客户端会退回到进程内运行 |
路线图
- 导入器(从其他存储迁移现有记忆)
- 可插拔的嵌入器(Ollama、兼容 OpenAI 的端点)
- 每张卡片的
valid_until时效性 - 可选的 FastMCP 传输方式
许可证
MIT — 你的记忆、你的文件、你的基础设施。永久如此。
图示由 assets/make_graphics.py 手工生成 SVG;运行 python assets/make_graphics.py --png 可重新生成。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。