关于 Benzi
Benzi 将源码编译为可查询的代码索引,并通过结构化工具提供调用、引用、继承和数据流信息。它面向使用 MCP 客户端或 Benzi 自带 Agent 的编码工作;编译器可独立接入现有 Agent,支持十种语言。
主要功能
- 01解析符号、调用关系与引用
- 02查询调用树和数据流
- 03定位定义及类层级
- 04支持十种编程语言
- 05提供 MCP 编译器服务
适用场景
- 01追踪错误数据值的来源
- 02评估修改函数后的影响范围
- 03查找符号定义与调用方
- 04让编码 Agent 查询代码结构
MCP 相关
Benzi 可作为 MCP 服务,将编译后的代码索引通过结构化工具提供给 Claude Code、Cursor 等 MCP 客户端。它提供调用者、调用树、数据流、定义和类层级等查询;Benzi Agent 的运行时追踪和受静态分析约束的编辑功能不通过 MCP 提供。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
20收录的工具列表 · 更新于 2 周前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| topic | enum | 是 | 读取的参考主题artifact | uids | languages | markup |
详细介绍

语言无关 · 模型无关 · 本地编译 · 自带密钥(BYOK)· 兼容 MCP


目录
— 什么是 Benzi —
— 在线演示 —
— 语言支持 —
— 快速入门 —
— SWE-bench Verified —
— 工作原理 —
— 工具集 —
— 功能 —
— Benzi 与 CC、DSH、OC 的对比 —
— 常见问题,以及 Benzi 的映射与 LSP/SCIP 索引器的对比 —
### Benzi 是什么
大多数 AI 编码 Agent 会用 grep 和 glob 把原始源代码塞进大模型的上下文窗口,然后寄希望于模型能找到重要内容。Benzi 会先解析每个文件——它基于 tree-sitter 构建,是一个真正的编译器——将代码转换为精确、可查询的映射。每个符号、每条调用边、每处引用,以及每个类的继承链,一次遍历,全部完成。
在回答任何问题之前,就会解析每个文件、解析导入、构建类的继承关系,并追踪每个标识符到其定义。调用流和数据流会在每个调用点汇合,因此只需一次工具调用,就能追溯错误值的来源。Claude Code 使用 grep;Cursor 使用嵌入;Aider 映射签名;Benzi 则以 O(1) 完成解析。目前支持 10 种语言,此外还提供用于 HTML、CSS 和 DOM-JS 的标记语言引擎——请参阅语言支持。Beta 期间可免费使用 Benzi。
你也可以尝试在在线演示中粘贴此仓库的链接!
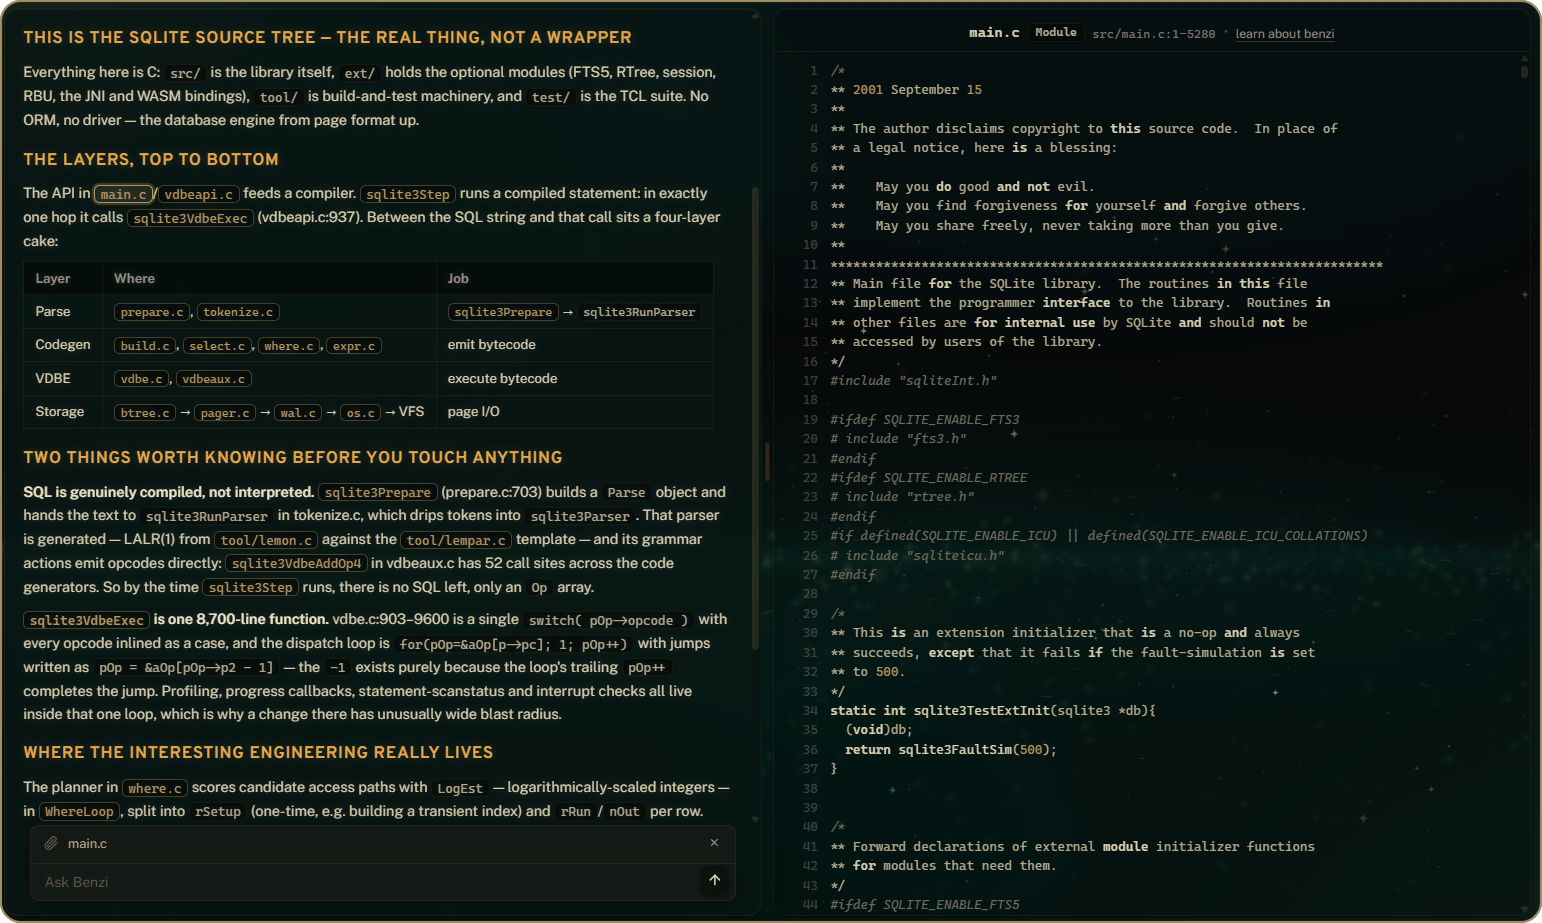
Benzi 在 SQLite 上的效果
喜欢这个方向?点个 ⭐,帮助很大。
在线演示
StallionSwipe · Python、HTML、CSS、JS —— 一款面向马匹的交友应用,由 Benzi 在一次聊天会话中从零开始构建。没有任何图像是文件:每匹马的肖像都是通过代码生成的程序化 SVG。配对成功后,它会通过真正的大模型实时与你调情。前端、后端和提示词——全部由 Benzi 编写。在线体验。
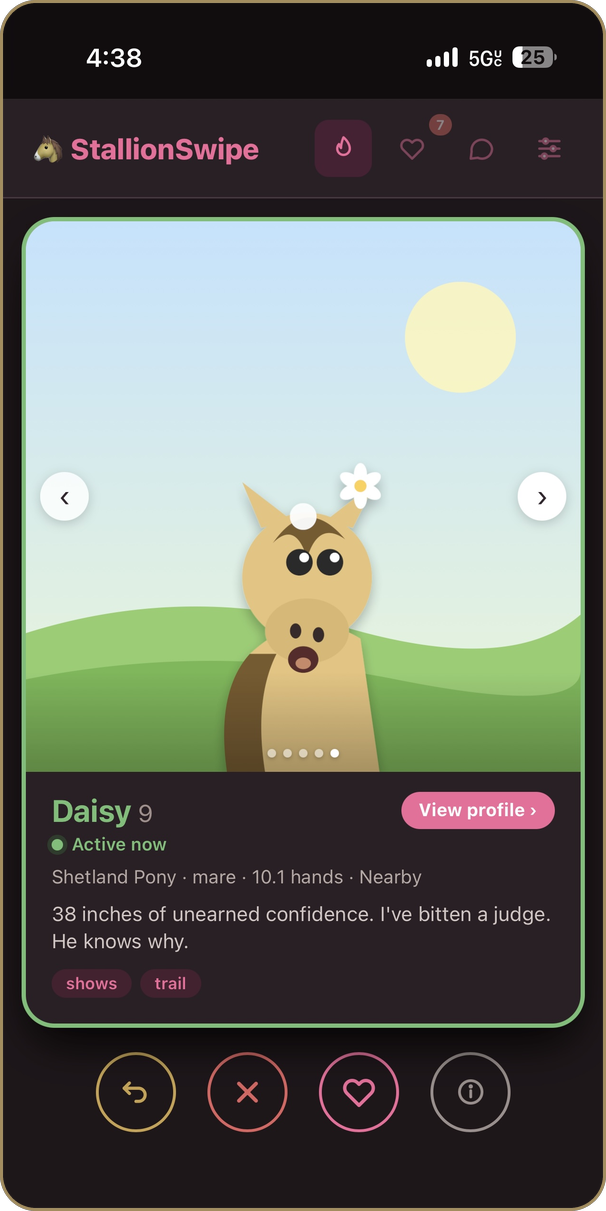
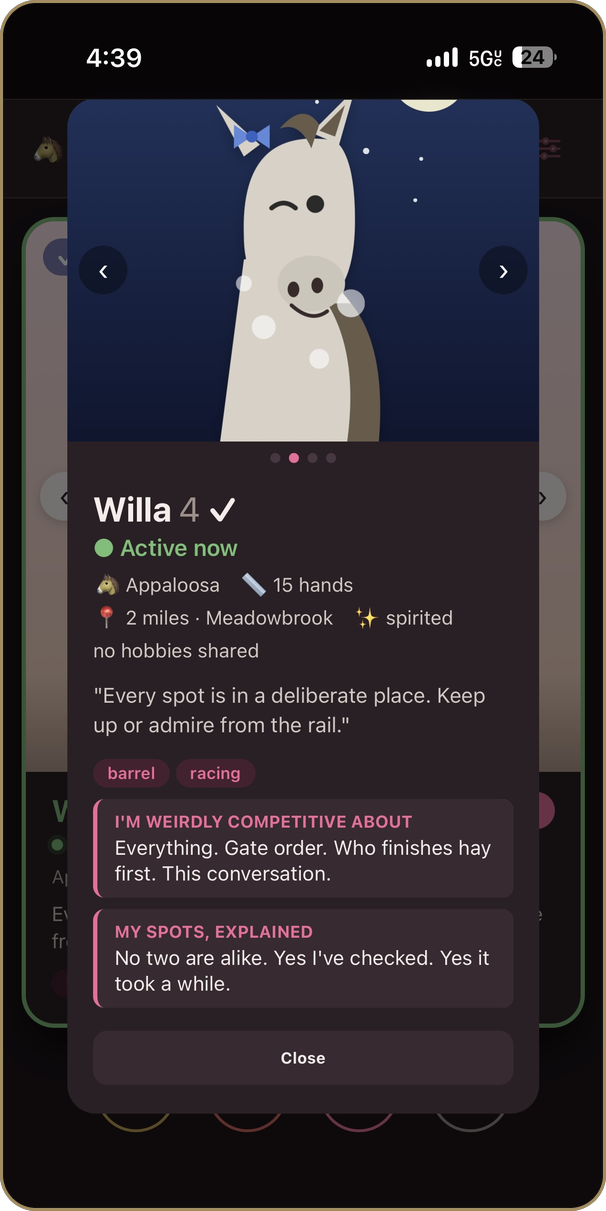
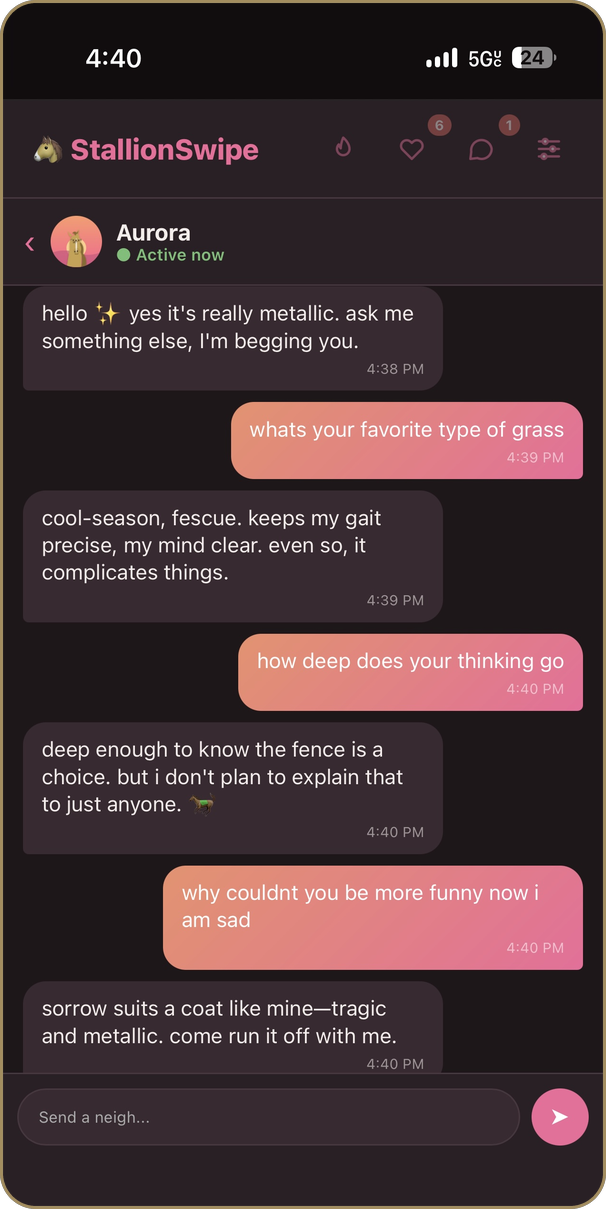
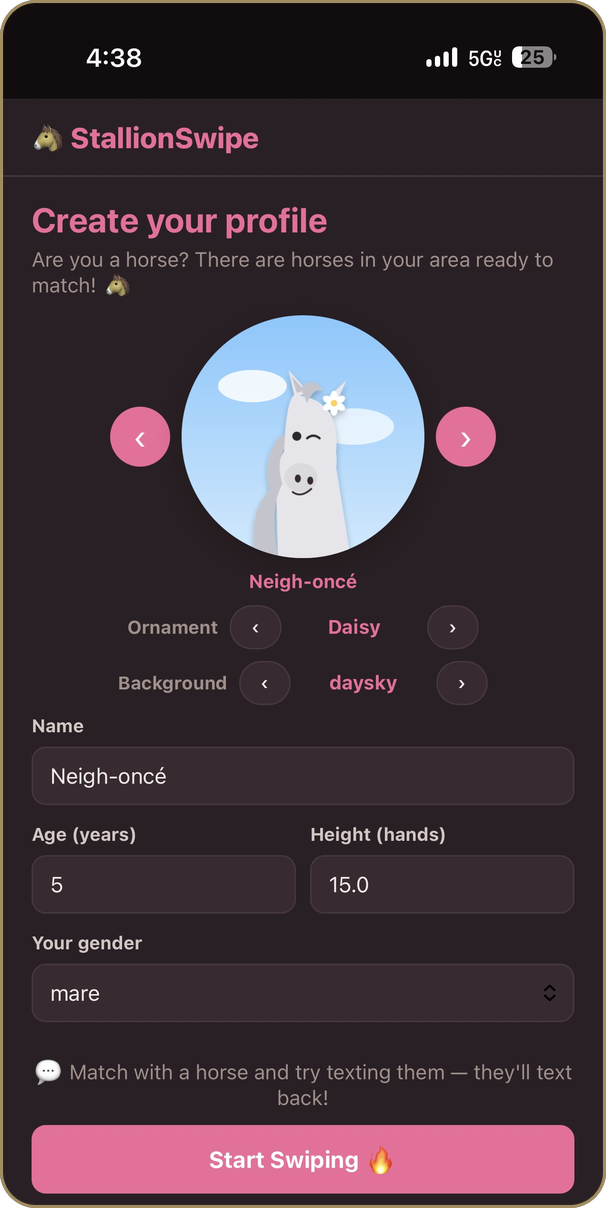
或者,在这里试试你选择的任意仓库 —— 让 Benzi 处理任意公开的 GitHub 仓库,它就会实时构建索引。varianttech.net/demo。
语言支持
Python · JavaScript · TypeScript · Java · C# · C++ · C · Go · Rust · Ruby
一个编译器,支持 10 种语言——每种语言都是一个 tree-sitter 语法插件,因此映射的核心内容(符号、调用边、引用、继承、数据流)在所有语言中都以相同方式构建。
支持深度不一。 Python 支持最深入,也是唯一带有运行时追踪器的语言。每种语言都能生成映射的核心内容,但各自都有尚未建模的语言结构。对于大多数代码,其他语言的映射效果都接近 Python。
运行时追踪器:暂时无法正常工作(2026 年 10 月 14 日)。 追踪运行仍会执行,但无法捕获在推导式、lambda 和生成器表达式内部发起的调用,也无法捕获 Python 3.9–3.10 项目中的大多数方法调用。修复将随下个版本推出。
C、C++、Rust 和 Ruby 的增量重新索引也尚未充分优化——功能可用,但在大型编辑循环中速度没那么快。
你所用语言的回答有误或内容不足?请附上仓库、问题以及回答错误之处,提交 issue——这样我们就能发现支持不完善的部分。
### 快速开始
Benzi 在 Beta 阶段完全免费。有两种使用方式,共用同一个登录配置:同一份 benzi-login 配置在任何地方都能使用。
-
Benzi Agent — Benzi 自带的 Agent,基于编译后的索引运行,可在 VS Code 中使用,也可从终端运行。这些功能属于 Agent 本身,因此 VS Code 和无头模式都支持,但无法通过 MCP 使用:
- 运行时跟踪器 — 运行代码并记录实际发生的情况:每次有歧义的调用实际命中了哪个目标,以及真实的参数值。
- 静态分析门控编辑 — 每次写入都会进行语法检查,并与最新索引核对,然后才会执行下一步;如果编辑导致代码出错,就会回滚,而不会基于错误代码继续操作。
- 每次编辑前后的影响范围 — 查看更改前哪些位置调用该符号、哪些位置持有该符号,以及哪些内容为其参数提供数据;更改完成后再次检查。
- 自动感知并升级到 pro — 当任务超出当前所用模型的能力时,Agent 会自动升级到更大的模型,任务完成后再切回。设置
BENZI_ESCALATE_MODEL=deepseek-pro(或其他模型别名)即可启用。 - 持久记忆与回滚 — 按仓库保存、重启后仍保留的事实,以及一键撤销任何编辑。
可通过以下任一方式运行:
-
VS Code 扩展 — VS Code Marketplace
- 从 VS Code Marketplace 安装 Benzi。
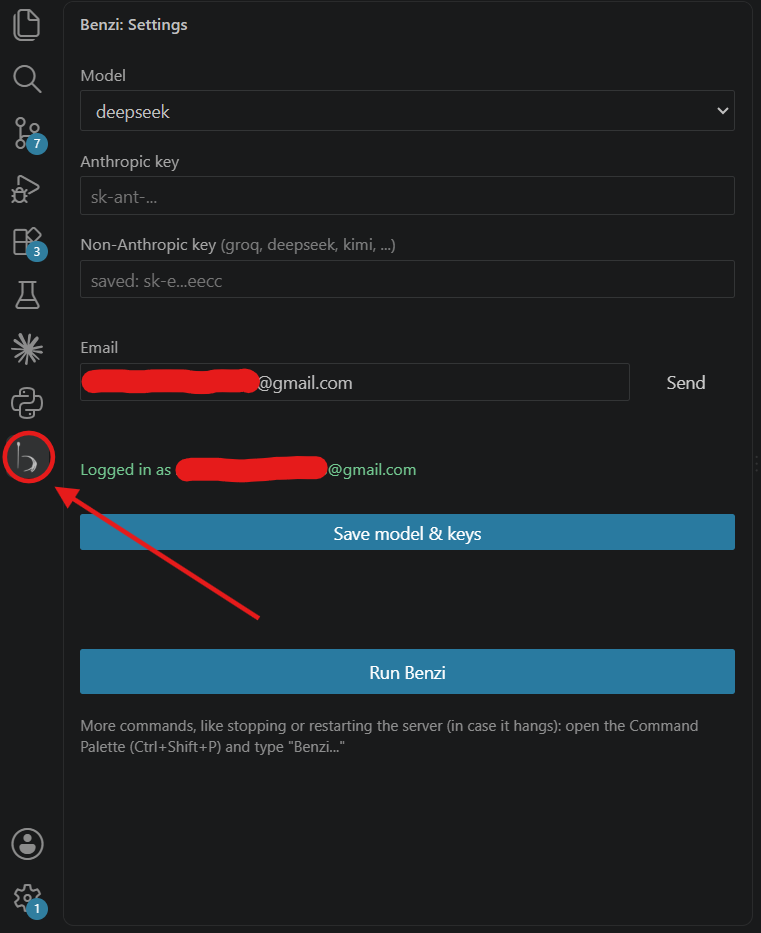
- 点击左侧活动栏中的 Benzi 图标(下图圈出的位置),打开 Benzi: Settings 面板。
- 选择模型并粘贴 API 密钥:可以使用 Anthropic 密钥,也可以使用非 Anthropic 密钥(DeepSeek、Groq、Kimi 等)。
- 输入电子邮箱并点击 Send,然后输入通过邮件收到的一次性验证码。
- 点击 Save model & keys,然后点击 Run Benzi。
-
无头 CLI — PyPI
操作步骤与 VS Code 扩展相同,只需在终端中安装、登录、设置模型和密钥,然后运行即可。
pip install benzi支持 Windows、macOS 和 Linux 上的 Python 3.11–3.14。安装后提供
benzi-login、benzi-headless和benzi-mcp命令。1. 登录 — 系统会通过邮件发送一次性验证码,输入该验证码即可。
benzi-login --login [email protected]2. 设置模型和密钥
benzi-login --model deepseek
benzi-login --nonanthropic-key YOUR_KEY      # 或者,使用 Claude 模型时:benzi-login --anthropic-key YOUR_KEY
3. 在仓库上运行 — 从终端运行,适用于脚本和 CI。
benzi-headless . "fix the failing test in parser.py"
-
作为 MCP 服务的 Benzi 编译器 — 将编译后的索引作为工具提供给你已经在使用的 Agent:Claude Code、Cursor 或任何 MCP 客户端。这相当于一张地图,但不包含 Benzi 的 Agent 循环,因此输出质量取决于你的 Agent,也不包含上述 Agent 功能。
步骤与无头模式相同:运行
pip install benzi,然后使用benzi-login登录。你可以跳过模型和密钥设置,因为模型调用由你自己的 Agent 完成。然后向 Agent 注册benzi-mcp,而不是运行benzi-headless。例如,在 Claude Code 中,只需为所有项目设置一次:claude mcp add --scope user benzi -- benzi-mcpbenzi-mcp随后会提供你启动 Claude Code 时所在文件夹的服务,因此切换项目时无需额外操作。若要固定使用某个仓库,不受启动位置影响,请传入该仓库的路径:claude mcp add --scope user benzi -- benzi-mcp /path/to/your/repo
VS Code 的设置面板和 benzi-login 共用同一份配置:登录一次,VS Code、无头模式和 MCP 都可以使用。
### SWE-bench Verified
完整的 SWE-bench Verified 数据集——来自 12 个 Python 仓库的 500 个真实 GitHub 问题——均使用 DeepSeek V4.1-Flash 端到端运行,每个实例尝试一次,并在各自独立的 Docker 镜像中通过官方 swebench.harness.run_evaluation 评测;所有容器均禁止访问 GitHub 和 PyPI 的网络。500 个实例中解决了 412 个(82.4%),总成本为 $12.96,每个修复约 3 美分,输入 token 中有 97.6% 由缓存提供。
| 已解决 | 412 / 500(82.4%) |
| 每个实例的尝试次数 | 1(pass@1) |
| 模型 | DeepSeek V4.1-Flash,采用默认力度的思考模式 |
| 500 个实例的总生成成本 | $12.96 |
| 每个已解决实例的成本 | $0.031 |
| 模型轮次:总计 / 每个实例的中位数 | 14,167 / 21.5 |
| 由提示词缓存提供的输入 token | 97.6% |
| 输出 token,总计(其中推理 token) | 13.5M(10.7M) |
完整技术报告:swebench-october/SWE_BENCH_REPORT.md(网页版本)。每个实例的成本、token 数和轮次:varianttech.net/benchmark_swebench。下方的跨评测框架效率对比(以及完整的 24 个 bug 图表):varianttech.net/benchmark。
工作原理
- 编译。 Tree-sitter 解析每个文件、解析导入、构建类的继承关系,并追踪每个标识符的定义。输出是索引,而非文本。
- 查询。 Agent 通过该索引上的结构化工具读取代码并制定计划——
profile、get_callers、backflow、trace_path、skim_source等约 30 种工具。 - 编辑,并设置门控。 每次写入都会通过真实解析器检查;如果解析失败,就会自动回退。写入前会检查影响范围——变更的符号、其调用方、其持有者以及相关测试;写入完成后还会再次检查。
- 运行验证。 在运行时追踪器下运行针对性的复现程序,以及影响范围检查标记出的测试。真实值、真实分发:这既能验证变更,也能确认映射——模糊的边会收敛到实际触发的目标。
- 增量重新索引。 每轮只重新解析磁盘上发生变化的内容——无论是你的编辑还是 Agent 的编辑,一视同仁。
- 从快照回退。 每次写入前都会为索引创建快照,因此撤销时会重新加载该快照,而不是重新推导索引。
- 返回第 2 步。 后续问题始终根据当前代码状态作答。
### 工具集
Benzi 的 35 多个工具中有 16 个。完整工具列表见此处。
| 工具 | 解答的问题 |
|---|---|
get_callers | 所有能到达某个函数的调用点——代码变更会影响到的部分。 |
call_tree | 从一个函数出发的传递调用闭包,可正向或反向追踪。 |
trace_path | 连接两个函数的调用链,以及沿途传递的数据。 |
external_calls | 某个作用域依赖了哪些库,以及它在何处调用这些库。 |
forwardflow | 某个函数的返回值最终流向何处,以及所有必须匹配的位置。 |
backflow | 错误值的来源,无需打开每个调用方。 |
profile | 一次调用即可查看某个符号的完整 360 度视图。 |
get_definition | 声明卡片——签名、文档和位置。 |
search_symbols | 在仓库的所有符号中进行不区分大小写的子串搜索。 |
get_hierarchy | 类型解析后的基类及其直接子类。 |
skim_source | 函数体的一层大纲,帮你判断哪些行值得阅读。 |
execute_from | 在调用追踪器下运行文件,并记录实际发生的情况。 |
check_last_execution | 读取上次运行记录的事实,无需重新运行。 |
execute_generated_testcase | 编写独立复现用例并运行,以调试自身变更。 |
rollback_edit | 通过重新加载快照撤销最近的写入,而非重新编辑。 |
upgrade_to_pro | 在任务进行期间将自身升级为更大的推理预算。 |
功能
- 六种状态,绝不猜测——每个调用点和每个文件都带有一种状态:已解析(已在仓库内证实的边)、外部(指向库,并附有导入证据)、候选(有歧义——完整保留范围有限的可能目标集合)、未解决(已发现但尚未确定,并说明 原因)、已观察(通过实际运行确认)、未索引(从未解析,并说明原因)。始终遵循一条规则:静态分析无法确定的内容会标记为未确定,而非猜测——运行程序才能确定它。
- 运行时追踪器——在执行期间挂钩每次调用,并将观察结果叠加到静态映射上。
- 可点击的推理依据——驱动这些工具的同一张映射也会在聊天旁显示实时调用图;Agent 提及某个函数时,该节点就会亮起。
- 持久记忆——每个仓库的持久事实会在重启后保留;只需学习一次的约定,不会在每个会话中重新推导。
- 双引擎:代码 + 标记语言——为 HTML/CSS/DOM-JS 单独建立索引,支持层叠解析和选择器优先级,也支持嵌入 Python 字符串中的前端代码。
- 与模型无关——支持 Anthropic、OpenAI 或任何兼容的 API;当问题超出当前模型的能力时,Agent 可以在任务进行期间将自身升级为更大的模型。
### 索引实际带来的变化
相同的 24 个 Bug,每个运行一次,共四种工具框架与模型组合。读取行数仅统计文件读取调用返回的内容——grep 和 shell 输出属于搜索,不算读取,因此这是所有工具框架中含义一致的唯一指标。
更多详情、按 Bug 拆分的数据和完整方法说明:varianttech.net/benchmark。
| 工具框架 · 模型 | 读取行数 | 相较于 Benzi |
|---|---|---|
| Benzi · Sonnet | 9,125 | — |
| Benzi · DeepSeek | 16,407 | 1.8× |
| Claude Code · Sonnet | 20,704 | 2.3× |
| DeepSeek Harness · DeepSeek | 43,598 | 4.8× |
随着 Bug 越来越难,每种工具框架都会打开更多源码——关键在于增长幅度。Benzi 的增长更平缓,因为它通过索引回答了 Bug 的大部分问题,而不是靠读取源码。
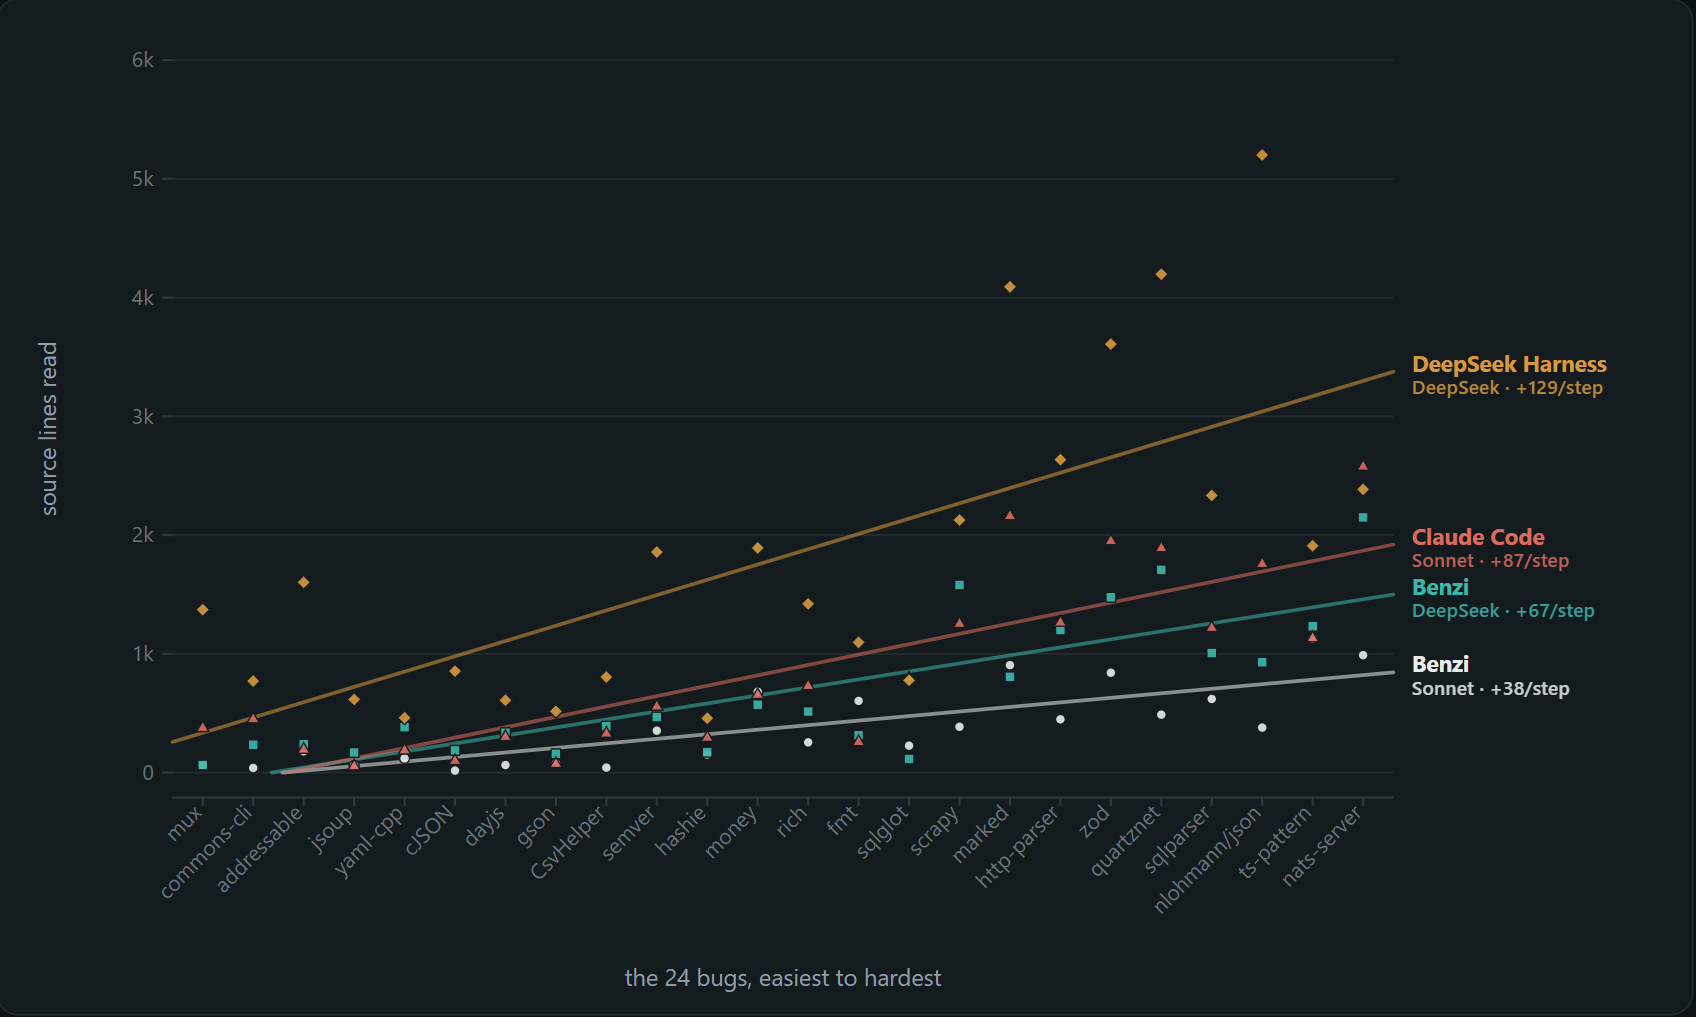
对于每个 Bug,Benzi 读取的源码都最少;Bug 越难,差距就越大——在打开文件之前,索引就已回答了修复所需的大部分问题。
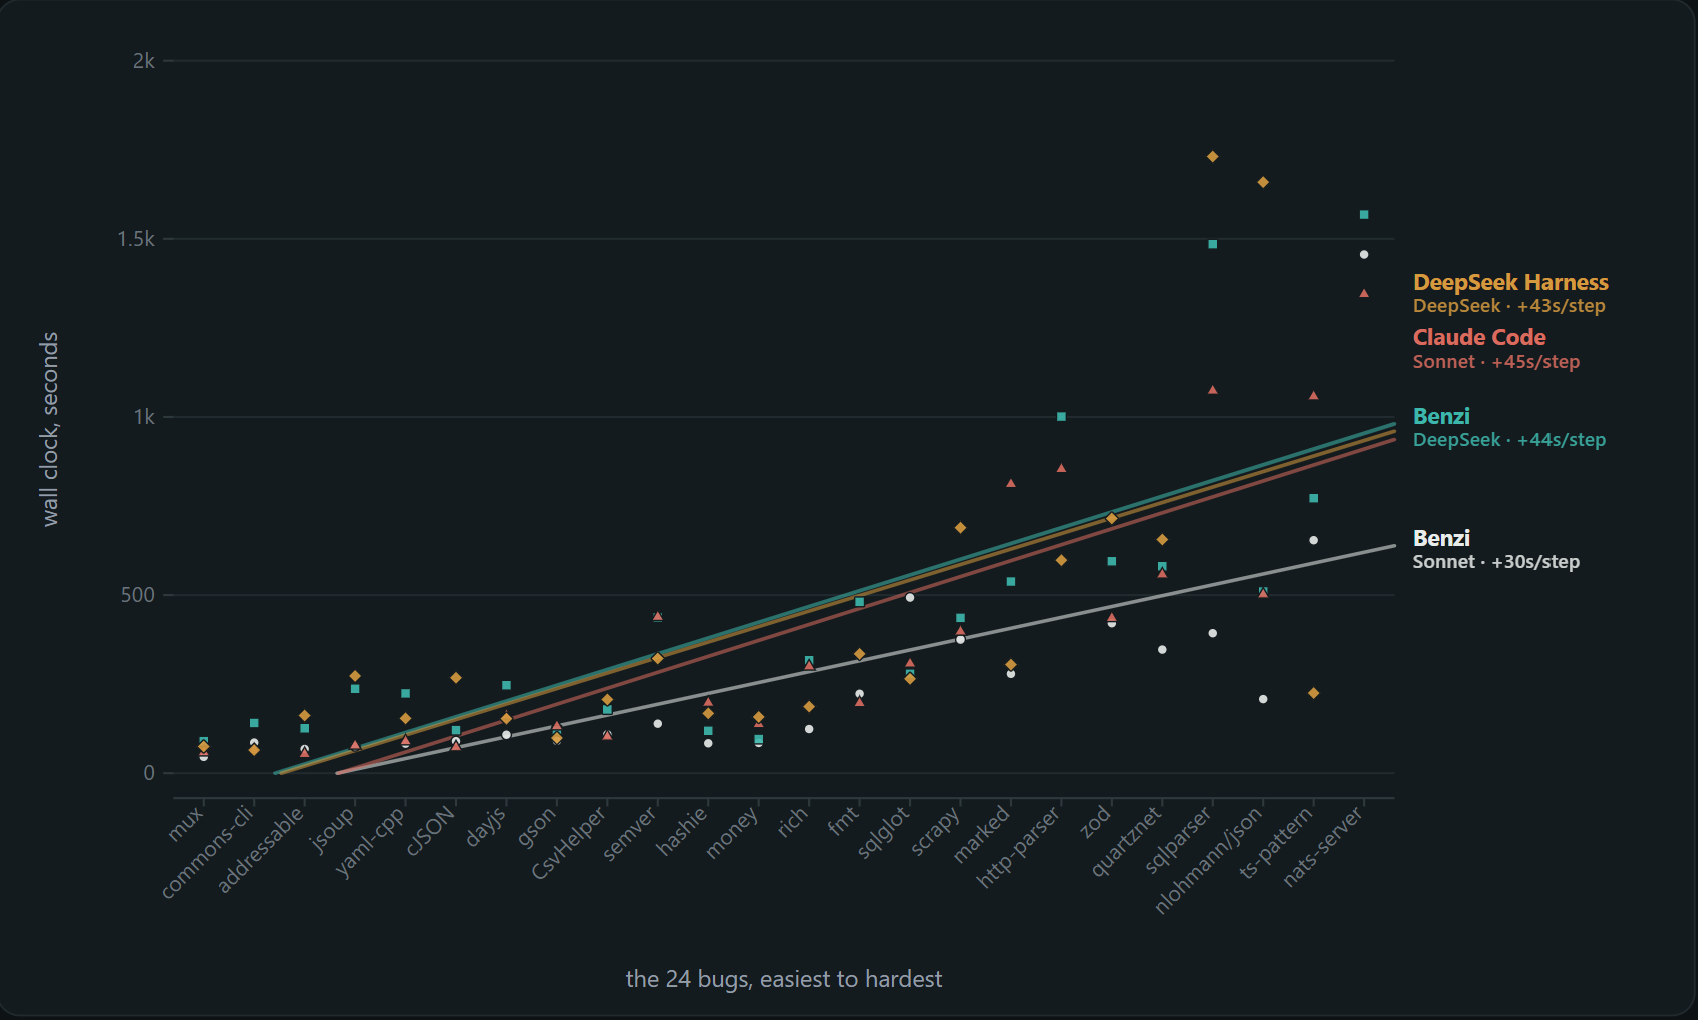
四种工具框架的实际用时相差不大——少读源码并不会让 Benzi 思考得更慢,只是降低了查找成本。
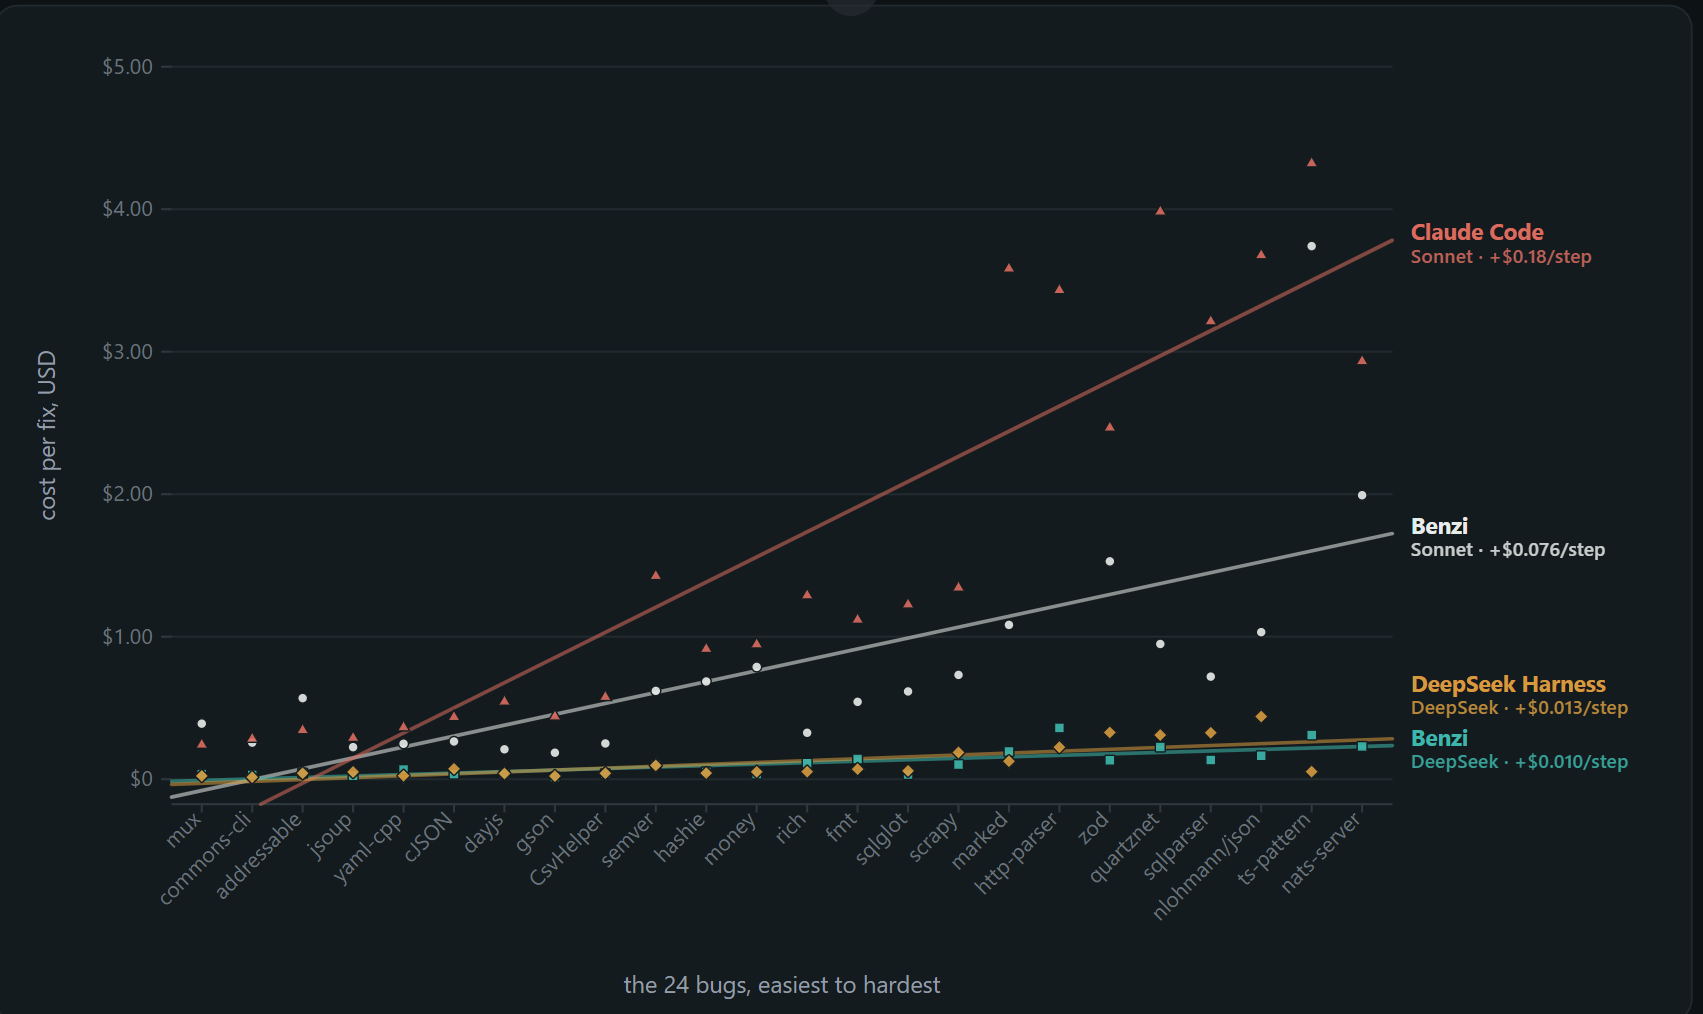
Benzi 使用 DeepSeek 时,每个 Bug 的成本约为 1 美分;随着 Bug 难度增加,Claude Code 的成本升至每步 0.18 美元——约为其 18 倍。
常见问题与比较
我的代码会离开本机吗? 不会。在 VS Code、CLI 或 MCP 中,编译器和索引都在本地运行——不会上传,也不会保留副本。只有 Agent 实际读取的代码片段会发送给你的模型提供商,这与任何 AI 助手一样,而且发送的内容更少:在相同的 24 个 Bug 上,读取 9,125 行,而 Claude Code 读取了 20,704 行。浏览器演示则不同——它会在服务端获取一个公开仓库,仅供读取,并在会话结束后删除。
它真的免费吗? 是的,Benzi 不收费。CLI 和 MCP 采用 BYOK 模式,因此你需要自行向模型提供商付费。产品仍处于早期阶段,并在持续开发中——这就是取舍,而不是付费墙。
它能在本地模型上运行吗? 原则上可以:Benzi 通过标准 API 与模型通信,因此本地模型(Ollama、LM Studio 等)可以接入。不过目前尚未支持。现在,Benzi 运行在托管服务提供商上,你需要使用自己的密钥。
我可以让它处理私有仓库吗? 网页演示不行(仅支持公开 GitHub API)。其他场景都可以——编译器会在本地处理你指定的任意路径。
它能处理多大的仓库? 浏览器演示的上限为 2,000 个文件,每个文件最大 2 MB。
它与 Cursor、Copilot 或 Claude Code 有什么不同? 它们进行搜索——使用 grep 或嵌入。Benzi 会先解析:构建包含符号、调用、继承和数据流的真实索引,然后基于索引查询,而不是猜测。在相同的 24 个 Bug 上,读取的源代码比 Claude Code 少 2.3 倍。详情请见:索引实际带来的变化。
它与基于 LSP 的 MCP 服务有什么不同? LSP 在光标所在位置、单个打开的文件中响应:跳转到定义或查找引用,一次处理一个位置和一跳。Benzi 会预先编译整个仓库,生成一个索引,因此可以回答针对整个代码库的问题:传递调用树、两个函数之间的路径,以及数据流,也就是错误值的来源或返回值的去向。每个答案还会标注置信度级别:已解析、候选、未解析(附带原因)或已观察。LSP 要么给出答案,要么不作回答。接着,运行时追踪器会观察实际触发的内容,解决静态分析无法解决的问题。编译器本身还与语言无关:十种语言通过同一条管线,生成同一种索引格式。LSP 则需要为每种语言单独配置服务端,并分别安装、配置和保持运行。
它与 CodeQL 或 Sourcegraph 的 SCIP 索引器有什么不同? 它们需要项目能够正常构建,并通过批处理建立索引:安装依赖、确保项目可以编译,CI 作业通常需要数分钟。Benzi 无需构建,即使代码尚未完成也能运行,并会在每次交互时只重新解析发生变化的部分。这使得写入门控成为可能:每次编辑都会在下一步之前根据最新索引进行检查,而不是等到重新构建之后。一个管线可覆盖全部十种语言,而不必为每种语言各用一个索引器。如果因此损失精度,Benzi 会将调用点标记为候选或未解析,而不是猜测。
它与 CodeGraph 有什么不同? 两者都会建立索引而不是进行搜索,但 CodeGraph 会检索——从查询的数据库中返回排名靠前的候选结果。Benzi 会解析——在回答之前确定名称所绑定的对象;如果调用点存在歧义,它会拒绝作答,而不是猜测。它还会像工程师阅读代码那样建模——文件 → 作用域 → 调用流 → 数据流/控制流,而不是构建扁平的符号图。
在 CodeGraph 自己的基准测试中(使用他们的仓库、问题和方法),Gemini、ChatGPT、Claude 和 DeepSeek 分别从全新账户评审了答案,四者都将 Benzi 排在第一。完整结果:varianttech.net/benchmark_codegraph。
由  Variant Technologies · varianttech.net
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。