关于 Neurarch
Neurarch 是面向机器学习开发者和 Agent 的 MCP 服务,用于在启动前评估模型结构和训练任务。它估算内存与 GPU 适配情况、诊断显存溢出,并提供离线结构检查。
主要功能
- 01估算训练峰值内存与 GPU 适配
- 02比较不同显卡可用的批次大小
- 03诊断 CUDA 显存溢出
- 04检查模型架构和层影响
- 05离线运行模型检查
- 06读取过往运行记录
适用场景
- 01训练启动前检查 GPU 是否适配
- 02为可用显卡选择批次大小
- 03显存溢出后排查可能原因
- 04开发期间验证模型结构
MCP 相关
Neurarch 向 Claude Code、Cursor、Claude Desktop、VS Code、Windsurf 和 Codex 等 MCP 客户端提供模型分析与训练规划工具。大多数工具可在本地离线运行;plan、history 和 model_changes 会访问外部数据。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
neurarch-mcp
在占用 GPU 资源之前,就能在 Agent 内了解 GPU 作业的需求。适用于 Claude Code、Cursor、Claude Desktop、VS Code、Windsurf 和 Codex 的 MCP 服务。
- 小型作业: 将它们打包运行,或迁移到更小的显卡上。
- 大型作业: 一次就选对显卡数量和分片方式。
- 由 Agent 启动的作业: 在使用 GPU 之前设置一道关卡,因为 Agent 无法评估自身作业所需的资源。




作业启动前调用 size_training_job,Agent 就能根据眼前的模型、批次和显卡了解:峰值显存(分别显示权重和优化器状态、激活值、存储的注意力分数)、能够容纳作业的最小显卡、每种显卡所能容纳的最大批次、单张显卡容纳不下时的双卡拆分方案、单次运行成本,以及一行结论,例如 will not fit a T4: needs ~30 GB with headroom (peak 26 GB) at batch 32, seq 2048, use L40S or batch <= 12。history 还会显示你所在组织中该结构上次运行时测得的数据。发生 CUDA 显存溢出错误后,diagnose_oom 会根据同一估算结果分析错误信息,指出原因(显卡容量不足、内存碎片、其他进程占用、大词表导致 logits 过大、运行期间内存增长),并优先给出影响最小的修复方法。接下来,它会检查作业能否通过前向传播:也就是 CI 机器人运行的结构检查(lint_model、check_design),离线时也能运行。无论作业由人还是 Agent 编写,它的回答都一致;这正是 GPU 账单的负责人想知道的问题。
查看效果
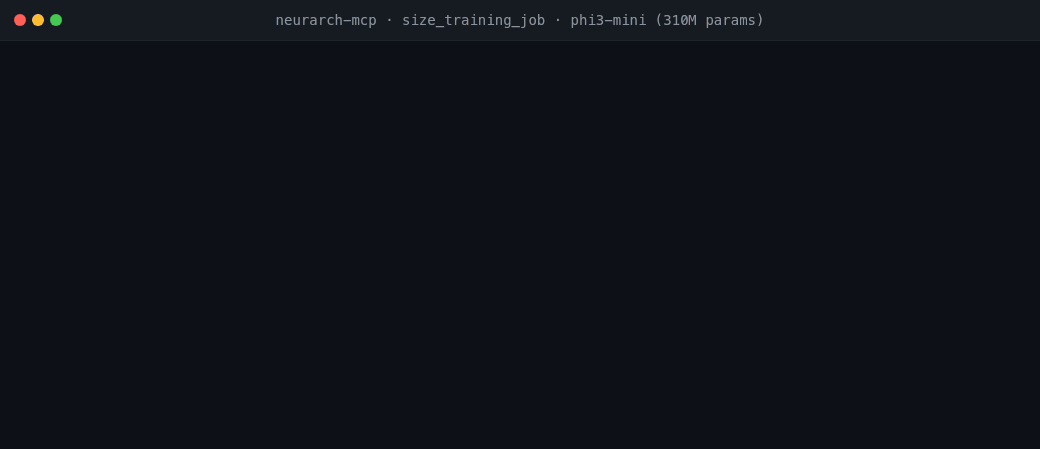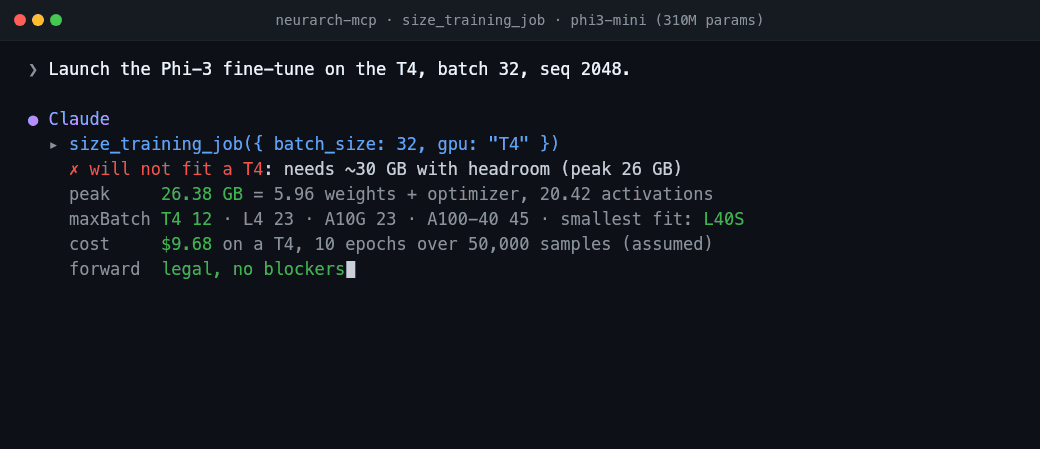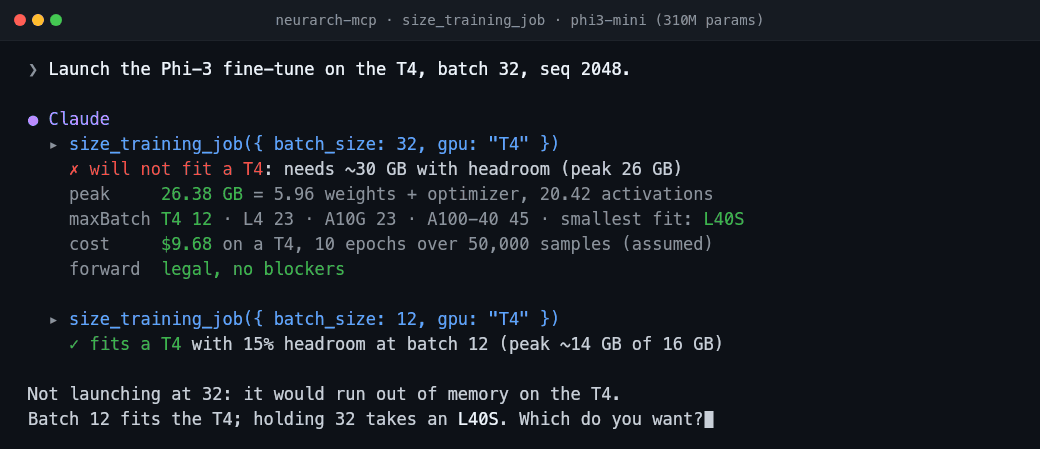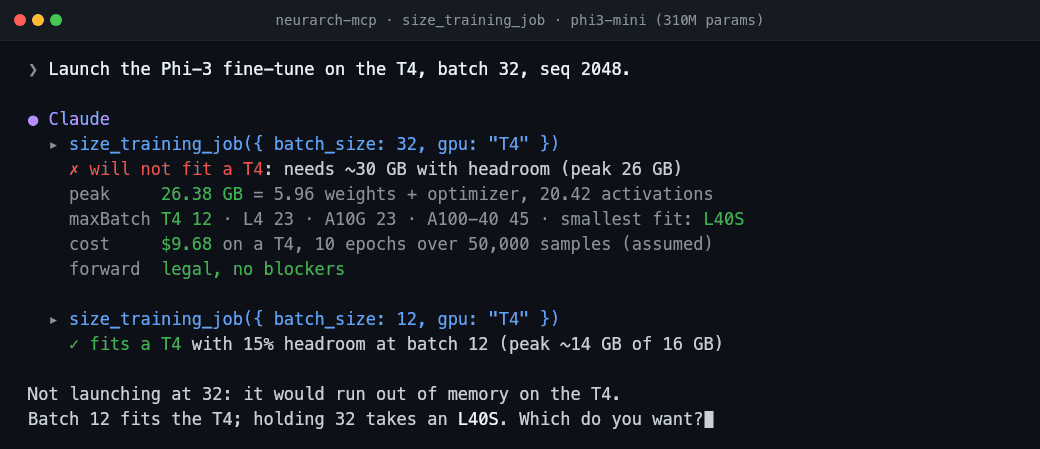
启动前。 该任务无法装入即将使用的显卡,因此 Agent 按工具给出的批次大小重新评估:
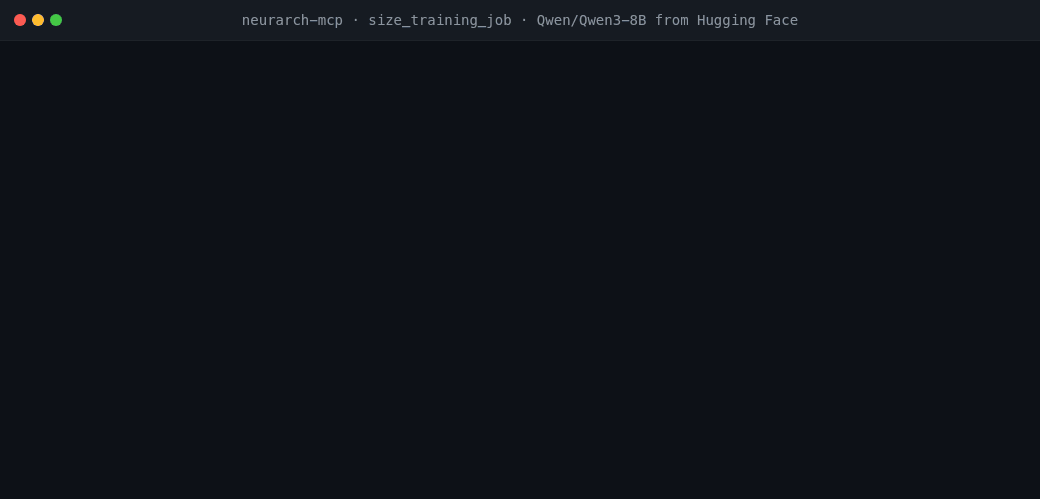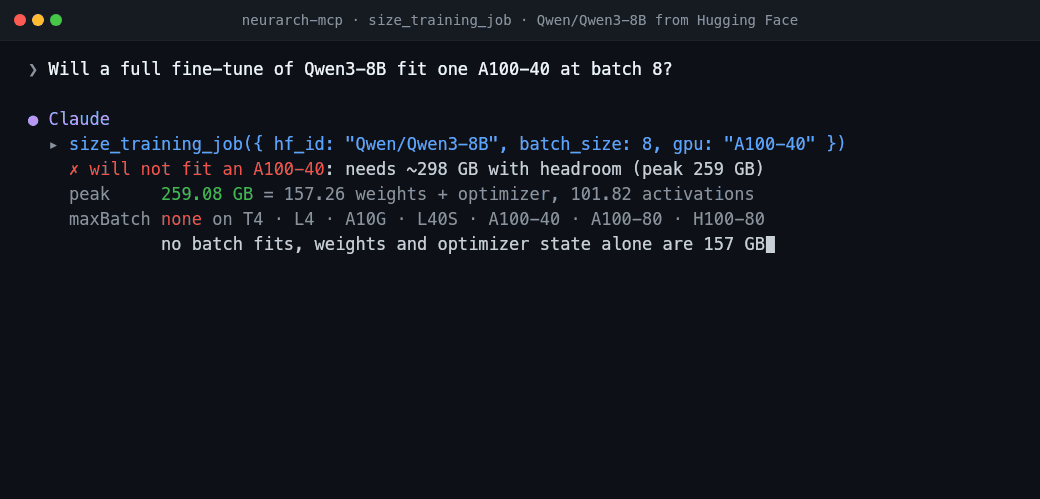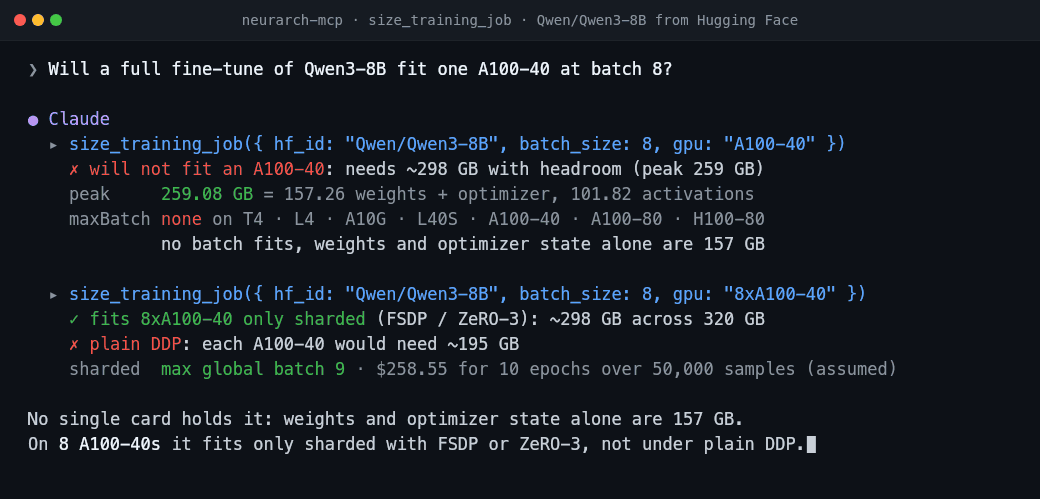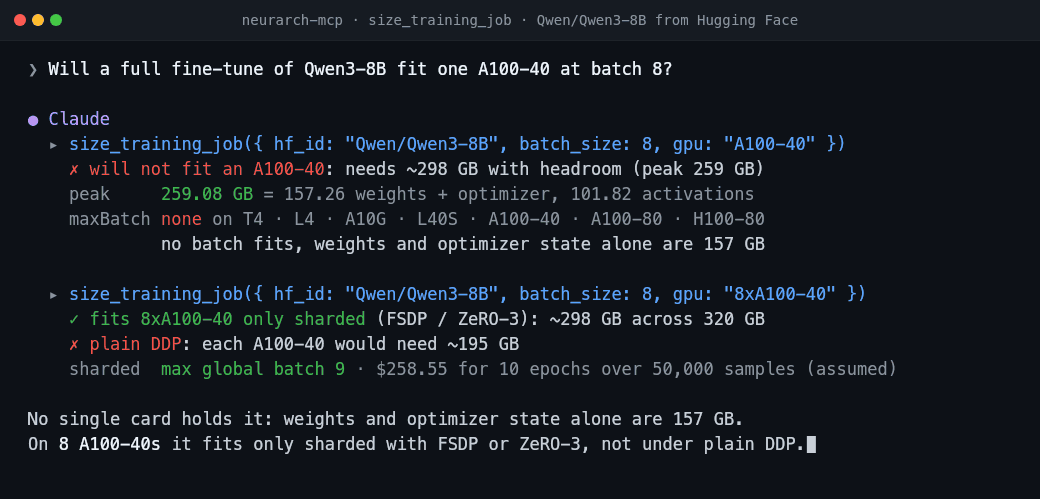
直接使用 Hugging Face 模型。 Qwen3-8B 在批次大小为 8 时无法装入任何单张显卡;使用 8 张 A100-40 时也只能通过分片训练:
发生 CUDA 显存不足错误后。 根据同一估算结果解读错误消息,并首先列出无需更改训练方式的修复方法:
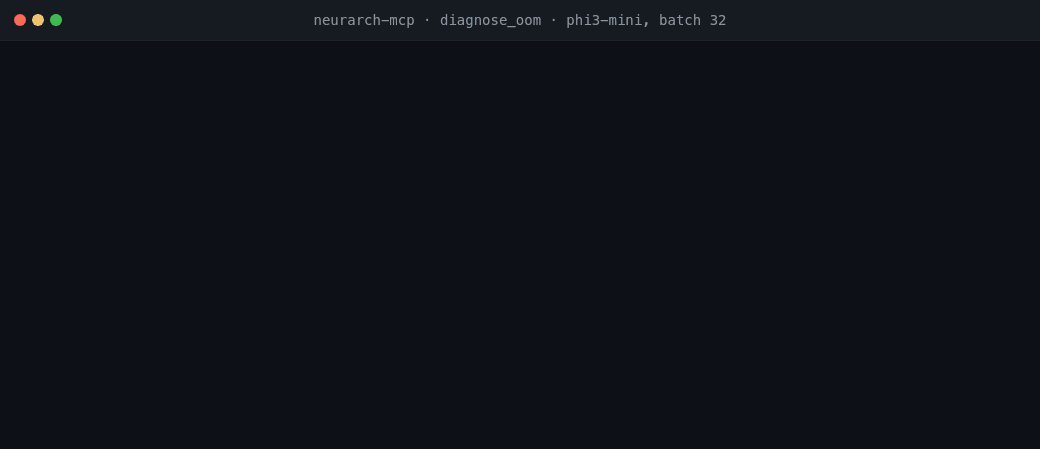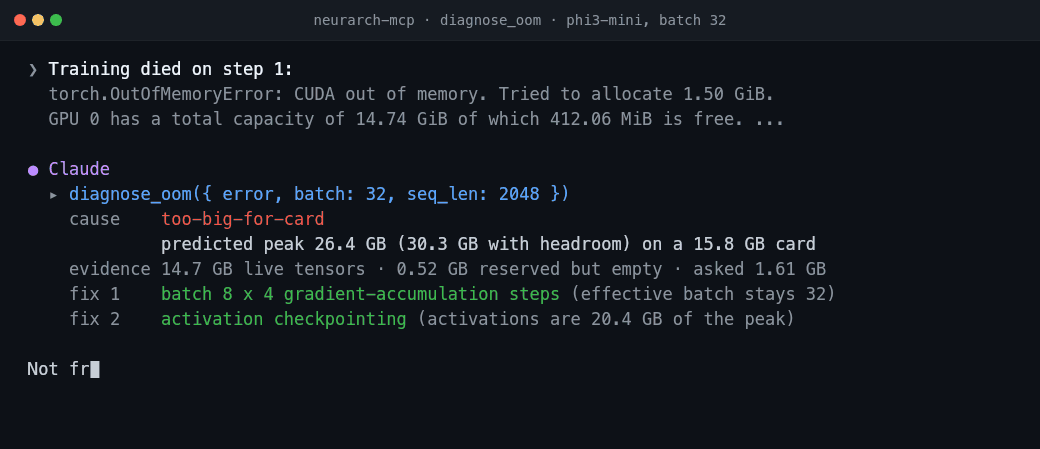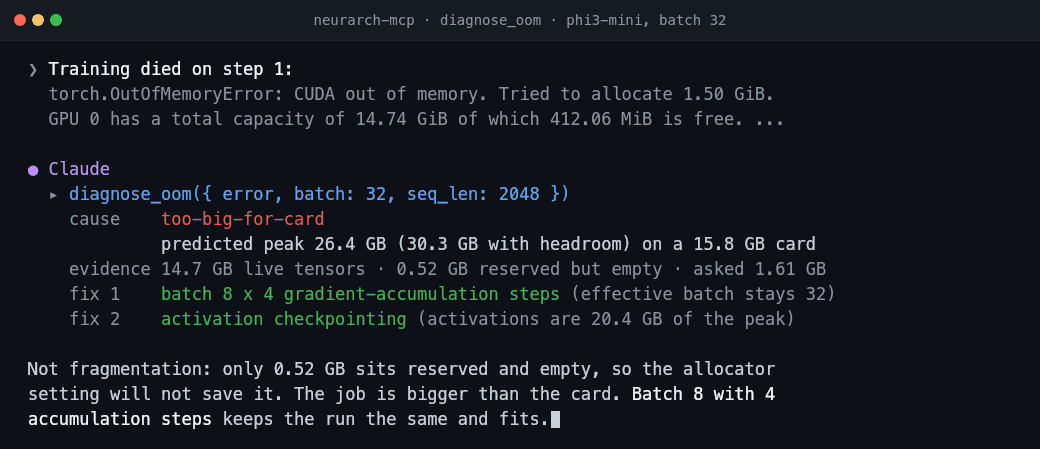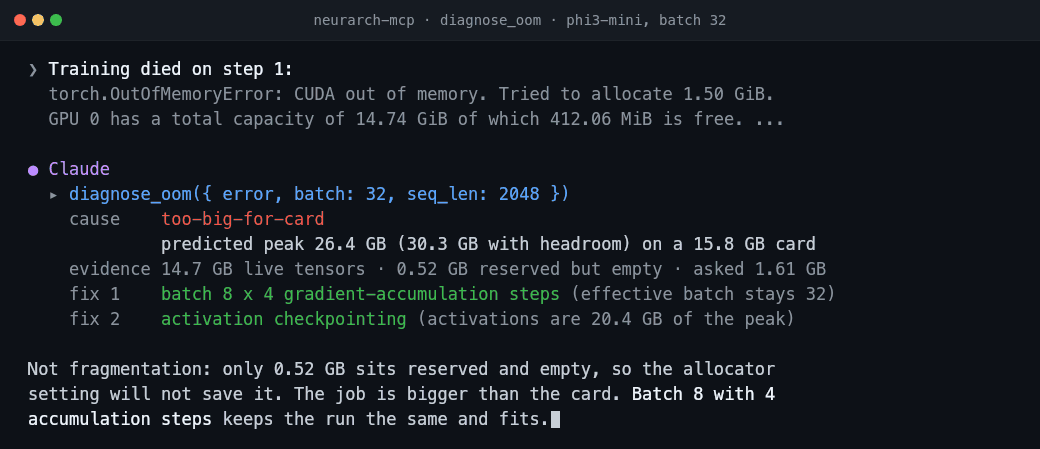
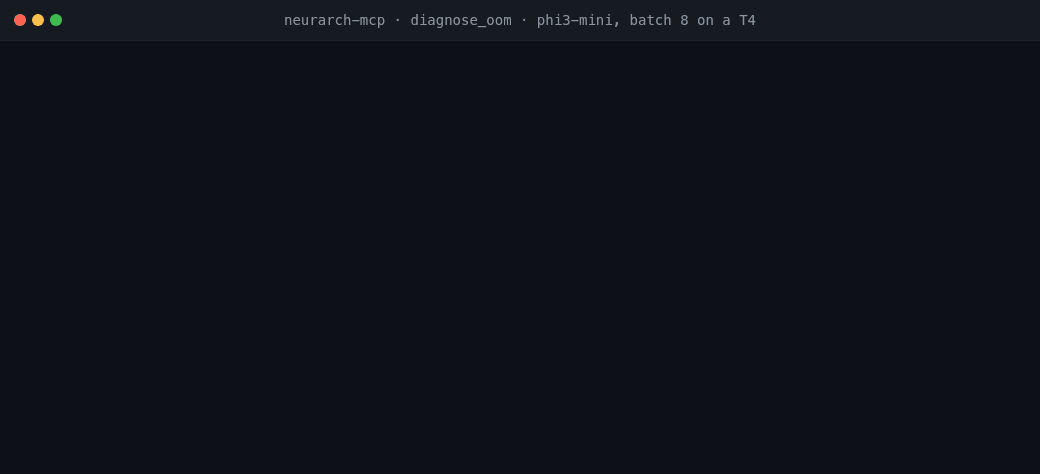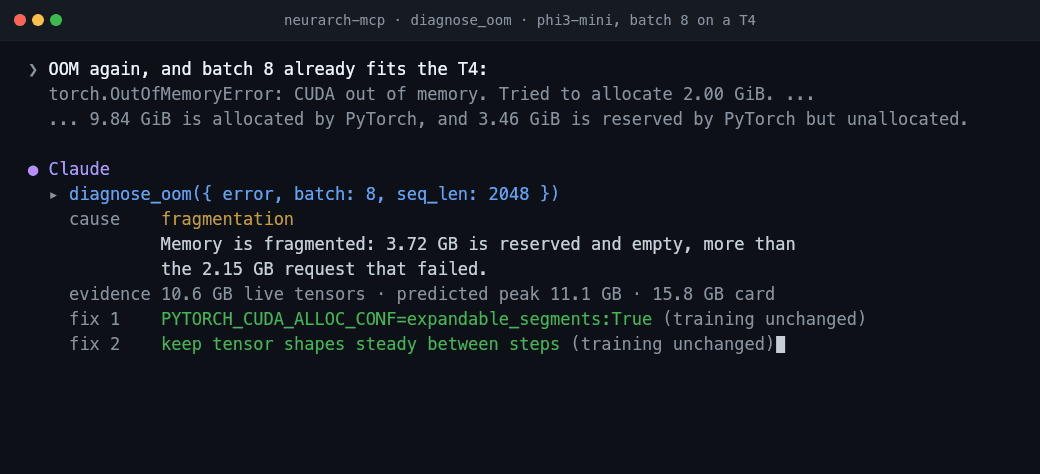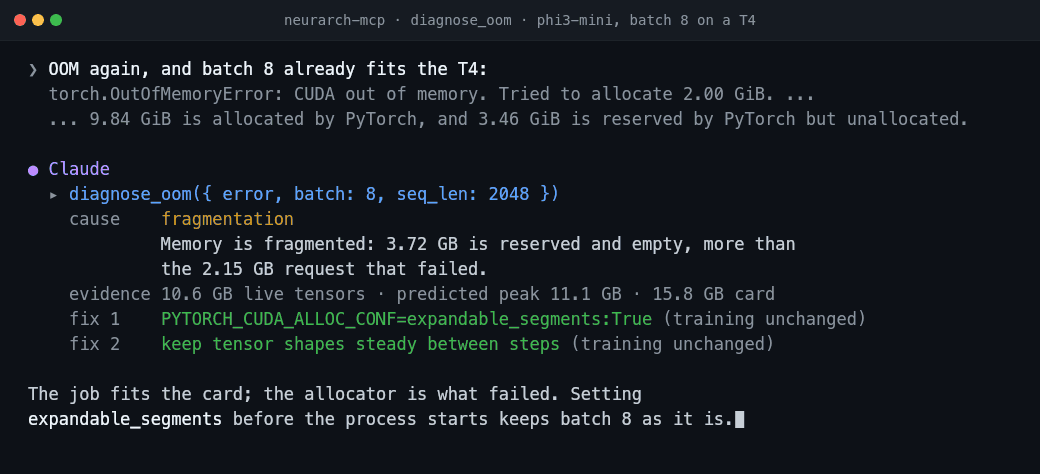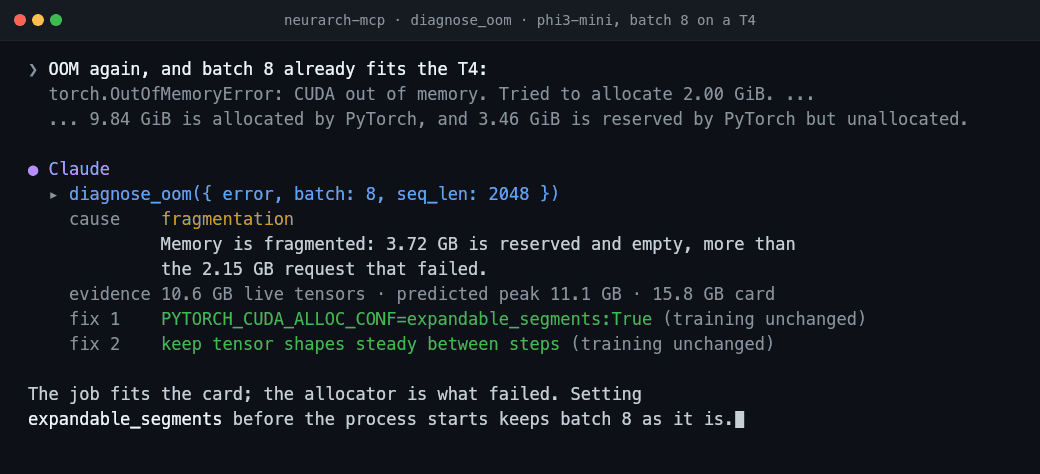
并非每次 OOM 都意味着要减小批次。 当任务能装入显存,但内存分配器无法分配时,修复方法不会改变训练设置:
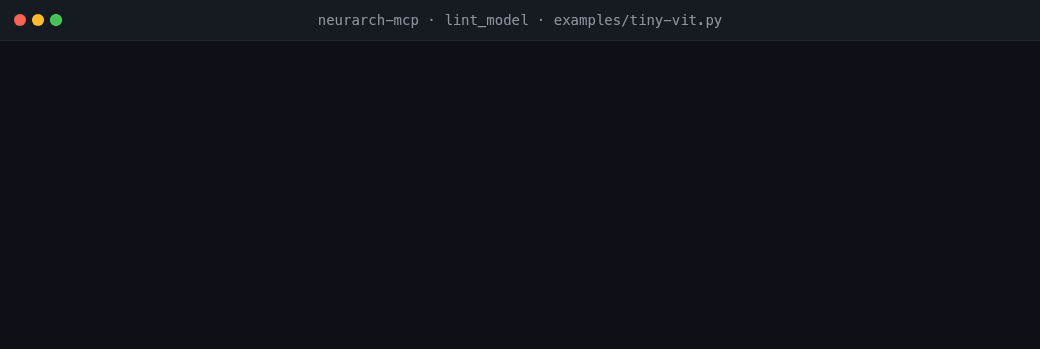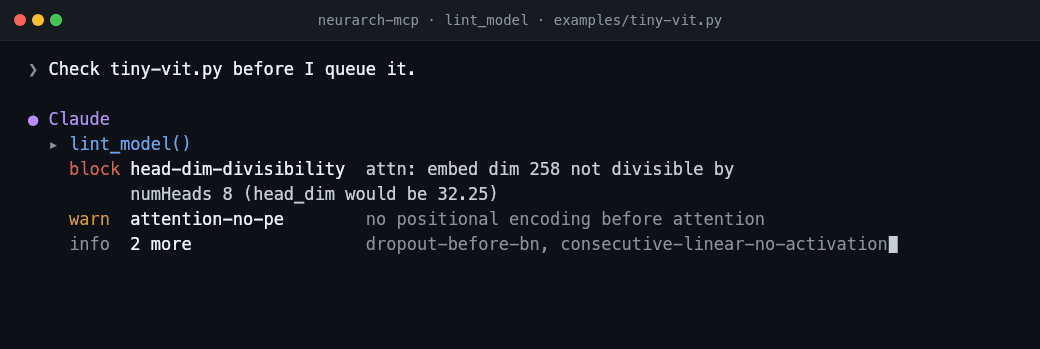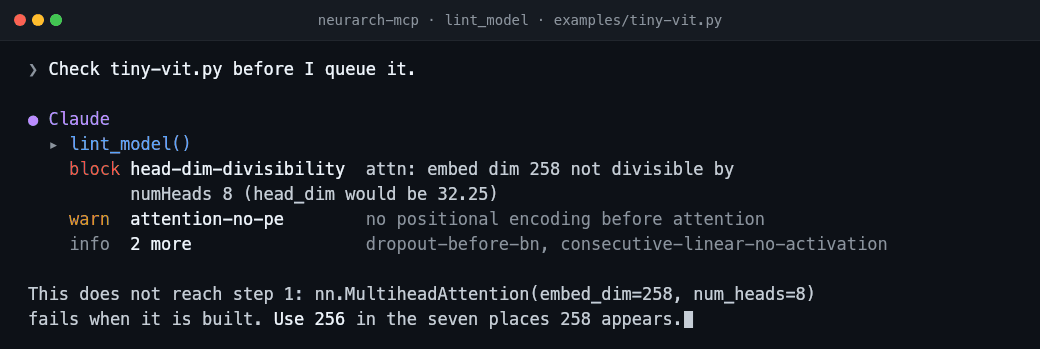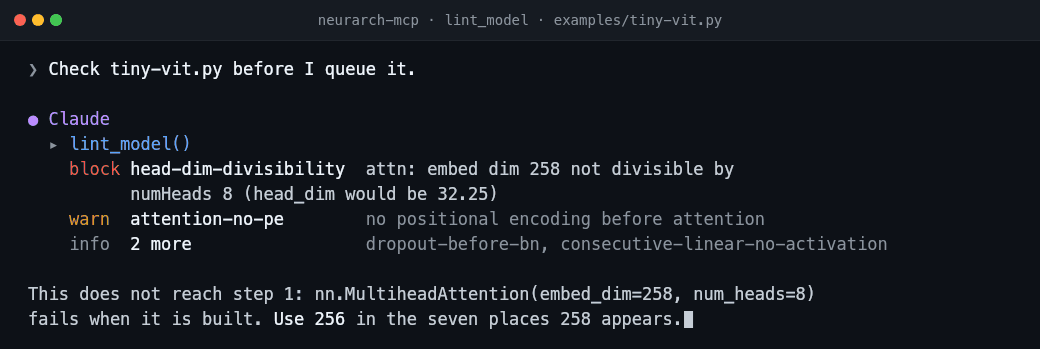
检查能否执行前向传播。 随附的 examples/tiny-vit.py 构建了一个头数无法整除的注意力层:
无需 Agent 询问。 neurarch-mcp hook 会在 Bash 调用运行前检查 python train.py 的启动配置,并阻止无法装入显存的任务:
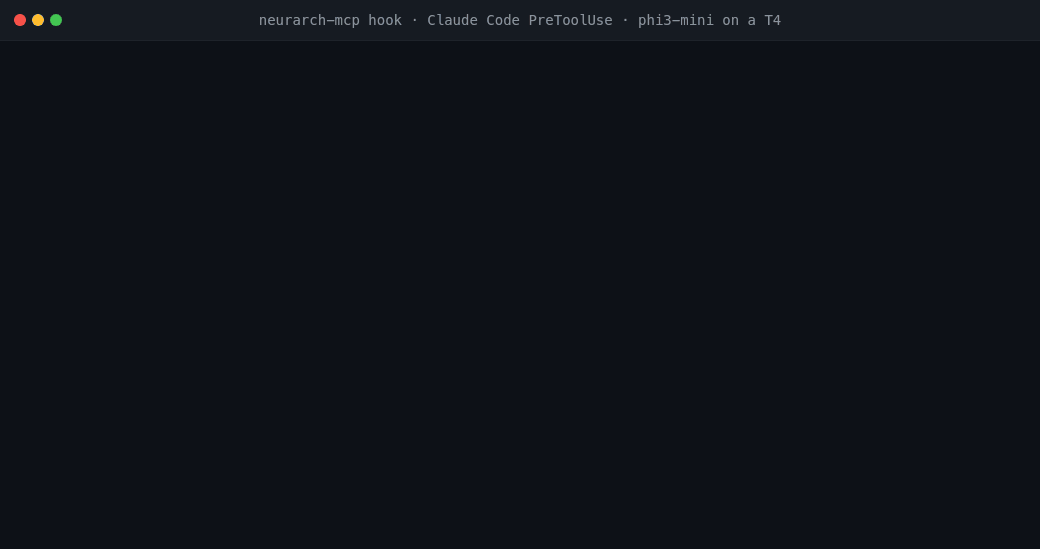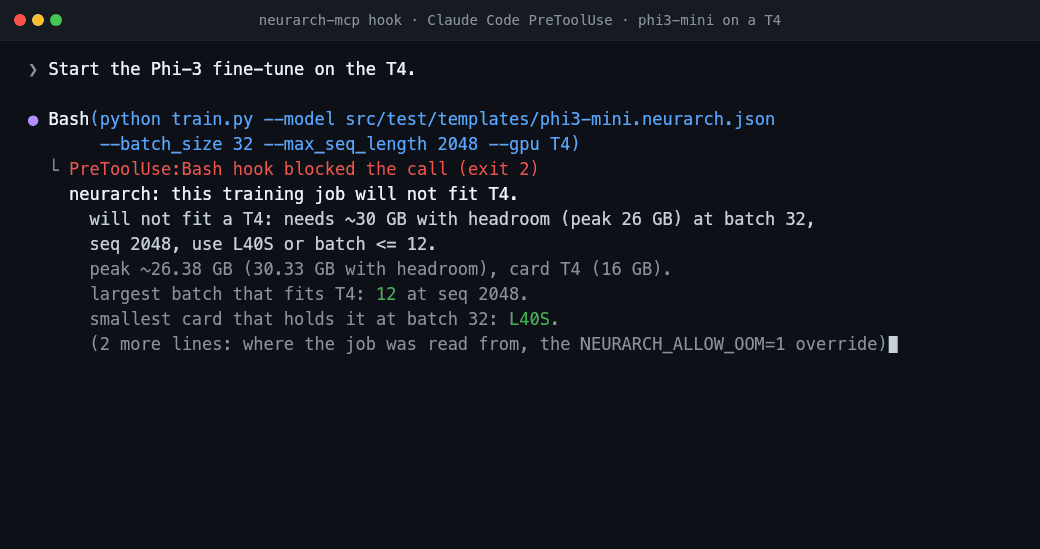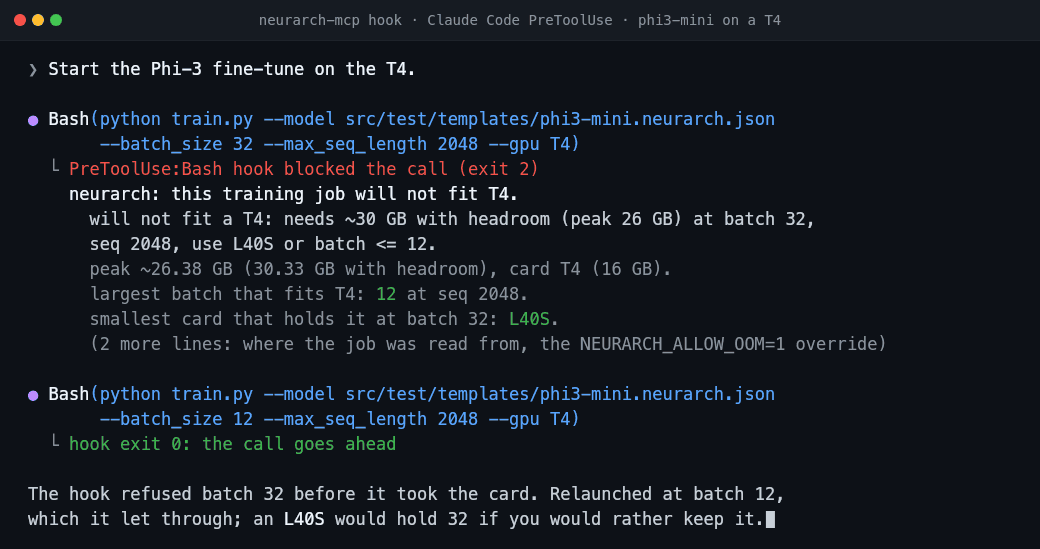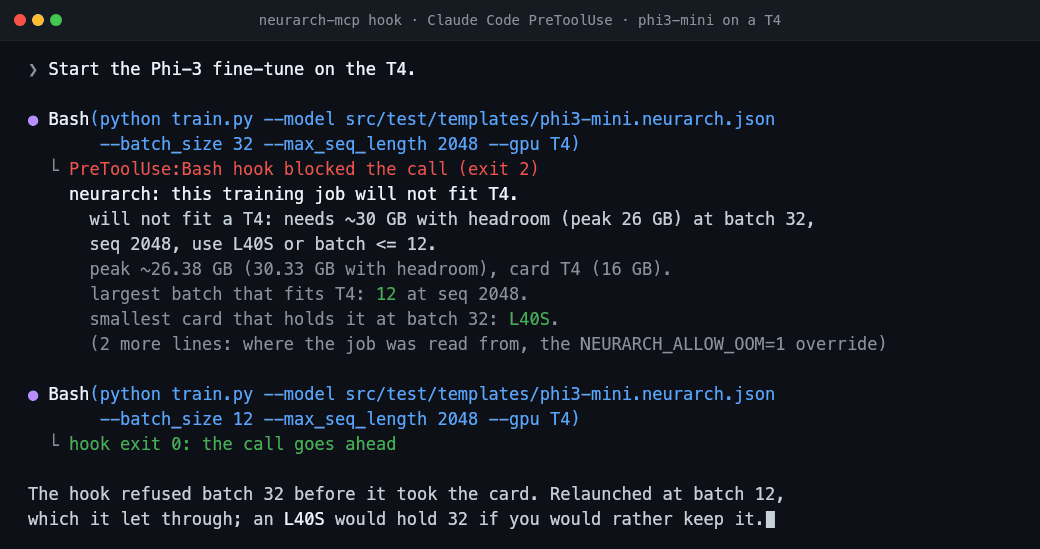
这些演示中的所有数值都来自工具在 phi3-mini、tiny-vit.py 和 hf:Qwen/Qwen3-8B 上的真实输出(0.17.1 和 0.17.2);错误文本仅为示例,模型最后的句子则是预先编写的。scripts/demo-anim/ 中包含调用记录。
显存数值是经过校准的 AdamW 配合 bf16 autocast 训练峰值估算值,并非实测值:每个参数按 1.2 x 16 字节计算;此外,每个 bf16 样本还需计算每层输出的 0.88 倍、已存储注意力分数的 3.64 倍(仅适用于 eager attention;SDPA 和 flash 不保留注意力分数)、每层权重矩阵中间结果的 1.34 倍、循环门状态的 5.2 倍,以及最大单个张量的 2.02 倍。该估算基于 41 种架构的 178 次实测运行拟合,其中包括显存不足的运行。每次留出一种架构进行测试时,在显存超过 1 GB 的场景下,中位误差为 7%;在 131 次无法装入 16、24、40 或 80 GB 显卡的运行中,该估算识别出了 113 次,而 accelerate estimate-memory 最多只识别出 8 次。拟合完成后测量的 25 次运行中,在 24 GB 显卡的临界情况下,中位偏差为 14%,因此应将其视为显存适配性检查,而非精确数值。所有运行记录均公开:neurarch.com/memory-calibration。
可以通过使用真实形状追踪模型来获取计算图,也可以让服务读取已保存的计算图、PyTorch .py 文件或 Hugging Face 仓库。除三个工具外,其余工具都在本机离线运行,无需 API 密钥或账户。三个工具中的两个 plan 和 history,会读取前沿模型在结构上无法获知的信息:这个确切结构上次在此处训练时发生了什么。这些信息不在权重或仓库中。第三个工具 model_changes 会读取 Hugging Face 模型不同修订版本之间变更的公开记录。它们是此软件包中仅有的会建立网络连接的工具。
安装
claude mcp add neurarch -- npx -y neurarch-mcp /abs/path/to/model.py # Claude Code
或者,在 Claude Code 中,通过一个 插件 一次性安装服务、启动钩子和技能:/plugin marketplace add neurarch-ai/neurarch-mcp,然后运行 /plugin install neurarch@neurarch-ai。
Claude Desktop、Cursor、VS Code、Windsurf 和 Codex 的客户端配置见下文。唯一的要求是 Node 20+;除了 npx 之外,无需执行其他安装步骤。
效果展示
一个 Agent 即将在 T4 上启动微调,目标文件是 src/test/templates/phi3-mini.neurarch.json(Neurarch 应用模板之一:包含 3.1 亿参数的 Phi-3 模块)。以下是工具输出的节选:
Agent ▸ (calls size_training_job { batch_size: 32, gpu: "T4" })
  verdict        will not fit a T4: needs ~30 GB with headroom (peak 26 GB) at batch 32,
                 seq 2048, use L40S or batch <= 12
  memory         peak 26.38 GB = 5.96 weights + optimizer state, 20.42 activations
                 (SDPA: the 40.13 GB of attention scores eager would keep are not counted)
  maxBatch       T4 12, L4 23, A10G 23, A100-40 45, L40S 56, A100-80 99, H100-80 99
  cost           $9.68 on a T4, 10 epochs over 50,000 samples (assumed; pass samples)
  forwardPasses  legal, no blockers
  lastRun        fingerprint 4e0b97b4: call history for what it measured last time

  (same job, attention: "eager", gpu: "A100-40")
  verdict        will not fit an A100-40: needs ~76 GB with headroom (peak 67 GB) at batch 32,
                 seq 2048, use A100-80 or batch <= 15
  memory         peak 66.51 GB = 5.96 weights + optimizer state, 60.55 activations
                 (40.13 GB of them the attention scores eager keeps)
针对 examples/tiny-gpt.neurarch.json 的真实对话,讨论预算所在位置:
You ▸ Where does the parameter budget live, and is it safe to drop block_1?

Claude ▸ (calls describe_architecture)
  tiny-gpt: 8 layers, depth 7, 57.8M params, 8.27 GMACs.
  Heaviest by params: token_embedding (25.7M, 44%), lm_head (25.7M), block_0/1 (3.1M each).
  Heaviest by compute: lm_head, then the two decoder blocks. Validation: clean.

  (calls layer_impact { names: ["block_1"] })
  Downstream of block_1: final_norm and lm_head (shape-sensitive, weight-carrying), then output.

  The budget is dominated by the embedding + LM head (~89%), not the decoder blocks,
  so dropping block_1 frees only ~3.1M params (~5%) while removing one of just two
  decoder layers. It is structurally safe (final_norm just re-reads block_0's output),
  but it is the wrong lever if your goal is shrinking the model. Quantizing the
  embedding/head would do far more.
此外,还会检查模型能否完成前向传播;以下示例使用 examples/tiny-vit.py,见上方录屏。这是一个运行时崩溃,却藏在读起来完全正常的源码中;无需联网、无需密钥或账户,几毫秒内即可离线发现。Neurarch CI action 报告的也是同一套规则,因此这里结果通过,CI 运行也会通过。规则经过实测(崩溃规则:96 个被拦截的图均导致 PyTorch 前向传播崩溃,80 个通过的图均成功运行);前置的静态解析器较弱,我们也对此进行了测量。
三种输入方式,按效果从好到差排列
| 输入 | Agent 能获得什么 | 方式 |
|---|---|---|
已追踪的图(neurarch-trace)。从这里开始。 | 所有信息,且包含真实形状,因为这些信息是在运行时读取的,而不是从文本推断出来的。可处理静态解析无法处理的情况:from_pretrained、timm、分散在多个文件中的模型,以及任何动态构建的内容。trace_model 工具会为 Agent 执行此操作。 | pip install neurarch-traceNEURARCH_TRACE=1 python train.py(无需指定目标、形状或修改代码:它会记录脚本运行的首次前向传播)或 neurarch-trace my_pkg.model:build --input 1,3,224,224 |
| Hugging Face 仓库 | 从 config.json 获取架构,并将已发布的参数量与图中的参数量并列显示,方便你查看两者有多接近(Qwen2.5-0.5B:494.00M,而实际为 494,032,768)。 | npx -y neurarch-mcp hf:Qwen/Qwen2.5-0.5B --hf |
自包含的 PyTorch .py 文件。备用方案。 | 当文件用固定尺寸自行构建层时,可获取层、类型、超参数和连接关系。形状和 FLOPs 未知,因为源码从未说明输入内容是什么;它们会报告为未知,而不是零。在真实仓库中,这是效果较差的路径,我们也测量了它有多差:在 116 个真实模型文件中,只有 41% 能生成一个人能够识别的图;对这些文件报告的 block 和 warn 发现,人工判定后 没有一项是真实缺陷。足以帮助了解情况,但不适合据此采取行动。研究。 | npx -y neurarch-mcp model.py |
从 Neurarch app(File → Save)保存的 .neurarch.json 是第四种输入,包含形状、分组和设计说明。添加 --watch,Agent 就能看到应用端的保存结果,无需重启。
此服务围绕以下流程构建,每项各用一句话说明:在启动任何作业前调用 size_training_job,用 history 查看该结构上次测得的数据,用 trace_model 获取包含真实形状的图,用 plan 生成 CI bot 发布的卡片,用 lint_model / check_design 检查是否能通过前向传播,用 suggest_fix 获取修改建议。其他所有工具都用于回答其中某一步引出的问题。
静态解析器能读取什么
我们对其进行了实际测量,而非仅作描述:docs/REAL_REPOS_STUDY.md 使用解析器和代码检查器处理了来自 59 个热门仓库的 116 个模型文件(nanoGPT、HF modeling_*.py、timm、torchvision、DiT、MAE、CLIP、Mamba、SAM、diffusers 等)。解析器能为 86% 的文件返回图,其中 41% 的图能让人识别为对应模型(Llama、Qwen2、Mistral 和 Gemma 会生成 58 个节点的图;nanoGPT 会生成 72 个节点的图),这一比例较 8 月的 63% 和 8% 有所提高。于 2026-09-09 重新测量,并为每条边记录来源:导入器根据语句顺序串接、而非从 forward() 读取的所有边都会被标记;依赖相邻关系的规则会跳过这些边;block+warn 发现从 92 项降至 37 项,三分之二的解析器伪影已消除。两种引擎发现的真实缺陷仍为零。这个图足以帮助了解情况,但还不足以据此执行代码检查;对 .py 中的发现采取行动前,请先运行 trace_model。
此版本带来三项变化。源码生成的图会在 describe_architecture 和 lint_model 中包含 parseQuality 评级(full、partial、thin),并指出修复方式。对于维度仍为源码文本的层,维度规则会暂缓执行,并将数量报告为 suppressed,而非直接丢弃。find_models 还会将解析结果较薄的模型标记为 partial,避免 Agent 基于仅含两个层的图制定计划。对于真实仓库,请使用 neurarch-trace:它会在运行时读取这些数值,因为只有在运行时才能获取这些数值。
每个读取工具都支持可选的 model_path,因此一个服务就能覆盖整个仓库:先询问 baseline.py,再询问 variant_b.neurarch.json,然后询问 zoo:llama-3-8b,全程无需重启。find_models 会告知 Agent 仓库中有哪些内容。
工具
从这里开始:在作业启动前估算规模
| 工具 | 可解答的问题 |
|---|---|
size_training_job | **训练作业在预留 GPU 前需要什么。**输入:模型(服务端的模型、指向 .py 的 model_path、已追踪的 .neurarch.json、zoo:<id> 或 hf:<org/name>,或 hf_id)、batch_size,以及可选的 gpu("A100-40"、"H100"、"8xH100")、seq_len、attention(默认值为 sdpa,也可以是 flash、eager)、用于估算价格的 epochs 和 samples,以及 data(seq_len、tokenizer_size、num_classes、image_size、channels)。返回:该批次的训练峰值及其权重与优化器、激活值和注意力分数各部分的占用;能容纳该峰值并留有 1.15 倍余量的最小显卡;每张显卡对应的 gpuVerdict(fits、borderline 或 does_not_fit),根据 upperBound 判断是否适配(估算值的 1.43 倍,在 91 次留出运行中有 95% 达到或超过实测峰值),以及 smallestSafeGpu(能容纳上界的最便宜显卡)和 maxBatchSafe;如果判定为临界,则提示在预留显卡前先测量一个步骤;提供 data 或 seq_len 时,还会返回 dataFit 报告,说明数据是否符合模型的接受范围(序列长度超过已学习的位置表、分词器大小超过嵌入层大小、标签数超过分类头容量、图像大小或通道数与第一层构建时的设置不符,这些情况都会导致首批数据运行崩溃),以及从 hf: 模型自身的 config.json 读取的标签数;T4、L4、A10G、L40S、A100-40、A100-80 和 H100-80 各自可支持的最大批次;单张显卡无法容纳时的双卡拆分方案;在指定显卡或最便宜的适配显卡上运行一次的成本;判定结果;计算图是否能完成前向传播;用于 history 的结构指纹;以及留出准确率说明。对于 N 张显卡的请求,会同时按普通 DDP(每张显卡上有一份完整副本,使用每设备批次)和分片 FSDP / ZeRO-3 进行估算。使用与 Neurarch 应用、CI 机器人和 POST /api/v1/plan 相同的 buildPlan 计算,随附 vendored 副本,可离线运行。如果计算图将隐藏状态或图像张量输入到令牌嵌入层,则会拒绝估算,因为按隐藏维度计算出的数值会不正确。 |
diagnose_oom | **作业为何耗尽 GPU 内存,以及最小的修复改动是什么。**发生 CUDA 内存不足错误后、调整批次大小之前调用。输入:error(原样提供打印出的错误文本,使用 PyTorch 的报错措辞),以及可选的模型(同上,或 hf_id;如果本地配置缓存中有,则无需联网即可读取)、batch、seq_len、step、attention,以及用于生成作业的 inference: true 和 gen_tokens。它会从错误信息中读取已分配、已预留但为空、其他进程占用及失败请求的数值,与 size_training_job 使用的相同预测峰值进行比较,并返回一个 cause(too-big-for-card、fragmentation、other-process、large-logits、undeclared-memory、grows-during-run、unknown)、一段 summary、错误信息中对应的 evidence 行、按改动幅度从小到大排列的 fixes(每项都带有 changesTraining 标记),以及所用的 job 信息。只有在作业超出显卡容量时才会建议减小批次,并同时给出能保持有效批次大小的梯度累积方案。此诊断由应用自身实现(npx neurarch oom),并随计划包提供 vendored 副本。 |
check_edit | **模型配置或架构的改动是否能运行但存在错误,以及它对内存的影响。**编辑后、训练前调用。输入:基础模型(base_model_path:.py、.neurarch.json、zoo:<id> 或 hf:<org/name>;或 base_config)和修改后的模型(服务端的模型、model_path、model_source 或 config);base_config 和 config 接受 Hugging Face config.json,形式可以是对象、JSON 文本或路径。可选参数:lora_target_modules、batch(默认值为 32)、seq_len、gpu、attention。返回 findings,每项包含稳定的 rule、严重程度、所涉及的张量或键,以及 seenIn(公开上游报告中记录的相关故障):vocab-resize-incomplete(调整大小后,某个按令牌索引的张量仍保留旧词汇表大小)、weight-tying-lost、attention-config-drift(头数、head_dim、hidden_size 和 kv 头数必须一并调整)、rope-context-drift(扩展上下文但未设置 RoPE 缩放);此外,对于 lora_target_modules,按 PEFT 的匹配方式进行匹配后,还会返回 lora-target-no-match、lora-target-partial 和 lora-target-wrapper;配置整除性问题则会以 lint ID head-dim-divisibility 和 gqa-head-divisibility 返回。然后返回 memory:在该批次和序列长度下修改前后的训练峰值、差值,以及作业是否仍能适配 gpu(或修改前后能容纳它的最小显卡);这些数据来自 size_training_job 使用的同一估算方式。这些检查由应用自身实现(src/utils/editChecks.ts),并随计划包提供 vendored 副本。 |
多 GPU 或服务启动前
check_parallel_layout 会说明 TP / PP / DP / CP / EP 切分是否合法、哪个流水线阶段是拖慢整体的瓶颈、与均衡切分相比预计会使步进速度减慢多少,以及消除瓶颈的切分方案。每项都标注为预计值(单卡矩阵乘效率根据公开的 GEMM 测量结果拟合;1F1B 调度按操作逐步模拟,从不实际计时):
check_parallel_layout { model_path: "hf:Qwen/Qwen3-8B", tp: 4, pp: 4, micro_batch: 1, global_batch: 32, seq_len: 4096, gpu: "h100" }
-> legal on 16 x h100-sxm; predicted 15.5% slower per step than a balanced split (slowest stage 3);
   split 10,10,9,7 is predicted 11.4% faster; bubble 8.6%; 1 warning
check_serving_config 会根据模型的 config.json、tokenizer_config.json、chat_template.jinja 和 generation_config.json 以及显卡,检查 vLLM、SGLang 或 llama.cpp 启动命令,并指出 TP 与注意力头的匹配情况、服务长度与上下文长度的匹配情况、KV 内存和并发情况、量化与显卡的匹配情况,以及聊天模板和采样器默认值(通过 against,显示相对于其替代模型的变化):
check_serving_config { command: "vllm serve Qwen/Qwen3-8B -tp 4 --max-model-len 131072 --max-num-seqs 64", gpu: "l4", gpus: 4 }
-> blocked: Served length 131072 is past the model's 40960-token context
   (+ warn: --max-num-seqs 64, but at most 3 requests fit at the full 131072 tokens; info: no --reasoning-parser)
两者都是应用自身的检查(npx neurarch layout、npx neurarch serve-check),随计划包一并提供,无需联网;hf: 模型首次使用时需要加上 --hf。
Hugging Face 下载内容可能变化前
check_pins 会查找在作业运行当天加载 main 所指向内容的下载操作(from_pretrained、load_dataset、hf_hub_download、snapshot_download、pipeline、vllm serve、SGLang 服务端、hf download、YAML 模型键),并针对每个文件列出具体修复方法。它是 npx neurarch pin-check 背后的扫描器,与 Bandit B615 保持一致,无需联网。model_changes 会说明受跟踪模型在不同修订版本之间有哪些变化(配置、分词器、聊天模板、生成默认值、权重),每项变化是否根据已发布规则构成破坏性变更;如果指定 since_revision,则只显示固定版本之后加入的内容。它会从变更记录读取两个公开文件;变更记录说明某个修订版本在机制上的变化,并不表示发生了破坏性变更;未跟踪的模型是没有记录,而不是没有变化。
check_pins { paths: ["."] }
-> 4 downloads not pinned to a commit in 3 files
   train.py:2  AutoModel.from_pretrained("Qwen/Qwen3-8B") has no revision: it loads whatever main is when the job runs
   fix: Pin a full 40-character commit: revision="<sha>", from https://huggingface.co/Qwen/Qwen3-8B/commits/main (`neurarch pin-check --resolve` looks it up).
model_changes { hf_id: "Qwen/Qwen3-8B" }
-> 1 recorded change, 0 breaking; main is b968826d9c46 (2025-07-26)
计划卡片及其背后的记忆
这是此包中仅有的两个会访问网络的工具。plan 会生成最终产物:与 Neurarch CI 机器人在拉取请求中发布、neurarch-trace CLI 打印的卡片相同,因此 Agent 和审阅者看到的是对同一计算图的相同描述。
| 工具 | 解答的问题 | 发送的内容 |
|---|---|---|
plan | 能否运行、成本是多少、适配哪些 GPU、违反了你们仓库的哪些规则、相对于基础设计有哪些变化,以及上次在这里用这种结构训练时发生了什么。 返回的 text 原样呈现。除非传入 policy,否则策略行会从仓库的 .neurarch.yml 中读取(与 CI 机器人读取的是同一个文件,合并方式也相同);base_path 会添加差异。NEURARCH_API_KEY 是可选项,设置后会添加历史记录行。share 固定为 false:Agent 无法发布你的设计。 | 计算图,发送至 POST /api/v1/plan。这是唯一会发送模型的工具。 |
history | 此精确结构上次在组织内部训练时测得的结果:指标、训练轮数、耗时、成本,按时间从新到旧排列,最多 20 条。记录以计算图的 8 字符结构指纹为键,因此回答的是结构形态而非文件;采用相同架构的两个人会看到相同的运行记录。传入 model_path,或直接传入计划结果中的 fingerprint。 | 指纹和你的密钥。绝不发送计算图。 |
它们存在的原因:能够读取你代码的前沿模型可以推理架构,但无法知道这种结构三天前曾在这里训练过,并在 34 秒内达到 98.65%,成本不到一美分。这个事实既不包含在权重中,也不在仓库里,更无法从计算图推导出来。
未设置 NEURARCH_API_KEY 时,history 不会发出请求,并会说明这一点。 它不会返回空列表:尚未读取的账本和空账本是不同的答案,只有其中一种意味着从未有人训练过这个结构。密钥可从 neurarch.com/developer 获取。
然后,判断它能否完成前向传播:离线阶梯
在三个数据集中,我们发现 Agent 很少会写出结构不合法的模型;在我们的实验中,专注于结构的 Agent 遇到的唯一一次失败是内存不足,因此尺寸评估应放在首位。如果结构存疑,可以用这些工具进行评估,值得按顺序逐级使用。每个工具都免费、离线且即时;check_design 会运行五个流水线阶段,因此从最高层开始的 Agent,最终会为一个较便宜工具已能回答的内容的三分之二付出代价。
| 工具 | 回答的问题 | |
|---|---|---|
| 1 | validate_model | 这是否是结构良好的计算图:是否存在环、悬空引用、重复名称或孤立节点。 |
| 2 | lint_model | 是否违反设计规则:注意力头维度与 GQA 可整除性、归一化/激活顺序、dropout 和特征范围、深层堆叠中缺少残差连接,以及可静态判定的形状规则。返回 provenance:对每条触发且有已发布测量结果支撑的规则,返回相应测量值。没有数值依据的规则会直接省略,不会被包装成有依据的结论。 |
| 3 | check_design | 模型能否训练、成本是多少、可以在哪里运行:就绪状态、参数量和成本估算、最佳部署目标及其延迟,以及仍待人工决定的事项。与应用和 POST /api/v1/check 使用相同的代码路径。 |
| 4 | rank_designs | 对 k 个候选设计排序。候选项可以是路径、zoo:/hf: 引用或内联计算图。被阻止的候选项(即预检发现表明计算图无法完成前向传播)会排在最后,并作为可收回预算返回;这部分有实测依据:96 个被阻止的计算图中,96 个在 PyTorch 前向传播时崩溃;80 个通过预检的计算图中,80 个均成功运行。合法候选项只依据有训练结果支撑的规则排序,且 并列就是并列:当没有实测结果能区分排名靠前的候选项时,recommended 为 null;这也是常见情况。每个候选项都会返回参数量、成本和 GPU 适配情况,供你按自己的预算打破平局;这些指标本身不会影响排序,但可通过 tie_break: "cost" 或 "params" 来打破实测结果的平局,返回值会回显并标注这是你指定的规则,同时保留 measuredRank。每个结果中都附带 calibration(成对准确率为 51.4%,覆盖率为 8.3%,属于样本内结果,不可引用;样本外测试中,该评分对 15 对候选项中的 11 对弃权,而阅读代码的 Claude Opus 5 答对了 15 对中的 12 对,始终选择较大设计的策略则答对了 15 对中的 11 对),因此不能将排序解读为质量预测。 |
| 5 | suggest_fix | 将这一发现转化为对文件的修改。 针对每条发现生成一个统一差异:规则明确指定数值或顺序时,给出 exact 修改(上述头维度崩溃问题会生成 7 行差异,将每个 258 改为 256);缺少层时则给出 proposal。应用修改后,再运行 lint。 |
检查
| 工具 | 功能 |
|---|---|
describe_architecture | 一次调用即可了解整体情况:按拓扑排序的流水线、深度、输入/输出形状、总参数量和 MACs、参数量 和 计算量最高的前 5 个瓶颈,以及验证汇总。从这里开始。 |
get_model_summary | 层数、总参数量、主要类型、输入/输出形状。 |
get_layer | 按名称查看单层:参数量、形状、备注、上游/下游连接。 |
find_layers | 按类型、名称正则表达式、作用域前缀或数据增强搜索;按参数量排序。 |
compare_layers | 对两个层进行结构差异比较。 |
layer_impact | 修改某一层或匹配的一组层时的 影响范围:对形状敏感以及携带权重的下游层。建议修改前先调用。 |
find_path, list_connections | 两层之间的有向路径;边列表。 |
param_count_by_block, flops_by_block | 按块、作用域或类型分组统计参数量和 MACs。 |
list_blocks, get_block | 折叠分组及跨越其边界的内容。 |
diff_models | 与另一个 .neurarch.json 文件进行结构差异比较。 |
mermaid_diagram | 将模型表示为 Mermaid flowchart TD。 |
list_hyperparams, get_design_notes | 用户在应用中设置和编写的内容。 |
参考库和其他模型
| 工具 | 功能 |
|---|---|
list_architectures | 搜索此服务捆绑的 81 种参考架构(DeepSeek-V3、Qwen2.5、Llama、Mixtral、Gemma、Whisper、CLIP、BERT、ViT、ResNet 等)。每种架构都采用模型配置文件中的真实维度,且参数量已经过核验,与公布的数据一致。离线运行。 |
load_architecture | 打开并描述一种架构。然后可在任意工具中使用 model_path: "zoo:<id>"。 |
load_hf_model | 将 Hugging Face 仓库作为图加载。仅在 --hf 下列出,因为它是唯一会打开网络套接字的工具。 |
find_models | 遍历目录,查找 nn.Module 定义和已保存的图,逐个尝试解析,并指出哪些需要改用 neurarch-trace。 |
trace_model | 在你的 Python 环境中运行 neurarch-trace,传入输入维度,并通过 model_path 返回包含真实形状的图。访问真实仓库的首选方式,不是备用方案:静态解析器能为 41% 的真实模型文件返回可识别的图,而且它报告过的问题至今没有一个是真正的缺陷。 |
export_pytorch | 将图导出为可运行的 nn.Module,使用应用自身的生成器。save_to 需要 --write,且绝不会指向启动服务时使用的文件。 |
写入(通过 --write 启用)
add_layer、modify_layer、add_connection、delete_layer、delete_connection、save_model。修改始终针对命令行传入的文件;写入工具会拒绝 model_path,因此 Agent 无法编辑自己编造的路径后再覆盖保存。对于 .py 文件,写入会被拒绝(图是从该文件派生的;使用 export_pytorch 生成新源码)。
每个工具都会声明它会如何处理你的文件(MCP 注解):读取工具为只读且仅限已知范围,load_hf_model 的范围开放,可能造成破坏的三个工具则会明确说明。结果中除了 JSON 文本,还会包含 structuredContent。
提示词和资源
在 Claude Desktop、Cursor 和 VS Code 中,这些会显示为斜杠命令。每个命令都按顺序列出工具调用步骤,并附带一条首要规则:回答中的每个数字都必须来自工具结果,不能凭对相似模型的记忆作答。
| 提示词 | 参数 | 功能 |
|---|---|---|
/review_design | focus? | 结构化评审:就绪情况、风险、预算所在,以及值得进行的修改及其影响范围。 |
/pre_train_checklist | 每项给出通过/未通过/未知,并由作出判断的工具提供依据,帮你在投入 GPU 时间之前做好检查。 | |
/shrink_for_target | target | 针对“参数量低于 100M”或“使用 T4 和 batch 32”的目标进行适配:找出预算所在,提出不同方案并排序。 |
/compare_with_reference | architecture? | 将模型与库中的已发布模型并列比较,并指出会影响训练的差异。 |
/explain_finding | rule | 说明某项发现对该模型的意义、背后的证据,以及消除该问题所需的最小修改。 |
客户端可固定为上下文的资源:neurarch://model(图)、neurarch://model/mermaid、neurarch://model/pytorch、neurarch://zoo、neurarch://zoo/{id}、neurarch://rules(来源信息表)、neurarch://docs 和 neurarch://docs/{tool}(每个工具的完整说明)。
如果 check_design 的判定最终取决于只有用户才能做出的决定(例如选择哪种数据,或是否值得花这笔钱),它也可以询问用户:传入 ask_user: true;在支持 MCP 引导的客户端中,系统会向用户提出问题,并将用户的回答一并返回判定结果。
是否能让 Agent 使用正确的工具,要通过实际测量,而不是凭空假设:npm run eval:tools 会通过 Claude Code 对构建好的服务运行六个固定问题,并对工具调用评分(提出修改前先运行 lint;对于“哪个更好”类问题,使用 rank_designs)。最新结果见 docs/tool-selection-eval.json。
也可通过 CLI 使用
npx -y neurarch-mcp lint model.py                 # findings, exit 1 on a block
npx -y neurarch-mcp lint a.py b.py --json         # for CI
npx -y neurarch-mcp check model.py                # the full verdict
npx -y neurarch-mcp check zoo:qwen2.5-7b          # on a reference architecture
在 shell 中运行相同的估算:npx neurarch
neurarch CLI 可针对 Hugging Face ID 运行此服务集成的估算,全程无需 Agent 参与。
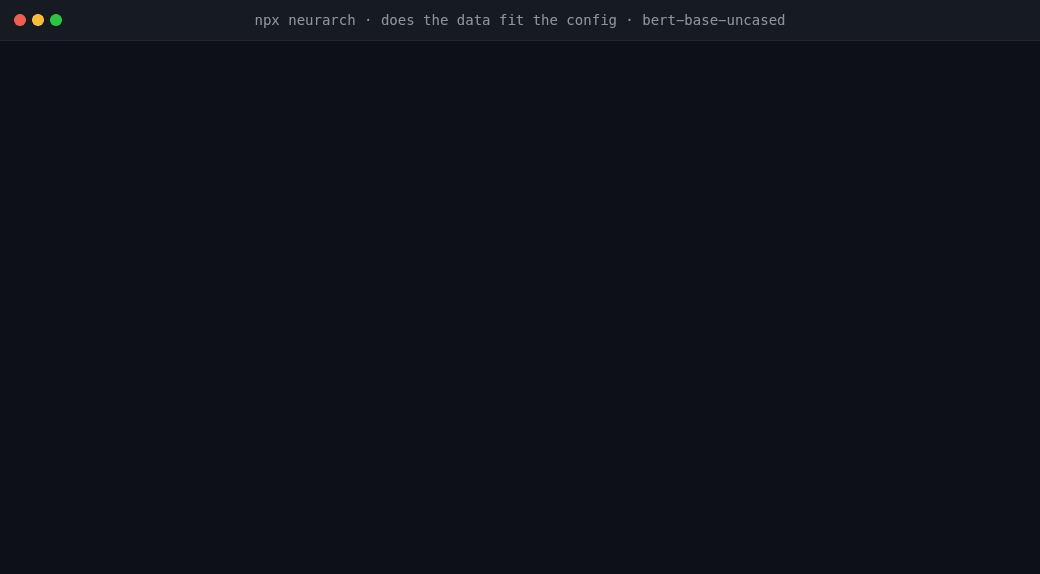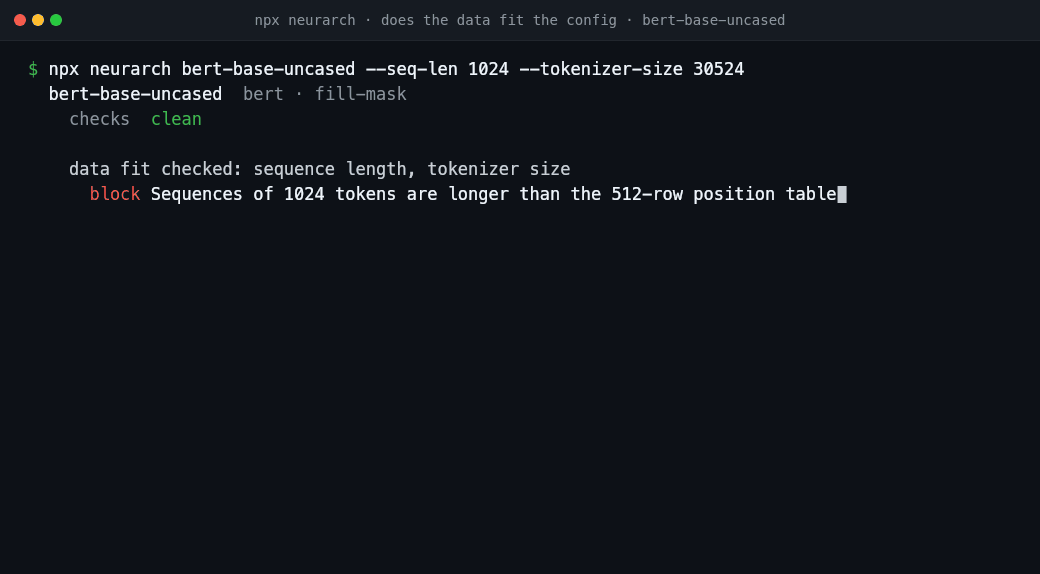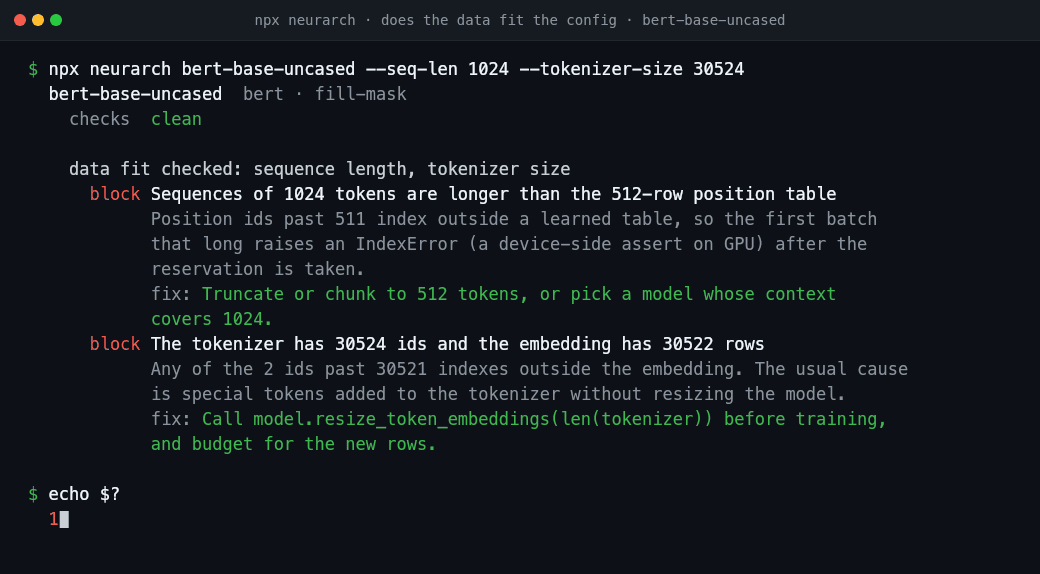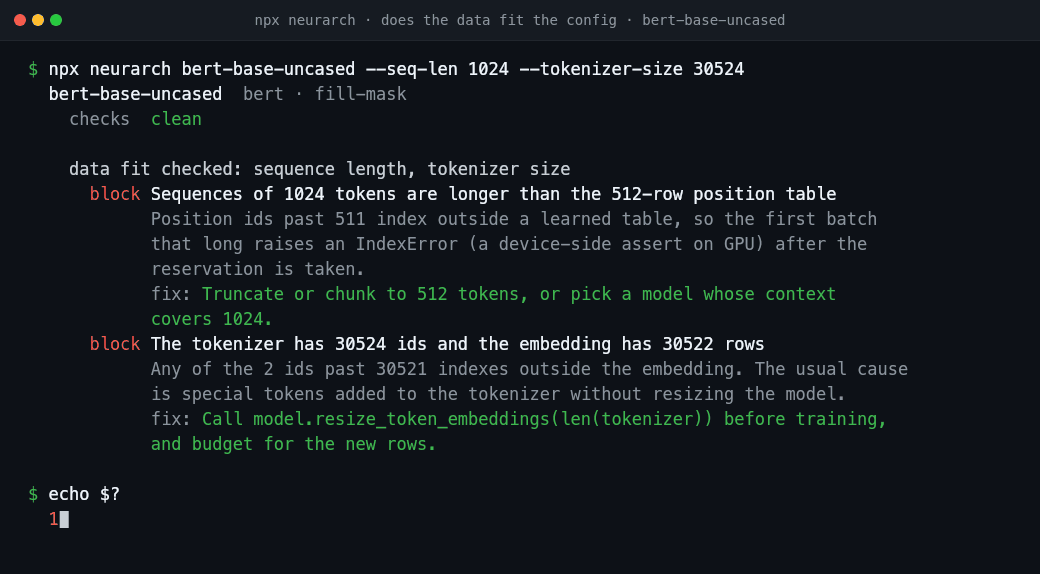
配置无法捕获的数据问题。 以下两种情况都能通过架构检查,却会在预留 GPU 后的首个批次中崩溃:
历史任务的请求量与所需量对比,数据来自团队已运行任务的 CSV:
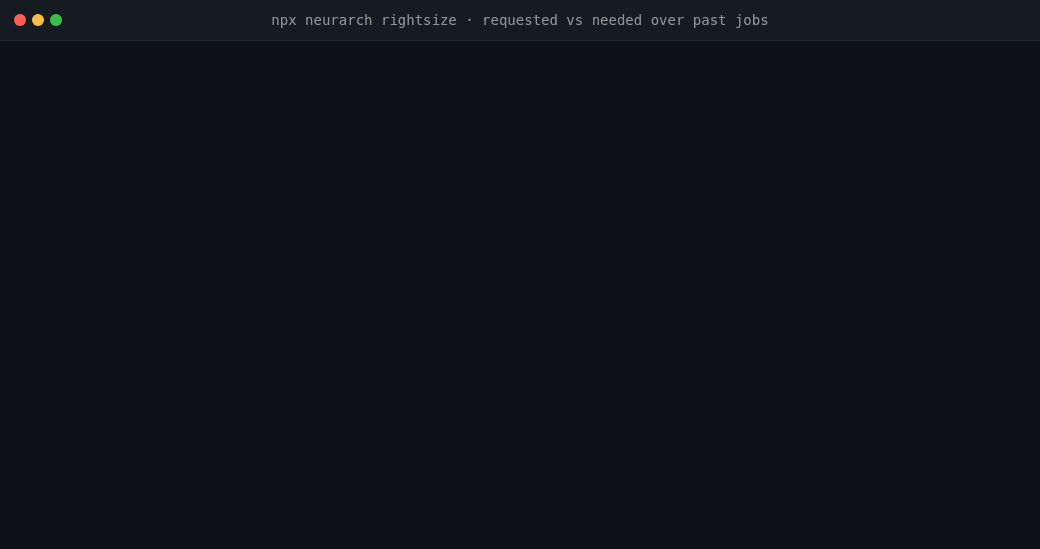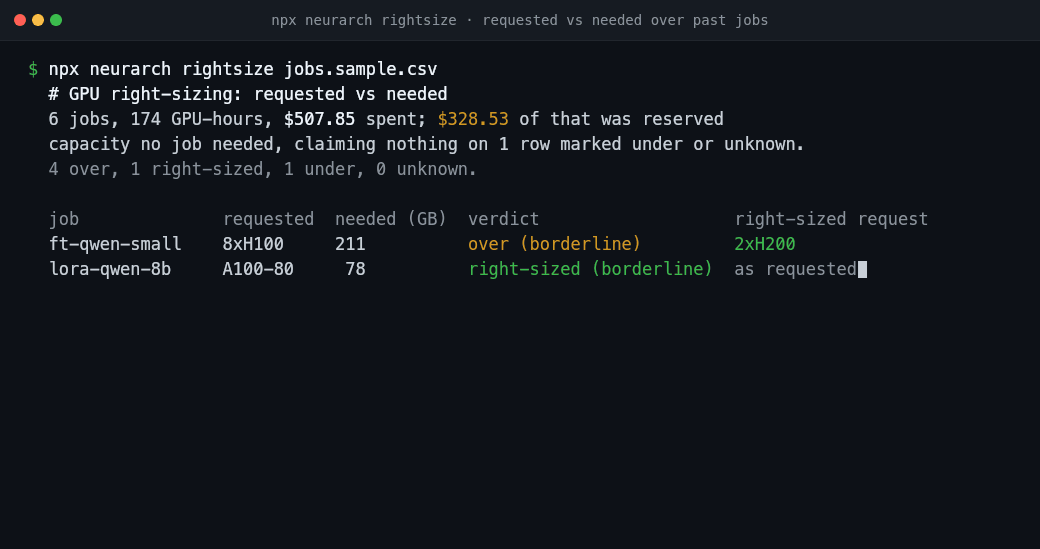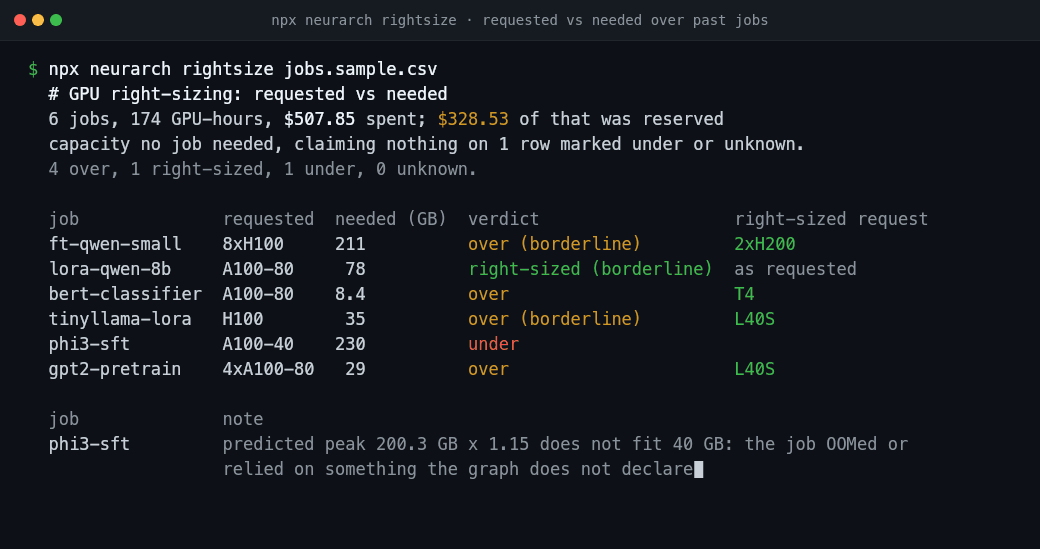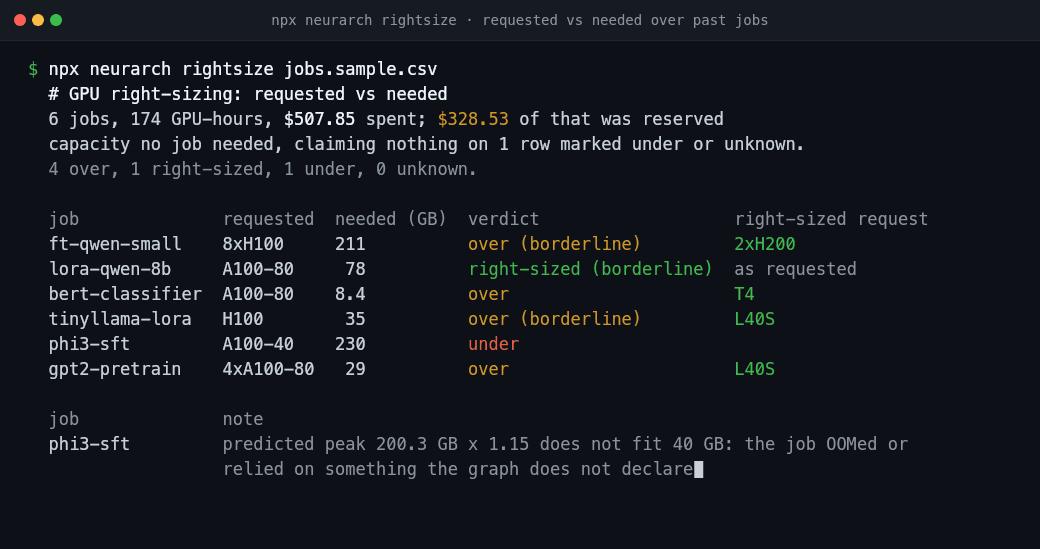
真实输出,所有字符串均未改动:neurarch 0.1.1 的 rightsize 命令针对其附带的 examples/jobs.sample.csv 运行,已删减列;data-fit 运行仅保留其 data-fit 部分,长句经过换行,但未改写。
一个 Claude Code 钩子:拒绝无法容纳的启动
neurarch-mcp hook 是一个适用于 Claude Code 的 PreToolUse 钩子。每次调用 Bash 前,它都会从 stdin 读取待执行命令;当命令启动训练(python train.py、accelerate launch、torchrun、deepspeed、sky launch)时,它会按 size_training_job 的方式精确估算任务大小;如果显卡无法容纳任务,它会声明退出码为 2,从而阻止调用,并向 Agent 提供原因:峰值显存、显卡、该显卡能容纳的最大批次,以及能容纳该任务的最小显卡。其他所有命令都会原样运行,且钩子不会输出任何内容。
将它添加到仓库中的 .claude/settings.json(或 ~/.claude/settings.json):
{
  "hooks": {
    "PreToolUse": [
      {
        "matcher": "Bash",
        "hooks": [
          { "type": "command", "command": "npx -y neurarch-mcp hook --hf" }
        ]
      }
    ]
  }
}
--hf 可让它从 huggingface.co 读取名为 org/name 的模型的 config.json(缓存一天);移除该选项即可保持离线,此时只会估算本地模型(.py、.neurarch.json、包含 config.json 的检查点目录、zoo:<id>,或缓存中已有的 hf: ID)。如果钩子要在每次 Bash 调用时运行,可执行 npm i -g neurarch-mcp,并将 "command": "neurarch-mcp hook --hf" 设为命令,以跳过 npx 的启动过程。
模型、批次、序列长度和显卡取自命令行(--model / --model_name_or_path、--batch_size / --per_device_train_batch_size 乘以 --nproc_per_node / --num_processes、--gradient_accumulation_steps、--max_seq_length / --seq_len、--gpu、sky launch --gpus A100-80GB:8、--attn_implementation);命令中未提供的内容则取自最近的 .neurarch.yml 中的 job: 区块。
该区块也是 neurarch-bot 用于拉取请求评论中显存占用信息的配置,语义相同,因此一个文件即可驱动两者:Agent 会因与拉取请求变红相同的原因,在启动前遭到拒绝。顶层的 job: 适用于所有模型;模型条目自身的 job: 则按键逐项合并覆盖。支持的键为 gpu、batch(估算显存时所用的每步批次)、seq_len、grad_accum(仅用于设置原因中显示的有效批次)、attention、epochs 和 samples;每个键都可以是一个值,也可以是指向自有 YAML 或 JSON 训练配置的 file:key,路径相对于仓库根目录,且允许使用点分隔键。未知键会被忽略。其中一个键专供钩子使用:model;因为 bot 从追踪到的文件列表中获取模型,而钩子没有可读取的追踪记录。
job:
  model: meta-llama/Llama-3.2-1B               # hook only: a path, zoo:<id>, hf:<org/name> or org/name
  gpu: A10G                                    # T4, L4, A10G, L40S, A100 40GB, A100 80GB, H100, 8xH100
  batch: configs/pretrain.yaml:batch_size      # a number, or file:key into your training config
  seq_len: configs/pretrain.yaml:seq_len
  grad_accum: configs/pretrain.yaml:grad_accum
  attention: sdpa                              # sdpa (default), flash or eager
当模型条目的 path(或其自身的 model)指定了正在启动的模型,或者该条目是唯一带有 job: 的条目时,该模型专属的 job: 就会生效。命令行会按键逐项覆盖区块中的设置。无法解析的指针会使对应键保持未设置,而不会进行猜测。
出现问题时,它会放行。无法识别的命令、未声明显卡或批次的任务(包括无法解析的 file:key 指针)、无法加载的模型、无法解析的显卡(单独写 A100 存在歧义),或任何错误,都会让调用继续运行。估算无法建模的任务也会放行:例如 --gradient_checkpointing、LoRA 或 PEFT 标志、4 位或 8 位加载,以及 CPU 卸载,因为估算值针对的是全量微调的峰值。该估算只是适配性检查,并非实际测量;在命令前添加 NEURARCH_ALLOW_OOM=1,即可放行被拒绝的启动。
同一钩子还会在启动 vLLM 或 SGLang(vllm serve、python -m vllm.entrypoints...、python -m sglang.launch_server)前调用 check_serving_config 进行预检查,并且只会在根据模型自身的 config.json 和标志读取到问题时阻止启动,例如 TP 无法整除注意力头数,或服务长度超出上下文长度;设置 NEURARCH_ALLOW_SERVE=1 即可放行:
$ vllm serve Qwen/Qwen3-8B --tensor-parallel-size 3
neurarch: this vLLM launch has 2 blocking findings for Qwen/Qwen3-8B.
  TP 3 does not divide 32 attention heads.
Claude Code 插件
服务、上面的钩子和 技能 会一起安装为一个 Claude Code 插件。本仓库就是它的市场:
/plugin marketplace add neurarch-ai/neurarch-mcp
/plugin install neurarch@neurarch-ai
在 Claude Code 2.1.275 或更高版本中,/plugin install neurarch --marketplace neurarch-ai/neurarch-mcp 一步即可完成这两项操作。在 Shell 中,对应的两个步骤是 claude plugin marketplace add neurarch-ai/neurarch-mcp 和 claude plugin install neurarch@neurarch-ai。
它包含的内容都来自 .claude-plugin/plugin.json 和 hooks/hooks.json:
- MCP 服务:通过
npx -y neurarch-mcp --hosted --hf启动;它本身不包含模型,因此每个工具都需要model_path(.py、.neurarch.json、zoo:<id>或hf:<org/name>)或hf_id。--hf允许hf:模型从 huggingface.co 读取config.json。 - 钩子:每次 Bash 调用前运行
npx -y neurarch-mcp hook --hf,与上文手动配置时完全相同:训练启动会进行资源规格设置,vLLM 和 SGLang 启动会进行预检。 - 技能:
/neurarch:neurarch-skill:在启动任务前设置资源规格,然后执行基于证据的编辑循环。
这两个命令仅在模型通过 Hugging Face ID 指定时才会联系 huggingface.co。若要保持离线,或让服务指向单个模型,请改用上文所述的手动方式配置服务和钩子,而不要安装插件。
客户端设置
在任何全局配置中都使用绝对路径:npx 不会从项目目录运行。项目级配置(.mcp.json、.cursor/mcp.json、.vscode/mcp.json)中可以使用相对路径。
Claude Code
claude mcp add neurarch -- npx -y neurarch-mcp /abs/path/to/model.py
或者提交项目级 .mcp.json,让每位协作者都能使用该服务:
{ "mcpServers": { "neurarch": { "command": "npx", "args": ["-y", "neurarch-mcp", "./model.py"] } } }
Claude Desktop
从 Releases 下载 .mcpb 并打开,或编辑配置(Settings → Developer → Edit Config;macOS ~/Library/Application Support/Claude/claude_desktop_config.json,Windows %APPDATA%\Claude\claude_desktop_config.json):
{ "mcpServers": { "neurarch": { "command": "npx", "args": ["-y", "neurarch-mcp", "/abs/path/to/model.py"] } } }
完全退出并重新打开 Claude Desktop;配置会在启动时读取。
Cursor
点击上方的 Add to Cursor,或创建 .cursor/mcp.json(项目级)或 ~/.cursor/mcp.json(全局):
{ "mcpServers": { "neurarch": { "command": "npx", "args": ["-y", "neurarch-mcp", "./model.py"] } } }
VS Code (Copilot agent mode)
点击上方的 Install in VS Code,或创建 .vscode/mcp.json(注意 servers 键):
{ "servers": { "neurarch": { "command": "npx", "args": ["-y", "neurarch-mcp", "${workspaceFolder}/model.py"] } } }
Windsurf、Codex,以及任何支持 Streamable HTTP 的客户端
command + args 的格式相同;只有文件位置不同。对于 HTTP 客户端,运行 npx neurarch-mcp model.py --http,并将客户端指向:
{ "mcpServers": { "neurarch": { "type": "http", "url": "http://127.0.0.1:8787/mcp" } } }
**验证:**让 Agent “列出你能看到的 Neurarch 工具。” 在 Shell 中运行 npx -y neurarch-mcp --help,即可打印用法和完整工具列表。
标志
--write:暴露六个变更工具。默认关闭。--watch:模型文件发生更改时重新加载。与应用配合使用。--hf:允许使用hf:<org/name>引用,并列出load_hf_model。这是唯一的网络开关。对于受限仓库,会发送HF_TOKEN;结果会在~/.cache/neurarch-mcp下缓存一天。--tools=full:公布所有读取工具。默认公布核心的十九个,按建议调用顺序列出(size_training_job、trace_model、plan、history、diagnose_oom、check_edit、check_parallel_layout、check_serving_config、check_pins、model_changes,然后是离线阶梯);无论采用哪种方式,所有工具仍可按名称调用,并且neurarch://docs/<tool>提供完整契约。默认列表每轮约消耗 Agent 5.5k 个令牌,完整列表约消耗 7.8k 个令牌,均包含输出架构。--toolsets=sizing,serving,...:仅公布这些分组(sizing、parallel、serving、changes、design、models、write)。只需评估训练任务规模的团队只需加载六个工具(每轮约 1.6k 个令牌)。write等同于--write,启动时的拒绝规则也相同;未知分组名称会导致服务在启动时停止。优先级高于--tools。--read-only:即使设置了--write或--toolsets=write,也绝不暴露写入工具。lint_model、find_layers、layer_impact、describe_architecture和check_design上的response_format: "concise" | "detailed"。默认采用简洁模式,并说明省略了哪些内容(omitted.count,或find_layers的fields);在 qwen2.5-7b 上,简洁模式会按规则统计信息类发现项,而不是逐项列出,从而将lint_model的输出从 10.6 KB 缩减到 1.4 KB。--http[=PORT]、--host=ADDR:通过 Streamable HTTP 提供服务。参见远程访问。--version、--help。
网络:三个工具、两个开关,仅此而已
| 内容 | 发送内容 | 何时发送 |
|---|---|---|
plan | 将你的图(以及基础图和策略规则)发送到 POST /api/v1/plan。share 固定为 false。 | 仅当 Agent 调用 plan 时。 |
history | 将 8 个字符的结构指纹和你的 NEURARCH_API_KEY 发送到 GET /api/v1/history。绝不发送图。 | 仅当 Agent 调用 history 且已设置密钥时。未设置密钥时不会发出请求。 |
model_changes | 向 www.neurarch.com 发出两次 GET 请求,获取公开静态文件:建议索引和某个模型的修订列表(其路径就是模型 ID)。不发送密钥、图或仓库中的任何内容。 | 仅当 Agent 调用 model_changes 时;索引缓存一小时。 |
--hf | 向 huggingface.co 请求某个仓库的 config.json;对于 check_serving_config,还会请求 tokenizer_config.json、chat_template.jinja 和 generation_config.json(以及已设置的 HF_TOKEN)。绝不发送你的模型。 | 仅在调用 load_hf_model 或使用 hf: 引用时;每个文件缓存一天。 |
NEURARCH_REPORT=1 | 发送一条匿名的结构与判定记录:结构指纹、层类型直方图、边数、(规则 ID、严重性)对。从结构上就不可能包含图。 | 每次调用 validate_model、lint_model、check_design 或 plan 后发送,不等待响应,最多等待 5 秒。 |
两个开关默认都处于关闭状态,NEURARCH_REPORT 的行为也没有改变:plan 加入了另外三个原本就会发送记录的工具,因此选择启用后,所有负责评分的工具都遵循同一规则;而 history 不进行评分,也不会发送记录。这里没有任何新功能默认开启;三个工具只会在被调用时访问网络,这一点已在各自的说明和 openWorldHint 注释中明确说明。启用 --hf 后,所有读取工具也都标注为开放世界,因为任何一个工具都可能接收 hf: 模型。
关闭 --hf、不设置 NEURARCH_REPORT,且不调用 plan 或 history 时,此服务完全不会发出网络请求,也没有其他工具例外:解析器、规则引擎、验证器、排序器和参考库都已随软件包一同提供,因此你的模型不会离开本机。NEURARCH_API(neurarch-trace 使用的同一变量)可将这两个账本工具指向其他位置。语料库策略:neurarch.com/rules.html#data。
远程访问
默认情况下,服务通过 stdio 通信,因此 Agent 和模型文件位于同一台机器上。--http 会通过 Streamable HTTP 提供相同的工具,因此托管式或手机上的 Agent 可以操作在你机器上运行的模型,例如通过 Cloudflare 或 Tailscale 隧道访问。
npx neurarch-mcp model.py --http                        # loopback, no auth needed
NEURARCH_MCP_TOKEN=$(openssl rand -hex 16) \
  npx neurarch-mcp model.neurarch.json --write --http --host=0.0.0.0
默认绑定到 127.0.0.1,并启用 DNS 重绑定保护;NEURARCH_MCP_TOKEN 会要求每个请求都携带 Authorization: Bearer <token>,且在 --write 绑定到非环回主机之前必须设置该变量。
**托管部署,磁盘上没有模型:**运行 npx neurarch-mcp --http --hf,即可启动一个服务,根据每次调用指定的内容作出响应(model_path: "zoo:..." / "hf:...",或通过 model_source 内联提供模型文本)。部署配置见 Dockerfile、fly.toml 和 docs/HOSTED.md。托管服务会看到客户端发送的模型文本,而本地服务不会;发布 URL 时请明确说明这一点。
来自真实代码的真实形状:neurarch-trace
静态解析无法超越源代码。 python/neurarch-trace 会实例化模型、使用钩子运行一次前向传递,并写入一个 .neurarch.json 文件,其中填入了所有形状,包括函数式残差加法和拼接:
pip install neurarch-trace
neurarch-trace models/resnet.py:ResNet18 --input 1,3,224,224 -o resnet18.neurarch.json
neurarch-trace hf:bert-base-uncased --input 1,128 --dtype long          # needs transformers
npx -y neurarch-mcp resnet18.neurarch.json
形状会省略批次维度([3,224,224],而不是 [1,3,224,224]),这是此处所有工具都遵循的约定。
开发
git clone https://github.com/neurarch-ai/neurarch-mcp && cd neurarch-mcp
npm install
npm run typecheck && npm run build && npm test     # vitest, 290+ tests
node dist/index.js --help
npm run build:mcpb                                 # the Claude Desktop bundle
CI 会在 Node 20 和 22 上运行类型检查、构建和测试。此软件包包含来自 Neurarch 主仓库的代码,因此无需网络、密钥或额外安装即可运行:src/vendor/engine.bundle.mjs(注册表、PyTorch 解析器、规则集、代码生成器、HF 配置转换器)和 src/vendor/verifier.bundle.mjs(五个流水线阶段、溯源表、排序器)。两者均为生成文件,经过契约测试,并断言不包含 import(对于 verifier,还不包含 fetch)。MCP SDK(@modelcontextprotocol/server,HTTP 适配器使用 @modelcontextprotocol/node)是唯一的运行时依赖。zoo/ 从 awesome-llm-model-zoo 同步,使用 npm run sync:zoo。
新增工具是一个小型、独立的 PR:请参阅 CONTRIBUTING.md。用于教会 Agent 通过这些工具执行证据门控编辑循环的技能位于 skills/(npx skills add neurarch-ai/neurarch-mcp)。
故障排除
- 客户端中始终看不到服务。 在任何全局配置中,模型路径都必须是绝对路径;
npx不会从你的项目目录运行。相对路径仅适用于项目级配置(.mcp.json、.cursor/mcp.json、.vscode/mcp.json)。 - 读取工具可用,但看不到写入工具。 你没有传入
--write。默认情况下此功能关闭,以防意外写入覆盖你正在应用中编辑的文件。 - 首次运行时
npx失败。 需要 Node >= 20(node --version)。 - 编辑配置后 Claude Desktop 中什么也没显示。 完全退出并重新打开应用;配置只会在启动时读取。
- 在应用中编辑后,Agent 看到的是过时的图。 添加
--watch,或重启服务。
本项目不是什么
- 不是通用代码库索引器。 它读取模型定义(
.py、.neurarch.json、zoo:、hf:),而非整个目录树。若要了解代码库结构,请使用 GitNexus 或类似工具。 - 不是训练器。 它会告知一次运行需要什么、能否启动、成本是多少,以及结果可以在哪里提供服务;它绝不会占用你的 GPU 时间。
- 不是测量工具。
size_training_job给出的是经过校准的估算值(根据 41 种架构上的 178 次实测运行拟合;留出测试中,中位误差为 7%,并标记了 131 次无法在单张显卡上运行的测试中的 113 次;拟合后测量的 25 次运行中,中位偏差为 14%);它不是性能分析器,而且使用 AdamW 以外的优化器或不使用 bf16 自动混合精度的任务会有所不同。check_design会指出哪些决策需要由你做出。 - 未连接到你的 Neurarch 工作区。 它会读取文件。实时编辑在 Neurarch 应用中进行;
--watch会跟踪其中的保存操作。
问题与反馈
此仓库是以下两者的公开主页:
- neurarch-mcp(此 MCP 服务):错误、协议变更、集成问题。
- Neurarch(应用):画布错误、Agent 问题、代码检查规则、功能请求。
| 🐛 报告错误 | 遇到故障或行为异常。 |
| 💡 请求功能 | 能让 Neurarch 或 MCP 服务变得更好的想法。 |
| ❓ 提出问题 | 有具体问题尚未弄清楚。 |
| 💬 发起讨论 | 开放式想法、设计反馈、“如何才能……”等。 |
请为问题添加 mcp、app、linter 或 feature-request 标签,以便我们更快地分类处理。
为此仓库点星
如果 neurarch-mcp 帮你省去了把 nn.Module 粘贴到聊天中的麻烦,一个 ⭐ 就能帮助其他机器学习工程师找到它。这是支持此项目最省力的方式。
贡献
新增工具是一个小型、自包含的 PR。请参阅 CONTRIBUTING.md,了解“添加工具”的 3 步指南。
开发
git clone https://github.com/neurarch-ai/neurarch-mcp
cd neurarch-mcp
npm install
npm run typecheck             # tsc --noEmit
npm run build                 # tsup → dist/index.js
npm test                      # vitest (≈190 unit + end-to-end tests)
node dist/index.js --help     # confirm bin works
CI 会在每次推送和 PR 中,在 Node 20 和 22 上运行 typecheck、build 和 test。
该包从 Neurarch 主仓库引入代码,所有内容都以相同的理由一并引入:此服务必须能在没有网络、没有 API 密钥且无需第二次安装的情况下运行。
src/lib/:纯 TypeScript 工具(模型类型、参数和 FLOP 估算器、影响分析器),在此处以源代码形式维护。src/vendor/engine.bundle.mjs:编译后的 Neurarch 引擎:组件注册表、为.py支持提供底层解析能力的 PyTorch 解析器,以及lint_model背后的规则集。此文件由工具生成,绝不手动编辑;文件头说明了如何重新生成;如果导出内容发生变化或文件引入了任何依赖,src/vendor/engine.contract.test.ts就会失败。src/vendor/verifier.bundle.mjs:编译后的 Neurarch 验证器,为check_design提供支持:包含五个流水线阶段以及规则来源表。它与应用和托管端点使用相同的代码路径,因此此处的 Agent 和应用中的用户会得到相同的结果。规则也相同:由工具生成、经过契约测试(verifier.contract.test.ts),并断言不包含任何依赖或fetch。
两者都不会增加运行时依赖:MCP SDK 仍然是唯一的依赖。
隐私政策
此服务运行在你的计算机上,设计上不会主动向外发送数据:
- 数据收集:默认不收集任何数据。你的模型文件、图和源代码均从磁盘读取,且只有在调用
plan工具时才会发送。 plan(按需):将你正在规划的图(以及你传入base_path时的基础图,还有.neurarch.yml中的策略行)发送到neurarch.com上的POST /api/v1/plan,由其生成卡片并返回。share固定为 false,因此不会发布任何内容;图仅用于处理此次调用。若你设置了NEURARCH_API_KEY,也会一并发送。其他工具都不会发送你的模型。history(按需,需要密钥):将图的 8 个字符的结构指纹和你的NEURARCH_API_KEY发送到GET /api/v1/history。图本身绝不会发送;如果没有设置密钥,该工具完全不会发出请求。NEURARCH_API(可选):将这两个工具指向其他主机;没有其他内容会读取此变量。--hf(可选):从 huggingface.co 获取模型的公开config.json。发送的内容:你请求的仓库 ID,以及你设置的HF_TOKEN(仅发送到 huggingface.co)。响应会缓存在本地~/.cache/neurarch-mcp中,可随时删除。NEURARCH_REPORT=1(可选,默认关闭):针对每个经过评分的图(validate_model、lint_model、check_design、plan),向 Neurarch 语料库发送一条匿名结构记录:结构指纹(8 字符哈希)、层类型直方图、边数,以及(规则 ID、严重性)组合。载荷格式无法包含你的图、参数值、层名称、文件路径或任何身份信息。策略和示例:neurarch.com/rules.html#data。- 托管实例(
neurarch-mcp.fly.dev)的运行方式本质上不同:它会在内存中处理客户端发送的模型文本或引用,以响应此次调用。除为期一天的hf:配置缓存外,服务器端不会存储任何内容;没有账户,也不会记录包含图内容的请求日志。该实例启用了NEURARCH_REPORT=1,因此每次评分调用也会发送上述匿名结构记录;如果你不希望这样,请使用本地服务。 - 保留期限:本地服务除本地缓存外不会存储任何内容。语料库记录(自愿选择加入)会以匿名汇总数据的形式无限期保留。
- 第三方:不会与任何人共享数据。唯一可能联系的第三方端点是 huggingface.co,且仅在使用
--hf时;只有plan、history和自愿选择加入的语料库报告会联系neurarch.com。 - 联系:[email protected],或提交 issue。
适用于整个应用的政策位于 neurarch.com/privacy,涵盖 Neurarch Web 应用;本节则涵盖此服务。
许可证
MIT。请参阅 LICENSE。
链接
- Neurarch:可视化神经网络编辑器,用于生成此服务读取的模型文件。
- Model Context Protocol:此服务实现的规范。
- npm:软件包页面。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。