关于 Codebase Brain
Codebase Brain 是本地 MCP 服务,可为仓库建立索引,让编码 Agent 通过文件和行号引用回答代码问题。它结合代码搜索、Git 历史、变更影响分析和文档漂移检查。
主要功能
- 01混合搜索代码和文档
- 02回答附带文件及行号引用
- 03追踪函数的 Git 变更历史
- 04分析变更的直接和间接影响
- 05检测文档漂移
- 06索引本地文件夹或公开 Git URL
适用场景
- 01查找与行为问题相关的代码
- 02了解函数变更的原因
- 03修改代码前检查调用方和测试
- 04发现与代码不符的文档引用
MCP 相关
它通过 MCP 工具提供仓库索引、搜索、历史查询、影响分析和文档检查,并包含 `brain://repos` 资源及 `answer_with_citations` 提示词。可通过 stdio 本地运行,也可作为受令牌保护的 Streamable HTTP 服务运行。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
uvx codebase-brain-mcpGITHUB_TOKEN密钥Optional. Raises GitHub's rate limit when reading pull request titles and descriptions.CODEBASE_BRAIN_HOMEWhere indexes and clones are stored (default ~/.codebase-brain).本地服务需要在你的电脑上安装运行环境(如 Node.js 18+)。各客户端的配置文件位置不同,请参考客户端文档。
工具
9收录的工具列表 · 更新于 3 天前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| name | any | 否 | 为其建立索引时使用的名称。默认为文件夹名或代码库名称。 |
| source | string | 是 | 本地目录,或 https git URL,例如 https://github.com/owner/repo。 |
详细介绍
Codebase Brain MCP


一个 MCP 服务,为 AI 助手提供可搜索、带引用的代码库记忆,包括代码库历史。将其指向本地文件夹或公开的 git URL。随后,Claude、Cursor 或任何 MCP 客户端都可以通过精确的 path:start-end 引用来回答有关代码的问题。
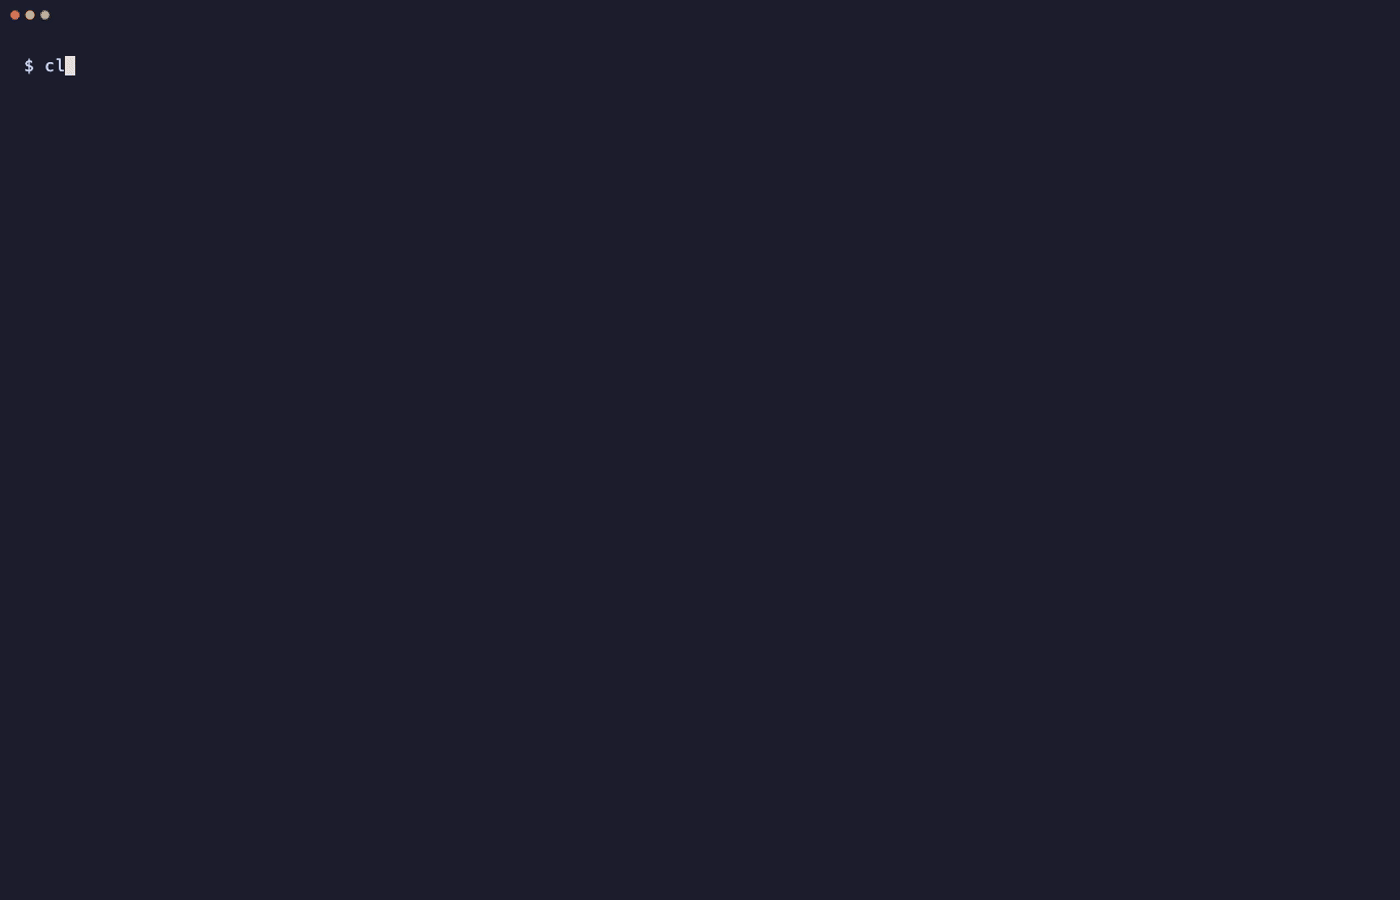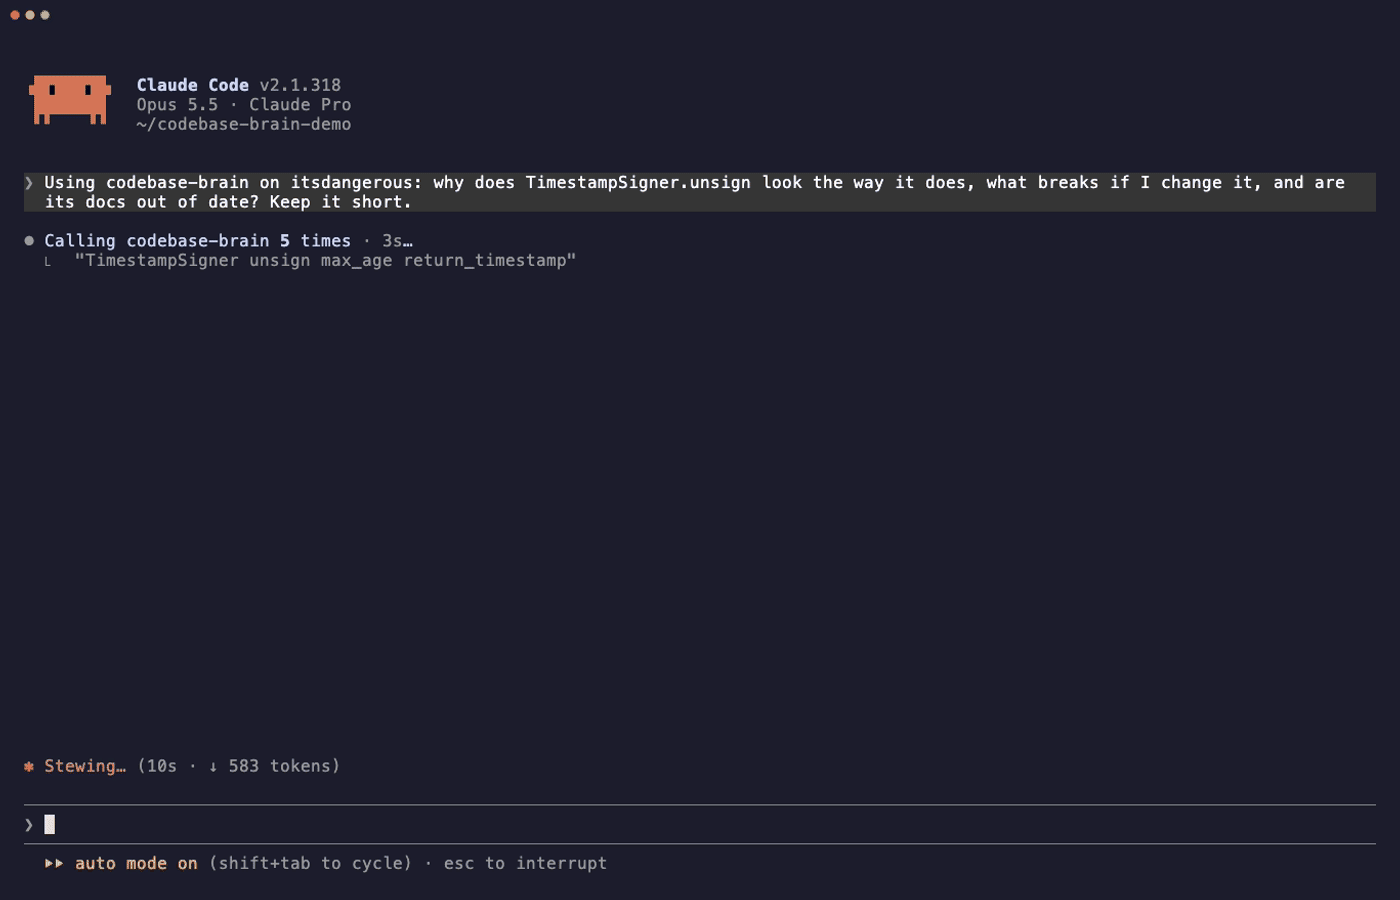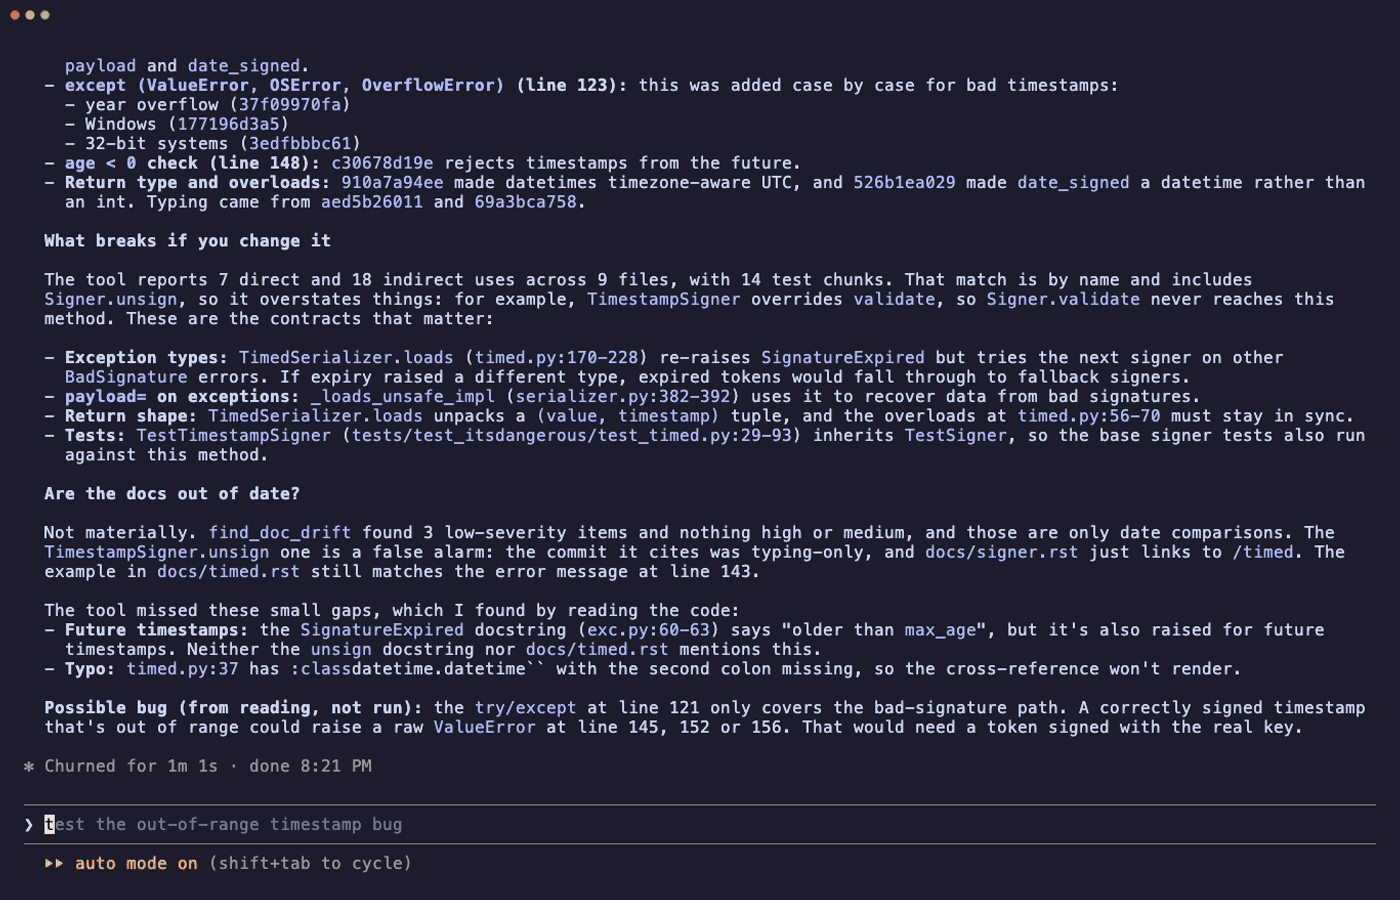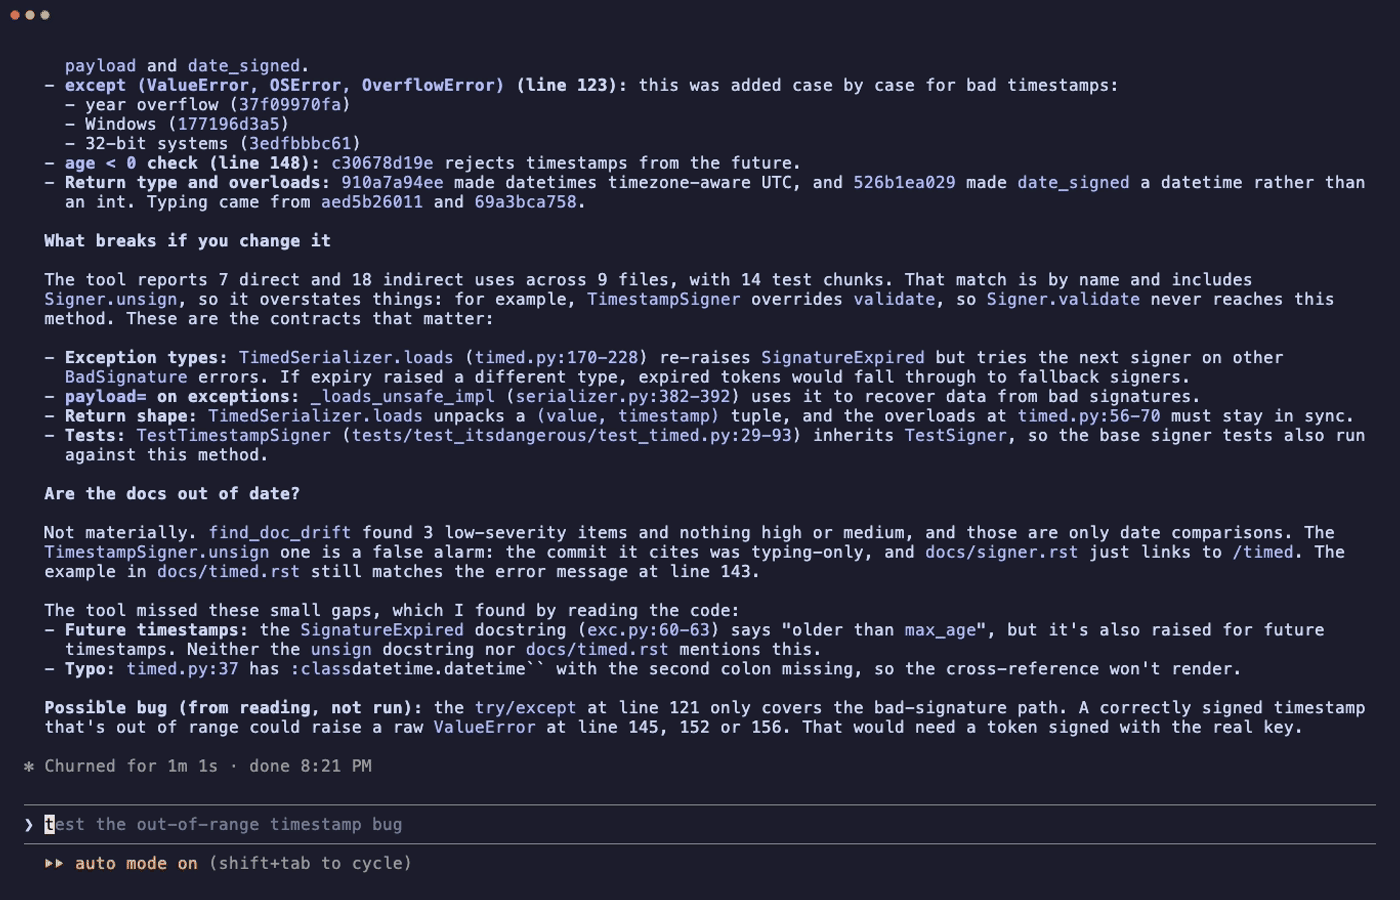
Claude Code 询问 TimestampSigner.unsign 为什么会是现在的样子、修改它会有什么影响,以及其文档是否仍然准确。Codebase Brain 会给出提交记录、调用方、测试和文档检查结果,并附上引用。(等待过程已加速。)
问题所在
AI 编码助手擅长编写新代码,却难以理解已有代码:
- 它们无法看到整个项目。 实际代码库包含数千个文件。助手只读取其中几个,然后猜测其余部分,因此会漏掉关键函数,或凭空编造不存在的函数。
- 你无法核实它们的回答。 如果你看不到出处,“过期时间由认证模块处理”这句话就没有用。没有文件和行号引用,你只能相信回答,或者自己重新阅读代码。
- 它们不知道代码为何如此。 代码展示了它做了什么。原因(“我们添加这项检查是因为它在 Windows 上会崩溃”)则记录在 git 历史和拉取请求中,助手从不查看。因此,它们会“清理”那些有其存在理由的代码,并让旧 Bug 再次出现。
- **它们不知道改动会破坏什么,**也不知道文档是否仍与代码一致。
- 许多工具会把你的代码发送到别人的服务器,以便建立可搜索索引。
Codebase Brain 为你提供的功能
一个适用于任何 AI 助手的插件,可将代码库变成助手真正能够查询的内容:
- 提供有依据的回答。 每条结果都指向确切的文件和行号,助手还可以打开这些位置。
- 理解代码的搜索功能。 无论你输入准确名称(
calculate_invoice_total),还是用通俗语言描述(“发票总额是如何计算的?”),都能找到相关代码。 - 代码背后的故事。 对于任何函数,它都会展示对该函数所做的每项更改、更改者、更改原因(来自提交消息和拉取请求),以及具体改动内容。
- 更改某项内容会造成什么影响。 展示直接或间接使用某个函数的所有内容,以及覆盖它的测试。
- 自动发现过时文档。 找出提及已不存在的函数、文件或设置的文档,或展示已无法正常使用的示例。
- 以隐私为设计核心。 一切都在你的计算机上运行。无需 API 密钥,你的代码也不会离开你的计算机。
为何与众不同(技术层面)
- 代码感知分块。 Python(使用
ast)和 JavaScript / TypeScript / JSX / TSX(使用 tree-sitter)会按函数、类、方法、箭头函数、接口、类型和枚举进行拆分,并保留其文档注释。Markdown 会按标题拆分。每个分块都记录其符号(TimestampSigner.unsign、Ky.#retry)和精确行号,因此引用指向真实代码。其他语言则按有重叠的行窗口建立索引。 - 混合检索。 SQLite FTS5 BM25(支持
camelCase/snake_case标识符拆分)结合本地嵌入,并通过倒数排名融合进行合并。无论是精确名称还是模糊问题,都能奏效。 - 本地且免费。 嵌入在你的设备上运行(
fastembed、ONNX)。无需 API 密钥,代码也不会离开你的计算机。 - 增量处理。 重新建立索引时,只会重新嵌入内容发生变化的文件。对于一个包含 42 个文件的代码仓库,在没有变更时重新建立索引大约需要 2 秒。
- 感知历史。
explain_history会通过 git(git log -L)追溯函数各行的历史,显示当前行的作者,并链接到每次变更对应的拉取请求。因此,Agent 能回答 “为什么要这样构建?”,而不只是 “它是做什么的?”。 - 影响分析。 在 Agent 修改任何内容之前,
impact_of_change会列出直接或间接使用某个函数的所有内容,以及调用该函数的测试。它支持跨 Python、JavaScript 和 TypeScript 文件分析,还会沿着构造函数追踪到创建其类的代码。 - 文档漂移检测。
find_doc_drift会检查 Markdown 和 reStructuredText 文档与代码是否一致。它能找出不存在的文件、函数、设置和标志;传入函数不接受的参数的示例;会导致失败的导入;以及比所描述代码的变更时间早很久才编辑过的章节。每条发现都会引用文档章节并建议修复方式(“它是否已重命名为checkout_total?”)。 - 便于 Agent 使用的输出。 结构化工具结果、只读工具注释、索引期间的进度通知,以及清晰且模型可据此采取行动的错误消息。
工具
| 工具 | 功能说明 |
|---|---|
index_repo(source, name?) | 为本地路径或 https:// git URL(浅克隆)建立索引。会报告进度。 |
ask_codebase(question, repo?, k?) | 返回最相关的代码和文档作为引用来源,并附上相关提交,同时指示只能依据这些内容作答。 |
search(query, repo?, k?, path_prefix?, kinds?) | 执行原始混合搜索,可按路径和分块类型筛选。 |
explain_history(symbol? | path, start_line?, end_line?, repo?) | 按时间倒序列出更改某个函数或行范围的所有提交,并提供相关差异、当前作者,以及 PR 标题和描述(GitHub)。 |
search_history(query, repo?, k?) | 根据提交说明的内容查找提交。 |
impact_of_change(symbol, path?, depth?, repo?) | 查找直接和间接使用某个函数或类的内容,以及相关测试。 |
find_doc_drift(path_prefix?, check_history?, repo?) | 按严重程度(高、中、低)列出与代码不再一致的文档。 |
read_lines(path, start, end, repo?) | 打开引用对应的确切行。拒绝访问代码仓库之外的路径。 |
list_repos() | 查看已建立索引的内容、对应提交以及所用语言。 |
还包括资源 brain://repos 和提示词 answer_with_citations。
安装
Codebase Brain 在你自己的设备上运行,因此无需服务或账号,而且免费。使用 uv:
# Claude Code
claude mcp add codebase-brain -- uvx codebase-brain-mcp

# Any MCP client (Claude Desktop, Cursor, ...): add this server to its config
{ "command": "uvx", "args": ["codebase-brain-mcp"] }
快速开始
uv sync
uv run codebase-brain index https://github.com/pallets/itsdangerous
uv run codebase-brain search "how is the signature timestamp checked for expiry"
0.0313  src/itsdangerous/timed.py:72-158  method TimestampSigner.unsign
0.0311  docs/timed.rst:1-28  code
0.0301  src/itsdangerous/timed.py:170-228  class TimedSerializer
询问它为何如此。explain_history(symbol="TimestampSigner.unsign") 会返回逐行历史记录:
src/itsdangerous/timed.py:72-158
  3edfbbbc 2022-03-24 handle OverflowError in timed unsign on 32-bit systems
  177196d3 2022-03-09 catch OSError on Windows
  37f09970 2022-03-08 catching year overflow ValueError
  c30678d1 2019-05-31 don't allow timestamps from the future
  910a7a94 2020-04-17 datetimes are timezone-aware utc
  ...
在 Claude Code 中使用
claude mcp add codebase-brain -- uv run --directory /path/to/codebase-brain-mcp codebase-brain
将其作为远程服务运行(Streamable HTTP)
export CODEBASE_BRAIN_TOKEN="$(python -c 'import secrets; print(secrets.token_urlsafe(32))')"
uv run codebase-brain serve --transport streamable-http --host 0.0.0.0 --port 8765
客户端使用 Authorization: Bearer <token> 连接到 http://<host>:8765/mcp。负载均衡器可公开访问 GET /healthz。远程模式默认受到严格限制:
- 没有令牌,就不开放公网端口。 如果没有至少 24 个字符的令牌,服务就不会监听 localhost 以外的地址。令牌采用恒定时间比较。
- 远程客户端无法读取服务的磁盘。 只能为公开的
https://Git URL 建立索引,不能使用本地路径,除非设置CODEBASE_BRAIN_ALLOW_LOCAL_PATHS=1。 - 超过
CODEBASE_BRAIN_MAX_FILES(默认值为 20,000)的大型仓库会被拒绝,并且每条 Git 命令都有超时限制。 - 针对 localhost 的 DNS 重绑定防护已启用;对
CODEBASE_BRAIN_ALLOWED_HOSTS中列出的主机也同样启用。
Docker
docker build -t codebase-brain-mcp .
docker run -p 8765:8765 -e CODEBASE_BRAIN_TOKEN="$CODEBASE_BRAIN_TOKEN" -v brain-data:/data codebase-brain-mcp
镜像以非 root 用户运行,并包含嵌入模型,因此启动迅速,运行时无需下载。镜像带有健康检查,并将索引保存在 /data 卷中。建立索引约需 1.2 GB 内存,因此请为容器分配 2 GB。
配置
| 变量 | 默认值 | |
|---|---|---|
CODEBASE_BRAIN_HOME | ~/.codebase-brain | 索引和克隆的仓库 |
CODEBASE_BRAIN_EMBEDDER | fastembed | hash 提供离线且确定性的嵌入器(用于测试) |
CODEBASE_BRAIN_EMBED_MODEL | BAAI/bge-small-en-v1.5 | 任意 fastembed 文本模型 |
CODEBASE_BRAIN_MAX_FILE_BYTES | 512000 | 跳过更大的文件 |
GITHUB_TOKEN | 未设置 | 可选。提高 GitHub API 在 PR 查询方面的速率限制 |
CODEBASE_BRAIN_FETCH_PRS | 1 | 设为 0 可禁止调用 GitHub API |
CODEBASE_BRAIN_TOKEN | 未设置 | HTTP 模式的 Bearer 令牌(除非绑定到 localhost,否则必需) |
CODEBASE_BRAIN_ALLOWED_HOSTS | 未设置 | 以逗号分隔的可接受 Host 值(DNS 重绑定防护) |
CODEBASE_BRAIN_ALLOW_LOCAL_PATHS | 1(stdio)/ 0(HTTP) | index_repo 是否可以读取本地目录 |
CODEBASE_BRAIN_MAX_FILES | 20000 | 拒绝可建立索引的文件数量超过此值的仓库 |
PORT | 8765 | HTTP 端口(Cloud Run 等平台会设置此项) |
严谨地测试文档与代码的偏差
对于维护良好的项目(itsdangerous),find_doc_drift 不会报告误报。它只报告了三个“值得关注”的部分:这些文档的编写时间是 2020 年,而其描述的代码在 2024–2025 年发生了变更。对于人为植入错误的文档,它能找出所有问题:文件被移动、函数被重命名(并给出正确建议)、设置和标志未知、函数不接受某个关键字参数,以及导入会失败。它会跳过变更日志,因为变更日志本来就应该提及已移除的内容。
评估
搜索是否真的能把正确的代码呈现给模型?codebase-brain eval 会通过基准测试给出答案。基准测试共有两套,每套包含 32 个问题,并固定在某个提交上;每个问题都列出了优质答案必须参考的代码或文档。这些问题是在测量任何结果之前,通过阅读代码编写的,此后一直没有改动。
Python:pallets/itsdangerous
在提交 672971d 中,关于 pallets/itsdangerous 的 32 个问题,详见
evals/datasets/itsdangerous.toml。
| 模式 | Hit@1 | Hit@3 | Hit@5 | Hit@10 | MRR@10(95% 置信区间) | nDCG@10 | p50 延迟 |
|---|---|---|---|---|---|---|---|
| 混合(默认) | 56% | 88% | 88% | 91% | 0.697(0.56–0.82) | 0.735 | 5 ms |
| 仅关键词(BM25) | 56% | 75% | 78% | 84% | 0.667(0.52–0.80) | 0.699 | <1 ms |
| 仅向量(bge-small) | 56% | 72% | 75% | 94% | 0.658(0.51–0.80) | 0.701 | 4 ms |
| 按问题类型划分的 Hit@5 | 描述行为(14) | 关于文档(7) | 提及代码名称(11) |
|---|---|---|---|
| 混合 | 71% | 100% | 100% |
| 仅关键词 | 64% | 71% | 100% |
| 仅向量 | 57% | 71% | 100% |
结果说明:
- **混合模式能在 88% 的问题中于前三条结果内找到正确答案,**而单独使用任一方法时,这一比例分别为 75% 和 72%。 提升主要来自用日常语言表述的问题,以及关于文档的问题。问题中提及代码名称时,所有模式都能找到答案。
- 它会如实反映不确定性。 对于 32 个问题,MRR 的置信区间有重叠,因此混合模式在这组数据上表现更好,但尚不能证明它在总体上更优。逐题来看,混合模式在 8 个问题上优于仅关键词模式,在 4 个问题上表现较差。
- 它也有已知的漏答。 有 4 个用与代码差异很大的措辞描述行为的问题,未能进入前 5 条结果。这些问题列在
evals/results/itsdangerous.md中,也是下一步要改进的内容。我们会先准备一组更大规模、留出的测试问题,以避免调优结果只适用于这 32 个问题。
TypeScript:sindresorhus/ky
在提交 3541888 中,针对 sindresorhus/ky 的 32 个问题,收录于
evals/datasets/ky.toml。
README 是一个包含 2,000 行的文件,因此文档问题必须找到正确的章节,而不只是找到文件。
| 模式 | Hit@1 | Hit@3 | Hit@5 | Hit@10 | MRR@10(95% CI) | nDCG@10 | p50 延迟 |
|---|---|---|---|---|---|---|---|
| 混合(默认) | 47% | 66% | 69% | 78% | 0.563(0.41–0.71) | 0.576 | 6 ms |
| 仅关键词(BM25) | 38% | 44% | 53% | 62% | 0.436(0.29–0.59) | 0.455 | 1 ms |
| 仅向量(bge-small) | 47% | 69% | 75% | 78% | 0.594(0.46–0.74) | 0.604 | 5 ms |
| 按问题类型划分的 Hit@5 | 描述行为(14) | 关于文档(7) | 指明代码名称(11) |
|---|---|---|---|
| 混合 | 36% | 100% | 91% |
| 仅关键词 | 7% | 86% | 91% |
| 仅向量 | 43% | 100% | 100% |
结果说明:
- **指明代码名称或询问文档内容的效果很好:**前 5 条结果的命中率为 91–100%。
- 用日常语言描述行为是薄弱环节(36%)。 ky 的测试约有 25,000 行,源代码约有
5,000 行;测试也用日常语言描述相同的行为,因此排名高于源代码。
所有未命中项都列在
evals/results/ky.md中。 - 这里的混合模式不如仅向量模式。 两者的区间大量重叠(混合模式在 5 个问题上胜过向量模式,在 9 个问题上落后), 因此无法证明哪种模式更好。仅关键词模式明显最差:混合模式在 12 个问题上胜过它,没有任何问题落后。
- 这些结果按测量值发布。调优(例如让源代码的排名高于测试)会用一组新的留出集进行验证,以免针对这些问题过拟合。
复现任一基准测试(首次运行时会下载代码库和嵌入模型):
uv run codebase-brain eval evals/datasets/itsdangerous.toml --out evals/results
uv run codebase-brain eval evals/datasets/ky.toml --out evals/results
测量方式:
- **Hit@k:**相关结果出现在前 k 条结果中。
- **MRR:**1 / 首个相关结果的排名。
- **nDCG@10:**每个目标只计分一次,因此重复的代码块不会抬高分数。
- **置信区间:**以问题为单位进行 95% 自举抽样,使用固定随机种子。
- **相关性:**如果结果位于目标文件中,且当目标指定了符号时,该结果是该符号或其某个方法,则视为相关。
- **数据集失效:**如果目标在固定的提交中已不存在,测试框架会报错。
工作原理
source ─► resolve (local dir / shallow https clone) ─► list files (.gitignore-aware, skips binaries and lockfiles)
       ─► chunk (ast / tree-sitter / headings / windows) ─► embed (fastembed) ─► SQLite: chunks + vectors + FTS5
query  ─► BM25 top 50 ┐
       ─► vector top 50 ┴─► reciprocal-rank fusion ─► filters ─► cited sources
安全
- 克隆采用无 blob 模式(
--filter=blob:none):保留完整历史,仅在需要时获取文件内容。 - 提交作者仅显示姓名;电子邮件地址绝不会被存储或返回。
- 只接受
https://克隆 URL。Git 使用GIT_ALLOW_PROTOCOL=https:file运行,且不会显示终端提示。 read_lines会解析路径,并拒绝任何位于已索引代码库之外的路径。- 代码库名称经过验证,因此无法跳出索引目录。
- 所有查询工具都标记为只读。
- HTTP 模式下:必须提供 bearer token(使用恒定时间检查)、仅允许 Git URL、限制代码库大小、防止 DNS 重绑定,并使用非 root 容器。
开发
uv run pytest           # 54 tests, offline (hash embedder, temporary git repos, in-process MCP client)
uv run ruff check .     # lint
uv run ruff format .    # format
uv run pyright          # types
路线图
- Git 历史和 PR 讨论:
explain_history、search_history - 符号引用和传递依赖项:
impact_of_change -
find_doc_drift:Markdown 和 reStructuredText、签名、导入、设置、标志、过时内容 - JavaScript 和 TypeScript(tree-sitter):分块、引用、影响分析
- 更多语言(Go、Rust、Java)的 tree-sitter 支持
- 带置信区间的检索评估(
codebase-brain eval) - 扩大留出评估集,然后调优检索(重排序、查询扩展)
- 可流式传输的 HTTP,支持 bearer token 身份验证;Docker 镜像
- PyPI 包、MCP Registry 条目
- 托管演示
- OpenTelemetry 跟踪
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。