关于 Nutrient DWS MCP Server
Nutrient DWS MCP Server 是连接 Nutrient DWS Processor 与数据提取 API 的本地 MCP 服务,供 AI 助手处理文档。该仓库已停止维护,项目建议改用 Nutrient 托管的 MCP 服务。
主要功能
- 01文档转换、编辑与合并
- 02OCR、脱敏与数字签名
- 03解析文档并提取结构化数据
- 04按自定义字段模式提取并附引用
- 05沙盒文件访问与账户用量查询
适用场景
- 01将 PDF 与 Office 文件转换为其他格式
- 02识别扫描文档中的多语言文本
- 03对合同签名并为敏感信息脱敏
- 04从发票提取字段并保留页码引用
MCP 相关
通过 stdio 将文档处理与数据提取工具提供给 MCP 客户端。此本地实现已停止支持;README 建议连接 Nutrient 托管的 MCP 服务。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
npx -y @nutrient-sdk/dws-mcp-serverNUTRIENT_DWS_API_KEY密钥Nutrient DWS API key. Optional for local desktop use (browser sign-in on first request); required for CI or headless environments.NUTRIENT_DWS_EXTRACTION_API_KEY密钥Data Extraction API key (starts with pdf_live_), needed for parse_document and extract_fields in static-key mode. OAuth covers both products.SANDBOX_PATHLocal directory the server is allowed to read and write documents in.LOG_LEVELMinimum logging level; defaults to info.MCP_LOG_FILELog file path; defaults to a temporary file in stdio mode.本地服务需要在你的电脑上安装运行环境(如 Node.js 18+)。各客户端的配置文件位置不同,请参考客户端文档。
工具
7收录的工具列表 · 更新于 3 周前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| outputPath | string | 是 | 输出文件的路径。(如有需要)启用沙箱时解析为沙箱路径,否则解析为本地文件系统路径。 |
| instructions | object | 是 | 构建说明。 |
| instructions.parts | array | 是 | 要构建的文档部分。 |
| instructions.output | any | 否 | 输出格式配置。支持 PDF、PDF/A、PDF/UA、图片、JSON 内容、Office 文档格式、HTML 和 Markdown。 |
| instructions.actions | array | 否 | 文档根据各部分构建后要执行的操作。 |
详细介绍
Nutrient DWS MCP 服务
重要
此本地 MCP 服务已不再受支持。请改用 Nutrient MCP。
Nutrient 现在将其 MCP 服务托管在
https://mcp.nutrient.io/mcp。将该 URL 添加到 MCP 客户端,并使用 Nutrient 账号登录。无需安装、无需 API 密钥,也无需沙盒文件夹。# Claude Code claude mcp add --transport http --scope user nutrient https://mcp.nutrient.io/mcp # 然后运行 /mcp,选择 nutrient,并选择 Authenticate # Codex codex mcp add nutrient --url https://mcp.nutrient.io/mcp && codex mcp login nutrient在 Claude 应用中,将
https://mcp.nutrient.io/mcp添加为自定义连接器。若要切换,请从客户端配置中移除@nutrient-sdk/dws-mcp-server,并添加该 URL。此仓库仅保留供参考,不会再获得新功能或修复。
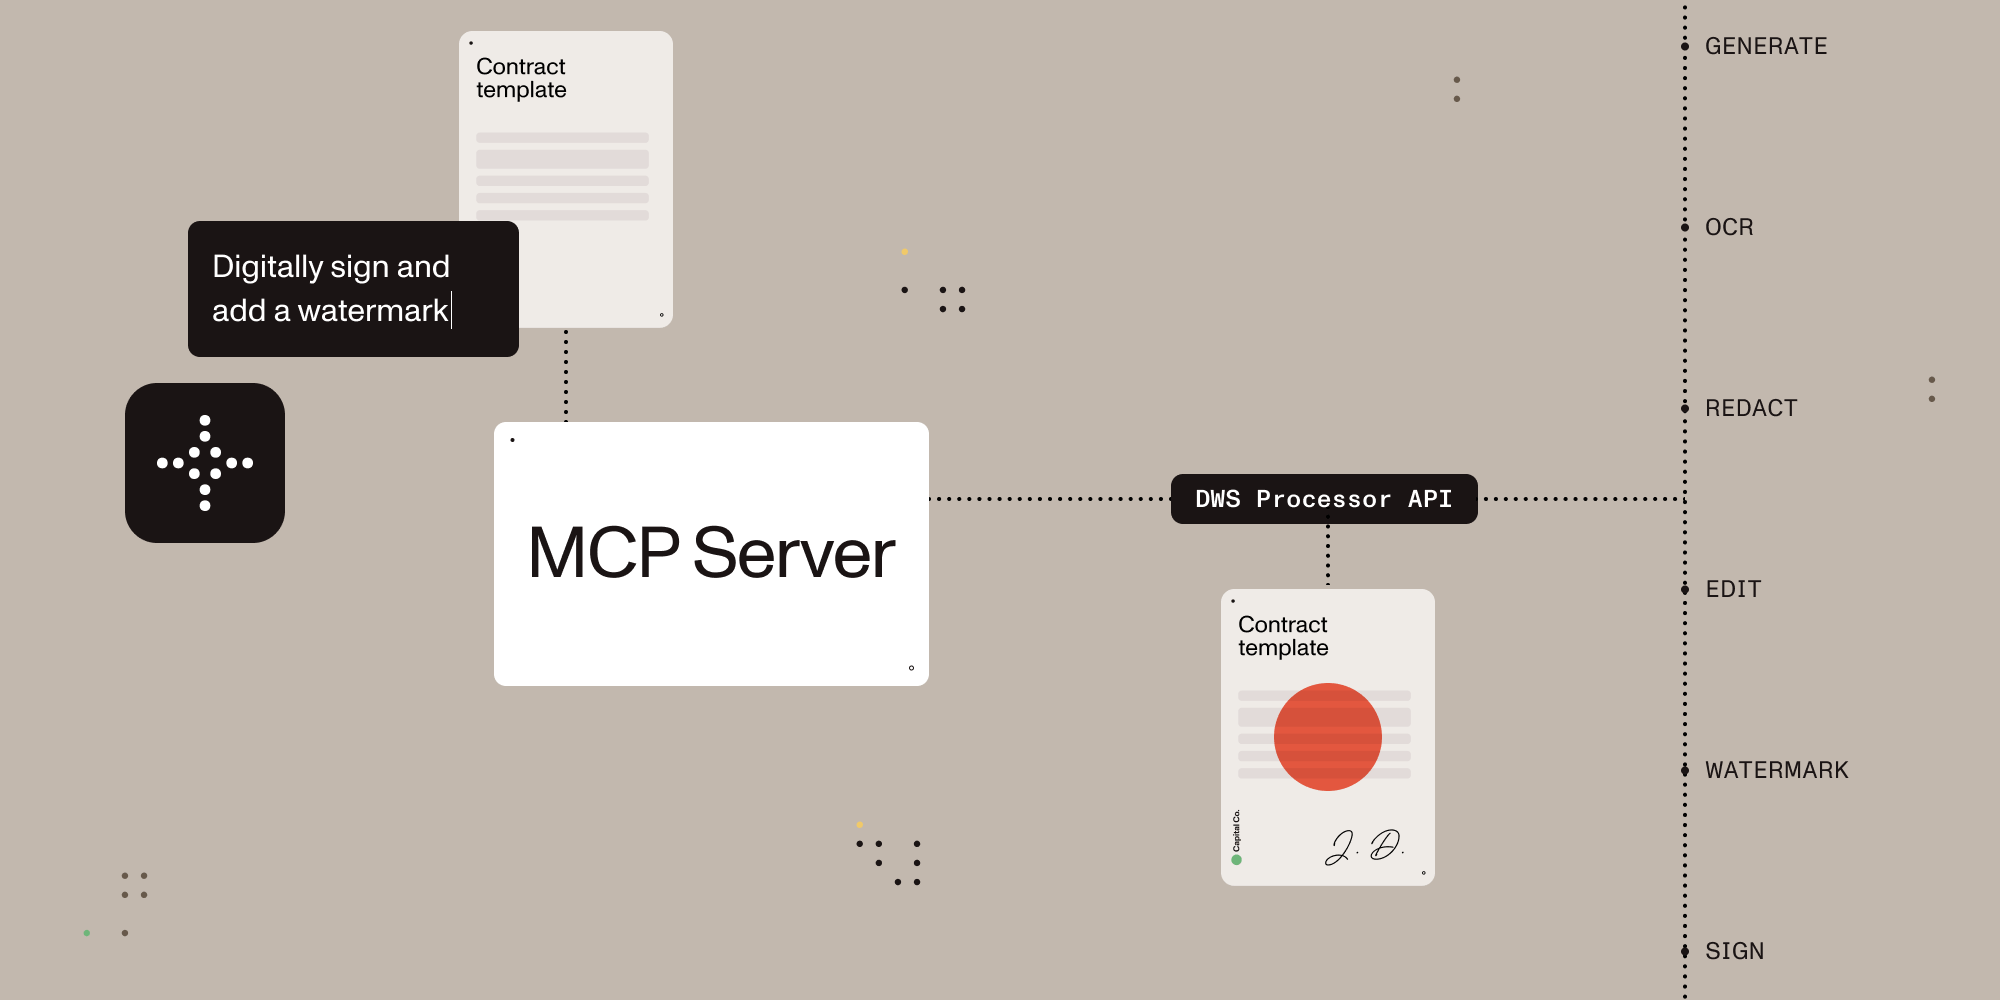

让 AI Agent 能够生成、读取、提取、处理和签署文档。
描述
一个模型上下文协议(MCP)服务,可将 AI 助手连接到 Nutrient Document Web Service(DWS) 处理器和数据提取 API,从而通过自然语言创建、编辑、转换文档,进行数字签名、OCR 和涂黑处理,还可提取结构化数据(包含边界框和置信度的类型化 JSON,或带有逐字段引用的架构引导式字段提取)。
功能
- 面向 Claude Desktop 和其他兼容 MCP 的客户端的本地 stdio MCP 服务
- 首次请求使用 Nutrient API 时通过浏览器进行 OAuth 身份验证,并可选择在 CI 和无头环境中使用 API 密钥作为备用方案
- 文档转换、OCR、涂黑、加水印、扁平化注释和数字签名(Processor API)
- 数据提取(Data Extraction API):将整份文档解析为 Markdown 或空间 JSON,然后将指定字段提取到你定义的 JSON 架构中,并附上逐字段引用。提供四种解析模式:
text(每页 1 个额度,不进行 OCR)、structure(1.5)、understand(9,默认模式)、agentic(18,VLM) - 支持沙盒的本地文件处理,并明确指定输出路径
- 只读查询 DWS 账号的额度和用量
你可以做什么
完成配置后,你或你的 AI Agent 可以通过自然语言处理文档:
你: “将 report-q1.pdf 和 report-q2.pdf 合并为一个文档” AI: “完成!我已将两份报告合并到 combined-report.pdf(共 24 页)。”
你: “从 application.pdf 中涂黑所有社会安全号码和电子邮件地址” AI: “我找到了 5 个社会安全号码和 3 个电子邮件地址,并已将其涂黑。涂黑后的版本已保存为 application-redacted.pdf。”
你: “为这份合同添加数字签名,并在第 3 页显示签名” AI: “我已为 contract.pdf 添加符合 PAdES 标准的数字签名。签署后的文档已保存为 contract-signed.pdf。”
你: “将此 PDF 转换为 Markdown” AI: “以下是从文档中提取的 Markdown 内容……”
你: “对这份扫描文档进行德语 OCR 并提取文本” AI: “我已使用德语 OCR 处理这份扫描件。以下是提取的文本……”
你: “从 invoice-0341.pdf 中提取供应商、发票编号、总额和到期日,并附上引用” AI: “以下是以 JSON 格式表示的四个字段。每个值都注明了对应的页码和边界框……”
安装
如果你使用 Claude Desktop,请在 Claude Desktop 设置 → 扩展中安装。如果你在本地开发,请使用下面的手动设置方法。
Claude Desktop MCPB 扩展默认将沙盒目录设为 ~/Documents/Nutrient。你可以在扩展设置中更改该目录。清空此字段后,服务器将不受沙盒限制启动,因此文件操作可以使用你的用户帐户可访问的任意路径。
1. 创建 Nutrient 帐户
在 nutrient.io/api 免费注册。
对于本地桌面使用,建议省略 NUTRIENT_DWS_API_KEY,并在首次使用 Nutrient API 的请求中完成浏览器登录流程。对于 CI、无头环境或脚本化设置,请在控制面板中创建 API 密钥并设置 NUTRIENT_DWS_API_KEY。
2. 配置 AI 客户端
选择你的平台并添加配置:
Claude Desktop
打开设置 → 开发者 → 编辑配置,然后添加:
macOS: ~/Library/Application Support/Claude/claude_desktop_config.json
Windows: %APPDATA%\Claude\claude_desktop_config.json
{
  "mcpServers": {
    "nutrient-dws": {
      "command": "npx",
      "args": ["-y", "@nutrient-sdk/dws-mcp-server"],
      "env": {
        "SANDBOX_PATH": "/your/sandbox/directory",
        // "C:\\your\\sandbox\\directory" for Windows
        // Optional for CI or headless usage:
        // "NUTRIENT_DWS_API_KEY": "YOUR_API_KEY_HERE"
      },
    },
  },
}
Cursor
在项目根目录中创建 .cursor/mcp.json:
{
  "mcpServers": {
    "nutrient-dws": {
      "command": "npx",
      "args": ["-y", "@nutrient-sdk/dws-mcp-server"],
      "env": {
        "SANDBOX_PATH": "/your/project/documents",
        // "C:\\your\\project\\documents" for Windows
        // Optional for CI or headless usage:
        // "NUTRIENT_DWS_API_KEY": "YOUR_API_KEY_HERE"
      },
    },
  },
}
Windsurf
添加到 ~/.codeium/windsurf/mcp_config.json:
{
  "mcpServers": {
    "nutrient-dws": {
      "command": "npx",
      "args": ["-y", "@nutrient-sdk/dws-mcp-server"],
      "env": {
        "SANDBOX_PATH": "/your/sandbox/directory",
        // "C:\\your\\sandbox\\directory" for Windows
        // Optional for CI or headless usage:
        // "NUTRIENT_DWS_API_KEY": "YOUR_API_KEY_HERE"
      },
    },
  },
}
VS Code (GitHub Copilot)
在项目中创建 .vscode/mcp.json,或将相同的服务器定义添加到用户的 mcp.json 配置文件中:
{
  "servers": {
    "nutrient-dws": {
      "type": "stdio",
      "command": "npx",
      "args": ["-y", "@nutrient-sdk/dws-mcp-server"],
      "env": {
        "SANDBOX_PATH": "${workspaceFolder}",
        // Optional for CI or headless usage:
        // "NUTRIENT_DWS_API_KEY": "YOUR_API_KEY_HERE"
      },
    },
  },
}
其他 MCP 客户端
任何兼容 MCP 的客户端都可以使用 stdio 传输连接:
SANDBOX_PATH=/your/path npx @nutrient-sdk/dws-mcp-server

# Optional for CI or headless usage:
NUTRIENT_DWS_API_KEY=your_key SANDBOX_PATH=/your/path npx @nutrient-sdk/dws-mcp-server
3. 重启 AI 客户端
重启应用以加载新的 MCP 服务配置。
4. 开始处理文档
将文档放入沙盒目录,并在提示词中使用明确的文件名或路径。明确的路径比含糊的文件浏览请求更安全、更可靠。
可用工具
| 工具 | 描述 |
|---|---|
document_processor | 文档处理工具,支持格式转换、OCR、加水印、旋转、扁平化注释和涂黑工作流 |
parse_document | 结构化数据提取(DWS Data Extraction API):提取带边界框和置信度的类型化 JSON 元素,或整个文档的 Markdown |
extract_fields | 基于架构的字段提取(DWS Data Extraction API):将指定字段提取为你定义的 JSON 结构,并为每个字段提供引文 |
document_signer | 使用 CMS / PKCS#7 和 CAdES 签名签署 PDF,并支持可见或不可见的外观选项 |
ai_redactor | AI 涂黑工具,可检测并永久删除姓名、地址、SSN、电子邮件等敏感内容,以及符合自定义条件的内容 |
check_credits | 只读帐户查询,用于查看当前 DWS 额度和用量。不会上传文档内容 |
sandbox_file_tree | 只读查看已配置沙盒目录中的文件 |
directory_tree | 沙盒模式禁用时只读查看本地文件。强烈建议使用沙盒模式 |
提示词
sign_and_watermark— 为文档添加文本水印,然后对带水印的 PDF 进行数字签名。extract_document_fields— 将命名字段提取到 JSON 对象中,并可选择在文件中保留引文。redact_pii— 检测文档中的个人身份信息并永久涂黑。parse_for_rag— 将文档解析为 Markdown,以用于检索增强生成和搜索索引。office_to_pdfa— 将 Office 文档转换为归档用的 PDF/A 文件。
文档处理器功能
| 功能 | 描述 |
|---|---|
| 文档创建 | 将 PDF、Office 文档(DOCX、XLSX、PPTX)和图像合并为单个文档 |
| 格式转换 | PDF ↔ DOCX、图像(PNG、JPEG、WebP)、PDF/A、PDF/UA、HTML、Markdown |
| 编辑 | 添加水印(文本/图像)、旋转页面、扁平化批注 |
| 安全 | 涂黑敏感数据(SSN、信用卡号、电子邮件等)、密码保护、权限控制 |
| 数据提取 | 现已作为专用工具提供 — 请参阅数据提取(parse_document),了解如何提取带坐标和置信度的类型化 JSON/Markdown |
| OCR | 对扫描文档进行多语言光学字符识别 |
| 优化 | 压缩 PDF 并进行线性化,不损失质量 |
| 批注 | 导入 XFDF 批注、扁平化批注 |
| 数字签名 | 符合 PAdES 标准的 CMS 和 CAdES 数字签名(通过 document_signer 工具) |
数据提取
parse_document 和 extract_fields 工具封装了 DWS Data Extraction API,并通过以下方式进行身份验证:
- OAuth(未设置
NUTRIENT_DWS_API_KEY):所有其他工具使用的同一浏览器流程令牌也适用于数据提取。无需额外配置。 - 静态 API 密钥:数据提取是一个独立产品,使用自己的租户,因此无法重复使用
NUTRIENT_DWS_API_KEY中的 Processor 密钥。请将NUTRIENT_DWS_EXTRACTION_API_KEY设置为从控制面板获取的数据提取密钥。若未设置,parse_document和extract_fields会返回错误,而不会调用 API。
parse_document 支持以下四种处理模式之一:
| 模式 | 输出 | OCR | 每页费用 |
|---|---|---|---|
text | 仅 Markdown | 否 | 1 个额度 |
structure | 空间结构或 Markdown | 是 | 1.5 个额度 |
understand(默认) | 空间结构或 Markdown | 是(AI 增强) | 9 个额度 |
agentic | 空间结构或 Markdown | 是(VLM) | 18 个额度 |
- 空间结构输出会返回带有边界框、置信度分数和阅读顺序的类型化元素(段落、表格、键值区域、公式、图片、手写内容)。由于元素列表可能很大,它会写入
outputPath,工具则返回不含内容的摘要(元素计数、低置信度标记、页面几何信息)。 - Markdown输出会以内联形式返回整个文档的 Markdown;也可在提供
outputPath时将其写入该路径(建议用于大型文档)——适用于 RAG 和搜索索引。 - 同时获取两种格式:传入
formats: ["spatial", "markdown"]而不是format,即可在一次调用中获得output.elements和output.markdown。第二种格式不额外计费。必须提供outputPath(与仅使用空间结构输出时相同);摘要还会报告 Markdown 的字节长度。
文档可通过 filePath(从本地文件系统或沙盒上传)或 url(由 API 直接获取)提供——必须且只能提供其中一项。
其他选项:
language—structure/understand/agentic模式的 OCR 语言;若不设置,API 会自动检测。maxLanguages/maxScripts用于限制自动检测考虑的语言/文字数量,且仅在未设置language时生效。- 仅适用于 Markdown 的格式选项:
useHtmlTables(默认true)、enableSemanticBlockFormatting(默认true)、includeHeadersAndFooters(默认false)、extractWordsFromPictures(默认false)。 - 每个响应都会报告数据提取额度用量。这与
check_credits报告的 Processor API 额度余额分开计算。
**注意:**以内联形式返回的提取内容(Markdown 输出或
extract_fields结果)会进入对话,并可能由宿主记录。对于敏感文档,建议将空间结构输出到文件,并使用有针对性的extract_fields调用。
Schema-Guided Extraction (extract_fields)
parse_document 会将整个文档解析为元素或 Markdown,而 extract_fields 只提取你指定的字段。传入一个 JSON schema(schema),其根节点为 type: "object",并包含 properties — 响应中的 output.data 会与该结构相匹配,例如 { invoiceNumber, total, lineItems: [...] }。
- 支持的 schema 关键字:
type、properties、required、items、description、字符串enum,以及format: "date"。不支持$ref/$defs和组合/条件关键字(allOf/anyOf/oneOf/if/then/else)。Schema 是封闭的 — 不要自行设置additionalProperties。限制:序列化后不超过 32 KB、最多 500 个字段、每个对象最多 50 个属性、最多 5 层嵌套,枚举值最多 50 个。 mode决定用于提取的解析方式:structure(每页 1.5 个积分)、understand(默认值,每页 9 个积分)或agentic(每页 18 个积分)— 不支持text模式,因为 schema 引导的提取需要结构解析,而text模式会跳过这一步。每页总费用为解析部分加上固定的提取部分,以 Data Extraction 积分计。output.data始终以内联、格式化后的形式返回 — 它就是答案,且受你自己的 schema 限定。此外还会提供引用匹配摘要,报告每个字段的依据情况(id_match、id_match_multiblock、id_match_partial、fuzzy_match、not_found),并列出返回结果为not_found的字段路径(最多列出 10 个,之后显示“+N more”)。字段路径来自你的 schema,而非文档,因此不会泄露文档内容。- 只有设置了
outputPath时,才会保留每个字段的引用信息(边界框、置信度、匹配质量)和页面几何信息 — 这些信息可能很大,而且若不同时打开文档,用处不大。不设置outputPath时,会有说明提示这些信息已省略。 - 只有显式设置时,才会传入
includeCitations(服务端默认值为true)、strict(默认值为false)和multimodal(默认值为false,会增加费用和延迟)。 instructions(自由文本,最多 10000 个字符)可为含义模糊的字段提供指导。language/maxLanguages/maxScripts的 OCR 调整方式与parse_document相同。
使用示例
以下示例假设文件位于已配置的沙盒中,并且你使用显式路径。
示例 1:HTML -> PDF -> 签名
用户提示词: Convert /path/to/sandbox/invoice.html to PDF and save it as /path/to/sandbox/invoice.pdf. Then digitally sign /path/to/sandbox/invoice.pdf with a visible signature and save it as /path/to/sandbox/invoice-signed.pdf.
执行过程: 服务端将 HTML 文件上传到 Nutrient,在沙盒中保存生成的 PDF,然后为该 PDF 签名,并将签名后的结果写入指定的输出路径。
示例 2:OCR 提取
用户提示词: Run OCR on /path/to/sandbox/scanned-contract.pdf, return the extracted text, and save the OCR'd file as /path/to/sandbox/scanned-contract-ocr.pdf.
执行过程: 服务端将扫描版 PDF 发送给 Nutrient 进行 OCR,在 Claude 中返回提取的文本,并将经过 OCR 处理的文件写回沙盒,以供后续使用。
示例 3:检查积分 -> 处理 -> 查看输出
用户提示词: Check my Nutrient credits, convert /path/to/sandbox/report.docx to PDF, save it as /path/to/sandbox/report.pdf, and then tell me where the output file was written.
执行过程: 服务端首先执行只读账户查询,然后将 DOCX 文件转换为 PDF,并将结果保存在沙盒中,同时准确告知用户输出文件的写入位置。
示例 4:借助架构提取字段并附上引文
用户提示词: 从 /path/to/sandbox/invoice-0341.pdf 中提取 vendor_name、invoice_number、total_amount 和 due_date,并将引文保存到文件旁边。
执行过程: Agent 使用小型 JSON 架构({ "type": "object", "properties": { "vendor_name": {"type": "string"}, "invoice_number": {"type": "string"}, "total_amount": {"type": "string"}, "due_date": {"type": "string"} } })和 outputPath 调用 extract_fields。服务会将 PDF 发送到 Data Extraction API,以 JSON 格式直接返回这四个值以及引文匹配摘要,并将每个字段的完整引文(页码、边界框、置信度)写入输出文件,以供审计。
与 AI Agent 框架配合使用
此 MCP 服务适用于任何支持 Model Context Protocol 的平台:
- Claude Desktop — 直接集成 MCP
- Cursor — 支持 MCP 的 AI IDE
- Windsurf — 支持 MCP 的 AI IDE
- VS Code + Copilot — GitHub Copilot MCP 集成
- LangChain / LangGraph — 通过 MCP 工具适配器
- OpenAI Agents SDK — 通过 MCP 服务集成
- 自定义 Agent — 任何兼容 MCP 的系统
为什么选择 Nutrient?
读写鸿沟
AI 可以读取并理解文档,但大多数工具到此为止。Nutrient 让 AI Agent 能够真正操作文档:合并、涂黑、签名、添加水印、转换格式、提取结构化数据等。
- 不止于 PDF 阅读 — 不仅是文本提取,还能全面创建、编辑和转换文档。
- 适用于生产环境 — 数千家公司信赖它处理关键任务的文档。
- 符合标准 — 支持 PAdES 数字签名、PDF/A 归档和 PDF/UA 无障碍访问。
- 云原生 — 无需管理基础设施。将文档发送到 API,即可获取结果。
- 全面涂黑 — 内置 SSN、信用卡、电话号码、电子邮件、日期等预设。
- 支持多种格式 — 处理 PDF、Office 文档、图像、HTML 和 Markdown。
配置
沙盒模式(推荐)
服务支持沙盒模式,可将文件操作限制在特定目录中。设置 SANDBOX_PATH 环境变量即可启用:
export SANDBOX_PATH=/path/to/sandbox/directory
npx @nutrient-sdk/dws-mcp-server
支持的 CLI 标志为 --sandbox <dir> 和 -s <dir>。无法识别的标志会导致启动错误。
启用沙盒模式后:
- 相对路径相对于沙盒目录解析
- 所有输入文件路径都会经过验证,以确保文件位于沙盒内
- 处理后的文件会保存在沙盒内
注意: 如果未指定沙盒目录,服务将不受文件路径限制。强烈建议启用沙盒模式以确保安全。
输出位置
处理后的文件会保存到由 AI 决定的位置。若要指定输出位置,请使用明确的输出路径,例如 save the result to /path/to/sandbox/output/result.pdf,或在沙盒中创建 output 目录。
身份验证
服务器通过以下任一方式向 Nutrient DWS API(https://api.nutrient.io)进行身份验证:
| 方式 | 适用情况 | 配置 |
|---|---|---|
| API 密钥 | 已设置 NUTRIENT_DWS_API_KEY | 将静态密钥作为 Bearer 令牌传递给 DWS API |
| OAuth 浏览器流程 | 未设置 API 密钥 | 首次发出使用 Nutrient API 的请求时,打开浏览器以进行 Nutrient OAuth 授权,并在本地缓存令牌 |
未配置 API 密钥时,服务器会保持连接,并在首次发出使用 Nutrient API 的请求时打开基于浏览器的 OAuth 流程(类似于 gh auth login)。令牌会缓存在 $XDG_CONFIG_HOME/nutrient/credentials.json 或 ~/.config/nutrient/credentials.json,并自动刷新。
数据提取(parse_document、extract_fields)是一个独立产品,拥有自己的租户。 使用 OAuth 时,一个令牌即可用于这两个产品,无需额外配置。使用静态 API 密钥时,NUTRIENT_DWS_API_KEY 中的 Processor 密钥不能用于数据提取;请将 NUTRIENT_DWS_EXTRACTION_API_KEY 设置为从仪表板获取的数据提取密钥,或者完全省略 NUTRIENT_DWS_API_KEY,改用 OAuth。
仅设置 NUTRIENT_DWS_EXTRACTION_API_KEY(未设置 NUTRIENT_DWS_API_KEY)时,服务器会以仅数据提取模式运行:parse_document 和 extract_fields 可正常工作,而 Processor 工具(document_processor、document_signer、ai_redactor、check_credits)会返回错误,而不会调用 API。
环境变量
| 变量 | 必填 | 说明 |
|---|---|---|
NUTRIENT_DWS_API_KEY | 否* | Nutrient DWS API 密钥(免费获取) |
NUTRIENT_DWS_EXTRACTION_API_KEY | 仅使用静态密钥时† | 来自控制面板的数据提取 API 密钥(以 pdf_live_ 开头),parse_document / extract_fields 需要此密钥 |
SANDBOX_PATH | 建议设置 | 用于限制文件操作范围的目录 |
AUTH_SERVER_URL | 否 | OAuth 服务基础 URL(默认值:https://api.nutrient.io) |
CLIENT_ID | 否 | OAuth 客户端 ID。设置后会跳过 DCR,并启用刷新令牌复用 |
DWS_API_BASE_URL | 否 | DWS API 基础 URL(默认值:https://api.nutrient.io) |
LOG_LEVEL | 否 | Winston 日志记录器级别(默认值为 info)。在 stdio 模式下,日志会写入 MCP_LOG_FILE |
MCP_LOG_FILE | 否 | 覆盖日志文件路径(默认值为系统临时目录) |
* 如果省略,服务会使用 OAuth 浏览器流程对 Nutrient API 进行身份验证。
† 仅在设置了 NUTRIENT_DWS_API_KEY 时适用:数据提取是单独的产品/租户,因此 Processor 密钥也无法用于对其进行身份验证。OAuth 下无需此密钥,一个令牌即可用于这两种产品。
数据处理
保留在本地的内容
- MCP 服务进程、沙盒执行和文件路径解析都在本地机器上运行。
sandbox_file_tree和directory_tree仅检查本地文件,不会将文档内容上传到 Nutrient。- API 密钥和 OAuth 凭据存储在运行 MCP 服务的本地机器上。
发送到 Nutrient 的内容
document_processor、document_signer和ai_redactor会将文档文件和处理指令上传到 Nutrient DWS API,以执行所请求的操作。check_credits会发送经过身份验证的账户查询,但不会上传文档文件。- 处理结果会写入你指定的本地输出路径。
安全说明:令牌存储
使用 OAuth 浏览器流程时,访问令牌和刷新令牌会以明文形式缓存于 $XDG_CONFIG_HOME/nutrient/credentials.json 或 ~/.config/nutrient/credentials.json(权限为 0600)。此文件包含与 API 密钥等效的凭据。请勿将其提交到版本控制中,也不要将其包含在共享备份中。
隐私政策
此扩展会从本地沙盒读取文件;在你调用文档工具时,会将文档内容和处理指令发送给 Nutrient;并会在运行 MCP 服务的本地机器上存储 API 密钥或 OAuth 凭据。
Nutrient 的隐私政策请参阅 nutrient.io/legal/privacy。
支持
如需产品或账户支持,请联系 Nutrient:nutrient.io/company/contact。
如需报告此 MCP 软件包特有的错误或功能请求,请使用 GitHub issues。
故障排除
将身份验证重置为初始状态
如果 OAuth 身份验证停止工作,请删除缓存的令牌文件以重新开始:
rm "${XDG_CONFIG_HOME:-$HOME/.config}/nutrient/credentials.json"
下次调用工具时,服务会自动注册新的客户端并打开浏览器以征求授权。
常见问题
Claude Desktop 中未显示服务?
- 确保已安装 Node.js 18+(
node --version) - 检查配置文件路径是否与您的操作系统相符
- 完全重启 Claude Desktop(检查任务管理器/活动监视器)
OAuth 登录时浏览器未打开?
- 这会发生在无头或远程环境中(SSH、Docker、CI)。请改为设置
NUTRIENT_DWS_API_KEY——配置 API 密钥后,服务会跳过浏览器验证流程。 - 在 macOS 上,请确保已在“系统设置”→“桌面与程序坞”→“默认网页浏览器”中设置默认浏览器。
升级后被要求重新登录?
- 为支持数据提取(
parse_document、extract_fields),服务现在会请求范围更广的 OAuth 权限,以便单个令牌同时用于 Processor 和 Data Extraction 产品。旧版本缓存的令牌不包含这些权限范围,因此下次调用工具时,服务会再次请求授权。这是预期行为,且只会发生一次——新令牌会按常规缓存和刷新。 - 在无法打开浏览器进行这次一次性授权的无头或 CI 环境中,请设置
NUTRIENT_DWS_API_KEY(若要使用 Data Extraction,还需设置NUTRIENT_DWS_EXTRACTION_API_KEY),以跳过 OAuth 流程。
出现“令牌交换失败”或“OAuth 授权失败”?
- 删除
${XDG_CONFIG_HOME:-$HOME/.config}/nutrient/credentials.json,然后重试。 - 如果使用自定义
AUTH_SERVER_URL,请确认服务可访问,且其/oauth/token端点正常工作。
出现“动态客户端注册失败”?
- 如果使用自定义
AUTH_SERVER_URL,请确认其可访问。 - 确保自定义身份验证服务在其
/oauth/register端点支持 RFC 7591 动态客户端注册。
出现“API 密钥无效”错误?
- 在 dashboard.nutrient.io 验证您的 API 密钥
- 确保已在
env部分正确设置密钥(没有多余空格)
令牌已过期,但刷新失败?
- 服务会使用缓存的刷新令牌自动刷新过期令牌。如果刷新失败(例如刷新令牌已被撤销),请删除
${XDG_CONFIG_HOME:-$HOME/.config}/nutrient/credentials.json——服务会在下次调用时通过浏览器重新进行身份验证。
未找到文件?
- 检查
SANDBOX_PATH是否指向现有目录 - 确保文档位于沙盒目录中
- 请助手检查已配置的沙盒,或直接检查沙盒目录
参与贡献
请参阅 CONTRIBUTING.md 中的贡献指南。
许可证
MIT 许可证——详情请参阅 LICENSE。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。