关于 crbro-memory
crbro-memory 是本地 MCP 服务,为 AI 助手提供跨会话的持久可搜索记忆。它按项目组织事实,并支持修正、过期管理和显式证据记录。
主要功能
- 01跨会话本地持久记忆
- 02事实级搜索与语义召回
- 03项目范围记忆与别名
- 04修正、退役或删除条目
- 05过期、证据与陈旧提示
- 06备份与凭据脱敏
适用场景
- 01在后续会话中回忆项目决策
- 02从大量记忆中查找具体事实
- 03修正过时信息并保留历史
- 04避免敏感凭据进入存储记忆
MCP 相关
向 MCP 客户端提供学习、召回、检查、修订和遗忘记忆的工具。工具定义包含读写及破坏性操作的注解。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
15收录的工具列表 · 更新于 1 周前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| project | string | 否 | 此会话所处理的文件夹或仓库:路径("C:/code/crbro-memory")、仓库名称或远程地址("owner/repo");仅最后一段有效。名称、系统映射或事实关键词中包含该名称的神经元会优先显示在 hot_topics 中,并列在 project_neurons 中(最多 5 个)。省略此参数时,启动结果与不传入它时完全相同。 |
详细介绍
🧠 CRBRO — AI 的持久神经记忆






CRBRO 是一款本地 MCP(Model Context Protocol)服务,可让你的 AI 助手在不同会话之间持久保留长期记忆。它采用生物神经架构——皮层、突触、海马体——自动存储、关联和检索知识。
免费开源(MIT)。包含全部 15 个工具——无需许可证、账户或分级套餐。
⭐ 如果 CRBRO 为你的 AI 带来了值得留存的记忆,在 GitHub 上点个星就是对它最好的支持。
☕ 如果它为你节省了时间,请请我喝杯咖啡。
也可以使用 USDC。请仅发送 USDC,并且仅使用所示网络;若使用其他网络,资金将无法找回。
| 网络 | USDC 地址 |
|---|---|
| Solana | 5n6Gfosk7SdwbvdtE9xiLWpcGPBBBGDZYRfAkWyCk86g |
| Ethereum(ERC-20) | 0xe176866f9d7fdb498e0d4a983d3e34d84dcd6bfc |
功能
- 🧭 项目连续性(2.10+) — 完整路径/仓库身份和显式别名会将神经元绑定到项目。每个 MCP 连接都有各自的当前项目,并可设置项目范围内的待办事项、可选截止日期和完成标准。
crbro_recall scope=all仍可查找其他项目。范围用于组织,并非访问控制边界。示例和兼容性。 - 🩺 只读诊断(2.10+) —
npx crbro-memory doctor --json会报告检测到的版本、大脑/客户端路径、上次启动时间、语义文件、备份和本地 Git 状态。它不会修复问题、读取凭据值、安装任何内容或执行拉取/推送。未知即表示未知;参见 doctor。 - 🧬 生物学架构 — 知识以神经元(皮层)、连接(突触)和会话记忆(海马体)的形式组织
- 🔍 事实级搜索 — 由 Orama 提供支持。每条事实单独编入索引,因此包含数百条事实的主题和只有三条事实的主题一样容易查找。每条结果都会返回确切的匹配行、记录时间、
confidence标签(weak= 问题只有很少一部分得到覆盖),以及排名靠前结果所在主题中接下来最相关的几行。简短的双语同义词表可以扩展问题的覆盖范围,而不会凭空编造术语 (v1.13+) - 🎯 读取条目,而不是神经元 —
crbro_inspect view=neuron会返回索引:以 ID、类型、日期和预览的形式列出每条事实、决策、模式、偏好、错误、债务和地图。entries=[ids]只读取指定条目;每条召回结果都带有自己的entry_id。完整读取整个神经元的功能仍然存在,即detail=full,但有明确的上限。一个包含 307 条事实的神经元,打开所需的令牌数从 66,952 降到了 1,887 (v2.1+) - 📓 日记可搜索 — 每个会话摘要都会按段落编入索引。
crbro_recall会将提及问题的日期列在专属的sessions_matched列表中,因此叙述内容不会排在事实之前;crbro_inspect view=sessions session=<id>可读取某一天的完整内容。仅使用词法搜索,升级时重建一次 (v2.2+) - 🗣️ 模型参与其中 — 有两种嵌入模型无法替代的手段,并经过盲测:保存时写入关键词(调用方知道同义词:一条关于 Hetzner 的记录会得到 hosting、alojamiento、servidor),以及同时搜索多种措辞并按排名融合结果。零磁盘占用,零内存占用;测量数据见下表 (v1.15+)
- 🧭 语义召回 —
npx crbro-memory init会安装本地嵌入模型(multilingual-e5-small,int8),并将其与关键词引擎融合,让原先无法通过字面匹配的改述也能被找到。它在大型知识库中最重要:在测试集周围加入 1,482 条无关事实后,原始测试的 recall@1 从 54% 提升至 67%,新的 96 题测试则从 31% 提升至 48%;在小型知识库中,测量结果与关键词引擎相差不超过 2 个百分点(2.7.2 上为 75% 对 77%)。每台机器只需一次约 500 MB 磁盘空间,服务运行时占用约 0.5 GB 内存;init --no-semantic可跳过安装,CRBRO_SEMANTIC=0可将其关闭 (v1.14+,从 v1.16 起默认安装) - 🔥 热度评分 — 根据频率、时效性和连接度自动跟踪相关性。同一会话中写入的主题会在整合时建立连接,因此图谱会自动填充 (v1.13+)
- 🕰️ 有意义的日期 — 时效性提升幅度最多为 4%,用于在平局时偏向较新的记录(测量结果:它只会打破完全相同的平局);
crbro_recall since/kind可将搜索范围缩小到“最近两周”或“仅过去的错误”;crbro_maintenance backfill_dates则会根据条目正文中明确写出的日期,为 1.13 之前的条目补上日期——绝不猜测 (v2.5+) - ⏳ 有效期与明确证据 — 事实有
volatile(90 天)、normal(365 天)、durable(730 天)或permanent有效期,可通过CRBRO_SHELF_DAYS配置;过期的声明会移至possibly_stale,并附带来源核查警告。从 2.10 起,重复一条事实不会验证它:只有crbro_revise status=verified才会重新开始核查。可选的evidence字段会记录带有参考资料的source,或user;较早的显式调用仍标记为unspecified,旧日期不会被提升为证据。参考资料只是数据,不会被执行。temporal用于区分当前声明与历史信息;intent=current用于区分历史匹配结果。相关性、来源、验证状态和时效性是不同的标签,并不保证事实为真。早期 Agent 基准测试显示,仅靠警告并不能可靠地促使 Agent 核查来源;这些历史测量结果仍见设计报告。 - 🧹 先报告再操作的维护功能 — 每次维护运行都会列出自身期限已过的条目、一次读取已装不下的神经元(可用
crbro_revise move_to拆分,同时保留所有日期),以及批量导入遗留下来的只有一行内容的神经元(compact:true会将它们折叠为摘要)。在收到指令前,所有操作都只读 (v2.5+) - 💽 自动备份 — 每天在整合时生成一份 gzip 压缩副本并进行轮换,备份保存在对应知识库旁边;
CRBRO_BACKUP_DIR可将备份指向已同步的文件夹。隔离区和机器令牌绝不会被带走 (v2.5+) - ✏️ 可更正 — 知识可以被取代或撤回,而不只是不断累积;适用对象包括事实,以及从 2.0 起的决策、模式、错误和债务。只会追加内容的记忆,会继续以今天的信心提供昨天的答案。已退役的内容仍保留在文件中,也可以恢复(
status=active);必须从磁盘上删除的内容则通过crbro_forget处理,且会先复制到隔离区 - 🔐 凭据感知 — API 密钥、令牌和密码在写入磁盘前会替换为标记。周围的句子会保留,秘密不会;
crbro_secret会将真实值存入操作系统自带的密钥链,因此拒绝该操作也不会让你无处存放这些信息 - 🏠 一个进程供所有客户端使用(可选启用) — 执行
npx crbro-memory daemon on后,连接到同一知识库的客户端不再各自加载一份副本:客户端启动后会成为一个 55 MB 的代理,由单个守护进程持有索引和模型。使用三个客户端测得:内存占用从 2,153 MB 降至 1,140 MB,第二个客户端的就绪时间从 1.8 秒缩短到 0.3 秒,而且在一个聊天中保存的记录可以立即在另一个聊天中召回。如果无法连接守护进程,或守护进程在调用过程中退出,客户端会自行提供服务并继续运行——这可能影响速度,但不会影响记忆 (v2.5+) - 👥 双编辑器安全并用 — 写入操作会按神经元串行处理,因此同时在两个 IDE 中运行 CRBRO 不会悄无声息地丢失事实
- 🤝 可按项目共享 — 只有明确共享的神经元才会同步到你配置的 Git 远程仓库。推送失败的内容会保留为未发送状态;离开空间时会保留本地恢复归档。即使未与团队共享,记忆工具返回的信息仍会到达你的 AI 客户端。
- 🗺️ 动态地图 — 每个主题都可以有一张始终保持最新的系统工作方式地图(
crbro_map),每次变更时都会整体替换;此外还有一张全局地图,展示主题簇和跨领域桥接关系 - 📓 错误记录簿 —
type: "error"会在错误发生的主题中,将每个真实错误及其更正一并存储,避免重复犯错。从 1.13 起会记录日期,因此召回时较新的更正优先 - ⚖️ 债务记录簿 —
type: "debt"会记录你有意没有构建的内容——包括限制条件和重新评估的触发条件——以免已经搁置的想法被反复提出 (v1.11+) - 🏷️ 诚实的工具定义 — 每个工具都带有 MCP 注解(
readOnlyHint、destructiveHint、idempotentHint、openWorldHint)、标题;读取工具还带有输出架构——让客户端在调用前知道哪些操作会读取、写入或造成破坏 (v1.13+) - 🧰 15 个工具,一个生命周期 — 每种读取操作都是
crbro_inspect的一种视图;crbro_learn、crbro_revise和crbro_forget是同一条规则的三个阶段(新事实取代旧事实,过时内容退役,有风险的内容删除);每个工具的描述都在首句说明它是读取还是写入,以及哪个相邻工具负责相关操作。在不触碰磁盘上知识库的前提下,工具数量从 1.x 的 23 个减少到 15 个;crbro_boot会将旧名称映射到新调用 (v2.0+) - 🔁 超越项目范围的经验教训 — 再次存储同一事实会增加计数(
confirmations,大于 1 时由crbro_inspect显示);crbro_consolidate会指出已存在于两个或更多项目神经元中的经验教训,并给出它们所属的tech_或process_神经元。它只会提出建议,绝不会移动任何内容 (v2.7+) - 🧷 精简而不丢失上下文(可选启用) —
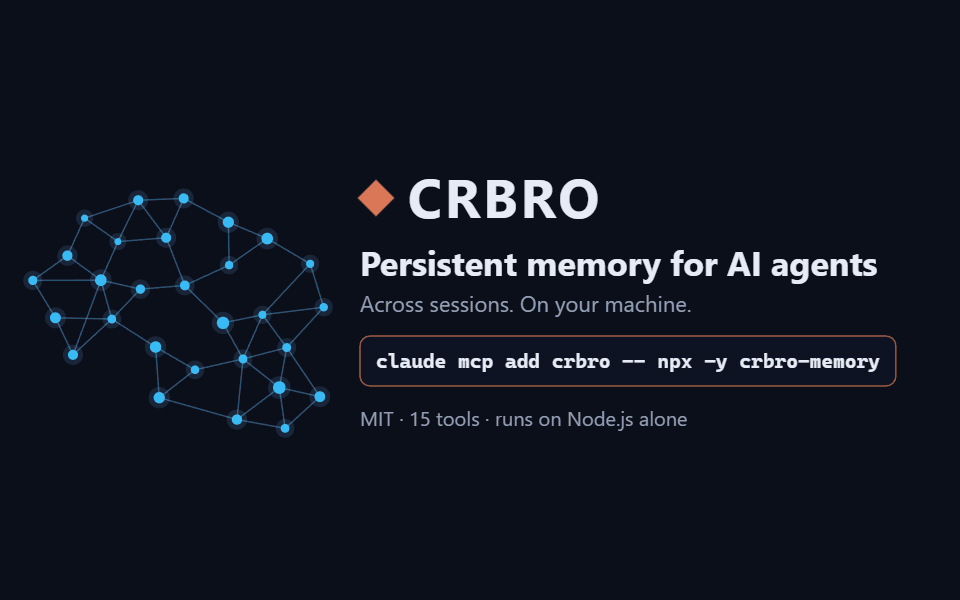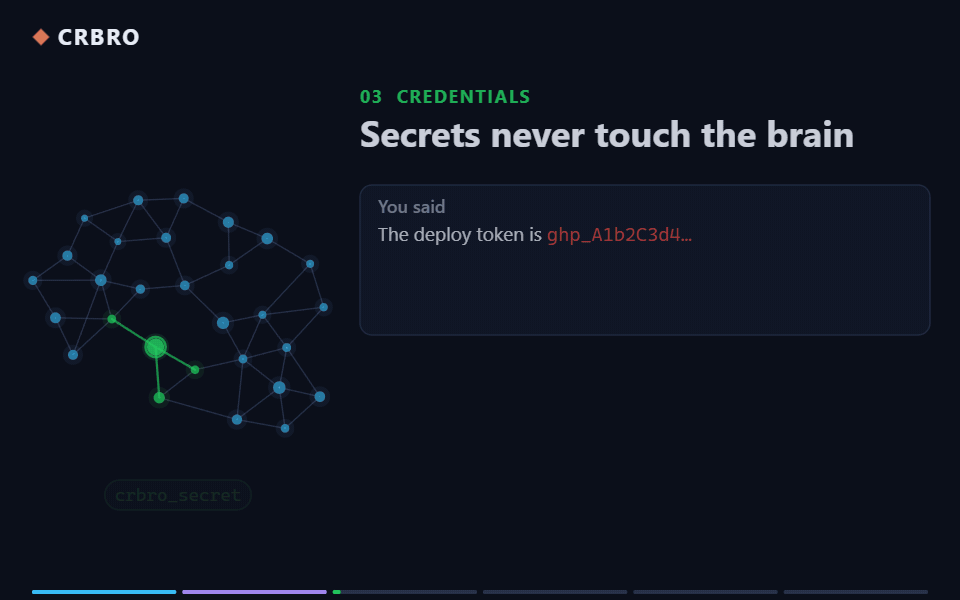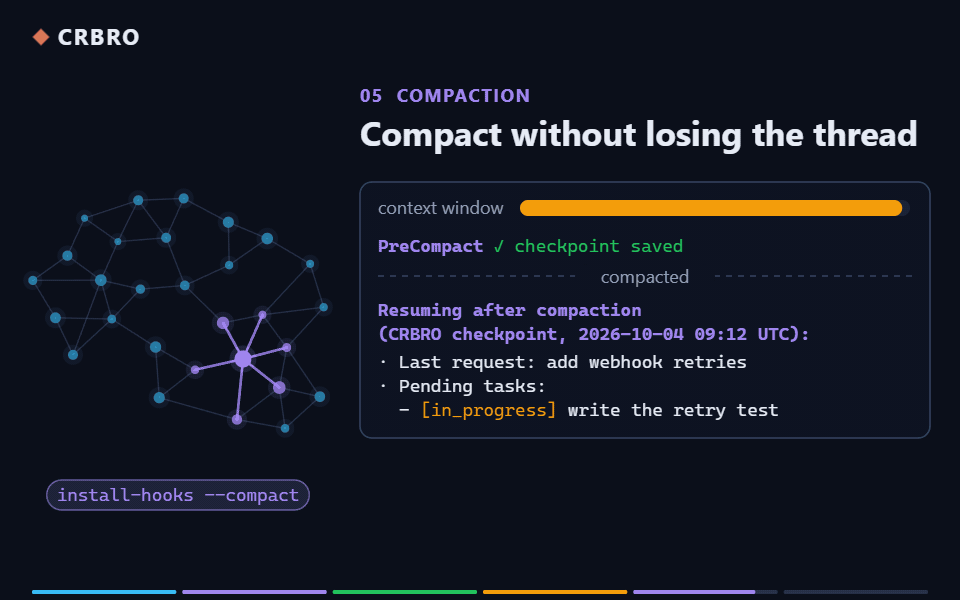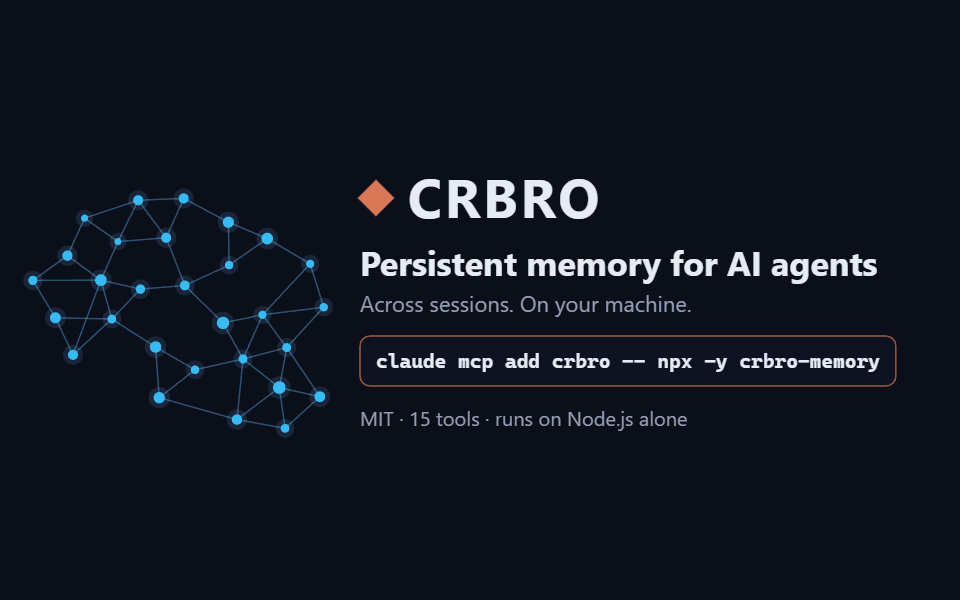
npx crbro-memory install-hooks --compact会在 Claude Code 会话压缩前保存经过脱敏的检查点,包括最近的请求、任务列表、待处理事项、文件夹和 Git 远程仓库;会话恢复时再交还给模型,最多 1,500 个字符。不调用模型 (v2.7+) - 📌 随时查看待处理事项(Claude Code 默认启用,可选择退出) — 在安装 Claude Code 的环境中,
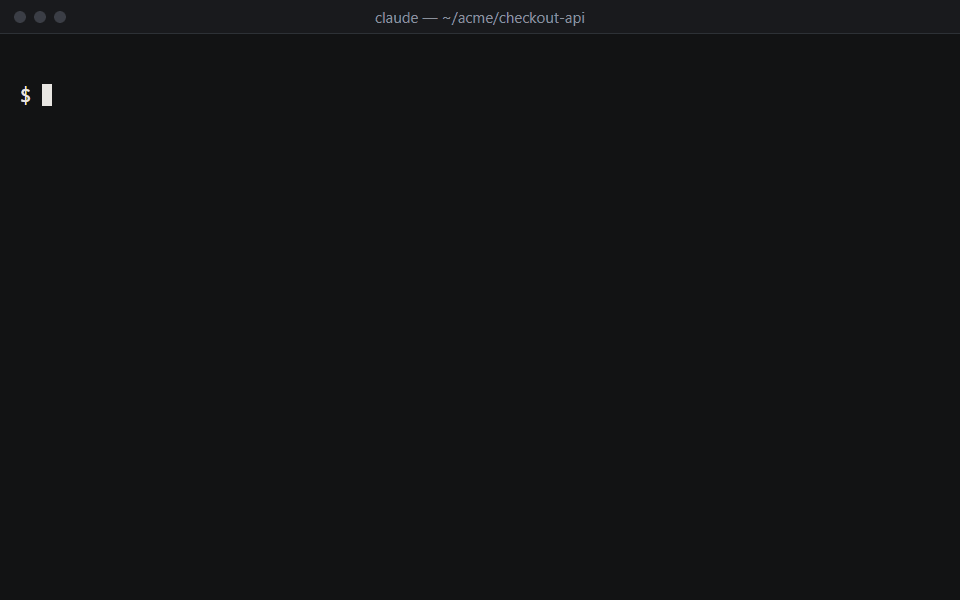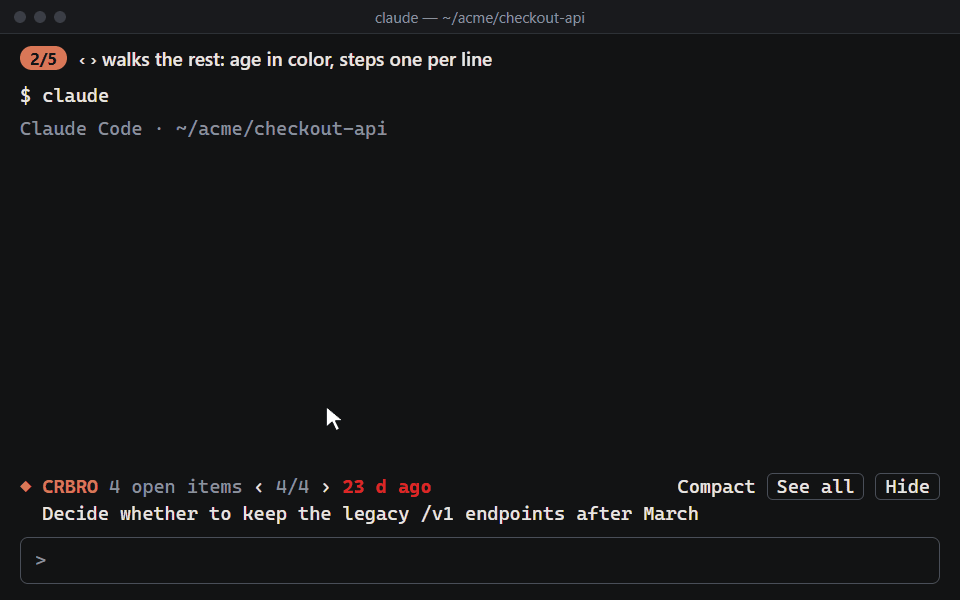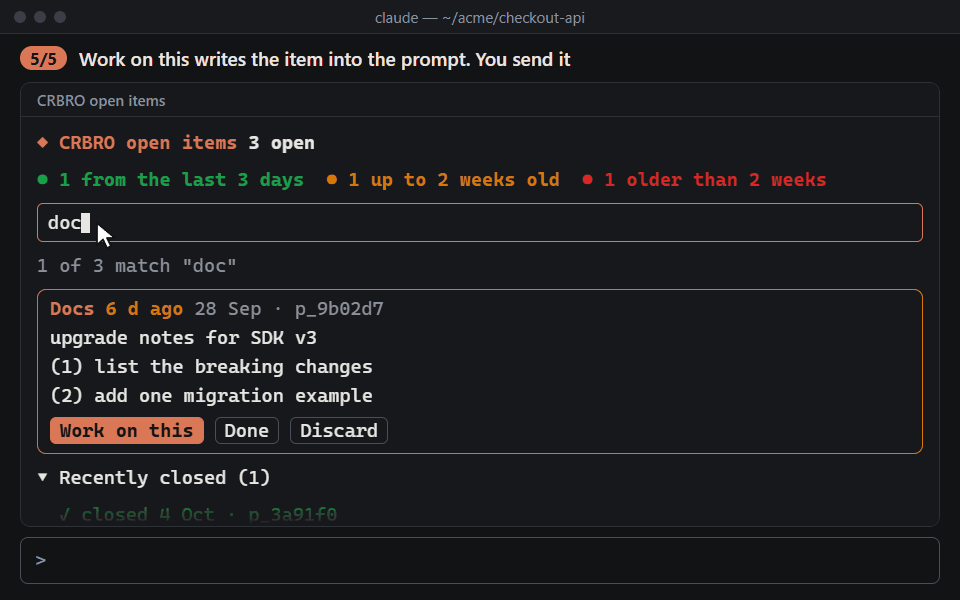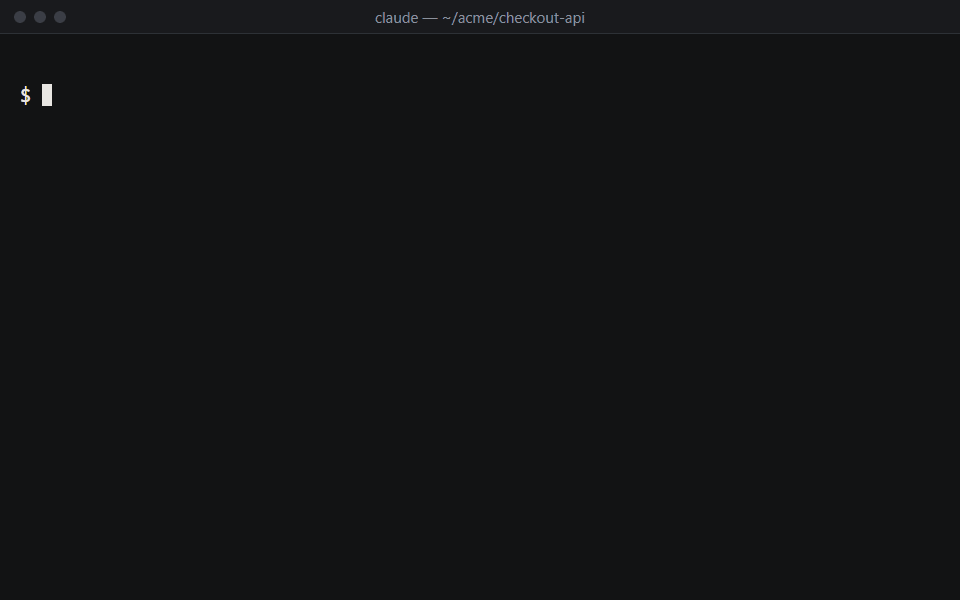
crbro_boot会自动添加 Claude Code 扩展并使其保持最新,同时让助手在完成安装时告知你一次:在提示词上方显示知识库中最新的待处理事项全文——标签独立显示,编号步骤逐行排列,时间长短用颜色表示——并提供/pending(别名/pendientes),以卡片形式展示所有待处理事项:筛选、开始处理、完成和丢弃(需确认),以及最近关闭的事项。它通过crbro_context读取并关闭事项;只有在无法连接服务时才直接读取知识库文件。支持英语或西班牙语(--lang)。需要 Claude Code 2.1.286 或更高版本:命令行界面以及桌面应用的 Code 选项卡。使用npx crbro-memory uninstall-mod可移除该扩展——无论运行 CRBRO 的是哪款应用,它都不会自动重新安装;也可以在某个 MCP 客户端的环境变量中设置CRBRO_MOD=0,避免该客户端安装扩展 (v2.8+) - 🔎 回顾会话(只读) —
crbro usage会按会话统计各模型使用的令牌数,并单独列出子 Agent;crbro postmortem会列出候选经验教训——需要反复重申的更正、连续失败的工具、再次提出的相同请求——但不会存储任何内容。两者都只读取 Claude Code 保存在本地磁盘上的日志 (v2.7+) - ⏱️ 在执行操作时调用记忆(可选启用) —
npx crbro-memory install-hooks --guard会配置 Claude Code 的PreToolUse钩子:在 shell 命令运行前,将提及该命令的已存储错误、债务和模式添加到模型上下文中——最多三条,每个会话仅一次,绝不阻止操作。只有在有人询问时,召回才会回答;但没人会在执行firebase deploy前一秒去问 - 🛡️ 子 Agent 钩子(可选启用) —
npx crbro-memory install-hooks --inject会配置一个 Claude Code 钩子,将行为规范传递给生成的子 Agent。从 1.12 起,注入功能默认关闭:三次无偏对照基准测试均未发现任何模型有可测得的收益,小型模型却受到实际损害;本项目不会将未经测量的行为设为默认选项 - ⛏️ 知识挖掘器 — 可选扫描本地
.md/.txt笔记,并将其导入知识库 - 🔒 本地存储,明确的数据流向 — 服务和可选的嵌入模型都在本地运行,不需要托管的 CRBRO 账户,也不进行遥测。MCP 工具结果会发送到你的 AI 客户端,并可能传给其模型提供商;团队同步和同步备份文件夹则使用你选择的目标位置。密钥链与常规记忆备份和发行包相互独立,但通过 MCP 读取秘密仍会将其返回给该客户端。请参阅安全性。
- 💾 基于文件 — 所有数据都以易读的 JSON 文件形式存储在
~/.crbro/中,可检查、比较差异,并使用 git 进行版本管理 - 🔌 原生支持 MCP — 适用于 Claude Desktop、Claude Code、Cursor、Windsurf,以及任何兼容 MCP 的客户端
有实测,不空谈
下面的每个数字都来自 benchmarks/ 中的基准测试,你可以在自己的机器上通过 node benchmarks/<name>/run.mjs 重现。所有测试结果都是确定性的,并会在 CI 中运行,不调用 API;例外是 Agentic 测试,它会让一个真正的 Claude Code Agent 执行任务,并消耗令牌。我们特意公开了那些不那么好看的结果。
简而言之,使用 2.7.2 在 2026-10-03 实测:新会话不会再次询问记忆中已有的信息——使用 CRBRO 时,真实 Agent 正确回答了 24 个答案只存在于记忆中的问题;不使用 CRBRO 时,24 个问题答对 0 个(haiku 和 sonnet,Claude Code 2.1.270,n=3)。按安装后的默认用法,盲测问题中有 75% 能在第 1 位找到正确事实,90% 能在主题的前三行内找到;再加上卡片中介绍的两种免费习惯,正确事实出现在第 1 位的比例升至 92%,出现在前几行内的比例升至 98%。另一场包含 96 个新问题、难度更高的测试中,第 1 位命中率为 57%;随着知识库增长,语义层的价值愈发明显:在 1,482 条无关事实中,它能找到 48% 的相关内容,而单靠关键词引擎时命中率降至 31%。语义层的表现自 2.5 版以来从 79% 降至 73%,原因是计算并列结果和向量的方式有两处改动,并非搜索错误。对抗性测试集中的凭据无一泄露,而一个会话完成所有这些操作仅花费约 1,000 个令牌。
| 内容 | 结果 | 实话实说 |
|---|---|---|
新会话不会再次询问(一个全新的 Claude Code 会话,没有历史记录,收到一个答案只存在于此前播种的记忆中的问题;提示词从未提及记忆;12 个冻结的虚构任务,运行前固定 4 项阈值;haiku 和 sonnet,Claude Code 2.1.270,n=3;测量日期:2026-10-03,node benchmarks/agentic/run.mjs) | 使用 CRBRO 时,对于只存在于记忆中的答案,24/24;给出 0 个已废弃值(被替换的值中 12/12 均未给出)——不使用 CRBRO 时为 0/24,而 sonnet 编造了 4 个 | 两组对照均符合预期:答案写在问题中时,两组都能答对(6/6);答案完全不存在时,CRBRO 和基础 Agent 一样经常拒绝作答(6/6,未编造任何内容)。在这 12 个相同任务的两次运行之间,服务端指令固定过两次——发布的结果是修正生效的那次,而非盲测结果——而且这些都是简短的单问题会话。该结果仅适用于这个模型和这个 Claude Code 版本;其他版本需要单独运行测试。预注册信息和每次运行记录见 benchmarks/agentic/ (v2.7.2) |
一个已改变、却无人标记废弃的值(stale-unmarked:四个虚构值——一个版本、一个价格、一个端口、一个职位上的人员——在记忆中仍存留了 200 天,而当前值位于工作目录中的文件内,两组都能读取;所有运行前均已预注册阈值;2.8.0 的 before 与保质期分支的 after 对比,haiku 和 sonnet,Claude Code 2.1.270,n=3;测量日期:2026-10-04) | 使用 CRBRO 时,两种模型在修改前和修改后答对的都是 0/12;未加警告就给出旧值的次数:haiku 从 11 降至 9 和 10,sonnet 从 12 降至 11 和 12(每种模型均进行了两次 after 运行)。不使用记忆时,Agent 会读取文件并答对 1-6/12 | 未达标——未提出预注册的主张。 保质期功能完成了它的工作(召回将全部四行标记为 possibly_stale,指出已有 200 天,并提示核实),但在 48 个 after 测试单元中,没有一个使用 CRBRO 的 Agent 打开文件:它们根据召回结果回答、拒绝作答,或有一次(sonnet)带着警告给出旧值。在这里,即使文件就在手边,记忆的表现仍然不如没有记忆。12 个原始任务在完整的 after 运行中仍通过全部四项阈值(24/24,已废弃值为 0,对照组 6/6)。这些任务中每个 CRBRO 测试单元的成本:haiku $0.0121 → ~$0.015,sonnet $0.0263 → ~$0.027。局限:没有任务中的旧值仍然正确,因此未测量错误警告;而且四段文本中有两段与检测器自己的示例相符。完整表格见 benchmarks/agentic/PREREGISTRO.md |
同一测试,第二次迭代(stale-unmarked-b:一个新的虚构项目,六个已改变的值——一个 SMS 服务提供商、一个价格、一个职位上的人员、一个 API 主机、一个时间、一个取消期限——在记忆中仍存留了 130-300 天,其中两个标记为易变、一个标记为普通、三个未标记;当前值位于两组都能读取的文件中;所有运行前均已预注册任务和阈值;2.8.0 的 before 与包含第二次迭代的分支 after 对比,每个模型运行一次,haiku 和 sonnet,Claude Code 2.1.270,n=3;测量日期:2026-10-04) | 使用 CRBRO 时,haiku 答对数为 0/18 → 1/18,sonnet 为 0/18 → 0/18;未加警告就给出旧值的次数:haiku 14 → 9,sonnet 18 → 12;带警告给出的次数:sonnet 0 → 6;拒绝作答次数:haiku 4 → 8。不使用记忆时,Agent 会读取文件,haiku 答对 6/18,sonnet 答对 9/18 | 未达标——未提出预注册的主张(两种模型的 U1、U2、U3 均未通过;U4 和 U5 通过)。召回仅标记了六行中的两行:其余四行未标记或标记为普通,且未满 365 天,因此作为当前值提供,前后没有任何变化(答案相同)。对于两行已标记的值,将旧值当作当前值给出的次数从 5 降至 0(haiku),从 6 降至 0(sonnet):haiku 拒绝作答,sonnet 带着警告给出答案。48 个测试单元中,使用 CRBRO 的 Agent 只有 1 个打开了文件。现在也测量了错误警告:当旧值仍然正确时,sonnet 仍会正确作答,但会加上“可能已过时”;haiku 则像 2.8.0 一样拒绝作答。12 个原始任务在相同运行中仍通过全部四项阈值。这些任务中每个 CRBRO 测试单元的成本:haiku $0.0114 → $0.0129,sonnet $0.0268 → $0.0272。六个任务由一位作者在一个项目中编写;产品变更的作者知道这些任务。完整表格见 benchmarks/agentic/PREREGISTRO.md |
实际安装后的检索效果(48 个盲测释义查询,由从未看过存储文本的人编写;自 1.16 起默认启用语义层;在 2.7.2 上于 2026-10-03 测量,CRBRO_SEMANTIC=1 node benchmarks/retrieval/run.mjs) | recall@1 75% · recall@3 81% · MRR 0.781 — 计入 also_matched 时为 81% / 90% | multilingual-e5-small(int8)生成的向量与 BM25 通过倒数排名融合。在这个小型数据集中,融合结果的排名第一命中率现在比关键词引擎低 2 个百分点(75% 对比 77%)——关键词引擎在 2.7.2 中有所改善,融合结果几乎没有变化——且没有干扰项达到真实命中项的分数(0/14)。它在 1.14 中提升了 8 个百分点;自 2.5 以来下降的 6 个百分点已在 benchmarks/README.md 中追溯。向量候选项低于该余弦分数下限(0.84)时会被丢弃;这个数值是在同一数据集上选定,并在独立调优集上重新检查过的——它是调优所得,并非盲测结果。磁盘占用约 500 MB;服务运行时占用约 0.5 GB RAM;需进行一次性嵌入处理(按批次测量时,4k 行的大脑约需 3 分钟;自 2.7.2 起逐行处理,耗时为 1.6 倍);每个进程加载模型约需 13 秒。自 1.16 起由 init 安装;CRBRO_SEMANTIC=0 可将其关闭 (v1.14+) |
| 使用卡片介绍的两种习惯进行检索(同一组 48 个查询;保存时添加关键词,并在召回时尝试多种表述;两者均由只看到测试一半内容的模型盲写;在 2.7.2 上于 2026-10-03 测量) | 仅关键词:recall@1 83% · recall@3 92% — 全部功能开启(关键词 + 改写 + 语义层):92% / 96%,计入 also_matched 时为 94% / 98% | 提升最大、且不花成本的方法是:保存事实时写入 2-5 个关键词,恰好弥补了嵌入模型无法弥补的缺口——这也是 crbro_learn 现在会在收到的事实缺少关键词时询问的原因。仅改写不会提升关键词引擎的排名第一命中率(77% → 77% / 90%);与关键词结合后则能进一步提升。全部功能开启时,没有干扰项达到真实命中项的分数。所有配置和仍未命中的问题见 benchmarks/README.md (v1.15+) |
仅使用关键词引擎(同一组 48 个查询;CRBRO_SEMANTIC=0,或尚未安装模型时;在 2.7.2 上于 2026-10-03 测量,node benchmarks/retrieval/run.mjs) | recall@1 77% · recall@3 83% · MRR 0.806 — 计入 also_matched 时相同(2.7.1 上为 71% / 77%) | 1.12 中为 56% / 69%。2.7.2 会根据查询词的稀有程度为其加权,权重在独立调优集上选定:这里提升了 6 个百分点,在含 1,482 条事实的海量数据中提升了 12 个百分点,而在新的 96 题测试中没有提升(49%)。朴素的子字符串搜索得分为 38% / 58%。这是每次安装的基础表现,未命中项列在基准测试输出中 |
| 大规模检索(第二套由 96 个问题 + 20 个干扰项组成的盲测,以及一个包含 1,482 条事实、涉及 114 个无关主题的海量数据集;这些事实在测试大脑之前已学习;测量前均已冻结;在 2.7.2 上于 2026-10-03 测量) | 实际安装后的结果:recall@1 57% · recall@3 60%;在海量数据中为 48% / 52%。仅使用关键词引擎:49% / 53%,在海量数据中为 31% / 40% | 新测试比原始测试更难,也更容易造成虚假的信心:实际安装后,20 个干扰项中有 8 个以真实命中项的分数被返回;仅使用关键词引擎时则有 11 个。2.7.1 和 2.7.2 的结果没有变化。它说明了语义层的用途:大脑中保存的无关事实越多,它对召回的帮助就越大——此处提升了 17 个百分点 |
| 检索——虚假的信心(14 个关于未存储内容的问题;在 2.7.2 上于 2026-10-03 测量) | 关键词引擎:有 2 个达到真实命中项的分数。实际安装后:有 0 个达到真实命中项的分数 | 关键词记忆几乎什么都能回答。每个结果都带有 confidence,在这组测试中,该标签能识别出几乎所有干扰项——代价是也会将一些真实命中项标为较弱。较弱意味着“问题中的少量内容得到匹配”,而非“答案错误”。在难度更高的 96 题测试中,它能识别的干扰项少得多(见上行) |
| 秘密信息脱敏(20 个采用对抗性伪装的凭据,19 个相似但无害的字符串) | 捕获率 100% · 误报率 0% | 在这组冻结的数据集上达到 100%——这是下限,不是安全性证明。随着新的规避形式出现,数据集会继续扩充;其中四项在第一次运行时未被捕获,后来已修复,并未隐藏 |
| 成本(CRBRO 为会话增加的开销) | 协议文本块约 1,000 tokens · 1,145 神经元大脑的完整启动负载约 ~2.8k tokens · 每次召回约 ~2k(五个排序结果)· 工具定义约 ~7.5k tokens · 使用关键词引擎在本地检索 300 条事实约 ~1 ms,使用需要嵌入问题的语义层约 ~10 ms | 启动文本块只付费一次。1,000 这个数字仅指协议文本——Card Zero 的十个协议,共 4,035 个字符,于 2026-10-03 测得(第十个协议加入前为 750);启动时返回的内容还包括热门主题、活动上下文和最近会话;在成熟的大脑中,该负载曾达到 20,352 tokens,直到 2.0.3 为其设置了明确上限——2.0.3 后测得 4,989,2.1 后测得 2,758;2.1 还将神经元视图改为索引(打开一个含 307 条事实的神经元:66,952 → 1,887 tokens),默认将召回结果限制为五个排序结果,并移除了每次响应都要付费的美化输出。现在不允许读取超过该上限的内容,所有被截短的内容都会明确说明。每次请求都要向加载所有工具的客户端(Claude Desktop、Cursor)提供 15 个工具定义(描述 + 输入架构共 29,897 个字符;于 2026-10-03 在 2.7.2 上通过真实的 tools/list 测得,再除以 4;计入三个读取工具的输出架构后为 35,416,约 8.9k tokens;2.7.1 上为 29,757;2.1.0 上为 27,095 和 32,246);Claude Code 会延迟加载这些定义,只为其使用的工具付费。减少的是工具数量,而非字符数:1.13 中的 23 个工具测得 21,662 个字符(约 5.4k tokens),因为每个参数的文本现在都放在吸收了该参数的工具中 |
这些基准测试刻意不声称什么——人的生产力、“它了解你”,以及与其他记忆系统的比较——都记录在 benchmarks/LIMITS.md 中。 |
快速开始
Claude Desktop:双击即可
从最新版本下载 .mcpb 安装包,并在 Claude Desktop 打开时双击它。安装就是这么简单:无需 Node、终端,也无需编辑 JSON;大脑文件夹可在安装对话框中设置。安装包内置关键词引擎;语义层则刻意不包含在内,因此不会在你不知情的情况下下载任何内容。
以下是另一种方式,适用于 Claude Code、Cursor 以及偏好使用 npm 的用户。
1. 初始化
在 ~/.crbro/ 中创建大脑,并从 1.16 版起安装语义回忆功能:本地嵌入模型,每台机器约需下载 500 MB,耗时几分钟。添加 --no-semantic 可跳过此步骤。
npx crbro-memory init
2. 添加到 MCP 配置
请在用户级别而非项目级别注册 CRBRO。 你的大脑位于
~/.crbro/,并在所有文件夹间共享;但如果你在某个项目中注册 服务,其他文件夹就无法使用这些工具,而且会看起来像是记忆消失了。 用户级别注册可让它随处可用,这正是这么做的目的。
Claude Code(一条命令,在每个文件夹中均可使用):
claude mcp add --scope user crbro -- npx -y crbro-memory
Claude Desktop(~/AppData/Roaming/Claude/claude_desktop_config.json):
{
  "mcpServers": {
    "crbro": {
      "command": "npx",
      "args": ["-y", "crbro-memory"]
    }
  }
}
Cursor(~/.cursor/mcp.json——使用主目录中的文件,而不是项目的 .cursor/):
{
  "mcpServers": {
    "crbro": {
      "command": "npx",
      "args": ["-y", "crbro-memory"]
    }
  }
}
运行
npx crbro-memory时出现UNABLE_TO_VERIFY_LEAF_SIGNATURE? 防病毒软件或企业代理正在检查 HTTPS(Avast 和 AVG 的“Web Shield”、Kaspersky、Zscaler……):它会用自己的根证书重新签署每个连接,而你的操作系统信任该证书,Node.js 却不信任。告知 Node 信任系统证书库——这不会关闭任何检查:Windows 上运行setx NODE_USE_SYSTEM_CA 1(然后打开新终端),其他系统上运行export NODE_USE_SYSTEM_CA=1;需要 Node 22.15+。若只针对一个 MCP 客户端,可将其放入该服务的env中:"env": { "NODE_USE_SYSTEM_CA": "1" }。切勿用strict-ssl=false或NODE_TLS_REJECT_UNAUTHORIZED=0来“修复”此问题:这会关闭所有内容的验证。
Docker(大脑位于 /root/.crbro;挂载卷以保留它。该镜像不包含语义运行时,因此其中的回忆功能仅基于关键词):
docker build -t crbro-memory . && docker run -i -v crbro-brain:/root/.crbro crbro-memory
3. 让它自行加载 — 不要跳过这一步
npx crbro-memory install-boot
安装服务并不意味着会调用它。 工具已经就绪,大脑也已存储在磁盘上,但没有任何东西读取它:助手无所依据地作答,而记忆看起来像是坏了,其实只是处于休眠状态。到目前为止,所有“CRBRO 记不住”的反馈都是这种情况,并非回忆功能有 bug。
install-boot 会将启动流程接入它找到的客户端,合并到你的配置中,绝不会重写配置。它具有幂等性,并且不会动你自己编写的任何钩子:
| 客户端 | 写入内容 |
|---|---|
| Claude Code | 在 ~/.claude/settings.json 中写入 SessionStart — 一条命令,其标准输出会进入会话,告知模型先调用 crbro_boot。Claude Code 无法从钩子中调用 MCP 工具,因此这条指令就是实现机制。 |
| Codex | 在 ~/.codex/hooks.json 中写入 SessionStart — 一个直接调用 crbro_boot 的 mcp_tool 步骤,并且将同一条指令作为第二层保障输出。 |
Codex 中的第二层保障并非多此一举:钩子可能会在 MCP 服务完成启动之前触发,此时直接调用就会丢失。指令可以覆盖这段时间。
不支持会话钩子的工具(Cursor、Windsurf、Antigravity……)会通过其常驻规则文件(.cursorrules、.windsurfrules、用户规则)完成同样的工作。install-boot 会打印出可直接粘贴的准确内容:
CRBRO:将
mcp__crbro__crbro_boot作为你的第一个工具操作调用,然后再作答,除非本会话已经包含其返回结果。在本次会话余下时间内,遵循它返回的protocol_enforcement区块。
然后重启、开启新对话,并确认 crbro_boot 确实已运行且返回了神经元数量。如果你仍然必须手动调用它,就说明这一步没有生效。
4. 开始使用
你的 AI 现在拥有 15 个记忆工具,并会自行启动大脑。回答任何有关过去工作的内容之前,先调用 crbro_recall;随时调用 crbro_learn;对话结束前调用 crbro_consolidate。
5.(Claude Code,可选)子 Agent 钩子
npx crbro-memory install-hooks --inject
会话上下文永远不会传递给由 Task 启动的子 Agent,因此这个钩子可以注入 crbro_boot 加载的同一协议区块 — 只有一个事实来源,并且设计上绝不会阻塞会话(任何失败都会降级为备用规则集并正常退出)。
从 1.12 版起,注入默认为关闭,原因源自实测,而非谨慎起见。 三轮基准测试采用了经过验证的干净对照组、盲测评审者和预先注册的阈值,结果发现:在所有可测量的 Agentic 探测中,前沿模型无论是否注入该区块,都达到了完美上限(它没有任何可提升之处);小模型在单次任务中会受到它的损害(范围控制表现:不注入时 10/10,注入后 0/10);而在 Agentic 模式下,唯一出现的差异行为是不利的 — 注入该区块的小模型 Agent 会钻失败测试套件的空子,并在 2/5 次测试中报告成功;不注入时为 0/5。一个没有带来任何实测效果、却可能诱发虚假合规的默认选项,不是本项目会采用的默认设置。如果你启用它,请使用 CRBRO_SUBAGENT_MATCHER 限定范围,并让小模型子 Agent 不参与。
6.(同一大脑连接多个客户端,可选)守护进程模式
npx crbro-memory daemon on       # then restart your MCP clients
npx crbro-memory daemon status
默认情况下,每个 MCP 客户端都会启动自己的 CRBRO:各自持有一份索引副本、一个嵌入模型(约 0.5 GB),以及一个内存索引;关闭时还会用它覆盖其他客户端的索引。启用守护进程模式后,第一个启动的客户端会启动一个独立运行的守护进程,所有客户端(包括启动它的客户端)都会成为连接到该进程的轻量代理。这个开关位于大脑内部,因此所有客户端会在下次启动时一并切换;无需更改它们的 MCP 配置。
这种设计只会影响速度,不会影响功能。如果没有可用的守护进程,客户端就像以前一样在进程内自行提供服务。如果守护进程在对话中途退出,代理会在替代进程上重新执行 MCP 握手,正在进行的调用则会收到错误,而不会一直挂起。使用其他构建版本的客户端会启动自己的守护进程,而不会连接到由其他版本启动的进程;旧进程会在空闲 20 分钟后退出(CRBRO_DAEMON_IDLE_MIN)。只有持有 <brain>/.daemon/ 中令牌的客户端才能访问管道或套接字,并且客户端发送任何内容之前,守护进程都必须先向客户端证明自己的身份。在某个客户端的环境变量中设置 CRBRO_DAEMON=0,即可让该客户端不使用守护进程。性能数据和真实进程测试见 benchmarks/daemon/。单个客户端使用此功能毫无收益。
7.(Claude Code,可选)守护钩子
npx crbro-memory install-hooks --guard
npx crbro-memory guard "git push origin main"   # what it would say, without installing anything
回忆是拉取式的:只有当有人想到要询问时,才能找到经验;而错误记录中恰恰保存着那些无人能在恰当时刻想起要询问的知识。此钩子会在服务器从你的错误、待办和模式中生成的小型索引(.search/triggers.json,每次整合时都会重写)中查找该命令,并将提及该命令的条目添加到模型本次工具调用的上下文中:最多 3 条,错误优先,最新的优先,每个会话中每条仅注入一次。它只读取一个小文件——不使用搜索索引、模型或网络——绝不阻塞或询问,出现任何故障时都会正常退出。与此处所有尚未经过测量的注入一样,此功能需选择启用。要移除此钩子,请从 ~/.claude/settings.json 中删除指定 crbro-guard 的 PreToolUse 条目。
8.(Claude Code,可选)精简内容,同时保留上下文
npx crbro-memory install-hooks --compact
npx crbro-memory uninstall-hooks --compact   # removes both and puts back what it replaced
精简会保留摘要,却丢失能让你知道进行到哪一步的细节。这里将两个 Claude Code 钩子接入 hooks/crbro-lifecycle.mjs:
PreCompact将会话检查点写入<brain>/checkpoints/<session_id>.json:你最近提出的两件事、任务列表的最后状态(TodoWrite或Task*工具)、知识库的待处理事项,以及文件夹和它的 git 远程地址(不含用户名、密码或查询字符串)。它读取的是转录记录,不会调用模型;写入磁盘前,会用知识库使用的同一过滤器对每个字符串进行整体脱敏,然后再截断长度。后台任务、其他 Agent 或/model等配置命令写入转录记录的内容不会被视为请求。超过七天的检查点会被删除,crbro backup不会将它们纳入备份。它还会打印“保留尚未保存内容”的提醒。SessionStart会打印启动通知,其中已填入文件夹路径(调用crbro_boot …时传入project="<folder>",因此会优先使用项目的神经元)、一行Project: <folder> · git: <remote>,以及——仅当会话从精简后恢复,且该会话存在未超过 24 小时的检查点时——“Resuming after compaction”区块,其中包含请求、待处理任务和待处理事项,长度不超过 1,500 个字符。该区块会将转录记录中的文本重新放入模型上下文;读取和保留的内容列于 SECURITY.md。
Claude Code 的 install-boot 条目会打印相同的通知,因此会被替换(并由 uninstall-hooks --compact 恢复)。你自行编写的 CRBRO 钩子永远不会被替换:新钩子会通过 --no-boot / --no-reminder 添加在其旁边,因此不会重复读取内容。只有 Claude Code 支持 PreCompact;不会改动 Codex 和其他工具。和其他钩子一样,它绝不会阻塞:不读取网络,不启动 git 进程;如果标准输入始终未关闭,它会自行结束,并且始终以状态码 0 退出。
9.(Claude Code,默认开启)查看待处理事项
无需运行任何操作:如果机器上安装了 Claude Code(存在 ~/.claude),第一次运行 crbro_boot 时就会安装此 mod,方式与下文的 install-mod 完全相同,语言设为自动;启动响应中会包含 mod_notice,由助手转告你——安装了什么、它会出现在新的 Claude Code 会话中,以及如何移除。此通知会发送给一周内最多三个服务进程(每个进程各一次)的首次启动,因为第一次启动可能是在无人查看的后台运行中。更新 CRBRO 后,如果启动时发现已安装文件与软件包不同(忽略换行符差异,使用 SHA-256 校验),就会刷新这些文件,但不会改动 settings.json,并告知你文件已刷新。同一台机器上较旧的 CRBRO 永远不会覆盖较新版本的文件;同一版本的两个构建(位于 npm 副本旁的检出版本)也不会互相改写。每个服务进程(每个守护进程)只运行一次,且绝不会导致启动失败。文件会在不阻塞的情况下复制,启动最多等待安装 1.5 秒;剩余的少量设置读取和写入操作是同步的,只需几毫秒。两个会话同时启动时,会通过锁文件轮流执行;只有当 settings.json 仍与读取时相同,才会写入——如果 Claude Code 恰好同时保存了更改,这些更改会被合并,而不会丢失。
如需停用:
npx crbro-memory uninstall-mod             # removes it and leaves a mark: never put back on its own, from any app
CRBRO_MOD=0                                # in one MCP client's env: that client never installs or updates it
uninstall-mod 是在整台机器上卸载的方式:标记保存在 ~/.claude/crbro-mods/state.json 中,所有 CRBRO 都会读取它。CRBRO_MOD=0 只对 MCP 配置中设置了该变量的客户端生效——如果 Codex、Cursor 或 Claude Desktop 中的 CRBRO 安装在同一个 ~/.claude 下,而没有设置该变量,那么它们不受影响——因此请在每个客户端中设置,或运行一次 uninstall-mod。手动从 CLAUDE_CODE_PLUGIN_DIRS 中移除 ~/.claude/crbro-mods/crbro-pending 也会被视为拒绝安装,下次启动时会提示一次,并说明如何恢复。install-mod 会清除标记。无法解析的 settings.json 不会被触碰;在该文件或软件包发生变化,或一天过去之前,不会重试同一项失败(如果文件被其他程序占用,则会在下次启动时重试)。如果列表中已经有另一个 crbro-pending(例如本仓库的检出副本),则不会在其旁边安装。如果 CLAUDE_CODE_PLUGIN_DIRS 只在 Claude Code 启动时的环境中设置,而未写入 settings.json,也不会安装——settings.json 的 env 优先于环境,因此将该变量写入其中会阻止这些插件加载——启动时会提示一次;将变量移入 settings.json 后,下次启动就会在它们旁边添加该 mod。尚未测试此 mod 是否适用于 2.1.286 之前的 Claude Code。
npx crbro-memory install-mod               # --lang en | es | auto (default: leave it as it is; auto on a first install)
npx crbro-memory install-mod --verify      # SHA-256 of the installed copy against this package; changes nothing
npx crbro-memory uninstall-mod
crbro_context 中留下的待办事项,只有在 crbro_boot 列出时才会被看到,因此已完成的工作会被反复提起好几周,未完成的工作却会被遗忘。此安装会添加 mods/crbro-pending,这是一个 Claude Code mod(函数钩子的插件):
- 提示词栏:位于提示词上方,显示最新的未完成事项全文。较短的
Label:会单独显示,(1) … (2) …步骤各占一行;未超过 3 天时显示为绿色,未超过两周时为琥珀色,超过两周后为红色。‹ › 可浏览其他事项,Compact 会将其折叠为一行,See all 会打开列表,Hide 会将其隐藏,直到使用/pending。 /pending(别名/pendientes):以卡片形式显示所有未完成事项,并提供忽略重音符号的筛选功能;还包括 Work on this(将事项写入提示词,供你发送)、Done 和 Discard,每项操作都需确认是或否,以及最近关闭的事项。
它会对拥有该工具的 MCP 服务调用 crbro_context 且不带参数来读取数据(此操作只会读取);在标准安装中,该服务名为 crbro,可通过会话的工具列表找到。它每分钟刷新一次,并在每次 CRBRO 工具调用后刷新。无法连接到 CRBRO 服务时,它会改为读取 <CRBRO_PATH or ~/.crbro>/prefrontal/active_context.json,解析方式与服务一致,并会说明这一点。此回退方式只能读取 Claude Code 自身运行环境中的 CRBRO_PATH(系统环境、你的 shell,或 ~/.claude/settings.json 的 env 块中设置的值),无法读取只在 MCP 服务自身 env 块中设置的值;如果 brain 只在该处配置,服务连接之前,提示词栏会读取 ~/.crbro,窗格会显示所读取的文件名。Done 和 Discard 始终通过服务执行——resolve_pending 会将事项保留在最近关闭列表中,discard_pending 则不会——此 mod 绝不会写入 brain。
install-mod 会将此 mod 复制到 ~/.claude/crbro-mods/crbro-pending,并将该文件夹添加到 ~/.claude/settings.json 中的 env.CLAUDE_CODE_PLUGIN_DIRS(Windows 上文件夹之间用 ; 分隔,其他系统用 :),且只添加一次;不会修改该文件中的其他内容,除非通过 --lang en 或 --lang es 指定 mod 自身的语言(pluginConfigs.crbro-pending.options.language,/config 中也有一行对应设置)。auto 会依次采用 CRBRO_LANG、LC_ALL / LC_MESSAGES / LANG,然后是系统区域设置。如果 settings.json 无法解析,就会保持不变;写入是原子的,重复运行不会造成任何变化。如果列表中已有一个插件名为 crbro-pendientes 的文件夹(这是此功能出现前手动复制的文件夹),它会在原位置被替换并重命名;该文件夹仍保留在磁盘上。任何其他副本、列表中的另一个 crbro-pending,或 ~/.claude/mods 中的副本,都会被指出且绝不会修改;只要它们存在,--verify 就会失败,因为 Claude Code 会显示两条色带。uninstall-mod 会从列表中移除该路径(如果变量最终为空,也会移除该变量),恢复被替换的 crbro-pendientes 文件夹(如果该文件夹仍存在),并删除 ~/.claude/crbro-mods/crbro-pending,除此之外不会删除任何内容。如果你的 Shell 中也设置了 CLAUDE_CODE_PLUGIN_DIRS,其中包含 settings.json 未列出的文件夹,install-mod 会将它们列出:settings.json 的 env 块会覆盖环境变量,因此如果这些插件停止加载,请将它们添加到该处。install-hooks --verify 也会检查该 mod。
Mod 需要 Claude Code 2.1.286 或更高版本,并会显示在 CLI 和桌面应用的 Code 标签页中;Claude Desktop 聊天、Codex、Cursor 和 VS Code 扩展不会显示它们。安装后请开启一个新会话。
工具
| 工具 | 描述 |
|---|---|
crbro_boot | 在会话开始时启动脑库——加载热点主题、上下文、最近三个会话和 retired_tools 映射。project(文件夹或仓库名称)会优先列出该项目的神经元,并将其列入 project_neurons |
crbro_inspect | 按 ID 或名称查看只读视图:view=status(显示进程运行的版本,以及 npx 在进程运行期间替换它后磁盘上安装的版本)、neuron、neurons、sessions、global_map。默认情况下,view=neuron 是索引——每个条目均显示 ID、类型、日期和预览;entries=[ids] 会完整读取指定条目,detail=full 会读取整个神经元。view=sessions session=<id> 会完整读取某天的日志 |
crbro_learn | 存储事实、决策、模式、偏好、错误或待办事项,并附上搜索关键词。supersedes 用于替换旧事实;shelf_life、reference 和 temporal 用于描述该声明。重复记录并不能验证它;实际检查后,请使用明确的 crbro_revise status=verified 并提供证据。 |
crbro_recall | 搜索所有存储的行,而不仅是主题名称——返回匹配内容、置信度以及该主题中接下来最相关的行。多个措辞会按排名合并;since("2026-09-01"、"2w")和 kind(["error"])可缩小范围;sessions_matched 列出提及该内容的日记,sessions_total 显示日记总数。若某行并非来自你本人,会注明其来源,also_matched 中也一样:origin 为 team:<space>(包含 by,即作者自行声明且可能伪造的信息);神经元不再共享时则为普通的 team;或者为 miner。如果某行的最佳匹配内容自上次验证以来已超过保质期,该行会单独返回在 possibly_stale 中:首先是 warning 和 next_step(回答前需检查的内容;若该行引用了文件,则注明文件名),接着是 last_known 中的内容,然后是 age_days、last_verified、shelf_life 和 shelf_inferred;回答随后会以 stale_warning 开头。旧版 also_matched 预览会包含 stale_days |
crbro_revise | 将事实(以及通过 entries 指定的决策、模式、错误和待办事项)标记为已被取代或已撤回;通过 status=active 重新激活;通过 status=verified 将事实、决策和模式标记为已对照来源检查并重新确认;编辑摘要、领域、标签或名称;也可使用 move_to 拆分神经元——条目保留原日期 |
crbro_forget | 永久删除,并先在 .quarantine/ 中保留副本——可删除神经元中的条目、整个神经元(需通过 confirm_token 分两步确认)或会话日志;还可使用 restore 和 merge_into |
crbro_connect | 创建、加强、设置神经元之间连接的强度,或删除连接(action=disconnect) |
crbro_context | 读取(不带参数)或更新当前工作上下文——主题、待处理事项、丢弃或清除 |
crbro_map | 维护一份描述主题系统运作方式的动态映射——整体替换,不做局部修改 |
crbro_consolidate | 会话结束时进行整合——记录会话的唯一方式;关联本次写入的主题并同步空间。promotion_candidates:本次会话中多个项目共有、可推广至其他项目的经验,以及建议的 tech_/process_ 神经元——仅供建议,不会自动移动 |
crbro_maintenance | 维护脑库——热度、修剪、完整性、repair、unarchive、重建索引。每次运行都会报告过期条目、超过保质期的条目(stale_entries、stale_sample)、过大的神经元和批量导入遗留内容;backfill_dates 和 compact 会对这些内容进行处理 |
crbro_audit | 查找脑库中存储的凭据,包括会话日志——报告凭据类型,但不报告具体值 |
crbro_secret | 将凭据存入操作系统钥匙串,并仅在脑库中保留其名称 |
crbro_space | 创建、加入、sync 或离开团队空间——用于共享项目的私有 Git 仓库 |
crbro_share | 将一个项目放入空间,并在操作前准确显示将要发送的内容;unshare 会停止跟踪该项目 |
从 1.x 升级
2.0 将工具数量从 23 个减少到 15 个,且无需改动磁盘上的脑:1.x 的脑可以原样打开,搜索索引会自行重建一次。七个读取工具变成了 crbro_inspect 的不同视图,会话日志现在只存在于 crbro_consolidate 中,而 crbro_sync 现在是 crbro_space action=sync。卡片中介绍的八个动词(boot、learn、recall、revise、forget、connect、context、consolidate)名称和参数都保持不变。每次调用 crbro_boot 都会通过 retired_tools 返回下表,因此学过旧接口的模型无需阅读文档也能找到对应方式;如果客户端直接调用已弃用的名称,则会收到 MCP 的“unknown tool”错误。
| 已弃用 | 改用 |
|---|---|
crbro_status | crbro_inspect view=status |
crbro_neuron | crbro_inspect view=neuron neuron=<id or name> |
crbro_neurons | crbro_inspect view=neurons [domain|type|min_heat|limit|offset] |
crbro_hot_topics | crbro_inspect view=neurons(行)和 view=status(hot_topics_recalculated) |
crbro_connections | crbro_inspect view=neuron neuron=<id> [min_strength] |
crbro_sessions | crbro_inspect view=sessions [limit] |
crbro_global_map | crbro_inspect view=global_map |
crbro_session_log | crbro_consolidate summary=... [topics_touched=[...]] — topics_touched 会记录你只读取过的神经元 ID(另有 crbro_context set_topics=[...] 可替换当前活跃主题) |
crbro_sync | crbro_space action=sync [name] |
如果你使用 Claude Code 钩子,请从 ~/.claude/settings.json 中的任意匹配器以及会话启动文本中删除 mcp__crbro__crbro_session_log:否则每次会话启动都会安排调用一个已不存在的工具。暂时无法迁移?1.x 仍可通过 npx -y crbro-memory@1 安装,但不会再获得新功能。每个保留工具内部的变化详见 CHANGELOG.md。
凭据
记忆不该保存你的密码,CRBRO 也不会这样做:任何看起来像凭据的内容,在写入磁盘前都会被替换为标记。但仅仅拒绝保存并没有多大帮助——密码仍然存在,最后还会以明文写进配置文件。
因此,crbro_secret 为它提供了一个存放位置:你机器自带的凭据存储。
| 平台 | 值的实际存放位置 |
|---|---|
| macOS | 通过 security 存储在 Keychain 中 |
| Linux | 通过 secret-tool 存储在 Secret Service 中 |
| Windows | 使用 DPAPI 加密,并绑定到你的 Windows 账户 |
在没有凭据存储的机器上——无头服务器、CI 运行器,或通过 SSH 访问且已锁定的密钥链——crbro_secret 会直接说明情况,而不会失败。环境变量仍可正常使用,CRBRO 的其他功能也不受影响。
CRBRO 不保留副本,也不会自行实现加密。凭据存储位于脑之外,因此同步、团队空间和任何 crbro_share 都无法访问它。脑中保存的是名称:
“example.com 的 WordPress 密码保存在
WP_EXAMPLE_APP_PASSWORD中。”
这足以让助手下周再次找到它,而任何读取你记忆文件的人都无法据此获取密码。
从终端操作
在 2.3 之前,唯一的使用方式是 crbro_secret,这意味着要把值输入与模型的对话中。crbro secret 可在 Shell 中使用同一个存储:
npx crbro-memory secret set GITHUB_TOKEN     # value read from stdin, never argv
npx crbro-memory secret list                 # names only, never values
npx crbro-memory secret get GITHUB_TOKEN     # pipe it; warns if it would hit the screen
npx crbro-memory secret remove GITHUB_TOKEN --yes
npx crbro-memory secret status               # which store this machine offers
参数会进入 Shell 历史记录和进程表,而标准输入不会。在终端中输入时,内容会隐藏;管道也同样可用:
Get-Content token.txt | npx crbro-memory secret set GITHUB_TOKEN    # PowerShell
op read "op://vault/github/token" | npx crbro-memory secret set GITHUB_TOKEN
同名环境变量始终优先,因此 CI 和临时覆盖无需触碰密钥链即可正常工作。在没有凭据存储的无头机器上,crbro_secret 会直接说明情况,而不会失败——环境变量仍可正常使用,CRBRO 的其他功能也不受影响。
团队记忆
一起处理同一件事的两个人,不该让各自的助手重复听同样的话。空间是一个或多个与队友共享的项目,由你拥有的私有 git 仓库承载——无需服务器,无需账号,也无需付费。
# One person, once:
crbro_space  action: create   name: "team"   remote: [email protected]:acme/team-memory.git   author: "ana"
crbro_share  neuron: "project_x"   space: "team"

# Everyone else, once:
crbro_space  action: join     name: "team"   remote: [email protected]:acme/team-memory.git   author: "bruno"
此后,它便不会妨碍你:每次会话开始和结束时都会交换笔记。每个人对该项目的了解,其他人的助手下次启动时都会知道。
它如何避免打扰你
- 没有人会写入其他人的文件。每个人只向自己的日志追加内容,每台机器都会根据所有日志重建项目,因此没有冲突需要解决——现在不会,分开一周后也不会。
- 如果有人将某条事实标记为不再成立,该标记就会生效。已撤回的知识不会因为某份过时副本仍将其标记为当前信息而重新生效。
- 队友根据来源核实一条共享事实后,会重新开始计算所有人的该条信息保质期:以最近一次核实为准。显式设置的
shelf_life也会同步,并采用最短的保质期——多一次不必要的提醒只需多做一次核实,缺少提醒却可能导致错误答案——因此共享事实的保质期可以缩短,但不能延长:下次同步时,日志中的较短保质期会恢复,crbro_learn会在shared_warning中说明这一点。日期晚于一天的核实记录(时钟快了)会视为未核实。使用旧版 CRBRO 的队友则不会收到核实记录。 - 无法连接是正常情况,不是错误。记忆可以离线使用,保存的内容会在下次同步时发出。
团队同步不会包含的内容
- 任何未明确共享的项目。
- 偏好设置——无论如何设置,都不能共享。它们最可能包含密钥。
- 已识别的凭据。如果
crbro_share发现凭据,会直接拒绝,并告知你凭据所在的位置。过滤器无法识别所有可能的机密;请将凭据值保存在独立的 OS 密钥链中,切勿放入共享笔记。
这些是团队同步的排除项,并不保证 AI 客户端的数据流或你选择用于存放知识库的云同步文件夹也会遵守这些规则。
发出去的内容无法收回。
crbro_share unshare:true会停止跟踪某个项目——不再发送笔记,后续同步也会忽略它——但队友一旦拉取了该项目,内容就已保存在他们的磁盘上。移除他们对仓库的访问权限,可以阻止他们收到任何新内容,但无法收回他们已有的内容。任何同步系统都是如此——分享之前就该了解,而不是分享之后。
架构
~/.crbro/
├── manifest.json           ← Brain metadata
├── cortex/                 ← One JSON per neuron (topic)
│   ├── project_octochat.json
│   └── tech_firebase.json
├── synapses/               ← One JSON per connection
│   └── syn_octochat__firebase.json
├── hippocampus/            ← One JSON per session
│   └── session_2026-05-06.json
├── prefrontal/             ← Working memory
│   ├── active_context.json
│   └── hot_topics.json     (the global map is computed live since 2.0, never stored)
├── .quarantine/            ← What crbro_forget removed, kept until you delete it
├── unshared.json           ← Projects you stopped following in a space (after an unshare)
├── archives/               ← Cold neurons (opt-in; nothing is archived unless you ask)
├── shared/                 ← One git repo per team space. Notes only, never the cortex
│   └── team/
│       └── neurons/project_x/ops/ana.a1b2c3.jsonl
└── .search/                ← Orama search index
    └── chunks.index.json   ← one document per fact
热度分数算法
每个神经元都有一个热度分数(0.0 - 1.0),根据以下因素计算:
- 频率(35%)——神经元被访问的频率
- 近期性(40%)——上次访问的时间(今天 = 1.0,超过 3 个月 = 0.05)
- 连接度(25%)——与其连接的突触数量
知识挖掘器
知识挖掘器是一个可选、完全本地运行的辅助工具,会扫描目录中的 .md 和 .txt 文件(笔记、文档、日志),并将知识提取到知识库中——这样 CRBRO 就能从你已经写下的内容中学习,而不仅仅是从对话中学习。它绝不会访问网络,也不会离开你的机器。
npx crbro-memory mine [dir]       # One-shot scan of a directory
npx crbro-memory setup-miner      # Install a scheduled auto-scan (OS task scheduler)
npx crbro-memory miner-status     # Check the auto-miner status
npx crbro-memory remove-miner     # Remove the scheduled task
命名说明:“miner”在这里指的是挖掘知识——从你自己的文本文件中提取事实。与加密货币挖矿无关。
CLI 命令
npx crbro-memory          # Start MCP server (stdio)
npx crbro-memory init     # Initialize brain + detect IDEs
npx crbro-memory install-boot  # Make the memory load itself in every conversation (above)
npx crbro-memory status   # Show brain status
npx crbro-memory reindex  # Rebuild the search index
npx crbro-memory eval     # Measure retrieval quality against your own query set
npx crbro-memory semantic status | install | build   # Semantic recall (installed by init; below)
npx crbro-memory secret set|get|list|remove|status   # Credentials in the OS keychain (above)
npx crbro-memory backup | backup list | backup restore FILE   # One gzipped copy, rotated; restore never lands on the live brain
npx crbro-memory daemon on | off | status | stop   # One process owns the brain for every client (above)
npx crbro-memory install-hooks --guard   # Stored lessons speak before a shell command runs (above)
npx crbro-memory install-hooks --compact # Checkpoint before a compaction, picked back up after it (above)
npx crbro-memory guard "<command>"       # What the guard would say for a command
npx crbro-memory install-hooks --verify  # SHA-256 of the installed hooks and mod against this package; changes nothing
npx crbro-memory install-mod [--lang en|es|auto]   # Open items above the prompt and /pending in Claude Code (above)
npx crbro-memory uninstall-mod           # Remove that mod and its CLAUDE_CODE_PLUGIN_DIRS entry
npx crbro-memory usage [--days N] [--session ID] [--project DIR] [--json]   # Tokens per model and session, subagents apart
npx crbro-memory postmortem [--days N] [--max N] [--json]   # Candidate lessons from past sessions; stores nothing
npx crbro-memory --help   # Help
语义召回
关键词引擎没有同义词,而盲测基准恰好揭示了它的短板:改述——例如,某条关于 Hetzner VPS 的事实对应的提问 “网站托管在哪里”。保存时写入关键词可以免费弥补大部分差距(见上文);小型嵌入模型在小型知识库上能再弥补一点,在大型知识库上则能弥补更多。自 1.16 起,npx crbro-memory init 会在每台机器上默认安装一次,只要运行时存在,该层就会启用。实测成本:磁盘占用约 500 MB(运行时约 380 MB + 模型 118 MB)、服务运行时约占用 0.5 GB RAM、每个进程加载模型约需 13 秒(在后台进行),以及一次性嵌入处理。使用 init --no-semantic 跳过安装;也可以随时在服务的环境变量中设置 CRBRO_SEMANTIC=0 将其关闭。
npx crbro-memory init                 # installs it (skip with --no-semantic)
npx crbro-memory semantic status      # runtime, model, on or off, and why
npx crbro-memory semantic build       # embed an existing brain once (a 4k-line brain: ~3 min in batches; 2.7.2 embeds one line at a time, 1.6x that)
每条新记录保存时都会生成嵌入(ID 是内容哈希,因此不会重复嵌入),模型会在启动后于后台预热,而 crbro_recall 会按倒数排名融合两种排序。向量排序所得的结果会带有 semantic_score;仅由向量匹配的结果在余弦相似度达到 0.86 时为 strong。设置 CRBRO_SEMANTIC=0 或缺少运行时时,不会读取向量,也不会加载模型:召回与关键词引擎逐字节一致。
模型是 multilingual-e5-small,并且有意保持不变。CRBRO_SEMANTIC_MODEL 接受任何 e5 系列模型;在同一基准上测试的 e5-base 和 e5-large 显示,单独使用时 large 模型表现更好(recall@1 为 71% 对 63%),但在 1.16 中与关键词引擎融合后,得分相同或更低(75% / 85% 对 79% / 83%),而磁盘占用是 4 倍、RAM 占用为 1.2 GB,且每行耗时是 6 倍。数据表见 benchmarks/README.md。
上述表格和 benchmarks/README.md 介绍了它在冻结基准测试中能带来什么、不能带来什么——其中也包括 0.84 的余弦相似度下限是在同一数据集上选定的这一事实。在安装 500 MB 模型前,值得了解一个限制:模型并不理解问题。查询与已存记录没有任何具体词汇重合时(例如,某条关于 Hetzner VPS 的事实对应的提问“哪台机器提供网页服务”),余弦相似度会落在平坦的 0.80–0.84 区间内,排序几乎随机——这是实测结果,也是设定下限的原因。它带来的是对词汇变化和实体的容错能力,这正是基准测试得分提升的来源。
衡量检索效果
eval 可帮助你分辨修复是否有效,而不是凭感觉判断。将你实际会提出的问题写入
~/.crbro/.eval/queries.json,并将每个问题对应到应该回答它的神经元:
[
  { "query": "how we deploy the api",
    "expect_neuron": "project_octochat",
    "expect_contains": "Cloud Run" }
]
然后运行 npx crbro-memory eval,即可查看正确的神经元有多少次排在首位、多少次进入前三,以及 MRR——还会列出每次未命中,让你看清错在哪里,而不必猜测。
隐私
CRBRO 知道的一切都以纯文本 JSON 文件的形式保存在你的设备上,位于
~/.crbro 或你指定的文件夹中。你可以打开、比较差异、用 git 备份并删除这些文件。没有账户、没有我们的服务、没有遥测,也没有分析:任何内容都不会发送给作者,而且服务端没有相关代码。
以下数据流可能会访问网络:
- 可选的语义层。
npx crbro-memory init(或semantic install)会从 Hugging Face 下载一个嵌入模型到~/.crbro/.semantic,约 500 MB,每台设备只下载一次。使用init --no-semantic可跳过,记忆检索仍仅使用关键词。桌面扩展 不会下载该模型。 - 团队空间。 如果你用自己拥有的 git 远程仓库运行
crbro_space,则会将你通过crbro_share明确共享的项目推送到该仓库。同步不包含其他任何内容:按设计排除偏好设置,而且只有你指定的项目才会被共享。 - 你的 MCP 客户端。 工具返回的任何内容都会被你正在交谈的助手读取,这样它才能使用你的记忆。这些数据在你和客户端之间传输,而不是发送给我们。
在文本写入磁盘之前,系统会将识别出的凭据模式替换为标记,并保留其所在的句子;crbro_secret 会将真实值存入你操作系统自己的钥匙串,而不是记忆库。显式调用 crbro_secret action=get 会将该值返回给 AI 客户端;静态加密无法阻止这项传输。常规记忆库备份不包含钥匙串。删除记忆库不会删除钥匙串条目、备份、对话日志或他人已收到的副本。要检查某个主题,请读取其文件或调用 crbro_inspect。
crbro usage 和 crbro postmortem 会在本地以只读方式读取 Claude Code 自己的会话日志,日志位于
~/.claude/projects:usage 只读取每条回复的模型名称和 token 数量,postmortem 只读取你输入的内容和调用的工具名称——绝不读取工具的输入或输出——并会对输出内容进行脱敏。
CRBRO 未经请求会写入 Claude Code 文件夹的唯一内容是 open-items mod:~/.claude/crbro-mods/(mod 本身、包含退出标记和已安装版本的 state.json、安装期间持有数秒的锁,以及一条保留到交接该通知的启动流程完成后才清除的通知),以及在 ~/.claude/settings.json 的 env.CLAUDE_CODE_PLUGIN_DIRS 中添加的一条记录。不会更改该文件中的其他键;文件会以 JSON 格式重写,并保留缩进和换行符(在 Windows 上,新文件会继承文件夹的权限)。不会下载或发送任何内容;如果不存在 ~/.claude、客户端中设置了 CRBRO_MOD=0,或已经执行 uninstall-mod,则不会进行这些操作。
每项防护措施的用途,以及如何报告漏洞,请参阅 SECURITY.md。
许可证
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。