关于 nanomem
nanomem 是面向需要追踪事实变化的应用的嵌入式记忆存储和 MCP 服务。它保留修订链并标记已被替代的事实,还通过文件型保险库支持搜索和历史查询。
主要功能
- 01为变化事实保留修订链
- 02标记已被替代的事实
- 03查询历史状态与变化
- 04基于文件的持久保险库
- 05提供七种 MCP 工具
适用场景
- 01回答已变化事实的当前值
- 02查询记忆在过去某时的内容
- 03查看近期变化和过时认知
- 04让助手与脚本共用保险库
MCP 相关
MCP 服务提供七种工具,用于添加和搜索记忆、查看历史与过去状态、追踪变化和波动情况,以及查询统计信息。搜索结果会在呈现给助手的文本中标出已被替代的事实。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
uvx nanomemNANOMEM_VAULTPath to the memory vault file. Defaults to ~/.nanomem/memory.dat.NANOMEM_PASSWORD密钥Passphrase to encrypt the vault at rest. Leave UNSET for a plaintext vault; setting it to an empty string is refused rather than silently producing one.本地服务需要在你的电脑上安装运行环境(如 Node.js 18+)。各客户端的配置文件位置不同,请参考客户端文档。
工具
7收录的工具列表 · 更新于 2 周前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| text | string | 是 | 要记住的信息。 |
| entity | string | 否 | 此内容所述的属性,例如 'employer'、'home_address'、'phone'。每次写入同一属性的新值时,都传入相同的值——这样 nanomem 才能判断哪条陈述取代了哪条。只有在确实不知道时才省略;此时词法标注器会进行猜测,而对于叙述性表达(“我换了工作,现在在……工作”),它的猜测效果很差。 |
| source | string | 否 | 来源标识符(例如 user_chat、doc.pdf)。 |
| timestamp | number | 否 | 该事实成立时的 Unix 秒数。默认为当前时间。 |
详细介绍
nanomem



一个用于存储会变化的信息的嵌入式存储。
应用记住的信息不是文档。它会被更正——人们会搬家、换工作、更换电话号码。向量存储会保留两种说法,并返回措辞与问题更相似的那一种,因此助手可能会信心十足地重复你两年前就已弃用的地址。nanomem 会保留整个变更链,并知道哪一端才是当前信息。
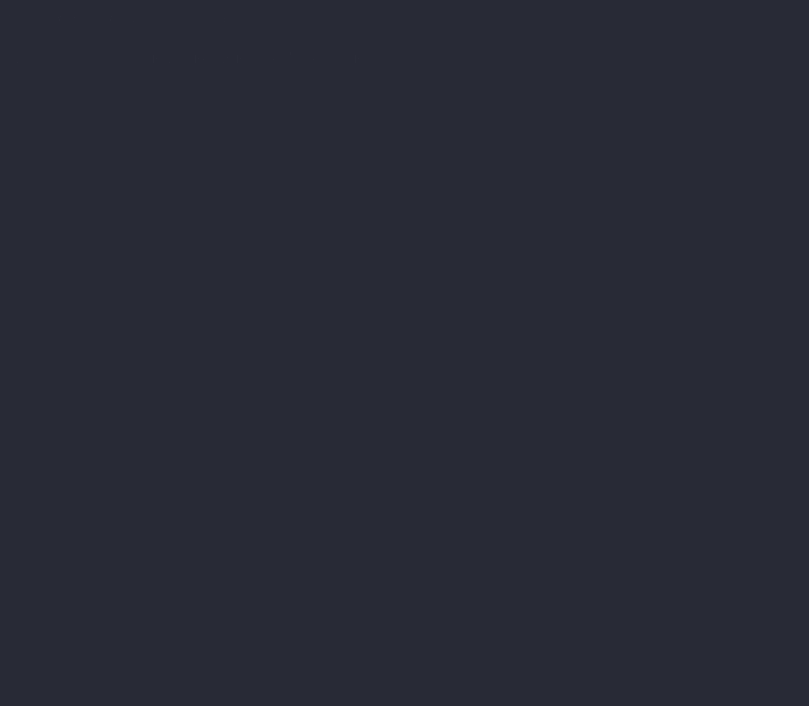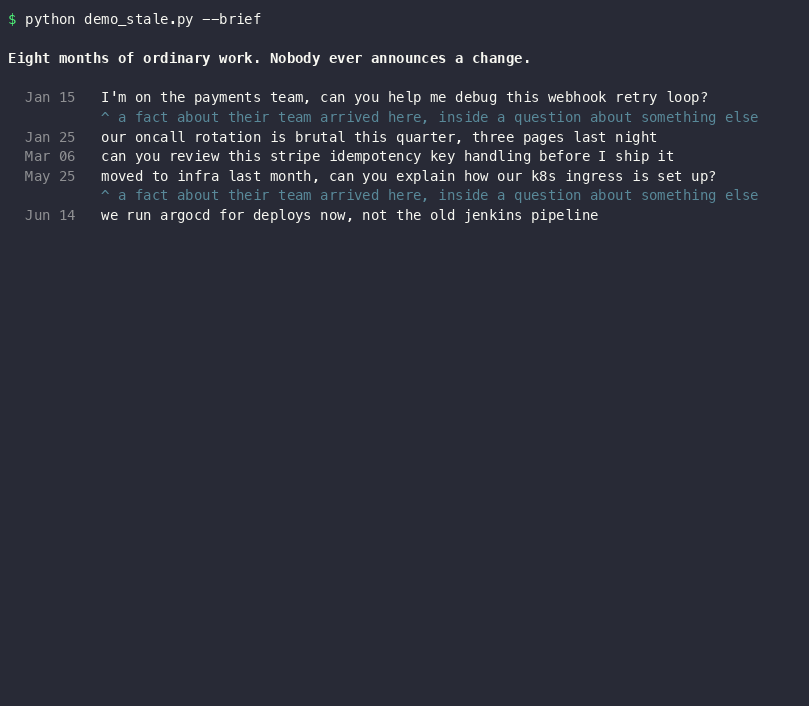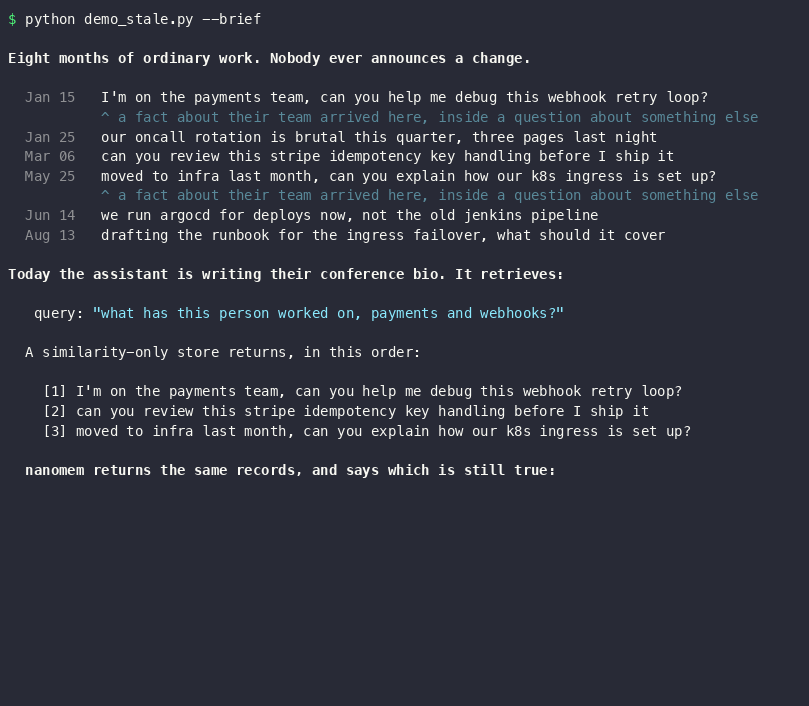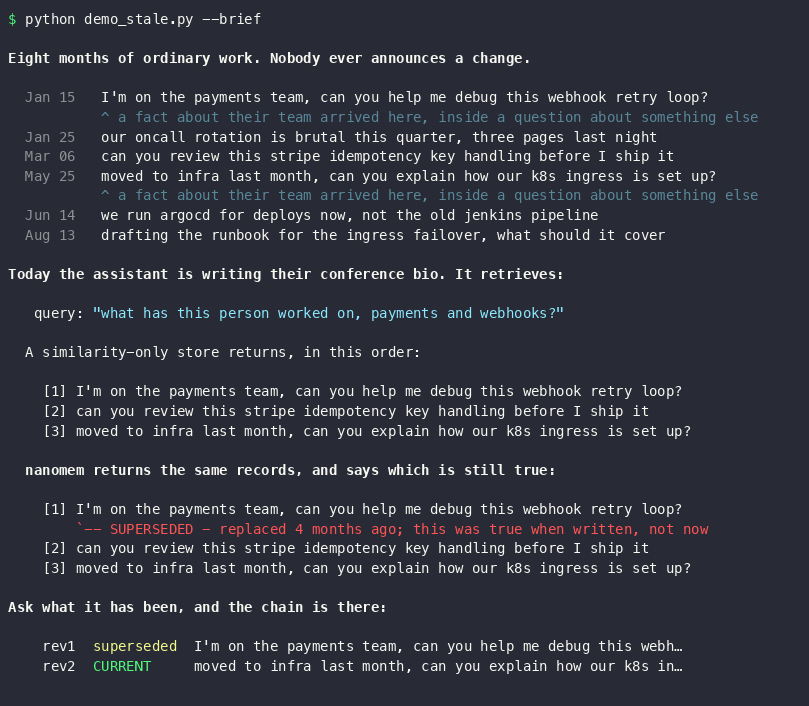
八个月的日常对话;团队信息只在闲聊中变更过一次。相似度仍会把旧信息排在第一位,因为问题的措辞更像旧工作——于是 nanomem 会给出它,并标明状态,而不是假装它没问题。这是针对本地 Ollama(nomic-embed-text)运行 demo_stale.py 的真实结果;运行 python3 assets/record_demo.py 可重新生成。这个标记并非来自模型:即使无法连接任何嵌入端点,运行同一个演示时仍会出现 SUPERSEDED 行,因为它是根据修订顺序而非相似度计算得出的。
证据 — 与 FAISS、sqlite-vec 和 Chroma 的比较(包括表现较差的方面)、进程在写入期间被终止时会发生什么,以及可在刚安装的副本上重新验证大部分结论的 pytest 命令。
快速开始 — 为助手提供一份了解变化的记忆
pip install nanomem
将此内容添加到 MCP 客户端的配置中。在 macOS 上,claude_desktop_config.json 位于 ~/Library/Application Support/Claude/:
{
  "mcpServers": {
    "nanomem": {
      "command": "nanomem-mcp"
    }
  }
}
配置就这么多。保险库默认位于 ~/.nanomem/memory.dat;设置 NANOMEM_VAULT,或传入 --vault /some/path.dat,即可将其放到其他位置。
重启客户端,然后告诉它一些以后会发生变化的事情:
“记住,我在 Acme Corp 工作。” (一周后) “其实我搬走了——现在在 Globex 工作。” “我在哪里工作?之前又在哪里工作?”
它会回答 Globex,并告诉你以前在 Acme 工作——这不是因为第二句话的措辞更接近问题,而是因为 nanomem 保留了变更链,并知道哪一端才是当前信息。问它*“我在三月份对此有什么看法?”*,它也能回答。
七种工具:nanomem_add、nanomem_search、nanomem_history、nanomem_as_of、nanomem_changes、nanomem_volatility、nanomem_stats——让助手能够询问某条信息曾经是什么、记忆在过去某个时刻相信什么、上周发生了什么变化,以及它自己的哪些认知已经过时。
保险库是一个普通文件。将 CLI 或 Python 脚本指向相同路径,即可读取助手写入的内容——回复发出前,数据就已写入磁盘,因此其他进程能立即看到,停止服务也不会导致数据丢失。
在 0.7.17 及之前的版本中,情况并非如此:服务只会在正常退出时写入,而 MCP 客户端会通过 SIGTERM 停止其服务。二十次 nanomem_add 调用,每次都回复了 "Stored …",随后收到 SIGTERM,保险库中却留下了零行。如果你运行的是早期版本,那么在未正常关闭的会话中,助手“记住”的任何内容都从未写入。
或在 Python 中使用
pip install nanomem
import time
from nanomem import Vault

DAY, now = 86400, time.time()
job = {"entity": "employer"}

v = Vault("memory.dat")
v.add("I work at Acme Corp.",                    metadata=job, timestamp=now - 300*DAY)
v.add("I moved jobs, I now work at Initech.",    metadata=job, timestamp=now - 155*DAY)
v.add("I switched again, I work at Globex now.", metadata=job, timestamp=now - 10*DAY)

print(v.search("where do I work")[0]["text"])
# I switched again, I work at Globex now.

for r in v.history("where do I work"):
    print(r["revision"], r["superseded"], r["text"])
# 1 True I work at Acme Corp.
# 2 True I moved jobs, I now work at Initech.
# 3 False I switched again, I work at Globex now.

print(v.search("where do I work", as_of=now - 200*DAY)[0]["text"])
# I work at Acme Corp.

f = v.volatility()[0]
print(f["entity"], f["n_revisions"], round(f["median_interval"]/DAY))
# employer 3 145
磁盘上只有一个文件。只有一个运行时依赖(numpy)。无需服务、守护进程,也无需重建索引。搜索是精确的——执行完整的余弦扫描,而不是使用近似索引——因此召回率按设计就是 100%,所有值得关注的问题都与时间有关,而非排序。
它会告知答案何时被截断
search 最多返回 top_k 条记录。现在它还会告知你遗漏了什么;对于无法查看的模型调用方,这一点尤为重要:
r = vault.search("revenue of every company in every year", top_k=3, min_score=0.6)

len(r)                      # 3   — it is a list; every existing caller is unchanged
r.truncated                 # True
r.n_above_floor             # 21  — how many cleared your min_score
r.explain()                 # "This answer is incomplete -- showing 3 of 21 records
                            #  scoring at or above your min_score of 0.60. ..."
对于多部分问题,有用的数字是哪些部分完全没有结果:
r = vault.search("What is Acme revenue? ... What port does staging use?")
r.unanswered_sub_queries    # the clauses that got no slot
如果没有截掉任何有用信息,explain() 会返回 "",因此可以放心地无条件追加——MCP nanomem_search 工具正是这样做的。
只有设置了 min_score 时才会提示。 默认值 0.0 会让每条记录都达到门槛,因此“显示 101 条中的 3 条”对所有曾经提出的查询都成立,包括答案实际只有一条记录的查询。每次都会触发的信号毫无意义。无论如何,计数仍保存在 r.n_above_floor 中。
这些计数无需额外开销:扫描本来就是穷尽式的,因此在应用 top_k 的那一行,这两个数字已经存在,只是之前被丢弃了。
它会标记不再成立的答案
时间戳能说明记录何时被写入,却无法说明它是否仍然成立——十年前写下的事实可能至今仍然有效,而上周写下的事实也可能已经失效。两者的区别在于,之后是否有记录取代了它;修订链知道这一点。
搜索一条已发生变化的事实时,你会得到它的多个值,因为链本来就是如此。现在每个值都会标明自己的状态:
for h in vault.search("where do I work", top_k=3):
    print(h["superseded"], h["text"])
# False  I switched again, I work at Globex now.
# True   I moved, I work at Initech.
# True   I work at Acme Corp.
ask() 会将这一信息放入提示词,因此模型在生成内容前就会知道哪些事实已经失效;MCP 工具则会在助手读取的文本中标记它们:
[2] (2025-08-17) [SUPERSEDED - replaced 8 months ago; this was true
    when written, not now]: I moved, I work at Initech.
一条十年间从未变化的事实不会带有任何标记。对于不属于任何链的记录,superseded 为 None——而不是 False,因为“没有任何内容取代它”在这里是未知,而非确定为真。
说明属性是什么
上面的 metadata={"entity": "employer"} 确实发挥了作用,值得专门用一段说明,因为这里很少有其他内容比它更重要。
写明属性名称后,nanomem 就知道这三条陈述属于同一条事实,因此会将它们保留为一条链。省略属性名称时,词法标注器会根据文本进行猜测——在每组 100 条链的测试中,对于措辞直白的链,70 组中的每条链都获得了相同且正确的标签;而对于叙述式措辞,100 组中一组都没有。在上面的例子中,它会把 “I moved jobs, I now work at Initech.” 标记为 location 而不是 career,因为 “moved” 的影响压过了 “work at”,导致这条链悄无声息地分成两条。
因此,如果你的应用有自己的属性,请将它们声明出来。nanomem 相比向量存储所具备的所有优势,都建立在它能识别哪些陈述谈的是同一件事之上——而你知道这一点,标注器却只能猜测。
软件包 0.8.3 · 引擎 3.4.6 · 容器格式 3 · arena 缓存格式 4。
许可证:Apache-2.0。 可用于商业用途、修改,也可随闭源产品一同发布——再分发时保留 LICENSE 和 NOTICE 文件,说明你做了哪些修改,并且不要使用项目或作者的名称为你的产品背书。义务仅此而已。
从 0.6.0 到 0.7.22,nanomem 使用 AGPL-3.0-or-later,并同时提供商业许可证。这种组合所保护的东西,价值还不如它劝退的用户:大多数公司会依据政策禁止使用 AGPL,许多开发者也会不看条款就避开它。按照旧条款分发的副本仍受旧条款约束,两份已被取代的文本也仍随项目一同提供—— LICENSE.agpl-3.0-or-later.md 和 LICENSE.preview-v1.0.md。 在 0.6.0 之前,wheel 元数据标明 Apache-2.0,而 LICENSE 文件却写着 All Rights Reserved;这一矛盾已在 0.6.0 解决,此后一直保持一致。
运行演示
cd nanomem_standalone
python3 demo.py          # stores, updates, searches, prints real stats()
python3 demo_stale.py    # the one worth seeing: a fact going stale over 8 months
在任一命令后添加 --brief,即可省略解释性文字,只保留计算结果;文件顶部的录屏展示的就是这种效果。
demo_stale.py 展示了 8 个月的日常工作记录,没有人明确宣布过变更——团队信息出现了两次,而且两次都在讨论其他事情的问题中提到。随后,助手撰写了一份简介;由于问题的措辞像是在谈论旧职位,相似度搜索把旧团队排在首位,而 nanomem 返回该信息时标记为 SUPERSEDED - replaced 4 months ago。打印的每一行都是计算得出的;编辑文件顶部的工作记录,然后重新运行即可。
它会存储一些事实,更新其中一条以展示修订处理,使用引用进行搜索,并打印知识库真实的 stats()——文档数量、文件大小、实测的 active_heap_ram_kb,以及文件是否加密(默认不加密)。
运行测试
python3 -m pytest -q
共 845 项测试,无需联网。
这里没有 test_security.py。本 README 的早期版本曾告诉你运行该文件来“证明磁盘上不存在任何明文”;但这个文件从未存在过,而且这种说法本身也是错的——除非你为知识库设置密码,否则它就是一个明文文件。你可以自行检查:
python3 -m nanomem.cli init demo.dat
python3 -m nanomem.cli add "the office wifi password is hunter2" --vault demo.dat
strings demo.dat | grep hunter2          # plaintext vault: it is there
python3 -m nanomem.cli rekey --vault demo.dat --new-password-stdin
strings demo.dat | grep hunter2          # password mode: it is not
在自己的脚本中使用
from nanomem import Vault

with Vault("my_knowledge.dat") as vault:            # plaintext by default
    doc_id = vault.add("Server backup runs daily at 02:00 UTC")
    vault.add("The staging database is on port 5433")

    hits = vault.search("When does the backup run?")
    print(hits[0]["text"], hits[0]["cosine"])
add() 会返回文档 ID,之后你可以通过该 ID 执行 get、update 或 delete。对于加密知识库,请传入 password="…"(或设置 NANOMEM_PASSWORD)。
**嵌入模型由你选择。**默认使用本地兼容 Ollama 的守护进程上的 nomic-embed-text,但任何维度的任何模型都适用——系统会从模型本身探测维度,并根据返回结果设置知识库的大小:
Vault("m.dat", embed_model="all-minilm")                    # 384-d
Vault("m.dat", embed_model="mxbai-embed-large")             # 1024-d
Vault("m.dat", embed_model="text-embedding-3-small",
      base_url="https://api.openai.com/v1/embeddings")      # 1536-d
Vault("m.dat", embedder=MyOwnEmbedder())                    # anything with
                                                            # .embed/.embed_batch/.dim
通过 base_url= 或 NANOMEM_EMBED_URL 将其指向任意地址。向 EmbeddingProvider 传入 dim= 可完全跳过探测(适用于气隙安装)。现有知识库的维度始终优先于你请求的维度,因此之后指定不同模型不会悄悄破坏知识库——系统会发出警告,文件也会保留自身维度。但此时该句柄只能部分使用:编码器仍是你指定的模型,因此每个需要生成新向量的调用——add、update(text=)、search、history——都会报错,直到你使用与文件维度相符的模型重新打开。读取仍可用,delete、prune、compact 和 forget_superseded 也仍会运行并重写文件,其行为与通过匹配维度的句柄操作完全相同(对 8 项操作进行测量,0 项存在差异)。直到 0.7.20 版本,文档都写着“每个调用都会报错”,这导致一位审阅者将正常的 prune 误认为会悄悄销毁数据。不会丢失任何内容,但系统也不会默默继续运行。
没有守护进程时,系统会使用一种回退方案,了解其原理很有必要:一个确定性的词法编码器,维度为 768-d——对单词和字符三元组进行哈希,不包含语义信息。它对 "the server is up" 和 "the server is down" 的评分为 0.783,对 "I drive a car" 和 "I own an automobile" 的评分为 0.286。反义词看起来相同,同义词则像是毫无关联。它能让处理流程在离线状态下继续运行,也适合冒烟测试;但不能替代嵌入模型,而且没有捆绑任何神经网络权重。
它与向量存储有何不同
nanomem 是一个只追加日志,因此它会保留事实曾经拥有过的每个值,而不只是当前值。因此,下面有四个问题可以得到解答,而向量索引无法表示这些问题,因为它们都不保留历史记录来查找答案。
with Vault("memory.dat") as v:
    v.history("where do I work")          # every value, oldest first, current last
    v.search("where do I work",
             as_of=1735689600.0)          # the answer as the memory stood back then
    v.changes(since=1735689600.0)         # what was written in a window, no query
    v.volatility()                        # how often each fact actually changes
在 Python 中,as_of 和 since 使用 Unix 时间戳;下方的 CLI 也接受 YYYY-MM-DD。history() 会返回每个值及其时间戳和 superseded 标志;最后一条是当前值。未曾更改的事实会返回一条记录,这是一个答案,而不是空结果。
volatility() 值得关注。它会读取修订日志,并按事实报告该事实被重述的次数、变更之间的典型间隔,以及当前值未经确认已持续多久——这样 Agent 就能判断自己的哪些信念已经过时,并再次询问:
fact             restated   changes every   last confirmed
mobile_phone            4          195 d           2237 d   ← ask again
employer                3          807 d             47 d
无需模型,也无需查询:直接对两个常驻列中的时间戳求差,不经过搜索路径。staleness() 会将其转换为概率,但除非传入 assume_memoryless=True,否则会返回 None——只有在数据按其自身假设生成时,按事实计算的速率才优于单一的全语料速率,因此默认不启用(evidence/staleness_calibration.json)。
这项功能的限制。 只有当 nanomem 能判断两条记录属于同一事实时,才会将它们视为同一事实;这需要词汇表或查询——对五种不依赖词汇表的信号进行了测量,它们在区分家庭地址和办公地址等同类属性时,表现都与随机猜测无异(evidence/grouping_signal_results.json)。使用规范表述时,一条链中的所有成员在 100 条链中有 70 条获得相同且正确的标签;使用叙述式表述(“周末把这条线路迁过去了,联系我请拨打……”)时,100 条链中则为 0 条(evidence/temporal_drift_results.json)。如果你的应用了解自身的属性,请声明这些属性——写入时传入 metadata={"entity": "employer"},并设置 group_floor_sim=0.45;在标签器最难处理的这类表述中,top-1 准确率可提高 19.0 个百分点(floor_retune_results.json)。如果依赖标签器,则不要改动这两项设置;相同设置会使准确率降低 13.9 个百分点。
凡是写入数据的地方都应声明。Python 中使用 metadata={"entity": ...},MCP 的 nanomem_add 工具中使用 entity,nanomem add 中使用 --entity。在 0.7.12 之前,后两种方式尚不存在,因此大多数调用方集成的两个接口只能依赖标签器,却没有任何提示说明这一点。
无法声明属性时要付出的代价。 对于标签器推断出的分组,search 和 history 可能会对哪个值是当前值产生分歧:history 会解析带标签的链并读取修订计数器,而 search 还会应用相关性下限;如果最新值的表述与问题的匹配程度不如较旧值,就可能被过滤掉。曾测量并否决了对推断分组中最新成员的豁免方案——在 3 个 persona 的聊天数据集上,这会造成 -19.4 个百分点的损失;从 0.40 到 0.80 的扫描也未找到能兼顾两者的阈值(evidence/floor_current_value_results.json)。因此,这是有意的权衡,并非疏忽。
0.7.12 在这里称 history 是权威来源,应优先于 search。这是错误的,该说法已撤回:history 本身也可能返回比实际更短的链,最糟糕时只返回一条标记为 superseded=False 的记录,而本库将其定义为“此事实从未改变”。这一截断问题已在 0.7.14 和 0.7.15 中修复——现在声明过的链会返回其包含的每个修订版本,changes() 也与之保持一致。
剩下的问题是两者仍会产生分歧。在 0.7.16 之前,本节曾写道**“声明实体后,分歧就会消失”**,依据是三条链都得分 3/3(evidence/entity_declaration_results.json)。第三次独立黑盒审查发现了一条已声明实体但仍会产生分歧的链,因此该说法是错误的;此前的测量也无法发现问题所在:在那三条链中,每个修订版本都会重述该属性(“我现在在 Initech 工作”),这使链中的成员彼此接近。当修订版本 1 写明属性,而后续修订版本只是隐含提及它时——例如先说“我的办公桌在 Kestrel House 的三楼”,再说“现在搬到了 Maple Wharf 大楼”——各成员之间的差异就会变大,而用于提升当前值的增益被限制在不足以应对这种差异的范围内。即使已声明实体,search[0] 仍返回了两次变更之前的办公桌位置,而 history() 返回了正确的位置。
0.7.16 在涵盖八个 arms 和两个 embedders 的 sweep 中提高了该上限
(evidence/revision_lead_cap_results.json)。针对导致问题的表述进行测量,共十二条链,每条链单独存放在自己的 vault 中,涵盖两种时间戳模式:
已声明的链,search top-1 == history 的当前值 | 0.7.15 | 0.7.16 |
|---|---|---|
| 后续修订隐式引用,真实模型(24 个案例) | 41.7% | 100.0% |
| 使用离线 fallback encoder 的相同链(12 条) | 25.0% | 75.0% |
| 表述漂移,生成的数据集(100 条) | 71.0% | 100.0% |
而 left to the tagger 仍为 2/3,没有变化,且仍只在三条链上测量
(evidence/entity_declaration_results.json)。
声明实体是让链可解析的关键;在真实的 embedding 模型上,它也能让这些数据集中的 search 和 history 得出一致结果。
但这并非保证。在此处测量的十二条离线 encoder 链中,所有剩余失败的原因都相同:该 encoder 采用词法匹配,最新修订与问题相距太远,相关性筛选会将其从结果中完全剔除,因此无论排名加权多高,都无法提升一条从未返回的记录
(6 次失败中有 6 次如此,见 revision_lead_cap_results.json 中的 arm H)。
这是此语料中的原因,并非唯一可能的原因。一位独立审查者构建了形态相同的链,测得了另一种失败:最新修订确实被返回,加权也已应用并达到 max_boost 上限,但要让它排在链首所需的提升幅度(约 0.68)仍超过 0.60 上限。提高上限可以解决这类问题,却无法解决此处测得的问题,因此已公布的 sweep 显示该 arm 从 0.60 到 1.50 均无变化。形态相同的两个语料在词法 encoder 上也可能相差很大,因此应将 75.0% 视为实际结果——这是对十二条链的测量,而非 fallback 的固有属性。tests/test_revision_lead_cap.py 会在所检查的数据集中达到上限时失败。可通过 changes() 查看未筛选的结果进行交叉核对。
基于它构建 RAG
检索是核心;生成是可选的,且不需要额外依赖
(使用标准库 urllib,连接到你指定的任意 endpoint)。
v.search("what port does staging use?", top_k=3)     # retrieval only
v.ask("What port does staging use?", llm="llama3.2") # -> {question, answer, citations}
v.ingest_file("runbook.md")                          # chunk + store a document
nanomem proxy 还会提供一个兼容 OpenAI 的 /v1/chat/completions,并注入记忆,因此现有应用可以将 nanomem 用作 provider 的替代,而无需更改代码即可获得记忆功能。
Providers。 将 base_url= 和 api_key= 传给 ask()/chat(),或在 Vault 上设置它们。基础 URL 决定请求格式:
| Ollama(默认) | http://localhost:11434 → 原生 /api/generate |
| OpenAI、Groq、Together、Mistral、DeepSeek、OpenRouter、Fireworks | 任意以 /v1 结尾的基础 URL |
| LM Studio、vLLM、llama.cpp | :1234、:8000、:8080 |
| Anthropic | https://api.anthropic.com/v1 → /v1/messages,x-api-key |
| Azure OpenAI | 传入以 /chat/completions 结尾的完整部署 URL |
Embedding 来自 NANOMEM_EMBED_URL(默认使用 Ollama 上的 nomic-embed-text)。路由根据解析出的端口决定,而不是根据 URL 中的子字符串决定——在 0.6.1 之前,主机名为 web8000.internal 的服务器会被错误路由,向 Anthropic 发送的 POST 请求也会发往 /v1/chat/completions,从而导致 404。
CLI
python3 -m nanomem.cli init company.dat
python3 -m nanomem.cli add "DB port is 5433" --vault company.dat
python3 -m nanomem.cli search "DB port" -k 3 --vault company.dat
python3 -m nanomem.cli history "DB port" --vault company.dat
python3 -m nanomem.cli search "DB port" --as-of 2026-03-01 --vault company.dat
python3 -m nanomem.cli changes --since 2026-01-01 --vault company.dat
python3 -m nanomem.cli stats --vault company.dat
python3 -m nanomem.cli rekey --vault company.dat --new-password-stdin
add 会打印文档 ID 及其自身耗时。
实测表现
搜索是精确线性扫描。对于扫描的文本,它返回的结果与穷举 fp32 余弦扫描相同——在包含 1,190 个文档的语料库中,120 个 top-4 排序没有一处差异(evidence/exactness_v3r2.json)——因此其延迟会随语料库增大而增长。
它扫描哪些文本取决于 decompose,该参数默认为 True。 多子句问题会被拆分,每个子查询都会进行穷举扫描,然后将最佳命中交错排列——因此结果是每个子句各自的穷举答案,而不是整个句子的穷举 top-k;对于多子句问题,两者并不相同。拆解的目的就在于此:让双部分问题的两部分都得到回答。如果希望将整个字符串视为单个查询,并让上述精确性声明从头到尾都适用,请传入 decompose=False。
| 语料库 | p50 | recall@4 | 与穷举 numpy 结果相同? | 与 FAISS flat 结果相同? | 索引 | 每个文档的 RSS |
|---|---|---|---|---|---|---|
| 1,190 | 0.052 ms | 68.3 % | 是 | 是 | 2.5 MB | — |
| 10,000 | 0.345 ms | 70.4 % | 是 | 是 | 22.0 MB | 8.4 KB |
| 71,433 | 1.762 ms | 60.6 % | 是 | 是 | 155.9 MB | 8.8 KB |
evidence/scale_results_v3r4.json、headtohead_v3.json、
rss_v3r4.json。测量环境为 Apple M4 Pro / Python 3.12、nomic-embed-text
768-d,随机插入顺序,500 个留出问题,摄取 → 关闭 → 重新打开
→ 搜索。(本文档中的所有 evidence/… 路径均相对于代码仓库根目录,而非当前文件夹;JSON 文件及生成它们的脚本都位于该目录中。)
“与穷举结果相同”列表示召回率。在 1,190 个文档时,排序也完全一致(120 个 top-4 排序没有一处差异);在 10,000 和 71,433 个文档时,少数平局的破局结果有所不同——分别是 500 个问题中的 2 个和 5 个,最大余弦差为 2.2e-05——这是因为磁盘上的向量采用 fp16 格式(evidence/verify_round3_v3r3.json)。
分数在同样意义上是精确的,不能再进一步保证:形状不同的两个 float32 矩阵乘法会以不同顺序进行归约,因此,不同 BLAS 实现为某个命中附带的分数,最后一两位可能不同——在同一查询上测得 Apple Accelerate 与 OpenBLAS 的差异为 2.98e-08,即两个 ulp。答案不会因此改变。对于 128 和 768 维的 4,000 个文档,最坏的 |fp32 − fp64| 误差为 2.01e-07,而第 4 名与第 5 名之间的最小差距为 4.46e-06——大 20 倍——且在 k = 1、4 或 10 时,150 个查询中没有任何一个无法判定(evidence/screen_exactness_results.json)。因此,“返回穷举扫描所返回的结果”指的是哪些文档会返回,以及它们的顺序——但对于排名确实无法区分的文档除外,因为语料库中没有可用于忠实决定其先后的依据。这并不是对旁边浮点数的位模式的承诺,而且永远也不可能是。
常驻内存约为每个文档 8–9 KB。早期文档曾声称内存占用“< 500 KB RAM”或“160 KB 活跃堆”;这些数字是 stats() 输出的常量,并非测量结果,现已删除。
随着知识库增长,写入耗时保持稳定:4,000 次新增中,前 500 次的平均耗时为 19.81 µs,最后 500 次为 19.32 µs,不含嵌入计算(evidence/headtohead_v3.json)。
删除一条记录会执行完整的原子重写——1,000 条记录时耗时 7.5 ms,10,000 条时耗时 70.5 ms(evidence/rewrite_cost_v3r4.json)。3.0 中没有墓碑。
文档
- USER_MANUAL.md — 中心入口,以及完整的实测性能表
- USER_MANUAL_PERSONAL.md — 聊天、个人资料、隐私
- USER_MANUAL_DEVELOPER.md — SDK、CLI、并发、迁移
- SERVICES_AND_API_SPECIFICATION.md — REST 端点和限制
- MULTIHOP_REASONING_AND_TOPOLOGY_GUIDE.md — 桥接,以及未能奏效的内容
- CHANGELOG.md — 0.1.x 的破坏性变更
依赖可选的密码模式前,请先阅读 nanomem.THREAT_MODEL。该模式使用 scrypt + SHAKE256 密钥流 + HMAC-SHA256 标签,基于 Python 标准库构建。它不是 AES,不是“256 位加密”,也未经审计。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。