关于 Tekmeria
Tekmeria 是面向 PubMed、Europe PMC、ClinicalTrials.gov 和 openFDA 生物医学证据的 MCP 服务。它为段落签发经过认证的句柄,并审计引用是否真实、引文是否逐字匹配,但不判断证据是否支持论点。
主要功能
- 01搜索生物医学证据来源
- 02签发经过认证的段落句柄
- 03审计引用来源与引文
- 04标记撤稿和版本变化
- 05报告未引用句子及审计结论
- 06运行离线录制演示
适用场景
- 01核查生物医学回答中的引用
- 02评估问答 Agent 的引用行为
- 03验证引文是否与来源匹配
- 04查看逐句引用审计结果
MCP 相关
通过 MCP 工具、资源和提示词提供生物医学证据检索与引用审计。审计检查已签发句柄及引文准确性,不判断段落是否支持论点。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
uvx tekmeriaNCBI_API_KEY密钥Raises the PubMed limit from 3 to 10 requests per second.NCBI_EMAILContact address NCBI asks for; sent only when set.OPENFDA_API_KEY密钥Raises openFDA's daily limit from 1,000 to 120,000 requests.CROSSREF_MAILTOPuts Crossref requests in its polite pool; sent only when set.本地服务需要在你的电脑上安装运行环境(如 Node.js 18+)。各客户端的配置文件位置不同,请参考客户端文档。
工具
7收录的工具列表 · 更新于 2 周前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| limit | integer | 否 | |
| query | string | 是 | 布尔搜索词。PubMed 字段标签(如 [tiab])仅搜索 PubMed;此时会跳过 Europe PMC,并报告服务降级。 |
| cursor | any | 否 | |
| date_to | any | 否 | YYYY or YYYY-MM-DD |
| sources | any | 否 | 默认值:both。重复项会合并。 |
| date_from | any | 否 | YYYY or YYYY-MM-DD |
| study_designs | any | 否 | 取自 MEDLINE 出版物类型 |
| open_access_only | boolean | 否 | |
| exclude_retracted | boolean | 否 | |
| peer_reviewed_only | boolean | 否 |
详细介绍





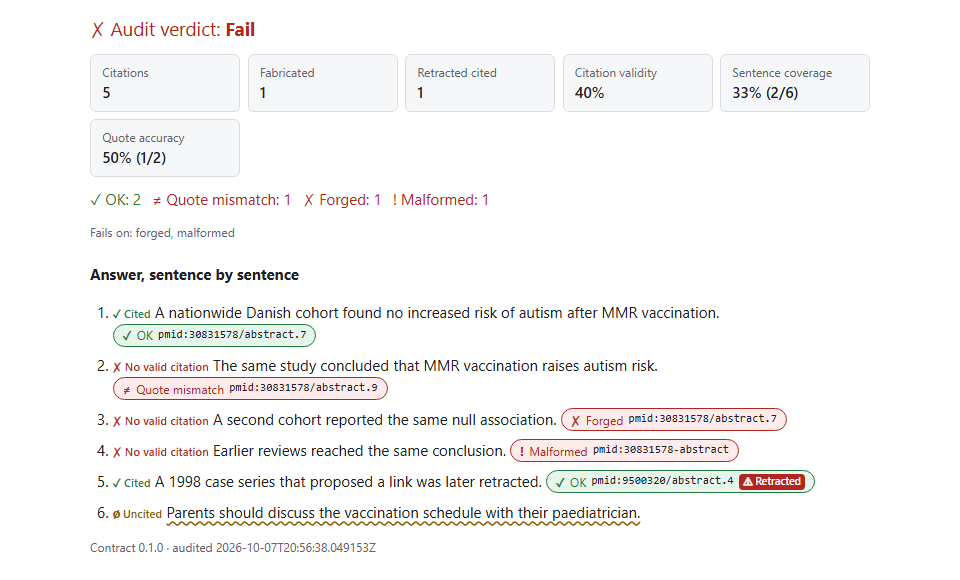
离线演示中的审计视图:每个句子都有状态,每条引文都有判定。该答案因包含一条伪造引文和一条格式错误的引文而未通过。
概述
Tekmeria 是一个 Model Context Protocol 服务,提供来自 PubMed、Europe PMC、ClinicalTrials.gov 和 openFDA 的生物医学证据。它返回的每段内容都带有一个简短句柄,例如 pmid:30831578/abstract.7~ae2tc,其末尾的校验码只有此安装实例能够计算。模型引用这些句柄,随后进行确定性审计,展示哪些引用真实有效、哪些指向已不存在的文本,以及哪些引文并非逐字引用。该项目面向构建或评估生物医学问答 Agent 的人员,以及希望提供用户可核验引用的 MCP 主机开发者。
回答生物医学问题时附带引用的语言模型,可能会引用不存在的论文、错误转述真实存在的论文,或引用已撤稿的研究。问题如今已蔓延至文献本身:一项对 250 万篇开放获取文章的审计发现,2023 年每 2,828 篇论文中就有 1 篇存在伪造引用,而 2026 年初这一比例升至每 277 篇中有 1 篇(Topaz et al., The Lancet, 2026)。答案写出后再进行的检查,必须判断不完全匹配的书目信息是否对应正确的研究。Tekmeria 将这一保证移至工具服务中。发放内容片段的服务同时签发其引用,因此核验时会对照已签发的内容,而不是通过搜索来查找。
审计检查来源和引文是否准确,而不检查内容是否支持结论。某段内容实际上是否支持其所对应的主张,会标记为
not_checked:tekmeria 将问题限定为确认内容真实且引文准确,并不判断其是否支持主张。逐字引用也不能解决这个问题:在对 12 个模型的评估中,逐字引用经常无法充分支持其主张(Zhang et al.)。
该项目不参与争夺覆盖范围的竞赛。BioMCP 已覆盖约 70 个生物医学数据源,而检索本身帮助有限:生物医学 RAG 相较于不使用检索,通常只提升 1 到 2 个百分点(Nourbakhsh et al.)。模型往往在引用上出错:
- 在要求模型引用时,Ahmed et al. 中表现最好的模型给出的 PMID 只有 15.3% 相关,其余大多对应真实存在但属于无关领域的论文;
- 在 Chen et al. 中,当强化学习只奖励正确答案时,医疗 Agent 的引用伪造率从 16.5% 升至 31.8%。
协议也指向同一方向:2026-07-28 MCP 修订版指出,需要在多次调用之间保持状态的服务应使用“显式、由服务签发并作为普通工具参数传递的句柄”。
其他项目也选择信任工具,而非模型。Agent 运行时可以为每次工具调用签发签名回执,并核验引用该回执的主张(Basu);渲染器可以仅在数值与其所指记录相符时将其标记为已验证(Solatorio);通过 MCP 访问的基因组编写工具层则要求每个数值都必须来自经过验证的工具(Ali et al.)。Tekmeria 将这一理念应用于生物医学内容片段的引用:模型写出的句柄本身经过了认证,因此无论答案由哪个模型或 MCP 主机编写,签发句柄的服务都能仅凭自己的密钥进行核验。
状态。 研究软件,版本 0.1.1。引用约定单独进行版本管理,当前为 0.1.0;当版本号处于 0.x 时,任何不兼容变更都会提高次版本号。变更记录见 CHANGELOG.md。技术说明介绍了设计和评估:10.5281/zenodo.23374728。
快速开始
你需要安装 uv(如果需要,它会安装合适的 Python)。无需 API 密钥。运行一条命令即可使用记录的响应运行离线演示,并在浏览器中打开其审计报告:
uvx tekmeria demo --open
要在聊天中使用 tekmeria,请将其添加到 Claude Desktop 或 VS Code 等 MCP 主机:参见用法。该命令会从 PyPI 安装已发布的软件包。若要改为运行开发版本,请使用 uvx --from git+https://github.com/PedroMarkovicz/tekmeria tekmeria,或将本地克隆路径传给 --from。
结果
这项评估是一项符合性测试:它植入已预先确定正确判定结果的引文,并检查审计是否按照规范作出判定。使用种子 0,每个类别 25 个用例:
| 检查项 | 衡量内容 | 结果 |
|---|---|---|
| 植入的引文 | 34 个类别中的 850 个用例,分别作为结构化声明和回答文本进行审计(其中 4 个类别仅使用一种形式) | 1,600 / 1,600 次审计正确 |
| 完整回答 | 多句回答中每个句子的状态、每条引文、各项指标和整体判定 | 257 / 257 项正确 |
| 其他种子 | 种子 1 至 10,每个类别 25 个用例;种子 0 使用 200 个用例(12,800 次审计,1,832 个回答) | 全部正确 |
| 注入的故障 | 38 个人工挑选的故障:宽松的比较器、丢失的排版折叠、错误的报告规则 | 捕获 37 个 |
| 变异分析 | 对审计代码中的比较操作、布尔运算符和整数常量进行的 78 个变异 | 71 个被杀死:52 个导致结果错误,19 个导致崩溃 |
| 实时试点 | 在 Claude Desktop 中向前沿模型提问一次;两次运行中的第二次(第一次因说明中的示例句柄而失败) | 服务端发出的 16 / 16 条引文,4 / 4 条引文逐字引用;结果为 warn,21 个句子中有 8 个未附引文;未检查支持情况 |
这些结果都无法衡量模型伪造引文的频率,也无法判断引文中的段落是否支持对应的句子。参考判定器由同一作者依据规范编写,与审计代码分开编写,因此并非独立;完整回答由模板构建;故障也由作者挑选。模型在获得句柄后如何引用,将留待后续研究。完整评估及其输出见下文。
引文的工作原理
pmid:30831578/abstract.7~ae2tc
\__/ \______/ \________/ \___/
scheme  id      path     check code: HMAC of everything before the "~"
方案包括 pmid、pmcid、ppr、nct 和 setid;仅提供当前版本的注册表(试验和标签)会携带所引用版本的信息。模型会在声明后写入 [handle],或在引用数字和剂量时写入 [handle "exact words"]。随后,审计会根据第一个未通过的检查,为每条引文给出一个判定:
flowchart TD
    C["A citation: a handle, and perhaps a quote"] --> G{"Does it match the handle grammar?"}
    G -- "no" --> M["malformed"]
    G -- "yes" --> K{"Does the check code match this installation's key?"}
    K -- "no" --> F["forged"]
    K -- "yes" --> R{"Could the source be reached?"}
    R -- "no" --> U["unavailable"]
    R -- "yes" --> P{"Do the record and the passage still exist?"}
    P -- "no" --> W["withdrawn"]
    P -- "yes" --> Q{"A quote, and not verbatim in the text as issued or as it is now?"}
    Q -- "yes" --> X["quote_mismatch"]
    Q -- "no" --> O["ok, with flags: retracted, preprint, version_changed"]
如果可配置的 fail_on 列表中存在任何情况(默认是伪造或格式错误的引文),则整个回答的结果为 fail;否则,如果无法访问某个来源,则为 incomplete;否则,如果有任何句子未附引文、任何引文的状态不是 ok,或所引用的来源已撤回,则为 warn;其他情况下为 pass。每个句子也会获得一个状态:cited、uncited,或在其所有引文均非 ok 时标为 invalid_only。报告还会添加各项指标,包括引文有效性、句子覆盖率、引文准确度以及伪造引文的数量。完整规则见 docs/CONTRACT.md。
| 实践 | 本项目中的做法 |
|---|---|
| 验证标识符,而非文献相似度 | 使用带密钥的校验码:不匹配标题或作者,也不判断原本指的是哪篇作品 |
| 将服务中断与伪造区分开 | unavailable 和 withdrawn 是各自独立的判定,因此服务中断永远不会被算作伪造。破坏句柄语法的副本错误属于 malformed;保留语法的副本错误仍会显示为 forged |
| 精确比对引文中的数字和剂量 | 引文仅在经过 Unicode NFC 规范化、空白折叠,以及一份固定列表中的排版字符折叠和不可见字符移除后进行比对,不会采用更宽松的处理方式 |
| 报告未检查的内容 | 每条引文都带有 support: not_checked |
| 标记文献状态 | retracted、preprint 和 version_changed 描述来源的状态,不会改变判定 |
| 确保报告可复现 | 输入、密钥、上游内容和缓存相同,则报告也相同,时间戳除外 |
架构
该服务是一个精简的 MCP 层,构建在证据服务和纯粹的引文契约之上。
flowchart TB
    subgraph HOST["MCP host: Claude Desktop, VS Code, MCP Inspector"]
        MODEL["Model"]
        VIEW["Audit view<br/>an MCP App"]
    end

    subgraph SERVER["server/ : MCP layer"]
        TOOLS["7 tools, a prompt,<br/>2 resource templates"]
    end

    subgraph CONTRACT["contract/ : pure and typed"]
        CODEC["Handle codec<br/>HMAC-SHA256, 25-bit check code"]
        AUDIT["Citation parsing and the audit"]
    end

    subgraph SOURCES["sources/ : evidence service"]
        SVC["Routing, merging, time budgets,<br/>handle minting and resolution"]
    end

    subgraph UP["Upstream APIs"]
        APIS["PubMed, Europe PMC, PubTator3, Crossref,<br/>ClinicalTrials.gov, openFDA"]
    end

    INFRA["infra/ : keys, rate-limited HTTP,<br/>SQLite cache, recorded fixtures"]

    MODEL <--> TOOLS
    TOOLS --> SVC
    TOOLS --> AUDIT
    AUDIT --> CODEC
    AUDIT --> SVC
    SVC --> CODEC
    SVC --> APIS
    SVC --> INFRA
    AUDIT -- "report" --> VIEW
各层职责
| 层 | 职责 |
|---|---|
契约(src/tekmeria/contract/) | 句柄编解码器、证据和报告模型、引文解析及审计;纯粹且具有完整类型。schemas/ 中的 JSON Schema 从这些模型导出。 |
来源(src/tekmeria/sources/) | 每个上游服务对应一个适配器,每种记录来源对应一个解析器,以及用于路由请求、合并来源并为审计解析句柄的证据服务。 |
基础设施(src/tekmeria/infra/) | 设置、密钥、限流 HTTP 客户端、SQLite 缓存和录制式 fixture 传输。 |
服务端(src/tekmeria/server/) | MCP 工具、资源和提示词。审计视图(src/tekmeria/ui/audit-view.html)由 web/(React 和 TypeScript)构建并提交,因此运行 tekmeria 无需 Node。 |
设计见 docs/specs,构建过程中做出的决策及其原因见其中的第 16 节。docs/DESIGN.md 展示了从问题到经过审计的答案的流程、评估方式,以及从推送到发布的流程。
演示
tekmeria demo 使用录制的响应离线运行。它会搜索、获取两篇论文,并审计一个答案,其中植入了六种情况:正确引文、错误引文、伪造的校验码、格式错误的句柄、引用已撤稿论文,以及未引用的句子。以下是审计结果:
verdict: FAIL  (5 citations: 1 malformed, 1 forged, 1 quote_mismatch, 2 ok)
fabricated: 1  retracted cited: 1  cited sentences: 2/6  verbatim quotes: 1/2
[1] cited: A nationwide Danish cohort found no increased risk of autism after MMR vaccination.
    ok             pmid:30831578/abstract.7~ae2tc "During 5 025 754 person-years of follow-up, 6517 children were diagnosed with autism"
[2] invalid_only: The same study concluded that MMR vaccination raises autism risk.
    quote_mismatch pmid:30831578/abstract.9~wdbv3 "MMR vaccination strongly increases the risk of autism"
                   closest: "MMR vaccination does not increase the risk for autism" (0.8491)
[3] invalid_only: A second cohort reported the same null association.
    forged         pmid:30831578/abstract.7~ae2t0
[4] invalid_only: Earlier reviews reached the same conclusion.
    malformed      pmid:30831578-abstract
[5] cited: A 1998 case series that proposed a link was later retracted.
    ok             pmid:9500320/abstract.4~z567x [retracted]
[6] uncited: Parents should discuss the vaccination schedule with their paediatrician.
在聊天中
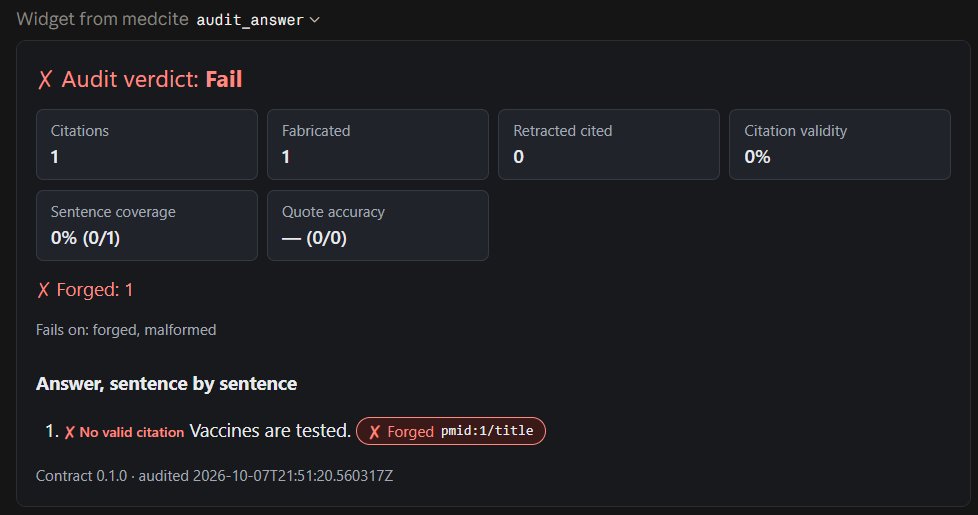
Claude Desktop 将 audit_answer 的结果显示为审计视图。此处展示的是一份引用了本服务从未签发的句柄的答案。截图拍摄时,项目使用的是第一个名称,组件的标题栏中显示了该名称。
一次真实运行
2026-10-07,Claude Desktop 中的模型按照 cite_by_handle 的说明回答了 “MMR 疫苗接种会导致自闭症吗?”,随后审计了自己的答案:
verdict: WARN  (16 citations: 16 ok)
fabricated: 0  retracted cited: 0  cited sentences: 13/21  verbatim quotes: 4/4
每条引文都真实可靠,每段引文都与原文完全一致。结果是警告,而非通过,因为有些句子没有引用。首次运行因一条伪造引文而失败,后来发现它是服务自身说明中的示例句柄;现已将其删除。两份对话记录及完整审计输出见 docs/live-run.md。
评估
tekmeria evaluate用于衡量审计的判定效果。它会在 34 个类别中植入正确结论已预先确定的引文:
- 真实引文,包括逐字引用,以及采用比较逻辑必须接受的排版变体的引文:空格、分解形式的重音符号、比较逻辑会折叠的所有破折号、撇号和引号,以及会移除的不可见字符;
- 只改动一处细节的引文:数字、小数点、比较符号、单位、负号、字母大小写、添加的重音符号、上标数字、删除的空格、插入的“not”或调换的单词;
- 伪造的核对码、路径和记录 ID,写在方括号外的伪造句柄、格式错误的句柄,以及写在引文内的注释;
- 不存在的段落和记录,以及已宕机的来源;
- 已撤回的论文、预印本和较早版本的记录;
- 藏在未闭合引号内的伪造句柄;
- 同一句中与真实引文并列的错误引用或已撤回记录引文。
案例的构建方式。
- 案例基于演示项目已记录响应中的 7 条真实记录(213 个段落)。
- 已撤回和不可用案例引用虚构路径、虚构记录,以及被视为无法访问的记录。
- 每个案例植入的内容由一个参考判定器决定,该判定器依据规范编写,且与审计不共享任何代码。但它并非独立:两者由同一位作者编写。
评分方式。
- 每个案例都会以结构化声明的形式和模型可能使用的某种引用格式的答案文本形式进行审计。裸句柄和隐藏句柄案例只对答案文本运行,而将引号嵌套在引文中的两个类别只对结构化声明运行。同一案例的两种审计使用相同的植入引文,因此并非独立观测。
- 只有当每条引文都得到植入的判定和恰好对应的标记时,案例才算通过。
- 这些案例也会写入由多个句子构成的完整答案。只有当每个句子的状态、每条引文、每项指标和最终判定都与植入内容一致时,完整答案才算通过。声明状态、指标或最终判定中的错误不会影响引文本身的判定,因此只有完整答案才能发现这些错误。完整答案分为三种:
- 混合:每次取四个案例,全部纳入,并添加标题、粗体引导语和无引文句子;
- 纯净:仅含真实引文,且应通过;
- 配对:从每个可写成答案文本的类别中,选取第一个案例(34 个类别中有 32 个),放在两个各自包含一条真实引文的句子之间,以便评估该案例对最终判定的影响。无论单独出现在一句中,还是与真实引文并列,引用不匹配或已撤回的引文都会产生
warn。
- CI 会在推送到
main和创建拉取请求时运行评估。
其输出如下,种子为 0,每个类别 25 个案例:
评估的完整输出:每个类别、判定、完整答案和记录
植入案例:1600/1600 正确(种子 0,每个类别 25 个;7 条记录,213 个段落) 完整答案:257/257 正确
| 类别 | 不同案例数 | 结构化声明 | 答案文本 |
|---|---|---|---|
ok_plain | 25 | 25/25 | 25/25 |
ok_quote | 25 | 25/25 | 25/25 |
ok_quote_reformatted | 25 | 25/25 | 25/25 |
ok_quote_apostrophe | 23 | 25/25 | 25/25 |
ok_quote_decomposed | 2 | 25/25 | 25/25 |
ok_quote_double_marks | 20 | 25/25 | - |
ok_quote_folded | 25 | 25/25 | 25/25 |
ok_quote_folded_marks | 25 | 25/25 | - |
ok_quote_invisible | 25 | 25/25 | 25/25 |
quote_number_changed | 25 | 25/25 | 25/25 |
quote_decimal_moved | 25 | 25/25 | 25/25 |
quote_comparison_flipped | 20 | 25/25 | 25/25 |
quote_unit_changed | 25 | 25/25 | 25/25 |
quote_sign_changed | 25 | 25/25 | 25/25 |
quote_case_changed | 25 | 25/25 | 25/25 |
quote_accent_added | 25 | 25/25 | 25/25 |
quote_compatibility_form | 25 | 25/25 | 25/25 |
quote_space_removed | 25 | 25/25 | 25/25 |
quote_negated | 25 | 25/25 | 25/25 |
quote_word_swapped | 25 | 25/25 | 25/25 |
forged_check_code | 25 | 25/25 | 25/25 |
forged_path_swap | 25 | 25/25 | 25/25 |
forged_record_id | 25 | 25/25 | 25/25 |
forged_bare | 25 | - | 25/25 |
malformed | 25 | 25/25 | 25/25 |
malformed_with_note | 25 | 25/25 | 25/25 |
withdrawn_path | 25 | 25/25 | 25/25 |
withdrawn_record | 25 | 25/25 | 25/25 |
unavailable | 9 | 25/25 | 25/25 |
retracted_cited | 5 | 25/25 | 25/25 |
preprint_cited | 2 | 25/25 | 25/25 |
version_changed | 25 | 25/25 | 25/25 |
hidden_in_quote | 25 | - | 25/25 |
invalid_beside_valid | 25 | 25/25 | 25/25 |
| 判定 | 植入数 | 检出数 | 精确率 | 召回率 |
|---|---|---|---|---|
malformed | 100 | 100 | 1.000 | 1.000 |
forged | 200 | 200 | 1.000 | 1.000 |
unavailable | 50 | 50 | 1.000 | 1.000 |
withdrawn | 124 | 124 | 1.000 | 1.000 |
quote_mismatch | 601 | 601 | 1.000 | 1.000 |
ok | 600 | 600 | 1.000 | 1.000 |
| 整体答案 | 正确数 | 植入的整体判定 |
|---|---|---|
| mixed | 200/200 | fail 128,incomplete 15,warn 57 |
| clean | 25/25 | pass 25 |
| paired | 32/32 | fail 7,incomplete 1,pass 9,warn 15 |
| 记录 | 植入的引用 |
|---|---|
| nct:NCT04363697 | 188 |
| 快照之外 | 87 |
| pmcid:PMC12585062 | 139 |
| pmid:30831578 | 25 |
| pmid:41187138 | 10 |
| pmid:9500320 | 25 |
| ppr:PPR1297067 | 25 |
| setid:7c4deb97-9966-4c8e-9ba6-bb260b71e130 | 401 |
选项。 --seed(默认值为 0)和 --per-category(默认值为 25)用于选择案例;--json-out 会写入完整报告,其中包含混淆矩阵。
如何解读。
- 小型样本池会被重复抽取:参见“不同案例数”。
- 植入的引用主要来自药品标签和试验:参见最后一个表格。
- 评估结果表明,审计能正确判定这些植入的错误。但这并未说明模型多常犯这类错误:要了解这一点,需要使用真实模型进行多次运行,例如上面的运行。
注入故障。 python -m tekmeria.evaluation.faults 每次破坏审计的一项判定(模拟真实 Bug),然后重新运行评估。38 个故障均为手动挑选:
- 比较器过于宽松:忽略大小写、标点、变音符号、空白字符、NFKC,或只检查前 40 个字符;
- 逐一移除合约的 19 种折叠规则,并加入一种未将不换行空格识别为空白字符的故障(单独删除该折叠条目本身不会改变结果,因为空白字符规范化已将其识别为空格);
- 不再删除 4 种不可见字符中的任一种;
- 校验码忽略路径、标志被删除,以及声明状态、覆盖率、有效性和整体判定规则错误;其中包括早先的两条规则:仅被无效引用引用的句子,或有效引用旁边存在无效引用时,都不会触发警告。 它能捕获其中 37 个。漏掉的那个会连同原因一并列出:快照中的段落都不含省略号,因此无法植入省略号折叠故障。CI 每个类别运行 10 个用例,足以让每种破折号和引号都出现。
变异分数。 python -m tekmeria.evaluation.mutants 的筛选没那么严格。它每次对审计代码做一处小改动(引文解析器、句柄编解码器、引文比较逻辑和审计本身),然后针对每处改动运行评估。改动会否定一次比较或将其移到边界之外、互换 and 和 or、移除一个 not、翻转一个布尔值,或给整数加 1。字符串和正则表达式常量不会被修改,因此分数几乎不能说明引文语法或折叠表的情况:注入故障的测试已覆盖了这些内容。
- 评估杀死了 78 处改动中的 71 处:52 处导致结果错误,19 处导致崩溃。
- 还有一处改动会阻止快照加载,因此评估无法对其进行判断,故未计入分数。
- 七处未被杀死的改动中,有三处对当前源解析器能够构建的任何记录都不起作用:两处位于
preprint规则中,该规则的两个信号总是由解析器同时设置;另一处涉及粗体引导语的处理,其效果会被后续步骤移除。 - 剩余四处是未能检出的故障:评估未评分的
checked_against、一个空引文(两处改动),以及普通[1]方括号文本。 - 以下内容超出范围,因此从未被修改:诊断信息
closest_match、check_handles工具、密钥长度检查、游标签名,以及仅证据服务使用的记录 ID 解析和段落寻址。
有些类别的段落数量很少:只有一个段落含有带重音字母,因此分解重音类别只测试一个字符。
用法
快速入门会运行离线演示。若要在聊天中使用 tekmeria,请将其添加到 MCP 宿主:
Claude Desktop、VS Code 和 MCP Inspector
Claude Desktop
将以下内容添加到 claude_desktop_config.json(Settings、Developer、Edit Config),然后重启:
{
  "mcpServers": {
    "tekmeria": {
      "command": "uvx",
      "args": ["tekmeria"]
    }
  }
}
然后使用 cite_by_handle 提示词开始聊天。audit_answer 还将审计视图(ui://tekmeria/audit-view)声明为 MCP App,供支持 MCP Apps 的宿主使用。
VS Code
将以下内容添加到 .vscode/mcp.json:
{
  "servers": {
    "tekmeria": {
      "type": "stdio",
      "command": "uvx",
      "args": ["tekmeria"]
    }
  }
}
MCP Inspector
npx @modelcontextprotocol/inspector uvx tekmeria
命令
| 命令 | 功能 |
|---|---|
tekmeria | 通过 stdio 提供 MCP 服务。 |
tekmeria --http --port 8000 | 在 http://127.0.0.1:8000/mcp 提供 Streamable HTTP 服务(仅限 localhost)。 |
tekmeria --demo | 使用公开演示密钥提供录制的演示数据:无需网络。 |
tekmeria demo | 运行离线演示并打印审计结果。添加 --json-out PATH 可输出报告,添加 --html-out PATH 可输出审计视图,添加 --open 可打开该视图。 |
配置
所有配置均为可选项,且从环境变量读取;不会读取 .env 文件。
八个环境变量
| 变量 | 用途 |
|---|---|
NCBI_API_KEY | 将 PubMed 的请求速率限制从每秒 3 次提高到 10 次。 |
NCBI_EMAIL | NCBI 要求提供的联系地址;仅在设置后发送。 |
OPENFDA_API_KEY | 将 openFDA 的每日请求限制从 1,000 次提高到 120,000 次。 |
CROSSREF_MAILTO | 将 Crossref 请求纳入其礼貌请求池;仅在设置后发送。 |
TEKMERIA_HANDLE_KEY | 句柄密钥,采用十六进制格式:至少 32 字节(64 个十六进制数字)。默认情况下,首次运行时会创建一个随机密钥并存储在用户数据文件夹中。 |
TEKMERIA_CACHE_PATH | SQLite 缓存的位置(默认:用户缓存文件夹)。 |
TEKMERIA_LOG_LEVEL | stderr 上 JSON 日志的日志级别(默认值 INFO)。 |
TEKMERIA_TOOL_DEADLINE_S | 每次工具调用允许的秒数(默认值 45)。 |
| 工具 | 功能 |
|---|---|
search_literature | 搜索 PubMed 和 Europe PMC(包括预印本),合并结果并去重。筛选条件:日期、研究设计、同行评审、开放获取、撤稿。 |
search_trials | 按疾病、干预措施或术语搜索 ClinicalTrials.gov;可按状态、阶段和已发布结果进行筛选。 |
search_drug_labels | 查找所有提及某种药物的 openFDA 药品标签,并按最新时间排序。 |
fetch_passages | 获取记录(pmid:、pmcid:、ppr:、nct:、setid:)及其段落,每个段落都附有句柄;同时添加实体和撤稿状态。 |
resolve_handles | 查找每个句柄对应的段落,并说明该句柄是否有效。 |
audit_answer | 审核答案中的引文并返回报告;将审核视图(ui://tekmeria/audit-view)声明为 MCP App。 |
describe_contract | 返回契约:句柄语法、判定结果、标记、指标和引文说明。 |
此外,还有一个提示词 cite_by_handle,以及两个资源模板 evidence://record/{+record_id} 和 evidence://passage/{+handle}(+ 可让句柄中的斜杠原样通过)。
开发
检查方式
uv sync
uv run pytest            # Python tests, offline (recorded fixtures)
uv run ruff check && uv run ruff format --check && uv run pyright
uv run pytest -m live    # smoke tests against the real APIs
审核视图:
cd web
npm ci
npm test && npm run typecheck
npm run build            # rewrites src/tekmeria/ui/audit-view.html; commit it
更改报告模型后,运行 uv run python -m tekmeria.contract.schemas。要从实时 API 重新录制固定数据,请删除 src/tekmeria/demo/fixtures/*.json,然后运行 uv run tekmeria record-fixtures(不要设置电子邮件或 API 密钥)。录制器仅保留演示、测试和评估所用的第三方文本:它会录制一篇采用 CC BY 协议的开放获取文章,从搜索结果中删除所有非 CC BY 或 CC0 的摘要,并且只保留演示、测试和评估所获取记录的 PubMed 摘要,以及 Europe PMC 在搜索结果中标记为 CC BY 或 CC0 的 PubMed 摘要(参见 NOTICE)。
发布 GitHub 版本会运行 .github/workflows/release.yml:检查 CI 是否已在带标签的提交上通过、标签是否与软件包版本一致、server.json 是否有效,以及本 README 链接的演示页面是否在线;随后运行测试并构建软件包。维护者在 pypi 环境中批准后,工作流会通过可信发布将软件包发布到 PyPI,然后在 MCP Registry 中登记新版本;两者均使用工作流的 GitHub 身份登录,因此无需在任何地方存储令牌。
仓库
| 路径 | 内容 |
|---|---|
| src/tekmeria/ | 服务、引文契约、证据来源、评估和离线演示 |
| web/ | 审核视图:使用 React 和 TypeScript 构建,并打包为一个提交到仓库的 HTML 文件 |
| tests/ | 针对已录制响应的离线测试,以及实时冒烟测试 |
| docs/ | 契约、设计及其决策、验收标准和实时运行记录 |
| schemas/ | 从模型导出的报告 JSON Schema |
它无法告诉你的内容
- 某段内容是否支持其对应的句子。 审计会检查引用是否由此服务签发、其中的段落是否仍然存在,以及任何引文是否为逐字引用(与签发时或当前文本一致)。但不会检查内容是否构成支持。
- 医疗建议。 Tekmeria 会检索和审计证据,但不会对证据作出判断,其返回的内容均不构成临床指导。它会查询公开的生物医学 API,且并非为患者数据而构建。
- 注册库的旧版本。 ClinicalTrials.gov 和 openFDA 只提供记录的当前版本;如果引用的旧版本已变更,系统会标记为
version_changed,但只能从 tekmeria 的缓存中获取其旧文本。 - 来自其他安装实例的句柄。 句柄只能在签发它的安装实例(密钥)上验证。
- PubMed 图书章节。 搜索会排除 StatPearls 或 GeneReviews 等记录,获取此类记录时会报告未找到。
- 跨页去重的结果流。
search_literature不会在同一页显示同一条记录两次,但该记录可能会在后续页面再次出现。
贡献与支持
- 遇到问题或有疑问: 请提交议题。如果判定有误,请附上你审计的答案文本和报告;句柄只能在签发它的安装实例上验证,因此请说明你是否使用了演示密钥。
- 发现漏洞: 请按照 SECURITY.md 中的说明,通过仓库的 Security 选项卡私下报告。
- 提交更改: 欢迎提交拉取请求。CONTRIBUTING.md 列出了需要运行的检查,以及更改需要满足的要求;如果更改会影响审计判定,则需要在评估中加入相应案例。
- 权利持有人希望删除已记录的条目时,可以按照 NOTICE 中的说明提交议题。
引用
引用 tekmeria 时,请使用 CITATION.cff 中的元数据;GitHub 的“引用此仓库”按钮会为其设置格式。发行版本存档于 Zenodo:10.5281/zenodo.23353865 始终指向最新发行版本,版本 0.1.1 的 DOI 为 10.5281/zenodo.23376855。Software Heritage 存档了完整历史记录;发行版本 0.1.0 的标识符为 swh:1:rel:9d852cbc58c0adc8919be14723b074d6dd5b7b45。各发行版本之间的更改记录于 CHANGELOG.md。
@software{markovicz_tekmeria,
  author  = {Markovicz, Pedro},
  title   = {tekmeria},
  note    = {Server-issued citation handles and a deterministic audit for biomedical evidence},
  version = {0.1.1},
  year    = {2026},
  doi     = {10.5281/zenodo.23376855},
  url     = {https://github.com/PedroMarkovicz/tekmeria},
  license = {Apache-2.0}
}
引用设计或评估时,请引用技术说明。该说明以预印本形式存档于 Zenodo:10.5281/zenodo.23374728 始终指向其最新版本,版本 1 的 DOI 为 10.5281/zenodo.23374729。
@misc{markovicz_tekmeria_note,
  author    = {Markovicz, Pedro},
  title     = {Tekmeria: Server-Issued Citation Handles and a Deterministic Audit for Biomedical {LLM} Answers},
  year      = {2026},
  publisher = {Zenodo},
  note      = {Preprint, version 1},
  doi       = {10.5281/zenodo.23374729}
}
数据与许可
代码:Apache License 2.0;请参阅 LICENSE 和 NOTICE。
src/tekmeria/demo/fixtures/ 下记录的 API 响应遵循其来源的条款,详见 NOTICE:来自 ClinicalTrials.gov 和 openFDA 的美国政府数据、来自 PubMed、Europe PMC 和 Crossref 的文献记录、一篇 CC BY 4.0 全文文章和一篇 CC BY 4.0 预印本,均已在其中注明出处。
Tekmeria 使用美国国家医学图书馆(PubMed、PubTator3 和 ClinicalTrials.gov)、Europe PMC、美国食品药品监督管理局(openFDA)和 Crossref 的公共 API。本项目与上述机构均无关联,也未获其认可。
以 ☕ 为伴,并对无法核实的引用保持适度怀疑
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。