关于 mockcrowd
mockcrowd 是面向创始人和产品团队的命令行工具,通过基于真实网络帖文的 AI 人格模拟讨论来评估产品创意。它将反馈与普通对照方案比较,并报告异议、可信度和付费意愿。
主要功能
- 01基于真实帖文构建人格
- 02与对照方案进行盲测投票
- 03模拟讨论并进行后续投票
- 04报告可信度与主要异议
- 05回测并记录实际结果
适用场景
- 01开发前比较产品创意
- 02评估特定定价下的付费意愿
- 03按受众细分探索异议
- 04评估免费功能或应用
MCP 相关
其 MCP 服务提供创意验证、报告查询、历史运行和可用 AI 后端列表,以及结果记录等工具。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
5收录的工具列表 · 更新于 今天
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| free | boolean | 否 | |
| idea | string | 是 | |
| brain | string | 否 | |
| model | any | 否 | |
| price | any | 否 | |
| agents | integer | 否 | |
| rounds | integer | 否 | |
| sources | any | 否 | |
| audience | any | 否 | |
| voices_file | any | 否 |
详细介绍



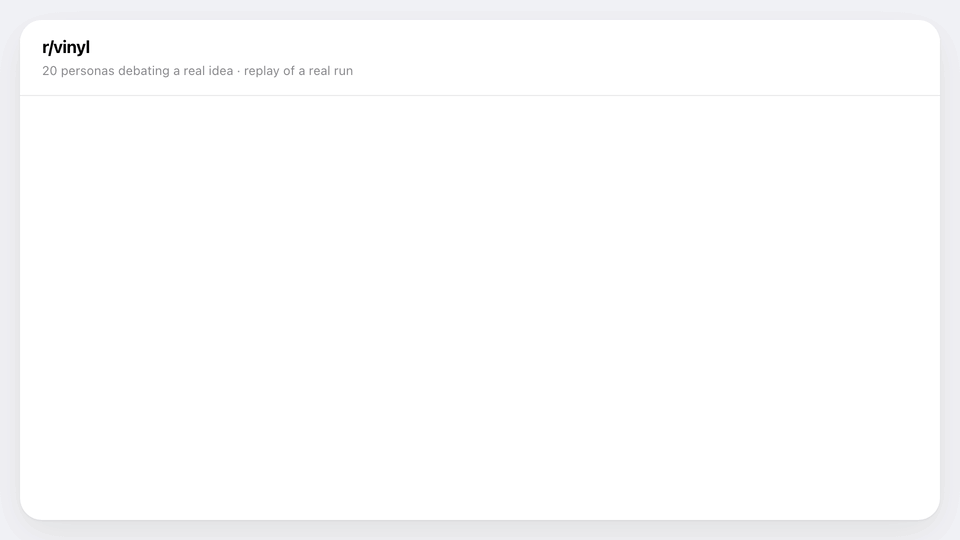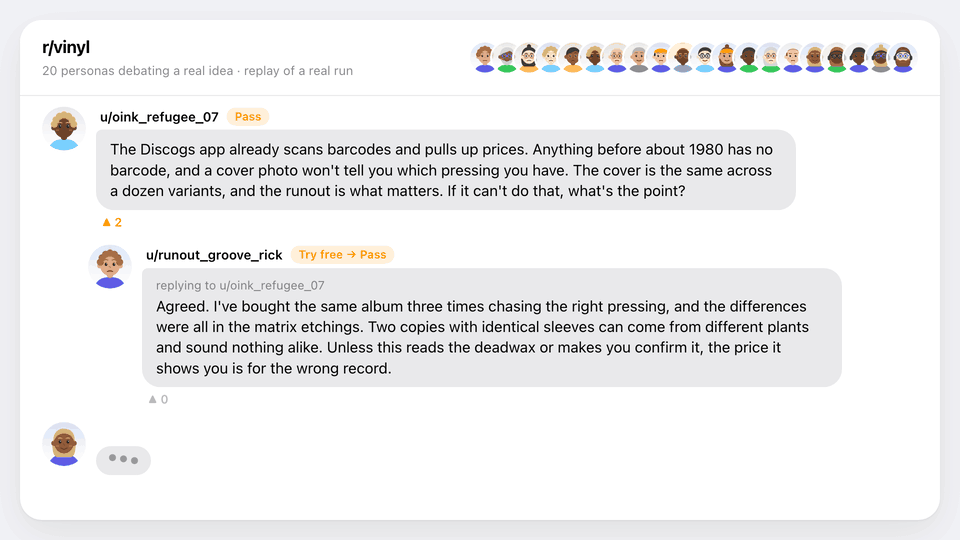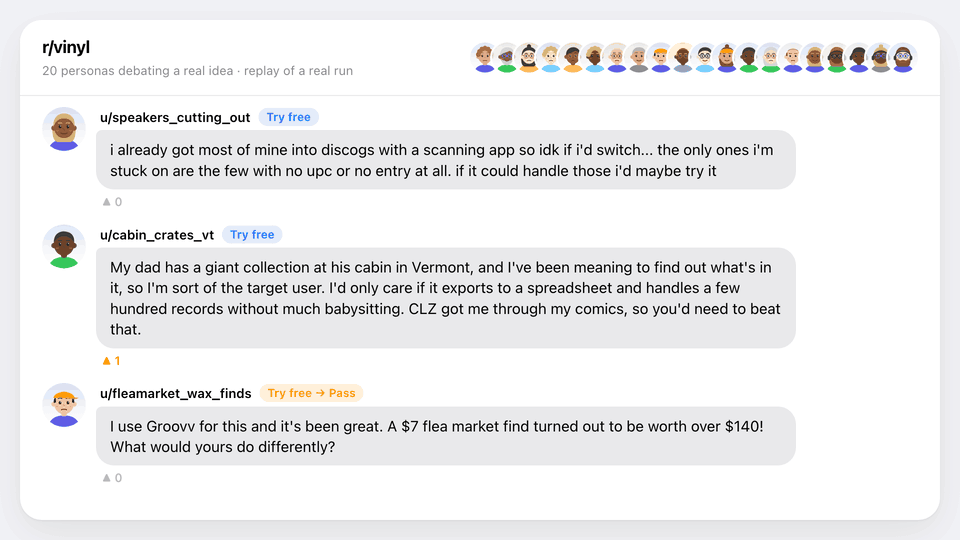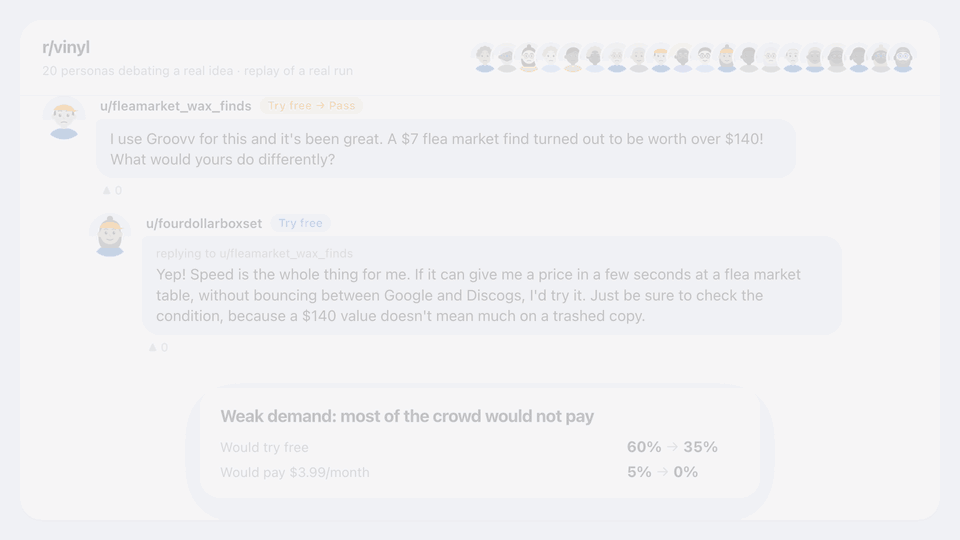
在构建之前验证你的产品创意。 mockcrowd 根据 Reddit、Hacker News 和 Bluesky 上的真实帖子,创建数百个 AI 人设,让他们在模拟的 Reddit 讨论串中围绕你的创意展开争论,并告诉你有多少人真的愿意付费、其他人为什么不愿意,以及这个答案有多值得信赖。
它在你的机器上运行,使用你已经拥有的 AI:Claude Code、Codex、Code Puppy、Ollama,或任何兼容 OpenAI 的 API。
mockcrowd validate "An app that scans your vinyl records with the phone camera to catalog your collection and track prices" --price "\$3.99/month"
小规模测试运行的真实输出(20 名人设、1 轮讨论、Claude、Hacker News 和 Bluesky 的声音):
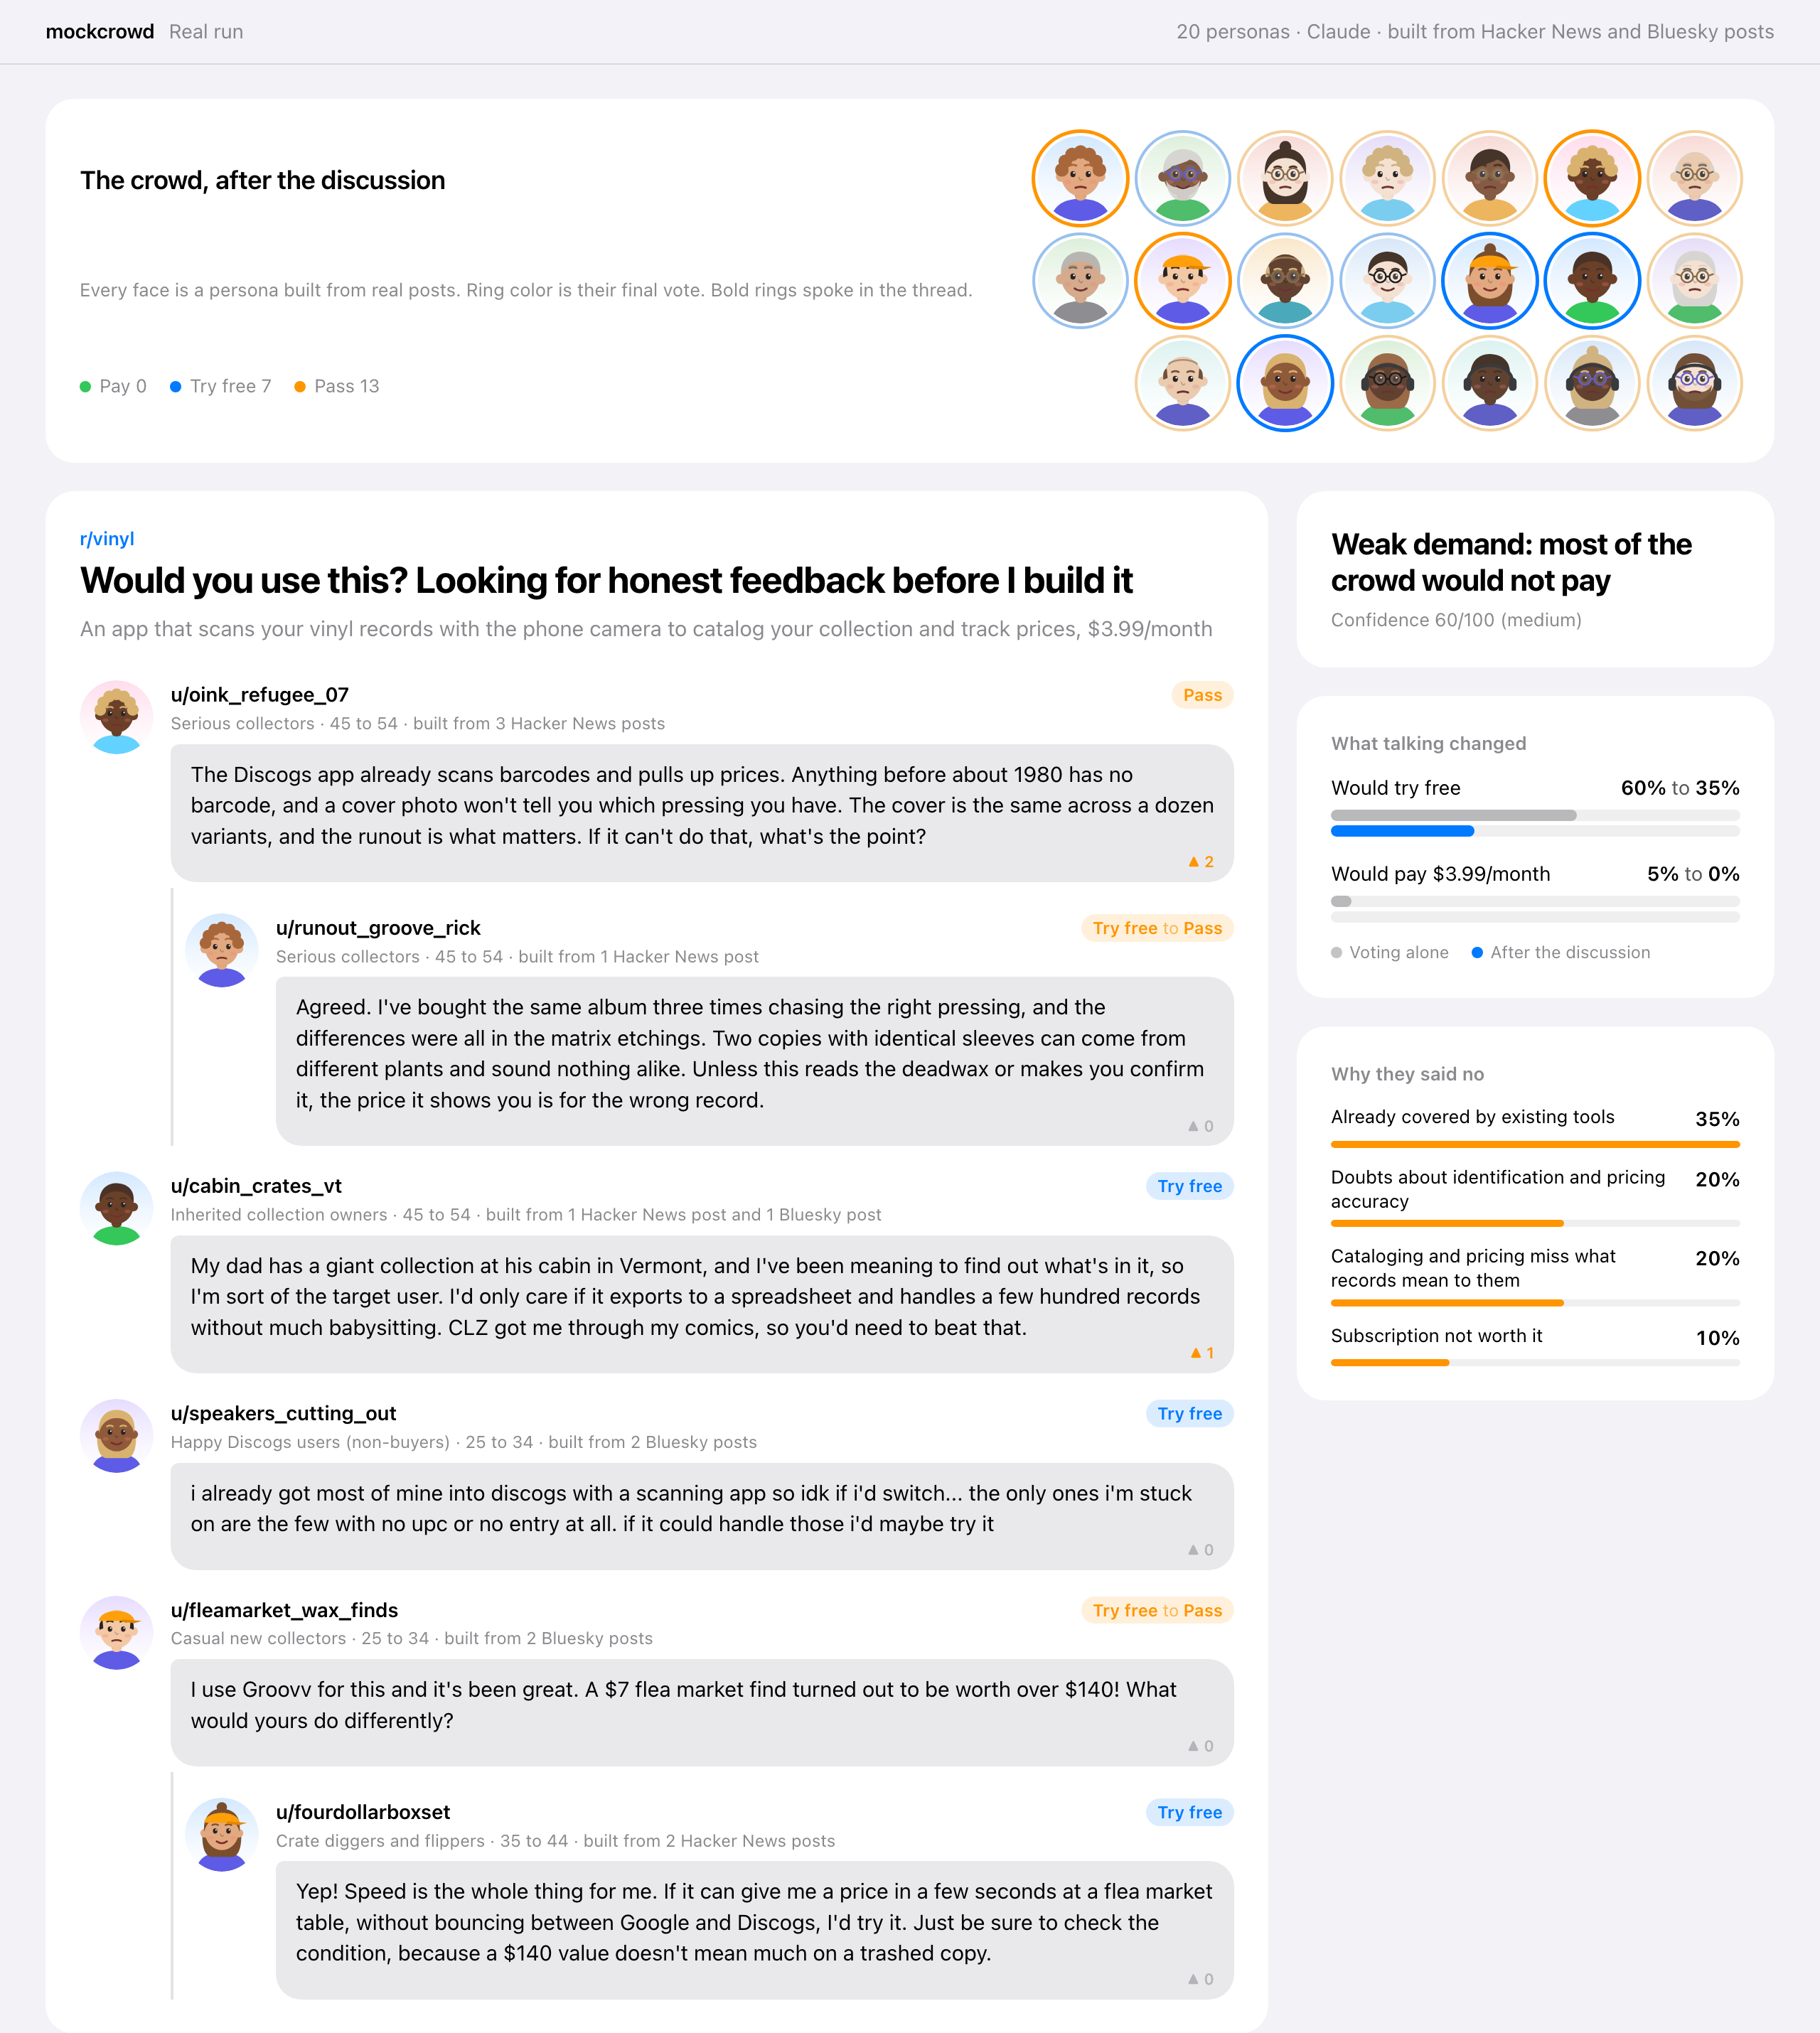
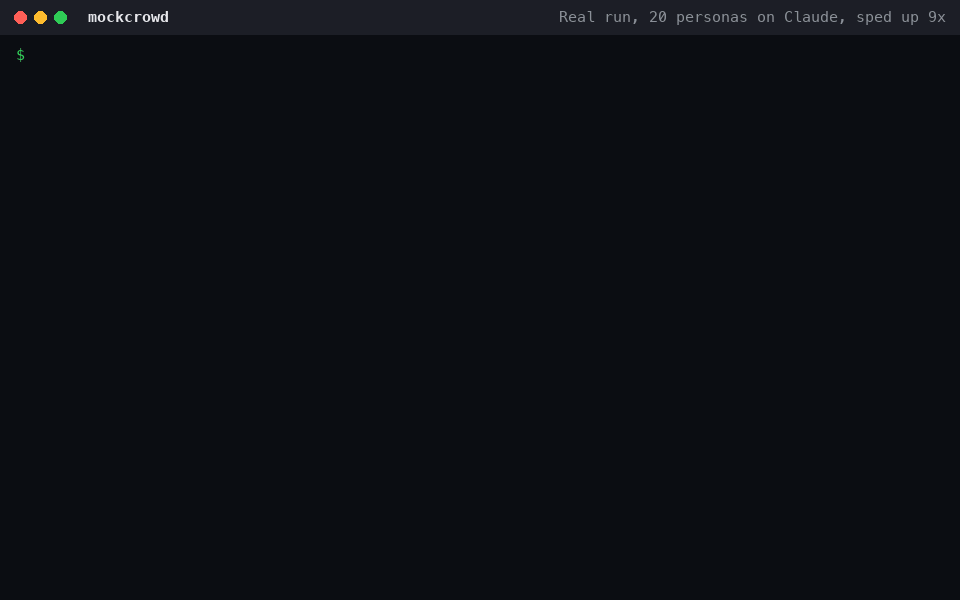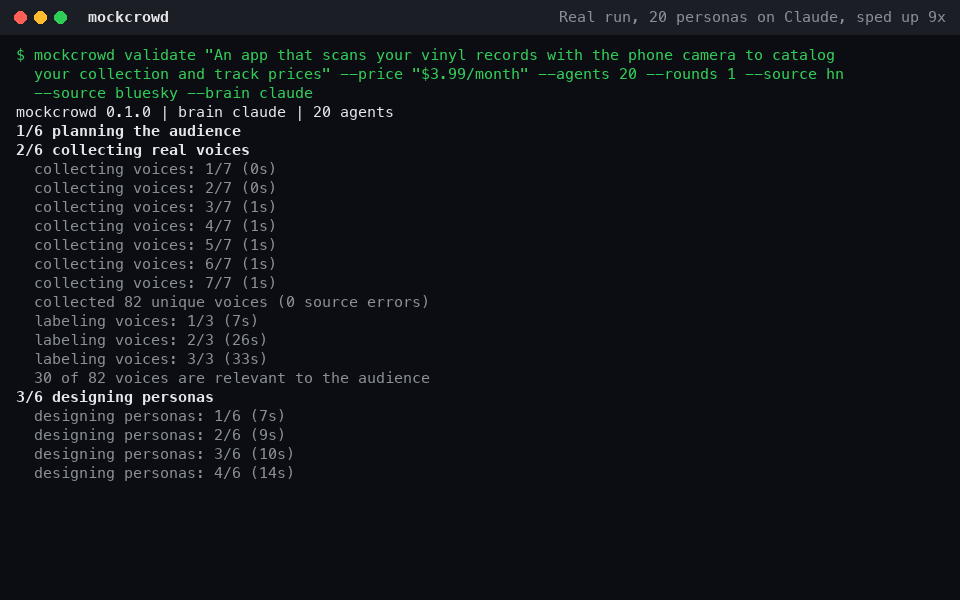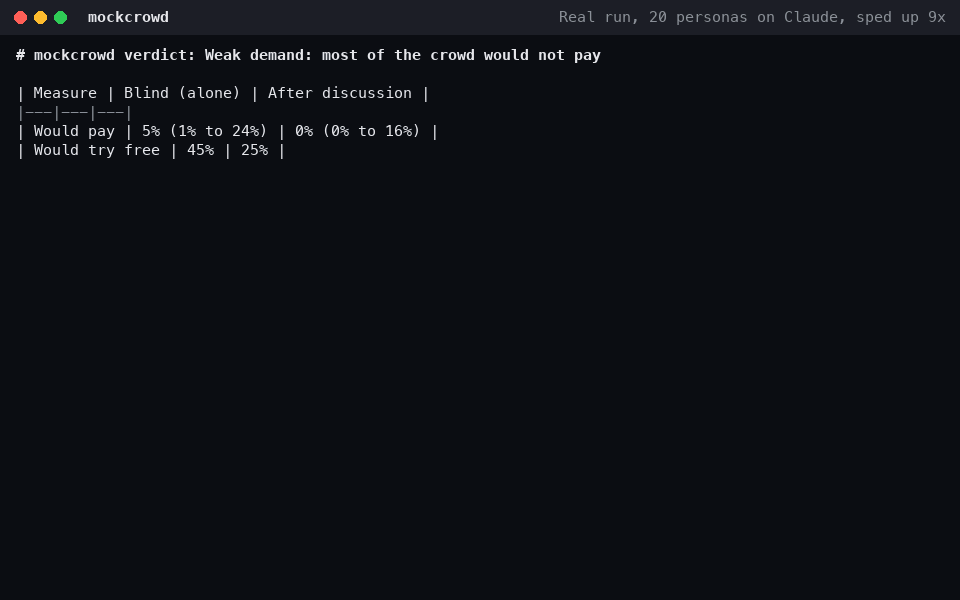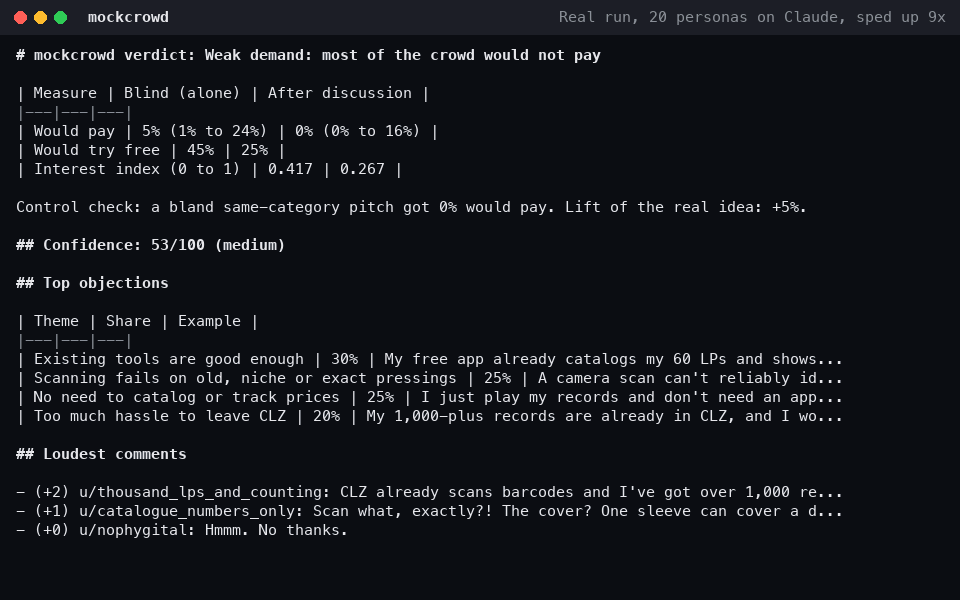
最初,60% 的人表示愿意免费试用,5% 的人愿意付费。讨论之后,愿意试用的比例降至 35%,没有人愿意付费。这正是你想在花一个月开发之前得到的答案。
它有何不同
| 向大模型询问“人们会买这个吗?”的问题 | mockcrowd 的做法 |
|---|---|
| 模型总是迎合用户,对所有事情都说好 | 每个人设还会在同一场盲测投票中评价一个平淡的对照宣传语。结论看的是相较于对照组的提升,而不是原始的肯定比例。 |
| 虚构的人设听起来像营销文案 | 每个人设都根据真实帖子构建,并引用这些帖子。人群中的立场分布(正面、中立、怀疑、负面)与这些帖子中测得的分布相匹配。 |
| 只有一种声音,没有社交互动 | Reddit 风格的讨论:每个讨论串约有 20 名人设、一个排序信息流,以及固定的操作选项(评论、回复、点赞、点踩、不采取行动),设计参考了 OASIS。你可以看到讨论前后的投票结果。 |
| 无法知道工具的结论是否准确 | 使用结果已知的产品(众筹记录和广为人知的失败产品)进行评估和回测,也可以记录你自己的结果。 |
安装
pip install mockcrowd
# or: uv tool install mockcrowd
mockcrowd brains        # shows which AI it can use
需要 Python 3.10 或更高版本。只有一个小型依赖项(certifi)。
mockcrowd 每天检查一次 PyPI,如果发现有更新版本,只会打印一行提示。它不会安装任何内容。使用 pip install -U mockcrowd 或 uv tool upgrade mockcrowd 升级。使用 MOCKCROWD_NO_UPDATE_CHECK=1 关闭检查。
选择大脑
mockcrowd 会使用找到的第一个大脑,也可以通过 --brain 指定。
| 大脑 | 运行方式 | 设置 |
|---|---|---|
claude | 使用 Claude Code 计划运行 claude -p | 已安装 Claude Code |
codex | 使用 ChatGPT 或 API 计划运行 codex exec | 已安装 Codex CLI |
code-puppy | 使用配置的模型运行 code-puppy -p | 已安装 Code Puppy |
ollama | 本地模型,免费且私密,但速度较慢 | 运行 ollama serve,然后使用 --model <name> |
openai | 任何兼容 OpenAI 的端点(OpenAI、OpenRouter、LM Studio、vLLM) | MOCKCROWD_API_BASE、MOCKCROWD_API_KEY、--model |
Claude 已完成端到端实时测试。Codex、Code Puppy、Ollama 和 OpenAI 适配器均根据各工具文档中的标志和 API 进行了测试,但尚未进行实时运行;欢迎提交报告。Claude 和 Code Puppy 运行时会关闭工具。Codex 在只读沙箱中运行,该沙箱会阻止写入,但不阻止读取,因此如果你的机器上存有敏感文件,请优先选择其他方案。
--model 会按你输入的内容原样传递。运行 500 个角色大约会进行 100 到 150 次大模型调用,因为每次调用都会处理一整批或一整条线程中的角色。速度更快、成本更低的模型可以缩短运行时间。OPENAI_API_KEY 仅用于 api.openai.com;其他端点需要 MOCKCROWD_API_KEY。
真实声音
| 来源 | 是否需要密钥 | 备注 |
|---|---|---|
| 是,免费 | 在 reddit.com/prefs/apps 创建一个“script”应用,并设置 REDDIT_CLIENT_ID 和 REDDIT_CLIENT_SECRET。Reddit 会阻止不带密钥的请求。免费访问仅供非商业用途。 | |
| Hacker News | 否 | 通过 Algolia 搜索 API 获取评论 |
| Bluesky | 否 | 搜索公开帖子 |
| GitHub | 否 | 仅当受众是开发者时,获取 Issue 及其热门评论。设置 GITHUB_TOKEN 可提高速率限制。 |
| App Store | 否 | 使用 --source appstore 启用。上次测试时,Apple 的公开评论源未返回任何评论。 |
| 其他任何来源 | X、Threads、Instagram、Discord、调查、支持工单、访谈记录:将帖子放入文件,并传入 --voices posts.jsonl(JSONL、CSV 或文本)。 |
报告会列出每个失败的来源;证据不足时,置信度分数会降低。
在编码 Agent 中使用
mockcrowd install-skill                    # Claude Code: ~/.claude/skills/mockcrowd
mockcrowd install-skill --dir <skills dir> # any agent that reads SKILL.md files
然后提出:“验证一下我每月 $3.99 的黑胶唱片收藏应用创意。”Agent 会运行 mockcrowd;如果某个来源被屏蔽,它可以使用自己的网络工具收集帖子并传入。
在任何 AI Agent 中使用(MCP)
pip install "mockcrowd[mcp]"
claude mcp add mockcrowd -- mockcrowd mcp   # Claude Code
任何其他 MCP 客户端(Cursor、Codex、Claude Desktop 或你自己的 Agent)都可以通过标准输入/输出运行命令 mockcrowd mcp 来启动它:
{"mcpServers": {"mockcrowd": {"command": "mockcrowd", "args": ["mcp"]}}}
若要始终运行最新版本而不安装,请使用 uvx:{"command": "uvx", "args": ["--python", "3.12", "mockcrowd[mcp]@latest", "mcp"]}。
| 工具 | 功能 |
|---|---|
validate_idea | 针对一个创意运行一组模拟受众,并返回结论、愿意付费和免费试用的比例、提升幅度、置信度、主要反对意见及完整报告 |
get_report | 获取过往运行的报告 |
list_runs | 列出过往运行及其结论 |
record_outcome | 记录运行后的实际结果,并将其转为回测案例 |
list_brains | 列出可用的 AI 后端 |
Agent 运行默认使用 60 个角色和 1 轮,以缩短运行时间。
免费创意和开源功能
如果某项内容不收费,例如开源功能或免费应用,请添加 --free。系统会询问受众是否愿意使用,而不是是否愿意付费;结论则根据讨论后相较于平淡对照组的兴趣得出。若要基于真实功能请求进行回测,请添加 --exclude github.com/owner/repo/issues/123,这样受众就不会看到用于评分的 Issue。
命令
mockcrowd validate "idea" [--price P | --free] [--audience A] [--agents 500] [--rounds 2]
                          [--voices file.jsonl] [--no-live] [--source reddit|hn|bluesky|github|appstore]
                          [--exclude TEXT]
                          [--question "choice:first:Which feature first?:scan|alerts|wishlist"]
                          [--brain auto|claude|codex|code-puppy|ollama|openai] [--model M]
mockcrowd collect "idea" -o voices.jsonl   # only gather real posts
mockcrowd runs                             # list past runs
mockcrowd report <run-id> [--json]
mockcrowd outcome <run-id> --demand high|medium|low --note "what really happened"
mockcrowd eval --suite quick|full|backtest [--gate]
运行结果会以 report.md 和 run.json 的形式保存在 ~/.mockcrowd/runs/<run-id>/ 中(包括每条声音、角色、投票和评论)。
一次运行的工作流程
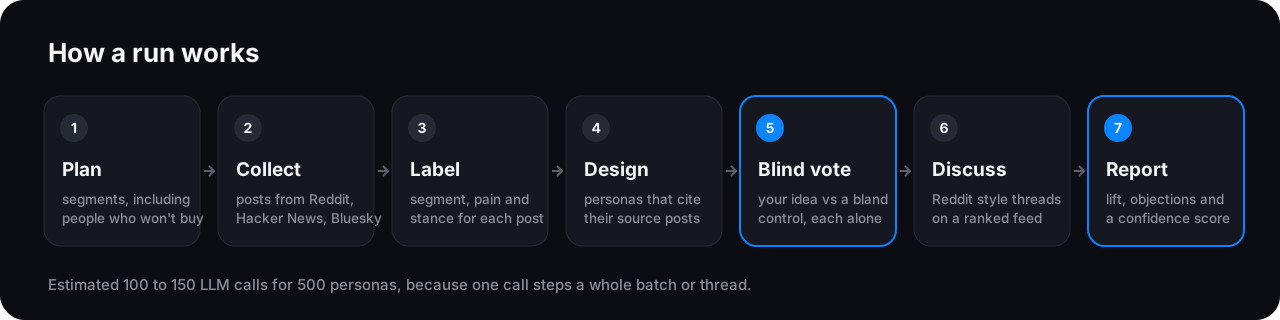
- 规划。 大脑读取你的想法,并列出细分群体(包括不会购买的人)、子版块和搜索查询。
- 收集。 从上述来源获取真实帖子。
- 标注。 为每篇帖子标注细分群体、相关性、痛点级别和立场。删除无关帖子。
- 设计。 根据真实帖子样本分批撰写角色,其细分群体占比和立场组合与这些帖子所反映的情况一致。每个角色都会引用其对应的帖子。
- 盲投。 每个角色单独回答:感兴趣程度、是否愿意免费试用、是否愿意付费、最大的反对意见,以及你自行输入的问题。真实想法和一个平淡无奇的对照方案会以随机顺序并排显示。
- 讨论。 由约 20 个不同角色组成讨论串,每轮每个角色在排序信息流中采取一项行动。
- 最终投票和报告。 报告各细分群体的投票占比及 95% 区间、相较对照方案的提升、讨论后的变化、各细分群体的结果、反对意见主题和置信度评分。
评估与持续改进
mockcrowd eval 会对模拟器本身进行评分,并将结果追加到 ~/.mockcrowd/evals/history.jsonl。使用 --gate 时,如果任何指标比其最佳值低 5 分以上,命令就会以状态码 1 退出。
| 指标 | 检查内容 |
|---|---|
| grounding, citation_valid | 角色是否基于真实帖子构建,以及其引用是否存在 |
| mix_fidelity | 群体的立场组合是否与真实帖子相符 |
| diversity | 角色是否彼此不同,而非互相复制 |
| control_lift, agreeableness | 群体是否会给平淡无奇的想法打高分 |
| persuasion_drift | 讨论对投票结果的影响程度 |
| stability | 重新投票是否会得到相同结果 |
| realism | 评判者能否分辨真实帖子和角色评论 |
| backtest_accuracy, backtest_auc | 已知成功案例的得分是否高于已知失败案例 |
| leakage | 大脑凭记忆认出多少个回测产品 |
回测包含 13 个案例:六个创下众筹或用户增长纪录的案例(例如 Pebble Time、Exploding Kittens、Flow Hive),以及七个广为人知的失败案例(例如 Juicero、Quibi、Fire Phone)。每个案例都会引用来源。方案说明会进行匿名处理,而泄漏指标会报告模型仍能认出这些案例的频率。
你的实际结果是最有力的信号。 测试或发布后,运行 mockcrowd outcome <run-id> --demand ...。该次运行会成为一个回测案例,之后的置信度评分也会纳入 mockcrowd 在类似案例上的表现。
诚实说明局限
- 这是一种模拟。可用它来给想法排序、发现反对意见并选择要实际测试的内容,而不是预测收入。
- 角色反映的是会在网上发帖的人;与大多数买家相比,他们更爱发声,也更有主见。
- 回测产品都很有名,因此模型可能知道它们最终的结果。请留意泄漏指标。
- 结论阈值只是起始值。回测会报告这些阈值在你的大脑上区分成功和失败案例的效果。
鸣谢
模拟设计遵循 CAMEL-AI 的 OASIS(Apache 2.0)。从种子材料构建世界并对其进行模拟的想法受到了 MiroFish 的启发。项目未包含这两个项目的任何代码。请参阅 NOTICE。
许可证
Apache 2.0
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。