关于 Sarup
Sarup 是面向泰语的上下文压缩 MCP 服务,适用于 Claude Code 和其他 MCP 客户端。它压缩较长的泰语和英语文本,同时缓存原文以便逐字节恢复;部分模式可选用 Ollama,并支持离线回退。
主要功能
- 01压缩泰语和英语文本
- 02通过哈希恢复缓存的原文
- 03提供五种压缩模式
- 04保留代码围栏并压缩 JSON
- 05自动压缩较大的工具输出
- 06统计会话节省的令牌
适用场景
- 01缩减模型上下文中的长工具输出
- 02有损压缩后恢复原文
- 03为 Claude Code 压缩泰语文档
- 04查看会话累计节省量
MCP 相关
它向 MCP 客户端提供压缩、原文恢复和会话统计工具。Claude Code 的可选 Hook 还会压缩较大的工具输出,并保存原文以供恢复。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
3收录的工具列表 · 更新于 2 天前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| mode | enum | 否 | 散文压缩策略。'extractive'(默认):离线 TF-IDF,逐字摘取子集,约 1ms。'semantic':嵌入中心性,压缩率最佳(需要 Ollama)。'abstractive':本地 LLM 改写(需要 Ollama,速度较慢)。'pipeline':依次执行 semantic -> abstractive,以最大限度节省内容。'auto':Ollama 可用时使用 semantic,否则使用 extractive。所有模式均可通过 sarup_retrieve 100% 恢复。如果因缺少 Ollama 或模型而回退,结果会包含说明所需安装内容的 'setup' 字段。extractive | semantic | abstractive | pipeline | auto |
| query | string | 否 | 可选的上下文查询。与此查询相关的句子会获得更高评分,因此更可能被保留。 |
| content | string | 是 | 要压缩的内容 |
| lossless | boolean | 否 | 仅应用无损转换(空白字符/JSON 压缩)。默认值为 false。 |
| target_ratio | number | 否 | 保留的散文比例(0.3–0.7)。默认值为 0.5。 |
详细介绍
总结 · Sarup
面向泰语的 Claude Code 上下文压缩工具。 一个真正能压缩泰语(减少 50–78% token)的 MCP 服务,并缓存每份原文, 确保内容永不丢失。衡量指标也切中要点:Claude 是否仍能正确回答。


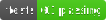
สรุป 意为“总结”。Headroom 会将泰语交给
noop处理(节省 0%),因为它的空白字符分词器无法识别泰语词语边界。Sarup 使用 PyThaiNLP 分词,因此既能压缩泰语,也能压缩英语——并缓存每份原文,确保内容永不丢失。
目录
亮点
- 🇹🇭 真正的泰语压缩——使用 PyThaiNLP
newmm进行词语分词,而非依赖空白字符。 - ♻️ 保证无损——每次压缩都会缓存原文;
verified: true可证明往返还原后逐字节一致。 - 🎚️ 五种模式:从离线运行、耗时 1 ms 的 TF-IDF,到节省 78% 的级联模式。
- 🧠 可选的本地 LLM——通过 Ollama 使用嵌入 + 改写,并可自动回退到离线模式。
- 📏 真实可信的指标:运行时使用真正的分词器(tiktoken);已发布的数据则使用 Claude 自带的分词器和泰语 QA 评测(Claude 还能正确回答吗?)。
- 🕳️ 清晰标示缺失内容:每处被删去的句子都会以
[…]标记,促使 Claude 检索信息,而不是把附近的事实误当成答案。 - 🔌 感知内容类型——内置 JSON 精简、日志去重和代码围栏原样保留功能。
- 🛟 不会影响 Claude 的正常工作——它是 MCP 工具,不是 API 代理;如果服务停止,工具只会消失,Claude 仍可继续工作。
为何安全——双层保障
| 层级 | 内容 | 保障 |
|---|---|---|
| 压缩视图 | 模型使用的精简文本 | 有损 · 体积小 · 成本低 |
| 检索存储 | 以稳定哈希为键保存的原文 | 无损 · 可恢复 |
激进的有损压缩之所以安全,是因为只需调用一次 sarup_retrieve(hash),就能取回原文。这就是“最大限度节省”和“100% 准确率”能够并存的原因——它们属于不同的层级。
工作原理
两个入口共用一个引擎:模型读取的低成本压缩视图,以及能够逐字节还原原文的无损 检索存储。
flowchart TD
    M["🧑 Manual<br/>sarup_compress()"]:::entry --> R
    A["⚙️ Automatic<br/>PostToolUse hook<br/>(Read · Bash · Grep)"]:::entry --> R

    R{"Sarup compress<br/>extractive · semantic · abstractive · pipeline"}:::engine
    R -- "compressed view<br/>50–78% fewer tokens" --> V["📄 Model context"]:::lossy
    R -. "cache original" .-> S[("🗄️ Retrieval store<br/>hash → original")]:::lossless

    V -. "need full detail?" .-> RET["🔑 sarup_retrieve(hash)"]:::lossless
    RET --> S
    S == "byte-for-byte ✓" ==> V

    classDef entry fill:#e0e7ff,stroke:#6366f1,color:#111
    classDef engine fill:#fde68a,stroke:#d97706,color:#111
    classDef lossy fill:#fef3c7,stroke:#f59e0b,color:#111
    classDef lossless fill:#bbf7d0,stroke:#16a34a,color:#111
- 手动——模型自行调用
sarup_compress/sarup_retrieve。 - 自动——钩子会拦截较大的工具输出,将原文缓存到
SARUP_DB_PATH, 并以压缩视图 + 检索哈希替代。源代码会跳过不处理;较小的输出则保持原样传递。
工具
| 工具 | 用途 |
|---|---|
sarup_compress(content, target_ratio?, lossless?, query?, mode?) | 压缩;返回压缩文本、哈希、令牌指标、verified、token_method。 |
sarup_retrieve(hash) | 逐字节还原原始内容。 |
sarup_stats() | 累计会话节省量。 |
sarup_compress 参数
| 参数 | 类型 | 默认值 | 含义 |
|---|---|---|---|
content | string | — | 要压缩的文本(必填)。 |
target_ratio | number | 0.5 | 保留的正文比例(0.1–0.9)。 |
lossless | boolean | false | 仅应用无损转换(空白字符/JSON 压缩)。 |
query | string | "" | 你需要从文本中获取的内容;与其匹配的句子会被保留。知道需求时请始终传入:在相同大小下,它将 QA 评测结果从 69% 提升到了 100%。 |
mode | string | extractive | 参见下方模式。 |
压缩模式
| 模式 | 方法 | 需要 Ollama | 节省¹ | 速度¹ | 输出 |
|---|---|---|---|---|---|
extractive (默认) | TF-IDF 评分 + 事实加权 + n-gram 去重 | 否 | 52.7% | 约 1 ms | 原文子集 |
semantic | 嵌入中心性 + 余弦去重 | 是 | 63.8% | 约 2 s | 原文子集 |
abstractive | 本地 LLM 改写 | 是 | 44.4% | 约 8 s | 改写文本 |
pipeline | 级联:语义 → 抽象 | 是 | 78.2% | 约 6 s | 改写文本 |
auto | Ollama 正常运行时使用语义模式,否则使用抽取式模式 | 可选 | 63.8% | 约 2 s | 子集 |
¹ 在一段包含 10 个句子的泰语段落(522 个令牌)上测得,改写模型为 gemma4:12b。通过存储机制,所有模式的内容都能 100% 还原;Ollama 模式在后端不可用时会平稳降级为抽取式模式。(gemma4:e4b:pipeline 为 82.2%;2026 年 6 月,gemma3:12b:88.1%。)
抽取式和语义模式的输出是输入句子的原文子集;每当句子被省略时,都会在单独一行显示 […]。包含具体信息(数字、泰语数字、X-Api-Key 等标识符)的句子得分高于一般陈述,因为问题通常会询问这些内容。
实测结果
$ .\.venv\Scripts\python.exe bench\benchmark.py

sample                      before   after   savings   verify
Thai prose                     522     247    52.7%       OK
Thai prose (aggressive)        522     189    63.8%       OK
English prose                  105      60    42.9%       OK
JSON (lossless)                 67      44    34.3%       OK
Logs                           563     300    46.7%       OK
TOTAL                         1779     840    52.8%    ALL OK   → 100% recoverable

Mode comparison (Thai prose, 522 tok):
  extractive 52.7% (1ms) · semantic 63.8% (2.1s) · auto 63.8% (2.1s)
  abstractive 44.4% (8.3s) · pipeline 78.2% (5.8s)      ← gemma4:12b
令牌数通过 tiktoken cl100k_base 计算。它是 OpenAI 的分词器,会低估 Claude 的令牌数,尤其是泰语;bench\benchmark.py --claude 会添加一列 Claude 自带分词器的结果(Anthropic count_tokens,需要 API 密钥)。
Claude 还能答对吗?
只有事实得以保留,减少 Token 才有意义。bench\eval_qa.py 会压缩 8 份泰语文档
(事故报告、会议记录、API 文档、人事政策、产品规格、支持聊天、README、销售
报告;一半是每行一句,另一半是密集段落),然后仅根据压缩后的内容向 Claude Opus 5.5 提出 32 个问题,并以确定性方式评分:
$ .\.venv\Scripts\python.exe bench\eval_qa.py        # uses your local `claude` login

mode               claude tok   saved  correct  abstain  wrong
──────────────────────────────────────────────────────────────
original                 4601    0.0%     100%       0%      0
extractive:0.5           3204   30.4%      69%      31%      0
extractive:0.3           1969   57.2%      44%      56%      0
semantic:0.5             3214   30.1%      62%      38%      0
extractive:0.5+q         3207   30.3%     100%       0%      0
abstractive:0.5          2697   41.6%      91%       9%      0     ← gemma4:12b
pipeline:0.5             1854   59.8%      59%      41%      0     ← gemma4:12b
(gemma4:e4b 的得分相同:抽象式压缩为 91%,流水线为 59%,错误率为 0。)
- 错误率为 0 是安全保障:事实被删除时,Claude 会如实表示不知道(弃答),并会在实际使用中调用
sarup_retrieve。它不会根据剩余内容猜测。 - 弃答 是盲目压缩的实际代价:在
0.5的设置下,大约三分之一的具体问题需要往返检索。知道自己要找什么?将其作为query传入(+q行)。 - 抽象式压缩能以每个 Token 保留最多事实(节省 42% 时保留 91%),因为改写可以在删去文字的同时保留所有数字;抽取式压缩则只能整句删除。它每份文档需要花费数秒,因此请通过
sarup_compress使用,而不是通过钩子。 - 两次评测中,改写都没有把事实转述错,但 8 份文档无法证明改写永远不会出错,因此原文始终可以通过一次
sarup_retrieve调用获取。 - 这里的 Token 数量来自 Claude 自身(取自回答调用的用量),包含约 40 个 Token 的
[sarup: …]页脚。对于这些较短(约 570 个 Token)的文档,页脚占比很高;而对于钩子实际压缩的大型输出,占比则会降低。 - 8 份文档只是小样本;不同模式之间相差几个问题属于随机波动。
在本次评测推动修复之前(2026 年 10 月):密集的泰语段落完全没有被压缩(未安装句子切分器所需的模型),extractive:0.5 的回答正确率为 59%,且有一个错误但信心十足的答案;semantic:0.5 的正确率为 47%。
示例
对一段泰语文本执行真实的 sarup_compress 调用(mode="auto",Ollama 已启动 → 使用语义模式):
// → sarup_compress(content="…518-token Thai paragraph…", mode="auto")
{
  "compressed": "จุดเด่นที่สำคัญที่สุดคือมันไม่มีทางทำให้ Claude พัง…",
  "hash": "caa568140bec0ff734937cf5",
  "original_tokens": 518,
  "compressed_tokens": 154,
  "tokens_saved": 364,
  "savings_percent": 70.3,
  "transforms": ["semantic_extractive", "embeddings", "thai"],
  "lossy": true,
  "verified": true,                    // round-trip proven byte-for-byte
  "token_method": "tiktoken:cl100k_base"
}
模型会继续基于 154 个 Token 的视图工作;只需一次调用即可获取完整的 518 个 Token 原文:
// → sarup_retrieve(hash="caa568140bec0ff734937cf5")
{ "content": "…the exact original text, restored byte-for-byte…" }
安装
作为 Claude Code 插件安装(最简单)
需要 uv:插件通过 uvx 运行 Sarup,并会在首次使用时获取
Python 和依赖项。无需克隆。在 Claude Code 中:
/plugin marketplace add PHUICMT/sarup
/plugin install sarup@sarup
这会安装 MCP 服务、自动压缩钩子和 /sarup:sarup-setup 技能。
缓存位于插件的数据目录中,因此插件更新后仍会保留。首次启动时,uvx 构建环境需要几秒钟。也可以改用 Shell:
claude plugin marketplace add PHUICMT/sarup,然后执行 claude plugin install sarup@sarup。
Ollama 为可选项。不使用它也能离线运行:钩子和默认的
extractive 模式不会调用它;若请求 semantic、abstractive 或 pipeline,则会回退到抽取式模式,并提供一个 setup 字段说明需要安装什么。
sarup_stats 会显示可用内容,而 /sarup:sarup-setup 会引导你添加
Ollama 和下文所列的模型。
从 PyPI 安装(适用于任意 MCP 客户端)
该软件包在 PyPI 上的名称为 sarup。使用 uv 时无需手动安装;只需让任意 MCP 客户端运行 uvx sarup:
{
  "mcpServers": {
    "sarup": {
      "command": "uvx",
      "args": ["sarup"],
      "env": { "SARUP_DB_PATH": "/home/me/.sarup-cache.db" }
    }
  }
}
在不使用插件的情况下于 Claude Code 中配置:claude mcp add sarup -s user -- uvx sarup。钩子命令为
uvx --from sarup sarup-hook --db <same file as SARUP_DB_PATH>。也可以使用 pip install sarup,它会将 sarup 和 sarup-hook 添加到 PATH。
从克隆的仓库安装
一条命令(创建虚拟环境、安装所有内容、为所有项目注册 MCP 服务,且可重复执行):
.\scripts\setup.ps1 -All      # Windows  (-All also adds the hook, the /sarup-setup skill, pulls Ollama models)
./scripts/setup.sh --all      # Linux / WSL / macOS
提示:
-All/--all会安装全局/sarup-setup技能,因此在任何其他机器上,只需在 Claude Code 中输入/sarup-setup,它就会引导你完成安装。(也可以单独运行scripts/install-skill.ps1/install-skill.sh。)
卸载同样干净利落(仅移除 Sarup 添加的内容;-Purge/--purge 还会删除虚拟环境和缓存):
.\scripts\uninstall.ps1       # Windows
./scripts/uninstall.sh        # Linux / WSL / macOS
手动安装
py -3.11 -m venv .venv
.\.venv\Scripts\python.exe -m pip install -e ".[dev]"
可选的本地大模型模式(semantic / abstractive / pipeline)需要 Ollama:
ollama pull nomic-embed-text     # embeddings → semantic mode
ollama pull gemma4:12b           # rewrite → abstractive / pipeline, 7.6 GB (or gemma4:e4b / gemma3:12b)
注册到 Claude Code
一键设置(推荐)。 自动检测此机器上的路径,探测 Ollama(选择最佳模式和模型),并将配置合并到 .mcp.json / .claude/settings.json 中,不会覆盖已有内容(会先创建 .bak 备份):
.\.venv\Scripts\python.exe scripts\install.py --with-hook --pull
- 没有 Ollama?它会配置离线
extractive模式,仍可正常使用。 - Ollama 正在运行?它会为
sarup_compress自动选择nomic-embed-text(语义模式)和最佳的已安装改写模型(gemma4:12b→gemma4:e4b→gemma3:12b→qwen3)。 无论哪种情况,钩子都会保持为extractive(每次工具调用时都会运行)。--pull会获取所有缺失的模型。 - 可重复执行,安全无虞;使用
--global则会写入~/.claude。
手动设置——也可以自行将其添加到 MCP 配置中(例如 .mcp.json 或 ~/.claude.json)。
将 <SARUP_DIR> 替换为克隆此仓库的绝对路径(上述安装程序会自动填入):
{
  "mcpServers": {
    "sarup": {
      "command": "<SARUP_DIR>/.venv/Scripts/python.exe",
      "args": ["-m", "sarup.server"],
      "env": { "SARUP_DB_PATH": "<SARUP_DIR>/.sarup-cache.db" }
    }
  }
}
在 Linux/macOS 上,解释器路径为
<SARUP_DIR>/.venv/bin/python。
或者通过 stdio 直接运行:
.\.venv\Scripts\python.exe -m sarup.server
自动压缩钩子
完全跳过手动工具调用:安装 PostToolUse 钩子,即可在大型 Read/Bash/Grep 输出进入上下文之前对其进行压缩,并缓存原文以供检索。为安全起见,会跳过源代码读取。完整设置说明见 hooks/README.md。
已于 2026 年 10 月修复。 早期版本会将压缩后的文本作为普通字符串返回。 Claude Code 只接受符合工具自身格式的
updatedToolOutput(Bash 使用{stdout, stderr, …},Read 使用{type, file: {content, …}}),并会静默丢弃字符串,因此该钩子在任何界面中都不会生效。现在它会保留每种工具的格式;已在 CLI(2.1.289)上验证:模型会收到压缩后的内容和检索哈希。若要查看钩子在你的构建版本中的行为,请将SARUP_HOOK_LOG设置为文件路径(每次调用记录一行 JSON)。
插件会为你完成这些设置。从克隆的仓库安装时,将 <SARUP_DIR> 替换为你的克隆路径,或运行 install.py --with-hook:
{
  "hooks": {
    "PostToolUse": [
      { "matcher": "Read|Bash|Grep",
        "hooks": [{ "type": "command",
          "command": "<SARUP_DIR>/.venv/Scripts/sarup-hook --db <SARUP_DIR>/.sarup-cache.db" }] }
    ]
  }
}
隐私与数据
为确保能够恢复,Sarup 会将原始内容缓存在存储中。请注意以下两点:
- 设置
SARUP_DB_PATH后,原文会以明文形式写入该 SQLite 文件(不加密)。请将其视为你压缩内容的缓存。 - 如果压缩的工具输出中含有机密信息(例如
.env内容或日志中的凭据),这些内容也会进入缓存。自动钩子会跳过源代码/配置文件读取,但Bash输出不受此限制——请仔细检查你处理的内容。
*.db 已加入 Git 忽略列表,因此缓存绝不会被提交。若要避免在磁盘上留下任何内容,请勿设置 SARUP_DB_PATH(仅存储在内存中;MCP 服务重启后会丢失缓存,且钩子不会替换输出——详见钩子文档)。
配置
| 变量 | 默认值 | 含义 |
|---|---|---|
SARUP_DB_PATH | (内存中) | 用于持久化跨进程存储的 SQLite 路径。获取钩子内容时必需。 |
OLLAMA_HOST | http://localhost:11434 | Ollama 端点。 |
SARUP_ABSTRACTIVE_MODEL | 已安装的最佳模型 | 用于抽象式改写 / 流水线改写的模型。未设置时:依次选择已安装的 gemma4:12b、gemma4:e4b、gemma3:12b、qwen3。 |
SARUP_EMBED_MODEL | nomic-embed-text | 用于语义嵌入的模型。 |
SARUP_HOOK_MODE | extractive | 钩子压缩模式。auto/semantic 需要 Ollama,每次工具调用耗时约 2 秒。 |
SARUP_HOOK_MIN_TOKENS | 400 | 仅当输出至少包含这么多令牌时,钩子才会压缩(基于令牌计数,在不同语言间公平适用)。 |
SARUP_HOOK_LOG | (关闭) | 用于追加记录的文件,每次钩子调用写入一行 JSON(事件、工具、大小、是否替换)。 |
项目结构
sarup/
├── src/sarup/
│   ├── server.py       # MCP stdio server — 3 tools
│   ├── compressor.py   # router + modes (extractive/semantic/abstractive/pipeline/auto)
│   ├── thai.py         # PyThaiNLP tokenization, sentence split, TF-IDF
│   ├── semantic.py     # embedding centrality + cosine dedup
│   ├── llm.py          # optional Ollama backend (generate + embed)
│   ├── tokens.py       # real token counting (tiktoken)
│   └── store.py        # CCR store: hash → original (memory + SQLite)
├── hooks/
│   ├── sarup_hook.py   # PostToolUse auto-compression hook
│   └── README.md       # hook install guide
├── bench/benchmark.py  # before/after measurement
├── tests/              # test_thai, test_mcp, test_hook, ...
├── README.md
└── STACK.md            # full stack + techniques
技术栈与技术
Python 3.11 · MCP · PyThaiNLP newmm · tiktoken · Ollama(可选)· SQLite · hatchling · pytest。
各模式背后的技术——TF-IDF 评分、嵌入中心性、级联流水线、内容路由和优雅降级——详见 STACK.md。
测试
.\.venv\Scripts\python.exe -m pytest tests/ -q
测试套件涵盖泰语 NLP、MCP 工具契约、所有模式(包括 Ollama 回退路径)、往返验证保证,以及自动压缩钩子(包括跨进程检索)。
质量评估单独进行,因为它需要模型:bench\eval_qa.py(参见
Claude 还能正确回答吗?)。默认使用本地
claude CLI 运行,也可使用 --backend api 并提供 Anthropic API 密钥;--dry-run 和
--limit 可降低检查成本;完整运行约需调用 Claude 170 次。
发布
- 在
pyproject.toml和server.json(其中两个位置)中更新version。 - 推送匹配的标签:
git tag v0.2.0 && git push origin v0.2.0。publish工作流 会执行测试、构建,并通过可信发布上传到 PyPI(无需令牌)。 - 在 MCP 注册表中列出此版本:先运行
mcp-publisher login github,再运行mcp-publisher publish(会读取server.json;本 README 顶部的mcp-name注释可证明 PyPI 软件包归属该项目)。
插件无需执行这些操作:它直接从仓库安装,并随每次提交更新。
路线图
- 将 QA 评估扩展到 8 份以上文档(长工具输出、日志、混合代码),再据此更改默认设置,例如从
auto改为 semantic。 - 升级到
mcp2.x(目前固定为<2:2.x 移除了Server.list_tools)。 - 可选支持 Typhoon 2.1 抽象式改写(受 Ollama 模板修复阻碍)。
- 按内容自适应调整
target_ratio。 - 已发布 PyPI 软件包(
sarup)并列入 MCP 注册表(io.github.PHUICMT/sarup)。 - 可作为 Claude Code 插件安装。
许可证
MIT
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。