关于 kairn
Kairn 是面向 AI Agent 的本地优先知识引擎,以知识图谱和情境路由保存并检索跨会话信息。它通过渐进式披露加载相关内容,并结合随时间衰减的经验记忆。
主要功能
- 01以类型关系构建知识图谱
- 02按关键词路由相关上下文
- 03渐进式披露摘要与详情
- 04保存并衰减经验记忆
- 05按置信度路由知识存储
- 06按工作区隔离 SQLite 数据
适用场景
- 01跨会话记住决策和解决方案
- 02查询项目中的关联知识
- 03按主题召回图谱与经验内容
- 04为每个工作区隔离项目记忆
MCP 相关
Kairn 通过 stdio MCP 服务连接 MCP 客户端,提供 22 个工具、只读资源和会话管理提示词,用于保存、搜索和召回知识图谱及经验记忆。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
我们还没有获取到这个服务的安装包或远程地址,请按项目 README 中的说明安装。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
Kairn
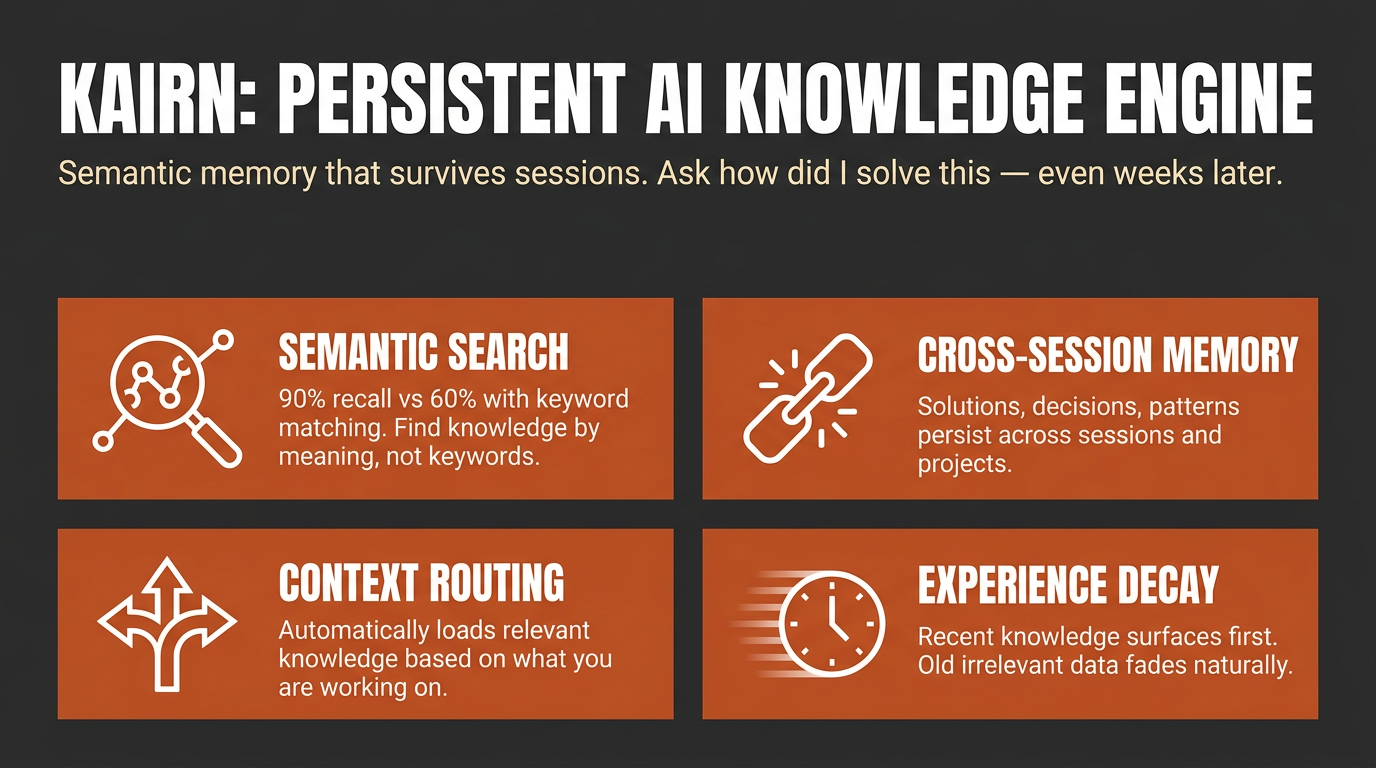
在 GitHub 上观看 30 秒演示。
面向 AI 助手的上下文感知知识引擎。
状态:预 1.0 版本。 自 2026 年 2 月起日常使用,测试套件可在 Linux、macOS 和 Windows 上运行(参见开发),并已发布 LongMemEval-S 基准测试(测量时间早于 0.3.0)。在 1.0 版本发布前,各版本间的接口仍可能发生变化。欢迎反馈和提交问题。
其他工具为 AI 提供记忆。Kairn 则为它提供带有智能上下文路由的知识图谱。它知道要加载什么、何时加载,以及加载多少——让 AI 保持专注,不被信息淹没。
pip install kairn-ai
kairn init ~/brain
kairn serve ~/brain
Claude Code 和 Codex 各只需一行;--init 会在首次启动时创建 ~/brain 及其数据库,因此即使没有运行 kairn init 也能使用:
claude mcp add kairn -- kairn serve --init ~/brain
codex mcp add kairn -- kairn serve --init ~/brain
或者将其安装为一键式捆绑包,无需配置 Python:从最新版本下载
.mcpb 文件,然后用 Claude Desktop 等支持捆绑包的应用打开。
其他客户端请参阅下方的快速入门。刚接触 Kairn?请跳转到前 5 分钟。
安装方式
| 方式 | 适用对象 | 命令 |
|---|---|---|
| PyPI | 所有使用 Python 的用户,以及所有 MCP 客户端 | pip install kairn-ai |
MCP Bundle(.mcpb) | Claude Desktop 和其他支持捆绑包的应用;无需安装 Python | 从 Releases 下载并打开 |
| Claude Code | 一行命令,使用 PyPI 安装 | claude mcp add kairn -- kairn serve --init ~/brain |
| Codex | 一行命令,使用 PyPI 安装 | codex mcp add kairn -- kairn serve --init ~/brain |
此捆绑包不包含任何 Kairn 源代码。它将 kairn-ai 声明为依赖项,由宿主通过 uv 解析,因此捆绑包安装和 pip install 运行的是相同代码。安装捆绑包时可以配置数据库的存放位置;默认位于 ~/.kairn,且不会离开你的设备。
为什么选择 Kairn?
每次 AI 对话都从头开始。之前的见解、决策和模式——全都消失。现有的记忆工具只能存储扁平的键值对,无法表示关系,也无法在合适的时机呈现恰当的上下文。
Kairn 与众不同:
- 上下文路由器 + 渐进式披露——根据关键词自动加载相关子图,从摘要开始,仅在需要时深入查看细节。没有其他工具能做到这一点。
- 结合 FTS5 的知识图谱——并非扁平存储。节点之间具有类型化关系(
depends-on、resolves、causes),并提供来源追踪以及覆盖所有内容的全文搜索。 - 经验衰减 + 自动提升——经验会随时间推移而降低相关性(生物衰减模型)。频繁访问的经验会自动提升为永久知识。你的 AI 会自然遗忘无关紧要的内容。
- 22 个 MCP 工具——适用于 Claude Code、Codex、Claude Desktop、Cursor、VS Code、Windsurf 和任何 MCP 客户端。包含用于 5 种动词关系判断的
kn_judge,以及用于只读健康诊断的kn_doctor。 - 按工作区隔离——每个工作区都拥有独立隔离的 SQLite 存储。团队部署支持 JWT 身份验证和基于角色的访问控制(owner / maintainer / contributor / reader)。
快速入门
Claude Desktop
在 macOS 上添加到 ~/Library/Application Support/Claude/claude_desktop_config.json,或在 Windows 上添加到 %APPDATA%\Claude\claude_desktop_config.json:
{
  "mcpServers": {
    "kairn": {
      "command": "kairn",
      "args": ["serve", "--init", "~/brain"]
    }
  }
}
Cursor
添加到 .cursor/mcp.json:
{
  "mcpServers": {
    "kairn": {
      "command": "kairn",
      "args": ["serve", "--init", "~/brain"]
    }
  }
}
VS Code
添加到 .vscode/mcp.json:
{
  "servers": {
    "kairn": {
      "type": "stdio",
      "command": "kairn",
      "args": ["serve", "--init", "~/brain"]
    }
  }
}
Windsurf
添加到 ~/.codeium/windsurf/mcp_config.json:
{
  "mcpServers": {
    "kairn": {
      "command": "kairn",
      "args": ["serve", "--init", "~/brain"]
    }
  }
}
重启编辑器。Kairn 的 22 个工具会显示在 MCP 部分。
前 5 分钟
端到端完成首次运行的引导:
pip install kairn-ai
kairn init ~/brain              # creates the workspace + database (optional: serve --init does it on first start)
添加上面的一行配置(或客户端的 Quick Start 代码片段),然后重启客户端。连接成功后,让助手记住一件事:
“记住,我们为分析服务选择了 Postgres 而不是 SQLite,因为我们需要支持并发写入者。”
这会在底层调用 kn_learn,并返回如下 JSON 封装(通过 kairn learn 从真实运行中捕获;这是该工具的 CLI 镜像):
{"_v": "1.0", "stored_as": "node", "node_id": "002d9c22", "experience_id": "d0710c2f", "type": "decision", "confidence": "high", "namespace": "knowledge", "candidates": []}
开启一个新会话,让它回想同一件事——这会调用 kn_recall,并呈现刚才存储的内容,无需重新解释:
{"_v": "1.0", "count": 2, "results": [
  {"source": "node", "id": "002d9c22", "name": "Decision: we chose Postgres over SQLite for the analytics service beca", "type": "learned_decision", "description": "we chose Postgres over SQLite for the analytics service because we needed concurrent writers", "relevance": 1.0, "relevance_kind": "match"},
  {"source": "experience", "id": "d0710c2f", "type": "decision", "content": "we chose Postgres over SQLite for the analytics service because we needed concurrent writers", "confidence": "high", "relevance": 1.0, "relevance_kind": "recency"}
]}
kn_learn 同时存储了一个永久图节点和一条会随时间衰减的经验(高置信度会同时存储两者,参见置信度路由);kn_recall 根据一个由三个词组成的主题找到了两者。
读取 relevance_kind 后再读取 relevance。 上面两行都显示 1.0,但含义并不相同。match 是词法匹配强度(bm25);经验的 recency 是时间衰减值——它为 1.0 是因为该行刚创建几秒钟,而不是因为匹配度高。第三个值 similarity 是语义召回路径上的嵌入余弦相似度;unscored 则表示该行没有可用的排序分数,系统填入了一个常量。不同类型的数值不可比较,因此不要只根据 relevance 对混合结果集排序。kn_recall 的 min_relevance 也要注意:它用一个数值,分别按匹配强度筛选节点、按新近度筛选经验,而两者的尺度不同。对于仅处理经验的 kn_memories 和 kn_prune,它表示新近度;在 kn_prune 中,它会删除数据。
随时运行 kairn status ~/brain 进行冒烟测试——如果它输出 JSON 统计信息块(节点/边/经验数量),说明工作区运行正常。想要用脚本演示所有核心功能,而不是手动操作?运行 kairn demo ~/brain——它会在大约 30 秒内演示节点创建、查询、经验保存、学习、召回和上下文处理。
何时使用哪个工具
22 个工具,第一天很难全记住。大多数会话只需要这些:
| 你想要…… | 使用 | 原因 |
|---|---|---|
| 记住新内容(决策、易踩的坑、模式、解决方案) | kn_learn | 默认入口——自动路由到永久节点(高置信度)或会衰减的经验(中/低置信度),无需自行判断 |
| 在用户表达偏好的当下记录明确陈述的用户偏好 | kn_preference | 专用的偏好写入路径——由你(调用模型)用一个明确的句子陈述该偏好;其半衰期比其他任何类型都长 |
| 添加你已确认持久有效的永久命名概念 | kn_add | 完全跳过衰减——用于结构性知识,而非日常经验 |
| 记录一次性经验,并明确控制置信度/衰减 | kn_save | kn_learn 封装的底层原语——想自行设置置信度/衰减时使用 |
| 按文本、类型、标签或命名空间搜索永久知识图谱 | kn_query | 你要找的是节点,而不是会衰减的经验 |
| 搜索已保存的经验,并按相关性和衰减程度排序 | kn_memories | 你要找的是经验内容(解决方案、易踩的坑、变通方法),而不是图谱节点 |
| 一次调用就获取与某个主题相关的所有内容 | kn_recall(扁平列表)或 kn_context(子图,渐进式披露:先显示摘要,需要时再查看完整详情) | 你还不知道答案属于节点还是经验——让 Kairn 两者都搜索 |
其他所有工具(kn_crossref、kn_related、kn_connect、kn_judge、kn_project/kn_projects/kn_log、kn_idea/kn_ideas、kn_promote_pending、kn_prune、kn_remove、kn_status、kn_doctor)都属于进阶用法——掌握基础用法后,请参阅下方完整的 22 个工具参考。
22 个工具(kn_ 前缀)
所有工具都遵循 MCP 协议,并返回 JSON 响应。
图谱(6)
| 工具 | 描述 |
|---|---|
kn_add | 向知识图谱添加节点 |
kn_connect | 在节点之间创建类型化边(宽松模式词汇) |
kn_judge | 记录 5 种动词判断边(严格模式:conflicts_with / supersedes / compatible / scoped / related) |
kn_query | 按文本、类型、标签、命名空间搜索 |
kn_remove | 软删除节点或边(可安全撤销) |
kn_status | 图谱统计、健康状况、系统概览 |
项目记忆(3)
| 工具 | 描述 |
|---|---|
kn_project | 创建或更新项目 |
kn_projects | 列出项目、切换当前项目 |
kn_log | 记录进度或失败条目 |
经验记忆(5)
| 工具 | 描述 |
|---|---|
kn_save | 保存会衰减的经验 |
kn_preference | 在用户表达时记录明确陈述的用户偏好(半衰期最长) |
kn_memories | 搜索时考虑衰减的经验 |
kn_prune | 移除已过期的经验 |
kn_promote_pending | 将访问频繁的经验提升为永久节点 |
想法(2)
| 工具 | 描述 |
|---|---|
kn_idea | 创建或更新想法 |
kn_ideas | 按状态、类别列出/筛选想法 |
智能功能(5)
| 工具 | 描述 |
|---|---|
kn_learn | 以置信度路由方式存储知识 |
kn_recall | 获取相关的过往知识 |
kn_crossref | 在当前工作区中查找相似的过往解决方案 |
kn_context | 关键词 → 相关子图,并渐进式披露 |
kn_related | 遍历图谱(BFS)以查找关联节点 |
诊断(1)
| 工具 | 描述 |
|---|---|
kn_doctor | 只读健康检查(锁定模式、FTS5 一致性、提升积压、命名空间膨胀、孤立边)——返回结构化封装,其中包含各项检查的判定结果和汇总摘要 |
资源与提示词
资源(供 MCP 客户端只读的上下文):
kn://status- 图谱概览、活跃项目kn://projects- 所有项目及近期进展kn://memories- 近期高相关度经历
提示词(会话管理):
kn_bootup- 加载活跃项目、近期进展和重要记忆(会话开始时)kn_review- 总结会话并建议后续步骤(会话结束时)
工作原理
架构
Any MCP Client (Claude, Cursor, VS Code)
        │
        ▼ MCP Protocol (stdio)
FastMCP Server (22 tools)
        │
   ┌────┼────┐
   ▼    ▼    ▼
Graph  Memory  Intelligence
Engine Engine  Layer
   │    │      │
   └────┼──────┘
        ▼
   SQLite + FTS5
   (per-workspace)
衰减模型
经历的相关性会按指数规律降低:
relevance(t) = initial_score × e^(-decay_rate × days)
| 类型 | 半衰期 | 说明 |
|---|---|---|
| solution | 120 天 | 稳定、持久 |
| pattern | 90 天 | 架构知识 |
| decision | 100 天 | 取决于上下文 |
| workaround | 40 天 | 临时修复会快速淡化 |
| gotcha | 70 天 | 棘手陷阱仍具相关性 |
| preference | 180 天 | 持久的用户偏好——初始估值,尚未根据访问尾部分布校准 |
半衰期是根据生产经历存储中真实的访问尾部分布校准得出的,而非猜测(有一个例外:preference 是一种新类型,目前没有访问历史,因此其数值是有记录的初始估值,待真实数据积累后再调整)。
通过 kn_learn 进行置信度路由:
high→ 永久节点 + 经历(不衰减)medium→ 经历,衰减速度加快 2 倍low→ 经历,衰减速度加快 4 倍- 自动晋升:访问次数达到 5 次及以上 → 永久节点
- 节点访问跟踪:
kn_recall、kn_context和kn_crossref会记录访问过的节点,为衰减和晋升流程提供数据
基准测试
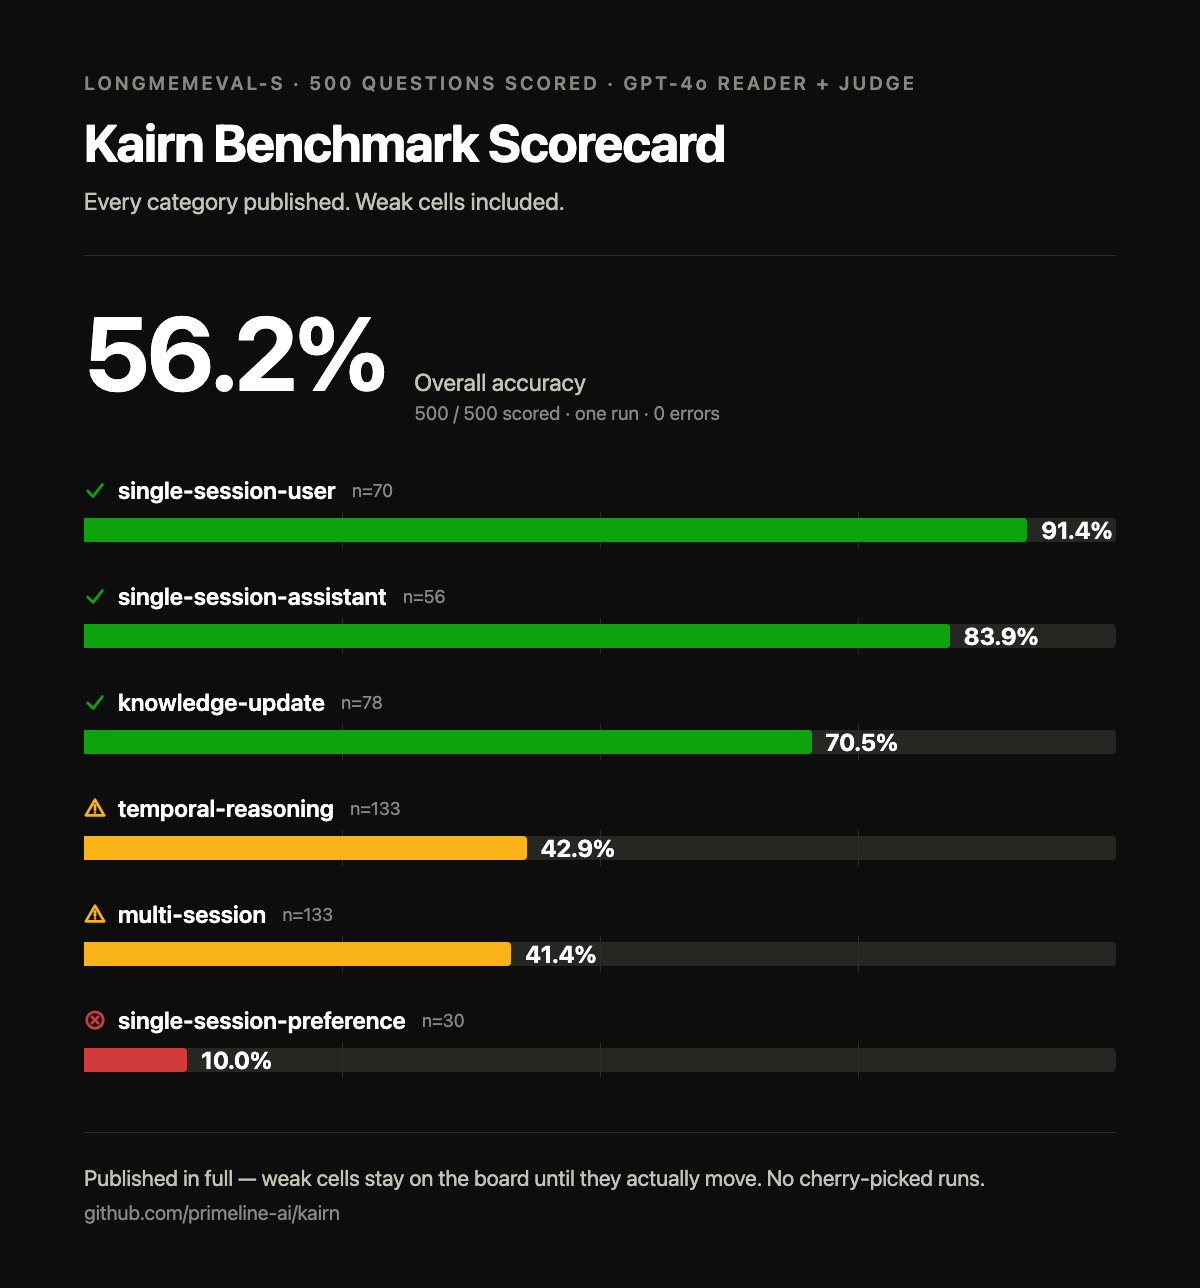
Kairn 在 2026-06-12 的测试中,LongMemEval-S 总体得分为 56.2%(500/500 道题完成评分, 由 GPT-4o 读取并判分,单次运行,0 个错误)。以下是各类别的实际数据, 包括表现不佳的类别——每个红色单元格都链接到对应的分析:
| 类别 | n | 准确率 | 分析 |
|---|---|---|---|
| 单会话-用户 | 70 | 91.4% | - |
| 单会话-助手 | 56 | 83.9% | - |
| 知识更新 | 78 | 70.5% | - |
| 时间推理 | 133 | 42.9% | 原因 |
| 多会话 | 133 | 41.4% | 原因 |
| 单会话-偏好 | 30 | 10.0% | 原因 |
500 道题中包含 30 道拒答变体(正确答案是拒绝作答);它们计入上述所属类别, 并单独评分:Kairn 对其中 96.7% 的题目都正确拒答。
该次运行中的召回延迟约为每次查询 1.4 ms(FTS5、进程内、无网络)。协议、 诚信说明和复现步骤:BENCHMARKS.md。
这些数据测于 2026-06-12,早于 0.3.0 中的召回改进(基于匹配度的经历评分、按覆盖率加权的节点相关性),目前尚未在 0.3.0 上重新测量。薄弱项会一直保留在榜单上,直到数据确实有所变化。没有挑选有利的运行结果,也没有隐藏类别。
命令行
kairn init [<path>]            # Initialize workspace; defaults to ~/.kairn
kairn serve [<path>]           # Start MCP server (stdio); defaults to ~/.kairn
kairn serve --init [<path>]    # Create workspace if needed and start MCP server; defaults to ~/.kairn
kairn status <path>            # Graph stats
kairn demo <path>              # Interactive tutorial
kairn benchmark <path>         # Local performance benchmarks (latency, not LongMemEval)
kairn token-audit <path>       # Audit tool token usage
kairn import git <path> <repo>...  # Import git commit history (zero-LLM, offline)
kairn import claude-code <path>    # Import Claude Code session history (zero-LLM, offline)
导入历史记录
kairn import git <workspace> <repo>... 会从 $0 处的一个或多个本地 git 仓库补充 Kairn 存储——不会调用大模型,也不会进行网络调用。约定式提交前缀会映射到经验类型(fix: -> 解决方案,feat:/refactor:/perf: -> 模式,其他情况 -> 决策);合并提交会被跳过。导入的经验会放入专用的 imported-git 命名空间,与自然积累的知识分开,因此始终可以区分,错误的导入也完全可撤销。
kairn import git ~/brain ~/code/my-project --dry-run   # Preview first
kairn import git ~/brain ~/code/my-project              # Then import for real
kairn import git ~/brain ~/code/proj-a ~/code/proj-b --since 2026-01-01
支持幂等操作——再次运行时只会导入尚未导入的提交,因此随着仓库历史增长,可以安全地再次运行。
Claude Code 转录记录
kairn import claude-code <workspace> 会从现有的 Claude Code 会话历史记录补充 Kairn 存储,同样免费且完全离线。不指定 --root 时,它会扫描 ~/.claude/projects;--root PATH 可重复指定,用于覆盖其他文件夹。导入的经验会放入独立的 imported-claude-code 命名空间,与自然积累的知识保持区分,错误的导入也可以撤销。
kairn import claude-code ~/brain --dry-run              # Review exactly what would be stored
kairn import claude-code ~/brain                        # Import (prompts once before writing)
kairn import claude-code ~/brain --root ~/other/projects --since 2026-01-01 --yes
存储内容(粗略模式): 每个会话对应一条经验——会话标题加上该会话中的第一条提示词。这种设计有意采用低细节、高精度的摘要,而不是细致地提取每个决策:基于规则且不调用大模型的提取器无法可靠地区分已记录的决策与普通的规划讨论,因此 import claude-code 会导入干净的会话级索引,而不是嘈杂的片段。这不是完整的转录记录归档,也不是一次性迁移——它支持幂等操作,旨在随着历史记录增长而重复运行。
隐私。 每个存储的字符串都会先经过确定性的机密信息脱敏处理(API 密钥、Authorization/Bearer 标头、password=/token=/secret= 赋值、常见供应商密钥格式、私钥块、嵌入 URL 的凭据)。工具输出和工具调用块绝不会被读取,只读取你自己的提示词文本。脱敏只是纵深防御,并非唯一的控制措施:真实运行(非演练)需要明确确认,且 --dry-run 会在写入任何内容前显示脱敏后的确切文本。脱敏能力受规则集范围限制,因此建议首次真实导入前先使用 --dry-run 检查;任何内容都不会离开你的设备。
作为插件安装
该插件需要 uv。
Claude Code:
claude plugin marketplace add primeline-ai/kairn
claude plugin install kairn@kairn
Codex:
codex plugin marketplace add primeline-ai/kairn
codex plugin add kairn@kairn
如果你已经通过 claude mcp add kairn 或 codex mcp add kairn 添加了 Kairn,请先使用 claude mcp remove kairn 或 codex mcp remove kairn 移除该条目,或者只保留一种安装方式,因为两种方式使用的名称都是 kairn。
有关插件功能以及 codex exec 审批说明,请参阅插件 README。
配置
KAIRN_WORKSPACE=~/brain               # Sets where config.yaml is read from and where 'kairn workspace' keeps team data; 'kairn serve' opens the store at the given path, or ~/.kairn without one, regardless of KAIRN_WORKSPACE
KAIRN_JWT_SECRET=<your-secret>        # Required for team features
KAIRN_LOG_LEVEL=WARNING               # Level of Kairn's log lines on stderr: DEBUG, INFO, WARNING, ERROR or CRITICAL; default INFO; overrides log_level in config.yaml
设置位于 <workspace>/config.yaml;kairn init 会写入该文件,而 serve --init 不会,因此如果你是从 serve --init 开始使用,请手动创建该文件。没有该文件时将应用默认设置。语义召回默认关闭,需主动启用。它会使用本地 Ollama 服务提供的嵌入向量对召回结果重新排序,因此存储的内容不会离开你的设备。
semantic_recall: true
embedding_model: bge-m3                 # ollama pull bge-m3
embedding_host: http://localhost:11434
semantic_recall_floor: 0.5              # cosine floor below which semantic recall abstains
semantic_recall_top_n: 30               # keyword candidates reranked by embeddings
experience_min_match: 0.0              # match floor for experience recall, 0.0-1.0; 0 turns it off
开发
git clone https://github.com/primeline-ai/kairn
cd kairn
pip install -e ".[dev,team]"
pytest tests/ -v --cov
ruff check src/ && ruff format src/
项目结构
src/kairn/
├── server.py              # FastMCP server + 22 tools
├── cli.py                 # CLI commands
├── config.py              # Configuration
├── core/
│   ├── graph.py           # GraphEngine (6 tools)
│   ├── memory.py          # ProjectMemory (3 tools)
│   ├── experience.py      # ExperienceEngine (4 tools)
│   ├── ideas.py           # IdeaEngine (2 tools)
│   ├── intelligence.py    # IntelligenceLayer (5 tools)
│   └── router.py          # ContextRouter
├── storage/
│   ├── base.py            # Storage interface
│   └── sqlite_store.py    # SQLite + FTS5 implementation
├── models/                # Data models
├── events/                # Event bus
└── auth/                  # JWT + RBAC (team feature)
性能
请自行测量,不要盲目相信此表:
kairn benchmark ~/brain --nodes 100
在 Apple M4 Pro 上,使用该命令运行一次,处理 100 个节点:
| 操作 | 测量结果 |
|---|---|
| 插入 | 每个节点 0.7ms(1,479 次操作/秒) |
| FTS5 查询 | 0.2ms(5,552 次操作/秒) |
| 图遍历 | 6.0ms(166 次操作/秒) |
这是在一台机器上运行一次的结果,因此应将其视为大致表现,而非规格指标——这也是将命令放在表格上方的原因。kn_connect 和 kn_crossref 过去曾在此处列出基准测试并未得出的数据;我们选择移除这些数据,而不是估算。
使用方
| 项目 | 使用 Kairn 的用途 |
|---|---|
| Quantum Lens | 持久化洞察存储、跨分析模式跟踪、透镜效果指标 |
| Claude Code Starter System | 会话记忆、项目状态、学习持久化 |
许可证
MIT
PrimeLine 生态系统的一部分
| 工具 | 功能 | 深入了解 |
|---|---|---|
| Evolving Lite | 自我改进的 Claude Code 插件——记忆、委派、自我纠正 | 博客 |
| Kairn | 面向 AI 的持久化知识图谱,支持上下文路由 | 博客 |
| tmux Orchestration | 并行 Claude Code 会话,支持心跳监控 | 博客 |
| UPF | 采用对抗式强化的三阶段规划 | 博客 |
| Quantum Lens | 用于多视角分析的 7 种认知透镜 | 博客 |
| PrimeLine Skills | 5 种适用于生产环境的 Claude Code 工作流技能 | 博客 |
| Starter System | 轻量级会话记忆与交接 | 博客 |
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。