关于 ContextSmith
ContextSmith 是面向编码 Agent 用户的本地代码上下文引擎。它结合代码索引与混合搜索,在指定 Token 预算内提供与任务相关的代码。
主要功能
- 01本地仓库索引
- 02词法与语义混合搜索
- 03代码图谱与 Git 历史
- 04按 Token 预算打包上下文
- 05符号影响与关系查询
- 06持久化代码备注
适用场景
- 01为编码 Agent 提供精简代码上下文
- 02在陌生仓库中查找相关函数
- 03修改符号前检查调用方
- 04跨会话保留代码相关决策
MCP 相关
它以 MCP 服务运行,向 MCP 客户端提供 `get_context`、`search`、`find_symbol` 和 `impact` 等工具。服务会在回答前刷新索引。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
10收录的工具列表 · 更新于 4 天前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| task | string | 是 | |
| budget_tokens | integer | 否 |
详细介绍
ContextSmith
为你的编码 Agent 提供正确的代码,而不是更多代码。
适用于 Claude Code、Cursor、Codex 和任何 MCP Agent 的本地上下文引擎。它会将你的 代码仓库编入代码图谱,结合混合搜索与 Git 历史记录,并针对每项任务提供重要代码, 打包进你选择的 token 预算中。



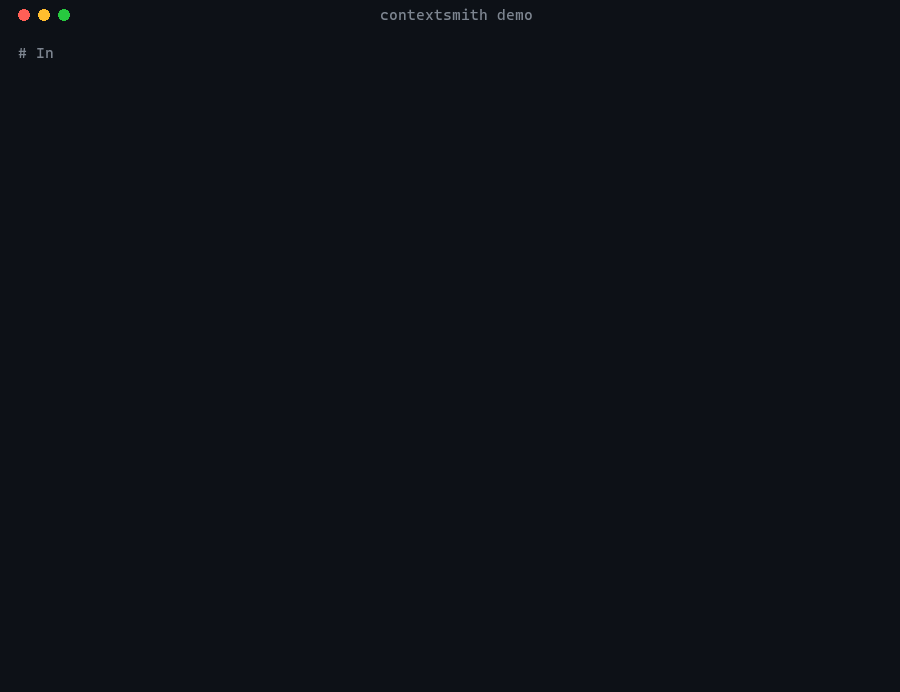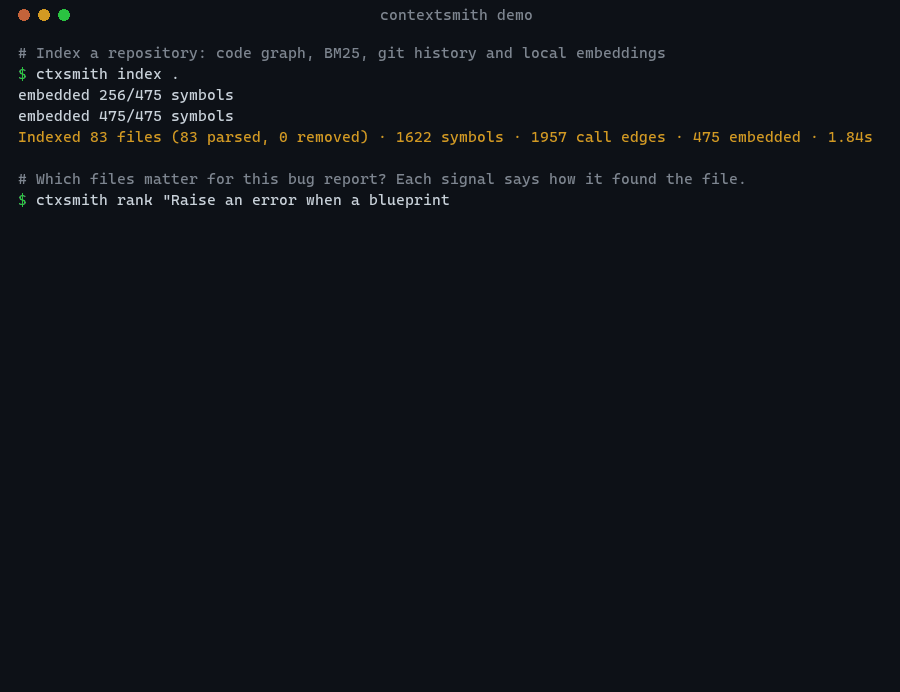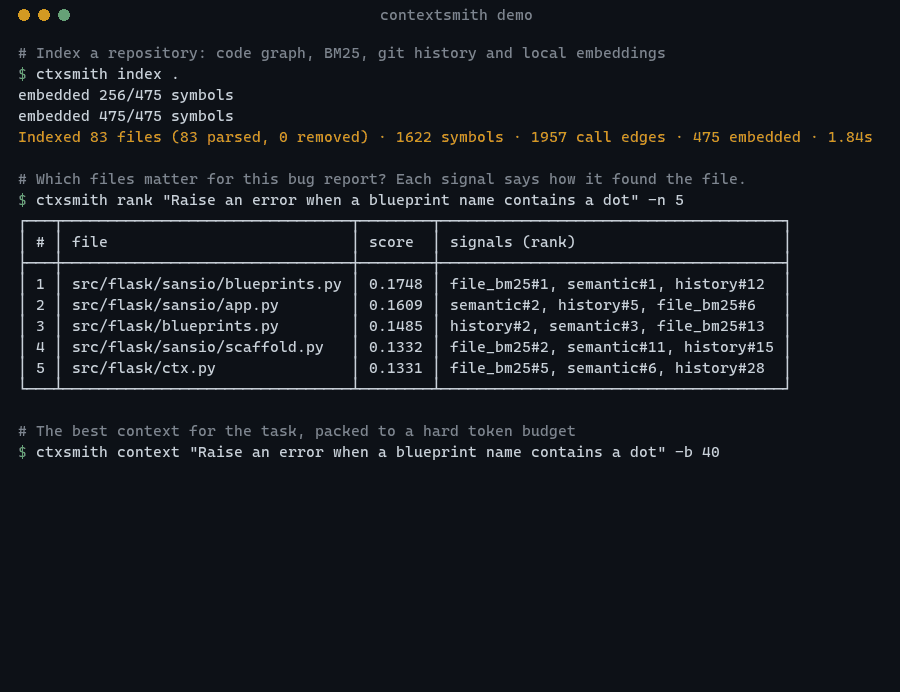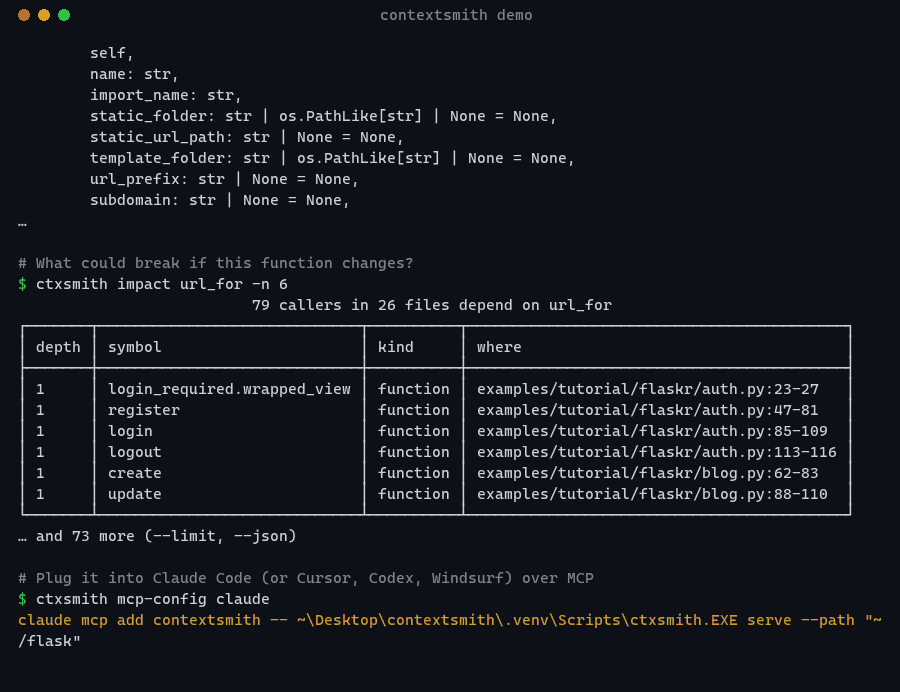
▶ 观看 60 秒视频:索引、上下文打包、实时 MCP 调用和基准测试。
编码 Agent 会把上下文窗口浪费在无关代码上。它们会搜索、打开整个文件,在找到需要修复的函数之前就耗尽空间,而且你要为它们读取的每个 token 付费。ContextSmith 会尽可能出色地回答一个问题:给定这项任务和 N 个 token,Agent 应该读取哪些代码?
| 92% 真实缺陷修复所需的文件都出现在 4,000-token 上下文中 而搜索 + 整个文件的比例为 29% | 1.7 倍 展示出需要修改的确切代码行的概率更高 48% 对比 29%,预算相同 | 100% 本地 无需 API 密钥,无需云服务, 代码绝不会离开本机 |
测试数据来自 SWE-bench Lite 的 114 个 Django 问题,调优过程从未接触过这些问题。方法与完整结果。
快速开始(60 秒)
pipx install "contextsmith[semantic]"      # or: pip install "contextsmith[semantic]"
cd your-repo
ctxsmith index                              # once; afterwards only changed files are re-read
ctxsmith context "Coupons are applied twice at checkout" --budget 4000
将它连接到你的 Agent(命令会打印适用于你机器的确切配置行):
ctxsmith mcp-config claude    # or: cursor, windsurf, codex
claude mcp add contextsmith -- ctxsmith serve --path /path/to/your-repo
之后,Agent 会自行调用 get_context,获取经过排序并符合预算的代码,而不是使用 grep 搜索。即使没有 [semantic] 额外组件,所有功能仍可正常使用,只是仅采用关键词搜索。
适用对象
开发者
- 在大型代码仓库中获得更快、更出色的 Agent 会话。 Agent 从正确的函数开始,而不是四处探索;减少错误修改和“我找不到”的反复尝试。
- 理解不熟悉的代码。
ctxsmith context "where are payment retries handled?"会返回相关函数及其文件和行号。 - 安全地进行修改。
ctxsmith impact charge_card会列出所有直接或间接调用它的内容:在修改之前,了解这项更改可能造成的影响。 - 记住容易忽略的注意事项。
ctxsmith note add "never call without the account lock" --symbol charge_card会将备注固定到代码上;之后每次为你和 Agent 提供该代码的上下文时,都会显示这条备注。
团队和公司
| 需求 | ContextSmith 如何满足 |
|---|---|
| 不得离开公司内部环境的代码(金融、医疗、政府、企业知识产权) | 完全在开发者的机器上运行。解析、搜索和嵌入都在本地完成;网络仅用于一次性下载两个小型开源模型,你可以在内部镜像这些模型,以供隔离网络的机器使用 |
| 可预测的 AI 支出 | 每个回答都有你设定的硬性令牌预算,因此每项任务的上下文成本是固定的,而不是“Agent 打开了什么就算什么” |
| 兼容你已经付费使用的 Agent | 标准 MCP 服务:Claude Code、Cursor、Windsurf、Codex、Copilot Agent 和内部 Agent 都使用同一索引 |
| 入职培训 | 新工程师及其 Agent 可以用日常语言提问,并快速找到合适的代码 |
| 代码审查和 CI | ctxsmith context "$PR_TITLE" -b 6000 可为审查机器人提供 PR 涉及并依赖的代码;ctxsmith impact NAME 可显示影响范围 |
| 团队知识 | 决策和不变量以备注形式保存在代码旁,而不是只存在某个人的脑海里 |
| 无供应商锁定,无需采购 | MIT 许可(允许商业使用),每个代码仓库一个 SQLite 文件,无需运行服务,也无需账户 |
典型的部署方式:每位开发者使用 pipx 安装,在工作所涉及的代码仓库中运行
ctxsmith index,然后在 Agent 中添加一行 MCP 配置。无需托管任何内容。
有关 CI 和离线配置,请参阅在公司中使用。
AI 工具构建者
ContextSmith 也是一个 Python 库。你可以将它用作自有 Agent、审查机器人或内部助手的检索层:
from contextsmith import Engine

eng = Engine("path/to/repo")
eng.index()
pack = eng.context("Fix the race when two users book the last seat", budget=6000)
prompt = f"{pack.text}\n\nTask: fix the race when two users book the last seat."
结果
测试方法:从 SWE-bench Lite 中选取一个真实的 GitHub issue,将仓库检出到该 issue 对应的提交(这样就不会泄露未来的代码或历史记录),把 issue 文本交给工具,然后检查实际修复所修改的代码是否会被检索出来。
Django 上的最终测试:114 个 issue,调优过程中从未见过。
| BM25,完整文件 | ContextSmith | |
|---|---|---|
| 修复文件排名第 1 / 进入前 3 / 前 5 | 50.9% / 70.2% / 77.2% | 51.8% / 79.8% / 85.1% |
| 修复文件位于 4,000 个 token 的上下文中 | 28.9% | 92.1%(3.2 倍) |
| 修复修改的确切代码行显示在 4,000 个 token 中 | 28.9% | 48.1%(1.7 倍) |
| 查询时间(中位数,笔记本 CPU,2,800 个文件的仓库) | 145 ms | 238 ms |
基线方法会按 BM25 排名,依次粘贴完整文件,直到用完预算,这正是“搜索仓库并打开文件”的 Agent 所采用的方式。ContextSmith 将相同数量的 token 用于重要函数和其余部分的轮廓,因此几乎总能纳入正确的文件。
所有策略与消融实验
| strategy | R@1 | R@3 | R@5 | R@10 | 4k 内的文件 | 8k 内的文件 | 4k 内的代码行 | 8k 内的代码行 | ms |
|---|---|---|---|---|---|---|---|---|---|
| BM25,完整文件 | 50.9 | 70.2 | 77.2 | 84.2 | 28.9 | 49.1 | 28.9 | 49.1 | 145 |
| 词法(无嵌入) | 48.2 | 74.6 | 78.9 | 86.0 | 86.0 | 89.5 | 42.3 | 46.2 | 145 |
| 仅嵌入 | 48.2 | 69.3 | 78.9 | 86.8 | – | – | – | – | 249 |
| ContextSmith(默认) | 51.8 | 79.8 | 85.1 | 88.6 | 92.1 | 96.5 | 48.1 | 50.7 | 238 |
| + 交叉编码器重排 | 34.2 | 73.7 | 81.6 | 91.2 | – | – | – | – | 1824 |
| 不使用 git 历史记录 | 56.1 | 78.9 | 84.2 | 90.4 | – | – | – | – | 249 |
消融实验的结论,包括未奏效的尝试:
- **嵌入值得保留:**将其加入词法排序器后,前 5 名命中率从 79% 提升到 85%,确切代码行覆盖率从 42% 提升到 48%。
- 交叉编码器重排会降低首位结果的表现(52% → 34%),延迟则是原来的 8 倍,因此默认关闭并标记为实验性功能。通用网页搜索重排器无法理解 issue 与代码之间的相关性;采用代码训练的重排器已列入计划。
- **Git 提交历史的效果不一:**它在调优用的仓库上有所帮助,但在 Django 上,移除它反而让 recall@1 提升了 4 个百分点。它仍保持启用,因为默认设置是在运行 Django 测试之前固定的;现在更改就等于在测试集上调优。
- 在 8,000 个 token 的预算下,完整文件在确切代码行覆盖率方面迎头赶上(49% 对 51%):这里的每个 Django 修复都只涉及一个文件,而在这一预算下,完整文件通常能放得下。
**方法。**使用 bench/tune.py 和 bench/tune_pack.py,在其他 8 个仓库(pytest、requests、flask、sphinx、pylint、xarray、astropy、seaborn)的 89 个 issue 上通过网格搜索选定权重,然后在运行 Django 测试之前冻结权重。使用 ctxsmith bench --repos django/django 即可复现(首次运行:在笔记本上约需两小时)。
工作原理
flowchart LR
    subgraph Index["ctxsmith index (incremental)"]
        TS["tree-sitter<br/>7 languages"] --> SYM["symbols · calls · imports"]
        SYM --> G["call graph<br/>PageRank"]
        SYM --> FTS["FTS5 BM25<br/>files · symbols · bodies"]
        SYM --> EMB["ONNX embeddings<br/>symbol summaries"]
        EMB --> VEC["sqlite-vec<br/>cosine index"]
        GIT["git log"] --> H["commit-message index<br/>co-change pairs"]
    end
    subgraph Query["get_context(task, budget)"]
        Q["task text"] --> S1["file BM25"] & S2["semantic kNN"] & S3["paths in task"] & S4["history BM25"]
        S1 & S2 & S3 & S4 --> RRF["reciprocal-rank<br/>fusion"]
        RRF --> KS["knapsack packer<br/>value per token"]
        KS --> OUT["≤ N tokens of code"]
    end
    Index -. one SQLite file .-> Query
每个仓库使用一个 SQLite 文件,其中包含所有内容:文件、符号、调用和导入关系、三个 FTS5 索引、Git 统计数据、团队笔记和向量索引(来自 sqlite-vec 的 vec0 虚拟表;在 SQLite 无法加载扩展的环境中,则使用 numpy 作为回退方案)。
检索(RAG)。 每种信号都会生成自己的文件排名列表;通过倒数排名融合将它们组合起来,避免任何单一的噪声信号占据主导:
| 信号 | 可捕捉的内容 |
|---|---|
对整个文件执行 BM25(拆分 camelCase/snake_case,提高路径权重) | 精确词汇 |
对符号摘要执行语义 kNN(BAAI/bge-small-en-v1.5、ONNX、CPU) | 用不同措辞表达的同一想法 |
任务中提到的路径(回溯信息、“在 foo/bar.py 中”) | 明确指向 |
| 对每个文件的提交消息执行 BM25 | “之前曾为类似 bug 修改过此文件” |
| 协同变更、调用图邻居、PageRank、精确名称提及 | 可用作权重;默认关闭,因为基准测试表明它们会损害文件排名 |
这些权重来自对 8 个仓库中的 89 个 SWE-bench Lite 问题进行的网格搜索(bench/tune.py),随后又在调优时未涉及的 Django 上进行了验证。
嵌入什么,以及为什么。 不嵌入整个文件,也不嵌入原始代码块:为每个函数或类生成一条简短摘要,包含路径、限定名称、签名和第一句文档字符串。在笔记本电脑的 CPU 上,这比嵌入函数体便宜约 30 倍,而且能识别“这是关于哪个函数的”。向量按内容哈希缓存,因此没有变化的函数不会被重复嵌入——无论是在重新索引时,还是在不同 Git 检出之间。跳过测试文件。
实验性重排。 ctxsmith context --rerank 使用交叉编码器(ms-marco-MiniLM-L-6-v2)对排名前 20 的文件重新评分。此功能默认关闭,因为基准测试表明它会损害效果(请参阅“结果”)。
打包。 候选项包括函数体(根据名称、文档字符串和函数体文本匹配)、类概览和文件概览。贪心背包算法会按每个 token 的最佳价值选择内容,降低同一文件中重复内容的权重,并根据最终渲染的文本强制执行预算,因此答案不会超出预算。
始终保持最新。 重新索引前会比较文件大小和修改时间,只重新解析和嵌入发生变化的文件;检查一个未更改的 2,800 个文件的仓库大约只需半秒。MCP 服务会在回答前执行此操作(最多每 2 秒一次),因此 Agent 不会从过期索引中读取自己刚编辑过的代码。
在 Agent 中使用(MCP)
ctxsmith mcp-config <client> 会输出适用于你机器的准确配置片段。
Claude Code
claude mcp add contextsmith -- ctxsmith serve --path /path/to/repo
无需安装,使用 uv(服务会为 Agent 打开的文件夹建立索引):
claude mcp add contextsmith -- uvx --from "contextsmith[semantic]" contextsmith
Cursor、Windsurf 和其他客户端(mcp.json):
{
  "mcpServers": {
    "contextsmith": { "command": "ctxsmith", "args": ["serve", "--path", "/path/to/repo"] }
  }
}
Codex(~/.codex/config.toml):
[mcp_servers.contextsmith]
command = "ctxsmith"
args = ["serve", "--path", "/path/to/repo"]
| 工具 | 返回内容 |
|---|---|
get_context(task, budget_tokens) | 为任务挑选的最佳代码,并按预算打包 |
search(query) | 排名靠前的函数和类 |
find_symbol(name) | 符号的定义位置 |
callers(name) / callees(name) | 调用图中的一跳关系 |
impact(name) | 所有传递性调用该符号的内容:更改可能造成的影响 |
related_files(path) | 通过代码关联的文件,以及在 Git 中共同变更的文件 |
add_note(text, path, symbol) | 供后续会话了解的决策或注意事项 |
overview() | 语言、规模、核心文件和变更最频繁的文件 |
reindex() | 强制执行增量重新索引 |
CLI
| 命令 | 功能 |
|---|---|
ctxsmith index [PATH] [--no-semantic] | 为代码建立索引;增量更新,安装额外组件后会启用嵌入 |
ctxsmith context "task" -b 4000 | 在令牌预算内提供最佳上下文 |
ctxsmith rank "task" | 按排名列出文件,并说明每个文件的发现依据 |
ctxsmith search "query" | 按排名列出函数和类 |
ctxsmith symbol / callers / callees NAME | 浏览调用图(脚本可使用 --json) |
ctxsmith impact NAME | 更改 NAME 可能造成哪些影响 |
ctxsmith related FILE | 列出通过代码关联的文件,以及会同时变更的文件 |
ctxsmith note add "text" --file F | 记录一项决策或注意事项 |
ctxsmith overview | 查看语言、代码规模、核心文件和变更最多的文件,以及语义功能状态 |
ctxsmith serve | 通过 stdio 提供 MCP 服务 |
ctxsmith mcp-config [claude|cursor|codex] | 为 Agent 提供设置代码片段 |
ctxsmith bench --repos django/django | 自行运行 SWE-bench Lite 基准测试 |
Python API
from contextsmith import Engine

eng = Engine("path/to/repo")       # index stored in path/to/repo/.contextsmith/
eng.index()                        # incremental; returns counts and timings
pack = eng.context("Fix the race when two users book the last seat", budget=6000)
pack.text, pack.tokens, pack.files, pack.spans   # markdown, size, files, line ranges shown

eng.rank("seat double-booked").files  # ranked files, with the signals that found each
eng.search("seat reservation")     # ranked functions and classes
eng.impact("reserve_seat")         # transitive callers
eng.related_files("booking/models.py")
eng.add_note("Seats are locked per show, not per seat", path="booking/models.py")
配置
| 变量 | 默认值 |
|---|---|
CTXSMITH_EMBED_MODEL | BAAI/bge-small-en-v1.5(任意 fastembed 文本模型,例如 jinaai/jina-embeddings-v2-base-code) |
CTXSMITH_RERANK_MODEL | Xenova/ms-marco-MiniLM-L-6-v2 |
FASTEMBED_CACHE_PATH | ~/.cache/contextsmith/models |
索引位于 <repo>/.contextsmith/(会自动加入 git 忽略列表)。没有
semantic 扩展组件时,所有功能仍可使用,只是采用词法方式。
在公司中使用
每位开发者自行使用(最常见的推广方式)。 执行 pipx install "contextsmith[semantic]",然后
在每个仓库中运行 ctxsmith index,并为每个 Agent 添加一行 ctxsmith mcp-config 配置。不需要
托管服务、账号或需要保护的共享服务。
在 CI 中:为代码审查机器人提供拉取请求涉及的代码。
# .github/workflows/pr-context.yml
name: PR context
on: pull_request
jobs:
  context:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
        with: { fetch-depth: 0 }            # full history powers the git signals
      - uses: actions/setup-python@v5
        with: { python-version: "3.12" }
      - uses: actions/cache@v4               # reuse the index and the model between runs
        with:
          path: |
            .contextsmith
            ~/.cache/contextsmith/models
          key: contextsmith-${{ github.base_ref }}
      - run: pip install "contextsmith[semantic]" && ctxsmith index
      - run: ctxsmith context "$TITLE" --budget 6000 > pr-context.md
        env:
          TITLE: ${{ github.event.pull_request.title }}   # via env, never inline: no injection
      - uses: actions/upload-artifact@v4
        with: { name: pr-context, path: pr-context.md }
将 pr-context.md 提供给你使用的任意代码审查模型,或者将 ctxsmith impact <function>
的输出作为评论发布,让审查者了解影响范围。
离线和隔离网络环境中的机器。
# on a machine with internet access (same OS and Python version as the target)
pip download "contextsmith[semantic]" -d wheels
ctxsmith index                     # downloads the embedding model (65 MB) once
# copy wheels/ and ~/.cache/contextsmith/models/ across, then on the offline machine:
pip install --no-index --find-links wheels "contextsmith[semantic]"
export HF_HUB_OFFLINE=1            # never try the network again
存储内容及位置。 每个仓库在 <repo>/.contextsmith/ 中都有一个 SQLite 文件:
其中包含符号、搜索索引、调用图、git 统计数据和提交消息、备注以及
嵌入向量。该文件会自动加入 git 忽略列表,且绝不会上传到任何地方。ContextSmith
不进行遥测;唯一的下载内容是首次使用时从 Hugging Face 下载的开源嵌入模型(未安装
semantic 扩展组件时不会下载),以及运行 ctxsmith bench 时下载的公开基准数据。
常见问题
我的代码会离开本机吗? 不会。解析、搜索、嵌入和 MCP 服务都 在本地运行。你的 Agent 仍会像处理读取的任何文件一样,将收到的上下文发送给它自己的模型提供方;ContextSmith 只是让上下文更精简、更相关。
它能处理多大的仓库? 在笔记本电脑 CPU 上对 Django(2,800 个文件、38,000 个函数和 类)进行测量:从零开始构建代码图、搜索索引和 git 索引需 16 秒, 首次为所有内容生成嵌入约需 3.5 分钟,每次查询需 0.2 秒,检查变更需 0.5 秒,磁盘占用 136 MB。首次运行后,只会重新解析和生成已变更文件的嵌入。
它会取代 Agent 自带的搜索功能吗? 不会,它能为 Agent 提供更好的起点。Agent 仍可打开任何文件;它只是从正确的函数开始,而不是从 grep 开始。
它使用哪些模型? 嵌入使用 BAAI/bge-small-en-v1.5(ONNX、CPU、65 MB),
可通过 CTXSMITH_EMBED_MODEL 更改。不涉及大模型:ContextSmith 负责检索,你的 Agent 负责推理。
费用是多少? 免费。采用 MIT 许可证,包括商业用途。
它已可用于生产环境了吗? 当前版本为 v0.1:已使用 Python 3.11–3.13 在 Windows、macOS 和 Linux 上测试,已公开进行基准测试,也坦诚说明了目前尚不可用的功能(见 Results)。 欢迎提交问题和拉取请求。
支持的语言
Python、JavaScript、TypeScript/TSX、Java、Go 和 Rust,使用 tree-sitter 解析。
对比
Graphify、codebase-memory-mcp、GitNexus、Serena 和 Claude Context 都是不错的工具;ContextSmith 的不同之处如下:
| ContextSmith | |
|---|---|
| 回答“在 N 个 token 的预算内,为这项任务提供最佳上下文” | ✅ 按预算打包,绝不超出预算 |
| 发布可复现的基准测试,包含基线和消融实验 | ✅ ctxsmith bench,使用留出仓库 |
| 融合词法、语义和 Git 历史信息 | ✅ |
| 完全本地运行,无需 API 密钥,只需一个 SQLite 文件 | ✅ |
| 将团队笔记固定到代码,并在上下文中呈现 | ✅ |
| 适合商业用途的许可证 | ✅ MIT |
路线图
多仓库索引、笔记过时跟踪、文件监视器、图视图、PR 影响报告,以及更多语言。欢迎提交创意和有基准测试支持的拉取请求:请参阅 CONTRIBUTING.md。
许可证
MIT
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。