关于 orionbelt-semantic-layer
orionbelt-semantic-layer 面向分析团队和 Agent,使用 YAML 定义指标与业务规则,并编译为特定方言的 SQL。它结合多事实查询规划、血缘追踪,并通过多种接口提供模型访问。
主要功能
- 01YAML 语义模型与业务规则
- 02编译为特定方言的 SQL
- 03多事实查询规划
- 04查询与模型血缘追踪
- 05REST、SQL 与 MCP 接口
适用场景
- 01在分析工具间定义共享指标
- 02让 Agent 提交任务专用模型与查询
- 03避免多事实查询中的扇形陷阱连接
- 04追踪查询结果所依据的表与连接
MCP 相关
它通过 stdio 或 HTTP 上的 MCP,向 AI Agent 提供语义模型、查询能力、业务规则及相关上下文。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
OrionBelt® 语义与上下文层、规则引擎和语义 Sidecar
在 YAML 中定义共享指标,或为一组问题建模。让 Agent 和 BI 工具通过统一的语义编译器进行查询。
一种语义 Sidecar:它与您现有的系统协同运行,而不是取而代之。



让大模型针对原始星型模式编写 SQL,迟早会把两个事实表连接起来,给出一个膨胀了 8 倍的收入数字。结果看起来没问题,也没人发现。
OrionBelt 是一个带有规则引擎的语义与上下文层,以**语义 Sidecar**的形式运行。您或 Agent 可以在 YAML 中声明维度、度量、指标和连接,为单个任务设定范围,也可以将其维护为共享模型。OrionBelt 通过真实的 AST 将它们编译为特定方言的 SQL,并通过复合事实层规划器处理多事实表查询,该规划器会阻止产生扇形陷阱的连接路径。查询可以请求按“国家”统计“总收入”;物理表和列的映射则保存在模型中。
无需 BI 工具介入,也不会受运行时锁定。直接连接您已有的系统即可。
为问题建模
Agent 可以只为需要回答的问题建模。 使用 POST /v1/oneshot/batch,它可以在一次请求中提交针对特定任务的 OBML 模型和多个独立查询。OBSL 会验证模型、编译或执行查询,并返回分别标识的结果,以及适用的 SQL、说明、警告和错误。
对于“按国家统计收入、月收入和平均订单金额”这些问题,Agent 只需定义一次相关列和计算,然后基于它们提出 3 个问题。默认情况下,批处理完成后会移除刚加载的模型;设置 persist_model: true 则会将其保留在会话中,以便继续提问。此工作流和长期使用的共享模型都由同一个编译器支持。
查看 Agent 工作流指南了解完整示例,或参阅单次调用 API 合约。
四种接入方式
同一个模型可服务于你已在使用的所有接口。共有四种接口,背后由同一个模型驱动:
| 接口 | 端口 | 通信协议 | 连接方式 |
|---|---|---|---|
| PostgreSQL wire | 5432 | Postgres 协议 | 通过 ATTACH 连接 DuckDB、Tableau、作为联邦数据源的 Dremio、Power BI、Superset、DBeaver、Metabase、psql |
| Arrow Flight SQL | 8815 | gRPC + Arrow | 通过 adbc_scanner 连接 DuckDB,通过 Flight SQL JDBC/ODBC 驱动连接 Tableau 和 Power BI,连接 ADBC 客户端(Python、Go、Java) |
| REST | 8000 | HTTP + JSON | 你的代码、笔记本、curl,以及 8 个 PEP 249 驱动(驱动在此处编译,然后直接在数据仓库上执行) |
| MCP | stdio / HTTP | Model Context Protocol | AI Agent:Claude、Cursor、Copilot、Windsurf |
两个 SQL 接口都支持 OBSQL,因此无论通过哪个接口接入,SELECT "Region", "Total Sales" FROM sales_model 都是同一个查询。ADBC 是使用 Flight SQL 接口的方式,并非第五种接口;DuckDB 则是可连接任一 SQL 接口的客户端。
八种输出方式
可编译为 BigQuery、ClickHouse、Databricks、Dremio、DuckDB/MotherDuck、MySQL、PostgreSQL 和 Snowflake。 模型背后的数据仓库与前端接口彼此独立:四种接口中的任一种,都可连接八种方言中的任一种。
以下是 TPC-DS 查询 98。同一列上的两个度量,只有一行不同:Class Revenue 被固定在比查询要求更粗的粒度上。
measures:
  Store Sales Amount:
    columns: [{dataObject: Store Sales, column: Ext Sales Price}]
    aggregation: sum

  Class Revenue:
    columns: [{dataObject: Store Sales, column: Ext Sales Price}]
    aggregation: sum
    grain: {mode: FIXED, keepOnly: [Class]}   # <- pin to Class, ignore query grain

metrics:
  Revenue Ratio:
    expression: "{[Store Sales Amount]} * 100.0 / {[Class Revenue]}"
这一行 grain 就会在下方转换为 SUM(...) OVER (PARTITION BY "Class")。
查询使用业务概念,而不涉及表、连接或 SQL:
select:
  dimensions: [Item ID, Item Description, Category, Class, Current Price]
  measures: [Store Sales Amount, Revenue Ratio]
where:
  - {field: Category, op: inlist, value: [Sports, Books, Home]}
  - {field: Order Date, op: between, value: ["1999-02-22", "1999-03-24"]}
pip install orionbelt-semantic-layer
obsl compile tpcds.obml.yml -q Q98.yml -d duckdb
WITH "base" AS (
  SELECT
    "Item"."i_item_id" AS "Item ID",
    "Item"."i_item_desc" AS "Item Description",
    "Item"."i_category" AS "Category",
    "Item"."i_class" AS "Class",
    "Item"."i_current_price" AS "Current Price",
    CAST(SUM("Store Sales"."ss_ext_sales_price") AS DECIMAL(18, 2)) AS "Store Sales Amount",
    SUM("Store Sales"."ss_ext_sales_price") AS "Class Revenue"
  FROM "main"."store_sales" AS "Store Sales"
  LEFT JOIN "main"."item" AS "Item"
    ON "Store Sales"."ss_item_sk" = "Item"."i_item_sk"
  LEFT JOIN "main"."date_dim" AS "Date"
    ON "Store Sales"."ss_sold_date_sk" = "Date"."d_date_sk"
  WHERE
    "Item"."i_category" IN ('Sports', 'Books', 'Home')
    AND "Date"."d_date" BETWEEN '1999-02-22' AND '1999-03-24'
  GROUP BY ALL
)
SELECT
  "Item ID" AS "Item ID",
  "Item Description" AS "Item Description",
  "Category" AS "Category",
  "Class" AS "Class",
  "Current Price" AS "Current Price",
  "Store Sales Amount" AS "Store Sales Amount",
  "Store Sales Amount" * 100.0 / NULLIF(SUM("Class Revenue") OVER (PARTITION BY "Class"), 0) AS "Revenue Ratio"
FROM "base" AS "base"
ORDER BY
  "Category" ASC,
  "Class" ASC,
  "Item ID" ASC,
  "Item Description" ASC,
  "Revenue Ratio" ASC
你无需编写连接路径、聚合上的窗口函数、NULLIF 防护逻辑或任何表名。将 -d duckdb 改为 -d snowflake,同样的两个文件就能编译为 Snowflake,也能编译为八种方言中的任一种。
这经过了验证,而非仅仅宣称。 40 个 TPC-DS 查询基于单个 OBML 模型构建,并与各引擎自己的参考 SQL 逐行比较:在 sf=1 时,DuckDB 上有 40 个查询中的 39 个匹配;在 sf=10 时,ClickHouse 上有 40 个查询中的 37 个匹配。其余差异均可追溯至参考版本,而非编译错误,并且每项差异都有记录。请参阅测试结果或 examples/tpcds_queries/ 中的查询。
每种引擎都返回相同答案
为八种引擎编译是容易的部分。各引擎对结果各执一词,而只修正函数拼写的中间层会把这种分歧原样传递到你的仪表板或 Agent。OrionBelt 会锁定答案:
| 表达式 | 各引擎的行为 | OrionBelt 返回值 |
|---|---|---|
x / 0 | 一种引擎返回 inf,四种引擎报错,其余返回 NULL | 所有引擎都返回 NULL |
round(2.5)(浮点数) | ClickHouse、PostgreSQL 和 MySQL 在遇到中间值时会舍入到偶数,结果为 2 | 所有引擎都返回 3 |
greatest(1, NULL, 3) | 四种引擎会跳过 NULL,结果为 3 | 所有引擎都返回 NULL |
length('äbcd') | ClickHouse 和 MySQL 按字节计数,结果为 5 | 4 个字符 |
json_value(doc, '$.a')(其中 a 是对象) | 四种引擎会返回序列化后的 JSON | NULL:路径未到达标量值 |
每一行都会在实际运行的引擎上执行并断言,而不是根据供应商文档推断。设置 expressionMode: portable 后,使用可移植目录之外的函数会报错,因此模型不会意外依赖某种引擎。
开放且可追溯
语义模型不应成为死胡同,每个数字也都应该能说明它的来源。
- 支持 Apache Ossie 双向转换。 OSI(开放语义交换)是用于构建可移植语义模型的开放标准,目前由 Apache Ossie(孵化中)持续开发。OrionBelt 支持 OBML 与 Ossie 双向转换,并在两个方向进行架构验证,可通过 REST、CLI(
obsl convert)和 UI 使用。转换器也作为独立软件包提供(pip install osi-orionbelt),并正在贡献给上游项目。 - 为每个制品和每条查询提供血缘信息。 维度、度量、指标或规则由什么构建而成;对于查询,还包括规划器实际选择的联接、多事实
UNION ALL分支和exists子查询,直至列和表。可通过 REST、CLI(obsl lineage)和 UI 以 JSON、Mermaid 或 Turtle 格式获取。 - 将模型作为标准图。 每个已加载的模型都会导出为 RDF(OWL、SHACL、SKOS、PROV),并支持只读 SPARQL 查询。因此,"哪些度量读取了此列?" 可以通过查询回答,而不必搜索代码;血缘链接也会指向同一张图。
OrionBelt 的适用场景
OrionBelt 是一个伴随组件,而不是一个平台。它会将 YAML 模型编译成正确的 SQL,并通过你已在使用的协议将其提供出来。它不会运行集群、管理你的缓存,也不会要求你采用云服务。
适合使用 OrionBelt 的场景:
- Agent 需要为一组问题编写一个小型模型,将模型和查询一并提交,并可选择将其用于后续分析。
- Agent 会查询你的数据,而悄然出错的数字是不可接受的。多事实查询会通过 Composite Fact Layer 规划器进行路由,该规划器会阻止扇形陷阱式连接路径,而不是悄悄地沿着这类路径求和。
- 你希望指标定义使用便于评审的 YAML 编写,且模型层中不使用 JavaScript 或 Python。
- 你的 BI 工具应通过自带的 Postgres 驱动程序连接,无需安装新连接器,也无需经过任何供应商运行时。
- 你需要在多个引擎上自行托管,并希望同一个模型都能编译运行,且每个引擎都能得到相同的答案。
- 你必须展示数字的来源:用了哪些列、哪些表,以及查询采用了哪条连接路径。
- 你的模型需要能在不同工具之间迁移,而不是只能在一个工具中使用;可以通过 Apache Ossie 或作为 RDF 图实现。
适合选择其他方案的场景:
- 你需要针对大规模、高并发仪表板优化预聚合和缓存。Cube 在这方面经过多年生产环境的打磨,而 OrionBelt 尚未做到。
- 你的指标已在 dbt 中管理,且团队对现状满意。MetricFlow 会让指标继续留在原处。
- 你想要的是探索性分析语言,而不是服务层。Malloy 更适合这种情况。
试用在线演示,其中已预加载模型;或者打开 Colab 笔记本,并使用 TPC-H 数据运行。
什么是上下文层?
语义层会告诉使用者如何计算一个数字:用哪张表、哪种连接、哪种聚合。上下文层还会告诉使用者这个数字代表什么,以及业务对它有什么要求,并以 Agent 可以查找而非猜测的形式呈现。在 OrionBelt 中,这些上下文与指标保存在同一个模型中:
- 业务规则 会针对模型中的维度、度量和指标声明条件:哪些客户算高价值客户,哪些类别不得亏本销售。规则引擎会将每条规则编译为用于报告其成员或违规项的查询,并可通过 REST、MCP、CLI(
obsl rules evaluate)和 UI 评估单条或全部规则。 - 外部概念映射 会将数据对象、维度、度量、指标和规则关联到组织已采用治理的概念(schema.org、FIBO、内部词汇表),并记录其来源。
- OBSL 图 会将每个已加载的模型公开为 RDF,因此可以使用 SPARQL 查询其中的构件、连接、规则和概念关联。
- 数据沿袭 会展示维度、度量、指标、规则或查询由什么构成,具体到表和规划器选用的连接;可在 API、CLI(
obsl lineage)和 UI 中以 JSON、Mermaid 或链接到 OBSL 图的 Turtle 格式查看。 - 每个构件上的描述、同义词和所有者为 Agent 提供用户实际使用的词汇。
Agent 可通过 MCP 和 REST 访问所有这些内容,以及查询工具;因此,计算数字的同一个模型也能解释数字。下一节将展示模型中的规则和概念关联。
不只是指标,更是含义
只知道 Total Sales 是一个总和的模型,仍会让 Agent 猜测什么是高价值客户,或者某个类别亏损销售究竟是错误还是事实。从 2.30 起,模型也承载了这些信息,这正是 OrionBelt 既是语义层、也是上下文层的原因:业务规则、与组织所治理本体的链接,以及作为 RDF 图的模型本身,都能让 Agent 理解数字背后的含义,而不仅仅是数字。
业务规则是针对模型自身维度、度量和指标设定的条件,无需 SQL。规则引擎会将每条规则编译为用于报告结果的查询:分类或资格规则的成员,以及验证或约束规则的违规项。
rules:
  Non-Negative Margin:
    type: validation
    severity: error
    description: Every product category must sell for at least what it cost
    grain: [Product Category]
    condition: {field: Gross Margin, op: ">=", value: 0}
此规则读取一个指标,因此属于聚合规则:它会通过与任何查询相同的规划器,在类别粒度上转换为 HAVING,也包括多事实查询。POST /v1/rules/{name}/evaluate 会返回此规则所涉及的违规类别,POST /v1/rules/evaluate 则会将所有规则整合为一份报告。
本体链接使用带来源信息的 SKOS 映射关系,将构件关联到组织已有治理体系中的概念:
ontology:
  prefixes:
    schema: "https://schema.org/"

dataObjects:
  Products:
    externalConceptMappings:
      - concept: schema:Product
        relation: exact
        justification: curated
链接不会改变 SQL,却会改变可提问的内容:每个已加载的模型同时也是一个 RDF 图,因此“哪些构件表示 schema.org Product”可以通过 SPARQL 查询;发现 API 也能通过 REST 提供相同查询(/concept-mappings、其 /namespaces,以及列出缺失项的 /unmapped)。
对于 Agent 来说,这就是猜测与查证之间的区别。通过 MCP,list_rules、evaluate_rule 和 find_concept_mappings 等工具与 execute_query 并列。
指南:业务规则、外部概念映射、OBSL 图与 SPARQL。
目录
建模问题 · 四种接入方式 · 八种输出方式 · 开放且可追溯 · 什么是上下文层? · 不只是指标,更是含义 · 30 秒上手 · Claude Desktop / MCP · 为什么选择 OrionBelt? · 功能 · 示例 · 文档 · 路线图 · 商业服务 · 开发
30 秒上手
选项 A:在线演示(无需安装)
打开在线演示 — 使用预加载示例模型的 Gradio UI。粘贴查询、选择方言,即可立即查看 SQL。
API 浏览器:Swagger UI | ReDoc
想试试 PostgreSQL wire 接口吗? Cloud Run 仅支持 HTTPS,因此公共演示无法开放 5432(pgwire)或 8815(Flight SQL)端口。只需运行两条命令,即可在本地启动相同的演示——其中包含内置的
orionbelt_1_commerceDuckDB 数据集和完整的 OBSQL 接口:docker run --rm -d --name orionbelt-demo \ -p 8080:8080 -p 5432:5432 -p 8815:8815 \ -e PGWIRE_ENABLED=true \ -e FLIGHT_ENABLED=true \ ralforion/orionbelt-semantic-layer-api:latest # REST + Gradio UI: http://localhost:8080/ui # pgwire(适用于任何 psql / DBeaver / Tableau / Power BI): psql "host=localhost port=5432 user=obsl dbname=orionbelt_1_commerce sslmode=disable" \ -c 'SELECT "Client Name", "Total Sales" LIMIT 5' # Flight SQL 冒烟测试: uv run python examples/obsql.py 'SELECT "Client Name", "Total Sales" LIMIT 5' docker stop orionbelt-demo容器默认使用
PGWIRE_AUTH_MODE=trust,因此在localhost上使用是安全的,但不能暴露到公共互联网。对于对外开放的部署,请设置AUTH_MODE=api_key(随 v2.12.0 发布):随后 pgwire 会通过共享密钥存储协商 SCRAM-SHA-256(或通过 TLS 使用明文)。
选项 B:Google Colab(无需安装)
 — 交互式笔记本,内含 TPC-H 数据:探索模型、编译不同方言的查询、对 DuckDB 执行查询并查看结果。需要 Python 3.12 运行时。
选项 C:从 PyPI 安装
pip install orionbelt-semantic-layer
然后粘贴到 Python REPL 中:
from orionbelt.parser import ReferenceResolver, TrackedLoader
from orionbelt.compiler.pipeline import CompilationPipeline
from orionbelt.models.query import QueryObject, QuerySelect

model_yaml = """
version: 1.0
dataObjects:
  Orders:
    code: ORDERS
    columns:
      Price: { code: PRICE, abstractType: float }
      Country: { code: COUNTRY, abstractType: string }
dimensions:
  Country:
    dataObject: Orders
    column: Country
    resultType: string
measures:
  Total Revenue:
    resultType: float
    aggregation: sum
    expression: "{[Orders].[Price]}"
"""

loader = TrackedLoader()
raw, source_map = loader.load_string(model_yaml)
resolver = ReferenceResolver()
model, result = resolver.resolve(raw, source_map)

query = QueryObject(select=QuerySelect(dimensions=["Country"], measures=["Total Revenue"]))
pipeline = CompilationPipeline()
output = pipeline.compile(query, model, "postgres")
print(output.sql)
输出:
SELECT
  "Orders"."COUNTRY" AS "Country",
  CAST(SUM("Orders"."PRICE") AS NUMERIC(18, 2)) AS "Total Revenue"
FROM ORDERS AS "Orders"
GROUP BY "Orders"."COUNTRY"
无需环境文件——编译流水线是无状态的。
启动服务:
orionbelt-api                              # REST API on :8000 (Swagger UI at /docs, Gradio UI at /ui)
orionbelt-ui                               # standalone Gradio UI on :7860 (connects to API on :8000)
FLIGHT_ENABLED=true orionbelt-api          # API + Arrow Flight SQL on :8815 (DBeaver, Tableau, Power BI)
PGWIRE_ENABLED=true orionbelt-api          # API + PostgreSQL wire on :5432 (Tableau, DBeaver, Superset, psql, Dremio source)
选项 C2:使用 uv 安装
uv pip install orionbelt-semantic-layer
uv run orionbelt-api                       # REST API on :8000 (Swagger UI at /docs, Gradio UI at /ui)
uv run orionbelt-ui                        # standalone Gradio UI on :7860 (connects to API on :8000)
FLIGHT_ENABLED=true uv run orionbelt-api   # API + Arrow Flight SQL on :8815 (DBeaver, Tableau, Power BI)
PGWIRE_ENABLED=true uv run orionbelt-api   # API + PostgreSQL wire on :5432 (Tableau, DBeaver, Superset, psql, Dremio source)
使用 obsl CLI(无需启动服务——直接在进程内编译):
obsl validate model.yaml                                  # lint a model (exit 1 on error, CI-friendly)
obsl compile model.yaml -q query.json -d snowflake        # print the generated SQL
obsl compile model.yaml --sql 'SELECT "Region", "Sales" FROM model'  # ... or from an OBSQL string
obsl describe model.yaml                                   # overview of data objects + artefacts
obsl diagram model.yaml                                    # Mermaid ER diagram
obsl convert obml-to-osi model.yaml                        # OBML -> OSI (and osi-to-obml)
obsl execute -q query.json --server http://host           # run against a deployed model (omit MODEL)
所有命令请参阅 CLI 指南。
无需 BI 工具即可对 Flight SQL 接口进行冒烟测试:
uv run python examples/obsql.py 'SELECT version()'
uv run python examples/obsql.py 'SHOW TABLES'
uv run python examples/obsql.py 'SELECT "Region", "Total Sales" FROM sales LIMIT 5'

# Multi-model deployment? Pick the model with -m:
uv run python examples/obsql.py -m sales 'SHOW TABLES'
uv run python examples/obsql.py --list   # discover loaded models via REST
30 秒体验 OBSQL
OBSQL — OrionBelt Semantic QL — 是 BI 工具和用户实际编写的 SQL 接口。支持直接使用标签、MEASURE() 标记或匹配的聚合包装器;验证聚合匹配;支持 WITH ROLLUP / WITH CUBE;不提供绕过机制来执行原始数仓 SQL。Arrow Flight SQL(v2.4+)和 PostgreSQL wire(v2.5+)使用相同的语言:
PGWIRE_ENABLED=true uv run orionbelt-api &

# Every BI tool already ships a Postgres ODBC/JDBC driver — point yours at :5432
psql "host=localhost port=5432 user=obsl dbname=sales sslmode=disable" \
  -c 'SELECT "Region", "Total Sales" LIMIT 5'

# All three measure forms compile to the same vendor SQL:
psql "..." -c 'SELECT "Region", "Total Sales"        FROM sales LIMIT 5'  -- bare
psql "..." -c 'SELECT "Region", MEASURE("Total Sales") FROM sales LIMIT 5'  -- explicit marker
psql "..." -c 'SELECT "Region", SUM("Total Sales")   FROM sales LIMIT 5'  -- matching aggregate
完整语法请参阅 OBSQL 参考。
选项 D:Docker
阶段 1 — 零配置启动(稍后通过 API 或 UI 加载模型):
docker run -p 8080:8080 ralforion/orionbelt-semantic-layer-api
打开 http://localhost:8080/docs 以浏览 API。
阶段 2 — 使用 docker compose 进行实际部署:
# docker-compose.yml
services:
  api:
    image: ralforion/orionbelt-semantic-layer-api:2.36.0
    ports: ["8080:8080"]
    env_file: .env
    volumes:
      - ./models:/app/models:ro
    environment:
      MODEL_FILES: /app/models/my-model.obml.yml

  ui:
    image: ralforion/orionbelt-semantic-layer-ui:2.36.0
    ports: ["7860:7860"]
    environment:
      API_BASE_URL: http://api:8080
docker compose up -d
完整的环境变量参考请参阅 .env.template。
Docker 说明:
- 容器内的
API_SERVER_HOST已设为0.0.0.0,无需覆盖。- 通过 stdio 使用 MCP 在 Docker 中无法工作。容器化部署请使用 MCP HTTP 客户端。
- 将模型挂载到
/app/models(或任意路径),并设置MODEL_FILES(以逗号分隔的路径),即可在启动时预加载模型。- 用于生产环境时,请固定版本标签(
:2.36.0),而不是使用:latest。
Claude Desktop / MCP
MCP 服务是一个独立的轻量客户端,负责将请求转发给 REST API:
将以下内容添加到 Claude Desktop 的 claude_desktop_config.json 中:
{
  "mcpServers": {
    "orionbelt": {
      "command": "uvx",
      "args": ["orionbelt-semantic-layer-mcp"]
    }
  }
}
也可与 Copilot、Cursor 和 Windsurf 配合使用。完整的设置选项请参阅 MCP 仓库。
为什么选择 OrionBelt?
| OrionBelt | dbt Semantic Layer | Cube | Malloy | |
|---|---|---|---|---|
| 模型格式 | YAML(OBML) | dbt 模型上的 YAML | YAML 或 JavaScript | Malloy 语言 |
| 运行时 | 可自托管服务 | dbt Cloud | Cube Core(可自托管)或 Cube Cloud | 库,以及 Publisher 服务 |
| 许可证 | BUSL-1.1(转为 Apache 2.0) | 定义开源;运行时位于 dbt Cloud | Apache 2.0 核心版 + Cube Cloud | 开源 |
| 查询接口 | 通过 PostgreSQL wire 和 Arrow Flight SQL 提供 OBSQL、REST、MCP、DB-API 驱动程序、命令行 | GraphQL、JDBC(Cloud) | SQL API(PostgreSQL wire)、REST、GraphQL | Malloy 语言;Publisher REST 和 MCP |
| 多事实查询 | UNION ALL 分支(CFL),拒绝扇陷路径 | 对共享实体执行 FULL OUTER JOIN | 按事实执行子查询,并通过共享维度联接 | 单根数据源 |
| 在每个引擎上得到相同答案 | 结果固定且经过执行(x/0、舍入、NULL、JSON) | 继承引擎语义 | 继承引擎语义 | 部分标准化:只要任一参数为 NULL,greatest / least 就返回 NULL;round 向远离零的方向舍入;length 按字符计数;x / 0 由引擎处理(在 DuckDB 上为 inf),且“无法保证所有函数在所有方言中都完全兼容” |
| 血缘 | 按构件和查询追踪,可深入到列及所选联接 | 语义模型和指标的目录 DAG;无逐查询血缘 | Cube Cloud Metadata API:面向目录集成,提供从多维数据集和成员到源表的血缘信息,包括数据库名称和 SQL 表达式;无逐查询血缘 | 未记录 |
| 互操作 | 双向支持 Apache Ossie;模型可表示为带有 SPARQL 的 RDF | 不支持 | 通过 Cube CLI 和 Platform API 导入和导出 Apache Ossie(2026 年 10 月;CLI 处于预览阶段,可通过 Cube 支持团队获取访问权限) | 不支持 |
| 模型中的业务含义 | 规则会编译到报告其结果的查询中;SKOS 链接到外部本体 | 列级数据测试;自由格式的 meta | 自由格式的 meta(ai_context) | 注释,不作解释 |
完整的双向比较(包括这些工具各自的优势):dbt、Cube、Malloy、LookML、AtScale。
功能
语义建模
- OBML 格式 — 基于 YAML 的语义模型,包含数据对象、维度、度量、指标和联接
- 跨架构查询 — 在单个模型中对多个数据库和架构的数据对象进行建模
- 静态模型筛选器 — 将必需的 WHERE 条件嵌入模型,并在扩展联接时自动应用
- 业务规则 — 无需 SQL,即可在维度、度量和指标上声明式定义
rules(分类、资格判定、验证、约束);编译为用于报告其发现结果的查询,可逐条或一次性全部测试并生成报告,也可在 UI 的 Business Rules 选项卡中列出和评估 - OBSL 图谱和 SPARQL — 为每个已加载模型导出 RDF 图谱并提供只读 SPARQL 查询;外部概念映射会将数据对象、维度、度量和指标作为 SKOS 匹配项关联到业务本体(FIBO、schema.org、企业术语表)
- OSI 互操作性 — 支持 OBML 与 Open Semantic Interchange 格式之间的双向转换;该格式现以 Apache Ossie(孵化中) 的名义开发
SQL 编译
- 8 种 SQL 方言 — BigQuery、ClickHouse、Databricks、Dremio、DuckDB/MotherDuck、MySQL、Postgres、Snowflake
- 基于 AST 的生成 — 自定义 SQL AST 可确保生成正确且防注入的 SQL(而非字符串模板)
- 星型架构和 CFL — 通过复合事实层自动解析联接,支持多事实查询
- 数据类型和精度 — 自动添加 CAST 包装,并按方言渲染类型、限制精度
- 显示格式 — 对度量/指标应用数字格式模式(
#,##0.00、0.00%),并根据区域设置进行渲染 - 时区设置 — 自动检测数据库会话时区,并在未检测到时使用
defaultTimezone,同时采用 ISO 8601 序列化 - sqlglot 验证 — 生成后检查所有受支持方言的语法
集成接口
- REST API — 用于模型管理、验证、编译和执行的 FastAPI 端点
- MCP 服务 — 面向 Claude、Copilot、Cursor、Windsurf 的独立轻量客户端
- AI 集成 — LangChain、OpenAI Agents SDK、CrewAI、Google ADK、Vercel AI SDK、n8n、ChatGPT
- Gradio UI — 用于模型编辑、查询测试和 ER 图的交互式 Web 界面
- DB-API 2.0 + Flight SQL — PEP 249 驱动和 Arrow Flight SQL 服务端,适用于 DBeaver、Tableau、Power BI;附带
examples/obsql.py,这是一个小型终端 CLI,可在不使用 BI 工具的情况下测试 Flight 接口 - 将 DuckDB 用作客户端(v2.27.1+)- 普通 DuckDB shell 可通过任一接口查询语义层。
ATTACH ... (TYPE postgres)会将模型挂载为表(SELECT ... FROM obsl.sales.model,需先执行一次SET pg_use_text_protocol = true);社区扩展adbc_scanner则通过 Flight SQL 全程使用 Arrow 完成查询。受治理的度量可以联接本地表,并写入CREATE TABLE AS。指南 - PostgreSQL Wire Protocol(v2.5.0+)— 在
:5432上提供原生 Postgres 协议接口。所有 BI 工具都已内置 Postgres ODBC/JDBC 驱动,因此用户只需“将现有连接指向 OBSL 即可使用”——Tableau、DBeaver、Superset、Power BI、普通psql,以及作为联合 Postgres 数据源的 Dremio(Dremio → OBSL → 可选地返回 Dremio 的湖仓,实现完整闭环)
面向 Agent 的 API
- 单次模型调用 + 查询:将特定任务的 OBML 和相互独立的子问题提交到
POST /v1/oneshot/batch;获取每个查询的结果,并可选择保留模型以便后续调用。请参阅Agent 工作流。 - 加载时检查模型健康状况 — 每次加载模型都会返回一个
health块,其中包含孤立的 dataObject、扇陷风险和不可达维度 — Agent 无需再进行一次防御性往返请求 - 查询计划端点 —
POST /query/plan会返回规划器的理解(规划器选择、物理表、联接路径、would_compile),但不会编译 SQL 或执行查询;选择启用include_database_explain,即可获取数据仓库的原始 EXPLAIN - 结构化警告 — API 中的每个
warnings列表都采用稳定的{code, severity, message, path, hint, context}格式,并遵循有文档说明的代码分类体系;Agent 可根据代码分支处理,而不必解析消息 - 模糊
/find恢复 — 搜索没有找到精确匹配项或同义词时,确定性的 Levenshtein + trigram 回退机制会返回包含分数和原因的近似候选项 - 维度值搜索:
POST /v1/values会列出或搜索某个维度包含的值(依次进行精确、前缀、包含和模糊匹配),让 Agent 根据数据确定筛选值,而不是猜测;模型的静态筛选条件仍会生效,设置valueSearch: false可隐藏列值 - 模型示例 — 可选的 OBML
examples:块,用于定义规范查询;GET /examples(支持通过?intent=筛选)可让 Agent 通过一次往返请求了解模型适合回答哪些问题
由新鲜度驱动的结果缓存
- 源级新鲜度契约 — 在
dataObject条目中声明refresh:块(interval / heartbeat / static);缓存会根据查询涉及的物理表所对应的契约推导查询 TTL,而非依赖调用方猜测 - 心跳失效 — 向物理表发送一次
POST /v1/heartbeat,即可使所有依赖该表的缓存查询失效,涵盖所有 dataObject 和会话 - DuckDB 元数据 + Parquet 结果 — 基于文件的缓存,提供精确保留类型的序列化、惰性过期和 LRU 容量清理;通过
CACHE_BACKEND=file选择启用 - 颠覆 Cube/dbt/Looker 模式 — 契约定义在源上,而非语义抽象层;所有读取该表的 cube/explore/保存的查询都使用同一真实数据源
开发者体验
- 源位置错误 — 验证错误会报告准确的 YAML 行号和列号
- ER 图 — 交互式 Mermaid 图,支持缩放和下载(MD/PNG/Turtle)
- 会话管理 — 具备 TTL 范围的会话,并提供线程安全的模型隔离
- JSON Schema — 完整的 OBML 和查询架构,可用于 IDE 自动补全(
yaml-language-server)
示例
定义语义模型(OBML)
# yaml-language-server: $schema=https://raw.githubusercontent.com/ralforion/orionbelt-semantic-layer/main/schema/obml-schema.json
version: 1.0
dataObjects:
  Customers:
    code: CUSTOMERS
    database: WAREHOUSE
    schema: PUBLIC
    columns:
      Customer ID: { code: CUSTOMER_ID, abstractType: string }
      Country:     { code: COUNTRY, abstractType: string }

  Orders:
    code: ORDERS
    database: WAREHOUSE
    schema: PUBLIC
    columns:
      Order Customer ID: { code: CUSTOMER_ID, abstractType: string }
      Price:             { code: PRICE, abstractType: float }
      Quantity:          { code: QUANTITY, abstractType: int }
    joins:
      - joinType: many-to-one
        joinTo: Customers
        columnsFrom: [Order Customer ID]
        columnsTo: [Customer ID]

dimensions:
  Country:
    dataObject: Customers
    column: Country
    resultType: string

measures:
  Revenue:
    resultType: float
    aggregation: sum
    expression: "{[Orders].[Price]} * {[Orders].[Quantity]}"
    dataType: "decimal(18, 2)"
通过 REST API 编译
# Create a session
curl -s -X POST http://localhost:8080/v1/sessions | jq .session_id
# -> "a1b2c3d4"

# Load the model
curl -s -X POST http://localhost:8080/v1/sessions/a1b2c3d4/models \
  -H "Content-Type: application/json" \
  -d '{"model_yaml": "..."}' | jq .model_id
# -> "abcd1234"

# Compile a query
curl -s -X POST http://localhost:8080/v1/sessions/a1b2c3d4/query/sql \
  -H "Content-Type: application/json" \
  -d '{"model_id":"abcd1234","query":{"select":{"dimensions":["Country"],"measures":["Revenue"]}},"dialect":"postgres"}' \
  | jq -r .sql
生成的 SQL(Postgres)
SELECT
  "Customers"."COUNTRY" AS "Country",
  CAST(SUM("Orders"."PRICE" * "Orders"."QUANTITY") AS NUMERIC(18, 2)) AS "Revenue"
FROM WAREHOUSE.PUBLIC.ORDERS AS "Orders"
LEFT JOIN WAREHOUSE.PUBLIC.CUSTOMERS AS "Customers"
  ON "Orders"."CUSTOMER_ID" = "Customers"."CUSTOMER_ID"
GROUP BY "Customers"."COUNTRY"
将 dialect 改为 bigquery、clickhouse、databricks、dremio、duckdb、mysql 或 snowflake,即可生成对应方言的 SQL。
Gradio UI
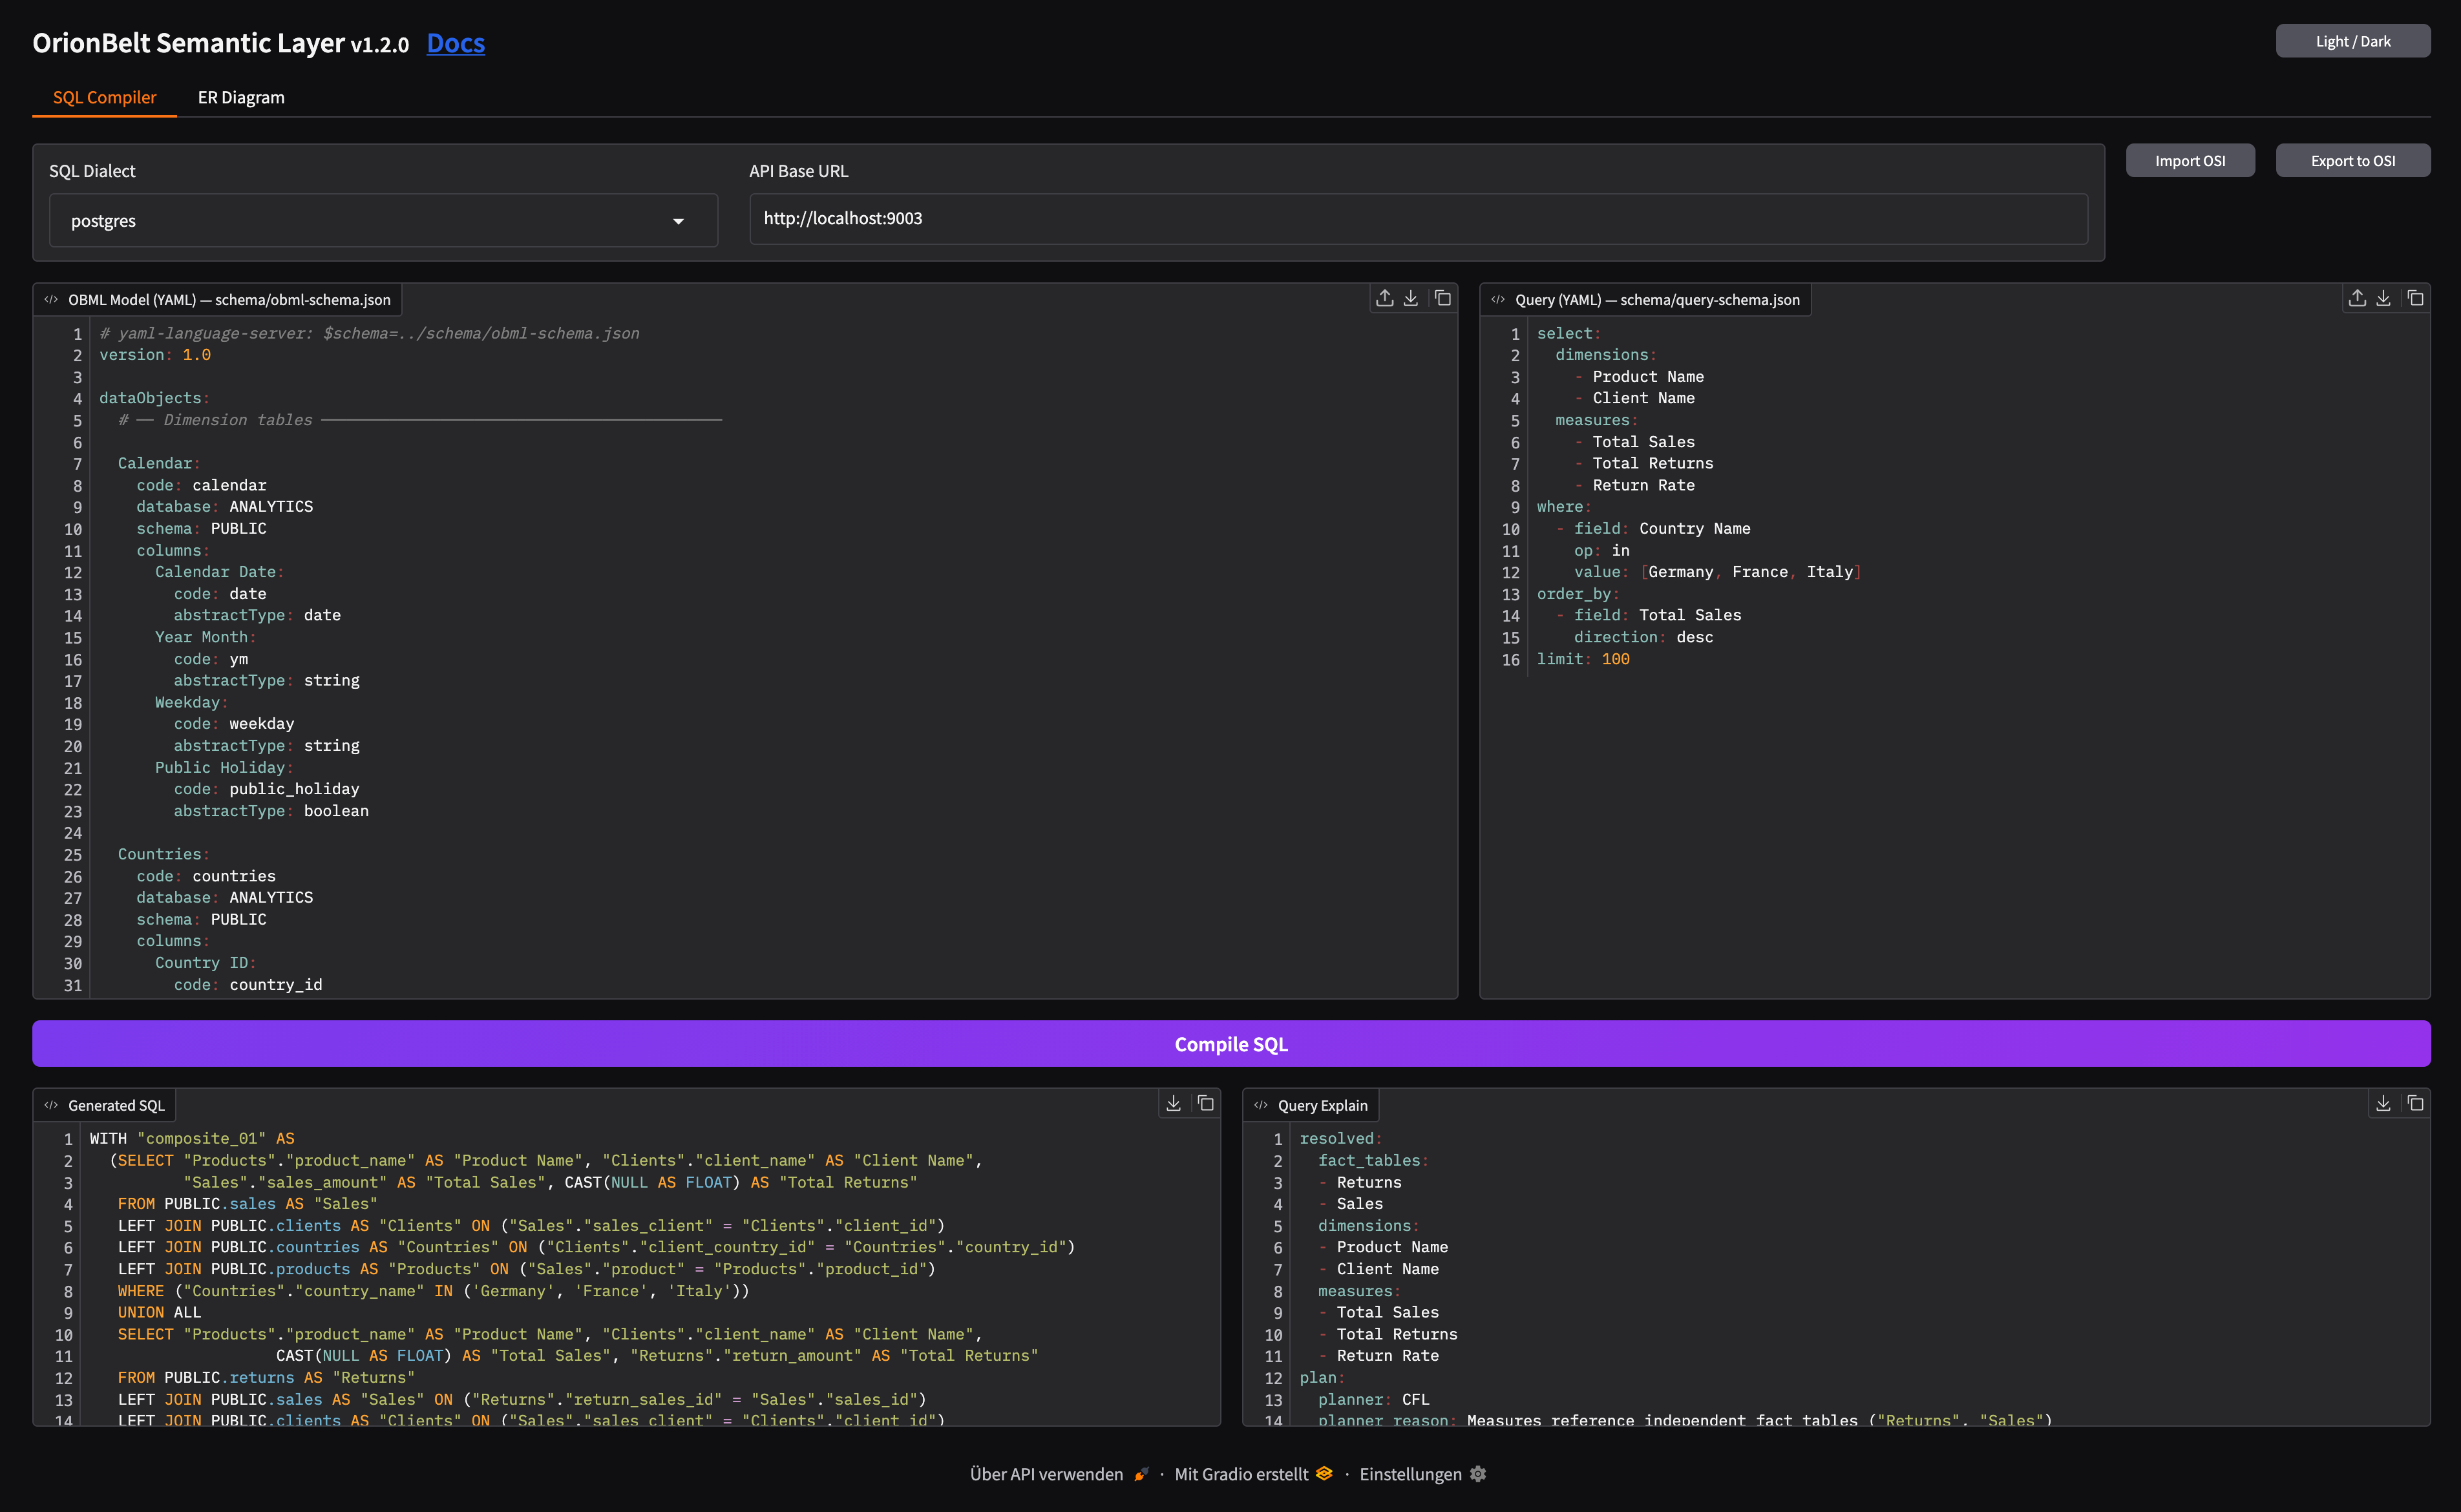
- SQL 编译器 — 并排显示 OBML 模型和查询编辑器,支持语法高亮、8 种方言选择、一键编译并输出格式化 SQL,以及查询解释
- 查询执行 — 对连接的数据库执行已编译查询,查看结果(数字格式会根据区域设置调整),并显示响应元数据面板,支持下载 TSV 和复制到剪贴板(需要
QUERY_EXECUTE=true) - ER 图 — 交互式 Mermaid ER 图,支持缩放、切换列显示和下载(MD/PNG/Turtle)
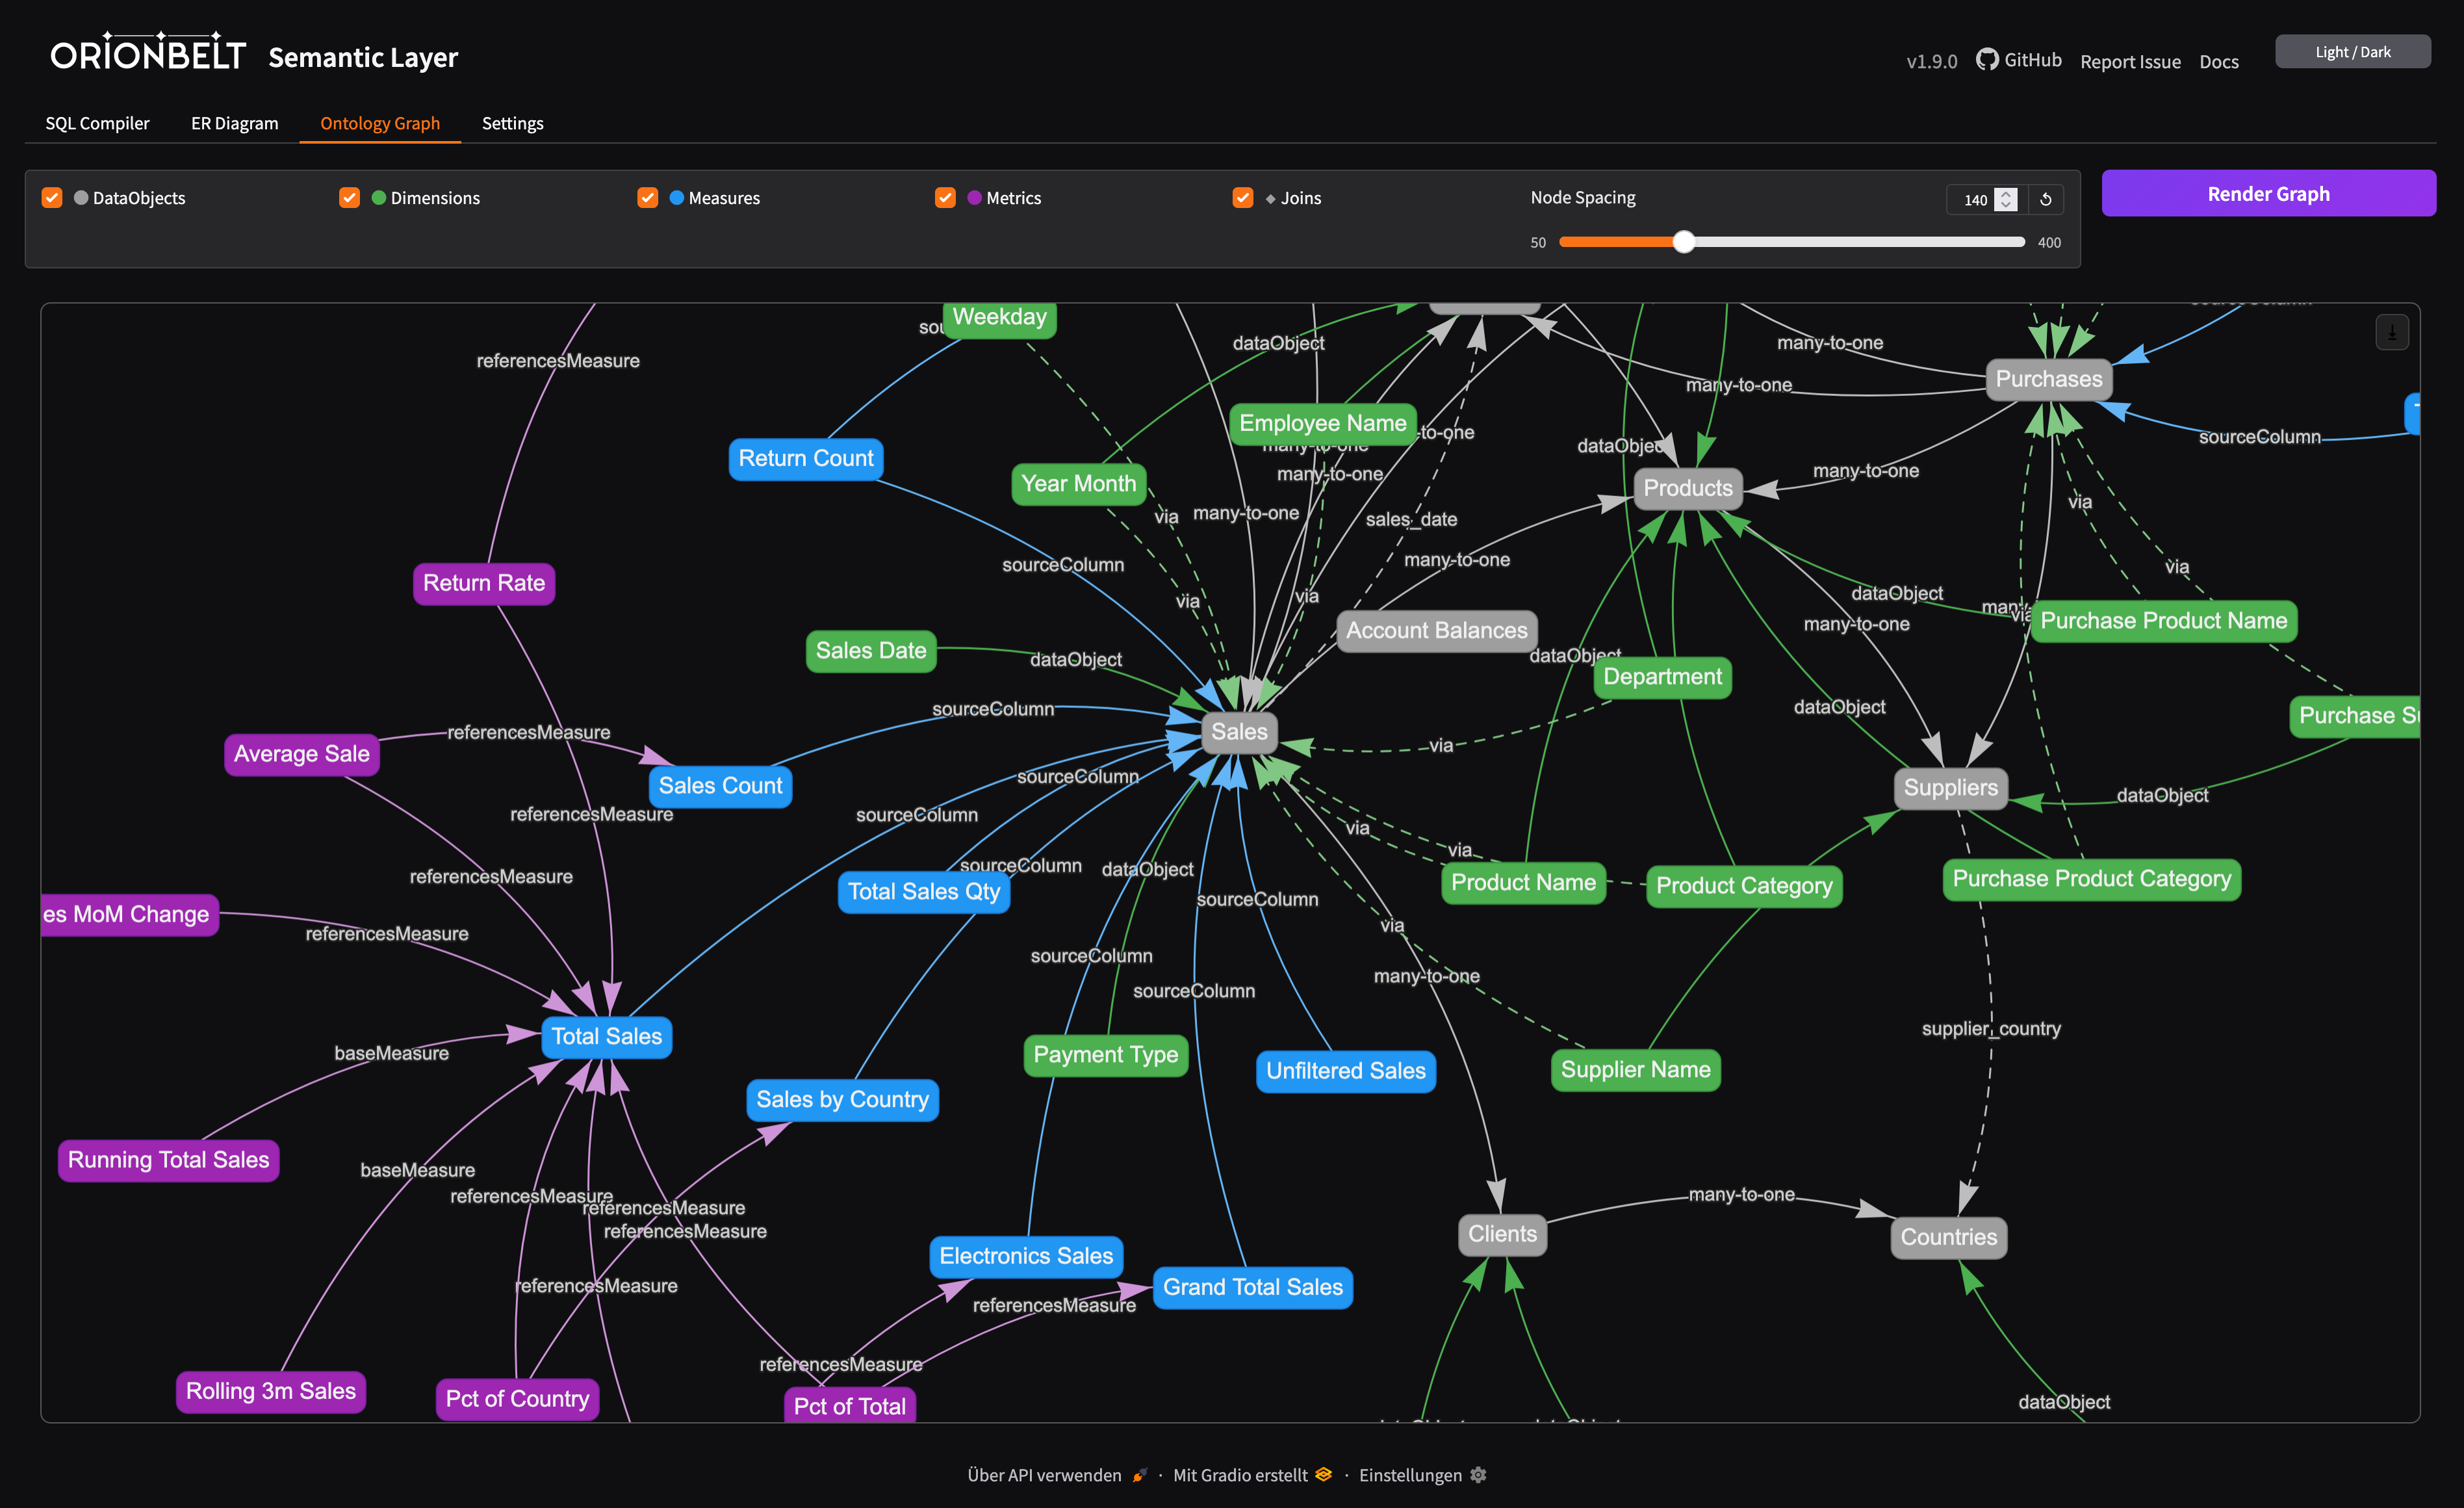
- 本体图谱 — 交互式 vis-network 可视化 OBML 图谱(数据对象、维度、度量、指标、连接),支持切换图层和调整节点间距
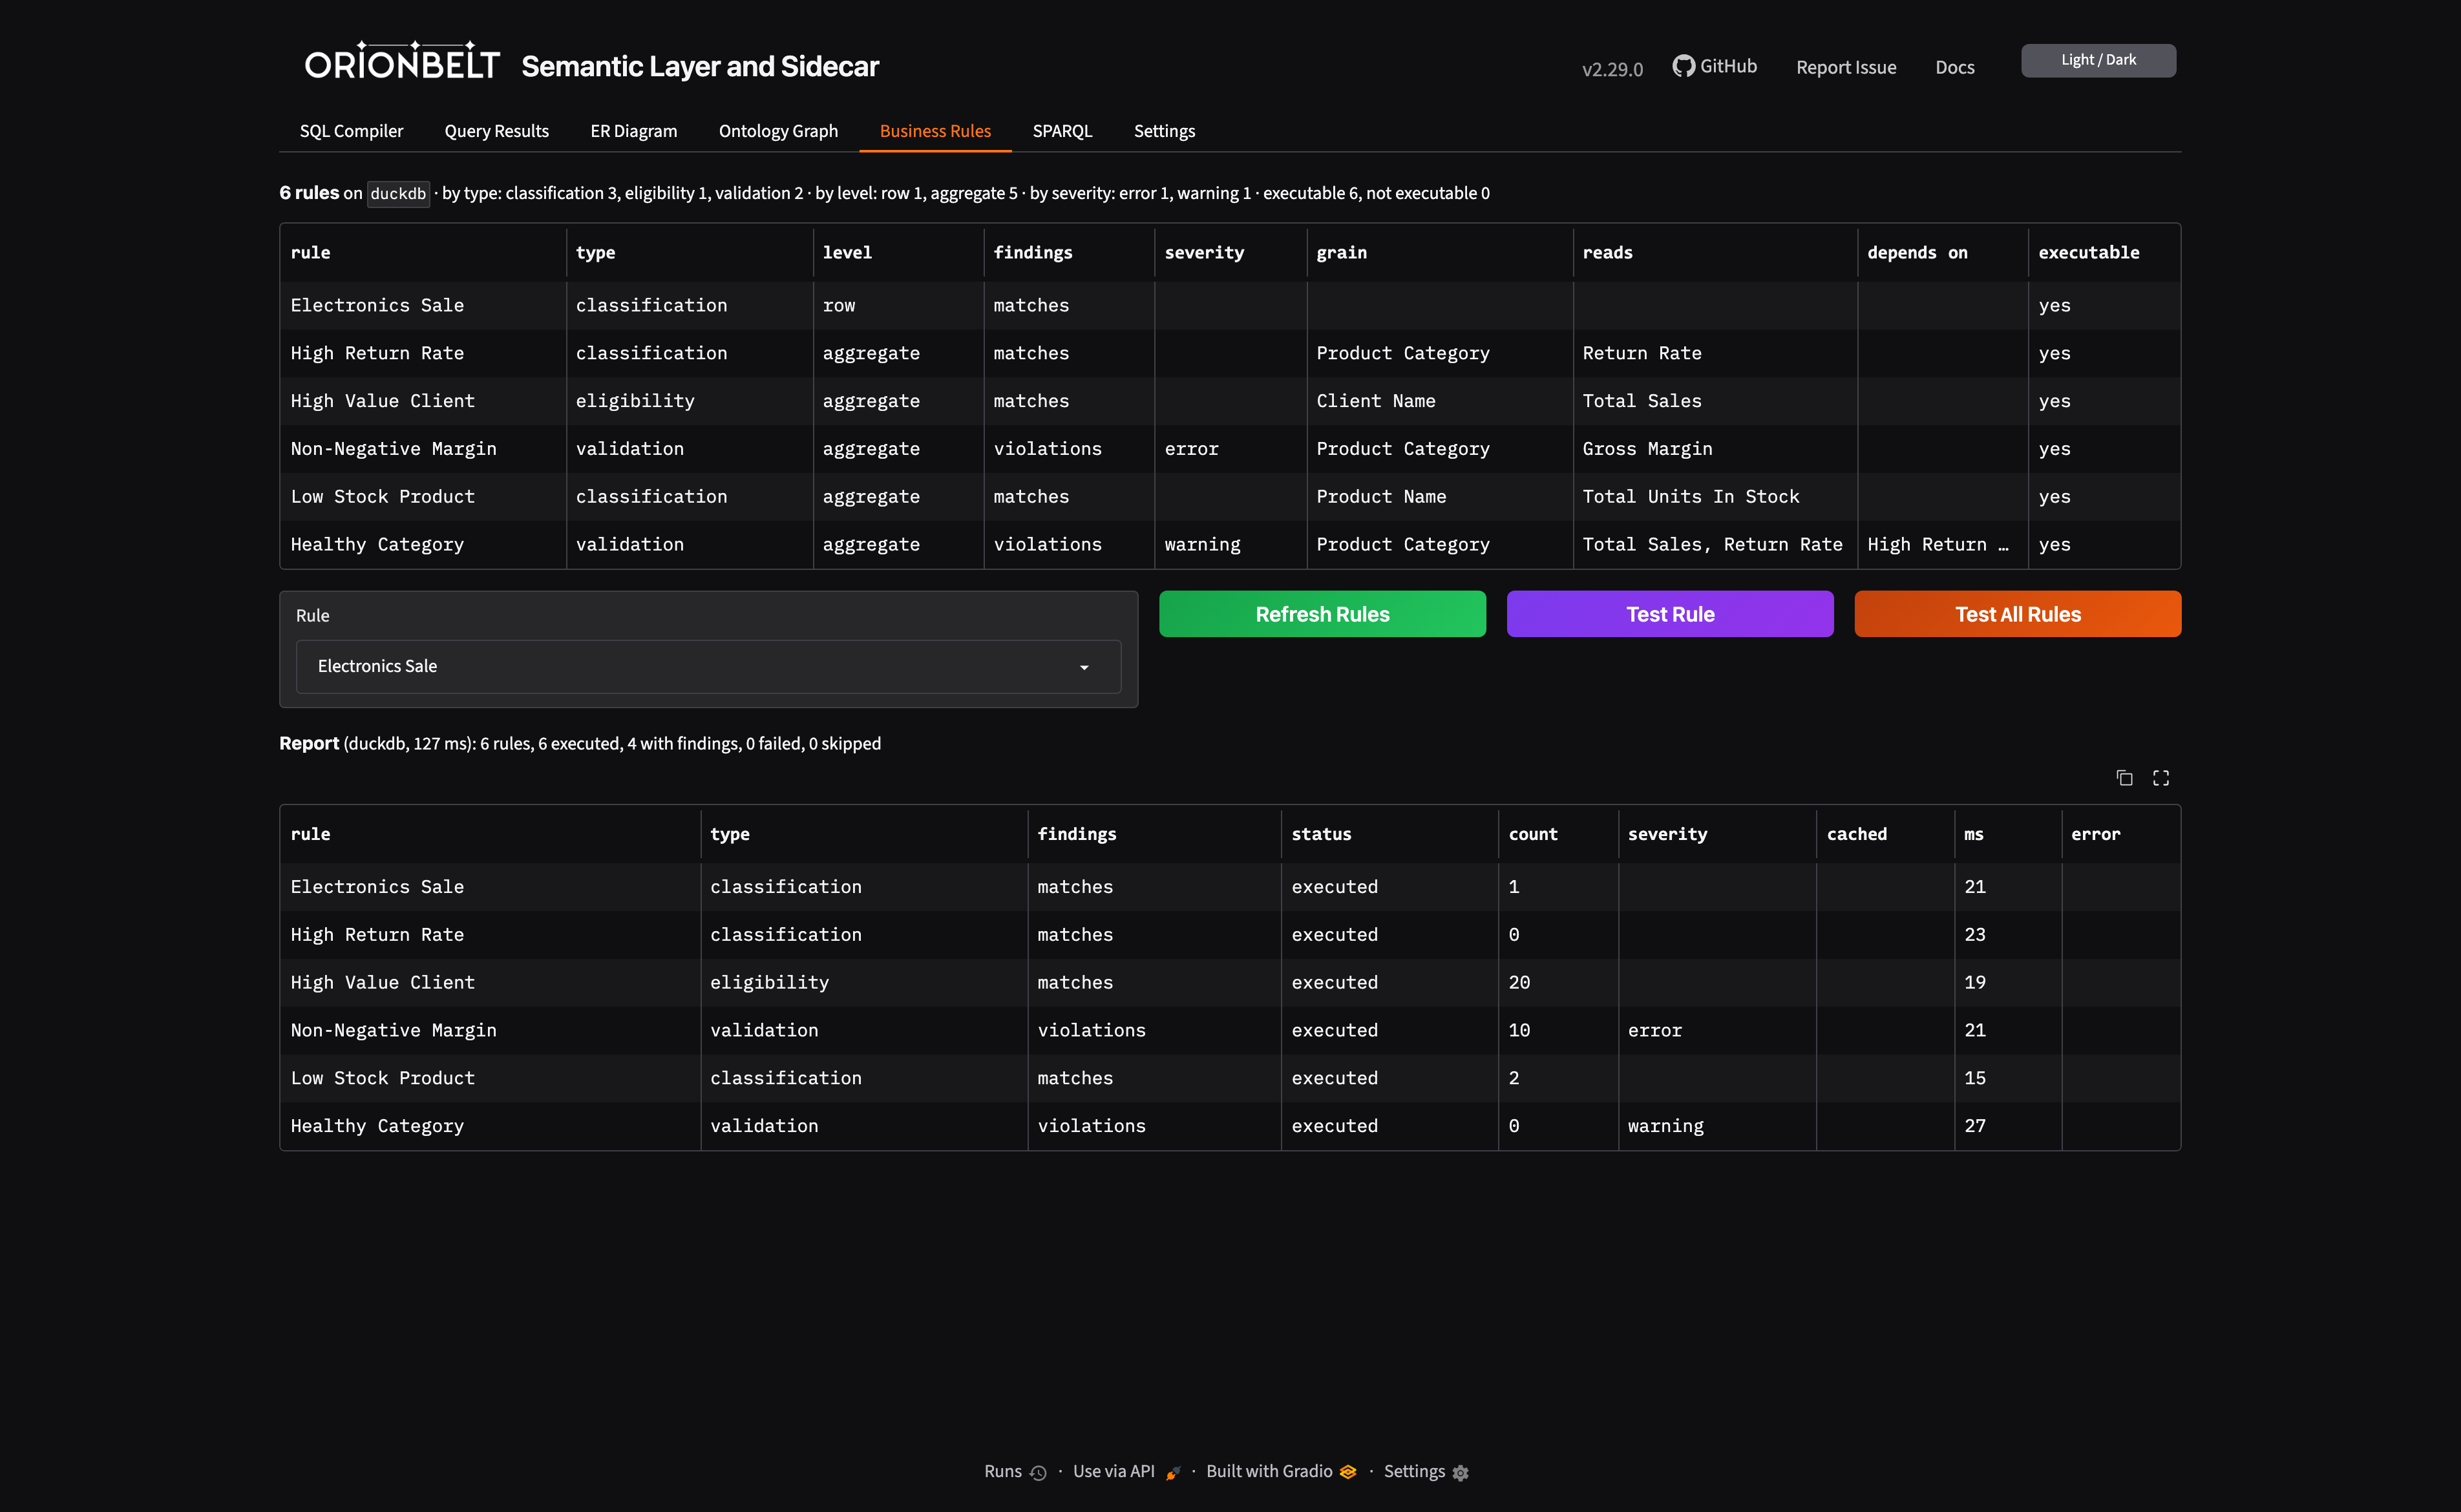
- 业务规则:显示模型规则及统计信息;点击某一行即可选中规则、显示其 OBML 定义、测试该规则或测试所有规则并生成报告
- SPARQL:在编辑器中对模型的 OBSL 图谱执行只读 SELECT / ASK 查询,支持 SPARQL 语法高亮,并提供可直接运行的示例集
- 编辑器工具栏 — 所有代码编辑器均提供清空、撤销、重做、上传、下载和复制按钮
- OSI 导入/导出 — 在 OBML 和 OSI 格式之间转换
- 深色/浅色模式 — 通过页眉按钮切换,状态会在会话间保留
嵌入式模式 — UI 挂载在 API 服务的 /ui 路径下:
pip install orionbelt-semantic-layer && orionbelt-api
# -> UI at http://localhost:8000/ui
独立模式 — 将 API 和 UI 作为单独的进程运行:
orionbelt-api                                              # API on :8000
orionbelt-ui                                               # UI on :7860 (connects to API on :8000)
API_BASE_URL=http://remote-api:8080 orionbelt-ui           # point UI to a remote API
文档
| 主题 | 链接 |
|---|---|
| 完整文档站点 | ralforion.com/orionbelt-semantic-layer |
| 安装 | getting-started/installation |
| 快速入门 | getting-started/quickstart |
| Docker 与部署 | getting-started/docker |
| 开发 | getting-started/development |
| OBML 模型格式 | guide/model-format |
| 查询语言 | guide/query-language |
| SQL 方言 | guide/dialects |
| 同比/环比指标 | guide/period-over-period |
| 趋势分析(rank / lag / lead / ntile、分区移动平均、统计聚合) | guide/trend-analysis |
| 编译流水线 | guide/compilation |
| OBSL 图与 SPARQL | guide/obsl |
| 业务规则 | guide/business-rules |
| 外部概念映射 | guide/concept-mappings |
| Gradio 用户界面 | guide/ui |
| AI 集成 | guide/integrations |
| OSI 互操作性 | guide/osi |
| REST API 端点 | api/endpoints |
| DB-API 驱动与 Flight SQL | drivers |
| 架构 | reference/architecture |
| 配置 | reference/configuration |
| 销售模型演练 | examples/sales-model |
| 多方言输出 | examples/multi-dialect |
| 多事实表:销售与退货 | examples/multi-fact |
| TPC-DS 基准测试 | examples/tpcds |
| 快速入门笔记本 | examples/quickstart.ipynb |
| 对比:概览 | comparison/ |
| 对比:与 dbt Semantic Layer 对比 | comparison/dbt |
| 对比:与 Malloy 对比 | comparison/malloy |
| 对比:与 LookML / Looker 对比 | comparison/lookml |
| 对比:与 Cube 对比 | comparison/cube |
| 对比:与 AtScale 对比 | comparison/atscale |
状态与路线图
| 状态 | 领域 |
|---|---|
| 已发布 | 8 种 SQL 方言、REST API、MCP 服务、Gradio UI、DB-API 驱动程序、Flight SQL、PostgreSQL wire protocol(v2.5.0+) — Tableau / DBeaver / Superset / Power BI / psql / 将 Dremio 用作联合 Postgres 数据源、OBSL/SPARQL、支持双向架构验证的 OSI v0.2 互操作、AI 集成(LangChain、CrewAI、ADK 等)、模型继承与扩展、数据类型与数值精度、时区设置、粒度与筛选器上下文覆盖、趋势分析 — 分区滚动窗口、用于 rank/lag/lead/ntile 的 MetricType.WINDOW、9 个统计聚合函数(CORR、COVAR_、REGR_、STDDEV_、VAR_)、REST / Flight / pgwire / UI 的 统一身份验证(v2.12.0) — 使用共享密钥存储的 AUTH_MODE=api_key、pgwire SCRAM-SHA-256 + 明文、工件组合解析(ACR,v2.14.0):根据当前查询,通过 composables 端点返回仍可添加的维度 / 度量 / 指标(包括 CFL 候选项),为引导式查询构建提供支持 |
| 计划中 | OIDC / SSO 身份验证与每个令牌的授权范围、用于自动化和 CI/CD 的 CLI、DDL 视图生成(根据查询创建 CREATE VIEW)、更多方言、更多 BI 工具集成、预聚合 / 物化层 |
商业服务
OrionBelt Semantic Layer 根据 BUSL-1.1 提供源码,直至转换为 Apache-2.0;免费发行版在已发布的 v2.6 功能范围内完全一致,可用于生产环境中的自托管。对于需要生产支持、托管运行时或嵌入式分析条款的团队,RALFORION 提供:
- 嵌入式分析许可证 — 在商业产品中提供 OBSL 时适用的重新许可条款
- 商业云服务 — 提供 SLA 的托管 OrionBelt 运行时
- 企业功能 — 为企业部署量身打造的能力
- 咨询 + 支持 — 实施、建模和生产支持
如需了解详情,请联系 RALFORION d.o.o.。
配套项目
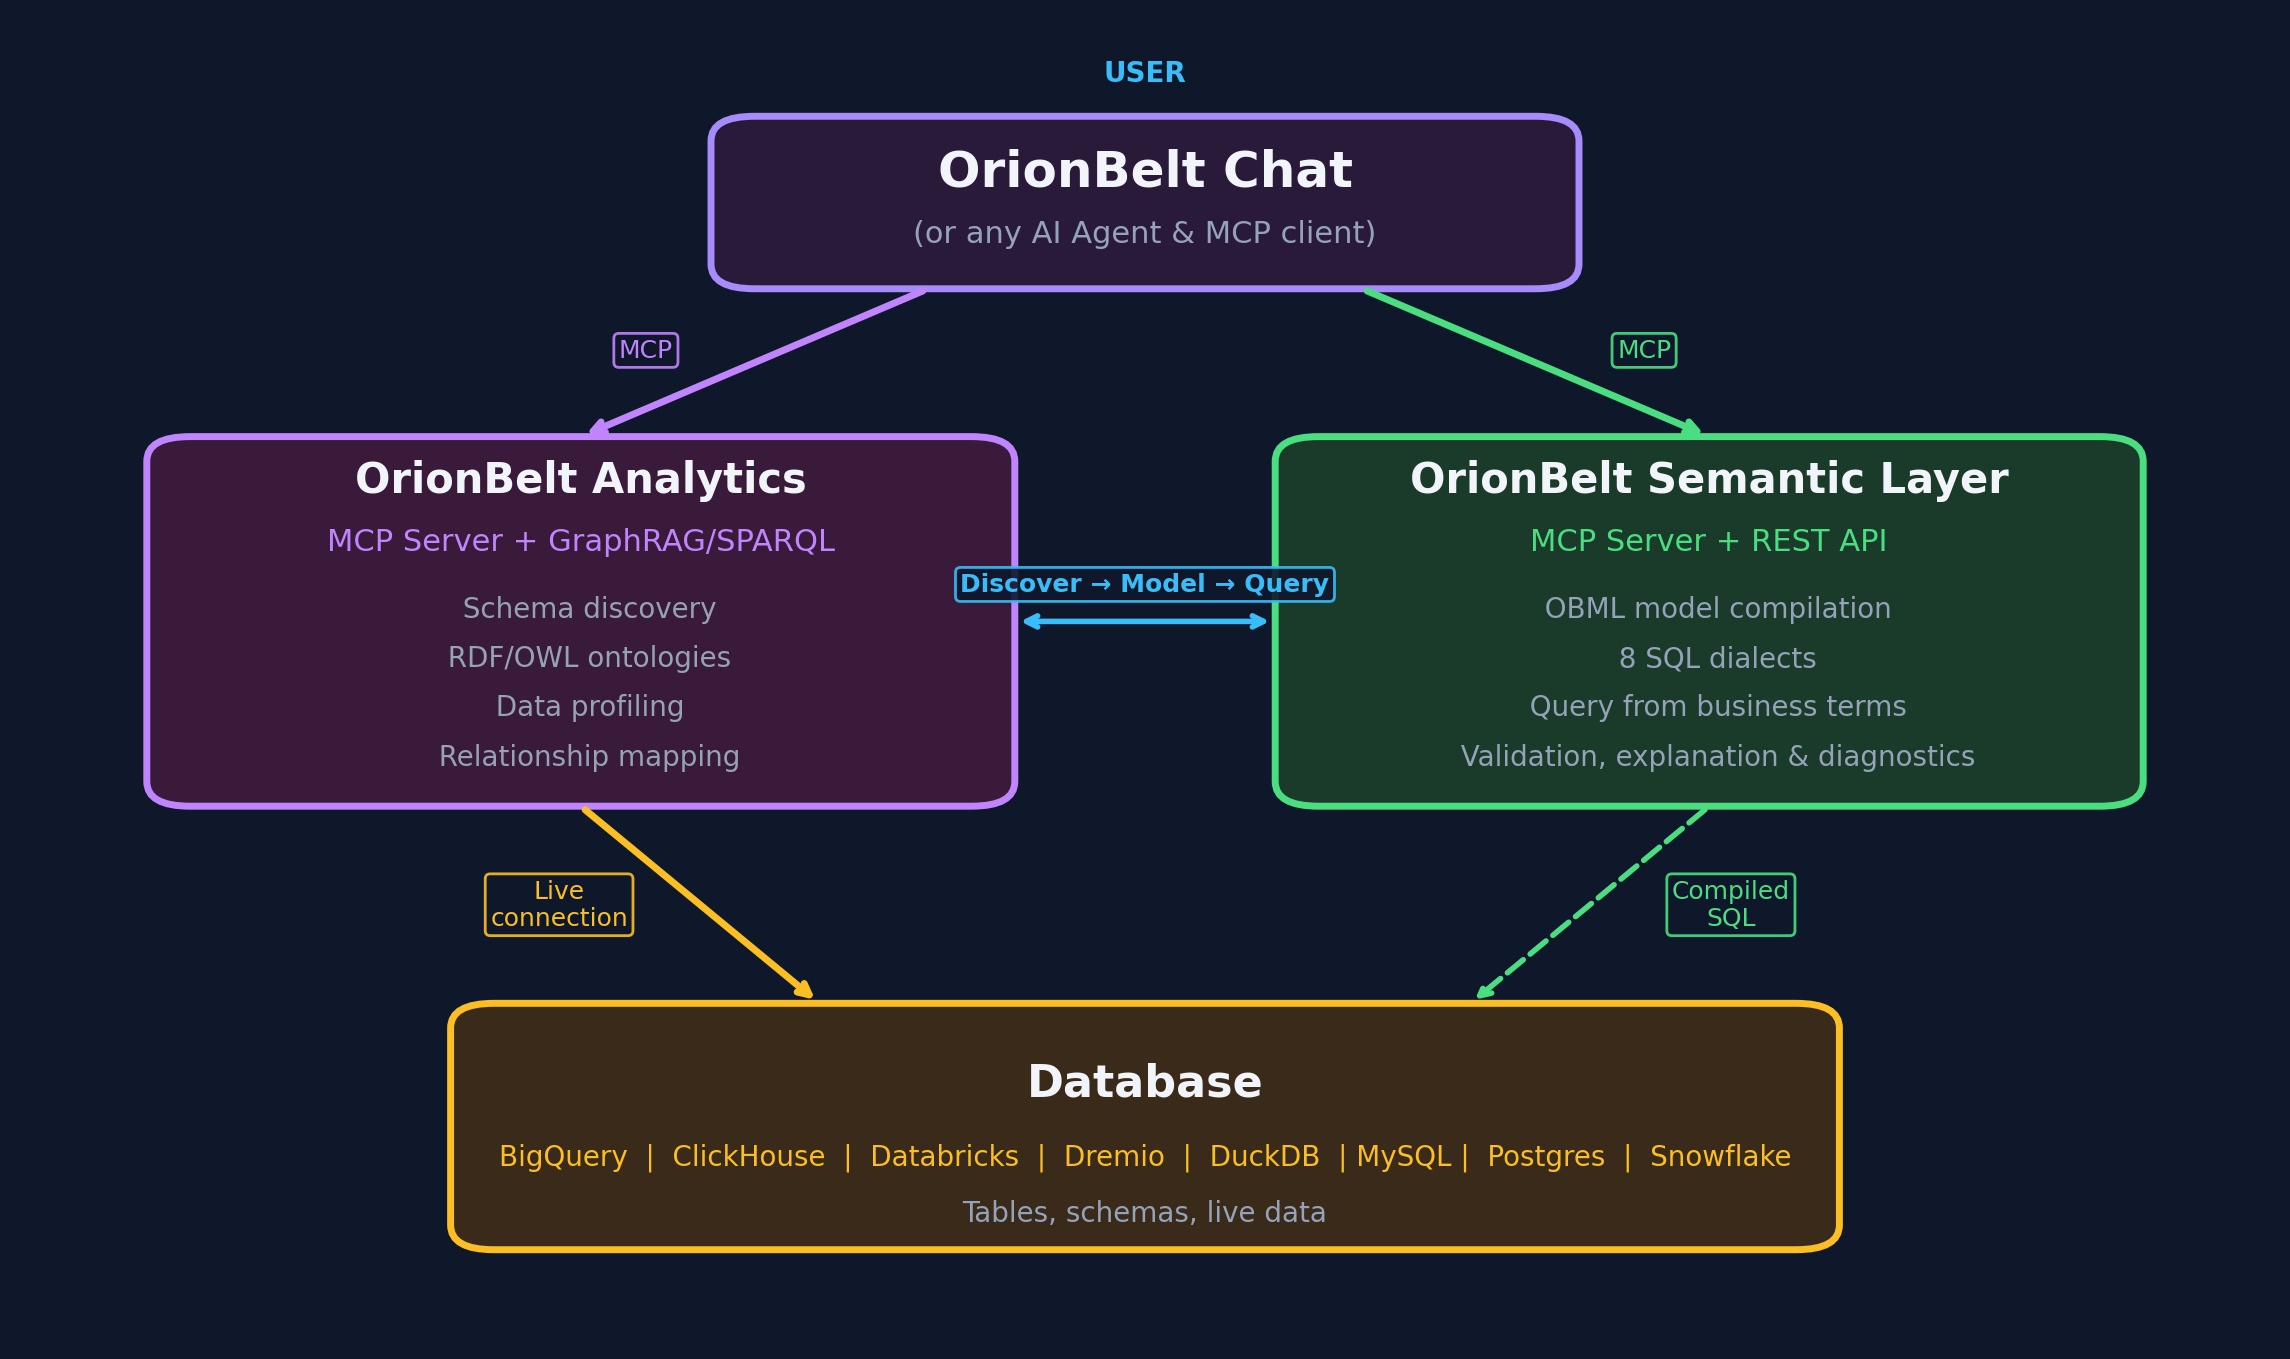
OrionBelt Analytics
一个基于本体的 MCP 服务,可分析关系数据库架构并生成 RDF/OWL 本体。与 OrionBelt Semantic Layer 搭配使用,可让 AI 助手通过本体浏览数据全景,并编译安全且适配方言的分析 SQL。
开发
为 OrionBelt 做出贡献或从源代码运行:
git clone https://github.com/ralforion/orionbelt-semantic-layer.git
cd orionbelt-semantic-layer
uv sync                           # install all deps (dev, docs, ui, flight, drivers)
uv run orionbelt-api              # start API on :8000
# Quality
uv run pytest                     # run tests
uv run ruff check src/            # lint
uv run ruff format src/ tests/    # format
uv run mypy src/                  # type check

# Docs
uv sync --extra docs && uv run mkdocs serve  # docs on :8080

# CI workflows
./scripts/check-action-pins.sh              # verify every Action pin
./scripts/check-action-pins.sh --offline    # skip the upstream tag lookups
GitHub Actions 固定版本
.github/workflows 中的每个 uses: 都固定为 40 个字符的提交 SHA,而不是标签,因为像 v7 这样的标签是可移动的标记:作业启动时,会运行其所有者指向的提交。每个 SHA 旁边的 # vX.Y.Z 注释指出该 SHA 所基于的确切补丁版本,并且必须是补丁版本,因为主版本标签会随着每次上游更新而移动。
固定版本可以确定运行的是哪段代码,但会让引用难以辨认,因此 scripts/check-action-pins.sh 会确保 SHA 及其注释准确无误。它会遍历每一行 uses:,要求其中包含提交 SHA、来自 ALLOWED_OWNERS 允许列表的所有者,以及确切的补丁版本注释;随后使用 git ls-remote 在上游解析该标签,如果标签指向的提交与固定的提交不一致,就会失败。容器操作必须按摘要固定;本地 ./ 操作会跳过。--offline 只检查 SHA 和注释格式,不进行网络调用。
此检查会作为 CI 中的 pins 作业运行,也会作为发布工作流(Docker、PyPI、文档)中检出代码后的第一步运行,因此标签绝不会发布未经验证固定版本的步骤所构建的产物。将所有者添加到 ALLOWED_OWNERS 是一项经过慎重考虑的决定:SHA 与自身标签匹配,并不能说明该操作是否适合放入此仓库。
许可证
版权所有 © 2026 RALFORION d.o.o.
OrionBelt® 是 RALFORION d.o.o. 的注册商标。
本项目依据 Business Source License 1.1 授权(SPDX:BUSL-1.1)。本许可作品将于 2030-03-16 转为 Apache License 2.0。
OrionBelt 重新分发的第三方作品及其条款,列于 THIRD_PARTY_NOTICES.md。
向本项目作出贡献,即表示你同意 贡献者许可协议。
如有商业许可相关咨询,请联系:[email protected]
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。