关于 Titen Memory
Titen Memory 是面向需要可追溯、具备范围控制记录的开发者的证据型 Agent 记忆库。它可在 SQLite 上本地运行,无需 API 密钥、大模型或嵌入服务,也支持 Cloudflare D1。
主要功能
- 01关联来源的声明与版本历史
- 02检索前进行授权和范围检查
- 03基于 FTS5 的排序搜索
- 04跟踪矛盾及其证据
- 05审计记忆库并提供逐项证据
适用场景
- 01将 Agent 记忆关联到来源观察记录
- 02按组织、项目或工作区限制检索
- 03检查记忆导出中的重复项和过期内容
MCP 相关
通过 stdio 和 Streamable HTTP 提供 MCP 工具,并提供知识图谱 MCP 资源。它可使用与 `@modelcontextprotocol/server-memory` 相同的九个工具名称和参数结构。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
npx -y titen-memoryTITEN_MCP_URLOptional. Streamable HTTP /mcp endpoint of a running Titen service. Set together with TITEN_API_KEY to use a shared store instead of the local one.TITEN_API_KEY密钥Optional. API key for the Titen service named by TITEN_MCP_URL. Required only when TITEN_MCP_URL is set.本地服务需要在你的电脑上安装运行环境(如 Node.js 18+)。各客户端的配置文件位置不同,请参考客户端文档。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
Titen
无需 API 密钥、无需大模型、无需嵌入服务商即可运行的 Agent 记忆。
每条记忆都会保留其来源、可读取对象,以及与之矛盾的证据。




由 C.A.D.I.S Agent 构建。
如果 Titen 对你有帮助,在 GitHub 上点个 ⭐,让更多人发现它。
## 30 秒上手无需账号、密钥或配置——但 CLI 需要在 Bun 1.2 或更高版本上运行,没有 Bun 就会拒绝启动:
curl -fsSL https://bun.sh/install | bash   # skip if you already have Bun
npx titen-memory mcp
未设置环境变量时,它会打开或创建 ~/.titen/memory.db,向其中写入真实的组织、工作区、项目和所有者,并在进程内通过标准输入/输出提供 MCP 服务——无需经过 HTTP,也无需粘贴密钥,且不会发起任何出站网络调用。检索使用 FTS5,因此无需嵌入提供方或模型。
curl -fsSL https://titen.dev/install.sh | bash 一步即可完成同样的操作:如果尚未安装 Bun,脚本会先安装 Bun,然后安装 titen 命令。
让 Agent 连接到它:
claude mcp add --transport stdio --scope user titen -- npx -y titen-memory mcp
已经在使用 @modelcontextprotocol/server-memory?Titen 提供相同的九个工具名称和相同的架构,也会响应 memory://knowledge-graph,因此客户端不会察觉到切换。首次以本地模式启动时,它会导入你现有的图谱。请传入旧存储的路径,因为该服务会将文件写在自身安装目录旁边,而不是你启动它的目录中:
claude mcp add --transport stdio --scope user titen \
  --env MEMORY_FILE_PATH=/path/to/memory.jsonl -- npx -y titen-memory mcp
即使不传入路径,Titen 仍会检查工作目录、其 node_modules 和 npm 的 npx 缓存;如果什么也没找到,它会在标准错误输出中说明,而不会默默地以空存储启动。稍后设置 TITEN_MCP_URL 和 TITEN_API_KEY,即可让 titen 连接到一个已运行的实例——完整设置步骤见下文。
审计任何 Agent 内存存储中积累的内容,包括 Titen 不拥有的存储:
npx titen-memory audit ./memory.json
有何不同
- 无需提供方、密钥或账号。 FTS5 词法检索是默认工作模式,而非备用方案。嵌入和模型增强属于可选投影;缺少它们时,系统也能正常运行。
- 没有运行时依赖。
package.json中没有声明任何依赖。它只需要 Bun 和一个 SQLite 文件;其他一切都是标准库和 Web API。 - 可直接替换
@modelcontextprotocol/server-memory。 共提供十九个工具——十个titen_*工具,以及参考服务的九个工具名称。search_nodes使用真正的检索,而不是子字符串扫描;首次运行时还会导入你现有的memory.json。 - 可审计不归其所有的存储。
titen audit可读取参考服务的memory.json、Mem0 导出文件或 Titen 存储,并报告重复项、回忆循环、机密模式和数据陈旧问题,同时为每项发现提供可手动核查的证据。 - 基准测试会公开损失。 五项预先登记的证伪条件中,有两项在针对 Titen 的测试中触发;它们会显示在下方图表中,而不会被排除在外。
已在运行 @modelcontextprotocol/server-memory?
该服务在 2026 年 7 月 31 日当周的下载量达到 106,662 次——它是 MCP 生态中很大一部分项目的默认记忆工具,而且刻意保持极简。阅读其发布的 2026.7.4 tarball 后发现:存储内容是一个以换行符分隔的 JSON 文件,每次修改都会完整重写;搜索则是
graph.entities.filter(e => e.name.toLowerCase().includes(query.toLowerCase()) || ...)
对小写化的搜索词使用 String.includes。没有分词器、没有词干提取、没有排名——结果按插入顺序返回——没有作用域或授权,也没有淘汰机制,因此文件会无限增长,每次调用的复杂度都是针对整个图的 O(n)。问它*"哪个服务处理退款"*,除非存储了这句原话,否则它什么也匹配不到。
Titen 提供相同的九个工具名称、相同的参数架构,以及相同的 memory://knowledge-graph 资源,因此客户端不会察觉到替换。变化发生在底层:search_nodes 会运行真正的检索流程——使用带词干提取的 FTS5,按相关性从高到低排序,并在配置了向量索引时使用该索引——而且每次读取都会限定到某个主体,并在检索前而非检索后进行授权过滤。
@modelcontextprotocol/server-memory | Titen | |
|---|---|---|
| 搜索 | String.includes,按插入顺序返回 | FTS5 + 词干提取,按相关性排序,可选向量 |
| 作用域 | 始终是整个图 | 组织 / 主体 / 项目 / 工作区,检索前强制执行 |
| 矛盾 | 被覆盖 | 保留、关联证据并标记 |
| 增长 | 完整重写文件,无限增长 | SQLite,保留和淘汰策略 |
| 提供方 | 无 | 无——无需密钥、大模型或嵌入提供方 |
首次启动时会导入;切换方法见上文。
审计任意 Agent 记忆存储
每个已发布的记忆基准都在某人整理的语料上衡量检索效果。人们实际报告的问题发生在写入端:存储中充斥着自身输出的副本。对一个生产环境存储进行的唯一一次公开审计发现,10,134 条目中有 97.8% 在 32 天后都是垃圾。没有任何指标衡量这一点。
npx titen-memory audit ~/.titen/memory.db        # a Titen store
npx titen-memory audit ./memory.jsonl            # @modelcontextprotocol/server-memory
npx titen-memory audit ./mem0-export.json --json # a Mem0 export
五项计数——完全重复、近似重复、召回循环、秘密模式、过时条目——每项都附有可手动核查的证据。**不联网、不用模型、不上传:**它以只读方式打开路径并打印报告;是否分享由你决定。如果某个存储缺少指标所需的信号,就会报告为无法从此导出内容中衡量,绝不会将其判定为失败。没有综合评分,也没有排行榜。
检测规则已发布在审计规则中。Titen 自身的数据——包括其存储中 17.9% 的重复内容和 96.7% 的过时内容,以及该工具在 Titen 自身发现的一个兼容性接口缺陷——详见自我报告。
由你撰写声明
Titen 的默认记忆模型是由调用方撰写声明。 consolidate()
接收你撰写的陈述,每条陈述都明确关联到你已记录的源观察。Titen 不会读取对话记录并自行判断哪些内容值得记住。
这是有意为之。每条声明都有作者、来源和范围,这让溯源、权限、冲突和审计问题都有据可答。这也确实会带来成本,而且这是诚实的比较基准:从原始对话中提取记忆的系统承担了 Titen 交还给你的工作。
模型辅助的提取和反思已实现并包含在软件包中,但须通过启用门槛才能使用,目前没有候选模型通过该门槛——记录中的最佳结果为 65.56%,低于 90% 的合约阈值。请将它们视为带有公开门槛的未完成工作,而非可以直接启用的功能。路线图列出了当前证据。
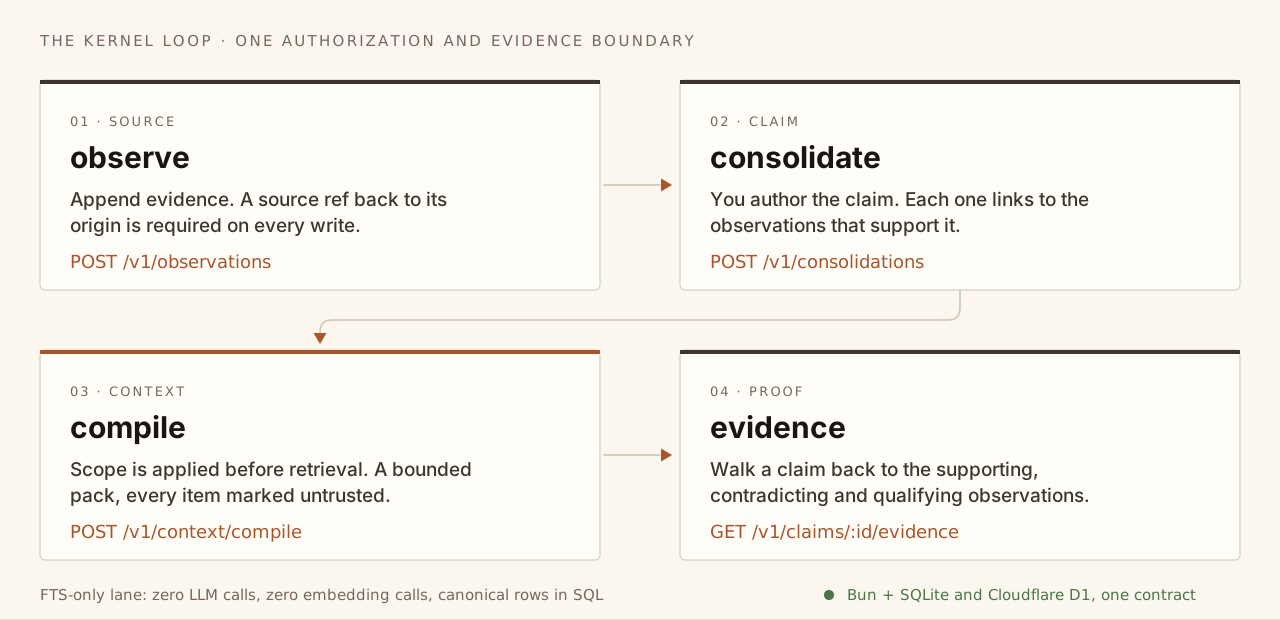
Titen 能回答的问题
| 问题 | Titen 的回答 |
|---|---|
| 这条记忆来自哪里? | 每条声明都指向源观察,并保留其版本历史。 |
| 这个 Agent 可以看到它吗? | 检索前会检查组织、主体、项目、工作区和可见性。 |
| 如果两个来源意见不一致怎么办? | 在通过明确的生命周期操作解决前,矛盾会一直保留并可见。 |
| 谁在执行这项工作? | 租约可防止无声的重复认领;检查点和交接让工作可以恢复。 |
| 我们能审计或迁移它吗? | 规范记录存储在 SQL 中,并提供经过身份验证的审计跟踪以及带版本控制的 JSONL 导出和导入。 |
| 我们需要大模型或向量数据库吗? | 不需要。默认安装仅使用 FTS,完全不依赖任何提供商;嵌入和模型增强则是可选投影。向量功能是否有帮助,取决于存储形态——见下文。 |
Agent 可通过经过身份验证的 REST、Streamable HTTP MCP、titen mcp
stdio 桥接或 TypeScript SDK 连接。Titen 绝不会将检索到的记忆视为指令,也不会运行 Agent 循环。
与领域基准对比
在 LongMemEval-S(MIT,由外部作者创建,500 个实例,246,930 轮对话)上,使用我们自己的评分器,失败项保留在分母中,并在每次运行前预注册测试方案。完整表格和方法见 titen.dev/benchmark。
以下每个数字都标明了测试条件,因为在同一语料库上,测试条件会让 recall@1 相差 63 个百分点。 *按实例(限定范围)*会为每个问题提供约 50 个会话作为搜索范围——这与产品实际处理的单主题场景一致。合并则将全部 19,829 个会话放入同一个未限定范围的存储库,并提出相同的 500 个问题。这是同一语料库的两种测试条件,并非对同一事物进行的两次测量;不注明测试条件的数字毫无意义。
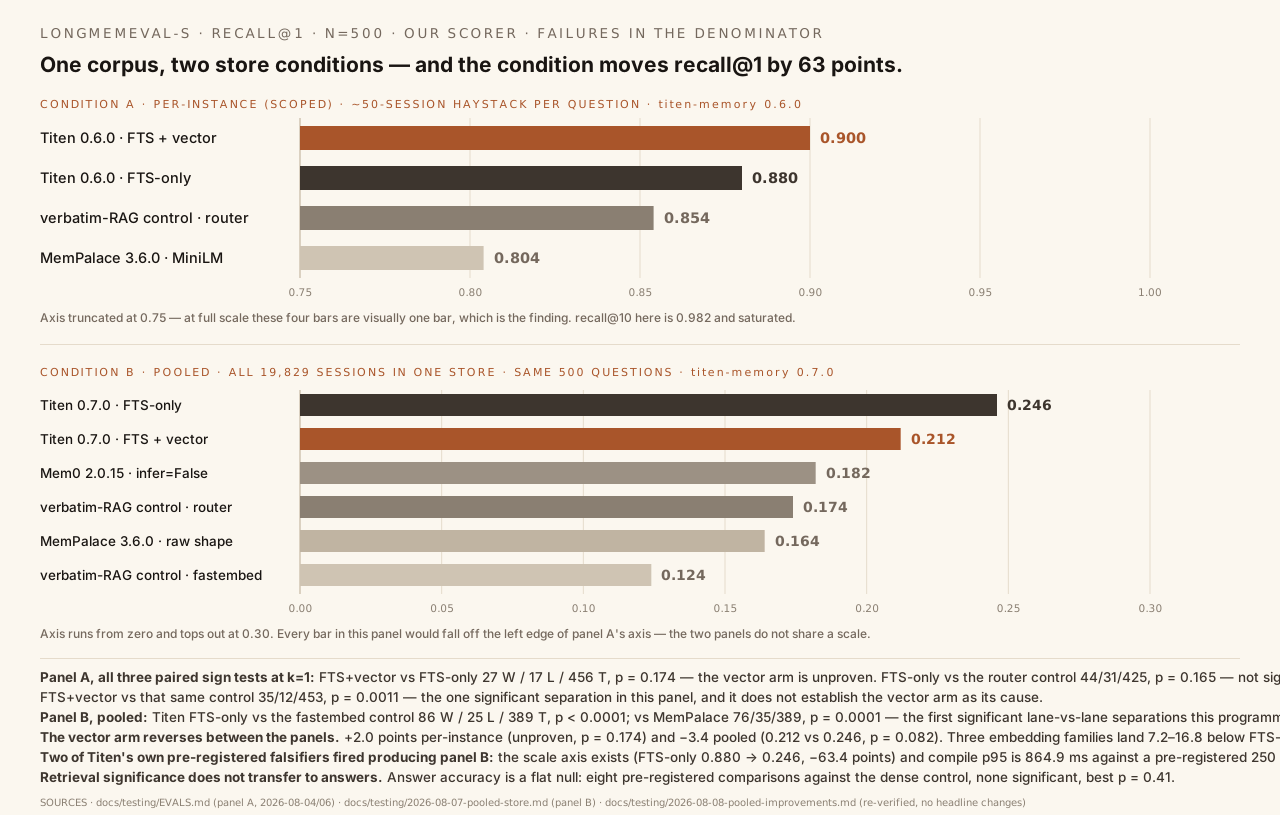
条件 A — 按实例(限定范围)
方案,n=500,titen-memory 0.6.0 | recall@1 | MRR@10 | 大模型调用次数 | 嵌入调用次数 |
|---|---|---|---|---|
| Titen 0.6.0,FTS + vector | 0.900 | 0.9384 | 0 | 4,989 |
| Titen 0.6.0,FTS-only | 0.880 | 0.9147 | 0 | 0 |
| verbatim-RAG 对照组(约 100 行余弦代码) | 0.854 | 0.9067 | 0 | 877 |
| MemPalace 3.6.0 | 0.804 | 0.8717 | 0 | — |
此条件几乎无法拉开差距。 recall@10 为 0.982,已趋于饱和;各主要方案之间仅相差 2.2 个百分点。三项配对符号检验中,恰好只有一项达到显著性,但结果并非表面看起来的含义:
- FTS+vector 与稠密检索对照组相比:35/12/453,p = 0.0011——差异显著。
- FTS+vector 与 FTS-only 相比:27/17/456,p = 0.174——尚不能证明这次胜出是由向量方案造成的。
- FTS-only 与该对照组相比:44/31/425,p = 0.165——差异不显著。
在此条件下,我们并未胜过 Mem0 的无大模型模式。 Mem0 infer=False 在双方共有的 n=60 子样本上得分为 0.8667;Titen FTS+vector 与之相比的结果为 3/4/53,p = 1.0——无法区分。其默认的 infer=True 模式调用大模型 2,981 次,得分却更低(0.8333),因此 Mem0 自身的信息提取在此处未带来可测量的收益。任何成本声明都必须注明所测配置。
答案准确率没有显著变化。 将同一个阅读器固定用于所有方案后,八项预注册比较均无显著结果(最低 p 值为 0.41)。检索显著性不会延续到答案上。
条件 B——合并存储中的全部 19,829 个会话
通道,合并存储 19,829,titen-memory 0.7.0 | recall@1 | MRR@10 | 相较于自身实例级单元格的损失 |
|---|---|---|---|
| Titen 0.7.0,仅 FTS | 0.246 | 0.3259 | −63.4 |
| Titen 0.7.0,FTS + 向量 | 0.212 | 0.3153 | −68.8 |
Mem0 OSS 2.0.15 infer=False | 0.182 | 0.2716 | −68.5 ¹ |
| 逐字 RAG 对照组,router embeddings | 0.174 | 0.2459 | −68.0 |
| MemPalace 3.6.0,已发布配置 | 0.164 | 0.2152 | −64.0 |
| 逐字 RAG 对照组,fastembed | 0.124 | 0.1868 | −64.8 |
| MCP 参考服务 | 0.000 | 0.0000 | 完全无法服务如此规模的存储 |
¹ 对比 Mem0 的 n=60 实例级单元格,而非 n=500。
在此条件下,Titen 的零服务商调用通道显著优于所有实测竞品——以下每组比较均以 Titen 为先,依次列出胜/负/平:相较 fastembed 对照组为 86/25/389(p < 0.0001),相较 MemPalace 为 76/35/389(p = 0.0001),相较 Mem0 infer=False 为 59/27(p = 0.0007),相较 router 对照组为 65/29(p = 0.0003)。这是本项目在此语料上首次得到显著的通道间检索差异;摄取耗时为 363.8 s,服务商调用为零,而 Mem0 耗时 3,953 s,进行了 205,641 次嵌入调用。
针对 Titen 预注册的五项证伪条件中,有两项触发;它们与这项胜利同样值得重视。
- 预测偏差超过 45 个百分点。 我们预注册的全量数据 recall@1 为 0.70–0.85,实测值为 0.246。LongMemEval-S 的人物设定从设计上就会共享话题,因此合并存储会让跨人物的近重复内容变得更密集,而非更稀疏:全部 377 个排名第 1 的错误命中都检索到了跨实例会话,没有一个检索到问题所属数据集中的错误会话。
- 编译 p95 为 864.9 ms,超过我们预注册的 250 ms 终止线;在 10,000 个会话的测试单元格中就已超过该阈值(430.8 ms)。我们承诺照常发布,因此仍予以发布。
没有任何架构能避开合并存储带来的损失——MemPalace 损失 64.0 个百分点,最强的稠密检索对照组损失 68.0 个百分点,而 Titen 损失 63.4 个百分点。并且向量通道在两种条件下的效果方向相反:实例级提升 2.0 个百分点(未经证实,p = 0.174),合并存储下则下降 3.4 个百分点(0.212 对比 0.246,p = 0.082);编译延迟为 2.8 倍,且此前进行了 9,054 s 的索引排空。现在三种嵌入系列在合并存储密度下都比仅 FTS 低 7.2–16.8 个百分点,因此文档仅将向量通道列用于有范围限定的存储。完整报告:合并存储条件。
范围限定是我们测得的最大影响因素
相同语料、相同 tarball、相同 500 个问题——一个通道限定到对应主体,另一个不限定:
存储形态,titen-memory 0.7.0 | recall@1 | compile p95 |
|---|---|---|
| 主体范围限定的锚点,424,168 条声明 | 0.880 | 138.1 ms |
| 未限定范围的合并存储,342,129 条声明 | 0.246 | 864.9 ms |
recall@1 提高 63.4 个百分点,延迟降低 6.3 倍。 这就是我们实测的先授权再检索的价值,也是对“只需按 user_id 限定范围”的实测回答——范围限定就是授权层,而 Titen 按设计会在检索前执行范围限定。
不同存储形态下,仅 FTS 的曲线为:范围限定时 0.880;合并存储包含 1k / 5k / 10k / 19,829 个会话时,依次为 0.524 / 0.364 / 0.308 / 0.246。请勿脱离这些数据单独解读 0.880。
改进周期未能通过任何关卡
2026-08-08,我们预先登记了一个周期,旨在改善这些指标——为延迟设定候选上限、测试六种排序变体,并尝试第三种嵌入系列——但**其中每个关卡都未能通过。没有任何改动发布。**六种排序变体全部未能通过各自的关卡:词项覆盖率 −2.4、邻近度 −14.4、分块求和 −11.8、组合 −3.6、本地交叉编码器 −1.2(每次编译增加 642 ms),RRF 融合 +0.2(p = 1.0)。其中有五种在限定锚点上进行了测试,也导致锚点表现退步。候选上限使 p95 改善了 4.5%,而预测值为 30–60%,因此延迟证伪结论仍然成立。第三种嵌入系列得分为 0.078。完整报告: 汇总改进周期。
这次失败带来了两点收获,都是证据,而非功能:
- **当前发布的排序方案有消融实验作为依据,并非偶然选择。**最佳分块聚合比按块求和高 11.8 个百分点;在两种条件下,当前发布的 BM25 排序都优于覆盖率、邻近度、二者组合、RRF 融合和本地交叉编码器。
- **前 10 名仍有 +26.2 个百分点的真实提升空间,尚未解决,也无人认领。**在 k=1 时,黄金答案位于汇总前 10 名的比例为 0.508,而基线为 0.246。低成本的词法修复空间已用尽;要达到这一上限,需要一种不依赖问题词项重叠的信号。
无论配置参数如何争论,依赖底线始终成立:**在两种条件下,Titen 仅使用 FTS 的路径都没有调用大模型,也没有调用嵌入服务。**Mem0 即使不使用大模型,仍然需要嵌入服务提供方。dependencies: {}、src/core/ 中没有任何外部导入,整个代码库中恰好只有两次出站调用,且二者都需显式启用。
其他已公开的劣势:在合成语料中,FTS-only 的 recall@1 会随着声明数量从 10³ 增至 10⁵ 而从 1.00 降至 0.49——而这还低估了上述真实数据中的性能下降;单进程在 10k 条声明时会占满一个核心;没有重排阶段;也没有任何外部评测套件对治理和协作原语进行评分。
面向团队的记忆,而非聊天机器人
仅用于存储的记忆会保存文本。仅用于检索的记忆会将文本嵌入并返回相近段落。二者都会把判断哪些信息仍然有效、是否获准使用或是否属实的责任留给调用方,而且都无法阻止两个 Agent 悄悄认领同一项工作。
Titen 的 Level 5 内核会将源观察转化为与证据关联的时序声明,并且只编译调用方有权查看的上下文。Level 6 则将该内核与检查点、租约、交接、治理、审计和签名联邦相结合。
Level 6 = 基于证据的上下文 + 协同工作 + 治理
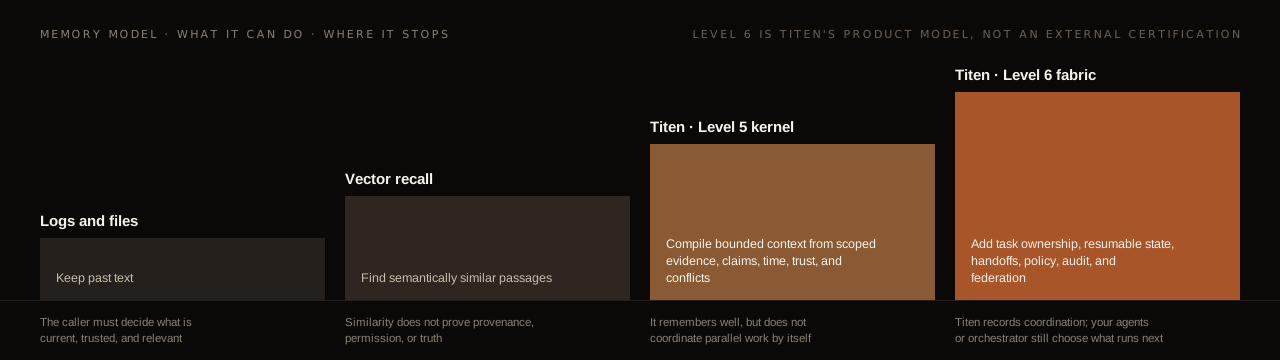
| 记忆模型 | 能力 | 边界 |
|---|---|---|
| 日志和文件 | 保存过往文本 | 调用方必须判断哪些信息仍然有效、可信且相关 |
| 向量召回 | 查找语义相似的段落 | 相似度无法证明来源、权限或真实性 |
| Titen Level 5 内核 | 根据范围受限的证据、声明、时间、信任和冲突编译有界上下文 | 记忆能力出色,但无法独立协调并行工作 |
| Titen Level 6 架构 | 增加任务所有权、可恢复状态、交接、策略、审计和联邦 | Titen 会记录协作情况;接下来运行什么,仍由你的 Agent 或编排器决定 |
Level 6 是 Titen 的产品模型,并非外部认证。这一区别可以从 API 中观察到:记忆和协作共用同一授权、证据和审计边界。
项目状态
Titen 尚未达到 1.0 版本。 根据 SemVer 第 4 条,
公共 API 尚不稳定。在 1.0.0 之前,次版本号是使用者唯一能获得的破坏性变更信号:从 0.5.7 升级到 0.6.0 可能会导致问题,而
^0.5.0 不会匹配 0.6.0。请固定到确切版本,并在升级前阅读
变更日志。
在 Titen 相关内容中出现 stable 一词时——npm 的 latest dist-tag、
titen.dev/version.json 中的 "channel": "stable",以及
titen version --check——它指的是发布渠道:正式发布,而非 next 上的预发布版本。它绝不表示 API 稳定,也不是成熟度徽章。请参阅
版本控制与发布渠道。
当前版本包含记忆内核、REST API、MCP 服务、 TypeScript SDK、协作工具、企业治理、签名联邦,以及运维仪表板。
你可以在 Bun 上搭配 SQLite 运行 Titen,也可以在 Cloudflare Workers 上搭配 D1 运行。语义检索是可选的:在 Bun 上使用 sqlite-vec,或在
Cloudflare 上使用 Vectorize 和 Workers AI——仅在维护者隔离的维护者发布堆栈上通过实时验证;该堆栈是测试生产环境,并非普遍可用
(参见范围说明)。Titen 在你自己的基础设施中运行。
客户端。 Titen 提供 TypeScript/JavaScript SDK、titen CLI,以及一个精简的 Python 客户端,位于
clients/python/。
该 Python 客户端是一个仅依赖标准库的单文件实现,涵盖
observe → consolidate → compile → evidence,并提供通用的 request 方法以访问其他所有路由。它未发布到 PyPI:从检出目录安装,使用
pip install ./clients/python,或将 titen.py 纳入项目。目前没有其他语言的客户端——这些调用方可直接使用经过身份验证的 REST API,而每个路由、作用域和错误格式都列在
API 参考中。
请参阅成熟度矩阵,了解详细的运行时证据和剩余门槛;或参阅 变更日志,查看发布历史。
安装并连接 Agent
本节介绍的是已部署的服务:一个长期运行的实例,拥有自己的 API 密钥,可通过 HTTP 供多个 Agent 访问。如果你只想为这台机器上的 Agent 提供记忆, 上方的30 秒快速体验就是完整的设置步骤,你可以跳到 可选的语义检索。
本地服务需要 Bun 1.2 或更新版本。网站安装程序会在需要时安装 Bun,然后为当前用户安装 titen 命令:
curl -fsSL https://titen.dev/install.sh | bash
titen --version
Windows PowerShell:
irm https://titen.dev/install.ps1 | iex
titen --version
你也可以运行 bun add --global titen-memory@latest。Bun 已在 PATH 中时,也可使用 npm 和 pnpm 全局安装。
已发布的软件包包含当前版本的运维仪表板。安装 CLI 后,运行 titen dashboard 即可提供该确切版本的 /dashboard/ 资源;它不会启用实时数据,也不会开放环回地址以外的监听器。
1. 创建存储
运行一次即可。不带 --db 时,Bun 服务命令会使用每位用户固定的存储 ~/.titen/service.db,不受当前目录影响:
titen bootstrap --org "My Org"
保存输出中的组织 ID、API 密钥和临时仪表板密码。Titen 只存储它们的哈希值。仪表板用户为 owner,首次登录时必须更改密码。
使用 ./titen.db 的现有版本不会自动迁移。请继续通过 --db /absolute/path/to/titen.db 明确使用该数据库,并在 serve、密钥管理、迁移和备份时使用相同的标志。
为每个 Agent 主机创建单独的可撤销密钥。替换组织 ID,并选择一个稳定的主体名称:
titen key create \
  --org-id org_replace_me \
  --principal agent-codex \
  --kind agent \
  --scopes "mcp:call,projects:create" \
  --trust asserted \
  --label codex
mcp:call 包含具有写入权限的记忆和协调工具。不要在所有 Agent 之间共用一个密钥。可选的 --subjects 和 --projects 可将该密钥的写入限制在指定的主体模式和项目 ID 内。--subjects castle:profile:alice,castle:shared 是写入限制;末尾的 * 表示前缀。不设置这些标志时,密钥不受限制。要添加限制,请撤销现有密钥并创建替代密钥。原始密钥只会显示一次。
titen project create 和 titen project update 接受 --default-visibility。未指定 visibility 的 remember 操作会使用项目默认值。未配置增强模型时,请在 titen_remember 中传入 consolidate: true,以便 titen_compile 返回这条写入。
2. 启动服务
titen serve
打开另一个 shell 并检查就绪状态:
curl --fail http://127.0.0.1:8787/readyz
export TITEN_MCP_URL="http://127.0.0.1:8787/mcp"
export TITEN_API_KEY="paste-the-agent-key-here"
将密钥保存在 shell、服务环境或密钥管理器中。切勿将其放入代码仓库。如果 Agent 在容器中运行或运行于另一台机器上,127.0.0.1 指向的是该 Agent,而不是 Titen 服务;请改用私有 HTTPS、Tailscale 或可信隧道 URL。
3. 连接 Agent 主机
Codex 可以直接连接 Titen 的 HTTP 端点。它存储的是环境变量名称,而不是密钥:
codex mcp add titen --url "$TITEN_MCP_URL" \
  --bearer-token-env-var TITEN_API_KEY
codex mcp get titen --json
Claude Code 可以启动捆绑的 stdio 桥接程序。它会继承 Claude 进程中的两个变量:
claude mcp add --transport stdio --scope user titen -- titen mcp
claude mcp get titen
OpenClaw 服务从 ~/.openclaw/.env 读取持久环境变量。将 TITEN_MCP_URL 和 TITEN_API_KEY 放入该文件,将文件权限设为 600,然后注册并探测远程服务:
openclaw mcp set titen \
  '{"url":"${TITEN_MCP_URL}","transport":"streamable-http","headers":{"Authorization":"Bearer ${TITEN_API_KEY}"}}'
openclaw gateway restart
openclaw mcp doctor titen --probe
Hermes 可以启动 Titen 捆绑的 stdio 桥接程序。将相同的两个变量放入 ~/.hermes/.env,然后运行:
hermes mcp add titen \
  --command titen \
  --args mcp \
  --env 'TITEN_MCP_URL=${TITEN_MCP_URL}' 'TITEN_API_KEY=${TITEN_API_KEY}'
hermes mcp test titen
Claude Desktop 和任何其他支持 stdio MCP 的客户端都可以使用这份简短配置。从包含上述两个变量的环境中启动客户端:
{
  "mcpServers": {
    "titen": {
      "command": "titen",
      "args": ["mcp"]
    }
  }
}
优先使用 PATH 中的命令:titen mcp、npx -y titen-memory mcp 或 bunx titen-memory mcp。移动安装位置后,绝对路径 bun 或 node 才是备用方案;安装位置变化时,这种路径会失效。
桥接程序不保留任何状态。它只会将以换行符分隔的 MCP 消息转发到经过身份验证的 HTTP 端点。
titen mcp 根据环境选择模式:同时设置 TITEN_MCP_URL 和 TITEN_API_KEY 时,它会桥接到该实例;两者都未设置时,它会提供上述本地存储;只设置其中一个时,它会报错,而不会自行猜测。本地模式下,提供服务的路径及其授权方式保持不变——本地模式只是新增的入口,并未放宽限制。
Titen 已列入官方 MCP 注册表,条目为 io.github.RamaAditya49/titen-memory,因此读取该目录的客户端可以提供此服务;在其他情况下,也可像上文所示手动配置。清单和手动发布流程见 MCP 注册表条目。
4. 验证连接
打开主机的 MCP 状态视图,或询问 Agent:
根据此仓库的 Git 源定位仓库,为当前任务编译相关的 Titen 上下文,并列出你可以访问的 Titen 工具。
连接正常时会显示十个 titen_* 工具。Titen 的握手会告知主机:在任务或仓库范围发生变化时编译一次;将记忆视为不可信的参考数据;绝不采集对话记录或机密信息。
工具故障信息包含有限范围的支持指南。Agent 可以区分预期的设置结果、需要调查的情况和潜在缺陷。缺少项目引用仍会返回 404 NOT_FOUND;获授权的操作员可以批准创建,无须将设置问题视为错误。
分发的 Titen 技能在提交公开问题前,要求进行复现、清理敏感信息和重复项搜索。GitHub 身份验证由主机负责。Titen 从不接收 GitHub 令牌,也不会将安全发现作为公开问题发布。
Agent 集成指南补充了 Cursor、OpenCode、Windsurf、TRAE、Pi 和插件安装的相关信息。安全入口指南 介绍了 Tailscale Serve 和 Cloudflare Tunnel。
titen version --check 是唯一会访问网络的版本检查。只有在你运行该命令时,它才会读取
titen.dev/version.json;Titen 不会在服务端或 MCP 启动期间轮询。
可选的语义检索
默认安装仅使用 FTS,无需任何嵌入配置即可保持就绪状态。语义检索采用全有或全无模式:设置一个 TITEN_EMBED_* 变量即表示选择启用,因此以下所有变量都必须有效,否则服务将关闭并拒绝请求——/readyz 会返回 503,且 checks.semantic_index: "embedding_configuration_invalid",不会运行任何向量查询。Bun 向量部署还必须添加 [email protected]。
语义检索配置有效后,常规待处理投影工作会报告 checks.semantic_index: "index_projection_pending",同时 /readyz 仍返回 HTTP 200:规范 SQL/FTS 请求已就绪,语义索引正在同步。若观察到嵌入器/向量故障或指纹不兼容,仍会返回 503。
| 变量 | 必需 | 随附默认值 | 缺失或无效时 |
|---|---|---|---|
TITEN_EMBED_BASE_URL | 是 | 无 | configured_error;必须是 http:/https:,且不得包含凭据、查询参数或片段 |
TITEN_EMBED_MODEL | 是 | Bun 上无;Workers 上为 @cf/baai/bge-base-en-v1.5 | configured_error |
TITEN_EMBED_DIMS | 是 | Bun 上无;Workers 上为 768 | configured_error;必须为 1–65,536 的整数,且必须与索引维度相同 |
TITEN_EMBED_REVISION | 是 | 无 | configured_error |
TITEN_EMBED_PROFILE | 是 | 无 | configured_error;每个模型系列仅接受一个值 |
TITEN_EMBED_MIN_COSINE | 是 | 无 | configured_error;每位操作员都必须单独校准此项 |
TITEN_EMBED_API_KEY | 仅当提供方需要承载令牌时 | 无 | 即使只提供此项,也会选择启用;此时服务会关闭并拒绝请求 |
其中三项在任何地方都没有默认值,也无法安全猜测其值:
TITEN_EMBED_REVISION是一个不透明且不可变的标识符,用于标识端点背后的确切权重,长度不超过 200 个字符。系统不会验证其格式——它会记录在存储的索引指纹中,因此更改此值会使索引失效并强制重建。这正是其用途:借此向 Titen 保证,存储中已有的向量与下一次查询使用的是同一组权重。无法提供不可变版本标识符的提供方应仅使用 FTS。TITEN_EMBED_PROFILE用于选择查询/文档输入转换方式,而可接受的值由模型 ID 强制决定。任何包含embeddinggemma的模型 ID(不区分大小写和标点)都只接受embeddinggemma-retrieval-v1;其他所有模型都只接受raw-unit-v1。EmbeddingGemma 模型无法使用未经转换的原始输入,也无法将 EmbeddingGemma 提示应用于其他模型。不匹配会导致configured_error,而不是发出警告。TITEN_EMBED_MIN_COSINE没有随附默认值。未设置的变量会读取为空字符串,因此会被拒绝;语义检索会以失败关闭的方式处理,而不会默默接受较弱的匹配。Titen 不提供通用阈值或预先检查过的阈值:请根据针对确切提供方、模型、版本和配置的固定评估来确定阈值。0是一个有效且刻意设置的值,表示“接受索引返回的所有候选项,并由排序来决定”。
EmbeddingGemma 示例——兼容 OpenAI 的端点提供 embeddinggemma,维度为 768:
bun add titen-memory [email protected]

TITEN_EMBED_BASE_URL=http://127.0.0.1:11434/v1 \
TITEN_EMBED_MODEL=embeddinggemma \
TITEN_EMBED_DIMS=768 \
TITEN_EMBED_REVISION=embeddinggemma-q4-2026-07-31 \
TITEN_EMBED_PROFILE=embeddinggemma-retrieval-v1 \
TITEN_EMBED_MIN_COSINE=0.32 \
bunx titen-memory serve
该模型 ID 只接受 embeddinggemma-retrieval-v1 配置。embeddinggemma-q4-2026-07-31 是占位符:请替换为提供方报告的不可变版本,并将其任何更改视为需要重建索引。0.32 也是占位符——请替换为你自行校准的下限,并记录测量方法。使用 curl --fail http://127.0.0.1:8787/readyz 验证;健康的向量部署会报告 capabilities.vector: "enabled"。
随附的向量路径已在使用 Bun 1.3.13 的 glibc Linux x64 上通过验证;其他平台需要自行进行就绪、排空和查询冒烟测试。
有关备份、密钥轮换、容器和持久化服务设置,请参阅 Bun/VPS 部署指南。
使用 SDK
SDK 使用 fetch,可在 Node 22+、Bun、Deno 和边缘运行时上运行。
titen-memory 仅支持 ESM,没有 CommonJS 入口,因此调用它的项目也必须是 ESM。npm init -y 会写入 "type": "commonjs",所以以下第二行不可省略:否则 Node 会在运行任何 Titen 代码之前报错,提示 SyntaxError: Cannot use import statement outside a module。
npm install titen-memory
npm pkg set type=module
将其保存为 titen-example.js,然后运行 node titen-example.js:
import { TitenClient } from "titen-memory";

const titen = new TitenClient({
  url: process.env.TITEN_URL ?? "http://127.0.0.1:8787",
  key: process.env.TITEN_API_KEY,
});

const subject = "release-runbook";
const observation = await titen.observe({
  subject_id: subject,
  kind: "imported_source",
  content: "The release runbook requires a rollback smoke test after deployment.",
  source: { type: "runbook", ref: "ops/release.md" },
  trust: "verified",
});

await titen.consolidate(subject, [
  {
    kind: "procedural",
    statement: "Run a rollback smoke test after deployment.",
    sources: [
      { observation_id: observation.observation_id, relation: "supports" },
    ],
  },
]);

const context = await titen.compile({
  subject_id: subject,
  task: "rollback smoke after deployment",
  max_tokens: 900,
});

console.log(context.items);
该脚本需要一个正在运行的服务和一个密钥:运行
titen bootstrap --org "My Org" 和 titen serve 来启动服务,然后导出
TITEN_API_KEY。在 TypeScript 中,同一个文件无需修改即可在 Node 22.18+ 或 Bun 上作为
titen-example.ts 运行;在其中写入 process.env.TITEN_API_KEY!
即可满足严格空值检查。跳过 npm pkg set type=module,改用
.mjs/.mts 作为文件名也可以——无论 package.json 如何设置,这些扩展名都属于 ESM。
max_tokens 接受 128 到 32,000 之间的值。每个返回的记忆条目都包含
untrusted: true;提示词边界和操作策略仍由客户端负责。
Python 调用方使用
clients/python/,
该客户端未发布到 PyPI,需从代码库检出后安装。其他语言则直接调用
API 参考
中的 REST API。
类型化方法涵盖常见的 Agent 操作。request() 和 requestRaw()
则可用于其余经过身份验证的 JSON 和流式路由。变更操作接受
idempotencyKey,可安全重试。
请求约定和作用域规则请参阅 Agent 指南 和 API 参考。
架构
同一套符合 Web 标准的 TypeScript 核心为两种运行时提供服务:
| 能力 | Bun / VPS | Cloudflare |
|---|---|---|
| HTTP | Bun.serve | Worker fetch |
| 规范 SQL | bun:sqlite | D1 |
| 词法检索 | SQLite FTS5 | D1 FTS5 |
| 可选向量 | sqlite-vec | Vectorize(见下方作用域说明) |
| 自动模型增强 | 已实现,兼容选择启用的 HTTP | 已实现,兼容选择启用的 HTTP |
| 后台工作 | 启动时执行和有界定时器 | 定时处理程序;触发器配置因环境而异 |
Vectorize 作用域。 Vectorize 和 Workers AI 已在维护者发布栈上实现并通过实时验证。该栈是维护者在其 Cloudflare 账户上独立运行的环境,包含有作用域限制的 BGE-M3 检索、有界修复、Cron、持久化和回滚。 这是测试生产环境,不代表普遍可用:没有客户部署在使用它,而且在依赖它之前,你的账户需要先完成就绪、排空和查询冒烟测试。没有 AI/Vectorize 绑定时,Worker 仍可保持就绪状态,检索使用词法 D1 FTS5。 maturity matrix 列出了确切的验证证据。
自动模型辅助的声明推导和反思已实现为可选启用的能力,包含持久化任务、有界验证和独立就绪状态。这些能力尚未在生产环境启用:没有候选模型通过冻结的启用门槛,锁定版评估和真实运行时冒烟测试也尚未记录。调用方应显式编写与证据关联的声明,具体说明见 由你编写声明。
基础服务不需要 Docker、Redis、Postgres、图数据库或向量数据库。授权在检索之前执行,每个候选项都会先从规范 SQL 中加载,再由 Titen 返回。
组件和故障边界请参阅架构概览。 Cloudflare 运维人员应从 Cloudflare 部署指南开始。
仪表盘
仓库中的 Astro 客户端位于 /dashboard/,是一个实时操作界面,包含 15 个目标区域,涵盖记忆、协作、运维、管理、治理和个人资料。每位用户都通过用户名和密码登录;环回适配器会将生成的短期密钥保存在不透明的 HttpOnly 会话中,绝不会将任何一个密钥写入浏览器存储。初始化时会创建 owner,并为其生成随机临时密码;添加用户也会采用相同的首次登录强制修改密码流程。持久化 SQL 限流机制会跨重启限制密码猜测。可选的 WebAuthn 通行密钥使用分阶段会话和一次性恢复代码,不会阻止公共 API 客户端使用。API 密钥仍可供 Agent、服务、SDK 和恢复流程使用。当服务断开连接或拒绝请求时,不会回退到样例数据。
每个数据区域都使用针对具体任务的表格、列表或事实视图。选择一条记录即可打开其检查器。行操作针对的就是该条记录。完整的授权响应仍可在默认关闭的 技术负载 折叠面板中查看,以便诊断。
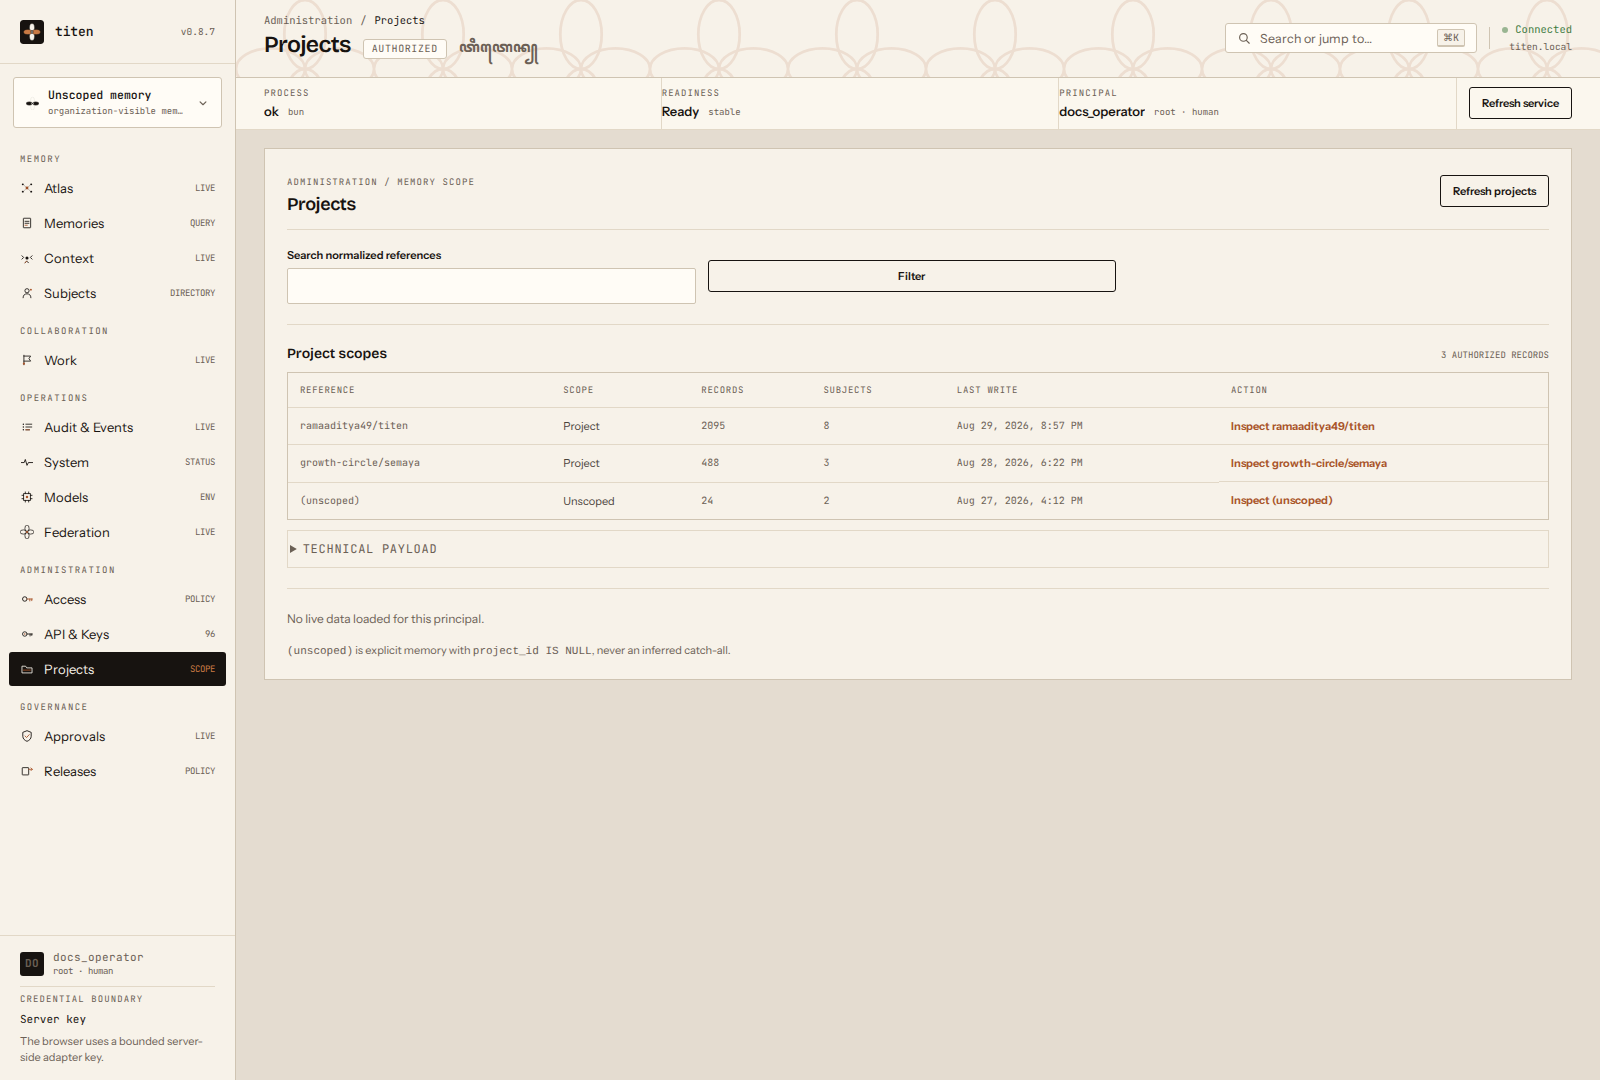
仪表盘指南 介绍了配置和验证。私有 Tailscale Serve 访问,或受 Access 保护的 Cloudflare Tunnel,请参阅 安全入口指南。
对于打包安装,请从同一发行版启动适配器:
TITEN_DASHBOARD_LIVE=true \
TITEN_DASHBOARD_AUTH=session \
TITEN_API_URL=http://127.0.0.1:8787 \
titen dashboard
文档
| 阅读内容 | 适用场景 |
|---|---|
| 黄金路径 | 完整的小团队示例 |
| API 参考 | REST、MCP、错误和兼容性 |
| 来源记忆导入 | 预览并从 16 个明确指定的来源配置导入精选记忆 |
| 架构 | 核心、运行时、存储和策略边界 |
| Agent 集成 | 特定宿主的 MCP 和技能配置 |
| VPS 部署 | Bun、容器、持久化和加固 |
| Cloudflare 部署 | Worker 和 D1 配置 |
| 安全仪表盘入口 | Tailscale Serve 或搭配 Access 的 Cloudflare Tunnel |
| MCP 注册表条目 | 将 server.json 发布到官方 MCP 注册表 |
| 审计规则 | titen audit 如何统计重复项、召回循环、机密和过时内容 |
| 路线图 | 基于证据的成熟度评估和计划中的工作 |
| 文档索引 | 产品、工程、安全和研究文档 |
开发
此仓库要求 Node 22+、Bun 1.2+ 和 pnpm。
git clone https://github.com/RamaAditya49/titen.git
cd titen
pnpm install
pnpm test
pnpm check:workflow
变更遵循 spec -> plan -> implement -> done 流程。修改公开行为、存储、授权或运行时契约前,请先阅读
CONTRIBUTING.md。
安全
将 Titen 限定为绑定到 127.0.0.1。远程 Agent 应使用专用网络或受信任的 TLS 反向代理。当该代理公开 /mcp 时,请将 TITEN_MCP_ORIGIN 设置为其准确的公开源。使用 TITEN_SECRET_KEYS 作为外部加密密钥环,用于持久化的 webhook 和联邦签名密钥,并在启用出站 webhook 前设置 TITEN_WEBHOOK_ALLOWED_HOSTNAMES。VPS 安全指南介绍了相关格式和轮换流程。
请勿在公开议题中报告漏洞。请使用 GitHub 私密漏洞报告,并遵循 SECURITY.md 的说明。报告中切勿包含真实凭据或私人记忆内容。
许可证
Titen 采用 Apache License 2.0 许可。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。