关于 Graphiti Local
Graphiti Local 是面向 Agent 记忆的本地优先时序知识图谱,提供命令行和只读 MCP 访问。图谱更新先进入独立队列,经人工审核批准后才会应用。
主要功能
- 01六个只读 MCP 工具
- 02时序图谱检索
- 03人工审核更新队列
- 04用于查询和摄取的命令行
- 05使用 Ollama 进行本地推理
- 06支持 LadybugDB、FalkorDB 和 Neo4j
适用场景
- 01为 Agent 检索项目决策
- 02应用前审核提取出的事实
- 03将 Markdown 或文本摄取到图谱
- 04查询当前事实或历史记录
MCP 相关
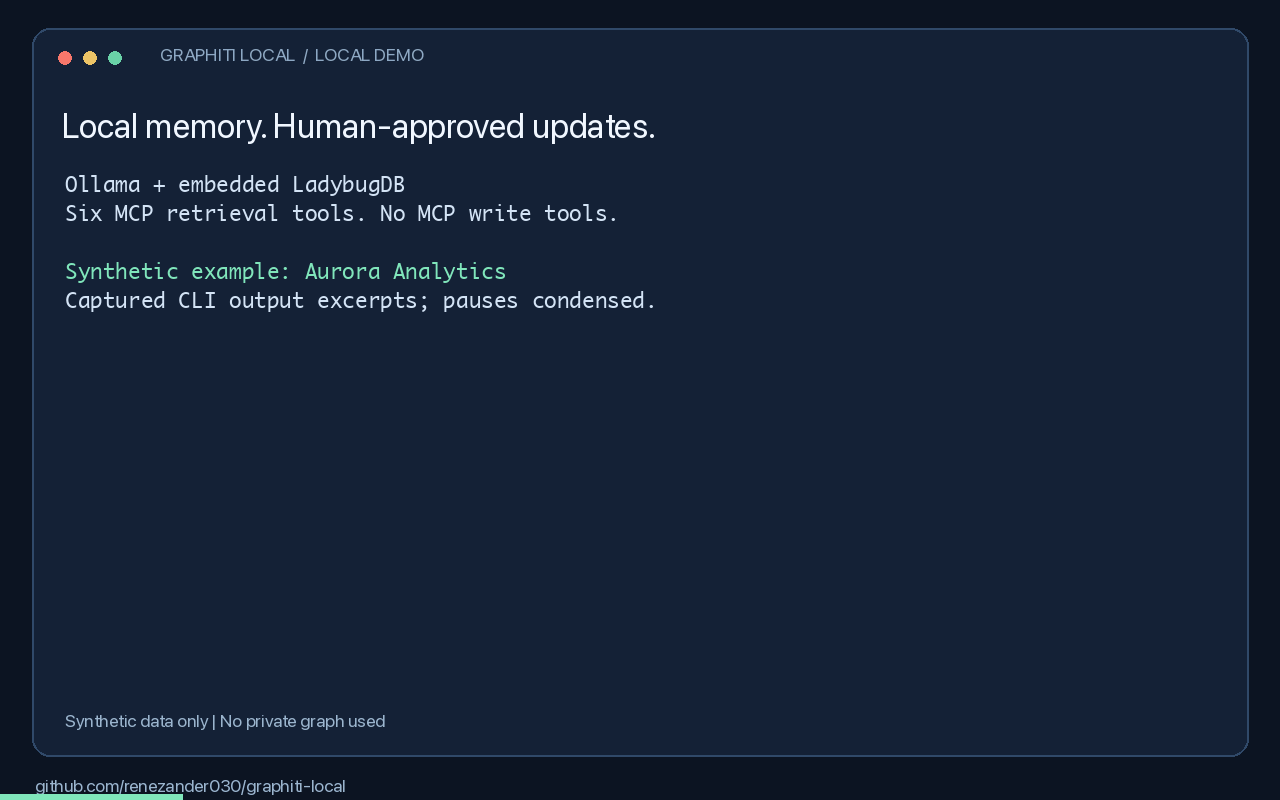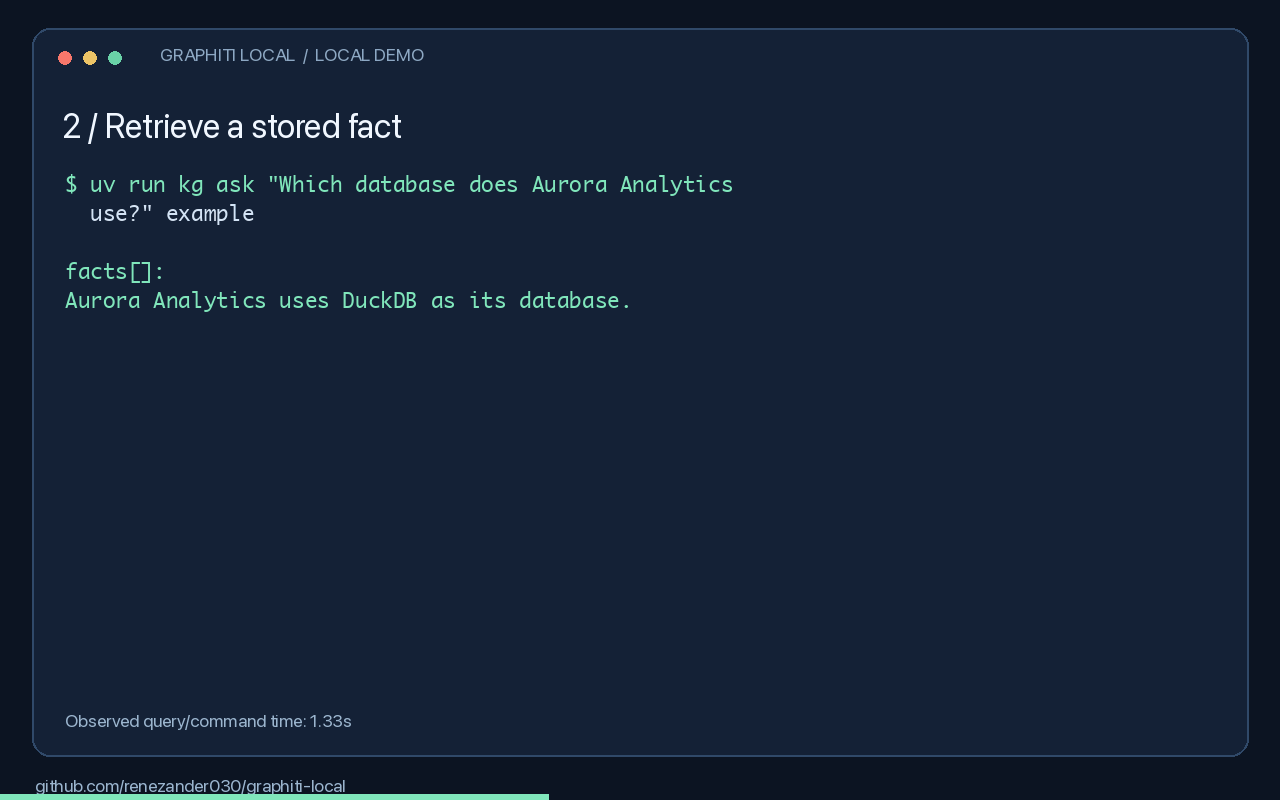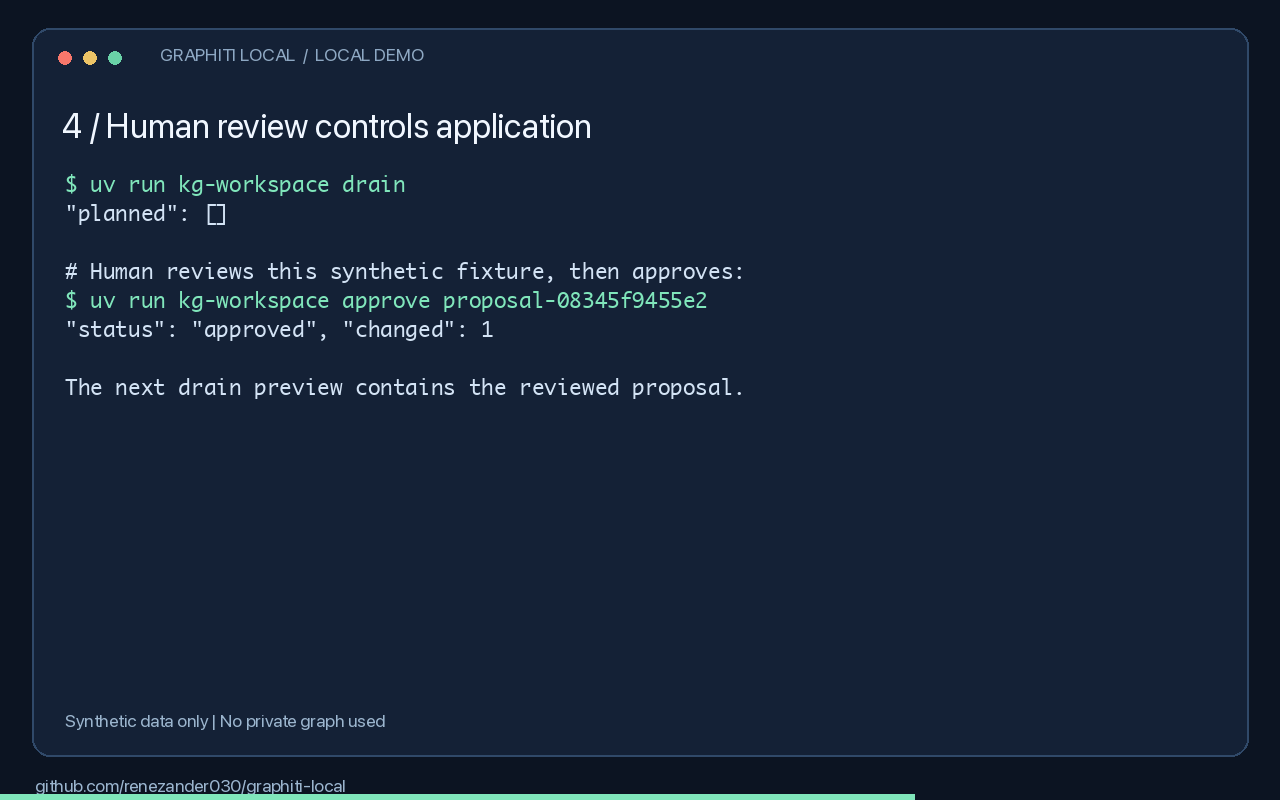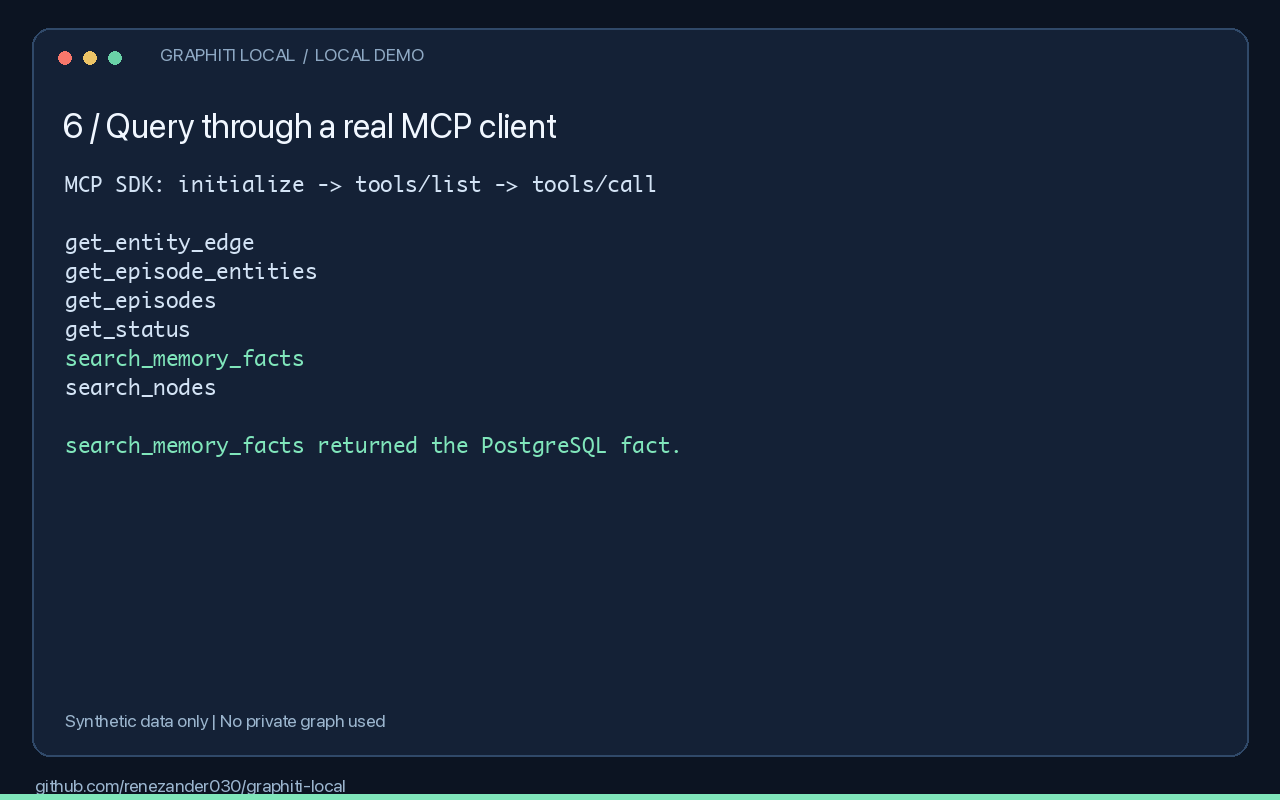
向 MCP 客户端提供六个只读工具,用于检索图谱信息。写入通过独立的人工审核和批准流程处理,不经由 MCP。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
Graphiti Local
为你的 Agent 提供本地记忆。由你审批它们学到的内容。
通过六个只读 MCP 工具或 kg CLI 检索项目决策。
待处理的更新会留在独立队列中,直到人工审批并应用。
Ollama 负责本地推理;内嵌的 LadybugDB 用于存储图数据。本地设置无需 Docker
或云 API 密钥。
输出摘录已缩短停顿。测量结果与局限性。
一条命令即可试用
uvx --from git+https://github.com/renezander030/graphiti-local kg-demo
基于随软件包提供的小型合成图回答问题。无需 Ollama、 无需下载模型,也无需设置数据库:检索仅使用关键词,因此不会联系模型。 将自己的问题作为参数传入即可提问。
这仅包含读取路径。从自己的文本构建图需要抽取,而抽取需要模型;完整设置方法见下文。
在本地试用
安装 uv 和 Ollama,然后启动 Ollama。下载设置所需的内容 需要联网。请在 bash 或 zsh 中运行以下命令:
git clone https://github.com/renezander030/graphiti-local.git
cd graphiti-local
uv sync --frozen
ollama pull qwen2.5:7b
ollama pull nomic-embed-text
export GRAPHITI_LOCAL_CONFIG="$PWD/config/ollama.example.yaml"
export KG_WORKSPACE_DIR="$PWD/workspace/local-demo"
export KG_LADYBUG_PATH="$KG_WORKSPACE_DIR/graph.ladybug"
uv run --frozen kg-ladybug-setup --database "$KG_LADYBUG_PATH" --apply
uv run --frozen kg doctor
uv run --frozen kg-ingest examples/local_memory_demo.jsonl --apply
uv run --frozen kg ask "Which database does Aurora Analytics use?" example
合成示例会返回 DuckDB。按照完整演练指南 提出 PostgreSQL 更新建议,审查并应用该更新,然后从 MCP 客户端检索。模型抽取可能出错;请检查返回的事实和有效时间戳。
若要在抽取内容影响已配置的图之前先进行审查,请运行
kg-ingest INPUT --review-output review.jsonl,检查快照,并在生成的
review.jsonl.review.jsonl 文件中将每条事实标记为 accept、refuse 或
contested。打印的还原命令会拒绝未解决的决定,并提升仅包含已接受事实的
校验和封存快照。默认情况下,搜索返回当前事实;kg ask --history 可显式查看历史记录。
kg-ingest 也可直接接受 Markdown/文本文件或目录树。大型文档会在稳定的文本边界处分段。临时写入会使用一个稳定的 episode id 重试;工作区中的 ingest-receipts.jsonl 和 ingest-failures.jsonl 会准确显示哪些内容已写入,以及哪些仍需处理。
在 Ladybug 上支持多用户
为每位用户分配一个组,并为每个组使用各自的 Ladybug 文件:
graph:
  groups: [alice, bob]
database:
  provider: ladybug
  ladybug:
    layout: per-group          # default: single, one file for every group
    directory: ./workspace/groups
server:
  transport: streamable-http
  auth:
    tokens:
      - {name: alice, token: "${ALICE_TOKEN}", groups: [alice]}
      - {name: bob, token: "${BOB_TOKEN}", groups: [bob]}
每个文件都以其组的 SHA-256 值命名,因此任何组 ID 都无法指向该目录之外。读取操作、kg ask 和 drain 只会打开其所访问组对应的文件;
授予 alice 的令牌绝不会打开 Bob 的文件。读取时需指定一个组,否则将使用令牌对应的单个组。若要在一个数据库服务器内实现租户隔离,请使用 FalkorDB 或 Neo4j。
适合你吗?
适用于需要明确人工审查的本地 Agent 记忆。若你需要 Agent 通过 MCP 写入,或希望使用无需本地设置的托管服务,则不适合。 此外也支持 FalkorDB 和 Neo4j。
如果这有助于你的工作流,请为仓库点星并分享你的设置结果。
由 René Zander 维护,他为 AI Agent 构建基于时序知识图谱的上下文层。
基于 Graphiti 构建的独立社区项目,与 Zep 无关联,也未获其认可。Apache-2.0。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。