关于 ZettelForge
ZettelForge 是面向网络威胁情报(CTI)的 Agentic 记忆系统,可从分析师笔记和威胁报告中提取 CVE、威胁行为体、IOC 和 ATT&CK 技术,并构建 STIX 2.1 知识图谱。整个过程在进程内运行,不依赖外部 API。
主要功能
- 01CVE、威胁行为体、IOC 与 ATT&CK 技术实体提取
- 02威胁行为体别名解析,如 APT28 与 Fancy Bear
- 03基于 STIX 2.1 的知识图谱与因果三元组
- 04向量检索与图遍历融合的意图感知召回
- 05Sigma 与 YARA 规则解析、校验并写入记忆
- 06OCSF 格式的审计日志
适用场景
- 01为 SOC 保存调查上下文,降低分析师离职造成的知识流失
- 02检索历史情报报告中与特定威胁行为体相关的记录
- 03将 Sigma 与 YARA 规则纳入同一本体进行关联查询
MCP 相关
ZettelForge 提供 MCP 服务,可在 Claude Code 中通过 zettelforge_remember、zettelforge_recall 等七个工具存取和检索记忆。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
7收录的工具列表 · 更新于 2 周前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| domain | string | 否 | 领域:cti、incident、general |
| evolve | boolean | 否 | 启用记忆演进:LLM 与现有笔记进行比较,并决定 ADD/UPDATE/DELETE/NOOP。速度较慢,但可避免重复或过时的知识。 |
| source | string | 否 | 来源引用 |
| content | string | 是 | 要存储的威胁情报文本 |
详细介绍
ZettelForge
唯一专为网络威胁情报构建的智能体记忆系统。
资深分析师离职时,两三年的上下文也会随之流失——客户环境、既往调查、攻击者 TTP、误报模式,以及每一次来之不易的“等等,这事以前见过”。ZettelForge 是一个智能体记忆系统,旨在让这些上下文留在团队中。
它从分析师笔记和威胁报告中提取 CVE、威胁行为者、IOC 和 ATT&CK 技术,解析别名(APT28 = Fancy Bear = STRONTIUM = Sofacy),构建 STIX 2.1 知识图谱,并通过自然语言向分析师和通过 MCP 向 Claude Code 提供所有过往调查内容。完全在进程内运行。无需 API 密钥。无需云端。数据不会离开主机。




Star · pip install zettelforge · 文档 · ThreatRecall(托管版) · 更新日志
v2.6.2(2026-04-27):配置网页编辑器现已为所有枚举字段(LLM/嵌入提供方、日志级别、PII 处理方式、综合格式)提供可用的下拉菜单,并新增可用的 Apply 按钮。新增
[crewai]extra,可将 ZettelForge 用作 CrewAI 工具——pip install zettelforge[crewai]。完整更新日志
如果 ZettelForge 适用于你正在使用的 CTI 工作流,点个 Star 是表明这一领域值得持续投入的最快方式。
问题
每个 SOC 都会失去分析师。他们离职时,调查背景、攻击者归因以及特定环境中的误报模式也会随之流失。接替他们的人会重新打开相同的工单、重读相同的报告,并从头重建相同的思维模型。
通用 AI 记忆系统无法解决安全团队面临的问题。它们无法区分 APT28 和 Fancy Bear,不知道 CVE-2024-3094 指的是 XZ Utils 后门,不会解析 Sigma 或 YARA,也不了解 MITRE ATT&CK 技术 ID 的概念。CTI 分析师给它们一年的情报报告后,得到的只是基于聊天记录的模糊语义搜索。
ZettelForge 专为以威胁图谱思考的分析师打造。它会自动提取 CVE、威胁行为者、IOC 和 ATT&CK 技术,解析不同命名规范中的别名,构建包含因果关系的知识图谱,并通过感知意图的混合搜索检索记忆——全程在进程内完成,无需依赖外部 API。
在 CTI 任务中,记忆增强可弥合小模型与大模型之间 33% 的差距(CTI-REALM,Microsoft 2026,以 GPT-4 作为大模型基线)。方法和对比请参阅完整基准测试报告。
| 能力 | ZettelForge | Mem0 | Graphiti | Cognee |
|---|---|---|---|---|
| CTI 实体提取(CVE、攻击者、IOC) | 是 | 否 | 否 | 否 |
| STIX 2.1 本体 | 是 | 否 | 否 | 否 |
| 威胁行为者别名解析 | 是(APT28 = Fancy Bear) | 否 | 否 | 否 |
| 包含因果三元组的知识图谱 | 是 | 否 | 是 | 是 |
| 按意图分类的检索(5 种类型) | 是 | 否 | 否 | 否 |
| 在进程内运行/无需外部 API | 是 | 否 | 否 | 否 |
| 采用 OCSF 架构的审计日志 | 是 | 否 | 否 | 否 |
| MCP 服务(Claude Code) | 是 | 否 | 否 | 否 |
数据管道
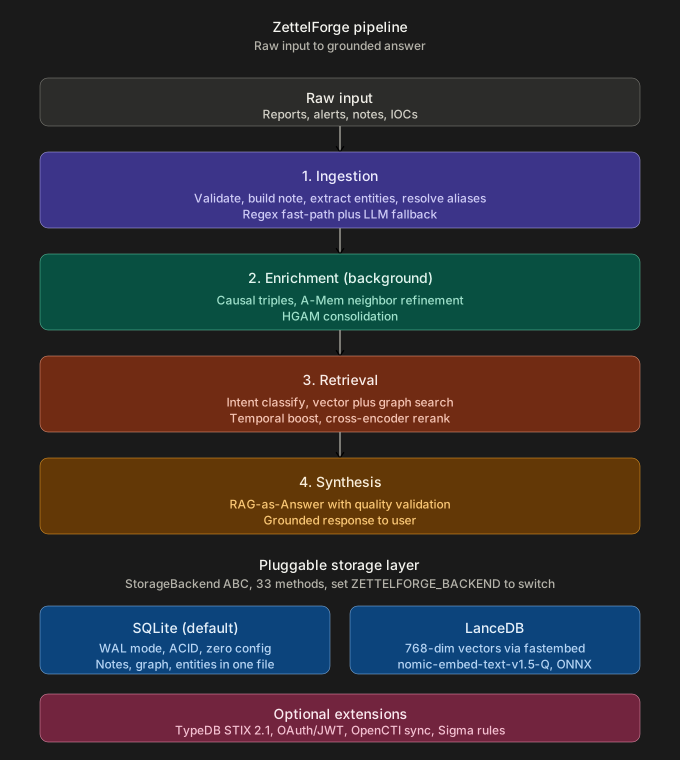
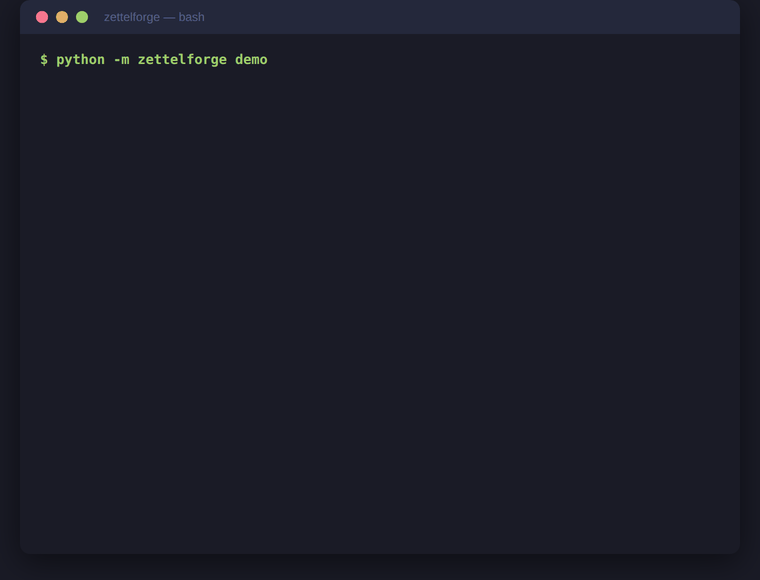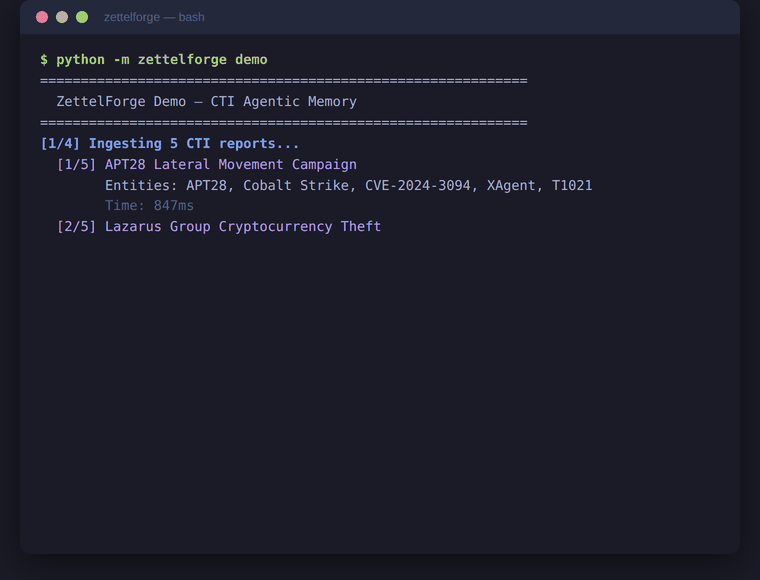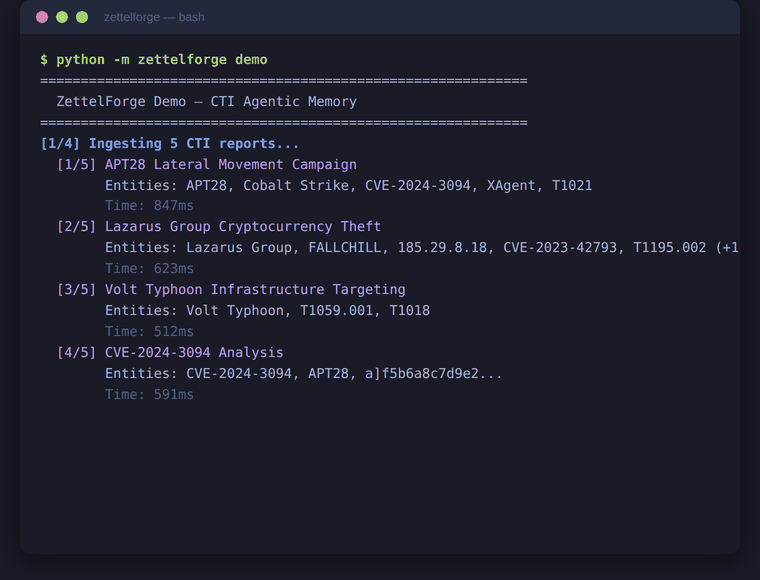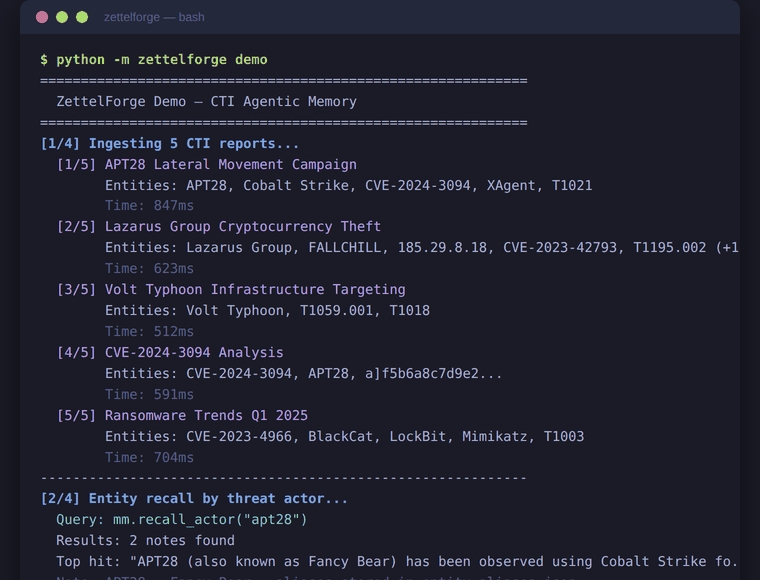
实体提取 -- 自动识别 CVE、威胁行为者、IOC(IP、域名、哈希、URL、电子邮件)、MITRE ATT&CK 技术、活动、入侵组织、工具、人员、地点和组织。全程使用 Regex + LLM NER 和 STIX 2.1 类型。
知识图谱 -- 实体成为节点,共现关系成为边。LLM 推断因果三元组(“APT28 使用 Cobalt Strike”)。时间边和取代关系用于追踪威胁情报的演变。
别名解析 -- APT28、Fancy Bear、Sofacy、STRONTIUM 均解析为同一个行为者节点。在存储和召回时自动生效。
混合检索 -- 向量相似度(768 维 fastembed、ONNX)+ 图遍历(在知识图谱边上执行 BFS),并根据意图分类加权。支持五种意图类型:事实、时间、关系、探索、因果。
记忆演变 -- 启用 evolve=True 后,会将新情报与现有记忆进行比较。LLM 会决定 ADD、UPDATE、DELETE 或 NOOP。过时情报会被取代,矛盾会得到解决,重复内容会被跳过。
RAG 综合 -- 使用 direct_answer 格式综合所有已存储记忆,生成答案。
架构采用进程内运行 -- 使用 fastembed(ONNX)生成嵌入,使用 llama-cpp-python 进行可选的本地 LLM 推理,使用 SQLite + LanceDB 进行存储,默认通过 localhost 上的 Ollama 运行。无需外部 API 密钥。首次运行下载嵌入/LLM 模型时可能会访问外部网络;模型预加载后,可完全离线运行(包括在物理隔离的主机上)。
采用 OCSF 架构进行审计日志记录 -- 每项操作都会生成符合 Open Cybersecurity Schema Framework 格式的结构化事件。如何处理日志流(SIEM、WORM 存储或不作处理)由你决定。
快速开始
30 秒快速示例(无需 LLM)
pip install zettelforge
from zettelforge import MemoryManager

mm = MemoryManager()

# Store CTI -- entities (CVEs, actors, ATT&CK IDs, IOCs) extracted via regex
mm.remember("APT28 uses Cobalt Strike for lateral movement via T1021")
mm.remember("APT28 (Fancy Bear) targets NATO defense contractors with spear-phishing")
mm.remember("CVE-2024-3094 is the XZ Utils backdoor (CVSS 10.0) affecting sshd")

# Recall blends vector + graph search; alias resolution kicks in (Fancy Bear -> APT28)
for note in mm.recall("What tools does Fancy Bear use?", k=3):
    print(f"[{note.metadata.tier}] {note.content.raw}")
在全新执行 pip install 的环境中,无需外部服务即可运行。嵌入通过 fastembed 在进程内运行(约 80MB 的 ONNX 模型会在首次调用时下载)。MemoryManager() 默认写入 ~/.amem/;可通过 ZETTELFORGE_DATA_DIR 或配置覆盖。可运行的示例位于 examples/quickstart.py。
添加 LLM,实现综合和更丰富的提取
ollama pull qwen3.5:9b && ollama serve
# With Ollama running, synthesize() returns a real summary across stored notes
answer = mm.synthesize("Summarize known APT28 TTPs")
print(answer["synthesis"]["answer"])
# Background LLM NER also enriches stored notes with additional entities
ZettelForge 会自动检测 Ollama。若要使用其他提供方(local llama-cpp、支持 100 多家提供方的 litellm、用于测试的 mock),请参阅配置。没有 LLM 时,synthesize() 仍会返回结构化响应,但 answer 字段只是备用占位内容;在仅通过 pip 安装的模式下,只有 remember 和 recall 能产生有用结果。
记忆演变
# New intel arrives -- evolve=True enables memory evolution:
# LLM extracts facts, compares to existing notes, decides ADD/UPDATE/DELETE/NOOP
mm.remember(
    "APT28 has shifted tactics. They dropped DROPBEAR and now exploit edge devices.",
    domain="cti",
    evolve=True,   # existing APT28 note gets superseded, not duplicated
)
工作原理
每次调用 remember() 都会触发以下流水线:
- 实体提取 -- Regex + LLM NER 可识别 CVE、入侵组织、威胁行为者、工具、活动、ATT&CK 技术、IOC(IPv4、域名、URL、MD5/SHA1/SHA256、电子邮件)、人员、地点、组织、事件、活动和时间引用(共 19 种类型)
- 知识图谱更新 -- 实体成为节点,共现关系成为边,LLM 推断因果三元组
- 向量嵌入 -- 768 维 fastembed(ONNX、进程内运行、每次嵌入耗时 7ms)存储在 LanceDB 中
- 取代检查 -- 检测实体重叠,并将过时笔记标记为已取代
- 双流写入 -- 快速路径约 45ms 即可返回;因果关系补充由后台工作进程延后处理
每次调用 recall() 都会混合两种检索策略:
- 向量相似度 -- 对嵌入进行语义搜索
- 图遍历 -- 在知识图谱边上执行 BFS,并按跳数距离评分
- 意图路由 -- 将查询分类为事实/时间/关系/因果/探索,并根据类型调整权重
- 交叉编码器重排序 -- ms-marco-MiniLM 根据相关性对最终结果重新排序
在 Claude Desktop 中于 60 秒内使用 ZettelForge
pip install zettelforge
在项目根目录中创建或编辑 .claude.json(如需全局访问,则编辑 ~/.claude/.claude.json):
{
  "mcpServers": {
    "zettelforge": {
      "command": "python3",
      "args": ["-m", "zettelforge.mcp"]
    }
  }
}
如果 ZettelForge 安装在虚拟环境中,请使用该 Python 解释器的完整路径:
{
  "mcpServers": {
    "zettelforge": {
      "command": "/home/user/.venvs/zettelforge/bin/python",
      "args": ["-m", "zettelforge.mcp"]
    }
  }
}
启动 Claude Code 并确认工具可用:
claude
# Inside the session, ask: "What tools do you have available from zettelforge?"
此处提供了七个工具:zettelforge_remember、zettelforge_recall、zettelforge_synthesize、zettelforge_entity、zettelforge_graph、zettelforge_stats 和 zettelforge_sync(需要企业版软件包)。完整的架构、JSON-RPC 请求/响应示例、错误代码和延迟单例生命周期,请参阅 MCP 协议参考。有关故障排除、虚拟环境路径和手动测试工具的信息,请参阅 set-up-mcp-server。
基准测试
根据已发表的学术基准进行评估:
| 基准 | 测量内容 | 得分 |
|---|---|---|
| CTI Retrieval(CTIBench 子集) | 归因、CVE 关联、多跳推理 | 75.0% |
| RAGAS | 检索质量(关键词出现情况) | 78.1% |
| LOCOMO(ACL 2024) | 对话记忆召回 | 22.0% |
得分列报告的是使用 Ollama 托管模型运行的 ZettelForge 测量结果,但 LOCOMO 行除外:该行在 v2.1.1 中使用 Ollama 云端评审模型重新测量,以进行评估评分(而非本地生成)。有关各基准的具体方法、版本历史和各套件评审配置,请参阅完整基准测试报告。
作为记忆的检测规则(Sigma + YARA)
Sigma 和 YARA 规则是一等记忆原语。解析、验证并摄取规则后,其标签会成为图边:MITRE ATT&CK 技术、CVE、威胁行为者别名、工具和恶意软件家族都会与其他笔记一样,通过同一套本体进行解析。共享的 DetectionRule 超类型包含 SigmaRule 和 YaraRule 子类型,因此同一个规则 UUID 可用于检索这两种格式。
Sigma 规则根据随附的 SigmaHQ JSON schema 进行验证。YARA 规则使用 plyara 解析,并根据 CCCS YARA metadata standard 进行检查(级别:strict、warn、non_cccs)。摄取操作具有幂等性——重新摄取未更改的规则时,会通过内容哈希 source_ref 返回原始笔记。
from zettelforge import MemoryManager
from zettelforge.sigma import ingest_rule as ingest_sigma
from zettelforge.yara import ingest_rule as ingest_yara

mm = MemoryManager()
ingest_sigma("rules/proc_creation_win_office_macro.yml", mm)
ingest_yara("rules/webshell_china_chopper.yar", mm, tier="warn")
# Bulk ingest from SigmaHQ or a private rule repo
python -m zettelforge.sigma.ingest /path/to/sigma/rules/
python -m zettelforge.yara.ingest /path/to/yara/rules/ --tier warn

# CI fixture check -- parse + validate, no writes
python -m zettelforge.sigma.ingest rules/ --dry-run
LLM 规则解释器(zettelforge.detection.explainer.explain)可为任何 DetectionRule 生成结构化 JSON 摘要,包括意图、关键字段、规避说明和误报假设。v1 中按需同步运行;异步扩充队列的接入计划在 v1.1 中推出。调用频率受 ZETTELFORGE_EXPLAIN_RPM 限制(默认每分钟 60 次调用)。
参考资料:Sigma spec、SigmaHQ rules、CCCS YARA、YARA docs。
集成
ATHF(Agentic Threat Hunting Framework)
将已完成的 ATHF 威胁狩猎任务摄取到 ZettelForge 记忆中。提取 MITRE 技术和 IOC,并在知识图谱中建立关联。
python examples/athf_bridge.py /path/to/hunts/
# 12 hunt(s) parsed
# Ingested 12/12 hunts into ZettelForge
ThreatRecall(托管版)
ThreatRecall 是启用了企业扩展功能的 ZettelForge 商业发行版。默认以托管式 SaaS 形式提供,也可选择在本地部署或部署在与外界隔离的环境中,以用于涉密场景。企业级附加功能:
- TypeDB STIX 2.1 后端 —— 通过模式强制执行的本体,并支持推理规则
- OpenCTI 同步 —— 与你的 OpenCTI 实例进行双向同步
- 多租户身份验证 —— 通过 OAuth/JWT 实现各租户间的数据隔离
- Sigma 规则生成 —— 根据提取的 IOC 生成检测规则(即将推出)
SaaS 部署只需几分钟,无需维护基础设施。自托管版本以可部署软件包的形式提供,适用于限制或禁止出站网络访问的环境。
加入候补名单 —— 目前正在招募设计合作伙伴。
配置
| 变量 | 默认值 | 说明 |
|---|---|---|
AMEM_DATA_DIR | ~/.amem | 数据目录 |
ZETTELFORGE_BACKEND | sqlite | SQLite 社区版后端。可通过扩展使用 TypeDB。 |
ZETTELFORGE_LLM_PROVIDER | local | local(llama-cpp)或 ollama |
所有选项请参见 config.default.yaml。
贡献
开发环境设置请参见 CONTRIBUTING.md。
许可证
MIT —— 参见 LICENSE。
由 Patrick Roland 构建 —— LinkedIn | Summit 7 Systems SOC 服务总监 | 海军核潜艇退伍军人 | CISSP、CCP(CMMC 2.0 专业人员)
支持项目
ZettelForge 采用 MIT 许可证。欢迎为仓库点星、提交问题和 PR——欢迎所有贡献。
致谢
- 灵感来自 Zettelkasten 和 A-Mem(NeurIPS 2025)
- 两阶段流水线的设计灵感来自 Mem0
- STIX 2.1 模式参考了 typedb-cti
- 与 LOCOMO(ACL 2024)和 CTIBench(NeurIPS 2024)进行了基准测试
- LanceDB | fastembed | Pydantic | TypeDB
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。