
关于 agent-eval
agent-eval 提供 CLI、Python API 和 MCP 服务,用统计回归测试比较不同版本的 LLM Agent。它报告显著性、效应量和置信区间,帮助团队区分行为变化与运行波动。
主要功能
- 01比较不同版本的分数分布
- 02报告 Mann-Whitney U 的 p 值
- 03计算 Cohen's d 效应量
- 04生成自助法置信区间
- 05在 CI 中拦截回归
适用场景
- 01检查提示词修改是否改变 Agent 行为
- 02在显著回归后阻止部署
- 03使用已有分数文件比较 Agent 版本
MCP 相关
其 stdio MCP 服务提供 `run` 工具,调用 `agent-regress` CLI 并返回解析后的 JSON 结果。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
Agent 评估




面向大模型 Agent 的统计回归测试:分别运行版本 A 和版本 B 各 50 次,得出 p 值、效应量,以及用于判断行为是否确实发生变化的 95% 置信区间。
pip install agent-regress-cli
(uv add 和 npm/npx 封装程序的安装方法见下文的安装。)
每个评估框架都跳过的测试
你修改了提示词。评估仍然通过。 但 Agent 的工具准确率从 84% 降到了 70%。
这是真正的回归吗?还是大模型每次运行时的噪声?
阈值测试无法回答这个问题。 agent-eval 可以。
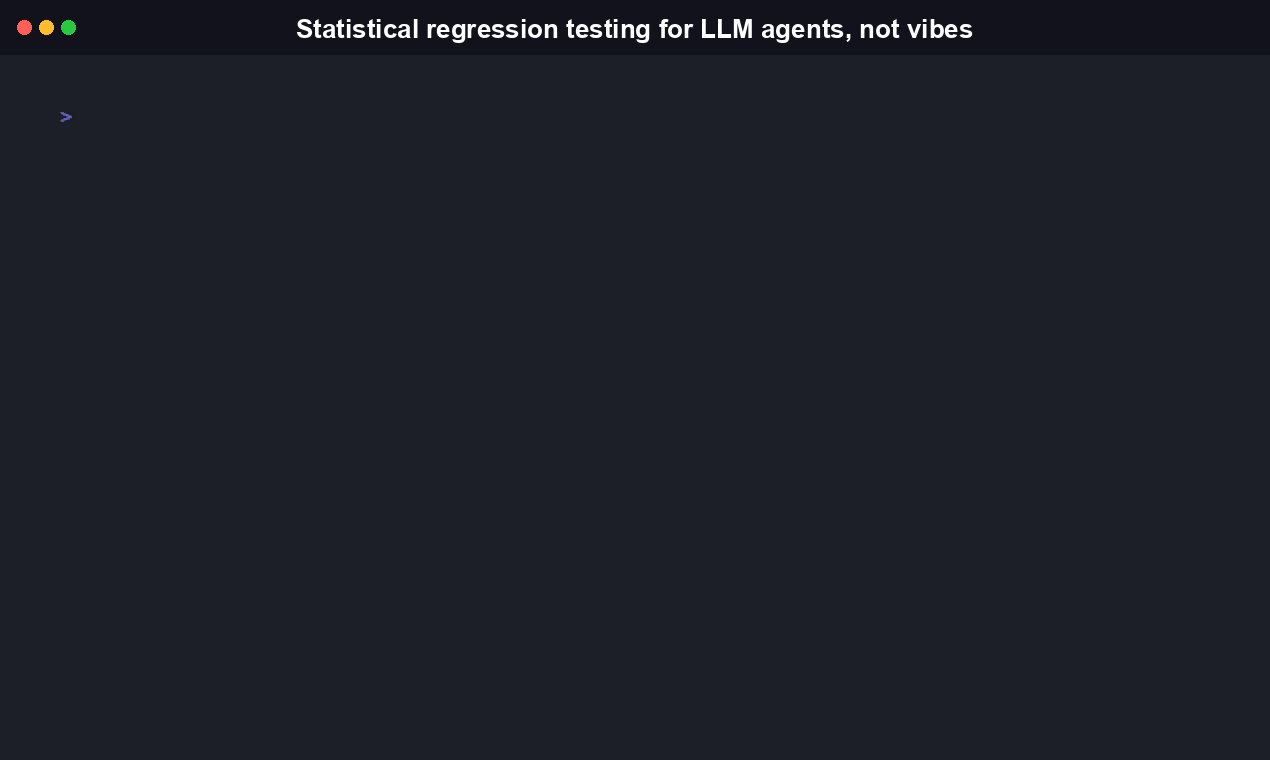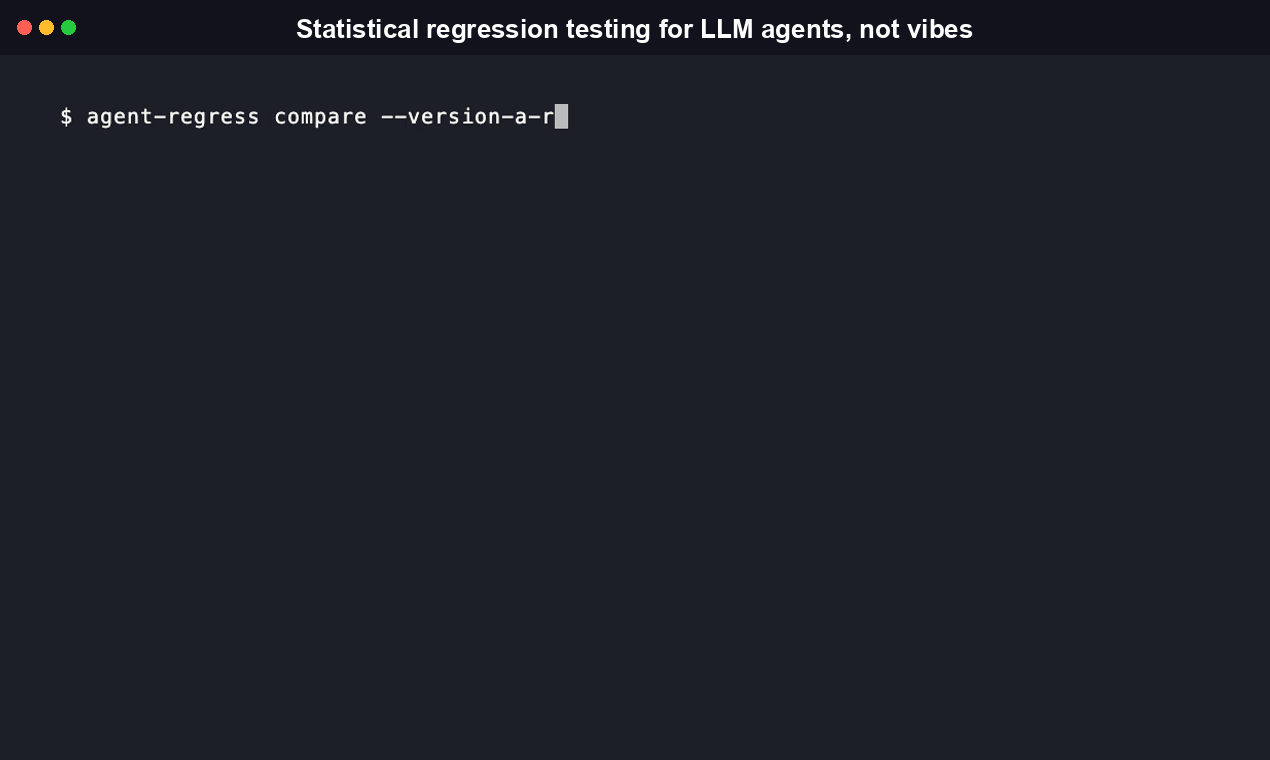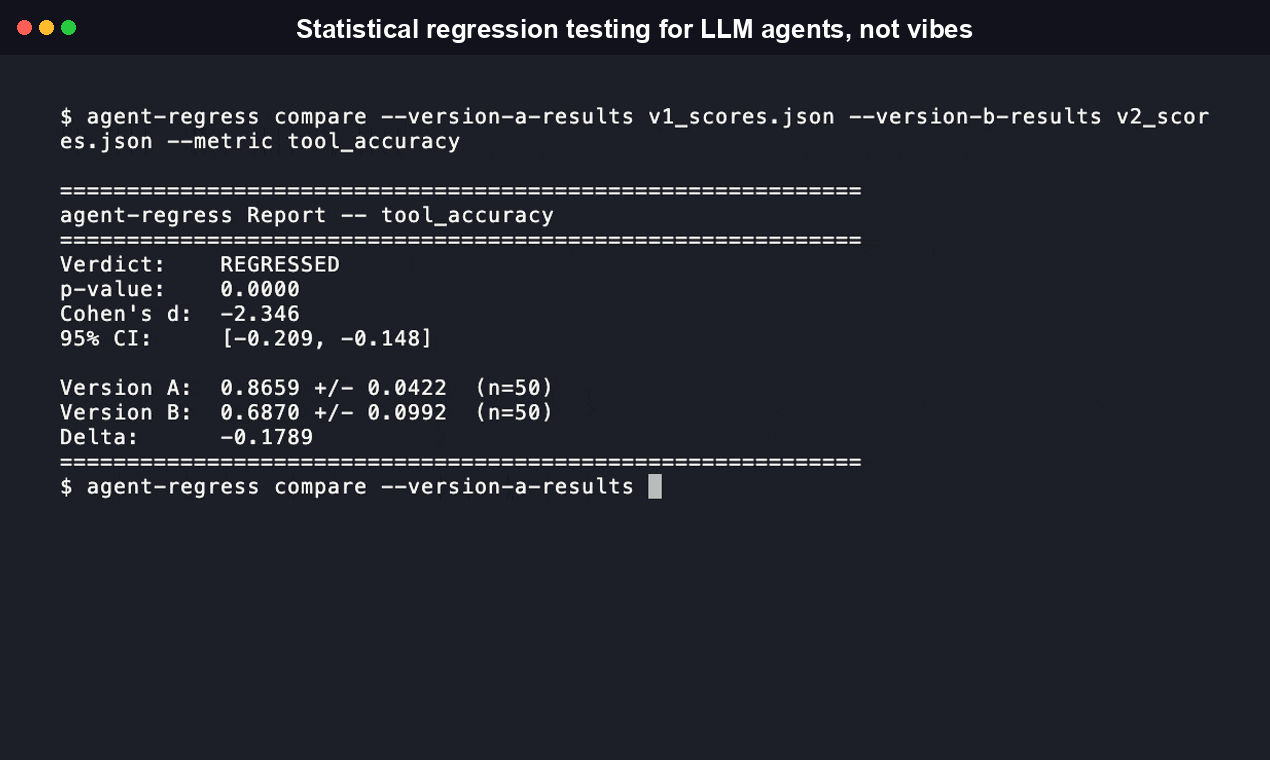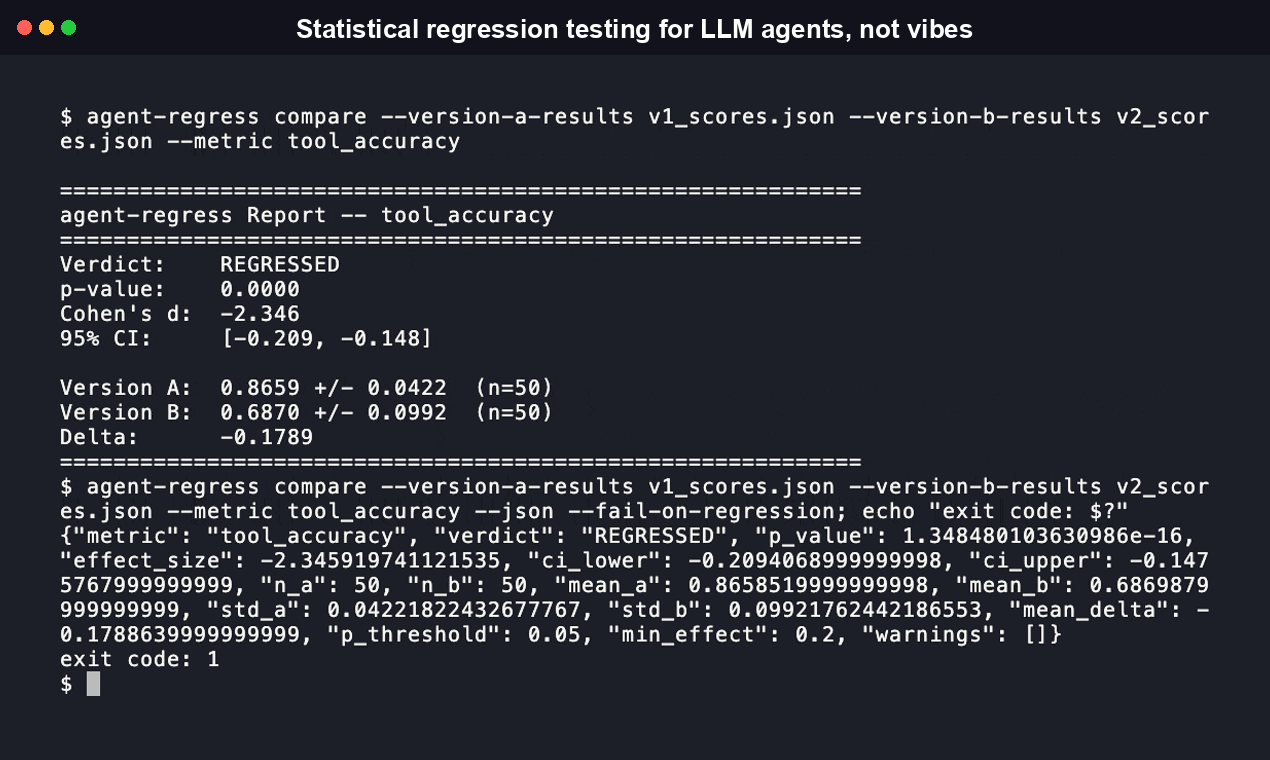
在版本 A 上运行 Agent 50 次,在版本 B 上运行 50 次。 得出 p 值、效应量,以及用于判断行为是否确实发生变化的 95% 置信区间。
p=0.003, Cohen's d=-0.61 -> REGRESSED (deploy blocked)
p=0.410, Cohen's d=0.021 -> STABLE (safe to ship)
说明
Promptfoo 是最广泛使用的开源大模型评估框架之一,于 2026 年 3 月被 OpenAI 收购,并继续开源,但其团队并入了 OpenAI 的 Frontier 平台。agent-eval 采用 Apache 2.0 许可证,可自托管,且没有商业依赖。统计核心(Mann-Whitney U、bootstrap CI、Cohen's d)永远不会设为付费功能。
安装
pip install agent-regress-cli
# or
uv add agent-regress-cli
# or, from Node/npx (thin wrapper around the same Python CLI)
npx agent-regress-cli
快速入门
30 秒上手(CLI)
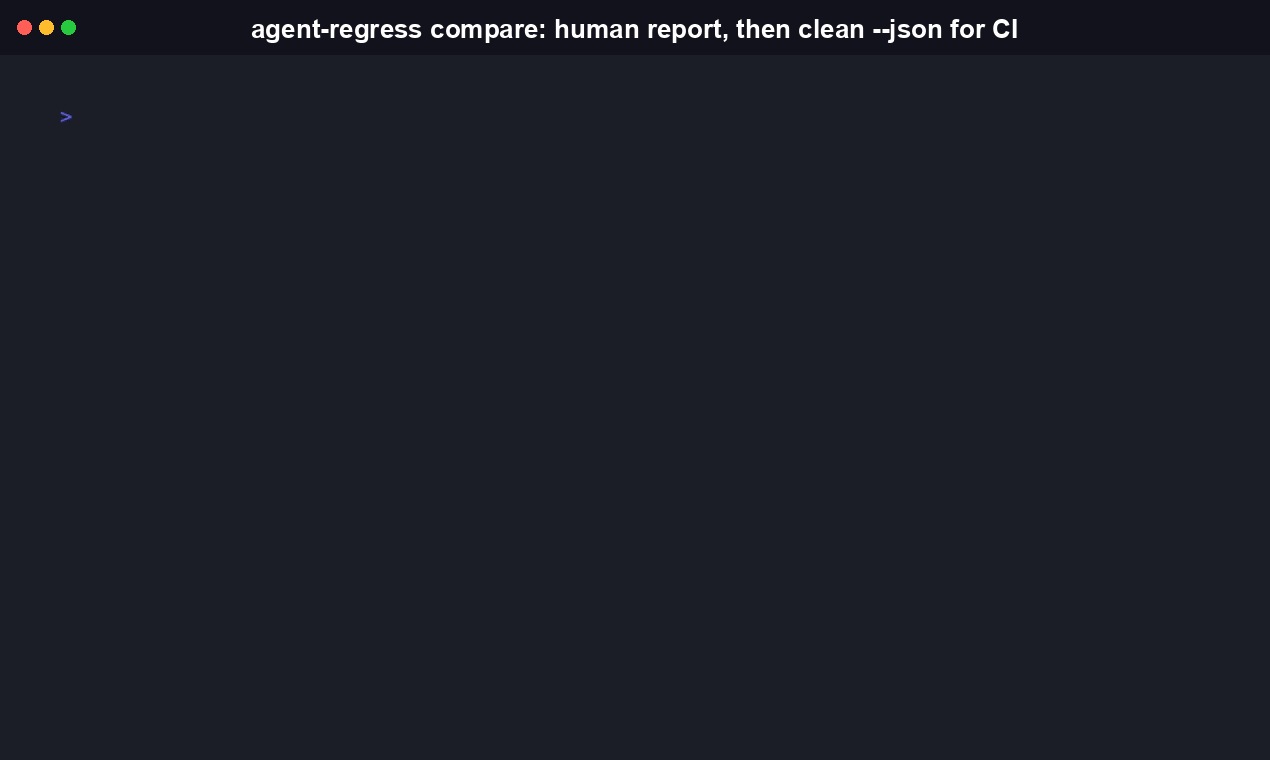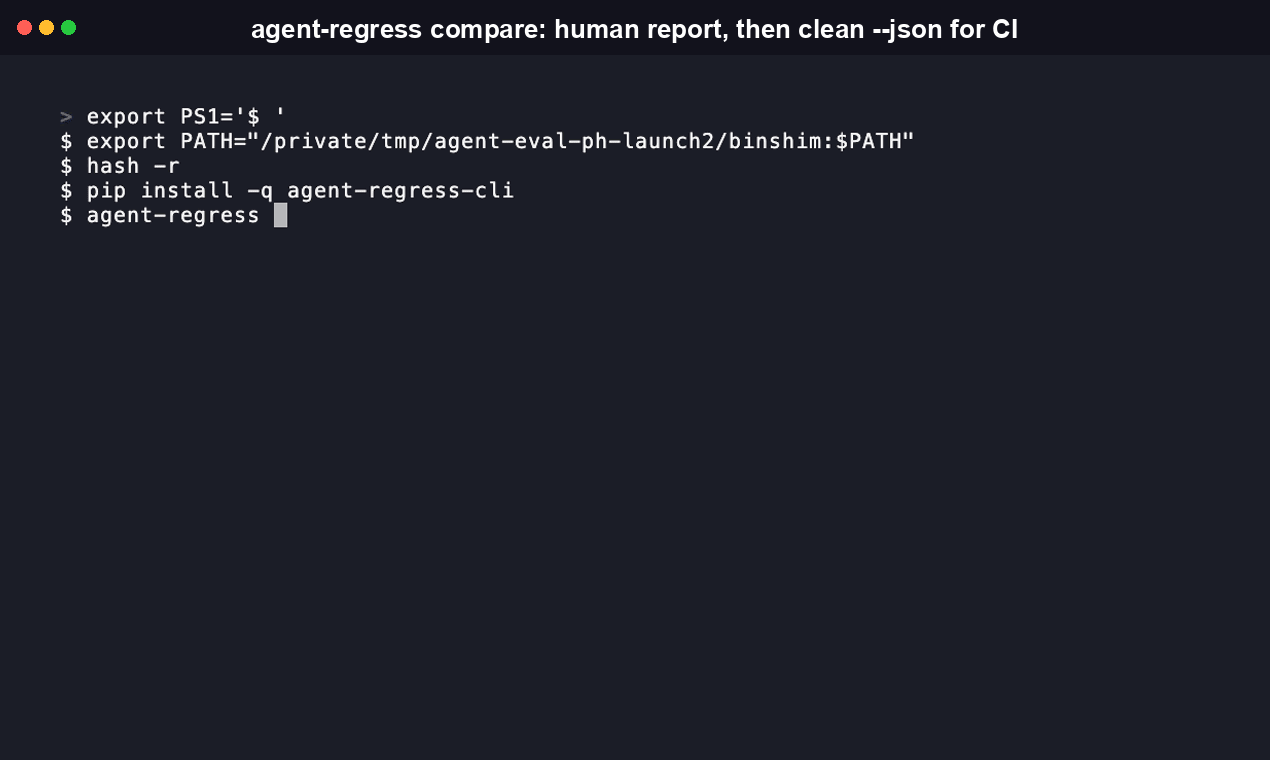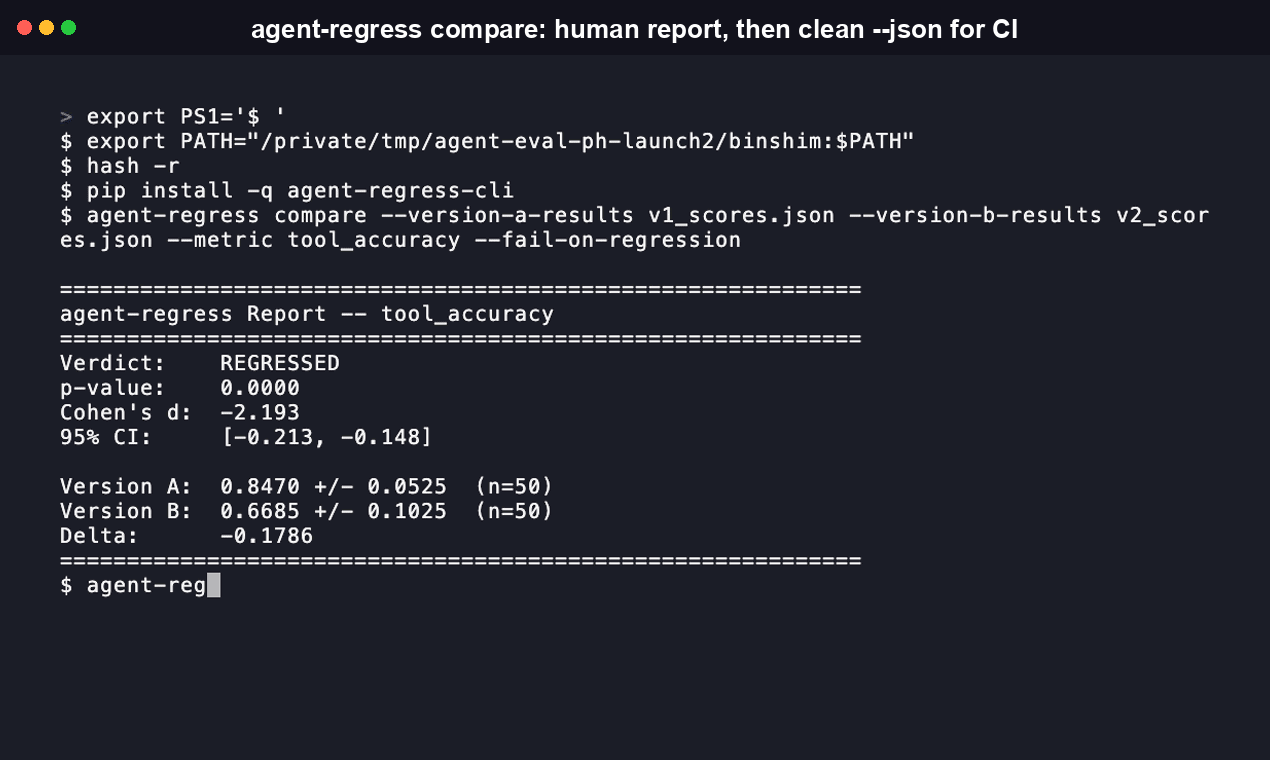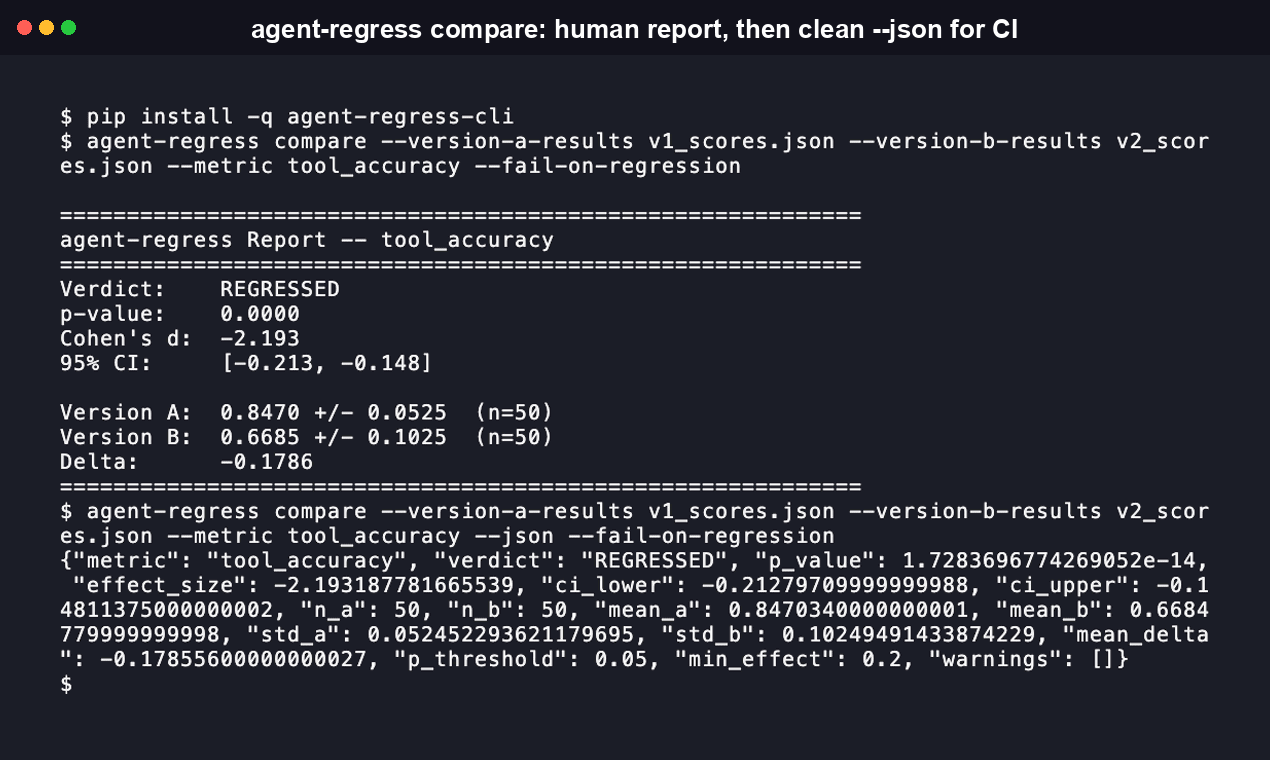
已经通过自己的测试框架获得每次运行的评分?将 CLI 指向两个 JSON 评分数组,每个版本一个:
pip install agent-regress-cli

agent-regress compare \
  --version-a-results v1_scores.json \
  --version-b-results v2_scores.json \
  --metric tool_accuracy

# ============================================================
# agent-regress Report -- tool_accuracy
# ============================================================
# Verdict:    REGRESSED
# p-value:    0.0000
# Cohen's d:  -2.193
# 95% CI:     [-0.213, -0.148]
#
# Version A:  0.8470 +/- 0.0525  (n=50)
# Version B:  0.6685 +/- 0.1025  (n=50)
# Delta:      -0.1786
# ============================================================
添加 --json --fail-on-regression,即可获得简洁、可解析的输出,并在结果为 REGRESSED 时返回非零退出码,直接接入 CI。
agent-regress compare 的所有标志:
| 标志 | 默认值 | 说明 |
|---|---|---|
--version-a-results PATH | (必填) | 版本 A(基线)每次运行评分 JSON 数组的路径。 |
--version-b-results PATH | (必填) | 版本 B(候选版本)每次运行评分 JSON 数组的路径。 |
--metric NAME | accuracy | 要比较的指标名称,会显示在报告中。 |
--p-threshold P | 0.05 | Mann-Whitney U p 值的显著性阈值。 |
--min-effect D | 0.2 | 用于判定统计显著差异为 REGRESSED/IMPROVED 而非 STABLE 的最小 |Cohen's d|。 |
--n-resamples N | 1000 | 计算置信区间时使用的自助重采样次数(最少:100)。 |
--json | 关闭 | 将报告作为单个 JSON 对象输出到 stdout,而非人类可读格式。警告仍会输出到 stderr,因此 stdout 保持干净、可解析的 JSON。 |
--fail-on-regression | 关闭 | 如果判定结果为 REGRESSED,则以状态码 1 退出(适用于 CI)。不使用此标志时,无论判定结果如何,命令都会以 0 退出。 |
顶层 agent-regress --version 标志会打印已安装的版本并退出。
退出码:
| 代码 | 含义 |
|---|---|
0 | 运行成功。判定结果可能是 REGRESSED、STABLE、IMPROVED 或 INSUFFICIENT_DATA;不使用 --fail-on-regression 时,退出码不反映判定结果。 |
1 | 已传入 --fail-on-regression,且判定结果为 REGRESSED。 |
2 | 用法或数据错误:参数无效或缺失、未提供子命令、--version-*-results 文件不存在或不是有效 JSON、评分数组为空或包含非数值,或者 --p-threshold(必须在 (0, 1) 范围内)、--min-effect(必须 >= 0)或 --n-resamples(必须 >= 100)的值超出范围。 |
在代码中使用(Python API)
想自行运行 Agent,而不是预先计算评分?使用 Python API:
from agent_regress import compare

# Any callable that takes a test case dict and returns a score 0.0-1.0
def agent_v1(test_case: dict) -> float:
    ...  # your existing agent

def agent_v2(test_case: dict) -> float:
    ...  # your updated agent

test_suite = [
    {"query": "find SKU for order 8823", "expected": "SKU-4492"},
    # ... more test cases
]

report = compare(
    version_a=agent_v1,
    version_b=agent_v2,
    test_suite=test_suite,
    n_runs=50,
    metric="tool_accuracy",  # use any name except "accuracy" when agents return floats
)

print(report)           # structured output with p-value, CI, effect size
report.assert_stable()  # raises AssertionError if behavior regressed
Agent 返回文本?传入评分器或使用内置评分器:
from agent_regress import compare, exact_match_scorer, f1_scorer

# exact_match_scorer: 1.0 if str(output).strip() == str(expected).strip()
# f1_scorer: token-level F1 (multiset — handles repeated tokens correctly)
report = compare(
    version_a=agent_v1,
    version_b=agent_v2,
    test_suite=test_suite,
    n_runs=50,
    scorer=exact_match_scorer,  # test_case must have an "expected" key
)
或者自行编写:
def my_scorer(output: str, test_case: dict) -> float:
    return 1.0 if output.strip() == test_case["expected"] else 0.0

report = compare(..., scorer=my_scorer)
MCP 服务
agent-eval 附带一个 Model Context Protocol 服务,让 AI Agent (Claude、Cursor 或任何兼容 MCP 的客户端)无需人工手动调用 CLI,即可直接运行统计回归测试。
安装扩展:
pip install "agent-regress-cli[mcp]"
将其添加到 MCP 客户端的配置中(对于 Claude Desktop,配置文件为 claude_desktop_config.json):
{
  "mcpServers": {
    "agent-eval": {
      "command": "uvx",
      "args": ["--from", "agent-regress-cli", "agent-regress-mcp"]
    }
  }
}
此服务提供一个名为 run 的工具,该工具会使用给定的子命令和参数调用 agent-regress CLI,并附加 --json,然后返回解析后的 JSON 结果:
run(["compare", "--version-a-results", "a.json", "--version-b-results", "b.json", "--metric", "accuracy"])
传输方式为 stdio,因此无需托管:MCP 客户端会将服务作为本地子进程启动。源文件:src/agent_regress/mcp_server.py。
为什么不选择 DeepEval、Promptfoo 或 Braintrust?
| 功能 | Agent Evaluation | DeepEval | Braintrust | Promptfoo |
|---|---|---|---|---|
| 统计版本对比(p 值) | 是 | 否 | 否 | 否 |
| 效应量报告(Cohen's d) | 是 | 否 | 否 | 否 |
| Bootstrap 95% 置信区间 | 是 | 否 | 否 | 否 |
| 分布偏移检测 | 是 | 否 | 否 | 否 |
| Tau-bench pass^k 测试框架(k=1,4,8) | 是 | 否 | 否 | 否 |
| GAIA Level 1-3 分层测试框架 | 是 | 否 | 否 | 否 |
| SWE-bench 脚手架评分测试框架 | 是 | 否 | 否 | 否 |
| 可自托管,无需 SaaS | 是 | 部分支持 | 否 | 是 |
| 样本量警告 | 是 | 否 | 否 | 否 |
| 核心许可证 | Apache 2.0 | MIT | 专有 | MIT† |
| 是否需要云账户 | 否 | 可选 | 是 | 否 |
| 测试类型 | 分布式 | 阈值 | 阈值 | 阈值 |
†Promptfoo 于 2026 年 3 月被 OpenAI 收购;目前仍根据其现行许可证保持开源。
DeepEval 测试的是单个 Agent 的响应是否达到质量门槛。Agent Evaluation 测试的是两个 Agent 版本之间的行为是否发生了显著变化,这是一个不同的统计问题,阈值测试无法回答。核心的 scipy Mann-Whitney U 调用只有一行代码,因此任何 SaaS 评估平台都可以添加它。随着生产使用不断积累的,是特定版本的回归历史,以及由社区维护、并对结果进行独立验证的基准排行榜。
统计测试能捕捉、阈值测试会漏掉的真实回归
LangGraph
- #5243:新的类型化
context=API 取代了非类型化的config['configurable']。无论使用哪种调用方式,单次运行都仍能通过阈值检查;只有对比 A、B 两个版本,才能判断这一切换是否改变了测得的行为。 - #4486:节点/任务级结果缓存可能会悄悄掩盖重复采样的方差。阈值检查并不关心结果是否来自缓存;统计对比依赖真正独立的样本,因此
agent-eval添加了缓存规避机制,以保护这一前提。
OpenAI Agents SDK
- #2463:Agent 作为工具调用时,会悄悄丢弃父级运行的
RunConfig。嵌套调用仍会返回看似正常的响应,因此单次响应检查会通过;只有检查多次运行之间的配置传递,才能发现回归。 - #2214:图像/音频/文件工具的输出被悄悄降级为纯文本。纯文本阈值评分器无法发现附件被丢弃。
CrewAI
- #6134:一项安全修复解决了文件工具在响应中泄露绝对文件系统路径的问题。质量评分器会检查答案是否正确,却不会检查答案是否同时泄露了路径,因此泄露内容也能通过门槛。
- #6236:工具新增了可选的 Pydantic
output_schema,从非结构化的str()输出转为结构化 JSON。尽管底层的架构已发生变化,旧格式和新格式在阈值评分器看来都可能“合理”。
这些回归正是本项目的创建初衷。所有 14 个有单独文档记录的 PR 的详细信息(来自一项覆盖 LangGraph、CrewAI 和 OpenAI Agents SDK、包含 29 个 PR 和 239 行记录的验证活动),请参阅 docs/pr-analysis.md。
此工具解决的问题
你修改了提示词。或者为了降低成本,从 GPT-4o 切换到了 GPT-4o-mini。又或者某个依赖悄悄更新了。你的评测仍然通过,因为它们会根据固定阈值测试单个响应。它们无法检测整个分布中的行为是否发生了变化。
准确率下降 3 个百分点,可能只是大模型方差带来的噪声,也可能是真实回归。没有统计检验,你无法判断是哪一种。团队要么忽略小幅下降,漏掉真正的问题;要么对所有情况都升级处理,被误报淹没。
Agent Evaluation 用 p 值和效应量回答分布层面的问题:
============================================================
agent-regress Report -- tool_accuracy
============================================================
Verdict:    REGRESSED
p-value:    0.0031
Cohen's d:  -0.610
95% CI:     [-0.221, -0.067]

Version A:  0.8400 +/- 0.0601  (n=50)
Version B:  0.7000 +/- 0.0903  (n=50)
Delta:      -0.1400
============================================================
当 CI 失败时,断言错误会给出阻止部署的消息:
AssertionError: REGRESSED: tool_accuracy dropped 16.7%
(p=0.003, Cohen's d=-0.61, 95% CI [-0.22, -0.07])
Version A: 0.840 +/- 0.060  (n=50)
Version B: 0.700 +/- 0.090  (n=50)
没有变化时:
Verdict:    STABLE
p-value:    0.4100
Cohen's d:  0.021
DeepEval、Promptfoo 和 Braintrust 会测试单个响应是否达到阈值。它们都无法回答某个版本的行为分布是否相较上一个版本发生了显著变化。Agent Evaluation 专门解决这一统计问题,而阈值测试无法回答这个问题。
加入 CI:回归时让构建失败
有两种模式,任选其一。
report.assert_stable() — 内联使用,在调用 compare() 后执行:
# test_regression.py -- add to your existing test suite
from agent_regress import compare

def test_no_regression():
    report = compare(
        version_a=production_agent,
        version_b=staging_agent,
        test_suite=load_test_suite(),
        n_runs=50,
    )
    report.assert_stable(
        p_threshold=0.05,  # act on changes at p < 0.05
        min_effect=0.2,    # Cohen's d threshold -- ignore noise below 0.2
    )
RegressionGate — 可复用的门控对象,适用于使用相同阈值运行多次比较的情况:
from agent_regress import compare, RegressionGate

gate = RegressionGate(p_threshold=0.05, min_effect=0.2)

def test_tool_accuracy():
    report = compare(version_a=prod, version_b=staging, test_suite=suite, n_runs=50)
    gate.check(report)  # raises AssertionError on regression; warns if n < 30

def test_routing_accuracy():
    report = compare(version_a=prod, version_b=staging, test_suite=routing_suite, n_runs=50)
    gate.check(report)
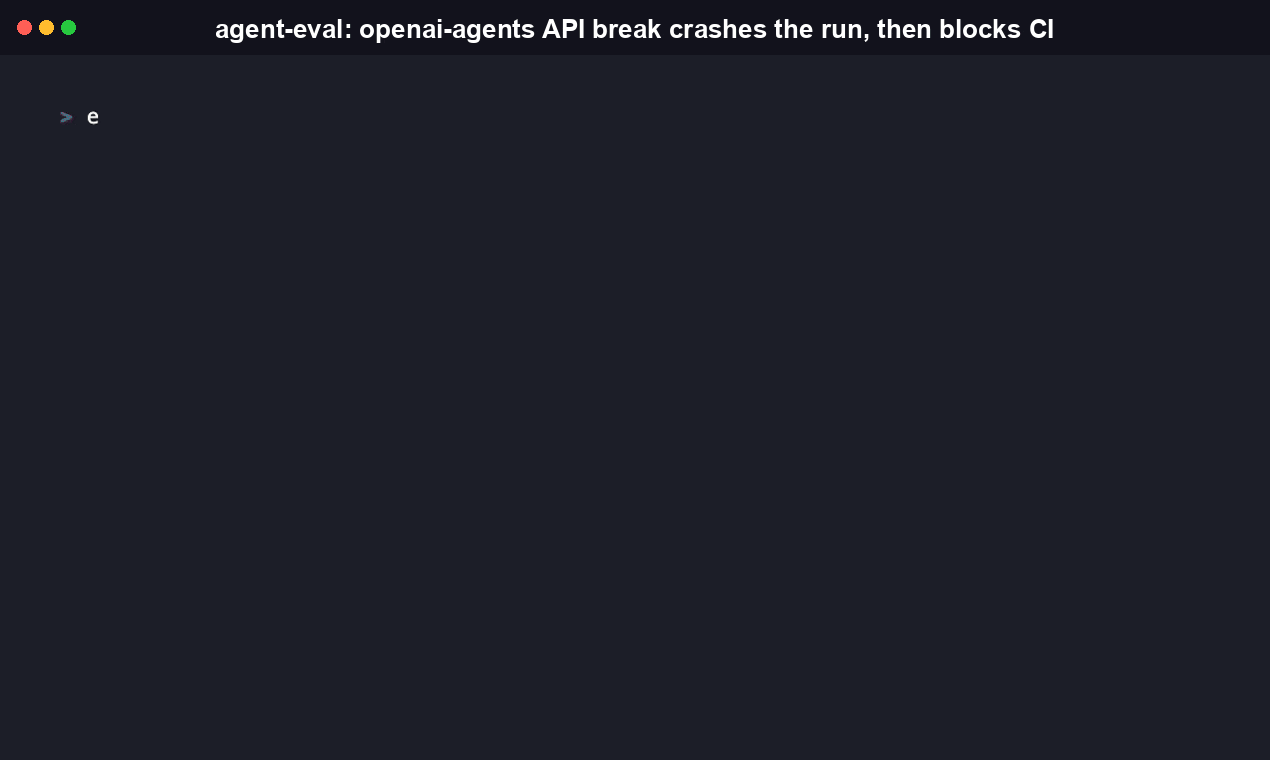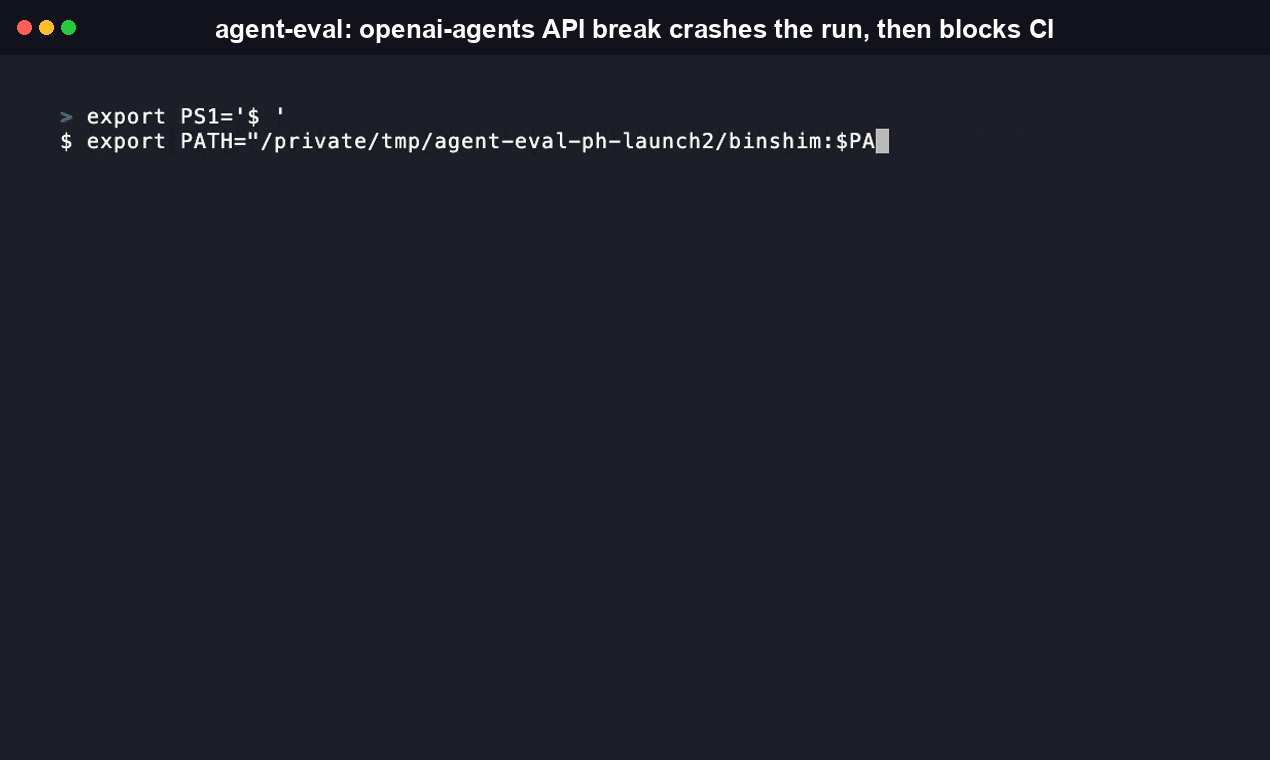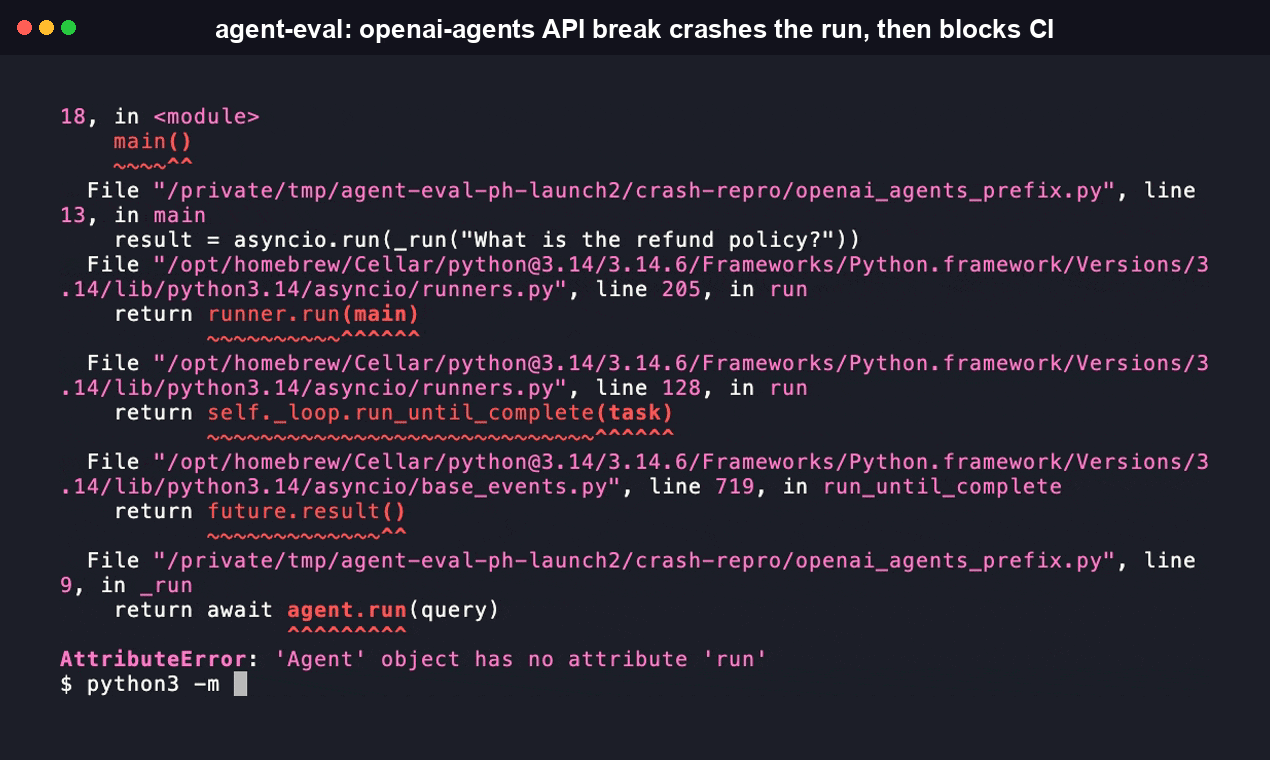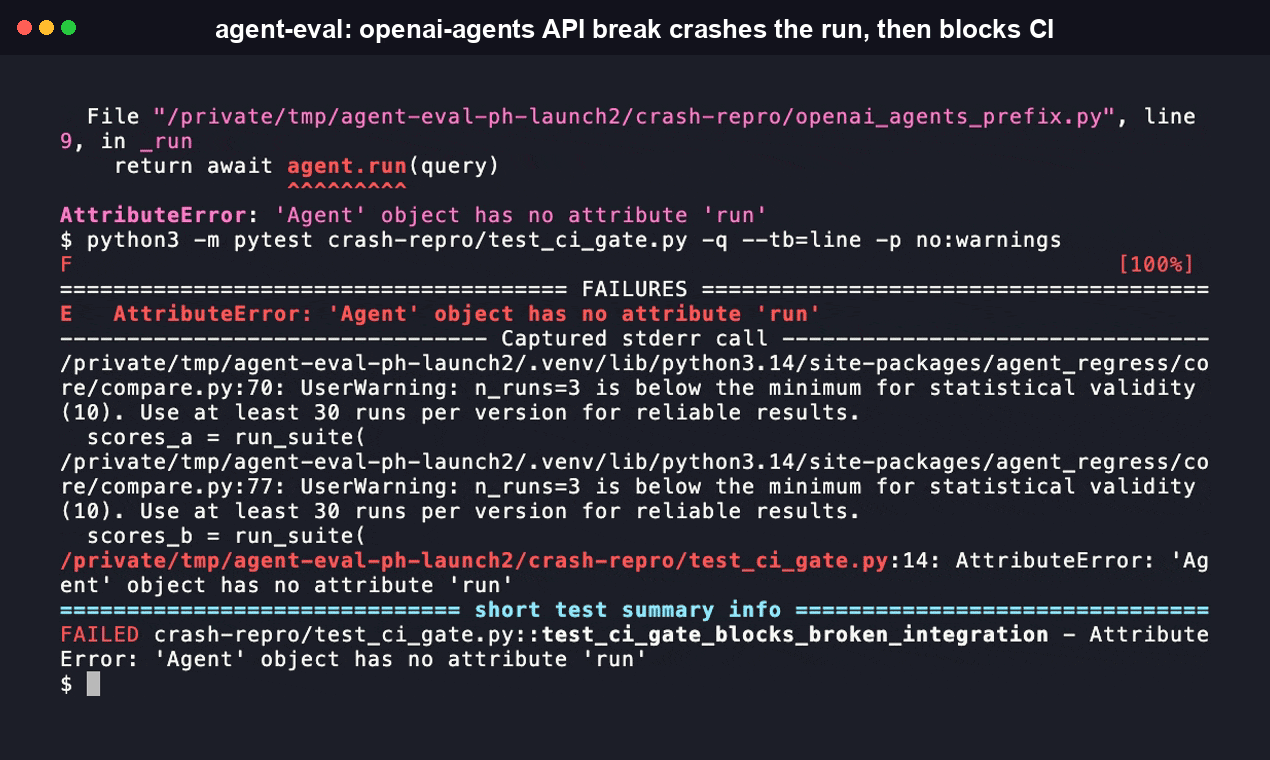
这两种模式都会在每个版本的 n < 30 时发出警告(而不是失败),并将 n < 10 视为数据不足,跳过门控。CI 门控阈值(30)有意低于 compare() 自身的一般低功效警告(n < 50,参见 常见问题)——它旨在防止过小的样本在无提示的情况下决定是否阻止构建,而不是像建议运行 50 次那样,保证达到 80% 的统计功效。
uv run pytest test_regression.py
统计方法
Agent Evaluation 会组合使用三种统计检验:
Mann-Whitney U 比较两个分数分布,无需假设它们服从正态分布。大模型分数并不服从高斯分布。U 检验不依赖特定分布,能够稳健地处理真实 Agent 输出中常见的长尾和双峰分布。
Bootstrap 置信区间(1,000 次重采样,seed=42)可给出平均分数差值的 95% CI。CI 会告诉你偏移幅度:[-0.22, -0.07] 的 CI 表示你有 95% 的把握认为,每次运行的真实准确率下降幅度介于 7 到 22 个百分点之间。
Cohen's d(合并标准差)可区分统计显著性与实际显著性。p=0.001 且 d=0.04 的变化是真实的,但没有实际意义。p=0.06 且 d=0.5 的变化在实际层面影响较大,但需要更多数据才能确认。默认 CI 门控仅在 p < 0.05 且 d >= 0.2 时触发。
完整方法请参阅 docs/statistical-methods.md。
基准测试
统计检验的开销是指运行比较本身所需的时间,不包括 Agent 调用。瓶颈在 Agent 调用,而非统计计算。
在 Apple M3 Pro、Python 3.14、scipy 1.15、numpy 2.2 上测得:
| 操作 | 每个版本 n=50 | 每个版本 n=1,000 |
|---|---|---|
| Mann-Whitney U | 0.34ms | 0.47ms |
| Bootstrap CI(1,000 次重采样) | 26ms | 31ms |
| 完整 compare() 统计开销 | ~27ms | ~32ms |
请参阅 docs/benchmarks.md 了解如何复现。
集成矩阵
| 框架 | 状态 | 安装 |
|---|---|---|
| LangGraph | 已发布(v0.1) | pip install agent-regress-cli[langgraph] |
| OpenAI Agents SDK | 已发布(v0.1) | pip install agent-regress-cli[openai-agents] |
| CrewAI | 已发布(v0.1) | pip install agent-regress-cli[crewai] |
| LangChain LCEL | 已发布(v0.1) | pip install agent-regress-cli[langchain] |
| AutoGen | 计划中(v0.3) | |
| Vercel AI SDK (TypeScript) | 计划中(v0.4) |
要比较同一框架的两个已安装版本(而非两个进程内配置)?请参阅
docs/cross-version-comparison.md 了解
subprocess_runner() 模式。
警告
[crewai]扩展:CrewAI 自带的记忆/知识/RAG 后端可能会引入 ChromaDB。目前 ChromaDB 存在一个尚未修复的严重 CVE(GHSA-f4j7-r4q5-qw2c),影响所有启用了trust_remote_code=True且暴露在网络中的 ChromaDB 服务。agent-eval本身不会启动、配置或暴露 ChromaDB 服务,因此仅当你自己的Crew执行这些操作时才会有影响;在修复发布之前,不要运行启用了trust_remote_code=True且暴露在网络中的 ChromaDB 实例。
标准基准测试
Agent Evaluation 提供三个标准 Agent 基准测试的测试框架:
Tau-bench pass^k 用于衡量 k 次独立尝试的可靠性。单次运行的基准测试无法发现性能下降:一个在 k=1 时成功率为 60% 的 Agent,在 k=8 时成功率会达到 99.93%。k=1 与 k=8 的曲线才是关键指标。
from agent_regress.benchmarks.tau_bench import TauBenchHarness

harness = TauBenchHarness(agent=my_agent, dataset=tau_bench_dataset)
results = harness.evaluate(k_values=[1, 4, 8])
GAIA Level 1-3 分层按任务难度分层。总体准确率会掩盖不同难度下的性能回退:一项有助于 Level 1 的提示词更改,往往会损害 Level 3 的表现。
from agent_regress.benchmarks.gaia import GAIAHarness

harness = GAIAHarness(agent=my_agent, dataset=gaia_dataset)
results = harness.evaluate()  # returns list[GAIALevelResult], one per level
for r in results:
    print(f"Level {r.level}: {r.accuracy:.3f}  ({r.n_correct}/{r.n_questions})")
SWE-bench 脚手架评分将框架的贡献与模型的贡献区分开来。
from agent_regress.benchmarks.swebench import SWEBenchHarness

harness = SWEBenchHarness(agent=my_agent, dataset=swe_dataset)
result = harness.evaluate()
print(f"scaffold pass rate: {result.scaffold_pass_rate:.3f}  ({result.n_resolved}/{result.n_instances})")
请参阅 leaderboard/README.md 提交结果。
在 Docker 中试用
git clone https://github.com/RudrenduPaul/agent-eval
cd agent-eval
docker compose up
启动两个服务:
- web(
http://localhost:8080)——由web/serve.py提供的排行榜 UI,读取leaderboard/results/*.json - example——运行
examples/01-basic-comparison/example.py,并将对比报告打印到标准输出
适合用于验证安装是否成功,并在将 agent-regress 接入自己的 Agent 之前查看排行榜 UI。
安全
- **供应链:**从 GitHub Actions 工作流构建并发布版本,使用 Sigstore 签名,并在每个 GitHub Release 中附带 CycloneDX SBOM。(目前尚未生成 SLSA 来源证明;这需要采用
slsa-framework/slsa-github-generator。) - **漏洞扫描:**每次 CI 运行时均使用 Trivy 扫描(仅检查 HIGH/CRITICAL,发现未修复漏洞时退出)。每次推送时执行 CodeQL 静态分析。
- **依赖锁定:**Dependabot 会让所有 GitHub Actions 和 Python 依赖保持最新。
- 漏洞披露:SECURITY.md——通过 GitHub Security Advisories 私下报告漏洞。
排行榜
leaderboard/ 目录通过版本控制跟踪不同模型和框架的 Tau-bench pass^k、GAIA 和 SWE-bench 结果。提交时,请创建包含符合 leaderboard/schema.json 格式的 JSON 文件的 PR。合并前会独立复现结果。
常见问题
agent-eval 是什么?它与普通的 LLM 评估框架有什么不同?
Agent Evaluation 是一个统计库,用于检测两个版本之间 Agent 的行为是否确实发生了变化。对版本 A 运行同一套测试 50 次,再对版本 B 运行 50 次,它会报告 p 值(Mann-Whitney U)、效应量(Cohen's d),以及分数差值的 bootstrap 95% 置信区间。大多数评估框架会检查单个响应是否达到固定的质量阈值。Agent Evaluation 则回答一个关于分布的问题:分数分布是否显著变化,还是变化只是 LLM 每次运行之间的噪声。
如何安装?它支持哪些平台?
pip install agent-regress-cli 或 uv add agent-regress-cli。它要求 Python 3.10 至 3.13(根据 pyproject.toml 中的分类器),且不包含特定于操作系统的代码,因此只要能运行这些 Python 版本,就可以在相应平台上运行。还提供 Node/npx 封装(npx agent-regress-cli,也以 agent-regress-cli 的名称发布在 npm 上)——它会调用同一个 Python 包,因此仍需提供 Python 工具链(或 uv/pipx,它们可以临时运行该工具,无需手动执行 pip install);如果两者都找不到,它会给出可采取行动的错误提示。
它与 DeepEval、Promptfoo 或 Braintrust 相比如何?
完整对比请见上文的对比表。简而言之:DeepEval、Promptfoo 和 Braintrust 都会测试单个响应是否达到固定的质量标准。这三者都不会报告 p 值、效应量或 bootstrap 置信区间,来判断两个版本之间的行为是否发生变化;而这正是 agent-eval 专门用于回答的统计问题。
我运行了对比,收到统计功效不足的警告,或者得到 INSUFFICIENT_DATA 判定。这是什么意思?
任一版本的运行次数少于 50 次时,库会发出警告(但不会失败),因为要以 80% 的统计功效可靠地检测中等效应(Cohen's d 为 0.2),需要这个样本量。每个版本少于 10 次运行时,它会返回 INSUFFICIENT_DATA,而不是 REGRESSED/STABLE/IMPROVED 判定,因为样本过小,无法信任任何统计结论。请使用 n_runs=50 或更高的值重新运行,以获得可据此采取行动的判定。
agent-eval 会调用我的 LLM,或代我管理 API 密钥吗?
不会。compare() 接收你提供的两个可调用对象 version_a 和 version_b,并使用你的测试套件运行现有 Agent 代码。Agent Evaluation 本身绝不会调用模型,而且 stats 模块(src/agent_regress/stats/)必须保持为纯 Python 和 scipy,不得调用 LLM,因此统计核心没有网络依赖,也无需配置凭据。
目前它集成了哪些 Agent 框架?
v0.1 已提供 LangGraph、OpenAI Agents SDK、CrewAI 和 LangChain LCEL 集成(见上文的集成矩阵),每种集成都可通过额外依赖安装,例如 pip install agent-regress-cli[langgraph]。AutoGen 和 Vercel AI SDK(TypeScript)集成已列入计划,但尚未发布。
我可以将 agent-eval 用于商业用途吗?它采用什么许可证?
可以。它采用 Apache License 2.0 许可,允许商业使用、修改和分发,并明确授予专利许可。你需要保留版权和许可证声明,并注明所做的任何更改;本软件不提供任何保证。完整文本请见 LICENSE。
参与贡献
- 提交 PR 前,请阅读 CONTRIBUTING.md
- GitHub 上已为适合初次参与的议题添加标签
- Stats 模块(
src/agent_regress/stats/)必须保持为纯 Python + scipy——绝不调用 LLM - 所有 PR 都要求 stats/ 覆盖率达到 95%,整体覆盖率达到 80%
设计问题请前往 GitHub Discussions 讨论。
Apache 2.0。欢迎贡献。
引用此作品
如果您在研究中使用 Agent Evaluation,请引用:
@software{paul2026agenteval,
  author = {Paul, Rudrendu and Nandy, Sourav},
  title = {Agent Evaluation: Statistical Regression Testing for LLM Agents},
  year = {2026},
  url = {https://github.com/RudrenduPaul/agent-eval},
  license = {Apache-2.0}
}
由 Rudrendu Paul 和 Sourav Nandy 构建
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。