
关于 memtrust
memtrust 是用于比较 Agent 记忆后端的独立基准测试工具,面向评估这些系统的开发者和研究者。它以统一评测运行多个后端,并输出原始日志与 JSON 报告;也提供 MCP 服务供 Agent 发起测试。
主要功能
- 01对多个记忆后端运行统一评测
- 02覆盖矛盾检测与压缩保真度
- 03生成 JSON 报告并汇总结果
- 04为报告生成并验证签名回执
- 05通过 MCP 工具启动基准测试
适用场景
- 01比较不同记忆后端的评测结果
- 02检查新旧事实冲突处理能力
- 03评估内容压缩后的还原保真度
- 04让 Agent 发起基准测试并读取报告
MCP 相关
附带的 MCP 服务通过单个 run 工具调用 memtrust run,并返回解析后的 JSON 报告。服务使用 stdio,由 MCP 客户端作为本地子进程启动。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
memtrust




各 Agent 记忆后端都会发布自己的基准测试数据,但测试各不相同,测量方式也各异。memtrust 使用相同的评估测试四种后端,并公开原始日志。让供应商接受测试,而不是由供应商自行测试。
pip install memtrust-cli
memtrust run --backends mempalace,mem0,zep,openviking --eval all
(如果你想为此仓库做贡献,而不只是运行它,请参阅开发——从克隆的仓库运行 pip install -e ".[dev]"。)
目录: 为何创建此项目 · 项目功能 · 命令 · 与相信供应商自己的数据有何不同 · 矛盾检测 · 压缩保真度 · 时间知识图谱边界 · 行业概况 · 基准测试 · GitHub Actions 用法 · 自托管 · 安装 · 托管层 · 后端覆盖范围 · 开发 · 常见问题 · 许可证 · 成功案例
为什么有这个项目
如果你最近比较过 Agent 记忆后端,可能已经注意到,每种后端都以不同的准确率数据为卖点,而这些数据来自不同的基准测试,测量方式也各不相同。MemPalace 社区已经公开指出了这个问题。MemPalace 仓库中的 Issue #27 于 2026 年 4 月 7 日提出,截至目前仍未解决。该 Issue 记录称,一项使用 Haiku 重新排序测得的 LongMemEval 100% 标题数据,无法通过仓库自带的基准测试脚本复现,因此因无法验证而从 README 中移除。人们到处引用的另一项 96.6% 数据,实际上主要归功于 ChromaDB 在原始模式下的默认嵌入,而非 MemPalace 自身的架构。实践中,“无损”压缩(“AAAK”模式)会使 LongMemEval 得分从 96.6% 降至 84.2%,相差 12.4 个百分点。两个试图修正报告问题的内部拉取请求 #433 和 #729 均于 2026 年 4 月 12 日关闭,未获合并——#729 从提交到关闭仅用了 7 分钟。截至本文撰写时,该 Issue 收到 232 个点赞反应和 39 条评论。
这并不意味着 MemPalace 或任何其他后端无法正常工作。这意味着此前没有任何供应商以外的人用相同方式运行相同测试,对所有选项进行比较并公布原始日志。
memtrust 会做这件事。它会运行 LongMemEval、LoCoMo,以及一组不断扩充、专为本项目构建的评测——截至本文撰写时共有 17 项,均已注册在 CLI 的 --eval 标志中。其中两项对于理解本项目的实际用途最为重要:
矛盾检测,因为 LongMemEval 和 LoCoMo 都没有测试记忆系统接入生产 Agent 后真正重要的问题——当新事实与旧事实矛盾时会发生什么?后端会标记冲突吗?会悄无声息地覆盖旧事实,不留下任何审计记录吗?还是会返回碰巧先检索到的版本?本项目跟踪的四种后端都没有公布这方面的数据。另一项是压缩/往返保真度评测,旨在直接检验上述“无损”之类的声明:它会存储内容、检索内容,并按照后端提供的各个运行模式(参见 MemoryBackendAdapter.supported_modes)评估字面重建保真度,而非语义准确度——这一机制可以让拥有有效 MemPalace 凭据的贡献者实际复现 mempalace/mempalace#27 记录的压缩模式准确率下降 12.4 个百分点,而不只是引用该数据。截至本文撰写时,这两项评测都尚未在运行中的 MemPalace 实例上执行——不过,两项都已在运行中的自托管 mem0ai 安装上执行;详见下文“基准测试”。其他评测——排序质量、崩溃恢复、抽取质量、嵌入漂移、规模/容量压力、锁竞争、统计准确度、孤立项清理、结果一致性、迁移回滚、过滤器注入、资源同步安全,以及时间知识图谱边界检测——都源于针对这四种受跟踪后端的具体真实缺陷报告;完整列表见下文“成功案例”。
**当前进展一览:**一个后端(mem0_direct,自托管 mem0ai)的实时基准测试结果,其中包括本项目尝试获取这些数据时,在 mem0 默认配置中发现的一个真实缺陷;以及针对 MemPalace、Mem0、Zep/Graphiti 和 OpenViking 提交的 197 个真实 GitHub Issue 和拉取请求,均由本项目独立进行根因分析——55 项(28%)通过,16 项(8%)部分通过,42 项(21%)属于真正的能力缺口,84 项(43%)不适用;每项判定都由不同于修复实现者的独立审查者重新验证。
它的作用
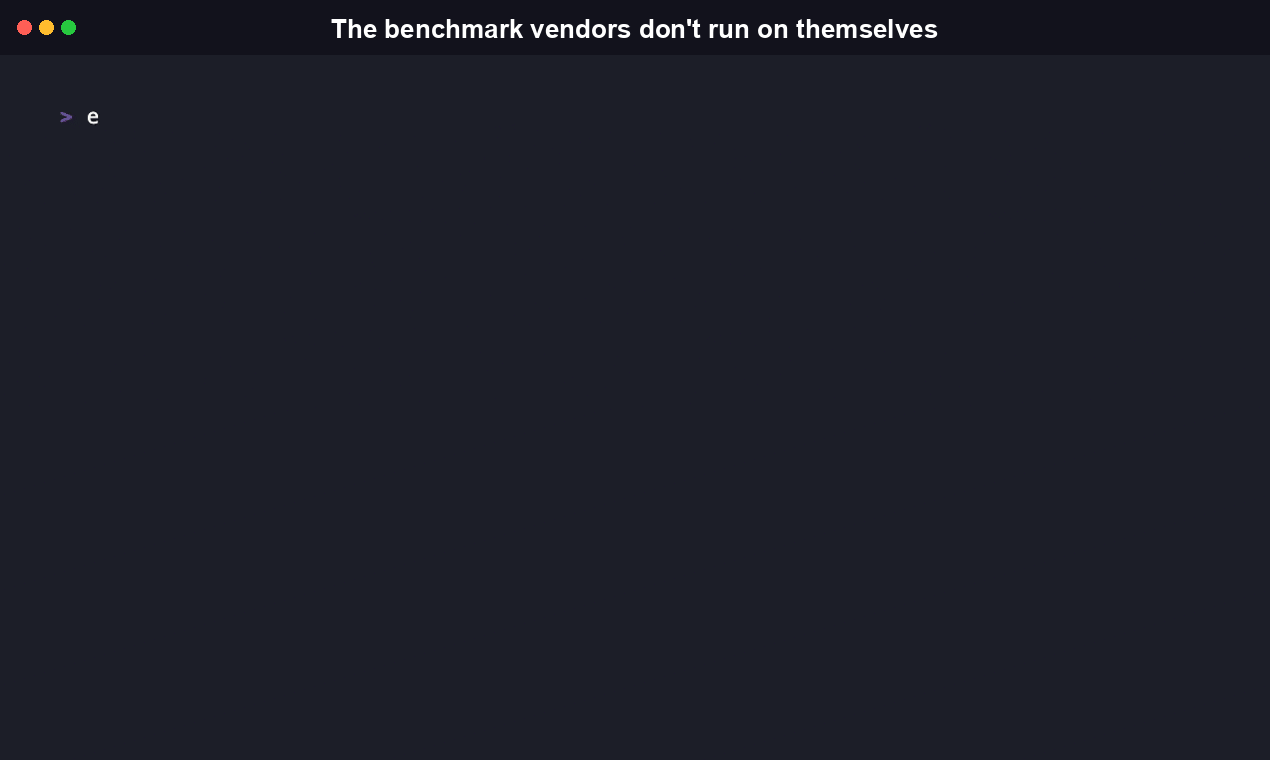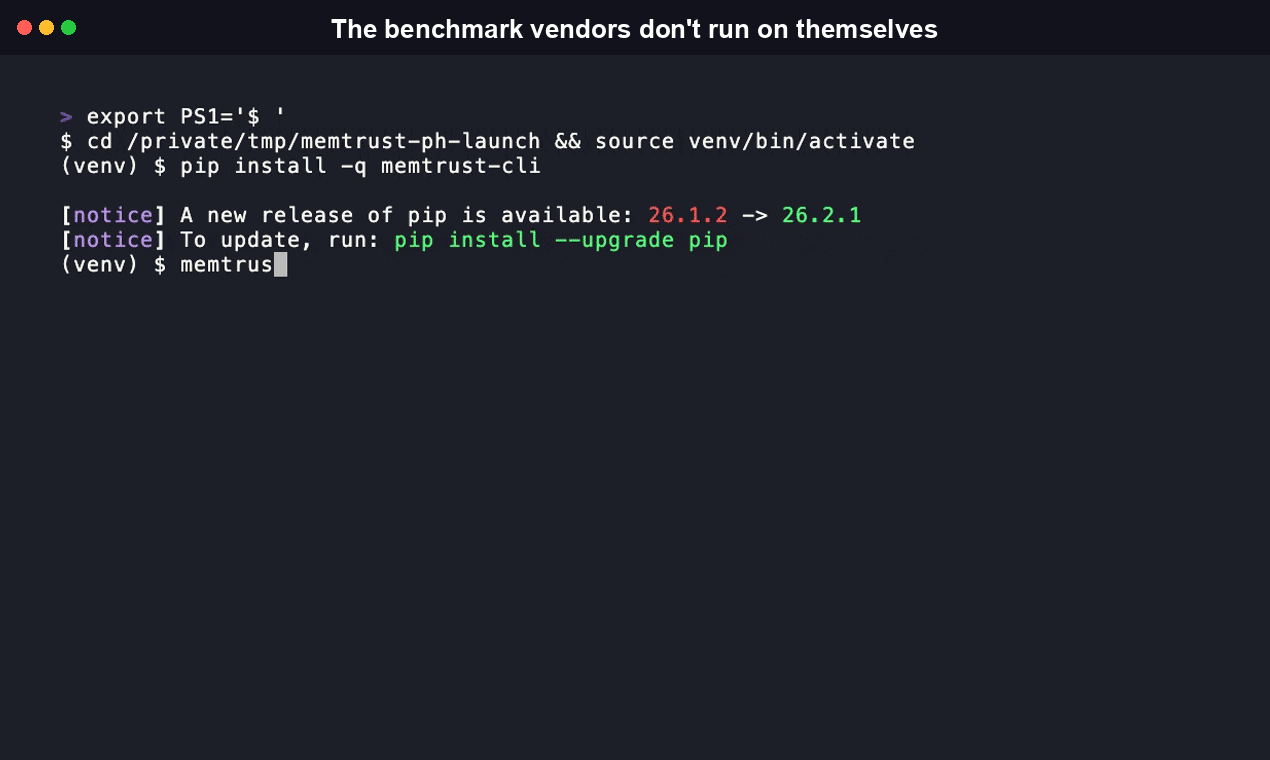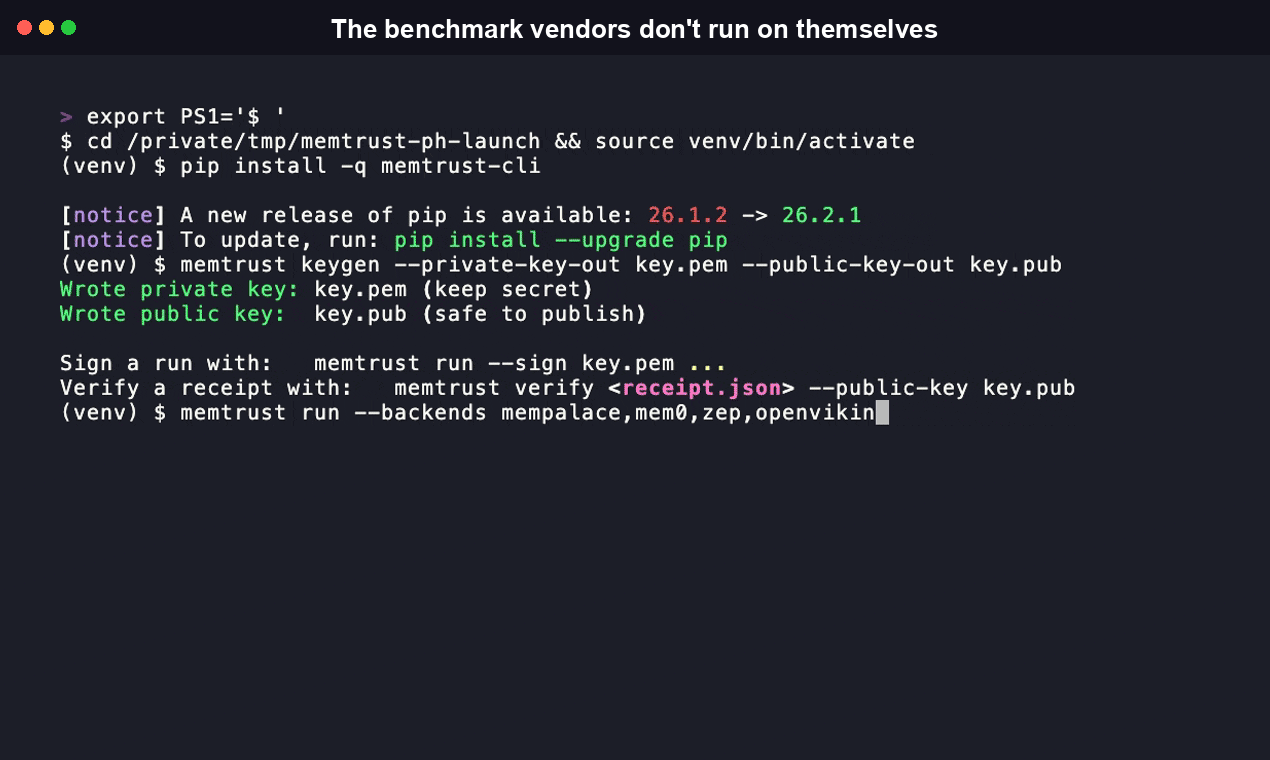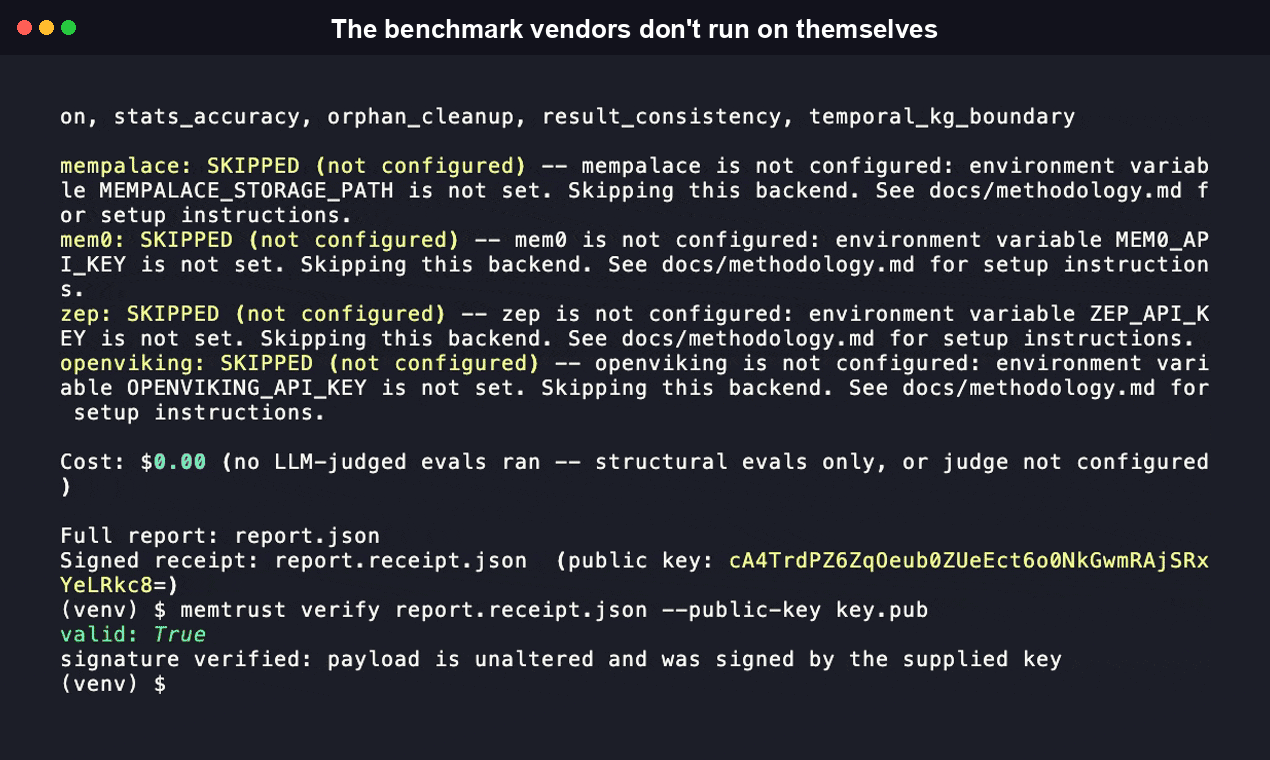
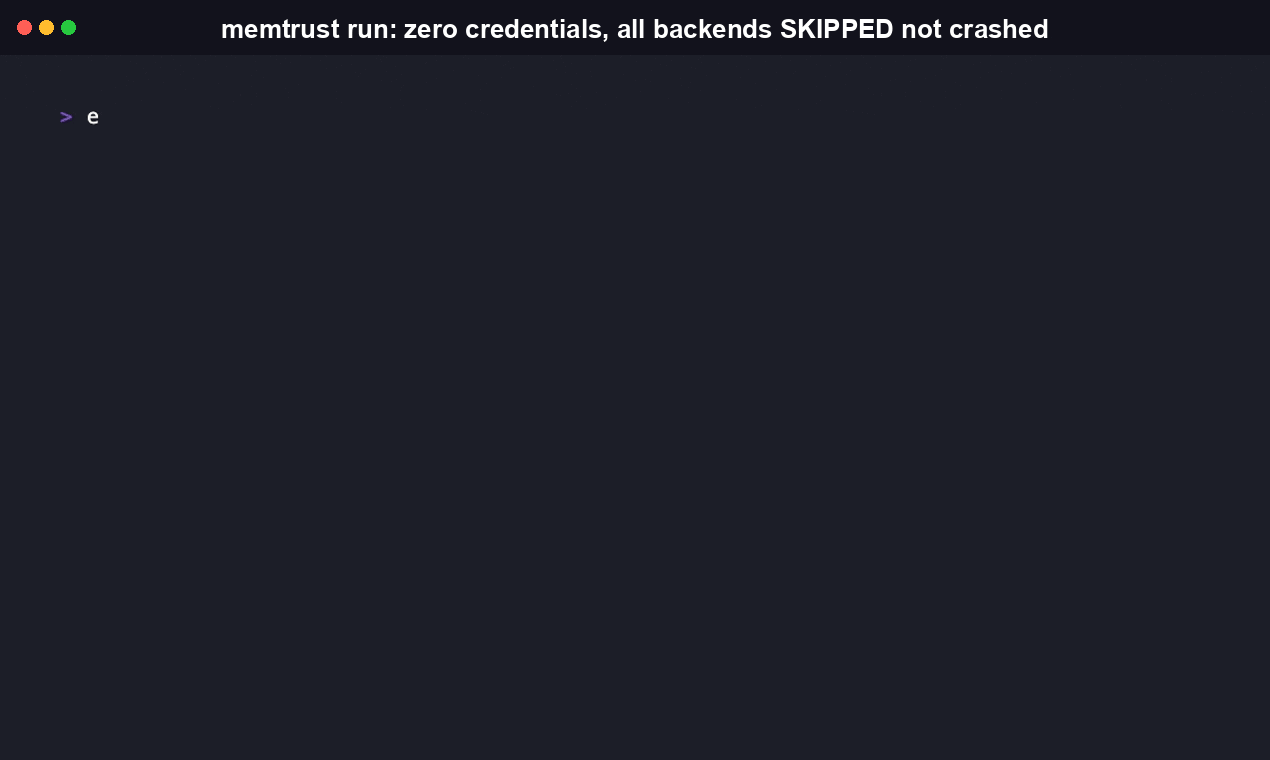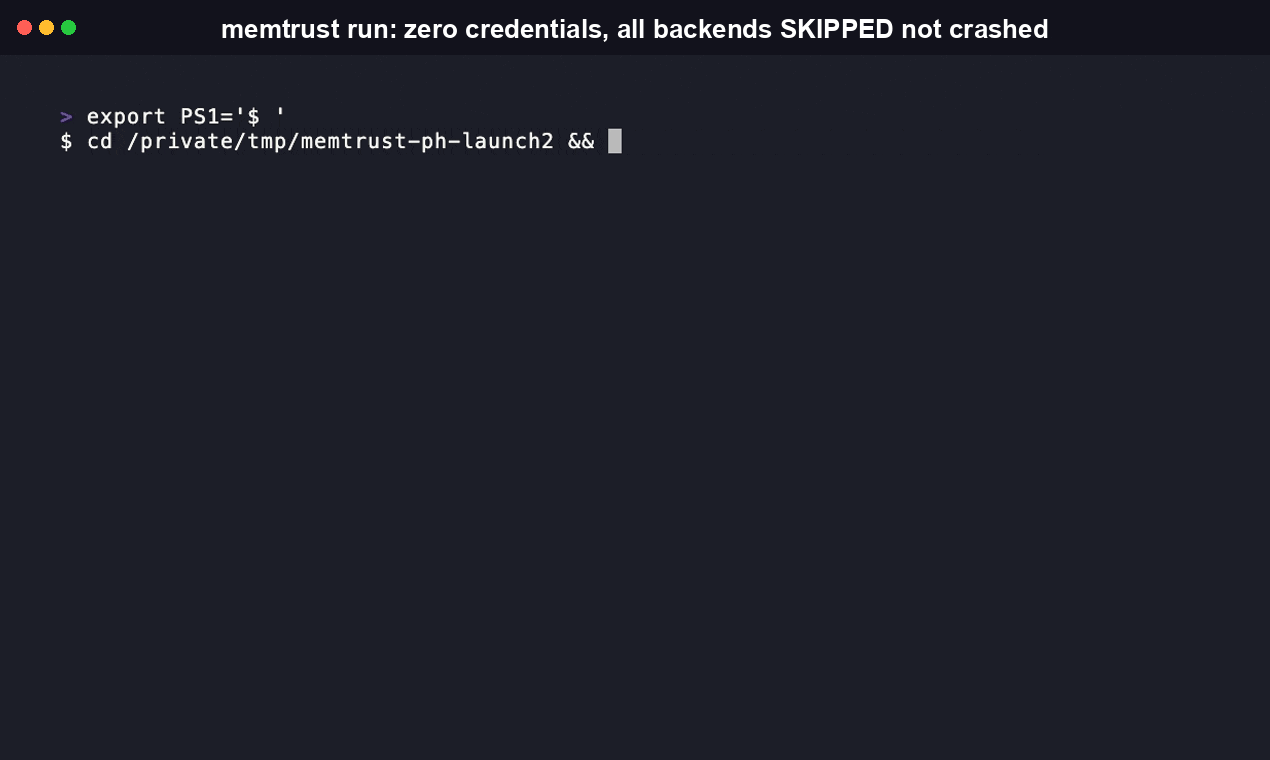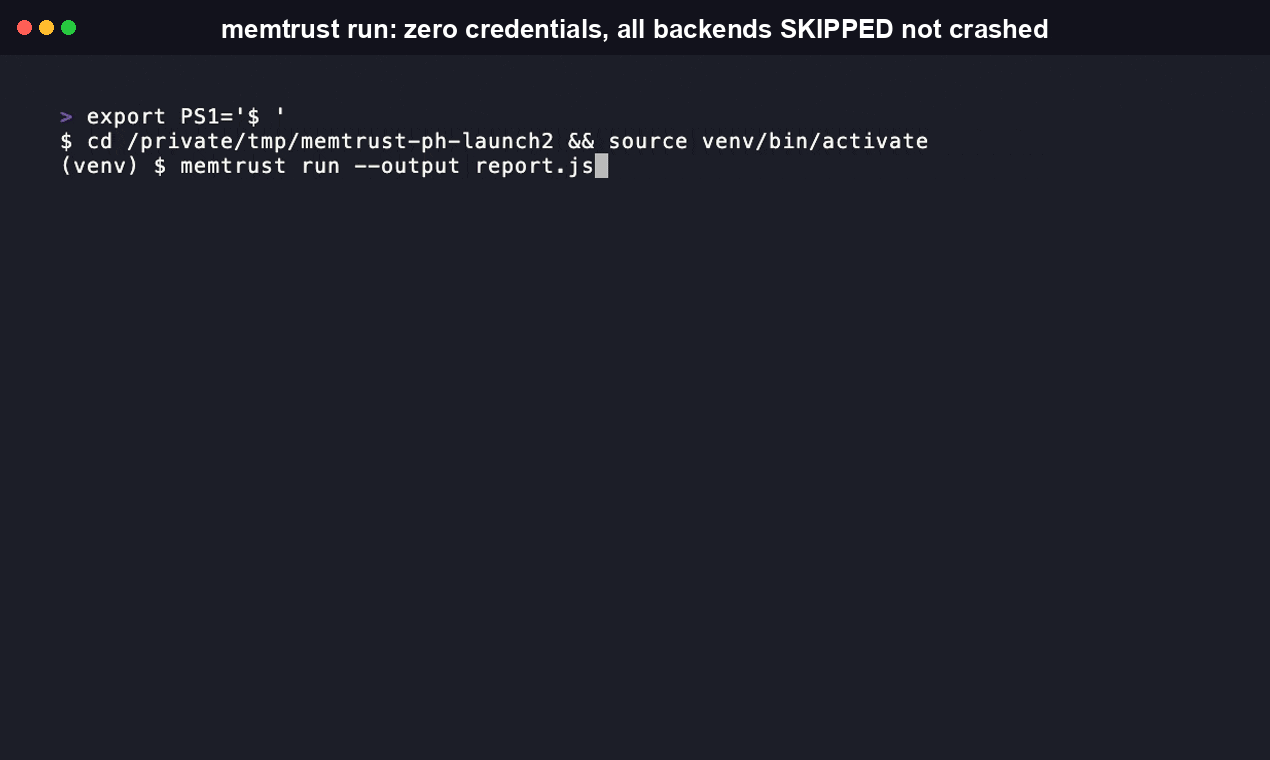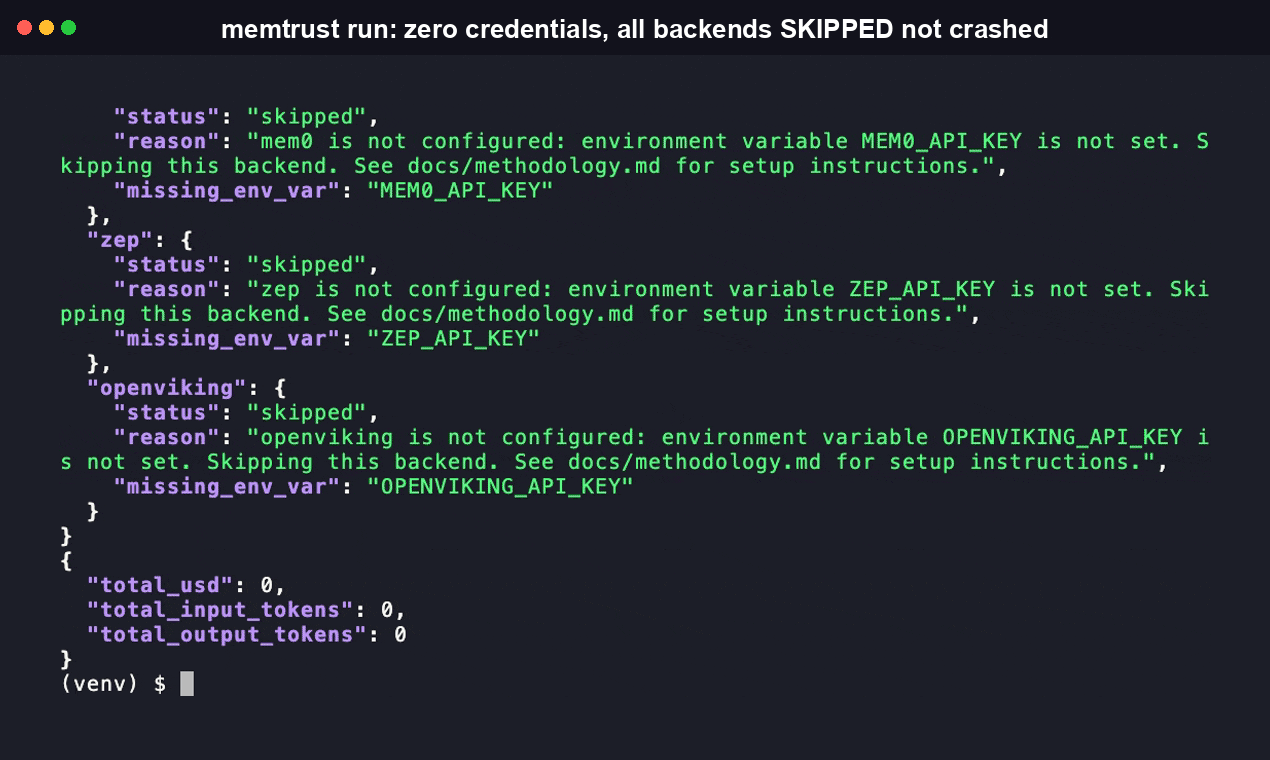
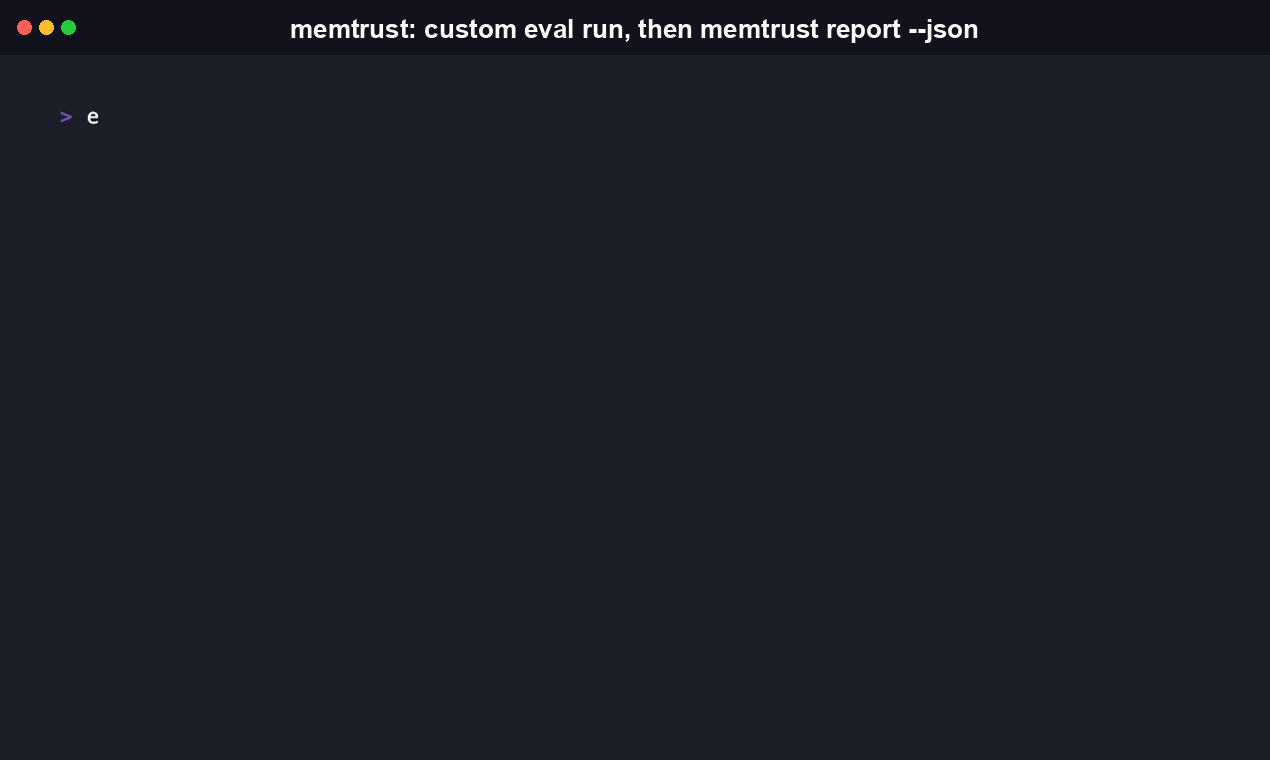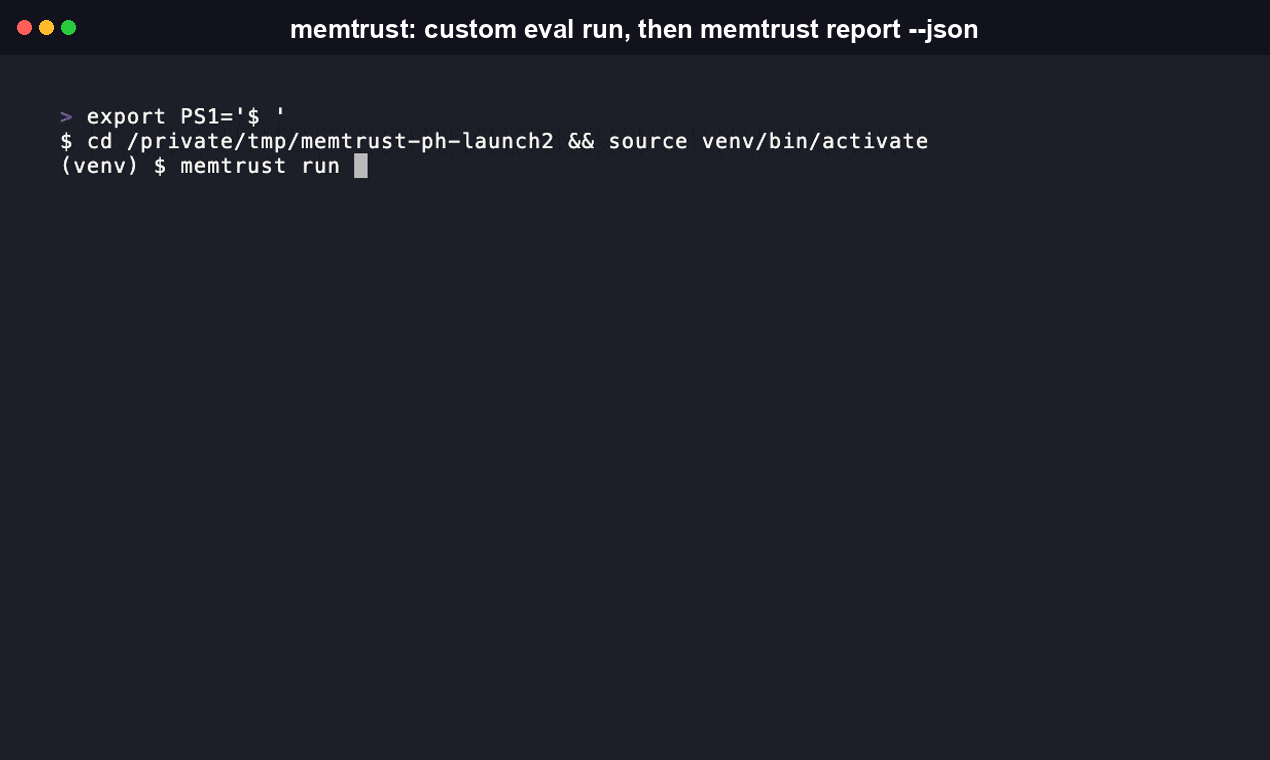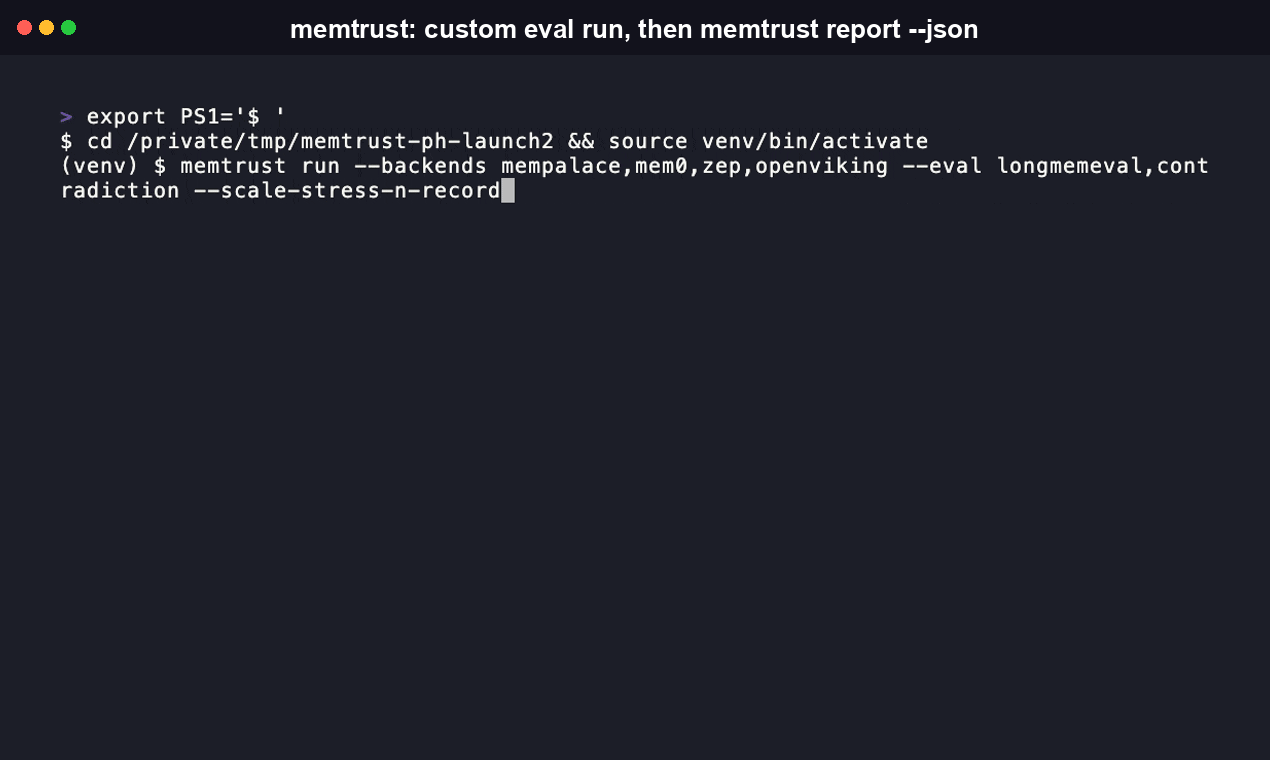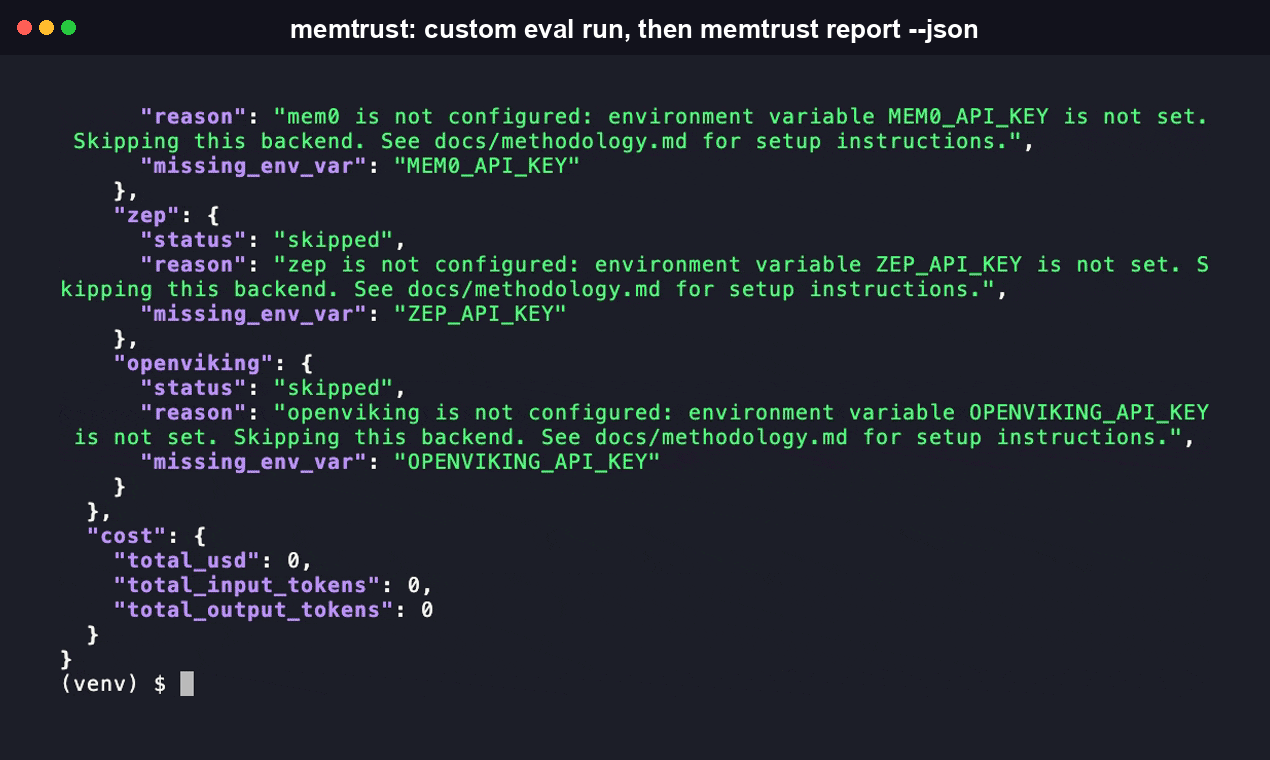
下面的每条命令都已在此仓库中实际运行,且未配置任何供应商 API 密钥,展示了相应输出。这里没有任何模拟内容。
$ memtrust run --backends mempalace,mem0,zep,openviking --eval all
memtrust 0.3.4 -- run_id=mt_2026-08-04T061759Z
Backends: mempalace, mem0, zep, openviking   Evals: longmemeval, locomo, contradiction,
resource_sync_safety, compression, ranking_quality, scale_stress, embedding_drift, crash_recovery,
extraction_quality, migration_rollback, filter_injection, lock_contention, stats_accuracy,
orphan_cleanup, result_consistency, temporal_kg_boundary

mempalace: SKIPPED (not configured) -- mempalace is not configured: environment variable
MEMPALACE_STORAGE_PATH is not set. Skipping this backend. See docs/methodology.md for setup
instructions.
mem0: SKIPPED (not configured) -- mem0 is not configured: environment variable MEM0_API_KEY is not
set. Skipping this backend. See docs/methodology.md for setup instructions.
zep: SKIPPED (not configured) -- zep is not configured: environment variable ZEP_API_KEY is not set.
Skipping this backend. See docs/methodology.md for setup instructions.
openviking: SKIPPED (not configured) -- openviking is not configured: environment variable
OPENVIKING_API_KEY is not set. Skipping this backend. See docs/methodology.md for setup
instructions.

Cost: $0.00 (no LLM-judged evals ran -- structural evals only, or judge not configured)

Full report: memtrust-report-2026-08-03.json
这就是全新克隆且没有凭据时真实、可复现的行为:所有后端都报告为 SKIPPED,命令正常退出,并且仍会生成有效的 JSON 报告。现在,memtrust --version 会正确显示已安装的版本,与 pip show memtrust-cli 的结果一致。早期版本即使已正确安装,也会显示 0.0.0+unknown,因为 src/memtrust/__init__.py 读取的是 importlib.metadata.version("memtrust"),而实际安装的发行包名为 memtrust-cli。这个问题仍保留在下方的常见问题解答中,作为记录,而没有删除;毕竟,一旦修复就悄无声息地抹去一个 Bug,恰恰是本项目致力于在他人的基准测试中抵制的做法。为你想实际测试的任何后端设置相应的环境变量(MEM0_API_KEY、ZEP_API_KEY、OPENVIKING_API_KEY、MEMPALACE_STORAGE_PATH),该后端就会使用其实时 API 真正运行,而不是被跳过。
测试套件通过对捆绑的合成测试数据进行离线验证,并对若干适配器使用真实安装的供应商包、仅模拟网络边界,从而证明了评估逻辑本身:
$ pytest --cov=memtrust --cov-report=term-missing
... (33 module rows total; the 11 most relevant to this README are shown below)
Name                                                          Stmts   Miss  Cover
-------------------------------------------------------------------------------------
src/memtrust/adapters/base.py                                   290      1    99%
src/memtrust/adapters/mempalace_adapter.py                      265     15    94%
src/memtrust/adapters/mem0_adapter.py                            140     12    91%
src/memtrust/adapters/mem0_direct_adapter.py                     281     34    88%
src/memtrust/adapters/openviking_adapter.py                      178     18    90%
src/memtrust/adapters/zep_graphiti_adapter.py                     63      3    95%
src/memtrust/adapters/zep_graphiti_selfhosted_adapter.py         165     24    85%
src/memtrust/evals/contradiction.py                              127      2    98%
src/memtrust/evals/compression.py                                 86      1    99%
src/memtrust/evals/temporal_kg_boundary.py                        90      3    97%
src/memtrust/receipt.py                                          118     10    92%
-------------------------------------------------------------------------------------
TOTAL                                                            4167    265    94%

590 passed, 8 skipped in 5.92s
这只是摘录,并非完整表格——仓库中覆盖率最低的模块 evals/mempalace_metadata_scale.py(70%)不在上面展示的 11 个模块之列;请自行运行命令,查看完整的逐模块明细。
590 项测试通过,覆盖 33 个源代码模块,整体语句覆盖率为 94%,矛盾检测评估覆盖率为 98%,压缩/往返保真度覆盖率为 99%,时序知识图谱边界评估覆盖率为 97%,适配器层覆盖率为 85%–99%。8 项跳过的测试是针对实时 mempalace 包的测试,只有安装可选的 mempalace-direct 扩展后才会运行(pip install -e '.[dev,mempalace-direct]')。每项测试都会模拟 HTTP 或线协议层,或使用内存中的伪后端——没有一项会访问真实网络。不过,现在相当一部分适配器测试会直接导入并测试实际安装的供应商类(mem0ai==2.0.12 的嵌入器和向量存储模块,以及通过可选的 mempalace-direct 扩展启用的真实 mempalace.mcp_server 函数);这些测试只模拟最外层的网络或线协议客户端边界,而非整个库。当前环境未安装 graphiti-core,因此其可自托管适配器的测试仍使用手写的 Protocol 替身,该替身依据已确认的真实包方法签名构建,而非使用真实类。具体哪些结论基于哪种验证方式,请参阅 docs/methodology.md 中的适配器置信度表。
命令
$ memtrust --help
Usage: memtrust [OPTIONS] COMMAND [ARGS]...

  memtrust: an independent, reproducible benchmark harness for agent-memory
  backends.

Options:
  --version  Show the version and exit.
  --help     Show this message and exit.

Commands:
  keygen  Generate a new Ed25519 keypair for signing `memtrust run`...
  report  Read a prior `memtrust run` JSON report and print a formatted...
  run     Run the eval suite against the requested backends.
  verify  Verify a signed receipt produced by `memtrust run --sign`.
| 命令 | 标志 | 功能 |
|---|---|---|
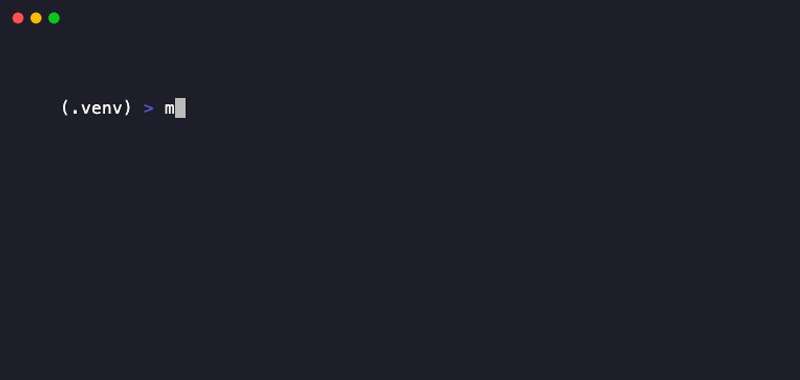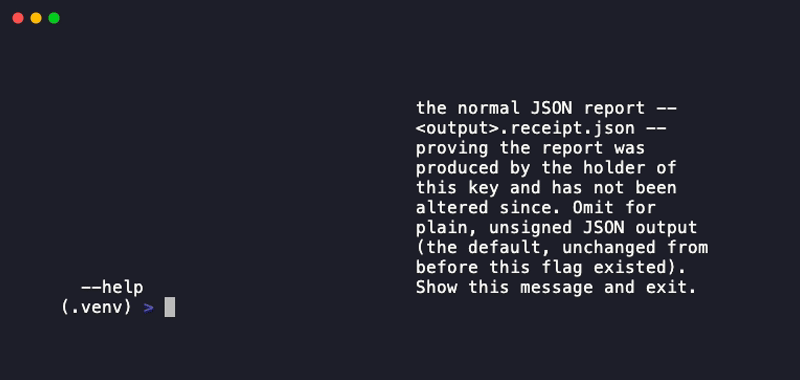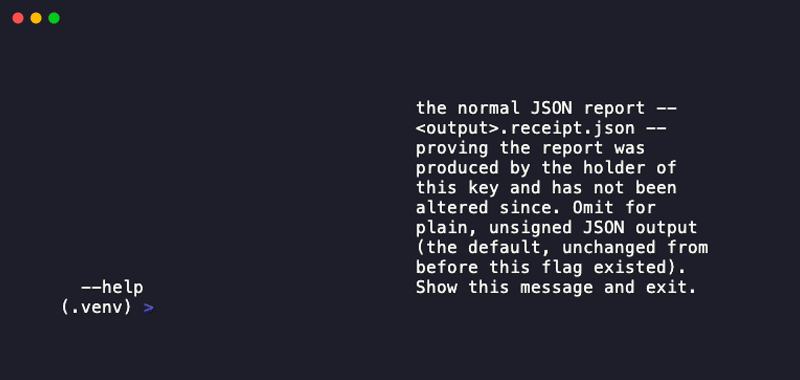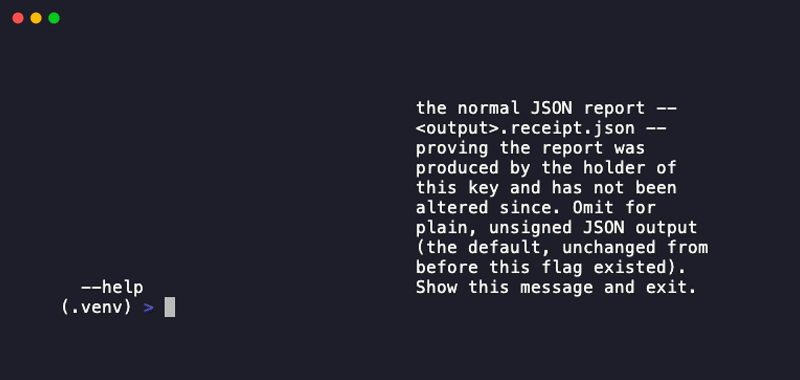
memtrust run | --backends TEXT 逗号分隔的列表或 all(默认值为 all) · --eval TEXT 从 longmemeval,locomo,contradiction,resource_sync_safety,compression,ranking_quality,scale_stress,embedding_drift,crash_recovery,extraction_quality,migration_rollback,filter_injection,lock_contention,stats_accuracy,orphan_cleanup,result_consistency,temporal_kg_boundary 中选择并以逗号分隔,或使用 all(默认值为 all) · --output FILE(默认写入 ./memtrust-report-<date>.json) · --locomo-dataset-path FILE 指定真实下载的 locomo10.json,供 LoCoMo 评测使用,而非使用随附的合成样例(memtrust 不会随附或自动获取真实数据集) · --locomo-exclude-question-ids-file FILE 从评分中排除已知真实答案有误的 LoCoMo 问题 ID · --scale-stress-n-records INTEGER(默认值为 500)设置规模压力评测存储并重新查询的合成记录数量 · --sign FILE 在报告旁写入已签名的 <output>.receipt.json,证明该报告由给定 Ed25519 私钥的持有者生成 | 针对指定的后端运行评测套件。未设置凭据环境变量的后端会打印 SKIPPED,运行将继续——此命令不会因缺少凭据而崩溃。temporal_kg_boundary 仅适用于 mempalace 后端(唯一接入 kg_add/kg_invalidate/kg_query 的适配器);对其他后端请求此项时会报告 not_applicable,而非报错。 |
memtrust report REPORT_PATH | 先前 JSON 报告的路径参数 · --json 以 JSON 格式打印解析后的报告,而非格式化摘要 | 读取由 memtrust run 写入的报告并打印格式化摘要。 |
memtrust keygen | --private-key-out FILE(默认值为 memtrust-key.pem) · --public-key-out FILE(默认值为 memtrust-key.pub) · --force 覆盖已有输出文件 | 生成新的 Ed25519 密钥对,用于通过 run --sign 对报告签名。 |
memtrust verify RECEIPT_PATH | --public-key FILE(或使用 MEMTRUST_RECEIPT_PUBLIC_KEY 环境变量) · --json 以 JSON 格式打印结果 | 验证由 memtrust run --sign 生成的签名回执;遭篡改或不匹配的回执将无法通过验证。 |
memtrust --version | -- | 打印已安装的版本。 |
以上每一行均直接来自在此仓库中运行 memtrust --help、memtrust run --help、
memtrust report --help、memtrust keygen --help 和 memtrust verify --help 的输出。
此处内容绝非杜撰。
MCP 服务
memtrust 提供 Model Context Protocol 服务,让 AI Agent (Claude、Cursor 或任何兼容 MCP 的客户端)无需人工手动调用 CLI,即可直接运行记忆后端基准测试。
安装额外组件:
pip install "memtrust-cli[mcp]"
将其添加到 MCP 客户端的配置中(对于 Claude Desktop,配置文件为 claude_desktop_config.json):
{
  "mcpServers": {
    "memtrust": {
      "command": "uvx",
      "args": ["--from", "memtrust-cli", "memtrust-mcp"]
    }
  }
}
该服务提供一个名为 run 的工具,会使用给定参数调用 memtrust run(memtrust 没有 --json 标志,因此包装程序会先写入私有临时 --output 文件,再读取该文件),并返回解析后的 JSON 报告:
run(["--backends", "mempalace", "--eval", "stats_accuracy"])
传输方式为 stdio,因此无需托管:MCP 客户端会将该服务作为本地子进程启动。源代码:src/memtrust/mcp_server.py。
这与信任供应商自己的数据有何不同
memtrust 跟踪的每个后端都会发布自己的基准数据。但它们发布的基准并不相同,评分方式和留出数据集的规范也各不相同。memtrust 并不是要你转而信任它,而是请你查看原始日志。每次运行的方法、提示词模板、数据集版本和评分标准都发布在 docs/methodology.md 中,并与生成这些数据的代码一同进行版本管理。如果方法有缺陷,你可以指出具体文件和行中的问题,而不是面对埋藏在供应商内部评估流程中的问题。
通用大模型评估框架(promptfoo、DeepEval、RAGAS 及类似工具)已经成熟且广泛使用,但它们都没有内置记忆后端适配器抽象或矛盾检测评估功能——这些框架面向的是 RAG 质量、红队测试和通用提示词评估,而非比较不同记忆系统如何处理随时间变化的事实。memtrust 有意专注于更狭窄、更具体的领域。
业界现状(经核实,未经基准测试)
截至本文撰写时的真实且可公开核查的数据(gh api repos/<org>/<repo>),并非 memtrust 运行得出的分数——关于准确性和矛盾处理能力的比较,在实际运行得出结果前仍留在下方的“基准测试”部分:
| 后端 | GitHub 星标数 | 自述简介 |
|---|---|---|
| MemPalace | 58,032 | “经过最佳基准测试的开源 AI 记忆系统。而且免费。” |
| Mem0 | 62,450 | “面向 AI Agent 的通用记忆层” |
| Zep / Graphiti | 29,526 | “为 AI Agent 构建实时知识图谱” |
| OpenViking | 27,859 | “面向 AI Agent 的自进化上下文数据库。统一 Agent 记忆、知识 RAG 和技能。” |
这些数据都无法说明哪个后端能正确处理相互矛盾的事实——这正是构建该测试框架的全部原因。星标数衡量的是采用情况,而非正确性。
真正重要的评估:矛盾检测
LongMemEval 和 LoCoMo 都衡量回忆能力:后端能否记住你之前告诉它的事实。这是必要条件,但并非充分条件。更难的问题是,当两个事实相互冲突时,后端会怎么做:你告诉它会议在下午 2 点,之后又说改到了下午 3 点。它会标记这项变更吗?会悄悄覆盖旧信息吗?还是会提供先检索到的那个?memtrust 的分类器会存储一个事实,再存储一个与之矛盾的事实,然后查询该事实,接着检查实际检索到的内容中是否包含这两个值,而不是信任适配器自身报告的任何冲突信号。具体分类方法请参阅 src/memtrust/evals/contradiction.py 和 docs/methodology.md 中的评分逻辑部分。
为另一个标题党式夸大说法打造的评测:压缩保真度
mempalace/mempalace#27 记录了两个彼此独立的夸大说法,而非一个:上文所述的 LongMemEval 分数差距,以及一项「无损」压缩声明,该声明在压缩运行模式下的实际测量结果低了 12.4 个百分点。此前,memtrust 根本无法复现第二个数字——共享接口无法让适配器区分「在模式 X 下运行」和「在模式 Y 下运行」。现在,MemoryBackendAdapter.store()/query() 接受可选参数 mode: str | None,而 MemoryBackendAdapter.supported_modes 则允许适配器声明其实际支持的模式字符串(MemPalaceAdapter.supported_modes 为 ("raw", "AAAK"),这是 mempalace/mempalace#27 本身使用的两个名称——关于这些名称的确切来源及置信度注意事项,请参阅 src/memtrust/adapters/mempalace_adapter.py)。没有模式变体的适配器也可以接受并忽略此参数,因此这项接口变更纯属增补,且向后兼容。
src/memtrust/evals/compression.py 会针对后端报告的每种模式,分别执行一次相同的存储后检索往返,并用直接、确定性的字符级相似度比率(fidelity_ratio(),通过 difflib.SequenceMatcher 计算,而非由大模型评判,因为「无损」声明说的是字面重建,而非语义层面的重建)为每次往返评分。这样一来,拥有有效 MemPalace 凭据的贡献者就可以运行 memtrust run --eval compression,直接复现「raw 与 AAAK」之间的保真度差距。截至本文撰写时,这项评测尚未在实时 MemPalace 实例上运行——它已在实时自托管的 mem0ai 安装上运行(平均保真度为 31.6%,见下文「基准测试」);关于尚未在实时环境中测量的其他评测和后端,请参阅 docs/methodology.md 了解同样适用的实时凭据注意事项。
源自 MemPalace 自身缺陷的评测:时间知识图谱边界检测
MemPalace/mempalace#1913(由已合并的 PR#1914 修复,贡献者 ggettert)描述了一个真实且具体的缺陷:_temporal_filter_sql 的 as_of 时间点查询在两端都使用了闭区间,因此,当某个事实的 valid_to 等于查询的确切 as_of 时刻时,它仍会匹配。手动将事实变更写成 kg_invalidate(ended=T),然后立即在完全相同的边界时刻调用 kg_add(valid_from=T)——这正是 MemPalace 修复前自己的 Agent 指南要求所有调用者采用的模式——此时 as_of=T 查询会同时返回刚刚结束的事实及其刚刚开始的后继事实。因此,一个单值事实会报告两个互相矛盾的答案,却不报错。src/memtrust/evals/temporal_kg_boundary.py 会针对 MemPalaceAdapter 的 kg_add()/kg_invalidate()/kg_query() 重现这一完全相同的手动操作序列,并使用新的 TemporalBoundarySignal 分类体系对结果进行分类。该体系不同于 ConflictSignal 和 RankingSignal,因为它关注一种范围狭窄、结构不同的故障:两个事实共享同一时刻,而非跨时间的矛盾或排序问题。
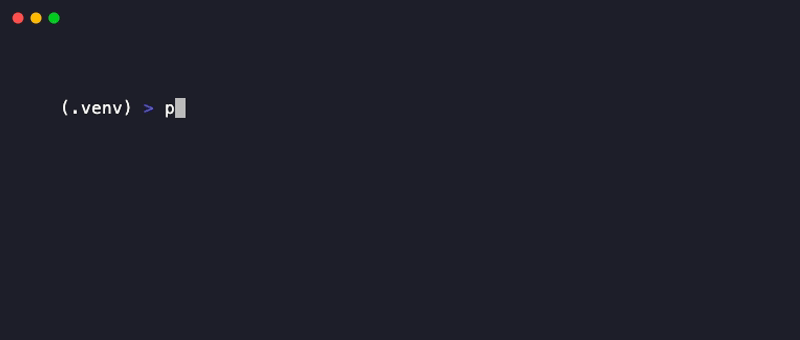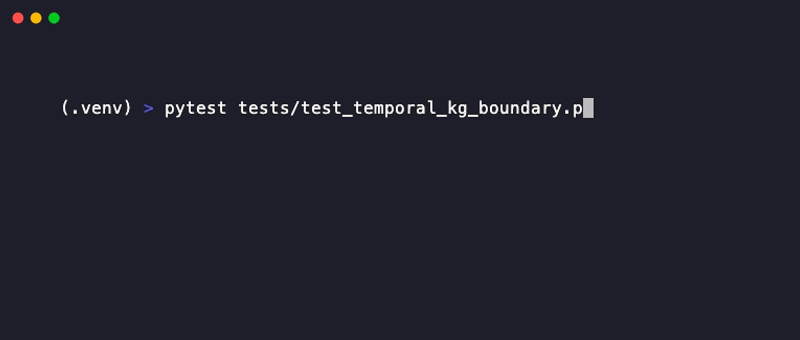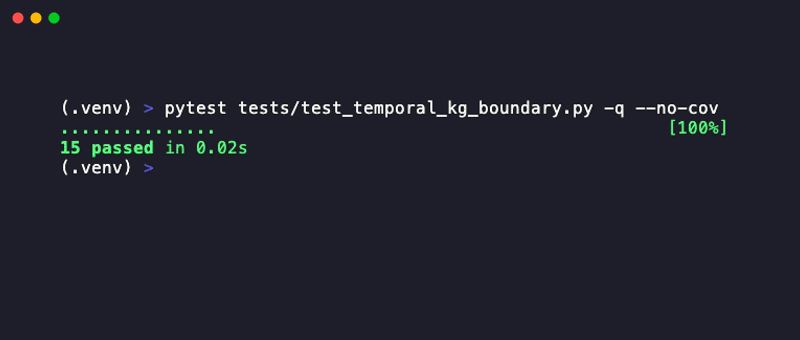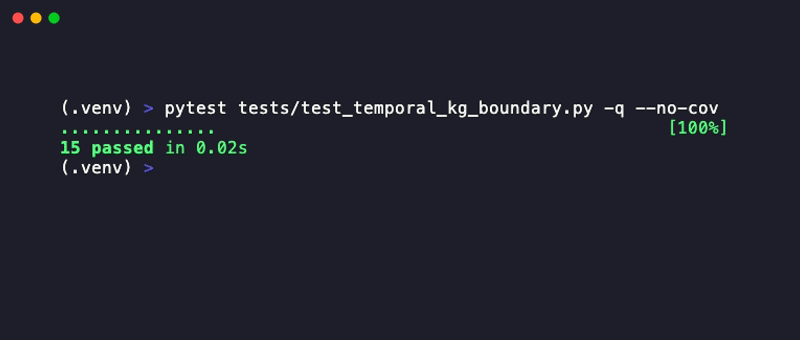
如实说明适用范围,方式与本项目对其他所有评测的说明一致:此构建环境未安装真正的 mempalace PyPI 软件包;在该适配器经过实时验证的 3.5.0 构建时,PR#1914 的修复尚未随任何已发布的 mempalace 版本推出——它列在该软件包变更日志的 [Unreleased] 部分中。tests/test_temporal_kg_boundary.py 证明了分类逻辑对于两个手写的模拟实现是正确的;这两个实现分别精确重现了已确认的 #1914 修复前(闭区间)和修复后(半开区间)的 SQL 比较。**该评测尚未在实时 MemPalace 实例上运行。**它已接入 memtrust run --eval temporal_kg_boundary(见上文“命令”);对于 mempalace 以外的任何后端,它会报告 not_applicable,而非报错。
基准测试
实时结果:mem0_direct(可自托管),2026 年 7 月。 MemPalace、Zep 和 OpenViking 尚未针对实时后端进行测试——各适配器的置信度级别见下文“后端覆盖情况”。Mem0 有一项真实结果,测试使用的是实际运行的 mem0ai 开源库,采用可自托管方式——在进程内通过 Mem0DirectAdapter 运行,由本地 Qdrant 实例提供支持,并使用 OpenAI API 进行嵌入和信息提取。
说明
此结果来自可自托管的
mem0ai开源库,而非 Mem0 托管的 Platform API。请勿将其解读为对托管产品的结论。
$ export MEM0_DIRECT_EMBEDDER_PROVIDER=openai
$ export MEM0_DIRECT_VECTOR_STORE_PROVIDER=qdrant
$ export MEM0_DIRECT_VECTOR_STORE_URL=http://localhost:6333
$ memtrust run --backends mem0_direct --eval contradiction,compression,extraction_quality
memtrust 0.3.2 -- run_id=mt_2026-07-20T210918Z
Backends: mem0_direct   Evals: contradiction, compression, extraction_quality

mem0_direct: configured, running evals...
  Running Contradiction-Detection against mem0_direct...
    flagged: 0.0%  silent-overwrite: 100.0%  served-stale: 0.0%  empty-or-lost: 0.0%
  Running Compression/Round-Trip-Fidelity against mem0_direct...
    fidelity by mode -- default: 31.6%
  Running Extraction-Quality against mem0_direct...
    junk-retained: 0.0%  valid-lost: 100.0%
    feedback-loop-duplicate: 0.0%

Cost: $0.00 (no LLM-judged evals ran -- structural evals only, or judge not configured)
完整原始报告已提交至 leaderboard/mem0_direct-2026-07-20.json,而 leaderboard/data.json 则将矛盾项数据带入静态排行榜网站(其中 mempalace/mem0/zep/openviking 仍显示为 not_measured;mem0_direct 是唯一一条真实结果)。
以下按案例逐一说明其含义,而不只是看百分比:
- 矛盾检测,7/7 个案例:每条相互矛盾的事实都悄无声息地覆盖了旧事实。 0% 的情况被标记为冲突,0% 返回了过时内容,0% 出现内容为空或丢失的情况。告诉它你的会议从 下午 2 点改到下午 3 点,它就会存储新事实,却不会提示任何变化——这正是 LongMemEval 和 LoCoMo 不会测试的问题,也正是上文“存在的原因”所讨论的问题。
- 压缩/往返保真度,5 个案例:字面字符级重建的平均准确率为 31.6%。 这是预期结果,不是缺陷——mem0 的设计目标是提取语义事实,而非逐字存储,因此字面重建得分本就不可能很高。这个数值具体说明了此后端“不适用于无损存储”意味着什么:询问它你说过什么,它会还原大意,而不是你的原话。
- 提取质量,15 个案例(12 个特意准备的无效案例,3 个特意准备的有效案例):保留的无效内容为 0%,丢失的有效案例为 100%。 所有 12 条无效输入(重复陈述启动文件内容、cron 心跳噪声、系统转储、诱导其生成幻觉用户资料的内容)都被正确拒绝。3 个有效内容案例也全部被丢弃——内容已存储,但检索时从未返回。有效案例的样本量较小(n=3);请将其视为值得进一步调查的信号,而非已确定的数字。
警告
本次测试发现了 mem0ai 本身的一个真实 Bug,而非 memtrust 的 Bug:全新安装的
mem0ai==2.0.12只要设置了OPENAI_API_KEY,所有基于 LLM 的提取调用就都会失败,对所有用户都是如此。
要得到上述任何一个数字,都必须先修复问题。mem0 自带的默认模型
(mem0/llms/openai.py:self.config.model = "gpt-5-mini")是一个推理级模型,只接受 API 的默认 temperature,但 mem0 自带的推理模型检测逻辑(mem0/llms/base.py 中的 reasoning_models 集合)检查的是字符串 "gpt-5o-mini",而不是
"gpt-5-mini"——这是两个不同的字符串,因此检测永远不会触发,mem0 无论如何都会在每次调用中发送 temperature=0.1。结果是每次提取调用都会出现 400 Unsupported value: 'temperature' does not support 0.1 with this model 错误;mem0 会悄悄捕获该错误,而 memtrust 则将其报告为
N/A (no scoreable cases),而非真实结果。Mem0DirectAdapter 现在通过显式传入 is_reasoning_model=True 绕过了这个问题——这是 mem0 自身针对这种情况提供的文档化覆盖选项——完整引用请参见 src/memtrust/adapters/mem0_direct_adapter.py 中的“默认 LLM 提取开箱即用时无法工作”部分。截至本文撰写时,尚未就此问题向 mem0ai 上游提交 Issue。
要复现此问题,或测量其余三个后端:
export MEM0_API_KEY=...          # and/or
export ZEP_API_KEY=...
export OPENVIKING_API_KEY=...
export MEMPALACE_STORAGE_PATH=...
export MEMTRUST_JUDGE_API_KEY=...   # needed for LongMemEval/LoCoMo grading; contradiction-detection doesn't need it

memtrust run --backends mempalace,mem0,zep,openviking --eval all
memtrust report memtrust-report-<date>.json
该命令会输出各后端的准确率和矛盾处理率,写入完整的 JSON 报告,并打印已运行的 LLM 评估的预估费用。现在已通过真实安装实例对 MemPalaceAdapter 的抽屉和知识图谱调用进行了在线验证(见下文“后端覆盖”),但 OpenViking 的记忆写入/查询路径,以及自托管 Mem0 和 Zep/Graphiti 适配器的部分功能,仍基于对文档或源码中产品概念的尽力解读构建,尚未通过实际运行确认 API——在将任何适配器的输出视为权威结果之前,请先参阅 docs/methodology.md 中的置信度表;也欢迎针对表中的缺口贡献修复。
今后在此发布任何 accuracy 数值时的标注要求。 LongMemEval 和 LoCoMo
的 accuracy 直接评估 LLM 判分器对原始检索记录内容的判定——两个评测运行器都不包含
答案生成步骤。这与 LongMemEval/LoCoMo 官方排行榜上的「先生成答案、再判分」QA 准确率
分数并非同一种指标。本项目发布的这两项评测的任何 accuracy 数值,都必须标注为「检索判分准确率」,不能只写「准确率」;未经此说明,不得与排行榜数值直接比较。请参阅 docs/methodology.md 中的「检索判分准确率与生成答案准确率」一节。
GitHub Actions 用法
按计划运行测试套件,并将结果发布到排行榜:
name: memtrust-leaderboard
on:
  schedule:
    - cron: "0 9 * * 1"  # weekly
  workflow_dispatch: {}

jobs:
  benchmark:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-python@v5
        with:
          python-version: "3.12"
      - run: pip install memtrust-cli
      - run: memtrust run --backends mempalace,mem0,zep,openviking --eval all --output leaderboard/data.json
        env:
          MEM0_API_KEY: ${{ secrets.MEM0_API_KEY }}
          ZEP_API_KEY: ${{ secrets.ZEP_API_KEY }}
          OPENVIKING_API_KEY: ${{ secrets.OPENVIKING_API_KEY }}
          MEMTRUST_JUDGE_API_KEY: ${{ secrets.MEMTRUST_JUDGE_API_KEY }}
      - run: git add leaderboard/data.json && git commit -m "Update leaderboard" && git push
本仓库自己的 CI(.github/workflows/ci.yml)会在每次推送和拉取请求时运行 lint、类型检查、测试和依赖项安全审计——无需供应商凭证,因为所有测试都完全离线运行。
自托管
git clone https://github.com/RudrenduPaul/memtrust
cd memtrust
pip install -e ".[dev]"
export MEM0_API_KEY=...
memtrust run --backends mem0 --eval all
将适配器指向你自己的后端,或者使用你自己的对话数据运行测试套件,而不是使用内置的合成测试数据(参见 docs/methodology.md 中关于替换为真实 LongMemEval/LoCoMo 数据集的说明)。除非你选择发布,否则任何内容都不会离开你的计算机。
安装
pip install memtrust-cli 是经验证可用的安装方式——截至本文编写时,已在全新虚拟环境中确认。pip show memtrust-cli 和 memtrust --version 均会报告 0.3.4。
npx(目前存在问题——已标注,未隐藏)
npm 包(memtrust-cli)已发布,不再返回 404;其 main 分支上的源文件
(npm/memtrust-cli/bin/memtrust.js)也能正确运行 uv tool run --from memtrust-cli==<version> memtrust <args>。然而,已发布的 0.3.4 npm 压缩包仍包含同一文件的早期错误构建版本,它运行的是 uv tool run --from memtrust==<version> memtrust <args>——指向一个名为 memtrust、从未存在过的 PyPI 项目(pypi.org/pypi/memtrust/json 返回 404,与下方 FAQ 中已有说明一致)。源代码修复已合入 main;包含该修复的 npm 版本尚未发布。今天通过下载实际发布的压缩包(npm pack [email protected])并直接检查 bin/memtrust.js 确认了这一点,而不是只读源代码并假定已发布版本与之相同:
$ npx -y memtrust-cli --version
npm error could not determine executable to run
  × No solution found when resolving tool dependencies:
  ╰─▶ Because memtrust was not found in the package registry and you
      require memtrust==0.3.4, we can conclude that your requirements are
      unsatisfiable.
在包含修复版包装脚本的新 npm 版本发布之前,请使用 pip install memtrust-cli(见上文)——它不受影响,因为问题只出在 npm 包装脚本中,而不在它引导安装的 PyPI 包中。对于装有 Node.js 但没有 Python 的 CI 和 Agent 运行器:在本节不再显示此提示之前,请暂缓使用 npx memtrust-cli,或安装 Python 并直接使用 pip install memtrust-cli。
npm 包命名为 memtrust-cli,以便一眼看出它是 CLI 工具(也避免与未来可能推出的 memtrust JS 库包冲突)。npx 总会自动将包名解析为相应的 bin 条目,因此修复版发布后,npx memtrust-cli ... 就是预期的零安装使用方式。安装后,该包还会将较短的 memtrust 命令作为第二个 bin 别名公开,与底层 Python CLI 自身的命令名称保持一致——这样后续每次调用就不必都输入 memtrust-cli。
这从来就不是零依赖安装方式:npx memtrust-cli 首次使用时仍会从 PyPI 获取 memtrust-cli。它省去的是手动配置 Python 工具链——它会通过捆绑的、经过验证的 Astral uv 副本为你引导安装解释器并获取软件包。每个平台的软件包都捆绑了 uv 自身 GitHub 发布版二进制文件的真实副本,并经过 SHA-256 验证(在 npm 包发布时获取,绝不会在最终用户安装时获取)。npm 包会锁定自身版本——有新的 PyPI 版本发布时,需更新 npm/memtrust-cli/package.json 的版本并重新发布;此后每次安装都会解析到该确切版本,而非运行时碰巧最新的版本。这里尚未完成的正是这一步重新发布。
托管信任层能带来什么
本仓库中的测试框架、适配器和排行榜构成了全部开源功能;它们本身就足以比较不同后端。在此基础上构建的托管层(仅在此描述,尚未实现)将增加持续回归监控,在受跟踪的后端发布新版本时自动重新运行测试套件;提供私有评分卡,使用与公开样例数据形状相同的方法针对团队自己的数据进行测试;并提供合规报告导出,供安全或法律审查需要有记录的第三方材料而非自由文本摘要的团队使用。这些功能目前都不存在。若将来实现,也只会作为免费测试框架的附加功能,绝不会成为使用该框架的前提。
后端覆盖情况
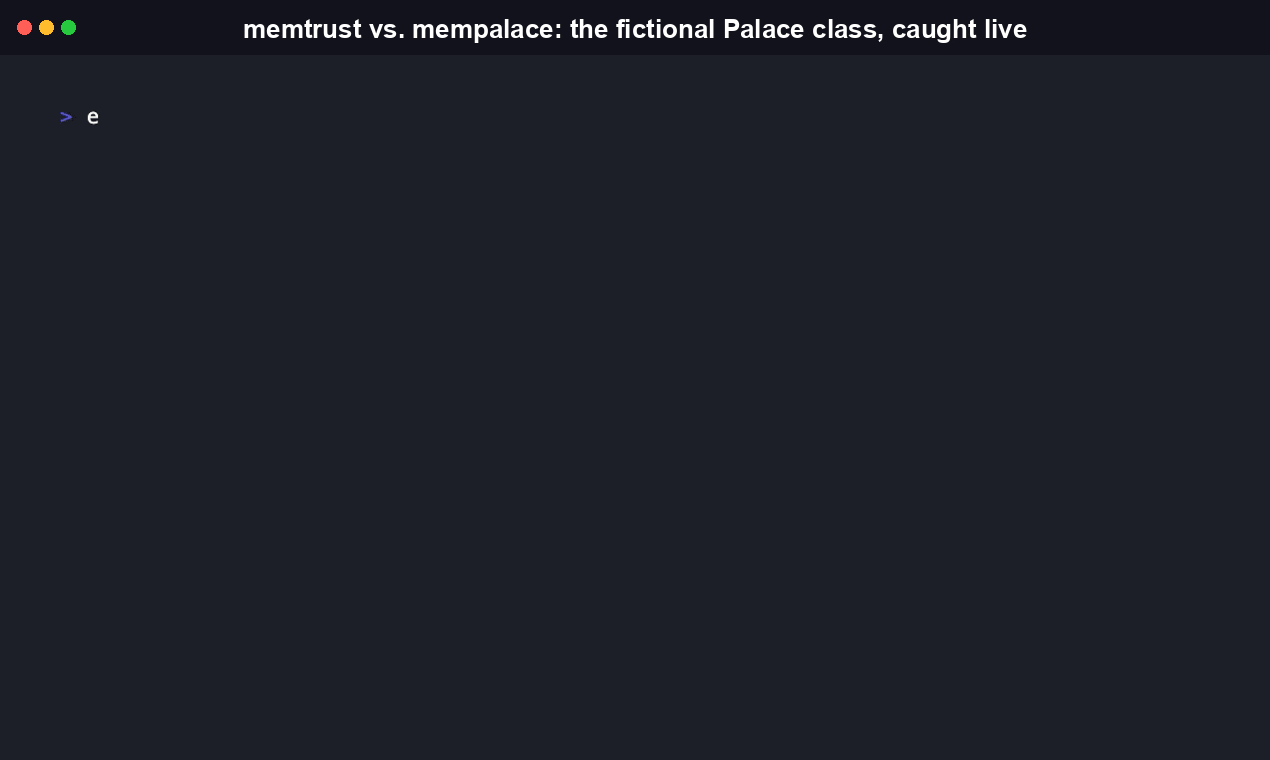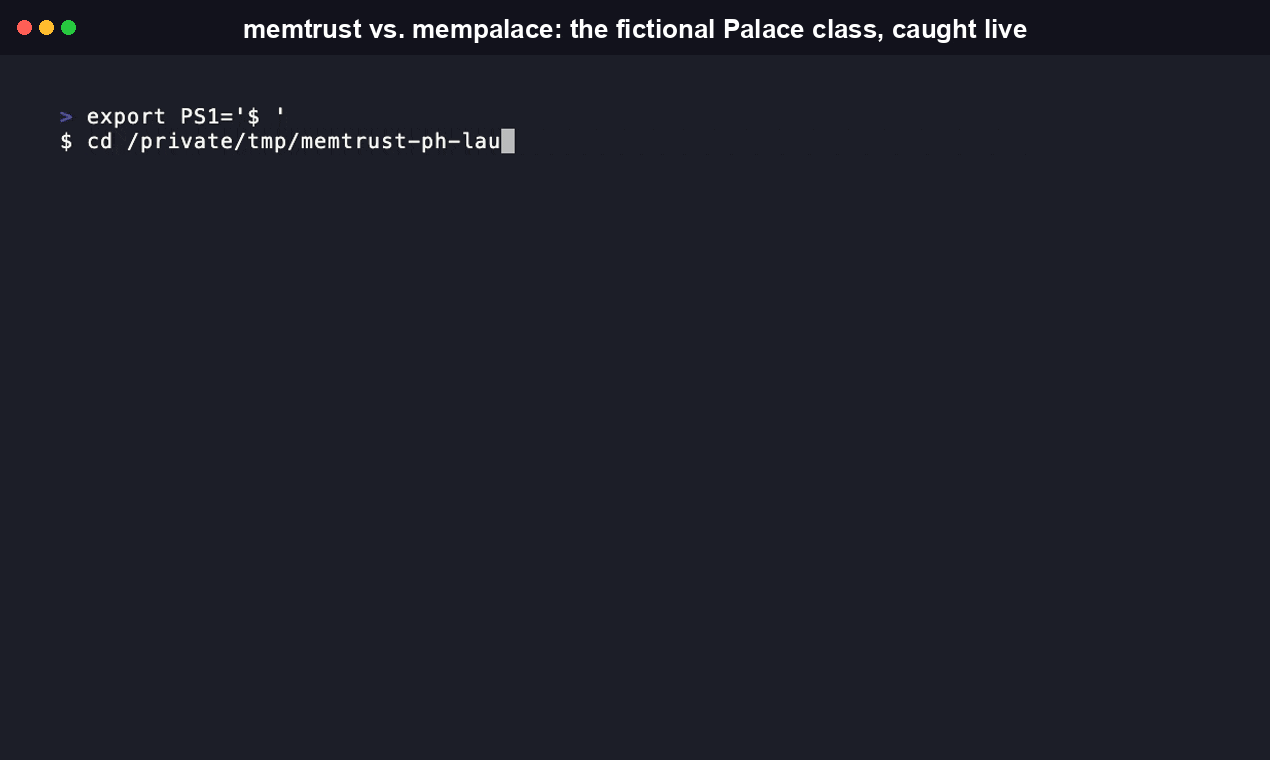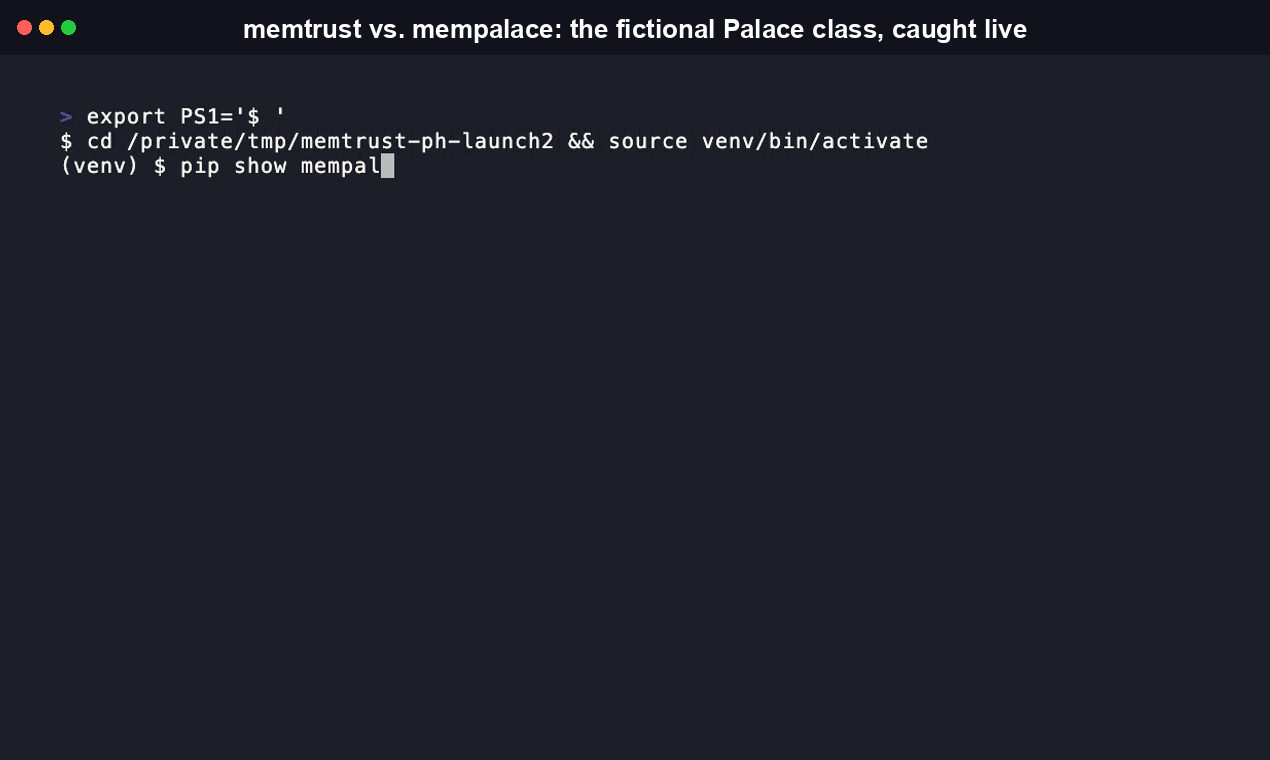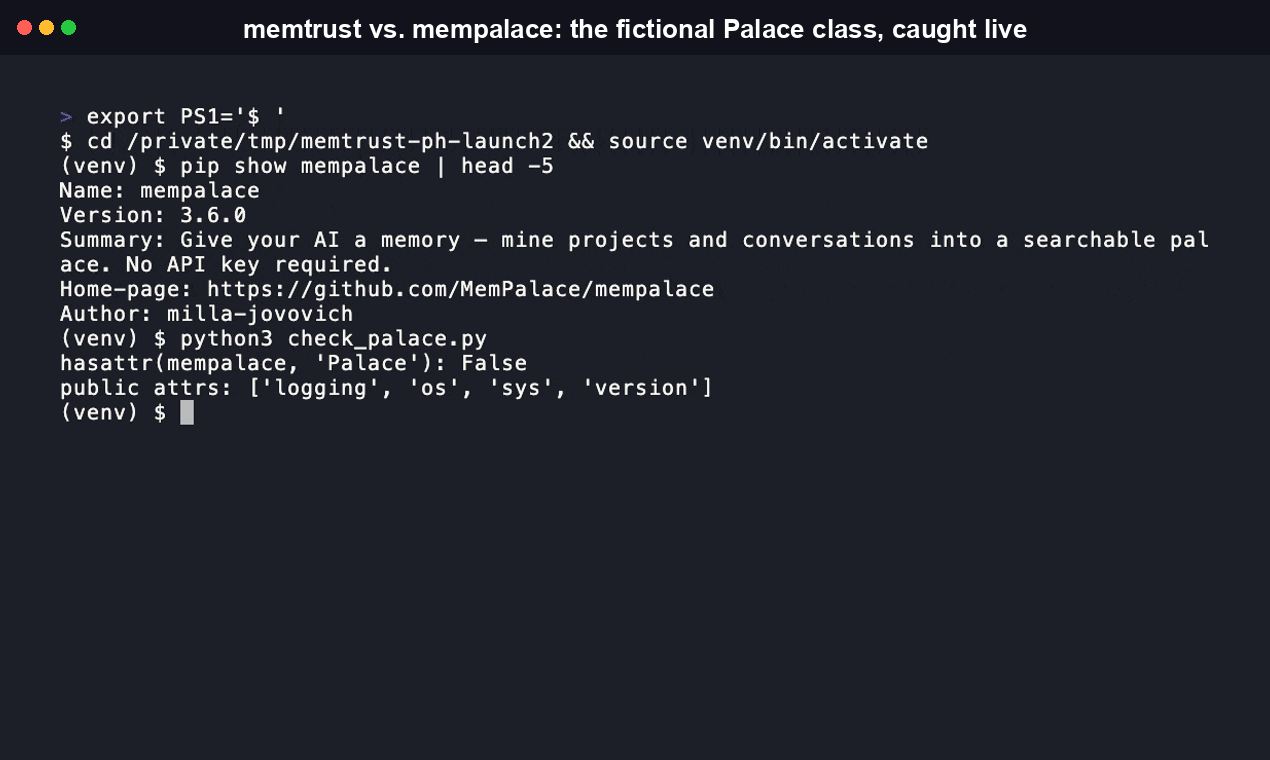
下方 MemPalace 行之前写着“需要根据实际运行的实例验证”——但实际需要做的远不止这些。此前每个版本的 MemPalaceAdapter 都调用了 mempalace.Palace 类(Palace(storage_path=...),并提供 .remember()/.recall()/.invalidate()),但真实安装的包中根本没有这个类。python3 -c "import mempalace; hasattr(mempalace, 'Palace')" 返回 False;遍历已安装包中的所有 class 定义,也找不到任何名为 Palace 的类。此前所有看似通过的测试,实际都在使用手写的假对象来模拟这个猜测,而非真实对象——在本项目的整个历史中,store()/query()/update() 从未在实际运行的 MemPalace 安装上真正生效,直到这次重写。src/memtrust/adapters/mempalace_adapter.py 已从头改写,改为调用 mempalace.mcp_server 中真实存在的普通模块级函数(tool_add_drawer、tool_search、tool_update_drawer、tool_delete_drawer、tool_kg_add/tool_kg_invalidate/tool_kg_query)——适配器模块文档字符串中记录的每一种返回结构,都通过实际调用这些函数,在真实的本地 chromadb 后端 palace 上采集,而非照搬文档字符串并轻信其内容。这正是整个项目旨在帮助大家在他人的基准测试中发现的错误;如今在 memtrust 自己的适配器中发现了这个问题,并公开提交修复,而非悄悄打补丁,这才是更有价值的故事。
| 后端 | 适配器状态 | 置信度(参见 docs/methodology.md) |
|---|---|---|
| MemPalace | 已实现——抽屉 API + 知识图谱 API | 对此适配器现在调用的真实 mempalace.mcp_server 函数置信度高,已在已安装 mempalace 3.5.0 的实例上完成实时验证(见上文)。压缩模式名称("raw"/"AAAK")以及已安装版本是否会填充 degraded_retrieval 警告,仍属于尽力而为的范畴——这两项注意事项都已在适配器模块文档字符串中明确说明。 |
| Mem0 | 已实现——托管 Platform API、自托管 OSS 服务,以及直接进程内库适配器 | 对托管 Platform API 以及已安装的 mem0ai==2.0.12 库中嵌入器/向量存储代码的实际行为置信度高(已通过阅读真实源码确认,并在测试中直接验证);对自托管 OSS 服务的路由结构置信度中高(已通过源码确认,未在实际运行的服务上测试)。 |
| Zep / Graphiti | 已实现——托管 Zep Platform API 和自托管 graphiti-core 适配器 | 对托管 API 文档中关于矛盾处理行为的描述置信度中高;对自托管适配器的协议层结构置信度中等(所有方法签名都已通过阅读 graphiti-core 的真实源码确认,但未在实际运行的 Neo4j/FalkorDB 实例上测试——此环境未安装该软件包)。 |
| OpenViking | 已实现 | 对架构的置信度中等,对具体的记忆写入/查询路径的置信度较低——它仍是最可能需要根据实际运行的实例进行修正的适配器。 |
添加后端适配器是主要的贡献方式——参见 CONTRIBUTING.md。
开发
pip install -e ".[dev]"
ruff check . && ruff format --check .
mypy --strict src/memtrust
pytest --cov=memtrust --cov-report=term-missing --cov-fail-under=80
pip-audit
如果你更希望每次提交时自动运行这些检查,而不是记得手动运行,.pre-commit-config.yaml 会将 ruff 和 mypy 接入 pre-commit。
常见问题
memtrust 是什么?它与阅读供应商自己的基准测试页面究竟有什么不同? 它是一个命令行工具,可针对 MemPalace、Mem0、Zep/Graphiti 和 OpenViking 运行相同的评测(LongMemEval、LoCoMo,以及在 --eval 中注册的另外 15 项评测,其中包括一项四个受测后端均未公布成绩的矛盾检测评测),并输出原始结果,而不是经过筛选的摘要。它的差异化之处不在于专有评分模型,而在于此前没有供应商以外的人用相同方式、对每个选项运行同一项测试,并将完整方法与生成结果的代码一同公开(docs/methodology.md)。请参阅上文“为何开发此项目”,了解促使本项目诞生的 MemPalace LongMemEval 夸大宣传(mempalace/mempalace#27)。
memtrust 支持我的平台吗?如果不支持,会怎样? npm 封装包(memtrust-cli)提供 6 个针对特定平台的可选依赖包——@memtrust-cli/darwin-x64、@memtrust-cli/darwin-arm64、@memtrust-cli/linux-x64、@memtrust-cli/linux-arm64、@memtrust-cli/win32-x64 和 @memtrust-cli/win32-arm64——每个包都捆绑了适用于对应平台且经过验证的 uv 二进制文件(npm/memtrust-cli/bin/memtrust.js)。安装时,npm install 会根据 process.platform/process.arch 选择匹配的包。若平台组合不受支持(32 位 x86,或此列表之外的任何平台),封装包会明确报错 no prebuilt uv binary available for <platform>/<arch>,而不会静默失败。底层的 memtrust PyPI 包本身只要求 Python 3.11+,因此在 npm 封装包未覆盖的平台上,仍可通过 pip install memtrust-cli 安装。
为什么 npx memtrust-cli --version 会报错“在软件包注册表中找不到 memtrust”? 这是一个确实存在且目前仍未解决的打包问题;我们通过直接下载已发布的 tarball(npm pack [email protected])确认了这一点,而不是只相信仓库源码:npm 上的 0.3.4 版本仍会运行 uv tool run --from memtrust==<version>,指向名为 memtrust 的 PyPI 项目,但该项目从未发布过。修复方案(改用 --from memtrust-cli==<version>,即实际发布的名称)已合并到 main,但尚未随 npm 新版本发布。在该版本发布前,pip install memtrust-cli 不受影响,仍是可靠的安装方式——具体复现步骤请参阅上文“安装”。
使用 memtrust 需要安装 Python 工具链吗? npm 封装包的设计目标就是免去这项要求——npx memtrust-cli run ... 旨在于底层运行 uv tool run --from memtrust-cli==<pinned version> memtrust <args>,让 uv 在首次使用时自行配置隔离的 Python 解释器。截至本文撰写时,已发布的 npm 0.3.4 包仍捆绑着该封装包的较早且有问题的版本(已确认的复现步骤请参阅上文“安装”);在修复版本发布前,你需要安装 Python 3.11+,并直接使用 pip install memtrust-cli(PyPI 包名)——无需 Node.js。
memtrust 与 RAGAS 这类通用大模型评测框架相比如何? RAGAS 使用客观指标和合成测试数据生成来评测 RAG 流程及其他大模型应用;它没有记忆后端适配器抽象,也没有专门设计用于检测某项事实是否与之前的事实矛盾的评测,因为这不是它要解决的问题。memtrust 则有意缩小范围:它只追踪 4 个指定的 Agent 记忆后端,其非召回类评测(矛盾检测、压缩/往返保真度、时间知识图谱边界检测)专门用于检验这 4 个后端对自身所作的声明。如果你需要广泛覆盖 RAG 或提示词评测,RAGAS 或类似框架更适合;如果你需要检查记忆后端是否会悄悄丢弃或覆盖彼此矛盾的事实,memtrust 就是为此而打造的工具。
为什么以前运行 memtrust --version 打印的版本与 pip 显示的已安装版本不一致? 这是早期版本中一个确实发布过的 Bug,并非假设性问题:在干净的虚拟环境中从 PyPI 安装 memtrust-cli,运行 pip show memtrust-cli 会报告正确的版本,但 memtrust --version 无论如何都会打印 0.0.0+unknown,因为 src/memtrust/__init__.py 读取的是 importlib.metadata.version("memtrust")——错误的发行包名称——而不是 version("memtrust-cli"),也就是该包实际安装时使用的名称。第一次尝试修复本身也不完整:它将查询名称硬编码为 "memtrust-cli",这会以相反的方式导致名为 memtrust 的镜像安装出问题——只安装了名为 memtrust 的发行包时,其已安装包元数据中根本没有 memtrust-cli 条目,因此查询总会失败,并回退到同一个 0.0.0+unknown。后续版本已彻底修复:现在会先查询 memtrust-cli,再回退到 memtrust,只有两个发行包名称都未安装时才会报告 0.0.0+unknown。这个回退逻辑是防御性的,并不代表目前存在一个名为 memtrust 的 PyPI 项目——当前准确答案请见下文“我可以安装 memtrust,而不是 memtrust-cli 吗?”。
我可以安装 memtrust,而不是 memtrust-cli 吗? 不可以,目前不行——本 README 以前曾声称存在一个独立的 memtrust PyPI 项目,且与 memtrust-cli 同步发布。经实时检查 pypi.org/pypi/memtrust/json,返回的是普通的 404:从未发布过名为 memtrust 的项目。运行 pip install memtrust 会报错:“No matching distribution found for memtrust.” memtrust-cli 才是唯一真实发布的 PyPI 名称;请安装它。(src/memtrust/__init__.py 仍有防御性回退逻辑:如果本地曾安装过名为 memtrust 的发行包版本,例如从本地构建安装,它也会读取该版本;但这与 PyPI 上是否存在正在发布的 memtrust 项目无关,而事实上该项目并不存在。)出于同样的原因,npm 包装器在 main 上的 bin/memtrust.js 现在会固定使用 uv tool run --from memtrust-cli==<version>;不过,已发布的 0.3.4 npm 构建尚未包含此修复——当前已确认存在问题的 npx memtrust-cli 状态请见上文“安装”。
memtrust 是否实际针对在线记忆后端运行过,还是所有结果都是合成的? 两者都有,README 也明确区分了它们。评测逻辑本身已通过随附的合成测试数据验证;对于若干适配器,也使用真实安装的供应商包进行了验证,仅对网络边界进行了模拟(见上文 pytest 覆盖率表)。其中一个后端有真实的在线运行结果:mem0_direct,也就是可自托管的 mem0ai OSS 库(不是 Mem0 托管的 Platform API),已针对矛盾处理、压缩和提取质量运行——具体数值以及这次运行发现的 mem0ai 自身真实 Bug,请见上文“基准测试”。截至本文撰写时,MemPalace、托管版 Mem0 Platform API、Zep 和 OpenViking 均尚未使用真实凭据针对在线后端运行。“后端覆盖情况”表会因此为每个适配器标注置信度(高/中/低);你可以使用自己的凭据运行,以获得经在线验证的数值。
我可以将 memtrust 用于商业用途吗?需要注明出处吗? 可以。它采用 Apache License 2.0 授权(见 LICENSE),允许商业使用、修改和分发,并要求保留许可证和版权声明,同时注明对代码所做的任何更改。仅仅因为你的产品依赖 memtrust,并不要求你将自己的产品开源。
如何获取仍标记为“尚未测量”的后端的实际准确率数据? 设置要测试的后端对应的凭据环境变量
(MEMPALACE_STORAGE_PATH、MEM0_API_KEY、ZEP_API_KEY、OPENVIKING_API_KEY,以及用于 LongMemEval 和 LoCoMo 等由大模型评判的评测的 MEMTRUST_JUDGE_API_KEY),然后运行
memtrust run --backends <name> --eval all 和 memtrust report <output-file>。未配置凭据的后端会显示 SKIPPED,运行仍会完成并生成有效的 JSON 报告——准确命令请参阅上文的“功能说明”和“基准测试”。
许可证
Apache 2.0。请参阅 LICENSE。
成功案例
真实贡献者针对 MemPalace、mem0、Zep/Graphiti 和 OpenViking 提交的 197 个真实问题/PR,均已由独立人员对照此代码库进行了根因分析:以当前实际存在的解决方案,能否诊断或解决所报告的问题?其中,55 个(28%)确认通过,16 个(8%)为部分通过(已收集证据,但需要人工进一步解读,或只涵盖了问题的一部分),42 个(21%)属于此测试框架尚未弥补的真实能力缺口,84 个(43%)则实际上不适用(功能请求、上游已修复,或确实不在范围内)。下方每项结论都经过与修复构建者无关的审核者对照当前代码库实时重新验证,并非仅仅引用变更日志。完整的分析和验证证据均在内部跟踪;这里的摘要面向所有想了解此测试框架能否发现自己所遇问题的人。
最值得关注的案例,说的是 memtrust 自身的漏洞,而非某个供应商的问题。 此次重写之前的所有版本中,MemPalaceAdapter 都调用了一个 mempalace.Palace 类——该类接受 Palace(storage_path=...),并提供 .remember()/.recall()/.invalidate() 方法——但真实安装包中根本不存在这个类。运行 python3 -c "import mempalace; hasattr(mempalace, 'Palace')" 会返回 False;已安装软件包的源代码中也完全没有名为 Palace 的内容。所有看似通过的测试,都在使用手写的假对象来验证这种猜测——store()/query()/update() 从未在实际安装的 MemPalace 上运行成功过。src/memtrust/adapters/ mempalace_adapter.py 已改为调用真实的 mempalace.mcp_server 函数,并通过对真实本地实例的实时调用,记录了所有文档所述的返回格式。这个旨在发现其他供应商夸大宣传的项目,在自己的代码中也发现了同样的问题模式,并且公开发布了修复,而不是悄悄处理。完整说明请参阅上文的“后端覆盖情况”。
MemPalace
- #1754 (@rodboev):修复了 dim-None pickle 被静默隔离时的检查点恢复问题。此前,memtrust 的矛盾评估无法区分“静默隔离”和“完全没有更新原语”;现在可以了(
ConflictSignal.EMPTY_OR_LOST)。 - #1929 (@jrzmurray):修复了 NUL 字节静默损坏 ChromaDB 索引的问题。此前,memtrust 的
store()会将“没有异常”视为写入已持久化的证明;现在新增了一个可选的写后读取验证步骤来捕获此类问题。 - #1450 (@lealbrunocalhau):修复了空 embedding 响应被判为错误答案而非基础设施故障的问题。与上方的 #1754 是同一项修复。
- #1823 / #1543 (@fatkobra):修复了锁和写入完整性问题,这些问题都指向了 #1929 所修复的同一个写后读取缺口。
- #1913 / PR#1914
(@ggettert):修复了一个时间知识图谱
as_of边界问题:事实的结束时间恰好等于查询时刻时,该事实仍会与后继事实一起匹配。memtrust 新增的时间知识图谱边界评估会复现触发此问题的手动执行kg_invalidate()然后kg_add()的确切序列——关于尚未经过线上验证的说明,请参见上方“根据 MemPalace 自身缺陷构建的评估”。 - PR#1890 / #1889
(@JosefAschauer):修复了
_hybrid_rank的authored_at时间顺序平局判定问题。memtrust 的排序分类器现在会将顶层的authored_at字段视为真正影响排序的信号,而不仅仅是metadata下的字段。 mem0 - #5973 (@abhay-codes07,已被 #5992 取代):空字符串实体 ID 筛选器范围限定错误。 memtrust 的 mem0 适配器只能访问托管版 Platform API,且完全没有删除操作, 因此无法发现此问题。现在有了经过测试、具备 delete/delete_many 基本操作的可自托管适配器, 便可以发现此问题。
- #4297 (@utkarsh240799):维度自动检测 修复。现在可自托管适配器会路由到正确的部署,但目前还没有测试能端到端复现 这个具体问题,因此只能部分发现,尚未完全捕获。
- #4573 (@jamebobob):对 10,134 条真实
mem0 条目进行为期 32 天的审计,发现其中 97.8% 是垃圾数据。memtrust 新增的提取质量评估和
ExtractionQualitySignal分类法涵盖了审计中发现的各类垃圾数据,包括其发现的 808 条重复项反馈循环问题。 - PR#5980 (@HrushiYadav):修复 Elasticsearch 向量存储的
筛选器注入问题。新增的筛选器注入评估会直接测试实际安装的
mem0.vector_stores.elasticsearch.ElasticsearchDB._validate_filter(),并确认它会拒绝该 PR 修复的 精确恶意筛选器形式({"user_id": {"$ne": ""}})。 - #4956 (@NDNM1408):一项尚未解决的提案,指出 mem0 的
仅添加管线会暴露过时、相互矛盾的事实,且没有新近度信号。memtrust 的矛盾评估现在会针对该分类法,
运行相同的字面仅添加场景(调用两次
store(),不显式更新)。 - #4884 (@wangjiawei-vegetable):硬编码的
仅支持英语的分词器会悄无声息地降低非拉丁文字检索效果。新增的
LanguageDegradationSignal和非拉丁文字测试样例现在可捕获此类问题—— 该功能专用于Mem0DirectAdapter(它会读取query(explain=True)返回的真实逐结果诊断 字段,只有该适配器具备此能力),并且与embedder_cost.py的成本归因评估和episode_temporal_leak.py的 Graphiti 专用评估一样,目前尚未接入memtrust run --eval的通用列表;在该 CLI 功能推出之前,请直接调用run_language_degradation_eval(),或查看tests/test_mem0_direct_adapter.py中的test_query_language_degradation_*测试。 Zep / Graphiti - #1489 (@brentkearney):双时态
invalid_at正确性缺陷。memtrust 曾丢弃 Graphiti 自身的invalid_at元数据,并根据固定的前 5 条文本匹配推断所有情况,误将一个已正确标记的案例判定为静默覆盖。现在会先检查元数据。 - #1275 (@rafaelreis-r,仍未解决):实体解析上下文随数据量呈 O(n) 增长,导致摄取约 300 条记录后,后续片段被静默丢弃。新增的可自托管
graphiti-core适配器,以及规模/数据量压力评估,会在递增检查点上追踪固定“锚点”记录的召回率,并通过真实的add_episode()摄取数据——与该问题所描述的模式相同。 - #836 (@matthiaslau) / #920
(@markwkiehl):
update_communities()/resolve_edge_contradictions()中出现的两个不同崩溃问题——一个是解包值过多错误,另一个是 tz-naive/aware datetime 比较错误。新增的CrashSignal分类可识别这两种确切情况,而非抛出不透明的通用异常。 - PR#1222 (@david-morales) / PR#1183
(@Milofax):FalkorDB 因全文查询为空或未转义而出现 RediSearch 语法错误。新增的
CrashSignal.QUERY_SANITIZATION_ERROR可识别这两个问题中原样提交的错误文本。 - #1467 (@elimydlarz,未解决,暂无互动):
GeminiEmbedder静默返回错误的向量数量。将 Gemini 嵌入器支持接入可自托管适配器后,新增的CrashSignal.EMBEDDING_BATCH_COUNT_MISMATCH可捕获此问题。
OpenViking
- #3029 (@dfwgj,仍未解决):飞书重新同步时静默删除用户管理的文件。memtrust 原本完全无法观察到这种故障模式;现在新增专门的资源同步安全评估,会预先创建生成文件和用户文件,触发重新同步,并检查哪些文件得以保留。
- #2850 (@lg320531124,仍未解决):BM25 搜索在大规模数据下静默返回空结果。专门的规模/数据量压力评估(
memtrust run --eval scale_stress)现在会存储大型合成语料,并在递增检查点重新查询,以复现此问题的模式——召回率在超过数据量阈值后骤降,且不抛出异常。 - #1581 (@0xble,修复遭拒,上游仍未解决):
v2_lock_max_retries=0实际表示无限重试,而非重试 0 次。新增的锁竞争评估会在并发写入冲突期间,断言响应时间不超过指定上限。 - #1255 (@SeeYangZhi):统计信息端点在记忆已持久化的情况下静默返回 0。新增的
get_stats()/StatsResult基元和专门的统计准确性评估现在可以捕获此问题。 - #2966 (@lRoccoon,上游尚未处理):
旧版记录被截断为 uint16,导致其永久无法删除。新增的
CrashSignal.LEGACY_CORRUPT_RECORD_UNDELETABLE现在会报告此问题,而非静默无操作。 - #204 (@ponsde,已关闭):由于已自行诊断出的维度不匹配,相同查询的搜索结果不确定(Jaccard 相似度为 0.11)。新增的结果一致性评估会计算多次相同查询两两之间的 Jaccard 相似度,直接捕获此类问题。 跨项目
- OneNomad-LLC/przm-bench(@mattstvartak):一个同类基准测试项目,实现了加密收据签名;memtrust 尚未实现。
memtrust现在支持真正的 Ed25519 签名和验证(使用cryptography库,而非手工实现的方案),可通过memtrust keygen/run --sign/verify使用——篡改过的收据会正确地验证失败,真实收据则会正确地验证通过。
上述内容以及完整 197 行集合中其他位置的若干 PARTIAL 和 FAIL——能力缺口项仍未解决,且有意不计为已修复:其中一些指向真实缺口,目前此测试框架确实无法在没有有效供应商凭证的情况下弥补;把接近通过的结果夸大为 PASS,会违背独立验证基准测试的全部初衷。有关哪些声明基于何种证据,请参阅本 README 和 docs/methodology.md 中的置信度说明。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。