
关于 ownvoice
OwnVoice 是用于 pocket-tts 的 Python CLI,可训练 LoRA 语音适配器并在本地保存适配器和元数据。它面向希望用语音片段微调语音生成的人,并提供训练前的 CPU 兼容性检查。
主要功能
- 01仅用 CPU 检查 LoRA 兼容性
- 02从 WAV 片段训练适配器
- 03基于相似度评估可用性
- 04本地保存适配器与元数据
- 05使用已保存适配器生成语音
适用场景
- 01训练前检查 pocket-tts 的 LoRA 支持
- 02根据语音录音训练适配器
- 03使用已保存的语音适配器生成语音
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
OwnVoice
为 pocket-tts 训练 LoRA 语音适配器并保留训练结果:它是存储在你自己的磁盘上的文件,而不是 API 订阅。


pip install ownvoice-cli
需要 Python 3.11 或更高版本。npx / agent-sandbox 安装方式请参阅下文的安装。
目录
安装
pip install ownvoice-cli
npx / Agent 原生环境: OwnVoice 是一个 Python/PyTorch CLI,因此 npm 包只是一个轻量封装,并非用 Node 重新实现。它会通过 uv 或 pipx(以已存在于 PATH 中的工具为准)引导启动真正的 CLI,适用于默认使用 Node 工具链的编码 Agent 沙盒和 CI 运行器。npm 包已从旧的普通名称 ownvoice(现已弃用)更名为 ownvoice-cli,以与 PyPI 对应包保持一致。
npx ownvoice-cli check
npm 封装和 PyPI 包(ownvoice-cli)均已发布,因此上面的命令现在就能使用。
Torch 和 CUDA: ownvoice check 无需 GPU,可在 CPU 上运行,这与 pocket-tts 本身支持 CPU 的设计一致。使用 NVIDIA GPU 训练实际的适配器会快得多。如果你有 NVIDIA GPU,请先按照 pytorch.org/get-started/locally 安装 CUDA 版 PyTorch,再安装 OwnVoice,以免 pip 静默地改装仅支持 CPU 的 wheel。在 Apple Silicon 或仅有 CPU 的机器上,默认通过 pip install 安装 torch 即可:ownvoice check 和 ownvoice infer 都能正常运行,而 ownvoice train 只是每个 epoch 耗时更长。
快速开始
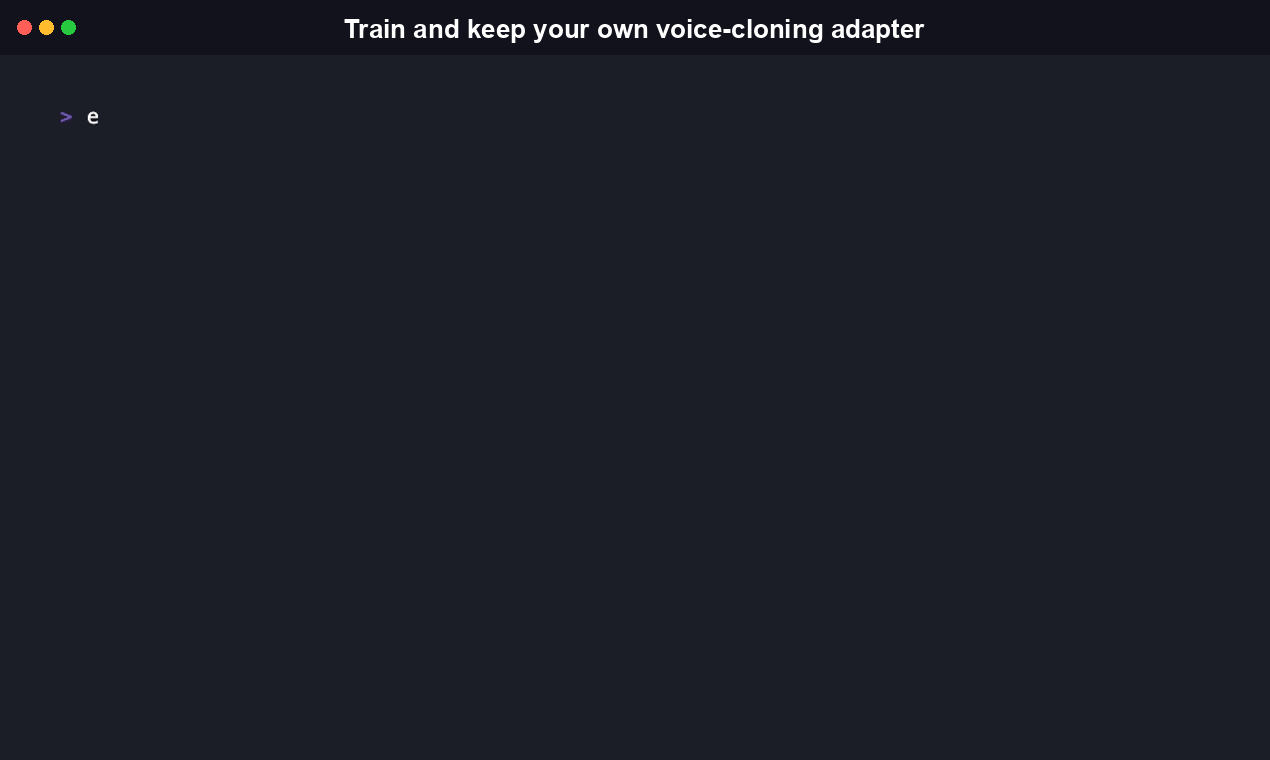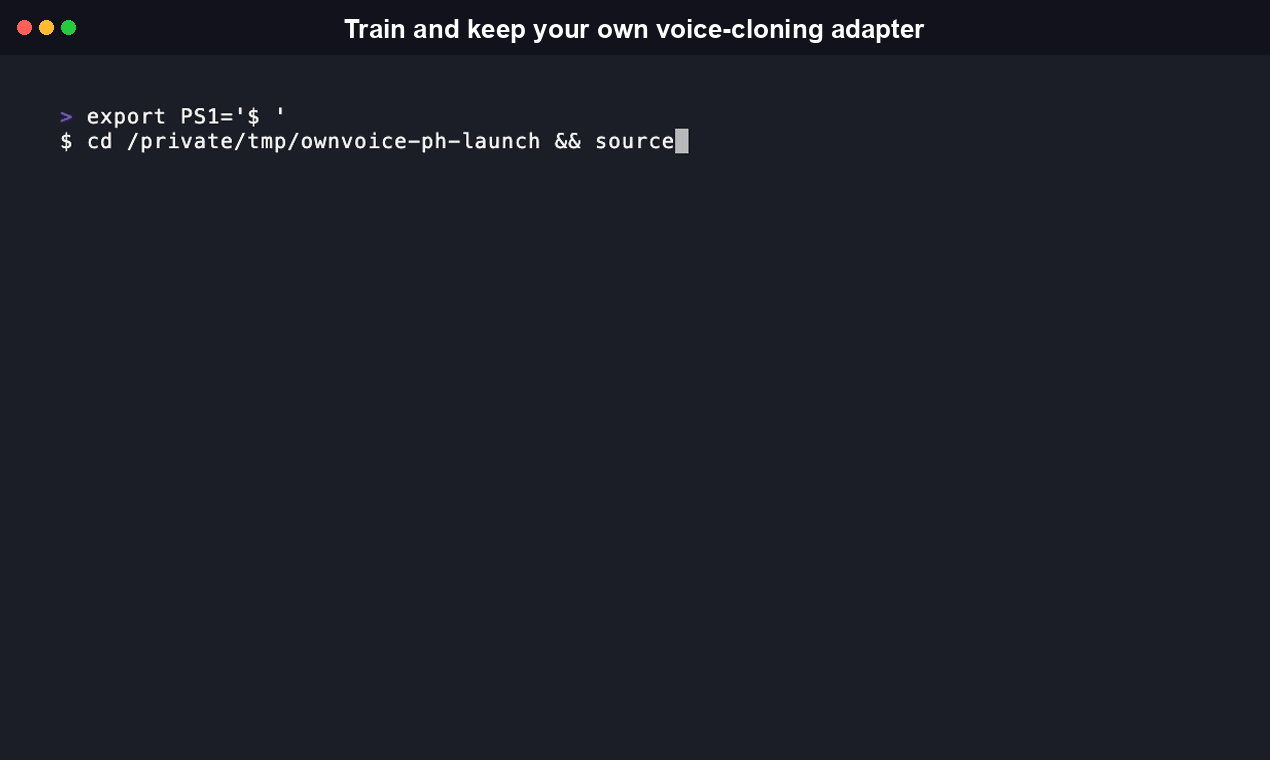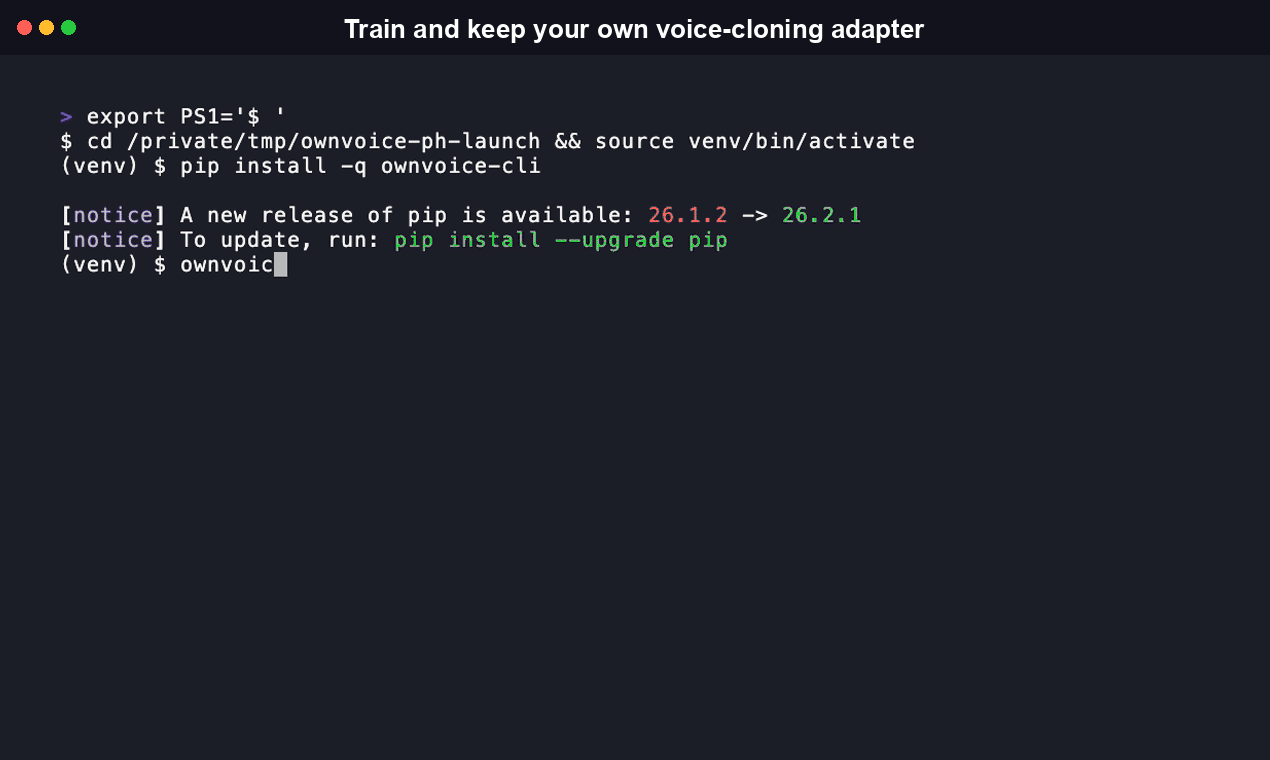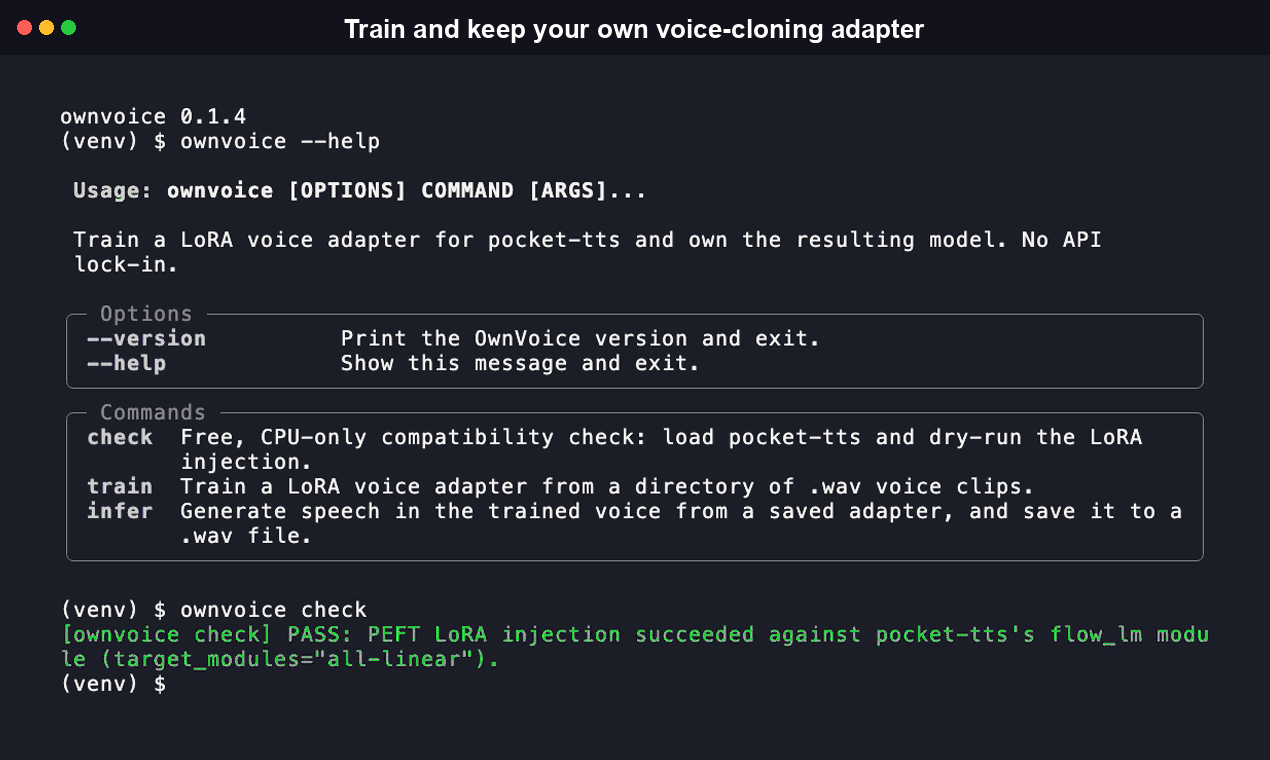
1. ownvoice check:免费的首日验证
在录制任何内容或租用 GPU 之前,请确认 PEFT 的 LoRA 注入确实适用于 pocket-tts 的真实模型结构。整个过程完全免费:仅使用 CPU,不训练,也不需要 GPU。
$ ownvoice check
[ownvoice check] PASS: PEFT LoRA injection succeeded against pocket-tts's flow_lm module (target_modules="all-linear").
如果失败,OwnVoice 会打印模型的真实模块树,而不是原始堆栈跟踪,这样你就能确切地看到哪里不匹配,并准确报告问题:
$ ownvoice check
[ownvoice check] FAIL: PEFT LoRA injection failed against pocket-tts's flow_lm module structure: <error detail>. Please post an honest blocker (this error plus the module tree above) as a comment on https://github.com/kyutai-labs/pocket-tts/issues/30 rather than working around it silently, that issue is exactly where this gap needs to be visible.

Module tree (for debugging / for the issue #30 blocker post):
<root>: FlowLMModel
input_linear: Linear
transformer: StreamingTransformer
transformer.layers.0.self_attn.in_proj: Linear
transformer.layers.0.self_attn.out_proj: Linear
...
2. ownvoice train
录制 5 到 10 分钟你想要训练的语音的清晰音频(你自己的声音,并获得你自己的同意,参见同意与滥用),将其拆分为几个 .wav 片段并放在同一目录中,然后将该目录提供给 OwnVoice:
$ ownvoice train --voice-clips ./my-voice-clips
[ownvoice train] USABLE ADAPTER
Usable adapter (similarity 0.812 >= 0.75). Try it now:
  ownvoice infer --adapter ownvoice-adapter/adapter.safetensors --text "This is my own voice, trained with OwnVoice."
只有 --voice-clips 是必填项。其他所有标志都有合理的默认值(详见下文的完整 CLI 参考)。
即使运行完成但未达到相似度门槛,也仍会以退出码 0 结束。这是带有明确下一步建议的结果,而非崩溃:
$ ownvoice train --voice-clips ./my-voice-clips
[ownvoice train] BELOW THRESHOLD
Below threshold (similarity 0.612 < 0.75). The adapter was still saved, try more/cleaner voice clips, more epochs, or a higher --lora-rank, then re-run. You can still listen to it:
  ownvoice infer --adapter ownvoice-adapter/adapter.safetensors --text "This is my own voice, trained with OwnVoice."
只有数据加载问题(没有可用片段)或捕获到的 PEFT 注入失败才会以非零状态退出。运行完成后始终会在输出目录中写入 adapter.safetensors 和 metadata.json(训练配置、相似度分数和时间戳):这两个文件由你保留,无需与服务器通信即可再次使用。
3. ownvoice infer
$ ownvoice infer --adapter ownvoice-adapter/adapter.safetensors --text "Hello, this is my own voice."
[ownvoice infer] Wrote ownvoice-output.wav
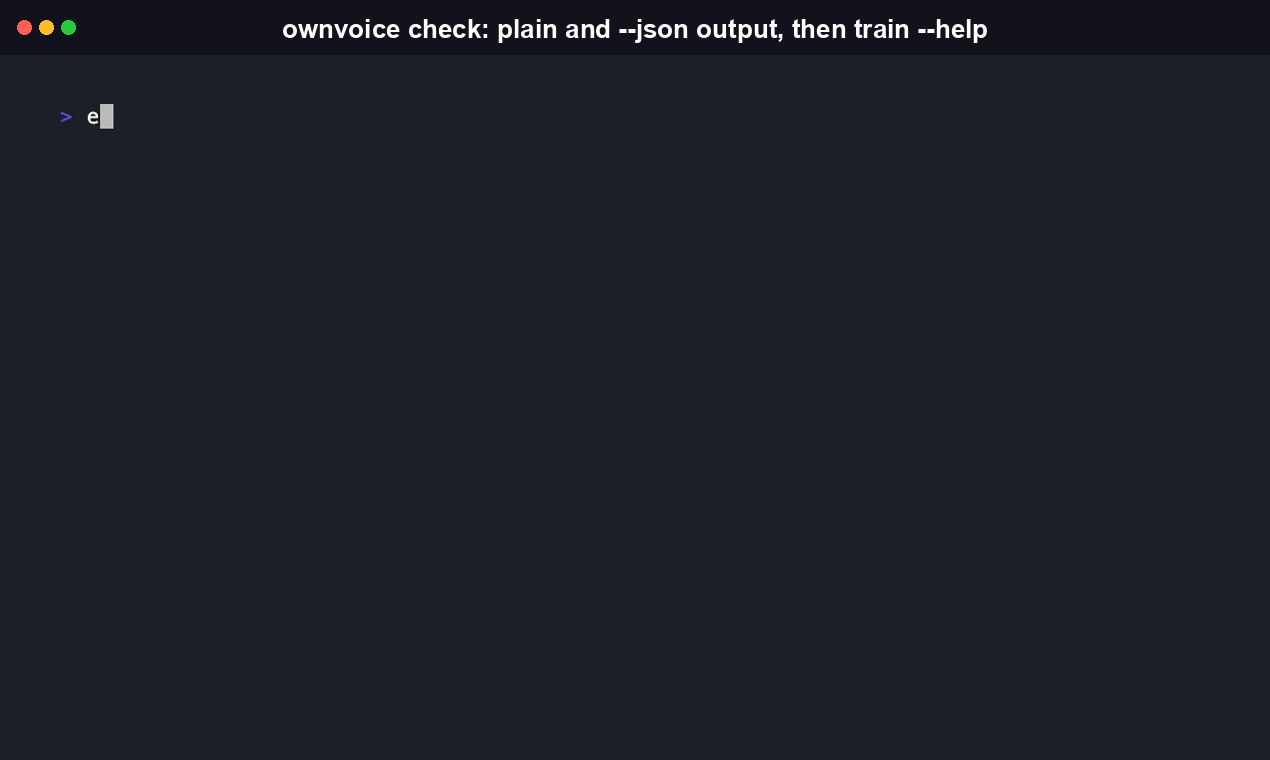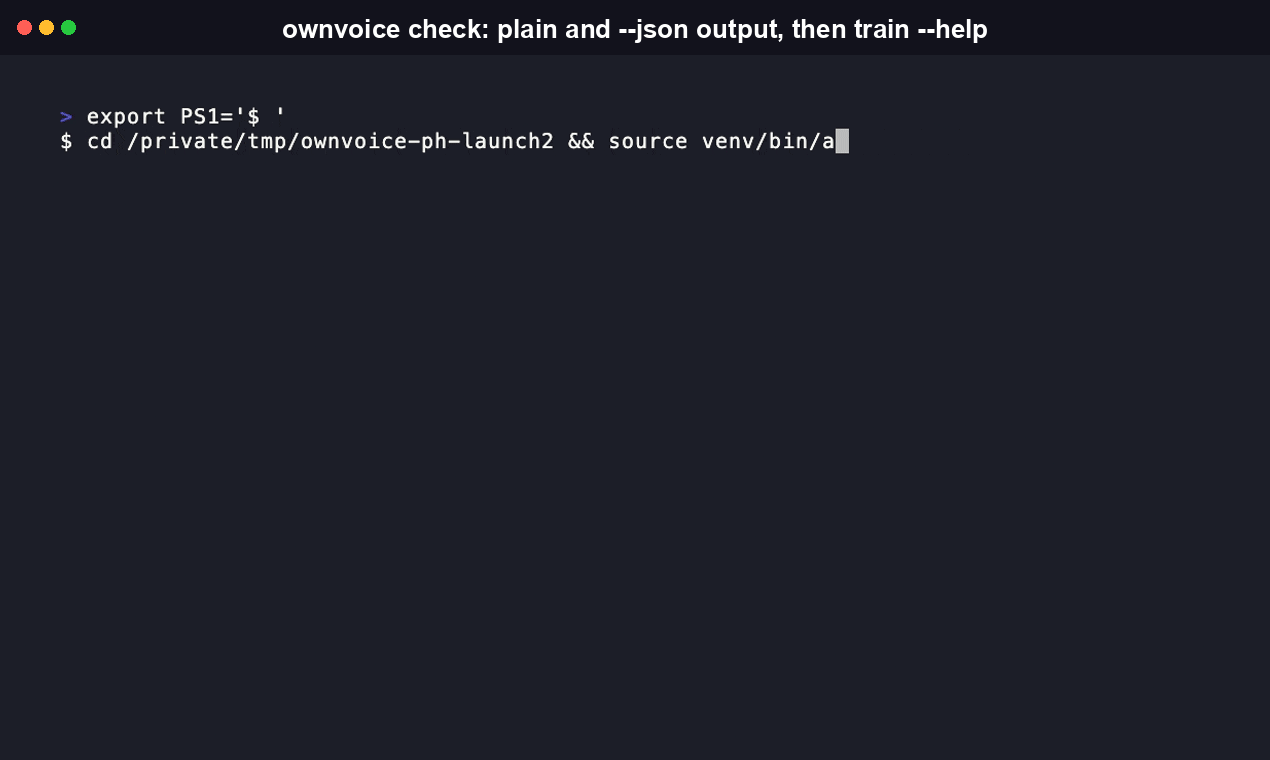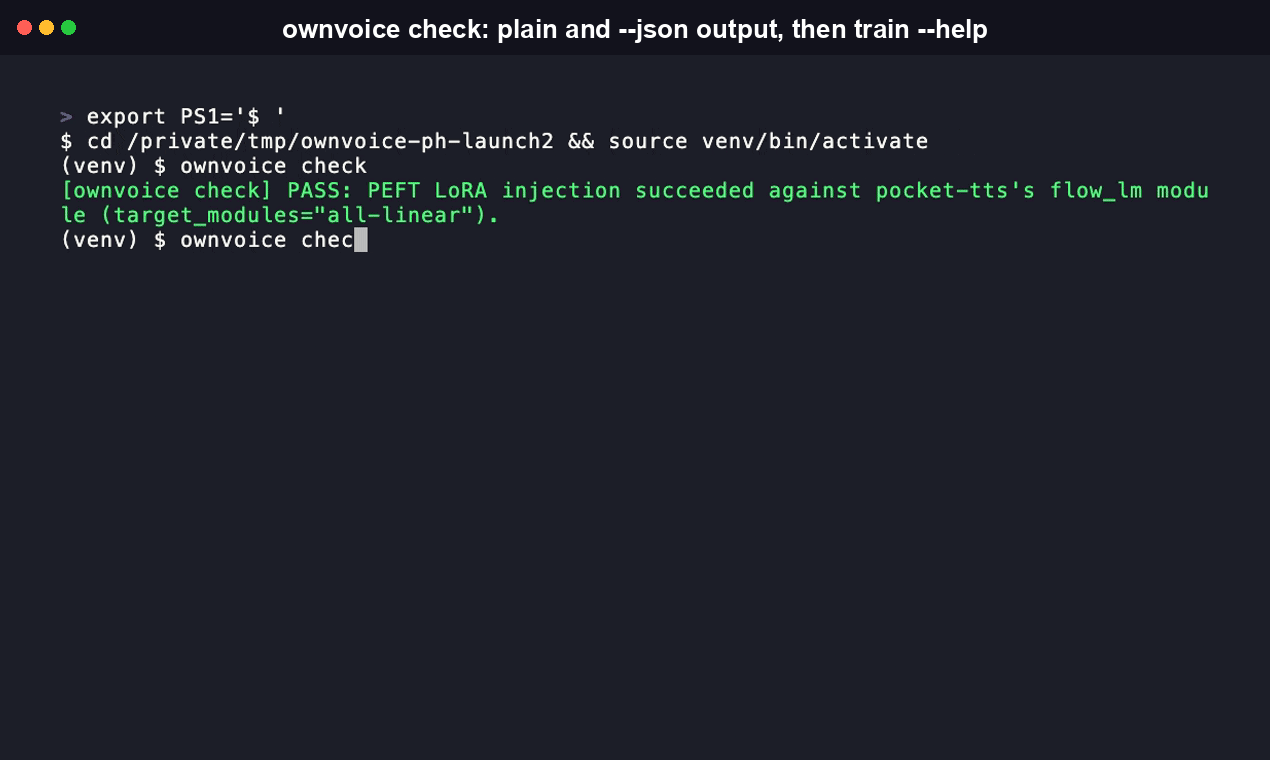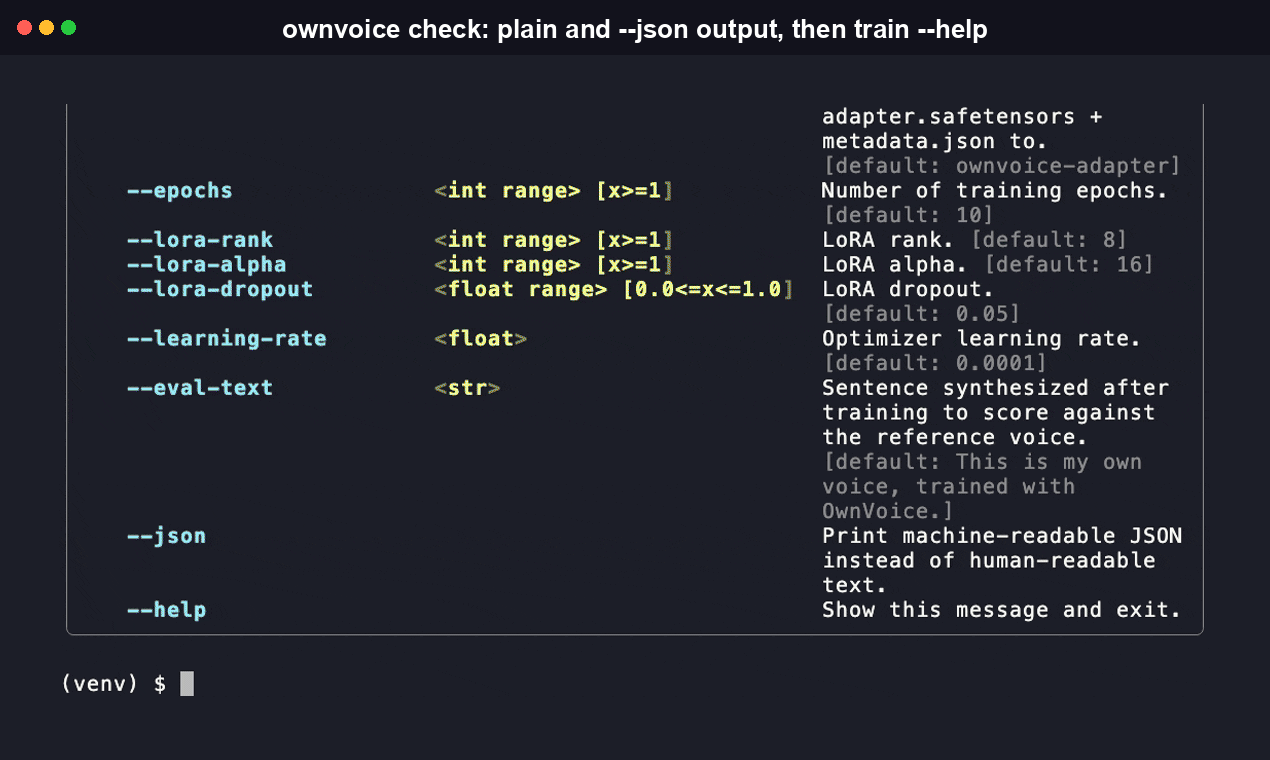
每个子命令也支持 --json,用于输出结构化、机器可解析的内容。如果脚本或 Agent 以编程方式调用 ownvoice,而不是由人员阅读终端输出,这种模式会很有用:
$ ownvoice check --json
{"success": true, "message": "PEFT LoRA injection succeeded against pocket-tts's flow_lm module (target_modules=\"all-linear\").", "module_tree": null}
CLI 参考
以下参考内容直接摘自各子命令实际的 --help 输出(PyPI 上的 ownvoice-cli 0.1.2)。
全局
ownvoice [OPTIONS] COMMAND [ARGS]...
| 标志 | 描述 |
|---|---|
--version | 打印 OwnVoice 版本并退出。 |
--help | 显示帮助信息并退出。 |
ownvoice check
免费的纯 CPU 兼容性检查:加载 pocket-tts 并试运行 LoRA 注入。无需 GPU,也无需训练。
| 标志 | 描述 |
|---|---|
--json | 输出机器可读的 JSON,而非人类可读的文本。 |
--help | 显示帮助信息并退出。 |
ownvoice train
使用 .wav 语音片段目录训练 LoRA 语音适配器。仅需提供 --voice-clips。
| 标志 | 类型 | 默认值 | 描述 |
|---|---|---|---|
--voice-clips | 目录,必需 | – | 用于训练的 .wav 语音片段录音目录。 |
--out | 路径 | ownvoice-adapter | 写入 adapter.safetensors 和 metadata.json 的目录。 |
--epochs | int,>=1 | 10 | 训练轮数。 |
--lora-rank | int,>=1 | 8 | LoRA 秩。 |
--lora-alpha | int,>=1 | 16 | LoRA alpha。 |
--lora-dropout | float,0.0–1.0 | 0.05 | LoRA dropout。 |
--learning-rate | float | 0.0001 | 优化器学习率。 |
--eval-text | string | "This is my own voice, trained with OwnVoice." | 训练后合成的句子,用于与参考语音进行评分。 |
--json | 标志 | 关闭 | 输出机器可读的 JSON,而非人类可读的文本。 |
--help | 标志 | – | 显示帮助信息并退出。 |
ownvoice infer
使用已保存的适配器生成训练语音,并保存为 .wav 文件。
| 标志 | 类型 | 默认值 | 描述 |
|---|---|---|---|
--adapter | 路径,必需 | – | 已训练的 adapter.safetensors 文件路径。 |
--text | string,必需 | – | 使用训练语音合成的文本。 |
--out | 路径 | ownvoice-output.wav | 输出 .wav 文件路径。 |
--reference-audio | 路径 | 已录制的参考音频 | 覆盖 OwnVoice 在训练时记录到 metadata.json 中的参考片段。 |
--json | 标志 | 关闭 | 输出机器可读的 JSON,而非人类可读的文本。 |
--help | 标志 | – | 显示帮助信息并退出。 |
功能
- 在为 GPU 花钱之前,免费检查兼容性。
ownvoice check会加载 pocket-tts,并在 CPU 上针对其真实的flow_lm模块树试运行 PEFT 的 LoRA 注入,不进行训练。如果失败,它会输出实际模块树,而不是堆栈跟踪,这样就能报告真正的阻碍,而不是让问题悄无声息地发生。 - 提供客观的可用/不可用信号,而不是猜测。 每次训练运行都会将生成的测试语句重采样为 16kHz 单声道,并使用 Resemblyzer 计算其与参考音频片段的余弦相似度。
0.75或更高会标记为USABLE ADAPTER;低于此值则标记为BELOW THRESHOLD。这是明确标记的结果,不是崩溃;无论哪种情况,退出代码都是0。 - 每个子命令都支持结构化输出。
check、train和infer都接受--json,返回一个可供机器解析的对象,而不是带颜色的终端文本:已直接确认,ownvoice check --json会返回{"success": true, "message": "...", "module_tree": null}。 - 只需保留两个文件,无需与服务往返通信。 训练完成后,会将
adapter.safetensors(训练后的权重,默认--lora-rank 8时为几 MB)和metadata.json(完整训练配置、相似度分数、每轮损失和时间戳)写入磁盘。之后随时可以用ownvoice infer加载它们,无需网络调用。 - 有意只支持一个基础模型。 OwnVoice 仅封装 pocket-tts。它没有用于第二个基础模型的抽象层,这与代码库自身“按设计只面向单一目标”的架构说明一致:LoRA 注入路径(针对 pocket-tts 真实
flow_lm层使用target_modules="all-linear")保持精确,而非通用化。
工作原理
voice clips (wav)
      |
      v
  data.py   --validate format/duration-->  clean clip set
      |
      v
  train.py  --PEFT LoRA (target_modules="all-linear")--> adapter.safetensors + metadata.json
      |
      v
  infer.py  --generate test utterance--> synthesized audio
      |
      v
  score.py  --resample to 16kHz mono--> Resemblyzer cosine similarity
      |
      v
  CLI report (>= 0.75 = usable adapter, below triggers a labeled next-step message)
ownvoice/data.py 会加载并验证语音片段目录。ownvoice/train.py 会加载 pocket-tts 的冻结基础模型,使用 PEFT(target_modules="all-linear")将 LoRA 适配器注入其 flow_lm Transformer,运行训练循环,并保存适配器和清单。ownvoice/infer.py 会将已保存的适配器重新加载到基础模型上并生成语音。ownvoice/score.py 会使用 torchaudio.transforms.Resample 将音频重采样为 16kHz 单声道,并使用 Resemblyzer 计算说话人相似度。
OwnVoice 有意仅支持单一模型:它只封装 pocket-tts,不为第二个基础模型提供抽象层,因为这不在范围内。
与同类工具的首次可用环境配置耗时对比
| 工具 | 首次配置出可用环境的耗时 | 显著的设计选择 | 来源 |
|---|---|---|---|
| kokoro-tts | 少于 2 分钟 | pip install git+...,CLI 可立即合成,无微调功能 | kokoro-tts README |
| Unsloth | 启动一次运行少于 1 分钟 | 一条命令即可开始训练(uv pip install) | Unsloth 文档 |
| pocket-tts | 数秒 | 使用 --voice <wav> 进行零样本克隆,不提供训练功能 | pocket-tts README |
| OwnVoice | 少于 2 分钟即可确认训练环境可用 | ownvoice check:免费、即时、仅用 CPU,在为 GPU 花钱之前验证 PEFT 兼容性 | 本仓库 |
OwnVoice 自身的训练运行确实需要 GPU 时间,并且会如实标明,不会用虚假的进度条掩盖这一点;这与 Unsloth 所遵循的同类工具惯例一致。OwnVoice 将少于 2 分钟压缩的是此前的所有步骤:确认你的环境确实可用。
OwnVoice 存在的意义
pocket-tts 是一款非常出色、采用 MIT 许可证、可在 CPU 上运行的本地文本转语音模型,由 Kyutai 开发。其维护者已明确表示,短期内不会提供微调代码:在 issue #30 中,维护者 @vvolhejn 写道:“我们近期不打算发布 TTS 和 STT 模型的微调代码。”该讨论帖有 18 人表达了对这项功能的需求。OwnVoice 是一款小巧、独立的 CLI,专门填补这一空缺:提供几段自己的语音录音,它就会训练一个由你自行保留和运行的 LoRA 适配器。
它不是托管服务,不收费,也不跟踪使用情况。它包含训练脚本、推理脚本和评分脚本,并通过三个 CLI 命令将它们整合起来。
OwnVoice 不是什么
pocket-tts 开箱即提供零样本语音克隆:将 .wav 文件传给 --voice(或在 Python 中调用 get_state_for_audio_prompt()),无需任何训练步骤就能克隆该声音。如果这就是你需要的功能,直接使用 pocket-tts 即可,它更简单、速度也更快。
OwnVoice 面向的是更具体的需求:将某种声音永久融入训练后的权重中,这样生成语音时就不再依赖于分发或在运行时重新处理参考音频片段;而且,与单片段零样本嵌入通常产生的结果相比(这是基于训练目标的预期,尚未经过大规模独立基准测试),多次生成的输出会更加一致。这正是 issue #30 中那 18 位参与者所描述的特定空缺,也是 OwnVoice 在 pocket-tts 已有的出色功能之上唯一新增的能力。
同意与滥用
此工具会使用你有权使用的音频克隆声音。未经他人明确同意,请勿克隆他人或公众人物的声音。OwnVoice 在此版本中不提供批量生成或自动扩展功能,以限制任何单次滥用造成的影响范围。
实现状态
这是一个刚起步的早期版本。ownvoice check、CLI 参数解析、语音片段验证、相似度评分算法,以及适配器/清单的保存和加载流程均已实现,并由测试套件(pytest)覆盖。我们对照 pocket-tts 的真实源码,从结构上验证了 LoRA 注入,随后也在实际环境中确认成功:针对实际下载的 pocket-tts 权重,在 CPU 上运行了 ownvoice check,PEFT 的 target_modules="all-linear" 注入确实成功了。此后,完整的训练和生成流程也经过了端到端的实际验证:使用已加载的 pocket-tts 权重进行真实的 2 轮 LoRA 训练,得到了有限且非 NaN 的流匹配损失;生成的适配器通过 ownvoice infer 生成了真实、非静音的 .wav 文件。这次验证发现并修复了朴素方案中的两个实际问题:(1)pocket-tts 发布到 PyPI 的推理专用软件包实际上并未提供通过 FlowLMModel.forward() 计算训练损失的方法,尽管其自身文档字符串声称可以,因此 OwnVoice 改为直接通过 flow_lm 的实际子模块计算流匹配损失;(2)在调用 generate_audio() 前将 base_model.flow_lm 替换为 PEFT 包装后的模型,会破坏 pocket-tts 内部的 KV 缓存状态查找——完全不需要替换,因为 PEFT 的 LoRA 注入已经原地修改了 base_model.flow_lm。还有一个需要了解的实际外部限制:公开可下载的 pocket-tts 权重(kyutai/pocket-tts-without-voice-cloning)会直接拒绝原始参考片段路径/URL;OwnVoice 通过自行预加载并重采样片段来绕过这一限制,但该检查点的声音克隆保真度属于基础模型的已知限制,并非 OwnVoice 的缺陷——如需 kyutai 的最佳质量克隆权重,请在 huggingface.co/kyutai/pocket-tts 申请受限访问权限。请自行运行 ownvoice check 并阅读源码,再决定是否信任它;对于如此早期的项目,这正是应有的审慎态度。
常见问题
OwnVoice 是什么?为什么不直接使用 pocket-tts?
OwnVoice 会为 pocket-tts 训练 LoRA 适配器,并将其保存到你自己的磁盘上,文件为 adapter.safetensors 和 metadata.json。之所以开发它,是因为 pocket-tts 的维护者表示,微调代码不在近期规划中(见 issue #30)。训练好适配器后,使用它就再也不需要 OwnVoice 了:ownvoice infer 只需将适配器加载回基础模型即可。
这与 pocket-tts 内置的 --voice <wav> 零样本克隆有何不同?
pocket-tts 本身就能通过单个参考音频片段克隆声音,无需训练步骤;可以在 CLI 中使用 --voice <wav>,或在 Python 中使用 get_state_for_audio_prompt()。OwnVoice 以速度换取一个永久训练好的适配器,因此生成时不再需要随身携带参考音频片段;而且(这是基于训练目标的判断,尚未经过大规模独立基准测试)与单个音频片段的零样本嵌入相比,重复生成的输出往往更加一致。如果零样本克隆已满足你的使用需求,直接使用 pocket-tts 即可,它更简单、更快捷。
安装需要什么?能在 Apple Silicon 或仅配备 CPU 的机器上运行吗?
需要 Python 3.11 或更高版本,然后运行 pip install ownvoice-cli。ownvoice check 和 ownvoice infer 完全不需要 GPU,在 Apple Silicon 或仅配备 CPU 的机器上都能正常运行,这与 pocket-tts 自身支持 CPU 的设计一致。ownvoice train 也能在 CPU 上运行,只是每个 epoch 耗时更长;如果你有 NVIDIA GPU 并希望加快训练速度,请先安装 CUDA 版 PyTorch。
OwnVoice 与 kokoro-tts 和 Unsloth 相比如何?
kokoro-tts 能让你在不到 2 分钟内开始语音合成,但完全没有微调步骤。Unsloth 能让你在不到 1 分钟内开始训练,但它是通用的大模型微调框架,并非专用于 TTS。OwnVoice 的适用范围比这两者都窄:只有一个基础模型(仅限 pocket-tts)和一个用途(训练声音适配器),此外还提供免费的 ownvoice check 步骤,可在你为 GPU 花费任何费用之前,确认 PEFT 的 LoRA 注入在你的环境中确实可用;这两种工具都没有对应功能。
训练已完成,但显示“BELOW THRESHOLD”,这是错误吗?
不是。这是带有标签的结果,不是崩溃;无论结果如何,ownvoice train 都会以 0 退出。如果低于 0.75 的余弦相似度门槛,适配器仍会保存到磁盘,OwnVoice 会明确建议你尝试更多或更干净的声音片段、增加 epoch 数,或提高 --lora-rank,然后重新运行。只有两种情况会导致命令以非零状态退出:没有可加载的可用音频片段,或捕获到 PEFT 注入失败。
我可以将 OwnVoice 及其生成的适配器用于商业用途吗?
OwnVoice 自身的代码采用 MIT 许可证(见 LICENSE)。pocket-tts 的代码包也采用 MIT 许可证,但 OwnVoice 实际下载并用于训练的模型权重 kyutai/pocket-tts-without-voice-cloning 和受限访问的 kyutai/pocket-tts 采用的是 CC-BY-4.0 许可证,而非 MIT。CC-BY-4.0 允许商业使用,但要求注明 Kyutai。由于你训练的任何适配器都源自这些权重,在发布基于它构建的商业产品之前,请确认符合这一署名要求。
我实际上可以克隆谁的声音? 只能克隆你自己的声音,或已明确且经核实同意的他人声音;未经同意,绝不能克隆公众人物的声音。请参阅上文的同意与滥用。此版本的 OwnVoice 不包含批量生成或自动扩缩功能,因此任何单次滥用造成的影响范围都较小。
MCP 服务
OwnVoice 提供了一个 Model Context Protocol 服务,因此兼容 MCP 的 Agent 可以直接通过 stdio 调用 ownvoice check / train / infer,无需通过 shell 执行命令并自行解析文本。
pip install "ownvoice-cli[mcp]"
将其添加到 MCP 客户端的配置中(例如 Claude Desktop 的 claude_desktop_config.json):
{
  "mcpServers": {
    "ownvoice": {
      "command": "ownvoice-mcp"
    }
  }
}
该服务仅提供一个工具:run(args: list[str]) -> dict。它会使用给定的 argv 调用真正的 ownvoice CLI,并以结构化 JSON 返回结果,因此调用方获得的行为与面向用户的 CLI 完全相同,包括 --json 模式。例如,调用 run(args=["check", "--json"]) 会返回 {"result": {"success": true, "message": "...", "module_tree": null}}。非零退出码、启动失败或子进程超时,都会以 {"error": "..."} 的形式返回,而不会抛出异常。
贡献
欢迎提交问题和 PR,项目全程采用 MIT 许可证。如果你想帮助弥补本项目所针对的实际差距,最有价值的贡献是向上游提交一个轻量级 LoRA 适配器训练脚本,贡献给 kyutai-labs/pocket-tts 项目本身;相关讨论见 issue #30。
许可证
MIT。详见 LICENSE。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。