
关于 workloadtruth
WorkloadTruth 是一款 CLI 和 MCP 服务,可根据 GPU 遥测将任务分类为训练、推理或空闲,供运维人员和 Agent 核验任务类型。它采用可检查的规则,并支持哈希链式本地审计日志。
主要功能
- 01基于遥测分类任务
- 02可检查的规则阈值
- 03持续监控与哈希链日志
- 04Synthetic 与 NVML 后端
- 05规避鲁棒性基准测试
适用场景
- 01核对 GPU 任务是否符合申报类型
- 02监测推理任务是否转为训练
- 03检查并验证本地分类记录
MCP 相关
stdio MCP 服务提供任务分类、运行合成数据规避基准测试及验证本地审计日志的工具。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
WorkloadTruth




安装 • 快速入门 • CLI 参考 • 比较 • 常见问题
仅凭遥测数据,将 GPU 工作负载分类为 TRAINING、INFERENCE 或 IDLE。无需更改工作负载代码,也无需作业自行申报标签。
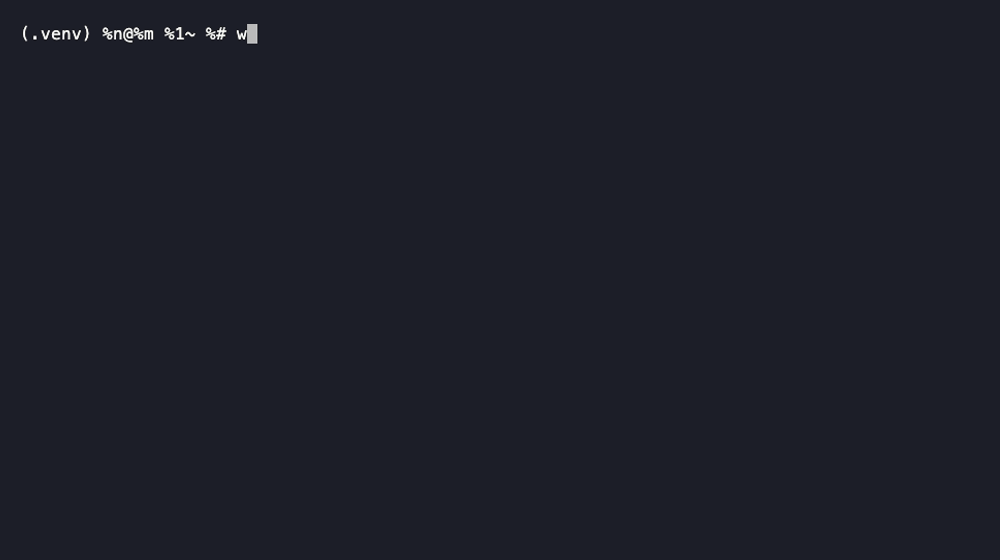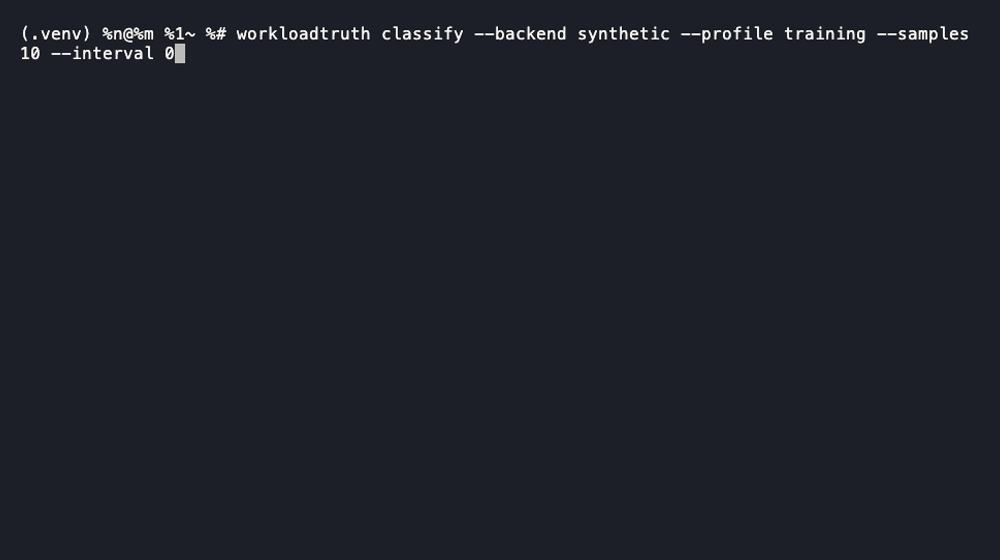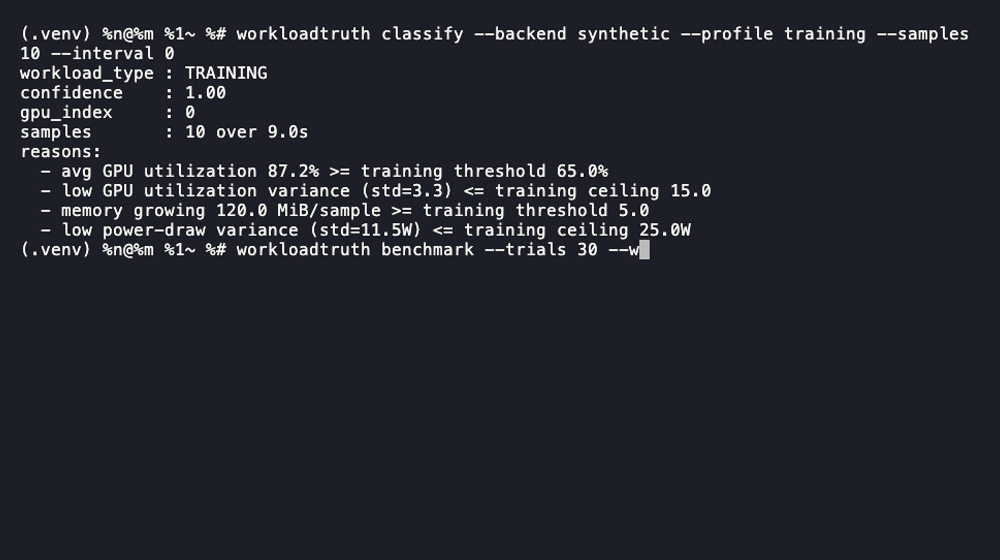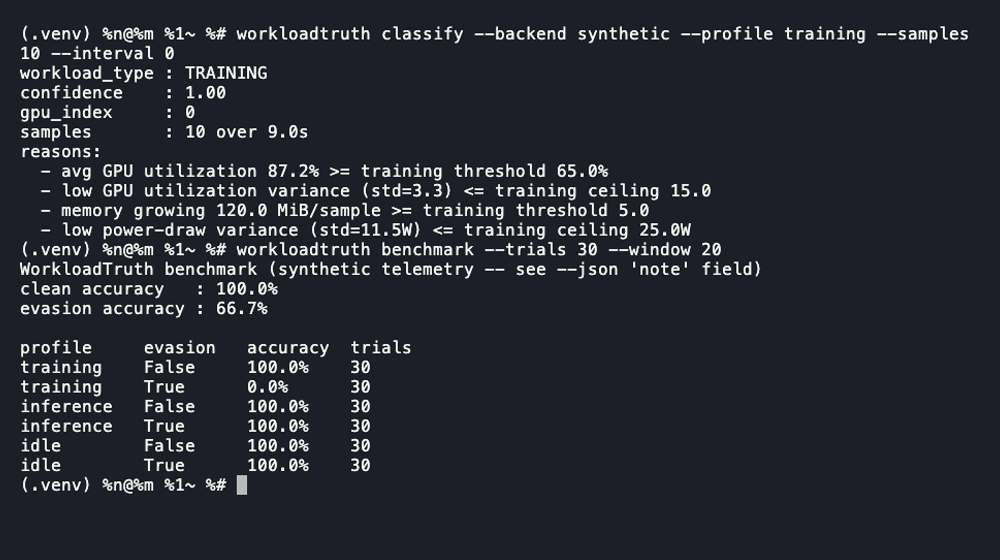
目前常用的所有 GPU 调度器,包括 run:ai、Slurm 和 Kubernetes GPU Operator,都会要求你在提交作业时申报它属于训练还是推理。但它们都不会核验。WorkloadTruth 会读取 GPU 遥测数据(利用率、内存模式、功耗),并独立判断作业类型,因此错误标记或行为异常的作业不会被忽略。
安装
# Real NVIDIA GPU telemetry (requires an NVIDIA driver on the host)
pip install "workloadtruth-cli[nvml]"

# Try it without a GPU, using the synthetic backend
pip install workloadtruth-cli

# npm launcher (thin wrapper around the PyPI package, see "Why two registries")
npx workloadtruth-cli --help
说明
npm 包是一个启动器,并非独立安装包。
npx workloadtruth-cli会从 PATH 执行真正的workloadtruth二进制文件,因此必须先安装 PyPI 包(pip install workloadtruth-cli)。
快速入门
# No GPU required. Classify a synthetic "training" telemetry trace.
$ workloadtruth classify --backend synthetic --profile training --samples 10 --interval 0
workload_type : TRAINING
confidence    : 1.00
gpu_index     : 0
samples       : 10 over 9.0s
reasons:
  - avg GPU utilization 87.8% >= training threshold 65.0%
  - low GPU utilization variance (std=3.4) <= training ceiling 15.0
  - memory growing 120.0 MiB/sample >= training threshold 5.0
  - low power-draw variance (std=9.4W) <= training ceiling 25.0W

# Real hardware
$ workloadtruth classify --backend nvml --samples 10 --interval 1 --json
在每条命令中添加 --json,即可切换为便于脚本和 Agent 使用的机器可读输出。
快速概览
- **适用场景:**发现成本分配错误的 GPU 作业(按低优先级“推理”计费、实际却在运行完整训练的作业),以及未经授权的工作负载变更(未经批准,推理端点开始利用实时流量进行训练)
- **不适用场景:**合规或监管审计工具。目前没有法规要求进行此类监控,详见下文的WorkloadTruth 不是什么
- **已有研究:**基于并引用了 arXiv:2606.19262(ICML 2026),详见与先前研究的关系
分类原理
WorkloadTruth 目前仅提供基于规则的分类器:针对从遥测时间窗口提取的四项特征(GPU 利用率的平均值和方差、内存增长斜率、功耗的平均值和方差)设定了一组公开且可检查的阈值。每个阈值都以具名常量的形式定义在 src/workloadtruth/classifier/rules.py 中,并附有解释其设计依据的注释。没有任何黑箱。
--experimental(基于 ML 的分类器)目前作为一个标志存在,但会明确报错并解释原因,而不会提供虚假的结果。arXiv:2606.19262 中训练的模型和数据集从未公开,而且本项目的构建环境中没有 NVIDIA GPU,无法收集真实训练数据。只有在真实且公开的数据集上完成训练,并经独立验证证明其优于基于规则的基线后,才会在此提供 ML 分类器,不会提前推出。
基准测试
workloadtruth benchmark 用于衡量分类器针对有文档记录的合成 GPU 遥测轨迹的准确率(具体配置参数请参见 synthetic_backend.py),既测试未受干扰的情况,也测试经过刻意规避转换后的情况。该转换模拟操作人员将训练任务伪装成推理任务的做法:限制利用率波动、压平内存增长,并插入人为的空闲间隔。
此测试使用的是合成数据,而非 NVIDIA 实时硬件数据,因此不能直接与 arXiv:2606.19262 的真实硬件数据进行比较。 以下分别列出两者的结果,并排对比,不会混合成一个数值。
| arXiv:2606.19262(真实硬件,NVML) | WorkloadTruth(合成轨迹,每单元 300 次试验) | |
|---|---|---|
| 未受干扰时的准确率 | 98.2% | 100.0% |
| 规避情况下的准确率 | 43-87% | 总体 66.7% |
总体规避准确率掩盖了真正的发现。按工作负载类型拆分后可以看到,WorkloadTruth 的基于规则的分类器目前会被规避型训练工作负载完全欺骗(准确率为 0%),但对规避型推理和空闲轨迹仍能保持准确(两者均为 100%)。仅限制 GPU 利用率,就足以让该分类器目前将训练任务判定为推理任务。
| 配置文件 | 未受干扰时的准确率 | 规避情况下的准确率 |
|---|---|---|
| 训练 | 100.0% | 0.0% |
| 推理 | 100.0% | 100.0% |
| 空闲 | 100.0% | 100.0% |
这正是该基准测试套件要揭示和跟踪的具体差距,而不是脚注。仅关注利用率方差的基于规则的分类器很容易被规避。通过融合多种信号来弥补这一差距,或在数据充足后使用真正训练出来的分类器,是未来的工作路线图,而非已经解决的问题。你可以自行复现:
workloadtruth benchmark --trials 300 --window 30 --json
CLI 参考
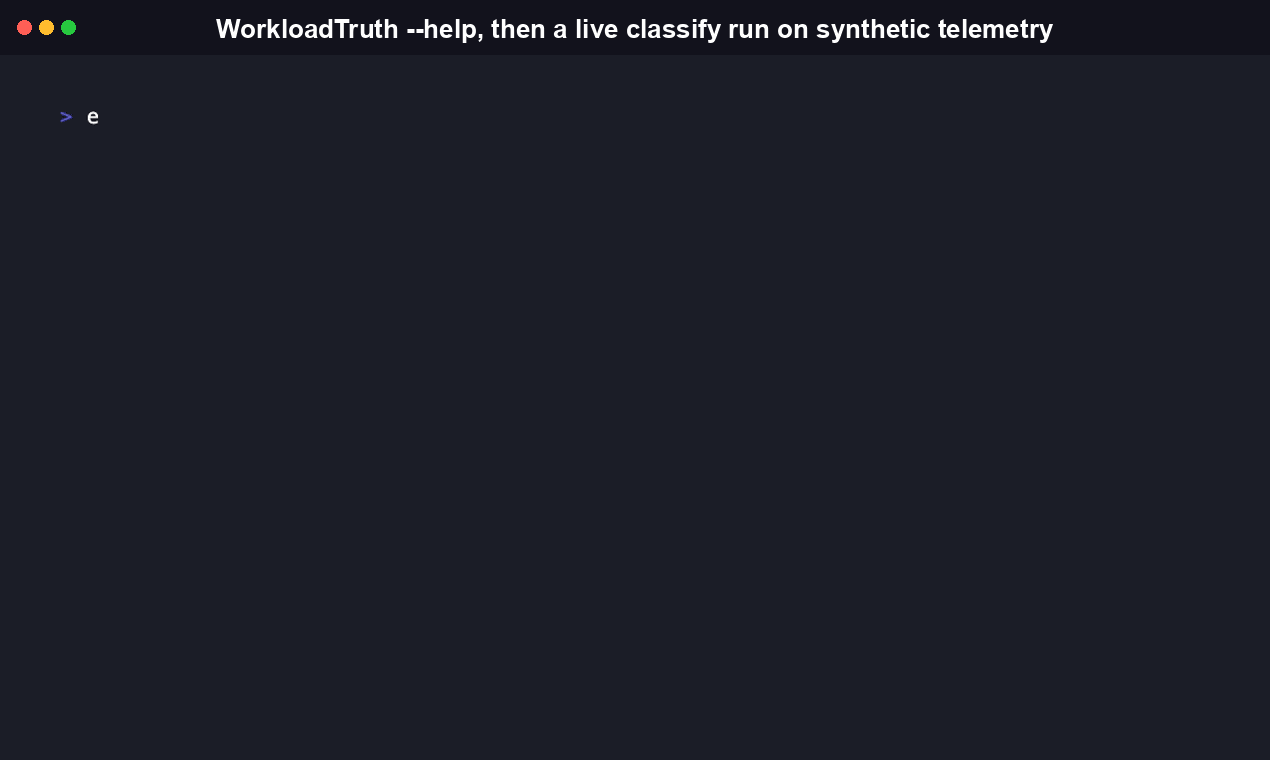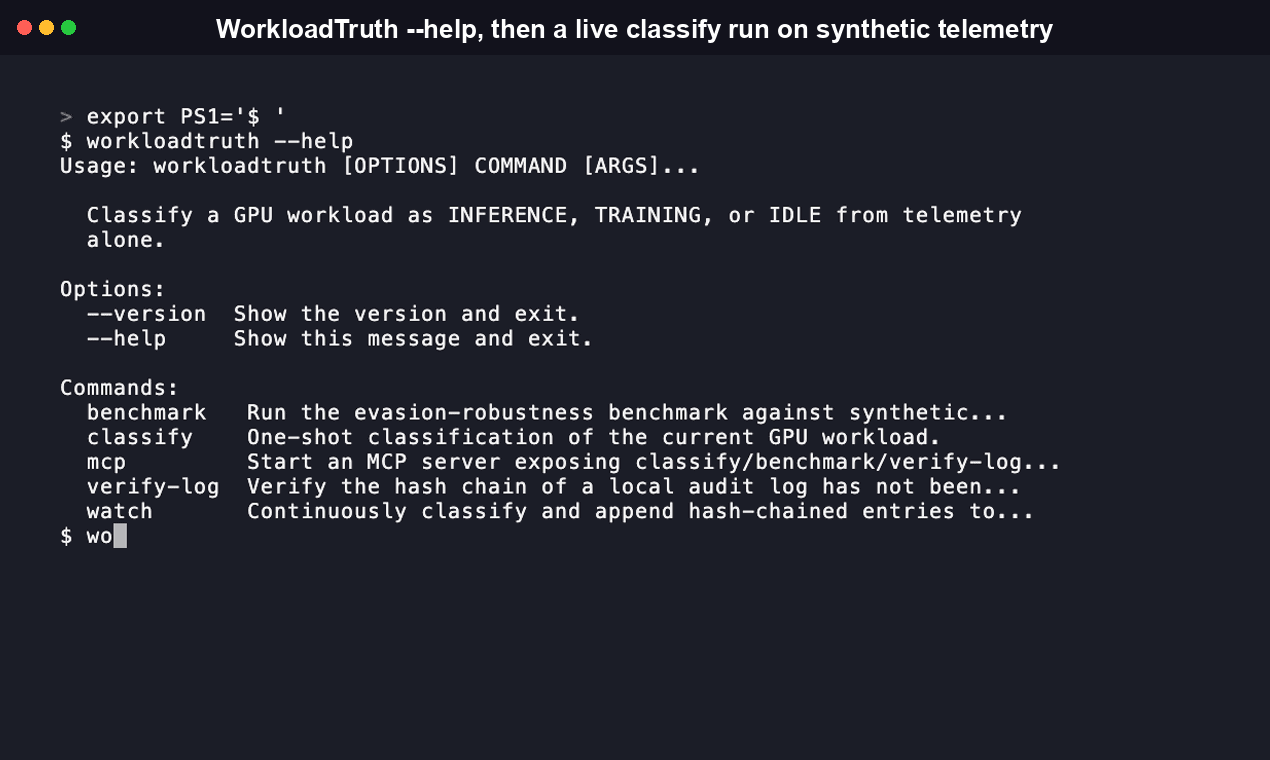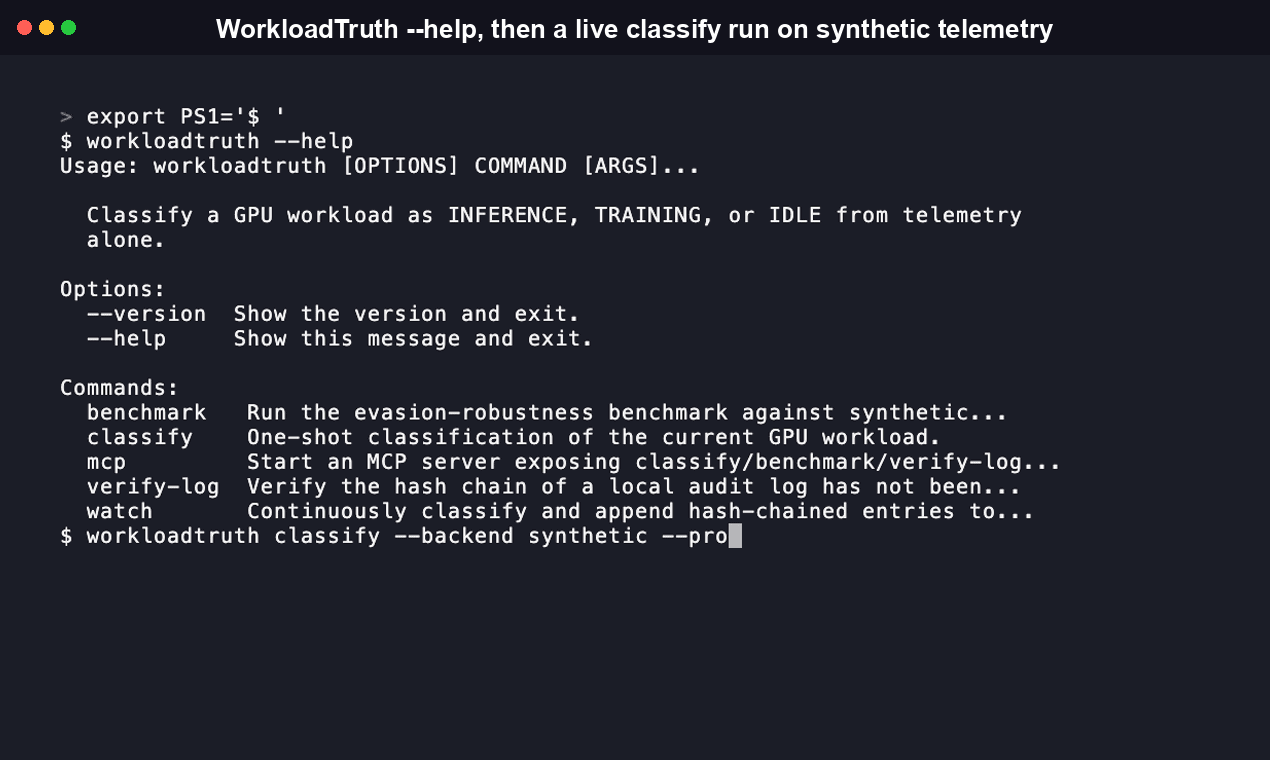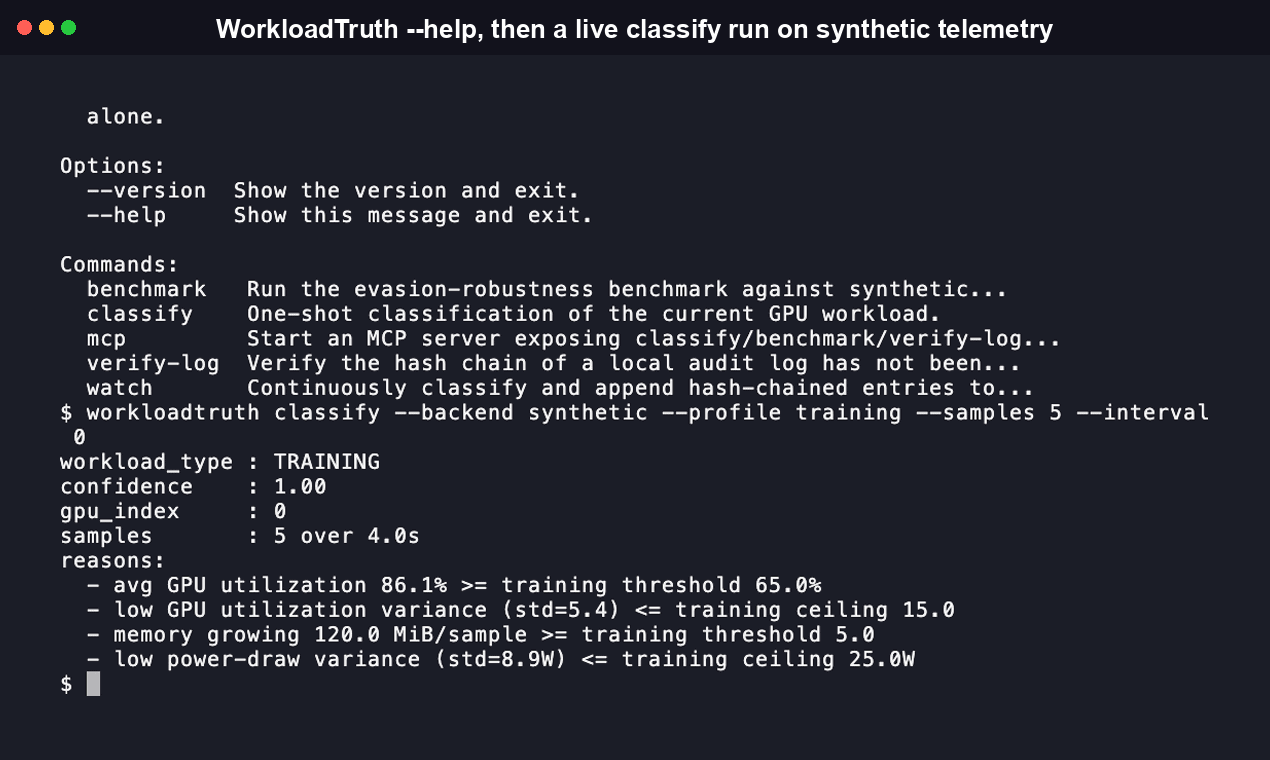
$ workloadtruth --help
Usage: workloadtruth [OPTIONS] COMMAND [ARGS]...

  Classify a GPU workload as INFERENCE, TRAINING, or IDLE from telemetry
  alone.

Options:
  --version  Show the version and exit.
  --help     Show this message and exit.

Commands:
  benchmark   Run the evasion-robustness benchmark against synthetic...
  classify    One-shot classification of the current GPU workload.
  mcp         Start an MCP server exposing classify/benchmark/verify-log...
  verify-log  Verify the hash chain of a local audit log has not been...
  watch       Continuously classify and append hash-chained entries to...
| 命令 | 用途 |
|---|---|
classify | 一次性分类。--backend synthetic|nvml、--profile(仅限合成数据)、--gpu-index、--samples、--interval、--experimental(暂不可用)、--json。 |
watch | 持续分类;每个窗口都会向本地审计日志追加一条哈希链记录。--window(每个窗口的采样数)、--iterations(0 = 无限运行)、--log-file、--json。 |
benchmark | 运行规避鲁棒性基准测试(见上文)。--trials、--window、--json。 |
verify-log | 重新计算每条审计日志记录的哈希,并确认哈希链未遭篡改。--log-file、--json。 |
mcp | 启动一个 MCP 服务(stdio),提供可供 Agent 调用的工具 classify_workload、run_benchmark、verify_audit_log。--backend。要求使用 Python 3.10+ 执行 pip install "workloadtruth-cli[mcp]"(见下文)。 |
每条命令都支持 --json。完整标志参考:workloadtruth <command> --help。
MCP 服务
WorkloadTruth 提供一个 Model Context Protocol 服务,让 AI Agent(Claude、Cursor 或任何兼容 MCP 的客户端)无需人工手动调用 CLI,即可对 GPU 工作负载进行分类、运行规避鲁棒性基准测试并验证审计日志。
安装附加组件:
pip install "workloadtruth-cli[mcp]"
将其添加到 MCP 客户端的配置中(对于 Claude Desktop,配置文件为 claude_desktop_config.json)。服务通过 workloadtruth mcp 子命令启动,而不是通过单独的控制台脚本启动:
{
  "mcpServers": {
    "workloadtruth": {
      "command": "uvx",
      "args": ["--from", "workloadtruth-cli", "workloadtruth", "mcp"]
    }
  }
}
该服务通过 stdio 暴露三个工具:
classify_workload(backend="nvml", profile="training", gpu_index=0, samples=10, interval_seconds=1.0, write_to_audit_log=False):采集 GPU 遥测数据,并将其分类为TRAINING、INFERENCE或IDLE。backend可以是"nvml"(真实硬件)或"synthetic"(有文档记录的合成轨迹,无需 GPU)。还可选择将结果追加到哈希链式审计日志中。run_benchmark(trials=50, window=30):针对合成遥测数据运行规避鲁棒性基准测试,并返回各配置文件在干净条件和经过规避混淆的条件下的准确率。verify_audit_log(log_file="workloadtruth.log.jsonl"):重新推导本地审计日志的哈希链,并报告日志是否遭到篡改。
示例调用:在无需 GPU 的情况下,对合成训练轨迹进行分类:
classify_workload(backend="synthetic", profile="training", samples=10, interval_seconds=0)
-> {"workload_type": "TRAINING", "confidence": 1.0, "gpu_index": 0, ...}
传输方式为 stdio,因此无需托管任何内容:MCP 客户端会将 workloadtruth mcp 作为本地子进程启动。仓库根目录还提供了 .well-known/agent.json 清单,用于 A2A 风格的发现,其中列出了 CLI 和 MCP 接口以及提供这些接口的软件包。源代码:src/workloadtruth/mcp_server.py。
审计日志
每次分类窗口期间,workloadtruth watch 都会向 workloadtruth.log.jsonl 追加一条哈希链式记录。每条记录的哈希都涵盖其自身内容以及上一条记录的哈希,因此,事后任何编辑、重排或删除都会导致从该处开始的哈希链断裂。workloadtruth verify-log 会重新推导每个哈希,并报告第一个断开的链接(如果有)。
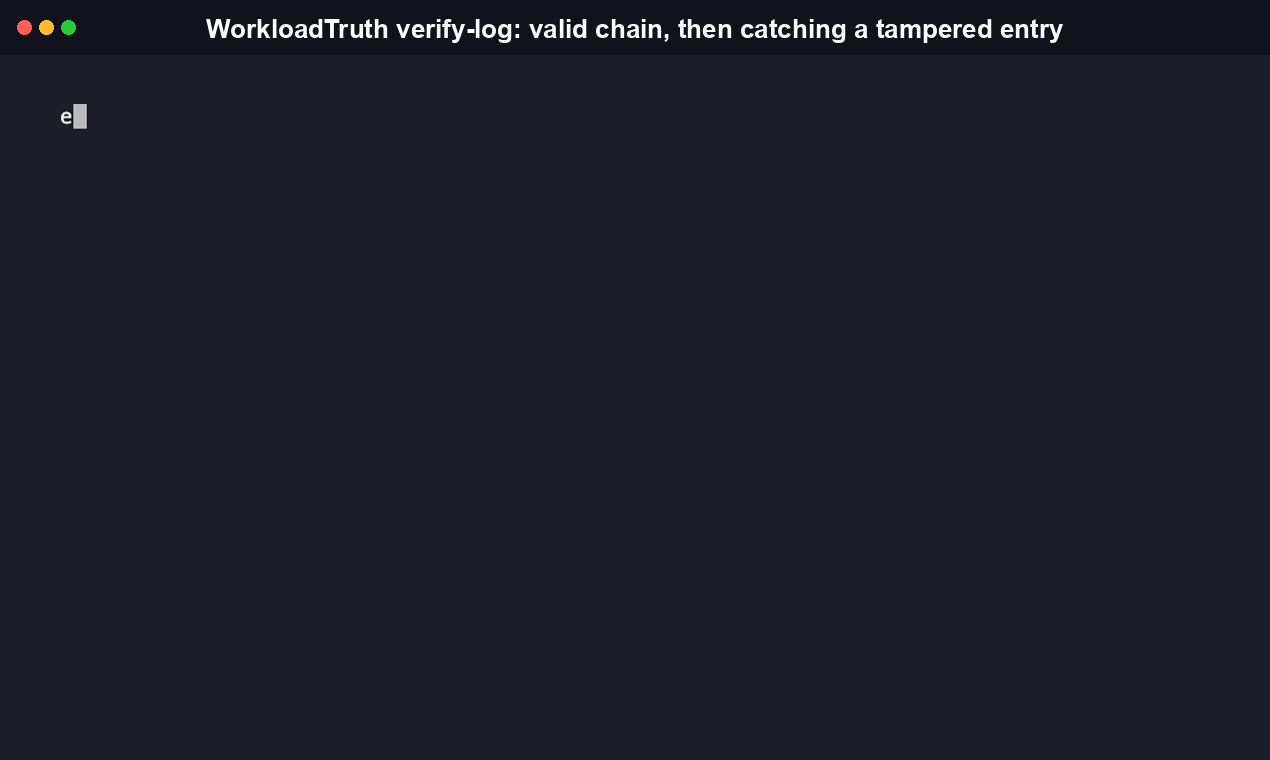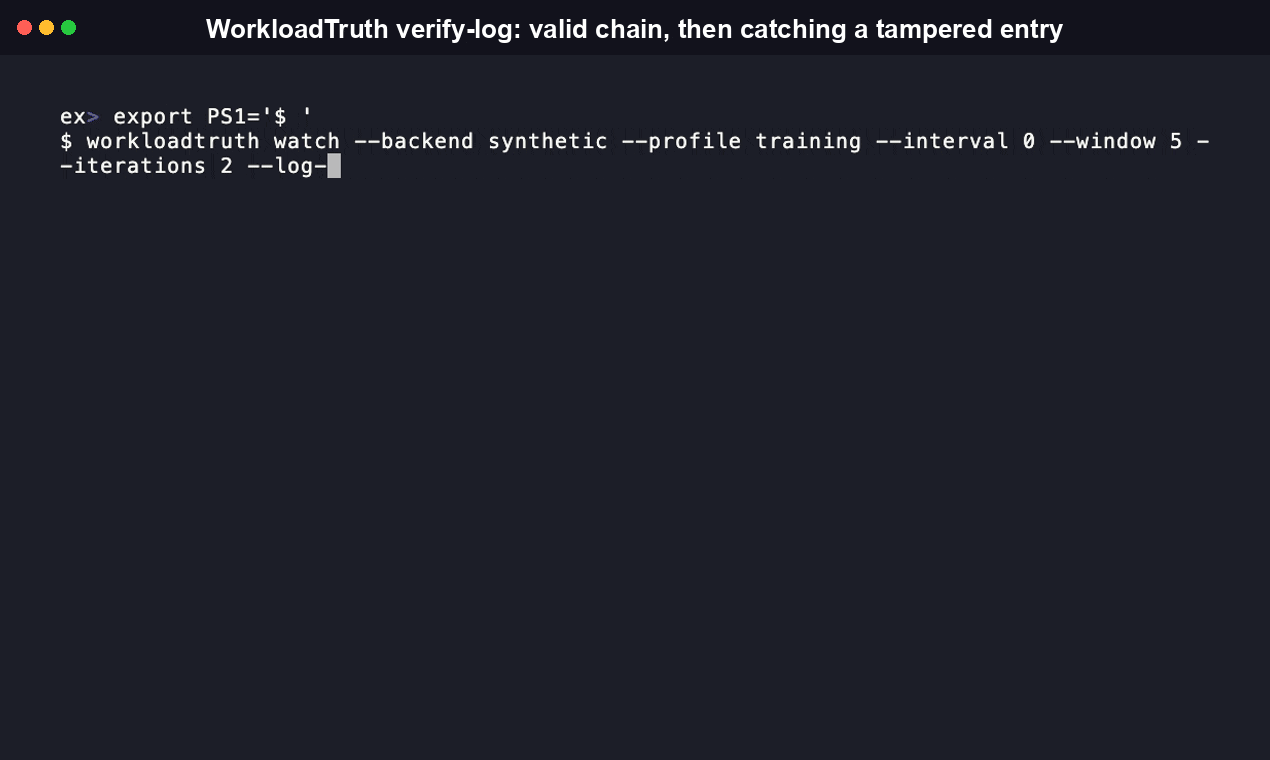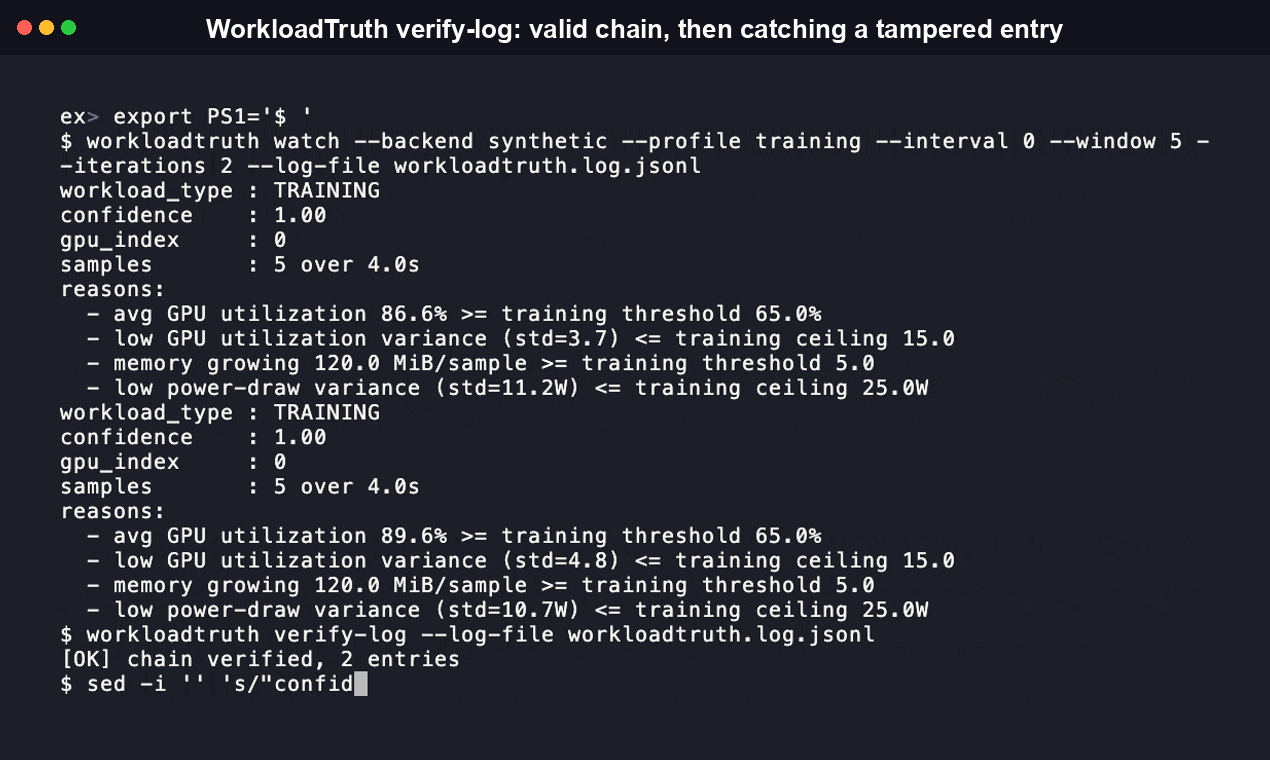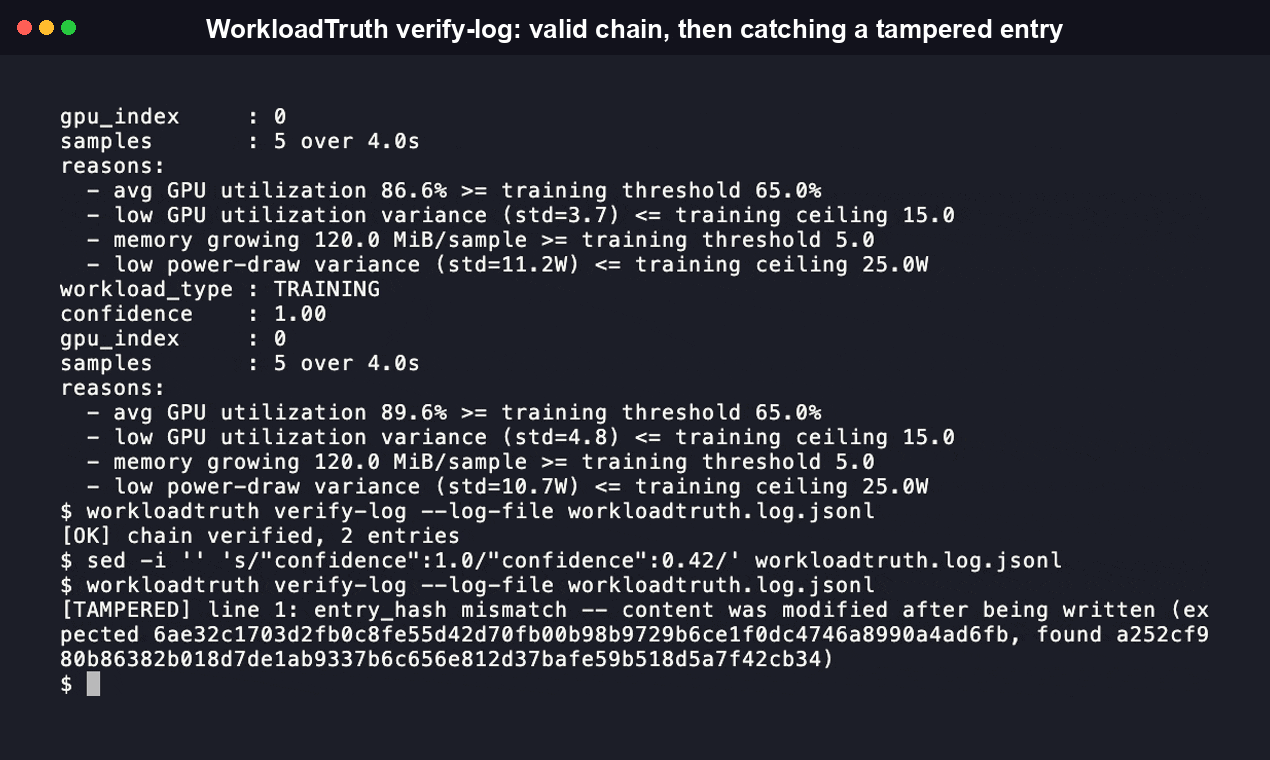
这可以证明分类了什么、何时分类,以及本地记录此后未被暗中篡改。但它不能证明分类本身正确,也不能作为符合监管要求的证据。详见下文。
为什么使用两个注册表
WorkloadTruth 使用 Python 实现。NVML(pynvml/nvidia-ml-py)是读取 NVIDIA GPU 遥测数据的成熟官方方式,也是最接近的先前研究(arXiv:2606.19262)所采用的方式。npm 软件包(workloadtruth-cli)只是一个轻量启动器,并非重新实现。它会定位并执行从 PyPI 安装的真正 workloadtruth 二进制文件,因此,面向 npm 的 Agent 工具可以使用 npx workloadtruth-cli,而无需用两种语言重复实现分类器。npm 软件包与 PyPI 软件包分别独立发布版本,因为它只包含启动脚本,不包含分类器本身。
对比
| WorkloadTruth | NVIDIA DCGM / dcgm-exporter | run:ai | Weights & Biases | |
|---|---|---|---|---|
| 读取 GPU 遥测数据 | 是(通过 NVML) | 是(数据源) | 是 | 是 |
| 自动分类工作负载类型 | 是 | 否,仅公开原始指标 | 否,工作负载类型由用户在提交作业时声明 | 否,设计上以训练运行作为范围,不进行分类 |
| 本地哈希链式审计记录 | 是 | 否 | 否 | 否 |
| 抗规避性基准测试 | 是(有文档记录且可复现) | 不适用 | 不适用 | 不适用 |
| 需要 NVIDIA GPU | 仅 nvml 后端需要;synthetic 后端无需 GPU | 是 | 是 | 否(通用系统指标) |
已直接根据各项目自身文档核实:DCGM exporter 文档、run:ai 推理概览、W&B 系统指标文档。这些项目都无法仅凭遥测数据分类工作负载类型。WorkloadTruth 正是为弥补这一空白而生。
WorkloadTruth 是什么,为什么会出现
WorkloadTruth 是一款开源命令行工具和 MCP 服务,仅使用 GPU 级遥测数据(利用率、内存模式、功耗),即可将正在运行的 GPU 工作负载分类为 TRAINING、INFERENCE 或 IDLE,无需更改工作负载自身代码,也不依赖用户自行报告的作业标签。
它的出现,是因为所有主流 GPU 调度器都会要求作业所有者在提交时声明作业类型,却从不检查该声明是否符合硬件的实际运行情况。这一空白会带来两个实际后果:成本分配错误(以低优先级“推理”价格调度的作业,实际却在进行完整训练)和未经授权的工作负载变更(推理端点悄然开始利用实时流量进行训练)。WorkloadTruth 如今弥补了这一验证空白,同时也成为首个开放且可安装的实现,落实了一项关于通过硬件遥测验证 AI 训练运行的真实学术研究方向(见下文)。
与先前研究的关系
WorkloadTruth 的核心技术,即根据遥测数据对训练与非训练 GPU 活动进行分类,并非新创。它直接应用了一项真实且活跃的研究方向:
- Yonadav Shavit(哈佛大学),《What does it take to catch a Chinchilla?》(2023):提出使用硬件级“训练记录”来验证大型训练运行。
- GovAI,《Computing Power and the Governance of AI》(2024):调研了计算治理机制,并明确将其定位为探索性研究,而非认可的政策。
- 《Hardware-Enabled Mechanisms for Verifying Responsible AI Development》(2025):硬件安全研究人员提出了片上证明机制。
- Rahman & Tajdari,《Detecting Hidden ML Training With Zero-Overhead Telemetry》(ICML 2026 Technical AI Governance workshop):一种可运行的 NVML 遥测分类器,在未混淆的工作负载上准确率为 98.2%,是本项目核心分类技术的直接先例。
**WorkloadTruth 的新增内容:**根据本项目截至 2026-07-19 的研究,这一研究方向尚无开源、可安装的实现,只有学术原型。WorkloadTruth 将其打包为可用产品:一个真正的 CLI、一个 MCP 服务、一份哈希链式审计日志,以及一套可复现的抗规避性基准测试,均以开放方式构建。它并未声称改进了论文中的分类技术。请参阅上文的基准测试部分:就其衡量的这一项而言,目前基于规则的分类器比论文中的 ML 方法更容易被规避。
WorkloadTruth 不是什么
- 不是合规或监管审计工具。 目前没有法律要求对推理/训练进行分类或报告。今后若有任何此类说法,都会注明具体已颁布的法规;截至本文撰写时,此类法规并不存在。
- 不是内容检查工具。 WorkloadTruth 仅读取 GPU 级信号(利用率、内存、功耗),绝不会检查模型权重、训练数据、提示词或生成内容。
- 不能证明操作“合规”或“安全”。 审计日志能证明分类了什么、何时分类,以及记录之后未被篡改;但不能证明分类正确,也不能证明遵守了任何政策。
常见问题
需要 NVIDIA GPU 吗?
只有使用 nvml 后端时才需要。--backend synthetic 会基于有文档说明的合成轨迹运行完整的分类器和 CLI,无需 GPU。适合试用工具或用于 CI。
能对 AMD 或 Intel GPU 工作负载进行分类吗?
目前还不行。遥测层采用可插拔接口(TelemetryBackend),正是为了能在不改动分类器的情况下添加新的供应商后端(AMD ROCm、Intel Level Zero)。参见 CONTRIBUTING.md。
分类器的准确度足以根据其输出向某人收费或处罚吗?
目前还不够。上文的基准测试部分如实说明了原因:目前对规避检测的训练工作负载,准确率为 0%。请将 workload_type 视为需要进一步调查的信号,而非定论。
为什么不直接使用论文中的 ML 分类器? 论文的训练权重和数据集从未公开。没有真实训练数据却重新实现 ML 分类器,只会产生未经验证的准确度说法,而非实测结果。参见分类工作原理。
这与 run:ai 或 NVIDIA DCGM 有什么不同? run:ai 和 DCGM 都会提供或使用 GPU 遥测数据,但二者都不会根据这些数据对工作负载类型进行分类。run:ai 完全依赖作业所有者在提交时声明的标签;DCGM 则只提供原始利用率和内存指标,供其他工具解读。WorkloadTruth 正是实际查看遥测数据并回答这个问题的那一层。参见比较表。
它能在 Windows、macOS 和 Linux 上运行吗?
只要能运行 Python 3.10+,就能在任何平台运行 synthetic 后端,包括本项目自身的 macOS 构建环境(该环境没有 NVIDIA GPU)。nvml 后端需要 NVIDIA GPU 和驱动,实际使用中意味着需要配备 NVIDIA 硬件的 Linux 或 Windows;macOS 不提供 NVML。
它采用什么许可证?可以用于商业用途吗? Apache 2.0。根据其条款,允许商业使用、修改和再分发;参见 LICENSE。
贡献
参见 CONTRIBUTING.md。安全问题:参见 SECURITY.md。
许可证
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。