关于 Saga
Saga 是一个面向 AI Agent 的项目跟踪 MCP 服务,类似 Jira,以 SQLite 文件保存项目、史诗、任务、子任务、依赖、评论和决策记录。它适合需要在多次会话之间保留计划状态的编码 Agent 使用,数据库为本地文件,无需账户或外部服务。
主要功能
- 01SQLite 文件存储项目、任务与依赖关系
- 02按项目限定作用域,支持多项目共享数据库
- 03依赖自动阻塞与解除阻塞,拒绝循环依赖
- 04推荐下一步任务并说明原因
- 05锁定任务描述以防止 Agent 误改规格
- 06审计日志记录每次变更,删除内容可恢复
- 07任务模板支持 {variable} 占位符替换
适用场景
- 01编码 Agent 跨会话延续未完成的实现计划
- 02记录任务依赖顺序并让 Agent 按序推进
- 03在任务评论中保留排查与修复过程的决策记录
MCP 相关
Saga 是一个 MCP 服务,向 MCP 客户端暴露 41 个工具,用于创建、查询和更新项目、任务及子任务。可通过 SAGA_TOOLS 设置只暴露核心的 13 个工具以减少上下文占用。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
41收录的工具列表 · 更新于 2 周前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| name | string | 是 | 项目名称 |
| tags | array | 否 | 用于分类的标签 |
| status | enum | 否 | 项目状态active | on_hold | completed | archived |
| description | string | 否 | Project description |
详细介绍
saga-mcp



你的编码 Agent 会在不同会话间丢失计划。第二天回来时,它不知道你们商定的五件事中哪些已经完成、哪些被什么事情阻塞,也不知道你为什么否决了第二种方案——因为计划留在了上下文窗口里,或者写在没人更新的 TODO.md 中。
saga-mcp 为 Agent 提供了一个真正的跟踪器:项目中的一个 SQLite 文件,用来保存项目、史诗、任务、子任务、依赖关系、评论、笔记和决策,并通过 41 个 MCP 工具提供访问。Agent 工作时会将信息写入其中,回来时再读出来。不需要账号、外部服务或网络调用——数据库就是一个由你掌控的文件。
安装
将 saga-mcp 添加到你的 MCP 客户端。相同的配置块适用于 Claude Code(项目中的 .mcp.json)、Claude Desktop(claude_desktop_config.json)以及其他任何 MCP 客户端:
{
  "mcpServers": {
    "saga": {
      "command": "npx",
      "args": ["-y", "saga-mcp"],
      "env": { "DB_PATH": "/absolute/path/to/your/project/.tracker.db" }
    }
  }
}
重启客户端。DB_PATH 是唯一必需的设置;首次使用时会创建文件及其架构。更喜欢全局安装?运行 npm install -g saga-mcp,然后使用 saga-mcp 作为命令,而不是 npx。
已在 Linux、macOS 和 Windows 上使用 Node 20、22 和 24 进行测试。
设置
| 变量 | 必需 | 说明 |
|---|---|---|
DB_PATH | 是 | .tracker.db SQLite 文件的路径。首次使用时创建。 |
SAGA_PROJECT | 否 | 将每个工具限定到一个项目,可按 ID 或名称指定。当多个仓库共用一个数据库时,为每个仓库单独设置。 |
SAGA_DESCRIPTION_LOCK | 否 | 工作一开始,on_progress 就会锁定任务描述。默认关闭。参见让 Agent 按计划推进。 |
SAGA_TOOLS | 否 | full(默认值)会列出全部 41 个工具。core 只列出普通跟踪会话所需的 13 个工具,每个会话可节省约 4,300 个 token。参见 token 成本。 |
不需要 API 密钥、账号或外部服务。
首次会话
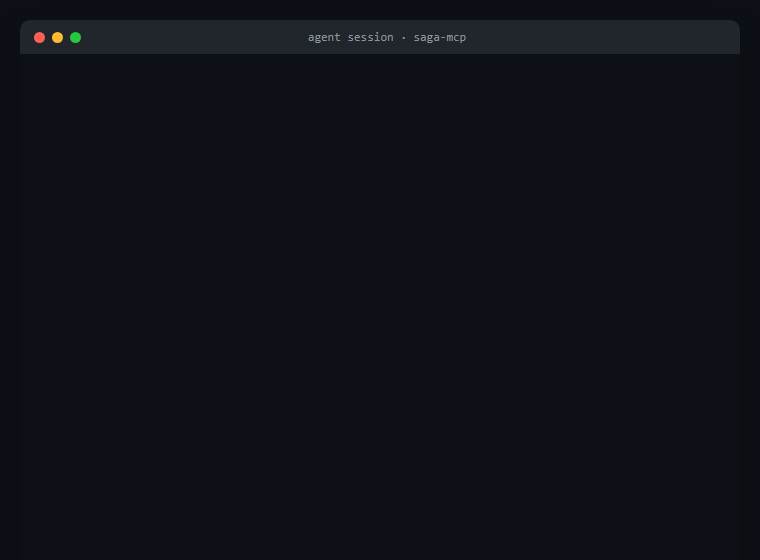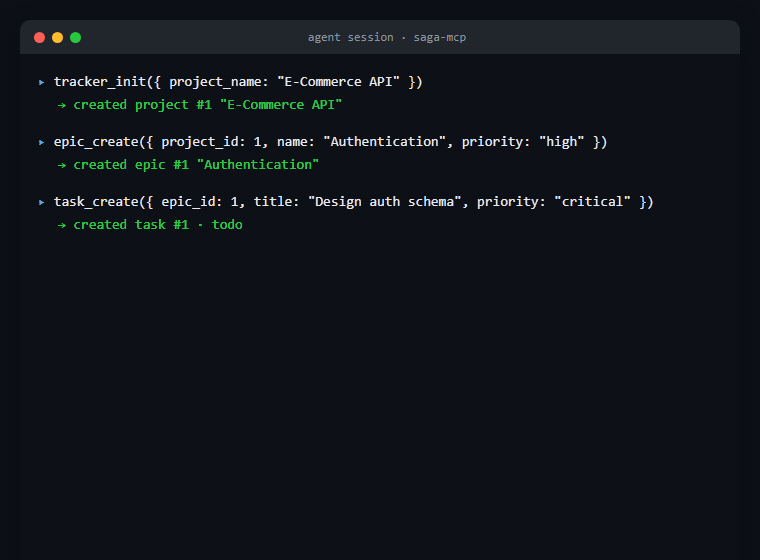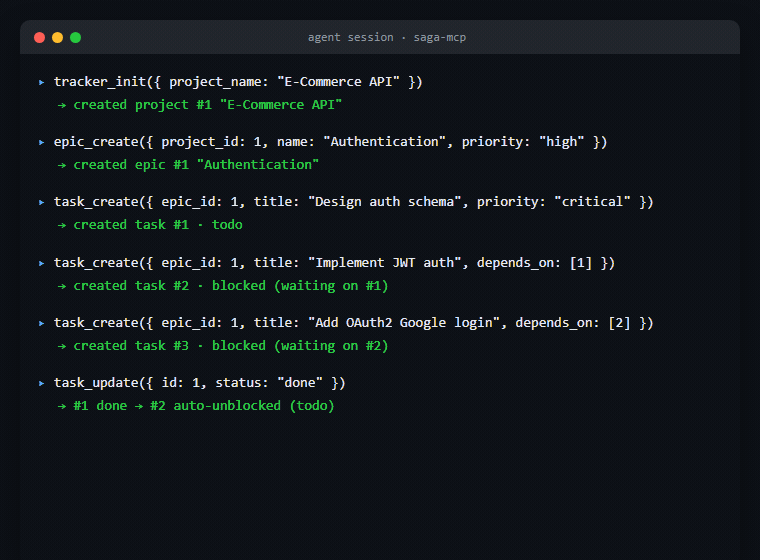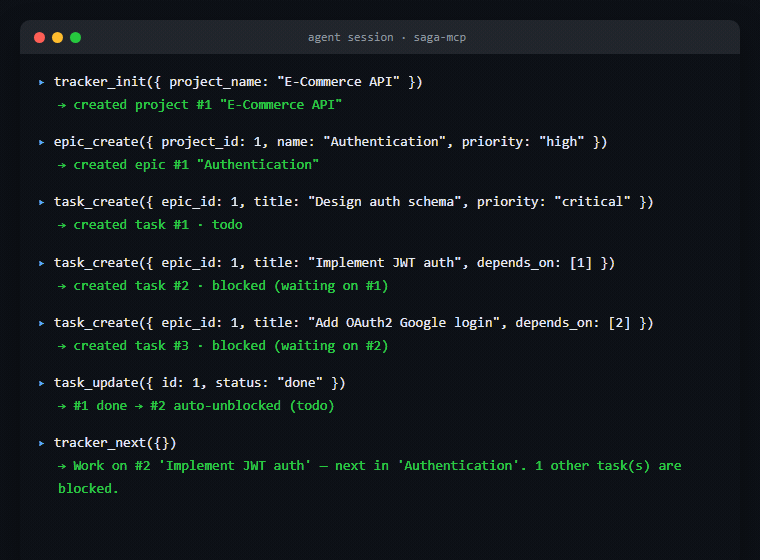
你:“为电商 API 设置跟踪,并规划身份验证。”
tracker_init({ project_name: "E-Commerce API" })
epic_create({ project_id: 1, name: "Authentication", priority: "high" })
task_create({ epic_id: 1, title: "Design auth schema", priority: "critical" })
task_create({ epic_id: 1, title: "Implement JWT auth", depends_on: [1] })
task_create({ epic_id: 1, title: "Add OAuth2 Google login", depends_on: [2] })
任务 2 和 3 会显示为已阻塞——它们的依赖项尚未完成。完成任务 1 后,任务 2 就会自动解除阻塞。这段完整对话是实际使用 saga-mcp 运行的:
下次会话,你:“我们上次进展到哪里了?”
tracker_next({})
  -> Work on #1 'Design auth schema' — critical priority, in the active epic
     'Authentication'. 2 other task(s) are blocked.
它会给出一条建议及其原因。如果想查看整体情况,tracker_dashboard({}) 会返回统计数据、史诗、已阻塞和逾期任务、近期活动及笔记,并在顶部提供摘要。
如果你更愿意查看而不是提问,saga-web 会在浏览器中展示同一个数据库:

你将获得什么
- 接下来要做什么 — 一条建议及其理由,成本约为仪表板的三分之一
- 真正的排序 — 依赖项会自动阻止和解除阻止,工具会遵循手动排序,并拒绝循环依赖,而不是陷入死锁
- 防止 Agent 偏离轨道 — 可锁定的描述,以及在写入时强制执行而非仅作提示的前置条件
- Web UI —
saga-web可在浏览器中提供同一数据库,支持读取和写入 - 模板 — 可复用的任务集,支持
{variable}替换,可直接编辑 - 归档和软删除 — 将已完成的工作从你需要付费的上下文中移出,并且可以恢复
- 宽容的输入 — 较小的模型将数组作为 JSON 字符串发送时,不会悄悄把批次合并成一条记录
- 一个数据库,多个项目 — 每个仓库使用单独的数据库,或共用一个文件
- 完整的审计跟踪 — 每次修改都会记录旧值和新值,Agent 移除的内容都可以恢复
- 41 个工具,每个工具都带有 MCP 安全注释;需要减少上下文开销时,还可使用分层工具集
询问接下来要做什么
tracker_dashboard 会把所有信息交给 Agent,让它自行推理。tracker_next 则直接回答这个问题:
tracker_next()
  -> Work on #12 'Write the adapter' — already in progress, high priority, in the
     active epic 'Provider swap'. Next step: implement. Also overdue: #18 'Renew cert'.
     3 other task(s) are blocked.
它会给出一条建议及其理由、建议任务中下一个未完成的子任务、几个备选项,以及所有逾期或受阻事项。大小约为仪表板的三分之一。
值得了解的排序规则是:继续优先于开始。 已在进行中的任务优先于尚未开始但已逾期或优先级更高的任务,因为中途放下工作只会让两件事都无法完成——逾期工作会在摘要中列出。系统绝不会推荐受阻任务,也会跳过已归档的史诗任务和已移除的任务;子任务依赖关系会决定所选任务中的下一步。
如果当前没有可执行的事项,系统会说明应解除哪些阻碍,而不是返回空答案:
Nothing is actionable: all 4 remaining task(s) are blocked.
Unblocking #7 'the keystone' would release 3 of them.
排序和依赖关系
明确指定的顺序优先于猜测。 task_list 会按优先级排序,直到有人为某个史诗任务安排顺序;此后则遵循该顺序:
task_reorder({ epic_id: 2, ordered_ids: [8, 5, 6] })
task_list({ epic_id: 2 })                        // 8, 5, 6 — the plan, in order
task_list({ epic_id: 2, sort_by: "priority" })   // priority, if that is what you want
优先级可以合理推测哪些事项更重要;有人明确写下的顺序则不是猜测。如果 Agent 收到了一份计划,就应该从头开始,而不是选择恰好标记为关键的步骤。
对于没有安排顺序的史诗任务,一切保持不变——仍和之前一样按优先级排序,而且始终会严格遵循显式指定的 sort_by。
未包含在 ordered_ids 中的内容会保留彼此的相对顺序,并排在末尾。sort_order 按升序排列,数值越低越靠前;在安排顺序后创建的任务不在该顺序中,因此会排在末尾,而非开头。在 Web UI 中,你可以在史诗任务内拖动任务来调整顺序。
任务依赖关系会自动阻止和解除阻止:
task_update({ id: 9, depends_on: [8] }) // 9 becomes blocked while 8 is open
每当阻碍项的完成状态发生变化(无论哪个方向),系统都会重新评估。因此,重新打开已完成的阻碍项会再次阻止其依赖任务,而清除最后一个依赖项则会解除阻止。系统会拒绝循环依赖,并指出循环内容;任务和子任务都一样——循环中的任何内容都会永远处于受阻状态。Web UI 会在受阻任务顶部显示横幅,说明它在等待什么,并提供选择器来添加或移除依赖关系。
让 Agent 不偏离轨道
防止 Agent 在长任务中出错的两道保护措施。
锁定描述。 Agent 有时会为了记录进度而改写任务描述,而它们本想添加的是评论——这样一来,双方约定好的规格就不见了。锁定描述后,task_update 就会拒绝修改:
task_lock_description({ id: 12 })
task_update({ id: 12, description: "..." })
  -> Task 12's description is locked and was not changed. Record progress with
     comment_add instead, or unlock it in the web UI if the description is genuinely wrong.
任务的其他内容仍可编辑——锁定的目的是保护规格,而不是冻结任务。普通的 task_update 无法顺带解除锁定;必须显式调用 task_lock_description,或通过 Web UI 切换锁定状态,而且这两种操作都会记录在日志中。
这项保护是为了防止混淆,而非对抗性控制:如果 Agent 收到解锁指令,仍然可以解锁。它将悄无声息的覆盖变成可见、可撤销的决定。
在计划中的每项任务上手动锁定,无法扩展到大规模使用,因此 SAGA_DESCRIPTION_LOCK=on_progress 可以替你完成:任务开始处理时就会锁定——即任务状态变为 in_progress、review 或 done,或创建时就处于这些状态。除非你设置该选项,否则默认关闭,因为它会改变 Agent 可以执行的操作。
"env": { "DB_PATH": "…", "SAGA_DESCRIPTION_LOCK": "on_progress" }
它设置的标志与 task_lock_description 设置的相同,而不是对每次写入另行判断。因此,字段由同一种机制管理:解锁任务后,无论其状态之后如何变化,它都会保持解锁状态。blocked 不算“已开始”——等待依赖项的任务尚未开始处理,而且依赖项会自行将任务移入或移出该状态。
子任务顺序和依赖关系。 新子任务会按顺序追加,而不是都放在位置 0;subtask_reorder 可通过一次调用设置顺序(也可以在 UI 中拖动),子任务还可以等待其同级子任务完成:
subtask_update({ id: 8, depends_on: [5, 6] })    // 8 waits for 5 and 6
subtask_update({ id: 4, blocks: [5, 6, 7, 8] })  // a bug that holds up the rest
读取结果包含 depends_on 和 blocked,而且写入时会强制执行阻止条件:如果前置条件尚未满足,则拒绝开始或完成子任务;如果任务的清单仍有未完成项,也会拒绝完成任务。
subtask_update({ id: 8, status: "in_progress" })
  -> Subtask 8 cannot be started — it waits on #5 'write the parser' (todo).
     Finish those first, or pass force: true to override deliberately (the override is logged).
当有人已决定阻止条件不再适用时,可通过 force: true 强行继续。它适用于 subtask_update、task_update 和 task_batch_update,而且每次覆盖都会写入活动日志,并注明跳过了什么。Web UI 会要求确认,然后再发送请求。
重要区别在于:Agent 悄悄忽略阻止条件,与有人主动选择覆盖阻止条件,并不是一回事。依赖关系只在单个任务内生效——等待另一项不同任务中某项内容的清单项,属于任务级依赖关系,而 task_update depends_on 已经能对此建模。
将评论作为决策记录
comment_add({ task_id: 5, content: "Investigated root cause: CORS headers missing on preflight" })
comment_add({ task_id: 5, content: "Fixed by adding OPTIONS handler. Tested with curl." })
task_update({ id: 5, status: "done" })
评论会跨会话保留——下次 Agent 调用 task_get(5) 时,就能看到完整的评论串。
如果发现某条评论有误,可以撤回它,同时保留记录:
comment_delete({ id: 12, reason: "Root cause was wrong — it was a proxy timeout", deleted_by: "pranab" })
该行仍保留在数据库和活动日志中。comment_list 和 task_get 会跳过它;comment_list({ task_id: 5, include_deleted: true }) 会显示它及撤回原因;comment_restore({ id: 12 }) 则可以将其恢复。Agent 删除的内容都可以恢复。
模板
一组可复用的任务,包含 {variable} 占位符,应用时填写:
template_create({
  name: "feature_workflow",
  tasks: [
    { title: "Design {feature} API",       priority: "critical", estimated_hours: 2 },
    { title: "Implement {feature}",        priority: "high",     estimated_hours: 8 },
    { title: "Write tests for {feature}",  priority: "high",     estimated_hours: 4 }
  ]
})

template_apply({ template_id: 1, epic_id: 2, variables: { feature: "user auth" } })
// -> "Design user auth API", "Implement user auth", "Write tests for user auth"
模板可以直接编辑,这很重要,因为 template_apply 引用的是模板 ID——重新创建模板会导致所有持有该 ID 的内容失效:
template_update({ id: 1, name: "Feature rollout" })                  // tasks untouched
template_update({ id: 1, tasks: [{ title: "Design {feature}" }] })   // name untouched
template_list({ include_tasks: true })                               // see what one creates
任务定义会在写入时而非应用时进行检查,因此遇到无效优先级或缺少标题时,会立即拒绝,而不是等到你已经选定一个大型任务后才失败。模板整体存储在数据库中,而非某个项目内。
Templates 选项卡会显示每个模板将创建哪些内容,以及它会要求填写的 {placeholders}:

清理旧工作
几乎都已完成的史诗任务列表,以及 Agent 创建却本应是子任务的任务,都是你每次调用都要为之付费的上下文。
epic_archive({ id: 4 })            // the epic and its tasks drop out of listings
task_delete({ id: 12, reason: "should have been a subtask" })
归档特意不使用 cancelled 状态:cancelled 表示“我们决定不做这件事”,而你想归档的大多数内容都是已完成的。归档的史诗任务及其任务会从 epic_list、tracker_dashboard、task_list 和 tracker_search 中消失——统计数据也会一并排除,而不只是列表——使用 include_archived 后则会重新显示。在 Web UI 中,“概览”和“史诗任务”标签页都可以归档史诗任务,默认隐藏已归档项目,并共用一个“显示已归档项目”开关。
没有任何内容会悄无声息地消失。仪表板会说明它排除了哪些内容:
Hidden: 2 archived epic(s) and 1 removed task(s) — pass include_archived to include them.
task_delete 与评论的软删除方式相同,但仅适用于仍处于 todo 状态的任务:进展更深入的任务都已有评论、时间记录和活动日志,删除它会使这些内容无处可依;如果其他任务依赖该任务,则会直接拒绝删除,以免留下永远无法解除阻塞的任务。该行会保留,task_restore 可以将其恢复,而 tracker_export 会包含已归档和已移除的行,因为遗漏内容的备份算不上备份。
容错输入
较小的模型经常会把数组参数作为包含 JSON 的字符串发送。所有接受数组的工具都支持这种形式,因此批量操作不会悄悄退化成单条记录:
subtask_create({ task_id: 3, titles: '["Write it","Test it"]' })   // 2 subtasks
subtask_create({ task_id: 3, titles: "- Write it\n- Test it" })    // 2 subtasks
task_batch_update({ ids: "[4,5]", status: "done" })                // both tasks
task_create({ epic_id: 1, title: "x", tags: "billing, urgent" })   // 2 tags
当意图变得模糊时,就会停止强制转换。标题中的逗号会原样保留——"Design the API, then implement it" 是一个子任务,而不是两个——而标签或 ID 列表中的逗号则是分隔符,因为它们都不能包含逗号。遇到确实无法使用的输入时,系统会拒绝并说明收到的内容和预期内容,而不是泄露 ids.map is not a function 这样的错误。
返回的数据与输入的数据格式一致。tags、metadata 和 source_ref 存储在 JSON 文本列中,每个响应都会在边界处解码它们,因此标签列表会显示为 ["billing", "urgent"],而不是 Agent 无法使用的转义字符串 "[\"billing\",\"urgent\"]"。
一个数据库,多个项目
saga-mcp 两种方式都支持:每个仓库使用一个 .tracker.db(便于移植,并将互不相关的工作分开),或者让每个仓库都指向同一个共享数据库。
共享设置需要额外配置一项内容。projects 是顶层表,因此一个共享文件中可以存放多个项目——但除非另行指定,task_list、note_list、activity_log 和 tracker_search 都会读取整个文件中的数据。仓库 B 中的 Agent 会看到仓库 A 的任务。为每个仓库设置 SAGA_PROJECT,即可让每个 Agent 只看到自己的项目:
{
  "mcpServers": {
    "saga": {
      "command": "npx",
      "args": ["-y", "saga-mcp"],
      "env": {
        "DB_PATH": "/Users/you/saga/central.tracker.db",
        "SAGA_PROJECT": "Payments platform"
      }
    }
  }
}
SAGA_PROJECT 可以是项目 ID 或项目名称(不区分大小写);如果两者都不匹配,启动时会失败并列出实际项目。每个作用域工具也都接受显式的 project_id 参数,其优先级高于环境变量。
| 设置 | 配置项 | 结果 |
|---|---|---|
| 每个仓库使用一个数据库 | DB_PATH | 无需设置作用域——每个文件对应一个项目 |
| 共享数据库,每个仓库各有一个 Agent | DB_PATH + SAGA_PROJECT | 每个 Agent 只会看到自己的项目 |
| 共享数据库,一个 Agent 管理所有内容 | DB_PATH | 工具会读取所有项目的数据 |
如果既没有设置 SAGA_PROJECT,也没有提供 project_id,tracker_dashboard 会默认使用文件中的第一个项目,并明确说明这一点——响应会包含 other_projects,摘要也会说明所用项目是推测出来的,而不是悄悄报告错误仓库的数据。
无论采用哪种设置,Web UI 都不受影响:项目切换器会列出数据库中的所有项目,且每个标签页都会限定为当前所选项目。
Web UI
以上内容都面向 Agent。saga-web 会在浏览器中呈现同一个数据库——有时,查看 Agent 刚写好的规范,或手动修正一个字段,比再输入一条提示词更快。
npx -p saga-mcp saga-web ./.tracker.db --open
或者连接到 MCP 服务已指向的数据库:
saga-web --db ~/saga/central.tracker.db --port 8080
| 选项 | 默认值 | 说明 |
|---|---|---|
--db <path> | $DB_PATH | 要打开的数据库。也可以使用位置参数指定路径。 |
--port <n> | 从 4319 起的第一个空闲端口 | 省略该选项时,saga-web 会使用第一个空闲端口,因此每个项目只需运行一个实例即可。--port N 会绑定到指定的 N 端口,如果端口被占用则会失败;--port 0 则由操作系统选择端口。也可以使用 SAGA_WEB_PORT。 |
--host <addr> | 127.0.0.1 | 绑定地址。默认仅限本地访问。 |
--read-only | 关闭 | 提供界面时移除所有编辑控件。 |
--open | 关闭 | 在默认浏览器中打开界面。 |
六个标签页:
- 概览 — 统计数据、各 Epic 的进度、受阻和逾期任务
- 看板 — 按五种任务状态排列的看板;拖动卡片即可更改其状态

- Epic — 完整的 Epic → Task → Subtask 树,是审阅 Agent 刚编写的规范最快捷的方式。受阻任务会标注 ⛔,注明其等待的事项;已完成的任务会显示删除线;还可以拖动任务调整顺序。Epic 也采用相同的显示方式——进行中时加粗,完成或取消后显示删除线;也可以在此处以及概览页归档每个 Epic

- 笔记 — 决策、背景信息和阻碍事项
- 模板 — 查看每个模板及其创建的任务和使用的
{placeholders};编辑详情和任务列表、将模板应用到 Epic,或删除模板 - 活动 — 完整的更改历史记录
此外还有:
- 任务抽屉 — 编辑任意字段、评论、删除或恢复评论、锁定描述、拖动子任务调整顺序,以及设置子任务之间的等待关系。每个子任务都有一个控件,可设置其完整状态(todo / in progress / done,或 blocked);拖动边缘即可调整抽屉大小。无论滚动多远,Refresh/Edit/Close 所在行都会固定在顶部;长表单也会将 Save 按钮保持在视野内

- Markdown — 描述、评论和笔记支持渲染标题、表格、列表、代码和链接。Agent 编写的内容会在任何 Markdown 规则运行前进行转义,因此原始 HTML 永远不会进入页面,并且只会跟随 http/https/mailto 链接
- 项目切换器 — 显示数据库中的所有项目,因此一个中央
.tracker.db就能涵盖你的所有代码仓库;包括活动页在内的每个标签页都限定在所选项目范围内 - 可分享、可刷新的 URL — 当前打开的项目、标签页和任务都会显示在地址栏中,因此刷新浏览器即可回到原处,使用前进/后退按钮可在任务间切换。任务抽屉中的 ⟳ 按钮无需重新加载页面即可重新读取该任务,获取 Agent 刚写入的内容
界面中的写入操作会调用 MCP 工具使用的同一组处理程序,因此手动进行的编辑也会经过相同的验证,并记录在与 Agent 操作相同的活动日志中——你修正内容后,Agent 调用 tracker_dashboard 就能看到修正结果及其原因。
几个刻意设定的限制:除非另有指定,否则它会绑定到 127.0.0.1;它没有身份验证(请勿将其放在共享网络上);并且不会创建数据库——请指定一个 MCP 服务已在使用的数据库。单独的 .tracker.db 文件目前不会汇总到同一个视图中;但一个数据库可以包含多个项目。
令牌开销
工具列表会在每个会话中、任何工作开始前占用上下文;列表响应也会在每次调用时再次占用上下文。两者都经过刻意精简:
- 响应采用紧凑 JSON 格式——不使用美化缩进,据测量,这可节省每个响应 20-27% 的开销
task_list行会省略空值和metadata,并将描述截断至 120 个字符(调用task_get可获取任务的完整文本)——根据描述长度,可缩小 19-39%activity_log会省略空列和行 ID(没有工具会用到它)——可缩小约 27%tracker_search返回预览而非完整记录——可缩小约 47%;如需完整文本,请调用task_get或note_listSAGA_TOOLS=core会将列出的工具面从约 7,200 个令牌缩减至约 2,900 个
note_list 会有意保留完整的笔记内容——它是检索工具,而不是预览工具。
当 Agent 只跟踪工作时,设置 SAGA_TOOLS=core;如果希望模板、导入/导出、会话差异等功能仍可被发现,则不设置该变量。即使未列出的工具也仍可按名称调用——core 缩减的是所宣传的工具,而非实际存在的工具。
核心十三个工具:tracker_init、tracker_next、tracker_dashboard、project_list、epic_create、epic_list、task_create、task_list、task_get、task_update、subtask_create、note_save、comment_add。
测试套件会为每个工具描述设置字节数预算,因此工具面不能不断累积扩张:添加工具就意味着要精简其他位置的文本,或说明增加预算的理由。
工具参考
入门
| 工具 | 描述 | 注释 |
|---|---|---|
tracker_init | 初始化跟踪器并创建第一个项目 | readOnly: false、idempotent: true |
tracker_next | 查看接下来要处理的工作、原因以及被阻塞的事项 | readOnly: true |
tracker_dashboard | 完整的项目概览及自然语言摘要 | readOnly: true |
项目
| 工具 | 描述 | 注释 |
|---|---|---|
project_create | 创建新项目 | readOnly: false |
project_list | 列出项目及其完成情况统计 | readOnly: true |
project_update | 更新项目(归档即软删除) | readOnly: false、idempotent: true |
Epic
| 工具 | 描述 | 注释 |
|---|---|---|
epic_create | 在项目中创建 Epic | readOnly: false |
epic_list | 列出 Epic 及其任务数量 | readOnly: true |
epic_update | 更新 Epic | readOnly: false、idempotent: true |
epic_archive | 归档/取消归档 Epic,并在列表中隐藏该 Epic 及其任务 | readOnly: false、idempotent: true |
任务
| 工具 | 描述 | 注释 |
|---|---|---|
task_create | 创建任务,可选设置依赖项 | readOnly: false |
task_list | 列出/筛选任务;如果存在手动排序,则按其顺序排列 | readOnly: true |
task_get | 获取任务及其子任务、备注、评论和依赖项 | readOnly: true |
task_update | 更新任务(自动记录日志、自动阻塞/解除阻塞) | readOnly: false、idempotent: true |
task_batch_update | 一次更新多个任务 | readOnly: false、idempotent: true |
task_reorder | 设置一个史诗任务中各任务的顺序 | readOnly: false、idempotent: true |
task_lock_description | 锁定/解锁描述,防止 Agent 改写 | readOnly: false、idempotent: true |
task_delete | 移除 todo 任务(软删除,可恢复) | readOnly: false、idempotent: true |
task_restore | 恢复已移除的任务 | readOnly: false、idempotent: true |
子任务
| 工具 | 描述 | 注释 |
|---|---|---|
subtask_create | 创建子任务,支持批量操作 | readOnly: false |
subtask_update | 更新标题/状态/位置;depends_on 和 blocks 用于设置顺序 | readOnly: false、idempotent: true |
subtask_reorder | 一次调用即可设置某个任务的子任务顺序 | readOnly: false、idempotent: true |
subtask_delete | 删除子任务,支持批量操作 | destructive: true、idempotent: true |
评论
| 工具 | 描述 | 注释 |
|---|---|---|
comment_add | 为任务添加评论(串联讨论) | readOnly: false |
comment_list | 列出任务的评论(除非设置 include_deleted,否则隐藏已移除的评论) | readOnly: true |
comment_delete | 移除评论(软删除,保留记录以供审计) | readOnly: false、idempotent: true |
comment_restore | 恢复已移除的评论 | readOnly: false、idempotent: true |
模板
| 工具 | 描述 | 注释 |
|---|---|---|
template_create | 创建可重复使用的任务模板,支持 {variable} 占位符 | readOnly: false |
template_list | 列出模板;include_tasks 可显示每个模板会创建的内容 | readOnly: true |
template_update | 就地编辑模板的名称、描述或任务 | readOnly: false、idempotent: true |
template_apply | 应用模板,通过变量替换创建任务 | readOnly: false |
template_delete | 删除模板 | destructive: true、idempotent: true |
备注
| 工具 | 描述 | 注释 |
|---|---|---|
note_save | 创建或更新备注(插入或更新) | readOnly: false |
note_list | 按筛选条件列出备注 | readOnly: true |
note_search | 对备注进行全文搜索 | readOnly: true |
note_delete | 删除备注 | destructive: true、idempotent: true |
搜索、历史记录和传输
| 工具 | 描述 | 注释 |
|---|---|---|
tracker_search | 跨实体搜索(项目、史诗任务、任务、备注) | readOnly: true |
activity_log | 按筛选条件查看更改历史记录 | readOnly: true |
tracker_session_diff | 查看自某个时间戳以来的更改——在会话开始时调用 | readOnly: true |
tracker_export | 将完整项目导出为嵌套 JSON(包含依赖项和评论) | readOnly: true |
tracker_import | 从 JSON 导入项目(格式需与导出格式一致) | readOnly: false |
工作原理
所有内容都存储在一个 SQLite 文件中。首次使用时会创建架构;升级时,现有数据库会原地迁移——无需运行迁移步骤。
Project
  └── Epic (feature/workstream)
        └── Task (unit of work)
              ├── Subtask (checklist item)
              ├── Comment (discussion thread)
              └── Dependencies (blocked by other tasks)
笔记类型
笔记取代了零散的 Markdown 文件。每条笔记都有一个类型:
| 类型 | 使用场景 |
|---|---|
general | 自由格式笔记 |
decision | 架构/设计决策 |
context | 供后续会话使用的对话上下文 |
meeting | 会议笔记 |
technical | 技术细节、规格说明 |
blocker | 阻碍和问题 |
progress | 进度更新 |
release | 发布说明 |
活动日志
每次创建、更新和删除都会被记录,并包含旧值和新值:
{
  "summary": "Task 'Fix CORS issue' status: blocked -> done",
  "action": "status_changed",
  "entity_type": "task",
  "entity_id": 15,
  "field_name": "status",
  "old_value": "blocked",
  "new_value": "done",
  "created_at": "2026-02-21T18:30:00"
}
正是这份日志让软删除安全可靠,并使时间跟踪自动化——工时由日志计算得出,而非手动输入。
隐私
saga-mcp 是完全本地运行、无需联网的工具。它不会收集用户数据、向外部服务发送任何内容、要求安装后保持互联网连接,也不会使用任何分析或遥测功能。
所有数据都只存储在 DB_PATH 指定的本地 SQLite 文件中。卸载 saga-mcp 并删除 .tracker.db 文件即可清除所有痕迹。
开发
git clone https://github.com/spranab/saga-mcp.git
cd saga-mcp
npm install
npm run build
DB_PATH=./test.db npm start

# the web UI against the same database
node dist/web/index.js ./test.db --open

npm test     # 359 unit and integration tests, no network
npm run e2e  # release gate: packs a tarball, installs it, drives the real binaries
npm test 会针对构建后的输出运行。npm run e2e 是发布前的关键门槛:它会打包实际要发布的 tarball,将其安装到其他位置,并通过真实的 stdio 驱动两个二进制程序——共 106 项检查,其中包括从较旧数据库升级的检查。
发布
发布到 npm 后无法撤销——版本号一旦使用就无法再次使用——因此这是最后一步,且由发布 GitHub release 触发,而不是推送 tag。
# 1. bump the version in package.json, manifest.json and server.json, then merge
# 2. tag it. Nothing is published yet.
git tag -a v1.19.0 -m "v1.19.0 — ..." && git push origin v1.19.0

# 3. verify the tagged build: this packs the tarball that would be published
#    and drives it end to end, including an upgrade from an older database.
npm run e2e

# 4. publish the release. This fires the publish workflow.
gh release create v1.19.0 --notes-file notes.md
该工作流会针对带 tag 的提交重新运行测试套件,拒绝与 package.json 不匹配的 tag,拒绝已发布到 npm 的版本,并将 GitHub 预发布版本发送到 next dist-tag,因此它绝不会成为用户运行 npm install saga-mcp 时安装的版本。发布失败时,可以使用 gh workflow run "Publish to npm" -f tag=v1.19.0 针对同一个 tag 重试。
支持
附带复现步骤的 Bug 报告在这里非常有价值——上文中一些更细致的行为,正是因为有人报告了显而易见的做法存在问题才得以实现。
相关项目
这是由一人构建的一组 Agent 基础设施的一部分,设计用于协同使用:
- yantrikdb-mcp — 为同一个 Agent 提供持久化认知记忆:它学到了什么,而非它计划了什么。
- brainstorm-mcp — 在将计划提交到跟踪器之前,进行多模型辩论。
- swarmcode — 在不同机器上的 Claude Code 实例之间建立实时频道。
- truenas-mcp — 通过一个分层工具提供 278 项 TrueNAS SCALE 操作。
- mcpier — 可自托管的 MCP 控制平面,让 API 密钥远离客户端。
许可证
MIT
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。