关于 Scaffold
Scaffold 是一个面向代码库的 RAG 系统,将源代码转换为图知识库,记录文件、类和函数之间的结构关系。适合需要让 AI Agent 理解和维护大型项目的开发团队。
主要功能
- 01将代码库构建为知识图谱
- 02同时维护向量与图两种表示
- 03为 LLM 与 AI Agent 注入精确上下文
- 04Neo4j 图数据库可视化浏览
适用场景
- 01让 AI Agent 理解项目架构后再进行修改
- 02辅助维护与重构大型 Python 项目
- 03减少对人工整理上下文的依赖
MCP 相关
该项目提供一个 MCP 服务端点,MCP 客户端(如 Cursor)通过 URL 连接后即可使用其上下文检索能力。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
docker run -i --rm -e CHROMA_SERVER_HOST -e CHROMA_SERVER_PORT -e CHROMA_COLLECTION_NAME -e NEO4J_USER -e NEO4J_PASSWORD -e NEO4J_URI -e PROJECT_PATH ghcr.io/beer-bears/scaffold:latestCHROMA_SERVER_HOSTCHROMA_SERVER_PORTCHROMA_COLLECTION_NAMENEO4J_USERNEO4J_PASSWORD密钥NEO4J_URIPROJECT_PATH本地服务需要在你的电脑上安装运行环境(如 Node.js 18+)。各客户端的配置文件位置不同,请参考客户端文档。
ghcr.io/beer-bears/scaffold:lateststdio工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍




Scaffold 是一个专门的 RAG(检索增强生成)系统,旨在彻底改变开发团队与大型代码库的交互方式。Scaffold 源于在实际工作中对传统文档和 AI 辅助开发方式的不满,为 AI Agent 提供所需的结构基础,使其能够有效构建、维护和修复复杂的软件项目。
挑战
现代开发团队面临三个关键问题:
- 文档衰退: 维护准确且最新的技术文档需要难以持续的人工投入。
- AI 上下文盲区: 大模型不了解项目特定的架构和业务逻辑,因此需要低效地手动提供上下文。
- 知识碎片化: 关键的系统知识只存在于团队成员的隐性经验中,并会在成员离开时流失。
我们的解决方案
Scaffold 会将源代码转换为存储在图数据库中的动态知识图谱,从而创建一个智能上下文层,以便:
- 捕获代码实体之间的结构关系。
- 同时维护代码库的向量表示和图表示。
- 为大模型和 AI Agent 提供精准的上下文注入。
- 支持构建、维护和重构工作流。
如同它的实体同名物,Scaffold 提供构建卓越成果所需的临时支撑结构——并在工作完成后消失。
入门
运行 Scaffold 主要有两种方式。请选择最适合您需求的方式。
选项 1:使用预构建的 Docker 镜像运行(推荐用户使用)
这是最快的 Scaffold 启动方式。它使用 GitHub Container Registry 提供的官方预构建镜像,无需克隆源代码仓库。您只需创建两个配置文件。
这是最快的 Scaffold 启动方式。它使用 GitHub Container Registry 提供的官方预构建镜像,无需克隆源代码仓库。您只需创建两个配置文件。
1. 准备项目目录
为项目设置创建一个新文件夹。
mkdir my-scaffold-server
cd my-scaffold-server
2. 创建配置文件
在 my-scaffold-server 目录中创建以下两个文件。
docker-compose.yaml:
services:
  scaffold-mcp:
    image: ghcr.io/beer-bears/scaffold:latest
    container_name: scaffold-mcp-prod
    env_file:
      - .env
    tty: true
    ports:
      - "8000:8080"
    depends_on:
      - neo4j
    volumes:
      - ./codebase:/app/codebase

  chromadb:
    image: chromadb/chroma:1.0.13
    container_name: scaffold-chromadb
    restart: unless-stopped
    volumes:
      - chroma_data:/data

  neo4j:
    image: neo4j:5
    container_name: scaffold-neo4j
    restart: unless-stopped
    environment:
      NEO4J_AUTH: "${NEO4J_USER:-neo4j}/${NEO4J_PASSWORD:-password}"
    volumes:
      - neo4j_data:/data
    ports:
      - "7474:7474"
      - "7687:7687"

volumes:
  chroma_data:
  neo4j_data:
.env:
# ChromaDB Settings
CHROMA_SERVER_HOST=chromadb
CHROMA_SERVER_PORT=8000
CHROMA_COLLECTION_NAME=scaffold_data

# Neo4j Credentials
NEO4J_USER=neo4j
NEO4J_PASSWORD=password
NEO4J_URI=bolt://neo4j:password@neo4j:7687

# Absolute path to your codebase
PROJECT_PATH=<ABSOLUTE_PATH_TO_YOUR_CODEBASE>
3. 运行应用程序
使用 Docker Compose 启动所有服务。
docker-compose up -d
Scaffold 现在将启动,并开始分析代码库中的代码。
选项 2:从源代码构建(面向开发者)
此方法适用于已克隆代码仓库并希望在本地构建 Docker 镜像的开发者。它非常适合为 Scaffold 贡献代码、进行自定义修改,或在可自托管模式下一次运行所有容器。
此方法适用于已克隆代码仓库并希望在本地构建 Docker 镜像的开发者。它非常适合为 Scaffold 贡献代码、进行自定义修改,或在可自托管模式下一次运行所有容器。
1. 设置项目
首先,克隆代码仓库并进入项目目录。
git clone https://github.com/Beer-Bears/scaffold.git
cd scaffold
接下来,根据提供的示例创建环境文件。
cp .env.example .env
2. 添加代码库
将要分析的 Python 项目放入 codebase 目录。
# Create the directory if it doesn't exist
mkdir -p codebase

# Copy your project files into it
cp -r /path/to/your/python/project/* ./codebase/
或者,你可以编辑 .env 文件,并将 PROJECT_PATH 变量设置为主机上项目的绝对路径。
3. 运行应用程序
使用 Docker Compose 启动整个应用程序栈。--build 标志会将本地源代码构建成新的 Docker 镜像。
docker-compose up --build -d
与 Scaffold 交互
容器运行后(无论使用哪种方法),你都可以与系统交互。
A. 配置 MCP 客户端(例如 Cursor)
将 Scaffold 服务添加到客户端的 mcp.json 文件中。
{
  "mcpServers": {
    "scaffold-mcp": {
      "url": "http://localhost:8000/mcp"
    }
  }
}
B. 探索知识图谱
访问 Neo4j Web UI,以可视化方式探索代码库的图谱。使用 .env 文件中的凭据(默认值:neo4j / password)。
URL: http://localhost:7474/
C. 发送直接 API 请求
你也可以使用 curl 直接测试 MCP 端点。
curl -N -X POST http://localhost:8000/mcp/ \
  -H "Content-Type: application/json" \
  -H "Accept: application/json, text/event-stream" \
  -d '{
    "jsonrpc": "2.0",
    "id": "1",
    "method": "tools/call",
    "params": {
      "name": "get_code_entity_information",
      "arguments": {
        "entity_name": "MyClassName"
      }
    }
  }'
你也可以查看 MCP 描述,获取 Docker 命令配置
工作原理
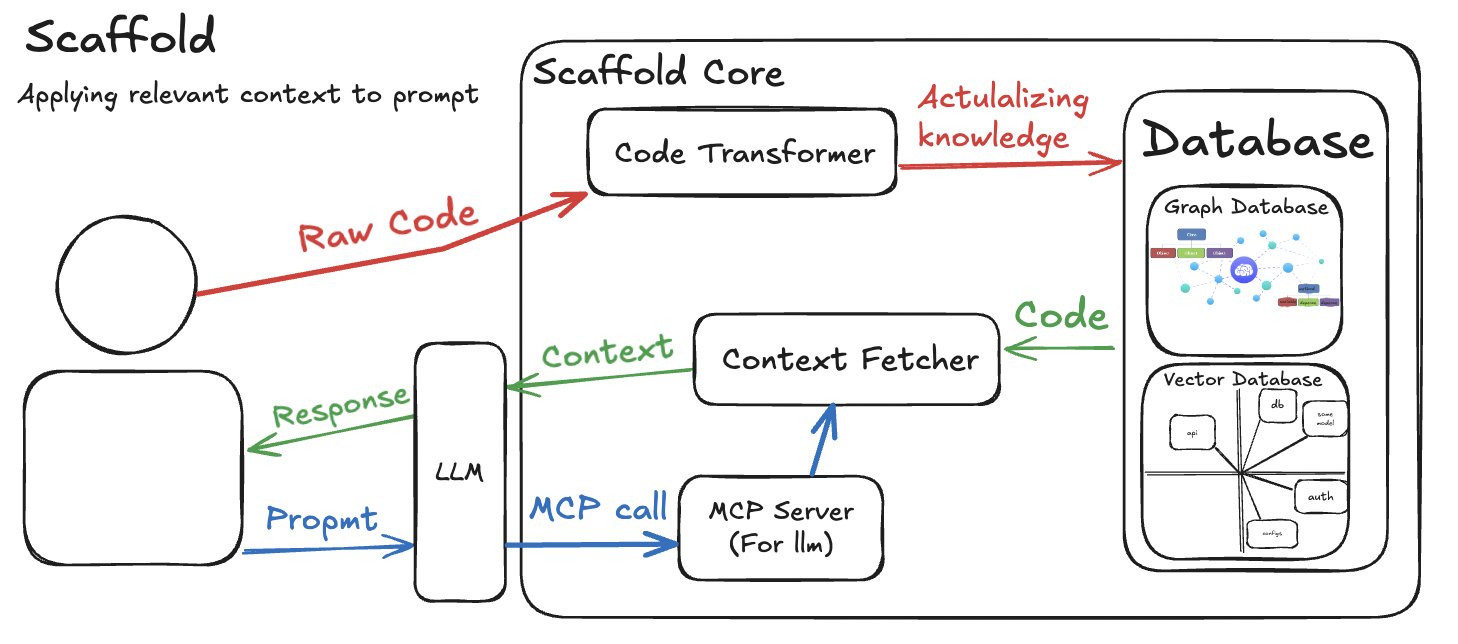
高层架构
查看架构示意图
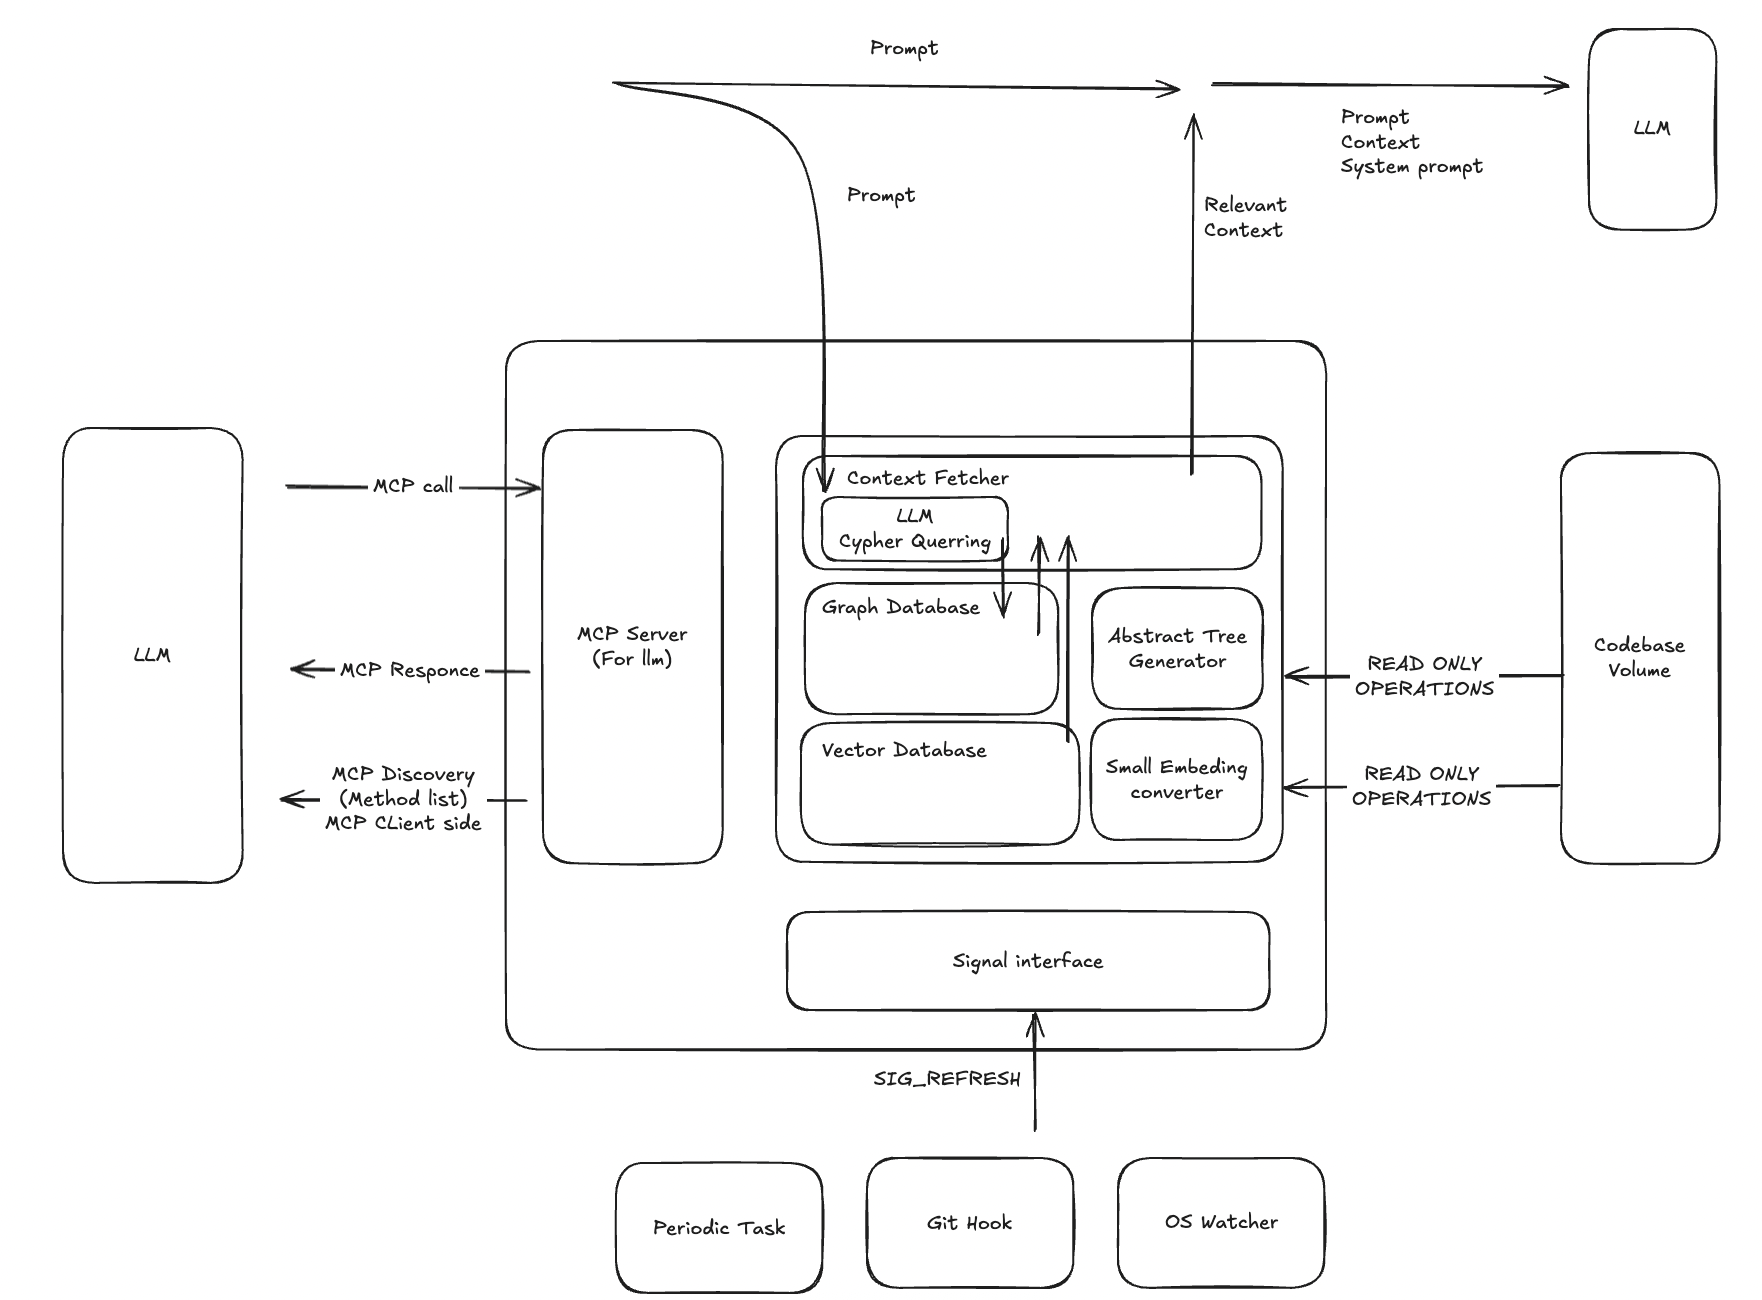
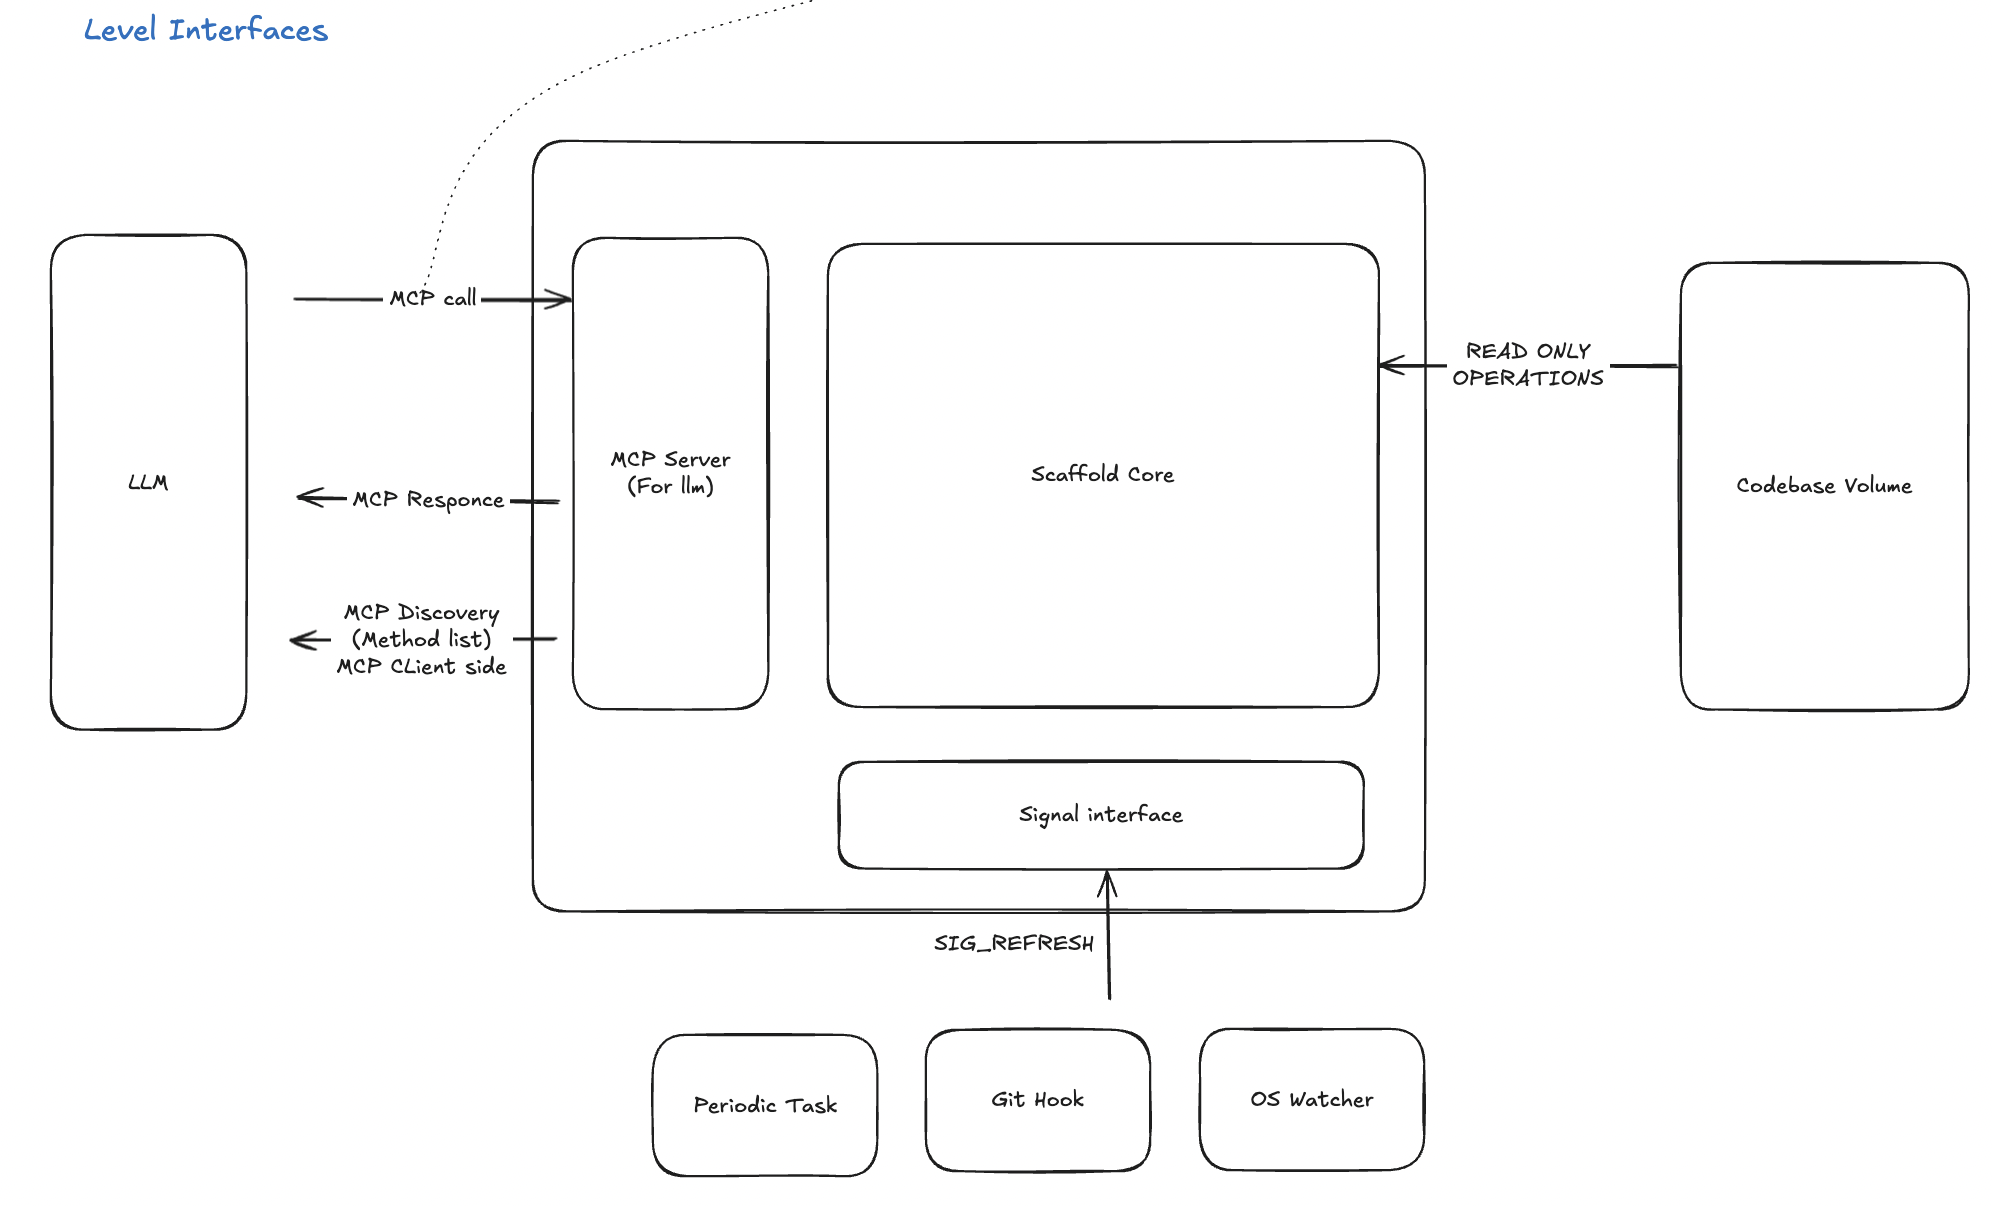
用例与接口图
查看更多图表
用例示意图
接口示意图
项目结构
.
├── docs
│   ├── img       # Static Images
│   └── research  # Research reports
└── src
    ├── core      # RAG Context Fetching Algorithms
    ├── database  # Graph/Vector Database Logic
    ├── generator # Abstract Tree Generator
    ├── mcp       # MCP Interface
    └── parsers   # AST Parcers
常见问题
什么是 RAG(检索增强生成)?
RAG(检索增强生成)是一种增强大模型(LLM)的技术,具体做法是:
- 从外部知识源检索相关信息
- 将检索到的信息补充到大模型的上下文中
- 生成更准确、能结合上下文的回答
传统大模型仅依赖训练数据,而 RAG 系统能够访问最新的项目专属信息,并通过让回答以实际代码库上下文为依据来减少幻觉。
Graph RAG 如何工作?
Graph RAG 通过将知识表示为图数据库中相互关联的实体,扩展了传统 RAG。这让系统不仅能理解和检索文本片段,还能理解和检索它们之间的结构关系(例如,某个函数调用另一个函数,某个类继承自另一个类)。对于复杂的软件工程任务,这种结构化上下文非常有价值。
资源
贡献
Scaffold 是一个开源项目,我们欢迎社区贡献!无论是报告错误、讨论功能,还是提交代码,我们都非常感谢你的帮助。
开始之前,请阅读我们的 贡献指南,了解如何设置开发环境、运行测试并提交拉取请求。
许可证
本项目采用 MIT 许可证。详情请参阅 LICENSE 文件。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。