关于 Semble
Semble 是面向编码 Agent 的本地代码搜索库、CLI 和 MCP 服务。它在 CPU 上搜索本地路径或 GitHub 仓库,缓存索引并返回相关代码片段,无需 API 密钥或外部服务。
主要功能
- 01自然语言与代码搜索
- 02搜索本地和 Git 仓库
- 03按文件位置查找相关代码
- 04缓存索引并增量更新
- 05无需 API 密钥的 CPU 运行
适用场景
- 01查找代码库中的实现细节
- 02跨相关仓库搜索
- 03从已知文件和行号定位相似代码
- 04为编码 Agent 提供针对性代码片段
MCP 相关
Semble 向 MCP 客户端提供 `search` 和 `find_related` 工具。Agent 可搜索本地路径或 HTTPS Git URL;索引按需创建,并随本地文件变化而更新。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
2收录的工具列表 · 更新于 2 周前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| mode | enum | 否 | 搜索模式。大多数查询建议使用 'hybrid'。hybrid | semantic | bm25 |
| query | string | 是 | 自然语言或代码查询。 |
| repo | any | 否 | 用于建立索引并搜索的 Git URL(例如 https://github.com/org/repo)或本地路径。启动时未配置默认索引时必填。首次调用后会缓存索引,因此重复查询速度更快。 |
| top_k | integer | 否 | 要返回的结果数。 |
详细介绍
为 Agent 提供快速、精准的代码搜索
比 grep+read 少用约 99% 的令牌


Semble 是一款专为 Agent 打造的代码搜索库。它能即时返回所需的准确代码片段,比 grep+read 少用约 99% 的令牌。对于大多数代码仓库,端到端索引和搜索整个代码库只需不到一秒;其检索质量与专门用于代码的 Transformer 相当,同时索引速度快约 480 倍,查询速度快约 23 倍(参见基准测试)。所有操作均在 CPU 上运行,无需 API 密钥、GPU 或外部服务。可将其用作 MCP 服务、通过 AGENTS.md 使用的命令行工具,或专用子 Agent,让任何编码 Agent(Claude Code、Cursor、Codex、OpenCode 等)都能即时搜索任意代码仓库。
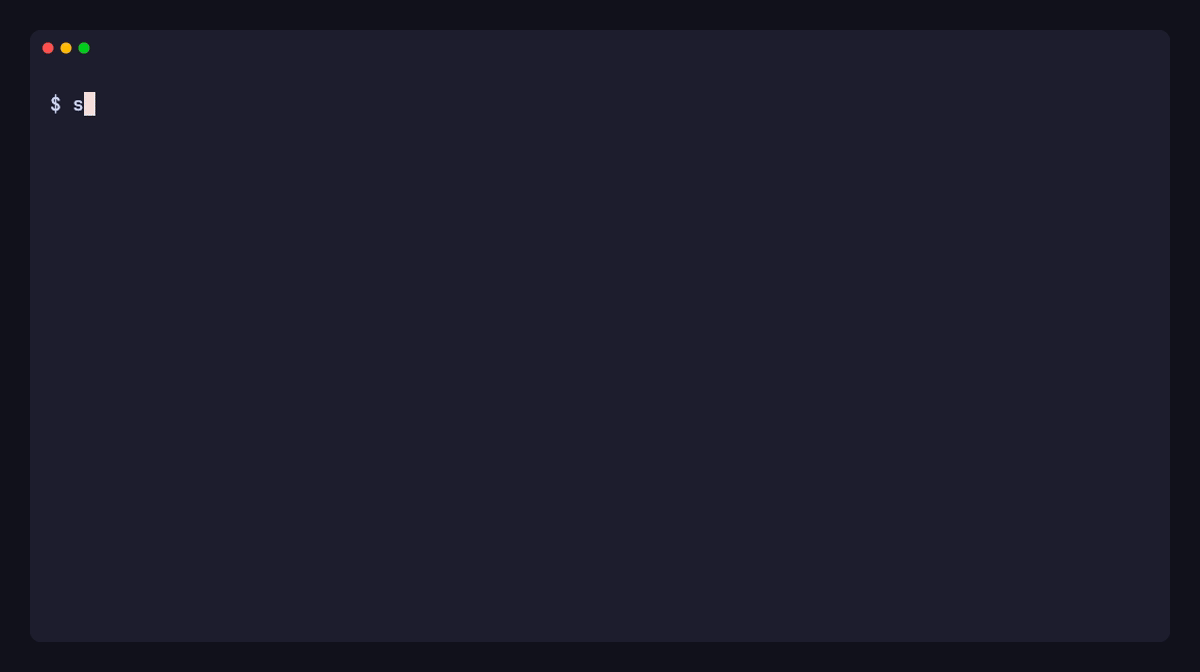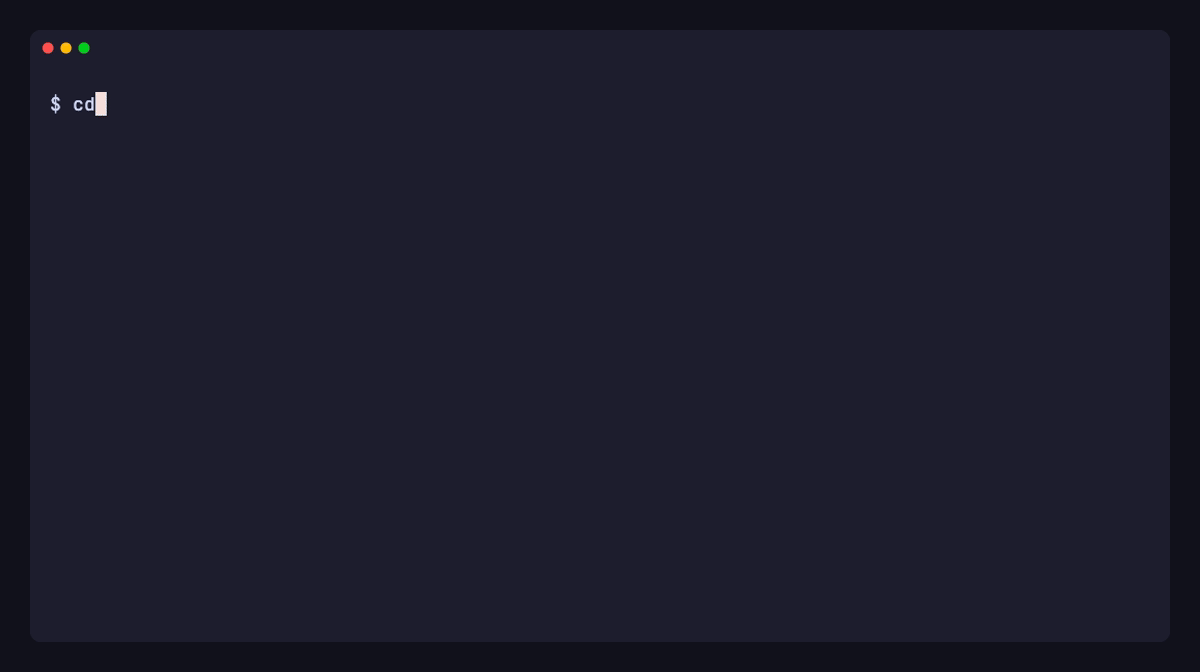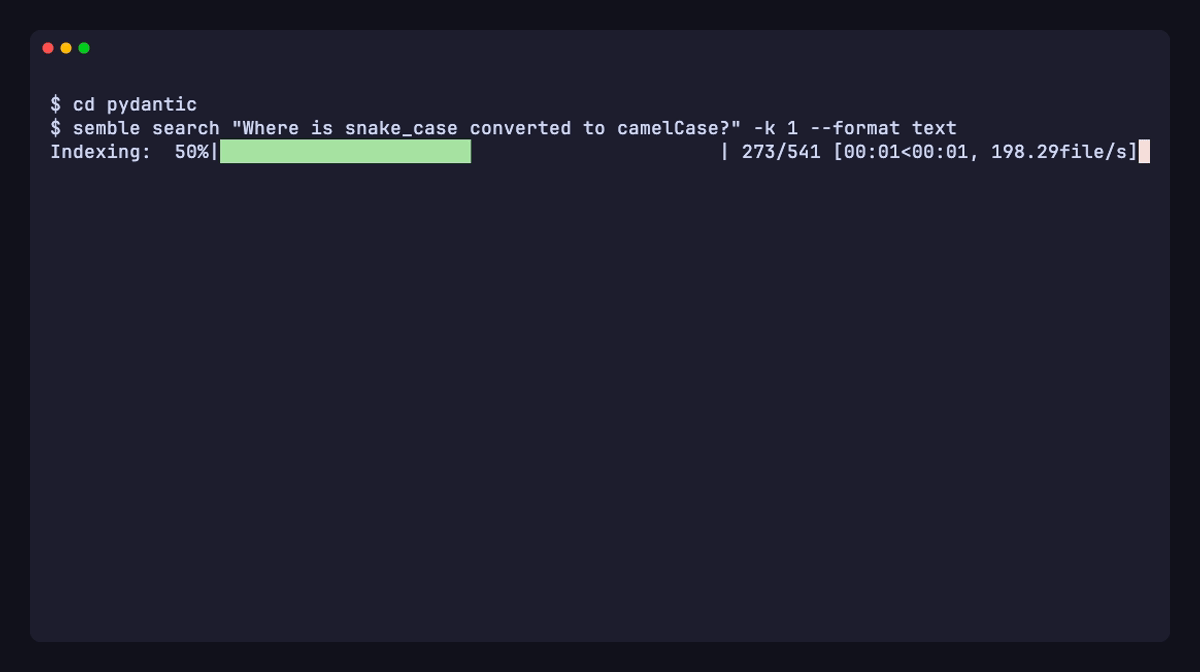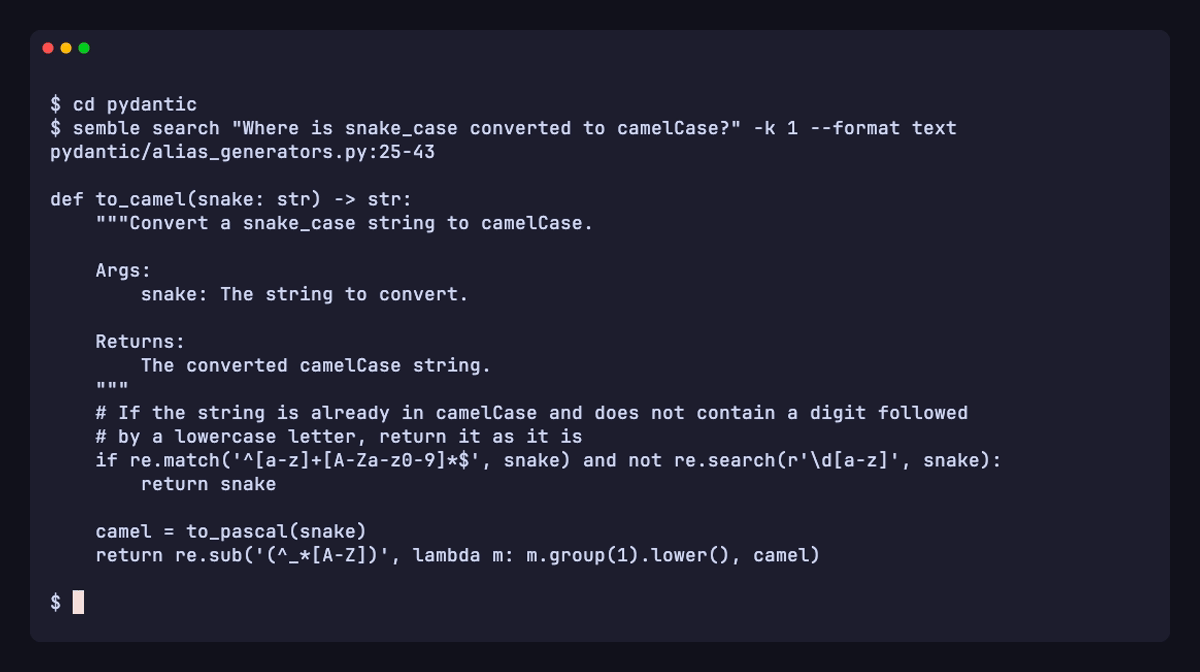
快速入门
你的 Agent 可以用自然语言向 Semble 查询(例如,"How is authentication handled?"),并仅获取相关代码片段,无需使用 grep 搜索或读取整个文件。
最快的入门方式是使用交互式安装程序。先安装 uv,然后运行:
uv tool install semble
semble install
semble install 会检测已安装的编码 Agent,例如 Claude Code、Codex 和 OpenCode,然后让你选择要启用的集成:
- MCP 服务:允许 Agent 直接将 Semble 作为工具调用。
- 说明:将命令行使用指南添加到 AGENTS.md / CLAUDE.md。
- 子 Agent:安装专用的
semble-search子 Agent。 - 技能:安装
semble技能,并在 AGENTS.md / CLAUDE.md 中添加指向它的单行引用,而不是添加完整说明。
若要撤销设置,请运行 semble uninstall。
手动设置说明(各 Agent 的 MCP 配置、AGENTS.md 片段、子 Agent 文件)请参阅安装文档。
更新 Semble
uv tool upgrade semble   # upgrade
uv cache clean semble    # for MCP users (restart your MCP client after)
无人值守安装
对于沙盒或脚本化环境,可使用 --agent,并可选用 --type,以跳过提示:
semble install --agent claude --type mcp subagent --yes
--agent 接受一个或多个 Agent ID(例如,claude、codex、pi);--type 接受 mcp、instructions、subagent、skill 或 all(默认值为除 skill 之外的所有类型);--yes 跳过确认提示(若要完全以非交互方式运行,必须指定 --agent)。
- 快速:在 CPU 上,平均约 500 ms 即可为一个代码仓库建立索引,并在约 1 ms 内回答查询。
- 准确:在我们的基准测试中,NDCG@10 达到 0.855,与专门用于代码的 Transformer 模型表现相当,但体积和成本仅为其一小部分。
- 节省 Token:仅返回相关片段,使用的 Token 比 grep+read 减少约 99%。
- 零配置:在 CPU 上运行,无需 API 密钥、GPU 或外部服务。
- MCP 服务:可与 Claude Code、Cursor、Codex、OpenCode、VS Code 及任何其他兼容 MCP 的 Agent 配合使用。
- 本地和远程:传入本地路径或 git URL,也可以传入多个路径或 URL,一起搜索相关代码仓库。
CLI
Semble 也提供独立 CLI,适用于脚本,或任何需要在没有 MCP 会话的情况下获取搜索结果的场景。索引会在首次运行时建立并缓存,并在文件更改时自动失效。
# Search a local repo (index is built and cached automatically)
semble search "authentication flow" ./my-project

# Search a remote repo (cloned on demand)
semble search "save model to disk" https://github.com/MinishLab/model2vec

# Search several repos at once (results are prefixed with the repo name)
semble search "invoice endpoint" ./service-a ./service-b

# Limit results
semble search "save model to disk" ./my-project --top-k 10

# Search docs/config/everything instead of just code
semble search "deployment guide" ./my-project --content docs   # or: config, all

# Find code similar to a known location
semble find-related src/auth.py 42 ./my-project

# Show only the first N lines of each result's snippet (0 = path/line range only)
semble search "authentication flow" ./my-project --max-snippet-lines 10
--content 接受 code(默认值)、docs、config 或 all。--format 接受 json(默认值)或 text。省略 path 时,默认使用当前目录;也接受 git URL。如果 semble 不在 $PATH 中,请改用 uvx --from "semble[mcp]" semble。semble --version(或 -V)会显示已安装的版本。
传入多个路径或 URL 时,会将它们作为一个语料库进行搜索,因此,对代码仓库 A 的查询可以找到定义在代码仓库 B 中的端点。每个索引按代码仓库分别缓存,并在查询时合并。结果路径会以代码仓库名称作为前缀(service-b/api/invoices.py),输出中还包含一个 repos 映射,记录前缀对应的绝对路径或 URL。将带前缀的路径传给 find-related,即可从已知位置跨所有代码仓库搜索。
控制索引的文件
Semble 会读取 .gitignore 和 .sembleignore 文件来确定要索引的文件。这两个文件都使用标准 gitignore 语法,其模式会合并。.sembleignore 可让你添加 Semble 专用规则,而无需修改 .gitignore。规则会递归应用,因此子目录中的 .sembleignore 会对该目录树生效。
**排除文件:**按与 .gitignore 相同的方式添加模式:
# .sembleignore
generated/     # exclude generated dir
*.pb.go.       # exclude Go protobuf files
**包含默认扩展名之外的文件:**在扩展名模式前加上 !,即可强制包含 Semble 默认不会索引的文件:
# .sembleignore
!*.proto       # include Protobuf files
!*.cob         # include COBOL files
运行 semble file-types 可查看每种内容类型会索引哪些扩展名。未列出的扩展名(包括 .json 和 .csv 等数据文件)默认不会被索引,但可以像上面那样使用 ! 模式强制包含。
无论忽略文件中的设置如何,Semble 始终会跳过一组常见的非源代码目录(例如 node_modules/、.venv/、dist/、build/、__pycache__/ 等)。
节省情况
semble savings 会显示 Semble 在所有搜索中节省的 Token 数量:
semble savings
  Semble Token Savings
  ════════════════════════════════════════════════════════════════════════

  Total saved:  ~714.2M tokens  (94%)
  Total calls:  14.3k
  Efficiency:  ███████████████████████░  94%

  By Period
  ────────────────────────────────────────────────────────────────────────
  Period             Calls           Saved  Ratio
  ────────────────────────────────────────────────────────────────────────
  Today                198    ~1.4M tokens  ███████████████████████░  95%
  Last 7 days        13.1k  ~707.2M tokens  ███████████████████████░  94%
  All time           14.3k  ~714.2M tokens  ███████████████████████░  94%

  By Call Type
  ────────────────────────────────────────────────────────────────────────
  #     Call type            Calls  Share
  ────────────────────────────────────────────────────────────────────────
  1.    search               14.1k  ████████████████    99%
  2.    find_related           205  █░░░░░░░░░░░░░░░     1%
  ════════════════════════════════════════════════════════════════════════
节省量按以下方式计算:对于每次调用,Semble 会记录包含已返回片段的唯一文件的字符总数,以及返回的片段的字符数。估算节省的 Token 数为 (文件字符数 − 片段字符数) / 4(每个 Token 按 4 个字符计算)。这是一个保守估算:基准是完整读取匹配到的文件,这也是编码 Agent 探索不熟悉的代码时常用的方式。
存储
默认情况下,Semble 的节省统计数据和任何已保存的索引都存储在操作系统的缓存目录中(macOS 上为 ~/Library/Caches/semble/,Linux 上为 ~/.cache/semble/,Windows 上为 %LOCALAPPDATA%\semble\Cache\)。若要更改此位置,可以设置环境变量 SEMBLE_CACHE_LOCATION,指定目标缓存目录的完整路径,例如 ~/my-folder/my-caches/semble。
首次使用时,Semble 还会从 Hugging Face 下载嵌入模型,并将其缓存在标准的 Hugging Face 缓存中(默认为 ~/.cache/huggingface/,如果设置了 $HF_HOME,则使用该目录);此操作仅执行一次,且需要网络连接。
使用 semble clear 删除缓存数据:semble clear index(已保存的索引)、semble clear savings(使用统计数据)、semble clear orphans(磁盘上已不存在的仓库对应的索引),或 semble clear all(所有数据)。
库的用法
Semble 也可以作为 Python 库使用,以便通过编程方式访问,适用于构建自定义工具或将搜索直接集成到你自己的代码中。
from semble import ContentType, SembleIndex

# Index a local directory (code only, the default)
index = SembleIndex.from_path("./my-project")

# Index docs and prose (markdown, rst, etc.)
index = SembleIndex.from_path("./my-project", content=ContentType.DOCS)

# Index everything (code, docs, and config)
index = SembleIndex.from_path("./my-project", content=[ContentType.CODE, ContentType.DOCS, ContentType.CONFIG])

# Index code and docs together
index = SembleIndex.from_path("./my-project", content=[ContentType.CODE, ContentType.DOCS])

# Index a remote git repository
index = SembleIndex.from_git("https://github.com/MinishLab/model2vec")

# Merge indexes from several repos into one (chunk paths are prefixed with the repo name)
index = SembleIndex.merge([("./service-a", SembleIndex.from_path("./service-a")), ("./service-b", SembleIndex.from_path("./service-b"))])

# Search the index with a natural-language or code query
results = index.search("save model to disk", top_k=3)

# Find code similar to a specific result
related = index.find_related(results[0], top_k=3)

# Each result exposes the matched chunk
result = results[0]
result.chunk.file_path   # "model2vec/model.py"
result.chunk.start_line  # 127
result.chunk.end_line    # 150
result.chunk.content     # "def save_pretrained(self, path: PathLike, ..."
当需要为大量文件建立索引时,CLI 和 MCP 服务会使用 4 个工作进程进行分块处理(SEMBLE_INDEX_WORKERS 用于设置进程数,0 表示禁用)。在 Python API 中,默认不启用此功能。要启用它,请设置 SEMBLE_INDEX_WORKERS,并在 if __name__ == "__main__": 代码块中调用 Semble,因为每个工作进程都会重新导入你的脚本。
MCP 服务
Semble 以 MCP 服务的形式运行,因此 Agent 可以直接将其作为原生工具调用来搜索任意代码库。仓库会按需建立索引并缓存;本地路径上的文件发生变化时,索引会自动更新。
| 工具 | 说明 |
|---|---|
search | 使用自然语言或代码查询搜索代码库。将 repo 设为本地路径或 https:// git URL(也可以传入路径列表,以同时搜索多个仓库),并将 content 设为 code、docs、config 或 all(默认值:code)。 |
find_related | 给定文件路径和行号,返回与该位置代码在语义上相似的代码块。 |
有关各 Agent 的设置说明,请参阅安装文档。要在多个 Agent 会话之间共享一个服务,请运行 semble --http;详情请参阅共享服务(HTTP)。
基准测试
我们在 19 种语言的 63 个仓库中使用约 1,250 个查询对质量和速度进行了基准测试(左图),并比较了在召回率相同的情况下与 grep+read 相比的令牌效率(右图)。
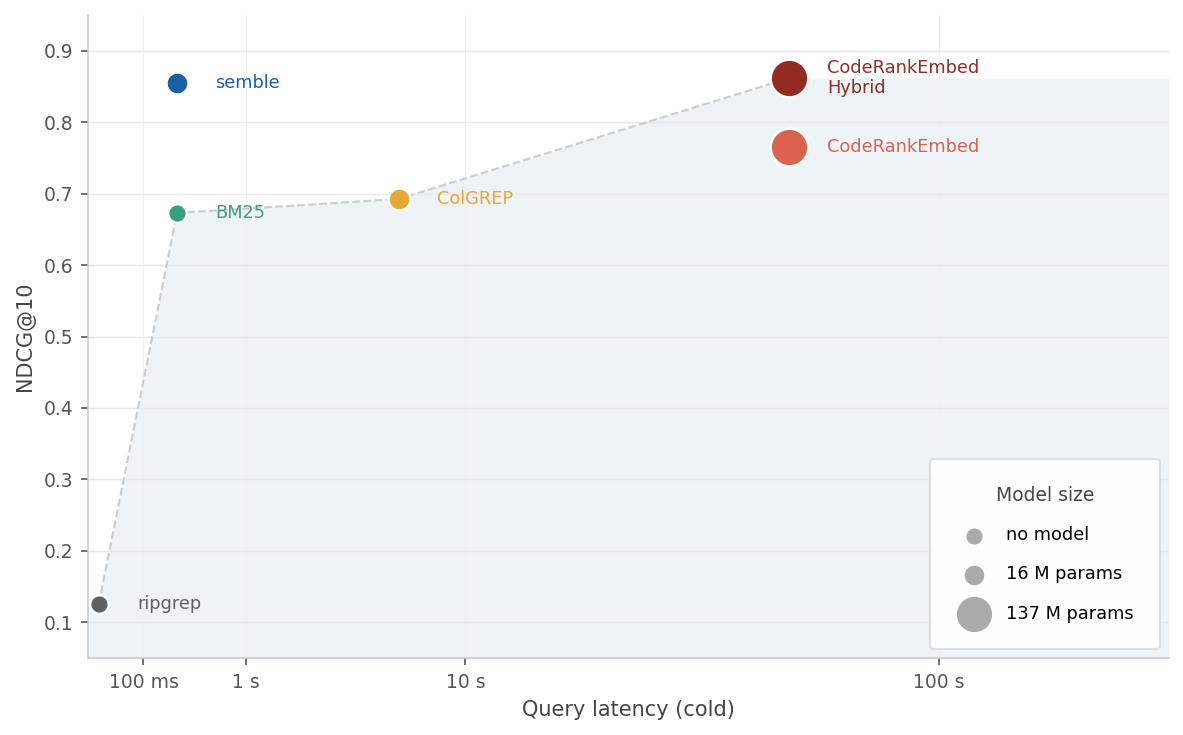 | 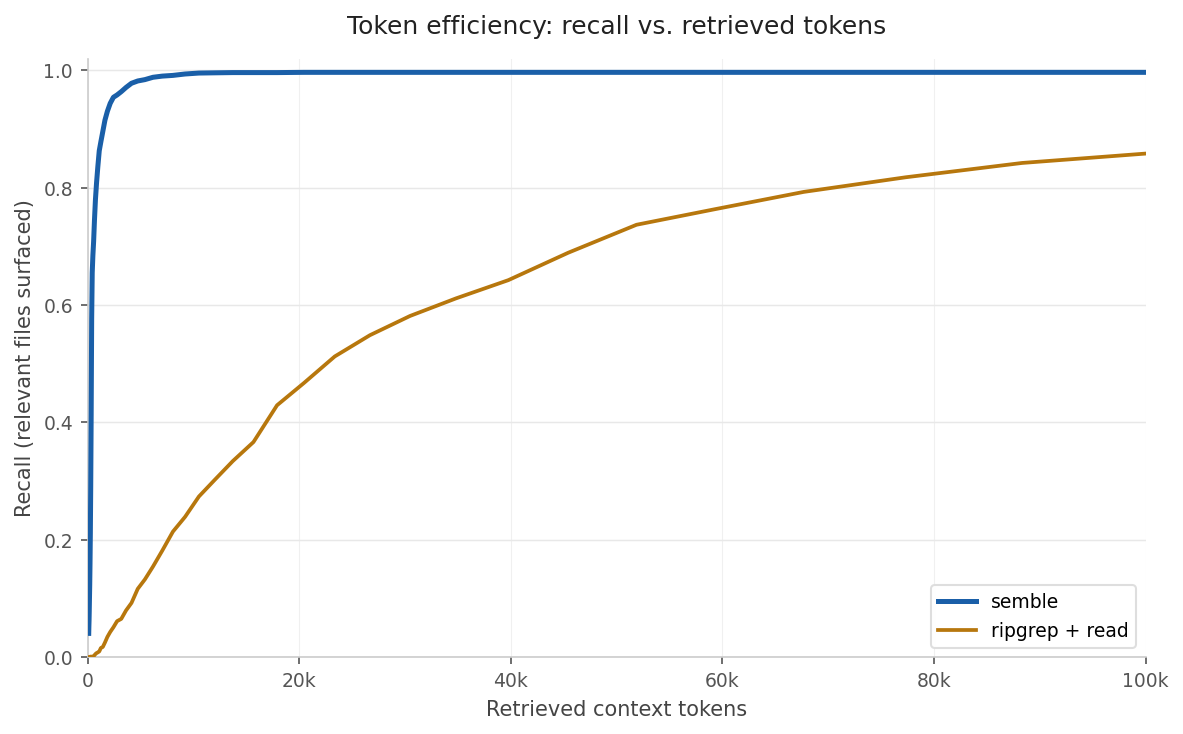 |
质量基准测试(左图)将检索质量(NDCG@10)与总延迟进行比较;semble 的质量与拥有 1.37 亿参数的 CodeRankEmbed 相当,而索引速度快 480 倍。令牌效率基准测试(右图)衡量各方法达到指定召回率所需的令牌数;semble 平均减少 99% 的令牌使用量,仅用 2k 个令牌即可达到 96% 的召回率,而 grep+read 需要完整的 100k 上下文窗口才能达到 85%。各语言的结果、消融实验和完整方法说明,请参阅基准测试。
工作原理
Semble 使用 tree-sitter 将每个文件拆分为能感知代码结构的片段,然后通过两个互补的检索器对每个查询与这些片段进行评分:使用代码专用模型 potion-code-16M-v2 生成静态 Model2Vec 嵌入,用于计算语义相似度;以及用于匹配标识符和 API 名称的 BM25 词法检索器。随后,使用倒数排名融合(RRF)合并两组评分。
合并后,结果会根据一组能感知代码结构的信号重新排序:
排序信号
- 自适应加权。 类似符号的查询(
Foo::bar、_private、getUserById)会获得更高的词法权重,而自然语言查询则在语义和词法检索器之间保持平衡。 - 定义加权。 定义所查询符号(
class、def、func等)的片段,排名会高于仅引用该符号的片段。 - 标识符词干。 查询词元会被提取词干,并与片段中的标识符词干匹配,从而额外提高包含这些词干的片段的权重。例如,查询
parse config会提高包含parseConfig、ConfigParser或config_parser的片段的排名。 - 文件关联性。 当同一文件中的多个片段与查询匹配时,该文件会获得加权,因此顶层结果反映的是文件整体相关性,而不是某个脱离上下文的片段。
- 噪声惩罚。 测试文件、
compat//legacy/兼容层、示例代码和.d.ts声明存根的排名会降低,从而让规范实现优先显示。
由于嵌入模型是静态的,查询时无需执行 Transformer 前向传播,因此所有操作都能在 CPU 上于数毫秒内完成。
首次搜索时,索引会自动缓存到磁盘。后续运行时,Semble 会遍历文件树并比较修改时间;新增、删除或更改的文件会被增量重新索引,无需重建其余索引。只有索引设置发生变化时才会完整重建(例如,升级 semble 后模型、分块方式或缓存格式发生变化)。在 MCP 模式下,文件发生变化时会自动检查并刷新索引,因此整个会话期间的结果都能保持最新。
使用自定义模型
如果你想使用其他模型,可以将 SEMBLE_MODEL_NAME 环境变量设置为本地路径或 Hugging Face 仓库。此路径会原样读取,并且应包含兼容 Model2Vec 的模型。如果你无法在运行时访问 Hugging Face,这一功能尤其有用。
致谢
感谢 Greptile 免费提供其 AI 代码审查平台的使用权限。
许可证
MIT
引用
如果你在研究中使用 Semble,请引用以下内容:
@software{minishlab2026semble,
  author       = {{van Dongen}, Thomas and Stephan Tulkens},
  title        = {Semble: Fast and Accurate Code Search for Agents},
  year         = {2026},
  publisher    = {Zenodo},
  doi          = {10.5281/zenodo.19785932},
  url          = {https://github.com/MinishLab/semble},
  license      = {MIT}
}
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。