关于 tokenmizer
TokenMizer 是面向 LLM 应用的本地代理,将会话构建为可查询的知识图谱,并在上下文耗尽时恢复相关信息。它还提供文件分析、缓存和令牌节省统计,并通过 MCP 工具访问图谱。
主要功能
- 01构建带关系和生命周期的会话图谱
- 02上下文耗尽时生成恢复内容
- 03分析文件并提取信息
- 04缓存响应并统计令牌节省
- 05支持多种会话领域
适用场景
- 01在新会话中恢复项目决策与待办
- 02追溯某项决策及其变更原因
- 03通过 MCP 检查会话图谱和节省统计
- 04分析大型文件
MCP 相关
TokenMizer 提供 MCP 服务,暴露会话检查点、恢复、图谱统计、节省统计、文件分析和决策追溯等工具。MCP 工具可直接读写图谱,不要求代理服务正在运行。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
5收录的工具列表 · 更新于 2 周前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| notes | string | 否 | 关于已完成工作的可选备注 |
| session_id | string | 是 | 此会话的唯一标识符(例如 'my-project-auth') |
详细介绍
TokenMizer
你的 AI 会忘记原因,TokenMizer 会记住。
一个兼容 OpenAI 的代理,可为你的会话构建知识图谱——记录决策、文件、错误、目标等,并在
上下文窗口耗尽时重放内容。它不是摘要,而是可查询的图谱,知道“我们从 MongoDB 切换到了 PostgreSQL,以及原因。”
一行即可接入 · 适用于 Claude、GPT、Gemini、Grok、DeepSeek、Mistral、Cohere、Ollama · MIT




快速开始 · 效果展示 · Claude Code & MCP · 基准测试 · 架构 · 路线图
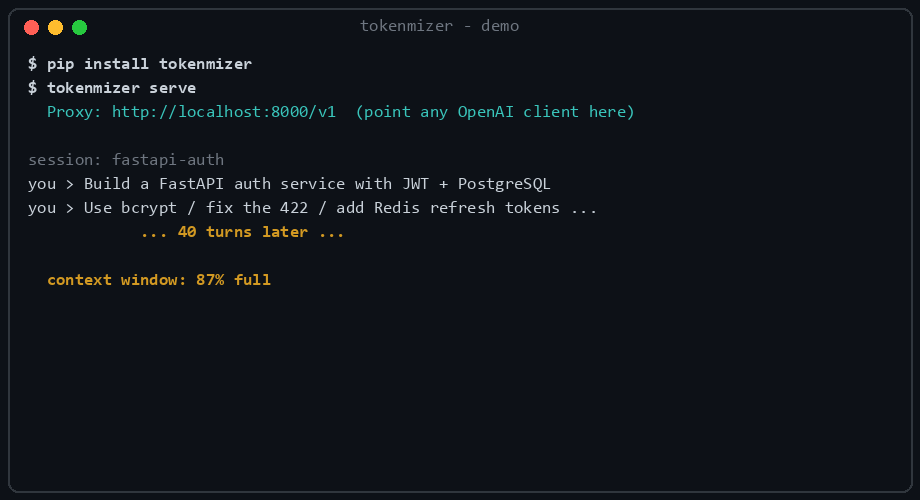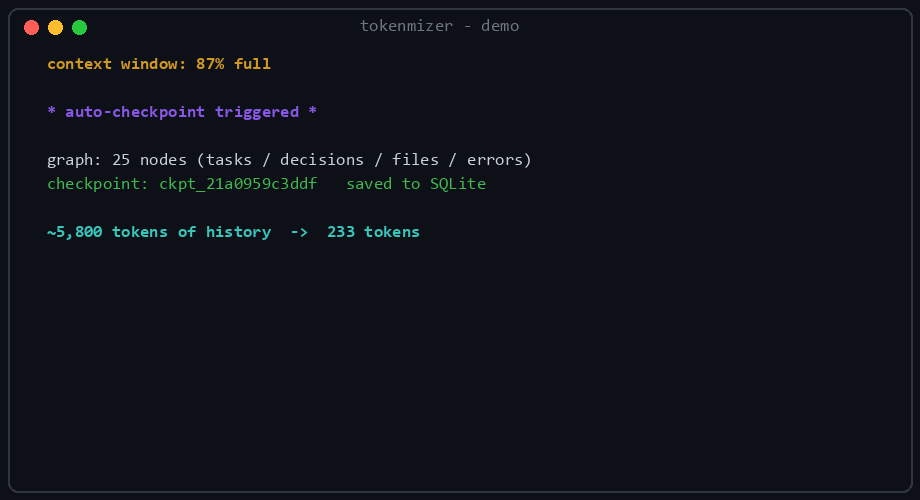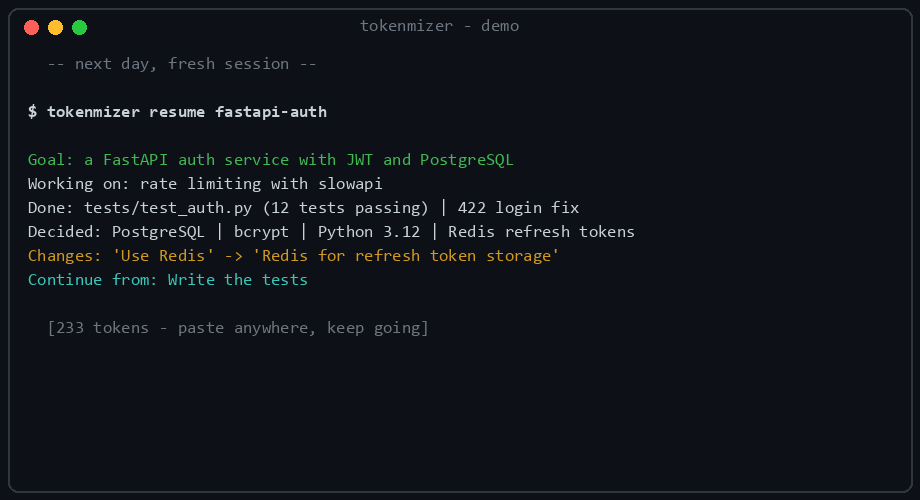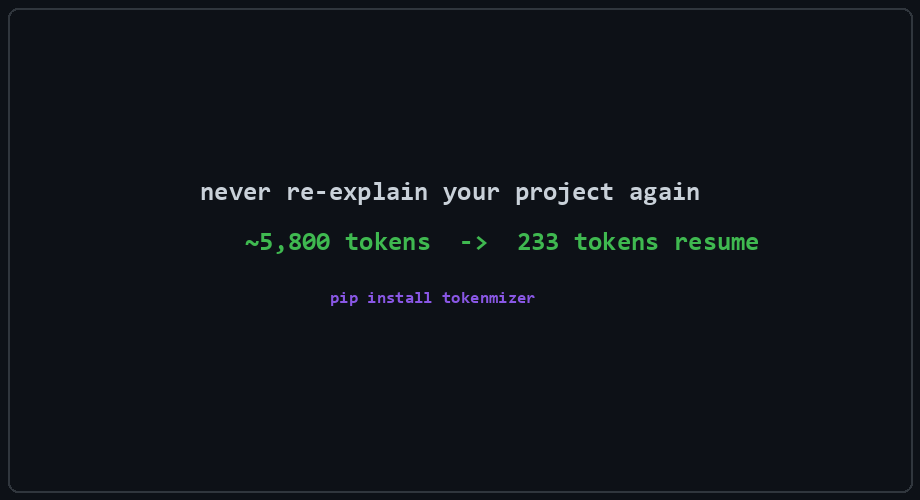
实际运行:25 个节点的图谱,检查点
ckpt_21a0959c3ddf,用 233 个 token 恢复。运行 python scripts/gen_demo_gif.py 重新生成。
问题
每次 AI 会话都有上下文限制。一旦达到限制,模型就会忘记数小时工作中形成的每个决策及其理由,而你不得不在下次会话开始时花上十分钟重新解释项目。
总结历史记录并不能解决这个问题。摘要会告诉你决定了什么,却会丢失为什么,也会丢失哪些方案被否决了——于是模型很乐意再次提出你在三次会话前就已经放弃的方案。
快速开始
pip install "tokenmizer[anthropic,cache]"
export TOKENMIZER_ANTHROPIC_API_KEY=sk-ant-...
tokenmizer serve
然后在客户端中修改一行:
from openai import OpenAI

client = OpenAI(
    api_key="your-key",
    base_url="http://localhost:8000/v1",   # only this changes
)

resp = client.chat.completions.create(
    model="claude-sonnet-4-6",
    messages=[{"role": "user", "content": "Continue where we left off"}],
    extra_body={"session_id": "my-project"},   # optional, enables memory
)
其他内容都保持不变:请求格式相同,响应格式相同,
另外增加一个 tokenmizer 区块,用于报告节省的内容。打开
http://localhost:8000,会话就已经在那里了。
Windows、Ollama、Docker 和完整分步指南
Windows(PowerShell)
$env:TOKENMIZER_ANTHROPIC_API_KEY = "sk-ant-..."   # this session
setx TOKENMIZER_ANTHROPIC_API_KEY "sk-ant-..."     # persistent
没有 API 密钥? Ollama 可在本地免费运行:
ollama pull llama3
pip install tokenmizer
# then set `provider: ollama` in tokenmizer.yaml
Docker
docker compose up -d
完整的安装说明、各提供商的环境变量以及配置参考,请参阅 docs/configuration.md 和 docs/deployment.md。
查看效果
这里展示的都不是模型图。每张截图和下方的演示都来自已发布的 UI,呈现的是
benchmarks/eval/corpus 中带标签的数据集里的会话。
会话图谱是可交互的页面,而不是图片
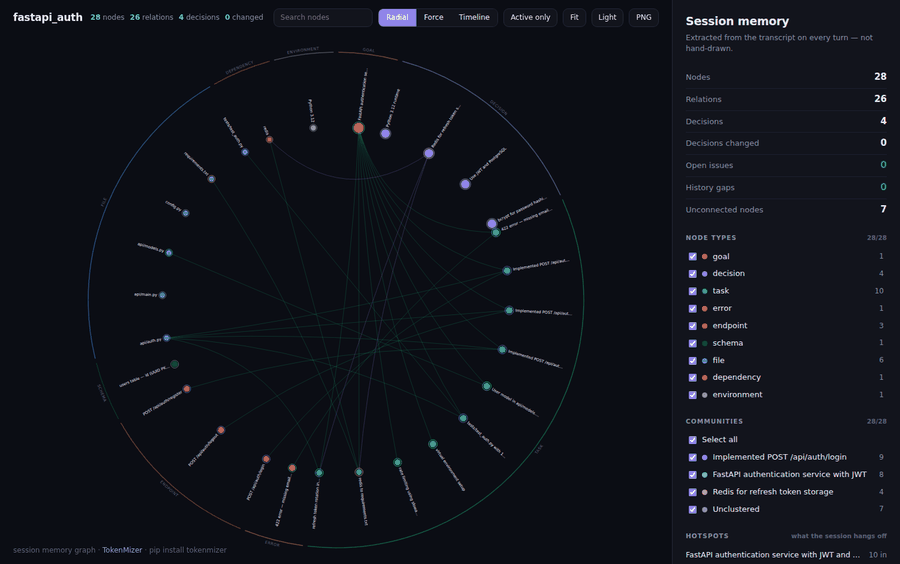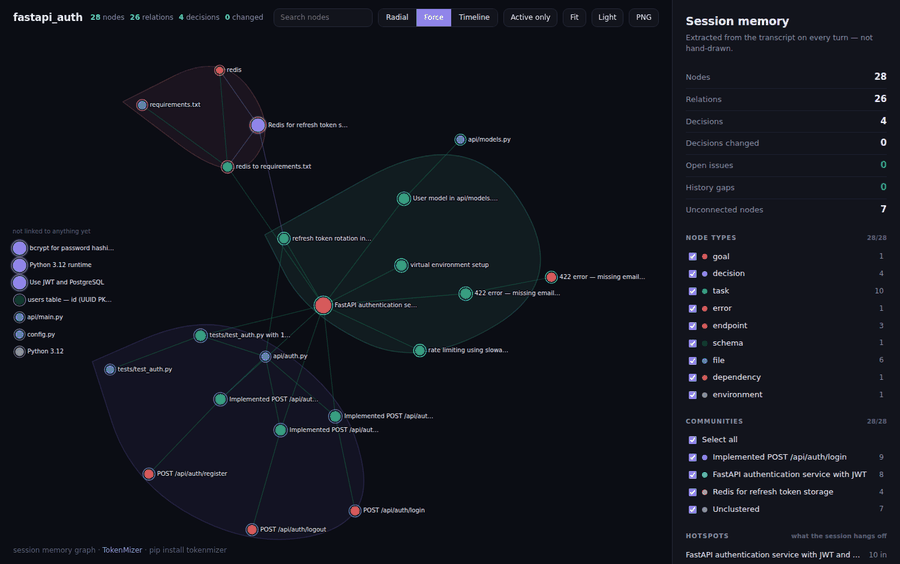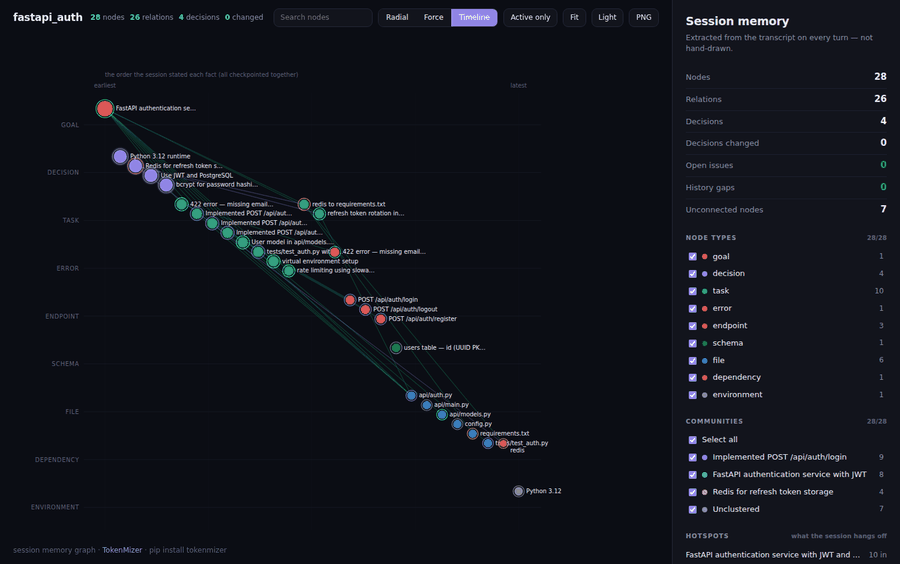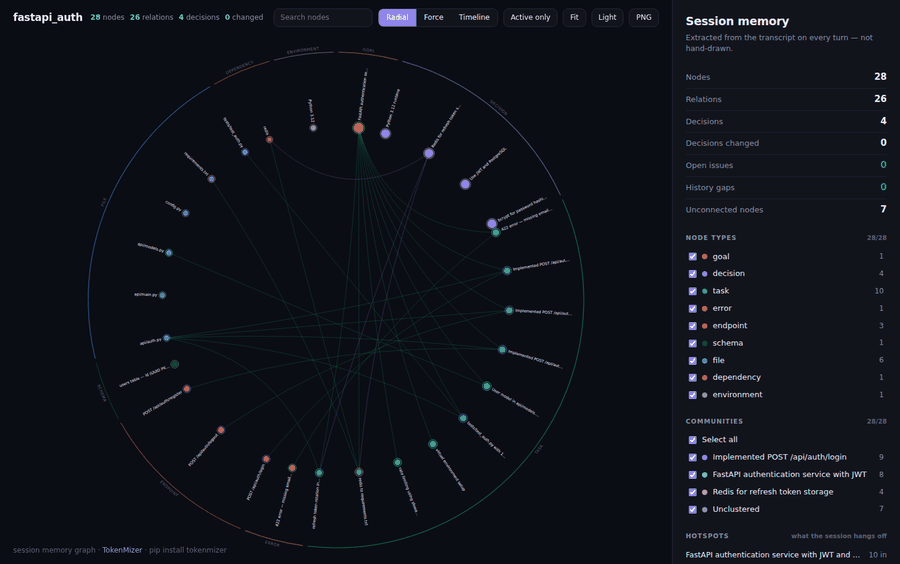
径向图 → 选择节点 → 力导向图 → 筛选类型 → 时间线 → 浅色主题。使用
python scripts/gen_graph_demo.py 重新生成。
选择一个节点,即可查看其类型、状态、社群、重要性、置信度、 首次出现时间以及它包含的所有关系——也就是事实背后的来源信息, 而不只是事实本身。筛选类型或社群时,计数也会随之变化。三种布局、浅色主题和 PNG 导出都只需点击一次。
这是一个完全独立的 HTML 文件,不会发出外部请求,因此可以离线打开、通过
file:// URL 使用,也可以发送给从未安装过 TokenMizer 的人。
仪表板展示它实际掌握的信息
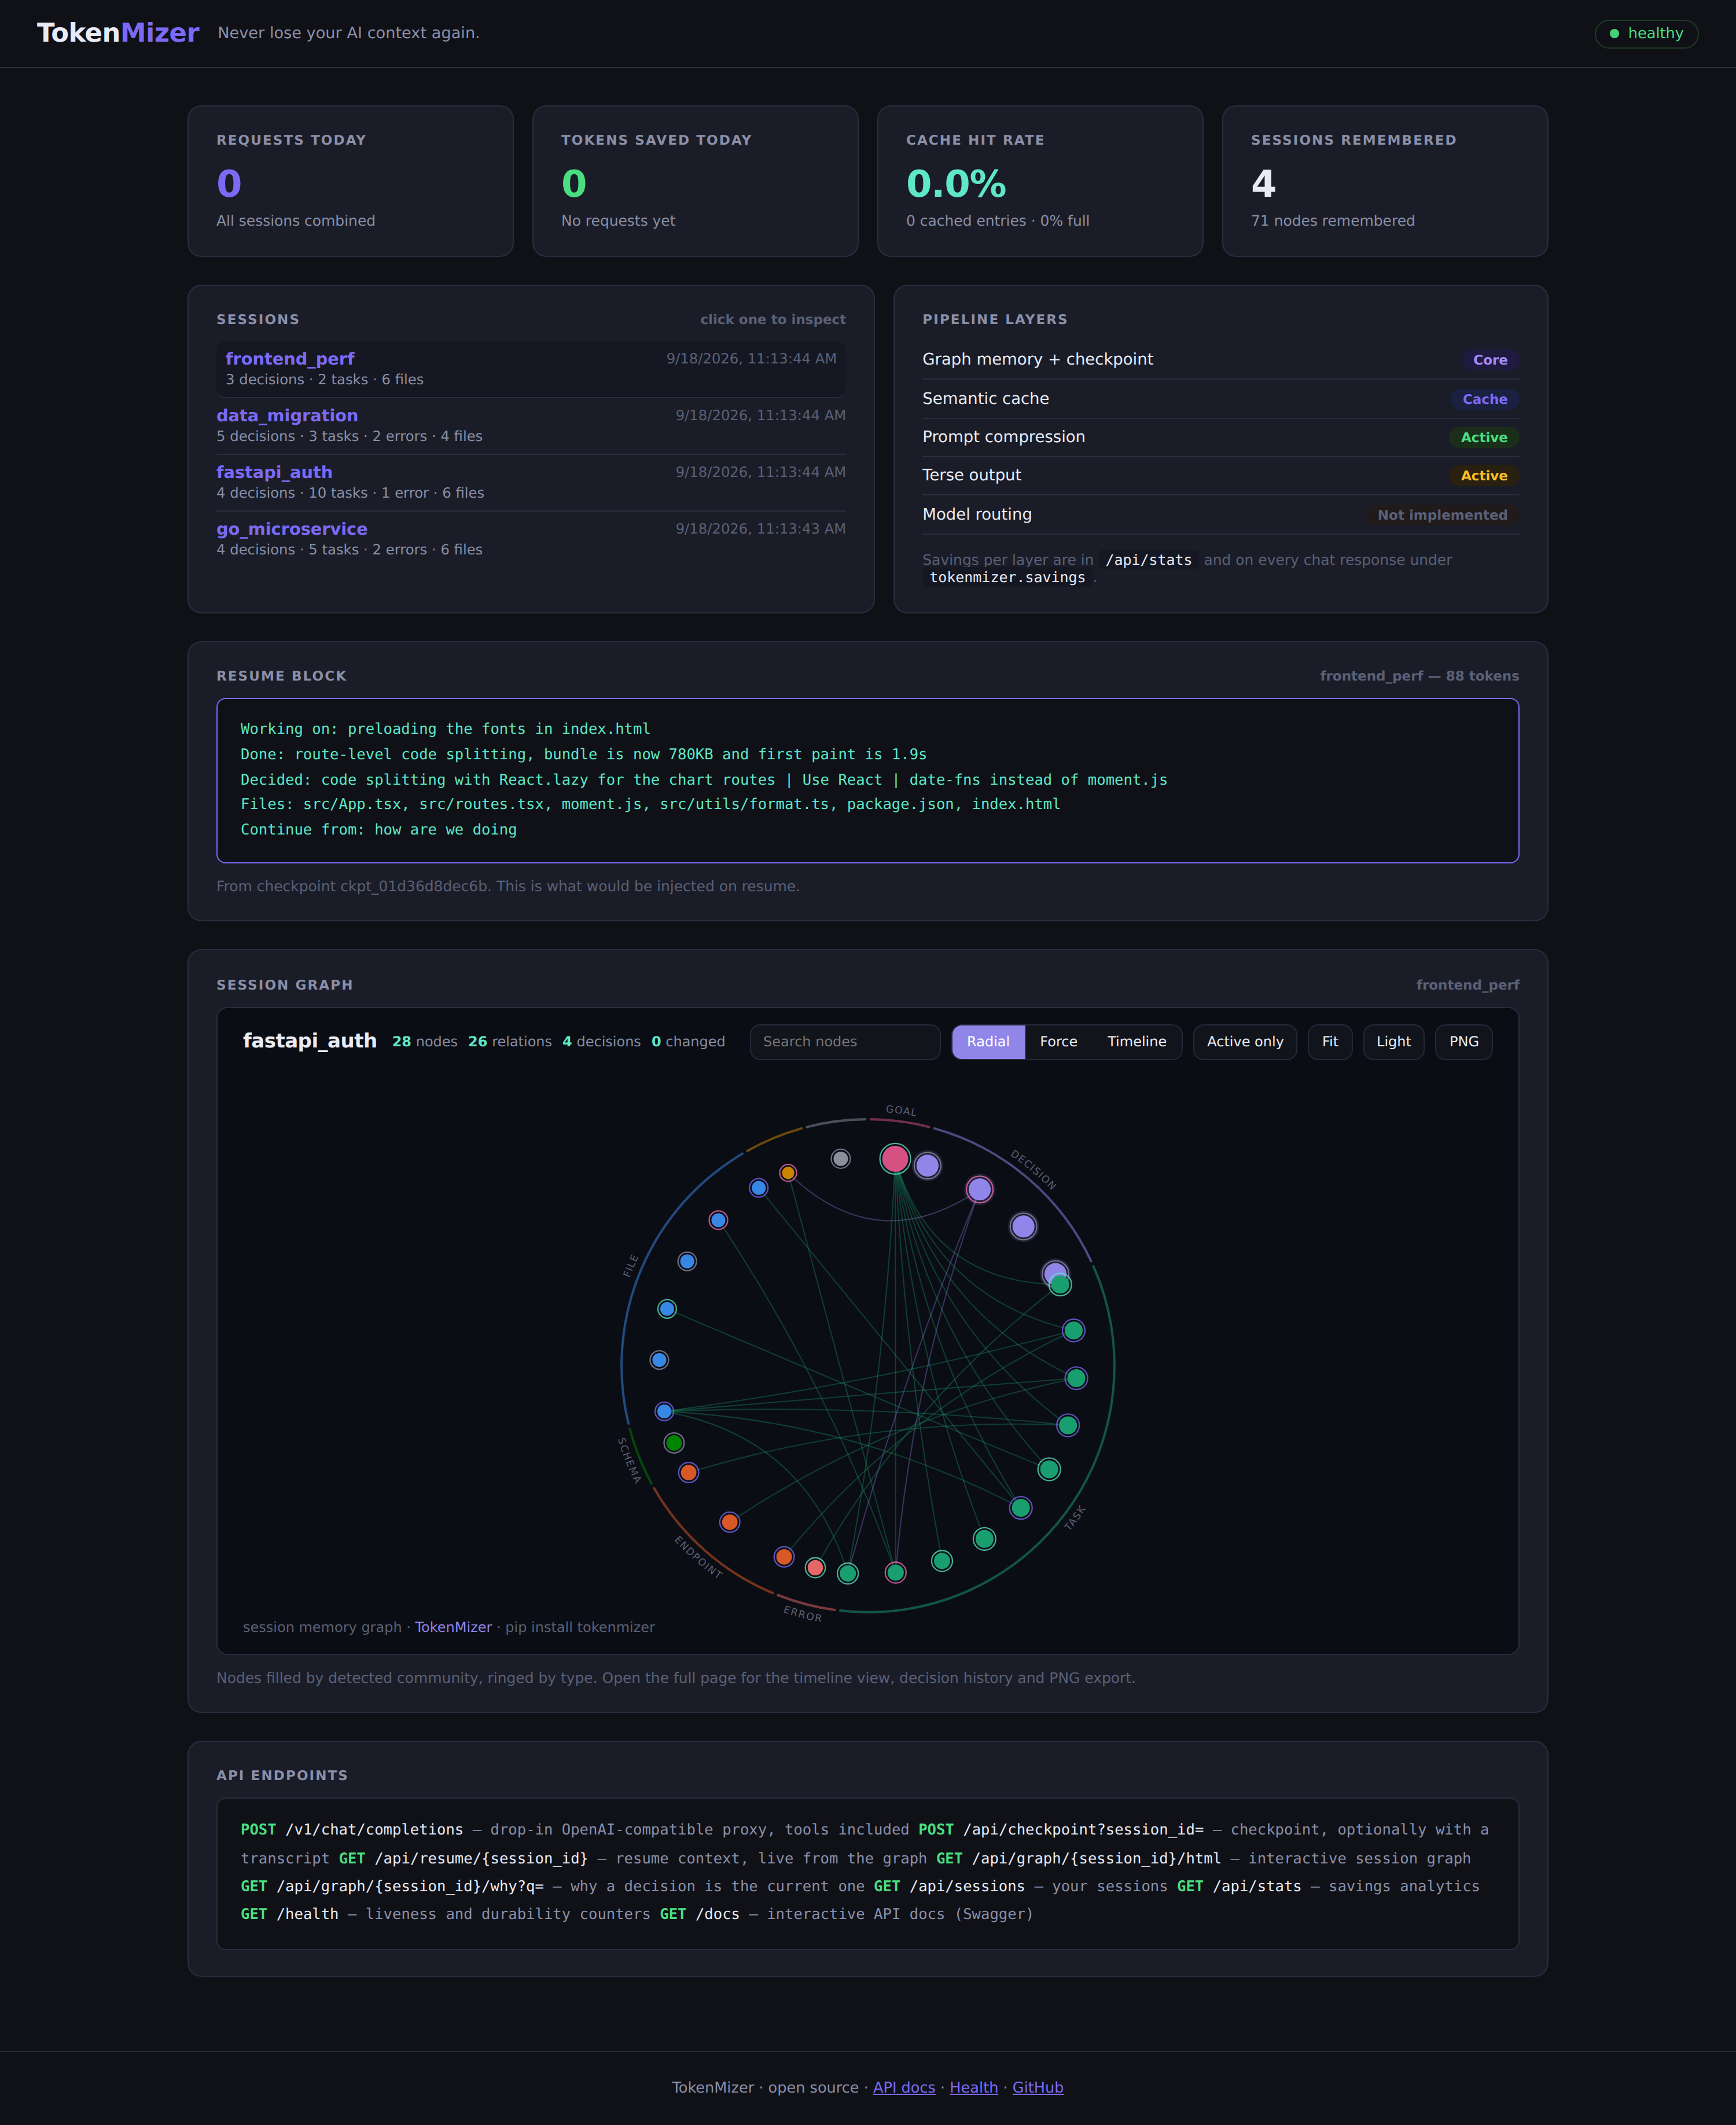
这里展示的是你的会话、每个会话此刻将注入的实时恢复区块,以及对应的图谱——
不是某个示例。健康状态指示器读取 /health;写入失败时,它会报告 degraded
并显示相关计数,而不是不管发生什么都显示 ok。
按照你的思路分组的会话图谱
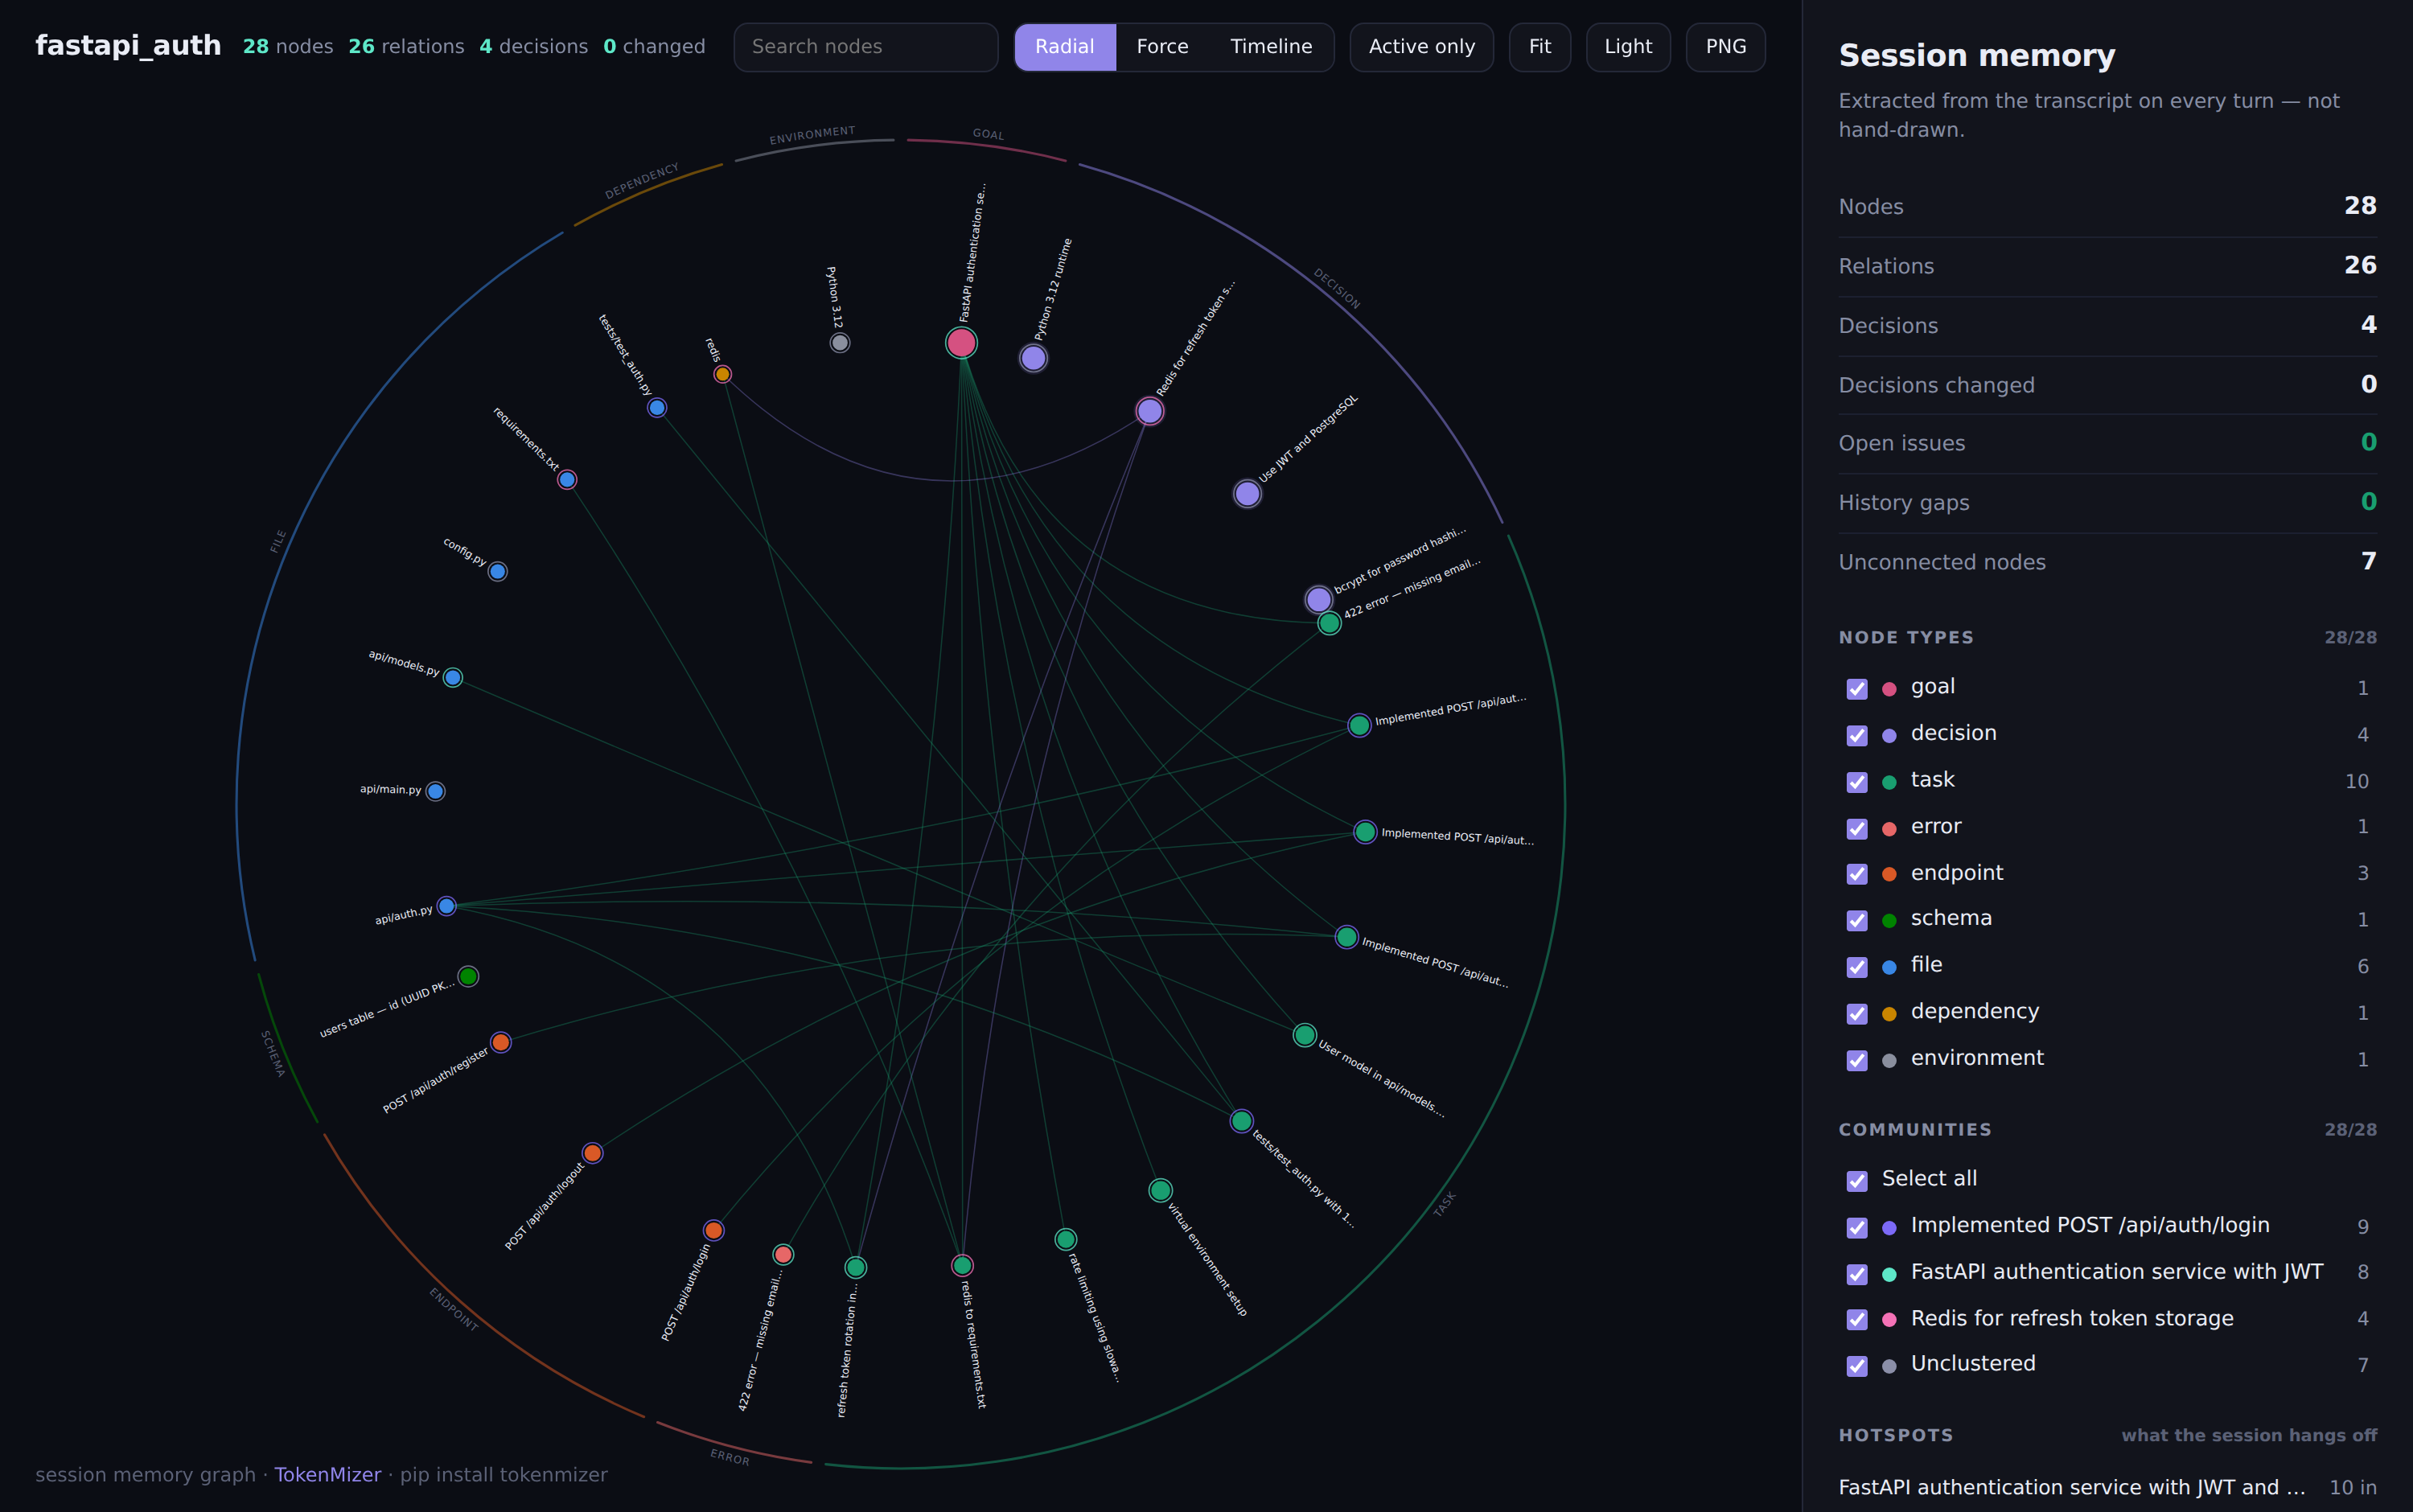
每种节点类型都占据圆的一段弧,并在圆环上标注名称;关系则以弦线形式穿过 中央。因此,即使还没读任何标签,也能看出会话的整体形状;判断节点属于哪种类型, 依据的是它所在的位置,而不是区分两种色调。调色板经过验证器检查,而非凭肉眼判断: 所有相邻颜色对都达到色觉障碍区分度下限,而四种本身不承载意义的类型则共用一种中性灰色。
旁边的面板统计会话掌握了哪些信息,以及缺少哪些信息—— 未解决的问题、变更过的决策、历史记录缺口、未连接的节点—— 然后列出检测到的社群、所有内容都围绕其展开的热点,以及不同类型的节点之间的指向关系。 可按类型或社群筛选、搜索,也可点击节点查看其背后的替代链。
同一会话的故事
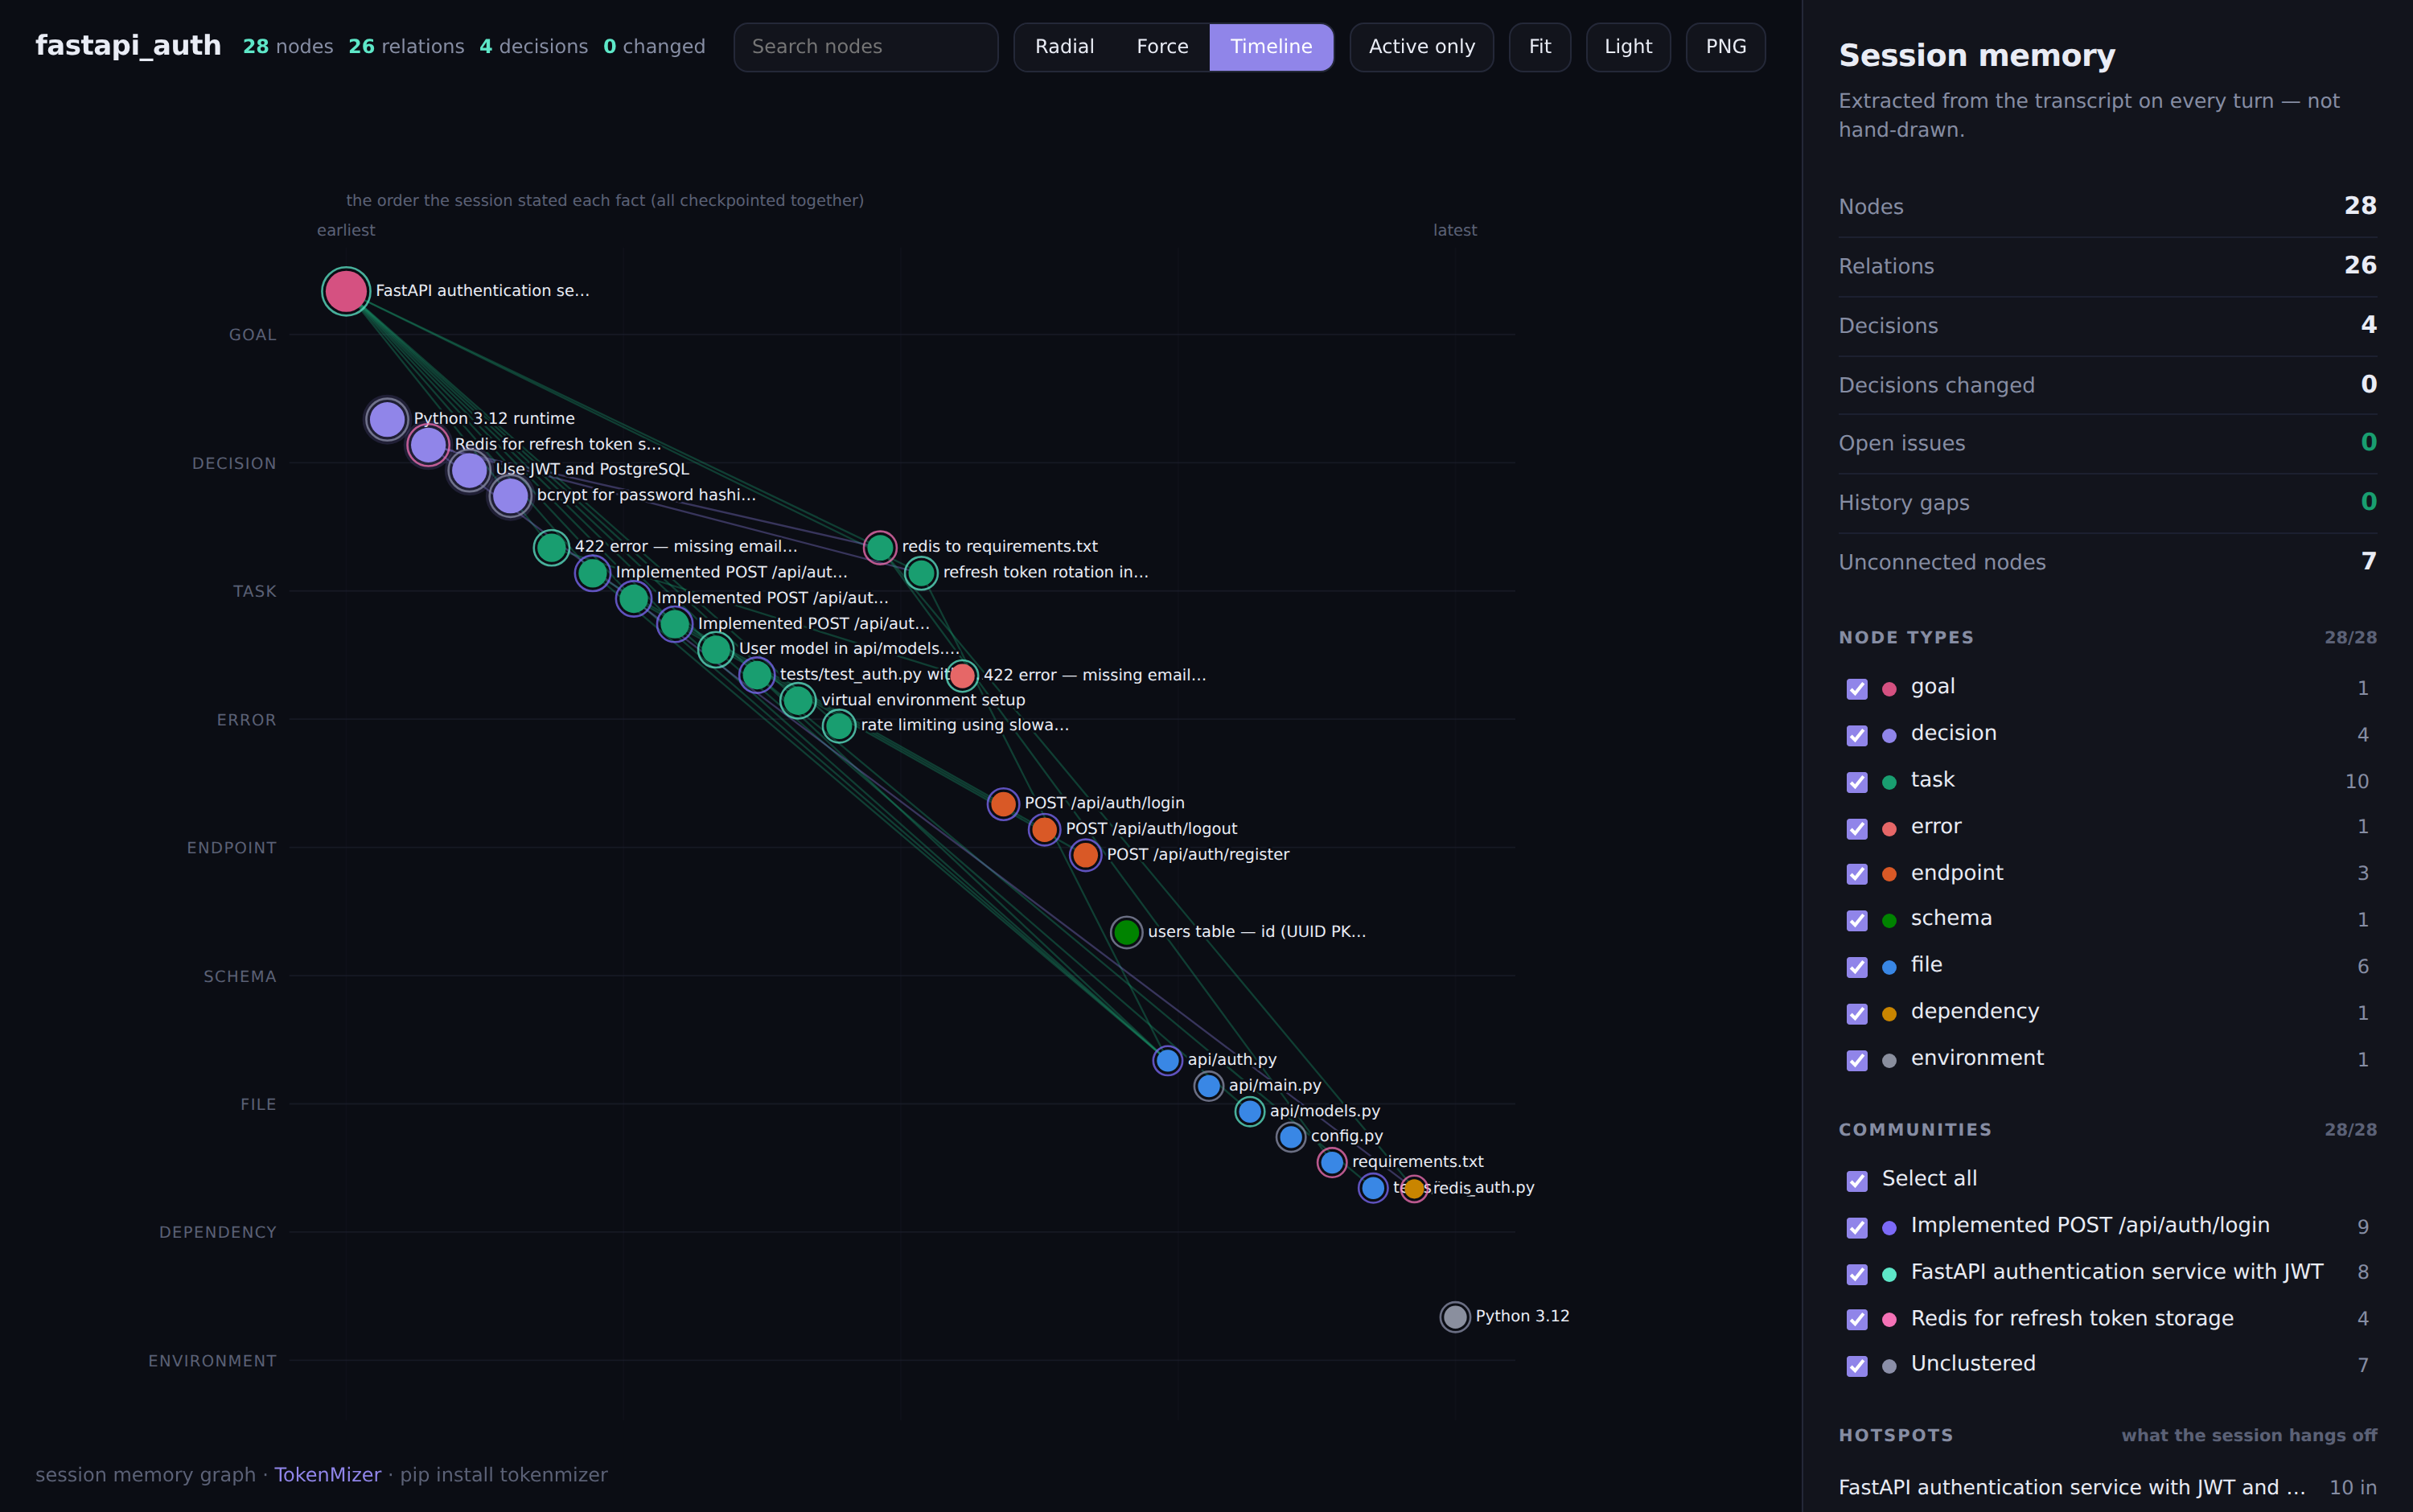
时间线模式会将每种节点类型放在独立泳道中,并按照事实进入会话的时间排序;取代关系则以弧线表示。如果一次调用就为整份记录创建了检查点,那么所有节点的时间戳都相同,时间轴会明确标出这一点,并退回到会话陈述内容的顺序,而不是凭空编造日期。
工作原理
TokenMizer 是应用与任意大模型之间的本地代理。每个请求都会经过一条处理流水线,构建实时知识图谱、压缩输入、缓存响应,并在上下文耗尽前创建检查点。
flowchart LR
    App["Your app<br/><sub>OpenAI-compatible client</sub>"]
    subgraph TM["TokenMizer :8000"]
        direction TB
        L0["<b>L0</b> File intelligence"]
        L1["<b>L1</b> Prompt compression"]
        L2["<b>L2</b> Terse-output injection"]
        L4["<b>L4</b> Graph memory<br/><sub>extract to window to inject</sub>"]
        L3["<b>L3</b> Semantic cache"]
        L5["<b>L5</b> Provider prompt cache"]
        L0 --> L1 --> L2 --> L4 --> L3 --> L5
    end
    LLM["Claude · GPT · Gemini<br/>Grok · DeepSeek · Ollama"]
    DB[("SQLite<br/><sub>graph · checkpoints · ownership</sub>")]

    App -->|"POST /v1/chat/completions"| TM
    TM --> LLM
    LLM -.->|response| TM
    TM -.->|"response + savings"| App
    L4 <-->|"per-row, locked"| DB
图谱不是摘要,而是具有生命周期的类型化节点和边——包括决策、任务、文件、错误、目标等。因此,被取代的决策会标记为已取代,而不是删除;状态转换还会记录触发原因。恢复内容块是从图谱中筛选出的视图,其中包含有效决策、未完成工作和未解决错误,总共只需几百个 token。
边承载着会话中实际存在的关系。修复错误的任务会通过 FIXES 关联错误节点,并将其关闭。未解决的错误会通过 BLOCKS 阻塞与之相关的任务。决策会通过 DEPENDS_ON 关联其指定的软件包。上文所示的社区检测依据的正是这些关系,/why 也会沿着这些关系追溯。
查看架构——请求顺序、数据模型和决策生命周期。
恢复内容是什么样的
Goal: FastAPI authentication service with JWT and PostgreSQL
Working on: refresh token rotation in api/auth.py | rate limiting using slowapi
Done: Implemented POST /api/auth/login | Fixed the 422 in LoginRequest | User model in api/models.py
Decided: Use JWT and PostgreSQL | bcrypt for password hashing | Redis for refresh token storage
Changes: 'Use moment.js' -> 'Use date-fns' - tree-shakeable, saves 230KB
Files: api/auth.py, api/models.py, config.py, tests/test_auth.py
Continue from: Add rate limiting to auth endpoints
用几百个 token 取代整段对话。摘要会丢失 Changes: 这一行所包含的信息;而
GET /api/graph/{session_id}/why?q=date-fns 会重放完整链路,展示每一步的触发因素、原因和证据。
记录习惯,而不只是项目
会话图谱会记住你对这个项目做出的决定,但不会记住你喜欢简短的回答——这是关于你本人的偏好,而非代码库的属性;即使在别处开始新会话,这种偏好也应该保留。
preferences:
  enabled: true      # off by default; read the note before turning it on
启用后,像“I prefer TypeScript, and keep answers brief”这样的对话轮次会按主体记忆,并作为几行系统提示词注入。/api/preferences(GET)会准确显示记住的内容以及注入的具体文本;使用 DELETE 并添加 ?key=... 调用同一路径可忘记一项偏好,不指定键则会忘记全部偏好。
默认关闭是有意为之。 偏好记忆的失败模式不是忘记,而是记住一条其实并非偏好的内容,并在一年内发送的每个提示词中反复提及。检测器采用一组正则表达式,因此会产生误报;这正是提供上述端点、并要求你主动启用此功能的原因。
不仅适用于编码会话
设置 domain 后,同样的五种结构会以另一套词汇进行识别。事故频道里没人会说“Decided:”,研究日志里也没人会说“Fixed:”,这就是为什么过去这些会话几乎无法恢复任何内容(宏平均 F1 为 11%,决策和错误均为 0%)。
domain: ops # coding (default) · research · ops · product
Incident: We are seeing an incident on the pricing service, checkout is failing
Mitigating: Still monitoring the replica lag | Follow-up to add a pool-size alert
Done: Restarted the pool workers and rolled back to build 4471 | Traffic is recovered
Decided: Root cause is connection pool exhaustion after the 14:02 deploy
Symptoms: Error rate is 34 percent and p99 latency jumped to 8 seconds
在 benchmarks/eval/corpus_domains 的标注会话上,结果从 11% 提升到 93%,同时编码语料保持不变——领域包的模式会在编码模式之后运行,只会增加识别结果。评测仅使用了三个手写会话,因此应理解为“该机制适用于这种形式的会话”,而非对普遍适用性的断言;基准测试也表达了同样的观点。
在工具中使用
有四种接入方式,可根据你的工作环境选择。它们都使用同一个图谱,因此在 Claude Code 中创建检查点的会话也能在命令行中恢复。
Claude Code — 插件
/plugin marketplace add Shweta-Mishra-ai/tokenmizer
/plugin install tokenmizer@Shweta-Mishra-ai/tokenmizer
然后,在任意会话中:
/tokenmizer:checkpoint my-project      save the session to graph memory
/tokenmizer:resume my-project          load it back (~300 tokens)
/tokenmizer:analyze data/sales.csv     digest a large file
/tokenmizer:stats                      token savings report
Claude Desktop、Cursor、VS Code、Zed — MCP 服务
{
  "mcpServers": {
    "tokenmizer": {
      "command": "tokenmizer-mcp",
      "env": { "TOKENMIZER_URL": "http://localhost:8000" }
    }
  }
}
| 客户端 | 配置位置 |
|---|---|
| Claude Desktop(macOS) | ~/Library/Application Support/Claude/claude_desktop_config.json |
| Claude Desktop(Windows) | %APPDATA%\Claude\claude_desktop_config.json |
| Claude Code | 项目中的 .mcp.json,或 ~/.claude/settings.json |
| Cursor | 设置、MCP、添加服务,使用相同的 JSON |
| VS Code / Zed | 它们的 MCP 设置,使用相同的 command 和 env |
| Codex CLI | ~/.codex/config.toml — TOML,参见 docs/api.md |
之后重启客户端。无需启动其他任何东西:
当 tokenmizer serve 未运行时,checkpoint_session、resume_session、get_graph_stats、why_decision
和 analyze_file 都会直接读写图谱,并说明是哪个路径提供了结果。只有要查看节省情况时才需要代理,因为节省情况是根据经过代理的请求来衡量的。如果
tokenmizer-mcp 不在你的 PATH 中,请使用
"command": "python", "args": ["-m", "tokenmizer.mcp.server"]。
六个工具: checkpoint_session、resume_session、get_graph_stats、
get_savings_stats、analyze_file 和 why_decision — 询问你的 Agent
“我们为什么选择 X?”,它就会沿着取代链梳理,并说明每一步的原因和证据。
其他情况 — 代理
任何兼容 OpenAI 的客户端都可以将 base_url 指向
http://localhost:8000/v1 来使用,如上方快速入门所示。这涵盖了
Continue.dev、Aider、LangChain、LlamaIndex、所有语言的 OpenAI SDK,以及
curl。
工具调用也会经过代理。 按 OpenAI 格式发送 tools / tool_choice,即可获取
message.tool_calls,无论是否采用流式传输;role: "tool" 的结果也会往返传递给模型:
resp = client.chat.completions.create(
    model="claude-sonnet-4-6",
    messages=[{"role": "user", "content": "weather in Pune?"}],
    tools=[{"type": "function", "function": {
        "name": "get_weather",
        "parameters": {"type": "object", "properties": {"city": {"type": "string"}}}}}],
    extra_body={"session_id": "my-project"},
)
call = resp.choices[0].message.tool_calls[0]     # finish_reason == "tool_calls"
OpenAI、DeepSeek、Mistral、OpenRouter 和 Grok 原生支持;Anthropic、Ollama、Gemini 和 Cohere 则会进行转换。全部九家提供商均支持流式和非流式传输——每家提供商的工具调用都会以 OpenAI 格式的增量内容传入流中,无论提供商是分段发送(Anthropic、Cohere),还是一次性完整发送(Ollama、Gemini)。工具流量绝不会压缩,工具调用轮次也绝不会缓存。
查看API 和 CLI 参考 — 所有端点、所有命令、 所有 MCP 工具。
在 Agent 内部 — 进程内运行,无需服务
对于已自行管理消息的 Agent 循环,可直接使用记忆功能。 无需代理、API 密钥或网络;它使用的 SQLite 存储与代理相同,因此 Agent 和代理可以共享一个会话。
from tokenmizer.agents import Memory

memory = Memory("order-service")          # default: the working directory name
memory.add(messages)                      # {"role", "content"} dicts; idempotent
memory.search("what are we storing orders in", top_k=5)
memory.context(token_budget=400)          # resume block for the system prompt
memory.why("postgres")                    # the decision trail
search 返回普通字典(type、label、summary、status、
confidence);decisions() 和 errors() 分别列出对应类别。使用方式相同,适用于 LangGraph、CrewAI、AutoGen 或手写循环:调用 add
传入目前为止的对话内容,并将 context() 放入系统提示词。
测量结果
python -m benchmarks.eval 使用一个包含 14 个会话(其中 6 个是真实对话记录)的标注语料库,评估提取结果:
| 类别 | 精确率 | 召回率 | F1 |
|---|---|---|---|
| 文件 | 100% | 100% | 100% |
| 决策 | 97% | 100% | 99% |
| 已完成任务 | 98% | 98% | 98% |
| 待处理任务 | 100% | 90% | 95% |
| 错误 | 93% | 96% | 94% |
| 宏平均 F1 | 97% |
报告的是精确率,而不仅仅是召回率。 如果提取器把整段对话记录作为一个节点输出,就能得到 100% 的召回率。因此,应该对仅报告召回率的提取指标持怀疑态度——包括我们早先给出的指标。
按来源分别评分,因为手写测试样例比真实对话记录容易处理,而单一总分会掩盖这一点:合成数据 98%,
真实数据 91%。 91% 才是反映真实会话的数字。n=14
是一个小样本,而且所有标签都由同一个人编写。
检索单独评估。 python -m benchmarks.graph_retrieval.query_eval 对 query() 返回的内容进行评分,问题采用人们提问的方式,而不是节点自己的措辞:仅使用关键词排序时,40 个案例的 recall@6 为 88%。在这个分支之前,评估只有 13 个案例,其中一个案例的结果翻转就会让总体数据相差 8 个百分点;每个案例都经过检查,确保能从各自的转录中找到答案,因为无法从原文中得到答案的问题衡量的是信息提取能力,而且会一直被误判为检索失败。只有在模型确实成功加载时,semantic_retrieval: auto 才会启用嵌入相似度;此前引用的 92% 数据早于评估集扩充,尚未重新测量。
端到端评估输入成本。 python -m benchmarks.savings.runner 通过真实代理重放一段对话,并使用一个模拟 Anthropic 文档所述提示词缓存规则的替代服务。与不使用缓存、每次都发送完整历史记录的客户端相比,40 轮时输入成本降低 61%,150 轮时降低 87%,300 轮时降低 93%;与已缓存自身历史记录的客户端相比,40 轮时成本高 10%,150 轮时持平,300 轮时低 41%。十轮会话的输入成本高 21%:会话未达到缓存最低要求,而且约 50 个 token 的简洁指令会在每次请求中计费,缩短输出所节省的成本则未计入。详情和注意事项见 基准测试。
Agent 会话单独评估,因为它们发送的内容大多是工具输出,而不是散文。在一个真实的 23 次请求 Agent 会话中,与仅使用客户端相比,代理发送的 token 少了 70%;而在本次发布之前,它没有减少任何 token。与会缓存自身历史记录的客户端相比,成本低 20%;代理随后在请求中使用的内容仍有 97% 得以保留(58 次请求时为 94%)。这只是一次会话的输入成本估算;保留信息不等于答案质量。详见 基准测试。
经独立测试,与另外 7 种方法进行了比较。 一项包含 100 个会话的独立基准测试(tokenmizer-research,使用的语料和评分器与上述数据不同)显示,TokenMizer 0.5.4 并列第一,宏平均 F1 为 60%,与 Mem0 风格方法(60%)和 Graphiti 风格方法(59%)相当,领先于 GraphRAG 风格方法(44%)、MemGPT 风格方法(35%)以及所有朴素基线(低于 20%)。
基于真实 Agent 流量评估,而非仅使用标注语料。 同一研究仓库在 1,467 个公开的 SWE-bench Agent 会话上运行该产品:包括使用 GPT-4、GPT-4o、Claude 3 Opus 和 Claude 3.5 Sonnet 的 SWE-agent,以及通过函数调用运行的 OpenHands,共约 3,100 万个 token。没有任何标签是手动编写的:
- Agent 编辑的文件取自其提交的补丁;
- Agent 的错误取自工具结果中的回溯信息和代码检查器输出。
会话按问题划分。仅在其中一半会话上查找 Bug;随后在另一半(716 个会话)上分别对修复前后的结果评分,各进行一次:
| 测试集,716 个会话 | 修复前 | 修复后 |
|---|---|---|
| 找回的运行时错误 | 63% | 92% |
| 到达恢复区块的运行时错误 | 20% | 50% |
| 到达恢复区块的已编辑文件 | 51% | 67% |
| 与真实错误相匹配的提取错误(下限) | 16% | 31% |
| 已编辑文件召回率 | 75% | 78% |
在生产环境条件下,每次调用发送一条消息,运行时错误召回率从 72% 提高到 96%。
对比方法只能找回这些运行时错误的 5–12%。完整表格、置信区间和有效性威胁:
REPORT_real_agents.md。
前往基准测试——了解记忆质量与纯摘要基线的对比、存储情况,以及如何评估自己的会话。
为什么选择 TokenMizer,而不是 X?
为什么不直接使用 Git 历史? Git 记录的是发生了什么变化,而不是你为什么决定改变它。你无法向 Git 询问“我们对身份验证做了什么决定?”或“我们为什么从 MySQL 切换到 PostgreSQL?”TokenMizer 会记录决策的触发因素、原因和证据,而不是差异。
为什么不使用 RAG(检索增强生成)?
RAG 检索的是相关片段,而不是对决策状态建模。如果你在会话中途从 bcrypt 切换到 Argon2,RAG 可能会同时检索两者,导致模型混淆当前使用的是哪一个。TokenMizer 会明确跟踪决策的取代关系:旧决策标记为 SUPERSEDED,新决策标记为 ACTIVE,恢复上下文只包含当前状态。
为什么不在每次会话开始时提供一份普通摘要? 摘要会丢失结构。面对一大段文本,你无法查询“所有已被取代的决策”或“是什么触发了身份验证方式的变更”。我们的基准测试显示,与79% 的摘要基线相比,图记忆保留了 89% 的已标注信息;而且与摘要不同,图可查询、可编辑,并且会逐步扩展,而不是每轮都重新生成摘要。请参阅基准测试。
为什么不使用 Mem0 或 Zep? Mem0 和 Zep 存储的是事实(“用户偏好 Python”)。TokenMizer 存储的是带有依据的决策——完整的因果链:做出了什么决定、什么取代了它、原因是什么、什么证据触发了变更。如果你需要“在不同会话中记住我的名字”,请使用 Mem0。如果你需要“记住我们因为成本原因从 PostgreSQL 切换到了 SQLite,证据如下”,请使用 TokenMizer。
为什么不使用 Graphiti? 两者都会构建时序知识图谱,在上述独立基准测试中的得分也相差不到 1 分。两者在运维方面有所不同:TokenMizer 使用 SQLite 运行,无需部署数据库;它会将图谱打包为独立的 HTML 页面,你可以离线打开或发送给他人;它还是一个兼容 OpenAI 的代理,因此采用它只需更改基础 URL,无需集成。若你已经在运行 Neo4j,并且希望使用 Cypher 查询图谱,Graphiti 会更合适。
为什么不直接使用更长的上下文窗口? 更长的上下文意味着更高的成本、更慢的推理速度,以及长历史记录中的注意力稀释。TokenMizer 会提取真正重要的信息,将会话压缩为平均 161 个 token 的恢复区块(经测量,n=3——请参阅基准测试),而不是简单地进行摘要。
尚未实现的功能
在此列出,以免你之后才发现:
| 设置 | 状态 |
|---|---|
routing.* | **已弃用,将在下一版本中移除。**从未实现。请使用 model_map(见下文)将一个模型名称映射到另一个名称——这就是当初希望通过它实现的功能。包含 routing: 区块的配置仍可加载,但会记录弃用警告。 |
state_backend: redis | 可接受,但从未实现;其行为与 memory 相同,并会在启动时发出警告。请使用 state_backend: sqlite,它可在同一主机上的多个工作进程之间共享速率限制器。 |
functions / function_call(已弃用的 OpenAI 格式) | 可接受但会被忽略,并发出服务端警告。请使用 tools / tool_choice,这些参数会被转发。 |
这些项目及其他所有内容的优先级计划见 docs/roadmap.md,其中每个计划项目都 附有促成该计划的衡量指标。
文档
| 架构 | 请求管道、图数据模型、决策生命周期、文件智能 |
| 配置 | 所有设置、环境变量、优先级、提供方 |
| API 与 CLI | 端点、命令、MCP 工具、工具调用、Claude Code 集成 |
| 部署 | Docker、多工作进程、持久性、会话隔离、安全性 |
| 基准测试 | 提取质量、记忆质量、存储、运行自己的基准测试 |
| 路线图 | 每一层的实测状态,以及优先级计划 |
| 比较 | 与其他令牌工具并行运行 |
| 贡献 | 设置、分层规则,以及如何改进提取 |
| 测试 | 如何运行测试套件、覆盖率底线和已知限制 |
| 更新日志 · 安全 | 版本发布历史以及如何报告漏洞 |
参与贡献
git clone https://github.com/Shweta-Mishra-ai/tokenmizer
cd tokenmizer
pip install -e ".[dev]"
pytest tests/ -q && ruff check tokenmizer/     # 2131 tests, must stay green
最有价值的贡献,是一个提取出错的会话。 评估语料库包含 14 个会话,且所有标签都由同一个人编写——这是这些数字能告诉你关于你的工作负载情况的真实上限。要突破这个上限,唯一的办法就是提供这里无人编写过的对话记录。按照 benchmarks/eval/corpus.py 中说明的格式,标注你自己的几个会话并提交 PR,或者在 issue 中提供遗漏的轮次。可以放心删改敏感信息——重要的是文本的形式,而非其内容。
CONTRIBUTING.md 介绍了设置、分层规则,以及如何运行评估工具。
如果你对项目有疑问或想讨论某些内容,请加入 Discord 服务器。
贡献者
我们向所有曾经成功将拉取请求合并到 TokenMizer 的人表示感谢。下方的头像展示了这些拉取请求的作者,按他们首次成功合并拉取请求的顺序排列。
TokenMizer 是一个由社区驱动的项目,你的贡献持续推动着它不断改进。完整名单请见贡献者图表。


支持
如果 TokenMizer 对你有用,请给它点个星标。只需一秒,确实能帮上大忙。
如果你愿意支持这项工作,也可以赞助。赞助完全自愿。
许可证
MIT © Shweta Mishra
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。