关于 HKEx Filings
HKEx Filings 是面向研究人员、合规团队和 AI Agent 的 Python 抓取工具及只读 MCP 服务,可提取香港交易所文件的文本与表格,并将数据写入九种数据库的任意组合。
主要功能
- 01抓取自 1999 年 4 月起的 HKEx 文件
- 02提取 PDF、HTML 和 Excel 文本及表格
- 03写入九种数据库的任意组合
- 04按数据块跟踪抓取覆盖情况
- 05提供托管和本地只读 MCP 服务
适用场景
- 01通过 AI Agent 搜索实时 HKEx 文件
- 02为研究或合规建立本地文件库
- 03提取文件文本和表格用于分析
MCP 相关
托管的 Streamable HTTP 网关提供只读工具,用于搜索文件、浏览文件类别、获取文件和查询服务器信息。本地 stdio 服务为已存储的文件库提供更多工具。
配置
远程服务无需本地安装。选择你使用的客户端,复制配置或使用一键安装。
https://hkex-listco-updates.ascent-partners.com/api/mcpclaude mcp add --transport http simonmak-ascent-hkex-filings https://hkex-listco-updates.ascent-partners.com/api/mcp{"mcpServers":{"simonmak-ascent-hkex-filings":{"type":"http","url":"https://hkex-listco-updates.ascent-partners.com/api/mcp"}}}在 Cursor 中打开{"servers":{"simonmak-ascent-hkex-filings":{"type":"http","url":"https://hkex-listco-updates.ascent-partners.com/api/mcp"}}}在 VS Code 中打开{"mcpServers":{"simonmak-ascent-hkex-filings":{"type":"http","url":"https://hkex-listco-updates.ascent-partners.com/api/mcp"}}}{"mcpServers":{"simonmak-ascent-hkex-filings":{"serverUrl":"https://hkex-listco-updates.ascent-partners.com/api/mcp"}}}命令在终端中运行;JSON 粘贴到对应客户端的 MCP 配置后重启。需要授权的服务会在首次连接时提示登录。
工具
4此工具无需参数。
详细介绍
HKEx 文件抓取工具
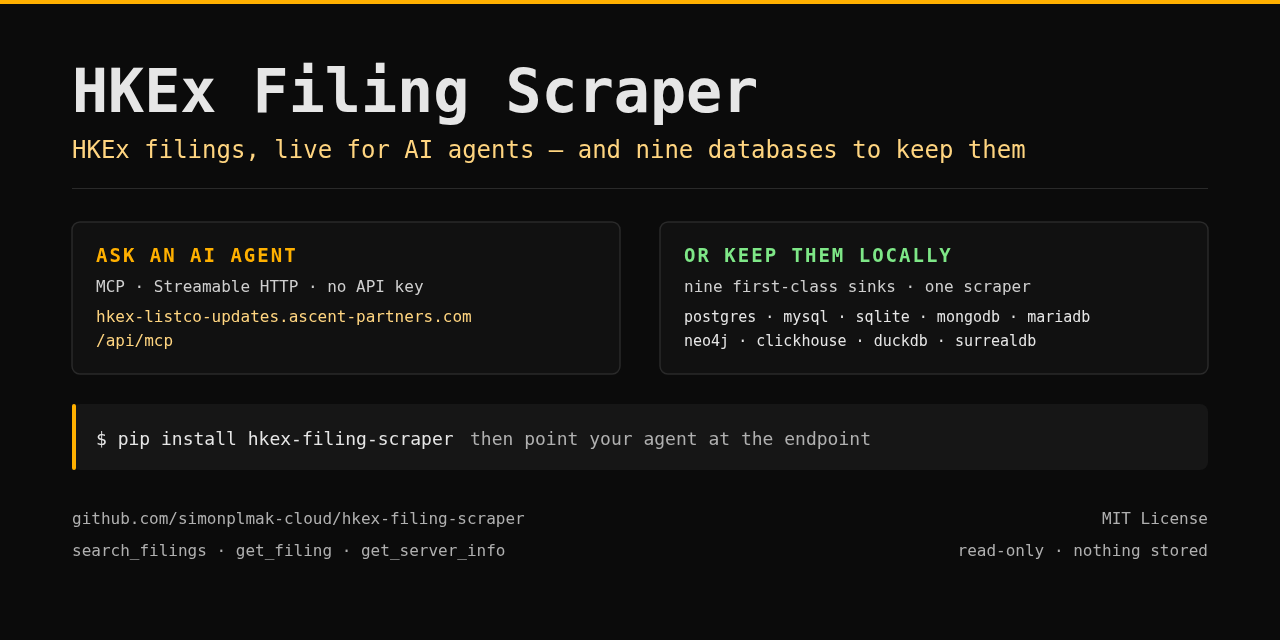
一款开源抓取工具,可获取 25 年以上的 HKEx 监管文件——支持写入九种数据库,具备全文提取、图谱关联功能,并为 AI Agent 提供只读 MCP 服务。






概览
**美国有 EDGAR 全文搜索,日本有 EDINET。香港却只有一个一次返回一页结果的搜索表单。**目前没有可批量获取、机器可读的 HKEx 文件全文语料库。本工具旨在构建这样一个语料库。
这是一款开源 Python 工具,可抓取香港联合交易所(HKEx)25 年以上的监管文件,并将其导入九种数据库的任意组合——支持全文和表格提取、分块级覆盖率、可选的图谱关联,以及一个只读 MCP 服务,方便 AI Agent 查询语料库或实时网站。
它直接调用未公开文档的 HKEx JSON API,比驱动浏览器更快、更可靠。
供应商与集成
数据库——九种一等支持的目标数据库,按文档中记录的受欢迎程度排序(参见支持矩阵):
- PostgreSQL — 适用于生产环境的开源关系型数据库
- MySQL / MariaDB — GPL 关系型数据库服务,共用一个驱动程序
- SQLite — 无需服务器的文件数据库,无须安装
- MongoDB — 文档数据库
- Neo4j — 属性图数据库
- ClickHouse — 列式分析引擎
- DuckDB — 进程内分析引擎
- SurrealDB — 多模型图数据库与文档数据库
AI 客户端——任何支持 MCP 的 Agent;提供适用于 Claude、ChatGPT、Cursor、VS Code/Copilot、Gemini CLI、opencode、Manus 和 Perplexity的现成配置。
可通过以下平台获取——PyPI · Glama · MCP Registry · 托管网关。
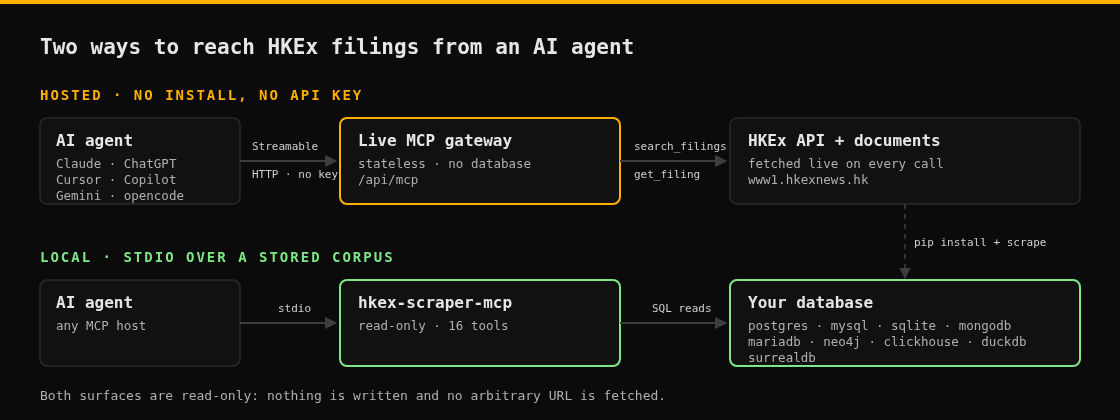
两种使用方式
| 托管式 MCP 网关 | 本地流水线 | |
|---|---|---|
| 说明 | 可供 AI Agent 连接的公共端点 | hkex-scraper CLI |
| 设置 | 无需设置——粘贴 URL 即可 | pip install + 一个环境变量 |
| 数据 | 实时来自 HKEx,不存储任何数据 | 存储在你的数据库中 |
| 文档 | 实时 MCP 网关 · AI Agent 支持 | 入门指南 |
使用托管式 MCP 网关
POST,Streamable HTTP,无需 API 密钥:
https://hkex-listco-updates.ascent-partners.com/api/mcp
四个只读工具:get_server_info、search_filings(时间窗口最长为 31 天,可选股票代码、标题、文档类型、类别和股票名称筛选条件)、
list_filing_facets(浏览时间窗口包含的内容)和 get_filing(下载一份文档并提取其中的文本和表格)。
将客户端指向该网关——例如 opencode:
{
  "$schema": "https://opencode.ai/config.json",
  "mcp": {
    "hkex-live": {
      "type": "remote",
      "url": "https://hkex-listco-updates.ascent-partners.com/api/mcp"
    }
  }
}
然后提问:
Use hkex-live to list the filings published between 2026-09-01 and 2026-09-18,
then summarise the interim report.
AI Agent 支持中提供了 Claude、ChatGPT、Cursor、VS Code/Copilot、Gemini CLI、opencode、Manus 和 Perplexity 的现成配置——对于已存储的语料库,stdio MCP 服务提供了更丰富的工具目录,并发布在 Glama 上。该网关已列入官方 MCP Registry,名称为 com.ascent-partners/hkex-filings。
Glama 推荐项目——只读的 stdio MCP 服务也发布在 Glama 上,Glama 会扫描构建好的服务,并为工具定义质量打分(目前为 4.7/5)。
快速开始(≤ 5 分钟)
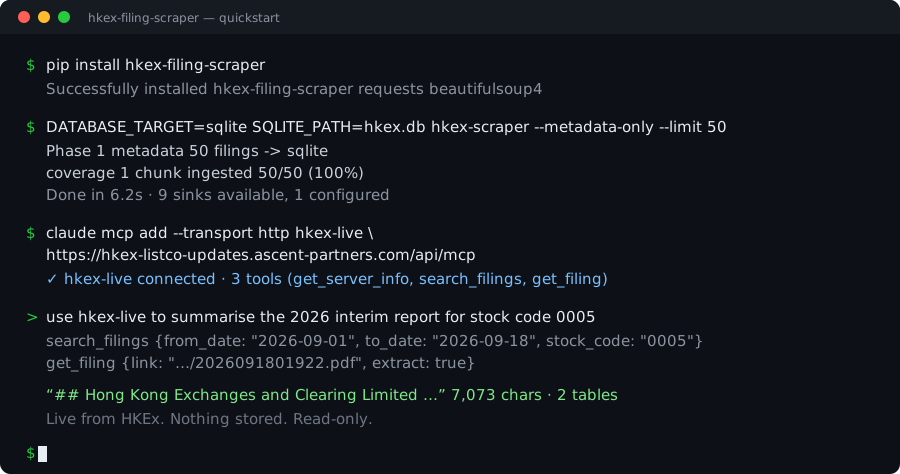
**最快方式:**无需安装——使用托管式网关 https://hkex-listco-updates.ascent-partners.com/api/mcp(Streamable HTTP),或安装并在本地运行:
pip install hkex-filing-scraper        # core; SQLite needs no server
pip install "hkex-filing-scraper[all]" # Excel + dotenv + every driver + the MCP server
cp .env.example .env                   # then set DATABASE_TARGET (below)
hkex-scraper --metadata-only --limit 100
可选扩展:excel、postgres、mysql、duckdb、mongodb、clickhouse、neo4j、mcp、pdf、all、dev。
DATABASE_TARGET 是按顺序排列、以逗号分隔的存储目标 ID 列表;顺序决定哪个存储目标提供读取服务。若要在不启动服务的情况下开始:
DATABASE_TARGET=sqlite
SQLITE_PATH=hkex.db
hkex-scraper 会运行完整流水线(元数据 + 文档 + 图谱);hkex-scraper --full-history 会涵盖自 1999 年 4 月以来的所有内容。架构会自动创建。完整安装选项和各存储目标的设置见入门指南。
数据库支持
每个目标端都是一等目标;表格行按文档记录的受欢迎程度排序。完整矩阵——许可证、能力差异、各引擎说明——请参阅 数据库目标端。
| 目标端 | 模型 | 许可证 | 附加项 | 幂等 upsert |
|---|---|---|---|---|
postgres | 关系型 | PostgreSQL License | postgres | ON CONFLICT DO UPDATE |
mysql / mariadb | 关系型 | GPLv2 | mysql | ON DUPLICATE KEY UPDATE |
sqlite | 关系型 | 公共领域 | — | ON CONFLICT DO UPDATE |
mongodb | 文档型 | SSPL¹ | mongodb | update_one(upsert=True) |
neo4j | 图 | GPLv3 (Community) | neo4j | MERGE |
clickhouse | 列式 | Apache-2.0 | clickhouse | ReplacingMergeTree + 读取合并 |
duckdb | 关系型 | MIT | duckdb | ON CONFLICT DO UPDATE |
surrealdb | 图 + 文档型 | BSL 1.1¹ | — | UPSERT / RELATE |
¹ 源码可用,但未获 OSI 批准——根据 ADR 0003 标注的例外情况。
有效目标端 ID(按文档记录的顺序):postgres、mysql、sqlite、mongodb、mariadb、neo4j、clickhouse、duckdb、surrealdb。设置一个变量,同一次运行即可将数据写入所有目标端:
# Order sets read precedence.
DATABASE_TARGET=postgres,sqlite
POSTGRES_DSN=postgresql://user:password@localhost:5432/hkex
SQLITE_PATH=hkex.db
与其他方案对比
获取 HKEx 文件的四种方式,以及各自的成本。
| 本项目 | HKEXnews 网页搜索 | 自行编写浏览器自动化 | HKEx 授权数据源 | |
|---|---|---|---|---|
| 批量导出 | 是 | 否 — 一次一页 | 是 | 是 |
| 历史数据可追溯至 1999 年 4 月 | 是 | 是,需手动操作 | 取决于你的代码 | 是 |
| 文档全文 | 从 PDF/HTML/Excel 中提取 | 否 — 需逐个打开文件 | 需自行构建提取器 | 因合同而异 |
| 结构化表格 | 提取为 Markdown | 否 | 需自行构建 | 因合同而异 |
| 覆盖范围验证 | 按数据块进行,可审计 | 不适用 | 需自行构建 | 供应商 SLA |
| 数据写入你的引擎 | 9 个引擎,可任意组合 | 否 | 由你接入的内容决定 | 通常为一种格式 |
| 速度 | JSON API,无需浏览器 | 手动操作 | 较慢 — 需渲染页面 | 快 |
| 成本 | 免费,MIT | 免费 | 你的时间 | 订阅 |
| 商业再分发 | 请参阅 docs/legal.md | 受限制 | 受限制 | 已授权 |
如果你需要获得授权、可再分发且有 SLA 保障的数据,请购买数据源。如果你需要用于研究、合规或 RAG 的完整本地语料库,本项目可以替代你原本需要自行编写的数据管道。
工作原理
flowchart LR
    A[HKEx JSON API] --> B[Phase 1: metadata]
    B --> C[Canonical record]
    C --> D{DATABASE_TARGET}
    D --> E[(PostgreSQL)]
    D --> F[(MySQL / MariaDB)]
    D --> G[(SQLite)]
    D --> H[(MongoDB)]
    D --> I[(Neo4j)]
    D --> J[(ClickHouse)]
    D --> K[(DuckDB)]
    D --> L[(SurrealDB)]
    B --> M[Graph linking]
    M --> D
    B --> N[Phase 2: download and extract]
    N --> C
- 阶段 1 通过 JSF 会话抓取文件元数据,将时间范围拆分为按月的数据块,并根据 16 个字符的 MD5
filingId去重。 - 阶段 2 下载每份文件的 PDF/HTML/Excel 文档,将文本和表格提取为 Markdown,并写入负载数据。
- 图关联(可选)在设置
COMPANY_TABLE时写入has_filing和references_filing边。 - 故障隔离 — 某个目标端发生故障时会记录并计数,但不会阻塞其他目标端;如果任一已配置目标端失败,运行将以非零状态退出。
HKEx API 会话
sequenceDiagram
    autonumber
    participant C as hkex-scraper
    participant J as HKEx site (JSF)
    participant A as HKEx JSON servlet
    C->>J: GET /search/titlesearch.xhtml
    J-->>C: HTML + javax.faces.ViewState
    C->>J: POST form (from/to dates + ViewState)
    C->>A: GET /search/titleSearchServlet.do (rowRange paging)
    A-->>C: JSON page of filings
    Note over C: generate_monthly_chunks() splits ranges > 1 month
    C->>C: dedupe on 16-char MD5 filingId
数据模型
erDiagram
    COMPANY ||--o{ EXCHANGE_FILING : has_filing
    EXCHANGE_FILING ||--o{ DOCUMENT : has_document
    EXCHANGE_FILING ||--o{ EXCHANGE_FILING : references_filing
    EXCHANGE_FILING ||--o{ SCRAPE_COVERAGE : chunk_of
    EXCHANGE_FILING {
        string filingId "16-char MD5"
        string stockCode
        string title
        datetime dateTime
    }
    DOCUMENT {
        text documentText
        array documentTables
    }
    SCRAPE_COVERAGE {
        int apiCount
        int ingestedCount
        int uniqueCount
        string runId
    }
exchange_filing 和 scrape_coverage 是 SCHEMAFULL;has_filing /
references_filing 是由 graph.py 写入的图边。
目标端契约与读取路由
flowchart LR
    CANON["canonical record<br/>per filing / document / coverage / edge"] --> DISPATCH["dispatch to every configured sink"]
    DISPATCH --> S1["sink A"]
    DISPATCH --> S2["sink B"]
    DISPATCH --> SN["sink N"]
    S1 -.->|error| LOG["logged + counted<br/>never blocks the others"]
    READ["reads: pending filings · tickers · titles · coverage"] --> FIRST["first configured sink<br/>whose capabilities include reads"]
    DISPATCH --> EXIT["sink_exit_code()<br/>non-zero if any sink failed"]
功能
- 快速抓取 API — 直接调用 HKEx JSON API;无需浏览器或 Selenium。
- 完整历史记录 — 涵盖 1999 年 4 月至今的所有披露文件,并检查分块覆盖情况。
- 文档处理 — 提取 PDF/HTML/Excel 文本和结构化表格,并转换为 Markdown。
- 多数据目标 — 可按任意顺序组合使用九种数据库,每种数据库都支持原生幂等 upsert。
- 适配 AI — 提供托管的实时 MCP 网关和本地 stdio MCP 服务。
- 可恢复且可观测 — 支持批处理、并行下载、停滞任务检测、各数据目标计数器,以及
--coverage-report/--parity-report/--verify。 - 可选依赖 — 核心依赖为
requests+beautifulsoup4;数据库驱动和文档提取功能为额外依赖,并提供优雅降级方案。
文档
- 快速入门 · 配置 · CLI
- 数据库目标(矩阵) — PostgreSQL、MySQL/MariaDB、SQLite、MongoDB、Neo4j、ClickHouse、DuckDB、SurrealDB
- 实时 MCP 网关 · AI Agent 支持 · MCP 服务
- 架构 · 故障排除 · 测试
- 路线图 · 风险缓解登记表 · 升级
- 最新动态 · 发布 · 法律与使用条款 · 变更日志
- 文档站点: https://hkex-listco-updates.ascent-partners.com/ · 本地试用(
examples/)
开发
pip install -e ".[dev,all]"
ruff check           # lint (py310, line-length 100)
ruff format --check  # formatting
pytest               # unit tests (no DB or network required)
测试均为纯单元测试;SQLite 和 DuckDB 合约测试在进程内运行,而需要服务端的集成 测试会跳过,除非已配置对应的数据库目标。请参阅 测试。
CI 和部署通过 APG workbench 流水线运行。
部署冒烟测试会通过负载均衡器探测公开主机名,而非本地端口。
贡献
请参阅 CONTRIBUTING.md;安全问题请按照 SECURITY.md 中的说明报告。 欢迎在 讨论区分享想法和提问。
由 Ascent Partners 构建。
如果这个项目为你节省了时间,在 GitHub 上点个 ⭐ 可以帮助其他人找到它。
与 Context7 搭配使用
最新的 HKEx Filing Scraper 文档已编入 Context7 索引,编码 Agent 可按需将其载入上下文。安装 Context7 MCP 服务或 ctx7 CLI 后,在提示词中指定此库:
use library /simonmak-ascent/hkex-filing-scraper for API and docs
许可证
MIT — 详见 LICENSE。该许可证仅涵盖本项目的代码;可选依赖各自遵循其许可证,尤其是 pdf extra(PyMuPDF / pymupdf4llm),其许可证为 AGPL-3.0,因此特意未包含在 .[all] 中。请参阅
docs/legal.md。
数据与使用条款: 本项目是用于研究未公开文档的 HKEx JSON API 的工具,与 HKEx 无关联,也未获其认可。商业再分发 HKEx 数据可能需要获得 HKEx 数据源的许可;请参阅 docs/legal.md。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。