关于 Sitemcp
SiteMCP 是一个已归档的命令行工具,可抓取整个网站并将页面内容提供给 MCP 客户端。它支持筛选页面、调整内容长度和指定正文选择器,适用于将网站文档接入本地 AI 助手。
主要功能
- 01抓取网站页面
- 02按路径匹配页面
- 03设置内容长度上限
- 04指定正文 CSS 选择器
- 05缓存已抓取页面
适用场景
- 01将网站文档提供给 MCP 客户端
- 02只抓取指定路径下的页面
- 03调整长篇内容的截取长度
MCP 相关
它以 MCP 服务的形式向客户端提供抓取的网站内容。该项目已归档,README 建议以静态方式获取文档。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
SiteMCP
警告
此仓库已归档。 使用此项目之前,请先阅读下方的说明。
归档说明
SiteMCP 创建于 2025 年 4 月 8 日,也就是模型上下文协议(原始推文,介绍文章,日语)问世之初。当时,MCP 是一个全新的概念,通过 MCP 服务将文档传递给 AI 助手是少数切实可行的选择之一。Claude Code 当时只能通过按使用量计费的方案使用,尚未广泛普及,技能等功能也还不存在。(因此,此仓库中的所有演示都是用 Claude Code Desktop 录制的。)
那时,编码 Agent 的能力远不如现在,而原生集成大模型的网页搜索充其量也不可靠,因此,抓取整个网站并通过 MCP 提供确实很有用。可以说,SiteMCP 是最早且最实用的方式之一,能够为本地 AI 助手提供文档。
此后的发展格局发生了显著变化。MCP 本身经历了一段快速增长期,随后有所回落,而社区也逐渐转向更简单、更高效的静态文档替代方案:将文档发布为可下载的 Markdown 文件,通过 npm 包分发,或者将网页搜索作为最后的手段。在我看来,用 MCP 提供静态文档已经成了一种反模式——这种做法带来的开销实在不值得。我在博客中详细谈到了这一点:
SiteMCP 发布一年后,我决定将其归档。如果你需要为 AI 助手提供文档,请遵循我上述博客文章中的建议,并尽可能以静态方式获取文档。

抓取整个网站,并将其用作 MCP 服务
https://github.com/user-attachments/assets/ebe2d7c6-4ddc-4a37-8e1e-d80fac49d8ae
日语演示
https://github.com/user-attachments/assets/24288140-be2a-416c-9e7c-c49be056a373说明
安装
一次性使用(任选其一):
bunx sitemcp
npx sitemcp
pnpx sitemcp
全局安装(任选其一):
bun i -g sitemcp
npm i -g sitemcp
pnpm i -g sitemcp
使用方法
sitemcp https://daisyui.com

# or better concurrency
sitemcp https://daisyui.com --concurrency 10
工具名称策略
使用 -t, --tool-name-strategy 指定工具名称策略,它将用作 MCP 服务名称(默认值:domain)。
该名称将用作 MCP 服务名称。
sitemcp https://vite.dev -t domain # indexOfVite / getDocumentOfVite
sitemcp https://react-tweet.vercel.app/ -t subdomain # indexOfReactTweet / getDocumentOfReactTweet
sitemcp https://ryoppippi.github.io/vite-plugin-favicons/ -t pathname # indexOfVitePluginFavicons / getDocumentOfVitePluginFavicons
内容最大长度
使用 -l, --max-length 指定内容的最大长度,默认值为 2000 个字符。
这适用于内容较长的网站,例如博客或文档。
可接受的内容长度取决于你使用的 MCP 客户端,详情请参阅 MCP 客户端的文档。
如有任何疑问,也欢迎提交 issue。
sitemcp https://vite.dev -l 10000
匹配特定页面
使用 -m, --match 标志指定要抓取的页面:
sitemcp https://vite.dev -m "/blog/**" -m "/guide/**"
匹配模式会针对目标页面的路径名进行测试,由 micromatch 提供支持。你可以查看所有受支持的匹配功能。
内容选择器
我们使用 mozilla/readability 从网页中提取可读内容,但在某些页面上可能会返回无关内容。此时,你可以指定一个 CSS 选择器,告诉我们在哪里查找可读内容:
sitemcp https://vite.dev --content-selector ".content"
如何在 MCP 客户端中配置
你可以从 MCP 客户端(例如 Claude Desktop)启动服务。
以下是 Claude Desktop 的配置示例:
{
  "mcpServers": {
    "daisy-ui": {
      "command": "npx",
      "args": [
        "-y",
        "sitemcp",
        "https://daisyui.com",
        "-m",
        "/components/**"
      ]
    }
  }
}
提示
- 有些网站包含大量页面。最好先运行
sitemcp,再将服务注册到 MCP 客户端。sitemcp默认会将页面缓存到~/.cache/sitemcp。你可以使用--no-cache标志禁用缓存。
许可证
MIT。
赞助商
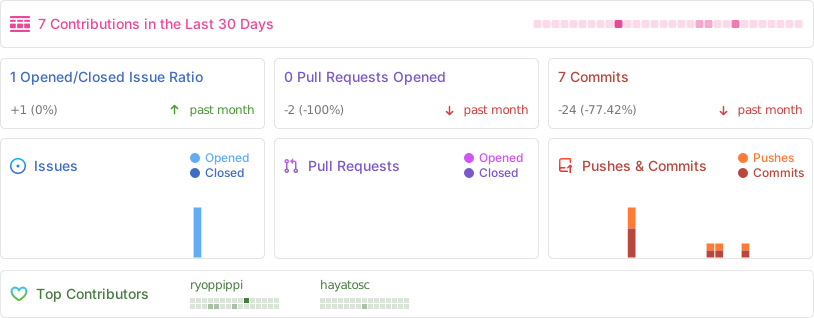
统计数据
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。