关于 M3 Memory
M3 Memory 是供 AI Agent 使用的持久记忆层,可在会话、工具和机器之间保存并检索信息。它默认在本地运行、支持离线,并结合关键词与语义搜索及记忆历史。
主要功能
- 01跨会话和 Agent 保存记忆
- 02关键词与语义混合检索
- 03保留记忆版本和变更历史
- 04支持 SQLite 与 PostgreSQL 存储
- 05多 Agent 共享记忆与任务交接
- 06提供命令行和 Web 仪表板
适用场景
- 01在新会话中找回项目决策
- 02在不同 AI 助手之间共享项目记忆
- 03按自然语言检索旧记录
- 04追踪变化中的事实及其历史版本
MCP 相关
M3 Memory 作为 MCP 服务向 AI Agent 提供记忆写入和检索能力,并可通过命令行访问同一存储。多个助手可连接共享记忆。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
10收录的工具列表 · 更新于 2 天前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| timeout | number | 否 | |
| database | string | 否 |
详细介绍
🧠 m3 Memory
让 AI 拥有持久记忆。
你的 AI 助手一直都很有用,直到你开始一段新对话,它便忘了你之前在做什么。m3 可以解决这个问题。
即使你关闭应用、开始新的会话或切换到其他 Agent,你的助手也能记住你的项目、偏好、决定和过往工作。默认情况下,所有数据都保留在你自己的电脑上,而且可以离线使用。m3 本身不需要云账户或 API 密钥;你的 AI 助手可能有自己的要求。



pipx install m3-memory  # or pip install m3-memory in a virtual environment; use one, not both
m3 setup                # finds your agents and connects them to m3
m3 doctor               # checks that everything is working
还没有 pipx?可以运行 sudo apt install pipx(Debian、Ubuntu)、brew install pipx(macOS)或
py -m pip install --user pipx(Windows)。如果安装后立即找不到 m3,请打开一个新的终端。
安装程序会查找你的 Agent 并将 m3 与它们连接。 m3 setup 会检测你的 AI Agent 并将 m3 接入每个 Agent;如果你运行本地 LLM(Ollama、LM Studio),它会询问你是否要用它来总结记忆并建立记忆之间的关联。这一步是可选的;如需使用,请在运行 m3 setup 前安装 LLM:Windows · macOS · Linux。安装就这么简单。
初次使用?5 分钟快速入门指南将引导你保存第一条记忆。
m3 是什么
m3 是 AI Agent 的记忆层:为你工作的 AI 助手,例如 Claude Code、Codex、Cursor 或 Gemini CLI。它在你自己的电脑上运行,并存储事实、决定、偏好和对话历史,让你的助手稍后能够回忆起这些内容,跨会话、跨工具和跨设备使用。助手通过 MCP 访问它。MCP 是 AI 助手连接工具的标准方式;你也可以通过命令行使用它。
它不是 AI 模型或聊天机器人。你仍然使用现有的助手;当它们需要记住或回忆某些内容时,就会调用 m3。
📅 使用 m3 的一周
**星期一:**你告诉 AI 助手你正在开发一个网站,并决定使用 PostgreSQL。
**星期三:**你开启一个新会话并询问:“我们上次进行到哪里了?”助手找到之前的决定并继续工作,无需你重复说明。
**星期五:**你切换 Agent,例如从 Claude Code 切换到 Codex。Codex 可以看到同一份项目记忆。
观看短视频,看看一个 Agent 保存的决定如何被另一个 Agent 回忆起来。(开发者:也可以通过命令行体验。)
✨ m3 能为你做什么
| 你想要…… | m3 会…… | 背后的实现 |
|---|---|---|
| 不再重复说明 | 记住你在之前会话中告诉它的内容 | 基于 MCP 和命令行的持久化记忆 |
| 从上次中断处继续 | 保存你的对话,并在需要时找回 | 聊天记录捕获 |
| 使用多个 AI 助手 | 在 Claude Code、Cursor、Gemini CLI 和其他工具之间共享一份记忆 | 一个本地存储,多个客户端 |
| 用自己的说法查找内容 | 即使你不记得确切措辞,也能找到相关记忆 | 混合搜索:结合关键词与含义 |
| 减少 AI 令牌用量 | 优先提供最相关的记忆,并在助手连接时只加载 6 个工具 | 91.8% 的问题都能优先找到正确会话;工具描述约占 3,200 个令牌,而非 33,000 个 |
| 跟踪变化 | 当决策变更时保留较早的版本:写入时基于相似度进行替代、支持显式更正,并可选择通过模型辅助检查矛盾 | 双时态历史、替代机制和矛盾检查 |
| 保护信息隐私 | 将所有内容存储在你的电脑上,并支持离线运行 | 默认使用 SQLite;可用于气隙环境 |
| 让助手协同工作 | 让多个助手共享笔记、交接工作并拆分任务 | 多 Agent 作用域与交接 |
| 保持记忆整洁 | 可在后台整理:关联相关事实、合并重复内容、淡化过时笔记 | 内置的认知循环(在 m3 setup 中启用) |
简单易懂,轻松上手,在你需要时功能强大。每一行都链接到相应的文档; 了解 m3 中的记忆如何运作介绍其机制,技术概要和基准测试 则提供了测量数据。
🎯 更好的记忆,减少令牌浪费
AI 助手一次只能处理一定量的文本,并以令牌为单位计量:令牌是词语的细小片段,也可能决定你的费用。当助手搜索记忆时,优先找到正确内容,就能少读无关信息。
An illustration, not a measurement:

  less precise search               m3: the right memory first
  1. unrelated note                 1. ✔ the decision you need
  2. unrelated note                    (it may already have what it needs)
  3. ✔ the decision you need
  4. unrelated note
  5. unrelated note
在 LongMemEval-S 基准测试中,m3 对 91.8% 的问题都将正确会话列为首个结果(500 个问题中有 459 个)。这衡量的是检索准确率,而不是令牌节省量:助手能节省多少,取决于它如何使用检索结果。m3 会按请求返回结果,因此,精准排序能让助手减少请求数量,或在找到第一个合适结果后停止,从而为实际工作留出更多空间。
m3 还通过另一项可测量的方式节省上下文:助手连接时,它只注册 100 多个工具中的 6 个,因此这些工具的描述约占 3,200 个令牌,而完整目录则约占 33,000 个令牌(接口)。
m3 中的记忆工作原理
当 Agent(或你在 shell 中)想要记住某件事时,会调用
memory_write。m3 会按原样存储文本,并附上类型、标题和元数据。
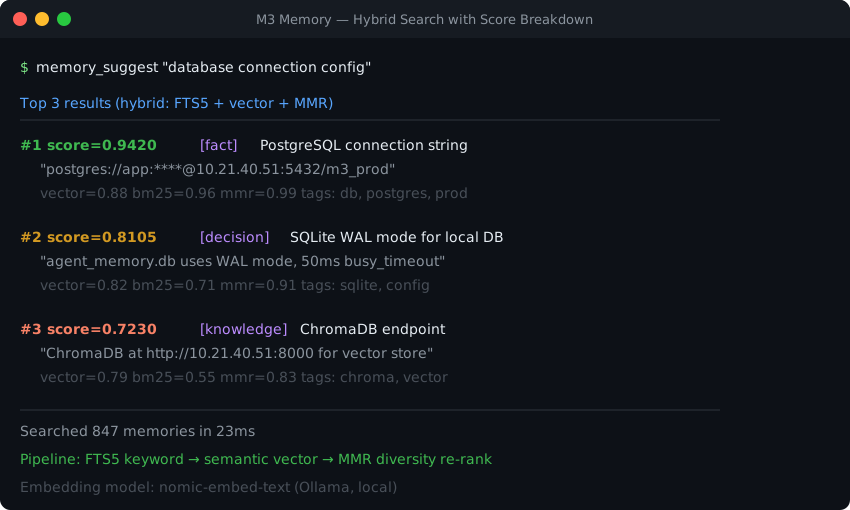
之后,memory_search 会通过混合检索找到它:关键词匹配(BM25)、
语义相似度(本地 BGE-M3 嵌入)和多样性重排序(MMR)。评分由 9
种信号共同决定,每条结果都能说明其原因。
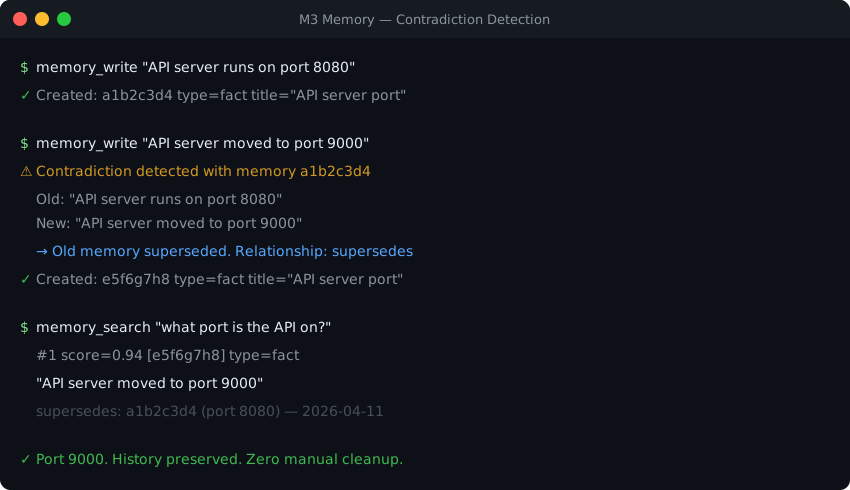
事实发生变化时,m3 不会覆盖它,而是通过 3 种各不相同的机制处理:
- 基于相似度的取代(每次写入时)。 如果一条新记忆与同类型的某条
旧记忆非常相似(默认余弦相似度高于 0.92),但文本不同,它就会成为当前版本:旧记忆的
valid_to会被设定为结束时间, 并且两者仍可通过as_of查询。系统不会判断两者是否真的矛盾,因此,改进后的表述(“使用连接池的 PostgreSQL”)也会取代旧的措辞;历史记录不会丢失。此机制仅适用于 Agent 自己的记忆,且只有在写入时指定其用户或 Agent 才会触发。 - 显式取代。 Agent 调用
memory_supersede来替换它确认有误的记忆。 - 矛盾检测(模型辅助)。 启用认知循环后,其 Reflector 阶段会使用模型找出真正相互矛盾的记忆,并记录这些矛盾以待处理。
启用认知循环后,m3 还会为新记忆生成嵌入、提取实体和关系,并衰减未使用的记忆。将相关笔记汇总为更高层级的信念则需要单独选择启用。
默认存储是单个 SQLite 文件。如果需要在多台机器间共享一个存储,可以选择 PostgreSQL 这一一等替代方案。
📍 项目状态
核心功能已稳定,Web 仪表板、认知循环以及 Observer 和 Reflector 阶段也已稳定。
| 状态 | 含义 | 功能 |
|---|---|---|
| 稳定 | 可放心基于此构建:每次发布都会进行测试,变更会附带弃用通知。 | 保存、搜索、更新和取代记忆 · 混合搜索(关键词加语义)· 版本历史 · 写入时取代 · GDPR 导出和擦除 · SQLite 和 PostgreSQL 存储 · MCP 服务和 m3 CLI · 跨机器同步 · Web 仪表板 · 后台认知循环 · Observer 和 Reflector 阶段 |
| 计划中 | 即将推出,按此顺序排列(ROADMAP)。 | 健康状态和 Prometheus 指标端点 · PostgreSQL 上的 HNSW 近似搜索 |
- **已审计记忆读取:**每次记忆读取和搜索命中都会记录读取者、数据所属对象及读取时间,日志保留 90 天,并纳入 GDPR 导出和擦除流程(GDPR)。聊天日志读取审计即将推出。
- 单一配置文件:
m3_config.toml包含所有设置,m3 config show会逐项显示设置及其来源(配置参考)。旧环境变量名称不再读取;m3 doctor会列出仍在设置的旧变量(环境变量)。 - **可预测的升级:**采用日历版本号(
YYYY.M.D.N)。重命名后的设置、参数或工具会在移除前继续可用,并显示警告;m3 doctor会列出仍在使用的旧名称(变更日志)。
⚡ m3 一览:技术能力
m3 是面向 AI Agent 的持久化、本地优先记忆层:它既是 MCP 服务,也是一个通过同一存储提供服务的 JSON 输入、JSON 输出命令行工具。它不是大模型、聊天机器人、纯向量数据库、RAG 框架或 Agent 运行时。 m3 不只是一个可搜索的记忆存储。 它结合了混合关键词与语义检索、双时态历史记录、自动替代、模型辅助的矛盾审查、知识图谱和后台记忆维护(认知循环)。多个 Agent 可以共享一个存储;多台机器可以共享一个 PostgreSQL 数据库,也可以通过 PostgreSQL 仓库同步本地存储。现有助手可以通过 MCP、CLI 或框架集成访问所有功能,无需新的 Agent 运行时,而且完全可以在自己的硬件上运行。
| 能力 | 支持情况 | 详情 |
|---|---|---|
| 跨会话和 Agent 持久记忆 | 内置 | 文本按原样存储,重启、开启新会话和切换 Agent 后仍会保留。(记忆模型) |
| 混合检索 | 内置 | BM25 关键词(SQLite FTS5)加本地 BGE-M3 向量,并通过 MMR 提升多样性:包含九项排名信号,每条结果都可以说明其得分原因。(排名信号) |
| 双时态历史 | 内置 | 每条记忆都记录有效时间和事务时间;可查询任意时间点的认知(as_of)。更正会关闭旧版本,但不会将其删除。(记忆模型) |
| 基于相似度的版本替代 | 内置 | 每次写入时,若存在同类型但文本不同的高度相似记忆,它就会成为当前版本。这是基于相似度,而非矛盾判断;旧版本仍保留在历史记录中(memory_history、as_of)。(矛盾检测) |
| 显式更正 | 内置 | memory_supersede 会记录替代内容,并保留对旧版本的查询能力。(记忆模型) |
| 模型辅助的矛盾审查 | 需要认知循环和模型 | Reflector 阶段会找出可能存在冲突的记忆,并记录下来以便解决。(记忆如何维护自身) |
| 知识图谱 | 内置 | 记忆之间的链接、最多 3 跳的图遍历,以及实体工具。实体默认通过基于规则的方式提取,也可在认知循环中由模型提取。(架构) |
| 后台维护(认知循环) | 内置;在 m3 setup 中启用 | 嵌入、实体提取、丰富处理(Observer 和 Reflector)、分类、会话摘要、剪枝、重要性衰减、同步和审计链。需要模型的处理阶段会使用本地或云端 LLM。(记忆如何维护自身) |
| 会话回顾 | 内置 | 每次新会话开始时,会显示近期会话的编号菜单(0 = 无);摘要由认知循环生成。 |
| 多 Agent 共享记忆 | 内置 | Agent、用户和组织范围,将任务交接到另一个 Agent 的收件箱,共享任务树,以及安全的并发写入。除非启用强制执行,否则 Agent 之间的隔离仅为建议性措施。(多 Agent) |
| 多台机器,共用一个存储 | 内置 | 每台机器都会直接读写同一个 PostgreSQL 16+ 数据库,无需单独的同步步骤。(多 Agent) |
| 多台机器,同步存储 | 可选 | 每台机器本地保存 SQLite,并每小时与 PostgreSQL 仓库进行双向同步(中心辐射式;以最新写入为准)。有意不采用点对点模式:由单一中心统一解决冲突,并集中管理一个需要保护的网络入口。(同步) |
| 本地嵌入,离线使用 | 内置 | BGE-M3 在你的机器上运行;安装后无需联网,并支持气隙环境安装。(主权部署) |
| 存储 | 内置 | 默认使用 SQLite:仅需一个数据库文件,无需运行服务。已测试 PostgreSQL 16、17 和 18;pgvector 可选。(架构) |
| 接口 | 内置 | MCP 服务;支持通过标准输入和标准输出传递 JSON 的 m3 CLI;由持有者令牌保护的远程 MCP 端点(m3 serve)。(CLI 参考) |
| 上下文效率 | 内置 | 9 个领域共 100 多种工具;启动时仅加载 6 种(约 3,200 个令牌,占 200K 窗口的 1.6%),其余按需加载。(领域门控) |
| Agent 集成 | 支持的集成 | Claude Code、Codex、Gemini CLI 和 Antigravity(插件和扩展);Cursor、Cline、OpenCode 和 OpenClaw(由 m3 setup 配置);Hermes(记忆提供方);Aider(通过代理)。(集成) |
| 框架集成 | 支持的集成 | LangChain 和 LangGraph、CrewAI、PydanticAI。(集成) |
| 聊天记录捕获 | 内置 | 在对话过程中保存每轮内容,并在 Agent 压缩上下文之前完成保存:Claude Code、Codex、Gemini CLI、Antigravity(应用、IDE 和 CLI)、OpenCode、OpenClaw 和 Aider。(聊天日志) |
| 文件记忆 | 内置 | 一个包含 25 种工具的领域,可导入整个目录并将其分块。(文件记忆) |
| 仪表板和 Wiki | 内置 | 本地 Web 仪表板(图谱、浏览器、审计日志、运行状况);m3 wiki generate 可生成 Markdown、HTML 或 Obsidian 知识库。(仪表板 · Wiki) |
| GDPR | 内置 | 支持导出(第 20 条)和删除(第 17 条);每次记忆读取和搜索命中都会记录 90 天。聊天日志读取目前尚未审计。(GDPR) |
| FIPS 140-3 | 已就绪 | m3 的加密操作通过单一提供方运行,可由经过验证的模块(wolfCrypt FIPS)提供;m3 本身不是经过验证的产品。(FIPS 边界) |
| 远程客户端 | 已验证 | 可通过 m3 serve 使用 Claude.ai、Anthropic API、xAI API(Grok)和 OpenAI Responses API。不支持 ChatGPT 应用连接器:它们需要 OAuth。(远程客户端) |
| 近似(HNSW)搜索 | 计划中 | 目前使用精确搜索,在 PostgreSQL 上由 pgvector 加速。(路线图) |
- 测试: 在 Windows、macOS 和 Linux 上使用 Python 3.12–3.15 运行了 5,700 多项测试;此外,Linux 上还有一个 PostgreSQL(含 pgvector)测试任务,并使用随 m3 一同发布的原生(Rust)核心;警告会导致构建失败。安全扫描结果发布于
docs/audits/。(测试) - 状态: 稳定:核心、Web 控制面板、自主认知循环以及 Observer 和 Reflector 阶段。Apache 2.0。(项目状态 · 路线图)
- 配置: 使用一个文件
m3_config.toml。m3 config show会输出所有设置及其来源。(配置参考) - 面向 AI Agent: llm-context.md 列出了实际工具名称和使用规则,features.json 则提供机器可读的摘要。
🧭 接下来
刚接触 AI 记忆? 从5 分钟快速入门指南开始, 然后查看对应系统的安装指南:Windows · macOS · Linux。遇到问题? 故障排除 · 常见问题 · 健康状态常见问题。
使用 AI Agent 构建应用? 安装 · 客户端配置 · LangChain · CrewAI · PydanticAI · Agent 说明 · 面向 AI Agent · 面向开发者 · 编码指南 · CLI 参考。
正在评估记忆系统? 基准测试 · 与 Mem0、Letta、Zep 等系统的比较 · 记忆模型 · 架构 · 技术细节 · 主权部署 · 合规性。
所有文档:文档索引。
🤝 多 Agent 记忆与跨机器使用
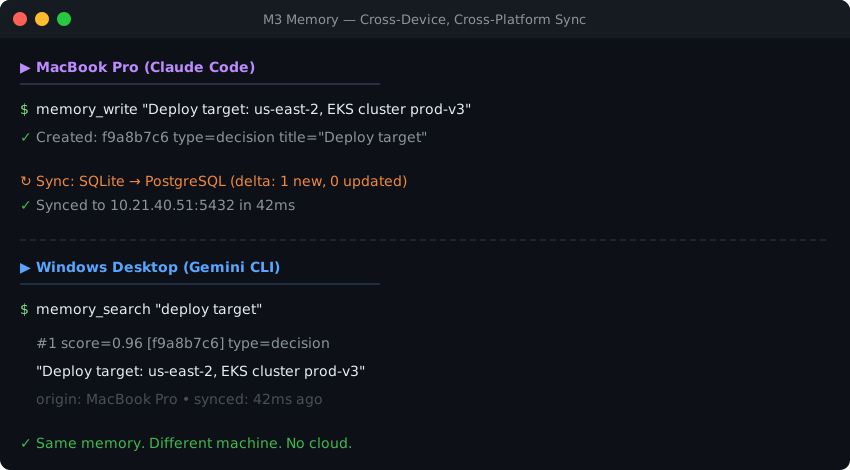
一个记忆层,服务多个 Agent 和机器。 m3 支持多个 Agent 并发共享一个数据库;支持独立的 Agent、用户和组织范围;支持交接和共享任务;还支持两种跨机器模式:直接访问同一个共享 PostgreSQL 数据库,或通过 PostgreSQL 仓库同步本地 SQLite 存储。
多个 Agent 可以同时共享同一份 m3 记忆。每条记忆都带有一个范围:agent(某个 Agent 自己的笔记)、user 或 org。Agent 通过将任务交接到另一个 Agent 的收件箱,以及使用共享任务树来进行协作。并发写入安全可靠:在 SQLite 上,16 个 Agent 同时写入,成功完成了 640 次写入,没有失败;每次最多等待半秒。默认情况下,Agent 之间的隔离仅为建议性;启用可选过滤器后,可在 SQL 中强制执行隔离。
跨机器使用有两种配置,运行方式各不相同:
- 一个共享 PostgreSQL 存储。 每台机器都读写同一个 PostgreSQL 16+ 数据库。无需单独的同步步骤;这种配置适用于机器集群。
- 与仓库同步。 每台机器保留自己的 SQLite 存储,并每小时与 PostgreSQL 仓库双向同步:记忆、嵌入、关系、任务和聊天日志行。仓库是中心节点(机器之间不会直接同步),以最新写入为准。部分仅存于本地的数据(例如实体图)会保留在对应机器上。
SQLite 是默认选项,m3 setup 会保留它。要切换到共享 PostgreSQL 存储,请运行:pip install "m3-memory[postgres]",使用 m3 secret set M3_PRIMARY_PG_URL 保存服务器地址,然后运行 m3 install-m3 --db-backend postgres。
对于无法在本地运行 m3 的客户端,m3 serve 可通过 bearer 令牌将记忆作为远程 MCP 端点公开。
(多 Agent · 同步 · 远程客户端)
📊 基准测试
要比较检索质量,请从 Session Hit-Rate(SHR,会话命中率)开始。 SHR 衡量记忆系统能否检索到包含问题所需证据的会话,不受生成答案的模型影响。
端到端 QA 准确率衡量的是另一种结果:整个系统能否给出正确答案。它取决于检索、答案模型、提示词和评判器,而这些因素在已发布的对比中很少保持一致。
m3 同时报告这两项指标,并将 SHR 作为主要检索基准。SHR 无法衡量记忆层的所有功能(它不评估替代关系、历史记录、维护和多 Agent 协作)。
检索准确率 — Session Hit-Rate @ k (主要检索指标)
在包含 500 个问题的 LongMemEval-S 数据集上,使用 m3 的生产搜索功能进行评估:
| 检索深度(k) | Session Hit-Rate(SHR)⁂ | 成功数 |
|---|---|---|
| 1 † | 91.8% | 459 / 500 |
| 5 | 98.2% | 491 / 500 |
| 8(默认) | 99.2% | 496 / 500 |
| 10 | 99.2% | 496 / 500 |
| 20 | 100.0% | 500 / 500 |
与之前的引擎相比,v3 将 SHR@5 从 96.2% 提升到 98.2%,将 SHR@10 从 96.8% 提升到 99.2%。在 k=20 时达到 100%,而之前的引擎在 k=30 时为 97.8%(LongMemEval issue #43)。 以上均为纯检索测量,不涉及答案模型。
† SHR@1 衡量正确会话是否为排名第一的结果。如果检索策略支持,高首位准确率可以让 Agent 检索更少的上下文。SHR@8 是 m3 的默认搜索深度:99.2% 的问题都能检索到黄金会话,与 k=10 时相同;而 k=10 在 LongMemEval-S 上会多检索 25% 的行,却没有收益。其他系统通常报告 k=5、k=10、k=20 或 k=50;比较时请使用相同的 k,并采用 m3 对应深度的数据。
⁂ 采用哪种聚合方式。 这些数值是逐题计算的二元
recall_any@k,这是 LongMemEval 相邻提交所采用的惯例。基准测试报告中按问题类型划分的表格采用了略有不同的聚合方式,在较浅深度下的数值略高(k=5 时为 98.8%,k=10 时为 99.4%);无论采用哪种方式,k=20 时都是 100.0%。上表列出的是较保守的数值。
端到端 QA 准确率 (取决于答案模型和评判器)
不使用数据集的问题类型标签(不进行预言式路由),准确率为 92.0%(500 条回答中有 460 条正确)。 这衡量的是整个系统;关于它为何不像 SHR 那样适合跨系统比较,请参见上方说明:
| 问题领域 | 数量(n) | 准确率 |
|---|---|---|
| 单会话用户 | 70 | 94.3% |
| 单会话助手 | 56 | 96.4% |
| 单会话偏好 | 30 | 80.0% |
| 多会话 | 133 | 87.2% |
| 时间推理 | 133 | 95.5% |
| 知识更新 | 78 | 93.6% |
| 总体摘要 | 500 | 92.0% |
QA 数值的生成方式。 m3 负责检索,不负责回答问题。在实际部署中,由调用它的 Agent 选择要检索的内容并撰写答案。基准测试框架扮演这一角色:它使用问题文本路由器(该路由器属于框架)为每个问题选择检索选项(会话扩展和预计算召回面,两者在 m3 引擎中均可用,但默认关闭),并提供答案提示词和模型。在这两种场景中,m3 内置的意图路由默认均为开启状态。检索数据(SHR)仅使用 m3 的搜索功能。
方法和可复现性详情见 LongMemEval-S 基准测试报告。
性能
- 写入: 延后生成嵌入时约为 2 ms:文本搜索可立即找到记忆;启用认知循环后,语义搜索可在 30 秒内找到记忆。内联生成嵌入时,写入约需 31 ms。
- 搜索: 在基准测试存储上约为 45 ms(p50)。在 50,000 条记忆时,SQLite 用时 0.45 秒,PostgreSQL 搭配 pgvector 用时 0.27 秒。一个实际的 83,000 条记忆存储在 SQLite 上用时 2.7 秒,在 PostgreSQL 搭配 pgvector 时用时 0.54 秒。
- 并发: 16 个 Agent 同时写入 SQLite,没有丢失任何数据,最长等待时间不超过半秒。
- 原生核心: Rust 核心可将 MMR 重排序加速 95× 至 846×,将批量余弦计算加速 97× 至 178×;不使用它时,结果相同,只是速度较慢。
(性能 · Oxidation 基准测试)
🔌 接口与集成
两个接口,一个存储库。 MCP 服务和 m3 CLI 使用同一个数据库。每个工具都从 stdin 读取 JSON,并向 stdout 写入 JSON,分为 memory、files、chatlog、tasks、agent、admin、conversations、diagnostics 和 entity。MCP 连接断开并不意味着记忆服务中断:客户端重新连接前,CLI 会继续工作。
完整工具目录,不增加上下文开销。 9 个领域中有 100 多个工具,但启动时只注册 6 个:memory_write、memory_search、memory_supersede、memory_get、chatlog_search 和 m3_call。在实际开发会话中,4 个记忆工具(memory_write、memory_search、memory_supersede、memory_get)占所有直接工具调用的 95%。Agent 可以通过 m3_call 按名称调用其他任何工具,也可以加载整个领域。
| 门控模式 | 已注册工具 | 架构中的 Token 数 | 占 200K 上下文窗口的比例 |
|---|---|---|---|
| 延迟加载(默认) | 6 | 约 3,217 | 1.6% |
典型活跃会话(+memory +admin) | 60 | 约 19,549 | 9.8% |
预加载模式(tools.lazy = false) | 120 | 约 33,149 | 16.6% |
Agent 和框架:
| Agent 或框架 | 连接方式 |
|---|---|
| Claude Code | 插件(/plugin marketplace add skynetcmd/m3-memory,然后运行 /plugin install m3@skynetcmd):/m3:* 命令、整理子 Agent、聊天捕获。也可以运行 m3 setup。(插件) |
| Codex | 插件(codex plugin marketplace add skynetcmd/m3-memory,然后从 /plugins 安装 m3):技能、聊天捕获、会话启动。也可以运行 m3 setup。(插件) |
| Gemini CLI | 扩展(gemini extensions install https://github.com/skynetcmd/m3-memory),或者运行 m3 setup,它也会配置聊天捕获。(扩展) |
| Google Antigravity | 插件或运行 m3 setup。(插件) |
| Cursor、Cline、OpenCode、OpenClaw | m3 setup 会为检测到的客户端配置连接;OpenClaw 需要 2026.3.22 或更高版本。(客户端设置) |
| Hermes Agent | 将 m3 用作记忆提供程序,由 m3 setup 配置连接。(Hermes) |
| Aider | 通过 m3 的 MCP 到 OpenAI 代理,并配合聊天日志监视器使用。(客户端设置) |
| LangChain 和 LangGraph | Python 库:存储、检索器和检查点器(pip install "m3-memory[langchain]")。(指南) |
| CrewAI | 存储后端(pip install "m3-memory[crewai]")。(指南) |
| PydanticAI | 工具集和历史记录处理器(pip install "m3-memory[pydantic-ai]")。(指南) |
| Claude.ai、Anthropic API、xAI API、OpenAI API | 通过 m3 serve 使用远程 MCP。不支持 ChatGPT 应用连接器(仅支持 OAuth)。(远程客户端) |
🛡️ 隐私、安全与运维
安装后,m3 默认离线运行。只有在你启用相应功能时,它才会连接互联网:你配置用于增强处理的云端大模型、与你指定的数据仓库同步,以及在 m3 setup 中选择启用的每日版本检查(仅向 pypi.org 发送一次请求)。
主权本地嵌入器
安装后,BGE-M3(1,024 维)会在你的机器上运行:一个共享嵌入服务位于 127.0.0.1:8082,供每个 m3 进程复用,因此内存中只需加载一份模型。在 m3 setup 中可选择启用进程内嵌入:处理短文本约快 1.9 倍,中等长度文本约快 1.75 倍,但每个进程都需要一份模型副本。m3 embedder install-gpu 会安装 CUDA 版本(已测试),或 Vulkan 和 Metal 版本;也支持任何兼容 OpenAI 的嵌入端点(m3 config set embed.url …)。
(嵌入:共享模式与进程内模式)
Rust 驱动的高性能核心
默认安装原生 Rust 核心(m3_core_rs),可加快排序和向量运算(测量结果见性能);如果不安装,m3 也能通过纯 Python 返回相同结果,只是速度较慢。(Rust 化基准测试)
企业级安全与合规
- 符合 FIPS 140-3 要求: m3 不实现任何密码学功能;其自身功能(机密库、密钥派生、HMAC、审计链、随机密钥)均通过一个可由经验证模块(wolfCrypt FIPS)提供服务的提供方运行,并且每条网络路径都有明确名称,在 FIPS 模式下会默认拒绝访问。已做好准备,但尚未通过验证:请参阅 FIPS 边界参考,了解各条路径和部署配置。
- 隔离网络安装: 支持通过预编译的 Python wheel 在无法访问互联网的情况下安装。(参阅自主部署指南和 FIPS 边界参考)。
- 存储位置: 数据库(
~/.m3/engine)、配置(~/.m3/config)和日志(~/.m3/logs)分别存放在独立的根目录下,且均可在m3_config.toml的[paths]中更改位置,以便分别保护。(配置参考 · 架构)
运维
- Web 仪表板:
m3 dashboard会在127.0.0.1:8088上提供本地控制面板,包含知识图谱、记忆浏览器、冲突和审计日志(支持 GDPR 操作)以及系统健康状况。(仪表板) - Wiki:
m3 wiki generate会将记忆编译为相互链接的 Markdown 知识库、独立的 HTML 查看器或 Obsidian 知识库。(Wiki) - 诊断:
m3 doctor会检查整个安装,m3 doctor --fix会修复问题;m3 config show --origin会打印每项设置及其来源。 - 审计与 GDPR: 每次记忆读取和搜索命中都会记录读取者、数据主体和时间,并保留 90 天;
gdpr_export和gdpr_forget涵盖第 20 条和第 17 条。(GDPR)
🎯 适用对象
适合使用 m3 的场景……
- **你运行家庭实验室或自托管技术栈:**只需执行一次
pip install即可安装 m3;无需账号或 API 密钥,也不会发出外部请求,除非你主动启用相关功能。它运行在你已有的硬件上,与其他自托管服务并行。默认使用 SQLite(无需任何基础设施);如果你需要在多台机器间共享存储,则可使用 PostgreSQL。 - 你有主权或数据驻留要求——适用于企业、政府、国防、医疗保健或任何受监管的环境:记忆和嵌入数据绝不会离开你的边界。嵌入模型在你自己的硬件上运行,存储是由你控制的文件,而且可通过预编译 wheel 在完全隔离网络的环境中安装。支持符合 FIPS 140-3 要求的加密(
crypto.fips_mode)、GDPRgdpr_forget/gdpr_export、审计日志,以及可重定位的存储根目录,便于对数据库和配置进行独立保护。 - **你希望能自由切换或添加 Agent,而不丢失它们已掌握的内容:**可随时或日后更换工具——Claude Code、Gemini、OpenClaw、Hermes,或未来推出的任何工具——项目知识都会随之保留,而不会因切换而消失。
- **你使用 LangChain/LangGraph 构建:**这是标准记忆模型的高级替代方案,新增双时态查询、带版本历史的取代机制,以及本地嵌入。
- 你使用 CrewAI(v1.10–1.x)构建:可直接替换的
StorageBackend(Memory(storage=M3StorageBackend(user_id="crew-alpha"))),为 CrewAI 提供双时态回忆、带版本历史的取代机制和本地嵌入;此外,还能实现单向量存储无法做到的功能:如果你愿意,CrewAI 写入的记忆也可供所有其他 m3 Agent 搜索(Claude Code、Gemini、LangChain)。pip install m3-memory[crewai]。参见 CrewAI 集成指南。 - **你使用 PydanticAI 构建:**可通过可直接替换的工具 + 自动回忆(
register_m3_tools、m3_recall_processor),或正式的M3MemoryToolset(真正的 PydanticAIAbstractToolset),使用基于 m3 的记忆。基于 Pydantic v2 构建,因此可在 Python 3.14 上通过普通的pip install m3-memory[pydantic-ai]安装运行。参见 PydanticAI 集成指南。 - **你需要安全性和合规性:**内置
gdpr_forget和gdpr_export工具,支持隔离网络环境,并提供审计日志。 - **你重视隐私:**无需云服务或订阅;除非你进行配置,否则任何数据都不会离开你的机器。
以下场景不适合使用 m3……
- 你需要托管式 SaaS 控制面板和托管基础设施(请使用 Letta)。
- **你不需要持久记忆:**你希望每次会话都从头开始,无法检索之前会话中的知识——而 m3 的设计目标恰恰相反,因此使用 Agent 内置的默认功能会更简单。
⚖️ m3 对比
m3 是一款本地优先、原生支持 MCP 的记忆层,始终留在你的机器上,并能与你已经在使用的 Agent 配合工作。Mem0 是一项面向云端、具有指定提取策略的记忆服务。Letta 是一个完整的 Agent 运行时,负责管理对话循环。Zep 和 Graphiti 是以图为核心的系统,通常需要专用图数据库。m3 无需你更改 Agent 技术栈或运行额外基础设施,即可添加持久、可搜索且带版本的记忆。
完整的逐项对比表涵盖 m3 与 Mem0、Letta、Zep、Graphiti、LangChain Memory / LangMem、agentmemory、Chronos、Hindsight、Mastra OM、Memento 等工具,并附有来源明确的基准测试和诚恳的“何时选择其他工具”建议,详见 COMPARISON.md。
🛠️ 面向开发者:记忆后端,而非框架
MCP 是可选的。 m3 是一个记忆层:它负责持久、可搜索的多 Agent 记忆,仅此而已,因此可以直接集成到你现有的任何环境中。每个工具都从 stdin 读取 JSON,并向 stdout 写入 JSON,因此无需 SDK 或 MCP 服务,就能在任何语言、钩子、CI 步骤或 cron 作业中通过脚本调用 m3:
echo '{"query":"auth","k":3}' | m3 memory memory_search --json-file - | jq '.items[].id'
结果可以组合使用,而特定语言的工作(代码解析、VCS 监视)则留在你负责的边界内。将 m3 用于编码工作介绍了相关模式:从搜索结果批量更新、使用 ast 或 tree-sitter 为代码符号编制索引,以及 git 钩子和 CI 步骤。(jq 不是依赖项;任何 JSON 解析器都可以。)
👀 看看它如何运作
从 shell 中查看你的 Agent 通过 MCP 执行的操作(输出截取自真实运行;ID 和分数在你的存储中会有所不同)。保存一个决策:
$ m3 memory memory_write --type decision --title "project-database" \
    --content "We chose PostgreSQL for our website."
"Created: 6795c684-53cb-4a6a-9518-819dbc585fe5"
稍后,在另一个会话中,或由连接到同一 m3 的另一个 Agent,用你自己的话提问:
$ m3 memory memory_search --query "Which database did we decide to use?" --k 1
{
  "count": 1,
  "items": [
    {
      "id": "6795c684-53cb-4a6a-9518-819dbc585fe5",
      "content": "We chose PostgreSQL for our website.",
      "title": "project-database",
      "type": "decision",
      "importance": 0.5,
      "bm25_score": 0.0,
      "score": 0.9122939705848694
    }
  ],
  "query": "Which database did we decide to use?",
  "grade_with": [
    "6795c684-53cb-4a6a-9518-819dbc585fe5"
  ]
}
问题与记忆没有任何共同词汇(bm25_score 为 0.0),但 m3 仍能按含义找到它。你的 Agent 会调用相同的工具,因此它能回忆起这个决策,而不是再次询问你。核心工具列出了你最常用的五个工具。想看演示?带字幕的短视频
展示了一个 Agent 保存决策、另一个 Agent 将其回忆起来的过程
(下载)。
⌨️ m3 CLI
内容来自 --content 或文件(memory_write_from_file --path),日志写入 stderr,因此 stdout 可直接用于管道。运行 m3 --version 检查 m3 是否已启动;如果 CLI 有响应,即使 MCP 客户端断开了连接,你仍可访问记忆(/mcp 会重新连接 Claude Code)。(CLI 参考)
📦 安装
需要 Python 3.12 或更高版本。 在 Python 3.11 上,pip 会静默地将你留在 2026.9.12.0,这是最后一个支持该版本的发行版。运行
python --version检查;HOW-TO-UPGRADE.md 按操作系统提供了升级说明。你的记忆不会受到影响:它们保存在虚拟环境之外的~/.m3/engine中。
顶部的安装说明介绍了常见流程(pip install m3-memory → m3 setup)。本节补充其他方式:Shell 安装程序、按 Agent 配置接入,以及手动配置 MCP。
一键安装(macOS 和 Linux)
curl -fsSL https://raw.githubusercontent.com/skynetcmd/m3-memory/main/install.sh | bash
- Windows 用户请参阅 Windows 手动安装指南。
- 要在任何平台上手动安装,请参阅特定操作系统的安装说明,或查看安装程序脚本。
开发者设置向导
如果你在 Python 环境中进行开发:
pip install m3-memory
m3 setup
m3 setup 向导会自动检测已安装的 Agent — Claude Code、Codex、Cursor、Cline、Gemini CLI、OpenCode、Antigravity、OpenClaw、Hermes — 并将 m3 memory MCP 服务接入每个 Agent,安装设置文件和钩子,配置主权 CPU 嵌入器,并执行系统诊断。每次运行 m3 update/m3 setup 时,都会重新检测并配置接入;m3 doctor --fix 会修正路径已变更的配置,因此你之后安装的 Agent,也会在下次运行 setup 或 update 时自动接入。
上述每个 Agent 和框架都通过 m3 setup 或其插件进行连接;请参阅集成表。
手动配置 MCP 服务
要向任何模型上下文协议宿主公开 m3,请将其添加到配置文件中:
{
  "mcpServers": {
    "memory": {
      "command": "m3"
    }
  }
}
🧰 核心工具
m3 有 100 多个工具;以下五个是你的主要接口。Agent 必须准确使用这些名称,
自行编造的名称会返回 unknown_tool。
| 工具名称 | 功能 | 使用时机 |
|---|---|---|
memory_write | 保存事实、决策、偏好或配置。 | 首次了解到值得留存的信息时。 |
memory_search | 混合关键词(BM25)和语义(向量)搜索。 | 写入前,以及用户询问过往工作时。 |
memory_supersede | 关闭旧事实并记录其替代内容,同时保留历史记录。 | 决策或观点发生变化时;优先使用它,而不是覆盖。 |
memory_get | 根据 ID 获取一条记忆。 | 搜索已返回其 ID 时。 |
memory_suggest | 搜索并明确列出每条结果的评分细目(通过 m3_call;启动时不会加载)。 | 需要了解结果排名原因时。 |
确保记忆准确的规则:
- 写入前先搜索。 首先调用
memory_search;如果存在相似记忆,则用memory_supersede替代它,或通过m3_call使用memory_update编辑它,而不要添加重复内容。 - 替代旧内容,不要覆盖。 更正应通过
memory_supersede(或写入时的自动检查)进行,这样旧版本仍可通过as_of查询。 - 固定记忆可防止老化,但不能防止更正。
memory_pin可使记忆免于衰减和过期;如果固定的记忆有误,仍可被替代。
完整参数请参阅 Agent Instructions Guide 和
完整 MCP 工具目录;机器可读的架构位于
docs/tools/MCP_CATALOG.json。
🤖 面向 AI Agent
将规则集 examples/AGENT_RULES.md 放入你的
工作区,教会 Agent 保持记忆整洁的习惯(写入前先搜索;更新而非重复添加)。
llm-context.md 列出了实际工具名称和使用规则,features.json 是
机器可读的摘要;可复制粘贴、让 Agent 自行安装 m3 的提示词位于
Agent instructions。
仅阅读本页面的 Agent 需要了解的操作事项:
- 启动时加载的工具包括
memory_write、memory_search、memory_supersede、memory_get、chatlog_search和m3_call;其他所有工具都可通过m3_call调用。 - 写入前先搜索,更正时使用
memory_supersede。 - 记忆具有作用范围(
agent、user或org),也可固定;固定只会阻止 衰减,不会阻止替代。 - 嵌入器默认在本地
127.0.0.1:8082运行。如果语义搜索没有返回结果,请检查embedder_status,或使用m3 embedder fetch-model下载模型。
🎬 实际演示
写入时替代与版本历史
混合搜索评分详情
多设备数据库同步
💬 社区
📜 许可证与致谢
本项目采用 Apache License 2.0 许可。详情请参阅 LICENSE。
构建工具
m3 Memory 由 skynetCMD 编写并维护。在 AI 编码助手 Gemini CLI、Claude Code 和 Google Antigravity 的协助下构建;它们在作者的指导下参与了代码编写。(它们是提供协助的工具,并非项目维护者、赞助方或共同所有者。)
资源与图标致谢
docs/badges/ 下的提供商徽章中嵌入了小型徽标图案:
- OpenClaw 和 OpenCode 图标来自采用 MIT 许可证的 LobeHub 图标集(
lobe-icons)。 - Hermes 徽章使用通用的蛇杖图案。
完整的第三方致谢列表请参阅 NOTICE。
PyPI 总下载量及近 30 天下载量。GitHub 克隆次数为唯一克隆数。徽章由 star-history.yml 按计划重新生成。
Python:m3 核心支持 Python 3.12、3.13、3.14 和 3.15。可选框架扩展各自有版本限制——PydanticAI 原生支持 3.14(可直接使用 pip install);CrewAI 与 m3 一起使用时需要 3.12–3.13(3.14 的替代方案已记录在文档中)。
⭐ Star 历史
⭐ 查看 Star 历史 →(点击展开图表)
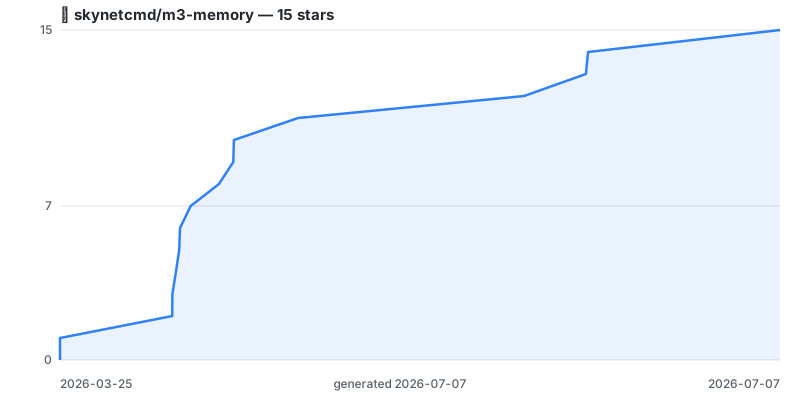
图表由 .github/workflows/star-history.yml 按计划使用仓库自身的令牌重新生成,不使用第三方嵌入内容。点击查看实时交互版本。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。