关于 MemoryPilot
MemoryPilot 是面向 AI Agent 的本地长期记忆 MCP 服务,以混合检索、知识图谱和压缩整理记忆。它使用单一二进制文件,支持跨会话和项目感知的记忆检索。
主要功能
- 01BM25 与向量混合检索
- 02时序知识图谱与 GraphRAG
- 03自动分类和压缩记忆
- 04跨会话、项目感知记忆
- 05支持 100 多种语言
适用场景
- 01跨会话恢复编码项目背景
- 02检索多语言历史记忆
- 03压缩上下文以节省令牌
MCP 相关
作为 MCP 服务,MemoryPilot 向客户端提供持久记忆的写入与检索能力。README 还列出 HTTP API。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
我们还没有获取到这个服务的安装包或远程地址,请按项目 README 中的说明安装。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
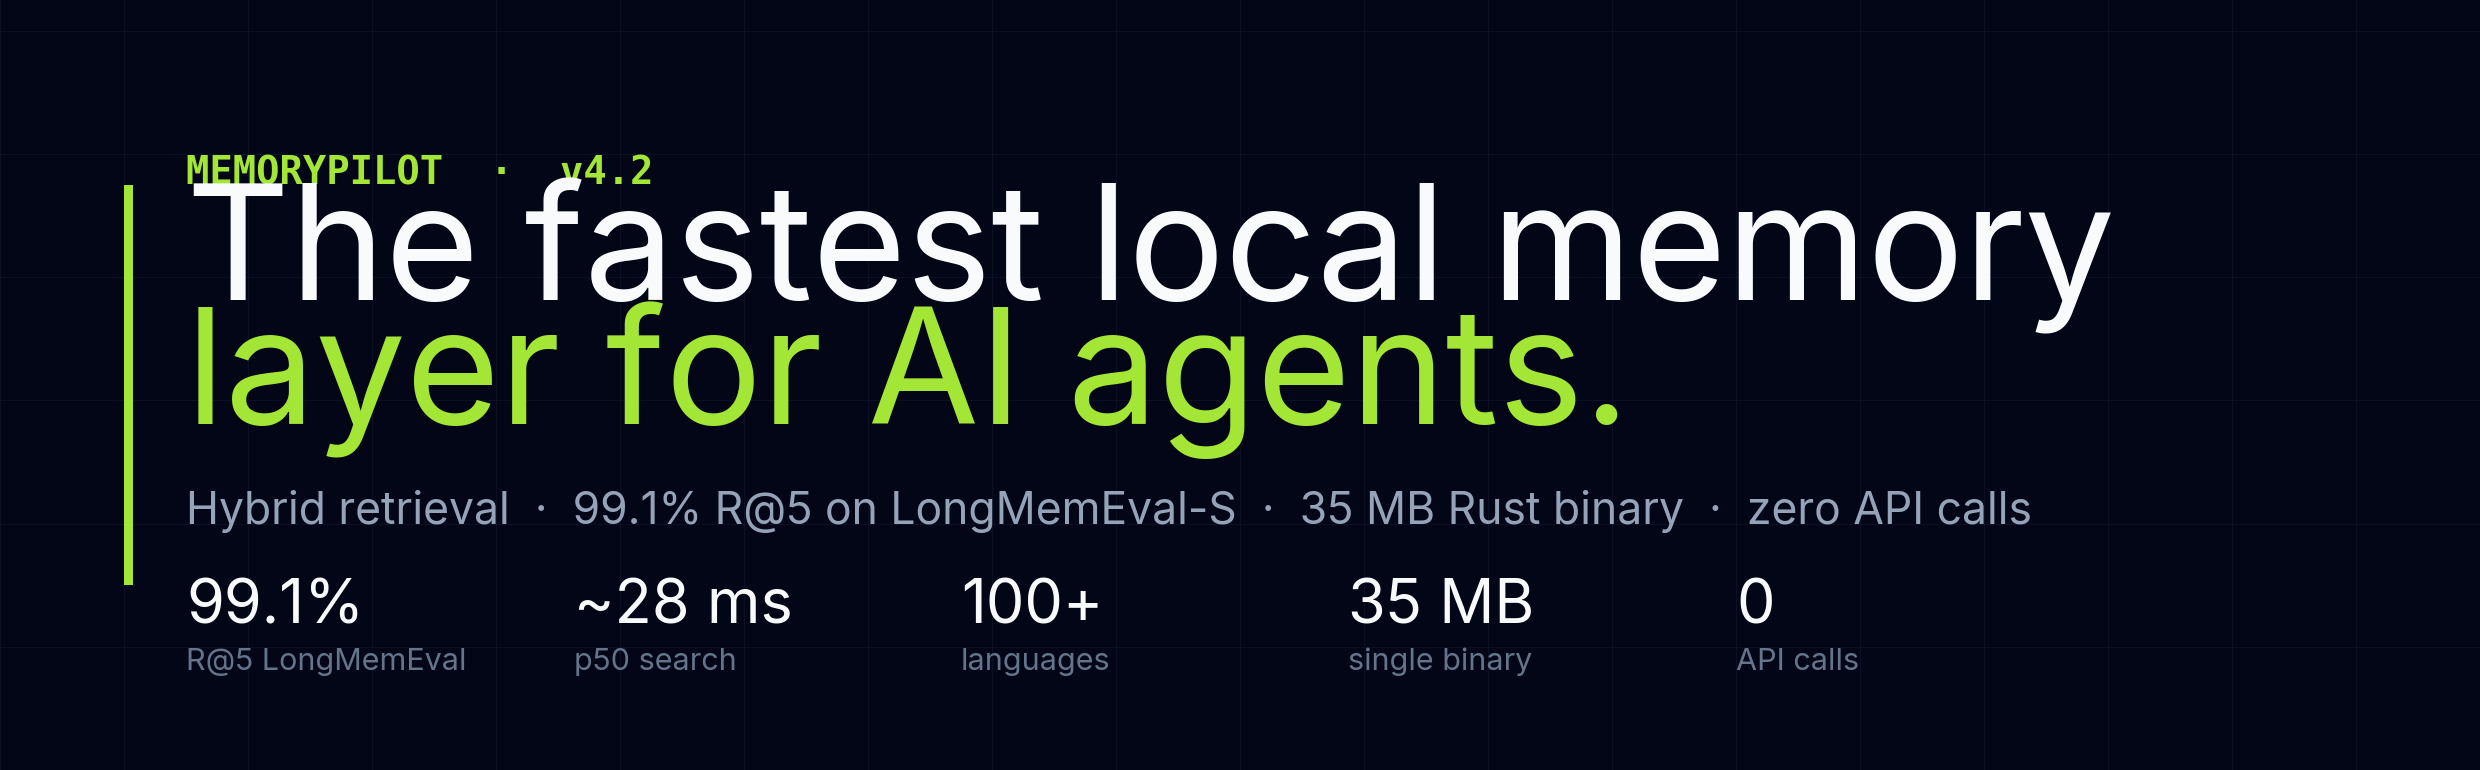
最先进的 MCP 记忆服务。就是如此。
混合搜索(BM25 + jina-embeddings-v5 RRF + cross-encoder 重排)· 100+ 种语言 · 时序知识图谱 · 查询感知排序 · 语料来源检测 · Agent/角色消歧 · 主题隧道 · AAAK 压缩(节省 5-10x 令牌)· GraphRAG · 分块 RAG · 自动压缩 · 自动分类 · 记忆胶囊 · HTTP API · 单一二进制文件 · 零 API 调用




为什么选择它
AI 编码助手会忘记不同会话之间的所有内容。MemoryPilot 为它们提供持久、可搜索的记忆,并具备项目感知、语义理解和自动知识整理功能。内置的 AAAK 压缩和记忆胶囊在加载上下文时可减少 5-10x 的令牌消耗。每条记忆在插入时都会自动分类,并设置合适的重要性、类型和 TTL。数据库会自动压缩——无需维护。
安装 MemoryPilot一条命令即可为 Cursor、Claude Desktop、VS Code、Windsurf、Claude Code、Codex 和 ChatGPT 安装。单一 Rust 二进制文件,无运行时依赖。 |
工作原理9 大支柱——混合搜索、时序知识图谱、GraphRAG、AAAK 压缩、自动分类、自我修复——端到端详解。 |
基准测试
LongMemEval-S(ICLR 2025)——学术标准
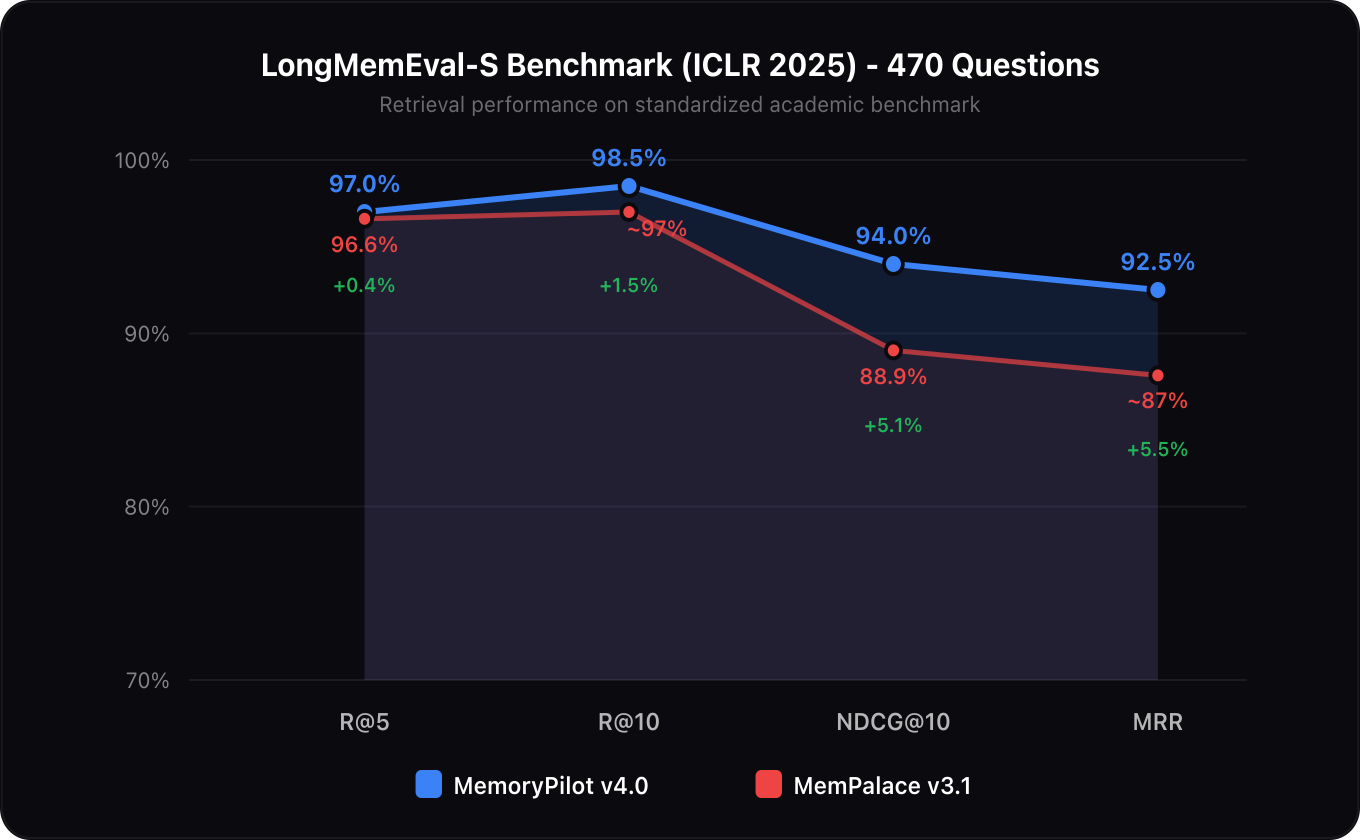
在 LongMemEval 基准测试的 470 个问题上进行了评估。该基准是长期记忆检索领域的标准学术数据集,采用轮次级粒度,每个干草堆约有 50 个会话。
与整个市场对比(LongMemEval-S,公开数据)
| 系统 | R@5 / 准确率 | 延迟 | 隐私 | 技术栈 | 来源 |
|---|---|---|---|---|---|
| MemoryPilot v4.2(自适应) | 99.1% | ~900 ms | 100% 本地 | Rust · 35 MB 二进制文件 · 零 API | 本仓库,--benchmark-longmemeval @470 |
| MemoryPilot v4.2(默认快速模式) | 98.7% | ~28 ms | 100% 本地 | Rust · 35 MB 二进制文件 · 零 API | 本仓库,--benchmark-longmemeval @470 |
| MemPalace v3.3.3(混合) | 98.4% | 未公布 | 100% 本地 | Python + ChromaDB · ~500 MB | MemPalace v3.3.3 发行说明 |
| agentmemory v0.9(11k+ 星) | 95.2% | 未公布 | 100% 本地 | Node + iii-engine + SQLite | github.com/rohitg00/agentmemory — benchmark/LONGMEMEVAL.md |
| Mem0(云端,OpenAI 后端) | 94.4% | ~6 787 个 token/查询 | 云端(OpenAI) | SaaS + OpenAI 嵌入 | mem0.ai 博客 |
| mcp-memory-service v10.34.0 | 80.4% | 未公布 | 100% 本地 | Python + SQLite-Vec + MiniLM | v10.34.0 发行说明 |
| Zep / Graphiti | 63.8% | “比基线低 90%” | 云端或自托管 | Python + Neo4j + LLM 提取 | arXiv 2501.13956 |
| Letta / MemGPT | 未在 LongMemEval 上测量 | — | 自托管 | Python 框架 | Letta 跟踪议题 #3115 |
MemoryPilot 是本次对比中唯一兼具 100% 本地运行和排行榜领先表现的系统。默认快速模式(~28 ms)已经胜过所有公布数据的竞品——包括 agentmemory(95.2%),它是当前 AI Agent 记忆类别中的热门项目,在 GitHub 上拥有 11k+ 星。自适应交叉编码器模式每次查询增加一次 ONNX 重排,耗时相应增加,可使 R@5 再提升 +0.4 个百分点;相较 agentmemory,MRR 领先 +6.7 个百分点(94.9% vs 88.2%)。
详细对比 — MemoryPilot 与 MemPalace(最接近的本地竞品)
| 指标 | MemoryPilot v4.2(默认快速模式) | MemoryPilot v4.2(自适应重排) | MemPalace v3.3.3 | 相较 MemPalace 的差值 |
|---|---|---|---|---|
| R@5 | 98.7% | 99.1% | 96.6% 原始 / 98.4% 混合 | 相较原始结果 +2.5% / 相较混合结果 +0.7% |
| R@10 | 99.6% | 99.4% | ~97%¹ | 相较原始结果 +2.6% |
| NDCG@10 | 95.1% | 96.0% | 未公布 | MemoryPilot 已公布 |
| MRR | 93.6% | 94.9% | 未公布 | MemoryPilot 已公布 |
| 平均搜索延迟 | ~28 ms | ~900 ms | 不适用 | 默认模式快 30 倍 |
¹ 使用完整的 470 道题评测集(剔除 30 道弃答题后),在两种模式下进行了验证:默认快速本地混合检索(BM25 + cosine RRF,~28 ms/查询,适合实时 MCP 流量),以及自适应交叉编码器重排(
MEMORYPILOT_CROSS_RERANK=adaptive,jina-v2-multilingual,融合权重 0.45,~900 ms/查询,适合基准测试和高风险召回场景)。默认模式已超过 MemPalace 在留出集上的混合模式结果;自适应模式则以更高延迟换取额外 +0.4 个百分点的 R@5 和 +1.3 个百分点的 MRR。
按类别划分(470 道题,自适应重排)
| 类别 | R@5 | R@10 | MRR |
|---|---|---|---|
| 单轮会话-用户(64) | 100% | 100% | 96.6% |
| 单轮会话-助手(56) | 100% | 100% | 98.8% |
| 多轮会话(121) | 100% | 100% | 95.7% |
| 知识更新(72) | 100% | 100% | 98.2% |
| 时间推理(127) | 97.6% | 98.4% | 93.3% |
| 单轮会话-偏好(30) | 96.7% | 96.7% | 75.9% |
法语 / 多语言基准测试 — --benchmark-fr
为补充仅支持英语的 LongMemEval,MemoryPilot 推出了自己的确定性法语基准测试,涵盖基础设施、移动端、Web、安全和 ML 领域的 109 条记忆和 109 个改写查询。这些查询在措辞上有意与已索引内容保持较大差异,以实际检验语义通道。
| 模式 | R@5 | R@10 | MRR | 平均延迟 |
|---|---|---|---|---|
| 默认快速模式(BM25 + jina RRF) | 92.7% | 99.1% | 74.4% | ~100 ms |
| 自适应交叉编码器重排(默认) | 99.1% | 99.1% | 97.4% | ~210 ms |
v4.5 修复了一个排序错误:自 v4.0 起,该错误一直将此基准测试的 R@5 限制在约 70%。知识图谱邻居被赋予硬编码分数(0.1),高于所有真实 RRF 命中(最高 2/41 ≈ 0.049),因此它们占据了交叉编码器窗口,并将真实匹配项挤到了 limit 之后。现在,邻居的分数低于最弱的真实候选项,只有交叉编码器才能将它们提升排名。
v4.5.0 还修复了这项工作中发现的两个写入路径稳定性问题:情节汇总每次运行都会嵌入每个小时分桶,即使情节已经存在也不例外;而且它会在 add_memory 中同步执行,随后还会在处理多字节法语文本时触发 panic。现在,这项工作在独立线程中运行,并会先进行低开销的存在性检查。此外,自动压缩在调用 run_gc / compact_to_capsules 时一直持有 Mutex,而这些函数合并后的行会重新进入 add_memory — 在汇总不再提前触发 panic 后,隐藏的死锁问题也随之显现。
得益于确定性记忆 ID、基于 ID 的确定性 RRF 平局判定、同步 ANN 预热,以及首次查询前显式预热交叉编码器,各次运行的 R@5 / R@10 波动范围不超过 ±1 个百分点。这是监测任何法语 / 多语言回归时应关注的指标。
v4.6 — 超越单条事实检索
v4.6.0 面向仅靠 top-k 检索器无法胜出的 LongMemEval 类别:多会话聚合、时间推理、知识更新和弃答。所有操作都在本地完成,并采用基于规则的方法或 int8 ONNX。在 LongMemEval-S@100(64 个单会话问题 + 36 个多会话问题,以及该切片中的 7 个弃答问题)上进行测试,并与 v4.5.0 对比;使用同一台机器,交叉编码器采用自适应模式:
| 指标 | v4.5.0 | v4.6.0 |
|---|---|---|
| R@5 / R@10 | 99% / 100% | 100% / 100% |
| MRR / nDCG@10 | 96.3% / 97.2% | 96.5% / 97.3% |
| 多会话 gold 覆盖率@10 | 93.6% | 94.5% |
| top-10 中包含所有 gold 会话的多会话问题数 | 30/36 | 32/36 |
| 可回答问题上的错误弃答率 | — | 4% |
抽取式回答(search_memory … answer=true),包含 gold | — | 48%(单会话为 72%;计数问题超出了片段抽取的能力范围) |
--benchmark-fr 的结果在噪声范围内没有变化(R@1 96.3%,R@5 99.1%,MRR 97.6%)。
- MMR 多样性(
src/diversity.rs)——根据存储向量的最大边际相关性,对入围结果以及紧随其后的 RRF 排名结果重新排序(λ = 0.4,冗余下限为 0.55)。排名第一的结果不会移动,因此 MRR 不受影响;第二个不同来源可以取代对第一个来源的重复表述。MEMORYPILOT_MMR=0可将其禁用。 - 时间定位(
src/temporal.rs)——记忆中的明确日期(2026-09-01、12 septembre 2026、September 12、hier……)在摄取时会成为date实体;查询中的时间短语(last week、il y a deux semaines、en mars、last Tuesday)会转换为一个天数范围,在该范围内提升有日期候选项的分数(×1.25),并轻微降低远超该范围的有日期候选项的分数(×0.85)。无日期的记忆不受影响,因此即使范围解析错误,最多也只会损失提升的分数。MEMORYPILOT_TEMPORAL=0可将其禁用。 - 上下文嵌入——对话转录片段和其他上下文信息较少的类型,会在嵌入时添加
[date · project]前缀;存储内容及其哈希保持不变。 - 替代旧记忆——每日整合流程会将一条记忆关联到较新的、内容近乎相同但值已更改的重述记忆(余弦相似度 ≥ 0.86,词汇重叠度为 0.55–0.95,间隔 ≥ 1 小时),并在搜索时降低旧记忆的排名(−0.35)。两条记忆仍都可检索;
consolidate_memories(apply=true)会报告建立的关联。 - 校准置信度——每次搜索都会返回
confidence: { top_cosine, peak, cross_score, margin, level, abstain }。在 LongMemEval 中,弃答问题的干扰记忆来自同一用户的其他会话,没有简单信号能将它们与可回答问题区分开(top-1 余弦相似度 p50 为 0.46 对 0.54,交叉编码器 logits 完全重叠),因此硬性abstain阈值刻意设得较保守(余弦相似度 < 0.35,错误弃答率为 4%),而level则提供分级信号。MEMORYPILOT_ABSTAIN_COSINE可调整下限。 - 抽取式阅读器(
src/reader.rs,选择启用)——使用answer: true的search_memory会对排名前 5 的段落运行deepset/roberta-base-squad2(int8 ONNX,125 MB,英语,通过空闲池按需加载),并返回字面片段或不返回结果。CPU 上每个问题约需 480 ms。它是用于基准测试的工具,也适用于字面查找捷径,并非语言模型:当检索器无法回答时,它对 7 个 LongMemEval 弃答问题中的 5 个选择了弃答。--benchmark-longmemeval --reader会报告 SQuAD 风格的 EM / F1 / contains。
搜索质量 — 真实场景(500 条记忆,30 个场景)
| 指标 | MemoryPilot v4.2 | MemPalace v3.1(原始) | Quantum Memory Graph |
|---|---|---|---|
| R@5 | 100% | 96.6% | 93.4% |
| R@10 | 100% | 不适用 | 93.4% |
| NDCG@10 | 95.6% | 88.9% | 90.8% |
| 聚类一致性 | 96.7% | 不适用 | 不适用 |
| 多语言 | 100+ 种语言(已验证法语 R@5 为 99.1%) | 仅支持英语 | 仅支持英语 |
| AAAK 压缩 | 5-10 倍(召回率不下降) | 30 倍(召回率降至 84.2%) | 不适用 |
| 平均搜索延迟 | 默认约 28 ms / 自适应约 410 ms | 不适用 | 约 80 ms |
| 二进制大小 | 35 MB | 约 500 MB(Python+ChromaDB) | 1.5 GB |
| 依赖项 | 0(单一二进制文件,已内置 ONNX) | Python + ChromaDB + SQLite | Python + ONNX |
与市面上最出色的记忆服务对比:
| 特性 | MemoryPilot v4.7 | MemPalace v3.3.3 | agentmemory v0.9 | Mem0 | Zep / Graphiti |
|---|---|---|---|---|---|
| LongMemEval R@5 | 99.1% | 98.4% | 95.2% | 94.4% | 63.8% |
| LongMemEval MRR | 94.9% | 未发布 | 88.2% | 未发布 | 未发布 |
| 搜索 | 混合 BM25 + jina-embeddings-v5-nano RRF(768 维,int8)+ 自适应 mmarco 交叉编码器 | ChromaDB 余弦相似度(all-MiniLM-L6-v2) | BM25 + 向量 + 图(RRF) | 向量搜索(云 API) | 时序 KG 遍历 + 向量 |
| 嵌入 | jina-embeddings-v5-text-nano-retrieval(支持 100 多种语言、8k 上下文、本地 ONNX) | all-MiniLM-L6-v2(仅支持英语) | all-MiniLM-L6-v2(仅支持英语) | OpenAI API 调用(外部) | OpenAI / 云端大模型提取 |
| 多语言 | 原生支持 100 多种语言(FR、EN、ES、DE、JA、ZH……) | 仅支持英语 | 仅支持英语 | 取决于 API | 取决于大模型后端 |
| 知识图谱 | 带有效性 + 置信度的时序三元组 | 时序三元组(SQLite) | 知识图谱(无有效期) | 基础图谱(无时序) | 时序 KG(Graphiti,核心特性) |
| GraphRAG | 自动实体提取 + 图遍历 + 组合式重排器 | 无 | 部分支持(图搜索通道) | 无 | 支持(基于大模型的提取) |
| 交叉编码器重排 | jina-v2-multilingual(自适应,约 250 ms) | 无 | 无 | 无 | 无 |
| 查询感知排序 | 偏好/时序/角色/更新/技术意图加权 | 混合 v4 关键词 + 时序加权 | 仅 RRF 融合 | 取决于 API | 图距离评分 |
| 语料来源检测 | AI 转录文本/代码库/笔记/平台检测 | v3.3.4 计划 | 无 | 无 | 无 |
| Agent/角色消歧 | Agent 与真实人物分开处理 | v3.3.4 计划 | 基于钩子的会话范围限定 | 无 | 部分支持(实体节点) |
| 主题隧道 | 通过 KG 建立跨项目主题链接 | v3.3.4 计划 | 无 | 无 | 无 |
| 代码感知分块 | Tree-sitter Rust/Python/TS/TSX/JS + Svelte 脚本提取 | Tree-sitter 代码分块 | 无 | 无 | 无 |
| 分块 RAG | 转录文本自动分块 + 自动提炼(8 种类型) | 按对话轮次分块 | 会话回放 + JSONL 导入 | 无 | 基于大模型的摘要 |
| 压缩 | AAAK + Memory Capsules(节省 5-10 倍 token) | AAAK 方言(实验性,会使召回率降至 84.2%) | 4 层整合 + 衰减 | 无 | 无 |
| 自动分类 | 插入时零样本判定类型/重要性/TTL | 无 | 通过钩子进行模式匹配 | 无 | 大模型分类实体 |
| 自动压缩 | 记忆数量达到 500 条以上时自动触发 GC | 无 | 生命周期衰减 + 自动遗忘 | 无 | 手动 |
| Memory Capsules | 将旧记忆压缩为精简摘要 | 无 | 基于层级的整合 | 无 | 无 |
| 记忆固定 | 固定关键记忆——始终参与召回,不受 GC 影响 | 无 | 无 | 无 | 无 |
| 图遍历 | 通过 KG 查找相关记忆(深度 1-3) | 无 | 支持(图通道) | 无 | 原生支持(Cypher / Neo4j) |
| 批量操作 | 按类型/项目/标签/时长删除,并带安全保护 | 无 | 治理删除 API | 无 | 手动 |
| 健康状况面板 | 记忆分布、过时数量、孤立项、数据库大小 | 无 | 实时 Web 查看器(端口 3113) | 无 | 无 |
| 重复项检测 | 使用 Jaccard 相似度扫描近似重复项 | 无 | 未记载 | 无 | 基于大模型的协调 |
| 人物检测 | 从文本中自动检测团队成员 | 无 | 无 | 无 | 大模型提取实体 |
| 自我修复 | 后台自动 lint 循环 | 无 | 无 | 无 | 无 |
| 垃圾回收 | 启发式合并 + 评分 + 清理孤立项 | 无 | 生命周期 + 衰减 | 基础 TTL | 无自动 GC |
| 项目大脑 | 支持,包含团队成员(少于 1500 个 token) | 无 | 按需生成会话摘要 | 无 | 无 |
| 文件监视器 | 根据近期编辑内容增强上下文 | 无 | 文件系统连接器(@agentmemory/fs-watcher) | 无 | 无 |
| 去重 | 内容哈希(精确)+ Jaccard 85%(模糊) | 基础哈希 | 置信度评分 | 嵌入相似度 | 基于大模型的合并 |
| HTTP API | 多线程 REST 服务(可选) | 无 | REST + MCP + 租约 + 信号 | 云托管 | REST + GraphQL |
| 记忆类型 | 13 种类型,重要性 1-5 | Wings/Rooms 层级结构 | 基于层级(工作/短期/长期/归档) | 1 种类型 | 情景式 / 语义式 |
| MCP 工具 | 41 个工具 | 29 个工具 | 51 个工具 | 不适用 | MCP 服务支持有限 |
| 钩子 / 事件捕获 | 为 Cursor、Claude Code 和 Codex 提供 SessionStart 自动召回 + Stop 自动摄取(增量处理、提炼、过滤 Agent 叙述、隐去机密信息)+ 文件监视器 | 无 | 12 个命名钩子(Claude Code、Cursor、Codex、Copilot CLI……) | 无 | 无 |
| 隐私 | 100% 本地运行,零 API 调用 | 100% 本地运行 | 100% 本地运行(SQLite) | 取决于云服务 | 云端或自托管(需要大模型) |
| 语言 | Rust(单个二进制文件,零依赖) | Python(通过 pip install 安装) | TypeScript / Node(通过 npm install 安装) | SaaS | Python + Neo4j |
| 启动 | 1-2 ms(open_at)/ 通过 open_at_warm 同步预热 | 约 5 ms | Node 启动 + iii-engine 初始化 | 不适用(云端) | 较重(Neo4j 启动) |
| 二进制文件 | 35 MB 单个二进制文件 | Python + ChromaDB(安装后约 500 MB) | Node 运行时 + iii-engine 依赖 | SaaS | Python + Neo4j(约 1.5 GB) |
| 存储 | SQLite WAL + FTS5 + 16 连接读池 | ChromaDB | SQLite + iii-engine | 云数据库 | Neo4j + Postgres |
| 并发 | EmbedPool(4)+ RerankPool(1,可调)+ 16 个读连接 + 防抖清理 | 单线程 | Node 事件循环 | 单线程 | 受 Neo4j 限制 |
| 外部大模型依赖 | 无 | 无 | 无(本地嵌入) | 需要 OpenAI | 摄取时需要大模型 |
| GitHub 星标数(2026 年 9 月) | 刚起步 | 刚起步 | 约 28.9k | 53k | — |
9 大支柱
1. 混合搜索(BM25 + jina RRF)
每条记忆在插入时都会通过 ONNX Runtime 生成 768 维 Transformer 嵌入(jina-embeddings-v5-text-nano-retrieval,int8,本地推理——支持包括法语、英语、西班牙语、德语、日语和中文在内的 100 多种语言;不调用 API,不使用外部服务;首次运行时会从其 Hugging Face 仓库获取模型,许可证为 CC-BY-NC-4.0)。查询和文档使用模型的非对称 Query: / Document: 前缀。int8 权重采用内存映射,因此嵌入器的常驻内存约为 250 MB,其中大部分是可回收的文件映射页面。搜索会并行执行 BM25 全文搜索和余弦相似度搜索,然后通过倒数排名融合合并结果。
结果会根据重要性权重、知识图谱链接密度和文件监视器上下文进行加权提升,并对已过期的知识三元组进行惩罚。
同一 MCP 中还提供临时工作记忆,可通过 remember_working、recall_working 和 clear_working 使用。它将快速会话便笺上下文保存在 RAM 中,最多 256 条,不会污染 SQLite 或持久记忆检索。
性能优化:
- 延迟生成嵌入:
add_memory会立即返回,嵌入在后台线程中计算 - 双层查询嵌入缓存(LRU 256 + SQLite 写穿缓存):重复查询会跳过 ONNX 推理
- 读取连接池(16 个连接):并发向量搜索不会阻塞写入,容量针对 HTTP 服务工作负载设置
- EmbedPool(4 个会话,可通过环境变量调整):并行生成嵌入,无需在单个 ONNX 互斥锁上串行执行
- RerankPool(1 个会话,可通过环境变量调整为 2 个):多客户端负载下并行执行交叉编码器重排序
- 内容哈希(FNV-1a):回填时跳过未更改的记忆
- 同步预热入口点
open_at_warm:返回前将 ANN 索引加载到 RAM 中,消除冷启动延迟(4 客户端并发基准测试中的 p95 搜索延迟从 3939 ms 降至 229 ms)
2. 时序知识图谱
具备时序有效性的完整知识图谱。事实包含 valid_from / valid_to 日期和 confidence 分数。事实过时时会被标记为无效,而不是删除,从而让 AI 了解知识的演变时间线。
系统会自动从记忆内容中提取实体(技术、文件、组件、人物),并建立双向链接。对于包含的三元组全部过期的记忆,其搜索结果会受到惩罚。
5 个专用 KG 工具: kg_add、kg_invalidate、kg_query、kg_timeline、kg_stats
3. GraphRAG
系统会自动分析每条记忆中的实体:技术、文件路径、组件、项目和人物。实体存储在专用表中。共享实体的记忆会通过推断出的关系类型(resolves、implements、depends_on、deprecates……)自动关联。
搜索时,MemoryPilot 会从最匹配的结果出发遍历知识图谱,提取相关上下文,例如找到促成某个特定错误修复的架构决策。随后,组合式重排序器会选择最佳的关联记忆簇,而不是独立的 Top-K 结果,从而生成连贯的上下文(簇连贯度达 94%)。经过调优的 RRF 融合(k=40)、精确词项覆盖度提升、智能 FTS 分词、查询时知识图谱扩展、时序新近度和重要性平局决胜机制,使 NDCG@10 达到 94%,R@5/R@10 均达到 100%。
4. 分块 RAG(对话记录)
保存完整的对话记录,同时避免占用大模型的上下文窗口。add_transcript 工具会自动将大文本分块为约 2000 个字符的内容块,并将它们相互关联。这些内容块不会包含在 recall 中,但可以完整搜索。
对于源代码,MemoryPilot 默认使用本地 tree-sitter 解析 Rust、Python、TypeScript、TSX 和 JavaScript,并通过提取 <script> 内容并对标记语言分块来支持 Svelte。代码会按照函数、类、impl 块、接口和导出等语义边界拆分,而不是按任意段落拆分。
自动提炼功能会从对话记录中提取结构化记忆:decision、preference、todo、bug、milestone、problem 和 note。智能消歧:同时提及某个 bug 及其解决方法的片段会被归类为 milestone,而不是 bug。
支持 session_id、thread_id、window_id,用于多窗口记忆范围管理。
5. AAAK 压缩
灵感来自 MemPalace 的符号化记忆语言。向 recall 或 get_project_brain 传入 compact: true 时,输出会使用简洁的竖线分隔格式,压缩约 3 倍:
[DEC:5] Use Clerk over Auth0 | tags:auth,stack | proj:MyApp
[PREF:4] Always use TypeScript strict mode | tags:typescript
6. 自我修复(自动代码检查器)
MemoryPilot 会监视你的文件。保存 Rust、Svelte 或 TypeScript 文件时,它会在后台运行代码检查。编译错误会自动作为 bug 记忆存储,并附带确切的堆栈跟踪。错误修复后,该记忆会自动删除。
代码检查器线程在其整个生命周期内会复用单个数据库连接。
7. 垃圾回收与自动压缩
系统会为旧的、重要性较低的记忆评分,以判断其是否适合清理。相关的过期记忆组会通过启发式关键词提取合并为精简摘要。孤立的链接和实体会被清理。大量删除后会对数据库执行压缩。
当记忆数量超过 500 时,会自动触发自动压缩:GC 会在 add_memory 后于后台运行,并防抖为每 5 分钟最多运行一次。无需手动干预。
记忆胶囊(compact_memories 工具):将旧的低重要性记忆压缩为约 100–200 个 token 的精炼胶囊。凭据和架构决策永远不会被压缩。胶囊会保留知识图谱链接,让陈旧记忆节省 5–10 倍 token,同时不丢失召回能力。
8. 零样本自动分类
如果调用方未指定类型或重要性,每条记忆在插入时都会自动分类。基于模式的启发式规则可检测:
- 凭据(API 密钥、机密)→ 重要性 5,无 TTL
- 架构决策 → 重要性 5
- 偏好/模式 → 重要性 4
- Bug → 重要性 3,TTL 为 90 天
- TODO → 重要性 2,TTL 为 30 天
- 代码片段 → 重要性 2
- 里程碑 → 重要性 4
无需大模型——仅使用纯正则表达式和关键词启发式规则。AI 仍可通过传入明确的 kind 和 importance 覆盖分类结果。
9. 项目大脑
一次工具调用即可返回项目的精简 JSON 快照,不超过 1500 个 token,包含技术栈、架构决策、活跃 Bug、近期更改、关键组件和团队成员(自动检测的人物实体)。支持使用 compact: true 进行 AAAK 压缩。
尚未发布
- 通过 Git 检查记忆:如果某条记忆引用了其项目仓库中的文件,就会将这些文件与记忆创建后提交的更改进行比较。只要有相关信息,搜索、回忆和获取操作就会添加一个
verification对象:likely_resolved(后续修复提交修改了某个缺陷引用的文件)、possibly_resolved(后续修复提交看起来像是解决了该缺陷)、changed_since(引用的文件已更改),或记录的resolved/verified。忽略大型提交(超过 40 个文件)以及文档、测试或杂务提交。按需读取 Git,并按每个 HEAD 缓存:不会将任何内容复制到数据库。verify_memory提供详细信息,resolve_memory使用修复提交记录 open / resolved / verified;已解决的缺陷会从项目知识库中移除。MEMORYPILOT_VERIFY=off可关闭此功能。 - 从仓库读取事实:
project_facts按需计算并返回项目仓库当前记录的项目情况,不会存储这些信息:软件包清单和版本(package.json、Cargo.toml、pubspec.yaml)、Cloudflare 配置(wrangler.toml/.jsonc,仅变量名)、cf-orchestrator 部署目标、Supabase 迁移、SvelteKit 路由、最近一次提交。回忆(project_facts)和项目知识库(derived_facts)会附带几行摘要。如果某条记忆记录的框架版本早于仓库使用的版本(例如写着“Tailwind 3”,而package.json中是^4.1.0),则会标记为contradicted;较新版本会被视为计划,而非过时事实。 - 连接器:GitHub、部署、Supabase 生产环境:
project_facts会添加未关闭和最近合并的拉取请求及未关闭的问题(通过已登录的gh),每个目标最近一次成功的 cf-orchestrator 部署及其目录中此后提交的更改、最近的 Git 标签及此后提交的更改;如果有 Supabase 访问令牌,还会添加supabase/migrations中尚未应用到生产环境的迁移(Management API,权限范围为database:read;令牌来自SUPABASE_ACCESS_TOKEN或 Keychain,服务为MemoryPilot,账户为supabase-access-token,通过 stdin 传给 curl,不会出现在命令行中)。回忆会读取后台每 5 分钟刷新的缓存副本,因此不会等待网络响应。如果某条引用拉取请求或问题的缺陷记忆创建后,该拉取请求已合并或该问题已关闭,则会标记为likely_resolved。MEMORYPILOT_CONNECTORS=off可关闭这些连接器。 - 将机密作为指针处理:现在任何工具都不会返回凭证值,包括
full模式和导出结果。凭证会以屏蔽后的标签和一个secret指针形式返回:指明值所在位置(通过update_memory设置的location、标签中的op://引用,或密码库),以及如何请求获取该值。只有reveal_secret {id, reason}能获取值:用户需在 macOS 对话框中确认,Agent 无法点击该对话框(Reveal / Refuse,55 秒);每次请求都会记录到~/.MemoryPilot/logs/reveal-audit.log,但不记录值。更新操作不会再破坏机密:如果写回屏蔽文本、替换元数据,或仅更改类型,操作会被拒绝或保留密文。MEMORYPILOT_REVEAL_CONFIRM=none会跳过对话框(仍会审计);MEMORYPILOT_SECRETS=reveal会恢复透明解密;通过 HTTP 使用时,除非设置MEMORYPILOT_HTTP_SECRETS=on,否则会拒绝reveal_secret。 - 以 1Password 作为机密存储位置:
MemoryPilot --sync-1password [--apply]会将密码库密钥备份到 1Password(项目“MemoryPilot vault key”),然后将每个凭证指向op://引用:如果已有关于同一账户(标题或文本中的 URL 主机名)的项目且其中已保存该值,就关联该项目;否则创建 Login 或 Secure Note(标签memorypilot-import)。不会删除任何内容;默认仅试运行。之后reveal_secret会优先从 1Password 读取值(若已安装则使用op-sof,否则使用op;值仅通过 stdin/stdout 传递),并说明值的来源。 memorypilot-core库:存储、搜索、回忆、知识图谱和密码库现已迁移至crates/memorypilot-core(Cargo 工作区);MemoryPilot二进制文件是基于它构建的 MCP 服务。db.rs已拆分为按领域划分的文件。记忆行通过MemoryStoretrait 处理,搜索和回忆的所有读取都通过RecallStoretrait 进行(目前使用 SQLite);其他存储必须通过契约测试(store-contractfeature)。测试相同,基准测试结果也相同(scripts/bench-gate.sh)。- 服务模式、存储(进行中,尚未发布):
crates/memorypilot-server在一个 Postgres 数据库中为许多客户存储记忆(全文搜索使用tsvector,向量使用 pgvector)。租户、空间和终端用户通过两层机制隔离:每次查询都会按它们进行筛选,行级安全策略则会拒绝任何属于其他租户的行。它通过了与 SQLite 相同的存储契约测试;写入流程(去重、实体和日期提取、链接)及混合搜索流程可在任一存储上原样运行:在法语基准测试中,Postgres 的 recall@10 为 100%,MRR 为 97.9%(SQLite:100% 和 98.1%),在相同的三个查询中未能排名第一。终端用户只能将自己的记忆关联到自己可见的内容。连接 Postgres 时必须使用 TLS,并验证证书和主机名(Mozilla 根证书加可选 CA 文件,例如 Supabase 的 CA 文件);本地或私有数据库也可以明确使用明文连接。memorypilot-server二进制文件通过池化会话提供 REST API(/v1/memories、/v1/search),使用每个应用各自的 API 密钥进行身份验证(read、write、subjects;只存储其 SHA-256 哈希,撤销后立即生效);使用X-MemoryPilot-Subject时,应用可代表自己的某位终端用户操作,该用户会在首次使用时创建,且只能修改自己的记忆。同一组密钥也可访问提供六种记忆工具的 MCP 端点(POST /mcp,Streamable HTTP);它同时支持当前无状态协议修订版(2026-07-28,每次请求都会检查版本和标头),以及仍使用initialize的客户端(2025-03-26 至 2025-11-25)。每个密钥都有请求速率限制(默认每分钟 600 次,超出时返回 429 和 Retry-After),每个租户都有记忆配额(默认 100,000 条),两者均可按租户调整。使用情况(请求、写入、搜索)按空间和日期统计,用于计费;每项更改都会按 ID 写入审计日志,应用角色可以追加日志,但无法读取。为满足 GDPR 要求,应用可以导出某位终端用户自己的记忆和事实(GET /v1/subject/export),也可以删除该终端用户及其所有内容(DELETE /v1/subject);这两种操作都会记录审计日志,且不会创建终端用户。客户离开时,其数据可导出为 JSON 行(export-tenant),且只有在提供租户的准确名称时才会删除(delete-tenant)。向量在后台计算,每次轮流处理一个租户的一批数据,因此记忆可立即通过关键词找到,稍后也可通过含义找到。对于较大的范围(5,000 个或更多向量),系统会通过维度与模型一致的 pgvector HNSW 索引(384、768 或 1024)查找最近邻,并使用迭代扫描,避免租户筛选导致结果为空。凭证使用租户专属密钥加密,该密钥再由MEMORYPILOT_MASTER_KEY封装(信封加密);读取和导出操作只会返回屏蔽后的标签。Docker 镜像(Dockerfile、docker compose up --build)内置 jina 嵌入模型,并在端口 8080 上提供服务。REST 客户端位于sdks/(TypeScript、Python、Dart;尚未发布)。MCP 客户端(claude.ai、ChatGPT)通过 OAuth 2.1 连接:PKCE S256、动态注册;终端用户在/oauth/authorize粘贴 API 密钥后,会获得一个mpt_令牌。将MEMORYPILOT_PUBLIC_URL设置为公开来源地址。SvelteKit 控制台(console/,通过/console提供服务)使用 API 密钥登录。有关如何接入 Claude、ChatGPT、iPhone、Slate、LightFrame 和 Docix,请参阅integrations/。不使用大模型的服务端基准测试见scripts/bench-server.sh。其管理命令可创建租户、空间和密钥(memorypilot-server help)。scripts/test-postgres.sh会针对本地 pgvector 容器运行其测试。 - 不弹出 Keychain 提示:服务仅在需要处理凭证时才会读取密码库密钥,并在后台线程中执行(提示不再会冻结所有请求)。macOS 发行版已签名并通过公证,Homebrew 会在 Apple Silicon 上安装它,
install.sh会检查校验和及签名团队。 - 密码库密钥安全与恢复:如果 Keychain 读取被拒绝,就不再创建新密钥(仅在条目缺失时才会创建)。
--restore-vault-key会在确认密钥可用于解封所有已加密凭证后,从 stdin 恢复读取的密钥;--reseal-recovered [--apply]会使用当前密钥重新加密已恢复为明文的凭证(JSON 从 stdin 传入),逐一与存储的标签核对,要么全部成功,要么全部失败。
v4.10 新增内容
- 自动隐藏过时记忆:如果较新的记忆针对旧记忆表示“用 X 代替 Y”,或记录同一事物的较新状态,旧记忆会被标记为
superseded(仍会保留,可通过 ID 读取,并可用unsupersede撤销),且不再出现在回忆或搜索结果中。 - 更好的回忆效果:与当前任务匹配的记忆会优先显示,并始终通过交叉编码器重新排序。回忆黄金集:top-1 从 73% 提升到 82%,top-5 从 91% 提升到 100%,跨项目泄漏从 9% 降至 0%。
- 启动时修复索引(
repair_index),并可使用MemoryPilot --seal-backup FILE...加密旧备份中的凭据。
v4.9 新增内容
- 回忆时隔离项目:只有当其他项目的记忆提及当前项目时,才会显示这些记忆(跨项目泄漏从 55% 降至 18%,命中率不变)。
- 精简工具列表:17 个核心工具(每次对话的架构约为 13 KB,而非约 24 KB);其他功能通过
memory_admin提供。MEMORYPILOT_TOOLS=full可恢复完整列表。 - 静态加密凭据:使用 XChaCha20-Poly1305 加密,密钥存储在 macOS Keychain 中(密钥文件存放在其他位置),通过 HTTP 时会脱敏(自「机密即指针」变更后,在所有场景中都会脱敏,详见 Unreleased)。
archive_transcripts:旧的原始转录文件移至~/.MemoryPilot/archive/*.jsonl,并从实时索引中移除。find_conflicts:报告同一项目中彼此矛盾的记忆。rate_skill:对已学习技能的使用情况提供反馈;可靠的技能排名靠前,表现不佳的技能排名靠后。- 远程访问:
--http现在需要令牌(~/.MemoryPilot/http.token),可通过Authorization: Bearer或/mcp/<token>传入。scripts/remote-access.sh会设置 LaunchAgent 和 Cloudflare 隧道,让 claude.ai、iPhone 应用或另一台 PC 使用同一份记忆。
安装
Homebrew(macOS / Linux)
brew install Soflutionltd/memorypilot/memorypilot
就这么简单。在 Apple Silicon 上,Homebrew 会安装已签名并经过公证的发布版二进制文件(从首个签名版本开始);Intel Mac 和 Linux 则通过 cargo 从源码构建(Homebrew 会自动安装 Rust)。安装后,请在克隆的仓库中运行 ./install.sh,或按照下方的手动 MCP 配置说明操作。
为什么 macOS 上签名很重要。 MemoryPilot 中存储的凭据使用保存在 Keychain 中的密钥加密。只有由创建该密钥的团队签名的二进制文件,macOS 才允许其在不询问的情况下读取密钥。签名版发布文件会在更新期间保留该身份,因此不会弹出提示;从源码构建的二进制文件(
cargo install、Intel 上的 Homebrew)每次构建都会有新的身份,macOS 会在每次更新后询问你的 Keychain 密码。如果没有存储凭据,就不会读取 Keychain。
一行命令 — 自动配置机器上的每个 IDE
curl -fsSL https://raw.githubusercontent.com/Soflutionltd/MemoryPilot/main/install.sh | bash
此操作会:
- 检测你的平台(macOS arm64 / x64、Linux x64 / arm64)。
- 从最新的 GitHub Release获取预构建二进制文件,并检查其
.sha256。 - 在 macOS 上检查签名:拒绝由其他团队签名的二进制文件,并在文件未签名时发出警告。
- 安装到
~/.local/bin/MemoryPilot,并在 macOS 上清除 Gatekeeper 属性。 - 一次性自动配置检测到的所有受支持 IDE / Agent — Cursor、Claude Desktop、Claude Code、Codex CLI、Gemini CLI、Windsurf、VS Code、OpenCode、Cline、Roo Code。
如果你的平台没有可用的预构建二进制文件,则会自动改用 cargo build --release --features http 构建(需要 Rust)。
其他安装方式
# Via Cargo, pinned to a release tag — works anywhere Rust runs
# (unsigned on macOS: Keychain prompt after each update if you store credentials):
cargo install --git https://github.com/Soflutionltd/MemoryPilot --tag v4.10.0 --bin MemoryPilot

# Local clone + auto-config (same installer, run from inside the repo):
git clone https://github.com/Soflutionltd/MemoryPilot.git && cd MemoryPilot && ./install.sh
安装程序具有幂等性:可随时重新运行以更新配置,且不会影响其他配置。
预构建二进制文件
每个版本都会附带适用于三个主流目标平台的预构建二进制文件。Linux 构建在每个 v*.*.* 标签上通过 发布 CI 工作流生成;macOS 构建由 Soflution 的 Developer ID 签名,并经 Apple 公证(scripts/release-macos.sh):
| 平台 | 目标三元组 | 归档文件 |
|---|---|---|
| macOS Apple Silicon | aarch64-apple-darwin | MemoryPilot-aarch64-apple-darwin.tar.gz |
| Linux x86_64 | x86_64-unknown-linux-gnu | MemoryPilot-x86_64-unknown-linux-gnu.tar.gz |
| Linux arm64 | aarch64-unknown-linux-gnu | MemoryPilot-aarch64-unknown-linux-gnu.tar.gz |
每个归档文件都附带一个 .sha256 文件,用于校验。请从发布页面获取。
Intel Mac(
x86_64-apple-darwin):没有预构建二进制文件——fastembed使用的ort/ ONNX Runtime crate 不会发布适用于此目标平台的预构建文件。请使用brew install Soflutionltd/memorypilot/memorypilot(从源代码构建)或cargo install --git ...。Apple Silicon Mac(M1 及更新机型)均提供预构建二进制文件。
支持的 IDE / Agent(由 ./install.sh 自动配置):
| Agent | 配置文件 / 命令 | 自动配置 |
|---|---|---|
| Cursor | ~/.cursor/mcp.json | ✓(stdio) |
| VS Code | ~/.vscode/mcp.json | ✓(stdio) |
| Claude Desktop | ~/Library/Application Support/Claude/claude_desktop_config.json | ✓(stdio) |
| Claude Code | claude mcp add | ✓(CLI) |
| Codex CLI | codex mcp add | ✓(CLI) |
| Gemini CLI | ~/.gemini/settings.json | ✓(stdio) |
| Windsurf | ~/.codeium/windsurf/mcp_config.json | ✓(stdio) |
| OpenCode | ~/.config/opencode/opencode.json | ✓(stdio) |
| Cline(VS Code) | ~/Library/Application Support/Code/User/globalStorage/saoudrizwan.claude-dev/settings/cline_mcp_settings.json | ✓(stdio) |
| Roo Code(VS Code) | ~/Library/Application Support/Code/User/globalStorage/rooveterinaryinc.roo-cline/settings/cline_mcp_settings.json | ✓(stdio) |
| ChatGPT Desktop | Settings → Apps → Create | 通过 HTTP(见下文) |
其他兼容 MCP 的客户端(使用相同的 stdio 二进制文件,需手动配置):
| Agent | 说明 |
|---|---|
| Goose | 在 ~/.config/goose/config.yaml 下配置 YAML——在 extensions: 下添加 MemoryPilot,并设置 type: stdio、cmd: ~/.local/bin/MemoryPilot |
| Kilo Code | 在 Kilo VS Code 扩展的存储路径下使用相同的 cline_mcp_settings.json 格式 |
| Continue.dev | ~/.continue/config.json——添加到 mcpServers |
| Zed | Settings → Assistant → Context Servers → 添加 stdio 命令 |
| Aider | 不原生支持 MCP;请使用 REST API(见 HTTP API 章节) |
该脚本具有幂等性——再次运行即可更新,且不会破坏现有 MCP 配置。
ChatGPT Desktop
ChatGPT 需要远程 MCP 端点。启动 HTTP 服务,然后将其添加为自定义连接器:
MemoryPilot --http 7437
在 ChatGPT 中:Settings → Apps → Create → URL:http://localhost:7437/mcp
手动安装
git clone https://github.com/Soflutionltd/MemoryPilot.git
cd MemoryPilot
cargo build --release --features http
cp target/release/MemoryPilot ~/.local/bin/
chmod +x ~/.local/bin/MemoryPilot
xattr -cr ~/.local/bin/MemoryPilot  # macOS only
然后手动将 MemoryPilot 添加到 IDE 的 MCP 配置中(文件路径见上表)。
工作原理
就这么简单。 MemoryPilot 会在启动时自动将动态系统提示词注入 IDE。AI 会在后台主动调用 add_memory,存储架构决策、API 密钥和错误修复,无需手动操作。所有已配置的 IDE 共用同一个记忆数据库。
对于 ChatGPT 或任何需要 HTTP 的 MCP 客户端:运行 MemoryPilot --http,即可在 /mcp 暴露 Streamable HTTP 端点。
也可通过 McpHub 使用 SSE 传输,并与其他 MCP 服务配合使用。
首次运行
# If upgrading from v1 (JSON files):
MemoryPilot --migrate

# Compute embeddings for existing memories:
MemoryPilot --backfill

# Force re-embed all (skips unchanged via content hash):
MemoryPilot --backfill-force
MCP 工具(30)
核心
| 工具 | 描述 |
|---|---|
recall | 从这里开始。一次性加载所有上下文:项目记忆、限定范围的线程/窗口记忆、偏好、关键事实、模式、决策、全局提示词。支持 mode = safe/default/full,并可通过 compact = true 进行 AAAK 压缩。 |
get_project_brain | 即时生成项目摘要(<1500 tokens):技术栈、架构、缺陷、近期变更、组件、团队成员。支持 compact = true。 |
search_memory | 混合使用 BM25 + jina RRF 进行搜索,并根据重要性、图谱链接和文件监视器上下文提升结果。采用批量三重评分。 |
get_file_context | 获取与工作目录中最近修改的文件相关的记忆。 |
记忆 CRUD
| 工具 | 描述 |
|---|---|
add_memory | 存储记忆并延迟生成嵌入,自动去重(精确哈希 + Jaccard 85%)、自动提取实体、自动建立图谱链接、自动分类(根据内容推断类型、重要性和 TTL)。 |
add_memories | 在一次调用中批量添加多条记忆,并逐项去重。 |
add_transcript | 将长篇转录存储为分块归档,并自动提炼结构化记忆(decision、preference、todo、bug、milestone、problem、note)。 |
ingest_session | 将本地 Claude/Cursor/会话转录导入同一个 MemoryPilot MCP。默认设置 distill_only=true,因此只会索引高价值记忆。 |
get_memory | 按 ID 获取记忆。 |
update_memory | 更新内容、类型、标签、重要性和 TTL。如果内容未变(通过哈希检查),则跳过重新生成嵌入。 |
delete_memory | 按 ID 删除记忆(同时删除关联实体和链接)。 |
list_memories | 按项目/类型筛选并分页列出记忆。 |
Agent 钩子(自动记忆,无需 Agent 费力)
MemoryPilot --install-hooks
会在找到的每个 Agent 中安装两个钩子(保留现有设置和钩子,并写入 .bak 备份文件):
| Agent | 文件 | 会话开始输出 |
|---|---|---|
| Cursor | ~/.cursor/hooks.json | additional_context |
| Claude Code | ~/.claude/settings.json | hookSpecificOutput.additionalContext |
| Codex | ~/.codex/hooks.json | hookSpecificOutput.additionalContext |
- 会话开始时运行
MemoryPilot --hook session-start --agent <agent>,并注入已打开项目的精简回忆。 - 停止时运行
MemoryPilot --hook stop --agent <agent>,立即返回{},并在独立进程中仅提炼自上一个轮次以来新增的转录行。对于用户消息,只保留用户实际输入的内容(Cursor 的<user_query>,跳过 Claude Code 的元信息行);过滤掉 Agent 的叙述(“正在检查……”“让我……”“Je vais……”),并在存储前编辑明显的秘密信息(API 密钥、JWT、IBAN)。
状态文件:~/.MemoryPilot/cursor-hooks-state.json。日志:~/.MemoryPilot/cursor-hooks.log。设置 MEMORYPILOT_DB=/path/copy.db 可使用副本进行测试。
知识图谱
| 工具 | 描述 |
|---|---|
kg_add | 添加事实三元组(主体 → 谓词 → 对象),可选设置有效期和置信度。 |
kg_invalidate | 将三元组标记为已过期(设置 valid_to),同时保留历史记录。 |
kg_query | 查询与某个实体相关的所有三元组,并支持按时间筛选和控制方向。 |
kg_timeline | 按时间顺序列出涉及某个实体的所有三元组。 |
kg_stats | 汇总统计信息:三元组总数、有效数、已过期数、唯一主体/对象数。 |
项目与配置
| 工具 | 描述 |
|---|---|
get_project_context | 获取包含偏好和模式的完整项目上下文。 |
register_project | 使用文件系统路径注册项目,以便自动检测。 |
list_projects | 列出项目及其记忆数量。 |
get_stats | 数据库统计信息:总数、按类型统计、按项目统计、数据库大小和卫生状况指标。 |
get_global_prompt | 自动从 ~/.MemoryPilot/ 或项目根目录发现 GLOBAL_PROMPT.md。 |
export_memories | 导出为 JSON 或 Markdown,并附带重要性星级。 |
set_config | 设置配置值(例如 global_prompt_path)。 |
维护
| 工具 | 描述 |
|---|---|
run_gc | 垃圾回收:合并旧记忆、清理孤立项并执行 vacuum。支持 dry_run。 |
compact_memories | 将旧的低重要性记忆压缩为精简摘要(约 100-200 个令牌)。凭据和架构信息永不压缩。 |
cleanup_expired | 移除已过期的 TTL 记忆(带防抖机制,每 60 秒最多运行一次)。 |
pin_memory | 固定关键记忆,使其始终包含在召回结果中,且永不被垃圾回收。 |
unpin_memory | 取消固定先前固定的记忆,使其重新符合垃圾回收条件。 |
find_related | 通过知识图谱遍历查找与给定 ID 相关的所有记忆(深度 1-3)。 |
bulk_delete | 按类型、项目、标签、时间或重要性删除记忆。绝不删除已固定的记忆。 |
get_memory_health | 健康报告:按类型/项目/重要性的分布、过时数量、孤立项、压缩潜力和数据库大小。 |
dedupe_report | 使用 Jaccard 相似度查找潜在重复项,供人工审核。 |
consolidate_memories | 将近似重复的临时记忆(嵌入向量余弦相似度 ≥ 阈值、同一项目,且不是决策/凭据/已固定记忆)合并到其中最新的一条记忆中,并合并标签、重要性、访问次数和图谱链接。默认仅试运行;设置 apply: true 执行;也会每天自动运行一次。 |
analyze_corpus | 检查文本但不写入记忆:来源、平台、Agent/角色设定以及可靠主题。 |
benchmark_recall | 使用黄金场景评测召回质量。 |
benchmark_search | 搜索质量评测:R@5、R@10、NDCG@10、聚类一致性和延迟。 |
migrate_v1 | 从 v1 JSON 文件导入。 |
记忆类型
fact · preference · decision · pattern · snippet · bug · credential · todo · note · milestone · architecture · problem · transcript_chunk
每条记忆都包含重要性(1-5)、可选 TTL、标签、项目范围、内容哈希,以及自动生成的嵌入向量和实体链接。
CLI
MemoryPilot                          # Start MCP stdio server
MemoryPilot --backfill               # Compute missing embeddings
MemoryPilot --backfill-force         # Re-embed all (skips unchanged via hash)
MemoryPilot --benchmark-recall       # Run recall quality benchmark
MemoryPilot --benchmark-search       # Search quality: R@5, R@10, NDCG@10, cluster coherence
MemoryPilot --benchmark-fr           # French/multilingual deterministic benchmark (109 queries, ±1pp variance)
MemoryPilot --benchmark-longmemeval  # LongMemEval-S benchmark, supports --limit N and --min-r5 PCT
MemoryPilot --benchmark-concurrency  # Multi-client concurrency bench (--clients N --queries-per-client N)
MemoryPilot --benchmark-latency      # open_at startup + search latency
MemoryPilot --http 7437              # Start HTTP REST server (requires --features http)
MemoryPilot --migrate                # Import v1 JSON data
MemoryPilot --version                # Show version
MemoryPilot --help                   # Show help
调整环境变量
| 变量 | 默认值 | 效果 |
|---|---|---|
MEMORYPILOT_CROSS_RERANK | adaptive | 设置为 1/always 可在每次查询时强制重排,设置为 0/off 可禁用。自适应重排会在较难或非英语查询时触发。 |
MEMORYPILOT_CROSS_RERANK_TOP_K | 12 | 交叉编码器重新评分的候选项数量。 |
MEMORYPILOT_CROSS_RERANK_WEIGHT | 0.45 | 融合时交叉编码器评分相对于 RRF 评分的权重。测试范围为 0.20-0.85;在 --benchmark-fr 上,0.45 是最佳运行点,在 LongMemEval 上的 R@5 与最优值相差不超过 0.2 个百分点。 |
MEMORYPILOT_RERANK_POOL_SIZE | 1 | 保持热运行的交叉编码器 ONNX 会话数量。只有在高并发负载下,2 才有帮助;每个额外的 mmarco 会话会占用约 120 MB。 |
MEMORYPILOT_EMBED_POOL_SIZE | 1 | 池中的嵌入 ONNX 会话数量(旧版 fastembed 模型使用 4,或在 1024 维时使用 2)。增加第二个 jina 会话会占用约 250 MB,只有在高并发写入时才有收益。 |
MEMORYPILOT_EMBED_THREADS | min(4, cores) | 嵌入器的 ONNX 算子内线程数。MEMORYPILOT_RERANK_THREADS(默认值为 min(2, cores))对交叉编码器执行相同设置。 |
MEMORYPILOT_RERANKER_MODEL | mmarco | mmarco-mMiniLMv2-L12-H384-v1 int8(Apache-2.0,驻留内存约 120 MB)。替代模型以相同方式提供(int8,内存映射):jina-v2(jina-reranker-v2-base-multilingual,280 MB,CC-BY-NC)和 gte-multilingual(gte-multilingual-reranker-base,341 MB,Apache-2.0)——二者在 --benchmark-fr 上的表现都更差(修复 v4.5 前的 MRR 为 63.5% / 62.1%,而基准为 65.3%),且延迟是两倍,因此不是默认选项。旧版 fp32 fastembed 模型:jina-v2-multilingual-fp32(1.1 GB)、bge-v2-m3、bge-base、jina-v1。 |
MEMORYPILOT_MODEL_IDLE_SECS | 600 | 空闲超过此时长后,嵌入器和重排器会话将被释放以节省内存(约 250 MB)。设置为 0 可使其常驻内存(用于基准测试)。 |
MEMORYPILOT_CONSOLIDATE | on | 每日基于嵌入对近重复的临时记忆进行整合(余弦相似度 ≥ 0.95 且词语重叠率 ≥ 0.6、同一项目,保留最新记忆),随后执行替代处理(参见 v4.6)。设置为 off 可禁用;consolidate_memories 可按需运行整合。 |
MEMORYPILOT_MMR / MEMORYPILOT_MMR_LAMBDA | on / 0.4 | 对最终候选项进行 MMR 多样性处理。0 可禁用;λ = 1.0 表示纯相关性,0.0 表示纯多样性。MEMORYPILOT_MMR_FLOOR(0.55)是判定两个候选项不冗余的余弦相似度下限。 |
MEMORYPILOT_TEMPORAL | on | 查询时提升或降低日期窗口内结果的权重。0 可禁用(摄取时仍会提取日期实体)。 |
MEMORYPILOT_ABSTAIN_COSINE / MEMORYPILOT_TRUST_CROSS | 0.35 / 1.0 | 低于余弦相似度下限时,搜索会报告 confidence.abstain = true,除非首位命中的交叉编码器 logit 达到信任阈值。 |
MEMORYPILOT_READER_NULL_MARGIN | 0 | 抽取式阅读器:片段 logit 必须比模型的无答案 logit 高出此数值。负值会让模型更常作答(−3 → 100 次中回答 92 次;在 LongMemEval-S@100 上仍能识别出 7 次弃答中的 3 次)。 |
MEMORYPILOT_EMBED_MODEL | jina | jina-embeddings-v5-text-nano-retrieval int8(768 维)。jina-q4 = 4 位变体(下载 140 MB,查询速度约快 5 倍;FR 上 R@5 降低 1 个百分点 / MRR 降低 3 个百分点)。通过 fastembed 提供的 Apache-2.0 替代模型:e5-small(384 维)、e5-base、e5-large、bge-m3(1024 维)。数据库会记录生成其向量的模型;更改模型会删除这些向量,并在下次启动时于后台重新嵌入所有内容(与此同时 BM25 仍可提供查询结果)。 |
HTTP API
使用 --features http 构建时,MemoryPilot 会提供多线程 REST API(4 个工作线程,每个线程都有自己的数据库连接):
# Health check
curl http://localhost:7437/health

# Call any MCP tool
curl -X POST http://localhost:7437/tools/call \
  -H 'Content-Type: application/json' \
  -d '{"name": "search_memory", "arguments": {"query": "auth setup", "limit": 5}}'
架构
src/main.rs        — CLI + MCP stdio server + file watcher init + HTTP server init + benchmark runners
src/code_chunker.rs — Tree-sitter code-aware chunking for Rust/Python/TS/TSX/JS/Go/Java/Kotlin/Swift + Svelte scripts
src/db.rs          — SQLite facade: hybrid search, CRUD, KG, GC, brain, recall, lazy embed, connection pool, ANN warm-up
src/db/benchmark.rs — Internal recall/search quality benchmark helpers
src/db/benchmark_fr.rs — French/multilingual deterministic benchmark (109 queries, ±1pp variance)
src/db/benchmark_longmemeval.rs — LongMemEval-S benchmark runner + regression guard support
src/db/transcript.rs — Transcript/session ingestion and local-only distillation
src/tools.rs       — 41 MCP tool definitions + handlers
src/protocol.rs    — JSON-RPC types
src/embedding.rs   — jina-embeddings-v5 via ONNX Runtime (fastembed for legacy models), EmbedPool, two-tier query cache
src/tokenizer.rs   — lean byte-level BPE (tiktoken ranks) and Unigram tokenizers, ~65 MB instead of ~535 MB with the `tokenizers` crate
src/onnx_external.rs — one-shot rewrite of embedded ONNX weights into a memory-mapped sidecar (ORT 1.28 keeps 3 copies otherwise)
src/pool.rs        — lazily-built, idle-evicting pool shared by the embedder and reranker sessions
src/db/consolidate.rs — embedding-based near-duplicate consolidation (daily + `consolidate_memories`)
src/reranking.rs   — Cross-encoder rerank (jina-v2-multilingual), RerankPool, adaptive trigger, confidence gate
src/ann.rs         — Persistent on-disk HNSW (usearch) with synchronous warm-up via `wait_for_ann_warm`
src/fts.rs         — FTS5 query variants (prefix, phrase, NEAR) + Snowball stemming
src/graph.rs       — Entity extraction (tech, files, components, people) + relation inference + graph traversal
src/gc.rs          — GC scoring, heuristic memory merging, stopwords
src/working_memory.rs — In-process scoped scratchpad memory for current MCP sessions
src/watcher.rs     — File system watcher + auto-linter with persistent DB connection
src/http.rs        — Optional multi-threaded HTTP REST server (feature-gated)
数据库架构
memories           — id, content, kind, project, tags, importance, embedding (BLOB),
                     content_hash, expires_at, last_accessed_at, access_count, metadata
memories_fts       — FTS5 virtual table (content, tags, kind, project)
memory_entities    — memory_id, entity_kind, entity_value, valid_from, valid_to
memory_links       — source_id, target_id, relation_type, valid_from, valid_to, confidence
knowledge_triples  — id, subject, predicate, object, valid_from, valid_to, confidence, source_memory_id
projects           — name, path, description
config             — key/value store
性能
| 指标 | 数值 |
|---|---|
| 二进制文件大小 | 35 MB |
启动(open_at) | 1-2 ms(ANN 预热在后台运行) |
启动(open_at_warm) | 在 10 k 条记忆上为 50-200 ms(ANN 同步加载,确保从第 1 次查询开始即可进行确定性搜索) |
| 默认快速搜索(BM25 + RRF) | 在 LongMemEval-S 上平均约 28 ms |
| 自适应交叉编码器搜索 | 在 --benchmark-fr 上平均约 210 ms(R@5 为 99.1%,MRR 为 97.4%;v4.4 为 230 ms / R@5 为 70.6% / MRR 为 65%,v4.3 为 415 ms / R@5 为 60% / MRR 为 57%) |
| 并发 p95(4 个客户端 × 20 次查询,500 条记忆,自适应) | 229 ms |
add_memory 延迟 | <1 ms(延迟嵌入) |
| 嵌入质量 | Transformer 768 维(jina-embeddings-v5-text-nano-retrieval int8,支持 100+ 种语言,8k 上下文) |
| 回填(1000 条记忆) | 在后台约 2 分钟(切换模型并重新嵌入;运行期间 recall 仍可交互,约 1 s) |
| RAM(两个模型均已加载,稳定状态) | 新数据库上约 370 MB,ANN 索引中有 2 000 条记忆时约 485 MB——几乎全部是内存映射的 int8 权重(247 MB jina + 118 MB mmarco),系统可在内存压力下回收(v4.3 空闲时约 3.5 GB / 峰值约 7 GB) |
| RAM(空闲) | 约 130 MB:无查询达到 MEMORYPILOT_MODEL_IDLE_SECS(默认 600 s)后,两个 ONNX 会话都会释放,并在下次查询时重建(一次约 0.8 s,仅重排器约 0.3 s) |
RAM(--benchmark-fr,峰值) | 364 MB(之前为 7.05 GB) |
| 读取并发 | 每个 Database 句柄使用 16 个连接池连接 |
| 运行时依赖 | 无(已捆绑 ONNX) |
优化
- 惰性嵌入:
add_memory插入时将嵌入设为NULL,后台线程异步计算并更新 - 内容哈希(FNV-1a):
--backfill-force会跳过内容未发生变化的记忆 - 两级嵌入缓存:在 SQLite 写穿查询缓存(
*.query_cache.sqlite,软上限为 8 192 条,采用 LRU 淘汰)之上,使用 256 条目的进程内 LRU 缓存,让重复查询在当前会话内和重启后都能即时完成 - 读连接池(4 个连接):并发向量搜索不会阻塞写入
- WAL 模式:SQLite 预写式日志,支持并发读写
- 批量评分:通过单次查询获取知识三元组计数和链接加权,而非执行 N+1 次查询
- 防抖清理:过期记忆清理最多每 60 秒运行一次
- 预处理语句:图遍历只需准备一次 SQL,而非为每个节点分别准备
- 调优后的 RRF 融合:k=40,相较标准 k=60,能更清晰地区分 top-K 结果
- FTS5 精度回退:针对代码符号、错误和命名概念,同时运行前缀、精确短语和 NEAR 邻近查询
- 加权 FTS 字段:内容、标签、类别和项目分别使用 BM25 权重,使结构化元数据也能计入评分
- ACT-R 风格激活:频繁复用和最近访问的记忆在最终重排前获得少量认知激活加权
- int8 量化嵌入:存储的向量小 4 倍(388 字节,而非 1536 字节),召回率几乎没有损失;直接在数据块上执行快速、适合 SIMD 的点积,避免每次搜索时分配内存
- 本地 HNSW ANN 索引(
usearch):持久化的磁盘近似最近邻索引,在分离的线程中从 SQLite 异步预热(启动时不阻塞),并在回填、异步嵌入工作线程和删除操作时增量更新。提供vector_ann候选项,让大型记忆库在增长到数万条以上时仍能保持快速。 - 绕过 ANN 扫描:索引达到 5,000 条及以上时,SQL 向量扫描仅限于 ANN top-K 与 BM25 命中项的并集——将 O(N) 数据块加载转变为 O(K) 查找,同时不改变排序逻辑
- 代码感知分块:tree-sitter 按语义单元拆分 Rust/Python/TypeScript/TSX/JavaScript,并提取 Svelte
<script> - 精确术语覆盖加权:当查询中 80% 以上的术语出现在记忆内容中时,加权 +10%
- 组合式重排器:贪心子图选择,每个连接保守加权 +5%(上限 15%)
- 知识图谱查询扩展:检索后根据知识图谱相关术语提升评分(每个实体加权 +4%,上限 15%)
- 时间新近度:对最近 3 天的记忆温和加权 +5%,并在 30 天内逐渐衰减
- 重要性决胜规则:每个等级 ±3%——绝不覆盖相关性信号
- 自适应交叉编码器重排(通过 FastEmbed ONNX 使用 jina-v2-multilingual,默认开启):针对困难查询/非英语查询触发,以可调的 0.45 权重与 RRF 分数融合;对简单的英语查询则平稳回退到 BM25+RRF,以将延迟控制在 30 毫秒以内。N 个会话组成的池(
MEMORYPILOT_RERANK_POOL_SIZE)可承载并发负载。 - 置信度门控:如果 top-1 RRF 分数已比 top-3 高 ≥ 25%,则跳过重排(潜在路径;启用强制重排时生效)
- 自动压缩:当记忆数量 > 500 时自动触发 GC,每 5 分钟最多触发一次
- 记忆胶囊:将旧的低重要性记忆压缩为约 100-200 个 token 的摘要(节省 5-10 倍空间)
- 零样本自动分类:插入时通过基于模式的启发式规则分配类别、重要性和 TTL,无需大模型
快速本地开发
日常验证请使用 cargo check;它可以检查类型和借用错误,无需承担完整的链接开销。
make check          # cargo check
make check-http     # cargo check --features http
make test           # cargo test
make timings        # cargo build --timings
make check-cached   # RUSTC_WRAPPER=sccache cargo check
sccache 是可选的,但建议在频繁重建时使用:
make sccache-install
make build-cached
也提供 Cargo 别名:cargo dev、cargo check-http、cargo test-fast、cargo timings 和 cargo build-http。
发布验证和基准测试请使用 cargo build --release --features http。在 macOS 上,默认不会启用 mold 或 lld 等链接器替换方案;修改 .cargo/config.toml 前,请先使用 cargo build --timings 进行测量。
自行运行基准测试
MemoryPilot --benchmark-search --scenario-limit 30    # R@5, R@10, NDCG@10, cluster coherence, latency
MemoryPilot --benchmark-recall --scenario-limit 12    # top1/top5 hit rate, cross-project leak, credential safety
MemoryPilot --benchmark-longmemeval [PATH] [--limit N] [--min-r5 PCT] # LongMemEval-S with regression guard
LongMemEval 基准测试会下载 LongMemEval-S 数据集,并以轮次级粒度评估 470 个问题的检索质量。结果以 JSON 格式输出,并按类别细分。
默认情况下,交叉编码器以自适应模式运行(针对困难查询/非英语查询触发)。可显式强制启用或禁用:
MEMORYPILOT_CROSS_RERANK=off MemoryPilot --benchmark-longmemeval benchmarks/longmemeval_s_cleaned.json     # baseline, ~28ms/query, 98.7% R@5
MemoryPilot --benchmark-longmemeval benchmarks/longmemeval_s_cleaned.json                                 # adaptive (default), ~900ms/query, 99.1% R@5
MEMORYPILOT_CROSS_RERANK=1 MemoryPilot --benchmark-longmemeval benchmarks/longmemeval_s_cleaned.json      # force on every query, max latency
MEMORYPILOT_CROSS_RERANK_WEIGHT=0.70 MemoryPilot --benchmark-longmemeval benchmarks/longmemeval_s_cleaned.json  # bias more toward the cross-encoder score
MEMORYPILOT_RERANKER_MODEL=bge-v2-m3 MemoryPilot --benchmark-longmemeval benchmarks/longmemeval_s_cleaned.json  # swap the model
支持的模型快捷名称:jina-v2-multilingual(默认)、bge-v2-m3、bge-base 和 jina-v1。在 470 个可评估的 LongMemEval-S 问题上验证的完整运行结果:默认快速模式达到 98.7% R@5、95.1% NDCG@10、93.6% MRR,平均搜索延迟约为 28 ms;自适应模式达到 99.1% R@5、96.0% NDCG@10、94.9% MRR,平均搜索延迟约为 900 ms。确定性的法语基准测试(--benchmark-fr)是所有多语言变更的标准回归测试;多次运行的 R@5 波动范围不超过 ±1 个百分点。
存储
- 数据库:
~/.MemoryPilot/memory.db - 全局提示词:
~/.MemoryPilot/GLOBAL_PROMPT.md - 模型缓存:
~/.cache/fastembed/(采用 Hugging Face 目录布局,首次运行时下载;可通过FASTEMBED_CACHE_PATH覆盖)。外置 ONNX 权重存放在其中的memorypilot-external/目录下。
许可证
Soflution Source Available License — 可免费使用,但不可分叉或修改。详情请参阅 LICENSE。
由 SOFLUTION LTD 构建
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。