关于 amem
amem 是面向个人开发者的本地记忆工具,让编码 Agent 在不同会话间保留代码库事实、技能和任务。可搜索的记忆仅存于本机,并支持本地加密与备份,还能为支持的客户端写入专属使用说明。
主要功能
- 01在本地保存可搜索的代码库事实
- 02将编码 Agent 客户端接入记忆
- 03通过项目任务看板跟踪待办工作
- 04加密记忆并创建本地备份
- 05安排记忆清理
- 06生成客户端专属使用说明
适用场景
- 01在不同编码会话间复用代码库决策
- 02探索前查找相关文件和约束
- 03按项目整理 Agent 的后续工作
- 04通过加密和备份保护本地记忆
MCP 相关
amem 通过本地端点向 MCP 客户端提供记忆与任务能力,并可配置客户端绑定代码库。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
16收录的工具列表 · 更新于 1 天前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| query | string | 是 | |
| platform | string | 否 | |
| sessionId | string | 否 | |
| workspace | string | 否 | 命名工作区(不是 git 仓库) |
详细介绍
amem



只保留在本机上的个人 Agent 记忆。 支持 Claude Code、Cursor、Claude Desktop、Copilot、Codex、Gemini CLI、Windsurf、Continue、Aider 和 Zed。
npx @iamem/amem setup
网站 · 功能 · 为什么选择 amem · 工作原理
编码 Agent 会在会话之间遗忘信息。它们每次都要重新搜索同一棵目录树、重新学习相同的约束,还会耗费 Token 去重新发现那些你已经付出代价做出的决策。
amem 为 Cursor、Claude Code 和其他本地宿主提供一份私密、可搜索的记忆,记录关于你的代码仓库的持久事实——谁负责什么、哪些文件重要、上次出了什么问题——让下一次会话一开始就能掌握情况,而不是从零开始。
amem context "sync auth startup"
# Agent Memory Context

## Best Claims
### claim.sync_auth_mode_startup
Kind: `constraint`
Why: `keyword+8`, `fts+18.0`, `embed+6.3`, `kind:constraint`, `fresh`

The sync service checks auth mode during startup before enabling Drive sync.
Anchors: `src/background/sync-service.ts`
不会上传任何内容,也不会在你的产品 Git 历史中写入内容。记忆仅保存在你笔记本电脑的 ~/.amem/ 下。
amem 的存在理由
| 不使用 amem | 使用 amem |
|---|---|
| Agent 每次会话都会广泛探索 | Agent 先查询记忆,再核验相关文件 |
| 决策埋在聊天记录中 | 决策变成带有文件锚点的结构化声明 |
| 团队承受共享“AI 上下文”文档的压力 | 明确是个人使用——你的提示词和经验都保留在本地 |
扁平的 AGENTS.md 日渐过时 | 小型图谱:组件 → 流程 → 声明,通过提案更新 |
amem 不是共享的公司 Wiki,也不是云端 RAG 产品。它是一款本地工具,面向希望 Agent 记住自己工作的个人开发者。
隐私(不可妥协)
| 项目 | 位置 | 是否共享? |
|---|---|---|
| amem 工具(本仓库) | GitHub / npm | 是——可安装 |
| 你的记忆数据库 | ~/.amem/graph.db(锁定时为 .enc) | 否 |
| Cursor 项目规则 | 产品仓库中的 .cursor/rules/amem.mdc | 可安全提交——仅包含指导信息,不含记忆内容 |
| 你创建的导出文件 / 备份 | 你保存的位置 | 请保密——不要提交 |
保证:
~/.amem创建时的权限为0700- 本地 UI 仅绑定到
127.0.0.1 - 记忆永不离开本机——没有托管同步,也没有“与组织共享”模式
- 仅发送可选的匿名安装 ping(参见遥测);可随时选择退出
- Agent 会收到指示,只存储代码仓库事实,而非专有的提示策略
- 可选的 AES-256-GCM 锁定和本地加密备份——仍不会使用云服务
要求
- Node.js 20+(原生
better-sqlite3) - git(仓库身份使用远程 URL / 根目录路径)
安装工具
npx @iamem/amem setup   # Node 20+ — installs the `amem` CLI
# or
npm i -g @iamem/amem && amem setup
开发时从克隆的仓库安装:
git clone https://github.com/sslugic/amem.git
cd amem
npm install
npm link
amem setup
参见 docs/npm-release.md。CI 会运行 npm test 和 npm run pack:check。better-sqlite3 使用自己的预构建版本——在常见的 macOS/Linux 和 Node 20/22 环境下无需额外的原生构建步骤。
如果 npm install 在编译原生代码时失败,请安装 Xcode CLT(macOS)或 build-essential(Linux)后重试,或者使用与预构建版本矩阵匹配的 Node 20/22 官方二进制版本。
遥测
在执行 npm install / npx 时(CI 和测试环境除外),amem 可能会向 https://getamem.com/api/beacon/npm-install 发送一次匿名 POST 请求,其中包含:
- 软件包名称和版本
- Node.js 版本
- OS 平台和 CPU 架构
不会包含代码、路径、用户名、电子邮件地址、IP 地址或记忆内容。选择退出:
AMEM_TELEMETRY_DISABLED=1 npm i -g @iamem/amem
存储在 ~/.amem 中的记忆仍永远不会离开你的设备。
快速路径
# Cursor or Claude Code in a git repo
amem init --platform cursor    # or: claude

# Other hosts (thin installers, same local DB)
amem init --platform windsurf|continue|aider|zed|claude-desktop

# Any other MCP client — binds the repo and prints the endpoint to paste
amem init --platform codex|copilot|gemini|cline|roo|jetbrains|opencode|goose|…
amem platforms                  # every id amem accepts (aliases included)

# Cross-repo “how I work” prefs (blended into project context)
amem init --personal
# or: amem setup --personal
静态加密 + 本地备份
amem lock --passphrase '…'       # or AMEM_PASSPHRASE
amem unlock --passphrase '…'
amem backup --passphrase '…'     # ~/.amem/backups by default
amem backup schedule             # daily local timer (no cloud)
amem backup unschedule
锁定期间,在执行任何打开 DB 的命令前,请设置 AMEM_PASSPHRASE(或解锁)。
嵌入及工具包的其他部分
一切免费。没有等级之分,也没有任何功能被保留——本地嵌入、记忆整理及其计划任务、规则同步和证明数据包均已包含。
amem embed use ngram                     # local n-gram model, or `external` for your own command
amem embed reindex
amem restore --file ~/.amem/backups/amem-….db.enc
amem hygiene
amem rules sync
amem it-pack --out ~/.amem/it-pack
amem doctor --attest
嵌入器默认使用哈希模型(无需下载);ngram 和 external(stdin 文本 → JSON 向量)也在本地运行。仍然没有云端嵌入 API,也不会上传任何内容。
结账 + 电子邮件投递是一个独立的卖家流程(npm run shop),不会随 CLI 一同发布。它可以从另一个项目的 .env 中提取 Mailtrap 和 Stripe 名称并加入白名单——详见 shop/README.md。
教会每个客户端如何使用 amem
将主机连接到 MCP 端点,只能让它知道 amem 存在;这并不会告诉它在探索前检查任务板或查询记忆。现在,amem init 和 amem setup 会将说明写入主机实际读取的文件中,一个命令即可完成其余所有操作:
amem instructions                 # the client(s) bound to this repo
amem instructions --all           # every supported client
amem instructions --check         # CI-friendly: exits 1 if missing or stale
amem instructions --platform roo  # just one
所有主机的说明均由一个规范文本 (src/instructions.ts) 生成,因此不同客户端之间的指导不会出现偏差:
| 文件 | 客户端 |
|---|---|
.cursor/rules/amem.mdc | Cursor |
CLAUDE.md | Claude Code |
AGENTS.md | Codex、Grok、OpenCode、Crush、Amp、Qwen、Droid、OpenHands、Warp、Zed、Cody、Antigravity、Neovim、Claude Desktop、Devin、Jules |
GEMINI.md | Gemini CLI |
.github/copilot-instructions.md | GitHub Copilot |
.windsurf/rules/amem.md · .continue/rules/amem.md · .clinerules/amem.md · .roo/rules/amem.md · .kilocode/rules/amem.md · .augment/rules/amem.md · .kiro/steering/amem.md · .trae/rules/amem.md · .amazonq/rules/amem.md | Windsurf、Continue、Cline、Roo、Kilo、Augment、Kiro、Trae、Amazon Q |
.junie/guidelines.md · .goosehints · .aider.amem.md | Junie、Goose、Aider |
共享同一文件的主机只会被写入一次,因此 --all 会生成 17 个文件,而不是 30 个。共享文件(CLAUDE.md、AGENTS.md、.github/copilot-instructions.md)会添加一个带标记的代码块,并在原位替换——你在代码块周围写的内容会保留:
# My Project
Use pnpm, not npm.


…
Aider 不支持 MCP,因此会收到 CLI 命令,而不是工具名称。每个文件都仅提供指导,不包含任何记忆内容,可以安全地提交。绑定客户端的说明缺失或过时的时候,amem doctor 会提示这一点。
自动整理的记忆
如果不定期清理,记忆就会逐渐失效。amem 会按计划清理,而不是等到有人提出要求:
amem hygiene schedule # daily; amem doctor warns when it is not installed
每次运行都会先创建安全备份,然后按仓库执行以下操作:
| 信号 | 含义 | 操作 |
|---|---|---|
| 非事实 | 以断言形式存储的聊天填充语 | 删除(若占仓库内容超过 25%,则暂不删除——与语料库大部分内容相符的启发式规则,本身就是失效的规则) |
| 锚点失效 | 该断言指向的文件全部已不存在 | 衰减。标签式锚点和没有来源的工作区除外 |
| 无用 | 已证明 3 次或更多,但从未回答过问题 | 衰减 |
| 未使用 | 在该时间窗口内既未被返回,也未被触及 | 衰减 |
| 近似重复 | 内容相同,锚点有重叠 | 合并 |
只有存在明确的正面证据时,断言才会被淘汰。缺少证明绝不会对其不利——否则,发布此功能就会导致所有内容一次性衰减。固定的断言永不衰减。
可核验的节省
amem context 会记录它交接了哪些内容;Agent(或根据宿主的会话记录,由停止钩子)会记录它仍需打开哪些内容。随后,根据未打开文件的实际大小计算节省量:
saved = Σ(measured tokens of anchors returned but not opened) − packet_tokens
系统不会要求模型估算自身的价值;如果某个数据包没有避免任何操作,就会报告亏损。仪表板会显示 modelled,直到有 30 条事件经过验证,然后切换为 measured,并根据观测到的比率修正总量。
amem usage attest --opened "src/db.ts"   # or let the stop hook do it
amem usage recompute --scope all --apply # re-measure historical events
首次设置(推荐)
amem ui
这会在 Setup 标签页打开 http://127.0.0.1:7843。它会扫描你的主文件夹,查找 git 仓库(跳过 Library、node_modules、Downloads 等无关目录)。勾选你需要的仓库,选择客户端(Cursor、Claude Code、Windsurf、Continue、Aider、Zed 等),然后点击 Start tracking selected。每个所选项目都会绑定到 ~/.amem,并在有对应安装程序时安装。
如果你更喜欢桌面窗口而不是浏览器标签页(使用相同的本地主机服务,隐私不变):
# once per machine/checkout (downloads Electron — not included in npm i -g)
npm run app:setup

amem app
amem ui 始终打开浏览器;amem app 则打开 Electron。两者都只与 127.0.0.1 通信。如果 UI 服务已在运行,amem app 会连接到该服务。全局安装:从软件包目录(或克隆目录)运行 npm run app:setup,然后运行 amem app。
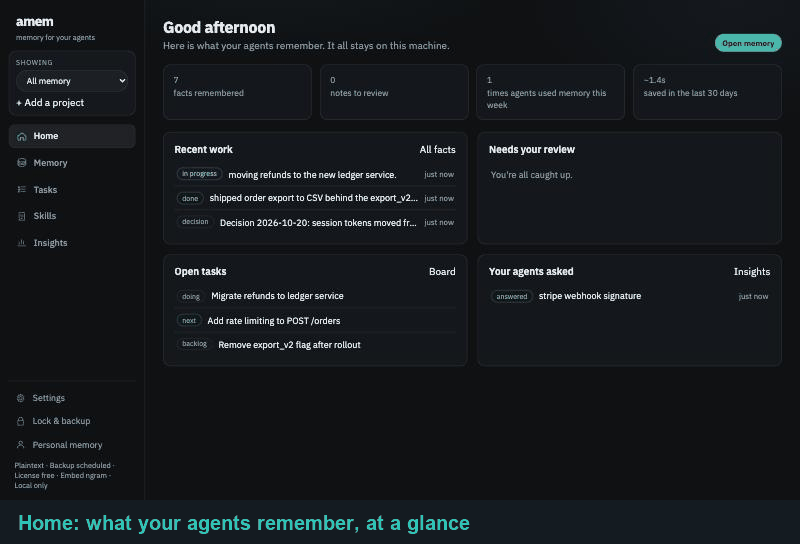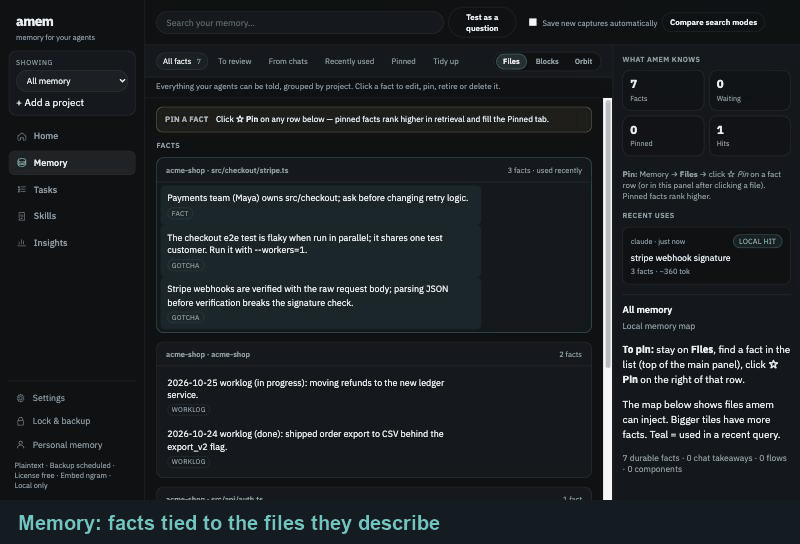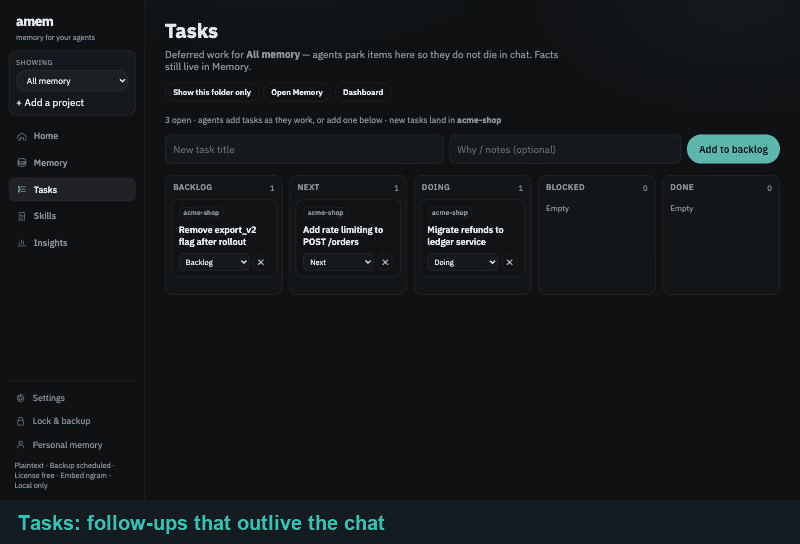
页眉包含 Personal 切换器(跨仓库偏好设置)和 Lock / backup 状态栏——显示锁定状态、上次备份时间和每日本地计划。Memory 页面也会显示相同的锁定/备份状态标签。Setup 标签页包含一份可复制的 remember contract,适用于任何 MCP 宿主(amem recipe)。
可选:勾选 Start amem ui when this computer logs in,以便电脑重启后重新启动本地主机服务:
amem service install    # macOS LaunchAgent, Linux systemd --user, or Windows Startup
amem service status
amem service uninstall
设置完成后的标签页:
- Setup — 扫描/选择仓库、平台、登录时自动启动、引导方案
- Memory — 按文件查看事实、经过评分的草稿(批准/替换旧内容/忽略/拒绝无用内容)、编辑/固定/删除、搜索、近期命中/未命中记录
- Tasks — 每个项目各自的看板,用于管理延后的 Agent 工作(Backlog → Next → Doing → Blocked → Done)。MCP:
amem_task_add/amem_task_update/amem_task_complete。未完成的任务会显示在amem_context中。持久事实使用 Memory;“以后再做”的事项使用 Tasks。 - Stats — 按大模型估算节省的 token 数,并支持导出为 JSON/markdown/PDF(仅为代理指标,并非账单)
仅启动服务(不打开浏览器):
amem ui --port 7843 --no-open
若要扫描其他文件夹(或只扫描部分文件夹),请将 AMEM_SCAN_ROOTS 设为以冒号分隔的目录列表。
命令行替代方案(无 UI)
cd ~/path/to/your-real-project
amem init --platform cursor    # or: --platform claude
amem doctor
amem status
若要让两个 Agent 共用同一份本地记忆,请在每个平台上各运行一次 init(或在 UI 中同时选择两个平台)。
日常使用流程
1. 探索前先查询
amem context "billing webhook retry"
也可以让 Agent 来处理——Cursor 会获得一条始终生效的项目规则;Claude 会获得钩子指导。两者都会安装以下技能:
amem-bootstrap— 初始化基础记忆amem-update-working-memory— 会话结束后保存长期有用的经验
钩子还会在会话开始/提交提示词时注入上下文、保存对话笔记、将会话结束草稿加入队列,并在上下文查询无结果后、Agent 随后引用真实文件时,将未命中→学习草稿加入队列。在记忆中批准草稿(或通过策略 auto_apply_kinds 允许低风险类型自动应用)。
会话开始时还会注入你最近的个人记忆(过去 7 天),这样新聊天就能接续上一次聊天。提及当前代码仓库的记忆会优先显示。使用类型 private(或锚点 private)保存的个人记忆绝不会出现在工作代码仓库的上下文中。描述仅为“Procedure for ”的自动生成技能,除非已使用过,否则不再建议;注入的文本也会在句子边界处缩短。Claude Code 通过 hookSpecificOutput.additionalContext 接收钩子上下文;Cursor 则通过 additional_context 接收。
停止检查点(可选启用)。 在 Claude Stop 钩子的命令中设置 AMEM_STOP_CHECKPOINT=1(AMEM_STOP_CHECKPOINT=1 amem hook),即可让 Claude 在停止前保存长期有用的上下文——仅当本轮做了更改(编辑、命令、写入类型的 MCP 工具),且这些工作完成后尚未向 amem 保存任何内容时才会执行。只读轮次以及已保存内容的轮次不会受到影响。
密钥过滤器。 记忆、捕获和技能写入会拦截密钥的值(明文密钥、令牌、密码、PEM 密钥、已知令牌格式),而不会拦截对密钥名称的提及,例如 SUMSUB_MOCK_WEBHOOK_SECRET,或类似 "$(gcloud secrets …)" 的引用。IT 策略 deny_claim_patterns 可添加更严格的规则。
2. 照常工作
将记忆视为一张地图,而不是事实来源。修改锚定文件前,先阅读这些文件。优先采用标记为最新的声明;对过时声明(锚定文件在声明之后发生过更改)进行核实。
3. 保存值得留存的内容
让 Agent 运行 amem-update-working-memory,批准记忆草稿,或自行应用提案:
amem propose validate /tmp/memory.json
amem propose diff /tmp/memory.json
amem propose apply /tmp/memory.json
4. 可选:一键安装 Agent
在产品代码仓库中,将 docs/agent-install-prompt.md 粘贴到 Cursor 或 Claude Code 中,然后让它为你运行设置流程。
存储的内容
记忆是 SQLite 中的一个小型本地图:
| 对象 | 含义 |
|---|---|
| 组件 | 子系统/模块(component.api) |
| 流程 | 工作的流转方式(flow.checkout) |
| 声明 | 带有文件锚点的长期事实(可以是 active 或 superseded;可选置顶) |
| 边 | 链接(声明 → 流程 → 组件);kind: "supersedes" 会将目标声明归档 |
| 草稿 | 等待在记忆中批准的待处理会话/未命中→学习提案 |
| 任务 | 项目看板上延后处理的工作(Backlog / Next / Doing / Blocked / Done)——不是长期事实 |
| 技能 | 可复用的多步骤流程,以 SKILL.md 文件形式存储(见下文) |
| 使用事件 | 每次 amem context 命中及其令牌估算值 |
声明是检索的基本单位。排序综合考虑以下因素:
- SQLite FTS5(Porter 词干提取)+ 关键词得分
- 设备端哈希嵌入(无需下载模型)
- 置顶加权、类型权重(
constraint/gotcha>session)、新鲜度 - 可选地将个人偏好声明融合到项目上下文中
每条注入的声明都包含一行 Why:。过时的声明(锚定文件在 updated_at 之后发生更改)会降低排序。
声明示例:
{
  "id": "claim.webhook_idempotency",
  "kind": "constraint",
  "text": "Stripe webhooks must be idempotent on event.id before mutating invoices.",
  "code_anchors": ["src/webhooks/stripe.ts"],
  "supersedes": ["claim.webhook_old_rule"]
}
supersedes(或 kind: "supersedes" 的边)会将较早的声明 ID 标记为已归档,使其不再参与检索。
Skills(程序性记忆)
Claims 回答什么是真实的。Skills 回答我们在这里如何做事——部署顺序、迁移流程、某人已经走过的调试路径。它们太长,不适合放进每个提示词中,因此会按需加载。
Skills 以 SKILL.md 文件的形式存放在 ~/.amem/skills/ 下,并在 SQLite 中建立索引以便排序:
~/.amem/skills/deploy-staging/SKILL.md
~/.amem/skills/deploy-staging/references/runbook.md
渐进式披露。 上下文数据包只包含名称和描述。Agent 确定某个流程适用后,会调用 amem_skill_view 获取正文,因此未使用的技能库几乎不消耗 Token。
学习循环。 amem 不附带模型,因此不会自行编写技能。会话结束时,它会查找难得的流程模式——列出的步骤或实际命令,以及它恢复过的错误或你给出的修正。当多个信号吻合时,它会排队提交一条建议,并在下一个上下文数据包中将其作为提示发送给你的 Agent。Agent 编写技能,由你审批。如果某项技能在一次最终仍遇到问题的会话中被加载,amem 会排队提交修订,而不是重复创建。
审核标准有意设得很高,每个会话最多只能排队提交一条建议。
amem skills list                # index of what is stored
amem skills show deploy-staging # full body
amem skills new deploy-staging --desc "Deploy staging and verify health"
amem skills import ./some-skill # bring in an agentskills.io skill
amem skills drafts              # pending suggestions and staged writes
amem skills approve <draft-id>
amem ui 中也有一个 Skills 标签页。
安全。 Skills 是 Agent 会遵循的指令,因此在写入前会扫描内容,检查凭据和提示词注入模式。三个策略键用于控制它们:
| 键 | 默认值 | 效果 |
|---|---|---|
skills_enabled | true | 控制存储、排序和注入的总开关 |
skill_write_approval | false | 暂存 Agent 写入内容供审核,而不是写入磁盘 |
skill_capture | true | 允许在会话结束时提出技能建议 |
如果 policy.toml 无法读取,则会强制启用 skill_write_approval。amem doctor --attest 会报告每项已安装技能的内容哈希,以便你对比告知 Agent 的操作指引。
目前备份只会复制数据库,不包含
~/.amem/skills/。在此功能实现之前,请将重要的 Skills 纳入版本控制。
Token 节省量(估算)
每次 amem context 都会记录一条使用事件。UI 的 Stats 标签页会按平台(cursor、claude 等)细分数据。
自动估算:
estimated_avoided = max(0, anchors×4000 + claims×200 − packet_tokens)
这只是探索过程得以避免的代理指标,并非你的 Cursor/Anthropic 账单。金额使用相同的 Token 代理指标,按每 100 万个输入 Token 3 美元计算(Sonnet 级别的输入)。Cursor 的包含用量和输出 Token 不按此方式计费,因此 $ 只能视为数量级估算。
节省时间是另一项代理指标:每个返回的文件锚点都按 Agent 无需进行的一次工具往返约 1.2 秒计算。会测量本地查询耗时(通过 localhost 上的 SQLite)。命中率统计的是 amem context 的关键字匹配,而不是 Cursor/模型 API 调用(这些调用仍会发生)。未命中表示没有存储的事实与查询匹配;仍可能注入最新事实作为较弱的回退内容,Agent 也仍会与模型交互。
Stats 还会显示月度预测值:根据最近 7 天的调用量(如果刚开始使用,则按实际天数),按 30 天换算。这仍是代理指标,而非账单。
如果你之后知道更准确的数值:
amem usage report --platform cursor --saved 12000
# or attach to a specific event:
amem usage report --event-id usage_… --saved 12000
LLM 客户端(不限于 Git 仓库)
amem 可以绑定命名工作区,即使它不是 Git 检出目录——可用于 Luna Client,或任何与 Cursor、Claude 或其他模型交互的工具。
amem init --workspace my-app
# seeds starter facts and runs a context check automatically
自行接入任何 LLM 客户端(HTTP 或 MCP)。使用 HTTP 时,请保持 amem ui 运行。客户端在每次调用模型之前:
const res = await fetch("http://127.0.0.1:7843/api/context", {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    workspace: "my-app",
    query: userMessage,
    platform: "app",
    sessionId,
  }),
});
const { markdown } = await res.json();
// prepend markdown to the prompt / tool result so the model skips a large retrieve
取得持久结果后:
await fetch("http://127.0.0.1:7843/api/remember", {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    workspace: "my-app",
    text: takeaway,
    kind: "session",
    anchors: ["my-app"],
  }),
});
MCP 配置(适用于任何 MCP 宿主):
保持 amem ui 运行(或运行 amem service install,使其在登录时启动)。GUI 应用通常无法在 PATH 中找到 amem,这会显示为“实时工具发现失败”/MCP error,而不是登录提示。建议优先使用 HTTP:
{
  "mcpServers": {
    "amem": {
      "url": "http://127.0.0.1:7843/mcp?workspace=my-app"
    }
  }
}
如果宿主能够启动二进制文件,也可以使用 Stdio。使用绝对路径输出配置:
amem mcp --print-config --workspace my-app
与 Git 仓库记忆共用同一个本地数据库。UI 切换器会将Git 仓库和工作区分组显示。可以随时更改工作区的显示名称——MCP slug(workspace=luna-ai)和已存储的声明仍绑定在同一个 ID 上。
amem rename "Luna Client" --workspace luna-ai
MCP 工具(Stdio 或 HTTP):
| 工具 | 使用时机 |
|---|---|
amem_context | 获取与当前问题相关的排序记忆包 |
amem_remember | 取得结果后存储持久事实 |
amem_recipe | 通用的先读取后写入约定(适用于任何 MCP 宿主) |
amem_skill_list | 低成本查看已存储流程的索引(仅名称和说明) |
amem_skill_view | 索引表明适用后,加载一项技能的正文 |
amem_skill_save | 存储刚刚整理出的多步骤流程 |
amem_repos | 查看受监控对象(Git 仓库和命名工作区) |
amem_stats | 查询时间、预估节省的 token/ms 和命中率 |
amem_graph | 查看为工作区或仓库存储的声明、组件和流程 |
amem_status | 查看绑定信息和计数;省略 workspace 可查看整台机器的概况 |
命令参考
amem setup [--personal] [--platform <host>]
amem init --platform <client>      # amem platforms lists every id
amem platforms [--json]
amem init --workspace <name> [--path <dir>] [--platform …]
amem init --personal
amem rename "<display name>" --workspace <slug>
amem status [--workspace <name>]
amem doctor [--attest] [--json]
amem context "<query>" [--workspace <name>] [--platform …]
amem remember "<text>" [--workspace <name>] [--kind …] [--anchor <path>]
amem recipe [--json]
amem skills list|show <name>|new <name> [--desc <text>]|rm <name>|sync|import <path>
amem skills drafts|approve <draft-id>|dismiss <draft-id>
amem mcp [--print-config] [--workspace <name>]
amem propose validate|diff|apply <file.json>
amem export [--out <file.json>]
amem wipe --yes
amem wipe --all --yes
amem lock|unlock --passphrase <secret>
amem backup [--out <dir>] [--passphrase <secret>] [--label <name>]
amem backup schedule [--out <dir>] [--hour <0-23>]
amem backup unschedule
amem session touch --platform cursor|claude [--session-id <id>]
amem hook
amem usage report --saved <n> [--platform …] [--event-id …]
amem usage export [--format json|md|pdf] [--days 30] [--scope current|all] [--out <file>]
amem license status|apply|activate|clear|issue|keys
amem embed status|use hash|use ngram|reindex
amem ui [--port 7843] [--no-open]
amem app [--port 7843]
amem service install|uninstall|status
| 命令 | 用途 |
|---|---|
setup | 一次性设置个人工作区,并可选择安装到宿主 |
init | 绑定 Git 仓库、命名工作区、个人偏好或宿主 |
rename | 更改工作区显示名称;MCP slug 和记忆仍保持绑定 |
context | 获取 Markdown 信息包;记录使用情况 |
remember | 存储一条本地事实 |
mcp | Stdio MCP 工具;UI 运行时可通过 http://127.0.0.1:7843/mcp 使用 HTTP MCP |
skills | 管理程序性记忆(list、show、new、import、drafts、approve) |
propose diff | 应用前预览声明、组件和流程的变更 |
propose apply | 在本地新增或更新结构化记忆 |
lock / unlock | 可选:对 graph.db 使用 AES-256-GCM 静态加密 |
backup | 本地快照(可选择加密);schedule 用于设置每日定时任务 |
ui | 在浏览器中使用设置向导、Memory 和 Stats(localhost) |
app | 在 Electron 窗口中使用同一 UI(只需运行一次 npm run app:setup) |
service | 登录项,使 amem ui 在重启后启动 |
doctor --attest | 为 IT 工单生成隐私/策略证明 |
export / wipe | 个人备份或删除(数据仍保留在本地) |
wipe --all --yes | 离职清理:清除所有仓库并移除 ~/.amem |
安装内容写入的位置
Cursor
| 项目 | 路径 |
|---|---|
| 技能 | ~/.cursor/skills/amem-* |
| 项目规则 | .cursor/rules/amem.mdc(位于产品仓库中) |
| Hooks | ~/.cursor/hooks.json |
如果技能或规则没有立即显示,请重新加载 Cursor。
Claude Code
| 项目 | 路径 |
|---|---|
| 技能 | ~/.claude/skills/amem-* |
| Hooks | ~/.claude/settings.json(SessionStart / UserPromptSubmit / Stop / 相关事件 → 完整的 amem hook) |
其他宿主
| 宿主 | amem 写入内容 |
|---|---|
| Windsurf | ~/.codeium/windsurf/mcp_config.json 中的 MCP 条目 |
| Continue | ~/.continue/config.json 中的 MCP 服务 |
| Aider | 仓库中的 .aider.amem.md 命令行提示 |
| Zed | settings.json 中的 context_servers / HTTP 提示 |
| Claude Desktop | claude_desktop_config.json 中的 stdio MCP 条目 |
amem platforms 中的所有其他客户端 — Codex、Copilot、Gemini CLI、Grok、Cline、
Roo、Kilo、Cody、Augment、JetBrains、Kiro、Trae、Antigravity、Neovim、OpenCode、
Goose、Crush、Amp、Qwen Code、Factory Droid、OpenHands、Amazon Q、Warp、Devin、
Jules — 均没有本地安装程序:amem init --platform <id> 会绑定仓库并打印 MCP 端点,供你粘贴(完整配置请运行 amem recipe)。
客户端 ID 会折叠别名,因此 claude-code、vscode、pycharm 和
chatgpt 会分别解析为 claude、copilot、jetbrains 和 codex,不会触发
policy.allowed_platforms。
安全与架构常见问题
amem 如何防止工具投毒和提示词注入?
不受约束、会盲目记录聊天记录的记忆工具,容易存储对话残留内容、恶意指令或遭污染的上下文。amem 通过多道防御关卡加以防护:
- 事实与噪声语法过滤(
isFactLike): 在对话句子、问题、聊天寒暄和用户提示词片段成为声明之前,系统会自动拒绝它们,即使其中提到了真实文件路径也不例外。 - 内置与自定义机密拒绝列表(
BUILTIN_DENY_CLAIM_PATTERNS): 内置正则表达式会丢弃密码、API 密钥、令牌和私钥。管理员可通过系统策略强制执行额外的正则拒绝模式。 - 质量与具体性评分(
scoreProposal): 系统根据锚点是否存在、持久性词汇(constraint、gotcha、must)以及具体程度为提案评分。低于拒绝阈值、内容单薄或评分较低的条目会被丢弃。 - 默认使用分阶段摄取队列(
ProposalDraft): 后台捕获和会话结束时的推断会作为提案存入 SQLite,等待用户在界面中审核。默认禁用自动应用(auto_apply_kinds = [])。 - 冲突与替代跟踪: 当新声明与现有事实共享锚点时,amem 会计算相似度并发出冲突警告,要求明确替代,而不是允许静默覆盖。
amem 如何防止上下文膨胀和跨项目记忆泄漏?
- 按仓库分区: 每条记忆声明、任务、组件和备注都以
repo_id为键(根据 Git 远程 URL / 工作区路径生成)。一个项目中的查询无法检索或泄漏其他仓库的记忆。 - 混合检索与严格限制:
amem_context不会倾倒整个图谱,而是结合 BM25 全文搜索、设备端嵌入、关键词匹配和时效性乘数进行排序,仅选取最相关的事实(默认限制:12 条)。 - 字符数硬上限: 自动注入的钩子内容严格限制在 2,400 个字符以内,以防止提示词膨胀和令牌耗尽攻击。
- 技能渐进式披露: 上下文包只会注入 Level-0 索引(技能名称和单行描述)。除非模型通过
amem_skill_view明确请求,否则不会注入完整的操作流程正文。
amem 如何处理代码变更,避免提供过时记忆?
每条声明都通过文件锚点(code_anchors)建立依据。生成上下文时,amem 会验证文件是否存在,并比较文件修改时间与声明创建时间:
- 如果锚定文件发生变更,该声明会被标记为过时,并在排序中降权。
- 上下文包会明确向 Agent 的提示词中注入警告:
"_X claim(s) marked stale — anchored files changed after the claim was written. Verify before trusting._"
amem 是否会暴露未经身份验证的网络服务或上传代码?
- **严格绑定到回环地址:**本地 HTTP UI / MCP 守护进程仅绑定到
127.0.0.1。硬编码的策略规则会阻止绑定到非回环地址。 - **零外部出站流量:**遥测已硬编码为关闭(
telemetry: false)。所有 SQLite 数据库(graph.db)、向量和日志都保存在~/.amem下,并采用0700本地文件系统权限。 - **可选的静态数据加密:**可以使用 AES-256-GCM 加密本地数据库(
amem lock --passphrase '...')。
开发 amem 本身
cd amem
npm install
npm run build
npm run test          # unit + integration + CLI e2e (node:test)
npm run smoke         # end-to-end CLI/API smoke
npm run test:all      # both
npm link
目录结构:
src/           CLI, SQLite, policy, attest, installers, localhost API
ui-static/     Setup / Memory / Stats UI
skills/        Agent skill markdown
templates/     Cursor rule + example enterprise policy
docs/          Agent install prompt + IT endpoint runbook + backlog
test/          Comprehensive node:test suite
scripts/       Smoke tests + MDM offboard helper
为测试覆盖默认内存目录:
AMEM_HOME=/tmp/amem-test amem status
企业端点(由 IT 管理)
amem 仍然是笔记本电脑上的个人记忆,而不是共享 wiki 或云端 RAG。
IT / DevEx 可以管理设备群:批准安装、策略、证明、离职处理。
| 控制项 | 机制 |
|---|---|
| 策略 | /etc/amem/policy.toml(系统级)覆盖 ~/.amem/policy.toml;或使用 AMEM_POLICY_PATH |
| 证明 | amem doctor --attest / --json(本地 UI 上也可通过 GET /api/attest 获取) |
| 敏感信息防护 | 内置拒绝模式 + 提议时应用策略 deny_claim_patterns |
| 导出锁定 | allow_export = false |
| 平台 / 仓库允许列表 | allowed_platforms、allowed_remote_hosts |
| 自动应用草稿 | auto_apply_kinds(为空 = 从不;仍仅在本地执行) |
| 离职处理 | amem wipe --all --yes 或 scripts/mdm-offboard.sh |
无法通过配置取消的硬性保证:
- 不会上传记忆遥测或声明 —
~/.amem始终保留在本地 - 仅发送可选的匿名 npm 安装 ping(选择退出:
AMEM_TELEMETRY_DISABLED=1) - UI 仅绑定到回环地址(
127.0.0.1) - 记忆保存在
~/.amem下(权限模式0700)
IT 快速入门
# 1) Pin / install amem on the endpoint (internal npm, pkg, or npm link)
# 2) Deploy policy (root-owned on managed machines)
sudo mkdir -p /etc/amem
sudo cp templates/policy.example.toml /etc/amem/policy.toml

# 3) Verify for security review
amem doctor --attest --json

# 4) On offboard / laptop return
amem wipe --all --yes
# or: scripts/mdm-offboard.sh
策略示例:templates/policy.example.toml
完整 IT 操作手册:docs/enterprise-endpoint.md
建议的推广步骤:小规模 DevEx 试点 → MDM 软件包 + 策略 → 如采购需要,则提供签名构建 / SBOM。共享组织记忆有意不在范围之内。
非目标
- 公司共享或同步记忆
- 云端托管的“团队大脑”
- 精确的服务提供商计费集成
- 云端 / 远程嵌入 API(仅使用本地 FTS5 + 设备端哈希嵌入)
- 将记忆内容写入产品 git 历史
后续设想(尚无排期):请参阅 docs/backlog.md。
许可证
MIT — 参阅 LICENSE。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。