关于 Sugra API MCP
Sugra API MCP 是面向 AI Agent 的数据服务连接器,通过一个 MCP 服务访问多个领域的 API,并在结果中提供来源与时效信息。
主要功能
- 01覆盖 36 个数据领域
- 02提供 1,600 多个数据端点
- 03结果包含来源和时效元数据
- 04本地目录支持搜索与描述
- 05提供 5 个 MCP 资源和 6 个工作流提示词
适用场景
- 01研究市场与宏观经济数据
- 02比较公司、行业与资产表现
- 03筛查制裁合规与实体身份
- 04汇总气候、海事和贸易信息
MCP 相关
作为 Sugra API 的 MCP 服务,向客户端提供数据查询工具、组合分析工具、资源和提示词。支持托管 Streamable HTTP 连接或本地 stdio 运行。
配置
远程服务无需本地安装。选择你使用的客户端,复制配置或使用一键安装。
https://app.sugra.ai/mcpclaude mcp add --transport http sugra-api https://app.sugra.ai/mcp{"mcpServers":{"sugra-api":{"type":"http","url":"https://app.sugra.ai/mcp"}}}在 Cursor 中打开{"servers":{"sugra-api":{"type":"http","url":"https://app.sugra.ai/mcp"}}}在 VS Code 中打开{"mcpServers":{"sugra-api":{"type":"http","url":"https://app.sugra.ai/mcp"}}}{"mcpServers":{"sugra-api":{"serverUrl":"https://app.sugra.ai/mcp"}}}命令在终端中运行;JSON 粘贴到对应客户端的 MCP 配置后重启。需要授权的服务会在首次连接时提示登录。
工具
11| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| dob | any | 否 | 个人的可选出生日期,格式为 YYYY-MM-DD。 |
| name | string | 是 | 要筛查的个人或组织名称(必填)。 |
| country | any | 否 | 可选的 ISO 3166-1 alpha-2 国家代码,用于缩小匹配范围。 |
| nationality | any | 否 | 可选的国籍,用于缩小匹配范围。 |
详细介绍
sugra-api-mcp


已发布于 Anthropic 的 Connectors Directory。可在网页端、桌面端和移动端的 Claude、Claude Code 及 Cowork 中使用。
已发布于 OpenAI 官方 Plugins Directory。可用于 ChatGPT 和 Codex。
通过一个 MCP 服务,让任意 AI Agent 访问覆盖市场、经济、公司、政府、新闻、气候、海事和实体筛查的 1,600 多个数据端点。
适用于 ChatGPT、Claude、Gemini、xAI、Cursor、VS Code 及任何 MCP 客户端。
面向 Sugra API 的官方 Model Context Protocol 服务:一个连接器、打包的端点目录,以及每条答案都附带来源归属信息的结构化工具结果。
实际效果
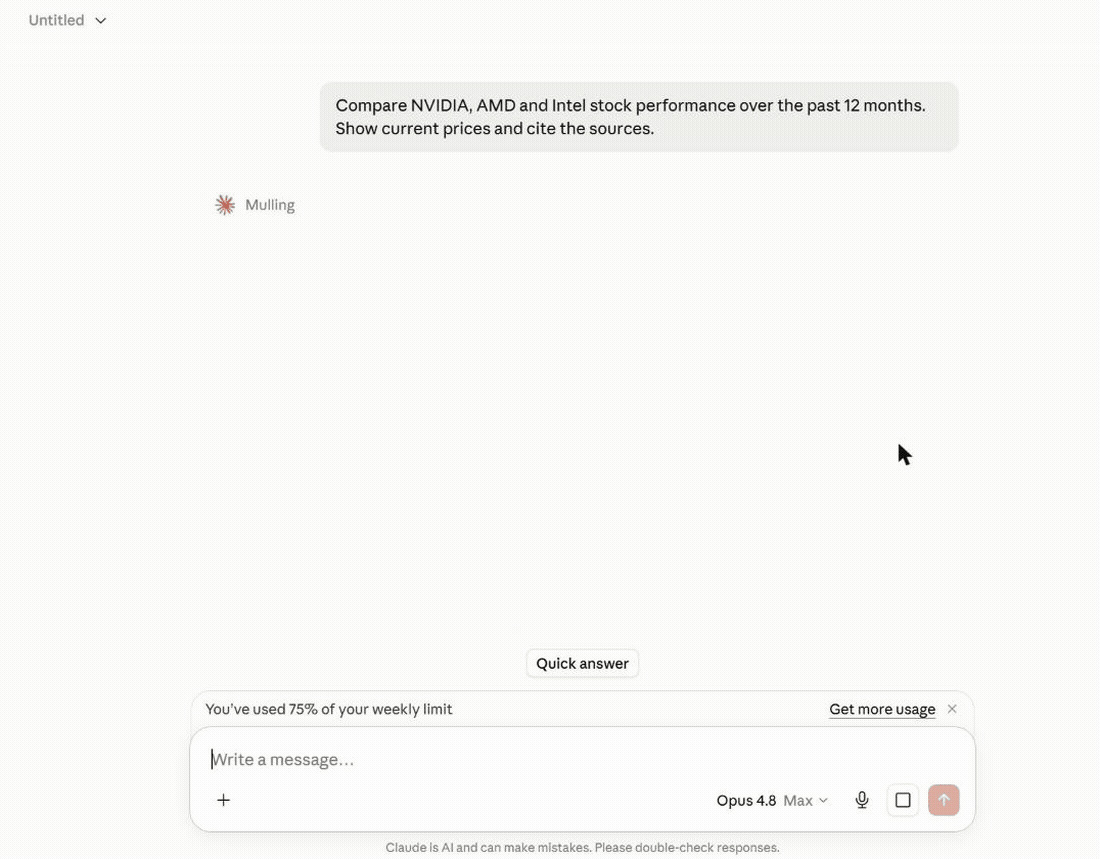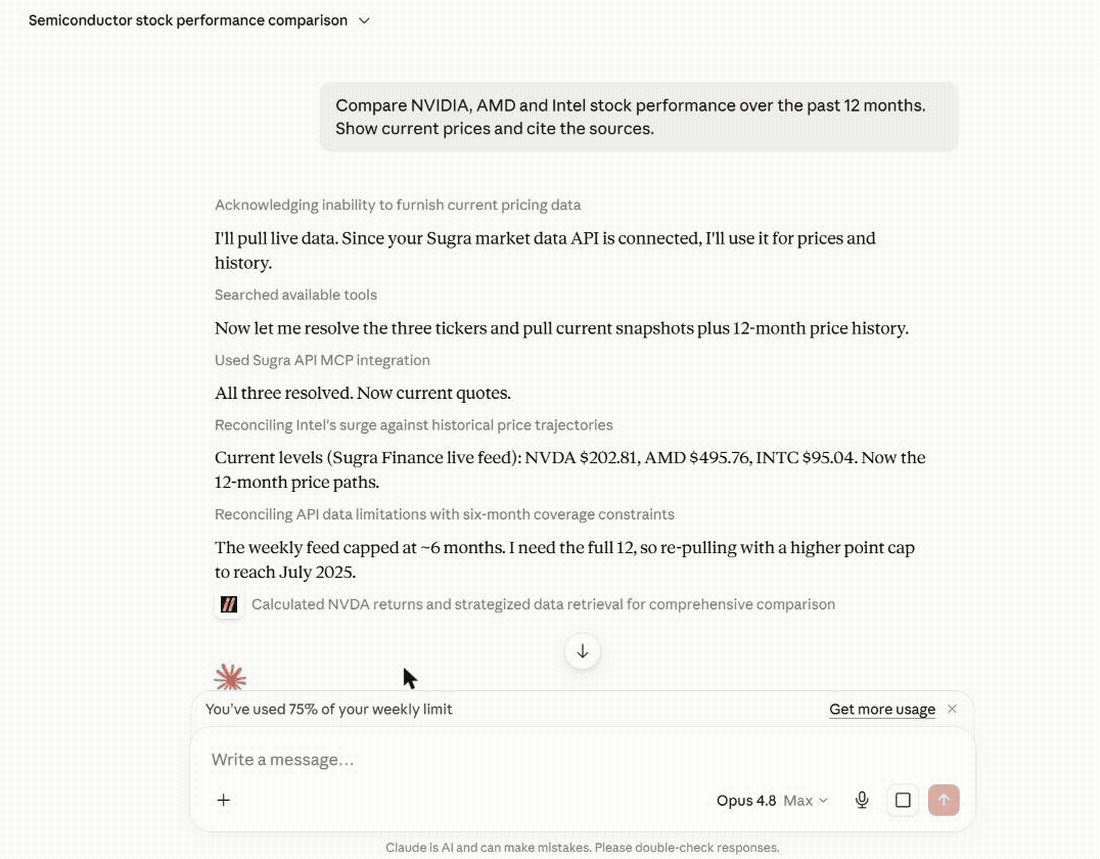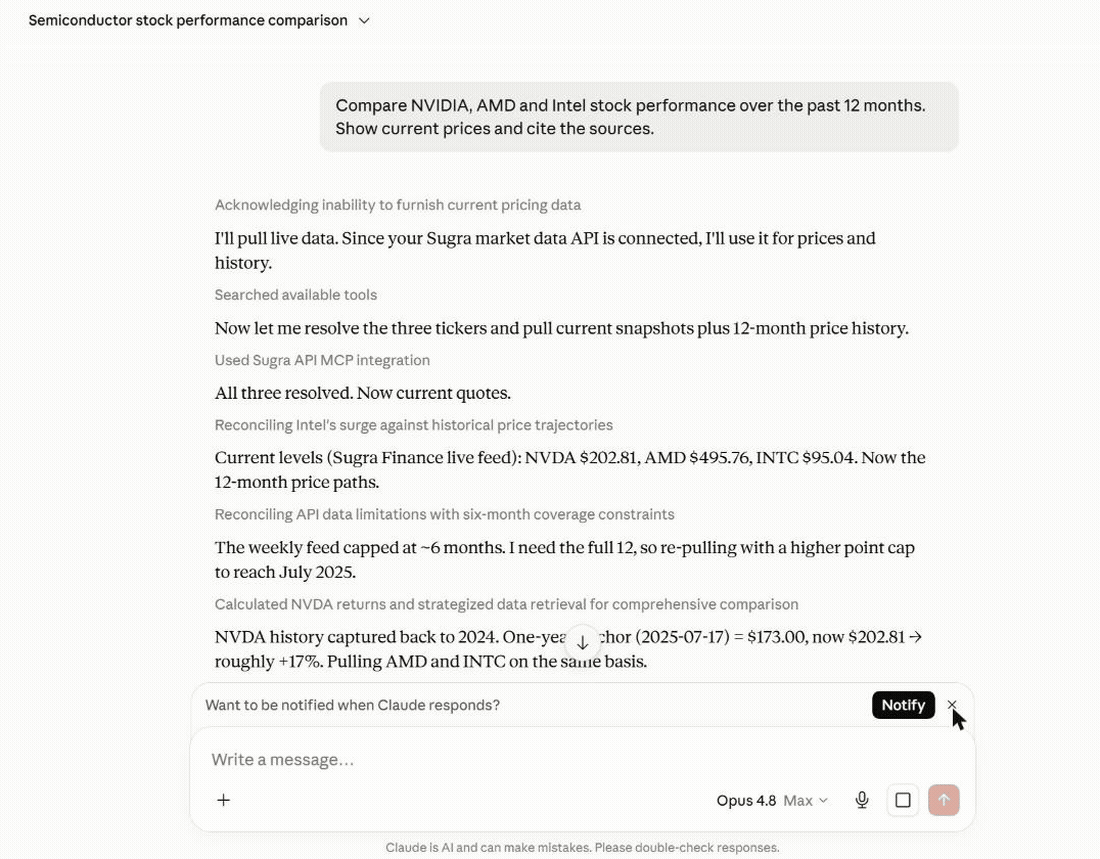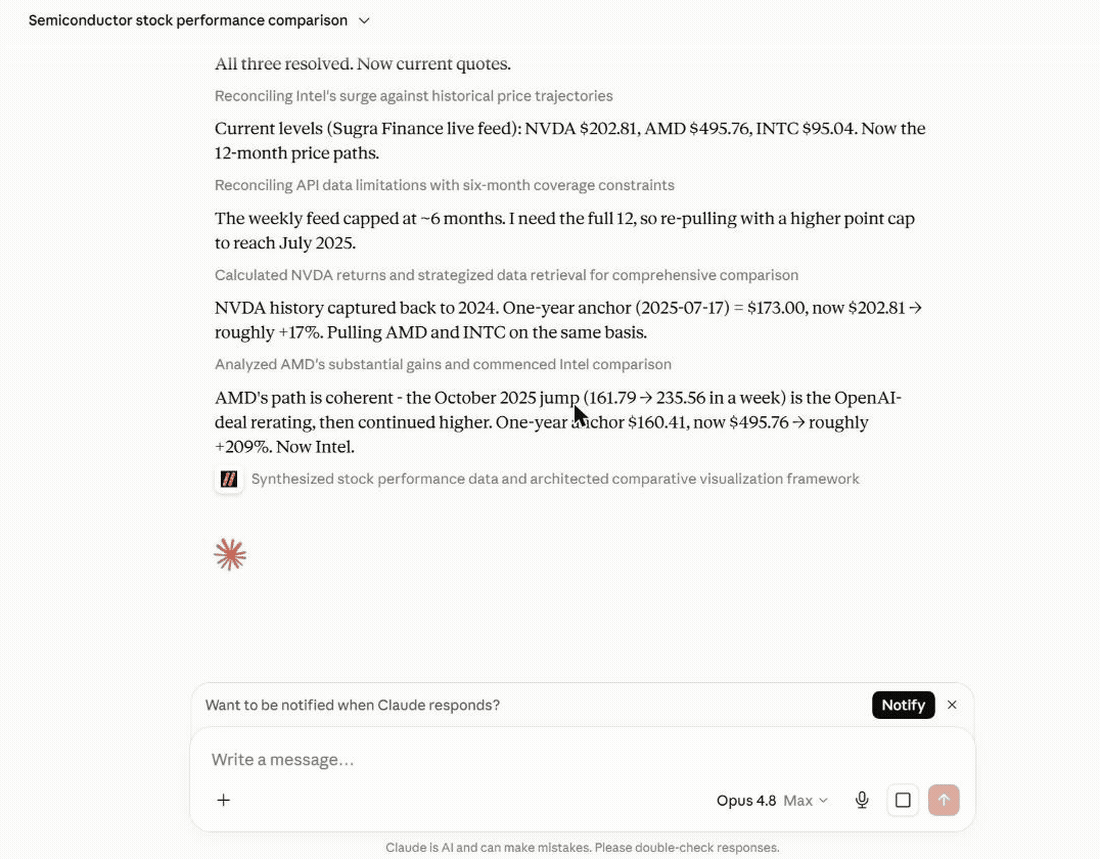
Agent 从头到尾回答真实问题:解析实体、获取实时快照和历史数据,并为每个数字标注来源和数据新鲜度:
更多示例:
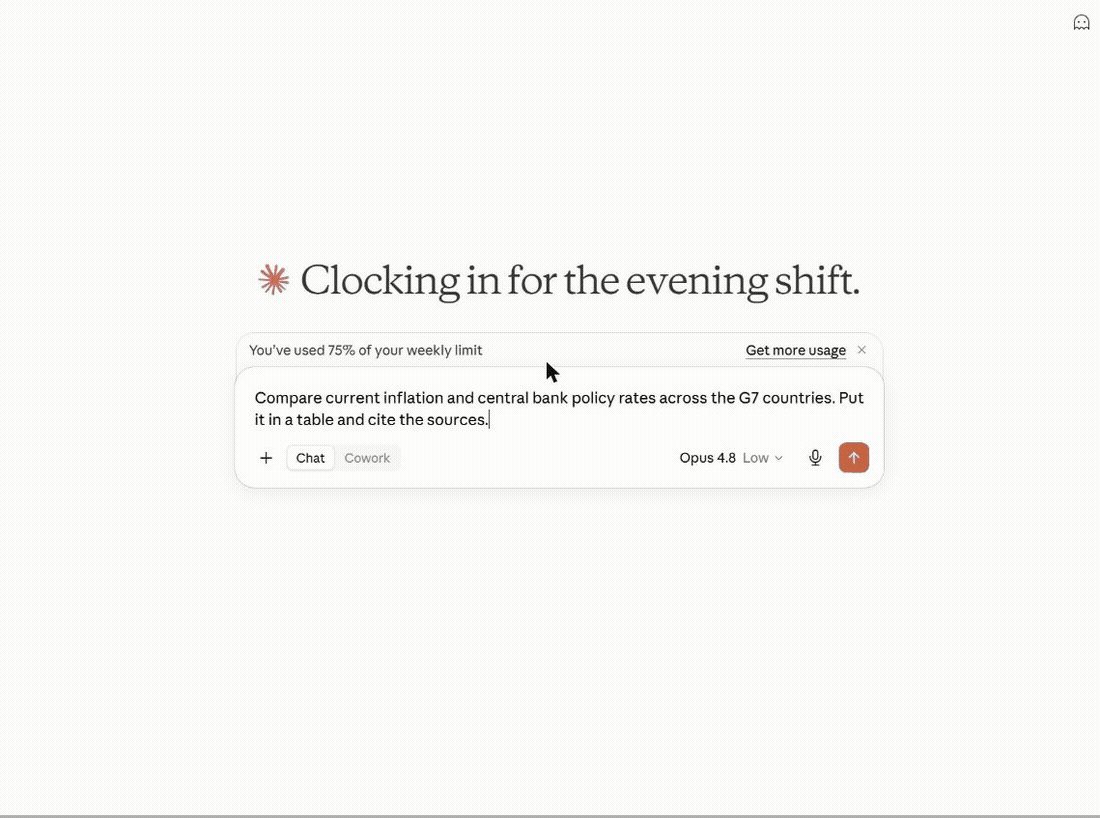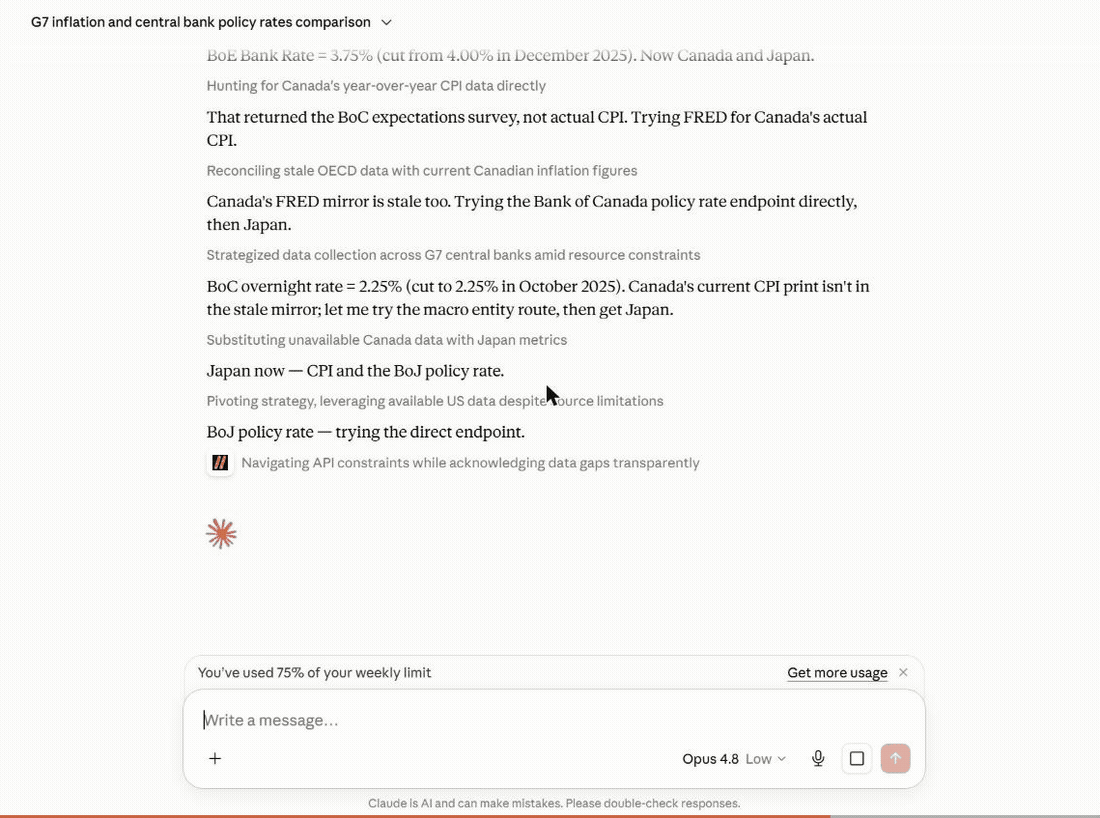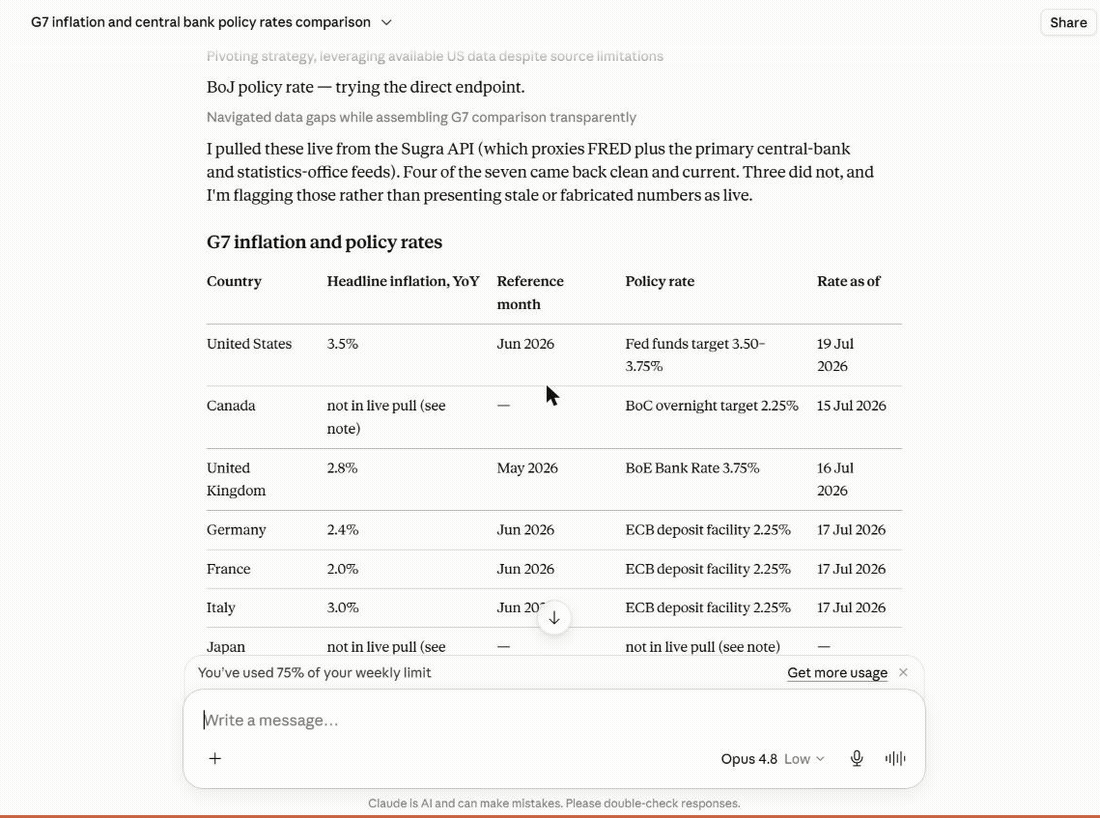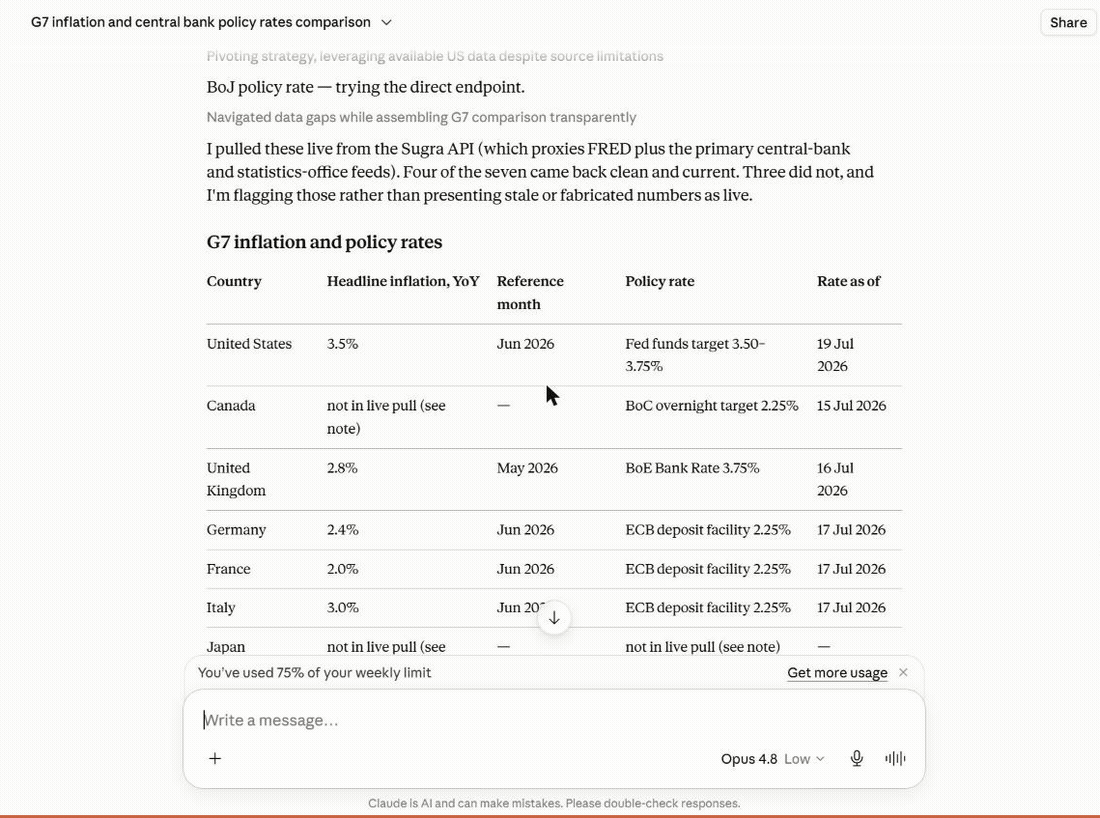
宏观研究 —— 一个提示词即可生成完整的 G7 通胀和政策利率表格,每个单元格都标注日期和来源;无法获取的数据会明确标出,而不是编造:
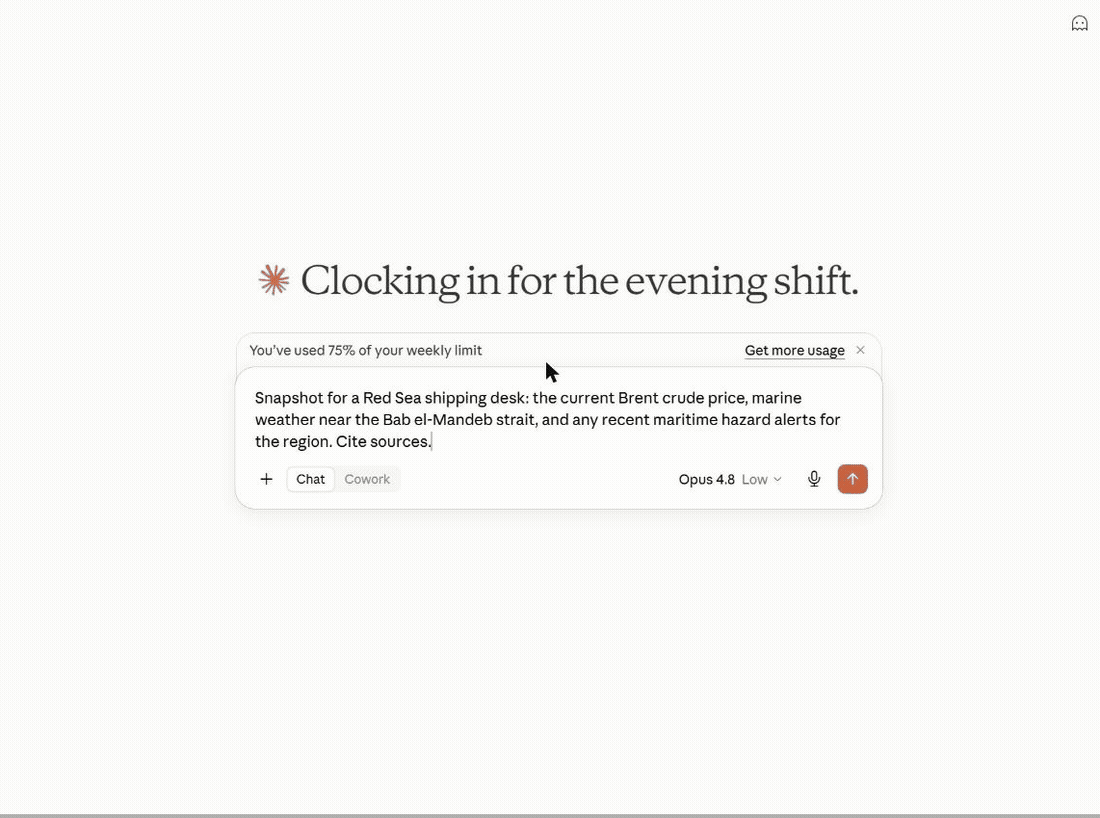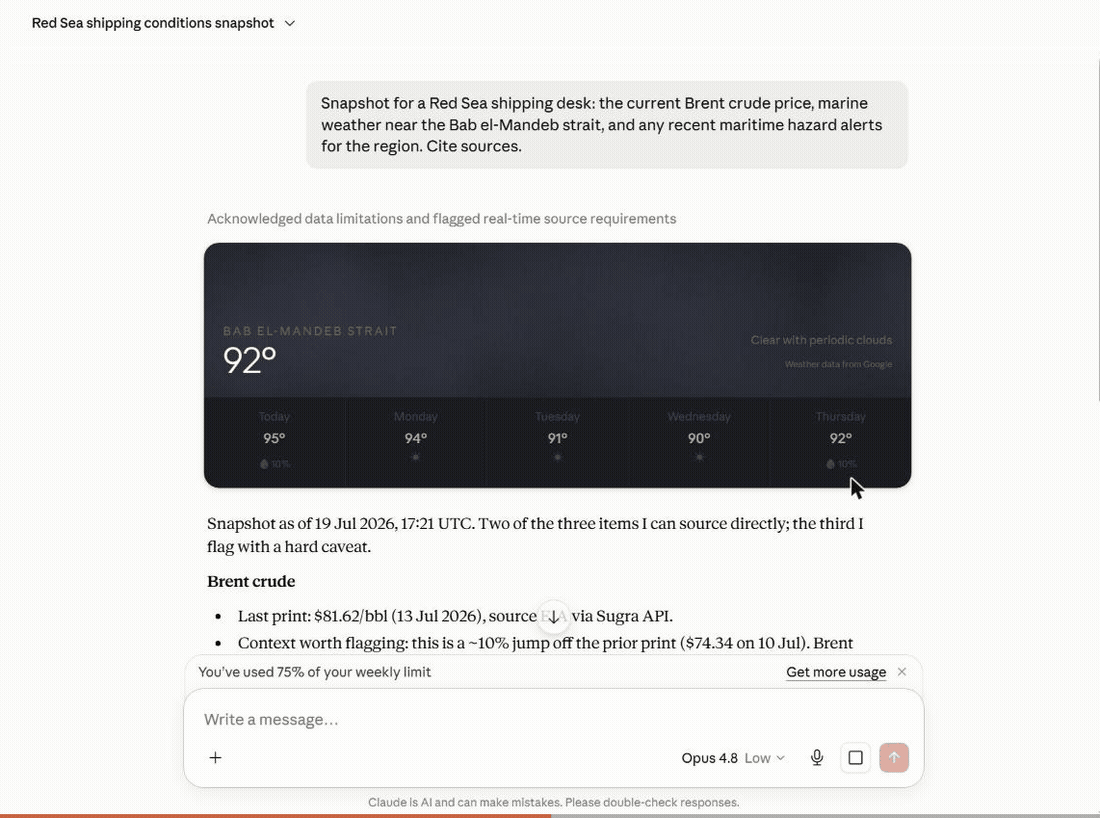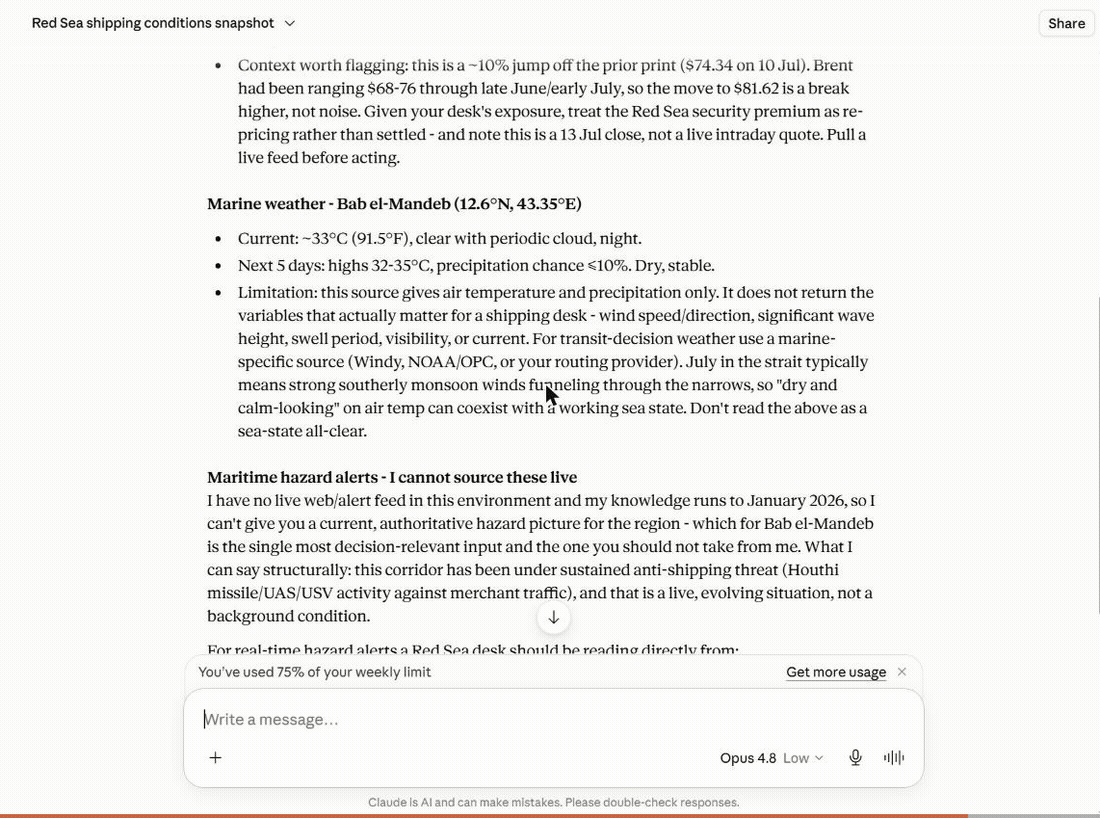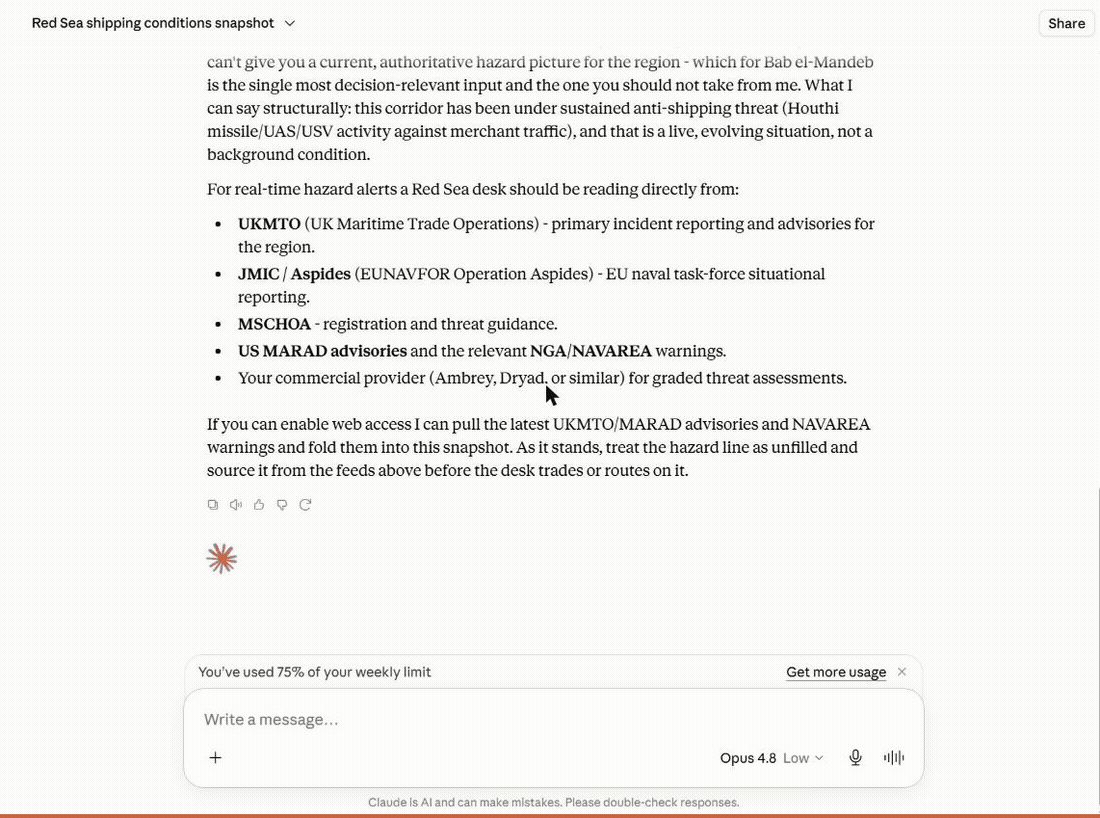
跨领域快照 —— 为航运团队汇总布伦特原油、海洋天气和区域风险数据,每项数据都附有来源和时间戳:
会话示例
托管 MCP 会话记录(此处展示的三个组合工具运行于托管端点)。以下为截取的示例——具体表述和数值会因每次运行及 BLS 发布的新数据而变化:
User: Where does US inflation stand, and how has it trended over the past year?

resolve_entity("US inflation")
  -> macro indicator cpi_us (U.S. Bureau of Labor Statistics)
get_snapshot("cpi_us")
  -> latest reading with freshness, provenance and quota cost
get_timeseries("cpi_us", metric="macro_series", range="1y")
  -> 12 monthly points with an explicit downsampling flag

Agent: US CPI printed 2.9% year over year in the latest release, down from
3.5% twelve months earlier - a steady decline since spring.
Source: U.S. Bureau of Labor Statistics via the Sugra API.
每个工具结果都包含结构化元数据——来源归属、数据新鲜度和速率限制成本——因此 Agent 可以引用来源并合理规划请求用量,而不必猜测。
工作原理
flowchart LR
    A["AI agent<br/>(ChatGPT, Claude, Gemini, xAI, IDEs)"] --> B["Sugra MCP<br/>gateway tools, plus agent tools when hosted"]
    B --> C["Sugra API<br/>1,600+ endpoints, 36 data domains"]
    C --> D["160+ primary sources<br/>markets, economics, government,<br/>news, climate, maritime"]
网关背后是 Sugra API:接入 160 多个一手数据源,包括主权国家统计机构、央行、政府间组织等,提供覆盖 36 个数据领域的 1,600 多个端点。服务内置完整端点目录,因此发现功能(搜索、描述、工具集)可在本地运行,无需网络调用;只有实际数据请求才会访问 API。
Agent 可以用它构建什么
Sugra API 技能位于 Sugra-Systems/sugra-api-skills。该服务从此仓库的固定提交中,将其中五项技能作为 MCP 资源(sugra://skills/...)提供:连接后通过 resources/read 读取 URI。
Agent 技能
这些技能用于指导如何循环使用目录。Claude Code 插件也会连接托管的 Sugra MCP 服务;Codex 和 Grok 插件及技能文件夹不会添加 MCP 工具,因此需要在这些 Agent 中单独连接服务(托管或本地)。每个 Agent 的插件包都位于 Sugra-Systems/sugra-api-plugins。
Claude Code
/plugin marketplace add Sugra-Systems/sugra-api-plugins
/plugin install sugra-api-skills@sugra-api-plugins
技能会显示为 /sugra-api-skills:<skill>,例如 /sugra-api-skills:discover-and-call。该插件还会添加托管服务 https://mcp.sugra.ai/mcp;请通过 /mcp 登录一次。
Codex
codex plugin marketplace add Sugra-Systems/sugra-api-plugins
codex plugin add sugra-api-skills@sugra-api-plugins
Grok
grok plugin install Sugra-Systems/sugra-api-plugins#xai
Cursor、Gemini CLI 和其他 Agent
npx skills add https://mcp.sugra.ai
也可以将 sugra-api-skills 的技能文件夹复制到 Agent 的技能目录中。
ChatGPT
这些技能可从 OpenAI 插件目录安装。MCP 服务会作为托管连接器附加,地址为 https://mcp.sugra.ai/mcp(永久别名为 https://app.sugra.ai/mcp)。
服务附带六个工作流提示词,可在支持 MCP 提示词的客户端中将这些流程变为一键操作:
- 市场与宏观研究 - “比较 G7 各国的通胀和央行政策利率。”(
macro_briefing) - 附带来源的股票概览 - “NVIDIA 今天的情况如何——价格、概况和市场背景?”(
market_snapshot) - 制裁与合规筛查 - “筛查这家供应商并确认其 LEI 身份。”(
sanctions_screening) - 行业比较 - “能源与科技:并列比较估值和资金流向。”(
sector_compare) - 气候、海事与贸易情报 - “本周红海航运情况:咽喉要道通行、原油价格和航线天气。”(
earth_conditions加上运输和大宗商品目录) - 来源发现 - “目录中有哪些固定收益数据,分别来自哪些机构?”(
source_overview)
每个回答都附带来源归属和时效性元数据,因此 Agent 可以引用来源,而不是猜测。
托管 MCP(推荐)
无需安装。在 Claude、ChatGPT 和 Codex 中,从目录添加 Sugra API MCP 服务:
- Claude(网页版、桌面版、移动版、Claude Code 和 Cowork):添加到 Claude 会在 Anthropic 的连接器目录中打开 Sugra API MCP 服务;连接服务并使用 Sugra 账户登录。在 claude.ai 中,目录位于 自定义 > 连接器。使用 claude.ai 账户登录的 Claude Code 会自动获取该连接器;
/mcp会列出它。 - ChatGPT 和 Codex:添加到 ChatGPT 会在 OpenAI 插件目录中打开 Sugra API MCP 服务。
其他 MCP 客户端或手动配置时,请指向托管的 Streamable HTTP 端点:
https://mcp.sugra.ai/mcp
- 网关工具,以及组合式 Agent 工具
resolve_entity、get_snapshot和get_timeseries - 通过 Claude 和 ChatGPT 连接器流程使用 OAuth 登录,或使用 API 密钥
Authorization: Bearer sugra_xxx_... - 在 claude.ai 中作为自定义连接器:自定义 -> 连接器 -> 添加自定义连接器
- 在 ChatGPT 中:设置 -> 连接器 -> 添加 MCP 服务
已经将 Sugra 作为自定义连接器添加到 Claude?该连接仍可正常使用,并会显示在“自定义”下。如果也从目录连接 Sugra API MCP 服务,就会有两个连接,因此请先移除自定义连接器,再从目录连接。
本地软件包
使用 API 密钥,通过 stdio(或可自托管的 HTTP)在你的计算机上运行:
pip install sugra-api-mcp
- 八个网关工具
- stdio 适用于桌面客户端和 IDE,Streamable HTTP 适用于自托管
- 使用
SUGRA_API_KEY进行身份验证
在 app.sugra.ai/register 获取免费 API 密钥(免费套餐:每天 50 次请求)。
快速开始
pip install sugra-api-mcp
export SUGRA_API_KEY=sugra_xxx_...   # free key: app.sugra.ai/register
sugra-api-mcp call quotes_symbol_price --params '{"symbol":"AAPL"}'
也可以通过 Agent 执行相同调用:将服务连接到客户端(见下一节),然后询问“ AAPL 目前的交易价格是多少?使用 Sugra。”Agent 会在目录中找到 quotes_symbol_price,并使用该代码调用它。
连接客户端
支持的客户端:
- Anthropic Claude:Claude Desktop、Claude Code(CLI)、claude.ai(网页)
- OpenAI GPT:ChatGPT(通过 MCP 连接器)
- Google Gemini:Gemini CLI、Gemini Code Assist(VS Code + JetBrains)
- xAI:xAI SDK 和 Responses API 中的远程 MCP 工具
- IDE:VS Code(原生)、Cursor、Zed、Cline、Continue.dev、Windsurf
- 自定义 Agent:基于 Python 或 TypeScript MCP SDK 构建的任何工具
Claude Desktop(stdio)
添加到 claude_desktop_config.json:
- macOS:
~/Library/Application Support/Claude/claude_desktop_config.json - Windows:
%APPDATA%\Claude\claude_desktop_config.json - Linux:Claude Desktop 没有 Linux 版本。在 Linux 上,使用
pip install sugra-api-mcp安装,然后使用 Claude Code(CLI)、IDE 客户端,或下方托管的 HTTP 端点。
{
  "mcpServers": {
    "sugra": {
      "command": "sugra-api-mcp",
      "env": {
        "SUGRA_API_KEY": "sugra_xxx_yourkey..."
      }
    }
  }
}
重启 Claude Desktop。Sugra 工具会显示在工具菜单中。
Claude Code(Anthropic CLI)
如果你使用 claude.ai 帐户登录了 Claude Code,可通过 添加到 Claude 从 claude.ai 的连接器目录连接 Sugra API MCP 服务,无需本地安装,它就会显示在 /mcp 中。若要改为运行本地软件包:
claude mcp add sugra -- sugra-api-mcp
# then set the env var that sugra-api-mcp reads
export SUGRA_API_KEY=sugra_xxx_...
也可以手动编辑 ~/.claude/config.json,使用与上方 Claude Desktop 相同的结构。
若要将技能安装为插件(这也会连接托管服务):
/plugin marketplace add Sugra-Systems/sugra-api-plugins
/plugin install sugra-api-skills@sugra-api-plugins
在 /mcp 中登录一次插件的服务。如果同时连接了 claude.ai 中的 Sugra API 连接器,Claude Code 只会显示插件的服务。如果也运行本地软件包,就会有两个 Sugra 服务:使用 claude mcp remove sugra 移除其中一个,或跳过插件,将 sugra-api-skills 的技能文件夹复制到 ~/.claude/skills/。
与 Gemini CLI 搭配使用
Gemini CLI 从 ~/.gemini/settings.json(用户范围)或项目中的
.gemini/settings.json 读取 MCP 服务。若要进行本地 stdio 安装,请添加:
{
  "mcpServers": {
    "sugra": {
      "command": "sugra-api-mcp",
      "env": {
        "SUGRA_API_KEY": "sugra_xxx_yourkey..."
      }
    }
  }
}
如果命令行脚本不在 PATH 中,请改用 "command": "python" 和
"args": ["-m", "sugra_api_mcp"]。对应的 Gemini CLI 命令为:
gemini mcp add --scope user -e SUGRA_API_KEY=sugra_xxx_yourkey... sugra sugra-api-mcp
也可以连接托管端点,无需安装软件包:
gemini mcp add --scope user --transport http \
  --header "Authorization: Bearer sugra_xxx_yourkey..." \
  sugra https://mcp.sugra.ai/mcp
运行 gemini mcp list 检查连接,然后在交互会话中输入 /mcp,查看可用工具。本地 stdio 连接会显示工具参考中的八个网关工具;托管端点还会显示三个仅托管端点提供的 Agent 工具。
如果从新目录连接本地服务失败,请先使用 gemini trust 检查并信任该工作区,然后重试。
这些示例已根据 Gemini CLI MCP 文档 和 Gemini CLI v0.51.0 进行验证。
Cursor、Zed、Cline、Continue.dev、Windsurf
这些客户端均有 MCP 设置文件(通常为 mcp.json 或同等文件),其 stdio 配置结构与 Claude Desktop 相同。
ChatGPT
添加到 ChatGPT 可从 OpenAI 插件目录安装 Sugra API MCP 服务。也可以将托管的 HTTP 端点(如下)添加为 MCP 连接器,因为 ChatGPT 不会启动本地 stdio 进程。
HTTP(claude.ai、ChatGPT、远程 Agent)
在 claude.ai 中,添加到 Claude 会从 Anthropic 的 Connectors Directory 连接 Sugra API MCP 服务;在 ChatGPT 中,添加到 ChatGPT 会从 OpenAI Plugins Directory 安装它。对于手动设置或任何其他 Streamable HTTP MCP 客户端,请使用托管端点:
https://mcp.sugra.ai/mcp
在连接器流程中使用 OAuth 进行身份验证,或使用 Authorization: Bearer sugra_xxx_...。
在 claude.ai 中将其设为自定义连接器:Customize -> Connectors -> Add custom connector。 在 ChatGPT 中:Settings -> Connectors -> Add MCP server。
工具参考
本地软件包提供八个网关工具。托管端点在此基础上额外提供三个组合分析工具(参见上文“托管 MCP”)。该软件包恰好提供八个工具:
| 工具 | 用途 |
|---|---|
fetch_data | 一步完成:为自然语言查询查找最佳端点并调用。将搜索和调用合并为一次往返。 |
search_endpoints | 搜索内置端点目录。运行时搜索不会获取 /openapi.json。 |
describe_endpoint | 按 operation_id 检查端点,包括路径、方法、参数、必需输入、agent_hints,以及 JSON 请求体 POST 操作的 request_body_schema。 |
call_endpoint | 按 operation_id 调用 Sugra API 操作。不再支持任意路径调用。 |
list_toolsets | 列出目录分组及其端点数量和描述。 |
list_sources | 显示内置目录的来源元数据。 |
sugra_entity_screen | 根据制裁名单和观察名单筛查名称(Sugra Entity)。 |
sugra_entity_lookup | 按标识符组合查询实体:anchor 为 lei 或 vat,并提供标识符 value;返回注册身份信息和筛查结果(Sugra Entity)。 |
call_endpoint 和 fetch_data 都支持使用 limit、fields 和 include_raw 整形响应。整形同样适用于带信封({"data": ...})和不带信封的负载;fields 条目可以使用指向嵌套对象的点分路径(geo.city),而 meta.shaped 会报告实际应用的内容(fields_applied / fields_unmatched、limit_applied、records_path、order、kept_end),而不是照抄请求。limit 和 fields 作用于记录列表:信封中的 data 列表、顶层裸数组,或对象 data 中唯一一个包含列表的字段,前提是 data、entries、events、history、items、observations、points、records、results、rows、series、timeseries 中恰好只有一个字段包含列表(例如最新新闻中的 data.items、FRED 序列中的 data.observations)。如果 data 中没有这样的唯一列表,但其每个值都是对象,且各自恰好包含一个名为 observations 的列表(例如多个具名子序列并列的情况),则 limit 会分别限制每个 data.<key>.observations 列表;此时 fields 仍指定 data 的键。该列表旁边的键(例如 total 和 count)会保持原样,记录内嵌套的列表则绝不会被截断。若 fields 条目指定了 data 本身的某个键,则会改为投影该对象;如果投影没有匹配到任何内容,则负载会保持完整。meta.shaped.limit_applied 表示是否生效了限制,meta.shaped.records_path 则指出所用列表(data、data.<key>、data.*.observations,或在未使用记录列表时为 null)。如果每条记录都包含一个格式一致的日期或时段键(例如 date、period 或 year),且列表按该键单向排列,limit 会保留记录列表中最新的一端:对于从旧到新的列表,保留最后 N 条记录并保持原有顺序;对于从新到旧的列表,则保留前 N 条记录。否则会保留前 N 条记录。每当 limit 限制了记录列表,meta.shaped.order 就会报告 asc、desc 或 unknown,meta.shaped.kept_end 则会报告 newest 或 first;对于并列的子序列,这两者各自都是按子序列名称映射的值。顶层 JSON 数组(或标量)始终会包装为 {"data": ...},以确保 MCP 结果是对象;否则 FastMCP 输出验证会将成功的调用报告为错误,并丢弃这些行。 |
fields 最多接受 32 个路径,每个路径最多 256 个字符、包含 16 个点分部分;超过其中任何限制时,调用会在发出请求前返回 projection_too_large。使用 fields 时,单次投影最多处理 100,000 个列表项,运行时间最长为 5 秒,且投影前的 JSON 响应最多为 2,000,000 个字符。这个上限远高于结果的 18,000 个字符限制,后者在投影后生效:为期 16 天的天气预报在应用 fields=["daily"] 并裁剪至符合限制之前,约有 295,000 个字符。不使用 fields 时,这些上限均不适用。整形会在专用的双线程工作池中执行,绝不会占用事件循环:最多有 8 个任务在运行或等待工作线程,其中同一调用方最多占 4 个;如果调用在 2 秒内找不到空闲槽位,则会返回 server_busy,其范围为 shaping 或 caller_shaping。
describe_endpoint 会为每个端点返回计算得出的 agent_hints,以便 Agent 在调用前预估耗时和并行度:
duration_class-fast(耗时约少于 2 秒,由快照支持)、slow(实时代理上游请求,偶尔超过 15 秒),或heavy(逐项处理上游请求,大批量调用可能超过网关超时时间)max_concurrency- 对单个会话并行调用次数的建议上限bulk_cost- 对逐项批量端点而言:请求正文中的每个项目会消耗 1 个请求额度(API 会在X-RateLimit-Cost响应标头中报告总数)
仅托管环境提供的 Agent 工具(mcp.sugra.ai/mcp)
托管 MCP 端点 https://mcp.sugra.ai/mcp 提供相同的八个工具,另外还有三个组合式 Agent 工具,这些工具在 stdio 或可自托管安装中不可用:
| 工具 | 用途 |
|---|---|
resolve_entity | 将自由文本(股票代码、公司、指标、加密货币、货币对)转换为规范的市场或宏观实体。对于含糊的匹配结果,会返回排序后的候选项,绝不会静默地选定某个结果。 |
get_snapshot | 输入实体和命名配方,获取一个组合式当前视图,其中包含新鲜度、来源、覆盖范围和计费信息块。组合调用按固定配方成本(1-2 个请求)扣除每日配额。 |
get_timeseries | 输入实体和指标(price、macro_series、etf_flows、etf_monthly_flows),获取有界序列,并明确标记是否进行了下采样。etf_flows 按申报频率估算;etf_monthly_flows 则是基金自身的 NPORT-P 月度申购与赎回数据。 |
这三个工具封装了一个内部组合层,该层需要仅在托管部署中提供的基础设施凭据。工具代码包含在软件包中,但只有托管 HTTP 入口点会注册这些工具,且仅当存在该凭据时才会注册——pip install sugra-api-mcp(stdio 和可自托管 HTTP)始终只提供经典的八工具网关。文档中仅托管环境可用的示例都会明确标注。对于合规实体查询(LEI / VAT、制裁筛查),请使用 sugra_entity_lookup 和 sugra_entity_screen,它们适用于所有传输方式。
ChatGPT 工具集
当 MCP initialize 中的客户端名称为 openai-mcp(ChatGPT),或未发送客户端名称且 User-Agent 以其开头时,该会话会列出 142 个类型化工具,以取代 search_endpoints、describe_endpoint、call_endpoint 和 fetch_data,并与上述其他工具并列:每个操作对应一个工具,名称采用动词形式(例如 get_stock_quotes 或 get_price_history),并具有自己的输入架构和精简结果。类型化工具不接受原始位置输入(坐标、地址、邮政编码)。类型化工具可能接受比其操作更少的输入:get_latest_news、search_news 和 search_global_news_articles 只接受一个必填主题或名称以及一个数量参数,而其他客户端仍可通过 call_endpoint 使用这些操作的所有输入。定义的 145 个类型化工具中,这三个不会列在此类会话中(sugra_api_mcp/server.py 中的 CHATGPT_UNLISTED_TYPED_TOOLS)。此类会话看到的任何内容都不会提及未列出的工具:list_toolsets 和 list_sources 会提供说明,但不包含 search_endpoints 筛选提示;它读取的提示词和 sugra://skills/ 资源使用的措辞也只提及已列出的工具。所有其他客户端看到的工具与上述工具保持一致;任何客户端仍可按名称调用这些工具。工具集定义在 sugra_api_mcp/catalog/data/typed_tools.json 中。
CLI
服务器启动方式不变:
sugra-api-mcp
sugra-api-mcp --transport streamable-http --port 8001
目录和网关辅助工具:
sugra-api-mcp doctor
sugra-api-mcp list-toolsets
sugra-api-mcp search "NASDAQ futures"
sugra-api-mcp describe cot_financial
sugra-api-mcp call quotes_symbol_price --params '{"symbol":"AAPL"}'
环境变量
面向用户的配置,适用于本地安装、MCP 客户端、Docker stdio 和目录沙盒(例如 Glama Try in Browser)。只需设置此项:
| 变量 | 必填 | 默认值 | 描述 |
|---|---|---|---|
SUGRA_API_KEY | 用于 API 调用 | - | 你的 Sugra API 密钥(sugra_...)。可在 app.sugra.ai/register 免费获取密钥(免费层级:每天 50 次请求)。启动服务不需要此密钥:目录工具(search_endpoints、describe_endpoint、list_toolsets、list_sources)无需密钥即可使用;调用 API 的工具在设置密钥前会返回结构化的 missing_api_key 错误。在 HTTP 模式下,如果客户端提供了 Bearer 令牌,此密钥仅作为备用。 |
可选覆盖项(除非有需要,否则留空):
| 变量 | 默认值 | 描述 |
|---|---|---|
SUGRA_API_BASE | https://sugra.ai | 覆盖 Sugra API 基础 URL(仅适用于可自托管版本或 Beta API)。 |
SUGRA_TIMEOUT | 30 | 此服务向 Sugra API 发起调用时,下游 HTTP 请求的超时时间,单位为秒。 |
可自托管 Streamable HTTP 的运维专用设置(反向代理 CORS/主机、OAuth 授权服务器配置和共享密钥)见 docs/self-hosting.md。不要将运维密钥放入公开的目录沙盒。SUGRA_MCP_TRUST_PROXY_HEADERS(默认关闭)会使服务读取 X-Real-IP 和 X-Forwarded-Host;仅当服务位于反向代理后,且该代理会在每个请求中覆盖这两个标头时才设置此项;切勿在客户端可直接访问进程的情况下启用(详情见同一指南)。
SUGRA_MCP_LIMITS(默认关闭)会启用在服务自身内存中计数的请求限制;同一指南中列出了相关设置。
使用 OAuth 的 HTTP 传输
使用 --transport streamable-http 运行时,服务允许未经身份验证的 MCP 发现请求(initialize、notifications/initialized、tools/list、resources/list、prompts/list 和 ping),以便 ChatGPT Apps 和其他混合身份验证客户端发现工具元数据。工具调用仍需提供 Authorization: Bearer ...。支持以下两种令牌格式:
- 原始 API 密钥(
sugra_...)- 作为下游的x-api-key传递。兼容较早的本地 API 密钥配置。 - OAuth JWT - 根据颁发方的 JWKS 验证签名。受众必须与
https://app.sugra.ai/mcp匹配,令牌必须包含sugra:read,并且托管访问权限会在解析用户的主 API 密钥前通过 APP 验证。成功的托管 OAuth 请求会在 APP 中更新 MCP 连接活动状态。
大多数用户应使用托管端点 https://mcp.sugra.ai/mcp,并将 API 密钥作为 Bearer 令牌提供,而不是自行托管 OAuth;目前,独立 OAuth 客户端请通过别名 https://app.sugra.ai/mcp 登录。如果你运行自己的 HTTP 进程,请参阅 docs/self-hosting.md。
超时与错误约定
SUGRA_TIMEOUT 限制此服务对 Sugra API 发起的每次下游 HTTP 调用的时长(默认 30 秒)。它是较长调用链中的一环;工具调用失败时,错误负载中的 elapsed_ms 会告诉你是哪一环出了问题:
MCP client (agent harness)         own tool timeout, often 60-180s, client-controlled
  -> hosted proxy (app.sugra.ai)   86400s, effectively unlimited
    -> this server (httpx)         SUGRA_TIMEOUT, default 30s
      -> Sugra API -> upstreams    15-60s per upstream call, server-side
工具调用失败时会返回结构化 JSON,而不是抛出异常,因此 Agent 可以选择重试策略:
error 值 | 含义 | 重试策略 |
|---|---|---|
upstream_timeout | 在 SUGRA_TIMEOUT 时限内未收到响应(elapsed_ms 接近 timeout_s x 1000) | 重试一次:中止的尝试通常会在服务端完成,并预热上游缓存。然后缩小请求范围(减少批量、收紧筛选条件)。 |
upstream_connect_error | 无法连接到 Sugra API(DNS 解析失败、连接被拒绝) | 短暂延迟后重试。 |
upstream_transport_error | 请求过程中连接中断 | 重试一次。 |
invalid_request_url | 无法构建请求,最常见的原因是参数使 URL 长度超过 65,536 个字符;请求未发送 | 减少或缩短参数值,或拆分请求。 |
unusable_api_key | API 密钥包含此服务无法在请求标头中发送的字符(非 ASCII 字符、换行符或其他控制字符,或者首尾的空格或制表符);请求未发送 | 不要重试:必须更换密钥(参见故障排除)。 |
response_too_deep | API 的响应嵌套过深,无法测量,因此不会返回 | 重试一次;若问题持续,请报告。 |
自由文本字符串 + status_code | API 返回了 HTTP 4xx/5xx;若 API 发送了 Retry-After 标头,则会包含 retry_after | 对 429/503,遵循 retry_after;对 4xx,修正请求。 |
tool_execution_failed | 网关内部发生意外故障(包含 exception_type) | 若问题持续,请报告。 |
query_too_long | search_endpoints 或 fetch_data 查询包含超过 64 个词项或 1000 个字符(包含 max_terms 和 max_chars)。词项是由两个或更多 ASCII 字母或数字组成的连续字符串,重复项也会计数;未执行搜索 | 将查询缩短为仪器、系列、地点或任务。 |
projection_too_large | fields 投影超出某项限制。limit_kind 表示具体限制:fields(路径超过 32 个)、path_chars(路径超过 256 个字符)、path_parts(点分隔部分超过 16 个)、rows(访问的列表项超过 100,000 个)、shaping_ms(超过 5 秒)或 raw_chars(投影前响应超过 2,000,000 个字符)。包含 limit、actual、field_index(从 0 开始,仅适用于 path_chars 和 path_parts)和 operation_id,但不会包含字段文本;前三种限制会在发送请求前拒绝请求 | 指定更少或更短的字段、添加 limit、缩小请求范围,或省略 fields。 |
server_busy | 已达到并发限制。对于服务级限制,scope 为 tool_calls、search 或 shaping;对于单个调用方的限制,scope 为 caller_tool_calls、caller_search 或 caller_shaping。若为 shaping 或 caller_shaping,则已发送 API 请求,但其响应被丢弃;其他任何范围下,调用都未执行任何操作 | 几秒后重试。 |
所有错误负载都包含 elapsed_ms。传输错误和 HTTP 错误中会包含 url(tool_execution_failed 可能在 URL 生成前触发,因此不包含)。对于三种传输错误和 invalid_request_url,status_code 为 null(未收到 HTTP 状态码)——以数值方式比较 status_code 的使用方应对此进行保护。如果工具调用失败时只返回了纯客户端消息,而没有结构化 JSON,则说明超时是在此服务上方的 Agent 执行环境中触发的:应提高客户端的工具超时时长,而不是 SUGRA_TIMEOUT。
示例
询问 Claude:
- “搜索 Sugra 端点,查找 NASDAQ 期货。”
- “描述
cot_financial操作。” - “调用
quotes_symbol_price,传入代码 AAPL,并且只返回代码和价格。” - “列出可用的 Sugra 工具集。”
故障排除
在查找 get_market_price、get_macro_indicator 或 get_news? 这些精选工具名称曾出现在一些较旧的目录列表中,但从未在此软件包中发布。单步自然语言调用请使用 fetch_data,或使用 search_endpoints 加 call_endpoint 进行明确路由。
工具响应中出现 missing_api_key
服务器无需密钥即可启动并列出其工具,但在服务器找到密钥之前,调用 API 的工具(call_endpoint、fetch_data、实体工具)会返回 {"error": "missing_api_key"}。根据运行方式进行检查:
- 作为客户端中的 MCP 工具使用(Claude、ChatGPT、Gemini、xAI、IDE 等):检查 MCP 配置文件中的
env区块。值应为完整密钥,例如sugra_ao1_...,不可为空,也不可额外加引号。 - Shell / CI:运行
sugra-api-mcp前执行export SUGRA_API_KEY=sugra_...。 - HTTP 模式:通过
.env或 systemdEnvironmentFile设置,而不是通过 shell 设置。
sugra-api-mcp doctor 会报告进程能否读取到密钥。
工具响应中出现 unusable_api_key
服务器用于此次调用的密钥包含服务器无法在请求标头中发送的字符(ASCII 以外的字母、不可见字符、换行符或其他控制字符,或两端的空格或制表符),因此调用 API 的工具不会发送请求,而是返回 {"error": "unusable_api_key"};重试也会以同样方式失败。根据密钥来源进行处理:
- 粘贴到配置文件或环境变量中的密钥可能会在传递过程中带上不可见字符。请从 app.sugra.ai/developer/keys 重新复制。
- 密钥本身含有此类字符(部分旧密钥会如此):请在 app.sugra.ai/developer/keys 轮换密钥并使用新密钥。通过登录连接(claude.ai、ChatGPT)使用时,服务器会使用你的账户密钥,并在五分钟内重新读取。如果页面没有提供轮换密钥的选项,请发送邮件至 [email protected]。
工具响应中出现 401 Unauthorized 或 403 Forbidden
密钥已被接受,但遭到拒绝。常见原因:
- 在 app.sugra.ai/developer/keys 重新生成了密钥,但配置中仍是旧密钥。
- 拼写错误——密钥仅包含小写字母和数字,不含空格或末尾换行符。
- 免费套餐已停用。请登录以确认状态。
429 Too Many Requests
已达到套餐的每日限额。响应标头包含 X-RateLimit-Reset,其值为计数器重置时的 UTC 时间戳(UTC 午夜)。通过 MCP 调用时,工具结果会包含 reason: daily_limit_reached、status_code: 429、retry_after,以及 retry_hint。该提示会告知模型在重置前(即 X-RateLimit-Reset 指定的时间;若 API 未发送重置时间或发送的值无效,则为 UTC 00:00)不要再次调用数据工具,并告知用户。若 API 提供了 daily_limit 和 plan,结果也会包含这两项。套餐信息:sugra.systems/api/pricing。
达到限额前,call_endpoint 或 fetch_data 的结果会显示剩余额度:meta.quota 包含 limit、remaining(今日剩余请求数)和 resets_at,这些值取自 API 的 X-RateLimit-* 响应标头。如果 API 未报告额度,结果中就不会包含 meta.quota。
Invalid Host header(仅限自托管 HTTP 模式)
FastMCP 会对反向代理后的公共主机名启用 DNS 重绑定保护。允许的主机设置请参阅 docs/self-hosting.md。
工具结果因出现 meta.truncated 提示而被截断
某些端点会返回非常大的负载(漫长的价格历史记录、逐小时预报、完整目录)。结果限制为 18,000 个字符的 JSON(带 ASCII 转义),因此 CJK 字符或带重音符号的字符会按 6 个字符的转义序列计数,非 ASCII 文本也会按较宽松的方式计数。客户端会以各自的方式限制传递给模型的内容:Claude Code 会将超过 50,000 个字符的工具结果写入文件,而不是交给模型;Codex 则按 Token 限制工具结果,预算由用户设置,超出时会截去中间部分。我们测量的所有形状在 18,000 个字符时(包括最密集的结果)都在 Codex 的默认预算内;但更密集的结果,或客户端设置的更低预算,仍可能被客户端截短。所有客户端的上限相同。较大的结果会被裁剪以符合上限,无论其形状如何:data 下最多两层的列表(data、data.<key>、data.<key>.<key>,具体取决于键名)会逐条记录测量;大列表会先于旁边的小列表被裁剪,且被裁剪的列表至少保留一条记录。列表会按与 limit 相同的排序规则保留较新的一端,否则保留最前面的记录;通过 call_endpoint 获取的预报或日历则会改为保留从今天开始的记录,无论按从旧到新还是从新到旧排序,kept_end 均为 nearest。fetch_data 会通过 call_endpoint 执行操作,并以相同方式裁剪;其 meta.fetch_data(当响应的 meta 是对象或不存在时写入)也计入上限。裁剪在整形线程池中运行,不会在事件循环上运行,因此线程池已满时会返回 server_busy;裁剪有 5 秒时限,在记录之间检查,超时后会拒绝结果;固定工具在该时限结束后半秒停止等待裁剪,call_endpoint 则在两个此类时限结束后半秒停止等待,因为其 fields 投影也有自己的时限;两者届时都会返回 response_too_large。如果裁剪在 2 秒等待期内无法启动,则会返回 server_busy。Sugra API 的故障或请求发送过程中的故障,会在任何关卡处理前限制为 17,000 个字符;服务器自行生成的拒绝响应也如此,例如回显调用内容的响应(未知的 operation_id 或参数、未解析的路径):过长而无法容纳的值(例如很长的 API 消息、URL 或标头)会被截短,并以 ... 结尾,同时在其旁边标记 <key>_truncated: true;不会删除任何键,因此状态和所有较短的值都保持不变。固定工具会像处理其他结果一样对错误响应正文进行关卡检查;如果错误负载超过上限,而 call_endpoint 原样传递该负载,则不会对其进行测量,而是直接拒绝。meta.truncated 会说明被裁剪的内容:reason(exceeds_response_size_cap)、被裁剪的最大列表的 path,以及其 original_count、kept_count、order 和 kept_end;original_chars、kept_chars 和 cap_chars 这些大小值;多个列表被裁剪时,每条路径对应一个 lists 条目(包含 kept_range,即保留部分的首尾日期);以及 retry_hint,其中会指出保留了什么,并且只包含该操作实际支持的参数。对于最多约两周的预报,会保留从今天开始的小时数据和完整的 daily 列表,提示会提供 fields=["daily"] 或更小的 params.forecast_days;16 天的预报也可能丢失最后几天,此时提示只会提供更小的 params.forecast_days,不过使用 fields=["daily"] 可在上限内返回全部 16 天;报价历史会保留最新的柱状数据,提示会提供 params.limit 或更窄的 params.start 到 params.end 范围。如果无法裁剪到上限内,结果会返回 response_too_large 错误,其消息会以字符数说明大小和上限,并指出超大的部分:单独就超过上限的记录;与响应其余部分及裁剪通知一起无法容纳的记录(包含两者的大小,以及有多少其他列表含有这样的记录);仅在列表放在一起时才无法容纳的情况下每个列表保留的那条记录(包含它们的总大小及其中最大的记录);或者列表以外过大的部分;如果可行,还会列出能排除该大块内容的 fields。拒绝响应本身始终不会超过上限:如果仍会超出,则只保留大小说明行和截短至 300 个字符的 URL。
Python version 3.12 or higher is required
sugra-api-mcp 需要 Python 3.12 或更高版本。检查版本:python --version。如果使用的是 Python 3.11 或更早版本:
- Ubuntu:从发行版软件包或 deadsnakes PPA 安装 Python 3.12 或更高版本。
- macOS:
brew install [email protected] - Windows:从 python.org 下载。
然后重新创建 venv。
托管的 mcp.sugra.ai/mcp 返回 5xx
托管端点可能会在部署后短暂重启。等待 60 秒后重试。如果问题仍然存在,请发送邮件至 [email protected]。
在本地调试工具调用
使用 stdio 运行并记录 JSON-RPC 消息:
SUGRA_API_KEY=sugra_... sugra-api-mcp 2>&1 | tee mcp-debug.log
使用 nc 或 MCP inspector,在另一个终端中手动发送 JSON-RPC。
开发
git clone https://github.com/Sugra-Systems/sugra-api-mcp
cd sugra-api-mcp
pip install -e ".[dev,http]"
export SUGRA_API_KEY=sugra_...
python -m sugra_api_mcp  # stdio mode
python -m sugra_api_mcp --transport streamable-http --port 8001  # HTTP mode
python scripts/build_endpoint_catalog.py  # rebuild bundled catalog from sibling API openapi.json
python scripts/build_endpoint_catalog.py --source https://sugra.ai/openapi.json  # from the live spec
# On DRIFT, catalog-parity.yml opens or updates PR branch ci/catalog-resync.
运行测试:
pytest
Docker
从仓库根目录构建镜像:
docker build -t sugra-api-mcp .
以 stdio 模式运行(默认入口点),供会启动本地进程的 MCP 客户端使用:
docker run -i --rm -e SUGRA_API_KEY=sugra_... sugra-api-mcp
使用 Docker Compose 在端口 8001 上运行 Streamable HTTP 传输:
export SUGRA_API_KEY=sugra_...
docker compose up -d
然后将 MCP 客户端指向 http://localhost:8001/mcp。如果已设置,compose 服务会从 shell 传递 SUGRA_API_KEY 和可选的覆盖项(SUGRA_API_BASE、SUGRA_TIMEOUT),并使用 http://localhost:8001/health 检查容器健康状态。反向代理和 OAuth 运维设置详见 docs/self-hosting.md。
应用发送的每个响应(包括错误)都会带有标头
Server: sugra-api-mcp。uvicorn 自身针对无法由 httptools 解析的请求返回的 400 响应也会带有此标头;http extra 会安装 httptools,uvicorn 默认会选用它。使用 h11 解析器时,该 400 响应不会带有此标头。在服务器环境中设置 SUGRA_MCP_SERVER_VERSION=1(或 true、yes、on),即可在该标头中添加软件包版本(sugra-api-mcp/<version>),并将版本添加到 /health 响应中;否则不会在其中包含版本。
关于身份验证:镜像中不会内置任何环境变量,容器启动也不需要任何环境变量。在 HTTP 模式下,客户端会在每个请求中使用 Authorization: Bearer sugra_... 进行身份验证,因此容器中的 SUGRA_API_KEY 仅作为不带 Bearer 令牌的请求的备用密钥。
许可证
MIT © 2026 Sugra Systems, Inc.
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。