关于 Vulcanus
Vulcanus 是面向编码 Agent 及其操作者的本地 Git 版本化 Markdown 记忆库。它将项目上下文组织为互相关联的层级,验证记忆图,并通过 MCP 服务提供回忆功能。
主要功能
- 01分层 Markdown 项目记忆
- 02MCP 回忆与搜索工具
- 03记忆图验证与修复
- 04从 AI 历史记录和笔记导入
- 05支持 Git 的同步与提交钩子
适用场景
- 01在会话开始时提供项目上下文
- 02跨会话记录决策与规则
- 03从聊天历史提取项目线索
- 04提交前检查记忆库链接
MCP 相关
`vulcanus serve` MCP 服务向 MCP 客户端提供回忆、搜索和追加决策等记忆库操作。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
8收录的工具列表 · 更新于 2 周前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| project | string | 是 | 项目名称、ID 或触发词 |
详细介绍
Vulcanus
你的编码 Agent 每次会话开始时都一无所知。 你得重新解释架构、重复已经做过的决定,还得看着它违反你上周定下的规则。上下文存在你的脑海里,也存在早已消失的滚动记录中。
Vulcanus 从源头解决这个问题。它构建一个AI 可读的第二大脑——一个由 Git 进行版本管理、由相互链接的 Markdown 文件组成的知识库,你和你的 Agent 都可以读取——并通过 MCP 提供服务,让 Agent 可以 recall 项目,而不是靠猜。
npm install -g @sunsato/vulcanus
vulcanus
请全局安装:MCP 服务(vulcanus serve)、技能和提交钩子都会运行 vulcanus 命令,因此它必须位于你的 PATH 中。npx @sunsato/vulcanus 可以临时试用,但你为 Agent 配置的任何东西都无法访问它。
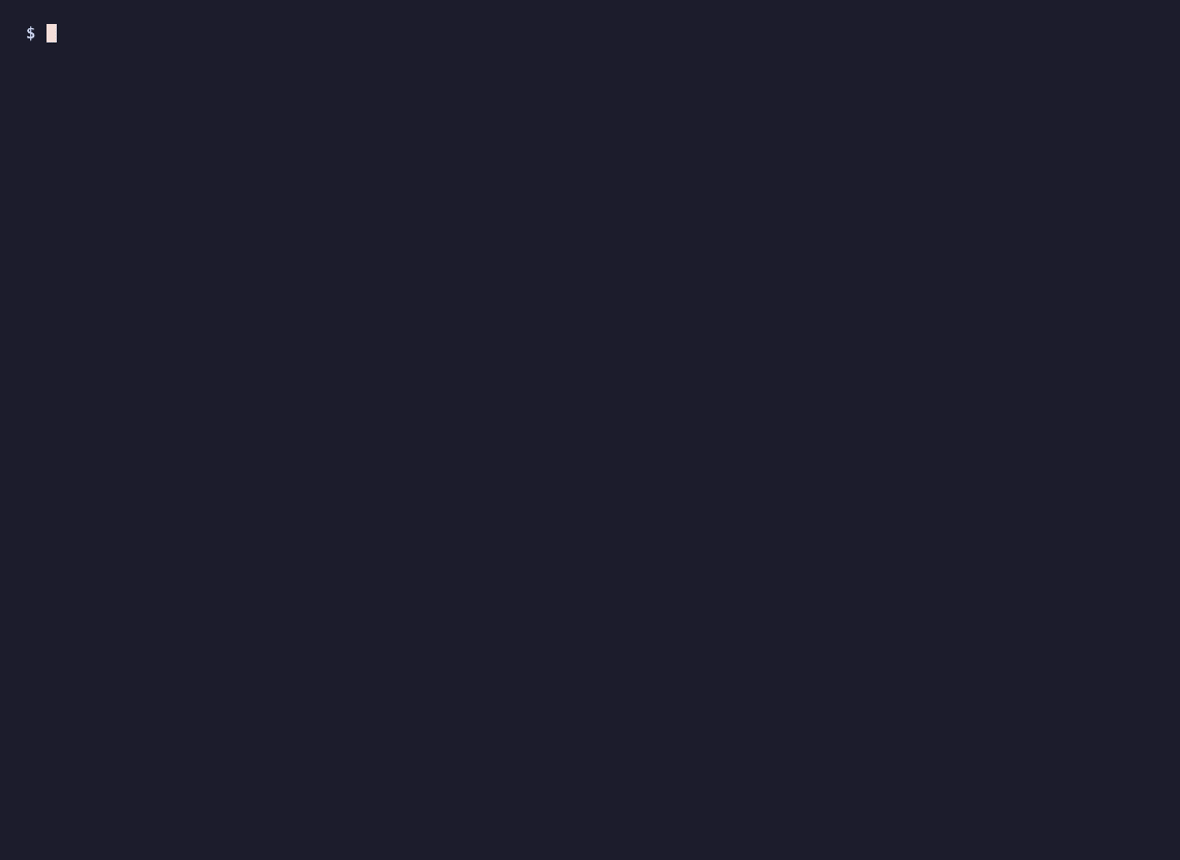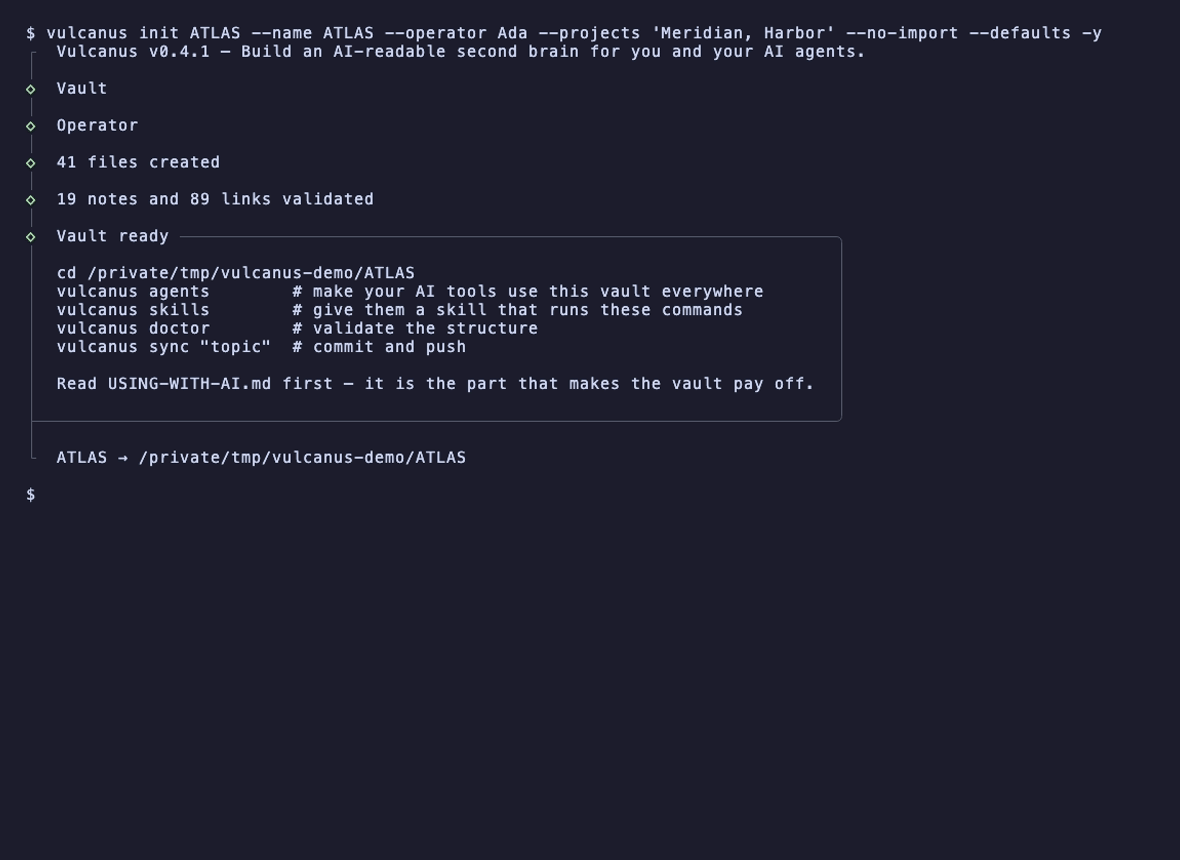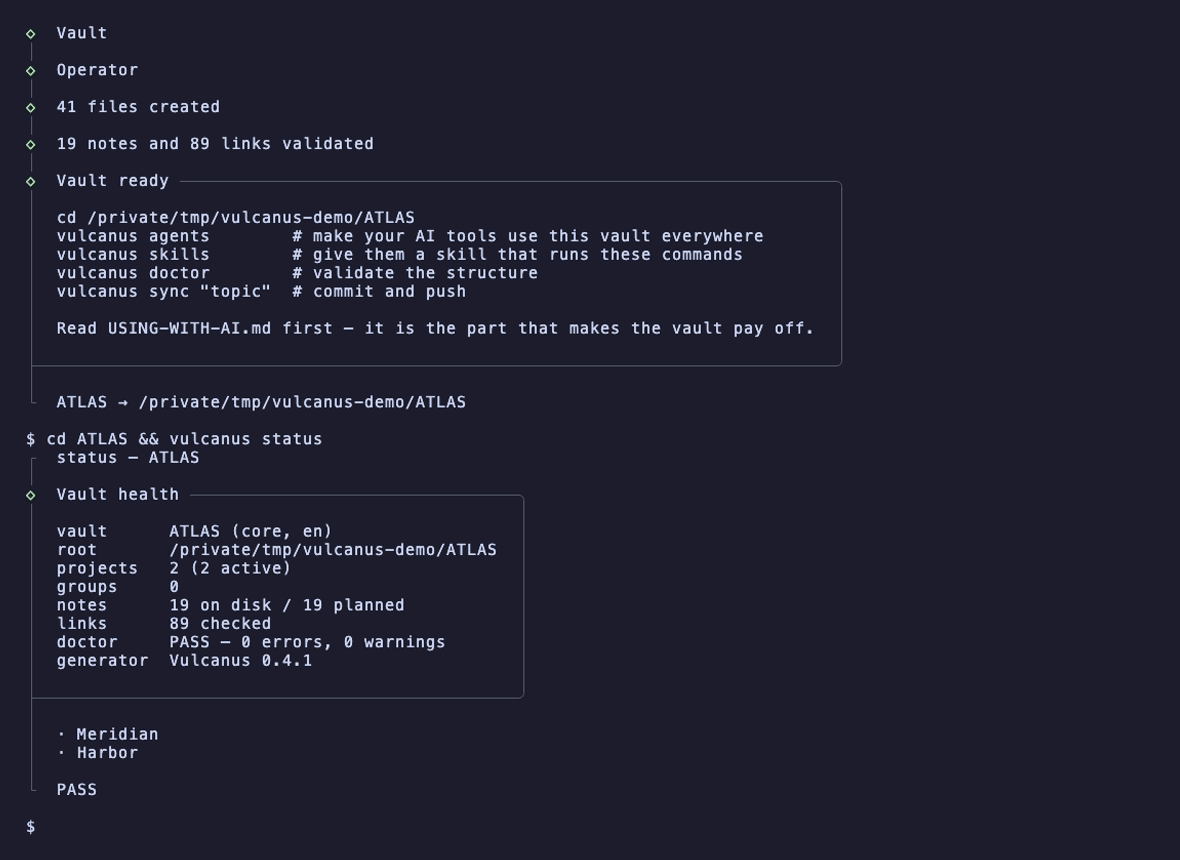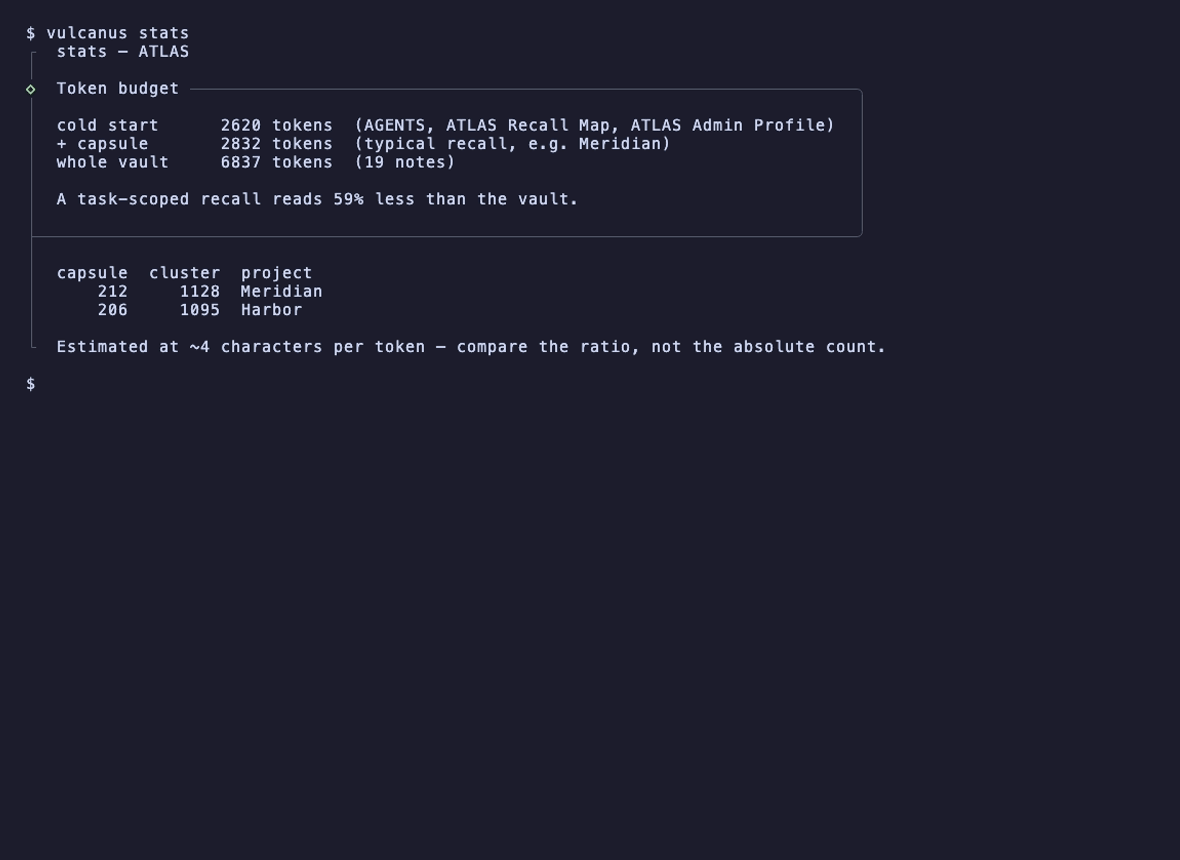
回答几个问题后,Vulcanus 会写入整个知识库——包括路由层、操作者档案、Agent 协议,以及每个项目对应的一个记忆集群——随后验证整个图谱是否确实连通。如果你已经在使用 Obsidian 知识库,它会将记忆结构添加到该知识库中,而不是另建一个。
需要 Node 22.12 或更高版本。它在本地运行:无需账户,也不会自动发起网络请求,除了每天可选的一次版本检查。使用 npm install -g @sunsato/vulcanus@latest 升级。
Sunsato 出品 · vulcanus.sunsato.com
为什么要用知识库,而不是提示词
它要取代的,正是那个不断膨胀的 CLAUDE.md。每项任务都会完整读取它;它会在悄无声息中变得过时,也没有任何东西会检查它声称的内容是否仍然属实。
知识库采用分层结构,因此回忆范围明确:Agent 先读取 Recall Map,然后读取任务所需的那个 Capsule,只有在需要权威依据或详细信息时才深入阅读。vulcanus stats 会在你自己的知识库中衡量这一点——在上方的演示中,按任务范围回忆的读取量比读取整个知识库少 59%。随后,vulcanus doctor 会确保每个链接都能解析、每个项目都可访问,让记忆出错时明确报错,而不是悄悄腐坏。
接入你的 Agent
知识库的价值取决于它能为你的工具提供多少回忆能力,因此,每种工具只需一条命令:
claude mcp add vulcanus -- vulcanus serve # Claude Code, or any MCP client
vulcanus skills --install # skills that run the real commands, in every repo
vulcanus agents # the block to paste into a tool's global instructions
下文的 MCP 服务、技能 和让 Agent 真正使用它将介绍每种工具提供的功能。
它会创建什么
YourVault
├─ AGENTS.md              # the protocol AI agents must follow in this repo
├─ CLAUDE.md              # points Claude Code at that protocol
├─ USING-WITH-AI.md       # how to make every tool recall this vault
├─ README.md
├─ vulcanus.json          # the manifest everything is derived and validated from
├─ .claude/skills/        # invocable skills for Claude Code
├─ .agents/skills/        # the same skills for Codex, Cursor, and Gemini CLI
├─ 00_System/             # Index, Recall Map, Admin Profile, Rules, Update Format …
├─ 02_Projects/           # one cluster per project
└─ _imports/              # raw AI exports, ignored by Git
每个项目集群包含五篇笔记,以及你要求添加的任何专用笔记:
| 笔记 | 内容 |
|---|---|
Capsule | 压缩后的必记摘要,Agent 会首先读取 |
Hub | 导航信息和集群边界 |
Context | 身份、定义、范围 |
Decisions | 已确认的选择和修正 |
Rules | 对未来行为的约束 |
Architecture / Flow / Visual Direction / Content Guidelines | 可选的领域详细信息 |
分层的目的在于节省 Token:Agent 先读取 Recall Map,然后读取一个 Capsule,只有在任务确实需要权威依据或详细信息时才会继续深入。
项目是什么,以及哪些人可以听说它
vulcanus.json 中每个项目的两个可选字段,用于记录无法通过备注强制执行的信息:
| 字段 | 值 | 回答的问题 |
|---|---|---|
kind | umbrella、product、lab、service-brand、client、client-product | 这个项目是什么,以便 Agent 知道如何归类和总结 |
visibility | public、private | Agent 是否可以在知识库之外提及这个项目 |
init 和 add project 会询问这两个字段,并且无论如何都会记录 visibility——“没人说过”和“操作员说是公开的”是两种不同的状态,只有其中一种可以安全地据此采取行动。recall 会返回标记;如果项目是私有的,还会附上不要在任何公开内容中提及它的指示。doctor 遇到不认识的值时会发出警告,而不是导致知识库检查失败,因为否则像 privte 这样的拼写错误会被每个 Agent 当作公开处理。
这是一个信号,不是访问控制:这里的任何机制都不会加密或隐藏文件。
自己维护的备注
生成的系统层是固定列表,因此你在 system 目录下编写的备注原本会被视为未托管,而链接了该备注的 System Hub 则会被视为过度链接——明明没有做错任何事,却会触发两条检查结果。vulcanus.json 中的 systemNotes 用于列出这些备注:
{ "systemNotes": ["Release Notes", "Semantic Index Strategy"] }
这些备注和其他系统备注一样会添加品牌前缀,因此在带品牌的知识库中,Release Notes 会解析为 <Vault> Release Notes。声明备注只会让知识库知道它的存在:备注不会被创建或重写,update 也会跳过它。System Hub 可以链接该备注;如果缺少条目,sync 会添加它;如果声明了备注却从未编写,系统也会报告,以免声明悄无声息地指向空内容。未声明的系统备注仍会被报告为未托管。
首先要问的是是否导入
首先,Vulcanus 会尝试读取现有的 AI 历史记录,并据此提出项目树方案:
| 来源 | 读取内容 |
|---|---|
| ChatGPT 数据导出 | conversations-000.json … 分批文件 |
| Claude.ai 数据导出 | conversations.json + projects.json |
| Claude Code | ~/.claude/projects/**/*.jsonl |
| Codex | ~/.codex/**/rollout-*.jsonl |
| Gemini CLI | ~/.gemini/tmp/**/logs.json 和已保存的 checkpoint-<tag>.json 对话 |
| Cursor | 每个工作区的聊天历史(state.vscdb),通过内置的 node:sqlite 读取 |
| Markdown 文件夹 | 任意备注目录——文件夹名称会作为项目信号 |
系统会自动检测位置,因此通常只需从列表中选择一项。Markdown 文件夹例外:系统不会主动探测,只有你指定路径后才会扫描。
对同一来源重新运行 import 时,只会提议新增内容——知识库的状态目录会记录已读取的对话 ID。--all 会重新读取所有内容。--json 会输出候选项及其依据,但不会写入任何内容。
除非你接受,否则历史记录中的任何内容都不会复制到知识库。 对话会在本地读取,精简为附有证据数量的候选项目名称,然后丢弃。只有你勾选的名称会成为备注;导入日志会记录扫描了多少条对话,但绝不会记录对话内容。
来源本身为对话分组的名称——例如 Claude 项目、仓库目录——是强信号,会默认勾选。仅根据标题出现频率推断出的名称则是提议项,默认不勾选。
你已经做出的决定
你的历史记录通常不只有项目名称:还包括你已经确定的选择和反复坚持的规则。在项目步骤之后,import 会询问是否查找这些内容(--memory 表示直接同意,--no-memory 跳过提问,--memory-only 则跳过项目发现,适用于已经包含项目的知识库)。
- 只读取你自己的消息。助手说的话不代表你的决定。
- 系统会根据英语、土耳其语、德语和西班牙语中的决定与规则短语匹配句子——“we decided”“from now on”“karar verdik”“ab sofort”“a partir de ahora”——并根据短语的强度、在多少段对话中重复出现以及时间新近程度进行排序。问题和代码会被忽略。
- 当对话的来源将其归入某个项目,或对话标题提到该项目时,该对话才会计入此项目。不计入正文中的提及。
- 知识库中已经记录的内容会被排除。如果某个候选项看起来是对现有有效决定的修订,则会作为其替代项提供,这样旧决定会被标记,而不是与新决定相矛盾(参见决定变更时)。
- 你需要逐一审核候选项:接受为决定、接受为替代项、接受为规则、编辑措辞、跳过或停止。每个项目每次运行最多处理 15 项。不会在无人审核的情况下接受任何内容——
--json配合--memory-only只会报告数量。 - 你接受的内容会按你接受时的措辞写入,并附上一行
source:: import · <source> · <date>。跳过的候选项会被丢弃,已审核过的对话会被记录下来,因此不会再次作为候选项提供(与项目发现分开记录,所以两者互不影响)。
--ai-extract [cli] 会将候选句子(而非对话记录)交给已安装的 AI 命令行工具,以合并重复项、去除无关内容并精简措辞;发送前会先向你展示将要发送的内容。返回的任何内容如果无法追溯到提供给它的句子,都会被丢弃。
命令
vulcanus init # create a vault, or add memory to an existing Obsidian vault (default command)
vulcanus status # one-screen vault health: projects, notes, doctor result, git state
vulcanus stats # token budget: what a cold-start agent reads, what recall saves
vulcanus doctor # validate the vault against its manifest
vulcanus add project # add projects and wire them into the graph
vulcanus project remove "Name"        # unlink a project; its notes move to _archive/
vulcanus project rename "Old" "New"   # folder, notes, and every link, in one move
vulcanus project archive "Name"       # mark it archived (--restore undoes it)
vulcanus import # propose more projects from an AI export or a notes folder
vulcanus serve # serve the vault to MCP clients: recall, search, append_decision, …
vulcanus agents # print the block that makes your AI tools use the vault
vulcanus skills # agent skills that run these commands for you
vulcanus update # bring the vault up to date with a newer CLI
vulcanus sync "topic"    # validate, then commit and push
vulcanus sync --watch    # regenerate and revalidate on every edit; never commits
vulcanus hooks install # a pre-commit hook that refuses to commit a broken graph
vulcanus completion zsh # completion script for bash | zsh | fish | pwsh
init 接受 --lang en|tr|de|es、--ai [cli] 和目标目录;add project 和 import 接受 --ai [cli];status 和 stats 接受 --json;doctor 接受 --repair 和 --json;import 接受 --source、--path、--ai-group [cli]、--memory、--no-memory、--memory-only、--ai-extract [cli]、--json 和 --all;update 接受 --dry-run、--force、--profile core|full 和 --json;sync 接受 --dry-run、--json 和 --watch;skills 接受 --raw、--install 和 --force。
所有命令都支持 --verbose 和 --quiet;--json 会隐含启用安静模式,因此标准输出仅包含机器可读内容。
退出码属于约定的一部分:0 表示命令按预期完成,1 表示知识库或操作未通过验证,2 表示命令使用错误(没有知识库、标志无效),130 表示在提示时取消。每次失败都会说明发生了什么、原因是什么以及接下来该怎么做。
以脚本方式运行 init
每个向导问题都可以通过标志回答,因此 init 也可以在没有 TTY 的情况下运行,例如在 CI、容器或 Agent 的 shell 中。一个标志恰好跳过对应的问题;--defaults 会用默认值回答其他所有问题,而 --dry-run 会打印将要创建的目录树,但不会写入:
vulcanus init ./vault --name ATLAS --operator Ada --projects "Meridian, Harbor" --defaults -y
vulcanus init ./vault --name ATLAS --defaults --dry-run   # look before you leap
完整标志列表:--name、--full-name、--tagline、--naming branded|generic、--profile core|full、--operator、--role、--aliases、--projects、--no-import、--git / --no-git、--defaults、--dry-run。
填写项目笔记
每当通过 init、add project 或 import 添加项目时,Vulcanus 都会询问你希望如何填写项目笔记:在此处回答问题、跳过并稍后自行编写,或交给你机器上已安装的 AI CLI。
AI 方式会在 PATH 中查找 claude、codex、cursor-agent(也会以 agent 名称安装)和 gemini,只提供实际存在的选项,并询问每个项目的源代码所在位置——同时建议你过去运行 Claude Code 和 Codex 会话时所在的目录。在启动任何操作之前,它会告诉你哪个 CLI 将接管终端、所在目录,以及具体要编写哪些笔记。未经你确认,不会启动任何进程;而且不能通过标志抑制此确认。
无论选择哪种方式,层级、分组以及要创建哪些专门笔记等简短的结构性问题都会在终端中询问。这些问题决定文件夹布局和生成的系统笔记;必须先确定这些内容,才能创建任何文件,而 AI 会话只有在笔记就绪后才会启动。AI 接手的是笔记正文,这才是实际的工作所在。
系统会要求 CLI 研究代码库,询问你那些无法从代码中找到答案的问题,并按照知识库的约定编写该项目群的笔记。会话退出后,doctor 会立即运行,因此破坏图结构的编辑会及时报告,而不是留待之后才发现。
让 Agent 真正使用它
无人阅读的知识库只是一堆文件夹,因此它自带强制执行层。
在知识库内部工作的 Agent 已经受到约束:AGENTS.md 包含完整协议,CLAUDE.md 会引导 Claude Code 使用该协议,.cursor/rules/vault.mdc 也会为 Cursor 做同样的事。
对于其他所有场景——其他代码库、普通聊天——运行 vulcanus agents。它会输出一段说明,其中包含你的知识库名称、路径和操作人员,供你粘贴到工具的全局指令中:
| 工具 | 粘贴位置 |
|---|---|
| Claude Code | ~/.claude/CLAUDE.md |
| Codex | ~/.codex/AGENTS.md |
| Cursor | Settings → Rules → User Rules |
| ChatGPT | Settings → Personalization → Custom instructions |
| Gemini CLI | ~/.gemini/GEMINI.md |
vulcanus agents --raw 只会输出代码片段,因此可以直接追加到文件中。每个生成的知识库也都包含 USING-WITH-AI.md,其中提供相同的指导。
技能
指令是描述性文本,模型可能会遵循,也可能不会。技能则是一项可调用的能力,因此“同步知识库”会实际运行 vulcanus sync,而不是由模型即兴编造一个等效操作。Vulcanus 会为每种知识库操作编写一个技能,另加一个召回技能,其中包含 Recall Map → Capsule → Hub → Context/Decisions/Rules 路由:
| 技能 | 执行内容 |
|---|---|
<vault>-recall | 不执行任何操作——它会说明读取顺序和权威规则 |
<vault>-doctor | vulcanus doctor,如果缺少结构,则加上 --repair |
<vault>-sync | vulcanus sync --dry-run,然后执行 vulcanus sync "topic" |
<vault>-add-project | vulcanus add project "Name" |
<vault>-import | vulcanus import |
<vault>-update | vulcanus update --dry-run,然后执行 vulcanus update |
技能遵循 Agent Skills 格式:每个技能对应一个目录,其中包含一个带有 name 和 description frontmatter 的 SKILL.md。description 决定模型是否会调用该技能,因此每个技能都会注明知识库、操作者,以及应触发该技能的表述方式。
每个知识库都会在两个位置提供技能——Claude Code 使用 .claude/skills/,Codex、Cursor 和 Gemini CLI 使用 .agents/skills/,这些工具都会读取这个厂商中立的目录。同一份文本的两个副本随知识库一起进行版本管理,这样 Agent 打开仓库后,从第一天起就能开始操作。不支持技能机制的工具会继续使用描述性文本路径;新增的只是一个渠道,而非取代现有渠道。
这只涵盖在知识库内部工作的 Agent,而第二大脑的意义在于随时随地召回信息。为此,技能必须存放在你的主目录配置中,Vulcanus 不会擅自这样做:
vulcanus skills --install
这会将技能写入 ~/.claude/skills/ 和 ~/.agents/skills/,并写入知识库的实际路径,这样其他仓库中的 Agent 就知道应该在哪里运行。Vulcanus 只会在知识库之外写入这一项;这绝不会在 init 期间发生,除非你传入 --force,否则它不会更改现有文件。单独运行 vulcanus skills 会说明将安装哪些内容;--raw 会输出这些文件。
sync 会推送到远程服务,而 update 会重写文件,对于一句聊天指令来说,后果都不小。这两个技能都会要求 Agent 先展示 --dry-run 输出,并在对话中征得你的确认;每个技能也都被要求报告命令的实际输出和退出代码,而不是声称操作成功。技能由文件管理,因此 doctor --repair 和 update 会将模板改进应用到现有知识库中。
MCP 服务
vulcanus serve 会将知识库转化为结构化记忆,供任何 MCP 客户端使用——Claude Code、Cursor 或你自己的 Agent 运行时——而不是临时读取文件:
| 工具 | 作用 |
|---|---|
recall | 返回项目的 Capsule 和待读列表——这是协议的入口——并指出已被取代或已过期的决策或规则 |
search | 按层级进行文本搜索;Capsule 和 Recall Map 中的匹配项优先显示,已被取代或已过期部分中的匹配项排在最后并注明状态 |
list_projects | 路由表:名称、状态、触发词、Capsule 路径 |
append_decision | 以 Decision/Details 格式记录已确认的决策;使用 supersedes 时,还会标记该决策所取代的决策 |
append_rule | 在项目的 Rules 笔记中记录长期规则;使用 supersedes 时,还会标记该规则所取代的规则 |
update_capsule | 替换 Capsule 的一个部分——绝不盲目重写整个文件 |
vault_status | 以 JSON 格式返回 vulcanus status 摘要 |
doctor | 执行完整的结构验证并列出所有发现 |
按客户端要求注册,例如 Claude Code:
claude mcp add vulcanus -- vulcanus serve
从知识库内部(或任意子目录)运行;如果客户端从其他位置启动,则传入 --cwd。全局注册也没问题:服务可从任何位置启动;如果当前目录中没有知识库,工具会说明这一点,而不是让服务启动失败。每次调用时都会重新解析清单和知识库位置,因此在服务运行期间创建或编辑的知识库会立即生效。
recall 还会如实说明自身内容的新旧程度:当 Capsule 比其下方的 Decisions、Rules 或 Context 更旧时,回答会附带过时警告,而不会把过期摘要说成当前信息。
Obsidian
知识库一经创建便是有效的 Obsidian 知识库——无需插件,也无需导入。打开文件夹即可看到图谱,其中已配置最短路径维基链接和重命名安全链接。
已经在使用 Obsidian 知识库?在其中运行 init,Vulcanus 会将记忆结构添加到该知识库,而不是在旁边创建一个独立知识库——系统会自动检测当前目录或其直接子目录中带有 .obsidian 文件夹的目录。检测到唯一一个知识库时会直接使用,不会询问;知识库身份取自文件夹,因此无需回答知识库名称;只有存在多个知识库时才会让你选择。你自己的笔记绝不会被覆盖——生成的文件只会写入尚不存在的位置;如果该文件夹已经是 Vulcanus 知识库,init 会停止并提示你使用 add project 或 update。
图谱视图也可用作健康检查:项目显示为集群,中心是枢纽,未链接的笔记会立即显现。在 Obsidian 中所做的编辑都是纯 Markdown,因此 CLI 和你的 Agent 会立即读取这些更改;vulcanus doctor 则确保手动编辑、Agent 编辑和生成的结构保持一致。
保持更新
vulcanus.json 记录上次写入知识库的 CLI 版本。较新的 CLI 在较旧的知识库上运行时,doctor 会发出警告,而 vulcanus update 会:
- 执行清单架构迁移
- 刷新 CLI 管理的文件,让现有知识库获得模板改进
- 创建新版本新增的笔记(包括升级到
--profile full) - 重新标记生成器版本并验证结果
你自己的笔记绝不会被重写——update 会报告保留原样的笔记数量。这包括 Index、各个中心页和 Import Log:它们保留了你写下的内容,因此会将新项目或更深层的系统层级关联进来,而不是重新生成。AGENTS.md 会进行合并——你添加的章节会保留,协议新增的章节也会加入。--dry-run 会先显示计划;清单不再描述的笔记会被列出,而不会删除。对于由更新版本的 CLI 写入的知识库,CLI 会直接拒绝操作,而不是将其降级。
每条命令执行后,CLI 每天最多检查一次 npm;如果有更新版本,会打印一行提示。设置 VULCANUS_NO_UPDATE_CHECK=1(或 NO_UPDATE_NOTIFIER),或在 CI 中运行,即可关闭此功能;离线时检查会静默失败。
验证
vulcanus doctor 负责确保不断扩展的知识库准确可靠。每项检查都根据 vulcanus.json 派生,因此会随着目录树的变化保持正确:
- frontmatter 是否完整(
type、project、status、tags),以及是否存在重复或空键 - 每个 wikilink 都能解析,且恰好解析到一篇笔记
- 每个中心页都链接到清单所述、归其管理的笔记
- 每篇项目笔记都链接回其所属的中心页
- 每个项目都有一个可从 Recall Map 到达的 Capsule
- 没有重复或大小写冲突的笔记名称
- 原始导出文件和生成状态确实已被 Git 忽略
AGENTS.md描述的是此 CLI 写入的 Agent 协议,而非已被取代的版本.claude/skills/和.agents/skills/中的技能副本没有出现差异- 每个
supersedes::/superseded-by::链接都指向真实标题,双方信息一致,且不存在循环取代自身的情况 - 没有决策已超过其
valid-until::日期却仍被标记为当前有效,也没有 Capsule 链接到此类决策
缺少必需结构属于错误;额外手动添加的链接属于警告,因为知识库本来就应当由人来撰写。
决策发生变化时
不再成立的决策不会被删除——它是历史记录,而且“我们为什么不再做 X 了?”是个合理的问题。决策会改为标记状态,并在标题下添加字段:
## Usage-Based Pricing

supersedes:: [[Acme Decisions#Flat Pricing]]

### Decision

Price per active seat.
## Flat Pricing

superseded-by:: [[Acme Decisions#Usage-Based Pricing]]
superseded-on:: 2026-10-05
仅在某个日期之前有效的决策会包含 valid-until:: 2026-12-31。所有知识库语言中的键名都使用英文;它们是字段,而不是正文。这些字段也适用于规则。
填写一侧后,vulcanus doctor --repair 会补上另一侧——插入缺失的反向引用,不触碰其他内容。提供 supersedes 时,append_decision 和 append_rule 会在一次调用中写入双方信息;如果目标不存在或已被取代,则会拒绝操作且不写入任何内容。recall 会列出不再有效的内容,让 Agent 跳过它们;search 会将它们排在最后;vulcanus status 会统计它们。
仍有错误时,vulcanus sync 会拒绝提交,并如实报告推送结果。
编辑安全性
生成的文件分为三类:
- seed — 所有可以承载你所写内容的文件:每条项目笔记、Recall Map、Index、每个中心页和 Import Log。只写入一次,绝不覆盖。添加项目或深化系统层时,会以精细修改的方式插入缺少的链接,而不是围绕这些链接重新生成文件。
- managed — CLI 完全负责的文件:
CLAUDE.md、Cursor 规则和生成的技能。doctor --repair会重写这些文件。 - merge — 只有
AGENTS.md。它必须兼具两种用途:既是每个 Agent 都会读取的协议,因此新步骤必须能应用于现有知识库;又是你可以自行扩展说明的文件。更新会保留你已有的所有章节,插入协议新增的章节,并刷新版本标记。你自定义章节的措辞变更不会同步到你这里——毕竟,丢失你的自定义内容会更糟。
--force 仍会重写所有内容,包括你自己的笔记。这是唯一会这样做的标志。
知识库命名
你选择的知识库名称会成为知识库的标识:使用默认的 branded 命名时,系统笔记会命名为 ATLAS Index.md、ATLAS Recall Map.md 等,知识库文件夹也会以此命名——因此 Obsidian 会以该名称打开它。若要使用便于移植的 Index.md / Recall Map.md 文件名,请选择 generic 命名。
生成的知识库已为 Obsidian 做好准备:使用最简形式的 Wikilink,链接会随重命名更新,工作区文件不会纳入 Git。
开发
npm install && npm run build && npm test
npm run dev -- doctor
源代码布局:manifest/ 推导所有路径和链接预期,generate/ 将计划转换为 Markdown,doctor/ 根据同一计划验证结果,importers/ 规范化 AI 导出内容,mcp/ 存放 serve 对外提供的、与传输层无关的知识库操作,commands/ 则将其接入 CLI。
CONTRIBUTING.md 介绍检查项、评审标准,以及如何添加导入器或语言。 docs/token-budget.md 评估分层结构实际节省的内容,以及测量方法。
vulcanus.sunsato.com 的着陆页位于 site/ — 这是一个静态文件,由 Cloudflare Workers 作为静态资源提供(wrangler.jsonc)。它通过发布晋级链进入生产环境:每个版本只打包一次,在屏蔽搜索引擎的 webtest 副本上进行测试,并且只有经过测试的包才会在批准后上线。发布前会运行完整的 CI 矩阵,发布后会对已发布的包进行冒烟测试;详情请参阅 CONTRIBUTING.md。
许可证
MIT © Sunsato
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。