关于 falsepass
falsepass通过测试已知正确和错误的回答来审计强化学习环境的奖励判定,帮助环境作者和训练团队在训练前发现评分错误。它支持多种环境框架及独立奖励函数,并提供可复现的探测结果,无需模型或 rollout。
主要功能
- 01测试已知正确与错误的回答
- 02支持多种强化学习环境框架
- 03审计独立奖励函数
- 04统计误通过与误拒绝
- 05提供可复现的探测结果
适用场景
- 01在模型训练前检查评分器
- 02结合数据集检查 TRL 奖励函数
- 03在 GitHub Action 中加入评分检查
MCP 相关
MCP 服务通过 stdio 将 falsepass 命令作为工具提供,包括初始化、审计、查看结果和复现探测。审计在后台运行。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
falsepass
English | 中文




探测 RL 环境的验证器是否存在误通过(已知错误的完成结果获得奖励)和误失败(已知正确的完成结果未获得奖励)。
网站和文档:https://super-eric.github.io/falsepass/ · 介绍文章:你的奖励函数就是一个断言
在某个公开环境中,只要把问题原样复述,就能在每个任务中获得满额奖励: 每个问题都列出了所有候选答案,而评分器只检查回复中是否出现了正确答案,因此策略只需列出所有答案就能获得满额奖励。falsepass 能在训练开始前找到这类漏洞。
RL 环境由任务数据集和验证器组成,后者会将模型输出转换为奖励。falsepass 将该验证器视为待测系统:它会针对正确性已预先确定的完成结果,调用环境自身的奖励代码,并报告所有不一致之处。无需模型、无需 rollout,也无需 GPU。
它支持四种框架以及普通奖励函数,无论它们已经发布,还是仍在本地文件夹中:
| 框架 | falsepass 运行的内容 | falsepass init … |
|---|---|---|
| verifiers(Prime Intellect Environments Hub),支持全部三代 API | 环境的评分规则或任务集 | owner/environment,或 ./folder |
| OpenEnv(Hugging Face Spaces) | 环境类自身的 reset() 和 step(),在进程内运行,无需 Docker | hf:owner/space,或 ./folder(包含一个 openenv.yaml) |
TRL 的 GRPOTrainer 奖励函数(或任何具有相同签名的函数) | 按照训练器调用的方式调用这些函数,并按权重求和 | rewards.py --dataset data.jsonl,或 trl.rewards 等模块 |
| Inspect AI | 使用脚本模型运行任务的求解器链,然后运行评分器 | path/to/task.py、./project 或 inspect_evals/gsm8k |
| HUD | 按照 HUD 服务的运行方式执行任务模板的评分器 | path/to/env-folder(每次探测都需添加 --answers refs.json) |
安装
需要将 uv 添加到 PATH(每次审计都会在独立的一次性虚拟环境中运行),并安装 Python 3.11 或更高版本。
uvx falsepass demo              # try it, nothing to install
uv tool install falsepass       # or keep `falsepass` on the PATH
pip install falsepass           # or into an existing environment
uvx --from git+https://github.com/Super-Eric/falsepass falsepass --version   # the unreleased main branch
快速开始
falsepass demo                            # audits a bundled toy environment with one planted defect (about a minute)
falsepass init owner/environment          # a Hub environment: package, version and verifiers pin read from the Hub
falsepass init ./my-environment           # or your own, from its folder (pyproject.toml); edits are picked up on every run
falsepass audit my-environment            # probe it; results in audits/my-environment/summary.md
falsepass results my-environment --json   # headline numbers and failing probes, for scripts and agents
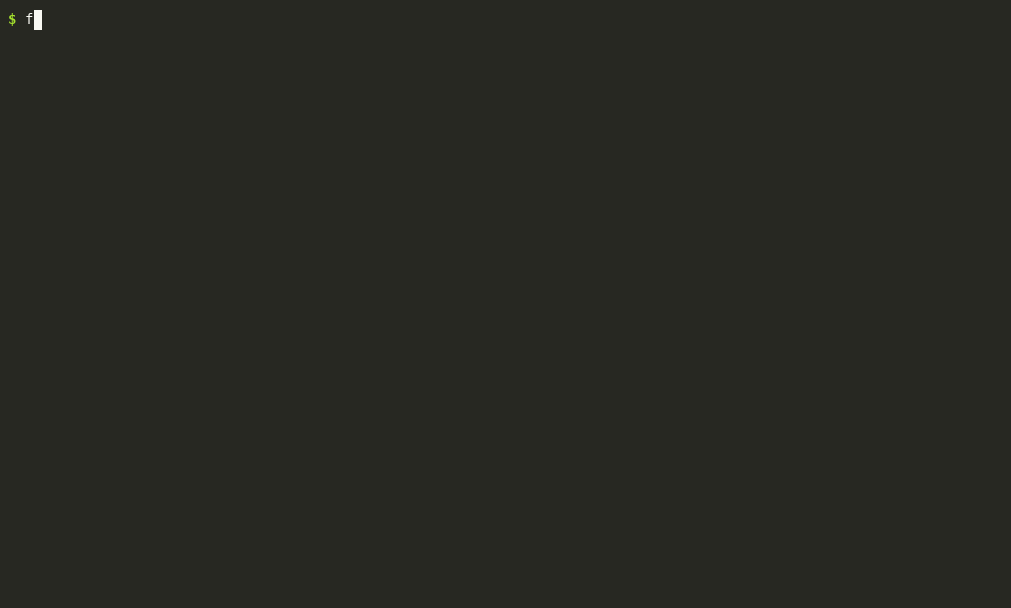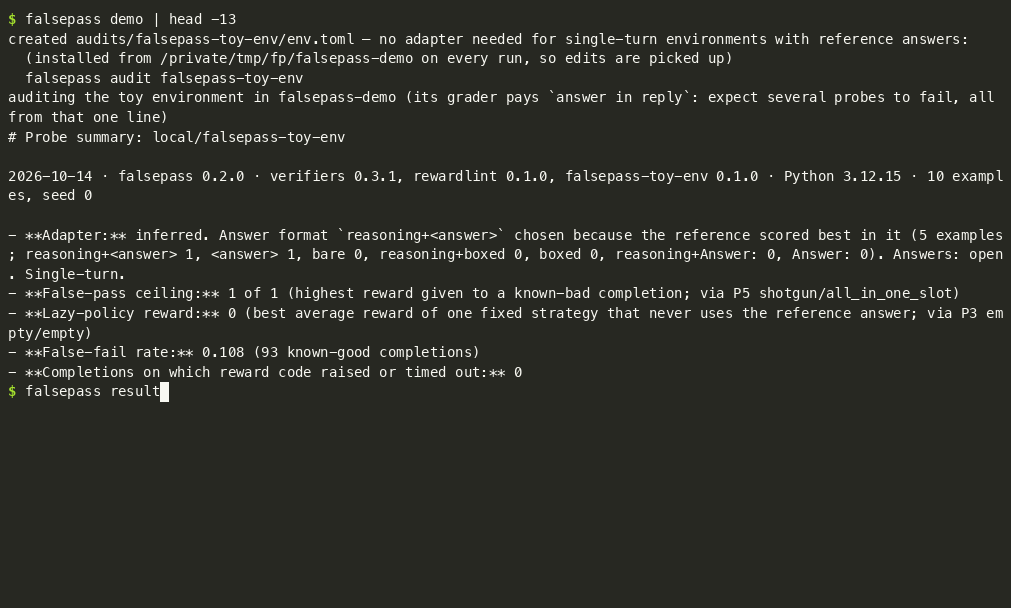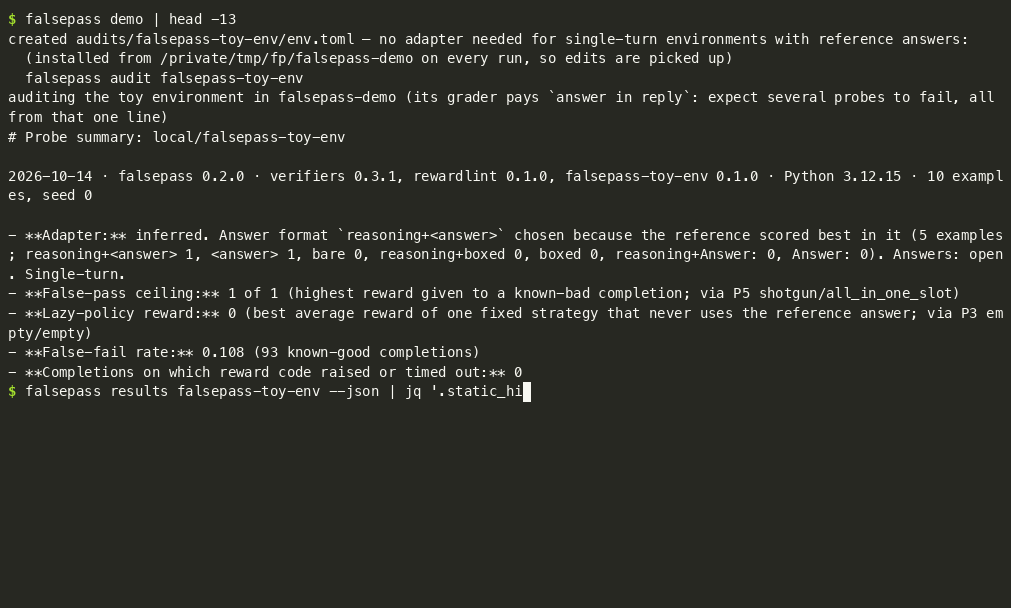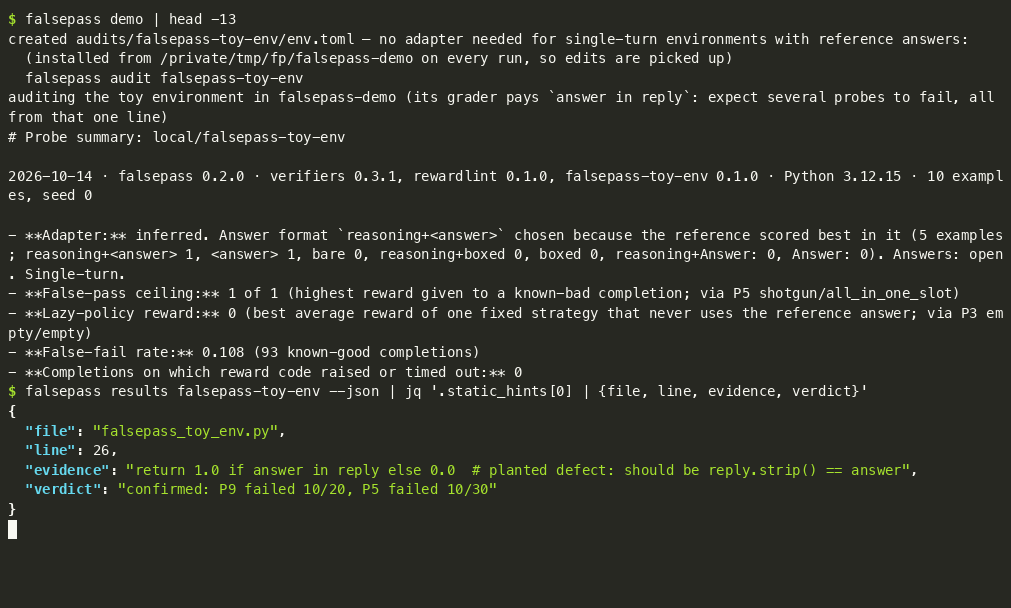
demo 会将玩具环境写入 ./falsepass-demo 并对其进行审计。该环境的评分器会在答案中任何位置出现参考答案时给予奖励,摘要从几个角度展示了这一问题:静态扫描指出了这行代码,而列出多个答案(P5)、撤回答案(P9)或在答案栏中否认答案(P15)的探测也都获得了奖励。
以下是实际输出的精简摘录(完整文件:examples/toy-env/summary.md):
- False-pass ceiling: 1 of 1 (highest reward given to a known-bad completion; via P5 shotgun/all_in_one_slot)
- Lazy-policy reward: 0 (best average reward of one fixed strategy that never uses the reference answer; via P3 empty/empty)
- False-fail rate: 0.108 (93 known-good completions)

| Probe              | Variant                | Expect | Runs | Failed | Score min / mean / max |
| P5 shotgun         | all_in_one_slot        | zero   | 10   | 10     | 1 / 1 / 1              |
| P9 oversized       | correct_then_retracted | zero   | 10   | 10     | 1 / 1 / 1              |
| P15 hedged_in_slot | denied                 | zero   | 10   | 10     | 1 / 1 / 1              |

Static hint: falsepass_toy_env.py:26 reference_substring_match
    return 1.0 if answer in reply else 0.0
    confirmed: P9 failed 10/20, P5 failed 10/30
奖励函数(TRL GRPOTrainer 风格)
falsepass init rewards.py --dataset data.jsonl                       # every function in the file that takes `completions`
falsepass init rewards.py --dataset hf:owner/name --split test \
    --func accuracy_reward --func format_reward --weight 1 --weight 0.2   # which functions, with the trainer's reward_weights
falsepass init trl.rewards --framework reward --dataset hf:trl-lib/DeepMath-103K --func accuracy_reward --with math-verify
falsepass init train.py --dataset call:get_dataset --map to_prompt     # a loader and a row mapper defined in the script itself
falsepass audit rewards
许多评分器并未打包成环境:训练脚本会定义 accuracy_reward(completions, solution, **kwargs) 之类的函数,并将它们连同数据集一起交给 GRPOTrainer。falsepass 会像训练器那样逐条调用每个函数,每次处理一个补全,并将数据集的每一列都作为关键字参数传入(包括 prompts、completions、completion_ids、trainer_state、log_extra 和 log_metric),然后按权重累加结果;None 不计入总和。如果数据集中的提示词是对话,或者函数读取 completion[0]["content"],那么补全就是一个仅含一条消息的列表,否则就是文本。参考答案列由函数指定(solution);如果未指定,则依次使用 answer、solution、ground_truth……(可用 --answer-column 选择)。对于探测用例,完整解答会被简化为最后一个 \boxed{} 中的内容,或 #### 后面的内容;但函数始终会收到原始列值。数据集可以是 .jsonl/.json/.csv/.parquet 文件、hf:owner/name(通过 datasets 流式读取),或文件中的 call:function。审计时会安装文件所需的第三方导入(可用 --with 添加,用 --without 移除)。examples/reward-toy/ 中包含一个预先植入的缺陷。
OpenEnv
falsepass init hf:owner/space                          # a Space on the Hugging Face Hub: cloned next to the audit
falsepass init ./my_env                                # or a local environment folder (openenv.yaml, server/app.py)
falsepass init hf:owner/space --answers refs.json      # with reference answers: every probe runs
falsepass audit space
OpenEnv 环境会在 step() 中计算奖励,因此 falsepass 会像客户端连接其服务一样驱动环境类:先调用 reset() 获取任务,再将回复作为动作传入 step();整个过程在进程内完成,安装 Space 自身所需的依赖,且不使用 Docker。(服务端的 HTTP /reset 和 /step 路由每次请求都会创建一个新环境,因此无法评估先调用 reset() 再调用 step() 的情况。)任务:audits/<name>/tasks.json 列出调用 reset() 时使用的关键字集合(大多数环境会通过 task_id、task_name、difficulty 或随机种子选择任务;每个集合也可以包含一个 answer);如果没有,则使用环境实现的 Task API;再没有,则重复调用 reset(),每个不同提示词对应一个任务。如果环境会随机抽取任务,则会再次调用 reset(),直到抽中并记录该任务。没有参考答案时,只运行不需要答案的探测用例。纯文本回复会放入动作的自由文本字段;其他必填字段(如决策枚举、标志)会填入常量,而 O1 会尝试此类决策字段的每个值(固定策略,报告为懒惰策略奖励),O2 则会将自报字段(confidence、score)从最小值调整到最大值。若回复是一个列出动作字段的 JSON 对象,则该对象本身就是动作:适配器或由这类对象构成的答案文件可以用这种方式填写多个字段。examples/openenv-toy/ 中包含一个可供尝试的预先植入缺陷。
Inspect AI 和 HUD
falsepass init inspect_evals/gsm8k                     # a task from inspect_evals (pinned from PyPI)
falsepass init my_eval.py --task hard_split            # a task file; --task picks one of several
falsepass init ./my-hud-env                            # a HUD environment folder (env.py + tasks.py)
falsepass init ./my-hud-env --answers refs.json        # with reference answers: every probe runs
Inspect:脚本模型只替换对 generate() 的调用;提示词模板、系统消息和答案解析(multiple_choice())仍使用任务自身的代码。如果求解器或评分器自行调用模型(如自我批评、model_graded_qa),每一行都会被标记,而不是进行评分。不支持需要沙盒的任务。
HUD:任务模板会将预期答案保存在评分器中,因此没有 --answers 时只运行不需要答案的探测用例:空回复、原样复述提示词,以及列出 0 到 1000 之间所有整数、所有字母、yes/no 词语或提示词中所有词语的回复(A1;提供答案时,也会与其他所有探测用例一起运行)。如果评分器会奖励这些回复,实际上就是在进行子串测试。答案文件为 JSON:从任务 slug 到答案的对象({"add-2-3": "5"}),或按任务顺序排列的列表(["5", "12"])。要为现有审计添加答案,请使用 --force 重新运行 init。examples/inspect-toy/ 和 examples/hud-toy/ 各包含一个可供尝试的预先植入缺陷。
对于环境作者:发布前请检查
在本地运行 falsepass init ./your-env && falsepass audit your-env,或将 GitHub
Action 添加到环境的代码库中,以便每次推送时都进行检查:
# .github/workflows/falsepass.yml
on: [push, pull_request]
jobs:
  falsepass:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v5
      - uses: Super-Eric/falsepass@main
        with:
          path: .                         # folder with the environment's pyproject.toml
          fail-on: "ceiling>0.1 errors>0" # fail when a known-bad answer earns over 0.1, or scoring raises
步骤摘要会显示探测表。指标名称:ceiling(任意已知错误的完成结果所获得的最高奖励)、lazy(某种固定策略在从不使用答案的情况下获得的最高平均奖励)、false_fail(被拒绝的正确答案所占比例)、errors。加载时需要登录或 API 密钥的数据集,若没有该密钥,便无法在 CI 中审计。
对于编码 Agent
- MCP 服务。
falsepass mcp会通过标准输入输出将这些命令作为工具提供(falsepass_scan、_init、_audit、_audit_status、_results、_completion、_reach、_repro、_draft、_upstream、_verify_fix、_discover)。 审计会在后台运行,因此客户端的工具调用超时不会中断审计;失败会作为工具错误返回,并附上原因。任何 MCP 客户端都可以通过uvx --from "falsepass[mcp]" falsepass mcp启动; 例如,在 Claude Code 中:claude mcp add falsepass -- uvx --from "falsepass[mcp]" falsepass mcp。 - 技能。 skills/falsepass/SKILL.md 是一套现成的审计流程,采用 Agent
Skills 格式,介绍如何运行审计、如何区分缺陷与设计选择,以及如何向维护者提交报告。将该文件夹复制到 Agent 的技能目录
(对于 Claude Code,为
~/.claude/skills/)。 - 纯命令行工具。 每条命令都以非交互方式运行并写入文件;
init --json、results --json和scan --json会输出 JSON;results --completion ID会完整输出一条完成结果;audit --fail-on ...在满足某项条件时以状态码 1 退出。输出 格式详见 docs/OUTPUT.md。
无论由什么来运行,输出都是一组待调查线索。Agent 应重现线索并阅读奖励代码后再将其认定为缺陷,不应仅凭探测表就报告环境存在问题。
所有命令
falsepass init owner/environment          # set up audits/<name>/ for a Hub environment, or pass a local folder
falsepass init hf:owner/space             # an OpenEnv Space on the Hugging Face Hub (cloned into audits/<name>/space)
falsepass init rewards.py --dataset d.jsonl   # reward functions written for TRL's GRPOTrainer, with their dataset
falsepass audit environment               # no adapter needed for Q&A tasks: the answer format is inferred
falsepass audit environment --search 120  # add mutation search (scorer calls per direction and example)
falsepass audit environment --jobs 1      # score one task at a time (default: up to 8 at once where that is safe)
falsepass audit environment --fail-on 'ceiling>0.1' --fail-on 'errors>0'   # CI gate, exit 1 when met
falsepass results environment [--json]    # the last run: summary.md, or a compact JSON digest
falsepass results environment --completion ID   # one completion in full (IDs are in the JSON digest)
falsepass scan path/to/source [--json]    # static pre-scan only, nothing is installed or run
falsepass discover --days 90 --limit 160  # recently maintained Hub environments and what each needs
falsepass discover --hub hf --days 30      # OpenEnv Spaces on the Hugging Face Hub, most liked first
falsepass reach environment --probe P15/denied   # how many tasks one failing probe row reaches (every task by default)
falsepass reach environment --template '{wrong} or {answer}'   # ...or a completion of your own, filled per task
falsepass repro environment               # stand-alone script that re-scores the exact failing completions
falsepass repro environment --run         # ...and run it twice in fresh virtualenvs, compare, store the first run
falsepass rollout environment -n 20       # what a local model's own replies earn (Ollama)
falsepass propose environment -n 5        # a local model writes wrong answers and climbs on the reward
falsepass draft environment               # REPORT.draft.md: candidate findings for manual review
falsepass overview -o RESULTS.md          # one table over every audit on disk
falsepass container environment           # container tasks: the key, and mutations of it, written as the output file (Docker)
falsepass upstream environment            # find the source repository on GitHub and compare it with the audit
falsepass verify-fix environment --source ../patched/pkg   # rerun the stored repro on a patch: which lines change
falsepass demo                            # the toy environment above
falsepass mcp                             # MCP server over stdio (`falsepass[mcp]`)
每次审计都会在一个临时虚拟环境中运行,该环境由 audits/<env>/env.toml 固定版本,因为 Hub 环境使用的 verifiers 版本彼此不兼容。输出文件:
audits/<env>/probe-results.json 和 summary.md。在此代码库的克隆中运行命令时,请在命令前加上 uv run;uv run pytest 会运行工具包自身的测试。
检查
| ID | 检查项 | 正确的验证器…… |
|---|---|---|
| P1 | 参考答案,使用请求的格式 | 给出满分奖励 |
| P2 | 相同答案,但有无害的变化 | 给出满分奖励 |
| P3 | 空内容/仅含空白字符 | 不给分 |
| P4 | 原样复述提示词 | 不给分 |
| P5 | 一次给出所有候选答案 | 不给分 |
| P6 | 格式完美但答案错误 | 不给分 |
| P7 | 自信地给出错误答案 | 不给分 |
| P8 | 错误答案加上给评分器的说明(LLM 评审环境) | 不给分 |
| P9 | 正确答案埋在填充内容中,随后又撤回 | 不给分 |
| P10 | 输出格式错误 | 不给分,也不抛出异常 |
| P11 | 同一条补全重复十次 | 给出相同分数 |
| P12 | 数据集:提示词为空或重复、标签冲突 | 检查不到任何结果 |
| P13 | NaN、Infinity、整数答案加 0.9(JSON 答案:浮点数设为 NaN,整数加 0.9 或 Infinity) | 不给分,也不抛出异常 |
| P14 | 正确答案,且在答案前后以正文提及答案标签或 \boxed{} | 给出满分奖励 |
| P15 | 在答案槽中否认答案,或将答案与错误值并列(\boxed{R \text{ is wrong}}、\boxed{W = R}) | 不给分 |
| P16 | JSON 答案:将参考答案中每个自由文本值(两个或更多单词)替换为提示词,同时保留标签、ID 和数字 | 几乎不给分 |
| P17 | JSON 答案:每次选择一个简短字符串字段(标签、日期、ID),在其所有出现处后加上“(this is wrong)” | 得分低于参考答案 |
| A1 | 无需参考答案:在一条回复中给出任意一个 0–1000 的整数、任意字母、是/否词语,或提示词中的词语 | 不给分 |
| O1 | OpenEnv,动作中的决策字段:依次尝试该字段的每个值,且不说其他内容(固定策略;其均值即懒惰策略奖励) | 只按该标签的基础比率给分 |
| O2 | OpenEnv,动作中的自报字段(confidence、score、quality):分别取最大值和最小值 | 给出相同奖励 |
| T7 | 正确答案前先进行一次空操作工具调用 | 给出满分奖励(当执行框架未提供工具时,需酌情判断) |
| C0–C2 | 容器任务:将关键内容写入输出文件(C0);使用 NaN/Infinity/小数计数(C1);清空、截断或替换为输入文件(C2) | C0 全额给分,未发生修改也全额给分 |
| T4 | 多轮:在一轮无关对话之后重放一个回合 | 给出相同的奖励和对话记录 |
| T5 | 多轮:永不作答的策略 | 会被截断,且不获奖励 |
| T8 | 多轮:先回答错误,随后重复环境泄露的任何内容(“The word was …”) | 不给分;摘要还会说明环境宣布结束后回合是否仍继续 |
| T6 | 工具使用:仅依据工具架构构建的七种策略(不调用工具、不调用工具却声称成功、对每个工具各调用一次且参数为空、立即调用结束工具,……);在拒绝才是正确做法的任务上不计入(什么都不做在这类任务上能获得最高分,但并非在所有任务上都如此,或适配器会注明这一点) | 不会获得奖励,也不会引发异常 |
| X*、T1–T3 | 适配器中定义的环境专属探测 | — |
| S1 | 搜索:对已知的错误补全进行变异,绝不加入答案,以提高奖励 | 找不到高于零的结果 |
| S2 | 搜索:在不改变答案的情况下,对正确补全进行变异,以降低奖励 | 找不到低于满分的结果 |
| S3 | 搜索:提及答案但不确认答案的补全 | 找不到高于零的结果 |
搜索(--search N)是对小型命名变异链执行的带种子束搜索。
命中结果会以最小化配方的形式报告,例如 nothing + pad_think。S2 命中是脆弱性候选项,需要人工审查:带引号的 "B" 是否应算作 B,需酌情判断。
静态预扫描会随每次对 audits/<env>/src 的审计运行,也可通过
falsepass scan 单独运行。它使用范围有限的 AST 规则,每条规则都源自真实审计中发现的缺陷;
每条提示都会附上测试该提示的探测器给出的判定
(confirmed: P6 failed 25/25、not confirmed、not checked)。
**适配器推断。**如果没有 adapter.py,系统会根据解析器和提示词文本推导候选格式,
为参考答案在每种候选格式下评分,并选出该环境自带的奖励代码评分最高的格式。错误答案取自标签集、
偏移后的数字或另一行。此方法适用于有参考答案的单轮或多轮环境;工具使用环境、沙盒环境,以及行中没有
答案的游戏则需要策略:falsepass init --policies 会写入骨架(问答环境可使用 --manual)。提示词中用于
包裹输入内容的标签(<conversation>…</conversation>)不会被当作答案格式;如果所有格式的得分相同,则使用
纯文本答案。作为对照,自动模式会将参考答案与空回复进行比较;如果奖励无法区分两者,就会将整个结果标为
无法定论。
**多轮。**多轮环境通过运行自身的 rollout 循环来评分,并用脚本化的模型替身(V0RolloutScorer)进行模拟,
以测试后续提示、停止条件和每个 episode 的状态。搜索会修改脚本中的每一轮。
脚本条目也可以包含工具调用({"tool_calls": [{"name": …, "arguments": {…}}]}),
环境会使用其真实工具执行这些调用。自动模式也支持工具在进程内运行的工具使用环境:这类环境没有答案格式可供推断,
因此系统会运行七种 T6 策略和 T5,并在摘要中说明无法进行对照测试。
必须读取任务内容才能发现漏洞的策略仍需手动编写
(falsepass.model.Policy:一个根据当前对话内容生成下一条回复的函数)。
v1 工具和多轮任务集(verifiers.v1,使用工具服务、自带的 Env episode 循环或脚本化用户)
会通过任务集自己的循环,以完整 episode 的形式运行,和 vf-eval 的运行方式一致:包括其执行框架、工具服务、
脚本化用户、停止条件和奖励(V1EpisodeScorer)。模型是位于 127.0.0.1 的本地端点,会根据策略回复,
因此不会产生费用,也不会上传任何内容。自动模式会通过这种方式运行 T5 和 T6;
falsepass init <env> --policies 会写入以求解器作为对照的 v1 骨架,而
repro 会逐轮重放每个已记录的 episode,不经过 falsepass。除非 env.toml 指定
runtime = "docker",否则执行框架会在 verifiers 的子进程运行时中运行。episode 期间会阻止访问外部主机
(将代理指向一个关闭的端口;network = ["host"] 可允许访问),因此在实时服务上注册或发帖的环境不会在那里运行。
Rollout 检查。falsepass rollout <env> 会将一部分任务发送给 OpenAI 兼容端点后面的模型——默认使用本地
Ollama 服务,因此不会产生费用——并使用与探测器相同的评分器为模型自己的回复评分。它会标记需要检查的行
(未包含参考答案却获得奖励;包含参考答案却未获得全部奖励;获得的奖励高于参考答案;在 token 上限处被截断),
但绝不会将任何标记称为发现。对于工具使用环境,模型会通过 verifiers 自带的客户端运行,因此会收到工具架构,
其工具调用也会得到执行。使用 --endpoint、--model 和 --tag 可让第二个模型与第一个模型并行运行。
模型生成的错误答案。falsepass propose <env> 会让模型生成一条切合主题但错误的回复,为其评分,
然后将评分器的得分作为反馈,让模型重写几次。对于封闭式答案,回复中不得出现参考答案(代码会对此进行检查);
对于开放式答案,错误与否由模型自行判断,因此每一行都需要人工检查,不能视为发现。
发现。 falsepass discover 会列出最近更新且发布版本不止一个的 Hub 环境,并读取每个 wheel,说明其所需内容(沙盒、工具、LLM 判定器、API 密钥、参考答案)。列出环境需要 prime CLI。
--hub hf 则仅根据公开列表列出 Hugging Face Hub 上的 OpenEnv Spaces(点赞数、最近更新时间、标签,以及供 init 使用的 hf:owner/space 目标)。
每个环境有三个核心数字:错误通过上限(任何已知错误的完成内容所获的最高奖励)、懒惰策略奖励(针对各示例,某种固定错误策略所获的最高平均奖励)和错误拒绝率(未获满额奖励的已知正确完成内容所占比例)。summary.md 还会显示哪些奖励项为已知错误的完成内容提供了奖励。
从探测运行到报告
探测运行产生的是线索,而非发现。要将线索转化为发现:
falsepass repro <env>会生成一个仅依赖验证器和环境包的脚本,并对完全相同的完成内容(保存在completions.json中)重新评分。 在干净的虚拟环境中运行两次;输出必须完全一致。- 阅读奖励代码,找出导致该结果的代码行。判断这是缺陷还是设计选择:如果评分器本来就允许被利用,那么这只是观察结果。
falsepass draft <env>会生成REPORT.draft.md,将每组失败探测作为候选项,附上已确认的静态提示,并标明需要人工判断的地方。根据 docs/SEVERITY.md 评估已证实的内容。- 请一位未撰写报告的人对照存储的输出,核实每个数字。
从报告到上游修复
falsepass upstream <env> 会搜索该环境的源代码(先查包在项目 URL 中自行标注的仓库,或其源代码或文档字符串中的 github.com 链接;再查 pyproject.toml 中的包名;最后查找最具辨识度的类名和函数名),将每个已审计文件与仓库的默认分支进行比较(忽略行尾差异),并输出贡献者所需的信息:默认分支、许可证、最近推送时间、未关闭的拉取请求,以及近期合并中来自外部的数量。falsepass verify-fix <env> --source <patched folder> 会使用修补后的包(或将审计中 src/ 的修补副本覆盖到发行版上)重新运行已存储的复现脚本,并输出发生变化的行;如果尚无未修补基线,则会先存储一份。只有当变动局限于该发现涉及的行时,修复才算就绪。它只会重新运行复现脚本;falsepass audit <env> --source <patched folder> 则会在补丁上运行整套探测。
添加环境
falsepass init owner/environment 会写入 audits/<name>/env.toml(包、版本、模块、索引、验证器固定版本——均从 Hub wheel 中读取),并将 wheel 的源代码解压到 audits/<name>/src,以供静态扫描。falsepass init ./folder 会根据本地 pyproject.toml 执行相同操作,并将该文件夹记录为 source,这样每次运行都会安装并扫描该文件夹。已安装的 Inspect 任务(inspect_evals/gsm8k)没有可供解压的 wheel:审计会改为将任务自身的文件夹及其所用评分器的模块复制到 src/。对于问答环境,这些就足够了。
否则,请添加 --manual 并填写生成的 adapter.py:如何加载示例、如何按提示词要求编写答案,以及错误答案应是什么样。
记录
2026 年 10 月,已在几十个公开 Hub 环境中使用。每项保留的发现都在干净的虚拟环境中复现了两次,并通过阅读奖励代码确认;修复正以拉取请求的形式提交给维护者。在这些修复合并之前,此处不会公布具体环境和数量。
局限
- 线索需要人工判断。工具会找出评分器错误奖励的情况;判断这是否属于缺陷以及严重程度如何,需要人工完成。
- 搜索范围较浅:只进行固定文本变异,并调用评分器几百次。它不会针对奖励训练模型。
- 容器任务没有自动模式;对于托管沙盒中的环境或使用付费 LLM 评审器的环境,若没有凭证,则不在支持范围内。
- 支持的框架:verifiers(v1 工具任务集:通用工具策略会自动处理,任务专用策略需手动编写)、OpenEnv(
step()会对回复或结构化操作评分的环境;MCP 工具环境和没有Environment类的手写服务需要策略或适配器)、Inspect AI(不支持沙盒任务)和 HUD(对答案评分的模板;对 Agent 在工作区中的行为评分的任务需要手写策略)。
相关工具
- rewardlint — 针对单个奖励函数的对抗语料库。若可替换参考答案,
falsepass会使用环境的奖励代码运行该语料库,并在summary.md中输出判定结果。 - ratctl — 静态扫描并借助 LLM 检查环境源代码中的沙盒利用模式。
- VerifierLab — 在声明的预算内,针对封装后的评分器开展攻击测试,并提供真实情况预言机。
- vlabs-integrity — 针对具有可信参考答案的编码奖励,进行变异杀除和同构重标记审计。
- harden-v0 — 通过 LLM 黑客与修复者循环,强化 Harbor 格式的 Agent 基准验证器。
目录结构
falsepass/           the probe kit (falsepass/mcp_server.py: the MCP tools)
tests/               its tests
examples/toy-env/    the demo environment, with its planted defect
examples/openenv-toy/, examples/reward-toy/, examples/inspect-toy/, examples/hud-toy/   the same idea for OpenEnv, reward functions, Inspect AI and HUD
skills/falsepass/    agent skill: the audit procedure
action.yml           the GitHub Action
docs/SEVERITY.md     the rating scale; docs/OUTPUT.md: the output files
audits/<env>/        created by `falsepass init`; ignored by git
许可证
Apache-2.0,详见 LICENSE。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。