关于 Vidlizer
Vidlizer 是面向需要解析视频、图片和 PDF 的用户的命令行工具,可将画面与语音整理为按场景划分的结构化 JSON。支持本地视觉模型或 OpenRouter,并提供多种输出格式及 MCP 工具。
主要功能
- 01解析视频、图片、PDF 和 URL
- 02按场景生成结构化 JSON
- 03支持本地模型与 OpenRouter
- 04识别语音并合并到场景
- 05提供 JSON、Markdown 和文本输出
适用场景
- 01整理视频中的场景、人物和文字
- 02提取 PDF 或图片中的视觉信息
- 03按指定时间范围分析视频片段
MCP 相关
提供 MCP 服务,包含 analyze_video 工具,可供 Claude Code、Cursor 和 Claude Desktop 等 MCP 客户端调用。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
vidlizer
输入视频、图像或 PDF,即可按场景获取结构化 JSON。


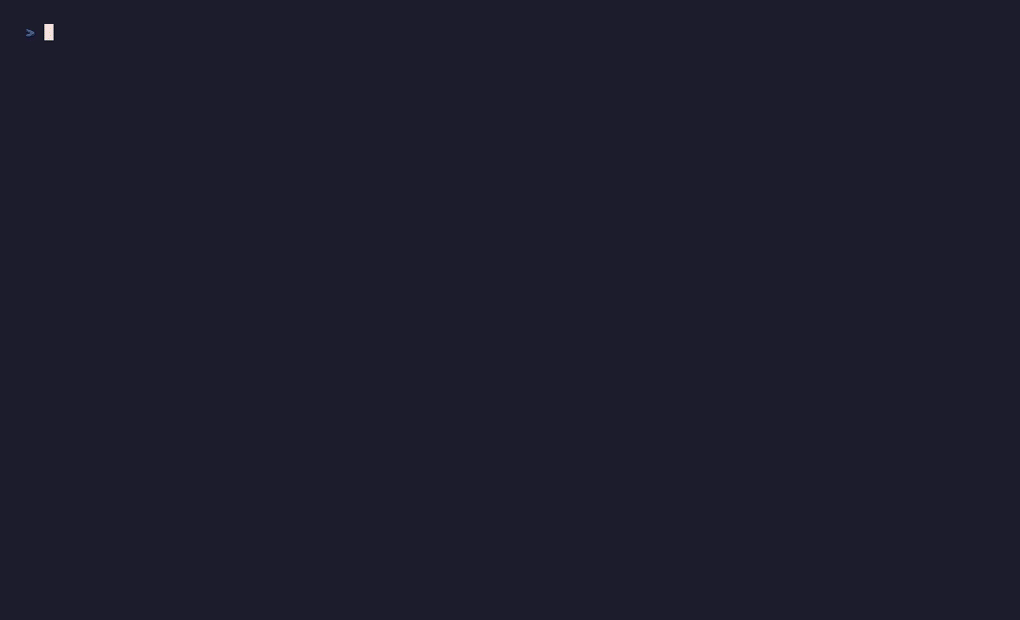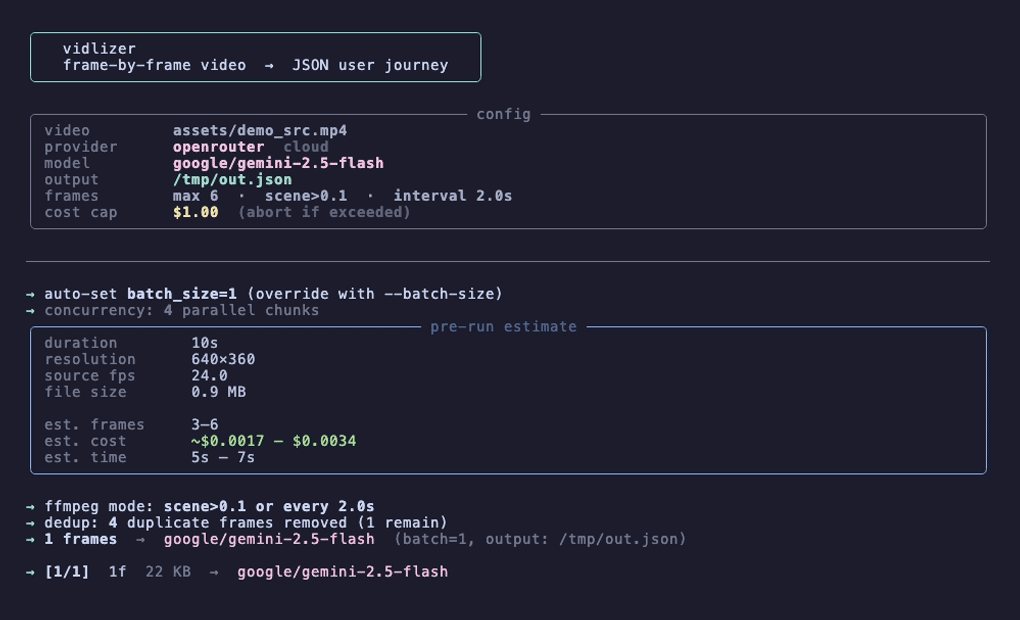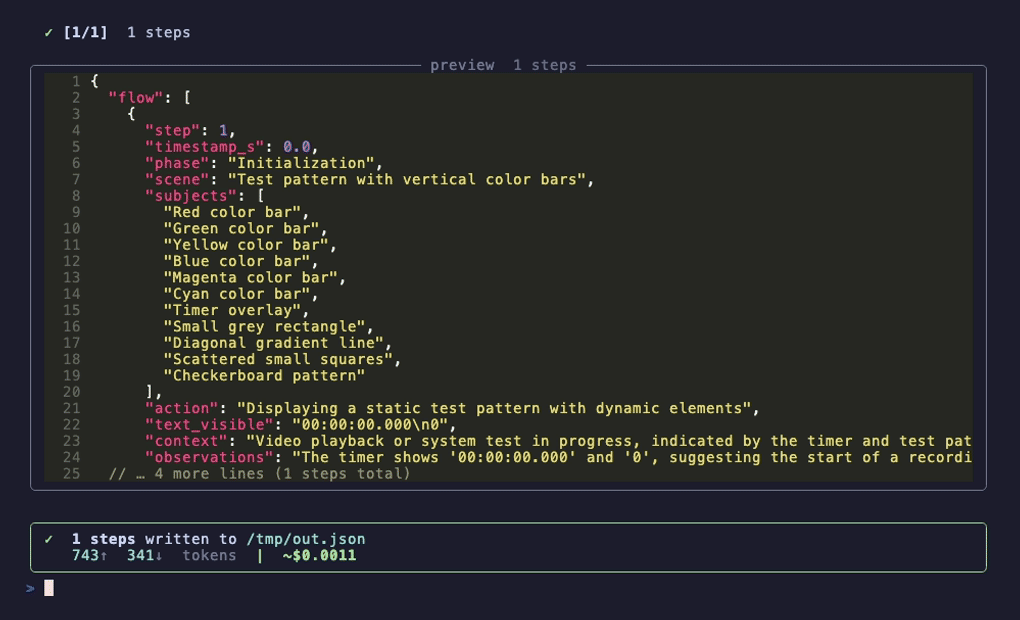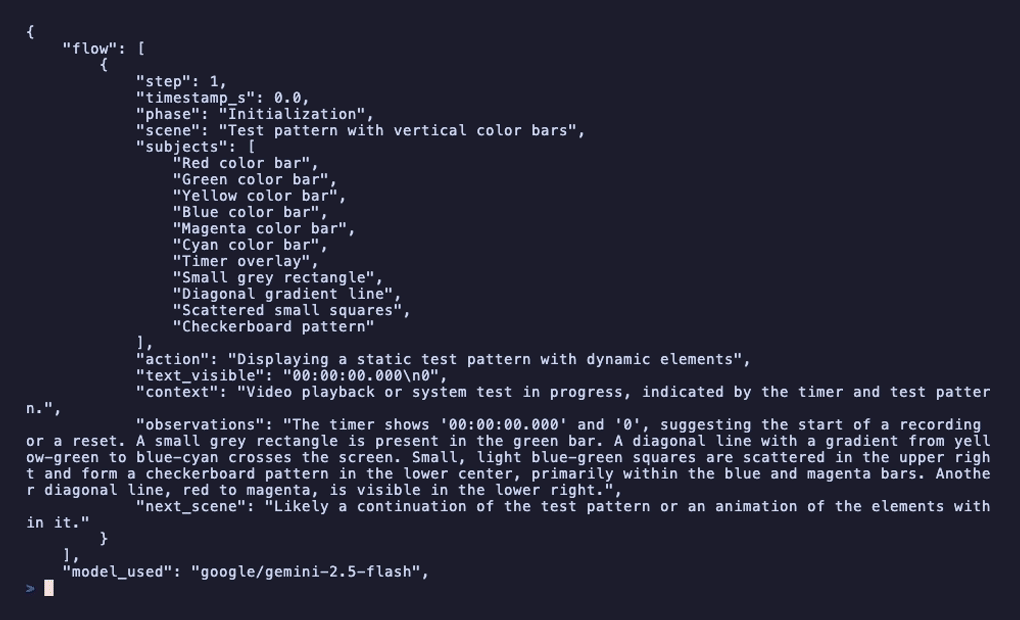
vidlizer 使用 ffmpeg 从任何视频、图像或 PDF 中提取帧,将它们发送给视觉大模型,并返回一个 flow 数组——每个场景对应一个条目。每个条目会说明发生了什么、画面中有哪些人、显示了哪些文字,以及发生了哪些变化。如果视频带有音频,它会使用 Apple MLX Whisper 转录音频,并将语音合并到每个步骤中。
可通过 Ollama 或任何兼容 OpenAI 的服务(LM Studio、vLLM、oMLX)完全在本地运行——无需 API 密钥,数据不会离开你的设备。也可以连接 OpenRouter 使用云端模型。vidlizer setup 会检测已安装的组件,并在一分钟内写好配置。
vidlizer demo.mp4
vidlizer "https://youtube.com/watch?v=..."
vidlizer screenshot.png
vidlizer document.pdf
✨ 功能
- 支持任意输入 — 本地视频、图像(jpg/png/webp/…)、PDF 或 URL(YouTube、Loom、Vimeo、Twitter)
- 4 种提供方 — Ollama(完全离线)、LM Studio(端口 1234)、oMLX(Apple Silicon,端口 8000)、OpenRouter(云端)——按此顺序自动检测
- 跨提供方回退 — 主模型失败时自动切换提供方(例如从 oMLX 切换到 OpenRouter)
- JSON 修复 — 模型输出格式错误时,会重新发送给模型修复后再跳过;可从不完整的 JSON 中恢复
- 免费模型保护 —
:freeOpenRouter 模型会自动强制设置concurrency=1,以遵守速率限制 - 3 种输出格式 —
--format json(默认)、summary(按阶段显示纯文本)、markdown(每个步骤为一个章节的文档) - 用量跟踪 —
--stats可显示所有运行中各模型的 token 和费用明细;提供get_usage_stats()MCP 工具 - 自动转录 — 检测音频并使用 Apple MLX Whisper(Neural Engine)转录,将语音合并到每个 flow 步骤中
- 感知去重 — 发送前移除近似重复的帧(节省 token)
- analyze_moment — 使用
--start/--end标志聚焦指定时间范围 - 内存缓存 — 再次处理同一文件时会跳过 API 调用
- 费用保护 — 支出超过
MAX_COST_USD(默认值为 $1.00)时中止 - 实时进度 — Rich 流式指示器会显示每批任务的耗时和 token 数量
- MCP 服务 — 可在 Claude Code、Cursor、Claude Desktop 中使用;通过环境变量锁定提供方/模型;结果包含
model_used+provider_used - 自动安装 — 缺少
ffmpeg时会通过 brew 安装;默认安装包已包含mlx-whisper(macOS) doctor --fix— 交互式修复向导:通过 Homebrew 安装缺失的 ffmpeg/Ollama/LM Studio,重新运行vidlizer setup以配置.env,并升级 mlx-whisper- 原生支持 Mac — 文件选择对话框、Apple MLX 转录,可处理 macOS Unicode 文件名(例如“11:26 AM”)
📦 要求
- macOS(推荐使用 Apple Silicon,以加快转录速度)
- Python 3.10+
- Ollama 模式:Ollama 已安装,并已拉取视觉模型(需要 5 GB+ RAM)
- LM Studio 模式:LM Studio 0.3.16+,并已加载视觉模型
- 云端模式:OpenRouter API 密钥
如果未安装 ffmpeg,首次运行时会通过 Homebrew 自动安装。
🚀 安装
选项 1 — uvx(无需安装,直接运行)
uvx vidlizer setup
选项 2 — pipx(隔离安装,全局可用)
pipx install vidlizer
vidlizer setup    # interactive wizard: detects providers, writes .env
选项 3 — pip / virtualenv
pip install vidlizer
vidlizer setup
选项 4 — 从源代码安装
git clone https://github.com/arizawan/vidlizer.git
cd vidlizer
python -m venv .venv && source .venv/bin/activate
pip install -e .
vidlizer setup    # or: cp env.sample .env
首次运行向导
vidlizer setup 会检测所有已安装的提供商,让你选择主要提供商和备用提供商,并为你写入 .env。如果尚未安装 Ollama 视觉模型,它还会提示你拉取一个。
$ vidlizer setup
  Detected providers:
    1.  Ollama        → qwen2.5vl:3b
    2.  OpenRouter    → google/gemma-3-27b-it:free

  Primary provider (1–2): 1
  Fallback (1–1, Enter to skip): 2

✓  .env written → /your/project/.env
健康检查
vidlizer doctor          # shows ffmpeg, .env, provider, mlx-whisper status
vidlizer doctor --fix    # interactive repair: brew-installs ffmpeg/Ollama/LM Studio, re-runs setup
手动配置提供商
Ollama(完全离线,无需 API 密钥):
# Install Ollama from https://ollama.com, then:
ollama pull qwen2.5vl:3b   # ~3.2 GB, requires 5 GB+ RAM (recommended)
ollama pull qwen2.5vl:7b   # ~6.0 GB, requires 10 GB+ RAM (best quality)
LM Studio(GPU 加速的本地推理):
# In LM Studio: load a vision model (e.g. Qwen2.5-VL 7B), enable the local server
# Set PROVIDER=openai and OPENAI_BASE_URL=http://localhost:1234/v1 in .env
OpenRouter(云端):
# Paste your OpenRouter key in .env:
# OPENROUTER_API_KEY=sk-or-v1-...
⚡ 快速开始
# Ollama — fully local, no API key
vidlizer demo.mp4 --provider ollama --model qwen2.5vl:3b

# LM Studio (or any OpenAI-compat server)
vidlizer demo.mp4 --provider openai --model qwen/qwen2.5-vl-7b-instruct

# OpenRouter (cloud)
vidlizer demo.mp4 --provider openrouter --model google/gemini-2.5-flash

# Analyze a YouTube video
vidlizer "https://www.youtube.com/watch?v=dQw4w9WgXcQ"

# Analyze a single image or PDF
vidlizer screenshot.png
vidlizer report.pdf

# Focus on a time range
vidlizer demo.mp4 --start 30 --end 90

# Output as Markdown or plain-text summary
vidlizer demo.mp4 --format markdown -o result.md
vidlizer demo.mp4 --format summary -o result.txt
不带参数运行,即可打开交互式文件选择器和提供商/模型选择器。
📄 输出
通过 --format 支持三种格式:
| 格式 | 标志 | 默认扩展名 | 说明 |
|---|---|---|---|
| JSON | --format json | .analysis.json | 完整的结构化流程数组(默认) |
| Markdown | --format markdown | .analysis.md | 按步骤分节的文档,包含场景/动作/语音 |
| 摘要 | --format summary | .analysis.txt | 按阶段分组的纯文本 |
默认输出路径为 <normalized-name>.analysis.json(或对应的扩展名),也可以传入 -o path。
{
  "flow": [
    {
      "step": 1,
      "timestamp_s": 0.0,
      "phase": "Introduction",
      "scene": "Title card with product logo on dark background.",
      "subjects": ["Logo", "Text overlay"],
      "action": "Static title card displayed.",
      "text_visible": "vidlizer — analyze any video",
      "context": "Opening of a product demo.",
      "observations": "Clean minimal design.",
      "next_scene": "Screen recording of the CLI.",
      "speech": "Welcome to the vidlizer demo."
    }
  ],
  "transcript": [
    { "start": 0.0, "end": 2.4, "text": "Welcome to the vidlizer demo." }
  ],
  "model_used": "gemma-4-E2B-it-MLX-4bit",
  "provider_used": "openai"
}
model_used 和 provider_used 反映实际生成结果的模型和提供商,包括回退后的情况。这些信息会显示在 MCP analyze_video 响应中,让 Agent 知道实际运行的是哪个提供商。
流程步骤字段
| 字段 | 说明 |
|---|---|
step | 连续递增的整数 |
timestamp_s | 以秒为单位的近似时间(来自帧标签) |
phase | 逻辑部分——介绍、演示、动作、结尾…… |
scene | 当前可见内容 |
subjects | 出现的关键人物、物体和 UI 元素 |
action | 正在发生的事情——交互、移动、旁白、事件 |
text_visible | 屏幕上所有可读文本 |
context | 持续状态——计时器、得分、主题、品牌…… |
observations | 错误、异常、情绪和重要事实 |
next_scene | 对后续内容的简要描述 |
speech | 此步骤中说出的转录文本(仅限包含音频的视频) |
🤖 模型
所有提供商每次请求都只发送 一帧(batch_size=1),以最大限度兼容上下文长度受限的模型。思考模式输出(<think> 标签)会自动剥除。
本地 — Ollama
完全离线,无需 API 密钥。使用 ollama pull <name> 安装:
| 模型 | 磁盘空间 | RAM | 备注 |
|---|---|---|---|
qwen2.5vl:3b ★ | 3.2 GB | ~5 GB | 推荐——128K ctx,JSON 能力强,支持多图 |
qwen2.5vl:7b ★ | 6.0 GB | ~9 GB | Ollama 中质量最佳——128K ctx,需要 10+ GB RAM |
minicpm-v:8b | 5.5 GB | ~8 GB | OCR 和视觉推理能力强,32K ctx |
llava-onevision:7b | 5.5 GB | ~8 GB | 多图和视频帧处理能力强,JSON 输出可靠 |
回退顺序(若配置的模型不可用):qwen2.5vl:7b → qwen2.5vl:3b → minicpm-v:8b → llava-onevision:7b → llava:13b → llava:7b
使用 Ollama 原生 /api/chat,并设置 format: json,以可靠地生成结构化输出。
本地 — LM Studio / oMLX / vLLM / LocalAI(兼容 OpenAI)
通过任何兼容 OpenAI 的服务实现 GPU 加速推理。设置 PROVIDER=openai,并将 OPENAI_BASE_URL 指向你的服务。
| 模型 | 显存 | 备注 |
|---|---|---|
qwen/qwen2.5-vl-7b-instruct ★ | ~8 GB | 推荐 — 128K 上下文、可靠的 JSON、多图像 |
qwen/qwen3-vl-8b ★ | ~10 GB | 最新 Qwen 视觉模型 — 自动剥离思考标签 |
qwen/qwen2.5-vl-3b-instruct | ~5 GB | 轻量 — 速度快,需 5–6 GB 显存 |
google/gemma-4-e4b-it | ~6 GB | Google MoE — LM Studio 0.3.16+ 原生支持 |
google/gemma-4-9b-it | ~10 GB | 能力更强的 Gemma 4 — 128K 上下文,更擅长遵循指令 |
zai-org/glm-4.6v-flash | ~8 GB | 智谱 AI MoE — 128K 上下文,JSON 能力强,延迟低 |
openbmb/minicpm-v-4.5 | ~8 GB | 基于 8B Qwen3 — OCR 能力强,支持多图像,适用于 vLLM |
oMLX(Apple Silicon 原生,omlx.ai)— 使用 HuggingFace 的 MLX 格式模型,在端口 8000 上自动检测(与 LM Studio 不同)。模型 ID 为 HuggingFace 路径:
| oMLX 模型 | 统一内存 | 备注 |
|---|---|---|
mlx-community/Qwen2.5-VL-7B-Instruct-8bit ★ | ~8 GB | Apple Silicon 首选 — 速度快,JSON 能力强 |
mlx-community/Qwen2.5-VL-3B-Instruct-8bit | ~4 GB | 轻量 — 需 4–5 GB 内存 |
mlx-community/Qwen3-VL-8B-8bit | ~9 GB | 最新 Qwen 视觉模型 — 自动剥离思考标签 |
mlx-community/MiniCPM-V-2_6-8bit | ~8 GB | OCR + 推理能力强 |
模型 ID 如 LM Studio 的模型浏览器、oMLX 管理面板或你的 vLLM 配置中所示。LM Studio / oMLX 一次只运行一个模型(无需回退)。加载多个模型的 vLLM 使用相同的回退顺序。
回退片段顺序(加载多个模型的 vLLM / oMLX):qwen2.5-vl-7b → qwen2.5-vl-3b → qwen3-vl → gemma-4 → glm-4 → minicpm-v → llava-onevision → llava
云端 — OpenRouter
实时获取模型及当前定价。运行 vidlizer --list-models 查看实时列表。
| 模型 | 输入 / 100 万 token | 备注 |
|---|---|---|
google/gemini-2.5-flash ★ | $0.15 | 推荐 — 1M 上下文、速度快、准确 |
google/gemini-2.5-flash-lite | $0.075 | 更便宜 — 准确度略低 |
google/gemini-2.5-pro | $1.25 | 质量最佳,成本较高 |
openai/gpt-4o | $2.50 | OpenAI 旗舰模型 |
openai/gpt-4o-mini | $0.15 | OpenAI 经济型选项 |
nvidia/nemotron-nano-12b-v2-vl:free | 免费 ⚡ | 有速率限制(8K/请求),128K 上下文 |
google/gemma-4-31b-it:free | 免费 ⚡ | 有速率限制,128K 上下文 |
免费模型失败时会自动回退到可用的最低价付费模型。
🎙️ 转录
对于带有音轨的视频,vidlizer 会自动:
- 使用 ffmpeg 提取单声道 16kHz WAV
- 使用 Apple MLX Whisper 转录(M 系列上的神经引擎 + GPU)
- 将每个转录片段合并到最近的流程步骤中,作为
speech
macOS 默认安装中包含 mlx-whisper。基础 Whisper 模型(约 150 MB)会在首次转录时下载。
若要退出:--no-transcript
🛠️ CLI 参考
子命令
vidlizer setup              # interactive wizard: detects providers, writes .env
vidlizer doctor             # health check: ffmpeg, .env, providers, mlx-whisper
vidlizer doctor --fix       # auto-repair: brew-installs missing deps, re-runs setup
vidlizer mcp-setup          # generate MCP config for Claude Code / Cursor / Claude Desktop
分析选项
vidlizer [video] [options]

positional:
  video                 Path to file or URL (YouTube/Loom/Vimeo/Twitter)

options:
  -o, --output PATH     Output path (default: <name>.analysis.json/.md/.txt)
  --format FORMAT       Output format: json (default), summary, markdown
  --provider PROVIDER   ollama | openai | openrouter  (openai covers LM Studio + oMLX + vLLM)
  --model MODEL         Model slug — Ollama name, OpenAI-compat ID, or OpenRouter slug
  --max-frames N        Max frames to send (default 60, hard cap 200)
  --start SECONDS       Analyze from this timestamp
  --end SECONDS         Analyze up to this timestamp
  --scene THRESHOLD     Scene-change sensitivity 0–1 (default 0.1)
  --min-interval SECS   Minimum seconds between frames (default 2)
  --fps FPS             Extract at fixed FPS instead of scene-change
  --scale PX            Frame width in pixels (default 512)
  --batch-size N        Frames per API call (0 = auto, default 1 for all providers)
  --concurrency N       Parallel batch workers (default: 4 for OpenRouter, 1 for local)
  --dedup-threshold N   Perceptual dedup Hamming distance (default 8, 0 = off)
  --no-transcript       Skip audio transcription
  --max-cost USD        Abort if spend exceeds this (default 1.00)
  --timeout SECS        Per-request timeout (default 600)
  -v, --verbose         Debug output
  --stats               Show token + cost usage stats by model, then exit
  --clear-stats         Reset usage log, then exit
🔧 环境变量
将 env.sample 复制为 .env:
# ── Provider ────────────────────────────────────────────────────────────────
# ollama    — local Ollama server (no API key, no cost)
# openai    — any OpenAI-compatible server (LM Studio, oMLX, vLLM, LocalAI, real OpenAI)
# openrouter — cloud inference via OpenRouter
PROVIDER=ollama

# ── Ollama (local, no API key) ──────────────────────────────────────────────
OLLAMA_HOST=http://localhost:11434
OLLAMA_MODEL=qwen2.5vl:3b

# ── OpenAI-compatible (LM Studio, oMLX, vLLM, LocalAI, real OpenAI) ─────────
#   LM Studio default port: 1234  |  oMLX default port: 8000  |  vLLM: 8000
OPENAI_BASE_URL=http://localhost:1234/v1
OPENAI_API_KEY=lm-studio        # "not-needed" for oMLX/vLLM, real key for OpenAI
OPENAI_MODEL=                   # exact model ID as shown in server (required)

# ── OpenRouter (cloud) ──────────────────────────────────────────────────────
OPENROUTER_API_KEY=sk-or-v1-...
OPENROUTER_MODEL=google/gemini-2.5-flash

# ── Frame extraction ────────────────────────────────────────────────────────
SCENE_THRESHOLD=0.1     # lower = more frames
MIN_INTERVAL=2          # seconds between forced frames
MAX_FRAMES=60
FRAME_WIDTH=512
MAX_COST_USD=1.00
BATCH_SIZE=0            # 0 = auto (defaults to 1 per request for all providers)
REQUEST_TIMEOUT=600

# ── Fallback ────────────────────────────────────────────────────────────────
# Same-provider fallback: set FALLBACK_MODEL only.
#   Blank = auto-detect installed models (Ollama) or available models (OpenAI-compat).
# Cross-provider fallback: set FALLBACK_PROVIDER + FALLBACK_MODEL.
#   FALLBACK_BASE_URL and FALLBACK_API_KEY default to the primary provider's values
#   if not set — override only when the fallback uses a different server/key.
FALLBACK_PROVIDER=      # ollama | openai | openrouter  (blank = same as PROVIDER)
FALLBACK_MODEL=         # model ID for fallback  (blank = auto-detect same-provider)
FALLBACK_BASE_URL=      # base URL for fallback openai/ollama server (optional)
FALLBACK_API_KEY=       # API key for fallback provider (optional)
📊 使用情况跟踪
每次成功运行都会向 ~/.cache/vidlizer/usage.jsonl 追加一条记录。测试运行(pytest)不计入。
vidlizer --stats          # print per-model breakdown
vidlizer --clear-stats    # reset log
输出示例:
Usage statistics  (/Users/you/.cache/vidlizer/usage.jsonl)

  Total runs:       12
  Total tokens in:  58,240
  Total tokens out: 6,102
  Total cost:       ~$0.0312
  Total steps:      94

  Model                               Provider     Runs   Tokens in  Tokens out  Cost USD
  gemma-4-E2B-it-MLX-4bit             openai          9      45,800       4,900      free
  google/gemini-2.5-flash             openrouter       3      12,440       1,202  ~$0.0312
也可作为 MCP 工具使用:get_usage_stats() → 返回相同数据的 JSON。clear_usage_stats() 会重置日志。
🔌 MCP 服务
可通过任何兼容 MCP 的 Agent 使用 vidlizer — Claude Code、Cursor、Claude Desktop、Gemini CLI。
模型和提供商通过环境变量设置,AI Agent 无法覆盖。 这样可防止 Agent 在会话中途切换到意料之外或成本高昂的模型。
安装
# uvx (no install — run directly)
uvx "vidlizer[mcp]" vidlizer-mcp

# pipx (isolated, globally available)
pipx install "vidlizer[mcp]"

# If vidlizer is already installed via pipx — inject mcp into the same venv
pipx inject vidlizer mcp

# pip / virtualenv
pip install "vidlizer[mcp]"
vidlizer-mcp 会自动添加到 PATH。使用 which vidlizer-mcp 验证。
关于 pipx 的说明:
pipx install vidlizer会创建vidlizer-mcp入口点,但不会安装mcp包。运行pipx inject vidlizer mcp添加该包,或直接使用pipx install "vidlizer[mcp]"安装。
一键设置 MCP
vidlizer mcp-setup
交互式向导会检测 vidlizer-mcp、读取你的 .env,并将配置写入编辑器的配置文件,或显示一行供你复制粘贴的命令。支持 Claude Code、Cursor、Claude Desktop 和 Windsurf。
手动配置
快速开始 — uvx(无需安装)
无需 pip install 或 pipx。uvx 会即时下载并运行 vidlizer:
{
  "mcpServers": {
    "vidlizer": {
      "type": "stdio",
      "command": "uvx",
      "args": ["--from", "vidlizer[mcp]", "vidlizer-mcp"],
      "env": {
        "PROVIDER": "ollama",
        "OLLAMA_HOST": "http://localhost:11434",
        "OLLAMA_MODEL": "gemma4:2b"
      }
    }
  }
}
将 env 区块替换为任意提供方(OpenRouter、LM Studio、oMLX)——command/args 保持不变。
使用二进制文件的绝对路径——运行 which vidlizer-mcp 即可获取。以下配置均使用 JSON(适用于 Claude Code、Cursor、Claude Desktop 和 Gemini CLI)。
通过 CLI 配置 Claude Code:
claude mcp add-json vidlizer '{"type":"stdio","command":"/path/to/vidlizer-mcp","env":{"PROVIDER":"openrouter","OPENROUTER_API_KEY":"sk-or-v1-...","OPENROUTER_MODEL":"google/gemini-2.5-flash"}}'
# Add --scope project for per-project config instead of global
单一提供方 — OpenRouter(云端)
{
  "mcpServers": {
    "vidlizer": {
      "type": "stdio",
      "command": "/absolute/path/to/.venv/bin/vidlizer-mcp",
      "env": {
        "PROVIDER": "openrouter",
        "OPENROUTER_API_KEY": "sk-or-v1-...",
        "OPENROUTER_MODEL": "google/gemini-2.5-flash"
      }
    }
  }
}
免费模型(带
:free后缀)在受到速率限制时会自动回退到最便宜的付费模型——无需额外配置。
单一提供方 — Ollama(本地,无需 API 密钥)
{
  "mcpServers": {
    "vidlizer": {
      "type": "stdio",
      "command": "/absolute/path/to/.venv/bin/vidlizer-mcp",
      "env": {
        "PROVIDER": "ollama",
        "OLLAMA_HOST": "http://localhost:11434",
        "OLLAMA_MODEL": "gemma4:2b"
      }
    }
  }
}
FALLBACK_MODEL为可选项——省略后会自动检测已安装的模型,并按首选顺序尝试。
单一提供方 — LM Studio(兼容 OpenAI,端口 1234)
{
  "mcpServers": {
    "vidlizer": {
      "type": "stdio",
      "command": "/absolute/path/to/.venv/bin/vidlizer-mcp",
      "env": {
        "PROVIDER": "openai",
        "OPENAI_BASE_URL": "http://localhost:1234/v1",
        "OPENAI_API_KEY": "lm-studio",
        "OPENAI_MODEL": "qwen/qwen2.5-vl-7b-instruct"
      }
    }
  }
}
单一提供方 — oMLX(Apple Silicon,端口 8000)
{
  "mcpServers": {
    "vidlizer": {
      "type": "stdio",
      "command": "/absolute/path/to/.venv/bin/vidlizer-mcp",
      "env": {
        "PROVIDER": "openai",
        "OPENAI_BASE_URL": "http://localhost:8000/v1",
        "OPENAI_API_KEY": "not-needed",
        "OPENAI_MODEL": "mlx-community/Qwen2.5-VL-7B-Instruct-8bit"
      }
    }
  }
}
跨提供方回退 — oMLX → OpenRouter
主要使用本地 oMLX;如果失败,则自动切换到 OpenRouter 云端。
{
  "mcpServers": {
    "vidlizer": {
      "type": "stdio",
      "command": "/absolute/path/to/.venv/bin/vidlizer-mcp",
      "env": {
        "PROVIDER": "openai",
        "OPENAI_BASE_URL": "http://localhost:8000/v1",
        "OPENAI_API_KEY": "not-needed",
        "OPENAI_MODEL": "mlx-community/Qwen2.5-VL-7B-Instruct-8bit",
        "FALLBACK_PROVIDER": "openrouter",
        "FALLBACK_MODEL": "google/gemini-2.5-flash",
        "FALLBACK_API_KEY": "sk-or-v1-..."
      }
    }
  }
}
跨提供方回退 — oMLX → Ollama
两者都在本地运行;如果 oMLX 失败(缺少模型 / 服务关闭),则由 Ollama 接替。
{
  "mcpServers": {
    "vidlizer": {
      "type": "stdio",
      "command": "/absolute/path/to/.venv/bin/vidlizer-mcp",
      "env": {
        "PROVIDER": "openai",
        "OPENAI_BASE_URL": "http://localhost:8000/v1",
        "OPENAI_API_KEY": "not-needed",
        "OPENAI_MODEL": "mlx-community/Qwen2.5-VL-7B-Instruct-8bit",
        "FALLBACK_PROVIDER": "ollama",
        "FALLBACK_MODEL": "qwen2.5vl:7b"
      }
    }
  }
}
FALLBACK_BASE_URL默认使用OLLAMA_HOST(或http://localhost:11434)——只有当 Ollama 位于非标准主机时才需要设置。
跨提供方回退 — Ollama → OpenRouter
优先使用本地;如果未安装模型或推理失败,则启用云端。
{
  "mcpServers": {
    "vidlizer": {
      "type": "stdio",
      "command": "/absolute/path/to/.venv/bin/vidlizer-mcp",
      "env": {
        "PROVIDER": "ollama",
        "OLLAMA_HOST": "http://localhost:11434",
        "OLLAMA_MODEL": "qwen2.5vl:7b",
        "FALLBACK_PROVIDER": "openrouter",
        "FALLBACK_MODEL": "google/gemini-2.5-flash",
        "FALLBACK_API_KEY": "sk-or-v1-..."
      }
    }
  }
}
同一提供方回退 — 指定备用模型
不需要自动检测时使用;两个模型使用同一提供方。
{
  "mcpServers": {
    "vidlizer": {
      "type": "stdio",
      "command": "/absolute/path/to/.venv/bin/vidlizer-mcp",
      "env": {
        "PROVIDER": "ollama",
        "OLLAMA_MODEL": "qwen2.5vl:7b",
        "FALLBACK_MODEL": "qwen2.5vl:3b"
      }
    }
  }
}
回退环境变量参考:
| 变量 | 用途 | 默认值 |
|---|---|---|
FALLBACK_PROVIDER | 回退使用的提供方(ollama/openai/openrouter) | 与 PROVIDER 相同 |
FALLBACK_MODEL | 回退模型 ID | 自动检测(同一提供方) |
FALLBACK_BASE_URL | 回退 openai/ollama 服务的基础 URL | OPENAI_BASE_URL 或 OLLAMA_HOST |
FALLBACK_API_KEY | 回退提供方的 API 密钥 | OPENAI_API_KEY 或 OPENROUTER_API_KEY |
日志
所有活动(帧提取、API 调用、错误)都会写入:
tail -f ~/.cache/vidlizer/mcp.log
工具
| 工具 | 返回内容 | 输出令牌数 |
|---|---|---|
analyze_video(path, **opts) | analysis_id + 元数据 | ~100 |
list_analyses() | 所有已存储的分析(仅元数据) | ~50/条 |
get_summary(id, level) | 简短/中等/完整的文本摘要 | ~200–2K |
get_step(id, step) | 单个流程步骤 | ~150 |
get_steps(id, start, end) | 步骤范围 | 按比例变化 |
get_phase(id, phase) | 指定阶段的所有步骤 | 按比例变化 |
search_analysis(id, query) | 与文本匹配的步骤(query 或 keyword) | 仅匹配项 |
get_transcript(id, start_s, end_s) | 部分转录文本 | 按比例变化 |
get_full_analysis(id) | 完整流程 + 转录文本 | 完整 |
delete_analysis(id) | 确认信息 | ~10 |
get_usage_stats() | 按模型统计的令牌数和费用明细 | ~50/模型 |
clear_usage_stats() | 重置用量日志 | ~10 |
令牌高效工作流
analyze_video 会将完整结果存储在磁盘上,并且只返回 analysis_id + 元数据(约 100 个令牌)。大模型按需提取特定部分——分析一个包含 60 个步骤的视频,登记时约需 100 个令牌,而每次查询只会加载所需内容。
agent: analyze_video("demo.mp4")
→ { "analysis_id": "abc123", "step_count": 42, "phases": ["Intro", "Demo", "Outro"] }

agent: get_summary("abc123", level="brief")
→ "Intro: Title card displayed | Demo: CLI recording | Outro: Results shown"

agent: get_phase("abc123", "Demo")
→ [ { step, timestamp_s, action, scene }, … ]

agent: search_analysis("abc123", "error")
→ [ { step: 17, matched_field: "observations", matched_value: "Stack trace visible" } ]
MCP 资源
| URI | 内容 |
|---|---|
vidlizer://analyses | 所有分析(元 JSON) |
vidlizer://analyses/{id} | 完整的分析 JSON |
vidlizer://analyses/{id}/summary | 中等长度的文本摘要 |
🧪 测试
全自动测试套件——248 个单元测试和集成测试,3 个端到端测试。
make install-dev    # installs pytest, pytest-html, pytest-mock
make test           # runs unit + integration (no network) → reports/test-report.html
make test-e2e       # also runs YouTube download + full pipeline e2e
make smoke          # real-provider smoke test against all detected providers
单元测试和集成测试报告:reports/test-report.html。测试覆盖:
- 帧提取(ffmpeg)、感知去重、缓存 TTL
- 音频检测、转录合并(无重复内容)
- PDF → 帧、图像编码、URL 检测
- 输出格式化程序:json/summary/markdown 正确性
- 使用模拟的 OpenRouter(伪 HTTP 服务)的完整流水线
- HTTP 层:SSE 解析、429 处理、成本上限、Ollama 流式处理
- 批处理:JSON 修复重试、免费模型并发保护
- 模型:定价查询、回退序列、格式辅助工具
- 使用情况跟踪:记录/统计/清除生命周期
- 针对真实媒体的真实 CLI 子进程调用
- YouTube 实际下载和完整分析(可通过
-m e2e启用)
冒烟测试
make smoke 会按顺序针对每个检测到的提供方运行完整的真实提供方流水线(Ollama → LM Studio → oMLX → OpenRouter)。测试开始前,会针对每个本地提供方交互式提示:
- 找到视觉模型 →
"Test ollama with qwen2.5vl:3b? [Y/n]" - 未找到视觉模型(Ollama)→
"Download qwen2.5vl:3b (~2.3 GB)? [y/N]" - 未找到视觉模型(LM Studio/oMLX)→ 提示加载模型并重试
每个提供方都在独立环境中测试,并使用自己的输出目录(防止缓存污染)。每个提供方的测试结束后,都会将本地模型从 VRAM 卸载。结果写入 reports/smoke-TIMESTAMP.html,其中包含各提供方的通过/失败评分卡。
make smoke                                  # auto-detect all providers
make smoke ARGS="--provider ollama"         # force single provider
make smoke ARGS="--provider openrouter"     # OpenRouter only (no local needed)
🤝 参与贡献
欢迎贡献!有关环境设置、代码风格和 PR 指南,请参阅 CONTRIBUTING.md。
- 错误报告:提交问题——请注明提供方、模型、macOS 版本和完整错误信息
- 功能请求:提交问题并描述使用场景
- PR:从
main分支创建分支,添加测试,确保make test通过且ruff check vidlizer/无错误
❤️ 支持
vidlizer 是免费开源软件。如果它为你节省了时间:
📝 许可证
MIT——参见 LICENSE。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。