关于 Web Researcher MCP
Web Researcher MCP 是面向研究人员、记者和分析师的本地网页研究 MCP 服务,可搜索可信来源并阅读完整页面。它还会核验引用及来源状态,并支持跨会话保留研究内容。
主要功能
- 01按可信网站筛选搜索
- 02搜索 SEC、法院及学术来源
- 03读取完整网页和文档
- 04核验引用与参考文献
- 05跨会话保存研究内容
适用场景
- 01为论文综述查找并核验引文
- 02检查法律文件中的案例引用
- 03交叉核对新闻与政府记录
MCP 相关
它向支持 MCP 的客户端提供网页搜索、页面阅读和引用核验等研究工具;可在本机运行,也可配置为团队共享服务。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
docker run -i --rm -e GOOGLE_CUSTOM_SEARCH_API_KEY -e GOOGLE_CUSTOM_SEARCH_ID -e SEARCH_PROVIDER -e SEARCH_ROUTING -e BRAVE_API_KEY -e SERPER_API_KEY -e SEARCHAPI_API_KEY -e SEARXNG_URL -e TAVILY_API_KEY -e EXA_API_KEY -e XQUIK_API_KEY -e EDGAR_CONTACT_EMAIL -e COURTLISTENER_API_TOKEN -e FRED_API_KEY ghcr.io/zoharbabin/web-researcher-mcp:1.50.4GOOGLE_CUSTOM_SEARCH_API_KEY密钥Google Custom Search API keyGOOGLE_CUSTOM_SEARCH_IDGoogle Programmable Search Engine IDSEARCH_PROVIDERSearch provider: google, brave, serper, searxng, searchapi, duckduckgo, tavily, exa, hackernews, reddit, bluesky, github, or xquikSEARCH_ROUTINGUse multiple search engines with automatic switching if one goes down (e.g. brave,google,serper)BRAVE_API_KEY密钥Brave Search API keySERPER_API_KEY密钥Serper.dev API keySEARCHAPI_API_KEY密钥SearchAPI.io API keySEARXNG_URLSearXNG instance URLTAVILY_API_KEY密钥Tavily Search API keyEXA_API_KEY密钥Exa API key (neural/semantic web search provider)XQUIK_API_KEY密钥Xquik API key (metered X/Twitter post search provider)EDGAR_CONTACT_EMAILContact email for SEC EDGAR (enables filing_search); falls back to OPENALEX_EMAILCOURTLISTENER_API_TOKEN密钥CourtListener API token (legal_search works without it; a token raises the rate limit)FRED_API_KEY密钥FRED API key (enables econ_search for Federal Reserve economic data)本地服务需要在你的电脑上安装运行环境(如 Node.js 18+)。各客户端的配置文件位置不同,请参考客户端文档。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍

web-researcher-mcp
你的 AI 研究助手。它会搜索、阅读你能打开的内容,并核查来源。
搜索网络和一手资料:SEC 文件、法院记录、专利、临床试验、全文论文。
阅读完整网页,包括需要使用你自己的账号登录才能查看的页面,例如 LinkedIn 和 X。
核查每条引文,在不同聊天中保留研究成果,并在你的机器上运行所有操作。
无需 API 密钥即可开始使用。
⭐ 如果你厌倦了 AI 编造信息,而 web-researcher-mcp 对你有所帮助,请给我们点个星 ⭐ — 这能帮助更多团队发现这个项目。
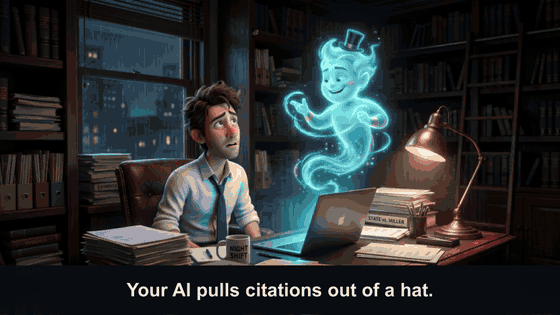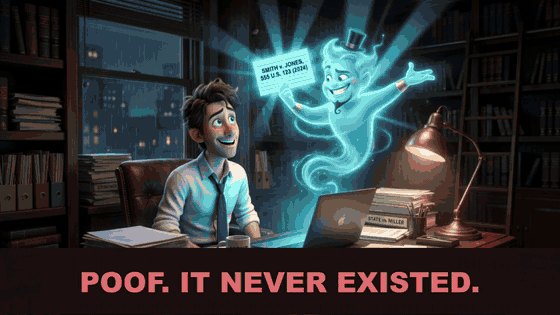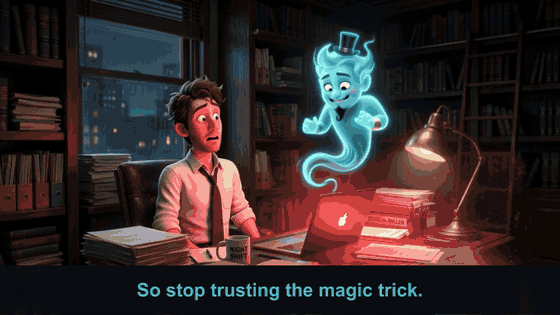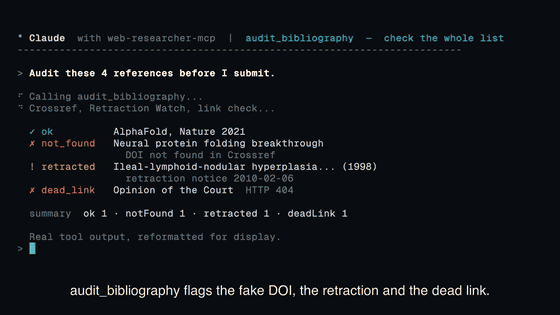
先展示问题的漫画,再呈现真实的工具输出。观看 43 秒视频。





Python 用户 — uvx(无需编译,适用于任何操作系统):
# One-time: install uv (skip if you already have it)
curl -LsSf https://astral.sh/uv/install.sh | sh        # macOS/Linux  (Windows: winget install astral-sh.uv)

claude mcp add --scope user web-researcher -- uvx web-researcher-mcp
uv 会为你的平台获取合适的预构建二进制文件并运行它 — 无需 Go、无需编译,也无需手动配置 PATH。将任何 MCP 客户端指向 uvx web-researcher-mcp 即可。也可使用 uv tool install web-researcher-mcp 或 pip install web-researcher-mcp。
macOS(Homebrew):
brew install zoharbabin/tap/web-researcher-mcp
claude mcp add --scope user web-researcher -- web-researcher-mcp
macOS / Linux(无需包管理器):
curl -fsSL https://raw.githubusercontent.com/zoharbabin/web-researcher-mcp/main/install.sh | sh
Windows(PowerShell):
powershell -ExecutionPolicy Bypass -c "irm https://raw.githubusercontent.com/zoharbabin/web-researcher-mcp/main/install.ps1 | iex"
无需开发工具 — 所有方法都会提供相同的签名二进制文件(PyPI wheel 会将其打包在内;其他方法会下载该文件并验证其校验和),并将其加入 PATH。如果存在 claude CLI,curl/PowerShell 安装程序还会自动将其注册到 Claude Code;Homebrew 会安装该二进制文件,因此请运行上面的 claude mcp add 命令来连接。
一键安装:

Cursor / VS Code / LM Studio 按钮会安装无需配置的 uvx 方案(编辑器会在添加前提示你确认;需要 uv — 见上文)。它会运行无需 API 密钥的 DuckDuckGo 网页搜索 — 非常适合立即试用;image_search/news_search 和更丰富的提供商则需要密钥(2 分钟即可完成,见配置)。**Claude Desktop:**下载适用于你平台的 .mcpb bundle 并双击它(设置 → 扩展),或者使用上面的 uvx 命令。
使用其他 MCP 客户端或想传入 API 密钥?请参阅连接到你的 AI 助手,了解各应用的配置;并参阅配置以选择搜索提供商。
现在,你的 AI 可以搜索网络和一手来源、阅读页面(包括需要登录才能访问的页面)、核查引用并开展多步骤研究。选择你信任的信息来源。
Python SDK
from web_researcher_mcp import WebResearcherClient

async with WebResearcherClient() as client:
    response = await client.web_search("CRISPR off-target effects 2024", num_results=5)
    for r in response.results:
        verified = await client.verify_citation(r.url)
        print(r.title, "—", "✓" if verified.exists else "?")

同步封装(适用于不使用异步的脚本和笔记本):
with WebResearcherClient.sync() as client:
    response = client.web_search("climate change 2024")
    print(response.results[0].title)
它能做什么
| 对你意味着什么 | |
|---|---|
| 搜索你会查找的所有内容 | 可限定在你信任的网站(镜片)中的网页搜索。还提供专用工具,用于搜索 SEC 文件、美国法院记录、专利、临床试验、经济数据和论文全文。无需 API 密钥。 |
| 以你的身份操作 | 启用 site_login 后,你的 AI 就能读取你已可访问的网页:LinkedIn、X、Facebook、Instagram、YouTube 等。你可以在自己的浏览器或私人登录窗口中自行登录,也包括双重身份验证。系统绝不会保存你的密码。登录信息会加密、按用户隔离并设有过期时间,site_logout 可将其移除。某些网站(如 LinkedIn)在其条款中禁止自动访问。请仅在允许自动访问的网站上使用。 |
| 依赖之前先核查 | verify_citation、audit_bibliography 和 verify_recommendation 会检查来源是否存在、是否已撤稿、链接是否有效,以及来源是否确实支持所述内容。它们提供证据,而非判定结果。准确性通过带标签的黄金标准集进行衡量(docs/TRUST_EVAL.md)。 |
| 阅读完整页面 | 支持 PDF、Word 和 PowerPoint 文件、YouTube 字幕稿及 Hacker News 讨论串,而不只是摘要片段。 |
| 留存并持续监测 | 会话在上下文丢失后仍可保留。research_panel 可对比多个模型的回答。引用可导出为 APA、MLA、BibTeX、RIS 或 CSL-JSON 格式。启用后,已保存的查询监控器会标记新结果,记忆功能可在不同聊天中保留发现,团队工作区则可供团队共享这些内容。 |
| 自行运行 | 免费、开源(MIT)、无需账户。你的查询只会发送给你选择的搜索提供商。可在笔记本电脑上运行单个二进制文件,也可为团队搭建共享服务。 |
| 始终有备用方案 | 多个搜索引擎协同工作。一个出错时,下一个会接手。 |
| 审计追踪 | 启用后,审计日志会通过防篡改哈希链记录每次工具调用。发布版本附带签名和 SLSA 来源证明。 |
为什么要做这个项目?
AI 的回答看起来有来源依据,但往往并非如此。
- 法院:Charlotin 数据库列出了超过 2,200 起涉及 AI 幻觉内容的法院判决。从 2027-01-01 起,加利福尼亚州 SB 574要求律师亲自核实法院文件中的每一条引用。
- **搜索:**2026 年的一项 WashU 审计发现,Google AI Overviews 中约每 9 条可核实的主张,就有 1 条未得到其引用页面的支持(作者称这是上限)。CJR 的 Tow Center测试了 8 款 AI 搜索引擎,发现它们在引用新闻来源方面都表现不佳。
- **你的工作:**如果内容会被引用、发表、提交或展示给客户,“可能是真的”远远不够。
**本项目的应对方式:**你的 AI 会从你选择的来源读取真实页面和记录,然后核查引用。每项主张都能追溯到你可以打开的链接。
兼容 Claude、Claude Desktop、Cursor、VS Code、Codex、Gemini CLI,以及任何支持 MCP 的 AI 助手。
适用人群
- 学术研究人员 — “我需要带有真实 DOI 的文献综述,而不是捏造的引文”
- 商业分析师 — “我的交付成果需要包含客户可以实际点击并核实的来源”
- 律师 — “如果我引用了不存在的案例,就会被罚款 50,000 美元”
- 记者 — “我需要交叉核对政府记录和法院文件,而不是 Perplexity 的摘要”
- 医学研究人员 — “依据健康博客做出的临床决策可能会伤害他人”
- 研究生 — “我花了 3 小时追查 AI 编造的一条引文”
- 市场与销售研究人员 — “最有价值的背景信息在我只有登录后才能打开的页面上”
- 企业团队 — “我们的竞争研究不能经过第三方服务器”
- 构建 Agent 的开发者 — “我希望搜索和阅读网页时无需按查询付费,也不受供应商锁定”

对比
| web-researcher-mcp | 内置 AI 搜索(Perplexity、ChatGPT、Google AI) | 搜索 API(Tavily、Exa、Brave) | 论文工具(Scite、Consensus、Elicit) | |
|---|---|---|---|---|
| 检查引文是否存在、是否已撤稿,以及是否支持所述主张 | 是 | 否 | 否 | 仅限论文 |
| 由你选择要搜索的来源 | 是(检索视角) | 否 | 域名筛选器 | 否 |
| SEC 文件、法院记录、专利、临床试验 | 是 | 仅网页 | 仅网页 | 否 |
| 阅读完整网页、PDF、YouTube 转录稿 | 是 | 摘录和摘要 | 视情况而定 | 否 |
| 在你的设备上运行,无需账户 | 是 | 否 | 否(托管 API) | 否(托管服务) |
| 可在你现有的 AI 客户端中使用 | 是 | 独立应用 | 是 | 部分支持 |
| 费用 | 免费,开源(MIT) | 订阅或捆绑服务 | 按量计费的 API 密钥 | 订阅 |
根据各供应商截至 2026 年 10 月公开的文档整理。如果有内容已过时,请提交问题。
何时使用哪种工具
- 内置 AI 搜索 — 快速随意地查找信息,无需引用来源时
- 搜索 API — 只需要经过排序的链接时。将其中一种与此工具搭配使用(它们都可以作为提供方接入),还可阅读网页并核查引文
- 论文工具 — 浏览单个学术论文数据库时
- web-researcher-mcp — 研究成果关系到你的声誉时:客户工作、法院文件、出版物、拨款申请、医疗决策、新闻报道
AI 可以用它做什么

| 工具 | 功能 |
|---|---|
web_search | 搜索网页 — 可通过 lenses 限定为仅搜索你信任的来源 |
scrape_page | 完整读取任意 URL — 网页、PDF、Word 文档、幻灯片、YouTube 字幕稿、Hacker News 讨论串(通过 HN API 原生读取);支持 mode: raw,获取未经处理、未净化的原始内容(例如检查 JSON 或 HTML) |
search_and_scrape | 先搜索,再读取最佳结果 — 通过质量评分筛选出最可靠的来源 |
image_search | 按尺寸、类型、颜色或格式查找图片 |
news_search | 搜索近期新闻,并可控制日期和筛选来源 |
academic_search | 查找真实论文及其真实 DOI — 作者、引用次数、开放获取链接 |
paper_fulltext | 通过 DOI、Semantic Scholar ID 或 URL 一次调用获取论文全文 — 无需先调用 academic_search,再调用 scrape_page |
citation_graph | 遍历论文的引用关系 — 包括论文引用的作品和引用该论文的作品,以及引用意图/影响信号 |
patent_search | 搜索专利局(美国、欧洲、国际),并使用分类代码 |
filing_search | 搜索 SEC EDGAR 中美国上市公司的申报文件(10-K、10-Q、8-K、…)— 或提取结构化 XBRL 公司数据 |
legal_search | 通过 CourtListener 搜索美国法院判决和案件档案 — 获取真实案件及其真实引文 |
econ_search | 查询经济数据 — 世界银行全球发展指标、OECD 经济指标、Eurostat 欧洲统计数据(均无需密钥),以及 FRED 美国宏观经济序列(GDP、CPI、失业率、利率;需要 FRED_API_KEY) |
clinical_search | 搜索 ClinicalTrials.gov — 临床试验注册信息,包括状态、阶段、赞助方以及是否已发布结果(用于信息检索,不构成医疗建议) |
monarch_search | 查询 Monarch Initiative 生物医学知识图谱 — 按表型相似度对疾病和基因排序,查找疾病/基因/表型实体,并遍历基因—疾病—表型关联 |
awesome_list_search | 搜索 ecosyste.ms Awesome API,查找围绕 GitHub 主题、由社区整理的「awesome-*」列表 — 提供结构化、可筛选的覆盖信息(星标数、精选条目数、主题),超越自由文本搜索 |
local_search | 根据本地意图查询搜索实体地点(餐厅、商店、服务、兴趣点)— 提供结构化 POI 详情和描述。需要 BRAVE_API_KEY |
brand_research | 调研公司的完整品牌形象 — 颜色(十六进制)、标志、字体、语气风格和社交媒体账号 — 可通过任意域名或公司名称查询。返回用于 AI 内容生成的结构化 JSON。无需 API 密钥;可选用 BrandFetch 密钥获取更丰富的数据 |
company_recon | 通过 OSINT 侦察公司 — 包括 Certificate Transparency 日志中的 SAN、Wayback Machine 历史 URL 清单、推导出的子域名,以及网页搜索生成的公司摘要。各阶段均可独立选择,失败时不会中断其他阶段 |
verify_citation | 在依赖某条引文前先核查 — 它是否存在、是否与真实记录匹配,以及是否已撤回或链接失效?提供证据,而非结论 |
audit_bibliography | 一次性审查整份参考文献列表 — 粘贴 CSL-JSON/RIS/BibTeX 文件(或会话),即可获取针对每个条目及整个文献集的标记,指出已撤回、链接失效和无法核实的引文 |
verify_recommendation | 审查 AI 生成的推荐列表(榜单、产品排名),检查自我推广、作者利益冲突、域名声誉和失效链接 — 揪出受 GEO 操纵影响的推荐。提供证据,而非结论 |
archive_source | 通过 Save Page Now 为 URL 创建最新的 Internet Archive(Wayback Machine)快照,确保被引用的来源在网页日后更改或消失时仍可核查 — 返回快照 URL 和时间戳(写入工具) |
sequential_search | 多步骤深度研究 — AI 会记住已找到的内容并以此为基础继续研究 |
get_research_session | 上下文丢失后恢复研究会话 — 从中断处继续 |
research_export | 将研究会话导出为可分享的报告(Markdown 或 JSON),并附上每个步骤的完整来源追溯信息 |
format_bibliography | 将收集的来源整理成格式化参考文献 — APA、MLA、BibTeX、RIS 或 CSL-JSON(适用于 Zotero/EndNote/Mendeley) |
research_panel | 向一组独立配置的大模型提出同一问题并比较回答 — 确定性地计算共识、矛盾和模型独有的观点,绝不由仲裁模型加以平滑处理 |
上方的大多数工具始终可用。少数工具仅在配置了相应提供方或配置时才会启用:citation_graph 和 research_panel 至少需要配置一个后端提供方;filing_search 需要 EDGAR_CONTACT_EMAIL;local_search 需要 BRAVE_API_KEY。 |
选择启用的工具。 这些工具在你开启相应功能前处于关闭状态。涉及个人数据的功能还需要记录同意。
| 工具 | 功能 | 启用方式 |
|---|---|---|
site_login、site_logout | 保存或移除登录信息(Cookie 或浏览器配置文件),以便 scrape_page 读取需要登录才能访问的页面。按用户隔离并加密。 | COOKIE_VAULT_ENABLED=true |
monitor_query_save、monitor_query_check | 保存查询,之后可仅获取新增结果 | MONITORING_ENABLED=true |
memory_save、memory_recall | 按用户跨会话保存发现,并设有保留期限 | MEMORY_ENABLED=true |
workspace_contribute、workspace_read | 将发现分享至团队工作区,并记录来源 | WORKSPACES_ENABLED=true |
get_my_analytics | 查看你自己的使用统计数据 | USER_ANALYTICS_ENABLED=true |
权威且经 CI 验证的工具列表及完整架构,请参阅 docs/TOOLS.md。
现成的研究模板
此服务还提供引导式提示词模板,你的 AI 助手可以一键调用。这些模板会引导它完成经过验证的多步骤流程,让你无需逐条说明所有指令:
| 模板 | 引导 AI 完成的任务 |
|---|---|
comprehensive-research | 围绕某个主题开展结构化、多步骤的深入研究 |
fact-check | 根据多个独立来源核实一项说法 |
competitive-analysis | 评估一家公司及其市场(新闻、专利、网络) |
literature-review | 系统地回顾某个主题的学术文献 |
brand-guidelines | 研究某个品牌,并为特定用途制定创意方向(落地页、电子邮件、视频简报)——调用 brand_research,并为你解读结构化 JSON |
company-recon | 对一家公司进行深入的 OSINT 侦察——梳理其基础设施、申报文件、人员和公开信息足迹 |
rare-disease-research | 基于 Monarch 知识图谱开展罕见病鉴别诊断和基因—疾病研究,并通过文献和临床试验进行佐证 |
research-panel-factcheck | 通过 LLM 面板核实一项说法,并追查每处意见分歧 |
research-panel-synthesis | 综合 LLM 面板的意见,得出一个答案,并将矛盾视为不确定性 |
curriculum-research | 研究某个学科的教学大纲覆盖情况、院校氛围和学术自由背景——调用采用 curriculum 视角的 web_search |
在大多数 AI 应用中,你可以在选择提示词或使用“/”命令的位置找到这些模板。此服务提供实时状态资源(stats://tools、stats://sessions、stats://rate-limits、stats://providers)、视角目录(lenses://catalog)、诊断信息(diagnostics://errors/recent、diagnostics://health、diagnostics://panel/spend),以及大负载内容的制品存储(research://artifact/{id}),以便你或你的 AI 查看用量、限额和当前启用的提供方。完整列表请参阅 docs/DEPLOYMENT.md。
快速开始
选项 1:Homebrew(macOS / Linux — 推荐)
brew install zoharbabin/tap/web-researcher-mcp
claude mcp add --scope user web-researcher -- web-researcher-mcp
Homebrew 会为你处理信任、更新和 PATH,无需担心签名警告。
选项 2:一键安装(适用于任何操作系统——无需开发工具)
macOS / Linux:
curl -fsSL https://raw.githubusercontent.com/zoharbabin/web-researcher-mcp/main/install.sh | sh
Windows(PowerShell):
powershell -ExecutionPolicy Bypass -c "irm https://raw.githubusercontent.com/zoharbabin/web-researcher-mcp/main/install.ps1 | iex"
下载二进制文件,根据已签名的发行版本验证其 SHA-256 校验和,将其添加到 PATH,并在已安装 Claude Code 的情况下完成注册。自定义安装位置:
INSTALL_DIR=/opt/tools curl -fsSL https://raw.githubusercontent.com/zoharbabin/web-researcher-mcp/main/install.sh | sh
其他安装方式
AUR(Arch Linux):
# Using any AUR helper (yay, paru, etc.)
yay -S web-researcher-mcp
或者手动执行:git clone https://aur.archlinux.org/web-researcher-mcp.git && cd web-researcher-mcp && makepkg -si
Nix / NixOS:
# Run without installing
nix run github:zoharbabin/web-researcher-mcp

# Add to your flake inputs
nix profile install github:zoharbabin/web-researcher-mcp
有关 NixOS 模块的用法,请参阅 packaging/nix/flake.nix。
Continue.dev:
将以下内容添加到 Continue 的 ~/.continue/config.json:
{
  "mcpServers": {
    "web-researcher": {
      "command": "uvx",
      "args": ["web-researcher-mcp"]
    }
  }
}
也可以复制 packaging/continue/config.json 作为起始配置。
WinGet(Windows):
winget install zoharbabin.web-researcher-mcp
Scoop(Windows):
scoop bucket add zoharbabin https://github.com/zoharbabin/scoop-bucket
scoop install web-researcher-mcp
Chocolatey(Windows):
choco install web-researcher-mcp
Homebrew Cask(macOS——经 Developer ID 签名并完成公证的二进制文件):
brew install --cask zoharbabin/tap/web-researcher-mcp
该 cask 提供经公证的 darwin 二进制文件(通过 Gatekeeper 检查)。大多数用户需要的是上面的 formula(brew install zoharbabin/tap/web-researcher-mcp),仅输入名称时会解析到该 formula;如需经公证的程序包,请明确传入 --cask。
Go 安装(如果已安装 Go):
go install github.com/zoharbabin/web-researcher-mcp/cmd/web-researcher-mcp@latest
claude mcp add --scope user web-researcher -- web-researcher-mcp
Docker:
# STDIO mode needs -i so the container's stdin stays attached for MCP JSON-RPC
docker run -i --rm \
           -e SEARCH_PROVIDER=brave \
           -e BRAVE_API_KEY=YOUR_KEY \
           docker.io/zoharbabin/web-researcher-mcp:latest
从源代码构建:
git clone https://github.com/zoharbabin/web-researcher-mcp.git
cd web-researcher-mcp
go build -o web-researcher-mcp ./cmd/web-researcher-mcp
连接到 AI 助手
安装脚本会自动在 Claude Code 中注册。对于其他应用,请将以下内容添加到 AI 的配置文件中:
{
  "mcpServers": {
    "web-researcher": {
      "command": "web-researcher-mcp",
      "env": {
        "SEARCH_PROVIDER": "brave",
        "BRAVE_API_KEY": "YOUR_BRAVE_API_KEY"
      }
    }
  }
}
还没有密钥?省略 env 即可。DuckDuckGo 无需配置即可使用。
其他客户端:
| 客户端 | 位置 |
|---|---|
| Gemini CLI | gemini mcp add web-researcher uvx web-researcher-mcp,或将上面的 JSON 配置块添加到 ~/.gemini/settings.json |
| Codex | ~/.codex/config.toml:添加 [mcp_servers.web-researcher],并设置 command = "uvx" 和 args = ["web-researcher-mcp"] |
通过设置 SEARCH_PROVIDER 和对应提供商的密钥,即可替换为 配置 表中的任意提供商。完成后,AI 助手便可使用所有研究工具。
配置

无需 API 密钥。 DuckDuckGo 是内置的零配置备用方案——安装后即可使用。若要提高结果质量并启用图片/新闻搜索,可添加以下任意一个提供商。它们均为可选且可互换——选择你已在使用或偏好的提供商即可;服务端会一视同仁地处理它们。
搜索提供商
设置 SEARCH_PROVIDER=<name>,并提供该提供商的密钥。所有提供商都支持搜索镜头,也可以组合使用,以便自动故障切换(参见搜索提供商)。
| 提供商 | SEARCH_PROVIDER | 密钥变量 | 获取密钥 |
|---|---|---|---|
| DuckDuckGo | duckduckgo | 无 | 内置,无需配置 |
| Google PSE | google | GOOGLE_CUSTOM_SEARCH_API_KEY + GOOGLE_CUSTOM_SEARCH_ID | 云控制台 + 搜索引擎 |
| Brave | brave | BRAVE_API_KEY | brave.com/search/api |
| Serper | serper | SERPER_API_KEY | serper.dev |
| SearchAPI.io | searchapi | SEARCHAPI_API_KEY | searchapi.io |
| You.com | youcom | YOUDOTCOM_API_KEY | you.com/docs/api-reference/search/v1-search |
| SearXNG | searxng | SEARXNG_URL | 可自托管 |
| Tavily | tavily | TAVILY_API_KEY | app.tavily.com |
| Exa | exa | EXA_API_KEY | dashboard.exa.ai |
| Hacker News | hackernews | 无 | 内置,无需配置(HN Algolia 索引) |
reddit | 无 | 内置,无需配置(公共 RSS) | |
| Bluesky | bluesky | 无 | 内置,无需配置(公共 AT Protocol API) |
| GitHub | github | 无(可选设置 GITHUB_TOKEN,可提高速率限制) | 内置,无需配置(公共 REST Search API) |
| Xquik | xquik | XQUIK_API_KEY | dashboard.xquik.com |
Google PSE 即将终止服务。 Google 已停止向新客户开放 Custom Search JSON API,并将于 2027-01-01 关闭该 API(Google)。现有密钥在此之前仍可使用。新配置请使用 Brave、Serper、SearXNG 或其他提供商。
每个提供商都有自己的免费层级、注册流程和功能组合(图片、新闻、时效性)。完整对比(索引分类、功能矩阵、快速选择指南)请参阅 docs/PROVIDERS.md,逐步配置密钥请参阅 docs/API_SETUP.md。配置多个提供商后,服务会自动进行故障切换,详见搜索提供商。
未设置 SEARCH_PROVIDER 时,如果存在 Google 密钥,服务会使用 Google;否则会回退到无需配置的 DuckDuckGo 提供商。因此,无论是否有密钥,都能开箱即用。
学术搜索(可选,无需注册)
学术搜索提供商(OpenAlex、CrossRef)接受联系邮箱,以通过 polite pool 获得更快的访问速度;无需注册,只需提供邮箱。配置方法请参阅 docs/API_SETUP.md,完整变量参考请参阅 docs/DEPLOYMENT.md。
设置这些变量后,
academic_search会返回真实论文及其 DOI、作者、引用次数和开放获取 PDF 链接。未设置时仍可使用,但会回退到网页搜索。
专利搜索(可选)
专利提供商(EPO、USPTO、The Lens)需要 API 密钥才能获取结构化专利数据。逐步配置说明请参阅 docs/API_SETUP.md,完整变量参考请参阅 docs/DEPLOYMENT.md。
设置这些变量后,
patent_search会返回包含分类代码、日期和发明人的结构化专利数据。未设置时会回退到网页搜索。
高级:HTTP 模式、OAuth 及其他所有设置
HTTP 模式、OAuth、速率限制、缓存、抓取和可观测性设置请参阅 docs/DEPLOYMENT.md。
内部机制
架构(面向开发者和贡献者)
完整的各软件包映射和分层示意图(MCP 传输层 → 工具分发 → 服务层 → 基础设施)位于 ARCHITECTURE.md,集中存放于一处以避免内容不一致。
设计原则(面向开发者)
- 全局状态为零 -- 所有依赖都通过构造函数注入
- 接口驱动 -- 每个外部依赖都通过接口提供,以便测试和替换
- 并发有界 -- 对外部 API 调用使用显式信号量
- 纵深防御 -- 在每一层实施 SSRF 防护、速率限制和内容清理
- 错误明确暴露 -- 返回错误,绝不吞掉错误;在边界处进行验证
搜索提供商
你可以选择为研究提供支持的搜索引擎。所有搜索引擎都能与搜索镜头配合使用。
| 提供商 | 全网 | 图片 | 新闻 | 备注 |
|---|---|---|---|---|
| DuckDuckGo | 是 | — | — | 默认配置为零(无需 API 密钥);大量使用时会受到速率限制 |
| Google PSE | 是 | 是 | 是 | 已停止接受新客户;将于 2027-01-01 终止。免费套餐:每天 100 次查询 |
| Brave Search | 是 | 是 | 是 | 独立索引;提供免费套餐 |
| Serper.dev | 是 | 是 | 是 | 结果与 Google 相同 |
| SearXNG | 是 | 是 | 是 | 可自托管,注重隐私,适用于气隙部署 |
| SearchAPI.io | 是 | 是 | 是 | 统一 API,支持多个搜索引擎后端 |
| You.com | 是 | — | 是 | 通过 You.com API 搜索网页和新闻 |
| Tavily | 是 | — | 是 | 面向 AI Agent 的搜索;提供简洁、适合大模型处理的内容 |
| Exa | 是 | — | 是 | 神经网络/语义搜索;也为 academic_search 和可选的付费抓取套餐提供支持 |
| Hacker News | 仅 HN | — | 是 | 默认配置为零(HN Algolia 索引);搜索 HN 讨论串,而非整个网络 |
| 仅 Reddit | — | 是 | 默认配置为零(公开 RSS);搜索 Reddit 帖子,而非整个网络 | |
| Bluesky | 仅 Bluesky | — | — | 默认配置为零(公开 AT Protocol API);搜索 Bluesky 帖子,而非整个网络 |
| GitHub | 仅 GitHub | — | 是 | 默认配置为零(公开 REST Search API);搜索 issue/PR,而非整个网络 |
| Xquik | 仅 X/Twitter | — | 是 | 搜索 X 帖子,而非整个网络;需要 XQUIK_API_KEY |
多个提供商(推荐)
配置多个搜索引擎,这样即使某个引擎出现问题,你的研究也不会中断:
export SEARCH_ROUTING=brave,serper,duckduckgo
如果 Brave 出现故障,它会自动尝试 Serper。如果 Serper 遭遇速率限制,则会继续尝试 DuckDuckGo。研究工作始终顺畅进行。
请参阅 docs/PROVIDERS.md,了解完整的提供商比较(索引分类、功能、免费套餐);高级路由选项(按主题路由、专利专用提供商等)请参阅 docs/DEPLOYMENT.md。
单个提供商
如果你只有一个搜索 API 密钥,也可以正常使用——只需完成配置即可。
提供商配置示例
多提供商路由(推荐):
export SEARCH_ROUTING=brave,serper
export BRAVE_API_KEY=BSAxxxxxxxxxx
export SERPER_API_KEY=...
单个提供商 — Brave Search:
export SEARCH_PROVIDER=brave
export BRAVE_API_KEY=BSAxxxxxxxxxx
单个提供商 — SearXNG(可自托管,注重隐私):
export SEARCH_PROVIDER=searxng
export SEARXNG_URL=http://localhost:8080
单个提供商 — Exa:
export SEARCH_PROVIDER=exa
export EXA_API_KEY=...
单个提供商 — Brave:
export SEARCH_PROVIDER=brave
export BRAVE_API_KEY=BSA...
配置表中的任何提供商都能以相同方式使用——设置 SEARCH_PROVIDER 和对应的密钥即可。
搜索镜头
搜索镜头可让你控制允许 AI 搜索哪些网站。与其搜索整个网络(从而搜到博客、垃圾内容和 AI 生成的低质内容),不如使用搜索镜头将结果限制为你信任的、适用于该主题的来源。
内置 Lens
| Lens | 侧重点 |
|---|---|
docs | 仅官方文档和 API 参考 |
academic | 预印本服务器、知识库、开放获取期刊 |
academic-extended | 预印本服务器、开放获取聚合平台,以及核心期刊索引之外的知识库 |
biomed | 罕见病和生物医学知识图谱来源——本体门户、基因-疾病数据库、精选罕见病登记库 |
clinical | 临床试验、药物安全、循证医学 |
curriculum | 学术课程数据、院校言论自由环境和全球教育统计数据 |
security | CVE、安全公告、漏洞研究 |
investigative_records | 公共记录、企业备案、FOIA |
programming | 代码文档、教程、问答 |
programming-goggle | 经 Brave 的 Programming Goggle 重新排序、优先呈现开发者内容的搜索结果——展示文档、代码库和权威技术内容(需要 Brave) |
devops | 基础设施和运维——Kubernetes、Docker、Terraform、云、CI/CD |
news | 时事、新闻报道 |
tech | 科技行业 |
legal | 法律、案例、法规 |
medical | 健康、医学 |
finance | 市场、备案文件 |
science | 研究、论文 |
government | 政策、法规 |
osint | 开源情报——公共记录、企业注册信息、社交足迹、基础设施 |
awesome-lists | GitHub 上由社区整理的“awesome-*”列表——涵盖各领域、经过 PR 审核的工具和资源合集 |
你也可以针对任何领域创建自己的 Lens——只需列出你信任的域名。
工作原理
当你(或你的 AI)使用 Lens 时,结果只会来自该 Lens 中的网站。例如,使用 medical Lens 意味着你的 AI 会搜索 PubMed、WHO、NIH 和其他临床来源,而不会搜索健康博客或补充剂广告。
你的 AI 会在你提出要求时自动使用 Lens。例如:“使用 clinical Lens 搜索 SGLT2 抑制剂的最新研究结果。”
创建自己的 Lens
为自定义 Lens 创建一个目录,并为每个 Lens 添加一个 JSON 文件:
{
  "name": "my-industry",
  "description": "Only searches sources I trust for my field",
  "domains": [
    "trusted-source.com",
    "industry-journal.org",
    "official-database.gov"
  ],
  "cx": ""
}
然后将服务器指向你的 Lens 目录:
export CUSTOM_LENSES_PATH=/path/to/my-lenses
现在,你的 AI 就可以使用 my-industry 这个 Lens。自定义 Lens 会在内置 Lens 之后加载——如果自定义 Lens 的 name 与某个内置 Lens 相同,就会覆盖该内置 Lens。每个 Lens 最多可添加约 10 个域名。
高级选项(可选——大多数用户可以忽略这些选项):
- cx — 将 Lens 标记为由 Google Programmable Search Engine 限定范围。此时,Lens 会跳过
site:注入。将该搜索引擎设为全局GOOGLE_CUSTOM_SEARCH_ID。Google 的 API 将于 2027-01-01 终止,因此建议优先使用domainsLens - goggle — 用于服务器端重新排序的 Brave Goggle URL(仅限 Brave)
隐私与安全
你的研究查询会直接从你的设备发送到你选择的搜索提供商,不会经过我们的服务器(我们没有服务器)。该工具完全在你的计算机上运行。
存储个人数据的功能(已保存的登录信息、记忆、分析数据、工作区)默认处于关闭状态。每项功能都需要主动选择启用、记录同意并进行加密存储。
技术安全详情(供企业 / 合规团队参考)
- SSRF 防护 — 阻止内部网络访问、云元数据端点和 DNS 重绑定攻击
- OAuth 2.1(HTTP 模式)— JWKS 令牌验证、按租户隔离、受众 / 签发者验证
- 速率限制(HTTP 模式)— 按租户和全局设置限制,以保护上游 API
- 内容净化 — 通过白名单策略清理 HTML、去重、质量评分
完整威胁模型请参阅 docs/SECURITY.md。
各 AI 应用的设置
Claude Code
将以下内容添加到 MCP 配置文件(~/.claude.json)。设置 SEARCH_PROVIDER 以及对应服务提供商的密钥(参见配置表)——以下示例使用 Brave:
{
  "mcpServers": {
    "web-researcher": {
      "command": "/path/to/web-researcher-mcp",
      "env": {
        "SEARCH_PROVIDER": "brave",
        "BRAVE_API_KEY": "BSA..."
      }
    }
  }
}
Claude Desktop
将以下内容添加到 ~/Library/Application Support/Claude/claude_desktop_config.json(macOS)或 %APPDATA%\Claude\claude_desktop_config.json(Windows):
{
  "mcpServers": {
    "web-researcher": {
      "command": "/path/to/web-researcher-mcp",
      "env": {
        "SEARCH_PROVIDER": "brave",
        "BRAVE_API_KEY": "BSA..."
      }
    }
  }
}
Cursor
将以下内容添加到项目根目录下的 .cursor/mcp.json:
{
  "mcpServers": {
    "web-researcher": {
      "command": "/path/to/web-researcher-mcp",
      "env": {
        "SEARCH_PROVIDER": "brave",
        "BRAVE_API_KEY": "BSA..."
      }
    }
  }
}
HTTP 模式(团队 / 共享服务)
适用于希望所有人连接到同一个共享实例的团队:
PORT=3000 \
OAUTH_ISSUER_URL=https://auth.example.com \
OAUTH_AUDIENCE=https://api.example.com \
./web-researcher-mcp
然后将任意 AI 应用连接到 http://localhost:3000/mcp/。
Docker Compose 示例
services:
  web-researcher:
    image: zoharbabin/web-researcher-mcp
    ports:
      - "3000:3000"
    environment:
      PORT: "3000"
      SEARCH_PROVIDER: brave
      BRAVE_API_KEY: ${BRAVE_API_KEY}
注意: 所有连接模式(STDIO 和 HTTP)下的工具行为完全相同。唯一的区别是身份验证(HTTP 需要 OAuth)和速率限制(HTTP 会强制执行每个租户的限制;STDIO 仅受上游 API 配额限制)。详情请参阅 docs/DEPLOYMENT.md。
性能
搜索结果可在一秒内返回。之前见过的结果会被缓存,重复搜索可即时返回。全文提取适用于 95% 以上的网站,包括试图拦截机器人的网站。对于大量使用 JavaScript 的网站,后台会自动启用真正的浏览器(无需设置)。
开发
go build -o web-researcher-mcp ./cmd/web-researcher-mcp   # Build
go test -race ./...                                        # Test (with race detector)
make verify                                                # Full CI gate (see Makefile for steps)
lint、gosec 和 govulncheck 工具已通过 go.mod 工具指令固定版本,因此 make verify 会使用 CI 所用的确切版本运行它们(无需全局安装)。分支保护要求 Lint、Test、Security 和 E2E 检查全部通过。
完整的开发工作流、代码风格指南和 PR 流程,请参阅 CONTRIBUTING.md。
故障排除
服务已启动,但工具因“API key”错误而失败
即使缺少凭据,服务也会启动(以便完成 MCP 握手)。请将 API 密钥设置在 MCP 客户端配置的 env 块中,而不是 shell 配置文件中。
部分页面返回空内容
对于大量使用 JavaScript 的网站,工具会使用真正的浏览器(Chromium)。使用二进制文件安装时,首次使用会自动下载(约 200MB)。如果已安装 Chrome,请将 CHROME_PATH 设置为其路径。Docker 镜像已内置 Chromium(预设了 CHROME_PATH),因此 JavaScript 渲染开箱即用,无需下载。
升级后缓存仍提供过期结果
磁盘缓存位于操作系统的缓存目录中(例如,macOS 上的 ~/Library/Caches/web-researcher-mcp/,Linux 上的 ~/.cache/web-researcher-mcp/)。删除该目录即可清除缓存,也可以将 CACHE_DIR 设置为自定义路径。
遇到搜索限制(429 错误)
如果服务提供商的免费额度用尽:
- 切换到其他服务提供商——将
SEARCH_PROVIDER设置为其他任一选项(参见配置);每个服务提供商都有自己的免费额度 - 设置多个服务提供商(例如
SEARCH_ROUTING=brave,serper)——如果某个服务提供商受到速率限制,系统会自动切换到下一个 - 或升级服务提供商的套餐
macOS:手动更新后出现“Failed to reconnect”/错误 -32000
只有在原地将新内容复制到现有文件上以替换二进制文件时,才会出现此问题(cp new /path/to/web-researcher-mcp)。在 Apple Silicon 上,macOS 会将二进制文件的临时代码签名缓存到文件上,原地覆盖可能导致下次启动时进程在启动前被终止。官方安装程序(Homebrew、单命令 install.sh 和 Claude Code 插件)会通过安装到新文件来避免此问题。要修复手动安装,请干净地替换文件并重新签名:
rm -f /path/to/web-researcher-mcp
cp /path/to/new-build /path/to/web-researcher-mcp
codesign --force -s - /path/to/web-researcher-mcp   # ad-hoc re-sign
然后重新连接客户端。(重新运行 install.sh 会自动正确完成此操作。)
贡献
欢迎贡献。请参阅 CONTRIBUTING.md,了解代码风格指南、开发工作流以及如何提交拉取请求。
文档
| 文档 | 描述 |
|---|---|
| ARCHITECTURE.md | 设计决策、技术栈、依赖项 |
| CONTRIBUTING.md | 开发环境设置、代码风格、PR 工作流 |
| docs/TOOLS.md | 工具规范和参数架构 |
| docs/EXAMPLES.md | 使用 JSON 工具调用的示例 |
| docs/API_SETUP.md | 所有搜索提供商的 API 密钥设置 |
| docs/SECURITY.md | 威胁模型、SSRF、身份验证、合规性(SOC2/GDPR/FedRAMP) |
| docs/PRIVACY.md | 数据流向、第三方处理方、数据保留 |
| docs/DEPLOYMENT.md | 构建、Docker、Kubernetes、客户端配置、扩展 |
| docs/PYTHON_CLIENT.md | Python SDK — WebResearcherClient 参考、同步封装器、安装 |
| docs/LESSONS_LEARNED.md | 从 Node.js 迁移到 Go 的经历与经验 |
| docs/SESSION_PERSISTENCE.md | 会话如何在上下文丢失后继续保留——设计、数据流、引用 |
| docs/MIGRATION.md | 从已弃用的 google-researcher-mcp 迁移 |
许可证
由 Zohar Babin 使用 Go 和 Model Context Protocol 构建
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。