关于 Wigolo
Wigolo 是面向 AI Agent 的本地优先网络工具,提供搜索、抓取、爬取、提取和研究功能,可作为 MCP 服务接入编码 Agent,也可通过 REST 或 SDK 使用。核心工具无需 API Key,数据保存在本地 ~/.wigolo/ 目录中。
主要功能
- 01多引擎网页搜索与结果评分
- 02自动升级的网页抓取
- 03多页面爬取与 robots.txt 遵守
- 04结构化数据提取
- 05本地缓存与变更检测
适用场景
- 01为编码 Agent 提供实时网页搜索与内容抓取
- 02在自托管 Agent 中通过 REST 接口调用网页工具
- 03基于多个来源生成带引用的研究报告
MCP 相关
该项目是 MCP 服务,可通过 npx -y wigolo 注册到 MCP 客户端,向其提供 search、fetch、crawl、extract 等网页工具。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
10收录的工具列表 · 更新于 3 周前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| url | string | 是 | 要获取的 URL |
| render_js | enum | 否 | JavaScript 渲染模式(默认:auto)auto | always | never |
| use_auth | boolean | 否 | 使用已存储的身份验证凭据(默认值:false) |
| max_chars | number | 否 | 要返回的最大字符数(硬截断) |
| max_content_chars | number | 否 | 将 Markdown 智能截断至 N 个字符,并在段落/标题边界处添加 [... content truncated] 标记。对于 AI agents,优先于 max_chars 使用。 |
| section | string | 否 | 按标题文本提取特定部分 |
| section_index | number | 否 | 部分匹配索引(默认值:0) |
| screenshot | boolean | 否 | 截取屏幕截图(默认值:false) |
| headers | object | 否 | 额外的 HTTP 标头 |
| force_refresh | boolean | 否 | 绕过缓存并从网络获取最新内容。适用于快速变化的页面(新闻、更新日志、仪表板)。 |
| max_tokens_out | number | 否 | 总输出的令牌预算上限。使用 cl100k-base BPE;非 OpenAI 分词器的计数可能偏差约 5-15%。同时设置 max_tokens_out 和 max_chars 时,max_tokens_out 优先。 |
| include_full_markdown | boolean | 否 | 在响应中包含完整的 Markdown 正文。多结果工具默认值为 false(仅返回证据摘录);设为 true 可恢复。 |
| citation_format | enum | 否 | 引用的呈现样式。'numbered'(默认)使用行内 [N] 标记;'json' 返回 citations[] 数组;'anthropic_tags' 使用 <source id='...'> 标签包裹来源。numbered | anthropic_tags | json |
| actions | array | 否 | 提取内容前要执行的顺序浏览器操作。存在此参数时会强制使用浏览器渲染(绕过优先使用 HTTP 的路由)。 |
| mode | enum | 否 | cache=仅使用 HTTP,接受过期缓存。default=标准抓取并检测 JS。stealth=完整浏览器渲染。cache | default | stealth |
详细介绍

为 AI Agent 提供本地优先的 Web 智能——无需密钥、无需云服务、无需按量付费。
适用于 Claude Code · Cursor · Codex · Gemini CLI · OpenCode · VS Code · Windsurf · Zed · Antigravity
以及更多 LangChain · CrewAI · LlamaIndex · Vercel AI SDK · n8n 和可自托管 Agent · 任意 MCP 客户端 · 纯 REST


赞助商

快速入门 · 工具 · wigolo 的独特之处 · Discord · 赞助商 · 基准测试 · 文档 · 示例 · 许可 · 反馈 · 常见问题
加入 Discord 社区——提问、寻求帮助,了解接下来正在开发的内容。
新功能和更新持续推出。关注 X 上的 @yourtowhid,获取全部动态以及使用 wigolo 的新方法;也欢迎在那里联系,洽谈合作或提供反馈 · 也可通过 LinkedIn 联系
wigolo 为 AI Agent 提供一个统一入口,处理所有与 Web 相关的任务:搜索、抓取、爬取、提取、缓存、查找相似内容、研究以及自主信息收集循环。它可以在 Agent 运行的任何地方运行——作为编码 Agent 旁边的 MCP 服务,作为 REST/MCP 端点运行在可自托管 Agent 所在的机器上,或通过 SDK 嵌入你自己的应用。核心工具无需 API 密钥,处理的内容不会离开 ~/.wigolo/,Agent 思考得越多,账单也不会随之增加。

npx wigolo init                              # set up the local engine — any system
npx wigolo init --agents=claude-code,cursor  # …or set up + wire your day-to-day agents in one command
需要在 macOS、Linux 或 Windows 上使用 Node ≥ 20,并预留约 1.5 GB 可用磁盘空间。直接运行 init 会设置本地引擎:下载浏览器引擎和设备端模型,运行健康检查,并报告各个组件的状态。添加 --agents 可在同一次运行中配置指定的 Agent,让你日常使用的编码 Agent 通过一条命令即可就绪。
- 支持的 Agent —
--agents接受以下任意值:claude-code·cursor·codex·gemini-cli·opencode·vscode·windsurf·zed·antigravity(用逗号分隔);wigolo 会写入 MCP 配置,并在支持的情况下为每个 Agent 添加说明。 - 其他任何配置方式 — 任何 MCP 客户端、Agent 框架或可自托管 Agent,都可以在自己的 MCP 配置中注册
npx -y wigolo。安装指南提供了每个客户端对应的确切配置块,以及 Docker、Homebrew 和单文件二进制程序的安装方式。 - 后续还会增加 — 支持列表会不断扩展,也欢迎提交 PR 添加你的 Agent;请参阅 CONTRIBUTING.md。
- 交互式设置 —
--interactive会启动纯文本流程;--wizard则会启动完整的终端 TUI。 - 稍后下载 —
--no-warmup会等到首次使用时再下载。组件下载失败不会导致设置失败;init 会报告尚未就绪的组件、提供确切的修复方法,并继续完成设置。
默认情况下,init 无需人工干预,因此可安全用于脚本和 CI;任何设置问题都会在此处的组件状态报告中显示,早于 Agent 的首次调用。**搜索、抓取、爬取、提取、缓存和查找相似内容均无需 API 密钥。**可随时检查运行状况:
npx wigolo doctor
如需彻底移除所有内容,请运行 npx wigolo config --uninstall --yes。你也可以将安装指南粘贴给任何 AI 助手,让它代为完成设置;该指南内容完整,可独立使用。
推荐 — 为 research 和 agent 配置免费密钥
搜索、抓取、爬取、提取、缓存和查找相似内容完全无需密钥。research、agent 和 search format=answer 会使用大模型撰写综合且带引用的答案。若未配置大模型,它们会返回原始简报和证据,供 Agent 整合。免费的 Gemini 密钥可以将其转换为完整答案:
export WIGOLO_LLM_PROVIDER=gemini
export GEMINI_API_KEY=<free-key>      # grab one at aistudio.google.com/apikey — the free tier is plenty
任何提供商都可以(anthropic · openai · groq);也可以通过 WIGOLO_LLM_PROVIDER=ollama(或任何兼容 OpenAI 的 URL)完全在本地运行,无需密钥。在 shell 或 Agent 的 MCP env 配置块中设置即可。提供商、模型以及无需密钥的本地模型选择方案请参阅配置指南。
Agent 会收到什么
每条搜索结果都是 Agent 可采取行动的证据。结果包含与来源中准确位置对应的原文摘录、Agent 可引用的引用 ID,以及可供检查的评分(真实结构的精简示例):
{
  "results": [{
    "title": "Logical replication - PostgreSQL docs",
    "url": "https://www.postgresql.org/docs/current/logical-replication.html",
    "excerpt": "Logical replication is a method of replicating data objects…",
    "citation_id": "src-1",
    "source_span": { "start": 1042, "end": 1305 },          // byte-exact provenance
    "evidence_score": { "final": 0.86, "semantic": 0.91, "lexical": 0.78, "engine_consensus": 3 }
  }],
  "citations": [{ "id": "src-1", "url": "…" }],
  "freshness_signal": { "published": "2026-05-12", "confidence": "high" }
}
wigolo 自带的评分器会将质量较差的结果标记为无用内容。系统会报告运行失败的引擎,并标记过期缓存,因此 Agent 始终清楚所依据的内容。各工具的完整响应规范请参阅工具参考。
工具
| 工具 | 功能 |
|---|---|
🔎 search | 多引擎网页搜索(18 个直接适配器),支持排序融合、ML 重排,以及可解释的单条结果评分。传入查询数组可并行扩大搜索范围。可按域名和时间范围筛选、匹配完整短语,或返回图片结果。 |
📄 fetch | 通过分层路由加载单个 URL;遇到反机器人挑战或 SPA 页面时,会自动从普通 HTTP 升级到无头浏览器引擎。返回整理后的 Markdown、元数据和链接。支持 PDF、单标题 section、经身份验证的会话,以及页面操作(点击/输入/滚动/截图)。 |
🕸️ crawl | 多页面爬取——BFS、DFS、站点地图或仅映射。支持每个域名的速率限制、遵循 robots.txt,以及去重模板内容。 |
🧩 extract | 从页面提取结构化数据:表格、元数据、JSON-LD、品牌标识、命名架构(Article/Recipe/Product/…),或任意自定义 JSON Schema。 |
💾 cache | 查询已访问的所有内容——支持关键词或混合语义搜索。此外还可查看统计信息、清除缓存和检测变更。 |
🧲 find_similar | 通过关键词、语义和实时网页三路融合,查找与某个 URL 或概念相似的页面。 |
🧠 research | 拆解问题 → 分发子查询 → 获取来源 → 综合生成带引文的报告(或由宿主大模型撰写的结构化简报)。 |
🤖 agent | 自主信息收集循环:规划 → 搜索 → 获取 → 提取 → 综合,并提供步骤日志、时间预算和可选的输出架构。 |
🔁 diff + ⏱️ watch | 查看页面自上次访问以来的具体变化;按需重新检查,并将变更发送到 webhook。 |
每个工具也可以从终端运行(wigolo search "…" --json)、通过带 NDJSON 管道的交互式 shell 运行(wigolo shell)、通过 REST 运行,以及通过 SDK 运行——CLI 参考。每个工具的完整参数指南见 docs/tools.md;可运行示例见 examples/。
与众不同之处
wigolo 并非付费工具的免费替代品——它旨在与它们比肩。它是面向 Agent 的专用网页层:提供可供 Agent 直接调用的 MCP 和 REST 接口,并具备付费服务收费提供的搜索和提取质量。它的特点包括:
- 专为 Agent 打造。 一次 MCP 调用即可并行向多个引擎发起多条查询,这是串行的宿主工具循环无法做到的。每条结果都附带透明的单条结果评分,且输出会考虑预算限制。
- 如实呈现结果。 结果中会标明过期缓存、获取失败、后端降级和内容截断。如果无法读取受机器人保护的页面,你会收到标记为
blocked_by_challenge的失败结果,而不是把挑战页面当作内容返回。 - 每次查询费用为 $0,可免费重复查询。 默认搜索通过直接适配器访问公共引擎;重排器和嵌入模型均在设备本地运行。每条响应都会缓存,因此再次查询既即时又免费。
- 默认保护隐私。 缓存、嵌入、模型和配置均保存在
~/.wigolo/下。除非你明确选择使用 LLM 进行综合,否则不会向任何第三方发送数据。
下面是一个真实结果的拆解示例。其中包括失败的引擎和质量较弱的结果,因为它们同样属于答案的一部分:

四种工具都得出了相同的核心答案,而且只有一种工具在给出答案的同时,返回了逐字且精确到字节的证据。
一次冷启动查询在单个 Claude Fable 5 会话中实时运行,并将四种网络工具置于同等条件下进行并行调用(内置 WebSearch、wigolo、Tavily、Exa),然后由 Agent 仅根据证据进行评判。四种工具都得出了相同的答案和相同的首要来源,因此屏幕上的对比证明了它们表现相当。只有 wigolo 返回了逐字摘录,并将其固定到源内容的字节偏移区间;还提供了可解释的评分分解和实时的逐引擎遥测数据,而且其自身的评分器将两个较弱的结果标记为垃圾内容。云端工具也有其价值:Exa 完整呈现了官方文档中的对比矩阵。运行你自己的查询,也会看到同样的结果。

对比
| wigolo | Firecrawl | Exa | Tavily | |
|---|---|---|---|---|
| 多引擎网络搜索 | ✅ | ✅ | ✅ | ✅ |
| 抓取与结构化提取 | ✅ | ✅ | ✅ | ✅ |
| 全站爬取与映射 | ✅ | ✅ | — | ✅ |
| 固定到源内容字节偏移区间的逐字摘录 | ✅ | — | — | — |
| 可解释的逐结果评分分解 | ✅ | — | — | — |
| 持久化本地记忆——即时重新查询,支持离线使用 | ✅ | — | — | — |
| 查询数据保留在你的设备上 | ✅ | — | — | — |
| API 密钥 / 账户 | 无 | 必需 | 必需 | 必需 |
| 每次查询的费用 | $0 | 按用量计费 | 按用量计费 | 按用量计费 |
功能状态截至 2026 年 7 月——请查看各供应商的文档,了解当前情况。
最后一项的优势会不断累积,因为 Agent 往往会集中发起查询:

超越编辑器
这十种工具可通过你偏好的任意方式,为各类 Agent 提供服务:通过 MCP 服务编码 Agent,通过 REST 服务其他用途,通过 SDK 嵌入,也可通过框架包装器直接集成。
REST API — wigolo serve
单个进程即可在 MCP 传输之外提供纯 JSON REST API。无需 MCP 客户端,只需使用 curl:
wigolo serve                          # 127.0.0.1:3333 — loopback is open; off-loopback requires a token

curl -sX POST http://127.0.0.1:3333/v1/search \
  -H 'Content-Type: application/json' \
  -d '{"query":"local-first software","max_results":5}'
POST /v1/{tool} 涵盖全部十种工具,GET /openapi.json 提供 OpenAPI 3.1 契约,/mcp 和 /sse 则通过同一端口为远程 MCP 客户端提供服务。绑定到环回地址之外时必须提供 bearer token,因此该服务默认采用失败即关闭的安全策略。可将 n8n、Hermes 风格的助手或任何可自托管 Agent 指向该服务。→ REST API
SDK — TypeScript 和 Python
轻量、类型化的客户端,内置本地模式,可为你查找或启动守护进程。无需单独执行 serve 步骤。
TypeScript — npm install wigolo-sdk(零依赖;Node / Bun / Deno / edge):
import { createLocalClient } from 'wigolo-sdk/local';

const { client, close } = await createLocalClient();   // reuse a running daemon, or spawn one
const res = await client.search({ query: 'local-first web search', max_results: 5 });
console.log(res.results.map((r) => r.title));
await close();                                          // stops the daemon only if this call spawned it
Python — pip install wigolo(仅使用标准库;支持同步与异步):
from wigolo import local_client

with local_client() as client:                          # reuse a healthy daemon, or spawn one
    res = client.search(query="local-first web search", max_results=5)
    for r in res["results"]:
        print(r["title"], r["url"])
框架集成
将 wigolo 的工具接入你已在使用的框架。你可以使用完整的十种工具,包括大多数框架网络工具不提供的缓存、find_similar、research 和 agent:
| 框架 | 包 | 提供的功能 |
|---|---|---|
| LangChain | wigolo-langchain | 每种工具均可作为 BaseTool 使用,另提供基于 search / find_similar 的 BaseRetriever,用于 RAG |
| CrewAI | wigolo-crewai | wigolo_tools() → 将这组工具交给任意 crew |
| LlamaIndex | wigolo-llamaindex | BaseReader,可将抓取、爬取或搜索到的页面加载为文档 |
| Vercel AI SDK | wigolo-vercel-ai-sdk | 为 generateText / streamText 提供工具工厂,适配 edge 环境 |
→ 框架集成
Docker
# stdio MCP — wire it into any MCP client as command: docker
docker run -i --rm -v wigolo-data:/data ghcr.io/knockoutez/wigolo

# HTTP server for remote / multi-client use
docker run -p 3333:3333 -v wigolo-data:/data \
  -e WIGOLO_API_TOKEN=a-long-random-secret \
  ghcr.io/knockoutez/wigolo serve --host 0.0.0.0
精简镜像会将模型延迟加载到卷中;ghcr.io/knockoutez/wigolo:latest-full 则预装了浏览器引擎。带版本号的发行版使用相同的 -full 后缀(例如,0.3.1-full)。也可在 Docker Hub 获取:towhid69420/wigolo。→ 安装与所有渠道
Agent 技能
包含 11 组技能的技能目录,能教会你的编码 Agent 如何熟练使用每个工具。它会在运行 init 时安装,并通过 wigolo skills add|list|remove 管理。→ 技能
给自托管用户的一点提醒:某些受防护机制保护的网站会评估 IP 信誉,因此数据中心 IP 可能无法通过用家庭网络即可通过的防护。wigolo 会标记这些失败;自托管指南介绍了可选的代理解决方案。
Star 历史
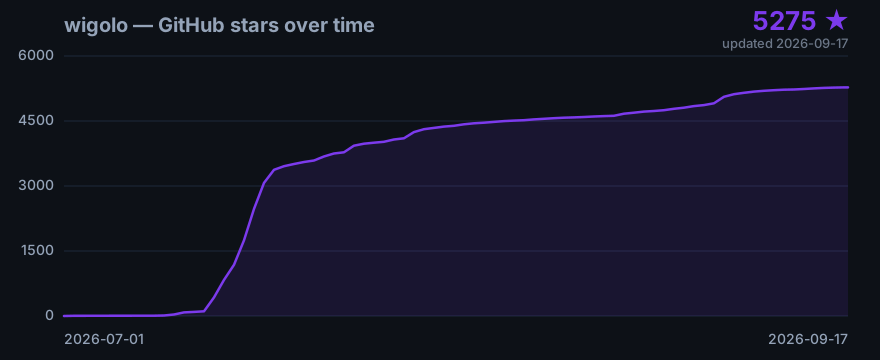
每日通过 GitHub API 更新。如果 wigolo 对你有用,请点个 ⭐。
架构
单个 Node 进程通过 MCP(基于 stdio 的 JSON-RPC)通信。所有重量级组件都在本地运行并按需加载,因此零密钥安装不会为未使用的部分产生任何开销。
flowchart TD
    A["🤖 AI agent<br/>any MCP client · REST · SDK"]
    A -->|MCP over stdio| B["<b>wigolo</b><br/>10 tools · dynamic instructions<br/>in-process browser pool + cache + models"]

    B --> C{"Tool layer"}
    C --> T1["search · fetch · crawl · extract"]
    C --> T2["cache · find_similar · research · agent"]

    T1 --> F["⚙️ Fetch router<br/>tiered escalation, learned per domain"]
    T1 --> S["⚙️ Search<br/>18 engines → rank fusion → ML rerank<br/><i>explainable evidence score</i>"]
    T2 --> DB[("🗄️ Local cache<br/>keyword + vector index")]
    T2 --> ML["🧠 On-device ML<br/>embeddings + reranker"]

    F -.->|optional| LLM["☁️ LLM<br/>synthesis only · opt-in"]
    S -.->|optional| SX["🔀 Aggregator backend<br/>opt-in legacy / hybrid"]

    F --> WEB["🌍 Public web"]
    S --> WEB

    style B fill:#7c3aed,stroke:#5b21b6,color:#fff
    style WEB fill:#0ea5e9,stroke:#0369a1,color:#fff
    style DB fill:#1e293b,stroke:#334155,color:#fff
    style LLM stroke-dasharray: 5 5
    style SX stroke-dasharray: 5 5
- 代码胜过模型。 确定性工作不交给大模型处理:规范化、排名融合、去重和架构匹配。模型仅用于判断,并且须经用户选择,且每个请求都有调用上限。由大模型填充的字段会与来源核对,若来源中不存在则置空。
- 基于信号的路由。 获取流程仅在出现可观测信号时才升级为使用真实浏览器,而非根据域名猜测:SPA 标记、防护页面内容、内容稀少。它会按域名学习,并在网站不再需要时取消学习;
wigolo tune list会准确显示它学到了什么。 - 像浏览器一样读取页面。 分层获取会等待拦截页挑战结束,并礼貌地按域名复用通行凭据:遵循 robots.txt,限制各域名的请求速率,提供适合研究的内容量。如果防护仍未解除,系统会标记并报告失败。
配置
全新安装后即可直接使用。调整三个设置可提升输出质量:
# 1. Synthesis — the biggest lever (research / agent / search-answer write real prose)
export WIGOLO_LLM_PROVIDER=gemini                   # or anthropic / openai / groq / ollama (keyless)
export GEMINI_API_KEY=<your-key>

# 2. Wider retrieval funnel
export WIGOLO_SEARCH=hybrid                         # core engines + aggregator fallback
export WIGOLO_GITHUB_TOKEN=...                      # GitHub code search 10 → 30 req/min

# 3. Land more fetches, stay warm
export WIGOLO_TLS_TIER=auto                         # per-domain learned fetch hardening
export WIGOLO_EAGER_WARMUP=1                        # pay the ~1s model load up front
值得养成的单次调用习惯: 使用查询数组(["a","b","c"])并行拓宽搜索范围 · 对重要查询使用 search_depth: "deep" · 文档查找时将 include_domains 作为硬性过滤条件。完整参考涵盖所有环境变量、配置文件键、搜索后端、缓存 TTL 和服务限制,详见配置指南。
文档与示例
docs/ — 完整手册: 快速入门 · 安装与渠道 · 配置 · 工具参考 · CLI 与 Shell · REST API · SDK 与集成 · 自托管 · Agent 技能 · 插件 · 故障排查与常见问题 · 隐私与安全
examples/ — 可直接运行的示例,每个示例都附有 README(大多数还提供终端录屏):单次 CLI 调用、NDJSON Shell 管道、通过 curl 使用 REST、TypeScript 与 Python SDK、Vercel AI SDK 工具、让自托管的 n8n 连接远程 wigolo、带 Webhook 的监控,以及编写自己的搜索引擎插件。文档也发布在网站上:wigolo.app/docs。
Beta 版与反馈
wigolo 目前处于公开 Beta 阶段。此处记录的所有功能均可用,并通过了 7,600 项测试;它很稳定,Beta 阶段主要是为了打磨体验。我们会继续保持 Beta,直到有足够多的人使用、试用并为它点星,让发布 v1 具有实际意义。你的反馈将影响后续开发,而且每条反馈都会有人阅读,通常当天就会回复:
如果 wigolo 成为你工作配置的一部分,以下三件事能帮助它持续发展:点一个 ⭐ Star(这是开源项目获得关注的方式)、请杯咖啡(开源版就是完整产品;商业许可证为项目提供资金支持,而非解锁受限功能),或**发送邮件**,邮件会直接发给编写这段代码的开发者。
故障排除
wigolo doctor 会指出任何故障组件,以及修复问题所需的确切环境变量或命令;wigolo doctor --fix 会修复常见问题,wigolo verify 会对每个组件进行健康检查。组件在 init 期间发生故障不会影响 wigolo:init 仍会以 0 状态码退出,而且核心搜索、抓取、爬取、提取和缓存功能无需模型或浏览器也能运行。常见问题:
- 下载缓慢或失败 — 重新运行
wigolo warmup --all(或--browser/--embeddings/--reranker);下载会继续进行并自动重试。 - Linux 上无法启动浏览器 — 运行
wigolo warmup --browser安装系统库(或显示准确的安装命令)。 - 原生构建错误 / Node 版本特殊 — 使用 LTS 版本,即 Node 22 或 24;也可使用 Node 26(受支持;在成为 LTS 前属于 Current 版本)。
- 使用代理 — 设置
USE_PROXY=true和PROXY_URL;对于检查 TLS 的代理,还需添加NODE_EXTRA_CA_CERTS。 - 你的 Agent 每次调用都询问权限 — 在客户端中允许这些工具,然后重启客户端;规则会在会话开始时读取。详情。
完整指南涵盖针对不同症状的修复方法、“X 故障时哪些功能仍可用”对照表、平台说明(包括 linux-arm64)和离线安装:docs/troubleshooting.md。
常见问题
免费?有什么隐情吗?
没有隐情,这是刻意如此设计的。高成本部分(排名、嵌入、浏览器引擎)都在你的硬件上运行,因此无需通过按查询计费来回收成本,也就没有计量收费的理由。项目由商业许可证和赞助提供资金,AGPL 从法律上防止项目转变为封闭式托管产品。
质量真的能媲美付费服务吗?
上方的基准测试部分是一次实时的四方对比,你可以复现:日常 Agent 查询的表现不相上下,付费工具在某些深度提取的边缘案例中仍有优势,而爬取是 wigolo 最擅长的领域。每个结果都会显示评分,因此你不必只听任何人的说法。
公共搜索引擎不会封锁或失效吗?
它正是为应对这些情况而设计的:融合 18 个搜索引擎并进行排名融合(任一引擎失效都几乎不会影响结果),采用分层抓取流程并针对各域名进行学习,还提供可选的聚合器回退方案。性能下降的后端会在输出中报告,而本地缓存则确保所有已访问过的内容无论如何都能继续使用。
这类抓取行为合规吗?
wigolo 像浏览器一样读取公共网络:默认遵守 robots.txt,设置各域名的速率限制,并将请求量控制在单台机器上运行一个 Agent 的研究级规模。它有意采用尽可能礼貌的方式。
我可以在工作中使用吗?
可以。如果你是公司,或正在基于 wigolo 构建商业产品,请购买商业许可证或赞助项目。请参阅 LICENSING.md。
为什么需要 1.5 GB 磁盘空间?
这是设备上的核心:完整的浏览器引擎,以及云服务在其服务器端运行并向你收费的排名和嵌入模型。下载到磁盘后,每次查询都可以免费使用它们。
可通过以下渠道获取
- npm —
wigolo(主要渠道 — 请参阅上方的快速入门) - PyPI —
wigolo(Python SDK) - Docker —
ghcr.io/knockoutez/wigolo·towhid69420/wigolo - 官方 MCP 注册表 —
io.github.KnockOutEZ/wigolo - 目录 — Glama · Smithery · mcp.so · LobeHub
Homebrew、curl | sh 和单文件二进制文件的相关说明请参阅安装指南。每台机器只使用一个渠道;它们共用 ~/.wigolo。
赞助商
感谢以下赞助商帮助维护 wigolo,并让所有人都能免费使用。你们的支持将直接用于项目工作。
TestMu AI(前身为 LambdaTest)是全球首个全栈 Agentic AI 质量工程平台,深受 18,000 多家企业信赖。
**wigolo 对所有人免费。**如果你或你的公司愿意帮助维护项目,我们欢迎更多赞助商 — 请发送邮件至 [email protected] 联系我们,或查看赞助内容以及 SPONSORS.md 中的条款。也欢迎通过 Buy Me a Coffee 一次性赞助。
贡献
欢迎提交错误报告、功能请求和 PR;请参阅 CONTRIBUTING.md。请保持工具处理程序简洁、添加测试,并在提交 PR 前运行测试套件。最友好的入门方式是使用插件系统自定义搜索引擎和提取器:用约 100 行代码添加搜索引擎,模板见 examples/plugin-search-engine。
许可证
本项目基于 GNU AGPL-3.0 开源且免费,并将一直如此。如果你是公司,或正在通过 wigolo 盈利,请购买商业许可证或赞助本项目。这有助于持续维护项目。请参阅 LICENSING.md。
如需报告漏洞,请参阅 SECURITY.md;如需了解名称的使用方式,请参阅 TRADEMARK.md。
wigolo 是开源、免费的,并且积极维护中。 如果它为你节省了按量计费的搜索费用,给个 ⭐、提交一条有价值的问题,或请一杯 ☕ 咖啡,都能帮助项目持续发展。
由 @KnockOutEZ 构建并维护 · [email protected] · X · LinkedIn
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。