关于 lean-memory
lean-memory 是嵌入式、本地优先的 Agent 记忆库,每个命名空间对应一个 SQLite 文件,无需服务或云端密钥。它面向需要持久化记忆的 Python 应用与 MCP Agent,并以取代旧事实而非删除的方式管理记忆。
主要功能
- 01从自然语言中提取事实并存储
- 02新事实自动取代冲突的旧事实
- 03混合稠密与稀疏检索,并使用重排序
- 04支持按时间点查询历史事实
- 05睡眠式离线维护与人工审核队列
适用场景
- 01为 Claude Code 或 Claude Desktop 提供本地持久记忆
- 02在 Python 应用中为每个用户维护独立记忆
- 03定期清理与审核 Agent 记忆中的重复内容
MCP 相关
该项目提供 MCP 服务,暴露 memory_add、memory_search、memory_clear 等工具,并在核心服务中提供维护与审核相关工具。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
lean-memory


嵌入式、本地优先的 Agent 记忆。无需服务、无需守护进程,也无需强制使用云端密钥。
状态(2026-07): 首个公开发布版本(0.2.1)已在 PyPI 和 MCP Registry 上线(MCP 优先发布);Claude Code 插件已随本仓库发布 (市场列表待上线)。 路线图和设计依据:
docs/superpowers/specs/2026-07-08-strategic-direction-design.md。 公共基准测试(LongMemEval/LoCoMo)有意推迟到发布之后;测试框架已完成(bench/phase2_*.py), 测试中暴露的引擎缺陷也已修复——详见docs/phase2-learnings.md。
from lean_memory import Memory

mem = Memory(root="./data")

mem.add("user-42", "I work at Acme Corp.")
mem.add("user-42", "I now work at Globex.")          # supersedes Acme automatically

mem.search("user-42", "where does the user work?")   # → "I now work at Globex."
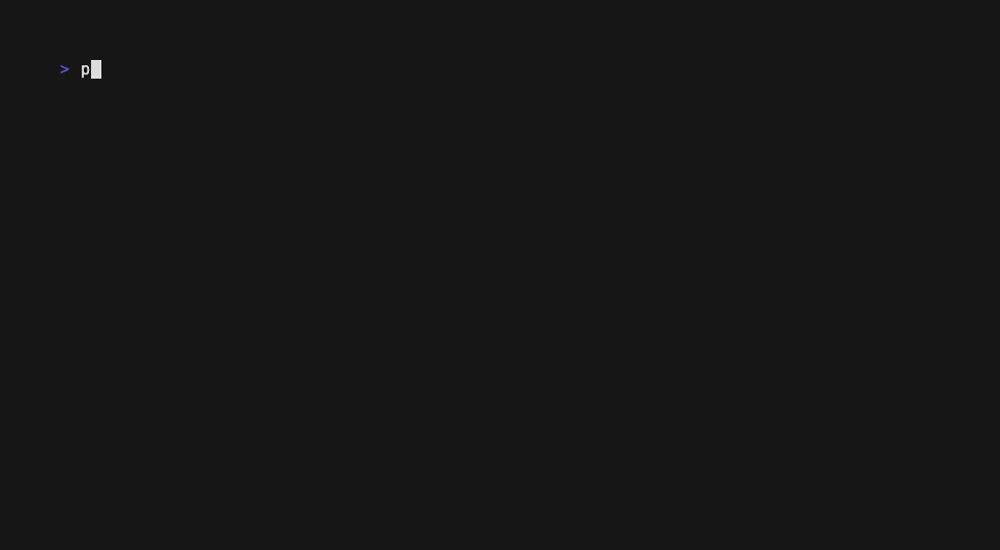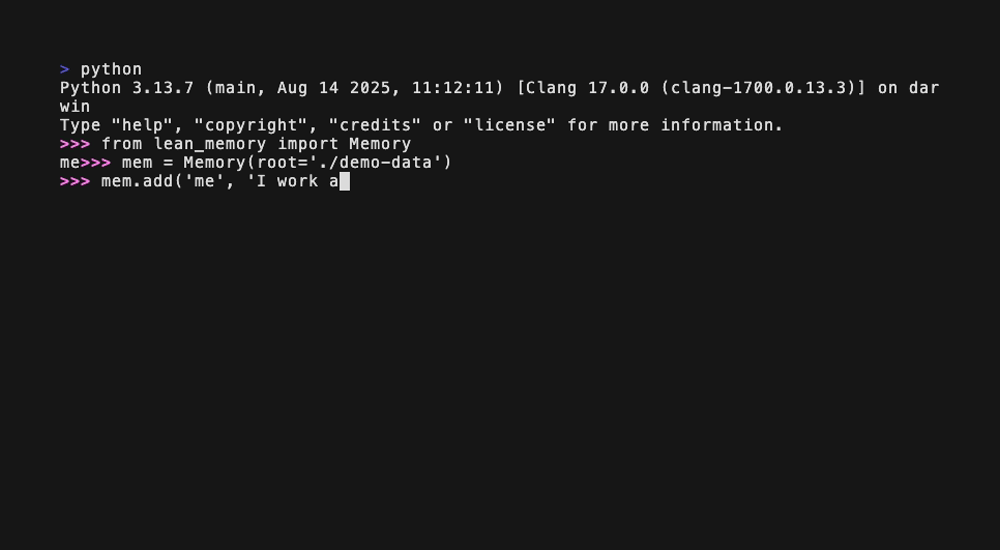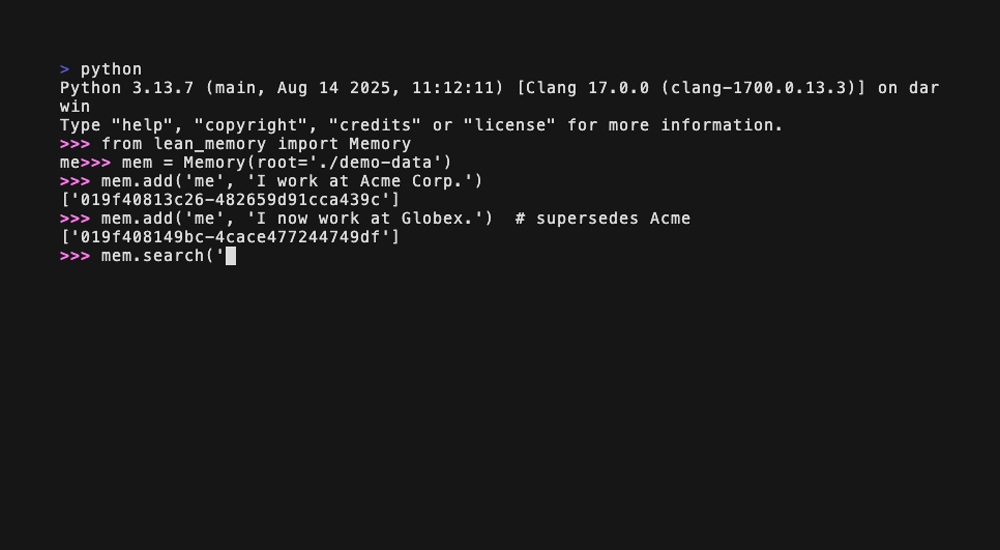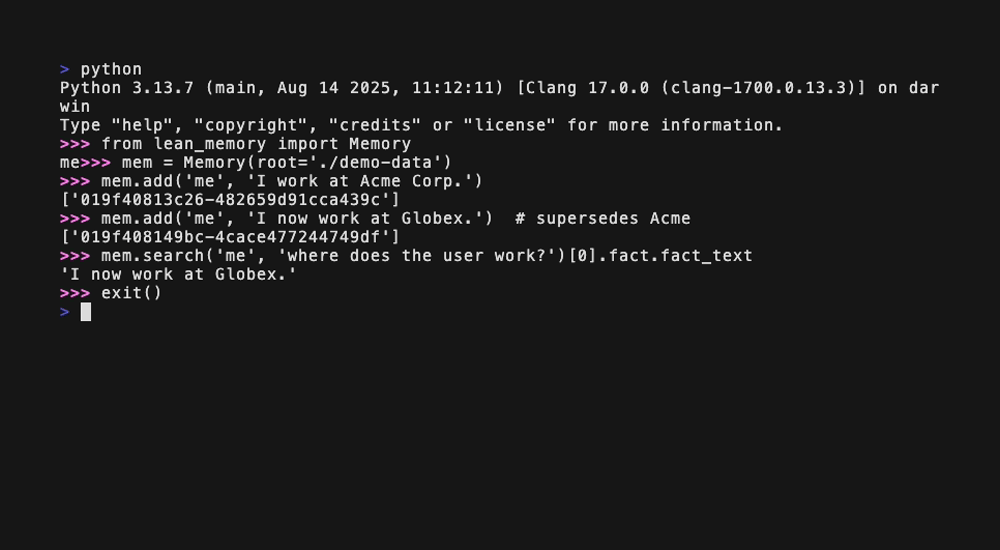
从自然语言中提取事实,将其存储在按命名空间划分的 SQLite 文件中,并通过密集 + 稀疏混合搜索进行检索。旧事实永不删除——它们会被更新取代,并且可以查询任意过去时间点的事实。
安装
pip install lean-memory
开箱即用,完全离线运行。可选扩展可解锁真实模型的质量:
| 扩展 | 功能 |
|---|---|
lean-memory[models] | 真实的嵌入模型 + 重排序模型(Qwen3-0.6B + Ettin-32M) |
lean-memory[extract] | GLiNER2 候选项生成,支持更丰富的信息提取 |
lean-memory[llm] | 基于 Ollama 的 LLM 类型标注流程 |
lean-memory[mcp] | 面向 Claude Desktop / Claude Code 的 MCP 服务桥接 |
lean-memory[examples] | 终端演示 Agent(需要 anthropic SDK) |
快速入门
from lean_memory import Memory

mem = Memory(root="./data")   # one SQLite file per namespace, stored under ./data/

# Store facts in natural language
mem.add("alice", "I work at Stripe.")
mem.add("alice", "I now work at Vercel.")   # supersedes Stripe automatically

# Retrieve — the superseded Stripe fact drops out; only the current one is returned
results = mem.search("alice", "what does Alice do for work?", k=3)
for hit in results:
    print(hit.fact.fact_text, hit.final_score)
# → I now work at Vercel. 0.89

# Point-in-time query — what was true at a specific moment?
mem.search("alice", "employer", as_of=1_700_000_000_000, is_latest_only=False)  # epoch ms

# Always close when done (flushes WAL)
mem.close()
演示 Agent
一个展示完整记忆循环的终端聊天机器人——添加、检索、取代、重启。 演示脚本位于仓库中(不会随软件包一起安装):
git clone https://github.com/Wuesteon/lean-memory && cd lean-memory
pip install -e '.[examples]'
export ANTHROPIC_API_KEY=sk-ant-...
python examples/chat.py                  # uses offline stubs by default
python examples/chat.py --namespace bob  # separate memory tenant, persists across restarts
没有 API 密钥?演示仍可运行——它会回显检索到的记忆上下文,而不会调用 Claude,因此你可以离线观察引擎的工作情况。
MCP 服务 — Claude Code / Claude Desktop 的记忆
为任意 MCP Agent 提供持久化本地记忆:三个工具(memory_add、
memory_search、memory_clear),每个命名空间一个 SQLite 文件,数据不会离开你的设备。
pip install 'lean-memory[mcp,models,extract]'
首次运行会下载三个开放模型(总计约 2.0 GB:用于检索的 Qwen3-Embedding-0.6B
- Ettin-32M 重排序模型,以及用于实际抽取的 GLiNER2-base(约 0.8 GB)——均无需授权。 预热一次,这样 MCP 客户端就不必等待下载:
python -c "from lean_memory.embed.sentence_transformer import SentenceTransformerEmbedder; \
from lean_memory.retrieve.rerank import CrossEncoderReranker; \
SentenceTransformerEmbedder().embed_one('warm'); CrossEncoderReranker().score('warm', ['up']); \
from lean_memory.extract.gliner_extractor import Gliner2Generator; from lean_memory.types import Episode; \
Gliner2Generator().generate(Episode(namespace='w', raw='I work at Acme.', t_ref=0, source='user'))"
Claude Code:
claude mcp add lean-memory -- lean-memory-mcp
Claude Desktop — 添加到 mcpServers(或复制 examples/mcp_config.json):
{ "lean-memory": { "command": "lean-memory-mcp", "env": { "LM_DATA_ROOT": "~/.lean_memory" } } }
数据根目录:LM_DATA_ROOT(默认值为 ~/.lean_memory)。也支持仅离线运行 —
服务会择机升级已安装相应额外依赖的后端([models] → 实际嵌入模型 + 重排序模型,[extract] → GLiNER2 抽取),
否则会回退到确定性桩后端(适用于 CI,但对实际使用而言没有语义意义 — 请安装 [mcp,models,extract])。
可选的
[llm]额外依赖有何作用。 标准的[mcp,models,extract]安装不包含 LLM 类型判定环节,因此升级处理的候选项中约 15% — 几乎全是推断类(derives)事实 — 会由确定性桩而非模型进行类型判定。断言类事实不受影响; 默认路径下,推断类型事实实际上处于次等地位。添加[llm](本地 Ollama 模型)后,升级处理的这类事实即可通过模型进行真正的受约束类型判定。请参阅 ARCHITECTURE.md → 已知限制。
睡眠时段维护与审核
记忆会逐渐堆积杂质:同一事实被换着说法重复十几遍、从未用到的旧记录,以及亟待总结的信息簇。lean-memory 会像睡眠整合记忆一样清理这些内容——这是一个在非工作时间运行的离线任务,用于去重、总结并降低低价值记录的级别,然后将需要判断的事项交给你,供你次日早上在 Web 控制台中逐项审核,或通过 Claude Code 对话审核。
CLI(lean-memory-maintain)是主要的触发方式。它默认采用试运行模式——报告它将会执行的操作,但不会写入任何内容:
lean-memory-maintain --root ~/.lean_memory              # dry-run: report only, zero writes
lean-memory-maintain --root ~/.lean_memory --apply      # auto-apply safe transforms + stage the rest
lean-memory-maintain --root ~/.lean_memory --auto-only   # with --apply: ONLY the provably-safe band, stage nothing
lean-memory-maintain --root ~/.lean_memory --json        # one machine-readable object, stable keys
--root 默认使用 $LM_DATA_ROOT;添加 --namespace NS 可只运行单个命名空间,而不是处理根目录下的所有 *.db。夜间定时运行——只需一行 crontab,即可每天凌晨 3 点运行安全范围内的操作,并为你暂存其他所有操作:
0 3 * * * lean-memory-maintain --root ~/.lean_memory --apply >> ~/.lean_memory/maintain.log 2>&1
**次日早上在 Claude Code 中审核。**需要判断的事项(近似重复项合并、摘要、淘汰)会暂存为提案——未经你批准,存储的记忆不会发生任何变化。运行 /review-memory 插件命令(或在控制台服务上调用 review-memory-maintenance MCP 提示词),Claude 会按实体分组,结合操作前后的证据逐项引导你审核队列,并且只记录你给出的决定。该功能由四个 MCP 工具提供支持——memory_maintenance_run(默认试运行,与 CLI 一样)、memory_maintenance_status、memory_review_queue 和 memory_review_decide——这些工具可在核心 lean-memory-mcp 服务以及两个控制台 MCP 接口中使用。设置 LM_MAINT_AUTO=1 可选择在过期命名空间首次收到工具调用时于后台自动运行(仅限安全范围内的操作);默认关闭。
**也可以在控制台中逐项审核。**记忆控制台提供一个 Review 页面:队列按实体分组,每项提案都附有操作前后的证据(近似重复项包含两段文本和余弦相似度;摘要包含来源和拟定文本;淘汰包含评分证据),并提供 Approve / Keep / Edit-then-approve / Promote 操作、按实体批量批准,以及运行维护的按钮(默认试运行;实际应用需先确认)。两个前端使用同一提案存储,并通过比较并设置决策,因此在一处作出的决定会在另一处显示为“已决定”,不会重复应用。
一段话说明安全机制。任何内容都不会被删除——维护操作只会追加记录、将其标记为已退役(即像普通的上位替代操作一样翻转 superseded_by),或将其降级到冷层。因此,完整历史始终可按任意过去时间点查询,存储谓词逐位保持不变,并由可执行测试保障。只有两种转换会自动应用:完全重复项退役和严格的淘汰范围;所有需要判断的事项都会暂存,由人工处理。未审核的提案会在 30 天后过期,而不是自动应用——沉默绝不代表同意。降级到冷层的事实仍可通过 as_of 查询和 search(..., include_cold=True) 访问,且只有明确操作才能将其提升回热层,因此读取操作永远不会持久改变 Agent 所看到的内容。
实际模型质量
默认后端是离线存根——结果确定且不依赖其他组件,但在语义上毫无意义。换用实际模型即可获得生产级检索效果:
pip install 'lean-memory[models]'
使用 Qwen3-Embedding-0.6B 和 Ettin-32M 重排器后,内部基准测试的检索效果从 1/5 提升到 4/5,无需修改任何代码。
基准测试结果、架构决策和实现状态请参阅 ARCHITECTURE.md。
工作原理
每次调用 mem.add() 都会运行一个包含 4 个阶段的混合抽取流水线:
- 规则 — 使用正则表达式 + dateparser 处理常见谓词(
works_at、lives_in,……) - GLiNER2 — 开放词汇 NER 候选项生成(默认使用离线存根)
- 路由器 — 倾向召回的升级机制:置信度较低、涉及共指以及推理得出的(
derives)事实会升级到 LLM 阶段 - LLM 类型判定 — 通过本地 Ollama 模型进行受约束的关系类型判定(默认使用存根)
矛盾检测按成本从低到高依次执行(槽位匹配 → 余弦相似度 → 令牌包含关系 → LLM)。冲突事实会被取代,而非删除——旧事实会保留,标记为 is_latest=False,并带有指向新事实的 superseded_by 指针。
实体身份通过规范化名称键解析——NFC + Unicode 大小写折叠 + 空白字符合并——因此 Acme、ACME 和 acme 会被视为同一主体,去重和取代机制也会实际作用于它们。这是完整的 Unicode 折叠,并非 SQLite 仅支持 ASCII 的 NOCASE:Café/CAFÉ 和 ЖУК/жук 也会被视为相同。标点和变音符号不会折叠(Yahoo! ≠ Yahoo,Café ≠ Cafe),显示名称会保留你首次使用的拼写。取舍在于:两个实际上不同、但仅大小写不同的主体(行星 Mercury 和金属 mercury)会被视为相同——没有任何内容会被删除,而且可以通过 search(as_of=…, is_latest_only=False) 继续读取已退役的事实。
检索将两阶段 Matryoshka 稠密搜索(256 维粗略 KNN → 全维度重新评分,默认嵌入器为 1024 维)与 BM25 稀疏搜索融合,应用 RRF 融合,通过交叉编码器重新排序,并使用显著性衰减进行评分(0.6·relevance + 0.2·recency + 0.2·importance)。
开发
git clone https://github.com/Wuesteon/lean-memory
cd lean-memory
python -m venv .venv && source .venv/bin/activate
pip install -e '.[dev]'
pytest -q    # full offline suite, no downloads
项目结构
src/lean_memory/
  memory.py                   Memory facade — the public API
  types.py                    Episode / Fact / RetrievedFact types
  store/                      Store interface + SqliteStore (vec0 + FTS5)
  embed/                      Embedder interface, FakeEmbedder, SentenceTransformer
  extract/                    4-pass extraction pipeline
  retrieve/                   Reranker interface, retrieval pipeline
examples/
  chat.py                     Terminal demo agent
  mcp_config.json             Drop-in MCP client config
tests/                        offline test suite
bench/                        Retrieval quality + BET-2 ablation harnesses
许可证
Apache-2.0
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。