关于 Awaitless
Awaitless 为编码 Agent 提供持久化执行层,可在本机、SSH 主机或 Slurm 上运行命令。它提供稳定的任务跟踪、具名 FIFO 队列和结果恢复,不需要常驻服务。
主要功能
- 01带稳定 ID 的持久化任务
- 02具名 FIFO 并发队列
- 03本机、SSH 与 Slurm 执行
- 04可恢复结果与有限日志
- 05CLI 与 MCP 任务控制
适用场景
- 01运行长时间构建或测试,无需轮询
- 02为具名稀缺资源排队
- 03客户端断开后恢复结果
- 04收集并行任务的完成结果
MCP 相关
其 stdio MCP 服务允许编码 Agent 提交、运行、等待和收集任务。持久化任务状态与执行不会因服务端或客户端会话结束而中断。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
11收录的工具列表 · 更新于 2 周前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| cwd | any | 否 | |
| env | any | 否 | |
| host | any | 否 | |
| name | any | 否 | |
| queue | any | 否 | |
| backend | any | 否 | |
| command | array | 是 | |
| artifacts | any | 否 | |
| resources | any | 否 | |
| capture_logs | any | 否 | |
| slurm_options | any | 否 | |
| timeout_seconds | any | 否 | |
| client_request_id | any | 否 | |
| stall_timeout_seconds | any | 否 | |
| inline_timeout_seconds | any | 否 |
详细介绍
Awaitless



为编码 Agent 提供自适应的持久化执行能力。
通过一个执行层运行命令。快速任务以内联方式返回;较长或排队中的任务则会在本地、SSH 和 Slurm 环境中持久运行。你的工作负载始终运行在你已有的基础设施上。
Agent 提交任务,Awaitless 负责执行。
Awaitless 是连接编码 Agent 与其所用计算资源的自适应持久化执行层。它为 Agent 提供统一稳定的任务约定,同时在底层复用你的本地机器、SSH 主机和 Slurm 集群。
在现有计算资源上统一管理任务生命周期
Coding agent → submit work → Awaitless owns the job lifecycle → Local / SSH / Slurm
| 持久化任务 | 命名的稀缺资源队列 | 完成与恢复 |
|---|---|---|
| 稳定 ID、状态、取消操作、有限长度的日志和 Artifacts,都会在客户端断开连接后保留。 | 持久化 FIFO 准入机制可防止过多任务同时使用同一命名资源。 | 可通过 Job ID 或可重放的完成游标获取退出代码和结果。 |
Awaitless 负责任务生命周期,而非硬件。它不会发现资源、理解 GPU 拓扑、分配多个资源,也不会取代集群调度器。运维人员为队列命名并设置固定并发数;Slurm 继续处理 --gpus 2 --mem 64G 等请求以及所有物理集群调度。
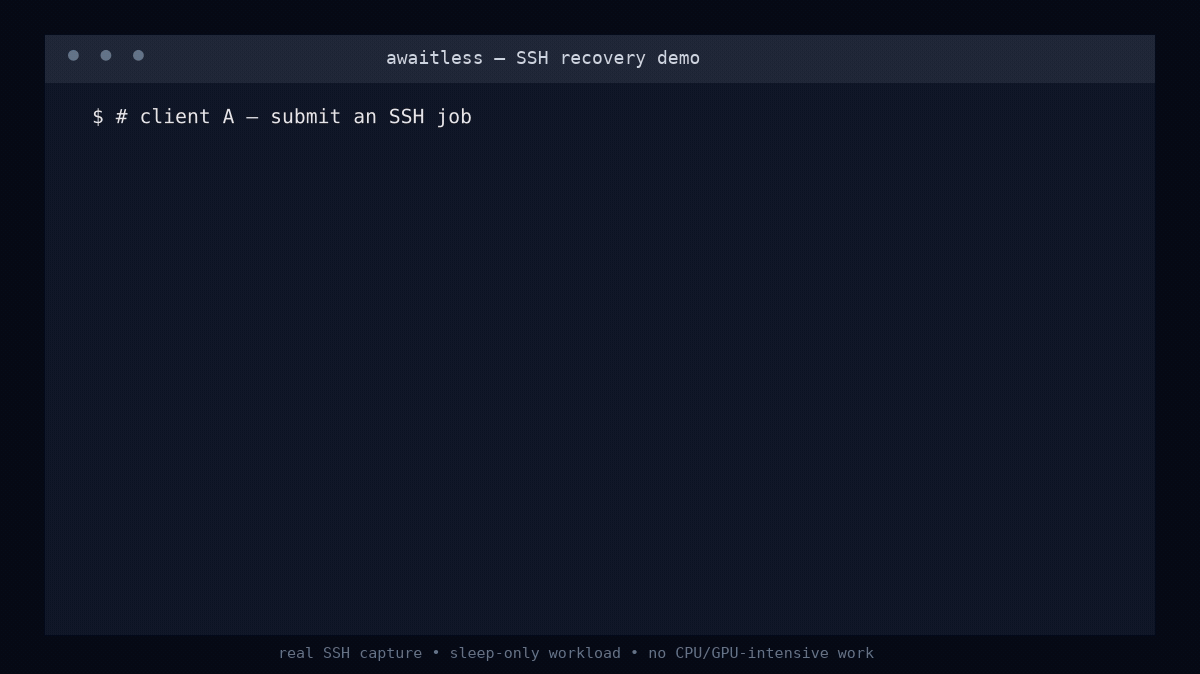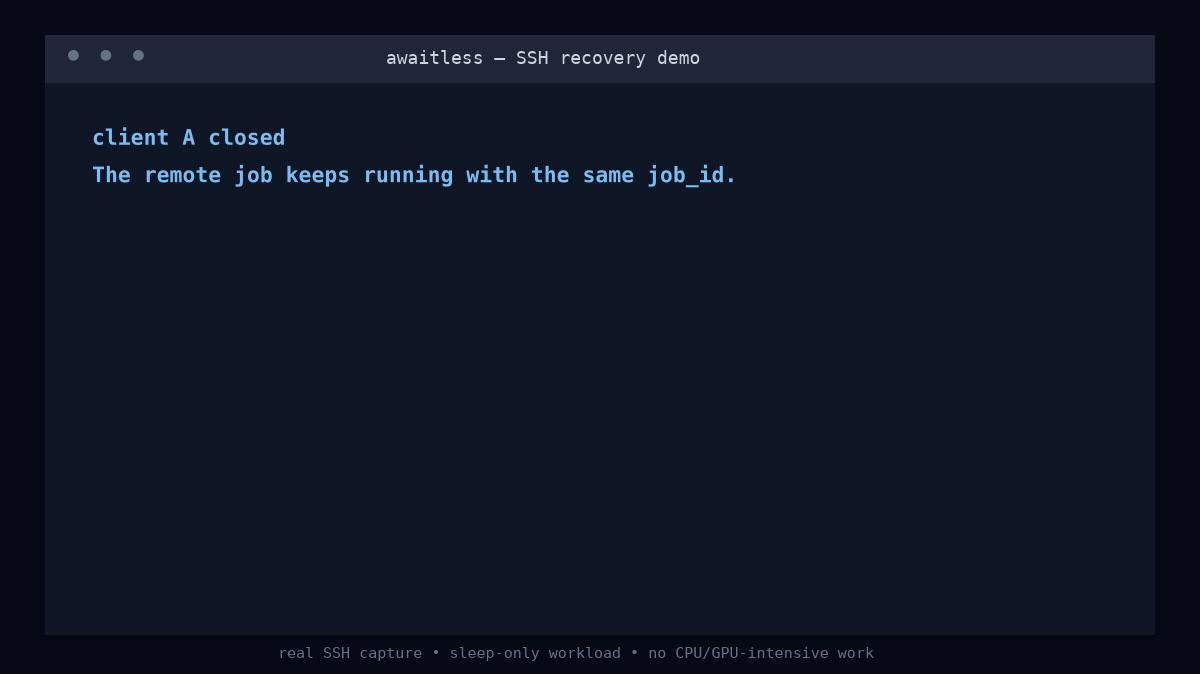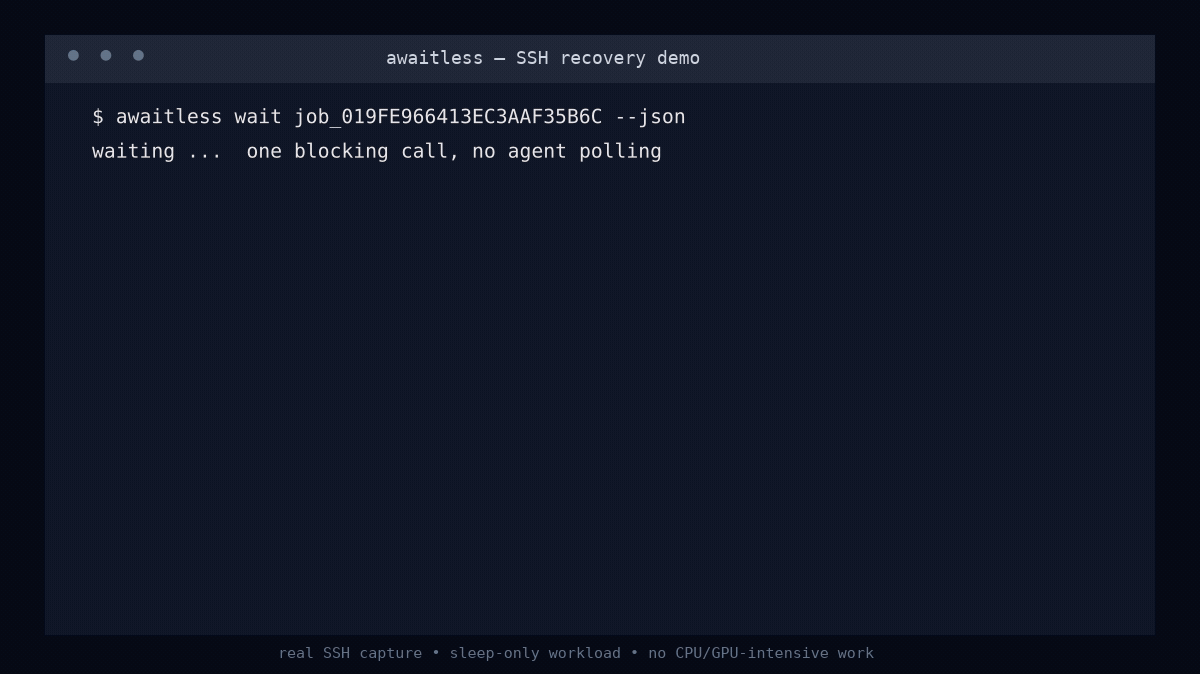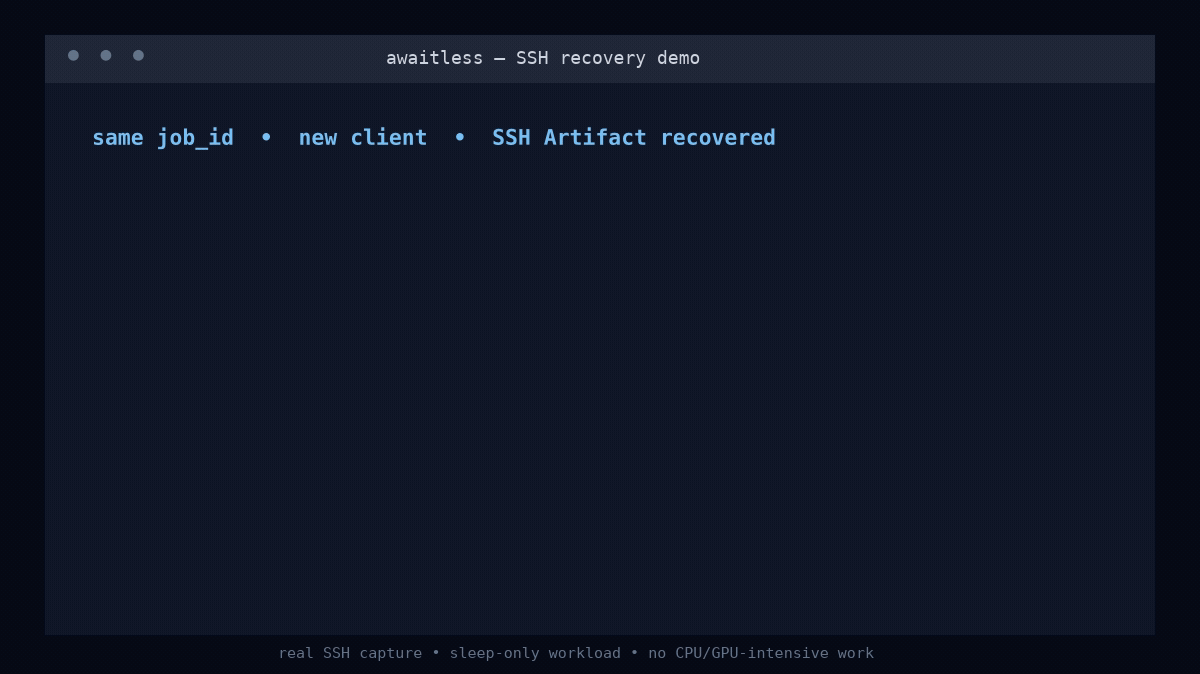
编码 Agent 应该编写代码,而不是看管任务
Agent 可以自行编写 run → sleep → check 循环。更难的问题是,如何在长时间运行的工作负载和不断变化的会话中,可靠地管理任务标识、断开连接后的恢复、队列准入、取消和结果交付。缺少这一执行层时,Agent 会不断将同一份不断增长的日志拉回上下文:
ssh gpu 'run_benchmark > job.log 2>&1 &'
ssh gpu 'tail -n 200 job.log'  # again...
ssh gpu 'tail -n 200 job.log'  # and again...
Awaitless 将整个生命周期整合为一次自适应执行调用和一个结果边界:
awaitless run --json --host gpu --artifact results.json -- ./run_benchmark
# quick: {"state":"succeeded","delivery":"inline","exit_code":0,...}
# longer: {"job_id":"job_019F...","state":"running","delivery":"detached",...}

awaitless wait job_019F... --json
# {"state":"succeeded","exit_code":0,"parsed_results":{...}}
分离运行的 JSON 还包含 job_state、wait_state、delivery_state 和可直接复制的 next_command。客户端等待超时并不意味着工作负载失败:可使用 awaitless wait --last --json 等待最近分离运行的 Job,也可使用返回的命令及其稳定 Job ID。若要查看基准测试行而无需读取大量日志末尾内容,可使用 awaitless logs <job-id> --grep 'PASS|FAIL|median|CV'。
每次 run 都会在启动前持久化。在内联时间窗口内完成时,结果看起来与普通命令执行结果无异;超过时间窗口则只会分离等待操作。中断等待操作、关闭 MCP 客户端,或启动全新的 Agent 会话:Job 仍会继续运行,其稳定 ID 可用于恢复结果。
在命名资源空闲前排队处理工作
创建一次持久化 FIFO 队列,然后立即提交每条命令:
awaitless queue create gpu0 --concurrency 1

awaitless submit --queue gpu0 -- python train_a.py
awaitless submit --queue gpu0 -- python train_b.py
awaitless submit --queue gpu0 -- python train_c.py
第一条命令会运行,其余命令会报告 queued。有可用容量时,每条命令都会自动启动。这是针对命名稀缺资源的持久化准入控制:固定并发数和 FIFO 顺序,不支持优先级或抢占。Awaitless 绝不会终止正在运行的工作来为后续任务腾出空间。
运维人员还可以全局或按主机将自适应运行绑定到队列:
[hosts.gpu]
hostname = "gpu.example.com"
queue = "gpu0"
这样,Agent 就可以调用 run,无需选择队列,也无需事先探测 GPU。
此队列不会发现资源、识别 GPU 拓扑、动态分配设备、发放租约,也不会组合诸如两块 GPU 加 64 GB 内存之类的请求。这些职责应由 Slurm 或其他调度器承担;Awaitless 则围绕该调度器提供面向 Agent 的作业生命周期管理。
消费最先完成的作业
v0.7 新增了 completions ... --drain --json,可在一次调用中消费一小组并行作业,无需客户端维护游标。长时间运行的作业可以通过 wait --progress-interval 30s 发出结构化心跳更新。使用 --capture-log PATH 保存由命令管理的日志,并使用 --resource gpu=0 或 --device 0 进行显式独占准入;终态结果会冻结有大小限制的日志、诊断信息、计时、环境以及以 SHA-256 标识的快照。
提前提交彼此独立的工作,保留每个 Job ID,然后在一个持久化的完成边界等待:
awaitless completions job_A job_B job_C --json
# {"completions":[...],"next_cursor":"cmp_...","active_job_ids":[...]}

awaitless completions job_A job_B job_C --after cmp_... --json
首次调用会立即返回已完成的工作,否则会阻塞,直到至少一个所选 Job 完成。处理完这批结果后,再推进到 next_cursor;重用较旧的游标可以安全地重放相同的完成 ID。如果客户端消失,新会话可以从已保存的游标继续。Awaitless 会持久化后续结果以供获取,但不会执行 Agent 的下一步推理,也不要求常驻通知服务。
v0.8 证据套件用四个问题取代了历史上的调用次数演示:Agent 是否正确选择协议,Job 在故障后能否存续且不会重复启动,Awaitless 是否能让执行管理状态远离推理循环,以及自适应 run 是否能让短命令保持低使用门槛。请参阅 v0.8 证据计划。
v0.8 证据状态
发布证据与模型和提交版本相关。仓库中检入的套件不会沿用早期版本或其他模型的数据。运行 v0.8 基准测试,检查每条原始记录,然后发布注明日期的报告,其中包含模型、配置哈希、Git 提交、跳过的工作负载,以及计入分母的所有失败。经过审核的 v0.8 证据报告包含完整的原始记录和分析摘要,而非仅列出选定的分数。
30 秒体验故障恢复流程
需要 Linux、Python 3.10+ 和 Bash。运行内置演示,无需持久安装:
uvx --from awaitless-runner awaitless demo --json
该演示会提交两个本地作业,终止它们的首个完成等待客户端,然后使用新客户端通过游标获取两个有大小限制的结果和 JSON Artifacts。
常规 CLI 用法:
uv tool install awaitless-runner
awaitless doctor --json
也可以使用 pip install awaitless-runner。
将其交给你的编码 Agent
在客户端的配置中添加一个 stdio MCP 服务(根据你的客户端调整外层键):
{
  "mcpServers": {
    "awaitless": {
      "command": "uvx",
      "args": ["awaitless-runner"]
    }
  }
}
首选的 run 工具会直接返回快速命令的结果,并自动为较长时间运行或排队的工作提供持久句柄。支持 Tasks 的客户端仍可使用 run_job,而低级客户端仍可使用 submit_job 和 wait_for_job。使用相同的 client_request_id 重试高成本提交,不会启动重复作业。对于并行工作,无论是否支持 MCP Tasks,所有客户端都可以使用 wait_for_completions。
规范性的身份、生命周期、续接、完成、Artifact 和兼容性契约见 Awaitless Agent Job Protocol。
Codex 插件
此仓库也是一个 Codex 插件。其清单将 Awaitless Agent 技能与 stdio MCP 服务打包在一起,Codex 会通过 uvx 启动该服务。从本地 Codex 市场安装此仓库,然后启动新的 Codex 任务,以便同时加载技能和 MCP 工具。
此插件要求 PATH 中有 uvx;首次启动 MCP 时,如果缓存中尚无 awaitless-runner,则会从 PyPI 下载。
直接使用 CLI 时,完整流程如下:
awaitless run --json --name tests -- python -m pytest -q
# If delivery is detached, save the returned job_id, then:
awaitless wait <job-id> --json
# Or recover the most recent detached job:
awaitless wait --last --json
一个接口,三种运行位置
| 后端 | Awaitless 提供的功能 |
|---|---|
| 本地 | 持久化进程组跟踪、取消、限制日志大小,以及具名事务队列。 |
| SSH | 相同的作业契约,以及在目标主机上协调的队列,无需远程守护进程。 |
| Slurm | 真正的 sbatch 调度,以及持久化的 Slurm ID、队列/记账状态、退出码、日志、取消和 Artifacts。 |
使用 --backend、--host 或配置默认值即可切换目标,无需更改 Agent 提交和收集工作的方式。
为什么不直接使用 shell 或 tmux?
| 工具 | 最适合的场景 | Agent 仍需构建的内容 |
|---|---|---|
| 阻塞式 shell 调用 | 快速检查和交互式工作 | 工程命令运行时间超出预期后的生命周期管理。 |
Shell 轮询/nohup | 让基本命令持续运行 | ID、状态、退出码恢复、限制日志大小、取消、去重和结果解析。 |
tmux | 人类从交互式 shell、REPL 和 TUI 中脱离 | 可靠的非交互式作业协议和包装脚本。 |
| Awaitless | Agent 运行的构建、测试、基准测试、远程作业和集群工作 | 只需提供命令,以及可选的要返回的 JSON Artifact。 |
Awaitless 不会取代交互式终端或 Slurm。它为编码 Agent 提供本地/SSH 机器上的持久化固定并发队列,并将集群资源调度交由 Slurm 处理。
工作原理
flowchart LR
    A["Coding agent"] -->|"run"| B["Awaitless MCP / CLI"]
    B --> C[("SQLite job record")]
    C --> Q["Optional queue admission"]
    Q -->|"capacity available"| D{"Backend"}
    D --> L["Local process"]
    D --> S["SSH host"]
    D --> H["Slurm allocation"]
    L --> I{"Finished inline?"}
    S --> I
    H --> I
    I -->|"yes: result"| A
    I -->|"no: durable handle"| A
    A -. "reconnect with stable ID" .-> C
    C --> E["Durable completion cursor"]
    E -->|"state + exit code + bounded logs + Artifacts"| A
Awaitless 没有守护进程、HTTP 服务或托管沙盒。每次调用都会打开同一个 SQLite 存储;已提交的运行器和调度器作业会在创建它们的 stdio 服务退出后继续运行。完整日志会保留在磁盘上,只有有限长度的尾部日志会进入 Agent 上下文。
文档
- 文档索引
- 产品定位与演进原则
- v0.6 自适应运行
- v0.7 不可变完成快照
- v0.5 持久化完成事件流
- CLI、配置、SSH、Slurm、持久化、Artifacts 和故障排除
- MCP Tasks 协议与兼容性
- 基准测试定义、方法与解读
- 真实 MCP → Slurm 断开连接证据
- 架构与设计原理
许可证
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。