关于 FrankenSurf
FrankenSurf 是供 AI Agent 使用的网页读取与搜索工具集,通过按成本递增尝试工具并检查页面内容,返回页面数据和尝试记录。它可通过 MCP、Python API 或命令行使用,也支持地图生成和爬取。
主要功能
- 01按成本递增尝试网页读取工具
- 02检查页面有效性并提供尝试记录
- 03搜索并核验搜索结果
- 04读取、映射和爬取网站
- 05可选付费回退与成本上限
- 06支持配置文件及人工验证交接
适用场景
- 01让 Agent 读取受访问限制的网页
- 02搜索并筛选特定主题或日期的结果
- 03将网站页面爬取为 Markdown
- 04在读取失败时查看使用过的工具及成本
MCP 相关
MCP 服务向客户端提供网页读取、搜索、站点映射与爬取等工具,并附带页面质量和工具尝试记录。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
19收录的工具列表 · 更新于 2 周前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| url | string | 是 | |
| items | any | 否 | |
| module | any | 否 | |
| render | any | 否 | |
| schema | any | 否 | |
| profile | any | 否 | |
| identity | any | 否 | |
| provider | any | 否 | |
| freshness | any | 否 | |
| lightning | any | 否 | |
| card_images | any | 否 | |
| expect_terms | any | 否 | |
| main_content | any | 否 | |
| allow_archive | any | 否 | |
| allow_handoff | any | 否 | |
| include_images | any | 否 | |
| module_override | any | 否 | |
| try_harder_than | any | 否 | |
| acquisition_policy | any | 否 | |
| allow_real_browser | any | 否 |
详细介绍

Frankensurf
为 AI Agent 提供一个 read() 调用,由 41 种网页工具拼接而成。
优先使用最便宜的工具,检查每个页面,并为每次尝试提供凭据。



每种网页工具总会在某些地方失效,而且失效的网站各不相同。Frankensurf 位于所有工具之前,为你的 Agent 提供一次调用。它会先尝试最便宜的工具,检查页面是否真实;只有网站进行阻拦时,才会改用更强大的工具,并返回干净的页面数据,以及获取数据的过程凭据。
| 优先使用最便宜的工具 普通 HTTP、Jina Reader、本地浏览器、免费隐身浏览器、托管浏览器,最后才是付费 API(仅在你允许时)。 | 检查每个页面 挑战页面、登录墙,或结果始终未加载的搜索页面,都算失败,而非成功。 | 展示处理过程 每个结果都会说明运行了哪些工具、各自耗时、费用,以及停止的原因。 |
快速开始
支持 Linux、macOS,或通过 WSL 使用的 Windows,需安装 Python 3.12+。无需账户或密钥。
pip install "frankensurf[mcp]"
frankensurf install        # every free tool: browsers, stealth browsers, local search, Crawl4AI
frankensurf read "https://www.walmart.com/search?q=air+fryer" --explain
读取过程会逐步升级,直到获取真实页面:
https://www.walmart.com/search?q=air+fryer
  ✗ http                   CAPTCHA                0.4s
  ✗ local                  CAPTCHA                1.5s
  ✓ camoufox               got the page           15.6s

air fryer - Walmart.com
24,192 characters via camoufox, complete (107 results), free
frankensurf install 的用法与 playwright install 类似:只需指定需要的工具
(frankensurf install search chromium);在 Linux 上添加 --with-deps 可安装浏览器所需的系统库;使用 --list 查看各处已安装的内容;使用 frankensurf uninstall all 将其移除。无需 Docker。每个版本都会从 PyPI 安装到全新的 Ubuntu 和 macOS 机器上,并经过检查。
使用方法
在 Agent 中使用,作为 MCP 服务(各客户端的配置方法):
claude mcp add frankensurf -- frankensurf-mcp
在 Python 中使用:
import frankensurf as fs

page = fs.read("https://example.com/pricing")
if page.ok:
    print(page.title, page.text[:500])
else:
    print("couldn't read it:", page.failure)    # {"code": "CAPTCHA", "message": ...}

pages = fs.batch(urls, links=True)               # paced per site, in order
hits = fs.search("playwright python tutorial", recency="month")
page = await fs.aread(url)                       # aread, abatch, asearch inside async code
对于长时间运行的服务,请保持一个 Runtime 处于打开状态:async with Runtime() as web: await web.read(url)。
映射和爬取:fs.map(url) 会列出网站的 URL;fs.crawl(url, limit=50) 会以 Markdown 格式读取网站的一个部分。
Agent 模式(pip install "frankensurf[agent]",支持任意 LiteLLM 模型):fs.ask("question") 会搜索、读取并回答,同时提供来源并说明无法读取的内容;fs.extract(urls, schema=...) 和 fs.summarize(url)。
Agent 模式。
在 Docker 中使用,一次安装即可供整个网络使用:docker run -p 3002:3002 -e FRANKENSURF_API_KEY=... ghcr.io/yail259/frankensurf
(Docker)。
在任何接受 Firecrawl URL 的工具中使用(GPT Researcher、Hermes Agent、OpenClaw、Open WebUI、Dify、LibreChat、n8n、LangChain、LlamaIndex 等):
运行 frankensurf serve,然后将其指向 http://127.0.0.1:3002(配置方法)。
在命令行中使用:
frankensurf read https://example.com --markdown
frankensurf search playwright python tutorial --recency week
frankensurf watch https://news.ycombinator.com/ --link-pattern 'item\?id=\d+'
在 Claude Code 中作为插件使用(MCP 服务加上教会 Claude 如何使用它的技能):
/plugin marketplace add yail259/frankensurf
/plugin install frankensurf@frankensurf
在 LangChain、OpenAI Agents SDK 或 CrewAI 中使用(pip install "frankensurf[langchain]" 等):
from frankensurf.agent_tools import langchain_tools   # or openai_agents_tools, crewai_tools
tools = langchain_tools()                              # frankensurf_read, frankensurf_search
你会得到原始页面数据,而非答案:文本或 Markdown、JSON-LD、页面自身的 JSON、图片以及回执。由你的 Agent 判断页面的含义。如果结果不符合预期,它会使用 retry_of=<trace_id> 再次请求,而 Frankensurf 会跳过它已经尝试过的所有工具。
基准测试
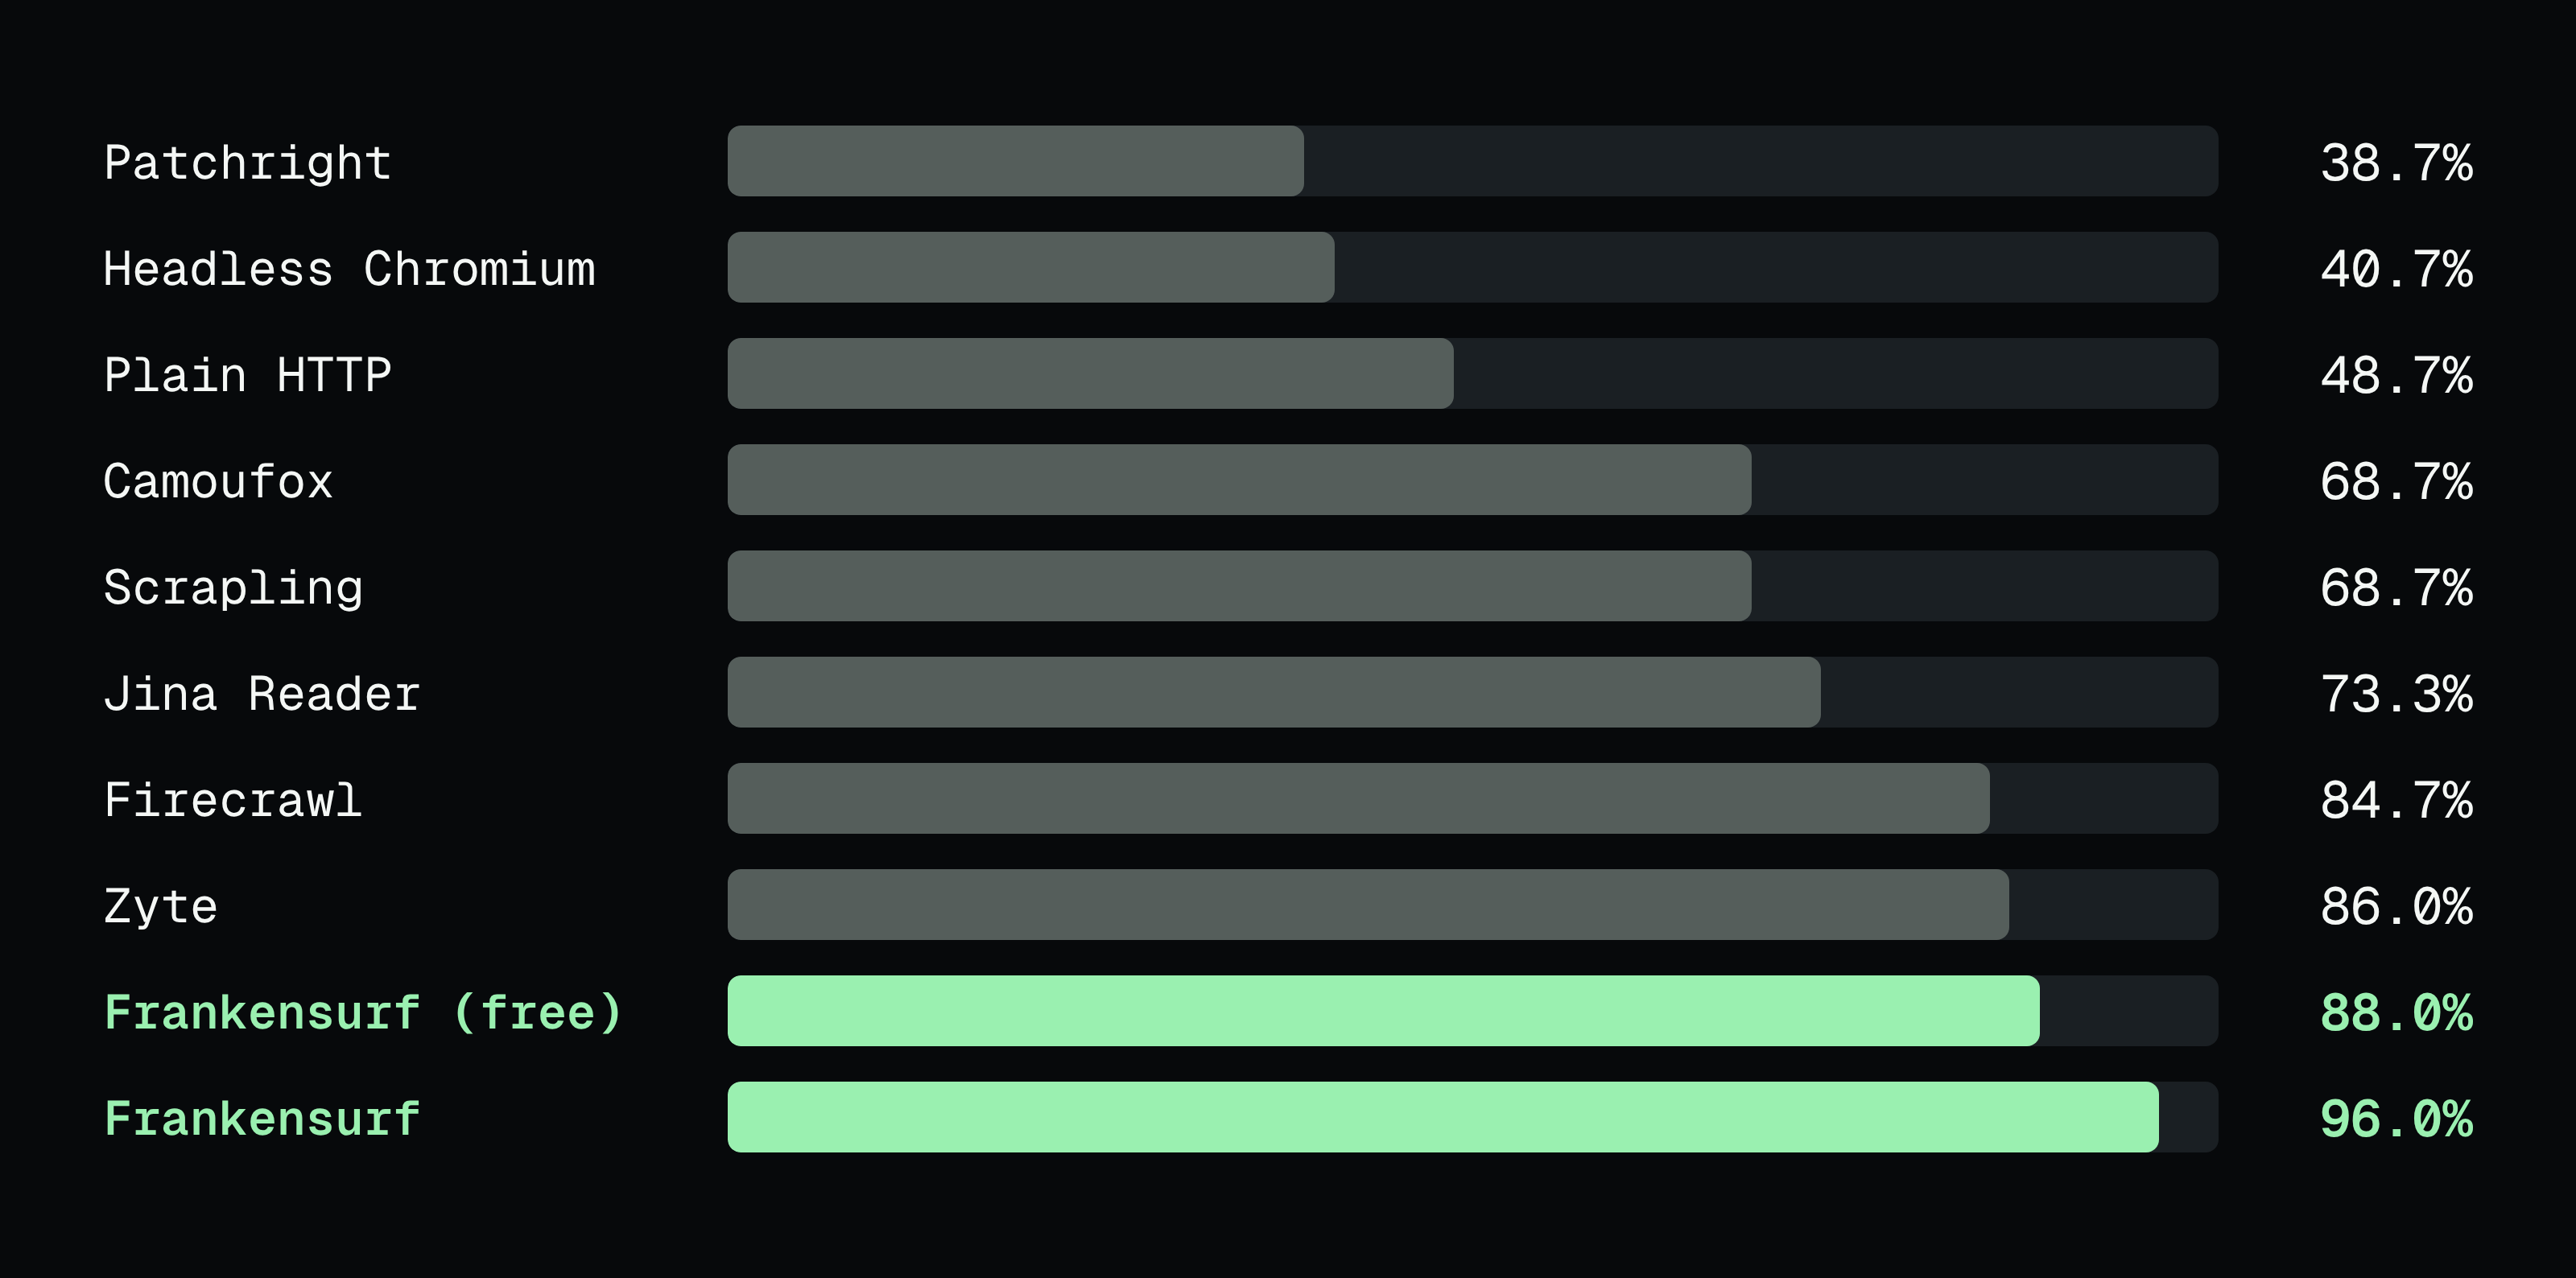
每 1,000 个正确页面的成本: Frankensurf 的免费工具费用为 $0,使用每月 $5 的服务成本约为 $0.01(正确率为 87–88%);搭配付费备用工具时为 $0.22(正确率为 96%);单独使用 Firecrawl 时,Scale 套餐为 $0.71,Standard 套餐为 $0.98(正确率为 85%)。 成本计算方式。
scripts/toolbench.py 会先单独运行每种工具,再运行 Frankensurf,对相同页面执行相同的内容检查。最新一组测试:从 15 个类别中选出 150 个网站,在读取任何网站之前完成选取;每个网站只读取一次(2026 年 10 月 11 日,原始数据见 benchmarks/2026-10-11/)。
| 工具 | 读取的网站 | 中位数 | 每 1k 的成本 |
|---|---|---|---|
| 纯 HTTP | 48.7% | 1.2 s | 免费 |
| 仅 Camoufox | 68.7% | 10.9 s | 免费 |
| 仅 Jina Reader | 73.3% | 1.5 s | 免费 |
| 仅 Firecrawl | 84.7% | 4.6 s | $4.28 |
| 仅 Zyte | 86.0% | 10.7 s | 未报告 |
| Frankensurf,仅使用免费工具 | 88.0% | 3.6 s | $0 |
| Frankensurf,搭配付费备用工具 | 96.0% | 2.9 s | $0.98 |
- Frankensurf 读取了 Firecrawl 漏掉的 17 个网站;Firecrawl 没有读取任何它漏掉的网站。
- 完全不使用付费工具时,Frankensurf 的表现与单独使用的最佳付费工具持平(88.0%,对比 86.0% 和 84.7%;在 150 个网站的测试规模下,这一差距处于误差范围内)。
- Frankensurf 最慢的读取耗时更长:耗时最长的 10% 需要 25.7 s,而 Firecrawl 为 10.6 s;这是因为读取过程会逐步尝试多种工具。
- 这并非个例:前一天的测试集为 95.3% 对比 85.3%;更早的新测试集分别为 89.5% 对比 80.3%,以及 88.5% 对比 74.1%。
在相同的 150 个网站上测试每种工具
| 工具 | 读取的网站 | 中位数 | 每 1k 的成本 |
|---|---|---|---|
| 仅 Patchright | 38.7% | 4.1 s | 免费 |
| 仅 Headless Chromium | 40.7% | 2.7 s | 免费 |
| 纯 HTTP | 48.7% | 1.2 s | 免费 |
| 仅 Camoufox | 68.7% | 10.9 s | 免费 |
| 仅 Scrapling | 68.7% | 8.5 s | 免费 |
| 仅 Jina Reader | 73.3% | 1.5 s | 免费 |
| 仅 Firecrawl | 84.7% | 4.6 s | $4.28 |
| 仅 Zyte | 86.0% | 10.7 s | 未报告 |
| Frankensurf,仅使用免费工具 | 88.0% | 3.6 s | $0 |
| Frankensurf,搭配付费备用工具 | 96.0% | 2.9 s | $0.98 |
中位数按成功读取的页面计算;成本按每 1,000 个正确读取的页面计算。ZenRows 和 Scrapfly 未列入(其套餐额度已用完)。测试使用全新的云虚拟机,其数据中心 IP 地址更容易被网站拦截:免费工具的成功率为 82.0%,闪电模式为 84.0%,中位耗时为 1.2 s。 参见基准测试。
与可自托管的 Firecrawl 对比
Firecrawl 也是开源的,因此对自行运行它的人来说,公平的比较问题是:自托管的 Firecrawl 表现如何?其文档称,自托管实例无法使用其云服务中的反机器人层 Fire-engine。在相同的 150 个网站上,于 2026 年 10 月 23 日进行测试;两种服务都在同一台机器的 Docker 中运行,每个网站均由两者读取,且按网站交替由哪一方先读取:
| 自托管 Firecrawl 2.11.604 | Frankensurf 0.52.0(免费工具) | |
|---|---|---|
| 正确读取的页面 | 89 / 150 | 126 / 150 |
| 错误页面被当作目标页面返回 | 18 | 5 |
| 无结果 | 43 | 19 |
| 读取期间的内存占用 | 约 4.2 GB,六个容器 | 1.4 GB,一个容器 |
| 两者都成功读取的页面的中位耗时 | 4.2 s | 4.8 s |
| 两者都成功读取的页面中,耗时最长的 10% | 9.8 s | 17.8 s |
| 放弃读取页面所需的时间(中位数) | 1.5 s | 16.5 s |
- Frankensurf 读取了自托管 Firecrawl 漏掉的 38 个网站;Firecrawl 读取了 Frankensurf 漏掉的 1 个网站。
- 更慢的长尾耗时和更晚的放弃时间,是多读取页面所付出的代价:自托管 Firecrawl 只尝试一次就停止,而 Frankensurf 会逐步尝试隐匿浏览器,并在返回页面前逐一检查。
- 数据行、脚本和设置:
benchmarks/2026-10-23-self-hosted-firecrawl/。 使用frankensurf compare urls.txt --against http://localhost:3002,在你自己的页面上运行测试。
搜索
search 会优先使用免费来源,并检查每条结果是否切合主题、页面类型是否合适,以及是否在日期范围内。只有在你允许使用付费工具时,Exa、Brave、Tavily、Serper 等付费来源才会加入。盲测时(将结果汇总并打乱,隐藏每条结果来自哪个工具),前五条中有用的结果:
| 盲测组 7(120 个查询) | 有用结果数(满分 5) | 每 1,000 次的费用 |
|---|---|---|
| Frankensurf,允许使用付费来源 | 4.67 | $9.38 |
| 仅 Exa | 4.66 | $9.50 |
| Frankensurf,免费(搭配本地搜索引擎) | 3.83 | $0 |
免费时,它的搜索效果优于 Firecrawl:在 35 个查询中表现更好,在 5 个查询中表现更差。允许使用付费来源时,它与 Exa 持平。本地搜索引擎(frankensurf install search,不使用 Docker 的 SearXNG)大幅增强了免费版的效果。v0.41 再次提升了免费搜索效果:在一组全新的 120 个查询盲测中,它有 41 个查询胜过 v0.40,12 个查询不如 v0.40(有用结果数为 3.42,对比 2.71,满分均为 5;
benchmarks/2026-10-14-search-v041/)。详情见
benchmarks/2026-10-13-search/。
盒子里还有什么
读取:质量等级、主要内容、竞速慢速读取、PDF
- 每次读取都带有
receipt.quality:good、partial或poor,以及paywall、menus或placeholder等标记,让 Agent 知道页面是否未能正常加载。 --schema product.json(MCPschema)会从页面的 JSON-LD、微数据、 元标记和自有 JSON 中填充 JSON Schema,并将结果写入extracted;如果必填字段缺失, 则会升级使用能力更强的工具(参见结构化字段)。--main(MCPmain_content=True)会添加main_text:不含菜单、页脚和 横幅的文章内容(搭配pip install "frankensurf[main]"效果最佳)。- 如果 3 秒后仍未获取到页面,就会在旁边启动另外两个免费工具,并保留第一个
完整页面(
--lightning会从一开始就进行竞速)。 - 如果 URL 返回“未找到”,则会使用网站自身的搜索功能查找;
receipt.rescued会标明这一点。 - 仍然被拦截?允许使用你机器上的真实 Chrome(
--real-browser,使用独立配置文件,绝不会使用你的配置文件),或使用第二个连接(FRANKENSURF_EGRESS)。
搜索:垂直分类、布尔查询、本地引擎
- 每个来源都支持
--site、--exclude-domain、--recency和--region,并可使用由官方免费 API 支持的--vertical(news、reference、discussions、qa、code、papers、books)。 - 监控类查询(
"Acme" OR "Acme Corp" (acquisition OR layoffs))会根据所关注的 名称进行判断;如果结果不理想,会仅用名称重试一次。 --mode merge会同时查询每个来源,并合并结果。frankensurf search-engine start|stop|status用于管理本地 SearXNG;重启后,搜索会重新启动它。
Agent:技能、配置文件、移交、网站模块
- 内置技能会向 Agent 介绍这些工具:MCP 服务会将其作为指令发送,而
frankensurf skill install会将其添加到~/.claude/skills。 - **配置文件:**登录一次后,任何工具都可以使用该会话;模型不会看到 Cookie 或密钥。
- **人工移交:**遇到只有真人才能通过的 CAPTCHA 或 2FA 时,会为你打开页面,然后继续操作。
- **网站模块:**将 Agent 对网站的了解保存为数据。
frankensurf module discover URL --query "desk lamp" --save会查找网站的搜索功能、读取结果并保存模块; 此后,在该网站上的搜索会返回结构化的items。 - 共享网站知识:
frankensurf share sync会根据社区学到的信息,记录哪些工具读取哪些网站;share export会导出你的数据,供你审核和贡献(两种方式均需选择加入)。 frankensurf watch-sites URL… --since DATE会列出网站通过信息源和站点地图发布的新页面。
付费工具和预算
无需密钥即可使用所有功能。付费工具需选择启用,并且只有在网站拦截了免费工具后才会使用,优先尝试最可能成功且成本最低的工具。设置相应密钥(例如 FIRECRAWL_API_KEY)并传入
--paid;--max-cost USD 可限制单次读取的费用。在 Python 中使用:allow_paid_fallbacks 和 max_cost_usd。
参见付费工具和预算。
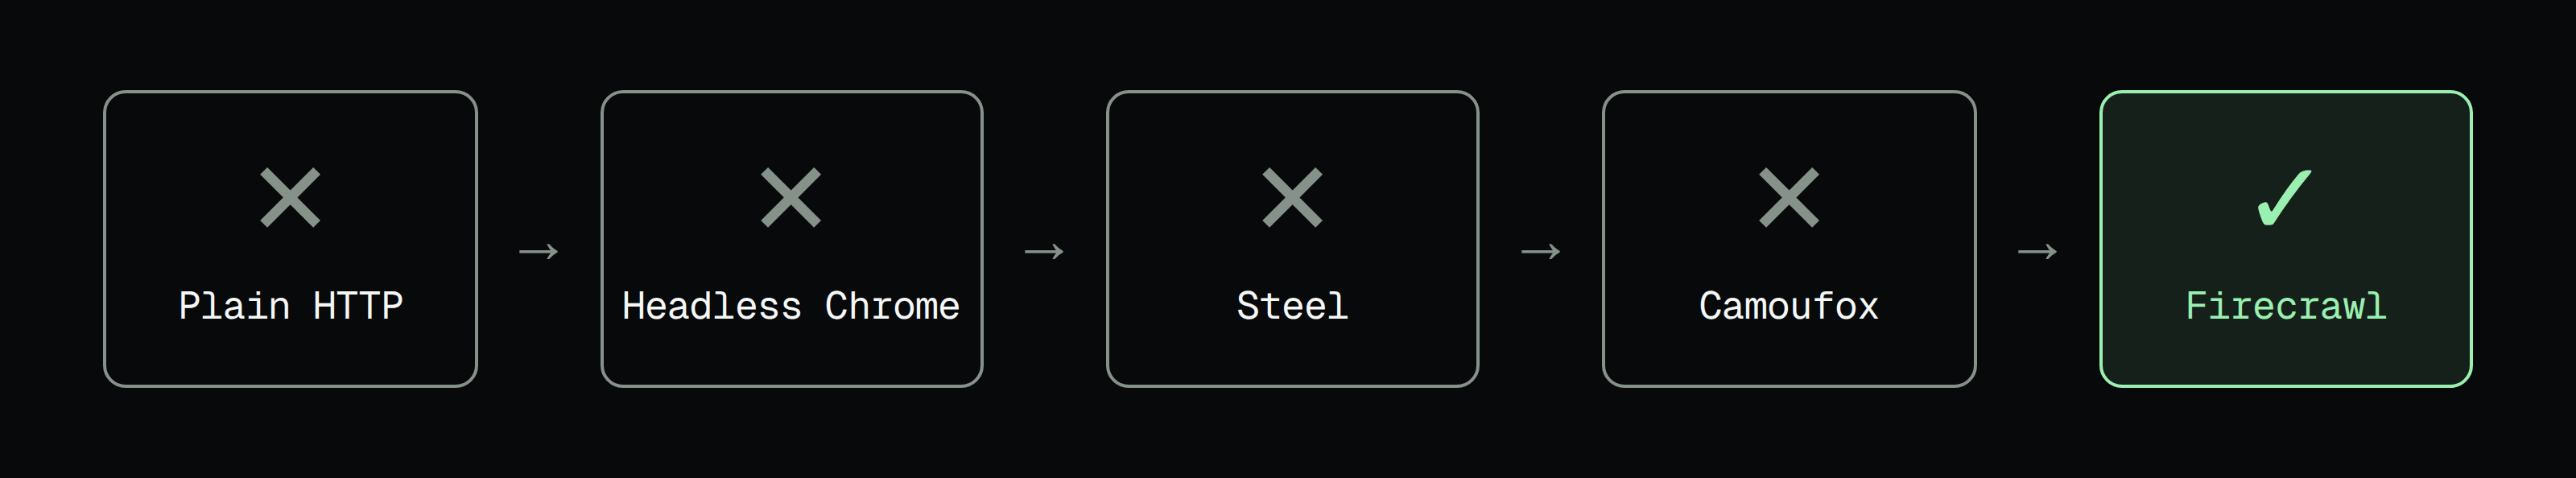
每种获取网页的方式都是一个阶梯:普通 HTTP 和 Markdown 协商、浏览器、隐匿浏览器和签名请求、托管浏览器、付费 API,最后是由真人在可见浏览器中突破限制。读取从成本最低的阶梯开始,只有在网页阻拦时才逐级上升。每个工具都是一个插件,因此可以将新工具作为另一个阶梯接入。
已知限制
目前仍处于 alpha 阶段,有些网站还是无法访问:
- **需要付费工具:**在一次仅使用免费工具的抽查中,Etsy、Home Depot、Yelp、Crunchbase 和 G2 都阻拦了所有免费工具。
- **目前都能突破:**Shopee、Temu 和 Idealista。
- **无需登录即可访问的社交网站:**LinkedIn、X、YouTube、Threads、Bluesky 和 Reddit 都可以正常读取。Instagram、TikTok、Facebook 和 Pinterest 只显示公开页面外壳;查看帖子需要登录。
- 已登录页面(你的信息流、订单)需要配置文件。
- **偶尔会很慢:**大多数读取只需几秒,但每十次中就有一次会尝试多个工具,耗时 25 s 或更久。
发现无法读取的网站? 请报告问题;每份报告都会成为测试用例。
开发
python3 -m venv .venv
.venv/bin/pip install -e '.[test,mcp]'
.venv/bin/frankensurf install
PYTHONPATH=.:src .venv/bin/pytest -q
产品设计见 SPEC.rst,贡献者规则见 AGENTS.md。新工具应作为插件接入,而不是在 Core 中添加分支:请参阅编写插件和 examples/frankensurf-plugin-example 中的示例。网站和文档位于 site/。
许可证
Apache-2.0。请参阅 LICENSE。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。