关于 agent-memory-os
AgentMemoryOS 是面向 AI Agent 团队的本地优先记忆系统,支持分级访问控制和节点间同步。其基于 SQLite 的核心无需额外依赖,可选组件提供 MCP 服务、Web UI 和语义召回。
主要功能
- 01基于 SQLite 的记忆存储与全文搜索
- 02Agent、团队和项目范围的强制访问控制
- 03支持访问撤销的联邦同步
- 04按预算选择上下文并进行关联召回
- 05记忆衰减、固定与整合
- 06可选语义召回、MCP 服务和 Web UI
适用场景
- 01在 Agent 团队间共享项目知识
- 02将私人记忆与共享上下文分开
- 03在节点间同步受范围限制的记忆
- 04在提示词令牌预算内提供相关记忆
MCP 相关
可选的 MCP 服务向 MCP 客户端开放 AgentMemoryOS 的记忆能力。它可通过 [mcp] extra 安装,也可使用 Docker 镜像的 stdio 模式运行。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
uvx agent-memory-osAGENT_MEMORY_AGENT_IDThis agent's identity; memories default to this owner and recall carries its ACL.AGENT_MEMORY_HOMEData home directory (default ~/.agent-memory).本地服务需要在你的电脑上安装运行环境(如 Node.js 18+)。各客户端的配置文件位置不同,请参考客户端文档。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍




English · 繁體中文
一个面向 AI Agent 团队的本地优先记忆系统——它不仅为单个 Agent 提供记忆,还为协同工作的 一组 Agent 提供共享记忆网络:在严格的 ACL 保护下,提供私有、团队和项目范围的记忆、联想式回忆,以及联邦同步,让网状节点(及其组织结构)保持一致。只需一个 SQLite 文件,无需任何必需依赖,采用 Apache-2.0 许可证。
为什么 · 对比 · 安装 · 快速入门 · 功能 · 联邦同步 · Web 界面 · 用户 指南
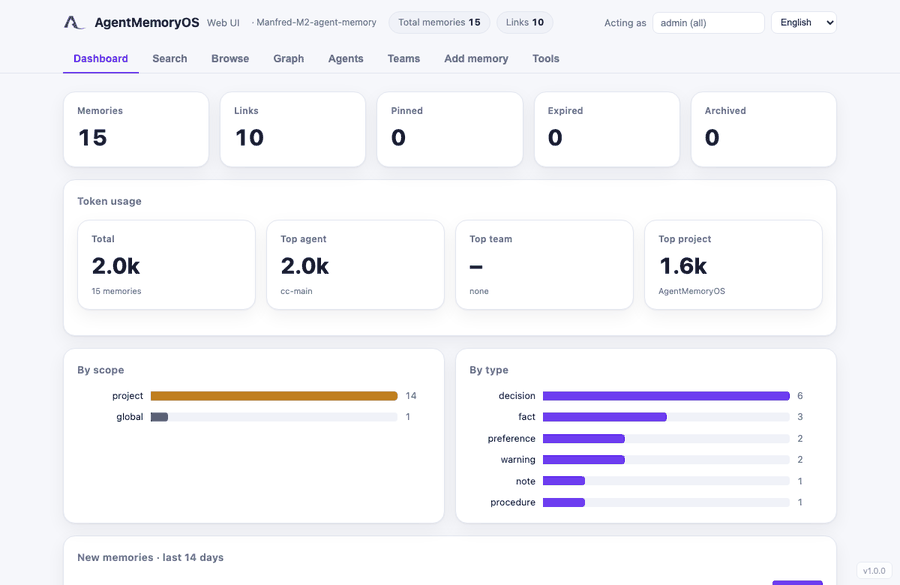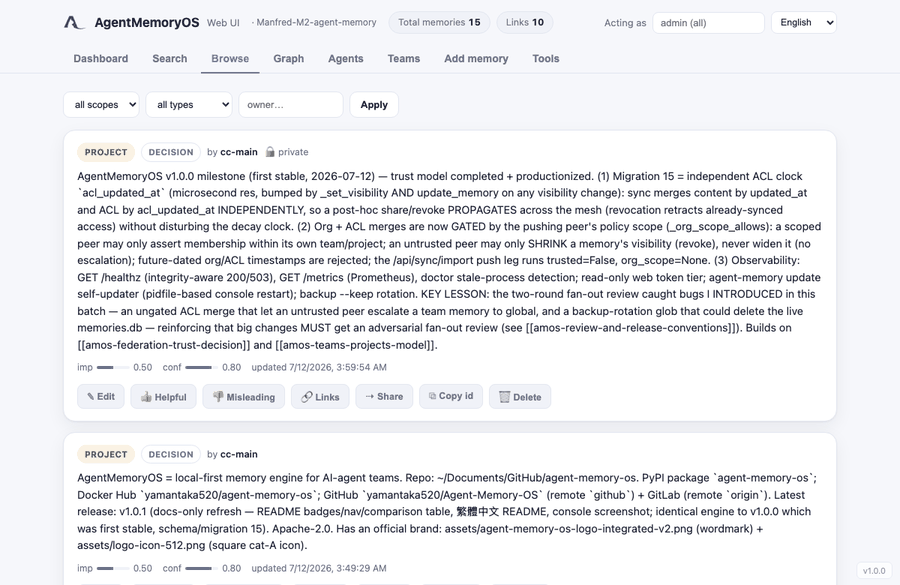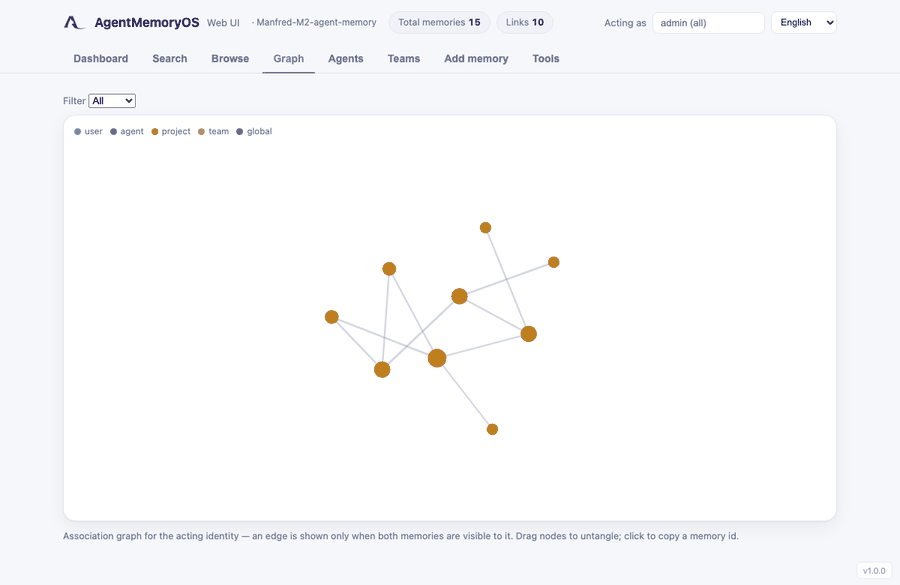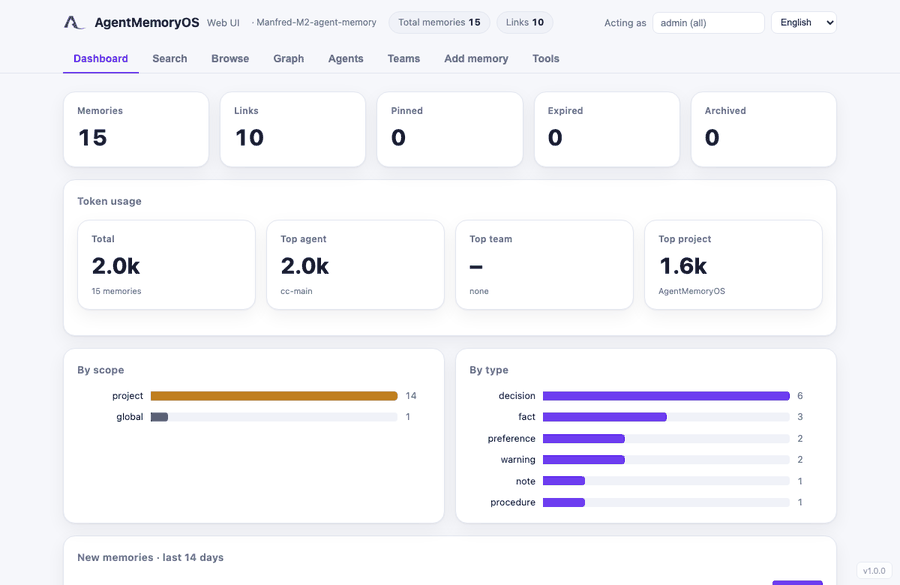
内置 Web 控制台:按 Agent/团队/项目查看令牌用量、浏览记忆,以及受 ACL 保护的关联图谱。
为什么
实际工作由多个 Agent 组成的团队完成——一个项目可能会混合使用 Claude Code、Codex、OpenClaw 和多个 Hermes 配置,涉及多个团队和项目,运行在一台或多台机器上。它们需要与合适的队友共享正确的知识,并对应该保密的内容严格保密:
- 每个 Agent 的记忆是基础,而非上限:可跨会话留存的持久事实、偏好、流程和经验教训。
- 团队和项目记忆才是关键:团队可以看到
team:<id>记忆;项目(团队的子集)可以看到project:<id>记忆;边界之外的内容不会泄露。成员关系是一等概念,可管理,并用于实施 ACL。 - 联邦同步确保网状网络保持一致:记忆以及组织结构(团队/项目/成员关系)都会在节点之间趋于一致,因此
project:<id>在任何地方都代表同一含义。 - 本地优先避免了云端记忆平台的延迟、成本和隐私权衡——记忆存储在本地 SQLite 文件中,每个提示词只会收到相关且符合预算限制的内容。
功能
- 本地优先、核心零依赖 — 一个 SQLite 文件(FTS5),无需服务器。执行
pip install即可开始使用。 - 团队和项目是一等功能 — 团队由节点成员组成;项目成员是所属团队成员的子集。
team:<id>记忆可覆盖整个团队,project:<id>记忆仅覆盖该项目——这是严格的 ACL,由控制台/CLI/API 管理。移除成员后,召回范围会立即收窄;删除范围会撤销其中的记忆。 - 跨节点联邦,具备真正的信任模型 — 可移植数据包和对等同步会收敛记忆、链接、档案以及组织结构(团队/项目/成员关系),采用最后写入者胜出策略和墓碑标记。每个对等节点的策略(
shared/full/team:/project:)都是强制执行的授权范围:对等节点只能在自身范围内声明成员关系,且只能缩小记忆的可见范围,不能扩大——数据包无法导致跨范围提权。 - 可传播的撤销 — 独立的 ACL 时钟会在网状网络中传递事后共享/撤销操作,因此撤销访问权限后,已同步该记忆的对等节点也会实际撤回访问权限——而不会影响衰减时钟。
- 感知请求方的 ACL — 每个 Agent 都有私有、Agent、团队、项目和全局记忆;可见性是排序前强制执行的硬性门槛,绝非软性评分。候选索引只返回 ID;内容会再次通过门槛检查后读取。
- 动态上下文包 — 按提示词预算筛选记忆,并提供可审计性(
context_pack_report()会说明每项内容的纳入/排除原因)。 - 事实仲裁 — 抑制重复内容、检测矛盾(
CONFLICT标记),并为核心记忆预留预算。 - 联想式召回(共振) — 权威的
memory_links图可让相关记忆浮现,即使它们与查询没有共同词项;遍历过程遵循 ACL 安全规则(不可见节点无法遍历)。 - 赫布强化 — 一同召回的记忆会增强彼此的链接(
record_recall,或在上下文包中设置auto_reinforce=True);无用的召回会减弱链接和置信度(helpful=False)。 - 按 Agent 区分的召回档案 — 不同 Agent 人设对记忆类型的权重不同(工程师更依赖
procedure,陪伴型 Agent 更依赖preference);档案会保存在数据库中,只会重新调整排序权重,绝不会绕过 ACL。 - 记忆生命周期管理 — 指数/线性衰减、固定保留、硬性过期,以及写入侧的
consolidate()流程,用于合并重复内容,并将经常共同召回的集群合成为概念记忆。 - 可选辅助组件 — 语义向量候选项(turbovec)、MCP 服务和 FastAPI Web UI,均通过 extras 提供;每个候选项都会重新经过 SQLite,并通过硬性门槛检查后才能使用。
对比
大多数 Agent 记忆系统都针对托管规模下由大模型驱动的提取进行优化。 AgentMemoryOS 则针对不同的定位进行优化:本地优先、团队范围和联邦式——由你自行运行,并在严格 ACL 下跨节点集群共享记忆。 这是对定位的比较(架构,而非基准测试);请根据各项目的最新文档核实每一行内容。
| AgentMemoryOS | Mem0 | Zep / Graphiti | |
|---|---|---|---|
| 运行方式 | 一个 SQLite 文件,pip install | 自托管(配置大模型 + 向量数据库)或托管服务 | Zep Cloud,或在 Neo4j/FalkorDB 上自托管 Graphiti |
| 核心功能是否需要大模型 | 不需要(FTS5 + 可选的本地向量) | 需要(大模型提取,例如 gpt-5-mini) | 需要(大模型构建时序图) |
| 外部服务 | 无需任何服务 | 大模型 API + 向量存储 | 图数据库 + 大模型 + 嵌入(自托管需运行 3 个以上系统) |
| 范围 / ACL 模型 | 私有 / Agent / 团队 / 项目 / 全局——排序前严格拦截 | 按用户 / Agent / 会话 ID | 按用户 / 会话图 |
| 跨节点联邦 | 支持——记忆和组织结构都会汇聚;撤销会传播 | 集中式存储 | 集中式(Cloud 或你自己的图数据库) |
| 内置 MCP 服务 | 支持 | 通过 SDK | 通过 SDK |
| 许可证 / 自托管 | Apache-2.0,完全开源 | 开源核心;图功能和高级套餐需付费 | Community Edition 已弃用;自托管需使用原始 Graphiti |
Mem0 和 Zep 擅长基于大模型的提取和托管规模的检索——这些正是 AgentMemoryOS 有意不做的事情。如果你想要一种依赖轻量、由自己掌控、能在离线状态下持续运行并按你的方式同步的记忆,并让多个 Agent 在团队内正确共享,就可以选择 AgentMemoryOS。
安装
pip install 'agent-memory-os[full]' # recommended: everything (Web UI, MCP, turbovec)
也可以按需选择组件:agent-memory-os(核心,无依赖)、[api](Web UI)、[mcp](MCP 服务)、[semantic](turbovec 向量召回)。
**Docker:**预构建的多架构镜像包含完整的 AgentMemoryOS(Web 控制台 + MCP 服务 + CLI);第一个参数用于选择模式:
docker run -p 8000:8000 -v amos-data:/data yamantaka520/agent-memory-os        # web console (default)
docker run -i --rm yamantaka520/agent-memory-os mcp                            # stdio MCP server
docker run --rm -v amos-data:/data yamantaka520/agent-memory-os check          # any CLI command
也可以运行 docker compose up -d。控制台地址为 http://localhost:8000,记忆会持久保存在卷中。请参阅 Docker 指南(Docker Hub 镜像 + 双节点同步网格)。
需要 Python 3.11+,并且 SQLite 支持 FTS5(标准 CPython 构建已包含)。
安装后,运行以下两条命令:
agent-memory doctor          # verifies FTS5, turbovec, and the other extras
                             # (add --install to auto-install anything missing)
agent-memory token create    # protects the Web UI API with a bearer token
令牌存储在 <home>/web_token(模式 600);agent-memory-web 会自动读取该令牌,控制台首次使用时会提示输入。之后可使用 agent-memory token show|rotate|disable 管理令牌。另有两种权限范围更窄的令牌:--readonly(仅限 GET 请求)和 --sync(仅限联邦路由——将此令牌交给对等节点,而不是管理员令牌)。
快速入门
想要可运行的脚本?
examples/team_memory.py展示了三个 Agent 如何在约 40 行代码中,在严格 ACL 下共享一个存储库——python examples/team_memory.py。
from agent_memory_os import MemoryClient, RecallProfile

client = MemoryClient(home="~/.agent-memory")

# Write memories with ownership and visibility
client.add("User prefers dark mode.", owner="mizuki", type="preference",
           visibility=[])                      # private to owner
client.add("Deploy target is port 8000.", owner="neo", type="environment",
           visibility=["global"])              # visible to every agent

# Requester-aware search: each agent sees only what it may see
hits = client.search("deploy port", requester_agent_id="neo")

# Token-budgeted context pack for the prompt, with reinforcement loop closed
pack = client.context_pack("deploy port", requester_agent_id="neo",
                           max_tokens=1200, auto_reinforce=True)

# Associate memories; linked memories resonate into future recalls
a = client.add("Staging deploy failed with database lock.", visibility=["global"])
b = client.add("Always snapshot before schema changes.", visibility=["global"])
client.link(a.id, b.id, relation="caused_by", weight=0.8)

# Persist an agent persona: soft ranking bias per memory type
client.save_profile(RecallProfile(agent_id="neo",
                                  type_weights={"procedure": 1.5, "note": 0.7}))

# Periodic hygiene: merge duplicates, synthesize concept memories
client.consolidate()
架构
query
  -> candidate providers (FTS5 | vector sidecar | resonance graph | fallback)
  -> merge/dedupe by stable memory_id
  -> rejoin authoritative rows from SQLite
  -> ACL hard gate -> expires_at hard gate
  -> scoring (relevance x importance x confidence x freshness x reinforcement)
  -> per-agent profile re-weighting (soft)
  -> truth arbitration + context budget allocation
设计不变量:
- SQLite
memories表是唯一事实来源;FTS / 向量索引可丢弃并可重建(rebuild_indexes())。 - 候选项提供方仅返回 ID 和分数——内容始终会在 ACL 和过期时间硬性检查通过后,通过 SQLite 重新读取。
- 关联边(
memory_links)是权威数据,可在重建索引后保留,会在未使用时衰减,并且绝不会让不可见记忆连接两个可见记忆。
完整契约请参阅 SPEC.md。
存储引擎:SQLite + turbovec
AgentMemoryOS 使用 两个权限严格区分的存储层:
- SQLite(始终启用)是唯一事实来源:记忆、链接、配置文件和 FTS5 词法索引都存储在同一个
memories.db文件中。 - turbovec(随
[full]/[semantic]安装)是语义向量引擎:一个内存量化索引,按含义而非关键词召回记忆。它被有意设计为 可丢弃——它仅返回候选memory_id和分数;每个候选都会重新进入 SQLite,并通过 ACL/过期硬性检查后,才能使用其内容;索引可随时删除并重建,不会触及事实存储。
语义召回开箱即用:
client = MemoryClient(home="~/.agent-memory", semantic="auto")
semantic="auto" 会接入一个基于内置确定性哈希嵌入器、可自行同步的 turbovec 索引(无需下载模型;词法向量可容忍拼写错误和词形变化)。每当 memories 表发生变化,索引都会自动重建;如果未安装后端,则会静默降级为词法召回 + 共鸣召回。如需更深层的语义能力,可使用自定义 embed_query,将任意嵌入模型接入 TurbovecSemanticCandidateProvider.from_vectors(...)。agent-memory doctor 可确认后端是否可导入。
记忆生命周期与保留
agent-memory retention               # archive expired + memories idle 4+ half-lives
agent-memory retention --half-lives 0   # expired only
agent-memory check                   # SQLite + FTS + link-graph integrity
归档的记忆将不再参与召回,但仍可恢复(Web UI → Tools → Retention & archive,或 POST /api/archive/{id}/restore)。衰减机制绝不会归档已固定的记忆和权威跟踪记忆。数据库通过带版本号、仅向前迁移的迁移表自动升级(agent-memory check 会报告架构版本)。
备份与恢复
agent-memory backup ~/backups/memories-$(date +%F).db --keep 14   # rotate, keep 14
agent-memory restore ~/backups/memories-2026-07-11.db --force
备份使用 SQLite 的在线备份 API,因此即使 Agent 正在写入,备份也保持一致。--keep N 会轮换删除同一命名系列中的旧备份(绝不会删除正在使用的数据库)。恢复后,可丢弃的索引会自动重建。
升级与运行状况。 agent-memory update 会检查 PyPI、执行升级并重启正在运行的控制台;--check 仅报告检查结果。可将运行状况检查指向 GET /healthz(200/503),并将 Prometheus 抓取器指向 GET /metrics。
多 Agent 项目
一个项目可以让 Claude Code、Codex、OpenClaw 和多个 Hermes 配置文件共用单个存储。为每个 Agent 注册其团队——可在控制台的 Agents 选项卡中操作,也可通过 API 完成——团队成员便会自动看到 team:<project> 记忆,无需额外配置:
curl -X POST localhost:8000/api/agents -H 'content-type: application/json' \
  -d '{"id": "cc-main", "kind": "claude-code", "teams": ["apollo"]}'
也可以通过代码声明整个 Agent 集群——每次打开存储时,都会重新应用 <home>/agents.toml(列在文件中的 Agent 以文件为准;手动注册的 Agent 不受影响):
[agents.cc-main]
kind = "claude-code"
teams = ["apollo", "shared-infra"]   # multiple teams = multiple projects

[agents.hermes-neo]
kind = "hermes"
teams = ["apollo", "ops"]
每个 MCP 服务都通过 AGENT_MEMORY_AGENT_ID 声明自身身份,因此记忆默认以该 Agent 为所有者,每次召回都会携带其团队 ACL。使用 agent-memory sync export apollo.jsonl --team apollo,即可将一个项目的共享记忆发送到另一台主机。
联邦(多主机同步)
# on the host being joined: mint a sync-scoped token for the peer
agent-memory token create --sync           # prints amos_sync_… (federation routes only)

# one-time, on the joining host
# easiest: pairing (one command on each side — tokens/mesh key exchanged for you)
#   on the existing node:  agent-memory team invite apollo
#   on the joining node:   agent-memory join <code> --url http://that-node:8000
# or wire a peer by hand:
agent-memory peers add https://other-host:8000 --peer-token <their sync token>

# converge with every registered peer (pull + push, deterministic merges)
agent-memory sync auto
对等节点按主机分别存储;sync auto(或控制台中的“立即同步网格”)会与每个对等节点进行双向收敛——记忆和配置文件采用最新写入者胜出,链接采用最强者胜出;无法访问的对等节点会分别失败,不会导致整体失败。文件包(sync export/import)适用于隔离网络环境中的迁移。配合 agent-memory service install 和 cron/定时器条目,即可持续同步网格。
加密传输。 为每个节点设置相同的网格密钥,同步数据包就会在应用层使用 Fernet 加密,因此即使通过普通 HTTP 或代理传输,记忆内容也能保持机密——密钥是单独的机密信息,不会通过网络传输:
agent-memory sync genkey                   # prints amos_sk_… ; needs the [secure-sync] extra
export AGENT_MEMORY_SYNC_KEY=amos_sk_…      # set the SAME value on every node
同步专用令牌仍通过 Authorization 标头传输,因此对于非 localhost 的对等节点,建议使用经证书验证的 https:// URL,以保护令牌。确切的安全保障请参阅 SECURITY.md。
Agent 集成
将 AgentMemoryOS 接入常用 Agent 的分步指南——点击任一磁贴:


Hermes Agent 使用原生记忆提供方插件(不仅仅是 MCP):
运行 pip install agent-memory-os && agent-memory hermes install,然后在
hermes memory setup 中选择
agent-memory-os——每轮都会注入回忆,amos_* 工具会携带团队/项目 ACL。无需 API 密钥,也无需大模型。请参阅
Hermes 指南。
任何支持 MCP 的 Agent 都可以使用相同的模式:运行
python -m agent_memory_os.mcp_server,将其作为 stdio MCP 服务,并指向共享的
AGENT_MEMORY_HOME。
MCP 服务

pip install 'agent-memory-os[mcp]'
python -m agent_memory_os.mcp_server
只需一行即可将其接入 Claude Code(设置 Agent 身份,以确保记忆归属正确):
claude mcp add agent-memory --env AGENT_MEMORY_AGENT_ID=cc-main -- python -m agent_memory_os.mcp_server
工具(12 个):memory_add(带有用于指定团队/项目/全局范围的 share 参数)、memory_search、memory_context_pack、memory_orchestrate_context、memory_link、memory_update、memory_share、memory_recall_feedback、memory_consolidate、memory_offload_context、memory_reload_context、memory_snapshot_diff。设置 AGENT_MEMORY_AGENT_ID,使每个 Agent 都以自己的身份运行——两个指向同一 home 的 Agent 可以立即共享 team:/project: 记忆。
Web 界面
pip install 'agent-memory-os[api]'
agent-memory-web --host 127.0.0.1 --port 8000 --home ~/.agent-memory-web
控制台支持English、繁體中文、简体中文、日本語和한국어——会根据浏览器自动检测,也可在页眉中切换。它提供统计信息仪表板(范围/类型/关系细分、14 天活动、最常回忆的记忆)、搜索和按时间浏览(记忆卡片支持就地编辑、反馈、链接和删除操作)、交互式关联图视图、包含每条记忆决策的上下文包预览,以及添加/链接/整合工具——所有操作均由全局“操作身份”驱动。
端点:健康状态/统计信息/仪表板/完整性 · 记忆 CRUD + 浏览 · 搜索 / 上下文包 / 编排 · 链接 + 图谱 · 回忆反馈 · 共享 / 撤销 / 审计 · 整合 / 保留策略 / 归档+恢复 · Agent 注册表 · 节点 + 网状同步 · 包导出/导入 · 所有者列表 / 重新分配 / 清除 · 机群状态/触发(Ed25519 签名的跨节点操作)。完整列表见用户指南。
搜索、浏览、图谱、回忆反馈和上下文包均接受 requester_agent_id,并执行与 SDK 相同的 ACL 硬性限制。未指定请求者的请求会以不受限的管理员视图运行——请仅绑定到 localhost,或使用 --token <secret>(或 AGENT_MEMORY_WEB_TOKEN)要求每个 API 路由都提供 bearer 令牌。
注意:请将 --home 数据库保存在本地磁盘上。网络文件系统(NFS/SMB)可能会导致 SQLite FTS5 创建架构时出现 database is locked 错误。
作为登录服务运行(macOS / Linux / Windows)
agent-memory service install [--host 127.0.0.1] [--port 8000]
agent-memory service status | start | stop | restart | uninstall
install 会将控制台注册到原生服务管理器,使其在登录时自动启动,并在故障后重启——macOS 上使用 launchd LaunchAgent,Linux 上使用 systemd 用户单元,Windows 上使用任务计划程序登录任务。无需管理员权限;服务会运行安装时使用的确切 Python 环境,并将日志写入 <home>/logs/web.log。在 Linux 上,如果需要在尚未登录时于启动时运行,请执行 loginctl enable-linger $USER。
添加 --dry-run 可预览操作。CI 会在 Ubuntu、macOS 和 Windows 上,使用 Python 3.11–3.13 运行完整测试套件。
开发
pip install -e '.[dev]'
pytest
状态
稳定版 — 1.x。 上述约定均已实现,并由测试套件覆盖(跨 3 种操作系统的 CI 矩阵包含 300 多项测试,另有迁移升级路径任务),还经过多轮扇出代码审查和安全审查(报告见 docs/reviews/)。性能已在 1 万条记忆的规模下得到验证(添加:0.17 ms,搜索:<1 ms,上下文打包:7.8 ms)。数据库会自动向前迁移;各版本新增内容请参阅 CHANGELOG。
文档
- 用户指南 — 概念、完整的 CLI / HTTP API / MCP 参考、多 Agent 与联邦功能演练、运维检查清单
- Docker 指南 —
docker/docker compose启动、通过环境变量配置、双节点同步网格 - SPEC — 按里程碑整理的约定与不变量
- 安全 & 威胁模型 — 漏洞披露政策、信任边界和已知限制说明
- 嵌入与规模 — 接入真正的嵌入模型;了解从 1 万到 100 万条记忆的行为
- 导入器 — 从 Mem0 / Zep / ChatGPT 迁移 · 兼容性 —
1.x语义化版本承诺 - 审查与报告 — 扇出代码与安全审查(涵盖
1.x系列)、性能与安全报告,以及验证工具(scripts/validation_run.py) - CHANGELOG · 路线图 · 集成指南
许可证
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。