关于 skeletongraph
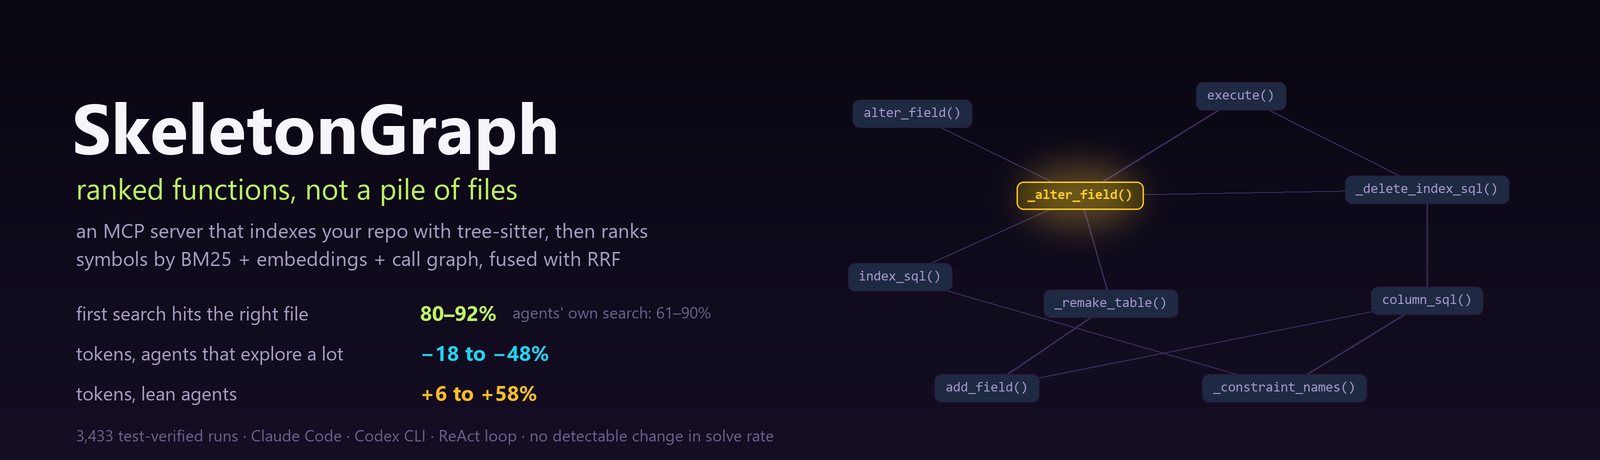
SkeletonGraph 用 tree-sitter 对仓库进行无 LLM 解析,并通过 MCP 为编码 Agent 提供按相关性排序的函数检索。它面向 IDE 中的编码 Agent,也提供终端工作流。
主要功能
- 01tree-sitter 函数级索引
- 02BM25、嵌入与结构信号融合
- 03按调用图扩展候选代码
- 04MCP 检索服务
- 05终端路由与执行工作流
- 06支持增量更新索引
适用场景
- 01为编码 Agent 查找相关函数
- 02在代码修改后更新仓库索引
- 03生成任务上下文文件
- 04通过终端路由编码任务
MCP 相关
SkeletonGraph 提供 MCP 上下文服务,将相关函数及其文件和行号提供给编码客户端。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍



兼容




可解析


**SkeletonGraph 使用 tree-sitter 为你的代码库建立索引——无需大模型——并通过 MCP 向编码 Agent 提供与其任务相关函数的排序列表。**它也是一项研究的实验工具,旨在探究更好的代码检索究竟能为必须修复代码的 Agent 带来什么;研究涵盖两个生产级 Agent、两种 Claude 行为模式和两个基准测试。简短答案如下;它比单看 token 比率更有用,也没那么好听。

使用 tree-sitter 一次性建立索引(无需大模型)→ 三种信号为相同符号排序 → 倒数排名融合返回带文件和行号的排序函数,并通过 MCP 提供给你的 Agent。
我们的发现
我们在所有可行的设置中运行了同一检索器:不使用 Agent、在开源权重模型上运行受控 Agent 循环,以及在 Claude Code(探索和精简模式)和 Codex CLI 中运行;测试数据为 SWE-bench Verified 和去污染后的 SWE-rebench—— 3,433 次 Agent 运行,每个补丁都通过运行项目测试进行验证,另有 500 次不使用 Agent 的检索评估;所有 Agent 对比均按任务配对。评估涵盖 Python 代码库。
1. 它的代码查找效果优于每个 Agent 自带的搜索
不使用 Agent,在 100 个 SWE-bench Verified 任务上(文件级别):
| 排序器 | MRR | recall@5 | recall@10 |
|---|---|---|---|
| grep | 0.159 | 0.236 | 0.348 |
| BM25 | 0.482 | 0.626 | 0.719 |
sg-rerank(BM25 + 结构) | 0.518 | 0.701 | 0.824 |
| BM25 + 密集向量 | 0.551 | 0.714 | 0.843 |
sg-fusion(BM25 + 密集向量 + 结构) | 0.658 | 0.785 | 0.856 |
在所有任务的 Agent 运行中,SkeletonGraph 的首次搜索在 80–92% 的任务中返回了修复涉及的文件,而 Agent 自带的首次搜索为 61–90%(在 Agent 实际调用搜索的任务中,分别为 87–96% 和 60–93%)。差距最大的是 Codex:在调用搜索的任务中,正确文件有 71% 的概率排在首位,而 Agent 自带搜索的这一比例为 32%。
2. 但 Agent 已经找到了正确代码——因此这项提升并未影响修复结果
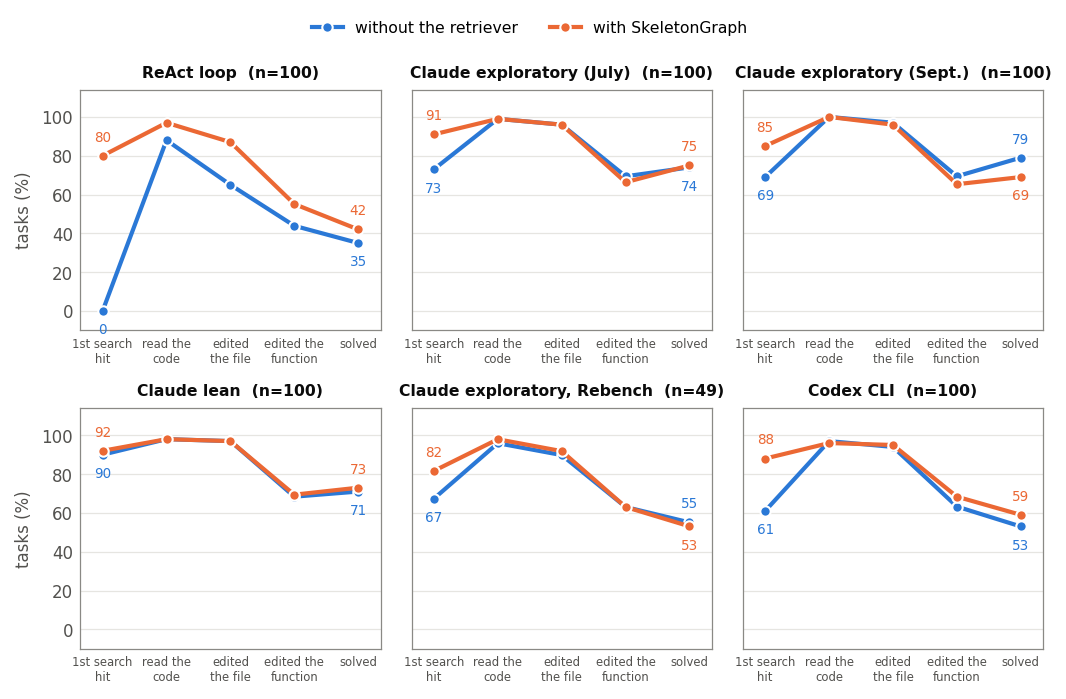
无论是否使用 SkeletonGraph,生产环境 Agent 都会在 96–100% 的任务中读取正确文件中的代码——在 SWE-bench Verified 上,通常通过第一个工具调用完成——并在 88–97% 的任务中编辑该文件。在函数级别上,Agent 的表现远非完美(63–69% 的任务中编辑了修复涉及的函数),而 SkeletonGraph 也未能改变这一情况。在结果不同的 69 个任务中,有 61 个任务的两组都已编辑了正确文件:差异在于修改是否正确,而非修改位置。没有任何生产环境 Agent 设置显示出检索带来的、在统计上可检测的解决率提升。只有经常无法自行找到代码的 Agent——受控循环中,不使用搜索的组仅在 65% 的任务中编辑了正确文件——从中获益(解决任务数从 35 增至 42,但不具有统计显著性)。
3. 它改变的是成本——方向由 Agent 决定
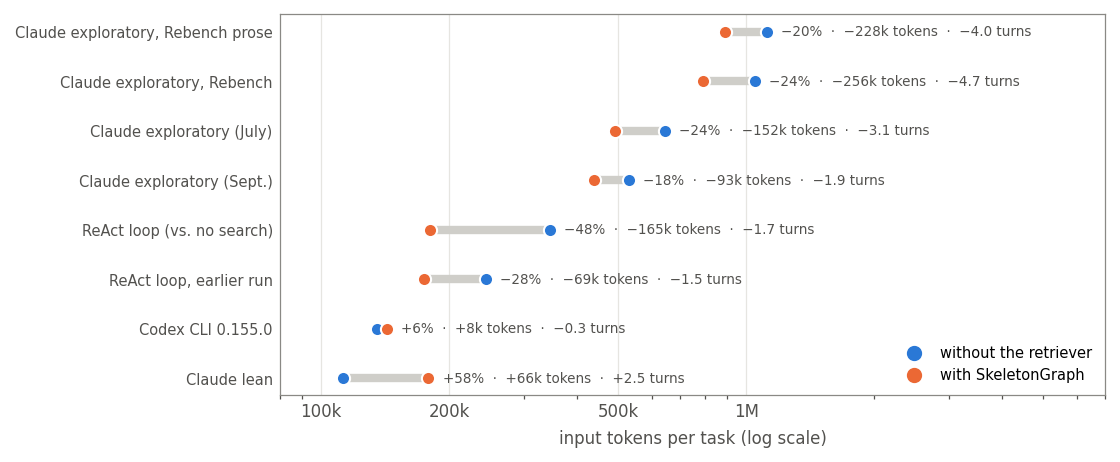
| 设置 | Agent 自行处理每项任务的 token 数 | 使用 SkeletonGraph |
|---|---|---|
| Claude 探索式,SWE-rebench | 1,048,603 | −24%(−256k token,−4.7 轮,−12¢) |
| Claude 探索式(7 月) | 644,504 | −24%(−152k token,−3.1 轮,−6¢) |
| Claude 探索式(9 月) | 530,478 | −18%(−93k token,−1.9 轮,−3¢) |
| ReAct 循环(开放权重模型) | 344,642 | −48%(−165k token,−1.7 轮,−1¢) |
| Codex CLI 0.155.0 | 134,955 | +6%(+8k token,−0.3 轮,−0.4¢) |
| Claude 精简模式 | 112,813 | +58%(+66k token,+2.5 轮,+2¢) |
如果 Agent 花费大量时间搜索、阅读和反复检查,SkeletonGraph 就能取代这些工作并节省成本;如果 Agent 已经能通过一两次调用找到代码,检索器就是额外叠加的开销,成本会略有增加。开销幅度小且有上限;Agent 原本花费越多,节省也越多。
4. Agent 会在你不知情时发生变化
在相隔三周的两个 Claude Code 窗口中——同一任务和提示词下,探索式版本为 2.1.274,精简版本为 2.1.278——内置 Agent 每项任务的工具调用轮数从 10.9 降至 4.7,阅读量减少到原来的五分之一,编辑后运行代码的任务数从 40 个降至 2 个,而它自己的首次搜索在 85 个任务中把正确文件排在首位,此前为 59 个。相同的检索后端在更精简的集成下,效果从每项任务节省 93k token 变为增加 66k token。产品版本、可用工具、账户加载的技能、集成方式,以及可能还有所使用的模型,都同时发生了变化。我们可以描述这两种情况,但不能把这种变化单独归因于版本号。这种波动性本身就是结果的一部分:有意义的评估单位是完整且版本固定的 Agent 环境。
使用时需要了解的事项
- 期待首次搜索效果提升,而非解决更多任务。 当前前沿 Agent 的瓶颈在于如何将找到的代码转化为正确的修复,而检索无法解决这一问题。
- 节省效果取决于完整的 Agent 环境。 对探索较多的 Agent 和任务,节省效果最大;对精简型 Agent,效果也可能变成少量开销。请在自己的配置上进行测量。
- 集成说明会消耗 token。 在 Codex 上,与普通集成增加 8k token 相比,随附集成每项任务增加了 53k token,且可解率没有可检测的差异。
包含置信区间和注意事项的所有结果都在
docs/RESULTS.md 中;复现方法见
eval/README.md。2026 年 7 月的预印本只报告了 Claude Code 的首个发布窗口。
SkeletonGraph 提供两种产品形态:
- SG IDE:适用于 Cursor、Claude Code、Copilot、Codex、 Antigravity、Windsurf 和其他 Agent IDE 的 MCP 上下文服务。
- SG CLI:用于路由、准备、试运行、提供商执行 和成本感知模型选择的终端工作流。
工作原理
SkeletonGraph 会将代码库解析为函数级结构、跨文件调用图 和 PageRank 中心性,无需调用 LLM——确定性强、成本低,并且每次编辑后都能即时重建。在查询时,它会解析问题中提及的符号,向外遍历调用图,并根据三种信号对候选项排序——BM25、代码嵌入和结构确认——再通过倒数排名融合进行合并。
prompt -> (optional) retrieval planner -> classify task -> find target nodes -> expand graph -> assemble packet
sg-rerank 是产品默认设置,会跳过稠密检索部分,以使用更轻量的索引;sg-fusion 会加入该部分,并在我们的检索基准测试中排名最高(见上表)。
安装
pip install skeletongraph           # core: indexing, MCP server, CLI (no API key needed)
pip install "skeletongraph[llm]"    # + litellm for sg run --execute / sg summarize --tier cloud
pip install "skeletongraph[all]"    # everything, including the evaluation harness
快速开始:SG IDE
如果你已在 Cursor、Claude Code、Copilot、Codex、 Antigravity 或其他支持 MCP 的编码环境中工作,请使用此路径。
cd your-project
sg init
sg build
sg doctor
sg init 会为所选 IDE 写入 MCP 配置和 Agent 指令文件。SG IDE 无需 API 密钥。你的 IDE 订阅/模型仍负责推理和编辑;SkeletonGraph 提供检索能力。
支持的 IDE 设置目标包括:
| IDE | 集成方式 | 模型切换 |
|---|---|---|
| Cursor | MCP + 规则 | 在 IDE 中手动切换 |
| Claude Code | MCP + CLAUDE.md | /model 命令 |
| GitHub Copilot | MCP + 指令 | 在 IDE 中手动切换 |
| Codex | MCP + AGENTS.md | 在 Agent 中手动切换 |
| Antigravity | MCP + 规则 | 在 IDE 中手动切换 |
| Windsurf | MCP + 规则 | 在 IDE 中手动切换 |
快速开始:SG CLI
如果你希望使用以终端为先的上下文和模型路由流水线,请使用此路径。
cd your-project
sg build
sg route "fix the auth token validation bug"
sg prepare "fix the auth token validation bug" --out .skeletongraph/context.md
sg run "fix the auth token validation bug" --dry-run
sg route、sg prepare 和 sg run --dry-run 无需 API 密钥。
要调用服务商:
sg config --cli-provider anthropic
$env:ANTHROPIC_API_KEY = "..."
sg run "fix the auth token validation bug" --execute
要在本地测试且不使用付费服务商密钥:
ollama pull qwen3-coder:latest
ollama serve
sg config --cli-provider local
sg run "fix the auth token validation bug" --dry-run
sg run "fix the auth token validation bug" --execute
本地执行适用于低成本的流水线测试。除非基准测试专门针对本地模型,否则请使用服务商模型进行质量基准测试。
模型依赖、预热与保持索引最新
SG 首次使用时会下载两个小型嵌入模型,均通过 sentence-transformers 下载(这是硬性依赖,不可选):
jinaai/jina-embeddings-v2-base-code(SG_DENSE_MODEL)——fusion/sg_search的语义检索部分。在运行sg warm时或 Agent 首次发起密集检索查询时加载。使用trust_remote_code=True加载(Jina 在 HF Hub 上提供自定义建模代码)——这会执行该模型仓库中的代码,与任何trust_remote_code模型相同。all-MiniLM-L6-v2(SG_EMBED_MODEL)——一个更小的独立模型,仅在索引时用作置信度评分的平局判定器。它会在**首次运行sg build**时自动下载,而非在运行sg warm时下载。
每个模型在一台机器上首次使用时都需要联网——之后,两个模型都会缓存在本地(Hugging Face 的模型缓存,以及 SG 自身的内容哈希缓存:密集检索部分使用 .skeletongraph/dense_cache,置信度平局判定器使用 .skeletongraph/embeddings.npz),因此后续构建都是增量式的:只有文本实际发生变化的函数才会重新生成嵌入。
启动 Agent 前先进行预热,这样相关开销会发生在设置阶段,而不是 Agent 首次真正搜索时:
sg build                 # parse + structural index (no LLM, fast)
sg warm --path .          # prebuild BM25 + dense caches (one-time; minutes on CPU)
sg warm --path . --mode rerank   # skip the dense leg entirely (no embedding cost)
如果不这样做,Agent 发起的首次 sg_search 调用会在执行过程中承担冷启动编码开销——在大型仓库中,这可能超过密集检索部分的内部超时时间(SG_DENSE_TIMEOUT_S,默认值为 20s),此时系统会静默降级为双信号结果(词法 + 结构),而不是彻底失败。预热可完全避免依赖这种回退。
文件变更时保持索引最新——有两种方式,请根据你的工作方式选择:
sg update --path .        # one-shot: re-index only files that changed since last build
sg watch --path .         # background daemon: auto-reindexes on save (needs `pip install "skeletongraph[daemon]"`)
sg watch 是持续开发时无需操心的选项——它会对快速连续的保存操作进行防抖处理,并调用与 sg update 相同的增量更新路径,因此编辑文件后无需手动重建,索引也会随之更新。
模型路由
SkeletonGraph 将面向 IDE 的模型标签与 CLI 服务商模型名称分开处理。
对于 IDE,模型层级仅供参考:
| 层级 | 典型用途 |
|---|---|
| SLM | 文档、解释、简单查找 |
| MLM | 常规编码、调试、测试、审查 |
| LLM | 架构设计、大范围迁移、低置信度任务 |
对于 CLI 执行,SkeletonGraph 可以路由到服务商模型名称:
sg config --cli-provider anthropic
sg config --cli-provider openai
sg config --cli-provider google
sg config --cli-provider local
动态路由会使用任务模式、置信度、候选项数量、令牌量和复杂度。代码变更任务默认设有 MLM 下限,因此节省成本不会以让较弱模型不安全地编辑代码为代价。在大型模型运行前,检索规划可以使用小型模型基于 AST/摘要提出目标。
IDE 集成
运行 sg init 和 sg build 后,将 SG 注册为 MCP 服务并写入 IDE 钩子:
sg install --ide claude-code   # Claude Code: hooks + MCP server + CLAUDE.md rules
sg install --ide cursor        # Cursor: MCP + .cursor/rules/skeletongraph.mdc + hooks
sg install --ide cline         # Cline: MCP config + rules block
sg install --ide roo           # Roo: MCP config + rules block
sg install --ide copilot       # GitHub Copilot: MCP + copilot-instructions.md
sg install --ide windsurf      # Windsurf: MCP + .windsurfrules
sg install --ide zed           # Zed: MCP config + rules block
sg install --ide continue      # Continue: MCP config + rules block
sg install                     # auto-detect all installed IDEs
codex 和 antigravity 是可接受的别名,目前会使用 Copilot 风格的 MCP 安装程序。
对于其他支持 MCP 的客户端,或要手动配置,请参阅 mcp.example.json 中的原始服务配置(sg serve --path /path/to/your/project)。上文测得的“纯净”集成是通过 SG_MCP_PLAIN=1 启动的服务,它会从工具描述和结果中移除引导文本,且注册时不包含 sg install 写入的规则和钩子。
安装后,请重启编辑器。SkeletonGraph 会作为后台 MCP 服务(sg serve --path .)运行,IDE 会自动连接。
MCP 工具
向 Agent 提供七种工具:
| 工具 | 调用时机 | 返回内容 |
|---|---|---|
sg_overview | 会话开始时——每个会话调用一次 | 约束 + Top-N 函数(按 PageRank 排序)+ 最近的轮次 + 索引统计 |
sg_search "query" | 主要检索方式 | 排名前 3 的匹配项,包含正文摘录 + 摘要 + 1 跳调用者;第 4 至 N 个匹配项以签名 + 摘要形式返回 |
sg_get "fqn" | 已知确切 FQN 时 | 签名 + 摘要 + 1 跳调用者 + 被调用者 |
sg_expand "target" | 需要的正文内容多于 sg_search 返回的内容时 | 完整函数正文 / 文件 / 行范围(受 token 数量限制) |
sg_constraint list / propose | 提出更改前 | 已确认 + 已提议的项目规则 |
sg_log | 查看最近的会话轮次时 | 最近 N 个轮次的摘要及涉及的文件 |
sg_decision | 做出设计 / 实现选择时(选定或否决,并说明原因) | 记录选择,使其在上下文压缩后仍然保留——之后可通过 sg_log(kind="decision") 回顾 |
智能上下文路由。 每次触发 UserPromptSubmit 时,SG 都会对提示词分类(架构 / 解释 / 决策 / 调试 / 测试 / 审查 / 通用),并从 .skeletongraph/ 中加入匹配的 MD 文件——例如,仅在设计 / 重构查询时加入 architecture.md,仅在询问“这个代码库是什么”时加入 project.md。约束 + 会话摘要 + 相关函数始终会被注入。
冷启动。 如果调用 MCP 工具时不存在 .skeletongraph/ 索引,SG 会在首次调用时自动构建(参见配置中的 auto_build_on_query)。
CLI 参考
索引与状态
| 命令 | 用途 |
|---|---|
sg init [--agent cursor] | 配置项目、IDE 预设、MCP 和约束 |
sg index | 完整索引(sg build 的别名) |
sg index --incremental | 仅重新索引已更改的文件 |
sg build | 执行完整索引并输出详细信息 |
sg update | 增量更新 |
sg status | 显示索引状态 |
sg doctor | 检查索引、路由、提供商和 Ollama 的就绪状态 |
sg overview | 项目骨架:主要函数、约束、会话 |
sg install [--ide <name>] | 写入 IDE 钩子和 MCP 配置 |
检索
| 命令 | 用途 |
|---|---|
sg search "query" | BM25 + 图搜索(无需 API 密钥) |
sg get "fqn" | 获取函数签名、摘要和调用者 |
sg expand "target" | 展开函数体、文件或行范围 |
约束与会话
| 命令 | 用途 |
|---|---|
sg constraint list | 列出所有约束 |
sg constraint propose "text" | 添加一项提案 |
sg constraint confirm <id> | 将提案提升为 decisions.md 中的决策 |
sg constraint remove <id> | 移除一项约束 |
sg constraint aggregate | 从 IDE 规则文件导入 |
sg log [--last-n 10] | 显示最近的会话轮次 |
摘要生成
| 命令 | 用途 | API 密钥 |
|---|---|---|
sg summarize --tier local | Ollama Tier-0.5(免费,在设备上运行) | 否 |
sg summarize --tier cloud | 云端 LLM Tier-1 | 提供商密钥 |
sg summarize --tier cloud --force | 重新生成所有函数的摘要 | 提供商密钥 |
模型路由与执行
| 命令 | 用途 | API 密钥 |
|---|---|---|
sg route "task" | 显示任务模式、层级和推荐模型 | 否 |
sg run "task" --dry-run | 规划路由执行 | 否 |
sg run "task" --execute | 调用已配置的提供商 | 提供商密钥或本地运行 |
sg config [--agent cursor] | 配置 IDE 和 CLI 模型 | 否 |
sg config --cli-provider anthropic | 设置 CLI 执行提供商 | 否 |
后台索引
| 命令 | 用途 |
|---|---|
sg watch | 守护进程:保存文件时自动重新索引 |
sg run --execute 的提供商输出会写入 .skeletongraph/runs/。
Python API
from skeletongraph.engine import SGEngine

engine = SGEngine(project_root=".")
result = engine.query("fix the content-length bug", delivery="cli")

print(result.context_text)
print(result.query_mode)
print(result.model_tier)
print(result.recommended_model)
print(result.routing_reason)
仓库布局
src/skeletongraph/      the package
  parser/                 AST extraction (tree-sitter)
  graph/                  dependency graph and ranking
  storage/                .skeletongraph persistence
  retrieval/              classification, resolution, model routing
  assembly/               context packet construction
  session/                memory and dedup
  server/                 MCP server
  install/                per-IDE hook + MCP config writers (`sg install`)
  hooks/                  IDE hook handlers
  llm/                    LiteLLM wrapper for optional CLI execution
  cli/                    Click commands
  engine.py               unified query pipeline
tests/                  unit tests (pytest)
eval/                   the evaluation harness — see eval/README.md
  datasets/               the frozen task sets
docs/
  RESULTS.md              every result, with confidence intervals and caveats
  assets/                 README images and the script that draws the banner and hero
复现结果
所有内容——任务集、每个 Agent 的驱动程序、验证,以及生成每个数字和图表的脚本——都位于 eval/ 中。每次运行的记录和转录文件有数 GB,将随标记版本发布,而不纳入 git。eval/results_summary.json 保存了计算得出的结果,因此无需这些文件也能重新生成图表:
pip install -e ".[all]"
python -m eval.scripts.make_submission_figures
许可证
SkeletonGraph 根据 MIT License 发布——可免费用于商业和私人项目,也可自由使用、修改和分发。
引用
如果 SkeletonGraph 对您的研究有所帮助,请引用这篇预印本:
@misc{doke2026skeletongraph,
  title  = {SkeletonGraph: A Zero-LLM Structural Retrieval Engine for Coding Agents,
            and Why Its Gains Land in the Cost Tail, Not the Median},
  author = {Doke, Yash},
  year   = {2026},
  note   = {Preprint, Research Square},
  doi    = {10.21203/rs.3.rs-10749266/v1},
  url    = {https://doi.org/10.21203/rs.3.rs-10749266/v1}
}
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。