关于 BioMCP-TS
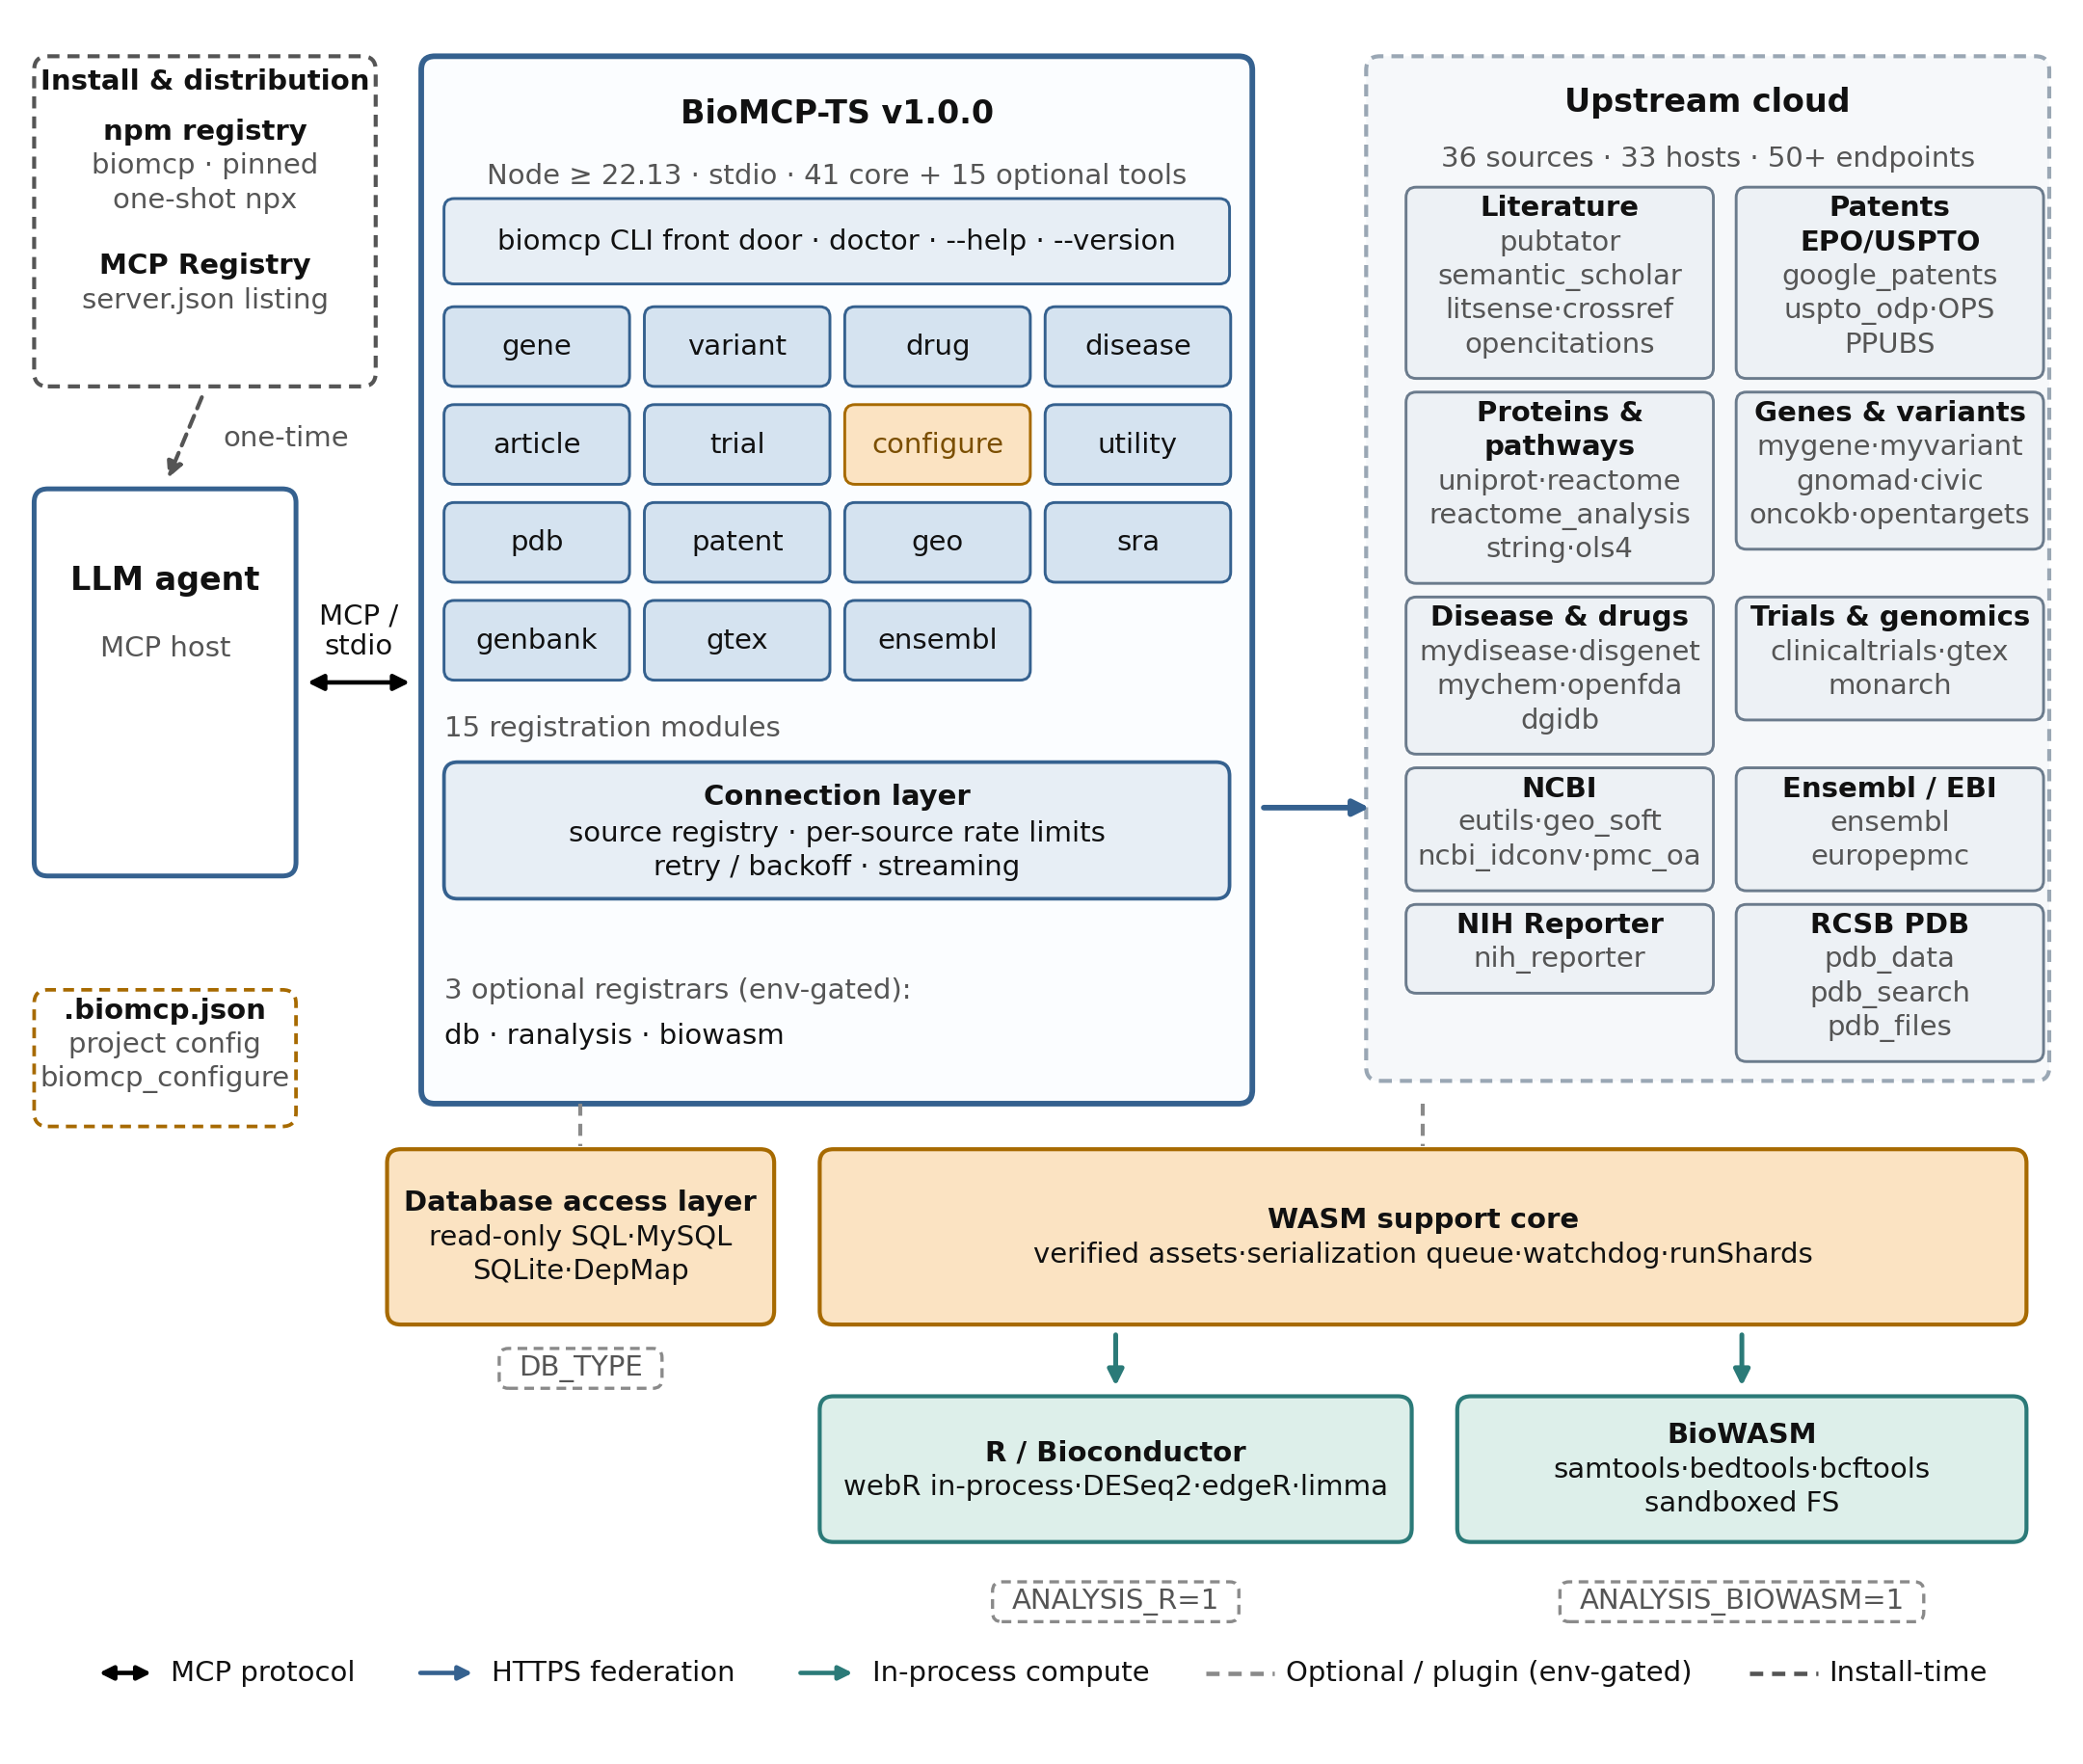
BioMCP-TS 是面向生物医学研究的 MCP 服务,为大模型提供基因、变异、药物、疾病、文献、试验及生物数据工具。它还提供可选的本地数据整理和分析工具箱。
主要功能
- 01搜索和获取基因及变异数据
- 02探索药物、疾病和临床试验
- 03联邦式生物医学文献搜索
- 04查询基因组和结构生物学数据集
- 05搜索专利并查询期刊指标
- 06可选的本地整理和分析工具箱
适用场景
- 01调查基因与疾病、药物之间的关联
- 02查找研究主题相关文献和试验
- 03查看变异注释和基因组记录
- 04搜索生物医学研究相关专利
MCP 相关
以 stdio MCP 服务运行,向 MCP 客户端提供生物医学研究工具,并联合访问上游数据库和 API。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
npx -y biomcpANALYSIS_BIOWASMSet to 1 to enable the samtools/bedtools/bcftools biowasm analysis toolsANALYSIS_RSet to 1 to enable the R/Bioconductor analysis tools (requires the webr peer dependency; use the pinned one-shot client command)DB_TYPESet to mysql or sqlite to enable the read-only SQL database toolsNCBI_API_KEY密钥Higher NCBI E-utilities rate limits (3 -> 10 req/s)S2_API_KEY密钥Higher Semantic Scholar rate limitsOPENFDA_API_KEY密钥Higher OpenFDA rate limitsONCOKB_TOKEN密钥Required by the variant_oncokb tool (OncoKB annotations)DISGENET_API_KEY密钥Required for DisGeNET disease-gene associations本地服务需要在你的电脑上安装运行环境(如 Node.js 18+)。各客户端的配置文件位置不同,请参考客户端文档。
工具
41收录的工具列表 · 更新于 2 周前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| query | string | 是 | 要搜索的基因符号、名称或关键字 |
| chromosome | string | 否 | 按染色体筛选(例如,“7”、“X”) |
| limit | integer | 否 | 最大结果数 |
| offset | integer | 否 | 结果偏移量 |
详细介绍
BioMCP


亮点
让每个人都能使用 Agent 访问生物信息学和生物制药数据库及分析。
- 按类别联邦访问 50 多个生物信息学、制药和专利数据库
- 可选工具箱,支持本地数据库整理,并使用 Bioconductor 和 SAM/BED/BCFtools 进行无依赖分析——无需安装 R、C 工具链或容器
- 完全以开源方式开发的具体示例指南
安装
npx -y biomcp doctor   # diagnose a machine: Node gate, config health, feature gates, peer deps
npx biomcp             # zero-config stdio MCP server (this is what MCP clients run); Node >= 22.13
设置指南见 docs/AGENT-INSTALL.md——一分钟即可开始,提供可复制粘贴的 Claude Desktop、Claude Code、Codex 和 OpenCode 配置项(一个固定版本的规范命令涵盖所有功能)、作为唯一故障排查入口的 biomcp doctor,以及便于 Agent 使用的 API 密钥和可选功能配置路径。
在一台机器上运行多个 Agent: biomcp 会按进程执行 arXiv 的使用条款速率限制(每 3 秒 1 次请求)。在一台机器上运行多个 biomcp MCP 实例时(例如,每个 Agent 运行一个 stdio 实例),各进程之间不会协调速率限制;arXiv 的使用条款会综合适用于你的所有机器。对于在单机上部署多个 Agent 的情况,请运行一个共享的 biomcp serve 守护进程(见 docs/SELF-HOSTING.md),使所有 Agent 共用一个进程和一个全局速率限制器。
可用工具
完整的工具架构(参数、枚举值、默认值)见 src/server/README.md。
基因(7)
| 工具 | 说明 |
|---|---|
gene_search | 按符号、名称或关键词搜索基因,并可按染色体筛选 |
gene_get | 按 HGNC 符号获取详细基因信息,可选择要包含的部分(core、pathways、protein、ontology、go、interactions、expression、protein_atlas、constraint、druggability、dosage_sensitivity、clinical_evidence、disease_associations、diseases、funding)。设置 smart=true 可自动解析基因别名(例如,“HER2” → “ERBB2”) |
gene_diseases | 获取与基因相关的疾病(DisGeNET / OpenTargets) |
gene_drugs | 查找靶向某基因的药物(OpenTargets;封装格式为 { results, warnings?, errors? }——OpenTargets 故障和无法解析的基因会放在 errors[] 中,而不会作为内嵌行出现) |
gene_trials | 查找针对某基因的临床试验 |
gene_articles | 查找与基因相关的文章(联邦检索 PubMed、EuropePMC、Semantic Scholar、arXiv、PubTator、LitSense;封装格式为 { results, warnings?, errors? }——各后端的故障会放在 errors 中) |
gene_enrich | 对基因列表进行通路富集分析(Reactome) |
变异(4)
| 工具 | 描述 |
|---|---|
variant_search | 按 rsid、HGVS、基因、ClinVar 临床意义、频率、CADD 搜索变异 |
variant_get | 获取变异详细信息,可选分区(频率、预测、临床;alphagenome_scores 目前会返回不可用错误,等待重新实现) |
variant_oncokb | 获取 OncoKB 癌症变异注释(需要 ONCOKB_TOKEN) |
variant_trials | 查找与变异相关的临床试验 |
药物(3)
| 工具 | 描述 |
|---|---|
drug_search | 按名称、作用机制或关键词搜索药物(响应结构为 { results, hint? }——未找到匹配项时,hint 会引导针对作用机制/靶点的查询使用 gene_drugs) |
drug_get | 获取药物详细信息,可选分区(us_regulatory、who_regulatory、safety、targets、indications、adverse_events——FDA FAERS 不良反应按报告数量排序;WHO PQ 列表查询,约 650 种全球卫生优先产品) |
drug_trials | 查找药物的临床试验 |
疾病(4)
| 工具 | 描述 |
|---|---|
disease_search | 按名称、表型或关键词搜索疾病(响应结构为 { results, warnings?, errors? }) |
disease_get | 按 ID(DOID、MONDO、OMIM 等)获取疾病详细信息,可选分区(基因关联、表型、通路) |
disease_drugs | 获取治疗某种疾病的药物(OpenTargets;响应结构为 { results, warnings?, errors? }——OpenTargets 故障和未能解析的疾病会放入 errors[],不会作为内联行返回) |
disease_trials | 获取某种疾病的临床试验(ClinicalTrials.gov;响应结构为 { results, warnings?, errors? }) |
文章(4)
| 工具 | 描述 |
|---|---|
article_search | 在 PubMed、EuropePMC、Semantic Scholar、arXiv、PubTator 和 LitSense 中进行联合文献搜索,可选按日期范围筛选;source: "preprint_only" 可切换为仅搜索 bioRxiv+medRxiv 预印本(摘要、引用数、日期筛选)。结果记录包含 journal_issn |
article_get | 按标识符(PMID、PMCID、DOI 或 bioRxiv/medRxiv 预印本 DOI)获取文章详细信息,可选包含以下部分:fulltext(完整文章正文,仅适用于可在 PMC/Europe PMC 免费阅读的文章——包括开放获取和免费阅读文章;默认情况下(fulltext_output="file")写入服务端 Markdown 文件,回复中包含 file_path 和标题大纲(含行号与字符数),便于有选择地使用 Read/Grep,同时避免将正文放入 Agent 上下文;fulltext_output="inline" 则通过 fulltext_max_chars 返回有长度上限的文本片段,默认值为 40000)、oa(开放获取/许可元数据和链接:状态为 open_access/free_to_read/paywalled/not_in_pmc/unknown,许可、PMC/PDF/DOI 链接)、annotations、graph(引用图)、citation(快速/完整引文数据;预印本的引用数据来自 Europe PMC)。all 不包含 fulltext。预印本记录包含所有版本、许可、类别、资助方、JATS 全文 URL(仅提供链接——获取文本请使用 preprint_fulltext)以及已发表版本映射。记录包含 journal_issn |
preprint_fulltext | 按需获取 bioRxiv/medRxiv 预印本全文(将 JATS XML 解析为各个部分),通过预印本 DOI 查询,可选指定版本(默认:最新版本)。严格按需获取(搜索期间绝不获取),下载间隔至少为 3 秒,按 (doi, version) 缓存——每个版本的 JATS 内容不可变——并遵循许可要求(cc_by → 每次回复均包含 cc by 和 CC URL;具体文章的许可决定其再利用方式)。www.biorxiv.org 会严格限制访问频率:遇到 429/Cloudflare 判定时,所有下载至少暂停 60 秒(遵循 Retry-After),冷却期间的调用会如实返回包含 retry_after_sec 的 rate_limited 信封;缓存副本仍可即时提供。output="file"(默认)会写入服务端 Markdown 文件(file_path + 大纲);output="inline" 会返回有长度上限的部分(fulltext_max_chars)。若需处理整个语料库,请使用 bioRxiv/medRxiv 每月 S3 存储桶(https://www.biorxiv.org/tdm) |
journal_metrics | OpenAlex 期刊质量指标(2 年平均被引次数——开放获取影响因子的替代指标)、h 指数、质量列表;可按名称、NLM 缩写或 ISSN 查询 |
试验(2)
| 工具 | 描述 |
|---|---|
trial_search | 按病症、干预措施、状态或阶段搜索临床试验。通过 page_token 使用基于游标的分页 |
trial_get | 按 NCT ID 获取试验详细信息,可选包含以下部分(资格条件、地点、结局) |
实用工具(2)
| 工具 | 描述 |
|---|---|
discover | 在所有实体类型中解析自由文本概念 |
batch_get | 并行检索多个实体 |
结构生物学(1)
| 工具 | 描述 |
|---|---|
pdb | 搜索 PDB 结构,获取条目元数据,可选包含以下部分(聚合物实体、配体、组装体、实验、引文),并下载结构文件(mmCIF/PDB) |
专利(2)
| 工具 | 描述 |
|---|---|
patent_search | 在全球范围内搜索专利(US、EP、WO、JP、100 多个主管机构),支持按受让人/发明人/CPC/状态/日期筛选,并按相关性排序(sort_by)。多词概念请使用引号精确匹配(例如,“flow cytometry”)。通过共引文挖掘自动发现奠基性现有技术(seminal_prior_art;设为 seminal: false 可禁用)。默认后端:USPTO Public Search 全文搜索(US,无需密钥,按相关性排序)+ EPO OPS(全球范围,需密钥);也可通过 source 使用 uspto_odp(US 书目信息)和 google_patents(尽力而为) |
patent_get | 按公开编号获取专利详情,包括各部分内容:摘要、权利要求(US 全文来自 USPTO Public Search;配置后,EP/WO 来自 EPO OPS,否则使用 Google Patents 页面)、引文(前向+后向)、专利族、分类 |
GEO(2)
| 工具 | 描述 |
|---|---|
geo_search | 按条目类型(GSE/GSM/GPL/GDS)和生物体搜索 NCBI GEO 功能基因组学研究(表达微阵列、RNA-seq、单细胞系列);结果包含交叉链接(bioproject、pubmed_ids;当 NCBI 链接 SRA 研究时还包括 sra_project,否则请使用 geo_get 的 sra 字段),便于串联查询 |
geo_get | 获取 GEO 系列/样本/平台的完整 SOFT 记录:摘要、生物体、样本预览(≤20)、补充文件 URL 和交叉引用;还可选择下载第一个补充文件。GDS 策展数据集会返回结构化指引({ accession, guidance, see_also: { series, sample } }),指向底层的 GSE/GSM,而非返回记录 |
SRA(2)
| 工具 | 描述 |
|---|---|
sra_search | 通过自由文本、登录号或字段语法搜索 NCBI 序列读取档案中的测序实验和运行;返回包含文库策略和运行次数的实验/研究/样本登录号 |
sra_get | 获取 SRA 登录号的完整详情:运行(SRR/ERR/DRR — 仪器、spots、碱基、大小)、实验(SRX/ERX/DRX — 文库设计)、研究(SRP/ERP/DRP — 实验列表)或样本(SRS/ERS/DRS);NCBI SRA 同样会索引 NCBI、ENA 和 DDBJ 的登录号 |
GenBank(3)
| 工具 | 描述 |
|---|---|
genbank_search | 按普通词语、登录号或字段语法搜索 NCBI 核苷酸记录(GenBank/RefSeq/INSDC);结果包括 accession.version、定义、长度、生物体、拓扑结构 |
genbank_get | 以 GenBank 平面文件或 FASTA 格式获取 GenBank/RefSeq 记录;完整记录上限为 2 Mb——更大的记录需要指定 seq_start/seq_stop 区域(最多 10 Mb;使用 strand=2 获取反向链) |
genbank_genes | 将 GenBank/RefSeq 登录号映射到对应的 NCBI Gene ID(elink nuccore→gene),以便衔接基因工具 |
GTEx(2)
| 工具 | 描述 |
|---|---|
gtex_expression | 获取 GTEx 各组织中的基因表达中位数(Analysis v10,54 个组织位点,TPM,按从高到低排序);接受 HGNC 符号或 Ensembl 基因 ID,可选单组织筛选 |
gtex_eqtl | 获取特定 GTEx 组织(v10)中某个基因显著的 cis-eQTL 关联:variant_id、p_value、NES、slope,按 p-value 升序排序 |
Ensembl(4)
| 工具 | 描述 |
|---|---|
ensembl_lookup | 将基因解析为 Ensembl 信息,适用于约 356 个物种:稳定 ID(含版本)、符号、当前组装上的坐标、规范转录本;expand=true 会添加转录本及其翻译/蛋白质 ID |
ensembl_homology | 通过 Ensembl Compara 查找跨物种的直系同源基因/旁系同源基因——目标稳定 ID、分类层级、序列一致性百分比,并按一致性排序;使用 target_species/target_taxon 筛选 |
ensembl_consequence | 通过 Ensembl VEP 按需计算新变异和非人类物种的变异后果:最严重后果、各转录本的影响(SIFT/PolyPhen)、共定位的 ClinVar/COSMIC/gnomAD 数据。已知人类变异可通过 variant_get 获取更深入的预计算评分;为提高精度,优先使用 HGVS 输入,而非 rsID |
ensembl_region | 查询当前组装中基因组区间(chr:start-end)内的基因/转录本/已知变异——用于位点初筛 |
R 分析(4,可选 — ANALYSIS_R=1)
| 工具 | 描述 |
|---|---|
analysis_r_deseq2 | 使用沙盒化 WebAssembly R 和 Bioconductor DESeq2 对 RNA-seq 计数进行差异表达分析(负二项分布、独立过滤、可选 LFC 收缩)。输入:整数计数矩阵 + 样本元数据 + 设计公式;输出:按调整后 p 值排列的基因摘要 Markdown 表格(format="json"、include_full=true 可获取完整的 base64(gzip(TSV)) 表格) |
analysis_r_edger | 使用 edgeR 进行差异表达分析——TMM 标准化、经验贝叶斯离散度、准似然 F 检验(test="qlm")或双组精确检验;输入/输出约定相同 |
analysis_r_limma | 使用 limma-voom 进行差异表达分析——采用精度加权线性模型和经验贝叶斯调节;输入/输出约定相同 |
analysis_r_session_info | R 运行时报告:R/webR 版本、已安装软件包的版本、内存、镜像端点——用于诊断分析问题 |
首次使用时会启动约 1 GB 的 WebAssembly R 工作进程,并从 GitHub releases 下载 wasm 软件包(约 62 MB,之后会缓存)。需要在 biomcp 旁安装 webr。指南:docs/R-ANALYSIS.md。
Biowasm 分析(8 个,可选——ANALYSIS_BIOWASM=1)
| 工具 | 描述 |
|---|---|
analysis_bam_summary | 检查比对文件(SAM/BAM/CRAM):头部 contig、样本/读取组、flagstat 比对指标,以及通过 idxstats 获取的各 contig 计数(需已建立索引)——在处理区域之前先了解“这个 BAM 中有什么?” |
analysis_bam_view_region | 获取基因组区域内的读取、深度、pileup 或读取提取结果(samtools view/depth/mpileup);已建立索引的源文件使用快速位置检索,无索引的源文件则通过流式 BED 筛选(深度计算要求输入按坐标排序,并会检测顺序违规),返回计数、覆盖度表、SAM 行或 BAM 文件 |
analysis_bcf_summary | 检查 VCF/BCF:contig、样本数量和名称,以及头部中的 INFO/FORMAT 字段清单 |
analysis_bcf_view_region | 以精简字段投影的形式获取区域内变异(bcftools query):选择列、样本子集、表达式筛选、变异类型——或生成切片后的 VCF.gz 文件 |
analysis_bed_op | 对 BED 轨道执行区间代数运算(bedtools intersect/merge/subtract/coverage/jaccard/sort),排序输入可使用流式 -sorted 算法 |
analysis_biowasm_convert | 格式转换:通过 samtools view 转换 SAM/BAM/CRAM,通过 bcftools view 转换 VCF/BCF,通过 bcftools query 将 VCF/BCF 转换为 TSV;结果为可复用作 artifact_id 的文件句柄 |
analysis_biowasm_session_info | Biowasm 运行时报告:固定的工具版本、资源缓存状态、引擎状态、保留的文件和内存 |
analysis_biowasm_cli | 受限的备用入口:使用经过允许列表筛选的 samtools/bedtools/bcftools 子命令和经架构验证的参数(不使用 shell,路径仅限 /shared 下) |
首次使用时会下载经校验和验证的 wasm 资源(约 4.5 MB,并会缓存);无需额外的 npm 包。已建立索引的源文件可通过快速位置检索回答区域查询(仅读取约 0.2% 的文件);无索引的源文件则回退到流式 BED 筛选。指南:docs/BIOWASM-ANALYSIS.md。
引用模块
引用模块以快速(约 4 秒)或完整(约 15–30 秒)模式整合 5 个提供方的数据。向前引用列表来自 Europe PMC、OpenCitations 和 Semantic Scholar;Crossref 提供引用计数和反向引用。提供方矩阵和架构详情:src/server/README.md。
可选功能
随软件包提供但默认不启用的功能。每项功能均有专属指南:
| 功能 | 启用方式 | 指南 |
|---|---|---|
数据库访问 — 用于 MySQL 和本地文件 SQLite 的只读 SQL 工具(db_query、db_list_tables、db_describe_table) | 设置 DB_TYPE(及连接环境变量);MySQL 需要 mysql2 peer 依赖项——请使用固定版本的一次性客户端命令(参见 docs/DATABASE.md) | docs/DATABASE.md |
R 分析 — 在沙盒化 WebAssembly R 中运行 DESeq2/edgeR/limma 的 Bioconductor 差异表达分析(analysis_r_deseq2、analysis_r_edger、analysis_r_limma、analysis_r_session_info);首次使用时从 GitHub releases 下载 wasm 软件包(约 62 MB,会缓存;网络较慢时可使用 asset_timeout_ms 或自行获取的 mirror_url) | 设置 ANALYSIS_R=1;需要 webr peer 依赖项——请使用固定版本的一次性客户端命令 ["npx","-y","-p","[email protected]","-p","[email protected]","biomcp"](启用所有功能的版本会添加 -p mysql2@3);预计 RSS 约为 1 GB | docs/R-ANALYSIS.md |
| Biowasm 分析 — 在沙盒化 WebAssembly 中运行 samtools/bedtools/bcftools(BAM/BED/VCF);可对真实人类规模的数据集进行流式处理和索引(扫描 BAM 文件约 300 MB,区域查询仅访问文件约 0.2% 的内容);资源首次使用时缓存,约 4.5 MB;无需额外 npm 软件包 | 设置 ANALYSIS_BIOWASM=1 | docs/BIOWASM-ANALYSIS.md |
Agent(以及用户)无需手动编辑环境变量配置块,即可通过始终可用的 biomcp_configure 工具自行完成配置:该工具会报告每个参数的状态和来源,为上述可选功能写入 .biomcp.json 项目配置文件(环境变量优先级更高;仅限环境变量的参数只能查询,且其值会被隐藏),验证更改、检测冲突、检查 peer 依赖项前提条件,并详细说明重启和验证步骤。详情:docs/ENV-VARS.md → Project config file。
文档
| 文档 | 内容 |
|---|---|
| docs/AGENT-INSTALL.md | 引导式安装和客户端配置(Claude Desktop、Claude Code、Codex、OpenCode) |
| docs/ENV-VARS.md | 所有环境变量的唯一可信信息来源 |
| docs/DATABASE.md | 数据库访问功能指南 |
| docs/R-ANALYSIS.md | R 分析功能指南(WebAssembly 中的 Bioconductor) |
| docs/BIOWASM-ANALYSIS.md | Biowasm 分析功能指南(WebAssembly 中的 samtools/bedtools/bcftools) |
| docs/DEVELOPMENT.md | 构建、测试、发布工作流 |
| docs/development/CI.md | CI 流水线、Dependabot 自动化、自动合并安全模型 |
| src/server/README.md | 完整工具架构(参数、枚举、默认值) |
| agent-test/README.md | 面向用户 Agent 的分析工具端到端测试 |
许可证
本项目基于 Apache License, Version 2.0 授权。归属信息请参阅 NOTICE。
BioMCP-TS 改编自上游项目 BioMCP Rust(MIT),采用 Agent 优先的开发方式并有所增强——谨向原作者致谢。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。